Niniejszy artykuł przedstawia powtarzalny schemat bioinformatyczny integrujący publiczne zbiory danych transkrypomicznych, uczenie maszynowe, walidację zewnętrzną, ilościową PCR z odwrotną transkrypcją, przesiew Connectivity Map oraz dokowanie molekularne w celu zidentyfikowania biomarkerów nadciśnienia płucnego i potencjalnych związków terapeutycznych.
Artykuł badawczy
Identyfikacja biomarkerów nadciśnienia płucnego oraz potencjalnych związków terapeutycznych z wykorzystaniem bioinformatyki i uczenia maszynowego
W tym artykule
Podsumowanie
Streszczenie
Celem niniejszego badania była identyfikacja molekularnych biomarkerów związanych z nadciśnieniem płucnym (PH) oraz potencjalnych małocząsteczkowych związków leczniczych z wykorzystaniem publicznych danych transkrypcyjnych i niezależnych zasobów walidacyjnych. Trzy zbiory danych z Gene Expression Omnibus (GSE22356, GSE33463 oraz GSE48149) zostały zintegrowane po normalizacji, adnotacji sond i korekcji efektu serii za pomocą metody ComBat. Do identyfikacji kluczowych genów cech wykorzystano analizę różnicowej ekspresji, ważoną analizę sieci koekspresji genów (WGCNA), analizę wzbogacenia funkcjonalnego, analizę sieci oddziaływań białko-białko oraz trzy algorytmy uczenia maszynowego. Wydajność diagnostyczną oceniono za pomocą krzywych charakterystyki ROC. Walidacja zewnętrzna obejmowała niezależną kohortę tkanek płucnych (GSE117261), zbiór danych z sekwencjonowania RNA pojedynczych komórek tętnicy płucnej (GSE210248) oraz walidację za pomocą ilościowej odwrotnej transkrypcji i PCR (qRT-PCR) w niezależnych próbkach tkanek płucnych. Do przesiewania potencjalnych związków wykorzystano repozycjonowanie leków w oparciu o Connectivity Map oraz dokowanie molekularne. Zidentyfikowano siedemdziesiąt osiem genów o różnicowej ekspresji, z czego jako kluczowe geny cech wybrano CXCL10, JUN, IFIH1, MX1 oraz TLR7. W niezależnej kohorcie tkanek płucnych GSE117261 gen JUN wykazał najsilniejsze wsparcie zewnętrzne, podczas gdy replikacja pozostałych genów była zmienna. Analiza qRT-PCR w 20 biologicznie niezależnych próbkach z nadciśnieniem tętniczym płuc oraz 20 próbkach kontrolnych potwierdziła nadekspresję wszystkich pięciu genów. Pozorny model qRT-PCR oparty na pięciu genach oraz 100 powtórzeń stratyfikowanej pięciokrotnej walidacji krzyżowej dały pole pod krzywą (AUC) wynoszące 1,000, choć niewielka kohorta wymaga ostrożnej interpretacji i niezależnej walidacji prospektywnej. Analiza pojedynczych komórek z zestawu GSE210248 potwierdziła zaburzoną komunikację między komórkami odpornościowymi a strukturalnymi oraz przełączanie fenotypowe komórek mięśni gładkich. Związek BRD-K91900765/VX-745 zajął najwyższą pozycję w przesiewie Connectivity Map. Białko MAPK14/p38α, jego ustalony cel farmakologiczny, zostało uwzględnione jako referencyjne białko dokujące, podczas gdy dokowanie do pięciu białek związanych z biomarkerami miało charakter eksploracyjny. Wyniki te wskazują na pięć genów jako potencjalne biomarkery PH oraz VX-745 jako hipotezę obliczeniowego repozycjonowania leku wymagającą walidacji eksperymentalnej.
Wprowadzenie
Nadciśnienie płucne (PH) to postępujący zespół kardiopulmonalny charakteryzujący się trwale podwyższonym ciśnieniem w tętnicy płucnej, zwiększonym oporem naczyniowym płuc oraz ostatecznie niewydolnością prawej komory serca. Obecne kryteria hemodynamiczne definiują nadciśnienie płucne jako średnie ciśnienie w tętnicy płucnej w spoczynku wynoszące >20 mmHg, zmierzone za pomocą cewnikowania prawego serca1Wśród różnych podtypów klinicznych nadciśnienie tętnicze płuc (PAH) jest jedną z najcięższych postaci i charakteryzuje się postępującym remodelowaniem naczyń płucnych. Jego cechy patologiczne obejmują dysfunkcję śródbłonka, nieprawidłową proliferację i migrację komórek mięśni gładkich tętnic płucnych, aktywację fibroblastów błony zewnętrznej, odkładanie macierzy zewnątrzkomórkowej, naciekanie komórek zapalnych oraz zwężenie lub obliterację dystalnych tętnic płucnych.2Zmiany te wskazują, że PH/PAH nie jest jedynie zaburzeniem skurczu naczyń, lecz złożoną chorobą przebudowy naczyniowej, napędzaną przez skoordynowane mechanizmy molekularne, komórkowe i immunologiczno-zapalne.
Obecne terapie PAH celują głównie w szlaki prostacykliny, endoteliny, tlenku azotu – rozpuszczalnej cyklazy guanylowej oraz fosfodiesterazy typu 53˒4. Chociaż leczenie to poprawia objawy, wydolność wysiłkową i parametry hemodynamiczne, jego efekty pozostają w dużej mierze naczyniorozszerzające i hemodynamiczne. Zdolność tych terapii do odwracania utrwalonego przebudowy naczyniowej płuc jest ograniczona, a wielu pacjentów nadal doświadcza progresji choroby mimo stosowania terapii skojarzonej. Dlatego identyfikacja nowych biomarkerów molekularnych i kandydatów terapeutycznych odzwierciedlających proces przebudowy stanowi istotną niezaspokojoną potrzebę. W szczególności aktywacja immunologiczno-zapalna, sygnalizacja związana z interferonem, szlaki receptorów Toll-podobnych, rekrutacja immunologiczna pośredniczona przez chemokiny oraz zmiana fenotypowa komórek mięśni gładkich wyłoniły się jako potencjalne czynniki przyczyniające się do progresji PH/PAH5˒6.
Wysokoprzepustowe zestawy danych transkrypcyjnych stanowią cenne zasoby do identyfikacji sygnatur molekularnych związanych z chorobą w nadciśnieniu płucnym (PH) i nadciśnieniu płucnym z niedoskonalnością serca (PAH). Jednak badania oparte na pojedynczym zestawie danych są często ograniczone przez małą liczebność próby, efekty seryjne, heterogeniczność platform oraz niewystarczającą walidację. Analiza ekspresji różnicowej pozwala zidentyfikować geny o zmienionej ekspresji, ale może nie w pełni oddawać powiązane z chorobą moduły koekspresji lub interakcje na poziomie sieci. Analiza sieci koekspresji genów z wagami (WGCNA) umożliwia identyfikację modułów genów związanych z cechami choroby, podczas gdy analiza sieci oddziaływań białko-białko (PPI) pozwala ujawnić geny o wysokim stopniu połączeń w sieciach biologicznych. Metody uczenia maszynowego mogą również pomóc w priorytetyzacji genów o wartości diagnostycznej lub klasyfikacyjnej. Jednak poleganie na pojedynczym algorytmie może wprowadzić błąd specyficzny dla danego modelu. Zintegrowanie analizy ekspresji różnicowej, WGCNA, analizy sieci PPI oraz wielu algorytmów uczenia maszynowego może zatem zwiększyć wiarygodność procesu odkrywania biomarkerów.
Kolejnym istotnym wyzwaniem w badaniach nad biomarkerami transkrypcyjnymi jest interpretacja biologiczna. Sygnały z tkanek w analizie bulk mogą odzwierciedlać zmiany w ekspresji genów w obrębie komórek naczyniowych, naciekanie komórek odpornościowych lub zmienione proporcje wielu populacji komórkowych. Sekwencjonowanie RNA z pojedynczych komórek (scRNA-seq) stwarza możliwość osadzenia genów kandydatów wyłonionych w analizie bulk w kontekście komórkowym. W przypadku nadciśnienia płucnego (PH/PAH) przebudowa naczyń płucnych obejmuje komórki śródbłonka, komórki mięśni gładkich, fibroblasty, monocyty/makrofagi, limfocyty oraz inne komórki odpornościowe lub strukturalne. Progresja choroby wiąże się również ze zmienioną komunikacją międzykomórkową oraz przełączaniem fenotypowym komórek mięśni gładkich. W związku z tym połączenie screeningu transkrypcyjnego bulk z walidacją na poziomie pojedynczych komórek może pomóc w ustaleniu, czy biomarkery kandydackie są związane z aktywacją immunologiczną, strukturalną przebudową naczyń czy zaburzeniem komunikacji wielokomórkowej.
Oprócz odkrywania biomarkerów, sygnatury transkrypcyjne mogą być wykorzystywane do komputerowego repozycjonowania leków. Mapa Połączeń (Connectivity Map, CMap) wiąże profile ekspresji genów związane z chorobą z małymi cząsteczkami, które mogą odwracać lub modulować te sygnatury7. W połączeniu z kuratelą związków i dokowaniem molekularnym strategia ta może generować hipotezy terapeutyczne możliwe do przetestowania eksperymentalnie. Chociaż predykcja CMap i dokowanie molekularne nie pozwalają na ustalenie skuteczności leku, mogą one pomóc w priorytetyzacji związków kandydackich do przyszłych testów wiązania z celem, eksperymentów komórkowych oraz walidacji w modelach zwierzęcych.
Opracowano zintegrowany i powtarzalny schemat postępowania w celu zidentyfikowania biomarkerów PH/PAH oraz potencjalnych związków terapeutycznych. Zintegrowano trzy publiczne transcriptomiczne zbiory danych z bazy Gene Expression Omnibus po przeprowadzeniu normalizacji i korekty efektu seryjnego. Do przesiewowej analizy w celu wyłonienia stabilnych genów cech wykorzystano analizę różnicowej ekspresji, WGCNA, analizę wzbogacenia funkcjonalnego, analizę sieci PPI oraz trzy algorytmy uczenia maszynowego. Do dalszej oceny wybranych genów zastosowano analizę charakterystyki operacyjnej odbiornika (ROC), niezależną kohortę walidacyjną z tkanki płucnej, dowody z sekwencjonowania RNA pojedynczych komórek tętnicy płucnej oraz walidację za pomocą ilościowej PCR z odwrotną transkrypcją w niezależnych próbkach. Na koniec, w celu zidentyfikowania potencjalnych związków, zastosowano repozycjonowanie leków w oparciu o CMap oraz dokowanie molekularne. Nowatorstwo badania polega na wielowarstwowym modelu walidacji, który łączy odkrycia transcriptomiczne z tkanki objętościowej, priorytetyzację za pomocą uczenia maszynowego, niezależną walidację, eksperymentalne potwierdzenie ilościową PCR z odwrotną transkrypcją, mechaniczną interpretację na poziomie pojedynczych komórek oraz obliczeniowy przesiew związków. Hipoteza badawcza zakładała, że PH/PAH jest napędzane przez skoordynowany program immunologiczno-zapalny i przebudowy naczyniowej, a stabilne geny w ramach tego programu mogą służyć jako potencjalne biomarkery i stwarzać możliwości repozycjonowania leków.
Protokół
Publiczne zbiory danych Gene Expression Omnibus (GEO) analizowane w niniejszym badaniu zawierały zanonimizowane dane transkrypcyjne z wcześniej opublikowanych badań i nie wymagały dodatkowej zgody komisji etycznej. Komisja Etyczna Uniwersytetu w Huaihua zatwierdziła niezależne badanie walidacyjne metodą ilościowej reakcji łańcuchowej polimerazy z odwrotną transkrypcją (qRT-PCR) w ludzkiej tkance płucnej (numer zgody 2024(A05112)). Przed pobraniem próbek od wszystkich uczestników lub ich prawnie upoważnionych przedstawicieli uzyskano pisemną świadomą zgodę. Procedury zatwierdzenia i zgody zastosowano do wszystkich 20 próbek tkanki płucnej od pacjentów z nadciśnieniem płucnym (PAH) oraz 20 próbek kontrolnych wykorzystanych w walidacji qRT-PCR. Narzędzia badawcze użyte w niniejszym protokole wymieniono w Tabeli materiałów.
1. Gromadzenie i wstępne przetwarzanie publicznych zbiorów danych transkryptomicznych
Zbiory danych z mikromacierzy GSE22356, GSE33463 i GSE48149 powiązane z nadciśnieniem płucnym (PH) pobrano z bazy danych GEO. Próbki z PH/nadciśnieniem tętniczym płuc (PAH) oraz próbki kontrolne wyodrębniono zgodnie z oryginalnymi adnotacjami fenotypowymi. Macierze ekspresji oraz pliki adnotacji platform pobrano za pomocą powtarzalnych skryptów R oraz pakietu GEOquery.
Adnotacja sond oraz mapowanie symboli genów przeprowadzono w sposób spójny dla wszystkich zbiorów danych. W przypadku, gdy wiele sond mapowało na ten sam gen, obliczano średnią wartość ekspresji. Zastosowano normalizację kwantylową, a geny o niskiej ekspresji lub niskiej wariancji zostały usunięte. Zbiory danych połączono, a efekty serii skorygowano za pomocą algorytmu ComBat z pakietu sva8. Korekcję oceniono za pomocą wykresów pudełkowych oraz analizy głównych składowych.
2. Identyfikacja genów o różnym poziomie ekspresji
Do porównania poziomów ekspresji między próbkami PH a kontrolnymi w macierzy ekspresji skorygowanej o efekt serii wykorzystano pakiet limma9. Zastosowano dopasowany model liniowy oraz statystykę empirycznego Bayesa. Geny różnicowo wyrażone zdefiniowano przy użyciu skorygowanej wartości P <0,05 oraz bezwzględnej zmiany log2 fold change > 0,585. Wyniki zwizualizowano za pomocą wykresów wulkanicznych (volcano plots) i map ciepła (heatmaps).
3. Konstrukcja ważonej sieci koekspresji genów
Ważoną sieć koekspresji genów skonstruowano przy użyciu pakietu WGCNA10. W celu wykrycia wartości odstających przeprowadzono klastrowanie próbek. Moc miękkiego progowania (soft-thresholding power) wybrano na podstawie indeksu dopasowania topologii wolnej od skali. Moduły genowe zidentyfikowano za pomocą algorytmu dynamicznego przycinania drzewa. Korelację eigengenów modułów analizowano w odniesieniu do fenotypu PH, a następnie wybrano moduł związany z chorobą o najsilniejszej korelacji. Geny z kluczowego modułu zestawiono z genami różnicowo eksponowanymi w celu wyłonienia genów konsensusowych.
4. Analiza wzbogacenia funkcjonalnego
Kategorie procesów biologicznych, komponentów komórkowych i funkcji molekularnych Gene Ontology zostały przeanalizowane przy użyciu oprogramowania clusterProfiler11. W celu zidentyfikowania szlaków sygnalizacyjnych przeprowadzono analizę wzbogacenia szlaków Kyoto Encyclopedia of Genes and Genomes12. Jako progi wzbogacenia przyjęto wartość P < 0,05 oraz wartość q < 0,2, a wzbogacone terminy przedstawiono za pomocą wykresów bąbelkowych11.
5. Konstrukcja sieci oddziaływań białko-białko i identyfikacja genów hubowych
Konsensusowa lista genów została wprowadzona do bazy danych STRING, z wybranym gatunkiem Homo sapiens oraz progiem ufności dla oddziaływań > 0,413. Plik oddziaływań zaimportowano do programu Cytoscape, a wtyczkę CytoHubba wykorzystano do rankingowania genów według stopnia węzła. Geny o wysokim stopniu połączeń zdefiniowano jako geny hubowe.
6. Wybór genów cech diagnostycznych przy użyciu uczenia maszynowego
Zastosowano trzy niezależne algorytmy selekcji cech. Po pierwsze, przeprowadzono regresję logistyczną z wykorzystaniem metody LASSO (least absolute shrinkage and selection operator) przy użyciu pakietu glmnet i 10-krotnej walidacji krzyżowej w celu zidentyfikowania genów o niezerowych współczynnikach14. Po drugie, zastosowano rekurencyjną eliminację cech (recursive feature elimination) z wykorzystaniem maszyn wektorowych wsparcia (support vector machines), aby usunąć redundantne cechy i wybrać podzbiór cech, który osiągnął najwyższą dokładność w walidacji krzyżowej15. Po trzecie, skonstruowano model lasu losowego, a cechy uszeregowano według średniego spadku zanieczyszczenia Gini16. Przecięcie zbiorów genów uzyskanych z trzech algorytmów posłużyło do zdefiniowania końcowego zestawu kluczowych genów cech. Pakiet pROC został wykorzystany do wygenerowania krzywych charakterystyki ROC (receiver operating characteristic) oraz obliczenia wartości powierzchni pod krzywą (AUC)17.
7. Walidacja genów kluczowych z wykorzystaniem niezależnych zbiorów danych bulk oraz single-cell
Zestaw danych GSE117261 został wykorzystany jako niezależna zewnętrzna kohorta walidacyjna dla tkanki płucnej, zawierająca 58 próbek z PAH oraz 25 próbek kontrolnych od dawców niezakwalifikowanych18. Zestaw ten nie był używany w analizie odkrywczej różnicowej ekspresji, konstrukcji ważonej sieci koekspresji genów ani w selekcji cech za pomocą uczenia maszynowego. Macierz ekspresji została znormalizowana i adnotowana, a różnicową ekspresję przeanalizowano przy użyciu pakietu limma v3.68.0. Korekcja stopy fałszywych odkryć metodą Benjamini-Hochberga została zastosowana dla całego adnotowanego transkrypтому. Krzywe charakterystyki operacyjnej odbiornika (ROC) dla pojedynczych genów obliczono przy użyciu pakietu pROC v1.19.0.1, 95% przedziałów ufności DeLonga oraz punktów odcięcia wskaźnika Youdena. W ramach GSE117261 dopasowano eksploracyjny model regresji logistycznej dla pięciu genów, a jego wewnętrzną wydajność dodatkowo oceniono za pomocą wielokrotnej zagnieżdżonej walidacji krzyżowej.
Zbiór danych GSE210248 (Tabela 1) został wykorzystany jako zewnętrzny zestaw walidacyjny dla pojedynczych komórek tętnicy płucnej, zawierający próbki od trzech pacjentów z PAH oraz trzech zdrowych dawców19. Dane zostały przetworzone przy użyciu oprogramowania Seurat v5.5.1 w celu kontroli jakości, normalizacji, redukcji wymiarowości, klastrowania i adnotacji komórek20. Zidentyfikowano główne populacje komórek, w tym komórki śródbłonka, komórki mięśni gładkich, fibroblasty, monocyty/makrofagi oraz komórki T/natural killer. Komunikację międzykomórkową przeanalizowano za pomocą CellChat v2.1.2 oraz bazy danych ligandów i receptorów CellChatDB.human21. Obiekt CellChat utworzono na podstawie znormalizowanej macierzy ekspresji Seurat oraz metadanych dotyczących typów komórek. Zidentyfikowano geny nadekspresjonowane oraz interakcje ligand-receptor, obliczono prawdopodobieństwa komunikacji, usunięto interakcje obejmujące grupy komórek liczące mniej niż 10 komórek, a następnie wywnioskowano i zagregowano sieci komunikacyjne na poziomie szlaków. Zbiór danych ten został wykorzystany wyłącznie do zewnętrznej walidacji mechanistycznej, a nie do trenowania modelu.
| Element | Opis |
| Zbiór danych | GSE210248 |
| Typ danych | sekwencjonowanie RNA pojedynczych komórek metodą kroplową 10x Genomics; wysokoprzepustowe profilowanie transkryktomiczne |
| Próbki ludzkie | trzy próbki tętnicy płucnej z PAH oraz trzy próbki tętnicy płucnej od zdrowych dawców |
| Źródło tkanki | tkanka tętnicy płucnej ex vivo, odzwierciedlająca głównie ekologię komórkową ściany naczyniowej płuc oraz proces przebudowy naczyniowej |
| Główny cel analityczny | lokalizacja typów komórek, przełączanie fenotypowe komórek mięśni gładkich, komunikacja między komórkami odpornościowymi a strukturalnymi oraz walidacja spójności mechanistycznej genów kandydackich |
Tabela 1: Podstawowe informacje dotyczące zbioru danych do walidacji jednokomórkowej GSE210248. Tabela podsumowuje numer dostępu do zbioru danych, platformę sekwencjonowania, źródło tkanki, skład próbek oraz cel analityczny walidacji jednokomórkowej tętnicy płucnej.
8. Walidacja ekspresji genów metodą qRT-PCR
Walidacja metodą qRT-PCR objęła 20 biologicznie niezależnych próbek tkanki płucnej PAH od pacjentów z PH/PAH oraz 20 biologicznie niezależnych kontrolnych próbek tkanki płucnej. Całkowity RNA wyekstrahowano przy użyciu zestawu Total RNA Extraction Kit. Stężenie i czystość RNA oceniono za pomocą spektrofotometru, a integralność RNA oceniono za pomocą elektroforezy w żelu agarozowym. Do analizy włączono wyłącznie próbki RNA o wartościach A260/280 między 1,8 a 2,1 i bez widocznej degradacji.
Równe ilości RNA poddano odwrotnej transkrypcji do komplementarnego DNA przy użyciu zestawu Solarbio Universal RT-PCR Kit (AMV; nr katalogowy RP1200). Ilościową PCR dla CXCL10, JUN, IFIH1, MX1 i TLR7 przeprowadzono z użyciem SYBR Green PCR Master Mix w systemie Real-Time PCR. Każda próbka biologiczna była analizowana w trzech powtórzeniach technicznych, wraz z kontrolami bez matrycy (no-template) i bez odwrotnej transkrypcji (no-reverse-transcription). Do dalszych analiz wykorzystano średnią wartość Ct z trzech powtórzeń technicznych; powtórzenia techniczne nie były traktowane jako niezależne obserwacje. Zastosowano startery obejmujące złącza ekson-ekson, generujące amplikony o długości 80–200 bp (Tabela 2). Specyficzność starterów zweryfikowano za pomocą NCBI Primer-BLAST oraz analizy krzywej topnienia22.
β-actin (ACTB) wykorzystano jako wewnętrzny gen referencyjny do normalizacji poziomów ekspresji genów docelowych. Ekspresję względną obliczono metodą 2-ΔΔCt23. Do porównań międzygrupowych, w zależności od rozkładu danych, zastosowano dwustronne testy U Manna-Whitneya, a dla pięciu genów wprowadzono korektę stopy odkryć fałszywych metodą Benjamini-Hochberga. Krzywe ROC dla pojedynczych genów wygenerowano z 95% przedziałami ufności DeLonga, a optymalne punkty odcięcia wybrano za pomocą indeksu Youdena. Model regresji logistycznej dla pięciu genów został wstępnie dopasowany i oceniony na tych samych 40 próbkach biologicznych; szacunek ten zdefiniowano zatem jako pozorną wydajność wewnątrzpróbkową. Aby ocenić potencjalne przeuczenie, przeprowadzono 100 powtórzeń stratyfikowanej pięciokrotnej walidacji krzyżowej z wykorzystaniem modelu regresji logistycznej z regularyzacją L2, a następnie obliczono zbiorczą wydajność ROC dla danych spoza próby walidacyjnej.
| Gen | Numer akcesyjny RefSeq | Starter przedni (5′–3′) | Starter odwrotny (5′–3′) | Rozmiar produktu (bp) | Tm (°C) | Przecinający ekson |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Tak |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Tak |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Tak |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Tak |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Tak |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Tak |
Tabela 2: Sekwencje starterów użytych do ilościowej PCR z odwrotną transkrypcją. Tabela zawiera geny docelowe, numery dostępowe RefSeq, sekwencje starterów w przód i w tył, wielkości produktów, temperatury topnienia oraz status obejmowania eksonów przez startery użyte do qRT-PCR.
9. Przesiewanie związków kandydackich i dokowanie molekularne
Sygnatury genów rdzeniowych o zwiększonej i zmniejszonej ekspresji zostały wprowadzone do bazy danych Connectivity Map w celu zidentyfikowania małych cząsteczek, które według prognoz odwracają profil ekspresji związany z PH7. Kandydaci zostali uszeregowani według wyniku Logit oraz prawdopodobieństwa predykcji.
Struktura trójwymiarowa BRD-K91900765/VX-745 została pobrana z bazy PubChem pod numerem CID 303852524. Informacje farmakologiczne dotyczące związku opracowano na podstawie publicznych baz danych leków, a deskryptory strukturalne obliczono przy użyciu DrugBank oraz SwissADME25,26. Struktury białek pobrano z RCSB Protein Data Bank, korzystając z następujących identyfikatorów PDB: CXCL10, 1LV9; JUN, 1JUN; IFIH1, 3B6E; MX1, 5GTM; TLR7, 7CYN oraz MAPK14/p38α, 1OUK27. Wykrywanie ślepych kawern oraz dokowanie molekularne przeprowadzono za pomocą programu CB-Dock2 v2.0 z silnikiem oceniającym AutoDock Vina v1.2.028,29. Pliki białek i ligandów przesłano do CB-Dock2, automatycznie wykryto potencjalne kawerny, a dokowanie wykonano w obrębie specyficznych dla kawern obszarów (docking-box) wygenerowanych przez serwer. Dla każdego białka zapisano identyfikator kawerny, wynik Vina, objętość kawerny, środek obszaru dokowania, wymiary obszaru dokowania oraz plik kompleksu białko-ligand. Poza z najbardziej ujemnym wynikiem Vina wybrano jako najwyżej ocenioną przewidywaną konformację. Białko MAPK14/p38α zostało uwzględnione jako ustalony cel farmakologiczny i pozytywny punkt odniesienia dla dokowania VX-745. Dokowanie względem CXCL10, JUN, IFIH1, MX1 i TLR7 miało charakter eksploracyjny i nie było interpretowane jako dowód bezpośredniego celowania farmakologicznego, wiązania, inhibicji ani skuteczności.
10. Analiza statystyczna i kontrola powtarzalności
Wszystkie analizy statystyczne wykonano w programie R, chyba że zaznaczono inaczej. Dwustronne wartości P < 0,05 uznano za statystycznie istotne. Korektę dla wielokrotnych testów zastosowano w analizach różnicowej ekspresji, wzbogacenia, walidacji zewnętrznej oraz qRT-PCR, zgodnie z powyższym opisem. W celu oceny stabilności modeli uczenia maszynowego i połączonych modeli qRT-PCR zastosowano walidację krzyżową.
Wyniki
Przetwarzanie wstępne publicznych danych transkryptomicznych i identyfikacja genów różnicowo wyrażonych
Integracja i korekcja metodą ComBat zbiorów GSE22356, GSE33463 oraz GSE48149 zredukowały systematyczne różnice między zestawami danych. Wykresy pudełkowe wykazały, że rozkłady ekspresji próbek stały się bardziej spójne po korekcie. Analiza głównych składowych wskazała, że przed korekcją próbki grupowały się głównie według źródła pochodzenia zestawu danych, natomiast po korekcie uległy większemu wymieszaniu, co świadczy o skutecznej redukcji efektu seryjnego (Rysunek 1).
Przy zastosowaniu progów wartości bezwzględnej log2 fold change >0,585 oraz skorygowanej wartości P < 0,05 zidentyfikowano 78 genów o różnej ekspresji, w tym 44 geny o nadekspresji oraz 34 geny o obniżonej ekspresji (Rycina 2A). Mapa ciepła wykazała, że geny związane z interferonami, w tym XAF1, MX1, IFI44L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 oraz TLR7, były ogólnie nadeksponowane w próbkach związanych z PH. W przeciwieństwie do nich, geny związane z linią erytroidalną, w tym HBG1, HBD, ALAS2, CA1 oraz SLC4A1, wykazywały tendencję do obniżonej ekspresji (Rycina 2B).
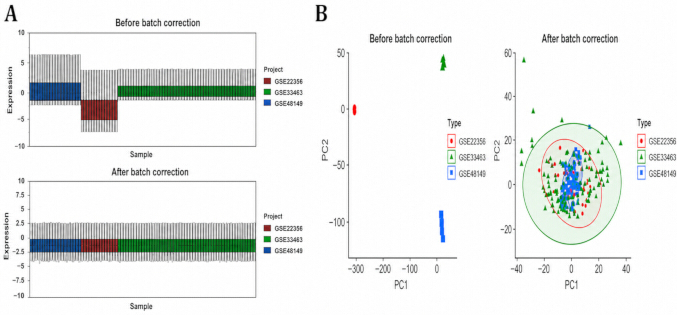
Rysunek 1: Korekcja efektu serii. (A) Wykresy pudełkowe połączonej macierzy ekspresji przed i po korekcji metodą ComBat. (B) Wykresy analizy głównych składowych (PCA) przedstawiające rozkład próbek przed i po korekcji efektu serii. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
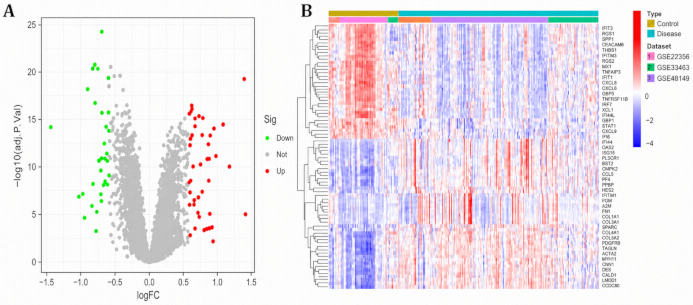
Rycina 2: Geny o różnicowej ekspresji. (A) Wykres wulkaniczny przedstawiający geny o zwiększonej i zmniejszonej ekspresji w próbkach związanych z PH. (B) Mapa ciepła przedstawiająca geny o różnicowej ekspresji pomiędzy grupą kontrolną a grupą chorobową. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Konstrukcja ważonej sieci koekspresji genów i wzbogacenie funkcjonalne
Klastrowanie próbek wykazało stabilne ogólne grupowanie bez oczywistych wartości odstających (Rysunek 3A). Wskaźnik dopasowania topologii bezskalowej zbliżył się do 0,8 przy potędze 9, w związku z czym do konstrukcji sieci wybrano β = 9 (Rysunek 3B). Klastrowanie genów i identyfikacja modułów dynamicznych pozwoliły na wyodrębnienie wielu modułów koekspresji (Rysunek 3C). Moduł niebieski wykazał najsilniejszy związek ze stanem PH (r = 0,55, P = 1 × 10⁻¹⁹), natomiast moduły turkusowy i szary również wykazały korelacje z PH (Rysunek 3D).
Geny konsensusowe, uzyskane poprzez przecięcie genów modułów kluczowej ważonej analizy sieci koekspresji genów z genami różnicowo eksponowanymi, były wzbogacone w obszarach obrony immunologicznej przeciwwirusowej, regulacji NF-κB i JAK-STAT, odpowiedzi na czynniki zapalne, wiązania receptorów cytokin i chemokin oraz regulacji transkrypcyjnej (Rysunek 4A). Analiza wzbogacenia w Kyoto Encyclopedia of Genes and Genomes zidentyfikowała interakcje cytokina-receptor cytokinowy, sygnalizację chemokin, sygnalizację receptorów NOD-like, sygnalizację receptorów Toll-like, sygnalizację czynnika martwicy nowotworu oraz sygnalizację interleukiny-17 (Rysunek 4B), co potwierdza, że dysregulacja immunologiczno-zapalna stanowi molekularną podstawę przebudowy naczyniowej płuc.
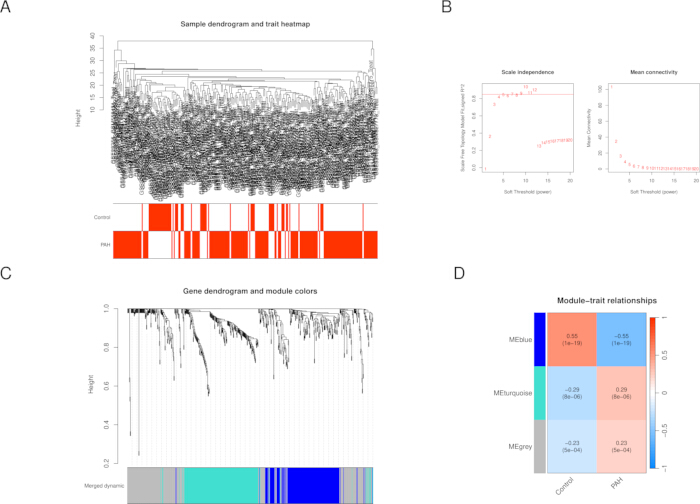
Rycina 3: Analiza ważonej sieci koekspresji genów. (A) Drzewo klastrowania próbek i mapa ciepła cech. (B) Wykres wyboru miękkiego progu. (C) Dendrogram genów i kolory modułów. (D) Mapa ciepła relacji moduł-cecha. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
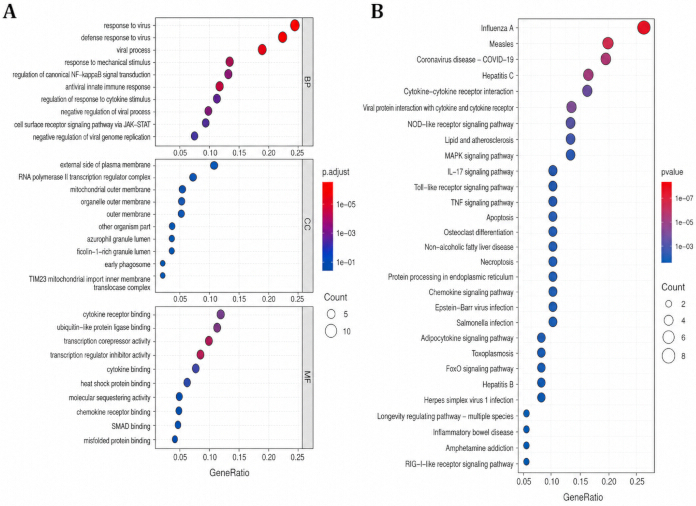
Rycina 4: Analiza wzbogacenia funkcjonalnego. (A) Wyniki wzbogacenia Gene Ontology dla genów konsensusowych. (B) Wyniki wzbogacenia szlaków Kyoto Encyclopedia of Genes and Genomes dla genów konsensusowych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Sieć oddziaływań białko-białko oraz screening genów węzłowych
Sieć oddziaływań białko-białko STRING skonstruowana na podstawie genów konsensusowych ujawniła powiązaną sieć immunozapalną (Rycyna 5A). Ranking CytoHubba oparty na stopniu węzła wykazał, że FN1, CD44, JUN, TGFB1, CXCL8 oraz BCL2 charakteryzują się wysoką łącznością (Rycyna 5B). Te geny hubowe mogą uczestniczyć w sygnalizacji zapalnej, adhezji komórkowej, przebudowie macierzy zewnątrzkomórkowej oraz strukturalnej przebudowie naczyń płucnych.
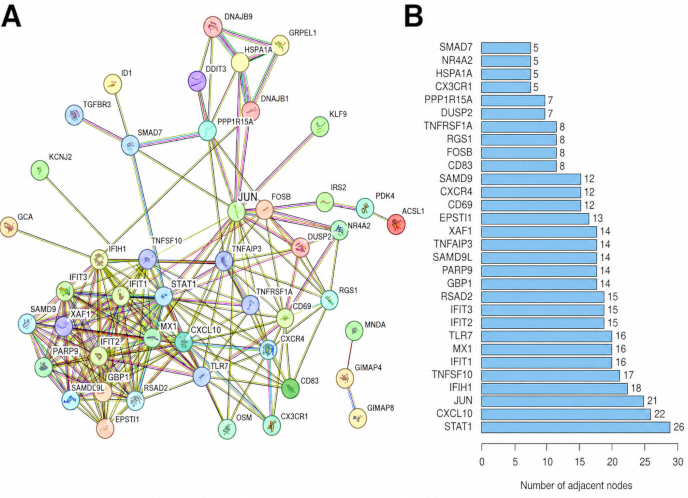
Rycina 5: Sieć oddziaływań białko-białko i geny hubowe. (A) Sieć oddziaływań białko-białko genów konsensusowych utworzona w programie STRING. (B) Geny hubowe uszeregowane według stopnia łączności, zidentyfikowane za pomocą wtyczki CytoHubba. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
Selekcja cech w uczeniu maszynowym i wydajność diagnostyczna
Regresja metodą LASSO (least absolute shrinkage and selection operator) zidentyfikowała sześć genów kandydackich z niezerowymi współczynnikami po walidacji krzyżowej (Rysunek 6A, B). Metoda SVM-RFE (support vector machine-recursive feature elimination) zachowała osiem genów, dając dokładność walidacji krzyżowej na poziomie 0,883 i błąd wynoszący 0,117 (Rysunek 7A). Błąd out-of-bag w analizie lasów losowych ustabilizował się, gdy liczba drzew była ≥100, a geny IFIH1, JUN oraz TLR7 znalazły się wśród najważniejszych genów według wyniku istotności (Rysunek 7B).
Analiza przecięcia wyników metod LASSO (least absolute shrinkage and selection operator), SVM-RFE (support vector machine-recursive feature elimination) oraz lasów losowych (random forest) pozwoliła zidentyfikować pięć kluczowych genów: CXCL10, JUN, IFIH1, MX1 oraz TLR7 (Rycina 8A). Analiza krzywej ROC (receiver operating characteristic) dla pojedynczych genów wykazała umiarkowaną do dobrej rozdzielczość diagnostyczną, przy wartościach pola pod krzywą (AUC) wynoszących odpowiednio 0,842 dla IFIH1, 0,833 dla JUN, 0,827 dla TLR7, 0,814 dla CXCL10 oraz 0,759 dla MX1 (Rycina 8B).
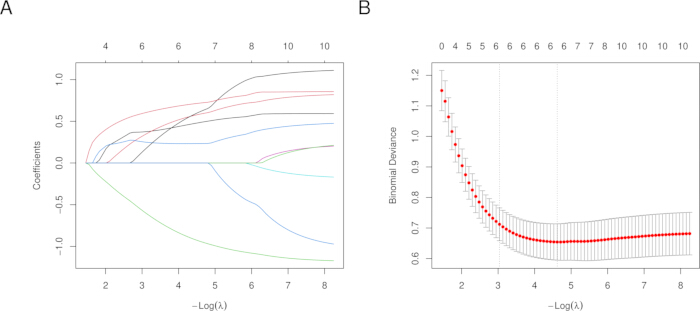
Rysunek 6: Analiza regresji Lasso (least absolute shrinkage and selection operator). (A) Ścieżka współczynników wygenerowana przez regresję Lasso. (B) Wykres błędu walidacji krzyżowej. Aby wyświetlić powiększoną wersję tego rysunku, kliknij tutaj.
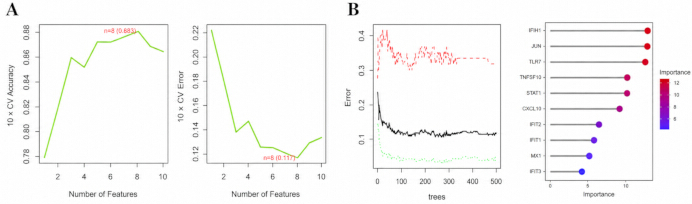
Rysunek 7: Analizy z wykorzystaniem maszyny wektorów nośnych z rekurencyjną eliminacją cech oraz lasów losowych. (A) Wykres selekcji cech metodą maszyny wektorów nośnych z rekurencyjną eliminacją cech. (B) Model lasów losowych i ranking istotności genów. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
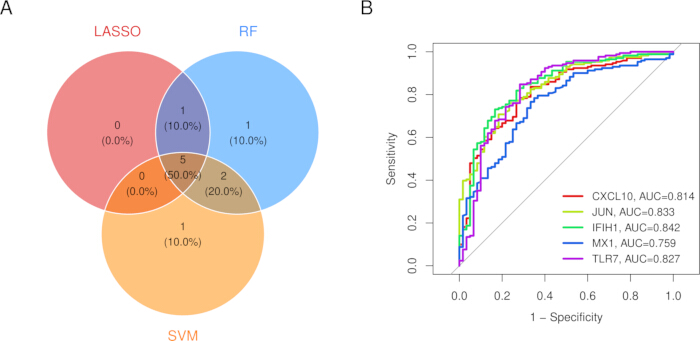
Rysunek 8: Podsumowanie uczenia maszynowego. (A) Diagram Venna przedstawiający część wspólną trzech algorytmów wyboru cech. (B) Krzywe charakterystyki operacyjnej odbiornika (ROC) dla pięciu kluczowych genów. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Walidacja zewnętrzna w GSE117261
Zbiór GSE117261 został wykorzystany jako niezależna kohorta walidacyjna tkanki płucnej i nie był uwzględniony w analizie różnicowej ekspresji, konstrukcji ważonej sieci koekspresji genów ani w wyborze cech metodami uczenia maszynowego (Tabela 3). Wyniki przeprowadzonej walidacji wykazały niejednorodną replikację w obrębie pięciu genów (Tabela 4). Poziom CXCL10 był podwyższony (log₂ fold change = 0.677; P = 0.0410; FDR = 0.144) i uzyskał AUC wynoszące 0.639 (95% CI, 0.491–0.786), przy wartości odcięcia 6.245, czułości 0.724 i swoistości 0.600. Poziom JUN był podwyższony (log₂ fold change = 0.463; P = 0.00248; FDR = 0.0194) i uzyskał AUC wynoszące 0.714 (95% CI, 0.593–0.835), przy wartości odcięcia 8.708, czułości 0.707 i swoistości 0.720.
IFIH1 (log2 fold change = 0.107; P = 0.371; FDR = 0.591; AUC = 0.543, 95% CI, 0.398–0.687), MX1 (log2 fold change = 0.109; P = 0.488; FDR = 0.690; AUC = 0.475, 95% CI, 0.337–0.614) oraz TLR7 (log2 fold change = -0.050; P = 0.543; FDR = 0.733; AUC = 0.546, 95% CI, 0.414–0.679) nie spełniły wcześniej określonych kryteriów wsparcia zewnętrznego. TLR7 wykazał również kierunek przeciwny do wyniku qRT-PCR. Eksploracyjny model pięciogenowy dopasowany i oceniony w ramach GSE117261 dał pozorną wartość AUC wynoszącą 0,740, podczas gdy powtarzalna walidacja krzyżowa zagnieżdżona (nested cross-validation) dała AUC wynoszącą 0,656. Zatem JUN otrzymał najsilniejsze niezależne wsparcie, CXCL10 wykazał ograniczony, spójny kierunkowo dowód, a replikacja IFIH1, MX1 i TLR7 była słaba lub niespójna.
| Pozycja | Opis |
| Numer dostępu do zbioru danych | GSE117261 |
| Źródło danych | Gene Expression Omnibus (GEO) |
| Typ próbki | Dane z mikromacierzy transkrypcyjnych tkanki płuc człowieka |
| Wielkość próby | 58 próbek PAH i 25 kontrolnych próbek od dawców niezakwalifikowanych |
| Platforma | GPL6244 / Matryca Affymetrix Human Gene 1.0 ST Array |
| Cel walidacji | Różnice w ekspresji, analiza ROC dla pojedynczych genów oraz eksploracyjne modelowanie łączone ROC dla pięciu genów: CXCL10, JUN, IFIH1, MX1 i TLR7 |
| Rola w niniejszym badaniu | Niezależny zewnętrzny zbiór danych walidacyjnych; nieujęty w pierwotnej analizie treningowej, WGCNA ani analizach selekcji cech |
Tabela 3: Podstawowe informacje dotyczące niezależnego zewnętrznego zbioru walidacyjnego GSE117261. Tabela podsumowuje źródło zbioru danych, rodzaj próbek, wielkość próby, platformę, cele walidacji oraz rolę GSE117261 w badaniu.
| Gen/model | PAH n | Kontrola n | log2 fold change | Wartość P | FDR | AUC | 95% CI AUC | Próg Youdena | Czułość | Swoistość |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| Model pięciogenowy (pozorny/wewnątrzpróbkowy) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| Model pięciogenowy (powtórzona zagnieżdżona walidacja krzyżowa) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
Tabela 4: Rzeczywiste różnice w ekspresji i wyniki walidacji ROC dla GSE117261. Tabela przedstawia wielkość prób PAH i kontrolnych, log₂-krotność zmiany (log₂ fold change), wartości P, wartości skorygowane o stopień fałszywych odkryć (FDR), wartości AUC, 95% przedziały ufności, punkty odcięcia indeksu Youdena, czułość, swoistość oraz interpretacje dla pięciu genów i eksploracyjnych modeli łączonych.
Walidacja ilościowej reakcji PCR z odwrotną transkrypcją
Walidacja za pomocą ilościowej reakcji PCR z odwrotną transkrypcją objęła 20 biologicznie niezależnych próbek tkanki płucnej od pacjentów z PAH oraz 20 biologicznie niezależnych próbek kontrolnych, przy czym dla każdej próbki biologicznej wyciągnięto średnią z trzech powtórzeń technicznych. Odnotowano istotny wzrost ekspresji genów CXCL10, JUN, IFIH1, MX1 oraz TLR7 w grupie PAH (Tabela 5; Rysunek 9A). Średnie wartości ekspresji względnej wynosiły odpowiednio około 3,470 dla CXCL10, 2,560 dla JUN, 2,760 dla IFIH1, 2,650 dla MX1 i 2,580 dla TLR7. Odpowiadające im wartości P/FDR wynosiły odpowiednio 1,43 × 10⁻7/7,15 × 10⁻7, 4,17 × 10⁻5/4,17 × 10⁻5, 1,10 × 10⁻5/1,38 × 10⁻5, 1,58 × 10⁻6/2,63 × 10⁻6 oraz 1,37 × 10⁻6/2,63 × 10⁻6.
Analiza ROC dla pojedynczych genów w oparciu o ekspresję qRT-PCR wykazała wartości AUC wynoszące odpowiednio 0,988 dla CXCL10 (95% CI, 0,961–1,000), 0,880 dla JUN (95% CI, 0,758–1,000), 0,908 dla IFIH1 (95% CI, 0,820–0,995), 0,945 dla MX1 (95% CI, 0,874–1,000) oraz 0,948 dla TLR7 (95% CI, 0,886–1,000) (Rysunek 9B; Tabela 5). Model regresji logistycznej obejmujący pięć genów osiągnął pozorną wartość AUC równą 1,000 (DeLong 95% CI: 1,000–1,000), przy czułości i swoistości na poziomie 1,000 (Rysunek 9C). Spójność kierunku ekspresji pomiędzy walidacją za pomocą ilościowej RT-PCR a zbiorem GSE117261 została przedstawiona za pomocą mapy ciepła (Rysunek 9D). Ponieważ do dopasowania i oceny wykorzystano te same 40 próbek, odzwierciedlało to pozorną wydajność wewnątrzpróbkową. W 100 powtórzeniach stratyfikowanej pięciokrotnej walidacji krzyżowej z użyciem modelu regresji logistycznej z regularyzacją L2, skumulowana wartość AUC poza próbą (out-of-fold AUC) również pozostała na poziomie 1,000 (95% CI, 1,000–1,000), a każde powtórzenie dało AUC równą 1,000. Pomimo tej wewnętrznej stabilności, kohorta była mała i nadal konieczna jest niezależna walidacja prospektywna. Porównanie kierunkowe z GSE117261 wykazało zgodne wzrosty dla CXCL10, JUN, IFIH1 i MX1, ale rozbieżny kierunek dla TLR7 (Rysunek 9D).
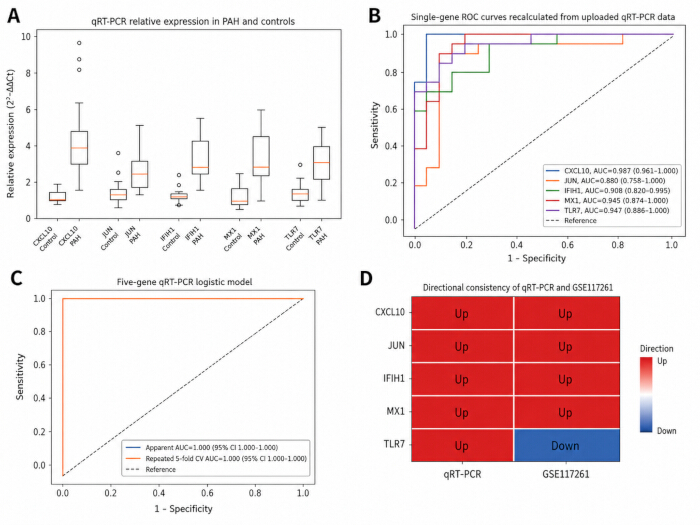
Rycina 9: Walidacja za pomocą ilościowej RT-PCR. (A) Wykresy pudełkowe przedstawiające względną ekspresję CXCL10, JUN, IFIH1, MX1 i TLR7 w 20 biologicznie niezależnych próbkach tkanki płucnej PAH oraz 20 biologicznie niezależnych próbkach kontrolnych. Każda próbka biologiczna była mierzona w trzech powtórzeniach technicznych, a do analizy wykorzystano średnią wartość Ct. Na każdym wykresie pudełkowym linia środkowa reprezentuje medianę, pudełko reprezentuje rozstęp międzykwartylowy, wąsy sięgają 1,5 raza rozstępu międzykwartylowego, a poszczególne punkty poza wąsami reprezentują wartości odstające. (B) Krzywe ROC dla pojedynczych genów na podstawie wartości ekspresji z qRT-PCR; przedstawiono wartości AUC oraz 95% przedziały ufności DeLonga. (C) Krzywe ROC dla modelu regresji logistycznej obejmującego pięć genów, pokazujące zarówno wydajność pozorną/wewnątrzpróbkową, jak i zbiorczą wydajność poza zakresem (out-of-fold) z 100 powtórzonych analiz stratyfikowanej pięciokrotnej walidacji krzyżowej. (D) Mapa ciepła pokazująca spójność kierunku ekspresji między qRT-PCR a GSE117261; CXCL10, JUN, IFIH1 i MX1 wykazały zgodny wzrost, natomiast TLR7 był niezgodny. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Gen/model | Wielopierścieniowe węglowodory aromatyczne (WWA) | Kontrola n | Kontrola 2^-ΔΔCt, średnia ± SD | PAH 2^-ΔΔCt, średnia ± SD | Kierunek | wartość p | FDR (korekta stopnia fałszywych odkryć) | AUC | AUC 95% CI | punkt odcięcia Youdena | Sensi- aktywność | Specyficzne miasto | Typ walidacji | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | Zwiększona ekspresja | 1,43E-07 | 7,15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | Analiza qRT-PCR pojedynczego genu | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | Zwiększona ekspresja | 4,17E-05 | 4,17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | Analiza qRT-PCR dla pojedynczego genu | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | Zwiększona ekspresja | 1,10E-05 | 1,38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | Analiza qRT-PCR dla pojedynczego genu | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | Zwiększona ekspresja | 1,58E-06 | 2,63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | Analiza qRT-PCR pojedynczego genu | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | Podwyższona ekspresja | 1,37E-06 | 2,63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | Analiza qRT-PCR pojedynczego genu | ||||
| Model pięciogenowy (pozorny/wewnątrzpróbkowy) | 20 | 20 | Nie dotyczy przewód | Nie dotyczy przewód | Nie dotyczy | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | Te same 40 próbek biologicznych wykorzystanych do dopasowania i ewaluacji modelu | ||||
| Model pięciogenowy (100-krotna 5-krotna walidacja krzyżowa) | 20 | 20 | Nie dotyczy przewód | Nie dotyczy kabel | Nie dotyczy | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | Wewnętrzna walidacja krzyżowa z wykorzystaniem regresji logistycznej z regularyzacją L2 | ||||
Tabela 5: Pełne wyniki ekspresji qRT-PCR i analizy ROC dla CXCL10, JUN, IFIH1, MX1 oraz TLR7, w tym analizy połączonego modelu pięciu genów. Tabela przedstawia wielkość próby dla PAH i grupy kontrolnej, wartości ekspresji względnej, kierunki ekspresji, wartości P, wartości skorygowane o wskaźnik fałszywych odkryć (FDR), AUC, 95% przedziały ufności, punkty odcięcia według indeksu Youdena, czułość, swoistość oraz typy walidacji dla poszczególnych genów i modeli połączonych.
Walidacja transkryptomiczna pojedynczych komórek w GSE210248
Zbiór GSE210248 dostarczył mechanistycznego wsparcia na poziomie komórkowym, wykazując, że przebudowa tętnic płucnych w PAH towarzyszy zaburzona komunikacja między komórkami odpornościowymi a komórkami strukturalnymi naczyń. Obserwacja ta była zgodna z wynikami analizy wzbogacenia transkryptomicznego typu bulk, która wykazała nasilenie odpowiedzi zapalnych, sygnalizacji chemokin, sygnalizacji receptorów Toll-podobnych oraz sygnalizacji czynnika martwicy nowotworu.
Dowody z analizy pojedynczych komórek sugerują, że sieć sygnalizacyjna tętnicy płucnej w PAH przesunęła się w stronę komórek strukturalnych, w tym komórek mięśni gładkich i fibroblastów. Komórki mięśni gładkich wykazywały wiele stanów, w tym podobny do perycyta/wykrywający tlen, kurczliwy, syntetyczny oraz podobny do fibroblasta. Wyniki te wspierają model choroby, w którym immunologiczna aktywacja zapalna oraz przebudowa strukturalnych komórek naczyniowych wspólnie napędzają progresję PH/PAH.
Przesiewanie związków kandydackich i dokowanie molekularne
Przesiewanie Connectivity Map zidentyfikowało BRD-K91900765 jako najlepiej oceniony związek kandydacki spośród 10 najlepszych wyników, z wynikiem Logit wynoszącym 10,13 i przewidywanym prawdopodobieństwem 0,085 (Rycina 10). Kurasja związków wykazała, że BRD-K91900765 odpowiada VX-745/neflamapimodowi, selektywnemu inhibitorowi p38α/MAPK14 o identyfikatorze związku PubChem 3038525 i masie cząsteczkowej 436,27 g/mol (Tabela 6).
Eksploracyjne dokowanie BRD-K91900765/VX-745 z pięcioma białkami związanymi z biomarkerami przyniosło najwyższe wyniki Vina wynoszące odpowiednio: -7,5 kcal/mol dla CXCL10, -7,6 kcal/mol dla JUN, -7,5 kcal/mol dla IFIH1, -8,7 kcal/mol dla MX1 oraz -8,1 kcal/mol dla TLR7 (Tabele 7–11; Rysunek 11A–E). Wyniki te wskazywały jedynie na przewidywaną kompatybilność strukturalną i nie potwierdziły, że pięć tych białek stanowi bezpośrednie cele farmakologiczne. Wstępne przewidywania dotyczące wchłaniania, dystrybucji, metabolizmu, wydalania i toksyczności sugerowały, że związek posiada kilka właściwości charakterystycznych dla leków, choć stosunkowo wysoka obliczona wartość cLogP wymaga dalszej oceny (Tabela 12). Jako pozytywną analizę referencyjną włączono dokowanie względem ustalonego celu VX-745, MAPK14/p38α (PDB ID: 1OUK). Najlepsza kawerna MAPK14, C1, uzyskała wynik Vina wynoszący -7,9 kcal/mol, objętość kawerny 3560 Å3, środek pola dokowania (docking-box center) o współrzędnych (2, 22, 34) oraz wymiary (22, 31, 31) (Tabela 13; Rysunek 11F).
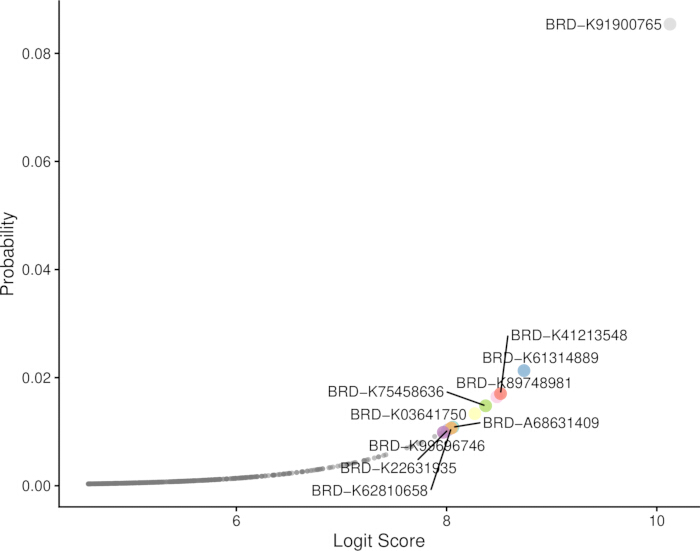
Rycina 10: Ranking związków kandydackich z Connectivity Map. Ranking związków kandydackich zidentyfikowanych w wyniku przesiewania Connectivity Map. Związek BRD-K91900765 uzyskał najwyższą pozycję w rankingu, z wynikiem Logit równym 10.13 i przewidywanym prawdopodobieństwem 0.085. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
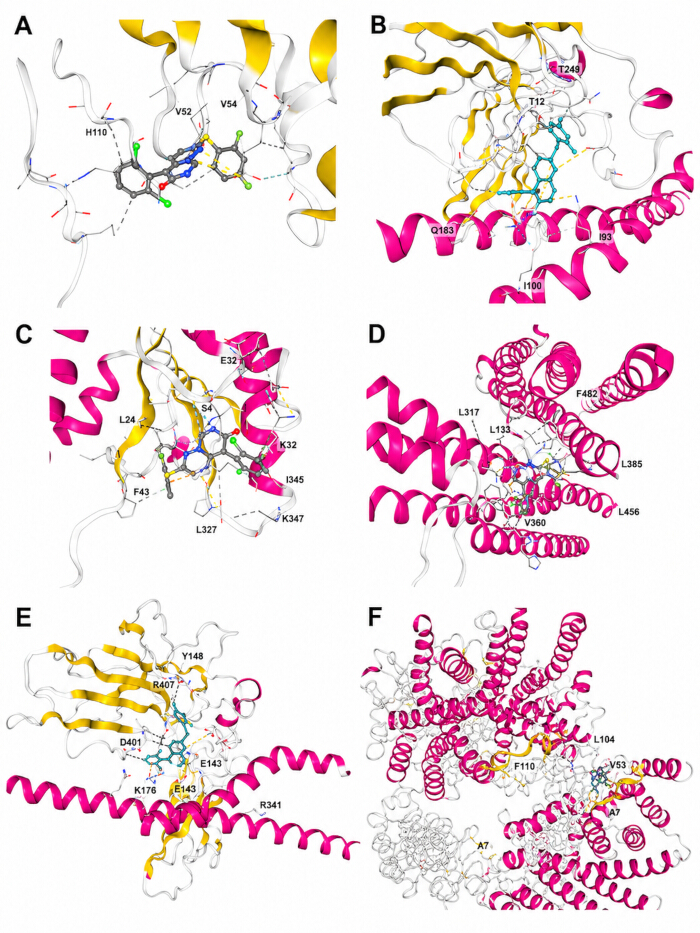
Rycina 11: Trójwymiarowe diagramy dokowania molekularnego dla BRD-K91900765/VX-745. (A) Dokowanie eksploracyjne z CXCL10. (B) Dokowanie eksploracyjne z JUN. (C) Dokowanie eksploracyjne z IFIH1. (D) Dokowanie eksploracyjne z MX1. (E) Dokowanie eksploracyjne z TLR7. (F) Dokowanie z referencją pozytywną dla ustalonego celu farmakologicznego MAPK14/p38α (PDB ID: 1OUK). Panele A–E wskazują na przewidywaną kompatybilność strukturalną i nie potwierdzają bezpośredniego celowania farmakologicznego. Aby zobaczyć powiększoną wersję tej ryciny, kliknij tutaj.
| Element | Opis |
| CMap/Broad ID | BRD-K91900765 (typowy format partii: BRD-K91900765-001-xx-x) |
| Nazwa zwyczajna/aliasy | VX-745; neflamapimod; VRT-031745; VD-31745 |
| Nazwa chemiczna | 5-(2,6-dichlorofenyl)-2-(2,4-difluorofenylosulfanylo)pyrimido[1,6-b]pyridazin-6-on |
| PubChem CID | 3038525 |
| numer CAS | 209410-46-8 |
| Wzór sumaryczny / względna masa cząsteczkowa | C19H9Cl2F2N3OS; 436,27 g/mol |
| Kanoniczne SMILES | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| Uznany główny cel farmakologiczny | Odnotowano również hamowanie MAPK14/p38α; p38β wykazywało jednak niższą selektywność niż p38α |
Tabela 6: Informacje chemiczne i farmakologiczne dla BRD-K91900765/VX-745. Tabela zawiera podsumowanie identyfikatorów związku, nazw alternatywnych, nazwy chemicznej, wzoru cząsteczkowego, masy cząsteczkowej, deskryptorów strukturalnych oraz ustalonego celu farmakologicznego BRD-K91900765/VX-745.
| Identyfikacja CurPocket | Wynik Vina (kcal/mol) | Objętość kawerny (ų) | Środek (x, y, z) | Rozmiar obszaru dokowania (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
Tabela 7: Przewidywane kieszenie dokowania dla BRD-K91900765/VX-745 z CXCL10 (PDB ID: 1LV9). Tabela przedstawia uszeregowane identyfikatory wnęk, wyniki Vina, objętości wnęk, środki pól dokowania oraz wymiary pól dokowania wygenerowane przez CB-Dock2.
| Identyfikator CurPocket | Wynik Vina (kcal/mol) | Objętość kawerny (ų) | Środek (x, y, z) | Rozmiar obszaru dokowania (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
Tabela 8: Przewidywane kieszenie dokowania dla BRD-K91900765/VX-745 z JUN (PDB ID: 1JUN). Tabela przedstawia uszeregowane identyfikatory wnęk, wyniki Vina, objętości wnęk, środki pudełek dokowania oraz wymiary pudełek dokowania wygenerowane przez CB-Dock2.
| CurPocket ID | Wynik Vina (kcal/mol) | Objętość kawerny (ų) | Środek (x, y, z) | Rozmiar obszaru dokowania (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
Tabela 9: Przewidywane kieszenie dokowania dla BRD-K91900765/VX-745 z IFIH1 (PDB ID: 3B6E). Tabela zawiera ranking identyfikatorów wnęk, wyniki Vina, objętości wnęk, środki pudełek dokujących oraz wymiary pudełek dokujących wygenerowane przez CB-Dock2.
| CurPocket ID | Wynik Vina (kcal/mol) | Objętość kawerny (ų) | Środek (x, y, z) | Rozmiar obszaru dokowania (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
Tabela 10: Przewidywane kieszenie dokowania dla BRD-K91900765/VX-745 z MX1 (PDB ID: 5GTM). Tabela przedstawia ranking identyfikatorów wnęk, wyniki Vina, objętości wnęk, środki pudełek dokujących oraz wymiary pudełek dokujących wygenerowane przez CB-Dock2.
| ID CurPocket | Wynik Vina (kcal/mol) | Objętość kawerny (ų) | Centrum (x, y, z) | Rozmiar dokowania (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
Tabela 11: Przewidywane kieszenie dokowania dla BRD-K91900765/VX-745 z TLR7 (PDB ID: 7CYN). W tabeli przedstawiono uporządkowane identyfikatory wnęk, wyniki Vina, objętości wnęk, środki pudełek dokowania oraz wymiary pudełek dokowania wygenerowane przez CB-Dock2.
| Kategoria | Parametr | Wynik | Interpretacja |
| Właściwości fizykochemiczne | Masa cząsteczkowa | 436,27 g/mol | Poniżej 500 Da, spełniając próg masy cząsteczkowej Lipinskiego |
| Właściwość fizykochemiczna | cLogP | Około 5,49 | Nieco powyżej 5, co sugeruje wysoką lipofilność oraz konieczność uwzględnienia rozpuszczalności i wiązania niespecyficznego |
| Właściwości fizykochemiczne | TPSA (całkowita polarna powierzchnia cząsteczki) | Około 47,26 Ų | Niska polarna powierzchnia cząsteczkowa, co jest zgodne z potencjalnie korzystną przepuszczalnością przez błony |
| Podobieństwo do leku | HBA/HBD | Maj-00 | Spełnia kryteria Lipińskiego w odniesieniu do akceptorów i donorów wiązań wodorowych |
| Podobieństwo do leku | Wiązania rotowalne | 3 | Niska elastyczność konformacyjna, sprzyjająca stabilnym konformacjom wiązania |
| Alerty strukturalne | ostrzeżenia PAINS/Brenk | Nie wykryto | Nie wykryto powszechnych interferencji typu pan-assay ani reaktywnych ostrzeżeń strukturalnych |
| Przewidywanie toksyczności | mutagenność w teście Amesa | Przewidywana toksyczność nie-Amesowskia | Sugeruje niskie przewidywane ryzyko mutagenne; wymagana jest wciąż walidacja eksperymentalna |
| Przewidywanie toksyczności | Karcynogenność | Przewidywany brak właściwości rakotwórczych | Sugeruje stosunkowo niskie przewidywane długoterminowe ryzyko kancerogenne; nadal wymagana jest walidacja eksperymentalna |
| Notatka farmakokinetyczna | Dostępność doustna/przenikalność do mózgu | Literatura oraz bazy danych wskazują na dostępną doustnie, przenikającą przez barierę krew-mózg małą cząsteczkę | Zgodnie z tłem jego opracowania jako inhibitora p38α; wciąż wymagana jest ponowna ocena w odniesieniu do wskazań w nadciśnieniu płucnym |
Tabela 12: Wstępne przewidywania fizykochemiczne, pod kątem podobieństwa do leku, ADMET oraz toksyczności dla BRD-K91900765/VX-745. Tabela podsumowuje przewidywane właściwości fizykochemiczne, miary podobieństwa do leku, alerty strukturalne, punkty końcowe toksyczności oraz charakterystyki farmakokinetyczne. Te obliczeniowe przewidywania są wstępne i nie zastępują eksperymentalnej walidacji farmakokinetycznej lub toksykologicznej.
| Id CurPocket | Wynik Vina (kcal/mol) | Objętość kawerny (ų) | Środek (x, y, z) | Rozmiar dokowania (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
Tabela 13: Przewidywane kieszenie dokujące dla BRD-K91900765/VX-745 z jego ustalonym celem farmakologicznym MAPK14/p38α (PDB ID: 1OUK), dołączone jako analiza referencyjna pozytywna. Tabela przedstawia rankingowe identyfikatory wnęk, wyniki Vina, objętości wnęk, środki obszarów dokowania oraz wymiary obszarów dokowania wygenerowane przy użyciu tego samego schematu dokowania, który zastosowano do pięciu białek związanych z biomarkerami.
Wspólnie analizy odkrywcze i wyniki qRT-PCR wskazują na CXCL10, JUN, IFIH1, MX1 oraz TLR7 jako potencjalne biomarkery PH/PAH związane z dysregulacją immunologiczną i zapalną oraz przebudową naczyniową płuc, choć niezależna replikacja w zbiorze GSE117261 była najsilniejsza dla JUN i zmienna dla pozostałych genów. BRD-K91900765/VX-745 jest kandydatem do repozycjonowania leku, wyłonionym metodami obliczeniowymi, z prawdopodobnym mechanizmem hamowania MAPK14/p38α; przed interpretacją terapeutyczną wymagana jest walidacja wiązania z celem, badania komórkowe, farmakokinetyczne, toksykologiczne oraz w modelach zwierzęcych.
DOSTĘPNOŚĆ DANYCH:
Wszystkie publiczne zbiory danych transkrypomicznych wykorzystane w niniejszym badaniu są dostępne w bazie danych Gene Expression Omnibus pod numerami dostępu GSE22356, GSE33463, GSE48149, GSE117261 oraz GSE210248. Wszystkie pliki z kodem, przetworzone zbiory danych, zanonimizowane surowe i przeanalizowane dane qRT-PCR, wyniki modeli oraz pliki wejściowe i wyjściowe dokowania molekularnego zostały zgromadzone w ustrukturyzowanym repozytorium Zenodo. Repozytorium zawiera plik README, który opisuje każdy plik, wersje oprogramowania i pakietów, kolejność uruchamiania skryptów oraz pełne kroki reprodukcji – https://zenodo.org/records/21682282
Dyskusja
Opracowano zintegrowany i powtarzalny schemat postępowania w celu zidentyfikowania biomarkerów molekularnych związanych z PH/PAH oraz potencjalnych związków terapeutycznych, łącząc publiczne dane transkryptomiczne, analizę ważonych sieci koekspresji genów, wzbogacenie funkcjonalne, analizę sieci oddziaływań białko-białko, trzy algorytmy uczenia maszynowego, walidację zewnętrzną, interpretację transkryptomiczną w pojedynczych komórkach, potwierdzenie za pomocą ilościowej reakcji polimerazy w łańcuchu z odwrotną transkrypcją (qRT-PCR), przesiew Connectivity Map oraz dokowanie molekularne. Geny CXCL10, JUN, IFIH1, MX1 i TLR7 były konsekwentnie priorytetyzowane jako kluczowe geny cech i wspólnie przypisane do immunozapalnej i związanej z interferonem osi molekularnej. Wyniki te wspierają koncepcję, że PH/PAH nie jest jedynie zaburzeniem hemodynamicznym, ale także złożoną chorobą przebudowy naczyniowej obejmującą aktywację immunologiczną, sygnalizację zapalną, wrodzone rozpoznawanie kwasów nukleinowych oraz strukturalne i komórkowe zmiany fenotypowe2,5,6.
Potencjał diagnostyczny pięciu genów został potwierdzony za pomocą wieloalgorytmicznej selekcji cech oraz analizy ROC w kohorcie odkrywczej. Niezależna walidacja w zbiorze GSE117261 była niejednorodna, a nie jednolita: JUN spełnił wcześniej określone kryteria FDR i AUC, CXCL10 wykazał zgodny kierunkowo nominalny wzrost bez znaczenia FDR w obrębie całego transkryptomu, IFIH1 oraz MX1 wykazały ograniczoną replikację, a TLR7 wykazał kierunek rozbieżny. Wyniki te nie potwierdzają tezy, jakoby wszystkie pięć genów zostało niezależnie zwalidowanych, i wskazują na możliwy wpływ składu kohorty, heterogeniczności tkanek, różnic platform oraz stopnia zaawansowania choroby. W przeciwieństwie do tego, analiza qRT-PCR w 20 próbkach tkanki płucnej od osób z PAH oraz 20 próbkach kontrolnych potwierdziła istotną nadekspresję wszystkich pięciu genów oraz korzystne parametry analizy ROC dla pojedynczych genów.
Logistyczny model qRT-PCR obejmujący pięć genów osiągnął pozorną wartość AUC wynoszącą 1,000 (95% CI, 1,000–1,000), a jego zagregowana wartość AUC z walidacji zewnętrznej (out-of-fold) pozostała na poziomie 1,000 w 100 powtórzeniach stratyfikowanej pięciokrotnej walidacji krzyżowej. Niemniej jednak model opracowano na podstawie zaledwie 40 próbek biologicznych, a całkowita separacja w małej kohorcie retrospektywnej może prowadzić do optymistycznych i niestabilnych szacunków wydajności. Panel ten należy zatem traktować jako eksploracyjną sygnaturę molekularną, a nie klinicznie zwalidowane narzędzie diagnostyczne. Przed wdrożeniem klinicznym niezbędne są badania na większych kohortach wieloośrodkowych, z predefiniowanymi stałymi współczynnikami modelu, walidacja na poziomie białek, immunohistochemia oraz testy prospektywne.
Wśród pięciu kluczowych genów, CXCL10 może promować rekrutację komórek odpornościowych i lokalną amplifikację stanu zapalnego w mikrośrodowisku naczyń płucnych. IFIH1 i TLR7 uczestniczą w wrodzonym rozpoznawaniu kwasów nukleinowych i mogą odzwierciedlać aktywację przeciwirusowych szlaków zapalnych. MX1 jest klasycznym genem stymulowanym przez interferon i może stanowić marker wewnątrzkomórkowy aktywacji szlaku interferonu typu I. JUN jest czynnikiem transkrypcyjnym reagującym na stres, który łączy stymulację zapalną z proliferacją komórek, apoptozą i przebudową tkanki. Razem geny te sugerują biologicznie spójny model, w którym aktywacja odporności wrodzonej i sygnalizacja związana z interferonem oddziałują na procesy przebudowy naczyniowej w PH/PAH. Ta interpretacja jest zgodna z wcześniejszymi dowodami, że zapalenie, odporność i szlaki związane z interferonem przyczyniają się do patobiologii PAH2,5,6.
Walidacja na poziomie pojedynczych komórek dostarczyła kontekstu mechanistycznego dla wyników uzyskanych z analizy bulk. Dane GSE210248 sugerowały, że przebudowie tętnic płucnych w PAH towarzyszyła zaburzona komunikacja między komórkami odpornościowymi a strukturalnymi komórkami naczyniowymi, w tym komórkami mięśni gładkich, fibroblastami, komórkami śródbłonka oraz monocytami/makrofagami. Obecność wielu stanów fenotypowych komórek mięśni gładkich, w tym kurczliwego, syntetycznego, czułego na tlen/perycyto-podobnego oraz fibroblastopodobnego, wspiera model choroby, w którym aktywacja immunologiczna i strukturalna przebudowa komórek zachodzą równocześnie. Te dowody komórkowe są istotne, ponieważ sygnały transkryptomiczne z analizy bulk mogą wynikać ze zmienionych proporcji komórek, nacieku komórek odpornościowych lub zmian transkrypcyjnych w rezydentnych komórkach naczyniowych. Analiza pojedynczych komórek plasuje zatem CXCL10, JUN, IFIH1, MX1 i TLR7 w ramach wielokomórkowego ekosystemu przebudowy naczyń płucnych, a nie w procesie ograniczonym do jednego typu komórek18,19,20,21.
Analiza repozycjonowania leków zidentyfikowała związek BRD-K91900765, odpowiadający VX-745/neflamapimodowi, jako najwyżej ocenionego kandydata obliczeniowego. VX-745 jest selektywnym inhibitorem p38α/MAPK14, a jego powiązanie z szlakami stresu zapalnego sprawia, że jest on mechanistycznie prawdopodobny w kontekście stanu zapalnego związanego z PH/PAH30. Dlatego też dokowanie do MAPK14/p38α zostało włączone jako mechanistycznie istotna analiza referencyjna dodatnia. W przeciwieństwie do tego, dokowanie do CXCL10, JUN, IFIH1, MX1 i TLR7 miało charakter eksploracyjny i wskazywało jedynie na przewidywaną kompatybilność strukturalną; nie wykazało ono, że białka te, powiązane z biomarkerami, są bezpośrednimi celami VX-745, ani nie ustanowiło bezpośredniego wiązania, inhibicji celu lub skuteczności terapeutycznej. Bardziej biologicznie prawdopodobna hipoteza zakłada, że VX-745 może pośrednio modulować zidentyfikowaną sygnaturę transkrypcyjną związaną z odpornością-zapaleniem i interferonem poprzez inhibicję MAPK14. Przewidywania Connectivity Map, wyniki dokowania oraz szacunki ADMET pozostają dowodami obliczeniowymi. Dalsze prace powinny obejmować biochemiczne testy wiązania z celem, eksperymenty na komórkach śródbłonka i mięśni gładkich tętnic płucnych, modele stymulacji zapalnej, oceny farmakokinetyczne i toksykologiczne oraz walidację na modelach zwierzęcych.
Niedawne badania eksperymentalne nad hipoksyjnym nadciśnieniem płucnym podkreśliły również znaczenie komunikacji między neutrofilami a komórkami naczyniowymi płuc. Wykazano, że interakcje między neutrofilami a komórkami mięśni gładkich tętnic płucnych zapośredniczone przez HCK, a także interakcje między neutrofilami a komórkami śródbłonka zapośredniczone przez SERPINB3, przyczyniają się do przebudowy naczyniowej płuc31˒32. Oś SERPINB3–STAT1/3 jest szczególnie istotna w kontekście niniejszych wyników, ponieważ w analizach transkrypcyjnych zidentyfikowano sygnały związane z interferonem, STAT1 oraz JAK–STAT. Wspólnie obserwacje te wspierają interpretację, według której aktywacja komórek odpornościowych i ich komunikacja z komórkami strukturalnymi naczyń mogą przyczyniać się do progresji PH/PAH.
Badanie to posiada kilka mocnych stron. Wykorzystano wiele publicznych zbiorów danych oraz korekcję efektu serii, aby zredukować błąd specyficzny dla konkretnych zbiorów danych. Analizę ekspresji różnicowej, ważoną analizę sieci koekspresji genów, analizę oddziaływań białko-białko oraz trzy algorytmy uczenia maszynowego połączono w celu zwiększenia odporności cech. Niezależna walidacja bulk, potwierdzenie metodą qRT-PCR oraz dowody z poziomu pojedynczych komórek dostarczyły uzupełniających, choć nieidentycznych warstw dowodowych. Heterogeniczne wyniki GSE117261 oraz mała kohorta qRT-PCR wskazują również na istotne ograniczenia, w tym niepełną replikację zewnętrzną, potencjalne efekty specyficzne dla tkanki i platformy oraz ryzyko przeuczenia modelu. Odkrywanie biomarkerów rozszerzono także o przesiewowe badanie związków kandydackich, jednak analizy dokowania pozostają na etapie generowania hipotez. Przyszłe badania powinny zwalidować pięć genów w większych niezależnych kohortach z wykorzystaniem transkryptomiki przestrzennej, proteomiki, immunohistochemii oraz modeli organoidowych lub układów vascular-on-chip. Podsumowując, CXCL10, JUN, IFIH1, MX1 i TLR7 pozostają kandydatami na biomarkery PH/PAH powiązane z immunologiczno-zapalnym i interferonowym przebudową naczyniową, podczas gdy BRD-K91900765/VX-745 jest kandydatem do repozycjonowania leków wyłonionym obliczeniowo, którego znaczenie terapeutyczne wymaga walidacji eksperymentalnej.
Oświadczenia
Autorzy oświadczają, że nie stwierdzono konfliktu interesów.
Podziękowania
Badanie to zostało wsparte przez Hunan Innovative Province Construction Project (nr 2022JJ30465).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 2× SYBR Green PCR Mastermix | Beijing Solarbio Science & Technology Co., Ltd. | Nr katalogowy SR1110 | Ilościowa amplifikacja PCR w czasie rzeczywistym z wykorzystaniem barwników oraz detekcja fluorescencyjna |
| AI21.msvmRFE.R oraz e1071 | Własny skrypt R z pakietem e1071 z repozytorium CRAN | AI21.msvmRFE.R; e1071 v1.7-17 | Rekurencyjna eliminacja cech z wykorzystaniem maszyny wektorów nośnych |
| Agaroza | Beijing Solarbio Science & Technology Co., Ltd. | Nr katalogowy A8201; CAS 9012-36-6 | Ocena integralności całkowitego RNA za pomocą elektroforezy w żelu agarozowym |
| Aparatura do elektroforezy w żelu agarozowym | Beijing Liuyi Biotechnology Co., Ltd. | Model DYCZ-24DN | Elektroforetyczna ocena integralności RNA |
| Silnik oceniający AutoDock Vina | Centrum Biologii Strukturalnej Obliczeniowej, Scripps Research | v1.2.0; RRID: SCR_011958 | Punktacja póz białko-ligand w ramach procedury CB-Dock2 |
| CB-Dock2 | Laboratorium Cao, serwer WWW CB-Dock2 | v2.0; dostęp w lipcu 2026 r. | Wykrywanie pustych wnęk oraz dokowanie molekularne związku VX-745 z wybranymi strukturami białek |
| CellChat | Pakiet R CellChat | v2.1.2 | Wnioskowanie i wizualizacja komunikacji międzykomórkowej na podstawie macierzy ekspresji pojedynczych komórek |
| CellChatDB.human | Dystrybuowane z pakietem R CellChat | CellChatDB.human; podzbiór sygnalizacji wydzielniczej; minimalny próg komórek = 10 | Baza danych interakcji ligand-receptor u ludzi dla CellChat |
| clusterProfiler | Pakiet R Bioconductor | v4.20.0; wersja Bioconductor 3.23 | Analizy wzbogacenia w oparciu o ontologię genów (Gene Ontology) oraz Kioto encyklopedię genów i genomów (Kyoto Encyclopedia of Genes and Genomes) |
| Mapa Połączeń (CMap/CLUE) | Broad Institute | zasób L1000/CLUE; RRID: SCR_016204; dostęp w lipcu 2026 r. | Obliczeniowa analiza repozycjonowania leków |
| Dedykowane primery oligonukleotydowe | Beijing Solarbio Science & Technology Co., Ltd. | Synteza na zamówienie; sekwencje starterów podano w tabeli 2 | Amplifikacja ACTB, CXCL10, JUN, IFIH1, MX1 i TLR7 |
| cytoHubba | Sklep z aplikacjami Cytoscape | v0.1 | Ranking genów typu hub w sieci oddziaływań białko-białko w oparciu o stopień węzła |
| Cytoscape | Konsorcjum Cytoscape | v3.10.4; RRID: SCR_003032 | Wizualizacja i analiza sieci oddziaływań białko-białko |
| DrugBank | Baza Wiedzy DrugBank | v6.0; RRID: SCR_002700 | Identyfikacja związków i kuratela informacji farmakologicznych |
| System do dokumentacji żeli | Beijing Liuyi Biotechnology Co., Ltd. | Model WO-9413B | Wizualizacja i rejestracja wyników analizy integralności RNA w żelu agarozowym |
| Gene Expression Omnibus (GEO) | Krajowe Centrum Biotehnologii Informacyjnej | GSE22356, GSE33463, GSE48149, GSE117261 oraz GSE210248; RRID: SCR_005012 | Pobieranie zbiorów danych transkrypomicznych z pojedynczych komórek oraz z całych populacji komórek |
| GEOquery | pakiet R Bioconductor | v2.80.0; wydanie Bioconductor 3.23 | Programowe pobieranie i import danych ekspresji oraz fenotypowych z GEO |
| glmnet | pakiet R z repozytorium CRAN | v5.0 | Regresja logistyczna metodą LASSO (least absolute shrinkage and selection operator) oraz regularyzowane modelowanie logistyczne |
| limma | pakiet R z projektu Bioconductor | v3.68.0; wersja Bioconductor 3.23; RRID: SCR_010943 | Analiza ekspresji różnicowej i statystyka empirycznego Bayesa |
| spektrofotometr NanoDrop | Thermo Fisher Scientific | NanoDrop ND-1000; oprogramowanie v3.8 | Pomiar stężenia RNA oraz wskaźników czystości A260/280 i A260/230 |
| NCBI Primer-BLAST | Krajowe Centrum Biotechnologii Informacyjnej | Narzędzie internetowe; RRID: SCR_003095; dostęp w lipcu 2026 r. | Weryfikacja specyficzności starterów |
| pROC | pakiet R z repozytorium CRAN | v1.19.0.1; RRID: SCR_024286 | Analiza charakterystyki operacyjnej odbiornika, przedziały ufności DeLonga oraz punkty odcięcia indeksu Youdena |
| Protein Data Bank (PDB) | RCSB Protein Data Bank | CXCL10: 1LV9; JUN: 1JUN; IFIH1: 3B6E; MX1: 5GTM; TLR7: 7CYN; MAPK14/p38α: 1OUK; RRID: SCR_012820 | Pobieranie eksperymentalnie wyznaczonych struktur białek do dokowania molekularnego |
| PubChem | Krajowe Centrum Biotechnologiczne (NCBI) | PubChem CID 3038525; RRID: SCR_004284 | Pozyskiwanie struktury trójwymiarowej i identyfikatorów chemicznych BRD-K91900765/VX-745 |
| R | R Foundation for Statistical Computing | v4.6.1; RRID: SCR_001905 | Obliczenia statystyczne, przetwarzanie danych, uczenie maszynowe i wizualizacja |
| lasy losowe | pakiet R z repozytorium CRAN | v4.7-1.2 | Wybór cech i ranking istotności zmiennych metodą lasów losowych |
| System PCR w czasie rzeczywistym | Stratagene, obecnie Agilent Technologies | System do analizy PCR w czasie rzeczywistym Mx3000P | amplifikacja qRT-PCR, detekcja fluorescencji, analiza krzywej topnienia oraz eksport wartości Ct |
| Seurat | pakiet R z repozytorium CRAN; Satija Laboratory | v5.5.1; RRID: SCR_016341 | Kontrola jakości, normalizacja, redukcja wymiarowości, klasteryzacja i adnotacja w sekwencjonowaniu RNA pojedynczych komórek |
| Proszę podać tekst do tłumaczenia. | Konsorcjum STRING | v12.0; RRID: SCR_005223 | Konstrukcja sieci oddziaływań białko-białko |
| sva (ComBat) | pakiet R Bioconductor | v3.60.0; wydanie Bioconductor 3.23 | Korekcja efektów seryjnych między zestawami danych |
| SwissADME | Szwajcarski Instytut Bioinformatyki | Serwer WWW; dostęp w lipcu 2026 r. | Wstępna analiza właściwości lekopodobnych, fizykochemicznych oraz parametrów ADME |
| Zestaw do izolacji całkowitego RNA | Beijing Solarbio Science & Technology Co., Ltd. | Nr katalogowy R1200 | Ekstrakcja i oczyszczanie całkowitego RNA z próbek tkanki płucnej |
| Uniwersalny zestaw RT-PCR (AMV) | Beijing Solarbio Science & Technology Co., Ltd. | Nr katalogowy RP1200 | Odwrotna transkrypcja całkowitego RNA do komplementarnego DNA |
| WGCNA (Analiza sieci współwyrażania genów ważonej) | pakiet R z repozytorium CRAN | v1.74 | Konstrukcja ważonej sieci współekspresji genów oraz analiza modułów i cech |
Bibliografia
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.