Niniejsze badanie identyfikuje pięć biomarkerów związanych z kuproptozą i ferroptozą w colitis ulcerosa poprzez zintegrowane uczenie maszynowe, sekwencjonowanie RNA pojedynczych komórek oraz walidację eksperymentalną, dostarczając informacji przydatnych w diagnostyce klinicznej i celowanej immunoterapii.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Celowanie w ferroptozę i kuproptozę w wrzodziejącym zapaleniu jelita grubego: wyniki kompleksowej bioinformatyki i walidacji eksperymentalnej
W tym artykule
Podsumowanie
Streszczenie
Wrzodziejące zapalenie jelita grubego (UC) jest przewlekłą chorobą jelit o nie w pełni zdefiniowanej patogenezie, charakteryzującą się rosnącą zapadalnością i wskaźnikiem hospitalizacji w nowo uprzemysłowionych krajach. W UC nadmierna śmierć komórek nabłonka jelitowego prowadzi do przerwania bariery śluzówkowej i wywołuje odpowiedzi zapalne. Ferroptoza i kuproptoza to dwie niedawno opisane formy regulowanej śmierci komórkowej. Większość badań nad UC analizowała te procesy oddzielnie; jednak ich połączona rola w progresji UC pozostaje niewystarczająco scharakteryzowana. Aby zbadać ich synergistyczną rolę w patogenezie UC, zastosowano podejście etapowe, obejmujące szerokoprofilowe analizy transkrypcyjne w celu identyfikacji potencjalnych celów, a następnie walidację w modelach in vitro. Geny różnicowo wyrażane (DEGs) zestawiono z genami związanymi z ferroptozą (FRGs) oraz genami związanymi z kuproptozą (CRGs). Wspólne cele zostały wyselekcjonowane przy użyciu konsensusu algorytmów uczenia maszynowego oraz analizy sieci współwyrażania genów z wagami (WGCNA). Pięć biomarkerów — LCN2, IDO1, CXCL2, NOS2 i CD274 — było znacząco nadekspresywnych w UC. Analiza jednokomórkowa pozwoliła scharakteryzować ich ekspresję w różnych typach komórek, przy czym LCN2 i NOS2 były przede wszystkim wzbogacone w komórkach nabłonkowych. Znaczenie mechanistyczne tych markerów oceniono dalej za pomocą testów in vitro. Leczenie inhibitorami ferroptozy lub kuproptozy łagodziło zapalenie związane z UC i modulowało ekspresję biomarkerów w modelach komórkowych Caco-2. Wyniki te identyfikują pięć biomarkerów związanych z progresją UC i dostarczają dowodów eksperymentalnych wspierających ich potencjalne zastosowanie w diagnostyce klinicznej i interwencjach terapeutycznych.
Wprowadzenie
Wrzodziejące zapalenie jelita grubego (WZJG) to nawracająca zapalna choroba jelit, która wiąże się z rosnącym globalnym obciążeniem i znacznymi długoterminowymi kosztami leczenia1,2. Chociaż aminosalicylany, kortykosteroidy, leki biologiczne i terapie małocząsteczkowe poszerzyły opcje terapeutyczne, trwała remisja pozostaje trudna do osiągnięcia u wielu pacjentów3,4. Ta niezaspokojona potrzeba kliniczna podkreśla znaczenie identyfikacji powtarzalnych markerów molekularnych i dostępnych mechanizmów, które mogłyby wspomóc wcześniejszą diagnostykę oraz terapię ukierunkowaną na mechanizm choroby5.
Ferroptoza jest zależną od żelaza formą regulowanej śmierci komórki, indukowaną przez peroksydację lipidów, wyczerpanie glutationu oraz upośledzenie aktywności GPX46. Podwyższone poziomy żelaza i malondialdehydu w UC są zgodne z ferroptotycznym uszkodzeniem nabłonka, podczas gdy eksperymentalna aktywacja osi SLC7A11–GSH–GPX4 lub bezpośrednie hamowanie ferroptozy mogą chronić barierę jelitową7,8.
Kuproptoza, opisana w 2022 roku, jest wywoływana przez wiązanie miedzi z lipoilowanymi białkami mitochondrialnymi, co prowadzi do agregacji białek i stresu proteotoksycznego9. Ponieważ jelito odgrywa centralną rolę w gospodarce miedzią, zaburzenie tej ścieżki może nasilać utleniające i zapalne uszkodzenia nabłonka w UC10.
Ferroptoza i kuproptoza mogą zbiegać się poprzez zaburzenia równowagi jonów metali, metabolizm mitochondrialny, wyczerpanie zapasów glutationu oraz stres oksydacyjny11. Pozostaje jednak niejasne, czy ta interakcja generuje powtarzalną sygnaturę molekularną w UC oraz czy taka sygnatura reaguje na inhibicję specyficzną dla danej ścieżki.
Hipoteza badawcza zakładała, że zaburzony crosstalk między ferroptozą a kuproptozą w UC zbiega się w powtarzalnej sygnaturze biomarkerów, którą można wytypować w zbiorach danych transkrypcyjnych typu bulk i single-cell oraz osłabić poprzez specyficzne dla szlaku hamowanie w modelu uszkodzenia nabłonka jelitowego. W związku z tym zintegrowano bioinformatykę wielokohortową, uczenie maszynowe, analizę pojedynczych komórek oraz celowane eksperymenty na komórkach Caco-2, aby zidentyfikować i funkcjonalnie ocenić potencjalne biomarkery (Rysunek 1).
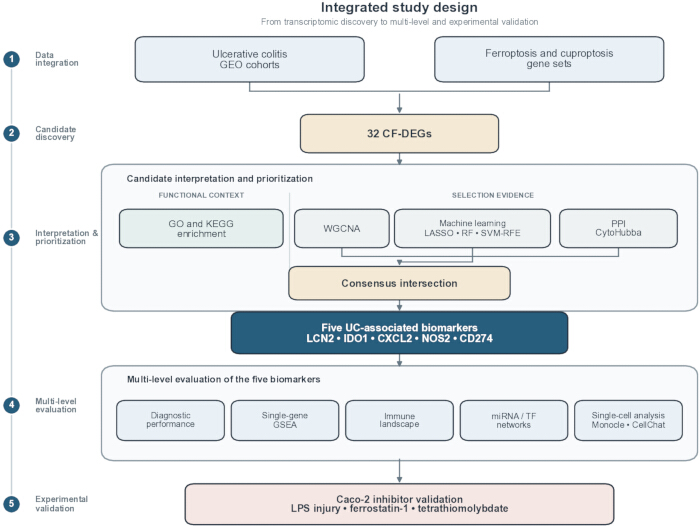
Rysunek 1: Schemat badania. Zintegrowany przepływ pracy dla wielkohortowego przesiewu transkrypcyjnego, priorytetyzacji biomarkerów w oparciu o uczenie maszynowe i sieci, lokalizacji na poziomie pojedynczych komórek oraz walidacji z użyciem inhibitorów w komórkach Caco-2. UC: colitis ulcerosa (nieswoiste zapalenie jelita grubego); GEO: Gene Expression Omnibus; WGCNA: ważona analiza sieci korelacjii ekspresji genów; PPI: oddziaływanie białko-białko; ROC: charakterystyka operacyjna odbiornika; GSEA: analiza wzbogacenia zestawu genów. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W badaniu wykorzystano publicznie dostępne zestawy danych oraz komercyjnie dostępne ludzkie linie komórkowe. Nie brali w nim udziału uczestnicy będący ludźmi, nie wykorzystano nowo pobranych tkanek ludzkich ani kręgowców; w związku z tym nie wymagano zgody instytucjonalnej komisji etyki. Narzędzia badawcze, oprogramowanie i zasoby online wykorzystane w protokole wymieniono w Tabeli materiałów.
1. Przetwarzanie danych dla analizy ekspresji różnicowej
W celu stworzenia kohort odkrycia i walidacji transkrypcyjnej przeszukano bazę danych Gene Expression Omnibus (GEO) przy użyciu terminu „ulcerative colitis”. Cztery zbiory danych — GSE87466, GSE92415, GSE107499 oraz GSE75214 — posłużyły jako zestaw treningowy, natomiast GSE47908 zarezerwowano do walidacji zewnętrznej. Zbiory danych treningowych znormalizowano i poddano korekcie efektu serii za pomocą narzędzia ComBat w programie Sangerbox 3.0, natomiast zbiór walidacyjny przetworzono niezależnie.
Łącznie 583 genów związanych z ferroptozą (FRGs) pozyskano z bazy FerrDB, a następnie uzupełniono o geny opisane w literaturze w celu zredukowania błędu wynikającego z korzystania z jednego źródła12. Zbiór 96 genów związanych z kuproptozą (CRGs) zestawiono na podstawie opublikowanych badań12,13,14. Analizę różnicowej ekspresji przeprowadzono przy użyciu pakietu limma, przyjmując progi |log₂ fold change| > 1 oraz wartość P skorygowaną metodą Benjamini-Hochberga < 0,05. Wykresy diagnostyczne normalizacji, korekcji efektu serii, różnicowej ekspresji oraz klasteryzacji przedstawiono na Rysunku uzupełniającym 1. Skład próbek, wykorzystane platformy oraz przydziały kohort podano w Tabeli uzupełniającej 1.
2. Identyfikacja CF-DEG w UC
Analizę korelacji Pearsona przeprowadzono przy zastosowaniu progów |r| > 0,5 i P < 0,05 w celu zidentyfikowania współwyrażonych genów związanych z ferroptozą (FRGs) oraz genów związanych z kuproptozą (CRGs). Otrzymany zestaw genów zestawiono z genami o różnej ekspresji (DEGs), aby zidentyfikować współwyrażone geny o różnej ekspresji związane z kuproptozą i ferroptozą (CF-DEGs).
3. Analiza wzbogaceń
Analizy wzbogacenia według Gene Ontology (GO) oraz Kyoto Encyclopedia of Genes and Genomes (KEGG) przeprowadzono przy użyciu narzędzia clusterProfiler oraz platformy Bioinformatics.com.cn. Jako próg istotności przyjęto wartość P < 0,05 po korekcie metodą Benjamini–Hochberga. Wykresy wzbogacenia przedstawiono na Rysunku uzupełniającym 2.
4. Ważona analiza sieci koekspresji genów (WGCNA)
Strukturę modularną leżącą u podstaw profili ekspresji genów przeanalizowano za pomocą ważonej analizy sieci współekspresji genów (WGCNA). Próbki nieprawidłowe zidentyfikowano i wykluczono poprzez grupowanie hierarchiczne w połączeniu z funkcją goodSamplesGenes. Następnie wyznaczono odpowiednią wartość potęgi miękkiego progowania (β), aby spełnić kryterium topologii wolnej od skali niezbędne do konstrukcji sieci.
Przetworzone dane dotyczące ekspresji wykorzystano do skonstruowania macierzy nakładania topologicznego (TOM) na potrzeby analizy koekspresji genów. Z zastosowaniem metody dynamicznego cięcia drzewa geny o wysoce spójnych wzorcach ekspresji zorganizowano w moduły genowe, z których każdy zawierał co najmniej 100 genów. Powiązania między eigengenami modułów (ME) a fenotypami przeanalizowano w celu zidentyfikowania modułów związanych z procesem chorobowym i wyodrębnienia odpowiadających im zestawów genów. Diagnostyka przesiewowa WGCNA została przedstawiona na Rysunku uzupełniającym 3.
5. Wybór biomarkerów
Aby wyłonić priorytetowe kandydaty do dalszych badań eksperymentalnych, równolegle zastosowano trzy algorytmy uczenia maszynowego15. Regresja LASSO (least absolute shrinkage and selection operator) została wykorzystana do selekcji cech, las losowy (random forest) z ntree = 500 posłużył do określenia rangi istotności genów, a maszyna wektorów wspierających z rekurencyjną eliminacją cech (SVM-RFE) została użyta do zidentyfikowania podzbioru cech z najniższym błędem walidacji krzyżowej. Pełna diagnostyka przesiewowa znajduje się na Rysunku uzupełniającym 5.
Znaczenie genów oceniano na podstawie wkładu poszczególnych genów w dokładność klasyfikacji, a geny o najwyższej randze zostały wyselekcjonowane w celu stworzenia wstępnego zestawu genów16. Algorytm SVM-RFE przeprowadził przesiewanie cech i optymalizację modelu poprzez iteracyjną eliminację cech, co pozwoliło na identyfikację optymalnego podzbioru cech dla klasyfikacji17. Geny wspólne dla trzech algorytmów uznano za potencjalne biomarkery zidentyfikowane za pomocą uczenia maszynowego.
Wykorzystano CF-DEG do skonstruowania sieci oddziaływań białko-białko (PPI), a następnie użyto narzędzia CytoHubba do rankingowania węzłów kluczowych. Przecięcie kluczowych modułów WGCNA, trzech wyników uczenia maszynowego oraz zestawu rdzeniowego PPI pozwoliło zdefiniować pięć zintegrowanych potencjalnych biomarkerów: LCN2, IDO1, CXCL2, NOS2 oraz CD274. Geny te sklasyfikowano jako diagnostyczne kandydatów związanych z UC. W dalszych eksperymentach z inhibitorami LCN2, IDO1, CXCL2 i NOS2 sklasyfikowano jako markery reagujące na hamowanie ferroptozy, natomiast CD274 jako marker reagujący na hamowanie kuproptozy. Geny te nie zostały uznane za udowodnionych regulatorów nadrzędnych żadnej z tych ścieżek.
6. Opracowanie modelu prognostycznego i ewaluacja wielometodowa
Aby ocenić potencjał translacyjny w zastosowaniach klinicznych zidentyfikowanej sygnatury genów, przy użyciu pakietu rms skonstruowano nomogram służący do oceny skuteczności diagnostycznej. Wydajność modelu oceniono za pomocą krzywej kalibracyjnej, testu Hosmera–Lemeshow (HL) oraz indeksu zgodności Harrella (C-index).
Kalibrację modelu oceniono za pomocą testu HL oraz średniego błędu bezwzględnego (MAE). Przyjęto, że wartość P > 0,05 oraz MAE < 0,1 będą odpowiednio progami akceptowalnego dopasowania i dokładności modelu. Wygenerowano krzywe charakterystyki operacyjnej odbiornika (ROC) oraz obliczono pole pod krzywą (AUC), aby ocenić wydajność prognostyczną nomogramu dla UC. Do oceny generalizacji i stabilności modelu wykorzystano niezależny zbiór danych.
7. Analiza wzbogacenia zbiorów genów (GSEA)
W zbiorze treningowym przeprowadzono analizę korelacji Spearmana pomiędzy każdym biomarkerem a wszystkimi pozostałymi genami. Wyniki korelacji zostały uszeregowane w celu wygenerowania uporządkowanego zbioru genów. Analizę wzbogacenia zbiorów genów (GSEA) przeprowadzono z wykorzystaniem zbioru genów c2.cp.kegg_medicus.v2025.1.Hs.symbols z bazy Molecular Signatures Database (MSigDB) jako referencyjnego. Ścieżki biologiczne z P < 0,05 uznano za istotnie wzbogacone.
8. Analiza krajobrazu immunologicznego
Narzędzie CIBERSORT oraz macierz sygnatur LM22 zostały wykorzystane do przeprowadzenia analizy dekonwolucji danych ekspresyjnych i oszacowania proporcji 22 podtypów komórek odpornościowych. Następnie przeprowadzono analizę korelacji Spearmana w celu oceny powiązań między pięcioma biomarkerami a podtypami komórek odpornościowych.
9. Analiza sieci regulacyjnych
Informacje na temat regulacji przez czynniki transkrypcyjne (TF) oraz mikroRNA (miRNA) powiązane z genami uzyskano z zintegrowanych baz danych ChEA3 i TarBase 9.0 za pośrednictwem platformy NetworkAnalyst. Do sieci regulacyjnej włączono miRNA powiązane z co najmniej dwoma węzłami.
10. Sekwencjonowanie RNA z pojedynczych komórek (Single-cell RNA-seq)
Zintegrowano zbiory danych z pojedynczych komórek dla UC: GSE116222, obejmujący trzy próbki zdrowych i trzy próbki z UC, oraz GSE214695, obejmujący sześć próbek zdrowych i sześć próbek z UC. Zachowano komórki, w których wykryto 200–5 000 genów, >1 000 unikalnych identyfikatorów molekularnych (UMI), < 30% transkryptów mitochondrialnych, < 3% transkryptów hemoglobiny oraz < 50% transkryptów rybosomalnych. Do normalizacji wykorzystano funkcję NormalizeData, a do korekty efektu seryjnego przed klastrowaniem i adnotacją zastosowano narzędzie Harmony.
Po filtrowaniu dane zostały znormalizowane przy użyciu funkcji NormalizeData. Do minimalizacji efektu serii pomiędzy próbkami wykorzystano algorytm Harmony. W celu redukcji wymiarowości i klastrowania komórek, aby scharakteryzować struktury lokalne i globalne w obrębie populacji komórek, zastosowano metodę UMAP (Uniform Manifold Approximation and Projection) oraz t-SNE (t-distributed Stochastic Neighbor Embedding). Do dalszych analiz zachowano łącznie 31 712 wysokiej jakości komórek. Typy komórek przypisano na podstawie kanonicznych genów markerowych dla poszczególnych typów komórek.
Analizę czasu pseudoczynnościowego (pseudotime) przeprowadzono przy użyciu oprogramowania Monocle 2 w celu zbadania zmian w stanach komórek nabłonkowych i mieloidalnych z tkanek UC. Ewaluowano trajektorie rozwoju komórek oraz różnice między grupami, a następnie zwizualizowano wzorce ekspresji biomarkerów wzdłuż trajektorii czasu pseudoczynnościowego.
Do oceny komunikacji międzykomórkowej pomiędzy subpopulacjami komórek nabłonkowych i mieloidalnych wykorzystano narzędzie CellChat. Zintegrowano wzorce ekspresji specyficzne dla poszczególnych subpopulacji, aby wywnioskować prawdopodobieństwa oddziaływań oraz kluczowe szlaki sygnalizacyjne między komórkami nabłonkowymi a mieloidalnymi i scharakteryzować ich potencjalne sieci regulacji międzykomórkowej.
11. Eksperymenty komórkowe
Ludzkie komórki raka gruczołowego jelita grubego Caco-2 hodowano w pożywce Dulbecco’s modified Eagle zawierającej 10% płodowej surowicy bydlęcej, 100 U/mL penicyliny i 100 µg/mL streptomycyny w temperaturze 37 °C w atmosferze 5% CO₂. Komórki Caco-2 wybrano jako powtarzalny model nabłonkowej monowarstwy do testów bariery jelitowej i uszkodzeń zapalnych; jednak ich nowotworowe pochodzenie ogranicza bezpośrednią generalizację wyników na nienowotworowy nabłonek jelita grubego. Informacje o pasażowaniu nie były dostępne w archiwalnych zapisach eksperymentalnych.
Model stanu zapalnego i uszkodzenia in vitro opracowano poprzez narażenie komórek na 1 µg/mL lipopolisarydu (LPS) przez 24 h. Komórki przydzielono do grupy kontrolnej z nośnikiem w postaci dimetylosulfoksydu, grupy z samym LPS, grupy z LPS + 4 µM ferrostatiny-1 lub grupy z LPS + 40 µM tetratiomolibdanu, przy zachowaniu dopasowanych końcowych stężeń rozpuszczalnika. Grupa z samym LPS służyła jako pozytywna kontrola uszkodzenia/modelu do porównań z grupami z zastosowaniem inhibitorów.
- Żywotność komórek
Żywotność komórek oceniono za pomocą testu żywotności komórek zgodnie z instrukcjami producenta. Po inkubacji w temperaturze 37 °C przez około 2 h zmierzono absorbancję przy 450 nm za pomocą czytnika mikropłytek. - Pomiar poziomów MDA i Fe²⁺
Wewnątrzkomórkowe poziomy malondialdehydu (MDA) i Fe2⁺ zmierzono przy użyciu odpowiednich zestawów testowych zgodnie z instrukcjami producentów. Całkowite białko oznaczono metodą kwasu bicinchoninowego, a każdy odczyt znormalizowano do zawartości białka w odpowiedniej próbce. - Analiza z użyciem fluorescencyjnej sondy jonów miedzi
Po usunięciu pożywki hodowlanej dodano specyficzną dla Cu2⁺ sondę fluorescencyjną w końcowym stężeniu 1 µM i inkubowano przez 30 min w temperaturze 37 °C. Obrazy pozyskano natychmiast, bez przemywania, za pomocą odwróconego mikroskopu fluorescencyjnego przy długościach fal wzbudzenia i emisji odpowiednio 510 i 578 nm. Parametry akwizycji pozostały stałe dla wszystkich grup, a skala obrazu została skalibrowana na 50 µm. - RT-qPCR
Całkowite RNA wyizolowano przy użyciu odczynnika do ekstrakcji RNA opartego na fenolu i guanidynium. Komplementarne DNA zsyntetyzowano z 1 µg RNA przy użyciu zestawu do syntezy pierwszej nici cDNA, natomiast do reakcji PCR w czasie rzeczywistym wykorzystano odczynniki oparte na SYBR Green. Każdą reakcję przeprowadzono w trzech powtórzeniach technicznych. Sekwencje starterów podano w Tabeli uzupełniającej 2, a względną obfitośćt mRNA obliczono metodą 2⁻ΔΔCt.
12. Analiza statystyczna
Normalność rozkładu oraz jednorodność wariancji oceniono odpowiednio za pomocą testów Shapiro–Wilka oraz Levene'a z centrowaniem do mediany. Dane spełniające oba założenia analizowano za pomocą nieparzystego dwustronnego testu t lub jednoczynnikowej analizy wariancji, a następnie testu Tukey’a (HSD). W przypadku niespełnienia któregokolwiek z założeń stosowano test t Welcha lub analizę wariancji Welcha, a następnie porównania Gamesa–Howella.
Wyniki przedstawiono jako średnia ± odchylenie standardowe. Rzeczywista liczba powtórzeń biologicznych, dokładne dwustronne wartości P oraz weryfikacje założeń zostały zamieszczone w Tabeli uzupełniającej 3. Zarchiwizowane arkusze źródłowe dla Ryciny 13 zawierają mniejszą liczbę powtórzeń kontrolnych dla paneli A (n = 4), C (n = 4) i F (n = 2), podczas gdy wszystkie pozostałe kombinacje paneli/grup obejmują n = 6.
Analizy obliczeniowe przeprowadzono przy użyciu programu R oraz narzędzi limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC, rms, Seurat v4, Harmony, Monocle 2, CellChat oraz Cytoscape/CytoHubba. Wykorzystano zasoby internetowe, takie jak FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn oraz Sangerbox 3.0.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Identyfikacja i adnotacja funkcjonalna genów współwyrażanych w procesach kuproptozy i ferroptozy
Zintegrowano cztery zestawy danych treningowych obejmujące 421 próbek UC oraz 97 zdrowych kontroli. Zidentyfikowano łącznie 551 genów o zróżnicowanej ekspresji, w tym 362 genów o zwiększonej i 189 genów o zmniejszonej ekspresji. Analiza korelacji wykazała 444 genów skorelowanych z ferroptozą i kuproptozą, a ich część wspólna z genami o zróżnicowanej ekspresji pozwoliła wyłonić 32 w...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Badanie to zintegrowało transkryptomikę masową, uczenie maszynowe, analizę pojedynczych komórek oraz ukierunkowane eksperymenty komórkowe w celu zbadania interakcji między ferroptozą a kuproptozą w UC. Pięć diagnostycznych kandydatów powiązanych z UC wykazano powtarzalnie w kohortach odkrywczych i walidacyjnych; zlokalizowano je głównie w przedziałach nabłonkowych i mieloidalnych, a w komórkach Caco-2 wykazały one ekspresję reagującą na hamowanie szlaków. Wyniki te wspierają etapowy schemat pracy, w którym priorytetyzacj...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie zgłaszają żadnych konfliktów interesów.
Podziękowania
Niniejsza praca była wspierana przez projekt Young Qihuang Scholar National Administration of Traditional Chinese Medicine (Grant nr 2022256). Wyrażamy wdzięczność wszystkim członkom zespołów badawczych z Liaoning University of Traditional Chinese Medicine oraz Third Affiliated Hospital of Liaoning University of Traditional Chinese Medicine za wsparcie techniczne oraz wkład w opracowanie danych i analizę bioinformatyczną.
Podczas redakcji wykorzystano OpenAI Codex (OpenAI) wyłącznie w celu pomocy w korekcie językowej w języku angielskim, formatowaniu dokumentu oraz weryfikacji jakości rycin. Cała treść naukowa, analizy, cytowania oraz końcowa prezentacja zostały przejrzane i zweryfikowane przez autorów, którzy ponoszą pełną odpowiedzialność za manuskrypt.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zestaw do oznaczania białka metodą BCA | Instytut Biotechnologii Beyotime | P0010 | Oznaczanie ilości białka w celu normalizacji. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Platforma internetowa; dostęp w 2026 r. | Platforma wizualizacji i analizy GO/KEGG. |
| linia komórkowa Caco-2 | ATCC | HTB-37 | Linia komórkowa gruczolakoraka jelita grubego człowieka wykorzystana w modelu uszkodzenia nabłonka. |
| Zestaw do liczenia komórek Cell Counting Kit-8 | GLPBio | GK10001 | Test żywotności komórek pomiarowy przy 450 nm. |
| CIBERSORT z sygnaturą LM22 | Twórcy CIBERSORT | LM22 | Dekonwolucja 22 frakcji komórek odpornościowych. |
| ChEA3 | Laboratorium Ma'ayan | Platforma internetowa; dostęp 2026 | Wzbogacenie czynników transkrypcyjnych i przewidywanie sieci regulacyjnych. |
| Tlenek węgla2 inkubator | Nie zarejestrowano | Nie dotyczy | Inkubator z nawilżaczem używany do hodowli w temperaturze 37 °C oraz 5% CO22. |
| Cu2+ sonda fluorescencyjna | BIOFOUNT | CAS 98907-26-7 | Wewnątrzkomórkowe Cu2+ detekcja fluorescencji. |
| Cytoscape z wtyczką CytoHubba | Konsorcjum Cytoscape | Wersja nie została zarejestrowana | Wizualizacja PPI i ranking węzłów centralnych. |
| podłoże Eagle modyfikowane przez Dulbecco | Gibco | 11965092 | Pożywka do hodowli komórek Caco-2. |
| Dimetylosulfotek* | Nie zarejestrowano | Z uwagi na brak tekstu źródłowego do przetłumaczenia, proszę o dostarczenie treści, którą należy przełożyć na język polski. | Kontrola nośnikiem. |
| Płodowa surowica bydlęca | Nie zarejestrowano | Kiedy nie dostarczono tekstu źródłowego do tłumaczenia, nie mogę wygenerować przekładu. Proszę o przesłanie treści, którą należy przetłumaczyć na język polski zgodnie z wytycznymi. | Suplement medium w stężeniu 10%. |
| Fe2+ Zestaw do analizy | Abcam | ab83366 | Pomiar wewnątrzkomórkowego poziomu Fe2+. |
| FerrDB | Twórcy FerrDB | Baza danych online; dostęp 2026 | Źródło genów związanych z ferroptozą. |
| Ferrostatyna-1 | Sigma-Aldrich | SML0583 | Inhibitor ferroptozy; stężenie końcowe 4 µM. |
| Harmonia | Broad Institute/społeczność | Wersja nie została zapisana | Korekcja efektu seryjnego w analizie pojedynczych komórek. |
| Odwrócony mikroskop fluorescencyjny | Olympus | IX71 | Cu2+ obrazowanie fluorescencyjne przy pobudzeniu/emisji 510/578 nm. |
| Lipopolisacharyd | Nie zarejestrowano | Podaj proszę tekst źródłowy do przetłumaczenia. | Bodziec wywołujący uszkodzenie zapalne w 1 µg/mL przez 24 h. |
| Zestaw do oznaczania malondialdehydu | Instytut Biotechnologii Beyotime | S0131S | Pomiar peroksydacji lipidów. |
| Czytnik płytek mikrotitracyjnych | Nie zarejestrowano | Ze względu na brak dostarczonego tekstu źródłowego, nie można przeprowadzić tłumaczenia. Proszę o wprowadzenie treści w języku angielskim, którą należy przetłumaczyć na język polski. | Pomiar absorbancji przy 450 nm. |
| Monocle | Bioconductor/społeczność | Wersja 2 | Analiza pseudoczasu pojedynczych komórek. |
| Baza Sygnatur Molekularnych | Broad Institute | c2.cp.kegg_medicus.v2025.1.Hs | Zestaw genów referencyjnych dla GSEA. |
| NetworkAnalyst | Twórcy NetworkAnalyst | Platforma online; dostęp 2026 | Integracja sieci czynników transkrypcyjnych i miRNA. |
| Penicylina–streptomycyna | Nie zarejestrowano | Nie dotyczy | 100 U/mL penicyliny i 100 µg/mL streptomycyna |
| R | R Foundation for Statistical Computing | Wersja nie została zarejestrowana | Środowisko analizy bioinformatycznej. |
| Zestaw pakietów R | CRAN/Bioconductor | Brak zapisów budowania pakietów | przepływy pracy limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC oraz rms. |
| System PCR w czasie rzeczywistym | Nie zarejestrowano | Ponieważ nie dostarczono tekstu źródłowego do przetłumaczenia, proszę o przesłanie treści, którą należy przełożyć na język polski zgodnie z wytycznymi. | urządzenie do RT-qPCR z SYBR Green. |
| Zestaw do syntezy pierwszej nici cDNA RevertAid | Thermo Fisher Scientific | K1622 | Synteza pierwszej nici cDNA z 1 µg RNA |
| Sangerbox | Deweloperzy Sangerbox | 3.0 | Normalizacja i korekcja efektu serii metodą ComBat. |
| Seurat | Laboratorium Satija/społeczność | Wersja 4 | Kontrola jakości, normalizacja, klasteryzacja i wizualizacja danych z pojedynczych komórek. |
| Oprogramowanie do analizy statystycznej | Nie zarejestrowano | Ponieważ nie dostarczono tekstu źródłowego do tłumaczenia, proszę o przesłanie treści, którą należy przetłumaczyć na język polski zgodnie z wytycznymi. | Analiza statystyczna oryginalnych eksperymentów komórkowych. |
| Proszę podać tekst do przetłumaczenia. | Konsorcjum STRING | Baza danych online; dostęp 2026 | Białko–konstrukcja sieci oddziaływań białkowych |
| odczynniki do real-time PCR z SYBR Green | Takara | RR820A | Ilościowa reakcja łańcuchowa polimerazy w czasie rzeczywistym (qPCR). |
| TarBase | Narzędzia DIANA | 9.0 | Eksperymentalnie potwierdzone miRNA–interakcje genetyczne |
| Tetratiomolibdan | Sigma-Aldrich | 323446 | Chelator miedzi; stężenie końcowe 40 µM. |
| odczynnik TRIzol | Takara | 9108 | Izolacja całkowitego RNA. |
Bibliografia
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.