Niniejszy protokół integruje deidentyfikację, normalizację terminologii, weryfikację źródeł oraz powtarzalną wizualizację w celu generowania audytowalnych, zagregowanych wyników z rzeczywistych rekordów ambulatoryjnych tradycyjnej medycyny chińskiej.
Artykuł metodologiczny
Weryfikowane u źródła wydobywanie i wizualizacja rzeczywistych zapisów przypadków klinicznych z zakresu tradycyjnej medycyny chińskiej z wykorzystaniem formuły Hegan Jianpi
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
Rzeczywiste zapisy z wizyt ambulatoryjnych w ramach tradycyjnej medycyny chińskiej (TCM) zawierają podłużne informacje o diagnozach, elementach zespołów objawów, opisach symptomów oraz zindywidualizowanych receptach, jednak ich półstrukturalny format utrudnia powtarzalną analizę. Niniejszy artykuł przedstawia poddany audytowi protokół konwersji zanonimizowanych zapisów przypadków w śledzone tabele zbiorcze i wizualizacje gotowe do publikacji. Przepływ pracy definiuje kryteria kwalifikacji i jednostki analizy, zachowuje mapowania między oryginalną a znormalizowaną terminologią, weryfikuje wszystkie zgłoszone liczniki i mianowniki oraz regeneruje rysunki z wersjonowanych tabel źródłowych. Zastosowany do zapisów z okresu od stycznia 2015 do czerwca 2024 roku protokół zidentyfikował 555 kwalifikujących się wizyt z przepisanymi lekami u 396 pacjentów. Końcowy zbiór danych zawierał 324 znormalizowane etykiety ziół oraz 9 339 wystąpień zastosowania ziół. Przepływ pracy wygenerował równoległe spektra chorób w medycynie zachodniej i TCM, jawne spektrum elementów zespołów objawów i macierz współwystępowania, profile częstotliwości ziół i materia medica, spektrum symptomów wywiedzionych z wywiadu obejmujące 37 terminów, 15 skierowanych reguł asocjacyjnych, hierarchiczne grupowanie oraz mapy ciepła zastosowania ziół zestratyfikowane według diagnozy. Przynajmniej jedno z wcześniej określonych słów kluczowych z wywiadu wykryto w 474 wizytach (85,41%). W przypadku, gdy pozwalają na to zasady instytucjonalne, opcja sztucznej inteligencji (AI) pod nadzorem człowieka może pomóc w weryfikacji terminologii, przeglądzie spójności między plikami oraz dopasowaniu podpisów do rysunków. Każde użycie AI musi zostać udokumentowane w oddzielnym raporcie z audytu i nie może zastępować przeglądu danych źródłowych. Dzięki zintegrowaniu zarządzania, normalizacji, obliczeń, interpretacji klinicznej i wyjścia wizualnego w jeden powtarzalny przepływ pracy, metoda ta przekształca rozproszoną dokumentację kliniczną w podlegający przeglądowi zasób badawczy. Protokół może zostać dostosowany do innych zbiorów danych z praktyk eksperckich, wieloośrodkowych projektów terminologicznych oraz prospektywnych platform danych klinicznych.
Wprowadzenie
Rzeczywiste rekordy z wizyt w ambulatoryjnych placówkach tradycyjnej medycyny chińskiej (TCM) przechowują podłużne rozumowanie kliniczne poprzez narracyjne opisy objawów, równoległe systemy diagnostyczne, opisy syndromów oraz zindywidualizowane recepty. Wczesne prace nad odkrywaniem wiedzy uznały zapisy przypadków za złożone dane doświadczalne, wymagające dedykowanych metod informatycznych przed możliwością wiarygodnego zbadania występujących w nich wzorców1. Następne badania wykazały, że synonimiczne wyrażenia opisujące objawy, precyzyjne encje oraz lokalnie dokumentowane terminy diagnostyczne muszą zostać znormalizowane bez usuwania oryginalnego sformułowania2,3,4,5,6. Dane z elektronicznej dokumentacji medycznej (EHR) mogą również wspierać obliczeniowe badania nad recepturami oraz wykorzystanie wielokrotnych narzędzi analitycznych, o ile kontekst kliniczny i pochodzenie danych pozostają widoczne7,8. W związku z tym niezbędne są autorytatywne referencje materia medica w celu standaryzacji nazw ziół, form przetwórstwa, właściwości, smaków oraz przypisań do południków9,10. Na poziomie raportowania wytyczne RECORD i STROBE wymagają przejrzystych opisów źródeł danych, reguł kwalifikowalności, zmiennych i decyzji analitycznych, podczas gdy zasady FAIR kładą nacisk na możliwe do prześledzenia i ponownego wykorzystania obiekty badawcze11,12,13. Rozważania te są szczególnie istotne, gdy rekordy zawierają powtarzające się wizyty, brakujące pola, nakładającą się terminologię oraz teksty wolne. Ocena przydatności do użytku musi odnosić się do kompletności, zgodności, prawdopodobieństwa i spójności źródeł14,15. Deidentyfikacja tekstów wolnych wymaga również wyraźnych procedur i weryfikacji ludzkiej, ponieważ metody zautomatyzowane mogą zachować użyteczną treść kliniczną, pozostawiając jednocześnie rezydualne ryzyko naruszenia prywatności16,17,18.
Po ustaleniu zasad zarządzania i terminologii, profilowanie częstotliwości, wydobywanie reguł asocjacyjnych oraz klasteryzacja hierarchiczna mogą dostarczyć uzupełniających perspektyw na strukturę recept19,20,21. Metody analizy sieci i mapowania nauki dodatkowo demonstrują, w jaki sposób skoordynowane reprezentacje wizualne mogą ujawnić zależności, których pojedyncza lista rankingowa nie jest w stanie uchwycić22,23,24,25. Niedawne badania nad reumatoidalnym zapaleniem stawów z depresją, inhibitorami kinaz Janus w wrzodziejącym zapaleniu jelita grubego oraz reumatoidalnym zapaleniem stawów z fibromialgią ilustrują wartość kryteriów wyszukiwania z blokadą wersji, sieci współwystępowania, klasteryzacji, interpretacji czasowej oraz wyraźnego określenia ograniczeń analitycznych26,27,28. Niniejsze badanie adaptuje te uniwersalne zasady projektowania do analizy rekordów klinicznych, a nie do bibliometrii literatury. W rekordach źródłowych Hegan Jianpi Formula odnosi się do formuły opartej na doświadczeniu, związanej z praktyką profesora Nai-li Yao29,30. Powiązane publikacje opisują jego szersze kliniczne podejście do harmonizacji wątroby i śledziony oraz śledziony i żołądka29,30. W niniejszym artykule metodologicznym nazwa formuły identyfikuje jedynie kontekst rekordu źródłowego i nie ustanawia stałego składu, dawki, wskazania terapeutycznego ani twierdzenia co do skuteczności. Przepływ obliczeniowy wykorzystuje reguły deterministyczne i ogólne metody statystyczne. Powtarzalna praktyka obliczeniowa wymaga dodatkowo zachowania danych wejściowych, dokumentacji parametrów, zaprogramowanych transformacji oraz weryfikowalnych wyników31,32. Opcja sztucznej inteligencji (AI) pod nadzorem człowieka może pomagać w weryfikacji terminologii, przeglądach spójności między plikami oraz wizualnej kontroli jakości, pod warunkiem udokumentowania jej zastosowania. Ekspertyza kliniczna, zabezpieczenia prywatności i odpowiedzialne podejmowanie decyzji przez człowieka muszą pozostać nadrzędne (Supplementary Table 1)33,34. Ogólnym celem tej metody jest przekształcenie zanonimizowanych rekordów przypadków TCM w audytowany łańcuch wyników uwarstwionych według chorób, syndromów, objawów, zastosowania ziół, asocjacji, klasteryzacji i diagnoz. Przykład praktyczny wykorzystuje 555 kwalifikujących się wizyt z receptami od 396 pacjentów, aby zademonstrować, w jaki sposób zarządzanie, normalizacja, obliczenia, interpretacja kliniczna i publikacja wizualna mogą zostać zintegrowane bez ujawniania rekordów na poziomie pacjenta, dokładnych szczegółów formulacji, proporcji dawek lub instrukcji przepisywania.
Protokół
Ta retrospektywna analiza zanonimizowanych rekordów klinicznych została przeanalizowana i zatwierdzona przez Komisję Etyki Medycznej Szpitala Guang'anmen Chińskiej Akademii Nauk Medycznych (numer zatwierdzenia 2026-108-KY; 13 lipca 2026 r.). Wymóg uzyskania świadomej zgody został zniesiony przez Komisję.
1. Ustanowienie zasad etyki, ładu organizacyjnego i bezpieczeństwa danych
- Wyznacz opiekuna danych, analityka danych źródłowych, recenzenta terminologii klinicznej, recenzenta ilościowego oraz badacza upoważnionego do zatwierdzenia udostępnienia danych zagregowanych. Odnotuj każdą z tych ról w dzienniku projektu.
- Przygotuj plan zarządzania danymi, określając dozwolony system źródłowy, okres badania, pola, lokalizację przechowywania, uprawnienia do dostępu, procedurę kopii zapasowych, okres retencji oraz ograniczenia dotyczące kluczy powiązań.
- Eksportuj wyłącznie minimalny zestaw zmiennych wymaganych do uprzednio określonej analizy. Uwzględnij lokalny identyfikator pacjenta, datę wizyty, wiek lub datę urodzenia (jeśli jest to dozwolone), płeć, diagnozę zachodnią, nazwę choroby według TCM, zanonimizowany tekst historii choroby, opis języka, opis tętna, opis zespołu oraz pola dotyczące ziół w recepturze.
- Usuń imiona, nazwiska, numery identyfikacyjne, numery telefonów, dokładne adresy, identyfikatory ubezpieczeniowe, dane kontaktowe oraz inne bezpośrednie identyfikatory w kontrolowanym środowisku instytucjonalnym. Zastąp każdy numer dokumentacji medycznej identyfikatorem pacjenta specyficznym dla projektu.
- Przeskanuj pola tekstowe pod kątem pozostałych identyfikatorów i zamaskuj każdy wykryty element. Przechowuj każdy klucz powiązań oddzielnie od analitycznego zbioru danych i wyklucz go z folderów roboczych, współpracy oraz przesyłania danych.
- Zachowaj pierwotny zanonimizowany eksport jako migawkę źródłową w trybie tylko do odczytu. Zapisz nazwę pliku, datę utworzenia, liczbę wierszy, liczbę kolumn, rozmiar pliku oraz sumę kontrolną w manifeście źródłowym.
- Utwórz oddzielne katalogi dla plików źródłowych, plików roboczych, słowników, tabel zagregowanych, rycin, skryptów oraz zapisów audytu.
- Ogranicz udostępniane lub współdzielone materiały do tabel zagregowanych, zatwierdzonych zanonimizowanych słowników, skryptów i rycin do publikacji. Nie przesyłaj rekordów możliwych do identyfikacji lub potencjalnie możliwych do ponownej identyfikacji do publicznych systemów generatywnej AI, niezatwierdzonych usług chmurowych ani publicznych repozytoriów.
UWAGA: Jeśli polityka instytucjonalna zezwala na pomoc AI pod nadzorem człowieka, dostarczaj wyłącznie zanonimizowane fragmenty tekstu lub tabele zagregowane. Odnotuj cel, zweryfikowany wynik, zaakceptowaną poprawkę, recenzenta oraz datę w dzienniku audytu.
2. Określenie reguły identyfikacji rekordów i jednostek analizy
- Zdefiniuj instytucję, warunki opieki ambulatoryjnej, odpowiedzialny zespół kliniczny, system elektronicznej dokumentacji medycznej oraz okres źródłowy przed rozpoczęciem przesiewu. W analizowanym przykładzie należy użyć zapisów z okresu od stycznia 2015 do czerwca 2024 roku.
- Przechowuj regułę identyfikacji kohorty w ograniczonym, kontrolowanym pod względem wersji pliku przed analizą wyników. Zapisz zaakceptowane warianty terminologiczne oraz wszystkie warunki włączenia i wykluczenia, nie ujawniając w manuskrypcie poufnych szczegółów formułowania tych reguł.
- Zastosuj zablokowaną wersję reguły identyfikacji zapisów na poziomie wizyty z przepisanym lekiem po normalizacji nazw ziół. Sfinalizuj pliki źródłowe, słowniki, regułę kohorty i parametry analizy jako jeden zestaw wydawniczy.
- Utwórz nową wersję i zregeneruj wszystkie zależne wyniki za każdym razem, gdy zmieni się komponent zablokowany wersyjnie. Nie modyfikuj reguły identyfikacji kohorty po przeanalizowaniu rozkładu chorób, częstotliwości występowania ziół, reguł asocjacji lub klastrów.
- Uwzględnij wizytę ambulatoryjną, jeśli mieści się ona w zablokowanym wersyjnie okresie badania, jest przypisana do poprawnego identyfikatora pacjenta w projekcie, zawiera interpretowalny zapis recepty i spełnia ograniczoną regułę identyfikacji zapisów.
- Wyklucz dokładne duplikaty eksportów, zapisy spoza okresu badania, zapisy bez interpretowalnej recepty oraz wiersze, które nie spełniają zablokowanej wersyjnie reguły identyfikacji. Przypisz jeden główny powód wykluczenia do każdego wykluczonego wiersza.
- Odróżnij powtórzone eksporty od rzeczywistych wizyt kontrolnych. Usuń wyłącznie dokładne duplikaty systemowe lub eksportowe i zachowaj rzeczywiste wizyty powtórne.
- Przypisz stabilne identyfikatory pacjentów i wizyt z przepisanym lekiem. Utwórz manifest kohorty zawierający wersję źródłową, wersję reguły, status przesiewu, powód włączenia lub wykluczenia, identyfikator pacjenta, identyfikator wizyty oraz status recenzenta.
- Używaj jednego zapisu na unikalnego pacjenta w celu przygotowania stałych podsumowań demograficznych, w tym wieku i płci. Przyjmij wizytę z przepisanym lekiem jako jednostkę analizy dla analiz chorób, zespołów, słów kluczowych z wywiadu, języka, tętna, ziół, reguł asocjacji oraz klastrowania.
- Oddziel kwalifikowalność do kohorty od dostępności zmiennych. Zachowaj wizytę, która w innym przypadku byłaby kwalifikowalna, nawet jeśli brakuje pola specyficznego dla danej zmiennej, i raportuj mianownik ocenialny dla każdej analizy.
- Zablokuj manifest kohorty przed przeprowadzeniem analizy opisowej. Zapisz liczbę kwalifikowalnych wizyt z przepisanym lekiem oraz liczbę unikalnych pacjentów i zregeneruj wszystkie zależne wyniki w przypadku zmiany decyzji o kwalifikowalności.
3. Normalizacja terminologii i zachowanie ścieżki audytu
- Utworzyć oddzielne słowniki z kontrolą wersji dla ziół, diagnoz zachodnich, nazw chorób w TCM, elementów zespołów, słów kluczowych wywiadu, terminów dotyczących języka, terminów dotyczących tętna oraz atrybutów materia medica.
- W każdym słowniku zawrzeć oryginalny termin, termin znormalizowany, kategorię terminu, pole źródłowe, regułę, źródło referencyjne, wersję słownika, recenzenta, datę recenzji oraz uwagi. Zachować każdy oryginalny termin po normalizacji.
- Normalizować nazwy chińskich materiałów leczniczych (CMM) przy użyciu autorytatywnych referencji nomenklaturowych9,10. Poprawić warianty typograficzne i skróty systemowe, zachowując jednocześnie klinicznie istotne formy przetworzenia.
- Zachować kwalifikatory przetworzenia, w tym: smażone (stir-fried), przetwarzane octem (vinegar-processed), smażone w miodzie (honey-fried), przetwarzane imbirem (ginger-processed), przetwarzane winem (wine-processed), zwęglone (charred) oraz surowe (raw), jako oddzielne etykiety.
- Utrzymywać oddzielnie zioła odmienne ortograficznie lub klinicznie. Nie łączyć Bai Shao z Bai Zhu ani nie wnioskować o rodzaju zioła z dwuznacznego skrótu bez weryfikacji źródła.
- Zachować oryginalną dawkę i jednostkę w oddzielnych polach, jeśli są dostępne. Usuwać tekst dawki wyłącznie podczas konstruowania zmiennych obecności ziół na poziomie wizyty.
- Nie interpretować częstotliwości występowania jako dawki skumulowanej lub intensywności leczenia.
- Normalizować nazwy chorób zachodnich i TCM niezależnie. Zachować system diagnostyczny oraz status diagnozy głównej; nie tłumaczyć etykiety choroby TCM na diagnozę zachodnią, chyba że obie zostały wyraźnie odnotowane.
- Przy pierwszym użyciu zdefiniować transliterowaną etykietę choroby TCM, jeśli jest to konieczne dla orientacji czytelnika. Zachować oryginalną etykietę źródłową.
- Rozdzielić wielowartościowy, jawny tekst zespołu za pomocą ograniczników zablokowanych wersyjnie i zmapować wyrażenia źródłowe na znormalizowane elementy zespołu. Usuwać powtórzenia każdego znormalizowanego elementu w obrębie jednej wizyty.
- Utrzymywać jawny tekst zespołu oddzielnie od kolumn wskaźników dziedziczonych lub pochodnych z punktacji.
- Zachować oryginalne pola języka, tętna, ustrukturyzowanych objawów oraz zanonimizowanego wywiadu jako oddzielne produkty danych. Nie traktować dopasowania słowa kluczowego z wywiadu jako równoważnego do ustrukturyzowanego objawu wprowadzonego przez klinicystę.
- Zlecić jednemu recenzentowi zaproponowanie każdego dwuznacznego lub wielo-do-jednego mapowania, a następnie przekazać je drugiemu recenzentowi klinicznemu do weryfikacji. Wykluczyć niepewne mapowania z publikowanych analiz do czasu ich rozstrzygnięcia w przeglądzie źródłowym.
- Sprawdzić pod kątem pustych znormalizowanych etykiet, mapowań jeden-do-wielu, mapowań wiele-do-jednego, duplikatów wpisów w słowniku, terminów nieprzejrzanych oraz przypadkowej utraty etykiet przetwarzania. Zablokować wersje słowników przed generowaniem tabel zagregowanych.
4. Weryfikacja pól źródłowych i blokada wyników raportowalnych
- Utwórz rejestr dowodów z jednym wierszem dla każdego twierdzenia w manuskrypcie, tabeli oraz panelu rysunku. Zapisz jednostkę analizy, pole źródłowe, wersję źródła, wersję słownika, wersję skryptu, licznik, mianownik, plik wyjściowy, recenzenta oraz zatwierdzone sformułowanie.
- Przelicz liczbę kwalifikujących się wizyt i unikalnych pacjentów, podsumowania demograficzne, liczbę przypadków chorób, liczbę jawnych zespołów objawów, liczbę słów kluczowych w historii, częstość występowania połączonych ziół oraz sumaryczne zużycie ziół bezpośrednio z plików zablokowanych wersyjnie.
- Porównaj każdą przeliczoną wartość z odpowiadającą jej wartością w manuskrypcie, arkuszu kalkulacyjnym lub na rysunku. Popraw manuskrypt i wygeneruj ponownie zależne wyniki za każdym razem, gdy zostanie potwierdzona rozbieżność.
- Rozwiąż każdą rozbieżność na poziomie pola źródłowego. Zapisz przyczynę, korektę, recenzenta i datę w rejestrze dowodów przed opublikowaniem dotkniętego tego problemu wyniku.
- Zweryfikuj, czy każda tabela zagregowana zawiera znormalizowaną etykietę, licznik, mianownik, definicję procentową, jednostkę analizy oraz identyfikator źródła wymagane do odtworzenia odpowiadającego stwierdzenia.
- Zweryfikuj mianownik użyty dla każdego procentu. Użyj unikalnych pacjentów dla stałych cech demograficznych oraz wizyt recepturowych dla dynamicznych zmiennych klinicznych i recepturowych.
- Porównaj etykiety rysunków, wartości, kolejność i definicje paneli z odpowiadającymi im zablokowanymi wersyjnie tabelami zagregowanymi. Regeneruj każdy rysunek po korekcie tabeli zamiast ręcznie edytować naniesione wartości.
- Poproś recenzenta klinicznego o weryfikację mapowań terminologicznych. Poproś recenzenta ilościowego o weryfikację liczności, wskaźników, metryk reguł i mianowników map ciepła.
- Zablokuj rejestr dowodów, tabele zagregowane i źródła rysunków pod jednym identyfikatorem wersji przed złożeniem manuskryptu.
5. Generowanie widm opisowych i wyników współwystępowania
- Wygeneruj podsumowania wieku i płci na poziomie pacjenta, przyjmując jeden wiersz dla każdego unikalnego pacjenta. Zachowaj i wyraźnie zaraportuj kategorie nieznane.
- Wygeneruj osobno widma chorób według medycyny zachodniej i TCM na poziomie wizyty z przepisywaniem leków. Zachowaj oryginalny system diagnostyczny i oblicz wiodące znormalizowane etykiety, stosując wspólny mianownik wizyt.
- Wygeneruj widmo syndromów-elementów z jawnego pola znormalizowanego tekstu syndromu. Rozdziel terminy za pomocą zablokowanych wersji ograniczników, usuń duplikaty każdego terminu w obrębie wizyty i oblicz częstotliwości na poziomie wizyt.
- Zbuduj macierz współwystępowania syndromów z tych samych zbiorów tokenów w obrębie wizyty. Zakoduj rozmiar węzła za pomocą częstotliwości wizyt, a szerokość krawędzi lub intensywność mapy ciepła za pomocą liczby współwystąpień parzystych.
- Wstępnie określ dokładny słownik słów kluczowych historii choroby w przypadku, gdy informacje o objawach mają głównie charakter opisowy. Przeskanuj wyłącznie zanonimizowane pole historii i policz każde pojęcie nie więcej niż raz w obrębie wizyty.
- Oblicz proporcję kwalifikujących się wizyt zawierających co najmniej jedno słowo kluczowe z historii i uszereguj wszystkie liczby słów kluczowych. Eksportuj pełną tabelę oraz wykreślony podzbiór.
- Wygeneruj częstotliwości połączonych ziół z znormalizowanych danych dotyczących recept. Policz każdą znormalizowaną etykietę zioła nie więcej niż raz na wizytę i zachowaj klinicznie istotne formy przetworzenia jako osobne etykiety.
- Wygeneruj profile Czterech Energii (Four-Qi), pięciu smaków i tropizmu południkowego na podstawie zablokowanego wersji słownika materia medica. Traktuj Cztery Energie jako kategorię jednowartościową dla każdego wystąpienia zioła z kodem właściwości.
- Traktuj pięć smaków i tropizm południkowy jako atrybuty wieloetykietowe. Określ mianownik zakodowany właściwością i zachowaj oddzielną jednostkę analizy.
- Wyeksportuj jedną tabelę zbiorczą czytelną dla maszyn dla każdej domeny opisowej przed wygenerowaniem końcowych wykresów.
6. Przeprowadzenie analiz reguł asocjacyjnych oraz klastrowania hierarchicznego
- Stwórz binarną macierz wizyt-recept-zioła z zablokowanej wersji znormalizowanej tabeli recept. Przypisz jeden wiersz do każdej kwalifikującej się wizyty i jedną kolumnę do każdej znormalizowanej etykiety zioła.
- Oblicz wsparcie (support), ufność (confidence) oraz lift dla skierowanych reguł asocjacyjnych pojedynczych ziół19. Zachowaj kierunek każdej reguły, ponieważ ufność zależy od poprzednika.
- Zastosuj zdefiniowane wcześniej progi: wsparcie ≥ 0.30, ufność ≥ 0.70 i lift > 1.0. Eksportuj każdą zatrzymaną regułę wraz z liczbą współwystępowania oraz wszystkimi trzema metrykami.
- Przedstaw kompletny zestaw zatrzymanych reguł w formie skierowanej dwudzielnej sieci reguł oraz uporządkowanego profilu siły reguł. Zakoduj szerokość krawędzi sieci za pomocą wsparcia, a kolor krawędzi za pomocą liftu.
- Zakoduj rozmiar punktu za pomocą wsparcia i opisz ufność w uporządkowanym profilu.
- Zweryfikuj, czy oba sposoby prezentacji reguł zawierają ten sam zestaw zatrzymanych reguł i zachowują kierunek reguły. Przed publikacją wyjaśnij każdą niezgodność w odniesieniu do wyeksportowanej tabeli reguł.
- Wybierz 20 zmiennych obecności ziół o najwyższej częstotliwości do klasteryzacji hierarchicznej. Oblicz parami odległości Jaccarda i zastosuj metodę średniego wiązania (average linkage).
- Oznacz dendrogram znormalizowanymi nazwami ziół. Interpretuj bliskość gałęzi wyłącznie jako podobieństwo w wzorcach występowania na poziomie wizyty.
- Przed generowaniem rycin wyeksportuj specyfikację macierzy binarnej, tabelę reguł, listę krawędzi sieci, kolejność danych wejściowych do klasteryzacji, macierz odległości oraz macierz wiązań.
- Poproś recenzenta ilościowego o ręczne odtworzenie jednej metryki reguły. Porównaj każdą krawędź sieci z tabelą reguł.
- Uruchom ponownie cały proces generowania reguł i klasteryzacji za każdym razem, gdy zmieni się kohorta, słownik terminologii lub macierz obecności ziół.
- W przypadku przykładu praktycznego przeprowadź deterministyczną analizę wrażliwości „jedna wizyta na pacjenta”, zachowując najwcześniejszy rekord zgodnie z kolejnością źródłową dla każdego pacjenta. Porównaj wynikowe 12 reguł z 15 regułami z analizy na poziomie wizyt.
- Zgłoś zmianę jako opisowy wynik odporności (robustness), a nie jako walidację na poziomie pacjenta. Skorzystaj z deterministycznego przeliczenia dostarczonego w Supplementary File 1.
7. Generowanie wzorców stratyfikowanych według diagnozy i ram interpretacji klinicznej
- Wybierz klinicznie istotne główne warstwy zachodniich diagnoz przed analizą rozkładu ziół specyficznych dla danej diagnozy.
- Zlicz każdą znormalizowaną etykietę zioła nie więcej niż raz na wizytę w obrębie każdej warstwy diagnozy. Oblicz rozpowszechnienie jako liczbę wizyt zawierających daną etykietę podzieloną przez całkowitą liczbę kwalifikujących się wizyt w tej warstwie.
- Użyj tego samego zestawu wyświetlanych ziół oraz stałej skali kolorystycznej 0%–100% dla wszystkich warstw diagnoz. Wyświetl wartości komórek, aby zachować dokładną interpretację.
- Przedstaw licznik i mianownik dla każdej wyświetlanej komórki w niezależnej tabeli zagregowanej.
- Stwórz oddzielny panel interpretacji klinicznej po ukończeniu opisowej mapy ciepła. Zachowaj wyraźny wizualny podział między obliczonymi wynikami a interpretacją ekspercką.
- Wypełnij warstwę wskazówek wyłącznie terminami, które można prześledzić w zablokowanej wersyjnie tabeli słów kluczowych historii lub w jawnych znormalizowanych opisach zespołów objawów.
- Poproś dwóch recenzentów klinicznych o uzgodnienie zwięzłych interpretacji kontekstowych dla wybranych wskazówek. Odnotuj recenzentów oraz ostateczne sformułowania w rejestrze dowodów.
- Powiąż każdą interpretację kontekstową z zastosowaniem badawczym, takim jak wybór zmiennych, walidacja prospektywna lub generowanie hipotez.
- W warstwie interpretacyjnej zastosuj przerywane łączniki niedyrekcjonalne. Pomiń treści dotyczące dawkowania, składu stałego oraz zaleceń terapeutycznych.
- Przejrzyj wspólnie mapę ciepła i panel interpretacyjny. Upewnij się, że obliczone rozpowszechnienie, kontekst ekspercki i przyszłe zastosowania badawcze pozostają wyraźnie odseparowane.
8. Przygotowanie i weryfikacja pakietu reprodukowalności
- Wyeksportuj manifest źródłowy, manifest kohorty, wersje słownika, rejestr dowodów, skrypty analizy, tabele zbiorcze, źródła ryciny oraz końcowe ryciny do osobnych katalogów.
- Nazwij każdy plik, używając stałego numeru ryciny lub tabeli oraz daty wersji. Zachowaj jedną aktualną wersję autorytatywną, a zastąpione wyniki zarchiwizuj osobno.
- Wygeneruj każdą rycinę jako jeden wielopanelowy plik obrazu. Wyeksportuj plik PDF w wysokiej rozdzielczości oraz plik PNG o rozdzielczości 300 dpi do wglądu.
- Umieść legendy ryciny w manuskrypcie i pozostaw je poza plikami obrazów. Opisz każdy panel, jednostkę analizy, mianownik oraz kodowanie wizualne.
- Przygotuj jeden niezależny plik XLSX dla każdej tabeli.
- Poproś niezależnego recenzenta o porównanie liczb w manuskrypcie z tabelami zbiorczymi oraz procentów z ich licznikami i mianownikami.
- Porównaj krawędzie reguł z tabelą reguł, a komórki mapy ciepła z macierzą źródłową.
- Uruchom automatyczne kontrole spójności nazw plików, wymaganych sekcji, wymiarów ryciny, liczby tabel, liczby referencji, pozostałości szablonu oraz zakazanych sformułowań.
- Poproś kliniczny zespół autorski o zweryfikowanie terminologii, interpretacji, granic własności intelektualnej, danych autorów, kolejności finansowania, sformułowań dotyczących etyki oraz końcowego zestawu rycin.
- Usuń z pakietu zgłoszeniowego pliki na poziomie pacjenta, klucze powiązań, nieograniczony wolny tekst, korespondencję wewnętrzną oraz tymczasowe artefakty z recenzji.
- Zablokuj wydany pakiet i zapisz jego wersję, datę, sumę kontrolną, wersję manuskryptu oraz status zatwierdzenia przez autorów. Utwórz nową wersję i dziennik zmian dla każdej kolejnej korekty.
Wyniki
Pomyślne zastosowanie protokołu pozwoliło na stworzenie możliwego do prześledzenia łańcucha łączącego zanonimizowany obraz źródłowy, manifest kohorty, słowniki terminologiczne, tabele zagregowane, skrypty oraz końcowe wykresy. Zablokowana wersja procedury przesiewowej zidentyfikowała 555 kwalifikujących się wizyt związanych z wypisaniem recept u 396 unikalnych pacjentów. Rycina 1 podsumowuje trzy skoordynowane etapy metody: nadzór, normalizację terminologiczną oraz analizę z przeglądem klinicznym. Odpowiednia dokumentacja przejrzystości i audytu, w tym granica danych zagregowanych dla przeglądu wspomaganego przez AI, została przedstawiona w Tabeli uzupełniającej 1.
Końcowa kohorta obejmowała 555 kwalifikujących się wizyt związanych z receptami, pochodzących od 396 unikalnych pacjentów (Rysunek 2 i Tabela 1). Rzeczywiste wizyty powtórne zachowano dla dynamicznych zmiennych klinicznych i recepturowych, natomiast wiek i płeć podsumowano po deduplikacji na poziomie pacjenta. Wiek pacjentów wahał się od 13 do 94 lat, przy średniej 47,11 lat i odchyleniu standardowym 14,88 lat. Kohorta obejmowała 228 pacjentek (57,58%), 167 pacjentów (42,17%) oraz 1 pacjenta o nieznanej płci (0,25%). Takie rozdzielenie jednostek analizy pozwoliło na zachowanie przebiegu wizyt podłużnych bez zawyżania mianownika demograficznego.
Spektra chorób w medycynie zachodniej i TCM podsumowano na Rysunku 3. Diagnozy zachodnie koncentrowały się na schorzeniach układu pokarmowego, dróg żółciowych i wątroby oraz trzustki. Grupowanie hierarchiczne przypisało 271 wizyt do schorzeń układu pokarmowego, 222 do schorzeń dróg żółciowych i wątroby lub trzustki oraz 62 do innych układów (Rysunek 3A). Dominującymi pojedynczymi diagnozami były przewlekłe zapalenie żołądka w 133 wizytach (23,96%), stłuszczenie wątroby w 77 wizytach (13,87%) oraz marskość wątroby w 46 wizytach (8,29%), a następnie przewlekłe zanikowe zapalenie żołądka, ból brzucha, przewlekłe zapalenie wątroby typu B, dyspepsja, refluksowe zapalenie przełyku, przewlekłe powierzchowne zapalenie żołądka oraz przewlekłe zapalenie trzustki (Rysunek 3C i Tabela 2).
Odpowiadające im spektrum nazw jednostek chorobowych w TCM zorganizowało te same wizyty zgodnie z równoległym systemem diagnostycznym. Nazwy chorób śledziony, żołądka lub jelit stanowiły 280 wizyt, chorób wątroby i pęcherzyka żółciowego 223, zaburzeń qi, krwi i płynów 26, zaburzeń ducha, klatki piersiowej i głowy 12, zaburzeń kanałów lub kończyn 5, zaburzeń ginekologicznych 4, a pozostałe kategorie 5 wizyt (Rycina 3B). Wei pi, zachowana etykieta choroby w TCM oznaczająca pełność lub dyskomfort w nadbrzuszu, została odnotowana w 163 wizytach (29,37%). Ji disease (etykieta TCM typu akumulacji), Gan zhuo (dosłownie: utrwalenie wątroby; zachowana klasyczna etykieta choroby w TCM), Bi disease (choroba zatorowa) oraz Xiao ke (pragnienie marniejące) zostały zachowane jako źródłowe etykiety TCM i nie zostały przekształcone w nowoczesne diagnozy biomedyczne. Gan pi, etykieta choroby w TCM stosowana we współczesnym chińskim konsensusie dotyczącym stłuszczenia wątroby, została odnotowana w 77 wizytach (13,87%)35. Źródłowe pola zachodnie i TCM pozostały niezależne i nie były stosowane zamiennie (Rycina 3D oraz Tabela 3). Xie xie (stolce luźne lub wodniste) oraz Fu xie (biegunka) były oddzielnymi oryginalnymi etykietami chorób w TCM, odnotowanymi odpowiednio 6 i 2 razy, i żadna z nich nie została utożsamiona z nowoczesną diagnozą biomedyczną. Przedstawienie obu spektrów obok siebie pozwoliło zachować logikę każdego z systemów diagnostycznych, wykazując jednocześnie kliniczny zakres zapisów źródłowych.
Jawne znormalizowane pole tekstu zespołu objawów zawierało 555 kwalifikujących się wierszy z wizyt. Po usunięciu duplikatów w obrębie wizyt, dominującymi elementami były: śledziona w 362 wizytach (65,23%), wątroba w 304 (54,77%), niedobór qi w 295 (53,15%), żołądek w 171 (30,81%), wilgoć w 151 (27,21%) oraz stagnacja qi w 109 (19,64%; Rysunek 4A i Tabela 4). Pozostałą część przedstawionego spektrum stanowiły: gorąco, retencja wody, krew, zastój krwi, kanały, nerki, serce oraz niedobór yin. Procenty nie były wzajemnie wykluczające się, ponieważ podczas jednej wizyty mogło wystąpić wiele elementów zespołu objawów.
Sieć oraz macierz liczbową wygenerowano z tych samych zestawów tokenów na poziomie wizyty (Rysunek 4B,C). Częste współwystępowanie koncentrowało się wokół śledziony, wątroby i niedoboru qi, z dodatkowymi powiązaniami z żołądkiem, wilgocią, stagnacją qi, gorącem i retencją wody. Zastosowanie jednej macierzy z zablokowaną wersją dla wykresu częstotliwości, sieci i mapy ciepła zapewniło, że wszystkie trzy panele reprezentowały te same dowody podstawowe na różnych poziomach szczegółowości. Przeprowadzony audyt odzyskanych danych wykazał 0 dokładnych dopasowań tekstu zespołu objawów/wskaźnika wśród 555 wierszy oraz średnią podobieństwo Jaccarda tekstu-wskaźnika na poziomie 0,1806. W związku z tym kolumny wskaźników zostały wyłączone z merytorycznego raportowania. Zachowane materiały nie zawierały rekonstruowalnych wektorów rozkładu sprzed oczyszczania; w konsekwencji nie oszacowano stabilności rozkładu pomiędzy wersjami. Analiza wrażliwości dla jednej wizyty na pacjenta odnosiła się natomiast do wpływu powtarzających się wizyt. Wyniki audytu źródeł i jakości danych podsumowano w Tabeli uzupełniającej 2.
Po normalizacji terminologii i zachowaniu klinicznie istotnych form przetwarzania, 555 wizyt obejmowało 324 odrębne zunifikowane etykiety ziół oraz 9339 przypadków stosowania ziół. Bai Shao odnotowano w 531 wizytach (95,68%), następnie Fu Ling w 520 (93,69%), Dang Gui w 510 (91,89%), Chi Shao w 467 (84,14%) oraz prażony Bai Zhu w 361 (65,05%). Rysunek 5A i Tabela 5). Krzywa rangi i częstotliwości 36 głównych etykiet wykazała stromy segment o wysokiej częstotliwości, po którym następował stopniowo rozszerzający się ogon (Rysunek 5B), co stanowiło zwarte przedstawienie komponentów wspólnego tła i indywidualnych zaleceń. Mapowania źródeł na formy znormalizowane, kwalifikatory przetwarzania, standardowe nazwy CMM, gatunki źródłowe oraz granice dowodowe leżące u podstaw nomenklatury ziół zostały udokumentowane w Tabela uzupełniająca 3.
Pomocniczy słownik materia medica zawierał 9 115 wystąpień zastosowań ziół z kodowaniem właściwości. Dominującymi kategoriami Czterech Energii (Four-Qi) były: ciepła (2 588, 28,39%), lekko zimna (2 339, 25,66%), neutralna (2 330, 25,56%) oraz zimna (1 221, 13,40%; Rysunek 5C). Po normalizacji terminologii smaku źródeł związków, głównymi kategoriami pięciu smaków były: gorzki (4 488, 49,24%), słodki (4 377, 48,02%) oraz ostry (2 893, 31,74%) (Rysunek 5D). W kodowaniu tropizmu południkowego dominowały: śledziona (5 541, 60,79%), wątroba (4 801, 52,67%), płuca (3 358, 36,84%), żołądek (2 988, 32,78%) oraz serce (2 702, 29,64%; Rysunek 5E). Rysunek 5F przedstawia odrębne jednostki analizy na poziomie wizyty oraz jednostki z kodowaniem właściwości wraz z powiązaniami ich powtarzalności. Wspólnie panele te demonstrują, w jaki sposób częstotliwość przepisywania oraz zstandaryzowane deskryptory materia medica mogą zostać podsumowane bez utraty terminologii specyficznej dla procesu przetwarzania.
Wstępnie określony słownik historii zawierał 37 dokładnych pojęć dotyczących objawów. Przynajmniej jedno pojęcie wykryto w 474 z 555 kwalifikujących się wizyt (85,41%). Dominującymi terminami były: suchość w gardle w 178 wizytach (32,07%), zmęczenie w 151 (27,21%), problemy ze snem w 139 (25,05%), wzdęcia brzucha w 115 (20,72%), refluks żołądkowo-przełykowy w 100 (18,02%), gorzki smak w 99 (17,84%), zgaga w 90 (16,22%), czkawka w 87 (15,68%), odbijanie w 87 (15,68%) oraz luźne stolce w 77 (13,87%; Rysunek 6A,B oraz Tabela 6).
Pełna krzywa rangi i częstotliwości przedstawiała cały rozkład 37 terminów, natomiast linia skumulowana podsumowywała koncentrację wszystkich wykrytych słów kluczowych w poszczególnych rangach (Ryc. 6C). Ryc. 6D przedstawia powtarzalną sekwencję użytą do wygenerowania spektrum: zablokowanie słownika, skanowanie zanonimizowanego tekstu historii, usuwanie powtarzających się pojęć w obrębie każdej wizyty oraz eksport zagregowanych liczb i wskaźników.
W procesie wydobywania reguł asocjacyjnych wykorzystano zablokowaną wersyjnie macierz obecności ziół w wizytach z przepisaniem leków, składającą się z 555 wierszy. Piętnaście skierowanych reguł dla pojedynczych ziół spełniło kryteria: wsparcie (support) ≥ 0,30, ufność (confidence) ≥ 0,70 oraz lift > 1,0 (Rysunek 7A,B oraz Tabela 7). Zachowane wartości wsparcia mieściły się w zakresie od 0,3009 do 0,7892, wartości ufności od 0,7302 do 0,9748, a wartości lift od 1,0010 do 1,1226.
Najczęściej współwystępującą skierowaną parą była Chi Shao > Fu Ling, na podstawie 438 wizyt, przy wsparciu (support) 0,7892, ufności (confidence) 0,9379 i lift 1,0010. Reguła odwrotna miała takie samo wsparcie i ufność na poziomie 0,8423, co pokazuje, dlaczego należy zachować kierunek reguły. Analiza wrażliwości progów pozwoliła zachować odpowiednio 18, 11, 21, 14, 7 i 4 reguły przy wsparciu ≥ 0,25 lub ≥ 0,35, ufności ≥ 0,65 lub ≥ 0,75 lub lift > 1,02 lub > 1,05. W analizie uwzględniającej jedną wizytę na pacjenta ta sama para wystąpiła w 316 wizytach, przy wsparciu 0,7980, ufności 0,9489 i lift 0,9994; w związku z tym nie została ona zachowana przy kryterium lift > 1,0. Wyniki perturbacji progów i wrażliwości na powtórne wizyty znajdują się w Tabeli uzupełniającej 4, a deterministyczne przeliczenia w Pliku uzupełniającym 1. W związku z tym wysokiego wsparcia na poziomie wizyt nie należy interpretować jako walidacji na poziomie pacjenta.
Najwyższe wartości liftu zaobserwowano dla Gan Cao > stir-fried Bai Zhu (1,1226) oraz Gan Cao > Chi Shao (1,1200). Rysunek 7A integruje wszystkie 15 zachowanych reguł w skierowanej sieci dwudzielnej, gdzie szerokość krawędzi koduje wsparcie (support), a kolor krawędzi koduje lift. Rysunek 7B szereguje te same reguły według liftu, skaluje każdy punkt zgodnie ze wsparciem oraz nanosi adnotacje dotyczące ufności (confidence). Tym samym oba panele odróżniają topologię sieci od ilościowej siły reguł, zamiast powielać tę samą reprezentację wizualną.
Grupowanie hierarchiczne 20 najczęściej występujących zmiennych dotyczących ziół zostało wykonane z wykorzystaniem odległości Jaccarada i metody wiązania średniego (Rycina 7C). Dendrogram zapewnia globalną reprezentację podobieństwa wzorców obecności na poziomie wizyt, co uzupełnia lokalne informacje kierunkowe dostarczone przez reguły asocjacyjne. Razem panele te demonstrują, w jaki sposób komplementarne ujęcia analityczne mogą zostać dopasowane do jednej, zablokowanej wersji macierzy binarnej.
Obliczono rozpowszechnienie w podziale na diagnozę dla stłuszczenia wątroby (77 wizyt), marskości wątroby (46 wizyt) oraz przewlekłego zapalenia żołądka (133 wizyty; Rycina 8A i Tabela 8). Bai Shao, Fu Ling oraz Dang Gui wykazały wysokie rozpowszechnienie we wszystkich trzech warstwach. W wizytach dotyczących marskości wątroby odnotowano znaczną obecność Dan Shen (95,65%), E Zhu przetwarzanego octem (86,96%), Bie Jia przetwarzanego octem (84,78%) oraz Sheng Huang Qi (60,87%). Wizyty związane ze stłuszczeniem wątroby wykazały wyższe rozpowszechnienie Yin Chen (41,56%) i Ze Xie (31,17%) niż w pozostałych warstwach, natomiast w wizytach dotyczących przewlekłego zapalenia żołądka często pojawiały się Huang Lian (44,36%), Mu Xiang (34,59%) i Chai Hu (36,09%). Mapa ciepła dostarcza zatem zwięzłego porównania opisowego zagregowanych wzorców przepisywania leków w głównych kontekstach klinicznych.
Rysunek 8B oddziela obliczenia od interpretacji. Zweryfikowane wskazówki historyczne są powiązane z zwięzłymi kontekstami eksperckimi, a następnie z zastosowaniami badawczymi, obejmującymi kontekstualizację elementów zespołu, porównywanie wzorców stratyfikowanych według diagnozy, wybór zmiennych do prospektywnej walidacji oraz generowanie pytań uzupełniających. Ten ostatni panel pokazuje, w jaki sposób wiedza kliniczna może wzbogacić wyniki analityczne, pozostając jednocześnie wyraźnie oddzieloną od obliczonej częstości występowania.
Rysunek 8C podsumowuje powtarzalność i granicę wydzielenia, odróżniając komponenty zweryfikowane u źródła lub przeanalizowane ponownie od elementów wymagających ostrożności lub dalszego potwierdzenia. Ta końcowa warstwa audytu zapobiega prezentowaniu nierozwiązanych lub niemożliwych do odtworzenia produktów analitycznych jako zwalidowanych wyników.
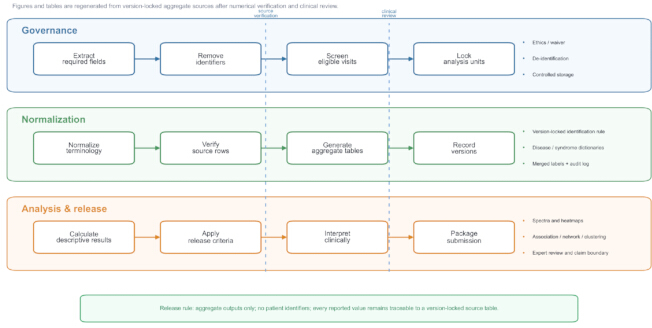
Rysunek 1: Przepływ pracy w procesie wydobywania danych z rekordów przypadków poddanych audytowi źródłowemu. Zarządzanie, normalizacja terminologii, analiza zagregowana, przegląd kliniczny oraz pakietowanie wydania zostały przedstawione jako następujące po sobie etapy przepływu pracy. Niebieskie, zielone i pomarańczowe pasy odróżniają domeny przepływu pracy, a przerywane linie pionowe wskazują bramki audytowe. Strzałki wskazują sekwencję przepływu pracy i nie implikują przyczynowości biologicznej. Reguła wydania określa, że udostępniane są wyłącznie wyniki zagregowane, identyfikatory pacjentów są wykluczone, a każda raportowana wartość pozostaje możliwa do prześledzenia do tabeli źródłowej z zablokowaną wersją. Słupki błędów nie mają zastosowania. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.
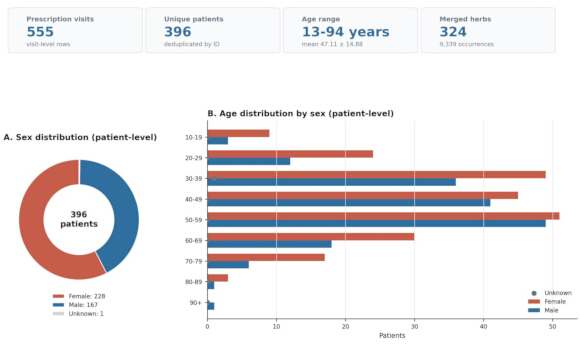
Rysunek 2: Profil zbioru danych i dane demograficzne pacjentów. Pola podsumowania zawierają informacje o 555 wizytach związanych z wypisaniem recept, 396 unikalnych pacjentach, zakresie wieku pacjentów od 13 do 94 lat ze średnim wiekiem 47,11 ± 14,88 lat oraz 324 złączonych etykietach ziół reprezentujących 9 339 przypadków stosowania ziół. (A) Rozkład płci wśród 396 unikalnych pacjentów, obejmujący kategorie: kobieta, mężczyzna i nieznana. (B) Rozkład wieku pacjentów według płci wśród tych samych 396 pacjentów. Pola podsumowania wykorzystują wyświetlane mianowniki na poziomie wizyt lub pacjentów, w zależności od kontekstu. Kolory rozróżniają kategorie płci oraz elementy podsumowania i nie mają znaczenia wnioskującego. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
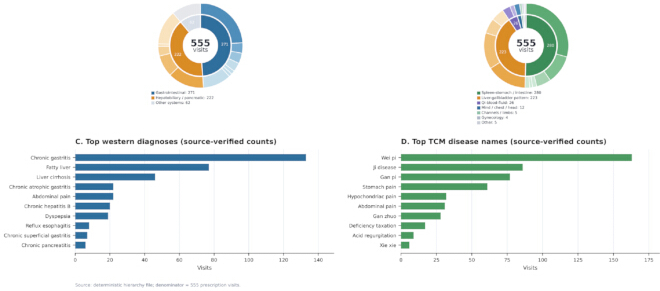
Rycina 3: Spektra chorób odzyskane z wizyt recepturowych. (A) Hierarchiczne grupy chorób zachodnich i (B) hierarchiczne grupy chorób TCM wywodzące się z 555 kwalifikujących się wizyt recepturowych. (C) Główne znormalizowane diagnozy zachodnie i (D) główne znormalizowane nazwy chorób TCM z tego samego mianownika na poziomie wizyt. Segmenty pierścieni i słupki reprezentują liczbę wizyt; kolory rozróżniają systemy diagnostyczne lub kategorie i nie reprezentują efektów leczenia. Zachowane etykiety źródłowe TCM zdefiniowano w Tabeli 3: Wei pi (pełność lub dyskomfort w nadbrzuszu), Ji disease (etykieta źródłowa TCM typu akumulacyjnego), Gan pi (etykieta choroby TCM stosowana w zaburzeniach stłuszczenia wątroby), Gan zhuo (dosłownie: utrwalenie wątroby; zachowana klasyczna etykieta choroby TCM), Bi disease (choroba z przeszkody/zatorowa), Xiao ke (wycieńczające pragnienie), Xie xie (luźne lub wodniste stolce) oraz Fu xie (biegunka). Te objaśnienia nie zamieniają etykiet źródłowych w nowoczesne diagnozy biomedyczne. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
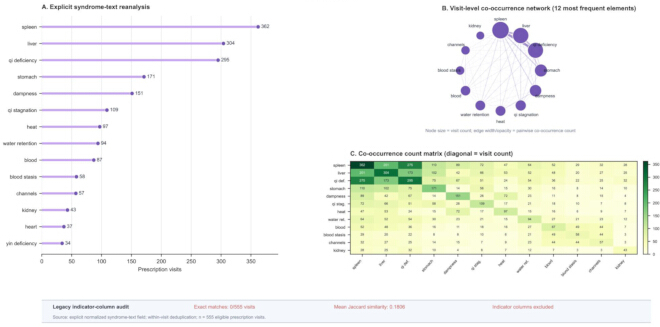
Rysunek 4: Jawne widmo tekstu zespołu oraz struktura współwystępowania. (A) Częstości na poziomie wizyt dla 14 znormalizowanych elementów zespołu po usunięciu duplikatów w obrębie wizyty, przyjmując 555 kwalifikujących się wizyt z przepisanymi lekami jako mianownik. (B) Sieć współwystępowania 12 najczęstszych elementów zespołu; rozmiar węzła reprezentuje częstotliwość wizyt, a szerokość i przezroczystość krawędzi reprezentują liczbę parzystych współwystąpień. (C) Odpowiadająca im symetryczna macierz liczby współwystąpień; komórki na przekątnej reprezentują częstotliwość wizyt indywidualnych, a komórki poza przekątną reprezentują liczbę parzystych współwystąpień. Pasek audytu wykazuje 0 dokładnych dopasowań tekstu zespołu/wskaźnika w 500 wierszach oraz średnią podobieństwo Jaccarda między tekstem a wskaźnikiem na poziomie 0,1806; w związku z tym kolumny wskaźników dziedzicznych zostały wykluczone z merytorycznego raportowania. W macierzy „Qi def.” oznacza niedobór qi, „Qi stag.” oznacza stagnację qi, a „Water ret.” oznacza retencję wody. Paleta kolorów ma charakter opisowy. Nie zastosowano słupków błędów. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
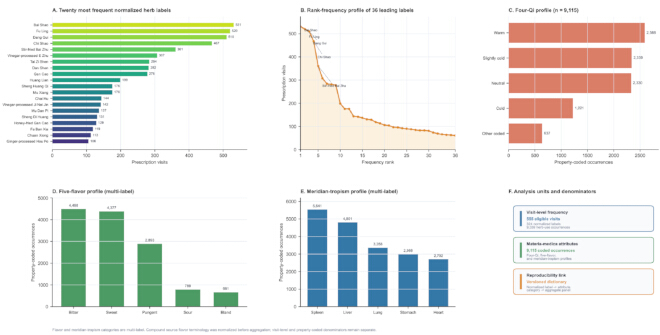
Rysunek 5: Często występujące zioła oraz znormalizowane profile atrybutów materia medica. (A) Dwadzieścia najczęstszych znormalizowanych etykiet ziół spośród 555 kwalifikujących się wizyt związanych z przepisywaniem leków. (B) Profil częstotliwości rangowej 36 wiodących znormalizowanych etykiet ziół. (C) Rozkład Four-Qi oparty na 9 115 przypadkach użycia ziół z zakodowanymi właściwościami; Four-Qi jest wartością pojedynczą dla każdego zakodowanego przypadku. (D) Rozkład Five-flavor i (E) rozkład tropizmu południkowego (meridian-tropism) oparte na tym samym mianowniku zakodowanych właściwości; oba są atrybutami wieloetykietowymi, zatem liczby w kategoriach nie są wzajemnie wykluczające się. (F) Jednostki analizy na poziomie wizyty oraz jednostki z zakodowanymi właściwościami wraz z łącznikiem ich odtwarzalności. Długości słupków reprezentują liczebność, a kolory rozróżniają panele. Słupki błędów nie mają zastosowania. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
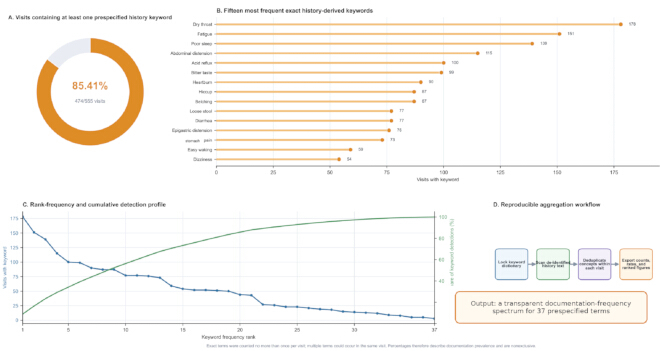
Rysunek 6: Spektrum słów kluczowych dotyczących objawów pochodzących z wywiadu oraz powtarzalny schemat agregacji. (A) Odsetek 555 kwalifikujących się wizyt recepturowych zawierających co najmniej jedno określone słowo kluczowe z wywiadu; 474 wizyty (85,41%) zawierały co najmniej jedno słowo kluczowe. (B) Piętnaście najczęstszych dokładnych pojęć objawów pochodzących z wywiadu. (C) Pełny rozkład częstotliwości rankingowej dla 37 terminów oraz skumulowany udział wykrytych słów kluczowych. (D) Zablokowany wersyjnie schemat postępowania od określonego słownika do wyników zagregowanych. Każde pojęcie było liczone nie więcej niż raz w ramach jednej wizyty, podczas gdy w tej samej wizycie mogło wystąpić wiele pojęć. Pomarańczowe słupki reprezentują liczbę słów kluczowych, a kolory schematu rozróżniają etapy przetwarzania. Słupki błędu nie mają zastosowania. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
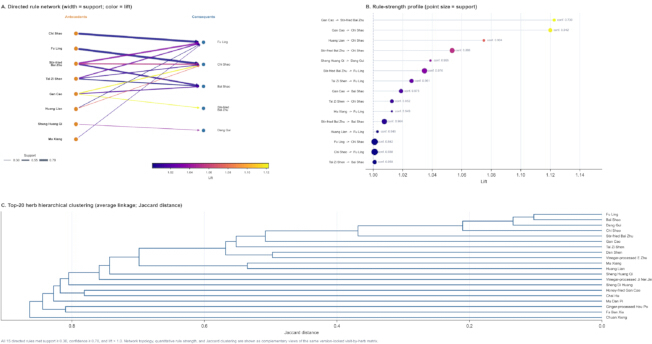
Rysunek 7: Skierowane reguły asocjacyjne ziół i klasteryzacja hierarchiczna. (A) Skierowana sieć dwudzielna wszystkich 15 reguł asocjacyjnych dla pojedynczych ziół spełniających zastalone progi: support ≥ 0.30, confidence ≥ 0.70 i lift > 1.0. Szerokość krawędzi reprezentuje support, a kolor krawędzi reprezentuje lift. (B) Profil siły reguł dla tych samych 15 reguł uszeregowanych według wartości lift; rozmiar punktu reprezentuje support, a sąsiednie etykiety podają confidence (conf.). (C) Klasteryzacja hierarchiczna z metodą średniego wiązania dla 20 zmiennych obecności ziół o najwyższej częstotliwości z wykorzystaniem odległości Jaccarda. Wszystkie panele wykorzystują wizyty po receptę jako jednostkę analizy i opisują wzorce współwystępowania zapisów, a nie skuteczność, synergię lub zalecaną kombinację stałą. Słupki błędów nie mają zastosowania. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
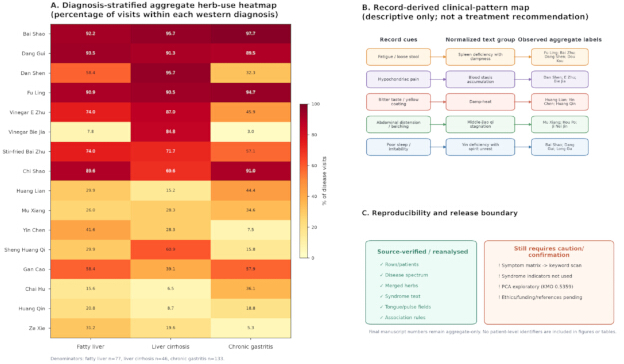
Rycina 8: Zagregowane wzorce stosowania ziół z rozwarstwieniem według diagnozy, mapa wzorców klinicznych oraz granica publikacji. (A) Mapa ciepła z rozwarstwieniem według diagnozy, przedstawiająca rozpowszechnienie 16 znormalizowanych etykiet ziół na poziomie wizyt w przypadku stłuszczenia wątroby (n = 77), marskości wątroby (n = 46) oraz przewlekłego zapalenia żołądka (n = 133). Każda komórka reprezentuje procent kwalifikujących się wizyt w ramach odpowiadającej warstwy diagnozy zachodniej, przy użyciu stałej skali kolorów 0%–100%. (B) Wyprowadzona z zapisów mapa wzorców klinicznych łącząca zweryfikowane wskazówki z zapisów z znormalizowanymi grupami tekstowymi i zaobserwowanymi zagregowanymi etykietami ziół. Przerywane, niedyrekcyjne połączenia odróżniają tę opisową warstwę interpretacyjną od obliczonego rozpowszechnienia; panel ten nie stanowi rekomendacji terapeutycznej. (C) Powtarzalność i granica publikacji odróżniająca komponenty zweryfikowane w źródłach lub poddane reanalizie od elementów wymagających ostrożności lub potwierdzenia. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Metryka | Wartość | Jednostka/mianownik | Status |
| Wizyty recepturowe | 555 | 555 wizyt z receptą | zweryfikowano na podstawie odzyskanego pliku XLSX |
| Unikalni pacjenci | 396 | 396 unikalnych pacjentów | zweryfikowano na podstawie odzyskanego pliku XLSX |
| Zakres wieku na poziomie pacjenta | 13-94 | lata | zweryfikowano |
| Średnia wieku na poziomie pacjenta +/- SD | 47.11 +/- 14.88 | lata | zweryfikowano |
| Średnia wieku +/- SD na poziomie wizyty | 48.22 +/- 15.82 | lata | zweryfikowano |
| Płeć na poziomie pacjenta | Kobiety: 228; mężczyźni: 167; nieznana płeć: 1 | 396 pacjentów | zweryfikowano |
| Płeć na poziomie wizyty | Kobiety: 327; mężczyźni: 227; nieznana płeć: 1 | 555 odwiedzin | zweryfikowano |
| Złączone zioła | 324 | wyróżniające się scalone nazwy | zweryfikowano |
| Połączone przypadki stosowania ziół | 9339 | 555 wizyt związanych z wypisywaniem recept | zweryfikowano |
Tabela 1: Profil zbioru danych. Demograficzne charakterystyki na poziomie pacjenta oraz zmienne na poziomie wizyty po receptę przedstawiono z zastosowaniem odpowiednich mianowników. Podano również znormalizowane sumy ziół.
| Nazwa choroby | Liczba | Procent wizyt |
| Przewlekłe zapalenie żołądka | 133 | 24 |
| Stłuszczenie wątroby | 77 | 13.9 |
| Marskość wątróby | 46 | 8.3 |
| Przewlekłe zapalne zapalenie zanikowe żołądka | 22 | 4 |
| Ból brzucha | 22 | 4 |
| Przewlekłe zapalenie wątroby typu B | 20 | 3.6 |
| Dyspepsja | 19 | 3.4 |
| Refluksowe zapalenie przełyku | 8 | 1.4 |
| Przewlekłe powierzchowne zapalenie żołądka | 7 | 1.3 |
| Przewlekłe zapalenie trzustki | 6 | 1.1 |
| Wrzodziejące zapalenie jelita grubego | 6 | 1.1 |
| Polip pęcherzyka żółciowego | 6 | 1.1 |
| Zespół pocholecystektomiczny | 6 | 1.1 |
| Dysfunkcja jelit | 6 | 1.1 |
| Kamienie żółciowe | 6 | 1.1 |
| Przewlekłe zapalenie wątroby | 5 | 0.9 |
| Zmęczenie | 5 | 0.9 |
| Dysfunkcja przewodu pokarmowego (niepewna oryginalna etykieta) | 5 | 0.9 |
| Przewlekłe zapalenie żołądka (niepewny opis pierwotny) | 5 | 0.9 |
| Autoimmunologiczna marskość wątroby | 4 | 0.7 |
Tabela 2: Główne znormalizowane diagnozy zachodnie. Liczby i procenty głównych znormalizowanych diagnoz zachodnich odnotowane podczas 555 kwalifikujących się wizyt związanych z receptami. Procenty obliczono, przyjmując liczbę kwalifikujących się wizyt związanych z receptami jako mianownik.
| Nazwa jednostki chorobowej według TCM | Liczba | Procent wizyt |
| Wei pi (pełność lub dyskomfort w nadbrzuszu) | 163 | 29.4 |
| Ji disease (etykieta TCM dla jednostek typu kumulacyjnego) | 86 | 15.5 |
| Gan pi (etykieta TCM stosowana w zaburzeniach stłuszczenia wątroby) | 77 | 13.9 |
| Ból żołądka | 61 | 11 |
| Ból w podżebrzu | 32 | 5.8 |
| Ból brzucha | 31 | 5.6 |
| Gan zhuo (dosłownie: utrwalenie wątroby; zachowana klasyczna etykieta chorobowa TCM) | 28 | 5 |
| Wycieńczenie z niedoboru | 17 | 3.1 |
| Refluks treści kwaśnej | 9 | 1.6 |
| Xie xie (stolce luźne lub wodniste) | 6 | 1.1 |
| Bezsenność | 4 | 0.7 |
| Czerwonka | 4 | 0.7 |
| Ból głowy | 4 | 0.7 |
| Bi disease (zespół zablokowania/utrudnienia) | 4 | 0.7 |
| Zaburzenia miesiączkowania | 3 | 0.5 |
| Uciski w klatce piersiowej | 3 | 0.5 |
| Zaburzenia pocenia | 3 | 0.5 |
| Zaparcia | 3 | 0.5 |
| Fu xie (biegunka) | 2 | 0.4 |
| Xiao ke (pragnienie wyniszczające) | 2 | 0.4 |
Tabela 3: Główne znormalizowane nazwy chorób w TCM. Liczba i odsetki głównych znormalizowanych nazw chorób w TCM odnotowane w 555 kwalifikujących się wizytach związanych z receptami. Odsetki obliczono, przyjmując liczbę kwalifikujących się wizyt związanych z receptami jako mianownik. Zachowane etykiety źródłowe i glosy wyjaśniające nie implikują równoważności z nowoczesnymi diagnozami biomedycznymi.
| Ranga | Element zespołu | Wizyty recepturowe | Kwalifikujące się wizyty | Procent odwiedzin |
| 1 | śledziona | 362 | 555 | 65.23% |
| 2 | wątroba | 304 | 555 | 54.77% |
| 3 | niedobór qi | 295 | 555 | 53.15% |
| 4 | żołądek | 171 | 555 | 30.81% |
| 5 | wilgoć | 151 | 555 | 27.21% |
| 6 | staza energii qi | 109 | 555 | 19.64% |
| 7 | ciepło | 97 | 555 | 17.48% |
| 8 | zatrzymywanie wody | 94 | 555 | 16.94% |
| 9 | Krew | 87 | 555 | 15.68% |
| 10 | staza krwi | 58 | 555 | 10.45% |
| 11 | kanały | 57 | 555 | 10.27% |
| 12 | nerka | 43 | 555 | 7.75% |
| 13 | serce | 37 | 555 | 6.67% |
| 14 | niedobór yin | 34 | 555 | 6.13% |
Tabela 4: Główne znormalizowane elementy zespołów objawów. Elementy zespołów objawów zostały wyekstrahowane z jawnego znormalizowanego tekstu opisującego zespoły i usunięto duplikaty w ramach każdej wizyty związanej z receptą. Liczby oparto na mianowniku wynoszącym 555 kwalifikujących się wizyt związanych z receptą; wartości procentowe nie są wzajemnie wykluczające się, ponieważ podczas jednej wizyty mogą wystąpić wiele elementów zespołu objawów.
| Zintegrowana etykieta ziół | Liczba | Procent wizyt |
| Bai Shao | 531 | 95.7 |
| Fu Ling | 520 | 93.7 |
| Dang Gui | 510 | 91.9 |
| Chi Shao | 467 | 84.1 |
| Smażony Bai Zhu | 361 | 65 |
| E Zhu przetwarzane octem | 307 | 55.3 |
| Tai Zi Shen | 284 | 51.2 |
| Dan Shen | 282 | 50.8 |
| Gan Cao | 278 | 50.1 |
| Huang Lian | 199 | 35.9 |
| Sheng Huang Qi | 176 | 31.7 |
| Mu Xiang | 176 | 31.7 |
| Chai Hu | 144 | 25.9 |
| Ji Nei Jin przetwarzane octem | 142 | 25.6 |
| Mu Dan Pi | 137 | 24.7 |
| Sheng Di Huang | 131 | 23.6 |
| Gan Cao smażone w miodzie | 129 | 23.2 |
| Fa Ban Xia | 119 | 21.4 |
| Chuan Xiong | 113 | 20.4 |
| Hou Po przetworzone imbirem | 106 | 19.1 |
| Yin Chen | 104 | 18.7 |
| Sheng Bai Zhu | 97 | 17.5 |
| Dou Kou | 96 | 17.3 |
| Sheng Long Gu | 92 | 16.6 |
| Zhe Bei Mu | 90 | 16.2 |
| Huang Qin | 88 | 15.9 |
| Dang Shen | 85 | 15.3 |
| Bie Jia przetwarzane octem | 83 | 15 |
| Gui Zhi | 83 | 15 |
| Sheng Mu Li | 81 | 14.6 |
| Jiao Zhi Zi | 74 | 13.3 |
| He Huan Hua | 69 | 12.4 |
| Huang Jing przetworzone winem | 66 | 11.9 |
| Chen Pi | 64 | 11.5 |
| Ze Xie | 63 | 11.4 |
| Jin Qian Cao | 61 | 11 |
Tabela 5: Główne znormalizowane etykiety ziół według częstotliwości występowania w wizytach recepturowych. Każda znormalizowana etykieta zioła została policzona maksymalnie raz na jedną wizytę recepturową. Liczby i wartości procentowe obliczono przyjmując za mianownik 555 kwalifikujących się wizyt recepturowych; klinicznie istotne formy przetworzenia zachowano jako oddzielne etykiety.
| Ranga | Słowo kluczowe pochodne z historii | Wizyty recepturowe | Kwalifikujące się wizyty | Procent odwiedzin |
| 1 | Suchość w gardle | 178 | 555 | 32.07% |
| 2 | Zmęczenie | 151 | 555 | 27.21% |
| 3 | Zaburzenia snu | 139 | 555 | 25.05% |
| 4 | Wzdęcie brzucha | 115 | 555 | 20.72% |
| 5 | Refluks kwasowy | 100 | 555 | 18.02% |
| 6 | Gorzki smak | 99 | 555 | 17.84% |
| 7 | Zgaga | 90 | 555 | 16.22% |
| 8 | Czkawka | 87 | 555 | 15.68% |
| 9 | Bekanie | 87 | 555 | 15.68% |
| 10 | Luźny stolec | 77 | 555 | 13.87% |
| 11 | Biegunka | 77 | 555 | 13.87% |
| 12 | Wzdęcie nadbrzusza | 76 | 555 | 13.69% |
| 13 | Ból brzucha | 73 | 555 | 13.15% |
| 14 | Łatwe wybudzanie | 59 | 555 | 10.63% |
| 15 | Zawroty głowy | 54 | 555 | 9.73% |
| 16 | Wymioty | 52 | 555 | 9.37% |
| 17 | Nudności | 52 | 555 | 9.37% |
| 18 | Tępy ból | 51 | 555 | 9.19% |
| 19 | Ból rozsadzający | 50 | 555 | 9.01% |
| 20 | Brak apetyku | 44 | 555 | 7.93% |
| 21 | Ból brzucha | 43 | 555 | 7.75% |
| 22 | Ucisk w klatce piersiowej | 27 | 555 | 4.86% |
| 23 | Drażliwość | 26 | 555 | 4.68% |
| 24 | Ból głowy | 23 | 555 | 4.14% |
| 25 | Borborygmus | 23 | 555 | 4.14% |
| 26 | Dyskomfort w nadbrzuszu | 21 | 555 | 3.78% |
| 27 | Kołatania serca | 19 | 555 | 3.42% |
| 28 | Żółty mocz | 18 | 555 | 3.24% |
| 29 | Uczucie ciała obcego | 15 | 555 | 2.70% |
| 30 | Ból kłujący | 14 | 555 | 2.52% |
| 31 | Zaparcia | 13 | 555 | 2.34% |
| 32 | Senność | 12 | 555 | 2.16% |
| 33 | Uczucie ciała obcego w gardle | 9 | 555 | 1.62% |
| 34 | Nadmierna potliwość | 8 | 555 | 1.44% |
| 35 | Ból w nadbrzuszu / Ból w podżebrzu | 5 | 555 | 0.90% |
| 36 | Tenesmus | 5 | 555 | 0.90% |
| 37 | Suche stolce | 3 | 555 | 0.54% |
Tabela 6: Główne słowa kluczowe objawów wywiedzionych z historii choroby. Dokładne pojęcia dotyczące objawów wykryte w zanonimizowanych tekstach historii choroby. Każde pojęcie było liczone nie więcej niż raz w ramach jednej wizyty związanej z receptą, podczas gdy w ramach tej samej wizyty mogło wystąpić wiele pojęć. Liczby i procenty obliczono przyjmując 555 kwalifikujących się wizyt związanych z receptą jako mianownik.
| Poprzednik | Następnik | Współwystępujące wizyty | Wsparcie | Ufność | Lift |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Smażony Bai Zhu | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Smażony Bai Zhu | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Smażony Bai Zhu | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Smażony Bai Zhu | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
Tabela 7: Skierowane reguły asocjacji ziół spełniające określone progi. Reguły zostały wygenerowane z 555 binarnych wierszy recepta-wizyta przy zastosowaniu parametrów: wsparcie ≥ 0,30, ufność ≥ 0,70 oraz lift > 1,0. W obliczeniach wsparcia mianownikiem jest 555 wizyt z wypisaniem recepty, a kierunek reguły został zachowany, ponieważ ufność ma charakter kierunkowy.
| Nazwa zioła | Stłuszczenie wątroby (n) | Stłuszczenie wątroby (N) | Stłuszczenie wątroby (%) | Marskość wątroby (n) | Marskość wątroby (N) | Marskość wątroby (%) | Przewlekłe zapalenie żołądka (n) | Przewlekłe zapalenie żołądka (N) | Przewlekłe zapalenie żołądka (%) |
| Bai Shao | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| Dang Gui | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| Dan Shen | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| Fu Ling | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| E Zhu przetwarzane octem | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| Bie Jia przetwarzane octem | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| Smażony Bai Zhu | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| Huang Lian | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| Mu Xiang | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| Yin Chen | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| Sheng Huang Qi | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| Gan Cao | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| Chai Hu | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| Huang Qin | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| Ze Xie | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
Tabela 8: Prewalencja stosowania ziół w podziale według diagnozy. Liczniki, mianowniki oraz prewalencja na poziomie wizyty dla 16 znormalizowanych etykiet ziół w przypadku stłuszczenia wątroby (n = 77), marskości wątroby (n = 46) oraz przewlekłego zapalenia żołądka (n = 133). Każda etykieta zioła została policzona nie więcej niż raz na kwalifikującą się wizytę związaną z przepisaniem leków.
Tabela uzupełniająca 1: Rejestr przejrzystości i audytu wspomaganego przez AI. Dokumentacja rozróżniająca rejestr analizy pierwotnej od przeglądu spójności na etapie rewizji przeprowadzonego 21 sierpnia 2026 r. Tabela zawiera informacje o narzędziu/modelu/wersji, zakresie danych wejściowych, celu, zidentyfikowanym niezgodności kardynalności Four-Qi, korekcie ludzkiej, ograniczeniach użytkowania, informacjach o recenzencie, rozstrzygnięciu oraz szablonie promptu. Do systemu AI nie przekazywano surowych danych na poziomie pacjenta. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2: Wyniki jakości danych z audytu źródeł. Przedstawiono kompletność odzyskanych pól, ustalenia z audytu, działania analityczne oraz stany wydania dla klinicznych pól źródłowych i starszych struktur analitycznych. Tabela dokumentuje wykluczenie niezgodnych starszych wskaźników zespołów objawów, korektę wcześniejszych sum ziół, brak możliwych do odtworzenia wektorów rozkładu sprzed czyszczenia dla szacowania stabilności między wersjami oraz ilości, których nie udało się odtworzyć. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 3: Mapowanie nomenklatury ziół. Kontrolowane etykiety wyświetlania ziół są powiązane z kwalifikatorami przetwarzania, standardowymi nazwami chińskich materiałów leczniczych (CMM), terminologią źródłową, źródłami botanicznymi, zoologicznymi lub mineralnymi, wersjami referencyjnymi, lokalizatorami dowodów oraz granicami dowodów. Etykiety specyficzne dla przetwarzania zostaną zachowane tam, gdzie mają one znaczenie kliniczne. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 4: Analizy wrażliwości progu i powtórnych wizyt. Przedstawiono perturbacje progów reguł asocjacyjnych, porównania zestawów reguł dla jednej wizyty na pacjenta, wskaźniki wrażliwości Chi Shao > Fu Ling oraz porównanie odległości danych wejściowych do klastrowania dla 190 par. Kliknij tutaj, aby pobrać ten plik.
Plik uzupełniający 1: Skrypt deterministycznego progu i czułości powtórnych wizyt. Skrypt deterministyczny wykorzystany do odtworzenia zagregowanych wskaźników progu oraz czułości powtórnych wizyt z zestawu danych źródłowych zablokowanego do konkretnej wersji. Plik nie zawiera danych na poziomie pacjentów. Prosimy kliknąć tutaj, aby pobrać ten plik.
Dyskusja
Głównym wkładem niniejszego protokołu jest stworzenie kompletnej i weryfikowalnej ścieżki prowadzącej od zanonimizowanych rekordów przypadków TCM do zbiorczych danych badawczych. Najbardziej krytycznymi krokami są: ustalenie reguły identyfikacji kohorty przed analizą wyników, rozróżnienie unikalnych pacjentów od wizyt związanych z wypisaniem recept, zachowanie każdego mapowania terminu oryginalnego na znormalizowany oraz weryfikacja każdego licznika i mianownika przed wizualizacją. Kontrole te zmieniają oczyszczanie danych z niewidocznej czynności wstępnej w udokumentowany element metodyki. Dostosowują one również przepływ pracy do standardów RECORD, STROBE, FAIR oraz uznanych ram jakości danych EHR11,12,13,14,15. Wynik uznaje się za gotowy do publikacji dopiero wtedy, gdy jego pole źródłowe, jednostka analizy, wersja słownika, reguła obliczeń, mianownik, tabela, figura oraz decyzja recenzenta mogą zostać odtworzone w rejestrze dowodów.
Metoda ta jest innowacyjna, ponieważ ład korporacyjny, inżynieria terminologiczna, obliczenia, wizualizacja oraz przegląd kliniczny są zintegrowane, a nie traktowane jako oddzielne zadania. Pojedyncza, jawna macierz syndromów generuje spektrum częstotliwości, sieć współwystępowania oraz mapę ciepła. Pojedyncza macierz wizyt z receptami według ziół wspiera zestawienia częstotliwości, skierowane reguły asocjacyjne oraz grupowanie hierarchiczne19,20,21. Pojedyncza tabela stratyfikowana według diagnozy umożliwia wyznaczenie zarówno dokładnych wartości procentowych, jak i końcowej mapy ciepła. Przepływ analityczny wykorzystuje skryptowe, reprodukowalne narzędzia open-source36,37,38,39,40, co pozwala na propagację korekty w słowniku wejściowym lub decyzji dotyczącej kohorty na wszystkie zależne wyniki. Wcześniejsze prace nad magazynami danych klinicznych wykazują również znaczenie przetwarzania wstępnego powiązanego ze źródłem oraz ponownego wykorzystania ustrukturyzowanych danych41,42. Taka architektura ogranicza ręczną transkrypcję, utrzymuje spójność między kodowaniem graficznym a tabelami źródłowymi oraz ułatwia audyt, nauczanie i przekazywanie metodologii innym zespołom badawczym.
Trzy ostatnie badania oparte na analizie baz danych dostarczają przydatnych zasad projektowania, choć ich jednostką analizy jest publikacja, a nie wizyta kliniczna. Badanie dotyczące reumatoidalnego zapalenia stawów i depresji łączy predefined search strategy z analizami krajów, instytucji, autorów, czasopism, słów kluczowych oraz ram czasowych26. Badanie nad wrzodziejącym zapaleniem jelita grubego i inhibitorami kinazy Janus wykorzystuje skoordynowaną analizę współpracy, współcytowań, klasteryzacji oraz analizy burst, aby odróżnić trwałe tematy od wyłaniających się frontów badawczych27. Badanie nad reumatoidalnym zapaleniem stawów i fibromialgią rozszerza mapowanie bibliometryczne o bioinformatykę, zachowując jednocześnie rozróżnienie między dwiema warstwami dowodów28. Niniejszy protokół stosuje tę samą zasadę skoordynowanych, ale niewymiennych widoków analitycznych. Przeniesienie metody do ginekologii, pulmonologii, reumatologii lub innej specjalizacji wymaga rekonstrukcji pól specyficznych dla danej dziedziny, słowników terminologicznych, reguł włączenia i wykluczenia, wyników oraz procedur przeglądu klinicznego przed ponownym wykorzystaniem zestawu reguł. Spektra chorób, sieci zespołów, słowa kluczowe objawów, reguły asocjacyjne, klasteryzacja i wzorce stratyfikowane według diagnozy wynikają ze źródeł o zablokowanej wersji, jednak każdy z tych elementów odpowiada na odrębne pytanie i zachowuje własny mianownik oraz granicę interpretacyjną.
Sztuczna inteligencja nadzorowana przez człowieka może zapewnić dodatkową warstwę kontroli jakości, jeśli ograniczy się do zatwierdzonych, zanonimizowanych fragmentów lub materiałów zagregowanych. W ramach tego procesu AI może porównywać terminologię w różnych plikach, sygnalizować niespójności między podpisami a tabelami, identyfikować etykiety wykraczające poza granice rycin, weryfikować, czy każdy wyświetlony węzeł sieci posiada prawidłową krawędź, oraz sugerować jaśniejsze sformułowania. AI nie określa kwalifikowalności kohorty, nie tworzy mapowań terminologicznych, nie wyciąga wniosków co do efektów leczenia ani nie zastępuje przeglądu danych źródłowych. Taki podział odpowiedzialności jest zgodny z szerszym ujęciem, według którego medyczna AI powinna wspomagać osąd człowieka, a nie zacierać odpowiedzialność33. Odzwierciedla to również nacisk standardu DECIDE-AI na przejrzyste czynniki ludzkie, obsługę błędów i rozliczalną ewaluację34. W związku z tym, w przypadku korzystania z pomocy AI, w dzienniku audytu powinny zostać zachowane informacje o celu każdego promptu, zweryfikowanym wyniku, zaakceptowanej poprawce, recenzencie oraz dacie.
Rozwiązywanie problemów jest szczególnie istotne, gdy wynik wydaje się klinicznie prawdopodobny, ale nie przechodzi procesu uzgadniania z danymi źródłowymi. W takich przypadkach interpretacja wyników końcowych powinna zostać wstrzymana do czasu ustalenia, czy rozbieżność wynika z określenia kwalifikowalności, deduplikacji, mapowania terminologii, wyboru pól, doboru mianownika czy montażu rysunków. Po wprowadzeniu korekty wszystkie zależne wyniki powinny zostać wygenerowane ponownie. Przedstawiony przykład opiera się na retrospektywnym zbiorze danych z jednego ośrodka, obejmującym pacjentów ambulatoryjnych ocenianych przez ekspertów, w którym powtarzające się wizyty nie są od siebie niezależne. Analiza wrażliwości dla jednej wizyty na pacjenta zredukowała liczbę zachowanych reguł z 15 do 12, zachowując jednocześnie obecność wszystkich 20 głównych ziół. Wśród wszystkich 190 nieuporządkowanych par spośród tych 20 wspólnych zmiennych korelacja Pearsona wyniosła 0,9944, współczynnik korelacji Spearmana rho wyniósł 0,9836, średnia bezwzględna zmiana odległości Jaccarda wyniosła 0,0146, a zmiana maksymalna 0,0528 (Tabela uzupełniająca 4). W związku z tym wysokiego poziomu wsparcia na poziomie wizyty nie należy interpretować jako walidacji na poziomie pacjenta. Spektrum historia-słowo kluczowe odzwierciedla dosłowną dokumentację, a nie zwalidowaną skalę objawów. Podsumowania materia medica są ważone według liczby wystąpień, a nie według dawki. Reguły asocjacyjne opisują współwystępowanie zapisów, a nie przyczynowość. Mapy ciepła w rozstrzębieniu według diagnoz mają charakter opisowy i nie określają skuteczności porównawczej, specyficzności choroby ani konieczności leczenia.
Protokół ten można zastosować w badaniach nad dziedziczeniem specjalistycznego doświadczenia klinicznego, w opisach kohort pacjentów w poradniach specjalistycznych, w wieloośrodkowej harmonizacji terminologii, w przeglądzie jakości dokumentacji, w wyborze zmiennych do rejestrów prospektywnych oraz w przygotowywaniu zagregowanych zbiorów danych do współpracy z zachowaniem prywatności. Przyszłe prace mogą obejmować prospektywne, ustrukturyzowane gromadzenie objawów, modele zgrupowane według pacjentów, jawne zmienne dawkowania, zdefiniowane a priori hipotezy porównawcze, walidację zewnętrzną, wersjonowane usługi terminologiczne, obliczenia chroniące prywatność oraz interaktywne rejestry dowodów. Przetwarzanie języka naturalnego i przeglądy wspomagane przez AI mogą dodatkowo ograniczyć powtarzalną kuratela danych, pod warunkiem zastosowania zasad zablokowanych wersyjnie oraz weryfikacji przez człowieka. Szerzej rzecz ujmując, protokół ten umożliwia przekształcenie rozproszonego doświadczenia klinicznego w przejrzysty obiekt badawczy, który może być analizowany, reprodukowany, kwestionowany i rozszerzany. Metoda ta nie przekształca częstotliwości w skuteczność; zamiast tego przekształca niedokumentowane decyzje analityczne w widoczne dowody, stanowiąc podstawę dla bardziej rygorystycznych pytań klinicznych i trwalszych badań nad TCM w warunkach rzeczywistych.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych konfliktów interesów.
Podziękowania
OpenAI Codex (gpt-5.6-luna i gpt-5.6-sol) był wykorzystywany wyłącznie podczas redakcji manuskryptu do sprawdzania spójności między plikami na poziomie zbiorczym oraz w celu uzyskania sugestii dotyczących sformułowań. Do systemu AI nie przekazywano żadnych rekordów na poziomie pacjenta. Wszystkie wyniki uzyskane przy wsparciu AI zostały niezależnie zweryfikowane z materiałami źródłowymi przez Tian Xia w dniu 21 sierpnia 2026 r. Autorzy sprawdzili i zatwierdzili ostateczną treść i ponoszą pełną odpowiedzialność za manuskrypt. Projekt ten był wspierany przez Narodowy Kluczowy Program Badań i Rozwoju Chin, Kluczowy Projekt Specjalny w zakresie Modernizacji Tradycyjnej Medycyny Chińskiej (nr 2025YFC3512800); Narodowy Główny Projekt Naukowo-Technologiczny Chin (projekt nr 2026ZD0554100; podprojekt nr 2026ZD0554101); Projekt Doskonalenia Zdolności do Badań Klinicznych i Translacji Osiągnięć w Centralnych Szpitalach Tradycyjnej Medycyny Chińskiej Wysokiego Szczebla, Projekt Specjalny w zakresie Przekazywania Doświadczeń Akademickich Renomowanych Starszych Ekspertów Tradycyjnej Medycyny Chińskiej (nr HLCMHPP2023016) oraz Fundację Nauk Przyrodniczych Autonomicznego Regionu Sinciang (nr 2025D01C213).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Arkusze kalkulacyjne do zbiorczej reanalizy | Lokalne pliki wygenerowane przez autora | Nie dotyczy | Stosowane do obliczania sum zbiorczych, tworzenia tabel i generowania rycin. |
| Eksport zanonimizowanej dokumentacji medycznej pacjentów ambulatoryjnych | Instytucjonalny system elektronicznej dokumentacji medycznej | Nie dotyczy | Stosować wyłącznie w kontrolowanym środowisku instytucjonalnym; dokumentacja na poziomie pacjenta nie stanowi materiałów do przedłożenia. |
| lxml | projekt lxml | 6.1.1 | Wersja oprogramowania użyta do serializacji z zachowaniem przestrzeni nazw podczas regeneracji na etapie rewizji; nie jest to historyczna wersja z etapu analizy pierwotnej. |
| Matplotlib | Projekt Matplotlib (matplotlib.org) | 3.11.1 | Wersja zaobserwowana w środowisku regeneracji na etapie rewizji oraz w metadanych SVG Rysunku 3; nie jest to historyczna wersja analizy pierwotnej. |
| NetworkX | Projekt NetworkX | Pakiet PyPI: networkx | Zarejestrowano identyfikator pakietu; w środowisku dziedziczonym nie zweryfikowano dokładnej wersji etapu rewizji. |
| NumPy | Projekt NumPy | 2.3.5 | Wersja oprogramowania użyta do regeneracji zaktualizowanych wyników zagregowanych; nie jest to historyczna wersja z pierwotnej analizy. |
| openpyxl | projekt openpyxl | 3.1.5 | Wersja oprogramowania użyta do wygenerowania poprawionych zbiorczych wyników w formacie XLSX; nie jest to historyczna wersja oryginalnej analizy. |
| pandas | projekt pandas | 3.0.1 | Wersja oprogramowania użyta do regeneracji poprawionych wyników zagregowanych; nie jest to historyczna wersja z oryginalnej analizy. |
| PyMuPDF | projekt PyMuPDF | 1.28.2 | Wersja oprogramowania użyta do regeneracji zaktualizowanych wyników w postaci rycin na etapie rewizji; nie jest to historyczna wersja z etapu pierwotnej analizy. |
| Python | Python Software Foundation | 3.13.15 | Wersja oprogramowania użyta do regeneracji zaktualizowanych wyników zagregowanych; nie jest to historyczna wersja z pierwotnej analizy. |
| SciPy | Projekt SciPy | Pakiet PyPI: scipy | Zapisano identyfikator pakietu; nie zweryfikowano dokładnej wersji etapu rewizji w środowisku dziedziczonym. |
Bibliografia
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.