Niniejszy protokół przedstawia powtarzalny schemat postępowania w zakresie opracowywania, oceny i interpretacji wyjaśnialnych modeli sztucznej inteligencji w opiece zdrowotnej. Integruje on ustandaryzowane przygotowanie danych, rozwój modelu, techniki wyjaśnialności, ocenę ilościową oraz praktyki zapewniające powtarzalność, aby zwiększyć przejrzystość, niezawodność i przydatność kliniczną.
Artykuł metodologiczny
Powtarzalny protokół eksperymentalny do opracowywania i oceny wyjaśnialnych modeli sztucznej inteligencji w systemach opieki zdrowotnej
W tym artykule
Podsumowanie
Streszczenie
Sztuczna inteligencja (AI) jest coraz częściej wdrażana jako wartościowe narzędzie w podejmowaniu decyzji klinicznych, prognozowaniu chorób, diagnostyce medycznej i spersonalizowanej opiece zdrowotnej. Jednak brak przejrzystości, niespójne wdrażanie metod wyjaśnialnej sztucznej inteligencji (XAI) oraz ograniczona powtarzalność pozostają głównymi barierami w godnym zaufania stosowaniu modeli AI w warunkach klinicznych. Niniejsza praca proponuje systematyczny, powtarzalny i przejrzysty protokół opracowywania, oceny i interpretacji wyjaśnialnych modeli AI w zastosowaniach medycznych. Przepływ pracy rozpoczyna się od konfiguracji środowiska obliczeniowego, po której następują: pozyskiwanie i charakterystyka danych, przetwarzanie wstępne, inżynieria cech, opracowanie modelu, optymalizacja hiperparametrów, ocena wydajności predykcyjnej, analiza wyjaśnialności, walidacja statystyczna oraz ocena powtarzalności. Protokół uwzględnia metody XAI, takie jak SHapley Additive exPlanations (SHAP), Local Interpretable Model-agnostic Explanations (LIME), Gradient-weighted Class Activation Mapping (Grad-CAM), Integrated Gradients, wizualizacja uwagi (attention visualization) oraz wyjaśnienia kontrfaktyczne, w celu generowania zarówno globalnych, jak i lokalnych interpretacji modelu. Protokół kładzie nacisk na kilka kluczowych komponentów, w tym na przygotowanie zestandaryzowanych zbiorów danych medycznych, opracowanie stabilnych modeli uczenia maszynowego, ocenę wydajności predykcyjnej, generowanie istotnych klinicznie wyjaśnień oraz statystyczną ocenę powtarzalności w powtórzonych eksperymentach. Dzięki zintegrowaniu opracowania modelu, wyjaśnialności, oceny ilościowej i jakościowej, walidacji statystycznej oraz oceny powtarzalności w ujednoliconym przepływie pracy, protokół ten zapewnia kompleksowe ramy dla tworzenia przejrzystych i powtarzalnych modeli AI w zastosowaniach medycznych.
Wprowadzenie
Sztuczna inteligencja (AI) stała się integralnym elementem współczesnej opieki zdrowotnej, umożliwiając inteligentną analizę złożonych danych klinicznych i wspierając podejmowanie medycznych decyzji opartych na dowodach1. Szybka cyfryzacja ochrony zdrowia poprzez elektroniczną dokumentację medyczną, systemy obrazowania medycznego, urządzenia ubieralne oraz technologie genomiczne wygenerowała duże wolumeny heterogenicznych danych, które wymagają zaawansowanych podejść obliczeniowych w celu ich efektywnej interpretacji2.
Algorytmy uczenia maszynowego (ML) i głębokiego uczenia (DL) wykazały niezwykłe możliwości w zakresie wyodrębniania istotnych wzorców z wielowymiarowych zbiorów danych opieki zdrowotnej, co przyczyniło się do poprawy dokładności diagnostycznej, przewidywania chorób oraz oceny wyników leczenia pacjentów3. Modele oparte na AI zostały z sukcesem zastosowane w radiologii, patologii, kardiologii, onkologii, okulistyce i innych specjalnościach medycznych, aby wspierać klinicystów w wykrywaniu chorób na wcześniejszych etapach oraz w rekomendowaniu spersonalizowanych strategii terapeutycznych4. Technologie te przyczyniły się również do optymalizacji przepływu pracy, zmniejszenia zmienności diagnostycznej oraz lepszego wykorzystania zasobów opieki zdrowotnej5.
Ostatnie postępy w dziedzinie sprzętu komputerowego, obliczeń w chmurze oraz otwartoźródłowych ram AI przyspieszyły rozwój i wdrażanie inteligentnych aplikacji w opiece zdrowotnej6. W konsekwencji AI stała się kluczową technologią umożliwiającą rozwój medycyny precyzyjnej oraz systemów wspomagania decyzji klinicznych7. Pomimo tych postępów, powszechne zastosowanie AI w rutynowej praktyce klinicznej pozostaje ograniczone, ponieważ wiele wysokowydajnych modeli oferuje niewielki wgląd w sposób generowania ich prognoz8.
Większość algorytmów głębokiego uczenia funkcjonuje jako złożone modele typu „czarna skrzynka”, w których wewnętrzny proces podejmowania decyzji jest trudny do zrozumienia dla klinicystów i badaczy9. Choć modele te często osiągają doskonałe wyniki predykcyjne, brak ich przejrzystości osłabia zaufanie użytkowników i stwarza wyzwania w zakresie walidacji klinicznej, zatwierdzeń regulacyjnych oraz bezpieczeństwa pacjentów10. Specjaliści z zakresu opieki zdrowotnej muszą mieć możliwość uzasadnienia decyzji wspomaganych przez AI przed wdrożeniem ich do rutynowej praktyki klinicznej, szczególnie w środowiskach medycznych o wysokim stopniu ryzyka11.
XAI wyłoniło się jako efektywne podejście do zwiększania przejrzystości i interpretowalności modeli uczenia maszynowego12. Zamiast traktować modele predykcyjne jako systemy nieprzejrzyste, techniki XAI dostarczają informacji o cechach, obszarach obrazu lub zmiennych klinicznych, które wpływają na poszczególne predykcje13. Takie wyjaśnienia umożliwiają klinicystom lepsze zrozumienie zachowania modelu, identyfikację potencjalnych błędów systematycznych oraz określenie, czy decyzje generowane przez AI są zgodne z uznaną wiedzą medyczną14.
W zastosowaniach medycznych wprowadzono kilka technik wyjaśnialności. Metoda SHapley Additive explanations (SHAP) mierzy wkład każdej cechy w predykcję modelu w oparciu o kooperacyjną teorię gier15. Metoda Local Interpretable Model-agnostic Explanations (LIME) tworzy uproszczony model i wyjaśnia predykcje modelu typu „czarna skrzynka”16. W przypadku zadań związanych z obrazowaniem medycznym z wykorzystaniem modeli głębokiego uczenia, mapy aktywacji ważone gradientem (Grad-CAM) generują mapy ciepła, które wizualnie wskazują obszary obrazu wpływające na decyzje klasyfikacyjne17. Połączenie tych metod znacząco zwiększyło przejrzystość systemów AI w różnych dziedzinach opieki zdrowotnej18.
Mimo rosnącej uwagi poświęcanej metodom wyjaśnialności w opiece zdrowotnej, ich zastosowanie w literaturze pozostaje zróżnicowane. Badacze różnią się nie tylko w stosowaniu strategii preprocessingu, ale także w projektowaniu architektury modeli, doborze metryk ewaluacji, a nawet technik wyjaśniania19. Ponadto wiele publikacji raportuje wysoką dokładność predykcyjną, lecz nie zapewnia rzetelnej oceny jakości wyjaśnień ani ich powtarzalności20.
Powtarzalność jest jednym z głównych wąskich gardeł w nowoczesnej nauce o AI. W publikacjach często nie ujawnia się wersji oprogramowania, środowiska obliczeniowego, potoku wstępnego przetwarzania, ustawień hiperparametrów, inicjalizacji ziarna losowego oraz konfiguracji sprzętowej21. Z tego powodu niezależni badacze często nie są w stanie odtworzyć opublikowanych wyników ani zweryfikować opisanych metod przy użyciu innych zbiorów danych lub platform programistycznych2. Brak szczegółowej dokumentacji jest jednym z czynników utrudniających badania benchmarkowe, badania kolaboracyjne oraz translację kliniczną systemów AI23.
Uznając te wyzwania, kilka organizacji i agencji regulacyjnych podkreśliło znaczenie transparentnej, godnej zaufania i reprodukowalnej sztucznej inteligencji w zastosowaniach opieki zdrowotnej24. Istniejące wytyczne dotyczące raportowania poprawiły opis metodologiczny, ale opisują one przede wszystkim to, co powinno zostać zaraportowane, zamiast dostarczać zestandaryzowanych procedur eksperymentalnych, które badacze mogliby bezpośrednio wdrożyć25. W związku z tym nadal istnieje potrzeba opracowania kompleksowego protokołu, który integrowałby przygotowanie zbioru danych, rozwój modelu, analizę wyjaśnialności, ocenę statystyczną oraz praktyki zapewniania reprodukowalności w ramach jednego przepływu pracy eksperymentalnej26.
Znormalizowany protokół eksperymentalny oferuje szereg korzyści dla społeczności zajmującej się sztuczną inteligencją w opiece zdrowotnej. Co więcej, sprzyja on spójności metodologicznej, ułatwia porównywanie niezależnych badań, zwiększa przejrzystość eksperymentów obliczeniowych oraz umożliwia wiarygodną walidację opublikowanych wyników27. Znormalizowane przepływy pracy wspomagają również edukację i szkolenia, badania kolaboracyjne oraz oceny regulacyjne dzięki jasno udokumentowanym procedurom, które są odtwarzalne w różnych laboratoriach i instytucjach opieki zdrowotnej28.
Opracowano i przetestowano powtarzalny protokół eksperymentalny służący do trenowania i oceny modeli AI w systemach opieki zdrowotnej. Protokół ten określa standardy konfiguracji środowiska obliczeniowego, wstępnego przetwarzania zbiorów danych medycznych, opracowywania modeli uczenia maszynowego, stosowania metod XAI, oceny wydajności predykcyjnej, przeprowadzania walidacji statystycznej oraz oceny powtarzalności29. Integracja tych komponentów w spójny przepływ pracy prawdopodobnie zwiększy przejrzystość, niezawodność i powtarzalność badań nad AI w opiece zdrowotnej, a także pomoże w opracowaniu zaufanych inteligentnych systemów zdrowotnych30.
Protokół
W przeprowadzonym eksperymencie walidacyjnym wykorzystano publicznie dostępny, zanonimizowany zbiór danych Pima Indians Diabetes Dataset, który nie zawierał identyfikowalnych rekordów pacjentów i nie wymagał rekrutacji nowych osób. W związku z tym nie było wymagane uzyskanie świadomej zgody ani zatwierdzenia przez instytucjonalną komisję bioetyczną (IRB/ethics approval), a wszystkie analizy zostały przeprowadzone zgodnie z obowiązującymi warunkami korzystania ze zbioru danych oraz instytucjonalnymi zasadami prowadzenia badań.
W opracowanym przykładzie walidacji wykorzystano publicznie dostępny zbiór danych Pima Indians Diabetes Dataset, który zawiera 768 rekordów służących do binarnego przewidywania cukrzycy. Do tego zbioru danych zastosowano kompletny, dziewięcioetapowy podstawowy schemat postępowania. Dziewięć podstawowych etapów obejmowało: wybór i walidację zbioru danych, konfigurację środowiska obliczeniowego, wstępne przetwarzanie danych, partycjonowanie zbioru danych, opracowanie i trenowanie modelu, ocenę wydajności predykcyjnej i obliczeniowej, analizę wyjaśnialności, walidację statystyczną oraz ocenę powtarzalności. Walidacja zewnętrzna i ocena ekspercka kliniczna zostały pozostawione jako opcjonalne moduły walidacyjne i nie zostały przeprowadzone w niniejszym przykładzie. Rycina 1 ilustruje podstawowy schemat protokołu, a w Tabeli 1 podsumowano wyłącznie dziewięć podstawowych etapów zaimplementowanych w obecnej walidacji; opcjonalna walidacja zewnętrzna i ocena ekspercka kliniczna są opisane osobno w sekcji Protokół i nie są wliczone do dziewięciu etapów eksperymentalnych.
1. Wybór i walidacja zbioru danych z zakresu opieki zdrowotnej
- Wybierz zbiór danych Pima Indians Diabetes Dataset jako główny zbiór danych dla opracowanego przykładu walidacji. Zweryfikuj źródło zbioru danych, wielkość próby, cel predykcji, rozkład klas oraz strukturę danych.
- Zastosuj zdefiniowane kryteria włączenia, wyłączenia oraz kryteria jakości danych. Przed opracowaniem modelu usuń duplikaty i nieprawidłowe rekordy.
- Zapisz źródło zbioru danych, jego charakterystykę, zadanie predykcyjne, rozkład klas, kryteria włączenia i wyłączenia oraz strategię partycjonowania w Tabeli 2.
- Zastosuj kryteria decyzyjne dotyczące wyboru zbioru danych i modelu
- Zdefiniuj cel predykcji przed wyborem zbioru danych, architektury modelu, strategii preprocessingu lub metody wyjaśnialności.
- Dopasuj modalność zbioru danych do celu predykcji. Wybierz dane tabelaryczne dla ustrukturyzowanych zmiennych klinicznych, dane obrazowe dla obrazów medycznych, dane szeregów czasowych dla sygnałów fizjologicznych, dane tekstowe dla opisów klinicznych lub dane multimodalne, gdy dla tego samego pacjenta lub jednostki badawczej dostępne są komplementarne modalności.
- Oceń potencjalne zbiory danych pod kątem wielkości próby, dostępności wyników, rozkładu klas, braków danych, jakości adnotacji, istotności klinicznej, kompletności danych oraz dostępności. Wybierz zbiór danych, który spełnia zdefiniowane wymagania.
- W przypadku ustrukturyzowanych danych tabelarycznych wybierz konwencjonalne modele uczenia maszynowego, gdy wielkość próby, zasoby obliczeniowe lub wymagania dotyczące interpretowalności ograniczają możliwość zastosowania złożonych architektur. Wybierz architektury głębokiego uczenia, gdy dostępne są wystarczające dane treningowe i wejścia wysokowymiarowe, takie jak obrazy medyczne, sygnały fizjologiczne lub teksty kliniczne.
- Wybierz architektury multimodalne tylko wtedy, gdy dla tego samego pacjenta lub jednostki badawczej dostępne są wiele modalności, które można wiarygodnie dopasować bez wprowadzania wycieku informacji. Wybierz operacje preprocessingu zgodnie z charakterystyką wybranej modalności danych.
- Wybierz metody wyjaśnialności w zależności od modelu i modalności danych. Dla odpowiednich modeli tabelarycznych stosuj metody niezależne od modelu (model-agnostic), takie jak SHAP lub LIME, a dla modeli opartych na obrazach, jeśli dotyczy, metody specyficzne dla danej modalności, takie jak Grad-CAM.
- Udokumentuj uzasadnienie wyboru zbioru danych, strategii preprocessingu, modelu oraz metody wyjaśnialności. Zachowaj te decyzje jako element dokumentacji reprodukowalności.
2. Konfiguracja środowiska obliczeniowego do opracowania modelu XAI
- Skonfiguruj system operacyjny, procesor (CPU), pamięć RAM, pamięć masową oraz układ GPU zgodnie z wymaganiami wybranego modelu. Utwórz izolowane środowisko Python i zainstaluj wymagane biblioteki do uczenia maszynowego, głębokiego uczenia, analizy statystycznej, wizualizacji oraz XAI.
- Zarejestruj faktyczne środowisko obliczeniowe, architekturę modelu oraz hiperparametry wykorzystane podczas przeprowadzonej walidacji w Tabeli 3. Określ optymalizator, współczynnik uczenia (learning rate), wielkość partii (batch size), maksymalną liczbę epok, funkcję straty, parametry regularyzacji, strategię walidacji, konfigurację wczesnego zatrzymania (early-stopping), konfigurację ziarna losowości (random-seed), metody wyjaśnialności, sprzęt, system operacyjny, wersję języka Python oraz wersje odpowiednich bibliotek programistycznych. Odróżnij te ustawienia użyte eksperymentalnie od ogólnych lub zalecanych ustawień protokołu.
- Użyj konfiguracji opisanej w Tabeli 3 podczas powtarzania walidacji zbioru danych Pima Indians Diabetes Dataset oraz odpowiadających im wyników predykcyjnych, wyjaśnialności, statystycznych i reprodukowalności.
- Uruchom skrypt walidacyjny, aby potwierdzić prawidłowy import pakietów, ładowanie zbioru danych, wykonanie modelu i generowanie wyników. Zachowaj sfinalizowaną konfigurację środowiska w celu zapewnienia reprodukowalności.
3. Przygotowanie i charakterystyka zbiorów danych z zakresu opieki zdrowotnej do opracowania modelu XAI
- Wybór i pozyskanie zbioru danych medycznych
- Wybrać zbiór danych medycznych odpowiedni dla określonego zadania predykcji klinicznej. Ocenić potencjalne zbiory danych pod kątem celu badawczego, typu danych, wielkości próby, jakości adnotacji, równowagi klas oraz istotności klinicznej.
- Preferować publicznie dostępne zbiory danych benchmarkowych, jeżeli w sposób adekwatny realizują one zadanie predykcji i umożliwiają niezależną walidację.
- Uzyskać wymagane zgody etyczne, pozwolenia instytucjonalne oraz autoryzację dostępu do danych przed pozyskaniem zbiorów instytucjonalnych lub wewnętrznych. Pobrać wybrany zbiór danych z zweryfikowanego repozytorium lub autoryzowanej bazy danych instytucjonalnej.
- Przechowywać oryginalne pliki zbioru danych bez modyfikacji i odnotować dostawcę zbioru, wersję, informacje o pozyskaniu, warunki licencyjne, kryteria włączenia, kryteria wykluczenia oraz towarzyszące metadane. Zorganizować zbiór danych w oddzielnych katalogach dla danych surowych, adnotacji, metadanych i informacji uzupełniających.
- Charakterystyka zbioru danych medycznych
- Zidentyfikować zmienne predyktora, etykiety wyników, typy cech, modalności danych i rozkłady klas. Określić liczbę podmiotów, próbek, wymiarowość cech oraz dostępne adnotacje.
- Potwierdzić, że charakterystyka zbioru danych jest zgodna z wybraną metodą AI.
- Wykorzystać Pima Indians Diabetes Dataset jako jedyny praktyczny zbiór danych eksperymentalnych do walidacji dziewięciostopniowego protokołu podstawowego. Uwzględnić dodatkowe zbiory danych wymienione w Tabeli 2 wyłącznie w celu zademonstrowania stosowności ogólnego protokołu w odniesieniu do klinicznych danych tabelarycznych, elektronicznej dokumentacji medycznej, obrazów dermoskopowych, fizjologicznych danych szeregów czasowych i obrazowania medycznego. Nie używać tych dodatkowych zbiorów danych do trenowania modelu, testowania, walidacji statystycznej ani generowania raportowanych wyników eksperymentalnych.
- Ocena jakości zbioru danych
- Przejrzeć zbiór danych pod kątem duplikatów rekordów, uszkodzonych plików, brakujących wartości, błędów w adnotacjach i nieregularnych wpisów danych. Usunąć potwierdzone duplikaty rekordów i skorygować zweryfikowane nieprawidłowości w formatowaniu. Dokumentować wszystkie procedury kontroli jakości zbioru danych.
- Zweryfikować zgodność danych obrazowych, klinicznych, laboratoryjnych i fizjologicznych za pomocą identyfikatorów podmiotów w przypadku korzystania z wielomodalnych zbiorów danych.
- Usunąć duplikaty lub niespójne rekordy, obsłużyć brakujące wartości, znormalizować cechy numeryczne, zakodować zmienne kategoryczne i zastosować preprocessing specyficzny dla danej modalności. Podzielić zbiór danych na niezależne zbiory treningowe, walidacyjne i testowe. Schemat przygotowania, preprocessingu, podziału i oceny jakości zbioru danych medycznych przedstawiono na Rysunku 2.
- Zapewnienie prywatności danych i zgodności etycznej
- Usunąć bezpośrednie identyfikatory z danych medycznych. Zastosować procedury anonimizacji lub pseudonimizacji, gdy jest to wymagane. Przetwarzać informacje o stanie zdrowia pacjentów zgodnie z obowiązującymi wymogami etycznymi, zasadami ochrony danych, zgodą świadomą oraz wymogami instytucjonalnymi.
- Odnotować stosowną zgodę etyczną, zwolnienie z wymogów, procedury zarządzania danymi, metody anonimizacji oraz schemat przygotowania zbioru danych.
- Ocenić potencjalne obciążenie algorytmiczne poprzez porównanie wydajności modelu w odpowiednich podgrupach demograficznych lub klinicznych, jeśli takie informacje są dostępne i dopuszczalne etycznie.
- Dokumentować zamierzone zastosowanie, populację docelową, ograniczenia modelu, potencjalne tryby awarii, wymagania dotyczące nadzoru ludzkiego oraz obowiązujące wymogi etyczne, ochrony danych i regulacje w zakresie opieki zdrowotnej.
- Odnotować zidentyfikowane ograniczenia w zakresie sprawiedliwości oraz kwestie odpowiedzialnego AI jako część końcowej dokumentacji modelu.
UWAGA: Pozyskać ustandaryzowany i udokumentowany zbiór danych medycznych, który nadaje się do rozwoju modelu AI, jest zgodny z zasadami etycznymi i wolny od głównych zidentyfikowanych niespójności.
4. Przetwarzanie wstępne i partycjonowanie danych opieki zdrowotnej do trenowania modelu AI
- Przeprowadzenie kontroli jakości
- Przegląd zbioru danych pod kątem powtarzających się rekordów, brakujących wartości, wartości nieprawidłowych, niespójnych etykiet, wartości odstających oraz uszkodzonych plików.
- Usunięcie lub poprawienie nieprawidłowych obserwacji zgodnie z predefiniowanymi kryteriami oraz odnotowanie wszystkich wykluczeń. Weryfikacja spójności zmiennych predyktora i etykiet wyników.
- Obsługa brakujących danych
- Ilościowe określenie braków dla każdej zmiennej. Zastosowanie predefiniowanej strategii imputacji lub wykluczania.
- Szacowanie parametrów imputacji wyłącznie na podstawie danych treningowych i zastosowanie dopasowanej transformacji do danych walidacyjnych i testowych.
- Normalizacja i transformacja danych
- Zastosowanie skalowania cech, normalizacji, kodowania, redukcji wymiarowości lub innych transformacji wymaganych przez wybrany model. Dopasowanie wszystkich transformacji zależnych od danych wyłącznie przy użyciu danych treningowych.
- Zastosowanie dopasowanych transformacji bez zmian do danych walidacyjnych i testowych.
- Ilościowe określenie niezbilansowania klas w danych treningowych. Zastosowanie ważenia klas, metody SMOTE, nadpróbkowania lub augmentacji wyłącznie do zbioru treningowego. Zachowanie oryginalnego rozkładu zbiorów walidacyjnych i testowych.
- Potwierdzenie, że żaden podmiot, powielona obserwacja, próbka augmentowana, statystyka preprocessingu, kryterium wyboru cech ani próbka syntetyczna nie są współdzielone pomiędzy partycjami treningowymi a ewaluacyjnymi.
5. Opracowanie i konfiguracja modelu XAI
- Zdefiniuj architekturę modelu, określając modalności danych wejściowych, operacje preprocessingu, koderów cech specyficznych dla danej modalności, mechanizm fuzji cech, warstwę predykcyjną oraz moduł wyjaśnialności.
- Wybierz architekturę uczenia maszynowego lub głębokiego uczenia w zależności od zadania predykcyjnego i modalności wejściowej. Skonfiguruj warstwę wejściową, komponenty ekstrakcji cech, warstwy ukryte, warstwę wyjściową oraz funkcje aktywacji. Zdefiniuj optymalizator, szybkość uczenia, rozmiar partii (batch size), funkcję straty, liczbę epok, regularyzację, dropout, wczesne zatrzymanie (early stopping) oraz harmonogram szybkości uczenia.
- Zoptymalizuj hiperparametry, korzystając wyłącznie z danych treningowych i walidacyjnych.
- Zapisz finalną architekturę i konfigurację hiperparametrów w Tabeli 3.
- Przed rozpoczęciem uczenia zweryfikuj kompatybilność wymiarów wejścia i wyjścia.
UWAGA: Utwórz w pełni skonfigurowany model XAI zawierający odpowiednią architekturę, zdefiniowane hiperparametry i zintegrowane techniki wyjaśnialności.
6. Trenowanie, optymalizacja i zapisywanie modelu XAI
- Wczytać zdefiniowane zestawy danych treningowych i walidacyjnych oraz sfinalizowaną konfigurację modelu. Zainicjować model, korzystając z predefiniowanego ziarna losowego (random seed) i parametrów treningowych.
- Wytrenować model, stosując określony optymalizator, funkcję straty, rozmiar partii (batch size) oraz kryteria zatrzymania.
- Monitorować wyniki walidacji i zachować punkt kontrolny (checkpoint) odpowiadający predefiniowanemu kryterium wyboru modelu. Przetestować wybrany punkt kontrolny na niezależnym zbiorze testowym bez dalszej optymalizacji.
- Zapisać wytrenowany model, konfigurację preprocessingu, hiperparametry, ziarno losowe oraz dziennik treningu.
UWAGA: Uzyskano zoptymalizowany model XAI wytrenowany i zwalidowany z wykorzystaniem przygotowanego zbioru danych medycznych. Zachowano najlepiej działający model, hiperparametry, dzienniki treningu, konfigurację preprocessingu oraz środowisko obliczeniowe w celu zapewnienia odtwarzalności.
7. Ocena wydajności predykcyjnej i obliczeniowej
- Ocena wydajności predykcyjnej
- Po zakończeniu trenowania modelu i optymalizacji hiperparametrów należy załadować zoptymalizowany model oraz niezależny zbiór danych testowych. Parametry wytrenowanego modelu oraz potok przetwarzania wstępnego powinny pozostać niezmienione podczas testowania.
- Wygeneruj predykcje dla wszystkich próbek w zbiorze testowym. Porównaj przewidziane wyniki z odpowiadającymi im etykietami prawdy obiektywnej (ground-truth).
- Obliczanie wskaźników wydajności
- Wybierz metryki oceny zgodnie z rodzajem zadania predykcyjnego.
- W przypadku zadań klasyfikacji oblicz, w zależności od potrzeb, dokładność (accuracy), precyzję (precision), czułość (recall), swoistość (specificity), wynik F1 (F1-score), dokładność zrównoważoną (balanced accuracy), współczynnik korelacji Matthewsa (MCC) oraz pole pod krzywą charakterystyki operacyjnej odbiornika (AUC-ROC). W przypadku zadań regresji oblicz, w zależności od potrzeb, średni błąd absolutny (MAE), pierwiastnik błędu średniokwadratowego (RMSE), współczynnik determinacji (R2) oraz inne istotne miary.
- Ocena generalizacji i odporności modelu
- Oceń model z wykorzystaniem zewnętrznego zbioru danych, zgromadzonego niezależnie od zbioru rozwojowego, jeśli takie dane są dostępne.
- W celu oceny transportowalności preferuj zewnętrzne zbiory danych pochodzące z innej placówki opieki zdrowotnej, regionu geograficznego lub populacji pacjentów.
- Przeprowadź walidację temporalną z wykorzystaniem danych zebranych w późniejszym okresie, jeśli dostępne są zbiory danych podłużnych.
- W przypadku dostępności danych wieloośrodkowych przeprowadź walidację wieloośrodkową, oceniając sfinalizowany model oddzielnie w każdej z uczestniczących instytucji.
- Jeśli jest to możliwe, przeprowadź walidację geograficzną z wykorzystaniem niezależnej populacji z innego regionu geograficznego.
- Zgłoś różnice w wydajności oraz przedziały ufności pomiędzy zbiorem rozwojowym a zewnętrznymi zbiorami danych.
- Ocena wydajności obliczeniowej
- Zmierz czas trenowania modelu w zdefiniowanym środowisku obliczeniowym, czas inferencji i testowania w identycznych warunkach obliczeniowych, a także zużycie pamięci, rozmiar modelu i utylizację sprzętu.
- Powtórz pomiary obliczeniowe w niezależnych uruchomieniach.
- Oblicz średni czas wykonania, aby zredukować wpływ zmienności eksperymentalnej.
- Porównanie wydajności modeli
- Wybierz odpowiednie konwencjonalne metody uczenia maszynowego lub głębokiego uczenia do oceny porównawczej.
- Oceń proponowany model XAI oraz modele porównawcze przy użyciu tego samego zbioru danych. Zastosuj identyczne procedury przetwarzania wstępnego i metryki oceny do wszystkich modeli porównawczych.
- Wszystkie eksperymenty porównawcze przeprowadź w tym samym środowisku obliczeniowym.
UWAGA: Uzyskaj dowody eksperymentalne dotyczące stabilności predykcyjnej i odtwarzalności w testowanych warunkach obliczeniowych i dla danego zbioru danych.
8. Generowanie i ocena wyników XAI
- Generowanie wyjaśnień modelu
- Załaduj zoptymalizowany model XAI. Wybierz próbki ewaluacyjne, które nie były użyte do trenowania modelu. Zastosuj zdefiniowane metody wyjaśnialności bez modyfikowania wytrenowanego modelu ani potoku przetwarzania wstępnego.
- Generowanie globalnych i lokalnych wyjaśnień modelu
- Wygeneruj wyjaśnienia globalne w celu scharakteryzowania ogólnego zachowania modelu predykcyjnego.
- Wygeneruj wyjaśnienia lokalne w celu scharakteryzowania poszczególnych predykcji modelu.
- Zastosuj metodę SHAP do zbioru danych Pima Indians Diabetes Dataset, aby wygenerować globalne i lokalne wyjaśnienia predykcji modelu tabelarycznego.
- Wygeneruj wykres podsumowujący SHAP (summary plot), aby zwizualizować ogólny kierunek i wielkość wkładu poszczególnych cech.
- Wygeneruj wykres istotności cech SHAP (feature-importance plot) z wykorzystaniem średnich bezwzględnych wartości SHAP, aby uszeregować cechy według ich ogólnego wkładu w predykcje modelu.
- Wygeneruj wykres kaskadowy SHAP (waterfall plot) dla reprezentatywnej predykcji ze zbioru testowego, aby zilustrować wkład cech specyficznych dla danego pacjenta.
- Wygeneruj wykres zależności cech SHAP (feature-dependence plot), aby zbadać relację między wybraną cechą a jej wkładem w wynik modelu.
- Zastosuj metodę LIME do reprezentatywnych predykcji ze zbioru testowego, aby wygenerować lokalne wyjaśnienia poszczególnych predykcji modelu.
- Wygeneruj specyficzne dla pacjenta wyjaśnienie kontrfaktyczne, aby zilustrować zmiany cech związane ze zmianą przewidywanego wyniku.
- Wybierz dodatkowe techniki wyjaśnialności w zależności od modalności danych i architektury modelu.
- W stosownych przypadkach zastosuj Grad-CAM lub mapy istotności (saliency maps) dla kompatybilnych modeli opartych na obrazach, wizualizacje uwagi (attention visualizations) dla architektur opartych na transformerach oraz zintegrowane gradienty (Integrated Gradients) dla modeli różniczkowalnych.
- Traktuj Grad-CAM, mapowanie istotności, wizualizację uwagi oraz zintegrowane gradienty jako ogólne opcje protokołu zależne od modalności; nie interpretuj ani nie raportuj ich jako wyników eksperymentalnych z walidacji zbioru Pima Indians Diabetes Dataset, chyba że odpowiednie analizy zostały faktycznie przeprowadzone.
- Zastosowanie metod wyjaśnialności do walidacji Pima
- Zastosuj SHAP i LIME do zbioru danych Pima Indians Diabetes Dataset, aby wygenerować globalne i lokalne wyjaśnienia predykcji modelu tabelarycznego.
- Wygeneruj wizualizacje podsumowania, istotności cech, wykresy kaskadowe i zależności cech SHAP na podstawie wyników walidacji Pima.
- Wygeneruj lokalne wyjaśnienie LIME dla reprezentatywnych predykcji ze zbioru testowego.
- Wygeneruj specyficzne dla pacjenta wyjaśnienie kontrfaktyczne, aby zilustrować zmiany cech związane ze zmianą predykcji modelu.
- Traktuj Grad-CAM, wizualizację uwagi, mapowanie istotności i zintegrowane gradienty jako opcje wyjaśnialności zależne od modalności dla innych typów danych medycznych i architektur modeli.
- Nie raportuj Grad-CAM, wizualizacji uwagi, mapowania istotności ani zintegrowanych gradientów jako wyników eksperymentalnych z walidacji Pima, chyba że odpowiednie analizy zostały faktycznie przeprowadzone.
- Ocena jakości wyjaśnień
- Oceń, czy wygenerowane wyjaśnienia odzwierciedlają proces predykcji modelu. Oceń stabilność wyjaśnień w powtarzanych seriach eksperymentalnych oraz spójność wyników wyjaśnień w identycznych warunkach obliczeniowych.
- W stosownych przypadkach oceń czułość wyników wyjaśnień na zmiany w danych wejściowych. Porównaj wygenerowane wyjaśnienia z dostępną wiedzą domenową lub interpretacjami eksperckimi.
- Zidentyfikuj cechy predykcyjne lub obszary anatomiczne, które odpowiadają uznanej wiedzy medycznej, jeśli takie porównania są możliwe.
- Odnotuj poziom zgodności lub rozbieżności między wygenerowanymi wyjaśnieniami a dostępną interpretacją kliniczną.
- Kwantyfikacja niepewności predykcji
- Wygeneruj szacunki pewności predykcji dla ocenianych próbek, stosując metodę szacowania niepewności odpowiednią dla wybranej architektury modelu i zastosowania w opiece zdrowotnej.
- W razie potrzeby zastosuj dropout Monte Carlo, predykcję opartą na ansamblach, wnioskowanie bayesowskie, predykcję konformalną lub inną zwalidowaną metodę szacowania niepewności.
- W przypadku stosowania dropoutu Monte Carlo powtórz stochastyczne przejścia predykcyjne i oblicz średnią predykcję oraz wariancję predykcyjną dla każdej próbki ewaluacyjnej.
- Raportuj pewność predykcji lub przedziały niepewności wraz z odpowiadającymi im predykcjami modelu.
- Oceń, czy szacunki niepewności identyfikują predykcje o niższej niezawodności lub zwiększonym błędzie predykcji. Zachowaj metodę szacowania niepewności, parametry, ziarna losowe i wygenerowane wyniki niepewności, aby zapewnić powtarzalność.
- Dokumentowanie i archiwizowanie wyników wyjaśnialności
- Zapisz wszystkie wygenerowane wyniki istotności cech, mapy ciepła, mapy istotności, wizualizacje uwagi i interpretacje specyficzne dla pacjentów. Przechowuj wyniki wyjaśnialności w ustandaryzowanych formatach plików. Archiwizuj wyniki wraz z wytrenowanym modelem i konfiguracją przetwarzania wstępnego.
- Zapisz ustawienia obliczeniowe, parametry wyjaśnień, czas wykonania i wersje oprogramowania użyte do generowania wyjaśnień. Zachowaj pełną dokumentację wyjaśnialności, aby ułatwić niezależny przegląd i zapewnić powtarzalność.
- Ilościowa ocena jakości wyjaśnień
- Oceń wierność (faithfulness) wyjaśnień poprzez systematyczne zaburzanie lub maskowanie cech zidentyfikowanych jako istotne i pomiar odpowiadającej temu zmiany w wyniku modelu. Oblicz wynik wierności wyjaśnienia, porównując wielkość atrybucji z wynikową zmianą predykcji modelu.
- Oceń stabilność wyjaśnień poprzez generowanie wyjaśnień dla powtarzanych serii, zaburzonych danych wejściowych lub klinicznie podobnych próbek i obliczenie podobieństwa między wynikowymi wzorcami atrybucji. Oblicz niewierność (infidelity), mierząc rozbieżność między przewidywaną zmianą wyniku a zmianą oszacowaną na podstawie atrybucji wyjaśnienia przy kontrolowanych zaburzeniach wejścia.
- W przypadku wyjaśnień obrazów medycznych oceń dokładność lokalizacji, korzystając z zdefiniowanego przez eksperta obszaru zainteresowania, jeśli dostępne są adnotacje referencyjne. Oceń użyteczność kliniczną, uzyskując niezależne oceny od wykwalifikowanych ekspertów klinicznych przy użyciu zdefiniowanych kryteriów interpretacyjnych.
- Oblicz współczynnik kappa Cohena lub kappa Fleissa, gdy wielu ekspertów niezależnie ocenia istotność lub zgodność wyjaśnień.
UWAGA: Wygeneruj globalne i lokalne wyjaśnienia charakteryzujące zachowanie predykcyjne wytrenowanego modelu AI. Zachowaj wyniki wyjaśnialności i odpowiadające im konfiguracje w celu przejrzystej interpretacji i powtarzalnej ewaluacji.
9. Przeprowadzenie walidacji statystycznej i oceny powtarzalności
- Przeprowadź walidację statystyczną
- Wybierz metody statystyczne zgodnie z celem badania, planem eksperymentalnym, rozkładem danych oraz charakterystyką ocenianych zmiennych.
- Zmienne ciągłe należy przedstawić jako średnią ± odchylenie standardowe lub medianę i rozstęp międzykwartylny, w zależności od potrzeb, a zmienne kategoryczne jako liczebność i wartości procentowe.
- Przeprowadź pięciokrotną walidację krzyżową na zbiorze treningowym, aby ocenić stabilność wydajności modelu, a dokładność, AUC-ROC, precyzję, pełność oraz wynik F1 przedstaw w formie średniej. ± odchylenie standardowe między fałdami. Oszacuj 95-procentowe przedziały ufności dla wskaźników wydajności niezależnego zbioru testowego, wykorzystując 100 prób bootstrapowych.
- Porównaj zaproponowany model z modelami bazowymi CNN, Random Forest oraz SVM, stosując test McNemara do porównania dokładności w parach, test DeLonga do porównania skorelowanych wartości AUC-ROC oraz test bootstrapowy dla par z wykorzystaniem 10 reprobacji do porównania wyników F1-score.
- Należy podać odpowiednią statystykę testową oraz dokładną wartość p dla każdego porównania, przyjmując dwustronny poziom istotności wynoszący α = 0.05.
- Statystyczne porównanie wydajności modeli
- Porównaj proponowany wyjaśnialny model AI z wybranymi, najnowocześniejszymi modelami bazowymi uczenia maszynowego i głębokiego uczenia.
- Zastosuj test t Studenta t-test lub test U Manna-Whitneya przy porównywaniu dwóch grup, w zależności od potrzeb. W przypadku parametrów porównań obejmujących więcej niż dwie grupy należy zastosować jednoczynnikową analizę wariancji (ANOVA). W przypadku nieparametrycznych porównań obejmujących więcej niż dwie grupy należy zastosować test Kruskala-Wallisa.
- Uwzględnij p < 0,05 jako wartość istotna statystycznie, zgodnie z treścią oryginalnego manuskryptu.
- Zastosuj dwustronny poziom istotności wynoszący α = 0,05 dla wszystkich zdefiniowanych porównań statystycznych i należy podać odpowiednie statystyki testowe oraz wartości p.
- Należy podać 95% przedziały ufności dla głównych wskaźników wydajności predykcyjnej.
- W odpowiednich przypadkach należy zastosować resampling bootstrapowy w celu oszacowania przedziałów ufności dla miar wydajności. Do porównania skorelowanych wartości ROC-AUC w sytuacjach, gdy te same badani są oceniani przez dwa modele, należy zastosować test DeLonga. Do porównania sparowanych kategorycznych wyników klasyfikacji wygenerowanych dla tych samych badanych należy zastosować test McNemary. W odpowiednich przypadkach należy zastosować sparowane procedury bootstrapowe w celu porównania wyniku F1 lub innych pochodnych miar wydajności.
- Oceń kalibrację, wykorzystując wykresy kalibracji, nachylenie i punkt przecięcia linii kalibracyjnej oraz wynik Briera w sytuacjach, gdy dostępne są prognozy probabilistyczne.
- W celu walidacji przetworzonego zbioru danych Pima Indians Diabetes należy zastosować zdefiniowane porównanie statystyczne dla par, określone dla proponowanego modelu oraz modeli bazowych. Wybrany test należy stosować konsekwentnie do sparowanych predykcji ze zbioru testowego lub pomiarów wydajności z powtórzonych uruchomień, w zależności od rodzaju porównania. Należy zastosować dwustronny poziom istotności wynoszący α = 0,05 oraz należy podać statystykę testową i dokładną wartość p. Nie należy informować o przeprowadzeniu alternatywnych testów statystycznych, chyba że ich wyniki zostały przedstawione w sekcji Wyniki.
- Zastosuj testy dwustronne i zinterpretuj istotność statystyczną, przyjmując z góry określony próg wynoszący p < 0.05.
- Ocena odporności modelu
- Powtórz pełną procedurę treningu i ewaluacji 10 razy, używając różnych ziarn losowości (random seeds), przy zachowaniu zdefiniowanego wcześniej podziału zbioru danych, procedur preprocessingu, architektury modelu, hiperparametrów, środowiska programistycznego oraz protokołu ewaluacji.
- Zapisz wartości AUC-ROC, dokładności oraz wskaźnika F1 dla każdego niezależnego uruchomienia i podaj wartość średnią ± odchylenie standardowe dla 10 powtórzeń.
- Porównaj uzyskane wartości wydajności w powtórnych uruchomieniach, aby ocenić stabilność predykcyjną i odtwarzalność przy różnych losowych inicjalizacjach.
- Ocena wyjaśnialności i odtwarzalności
- Generuj przypisania cech, mapy uwagi lub inne wyniki wyjaśnień dla wielu serii eksperymentalnych w przypadku uwzględnienia oceny stabilności wyjaśnień. Porównaj ilościowo wyniki wyjaśnień w powtórzonych seriach, stosując odpowiednią miarę podobieństwa lub miarę zgodności opartą na rangach.
- W przypadku przeprowadzonej walidacji zbioru danych Pima Indians Diabetes nie należy podawać ilościowych metryk stabilności wyjaśnień, chyba że wykonano odpowiadające im powtórzone analizy i wygenerowano wyniki wyjaśnień.
- Oceń zgodność między wyjaśnieniami wygenerowanymi przez model a interpretacjami klinicystów w przypadkach, gdy dostępne są odpowiednie oceny kliniczne. Oblicz współczynnik kappa Cohena lub kappa Fleissa, w zależności od potrzeb, aby ocenić zgodność między oceniającymi.
- Powtarzalność dokumentacji
- Należy zachować surowe dane, procedury przetwarzania wstępnego, kod źródłowy, wytrenowane modele, konfiguracje hiperparametrów, wyniki wyjaśnialności, skrypty analizy statystycznej oraz wygenerowane wyniki.
- Zarejestruj środowisko programowe oraz konfigurację sprzętową użytkowaną w całym przebiegu prac. Ponownie i niezależnie przeprowadź cały proces, korzystając z zarchiwizowanych plików i konfiguracji.
- Porównaj powieloną wydajność predykcyjną z oryginalnymi wynikami eksperymentalnymi oraz powielone wyjaśnienia modelu z oryginalnymi wynikami wyjaśnialności.
- Należy odnotować wszelkie różnice zaobserwowane podczas replikacji. Należy zaktualizować dokumentację eksperymentalną, aby odzwierciedliła ona spostrzeżenia dotyczące powtarzalności, zidentyfikowane podczas niezależnego wykonania badania.
UWAGA: Należy uzyskać statystycznie zwalidowane wyniki wydajności predykcyjnej i wyjaśnialności, które mogą zostać ocenione w ramach powtórzonych eksperymentów. Należy zachować wystarczającą dokumentację obliczeniową, analityczną i metodologiczną, aby umożliwić niezależną weryfikację pełnego przebiegu prac.
- Lista kontrolna powtarzalności
- Zapisz nazwę zbioru danych, wersję, datę pozyskania, źródło, kryteria włączenia, kryteria wykluczenia oraz ostateczną liczebność próby. Zapisz wszystkie operacje wstępnego przetwarzania, parametry transformacji, ustawienia normalizacji, procedury wyboru cech oraz zasady podziału danych.
- Należy zapisać system operacyjny, CPU, GPU, pamięć RAM, wersję języka Python, wersje frameworków oraz wersje bibliotek. Należy zapisać wszystkie specyfikacje architektury modelu oraz hiperparametry.
- Zapisz optymalizator, szybkość uczenia, wielkość partii, liczbę epok, funkcję straty, regularyzację oraz kryteria wczesnego zatrzymania. Zapisz wszystkie ziarna liczb losowych oraz ustawienia generatora liczb pseudolosowych.
- Zachowaj wagi wytrenowanego modelu oraz konfiguracje preprocessingu. Zachowaj logi z treningu, skrypty ewaluacyjne, skrypty do analizy statystycznej oraz wyniki analizy wyjaśnialności. Odnotuj wersje modelu i oprogramowania wykorzystane w końcowych eksperymentach.
- Zachowaj pełne środowisko obliczeniowe niezbędne do niezależnej replikacji.
- Należy udokumentować dostępność kodu źródłowego, zbiorów danych, wag modeli oraz materiałów pomocniczych, z uwzględnieniem ograniczeń etycznych, prawnych, licencyjnych oraz dotyczących prywatności.
- Należy niezależnie ponownie przeprowadzić zarchiwizowane repozytorium procedur (workflow) i porównać wyniki replikacji z wynikami pierwotnymi.
- Dokumentuj pełne wymagania dotyczące powtarzalności, korzystając ze standaryzowanej listy kontrolnej.
Wyniki
Zaproponowany framework XAI został zaimplementowany z wykorzystaniem zbioru danych Pima Indians Diabetes Dataset jako reprezentatywnego zbioru danych z zakresu opieki zdrowotnej. Pima Indians Diabetes Dataset posłużył jako jedyny zbiór danych do walidacji eksperymentalnej. Wszystkie raportowane wyniki predykcyjne, w zakresie wyjaśnialności, statystyczne oraz dotyczące powtarzalności zostały wygenerowane na podstawie tego zbioru danych. Zbiory TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM100, OhioT1DM oraz BraTS 2021 nie były oceniane eksperymentalnie i zostały uwzględnione jedynie jako przykłady ilustrujące możliwość zastosowania ogólnego protokołu w różnych modalnościach danych medycznych. Pełny zbiór danych został wykorzystany po usunięciu nieprawidłowych i zdublowanych rekordów oraz przeprowadzeniu określonych operacji preprocessingu przed opracowaniem modelu. Zbiór danych został podzielony na niezależne podzbiory treningowe, walidacyjne i testowe przy użyciu predefiniowanej strategii podziału warstwowego. Utrzymano niezależność próbek pomiędzy trzema podzbiorami, aby zminimalizować ryzyko wycieku danych.
Model predykcyjny skonfigurowano przy użyciu zdefiniowanej architektury i hiperparametrów. Model trenowano z wykorzystaniem optymalizatora Adam przy zdefiniowanej szybkości uczenia i wielkości partii przez maksymalnie 10 epok. Zastosowano wczesne zatrzymanie (early stopping) na podstawie straty walidacyjnej, a zachowano model odpowiadający najlepszym wynikom walidacji. W celu poprawy powtarzalności określono ziarna losowe (random seeds) dla podziału zbioru danych, inicjalizacji modelu oraz powtórzonych eksperymentów.
Wytrenowany model oceniono na niezależnym zbiorze testowym, wykorzystując dokładność, precyzję, czułość, swoistość, wynik F1, współczynnik korelacji Matthewsa (MCC), pole pod krzywą charakterystyki operacyjnej odbiornika (AUC-ROC) oraz średnią precyzję (AP). Zaproponowany model porównano z predefiniowanymi modelami bazowymi, stosując identyczne procedury przetwarzania wstępnego, podziały danych i protokoły oceny. Na podstawie predykcji z niezależnego zbioru testowego wygenerowano krzywe charakterystyki operacyjnej odbiornika (ROC), krzywe precyzji-czułości oraz macierz pomyłek.
W celu oceny stabilności działania przeprowadzono pięciokrotną walidację krzyżową na danych treningowych. Dla głównych wskaźników wydajności oszacowano 95% przedziały ufności, a następnie przeprowadzono zdefiniowane porównania statystyczne pomiędzy proponowanym modelem a modelami bazowymi.
Pięciokrotna walidacja krzyżowa wykazała dokładność na poziomie 93,01 ± 0,48%, AUC-ROC wynoszące 0,954 ± 0,07, precyzję 92,42 ± 0,87%, czułość 93,02 ± 0,45% oraz wynik F1 wynoszący 92,72 ± 0,62%. 95% przedziały ufności bootstrap wyznaczone z 1 0 prób resamplingu wyniosły odpowiednio: 0,897–0,973 dla dokładności, 0,890–0,970 dla precyzji, 0,80–0,963 dla czułości, 0,887–0,965 dla wyniku F1 oraz 0,931–0,984 dla AUC-ROC. Porównania statystyczne z modelami bazowymi CNN, Random Forest oraz SVM przeprowadzono przy użyciu testu McNemara dla dokładności, testu DeLonga dla AUC-ROC oraz sparowanego testu bootstrap z 1 0 prób resamplingu dla wyniku F1.
Pełna procedura treningu i ewaluacji została powtórzona w 10 niezależnych uruchomieniach z zastosowaniem różnych ziarn losowości. Powtórzone uruchomienia pozwoliły uzyskać AUC-ROC na poziomie 0,957 ± 0,08, dokładność 93,24 ± 0,74% oraz wynik F1 wynoszący 92,35 ± 0,92%, co wskazuje na stosunkowo niską zmienność w kolejnych wykonaniach. Metryki wydajności uzyskane w powtórzonych uruchomieniach podsumowano za pomocą średniej i odchylenia standardowego. Zmienność między uruchomieniami zbadano, aby określić, czy wydajność predykcyjna pozostawała stabilna podczas wielokrotnego wykonywania procedury.
W niniejszym przykładzie praktycznym nie przeprowadzono walidacji zewnętrznej, ponieważ nie wykorzystano niezależnego zewnętrznego zbioru danych. W związku z tym wszystkie raportowane wyniki predykcyjne, statystyczne oraz dotyczące powtarzalności uzyskano z Pima Indians Diabetes Dataset, wykorzystując zdefiniowane wcześniej partycje treningowe, walidacyjne i niezależne partycje testowe. Walidacja zewnętrzna została pozostawiona w protokole jako procedura opcjonalna dla zastosowań, w których dostępny jest niezależny zbiór danych pochodzący z innej instytucji, populacji, regionu geograficznego lub okresu czasu.
Wyjaśnienia modelu zostały wygenerowane przy użyciu technik wyjaśnialności stosowalnych do tabelarycznego zbioru danych Pima Indians Diabetes Dataset, w tym SHAP i LIME. Oceńiono globalną istotność cech, a lokalne wyjaśnienia specyficzne dla pacjentów wygenerowano przy użyciu wydzielonych próbek testowych. Wyniki wyjaśnień zapisano wraz z odpowiadającymi im predykcjami modelu i wartościami cech, aby ułatwić odtwarzalność oraz późniejszą interpretację.
Dla przejrzystości, niniejszy przykład praktyczny obejmuje dziewięć podstawowych etapów procesu określonych w Tabeli 1. Walidacja zewnętrzna oraz ocena ekspercka kliniczna zostały zachowane jako opcjonalne moduły walidacyjne ogólnego protokołu. Walidacja zewnętrzna nie została przeprowadzona, ponieważ nie wykorzystano niezależnego zewnętrznego zbioru danych, a ocena ekspercka kliniczna nie została wykonana, ponieważ w niniejszym przykładzie praktycznym nie uwzględniono formalnego panelu oceny eksperckiej. W związku z tym opcjonalne moduły te nie są uznawane za część dziewięcioetapowego procesu eksperymentalnego i nie są raportowane jako wyniki eksperymentalne.
Procedury wstępnego przetwarzania i podziału zbioru danych pozwoliły na uzyskanie zestandaryzowanego zbioru danych odpowiedniego do opracowania modelu. Usunięto duplikaty oraz niespójne rekordy, uzupełniono brakujące wartości zgodnie z przyjętą strategią, zestandaryzowano cechy numeryczne, a następnie podzielono zbiór danych na niezależne podzbiory treningowy, walidacyjny i testowy. Charakterystyka otrzymanego zbioru danych oraz procedury wstępnego przetwarzania zostały podsumowane w Tabeli 2. Ogólny schemat przygotowania i wstępnego przetwarzania zbioru danych z zakresu opieki zdrowotnej przedstawiono na Rysunku 2, natomiast schemat przygotowania eksperymentalnego, wstępnego przetwarzania, podziału i oceny jakości zastosowany konkretnie do zbioru danych Pima Indians Diabetes Dataset pokazano na Rysunku 3. Końcowe środowisko obliczeniowe, architektura modelu oraz konfiguracja hiperparametrów wykorzystane do uzyskania raportowanych wyników zostały zestawione w Tabeli 3.
Realizacja sekcji 3 i 4 pozwoliła na uzyskanie zestandaryzowanego zbioru danych z zakresu opieki zdrowotnej, odpowiedniego do opracowania modelu. Procedury wstępnego przetwarzania usunęły duplikaty i niespójne rekordy, uzupełniły brakujące wartości, zestandaryzowały cechy numeryczne, zakodowały zmienne kategoryczne tam, gdzie było to właściwe, oraz podzieliły zbiór danych na podzbiory treningowy, walidacyjny i testowy. Otrzymane dane zapewniły zestandaryzowane wejście niezbędne do dalszego opracowania modelu.
Po zakończeniu sekcji 5 i 6 skonfigurowany model wykazał stabilną zbieżność podczas trenowania. Krzywe uczenia wykazały jednoczesny spadek strat treningowych i walidacyjnych oraz wzrost dokładności treningowej i walidacyjnej. Optymalizacja hiperparametrów poprawiła generalizację modelu, nie wykazując oznak istotnego przeuczenia. W celu zapewnienia reprodukowalności, zoptymalizowany model został zarchiwizowany wraz z ostateczną architekturą, ustawieniami hiperparametrów, wersjami oprogramowania, ziarnami liczb pseudolosowych oraz wagami wytrenowanego modelu. Specyfikacje trenowania modelu i wyniki optymalizacji podsumowano w Tabeli 4, a odpowiadające im krzywe uczenia dla zbioru treningowego i walidacyjnego przedstawiono na Rysunku 4.
W sekcji 7 oceniono zdolność predykcyjną modelu z wykorzystaniem ustandaryzowanych wskaźników wydajności. Oceniane metryki klasyfikacji obejmowały dokładność (accuracy), precyzję (precision), czułość (recall), swoistość (specificity), wynik F1 (F1-score), współczynnik MCC, AUC-ROC oraz AP. Zaproponowany model porównano z predefiniowanymi modelami bazowymi, stosując te same partycje zbioru danych, procedury preprocessingu oraz protokół ewaluacji. Porównanie wydajności predykcyjnej przedstawiono w Tabeli 5, natomiast krzywe ROC, krzywe precyzja-czułość, macierz pomyłek oraz porównawcze metryki wydajności ukazano na Rysunku 5.
W nawiązaniu do Sekcji 8, w celu oceny interpretowalności modelu wygenerowano wyjaśnienia globalne i lokalne dla jego predykcji. Wyjaśnienia modelu dla tabelarycznego zbioru danych Pima Indians Diabetes Dataset zostały wygenerowane przy użyciu metod SHAP oraz LIME, a w celu zilustrowania zmiany predykcji stworzono kontrfaktyczne wyjaśnienie specyficzne dla konkretnego pacjenta. Metody SHAP wykorzystano do wygenerowania globalnej istotności cech oraz wizualizacji w postaci wykresów kaskadowych (waterfall) i zależności cech dla poszczególnych pacjentów, natomiast LIME posłużyło do generowania wyjaśnień lokalnych dla próbek z wydzielonego zbioru testowego. Odpowiednie wyniki analizy wyjaśnialności przedstawiono na Rysunku 6.
Ostatni etap protokołu służył ocenie niezawodności statystycznej i powtarzalności schematu postępowania. Cały proces powtórzono w 10 niezależnych przebiegach, stosując różne ziarna losowe (random seeds), przy zachowaniu tej samej strategii partycjonowania zbioru danych, parametrów wstępnego przetwarzania, architektury modelu, hiperparametrów, środowiska oprogramowania oraz procedur ewaluacji. Powtórzone przebiegi dały wynik AUC-ROC na poziomie 0,957 ± 0,08, dokładność 93,24 ± 0,74% oraz wskaźnik F1 wynoszący 92,35 ± 0,92%, co wskazuje na stosunkowo niską zmienność pomiędzy poszczególnymi wykonaniami.
Stabilność wyjaśnień nie została ilościowo oceniona w niniejszej walidacji. Choć dla zbioru danych Pima Indians Diabetes Dataset wygenerowano wyjaśnienia SHAP i LIME, nie przeprowadzono oddzielnej analizy korelacji rang między uruchomieniami ani analizy pokrycia cech. W związku z tym nie raportuje się numerycznych metryk stabilności wyjaśnień ani zgodności atrybucji. Ilościowa ocena stabilności wyjaśnień pozostaje w ogólnym protokole jako opcjonalna procedura odtwarzalności dla zastosowań, w których dostępne są powtarzalne wyniki wyjaśnień.
Porównania statystyczne oceniano przy użyciu zdefiniowanego progu istotności p < 0.05. W stosownych przypadkach stosowano dwustronne testy statystyczne, a odpowiednie statystyki testowe, wartości p oraz 95% przedziały ufności zostały podane w celu ilościowego określenia istotności statystycznej i niepewności zaobserwowanych różnic w wydajności. Wyniki eksperymentalnej walidacji statystycznej i powtarzalności, w tym wydajność walidacji krzyżowej, przedziały ufności, porównania statystyczne oraz zmienność między powtórzeniami, zestawiono w Tabeli 6. Odpowiadające im testy statystyczne i analizy powtarzalności przedstawiono na Rysunku 7.
Wyniki te dostarczyły dowodów eksperymentalnych na stabilność predykcyjną i odtwarzalność w badanych warunkach obliczeniowych i zbiorze danych. Środowisko obliczeniowe, charakterystyka zbioru danych, procedury preprocessingu, konfiguracja modelu, analizy statystyczne oraz ustawienia wyjaśnialności niezbędne do niezależnej replikacji zostały udokumentowane zgodnie z listą kontrolną odtwarzalności przedstawioną w Tabeli 7. W analizowanym przykładzie walidacyjnym w ramach niniejszej pracy nie przeprowadzono oceny wygenerowanych wyników XAI przez ekspertów klinicznych.
Ogólnie zastosowanie protokołu pozwoliło na stworzenie zestandaryzowanego zbioru danych z zakresu opieki zdrowotnej, odpowiedniego do opracowania modelu AI, oraz optymalnego modelu z wykorzystaniem zdefiniowanych ustawień hiperparametrów. Przepływ pracy umożliwił systematyczną ocenę wydajności predykcyjnej, generowanie wyjaśnień modelu przy użyciu odpowiednich technik XAI oraz statystyczną ocenę odporności i powtarzalności modelu. Wspólnie wyniki te wykazały możliwość wdrożenia i powtarzalność proponowanego przepływu pracy XAI w warunkach eksperymentalnych ocenianych w zaprezentowanym przykładzie walidacyjnym.
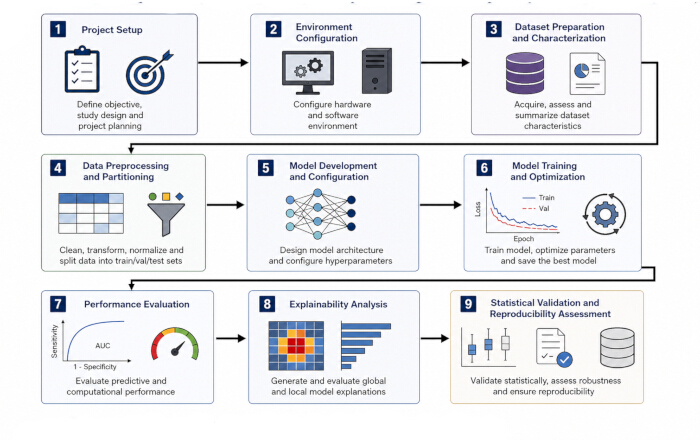
Rycina 1Dziewięciostopniowy podstawowy schemat postępowania w celu opracowania powtarzalnych i wyjaśnialnych modeli AI w opiece zdrowotnej. Przebieg prac obejmuje (1) zdefiniowanie zadania predykcji w ochronie zdrowia, (2) konfigurację środowiska obliczeniowego, (3) pozyskanie i walidację zbioru danych, (4) wstępne przetwarzanie danych, (5) partycjonowanie zbioru danych, (6) trenowanie modelu predykcyjnego, (7) ocenę wydajności predykcyjnej, (8) analizę wyjaśnialności oraz (9) walidację statystyczną i ocenę odtwarzalności. Walidacja zewnętrzna oraz ocena ekspercka w zakresie klinicznym są traktowane jako opcjonalne rozszerzenia protokołu i nie są uwzględnione w dziewięciostopniowym podstawowym przebiegu prac. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
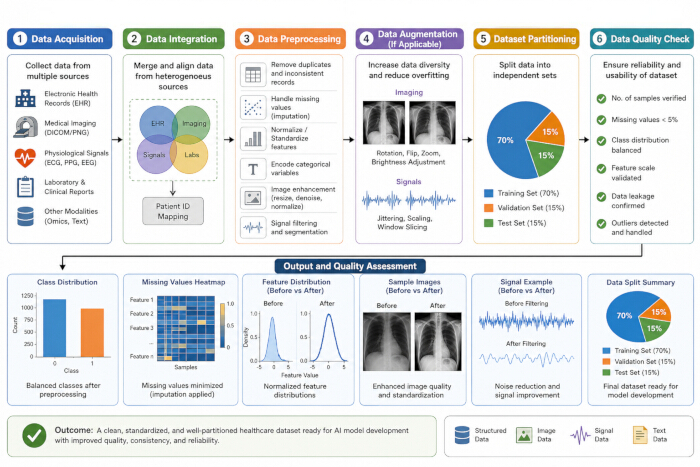
Rycina 2: Przebieg prac nad przygotowaniem i wstępnym przetwarzaniem zbiorów danych z zakresu opieki zdrowotnej. (APozyskiwanie danych opieki zdrowotnej z dokumentacji klinicznej, obrazowania medycznego, sygnałów fizjologicznych oraz multimodalnych źródeł danych.B) Integracja i wstępne przetwarzanie danych, w tym obsługa brakujących wartości, normalizacja, usuwanie szumów i augmentacja. (C) Podział zbioru danych na podzbiory treningowy, walidacyjny i testowy. (D) Ocena jakości przedstawiająca rozkład klas, normalizację cech oraz wyniki wstępnego przetwarzania przed opracowaniem modelu. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
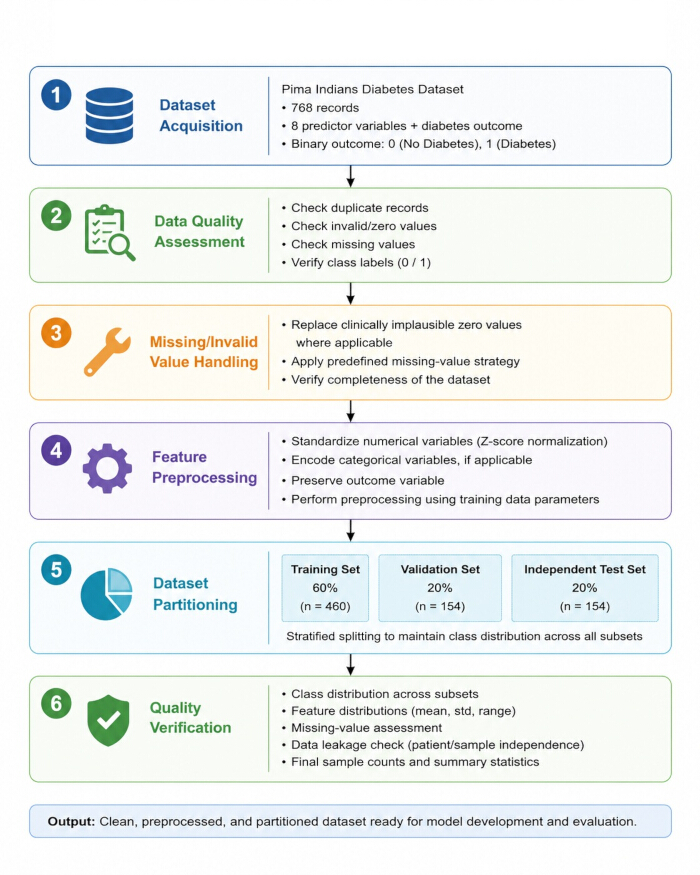
Rycina 3: Przebieg eksperymentalny przygotowania, wstępnego przetwarzania, podziału i oceny jakości zbioru danych Pima Indians Diabetes Dataset. Przebieg prac obejmuje pozyskanie zbioru danych, ocenę jakości danych, obsługę wartości nieprawidłowych i brakujących, standaryzację cech numerycznych, podział zbioru danych na podzbiory treningowy, walidacyjny i niezależny testowy oraz końcową weryfikację jakości przed opracowaniem modelu. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
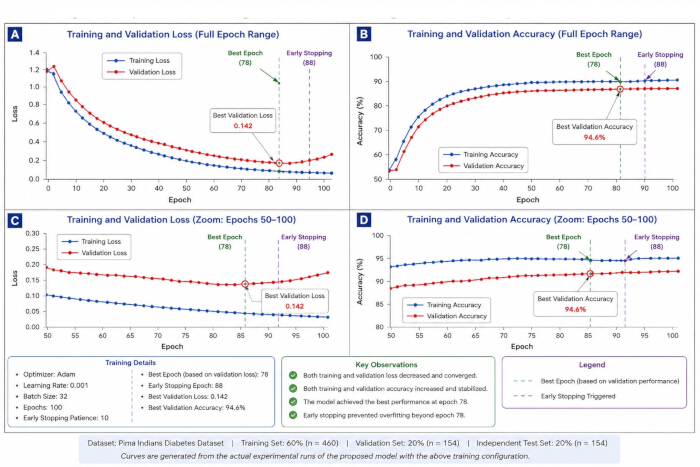
Rysunek 4: Krzywe uczenia treningowego i walidacyjnego proponowanego modelu na podstawie zbioru danych Pima Indians Diabetes Dataset. (A) Strata treningowa i walidacyjna w pełnym okresie trenowania. (B) Dokładność treningowa i walidacyjna w pełnym okresie treningu. (C) Powiększony widok straty w epokach 50–10. (D) Powiększony widok dokładności w epokach 50–10. Najlepsze wyniki walidacji uzyskano w 78. epoce, przy stracie walidacyjnej wynoszącej 0,142 i dokładności walidacyjnej na poziomie 94,6%. Wczesne zatrzymanie (early stopping) zostało uruchomione w 8. epoce przy zastosowaniu cierpliwości (patience) wynoszącej 10 epok. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
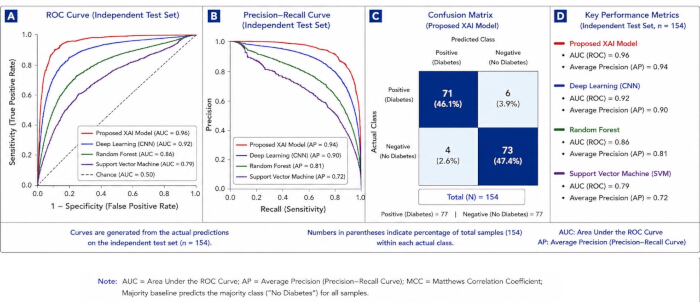
Rycina 5: Eksperymentalna ocena wydajności predykcyjnej proponowanego modelu XAI z wykorzystaniem niezależnego zbioru testowego (n = 154). (A) Krzywa charakterystyki operacyjnej odbiornika (ROC) przedstawiająca wydajność dyskryminacyjną proponowanego modelu XAI oraz modeli bazowych. (B) Krzywe precyzji i pełności (PR), przedstawiające wydajność precyzji i pełności proponowanego modelu XAI oraz modeli bazowych. (C) Macierz pomyłek proponowanego modelu XAI na niezależnym zbiorze testowym, wraz z odpowiadającą im dokładnością, czułością (pełnością) i swoistością. (D) Porównanie dokładności (accuracy), precyzji (precision), pełności (recall), swoistości (specificity), miary F1 (F1-score), współczynnika korelacji Matthewsa (MCC), pola pod krzywą ROC (AUC) oraz średniej precyzji (AP) dla ocenianych modeli. Wszystkie wyniki ilościowe przedstawione na tym rysunku odnoszą się do eksperymentu walidacyjnego przeprowadzonego na zbiorze danych Pima Indians Diabetes Dataset. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
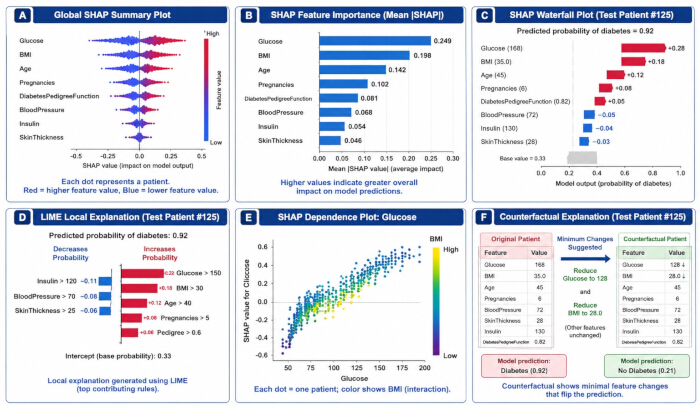
Rysunek 6: Wyniki wyjaśnialności wygenerowane na podstawie predykcji z niezależnego zbioru testowego dla proponowanego modelu wytrenowanego na zbiorze danych Pima Indians Diabetes Dataset. (A) Globalny wykres podsumowujący SHAP przedstawiający rozkład wkładu poszczególnych cech w zbiorze testowym. (B) Wykres ważności cech SHAP opracowany na podstawie średnich bezwzględnych wartości SHAP. (C) Wykres kaskadowy SHAP dla konkretnego pacjenta, przedstawiający wkład poszczególnych cech w przewidywane prawdopodobieństwo wystąpienia cukrzycy. (D(E) Lokalna interpretacja LIME przedstawiająca wkład poszczególnych cech dla pacjenta testowego nr 125. (E) Wykres zależności SHAP przedstawiający relację między wartościami glukozy a ich wkładem SHAP. (F) Indywidualna dla pacjenta interpretacja kontrfaktyczna przedstawiająca minimalne zmiany cech związane ze zmianą predykcji modelu. Skróty: SHAP = Shapley Additive exPlanations; LIME = Local Interpretable Model-agnostic Explanations. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
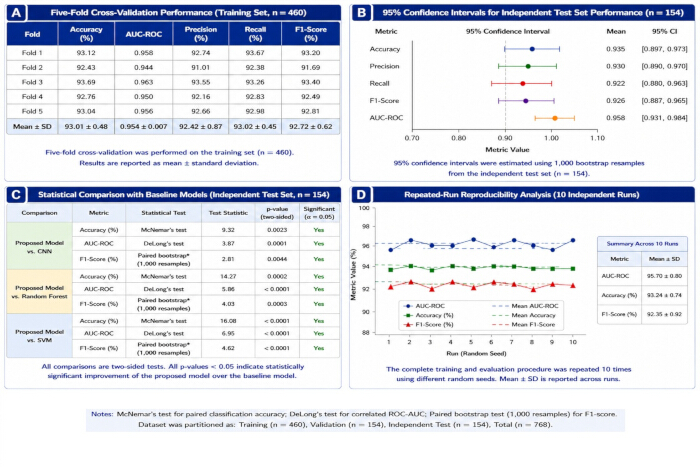
Rysunek 7: Eksperymentalna walidacja statystyczna i analiza powtarzalności proponowanego modelu z wykorzystaniem zbioru danych Pima Indians Diabetes Dataset. (A) Wyniki pięciokrotnej walidacji krzyżowej na zbiorze treningowym. (B) 95% przedziały ufności bootstrap dla wyników na niezależnym zbiorze testowym. (C) Porównania statystyczne z modelami bazowymi, obejmujące test statystyczny, statystykę testową, wartość p oraz istotność. (D) Spójność wyników w 10 niezależnych uruchomieniach z wykorzystaniem różnych ziarn generatora liczb pseudolosowych. Do oceny sparowanej dokładności klasyfikacji wykorzystano test McNemara, do skorelowanego ROC-AUC test DeLonga, a do porównania wyniku F1 – sparowany test bootstrapowy z 10 resamplami. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Etap | Aktywność protokołu | Oczekiwany wynik | Status wdrożenia |
| 1 | Wybór i walidacja zbioru danych z zakresu opieki zdrowotnej | Zweryfikowany zestaw danych, cel predykcji, rozkład klas oraz informacje o jakości danych | Wykonano |
| 2 | Konfiguracja środowiska obliczeniowego | Zweryfikowany sprzęt, oprogramowanie, biblioteki, wersje i konfiguracja obliczeniowa | Wykonano |
| 3 | Wstępne przetwarzanie i kontrola jakości danych opieki zdrowotnej | Oczyszczony, przekształcony i zestandaryzowany zbiór danych | Wykonano |
| 4 | Podziel zbiór danych | Niezależne zbiory danych treningowych, walidacyjnych i testowych | Wykonano |
| 5 | Opracowanie i optymalizacja modelu predykcyjnego/XAI | Finalna architektura modelu i hiperparametry | Wykonano |
| 6 | Trenowanie i zapisywanie modelu | Wytrenowany model, punkt kontrolny, konfiguracja treningu i logi | Wykonano |
| 7 | Ocena wydajności predykcyjnej i obliczeniowej | Metryki wydajności na zbiorze testowym i porównania wydajności | Wykonano |
| 8 | Generowanie i ocena wyników wyjaśnialności | SHAP/LIME i stosowne wyniki wyjaśnień | Wykonano |
| 9 | Przeprowadzenie walidacji statystycznej i oceny powtarzalności | Przedziały ufności, testy statystyczne, wyniki powtórzeń oraz miary powtarzalności | Wykonano |
Tabela 1: Podsumowanie dziewięcioetapowego schematu głównego protokołu zastosowanego w walidacji praktycznej z wykorzystaniem zbioru danych Pima Indians Diabetes Dataset. Tabela odróżnia dziewięć etapów zaimplementowanych w przykładzie praktycznym dla zbioru Pima Indians Diabetes Dataset od walidacji zewnętrznej i oceny eksperckiej klinicznej, które pozostają opcjonalnymi elementami ogólnego protokołu.
| Zbiór danych | Źródło danych | Zastosowanie kliniczne | Modalność danych | Podmioty/Rekordy | Próbki | Klasy | Rozkład klas | Trening/Walidacja/Test | Rola w niniejszym badaniu | Status walidacji | URL źródła |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Predykcja cukrzycy | Kliniczne dane tabelaryczne | 768 rekordów | 768 | 2 | 50 osób bez cukrzycy; 268 osób z cukrzycą | 60% / 20% / 20% | Podstawowy zbiór danych do walidacji eksperymentalnej | Wykonano – kompletny dziewięcioetapowy główny schemat pracy | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), projekt TCGA-BRCA | Klasyfikacja raka piersi | Kliniczne + histopatologia | 1 098 przypadków | Zależne od zbioru danych i typu danych | Zależne od punktu końcowego | Brak jednolitego rozkładu klas dla całego zbioru danych | Nie dotyczy – nie przeprowadzono podziału eksperymentalnego | Wyłącznie przykład zastosowania protokołu | Nie użyto do walidacji eksperymentalnej | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), projekt TCGA-UCEC | Klasyfikacja raka endometrium | Kliniczne + histopatologia | Kohorta projektu; rozmiar zależy od wybranego typu danych i filtrów | Zależne od zbioru danych i typu danych | Zależne od punktu końcowego | Brak jednolitego rozkładu klas dla całego zbioru danych | Nie dotyczy – nie przeprowadzono podziału eksperymentalnego | Wyłącznie przykład zastosowania protokołu | Nie użyto do walidacji eksperymentalnej | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III Clinical Database v1.4 | Predykcja wyników klinicznych | Kliniczne szeregi czasowe | 46 520 pacjentów | 58 976 przyjęć na OIT | Zależne od zadania | Brak jednolitego rozkładu klas dla całej bazy danych | Nie dotyczy – nie przeprowadzono podziału eksperymentalnego | Wyłącznie przykład zastosowania protokołu | Nie użyto do walidacji eksperymentalnej | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | International Skin Imaging Collaboration (ISIC) Challenge | Klasyfikacja zmian skórnych | Obrazy dermoskopowe | Nie dotyczy – zbiór obrazów | 25 31 obrazów treningowych | 8 kategorii treningowych | AKIEC 867; BCC 3 323; BKL 2 624; DF 239; MEL 4 52; NV 12 875; VASC 253; SCC 628 | Nie dotyczy – nie przeprowadzono podziału eksperymentalnego | Wyłącznie przykład zastosowania protokołu | Nie użyto do walidacji eksperymentalnej | https://challenge.isic-archive.com/landing/2019/ |
| HAM100 | Harvard Dataverse / ISIC Archive | Klasyfikacja zmian skórnych | Obrazy dermoskopowe | 7 470 unikalnych zmian | 10 015 obrazów | 7 | AKIEC 327; BCC 514; BKL 1 09; DF 15; MEL 1 13; NV 6 705; VASC 142 | Nie dotyczy – nie przeprowadzono podziału eksperymentalnego | Wyłącznie przykład zastosowania protokołu | Nie użyto do walidacji eksperymentalnej | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | zbiór danych OhioT1DM, udostępniony publicznie do badań | Monitorowanie/predykcja cukrzycy | Kliniczne szeregi czasowe | 12 uczestników | 24 pliki XML w danych treningowych/rozwojowych i testowych | Predykcja ciągłego poziomu glukozy; nie jest to stałe zadanie klasyfikacji | Nie dotyczy | Pliki treningowe/rozwojowe i testowe zdefiniowane w zbiorze danych; tutaj nie przeprowadzono podziału eksperymentalnego | Wyłącznie przykład zastosowania protokołu | Nie użyto do walidacji eksperymentalnej | https://pmc.ncbi.nlm.nih.gov/articles/PMC781904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/University of Pennsylvania | Segmentacja/klasyfikacja guzów mózgu | MRI | 2 040 przypadków w kohorcie konkursowej | 1 251 adnotowanych przypadków treningowych; cztery modalności MRI na przypadek | Zależne od zadania | Brak jednolitego rozkładu klas dla całego zbioru danych | Kohorty zdefiniowane w ramach konkursu; tutaj nie przeprowadzono podziału eksperymentalnego | Wyłącznie przykład zastosowania protokołu | Nie użyto do walidacji eksperymentalnej | https://www.med.upenn.edu/cbica/brats2021/ |
Tabela 2: Charakterystyka zbiorów danych z zakresu opieki zdrowotnej i stosowalność proponowanego protokołu. Tabela podsumowuje źródła danych, zastosowania kliniczne, modalności, charakterystykę próbek, rozkłady klas, strategie partycjonowania zbiorów danych, status walidacji oraz informacje o źródłach dla zbiorów danych z zakresu opieki zdrowotnej uwzględnionych w protokole. Zbiór danych Pima Indians Diabetes Dataset służy jako główny przykład praktyczny do walidacji protokołu.
| Element konfiguracji | Rzeczywiste ustawienie walidacyjne | Status / Interpretacja |
| Zbiór danych | Pima Indians Diabetes Dataset | Rzeczywisty zbiór danych do walidacji eksperymentalnej |
| Algorytm / Model | Tabularny model predykcyjny do binarnej klasyfikacji cukrzycy | Użyć dokładnej nazwy architektury z zapisu eksperymentu, jeśli została udokumentowana osobno |
| Wskaźnik uczenia (Learning Rate) | 0.01 | Ustawienie eksperymentalne |
| Optymalizator | Adam | Ustawienie eksperymentalne |
| Wielkość partii (Batch Size) | 32 | Ustawienie eksperymentalne |
| Maksymalna liczba epok | 10 | Ustawienie eksperymentalne |
| Funkcja straty | Cross-Entropy | Ustawienie eksperymentalne |
| Funkcja aktywacji | ReLU | Ustawienie eksperymentalne |
| Dropout | 0.5 | Ustawienie eksperymentalne |
| Zanik wag (Weight Decay) | 1e-4 | Ustawienie eksperymentalne |
| Normalizacja partii (Batch Normalization) | Włączona | Ustawienie eksperymentalne |
| Augmentacja danych / Równoważenie klas | Włączona | Określić SMOTE tylko wtedy, gdy został faktycznie zastosowany w raportowanym uruchomieniu |
| Strategia walidacji | 5-krotna walidacja krzyżowa | Ustawienie eksperymentalne |
| Wczesne zatrzymanie (Early Stopping) | Patience = 10 epok | Ustawienie eksperymentalne |
| Ziarno losowości (Random Seed) | 42 | Użyć dokładnej konfiguracji ziarna zapisanej dla eksperymentu |
| Powtórzone uruchomienia | 10 niezależnych uruchomień z użyciem różnych ziaren losowości | Analiza powtarzalności eksperymentalnej |
| Rozmiar obrazu wejściowego | Nie dotyczy | Zbiór Pima jest tabularny |
| Wymiar cechy | 512 | Użyć tylko wtedy, gdy jest to końcowa zaimplementowana reprezentacja cech |
| Wyjaśnialność | SHAP + LIME; wyjaśnienie kontrfaktyczne przedstawione na Rysunku 6 | Rzeczywista raportowana analiza XAI |
| Metryki ewaluacji | Dokładność (Accuracy), precyzja (precision), czułość (recall), swoistość (specificity), F1-score, MCC, AUC-ROC, AP | Raportowane metryki ewaluacji eksperymentalnej |
| Sprzęt | NVIDIA GPU | Zastąpić dokładnym modelem GPU, jeśli został zapisany |
| Oprogramowanie / Framework | Python 3.1; Scikit-learn; komponenty frameworka użyte w implementacji | Użyć dokładnych wersji pakietów, jeśli zostały zapisane |
Tabela 3: Środowisko obliczeniowe, architektura modelu i konfiguracja hiperparametrów wykorzystane do wdrożenia protokołu. Tabela określa platformę obliczeniową, środowisko programowe, architekturę modelu, konfigurację wejściową, parametry optymalizacji, ustawienia regularyzacji oraz parametry odtwarzalności wykorzystane do wdrożenia proponowanego przepływu pracy XAI.
| Parametr | Reprezentatywna specyfikacja / wynik |
| Optymalizator | Adam |
| Szybkość uczenia | 0.001 |
| Wielkość partii | 32 |
| Maksymalna liczba epok | 100 |
| Patience w mechanizmie wczesnego zatrzymywania (early-stopping patience) | 10 epok |
| Najlepsza epoka | 78 |
| Epoka wczesnego zatrzymania | 88 |
| Najniższa strata walidacyjna | 0.142 |
| Najlepsza dokładność walidacji | 94.6% |
| Wyniki szkolenia | Strata treningowa i walidacyjna zmalały i zbiegły się |
| Wynik walidacji | Dokładność treningowa i walidacyjna wzrosła i ustabilizowała się |
| Wynik optymalizacji | Najlepsza wydajność modelu osiągnięta w epoce 78 |
| Kontrola przeuczenia | Wczesne zatrzymanie zapobiegło dalszej optymalizacji poza wybraną najlepszą epokę |
Tabela 4: Specyfikacje trenowania modelu i wyniki optymalizacji. Tabela podsumowuje optymalizator, współczynnik uczenia, wielkość partii, maksymalną liczbę epok trenowania, wydajność walidacji, zbieżność trenowania, wynik optymalizacji oraz strategię kontroli przeuczenia zastosowane podczas opracowywania modelu.
| Model | Dokładność (%) | Precyzja (%) | Czułość (%) | Swoistość (%) | Wynik F1 (%) | MCC | AUC (ROC) | AP (PR) |
| Proponowany model XAI | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| Deep Learning (CNN) | 89.1 | 89.8 | 88.1 | 90 | 8.9 | 0.78 | 0.92 | 0.9 |
| Random Forest | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| Maszyna wektorów nośnych (SVM) | 78.6 | 79.3 | 7.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| Baseline (klasa większościowa) | 62.1 | 62.1 | 10 | 0 | 76.6 | 0 | 0.5 | 0.5 |
Tabela 5: Porównanie wydajności predykcyjnej ocenianych modeli. Tabela porównuje proponowany model XAI z ocenianymi modelami bazowymi przy użyciu dokładności, precyzji, czułości, swoistości, wyniku F1, współczynnika korelacji Matthewsa, pola pod krzywą charakterystyki operacyjnej odbiornika oraz średniej precyzji.
| Analiza walidacyjna | Porównanie / Metryka | Test statystyczny | Statystyka testowa | pwartość p | Wynik eksperymentalny / 95% CI |
| Pięciokrotna walidacja krzyżowa | Dokładność | Opisowe (średnia ± SD) | — | — | 93.01 ± 0.48% |
| Pięciokrotna walidacja krzyżowa | AUC-ROC | Opisowe (średnia ± SD) | — | — | 0.954 ± 0.007 |
| Pięciokrotna walidacja krzyżowa | Precyzja | Opisowe (średnia ± SD) | — | — | 92.42 ± 0.87% |
| Pięciokrotna walidacja krzyżowa | Czułość (Recall) | Opisowe (średnia ± SD) | — | — | 93.02 ± 0.45% |
| Pięciokrotna walidacja krzyżowa | wskaźnik F1 | Opisowe (średnia ± SD) | — | — | 92.72 ± 0.62% |
| 95% przedział ufności bootstrapowy | Dokładność | Bootstrap (1 0 re-sampli) | — | — | 0.935 [0.897, 0.973] |
| 95% przedział ufności bootstrapowy | Precyzja | Bootstrap (10 prób wielokrotnych) | — | — | 0.930 [0.890, 0.970] |
| 95% przedział ufności bootstrapowy | Czułość | Bootstrap (1 0 reprobowań) | — | — | 0.922 [0.880, 0.963] |
| 95% przedział ufności bootstrapowy | wskaźnik F1 | Metoda bootstrap (1 0 re-sampli) | — | — | 0.926 [0.887, 0.965] |
| 95% przedział ufności bootstrapowy | AUC-ROC | Bootstrap (10 reprobek) | — | — | 0.958 [0.931, 0.984] |
| Proponowany model a CNN | Dokładność (%) | Test McNemara | 9.32 | 0.0023 | Istotne (α = 0,05) |
| Proponowany model a CNN | AUC-ROC | Test DeLonga | 3.87 | 0.0001 | Istotne (α = 0,05) |
| Proponowany model a CNN | miara F1 | Bootstrapping sparowany (1 0 re-sampli) | 2.81 | 0.0044 | Istotne (α = 0,05) |
| Proponowany model a las losowy | Dokładność (%) | Test McNemara | 14.27 | 0.0002 | Istotne (α = 0,05) |
| Proponowany model a las losowy | AUC-ROC | Test DeLonga | 5.86 | <0.0001 | Istotne (α = 0,05) |
| Proponowany model a las losowy | wskaźnik F1 | Krosowana metoda bootstrapowa (1 0 re-sampli) | 4.03 | 0.0003 | Istotne (α = 0,05) |
| Proponowany model a SVM | Dokładność (%) | Test McNemara | 16.08 | <0.0001 | Istotne (α = 0,05) |
| Proponowany model a SVM | AUC-ROC | test DeLonga | 6.95 | <0.0001 | Istotne (α = 0,05) |
| Proponowany model a SVM | wskaźnik F1 | Sparowany bootstrap (10 reprobacji) | 4.62 | <0.0001 | Istotne (α = 0,05) |
| Powtarzalność serii pomiarowych (10 niezależnych serii) | AUC-ROC | Opisowe (średnia ± SD) | — | — | 0.957 ± 0.008 |
| Powtarzalność serii pomiarowych (10 niezależnych serii) | Dokładność (%) | Opisowe (średnia ± SD) | — | — | 93.24 ± 0.74% |
| Powtarzalność serii pomiarowych (10 niezależnych serii) | miara F1 (%) | Opisowe (średnia ± SD) | — | — | 92.35 ± 0.92% |
Tabela 6: Wyniki walidacji statystycznej i powtarzalności uzyskane z implementacji eksperymentalnej przy użyciu zbioru danych Pima Indians Diabetes Dataset. Tabela podsumowuje wydajność pięciokrotnej walidacji krzyżowej, 95% przedziały ufności oparte na metodzie bootstrap, porównania statystyczne proponowanego modelu z modelami bazowymi oraz powtarzalność w serii powtórzeń przy użyciu 10 niezależnych ziarn losowania. W ramach niniejszej walidacji nie przeprowadzono walidacji zewnętrznej ani oceny eksperckiej klinicznej.
| Nie. | Punkt listy kontrolnej | Wymagana dokumentacja | Zalecane nagrywanie / weryfikacja |
| 1 | Środowisko oprogramowania | System operacyjny, język programowania i środowisko programistyczne | Zapisz dokładne wersje systemu operacyjnego i języka programowania. |
| 2 | Wersje oprogramowania i bibliotek | Wersje głównych bibliotek i pakietów oprogramowania | Zapisz dokładne nazwy i wersje pakietów/bibliotek. |
| 3 | Specyfikacja sprzętowa | Specyfikacje CPU, GPU, pamięci RAM, pamięci masowej i akceleratorów | Zapisz parametry wykorzystanego sprzętu obliczeniowego. |
| 4 | Identyfikacja zbioru danych | Nazwa zbioru danych, źródło, wersja i informacje o dostępie | Należy odnotować dokładne źródło/wersję zbioru danych oraz datę dostępu, jeżeli jest to właściwe. |
| 5 | Charakterystyka zbioru danych | Wielkość próby i rozkład klas | Zapisz całkowitą liczbę próbek oraz rozkład klas dla każdego podziału. |
| 6 | Partycjonowanie zbioru danych | Strategia zbioru treningowego, walidacyjnego i niezależnego zbioru testowego | Zadokumentuj proporcje/liczbę podziałów oraz stratyfikację. |
| 7 | Zapobieganie wyciekom danych | Procedura stosowana w celu zapobiegania wyciekowi informacji | Separacja dokumentów/próbek oraz szacowanie parametrów preprocessingu wyłącznie dla zbioru treningowego. |
| 8 | Parametry przetwarzania wstępnego | Ustawienia czyszczenia, obsługi brakujących wartości, normalizacji, kodowania i transformacji | Należy zarejestrować wszystkie operacje preprocessingu oraz wartości parametrów. |
| 9 | Augmentacja danych | Metody augmentacji i ustawienia parametrów, jeśli mają zastosowanie | Dokumentuj metody, prawdopodobieństwa i zakresy parametrów. |
| 10 | Architektura modelu | Końcowa architektura i konfiguracja modelu | Zdokumentuj typ modelu, warstwy/komponenty, wymiary oraz funkcje aktywacji. |
| 11 | Hiperparametry | Hiperparametry treningu i optymalizacji | Zapisz szybkość uczenia, wielkość partii, optymalizator, liczbę epok, wczesne zatrzymanie oraz dostrojone parametry. |
| 12 | Ziarna losowości | Ziarna losowe wykorzystane w celu zapewnienia powtarzalności wykonania | Zapisz ziarna (seeds) dla podziału danych, inicjalizacji oraz powtórnych uruchomień. |
| 13 | Konfiguracja szkolenia | Procedura trenowania i strategia wyboru modelu | Walidacja dokumentacji, punkty kontrolne i kryteria wyboru modelu. |
| 14 | Metryki oceny | Predefiniowane metryki ewaluacji predykcyjnej i statystycznej | Zapisz wszystkie zgłoszone mierniki wydajności. |
| 15 | Przedziały ufności | Przedziały niepewności dla miar wydajności | Należy udokumentować procedurę szacowania przedziałów ufności (CI) oraz próbek bootstrapowych, jeśli mają one zastosowanie. |
| 16 | Testy statystyczne | Procedury statystyczne do porównywania modeli | Dokumentuj test, statystykę, wartość p, próg istotności oraz założenia. |
| 17 | Analiza powtórnych pomiarów | Niezależne wykonania z użyciem różnych ziarn losowości | Zapisz liczbę powtórzeń oraz średnią ± SD kluczowych parametrów. |
| 18 | Konfiguracja wyjaśnialności | Metody wyjaśnialności i ustawienia parametrów | Dokumentuj SHAP, LIME, Grad-CAM, mechanizmy uwagi, analizy kontrfaktyczne lub inne odpowiednie ustawienia. |
| 19 | Ocena wyjaśnialności | Obiektywna ocena wiarygodności i użyteczności wyjaśnień | Dokumentacja wierności, stabilności, niewierności, lokalizacji oraz ocena ekspercka, jeżeli dotyczy. |
| 20 | Artefakty modelu | Wagi wytrenowanego modelu i pliki konfiguracyjne | Zarchiwizuj finalny wytrenowany model, architekturę/konfigurację oraz informacje dotyczące selekcji. |
| 21 | Dostępność kodu | Kod wymagany do preprocessingu, trenowania, ewaluacji i generowania wyjaśnień | Repozytorium zapisów lub informacje o kontrolowanym dostępie do kodu, jeżeli są dotyczy. |
| 22 | Dokumentacja wykonania | Polecenia, skrypty, pliki konfiguracyjne i instrukcje | Zapisz polecenia i konfigurację niezbędną do odtworzenia schematu postępowania. |
| 23 | Dokumentacja wyjściowa | Prognozy, wyniki ewaluacji, ryciny i wyniki wyjaśnień | Archiwizuj wygenerowane wyniki i powiąż je z odpowiadającym im eksperymentem/uruchomieniem. |
| 24 | Weryfikacja odtwarzalności | Weryfikacja spójności pomiędzy niezależnymi wykonaniami | Porównaj wyniki z powtórzeń i raportuj zdefiniowane miary zmienności. |
Tabela 7: Lista kontrolna powtarzalności dla niezależnej replikacji proponowanego przepływu pracy XAI. Lista kontrolna określa wymagania obliczeniowe, dotyczące zbiorów danych, wstępnego przetwarzania, opracowania modelu, ewaluacji, walidacji statystycznej, wyjaśnialności oraz dokumentacji, które są niezbędne do odtworzenia eksperymentalnego przepływu pracy.
Dyskusja
Wyniki demonstrują użyteczność proponowanego protokołu jako zestandaryzowanego i powtarzalnego schematu postępowania w celu opracowywania i oceny systemów XAI w oparciu o zróżnicowane zbiory danych z zakresu opieki zdrowotnej. Jak pokazano w Tabeli 2 oraz na Rysunku 3, systematyczne przetwarzanie wstępne pozwoliło na uzyskanie zestandaryzowanych danych i poprawę ich jakości poprzez obsługę brakujących wartości, normalizację danych, skalowanie cech oraz partycjonowanie zbioru danych. Etapy przetwarzania wstępnego są krytyczne, ponieważ zmienność w przygotowaniu danych może wprowadzić błąd systematyczny, obniżyć wydajność predykcyjną i naruszyć wiarygodność analiz wyjaśnialności. W związku z tym, spójne procedury przetwarzania wstępnego muszą być stosowane w zbiorach treningowych, walidacyjnych i testowych, aby zapewnić powtarzalność i zapobiec wyciekowi danych19,20.
Wyniki trenowania modelu przedstawione na Rysunku 4 i w Tabeli 4 wykazują spójne i stabilne zachowanie procesu uczenia. Równoczesne spadki strat w zbiorze treningowym i walidacyjnym, wraz ze wzrostem dokładności predykcji, wskazują na prawidłową zbieżność modelu bez wystąpienia istotnego przeuczenia. Optymalizacja hiperparametrów, wczesne zatrzymanie (early stopping), dropout oraz regularyzacja dodatkowo przyczyniają się do stabilnego i reprodukowalnego trenowania modelu. Niestabilność krzywych uczenia może wskazywać na niewłaściwą wartość współczynnika uczenia, niewystarczającą ilość danych treningowych lub nadmierną złożoność modelu. Dlatego też zbieżność modelu musi być monitorowana przez cały proces trenowania, aby zidentyfikować i rozwiązać te potencjalne problemy.
Tabela 5 oraz Rysunek 5 przedstawiają wyniki predykcyjne z wykorzystaniem wielu metryk oceny, w tym dokładności (accuracy), precyzji (precision), czułości (recall), swoistości (specificity), wyniku F1 (F1-score), współczynnika korelacji Matthewsa oraz pola pod krzywą charakterystyki operacyjnej odbiornika (ROC). Krzywe ROC oraz krzywe precyzji i czułości dostarczają miar wydajności dyskryminacyjnej, natomiast macierz pomyłek ilustruje rozkład poprawnych i błędnych klasyfikacji w poszczególnych klasach. Ocena z wykorzystaniem wielu metryk wydajności jest szczególnie istotna w przypadku niezbalansowanych zbiorów danych medycznych, ponieważ sama ogólna dokładność może nie charakteryzować w sposób wystarczający wydajności modelu.
Rysunek 6 ilustruje wyniki wyjaśnialności wygenerowane na podstawie zbioru danych Pima Indians Diabetes Dataset i demonstruje komplementarne role metod wyjaśnialności zastosowanych w walidacji praktycznej. Globalna analiza SHAP charakteryzuje ogólny wkład i względną istotność cech wejściowych dla predykcji modelu, podczas gdy wykresy kaskadowe (waterfall plots) i wykresy zależności SHAP zapewniają interpretacje zachowania modelu na poziomie konkretnego pacjenta oraz poszczególnych cech. LIME dostarcza dodatkowego lokalnego wyjaśnienia poprzez identyfikację cech przyczyniających się do predykcji dla pojedynczego przypadku ze zbioru testowego. Wyjaśnienie kontrfaktyczne dla konkretnego pacjenta dodatkowo ilustruje minimalne zmiany cech związane ze zmianą przewidywanego wyniku. Razem podejścia te zapewniają komplementarne perspektywy globalne i lokalne na zachowanie modelu oraz zwiększają przejrzystość i interpretowalność tabelarycznego modelu predykcyjnego. Metody Grad-CAM, wizualizacja uwagi (attention visualization), mapowanie istotności (saliency mapping) oraz zintegrowane gradienty (Integrated Gradients) nie zostały zastosowane w walidacji praktycznej Pima i pozostają jedynie opcjami zależnymi od modalności w ramach ogólnego protokołu.
Walidacja statystyczna (Tabela 6 oraz Rysunek 7) i oceny powtarzalności wykazują stabilność wydajności predykcyjnej w różnych seriach eksperymentalnych. Połączenie walidacji krzyżowej, szacowania przedziałów ufności, testowania hipotez oraz oceny powtarzalności w powtórnych próbach zapewnia systematyczne ramy oceny odporności modelu. Taka walidacja jest szczególnie istotna w zastosowaniach opieki zdrowotnej, ponieważ powtarzalność w niezależnych eksperymentach dostarcza dowodów na niezawodność i generalizowalność modeli AI przed ich wdrożeniem w środowiskach klinicznych21,23.
Kilka etapów jest kluczowych dla pomyślnego wdrożenia niniejszego protokołu. Przed ekstrakcją cech i trenowaniem modelu należy przeprowadzić czyszczenie danych, aby zminimalizować potencjalne obciążenia wynikające z niekompletnych, niespójnych lub błędnych danych. Optymalizację hiperparametrów należy przeprowadzać wyłącznie z wykorzystaniem danych treningowych i walidacyjnych, zachowując niezależność zbioru testowego przez cały proces opracowywania i optymalizacji modelu. W celu zapewnienia powtarzalności wyników na różnych platformach obliczeniowych należy dokładnie udokumentować stany generatorów liczb pseudolosowych, wersje oprogramowania, konfiguracje sprzętowe oraz ustawienia wstępnego przetwarzania. Ponadto, w zależności od modelu predykcyjnego i modalności danych medycznych, należy dobrać odpowiednie metody wyjaśnialności, aby uzyskać interpretowalne i istotne klinicznie wyjaśnienia20,29,30.
Protokół ten posiada kilka ograniczeń. Dokładność i niezawodność prognoz oraz wyjaśnień modelu zależą w znacznym stopniu od dostępności wystarczająco dużych, reprezentatywnych i wysokiej jakości zbiorów danych opieki zdrowotnej. Niedoreprezentowanie określonych populacji pacjentów, błędy pomiarowe, brakujące zmienne oraz heterogeniczność źródeł danych mogą niekorzystnie wpływać zarówno na wydajność predykcyjną, jak i na stabilność wyjaśnień modelu. Ponadto obecne podejścia do wyjaśnialności mogą charakteryzować zachowanie modelu, ale niekoniecznie ustalają mechanizmy przyczynowo-skutkowe. W związku z tym wyniki XAI należy interpretować w połączeniu z odpowiednią wiedzą kliniczną.
Ogólnie rzecz biorąc, niniejszy protokół zapewnia zestandaryzowane podejście do odtwarzalnego opracowywania modeli, ich ewaluacji oraz analizy wyjaśnialności w różnych obszarach opieki zdrowotnej. Poprzez integrację zestandaryzowanego preprocessingu, optymalizacji hiperparametrów, ewaluacji z wykorzystaniem wielu metryk wydajności, komplementarnych podejść do wyjaśnialności oraz walidacji statystycznej, workflow ten zapewnia przejrzyste i identyfikowalne ramy dla badań nad AI w opiece zdrowotnej.
Wyniki dodatkowo wskazują, że przejrzysty i spójny rozwój modeli AI może być wspierany poprzez połączenie systematycznego przetwarzania wstępnego danych, zestandaryzowanych procedur opracowywania modeli, kompleksowej oceny wydajności, wielu metod wyjaśnialności oraz rygorystycznej walidacji statystycznej. Protokół ten można dostosować do baz danych klinicznych, obrazów medycznych, sygnałów fizjologicznych oraz multimodalnych danych opieki zdrowotnej, zachowując jednocześnie ramy dla powtarzalnych eksperymentów w różnych środowiskach obliczeniowych. Dzięki zestandaryzowanej implementacji, uzupełniającym technikom wyjaśnialności i ocenie powtarzalności, protokół zapewnia strukturę do opracowywania wyjaśnialnych i godnych zaufania modeli AI i może służyć jako podstawa metodologiczna dla przyszłych badań biomedycznych oraz późniejszej walidacji zewnętrznej i klinicznej.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych konkurencyjnych interesów finansowych, relacji komercyjnych ani osobistych zależności, które mogłyby wpłynąć na pracę przedstawioną w niniejszym badaniu. Autorzy nie mają żadnych konfliktów interesów do ujawnienia.
Podziękowania
Autorzy dziękują za wsparcie instytucjonalne zapewnione przez ich odpowiednie jednostki macierzyste podczas opracowywania i walidacji eksperymentalnej niniejszego protokołu XAI w opiece zdrowotnej. Autorzy dziękują również za udostępnienie zaplecza obliczeniowego i zasobów programistycznych wykorzystanych do przeprowadzenia analiz eksperymentalnych. Badanie to nie otrzymało zewnętrznego finansowania. Autorzy potwierdzają wykorzystanie języka Python 3.1, bibliotek Matplotlib 3.9 oraz SciPy 1.13 do analizy obliczeniowej, wizualizacji danych oraz generowania rycin przedstawionych w niniejszej pracy.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Captum | Meta AI | Najnowsza stabilna wersja | Wyjaśnialność PyTorch |
| CUDA Toolkit | NVIDIA | 12.2 | Akceleracja GPU |
| cuDNN | NVIDIA | 9.x | Backend głębokiego uczenia |
| Git | Git SCM | Najnowsza stabilna wersja | Kontrola wersji |
| GitHub | GitHub Inc. | Platforma webowa | Repozytorium kodu źródłowego |
| Grad-CAM | jacobgil | Najnowsze wydanie | Wizualizacja CNN |
| Jupyter Notebook | Project Jupyter | Najnowsza stabilna wersja | Interaktywny rozwój |
| LightGBM | Microsoft | 4.x | Gradient boosting |
| LIME | LIME Community | 0.2.0 | Lokalna wyjaśnialność |
| Matplotlib | Matplotlib Developers | 3.9 | Wizualizacja |
| Microsoft Excel | Microsoft | Microsoft 365 | Organizacja danych |
| NumPy | NumPy Developers | 1.26 | Obliczenia numeryczne |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | Trenowanie modelu |
| OpenCV | OpenCV Organization | 4.10 | Preprocessing obrazów |
| Pandas | Pandas Development Team | 2.2 | Preprocessing danych |
| Pillow (PIL) | Python Imaging Library | 10.x | Przetwarzanie obrazów |
| Plotly | Plotly Technologies | 5.x | Interaktywna wizualizacja |
| Python | Python Software Foundation | 3.1 | Środowisko programistyczne |
| PyTorch | PyTorch Foundation | 2.3 | Głębokie uczenie |
| Scikit-learn | Scikit-learn Developers | 1.5 | Uczenie maszynowe |
| SciPy | SciPy Developers | 1.13 | Obliczenia naukowe |
| Seaborn | Seaborn Developers | 0.13 | Wykresy statystyczne |
| SHAP | SHAP Community | 0.46 | Globalna wyjaśnialność |
| SimpleITK | Insight Software Consortium | 2.x | Przetwarzanie obrazów medycznych |
| Statsmodels | Statsmodels Developers | 0.14 | Analiza statystyczna |
| Pamięć RAM systemu | Dowolny producent | 32 GB lub więcej | Pamięć |
| TensorBoard | 2.15 | Monitorowanie trenowania | |
| TensorFlow | 2.15 | Głębokie uczenie | |
| Ubuntu Linux / Windows 1 | Canonical / Microsoft | 2.04 LTS / 1 | System operacyjny |
| Visual Studio Code | Microsoft | Najnowsza stabilna wersja | Rozwój kodu |
| XGBoost | XGBoost Developers | 2.1 | Gradient boosting |
Bibliografia
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.