Zintegrowane analizy transkryptomiczne z populacji komórek (bulk) oraz pojedynczych komórek (single-cell) pozwoliły na zidentyfikowanie sześciu diagnostycznych biomarkerów związanych z metabolizmem hemu w keloidach. Walidacja eksperymentalna potwierdziła dysregulację receptora 1 podgrupy C wirusa białaczki kotów (FLVCR1) w fibroblastach keloidów, natomiast dokowanie molekularne wskazało (+)-gallocatechinę jako potencjalny związek oddziałujący z FLVCR1, co uzasadnia dalsze badania funkcjonalne.
Artykuł badawczy
Identyfikacja biomarkerów związanych z metabolizmem hemu w keloidach z wykorzystaniem analizy transkrypcyjnej i hodowli ludzkich fibroblastów
W tym artykule
Podsumowanie
Streszczenie
Keloidy to zaburzenie włóknisto-proliferacyjne o wysokim stopniu nawrotów i niejasnej patogenezie, dla którego brakuje skutecznych celów terapeutycznych. Niedawne dowody sugerują, że przeprogramowanie metaboliczne, w szczególności w obrębie metabolizmu hemu, może napędzać włóknienie. Niniejsze badanie analizuje rolę metabolizmu hemu, koncentrując się na receptorze 1 podgrupy C wirusa białaczki kociej (FLVCR1), w patogenezie keloidów oraz bada jego potencjał diagnostyczny i terapeutyczny. Przeanalizowano zestawy danych bulk RNA-seq oraz dane z sekwencjonowania RNA pojedynczych komórek (scRNA-seq). W celu zidentyfikowania diagnostycznych biomarkerów związanych z metabolizmem hemu zastosowano analizę ekspresji różnicowej, operator najmniejszego bezwzględnego kurczenia i selekcji (LASSO) oraz modele lasów losowych (RF). Przeprowadzono analizę nacieku immunologicznego, mapowanie pojedynczych komórek, konstrukcję sieci mikroRNA (miRNA) oraz dokowanie molekularne z zastosowaniem związków pochodzących z tradycyjnej medycyny chińskiej. Zidentyfikowano sześć biomarkerów związanych z metabolizmem hemu, które posłużyły do stworzenia nomogramu diagnostycznego o wysokiej dokładności. FLVCR1, wykazujący wzbogacenie w komórkach śródbłonka i melanocytach, korelował negatywnie z limfocytami T pomocniczymi dla mieszków limfatycznych, co sugeruje immunometaboliczny crosstalk. Analiza regulacyjnej sieci miRNA ujawniła pięć miRNA współcelujących we wszystkie sześć biomarkerów. Dokowanie molekularne wskazało (+)-gallocatechinę jako ligand FLVCR1 o wysokim powinowactwie. Wyniki te sugerują związek między metabolizmem hemu zależnym od FLVCR1 a zmianami immunologicznymi w patogenezie keloidów. Panel biomarkerów wykazał potencjał w diagnostyce eksploracyjnej, a (+)-gallocatechinę zidentyfikowano jako kandydujący związek oddziałujący z FLVCR1, wymagający dalszej walidacji. Badanie to sytuuje keloidy w obrębie spektrum metabo-włóknienia i proponuje interwencję metaboliczno-immunologiczną jako nową strategię terapeutyczną.
Wprowadzenie
Keloid, zaburzenie włóknisto-proliferacyjne charakteryzujące się nadmiernym odkładaniem macierzy zewnątrzkomórkowej wykraczającym poza granice pierwotnego uszkodzenia skóry, dotyka 4–16% populacji światowej, przy znacznie wyższej zapadalności wśród osób pochodzenia afrykańskiego, azjatyckiego i latynoskiego1,2. Pomimo histologicznie łagodnego charakteru, keloid powoduje znaczne obciążenia fizyczne i psychospołeczne poprzez uporczywy świąd, ból, przykurcze funkcjonalne oraz oszpecenie kosmetyczne. Obecne metody terapeutyczne, w tym wewnątrzzmianowe kortykosteroidy, wycięcie chirurgiczne, radioterapia i terapia laserowa, pozostają suboptimalne, a wskaźniki nawrotów po monoterapii przekraczają 50%3,4,5. Ten impas terapeutyczny podkreśla fundamentalną lukę w naszym rozumieniu patogenezy keloidów, w szczególności w zakresie czynników inicjujących i podtrzymujących kaskadę włóknienia poza kanoniczne sygnalizacje profibrotyczne.
Współczesne badania koncentrują się głównie na kanonicznych szlakach, takich jak sygnalizacja TGF-β/Smad oraz aberracyjna aktywacja fibroblastów6,7,8. Chociaż w tkankach keloidalnych udokumentowano naciek komórek odpornościowych — w szczególności makrofagów spolaryzowanych do fenotypu M2, limfocytów T regulatorowych oraz rozregulowanych komórek dendrytycznych9,10, badania te w dużej mierze traktują zmiany immunologiczne jako wtórne następstwa dysfunkcji fibroblastów, a nie jako ich nadrzędne regulatory. Co istotne, programy metaboliczne, które mogą aktywnie kształtować tę immunofibrotyczną interakcję, pozostają całkowicie niezbadane w patogenezie keloidów11,12,13. Luka w wiedzy ta jest uderzająca, biorąc pod uwagę pojawiające się paradygmaty w zaburzeniach włóknistych, w których przebudowa metaboliczna służy jako główny regulator remodelowania tkanek.
Przeprogramowanie metaboliczne wyłoniło się w ostatnim czasie jako centralny punkt w procesie fibrogenezy w wielu układach narządowych. W włóknieniu płuc i wątroby zaburzona homeostaza hemu — wynikająca ze zmienionej ekspresji transporterów, białek wychwytujących lub enzymów biosyntetycznych — wywołuje stres oksydacyjny, ferroptozę oraz zapalenie sterylne, które bezpośrednio promują odkładanie kolagenu14. Akumulacja hemu aktywuje inflamasom NLRP3, co prowadzi do aktywacji fibroblastów, podczas gdy niedobór receptora 1 podgrupy C wirusa białaczki kotów (FLVCR1) nasila włóknienie tkanek poprzez nierozwiązaną toksyczność hemu. Wyniki te pozycjonują metabolizm hemu nie tylko jako proces utrzymania funkcji komórkowych, ale jako dynamiczne centrum sygnalizacyjne zdolne do inicjowania kaskad włóknienia — paradygmat ten nie został jeszcze przetestowany w przypadku skórnych zaburzeń fibroproliferacyjnych.
Prawdopodobieństwo immunomodulacji pośredniczonej przez hem jest dodatkowo potwierdzone dowodami mechanistycznymi z modeli raka i przewlekłego stanu zapalnego. Hem funkcjonuje jako cząsteczka sygnalizacyjna, która bezpośrednio moduluje losy komórek odpornościowych: promuje polaryzację makrofagów z typu M1 na M2 poprzez szlak sygnałowy TLR4/NF-κB15, wpływa na różnicowanie limfocytów T poprzez Bach2-zależną represję transkrypcyjną16 oraz krytycznie reguluje dojrzewanie komórek dendrytycznych poprzez zależny od FLVCR1 eksport hemu17,18. Warto zauważyć, że FLVCR1, błonowy transporter eksportujący hem, niezbędny dla komórkowej homeostazy hemu, został ostatnio powiązany z rozwojem komórek odpornościowych i dysfunkcją śródbłonka19. Te zbieżne dowody wskazują na FLVCR1 jako prawdopodobne ogniwo molekularne łączące zaburzenia metaboliczne hemu z patologiczną przebudową układu odpornościowego — jest to hipoteza o głębokich implikacjach dla patogenezy keloidów, biorąc pod uwagę ich charakterystyczne, bogate w komórki odpornościowe mikrośrodowisko.
Mimo znaczących postępów w zrozumieniu interakcji między hemem a układem odpornościowym w innych kontekstach chorobowych, pozostaje całkowicie niezbadane, czy rozregulowany metabolizm hemu służy jako czynnik napędzający, który inicjuje lub potęguje patologiczną odpowiedź immunologiczną w keloidach. Ta krytyczna luka w wiedzy uzasadnia pilną potrzebę przeprowadzenia badań z kilku powiązanych powodów: keloidy wykazują charakterystyczne cechy patologiczne — w tym uporczywy stan zapalny i stres oksydacyjny — wspólne z metabolicznie uwarunkowanymi zaburzeniami włóknistymi, takimi jak włóknienie płuc i wątroby, co sugeruje potencjalną wspólnotę w underlying mechanizmach regulacyjnych. Mechanizm eksportu hemu zorientowany wokół FLVCR1 został zwalidowany mechanistycznie w tkankach pozaskórnych jako bezpośrednio sterujący kluczowymi funkcjami odpornościowymi, takimi jak polaryzacja makrofagów i dojrzewanie komórek dendrytycznych, co stanowi solidną podstawę teoretyczną do ekstrapolacji tych wniosków na immunopatologię keloidów20. Co najważniejsze, celowanie w tę oś metaboliczno-immunologiczną oferuje szansę na zmianę paradygmatu i wyjście poza obecne terapie objawowe, które jedynie tłumią wtórne efekty włóknienia, potencjalnie umożliwiając interwencję u źródła metabolicznego progresji choroby21.
Opierając się na powyższym uzasadnieniu, wysunęliśmy hipotezę, że dysregulacja metabolizmu hemu scentrowana wokół FLVCR1 aktywnie przebudowuje mikrośrodowisko immunologiczne, napędzając patogenezę keloidów. Aby systematycznie zweryfikować tę hipotezę, zintegrowaliśmy analizy transkrypomiczne całych tkanek (bulk) oraz pojedynczych komórek w podejściu wielopoziomowym: najpierw zidentyfikowaliśmy i zwalidowaliśmy biomarkery diagnostyczne związane z metabolizmem hemu w tkankach keloidów, wykorzystując algorytmy uczenia maszynowego oraz weryfikację na niezależnej kohorcie; następnie, za pomocą mapowania w rozdzielczości pojedynczych komórek, określiliśmy przestrzenne wzorce ekspresji tych biomarkerów w różnych komponentach komórkowych – w tym w komórkach śródbłonka, fibroblastach, melanocytach i subpopulacjach immunologicznych; następnie wyznaczyliśmy ich korelacje ilościowe z konkretnymi populacjami komórek odpornościowych, aby ustanowić funkcjonalne powiązania immunometaboliczne; i na koniec skonstruowaliśmy sieci regulacyjne mikroRNA (miRNA) scentrowane wokół FLVCR1 oraz przeprowadziliśmy dokowanie molekularne z związkami tradycyjnej medycyny chińskiej, aby zidentyfikować punkty interwencji farmakologicznej. To kompleksowe badanie nie tylko ujawnia wcześniej nieznaną oś metabolizmu hemu i układu odpornościowego w patogenezie keloidów, ale także dostarcza panelu biomarkerów o znaczeniu translacyjnym, posiadających podwójny potencjał diagnostyczny i terapeutyczny w leczeniu tego opornego zaburzenia fibroproliferacyjnego.
Protokół
Zatwierdzenie etyczne oraz świadoma zgoda nie były wymagane w niniejszym badaniu, ponieważ wszystkie dane pochodziły z publicznie dostępnych baz danych, w tym Gene Expression Omnibus (GEO), a w badaniu nie brali bezpośredniego udziału możliwi do zidentyfikowania uczestnicy będący ludźmi ani zwierzęta.
Pozyskiwanie i wstępne przetwarzanie danych
Geny związane z metabolizmem hemu pozyskano z bazy danych Molecular Signatures Database (MSigDB; patrz Tabela materiałów oraz Tabela uzupełniająca S1), w tym zestawy genów z REACTOME_Heme_Biosynthesis, REACTOME_Heme_Degradation, Wikipathway_Heme_Biosynthesis, REACTOME_Scavenging_Heme_from_Plasma oraz HALLMARK_Heme_Metabolism. Wszystkie zestawy danych analizowane w niniejszym badaniu pochodziły z ogólnodostępnych źródeł. Dwa zestawy danych z macierzy ekspresji genów (bulk gene-expression microarray) pobrano z bazy danych Gene Expression Omnibus (GEO): GSE44270, obejmujący 18 próbek keloidów i 14 próbek normalnej skóry, oraz GSE7890, obejmujący 10 próbek keloidów i 9 próbek normalnej skóry. Zestawy GSE44270 i GSE7890 zostały wygenerowane odpowiednio na platformach GPL6244 i GPL570. Pliki macierzy serii oraz odpowiadające im informacje o próbkach pobrano i zaimportowano do środowiska R. Ponieważ wartości ekspresji w plikach macierzy serii zostały już wcześniej przetworzone i znormalizowane przez osoby przesyłające dane, nie przeprowadzano dodatkowej transformacji log2 ani normalizacji między próbkami. Oba zestawy danych przetwarzano niezależnie i nie łączono ich ze względu na zastosowanie różnych platform macierzy. Zestawy danych poddano wstępnej obróbce zgodnie z poniższym opisem (patrz Tabela materiałów). Sondy genowe przypisano do odpowiadających im symboli genów, a sondy, które nie posiadały adnotacji genowych lub odpowiadały wielu genom, wykluczono. W przypadku genów z wieloma zestawami sond, wartość ekspresji przypisywano na podstawie najwyższego wykrytego poziomu ekspresji. Dodatkowo pobrano dane z sekwencjonowania RNA pojedynczych komórek (scRNA-seq) z GSE163973, zawierające trzy próbki keloidów, i przetworzono je zgodnie ze standardami kontroli jakości zdefiniowanymi w oryginalnym badaniu.
Przesiewowe badanie i walidacja markerów diagnostycznych związanych z metabolizmem hemu w keloidach
W celu zidentyfikowania genów związanych z metabolizmem hemu o różnym poziomie ekspresji w keloidach, do zestawu danych GSE44270 zastosowano test sum rang Wilcoxona przy użyciu funkcji R wilcox.test, przyjmując próg istotności P < 0.05. Aby zidentyfikować potencjalne markery diagnostyczne dla keloidów, wykorzystano dwa modele uczenia maszynowego: lasy losowe (random forest, RF) oraz regresję logistyczną z zastosowaniem metody najmniejszego bezwzględnego kurczenia i selekcji (LASSO). Analizę lasów losowych przeprowadzono z ziarnem losowym (random seed) równym 1, aby zapewnić powtarzalność (patrz: Tabela materiałów). Model zbudowano z wykorzystaniem 500 drzew (ntree = 500), a istotność genów oceniano na podstawie średniego spadku nieczystości węzła (IncNodePurity). Wybrano geny o wartościach istotności większych niż 0,3 jako kandydackie biomarkery wyłonione za pomocą lasów losowych. Regresję logistyczną LASSO przeprowadzono dla α = 1, a podczas trenowania modelu oceniono 50 wartości lambda (patrz: Tabela materiałów). Optymalny parametr kary określono za pomocą 5-krotnej walidacji krzyżowej z funkcją cv.glmnet, przy odpowiedzi binominalnej. Geny o niezerowych współczynnikach regresji zachowano jako kandydaci wybrani przez LASSO. Ostatecznie część wspólną genów zidentyfikowanych przez lasy losowe i regresję LASSO uznano za końcową diagnostyczną sygnaturę genową. Końcową diagnostyczną sygnaturę genową oceniono za pomocą modelu opartego na nomogramie. Cały proces selekcji cech i szacowania parametrów modelu przeprowadzono wyłącznie w kohorcie odkrycia (GSE44270), a opracowaną sygnaturę sześciu genów poddano dalszej ocenie w niezależnej kohorcie walidacyjnej (GSE7890). Wydajność diagnostyczną nomogramu oceniono poprzez obliczenie pola pod krzywą charakterystyki operacyjnej odbiornika (AUC). Aby zbadać stabilność modelu, analiza obejmowała 5-krotną walidację krzyżową oraz 1000 iteracji próbkowania bootstrapowego, z których wyliczono wartość AUC skorygowaną o optymizm. Następnie wykorzystano analizę krzywej decyzyjnej (DCA) do oszacowania potencjalnej korzyści netto z nomogramu; wynik ten zinterpretowano jednak z ostrożnością ze względu na małą wielkość próby.
Infiltracja komórek odpornościowych i analiza korelacji
Wzbogacenie komórek odpornościowych oceniono za pomocą analizy wzbogacenia zestawów genów dla pojedynczych próbek (ssGSEA) (patrz Tabela materiałów). Macierz sygnatur komórek odpornościowych pozyskano z wcześniej opublikowanego badania Charoentong i wsp.22, która zawierała 782 geny markerowe reprezentujące 28 populacji komórek odporności adaptacyjnej i wrodzonej. Analizę przeprowadzono z wykorzystaniem jądra Gaussa na ciągłych, znormalizowanych wartościach ekspresji z mikromacierzy. Po dopasowaniu genów markerowych do macierzy ekspresji wymagana była minimalna wielkość zestawu genów wynosząca 10, a otrzymane wyniki ssGSEA zostały znormalizowane. Wszystkie pozostałe ustawienia pozostawiono w wartościach domyślnych. Następnie obliczono współczynniki korelacji Pearsona, aby ocenić zależności między wynikami wzbogacenia komórek odpornościowych a ekspresją genów diagnostycznych. Powstałą macierz korelacji przedstawiono w formie wykresu korelacji, a wybrane powiązania zobrazowano dodatkowo za pomocą wykresów typu lollipop (patrz Tabela materiałów).
Przetwarzanie i analiza danych sekwencjonowania RNA pojedynczych komórek
Dane z sekwencjonowania RNA pojedynczych komórek pobrano z bazy GSE163973, a w niniejszej analizie uwzględniono jedynie trzy próbki keloidów: KF1, KF2 i KF3. Dane o ekspresji zostały zaimportowane i przetworzone zgodnie z opisem poniżej (patrz: Tabela materiałów). Wykluczono komórki z liczbą całkowitych unikalnych identyfikatorów molekularnych (UMI) mniejszą niż 200 lub większą niż 6 000 oraz usunięto przewidywane dublety. Liczba ekspresji genów dla każdej komórki została znormalizowana do całkowitej ekspresji komórkowej, pomnożona przez współczynnik skali 10 000 i poddana transformacji logarytmicznej. Podczas skalowania danych wyeliminowano zmienność związaną z efektem serii (batch effect), a otrzymane pozostałości skalowane wykorzystano w dalszej analizie. Na podstawie średniej ekspresji i dyspersji wybrano 2 000 genów o wysokiej zmienności, dla których przeprowadzono analizę głównych składowych. Pierwsze 15 głównych składowych wykorzystano do skonstruowania grafu k-najbliższych sąsiadów w oparciu o odległości euklidesowe, który następnie przekształcono w graf wspólnych najbliższych sąsiadów. Komórki pogrupowano za pomocą algorytmu Louvain przy rozdzielczości 0,8, a przybliżoną projekcję i projekcję rozmaitości (UMAP) wykonano z wykorzystaniem tych samych 15 głównych składowych. Typy komórek zinterpretowano zgodnie z definicjami typów komórek przedstawionymi w oryginalnym badaniu, a uzyskane adnotacje zapisano w polu metadanych. Adnotacje typów komórek oraz przypisania do klastrów zwizualizowano na współrzędnych UMAP, a ekspresję genów diagnostycznych przedstawiono dla zinterpretowanych populacji komórek.
Konstrukcja sieci regulacyjnej miRNA–mRNA
Sieć regulacyjna miRNA–mRNA została skonstruowana zgodnie z poniższym opisem (patrz Tabela materiałów). Jako organizm wybrano Homo sapiens, a identyfikatory genów podano w postaci oficjalnych symboli genów (Official Gene Symbols). Geny kandydujące wprowadzono do modułu interakcji gen–miRNA, a jako bazę danych interakcji wybrano TarBase v9.0. TarBase zawiera eksperymentalnie potwierdzone interakcje regulacyjne miRNA–gen. Do konstrukcji sieci zachowano wyłącznie interakcje miRNA–mRNA potwierdzone eksperymentalnie, obejmujące wprowadzone geny kandydujące, natomiast wykluczono interakcje przewidziane bez dowodów eksperymentalnych. Nie wprowadzono dodatkowego progu wskaźnika ufności.
Wirtualne przesiewanie oparte na strukturze i analiza dokowania molekularnego
Przeprowadzono wirtualny screening w celu wyłonienia priorytetowych ligandów kandydujących z biblioteki związków przeciwko ludzkiemu białku FLVCR1 (białko 1 spokrewnione z receptorem podgrupy C wirusa białaczki kotów; patrz w Tabela materiałów) przy użyciu schematu wirtualnego przesiewania opartego na strukturze (SBVS). Trójwymiarową strukturę ludzkiego białka FLVCR1 pobrano z Protein Data Bank (PDB ID: 8UBZ). Struktura ta przedstawia ludzkie białko FLVCR1 związane z choliną, wyznaczone metodą kriomikroskopii elektronowej pojedynczych cząsteczek przy rozdzielczości globalnej 3,02 Å. Å (numer akcesyjny EMDB: EMD-42110). Wybrano strukturę wyznaczoną eksperymentalnie, ponieważ zawiera ona konformację FLVCR1 związaną z substratem, a tym samym dostarcza informacji strukturalnych pozwalających zdefiniować fizjologicznie istotną jamę wiążącą ligand. Podczas przygotowania receptora zachowano współrozstrzygnięte cząsteczki choliny (CHT) i hemisukcynianu cholesterolu (Y01), aby utrzymać środowisko strukturalne otaczające region wejścia substratu i wiązania ligandu. Przestrzeń poszukiwań dokowania zdefiniowano wokół jamy wiążącej substrat/ligand FLVCR1, obejmując współrozstrzygnięty region wiązania choliny. Środek siatki (grid box) wyznaczono w punkcie x = 160,587 Å, y = 160,613 Å, a z = 160,484 ÅWymiary przestrzeni dokowania (docking box) ustawiono na [X × Y × Z Åaby zapewnić odpowiednie pokrycie kieszeni wiążącej substrat oraz otaczających ją reszt. Następnie związki kandydujące poddano dokowaniu do tego zdefiniowanego obszaru wiązania. Pozy dokowania uszeregowano według przewidywanego powinowactwa wiązania, przyjmując, że bardziej ujemne wyniki dokowania wskazują na korzystniejsze przewidywane oddziaływania liganda z FLVCR1. Związki o najwyższym rankingu wybrano do dalszych analiz trybu wiązania oraz oddziaływań białko-ligand.
Symulacje dynamiki molekularnej i obliczenia wolnej energii wiązania metodą MM/GBSA
Symulacje dynamiki molekularnej (MD) zostały wykorzystane do dalszej analizy przewidywanego kompleksu białko-ligand (patrz Tabela materiałów). Topologię ligandu przygotowano poprzez przypisanie parametrów General Amber Force Field (GAFF) oraz uwzględnienie ładunków restrained electrostatic potential (RESP). Kompleks opisano następnie za pomocą pola siłowego Amber99SB-ILDN, umieszczono w modelu wody 3-punktowej z przenośnym potencjałem międzycząsteczkowym (TIP3P) i zneutralizowano za pomocą trzech jonów Na+⁺ jony. Po minimalizacji energii metodą najszybszego spadku system poddano ekwilibracji przez 100 ps w zespole stałej liczby cząsteczek, objętości i temperatury oraz przez kolejne 100 ps w zespole stałej liczby cząsteczek, ciśnienia i temperatury, wykonując po 100 000 kroków w każdej fazie. Następnie przeprowadzono 100 ns symulacji produkcyjnej w temperaturze 300 K i pod ciśnieniem 1 bar, stosując krok czasowy 2 fs. Otrzymaną trajektorię przeanalizowano pod kątem średniokwadratowego odchylenia (RMSD), średniokwadratowych fluktuacji (RMSF), promienia żyracji (Rg), powierzchni dostępnej dla rozpuszczalnika (SASA), trwałości wiązań wodorowych oraz wolnej energii wiązania metodą mechaniki molekularnej i ogólnej powierzchni Borna (MM/GBSA).
Hodowla komórkowa
Linię komórkową normalnych ludzkich fibroblastów skóry NHDF oraz pierwotną linię komórkową fibroblastów keloidów PKF hodowano w pożywce do wzrostu fibroblastów uzupełnionej o 2% płodowej surowicy cielęcej, rekombinowany ludzki podstawowy czynnik wzrostu fibroblastów (1 ng/mL) oraz insulinę (5 µg/mL). Obie linie komórkowe utrzymywano w inkubatorze z nawilżaniem w temperaturze 37 °C przy 5% CO₂ i pasażowano po osiągnięciu 80–90% konfluencji.
Analiza Western blot
Całkowite białko wyizolowano z komórek NHDF i PKF przy użyciu buforu do lizy składającego się z buforu do radioimmunoprecypitacji, fluorku fenylometylosulfonylowego, koktajlu inhibitorów proteaz oraz inhibitorów fosfataz. Stężenie białka określono za pomocą testu kwasu bicynkoninowego, po czym równe ilości białka rozdzielono metodą elektroforezy w żelu poliakrylamidowym z dodecylosiarczanem sodu, a następnie przeniesiono na membranę z polifluorku winylidenu. Membranę blokowano przez 90 min w temperaturze pokojowej przy użyciu 5% roztworu odtłuszczonego mleka w proszku przygotowanego w soli buforowej Tris-Tween, a następnie inkubowano przez noc w temperaturze 4 °C z przeciwciałami pierwszorzędowymi przeciwko FLVCR1 (królicze poliklonalne, 1:1 000) i GAPDH (mysie monoklonalne, 1:20 000). Następnego dnia przeprowadzono 90-minutową inkubację z przeciwciałem drugorzędowym w temperaturze pokojowej. Intensywność prążków zmierzono programem ImageJ, a względne poziomy białek znormalizowano względem wewnętrznej kontroli GAPDH. Do każdego badania western blot wykorzystano co najmniej trzy niezależne powtórzenia biologiczne.
Analiza ilościowej odwrotnej transkrypcji i polimerazy łańcuchowej w czasie rzeczywistym z detekcją fluorescencyjną (qRT-PCR)
Całkowity RNA przygotowano z komórek NHDF i PKF przy użyciu wskazanego zestawu. Następnie otrzymano cDNA z wykorzystaniem wskazanego cDNA Synthesis Mix for qPCR (z dsDNase). qRT-PCR przeprowadzono w systemie PCR w czasie rzeczywistym, a ekspresję FLVCR1 zmierzono za pomocą wskazanego SYBR Green Fast Mix. mRNA GAPDH służyło jako wewnętrzna referencja do normalizacji. Każda reakcja qRT-PCR była wykonywana w trzech powtórzeniach technicznych, a względne poziomy mRNA obliczono metodą 2−ΔΔCt. Każdy eksperyment przeprowadzono niezależnie co najmniej trzy razy, a sekwencje starterów podano w Tabeli uzupełniającej S2.
Analiza statystyczna
Różnice między grupami badano przy użyciu testu suma rang Wilcoxona, a wartości przedstawiono jako średnia ± odchylenie standardowe (SD). Powiązania między zmiennymi ciągłymi analizowano za pomocą współczynnika korelacji Pearsona. Wyniki przy P < 0,05 uznano za istotne statystycznie. Poziomy istotności oznaczono jako ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001 oraz ****, P < 0,0001.
Wyniki
Przesiewowe poszukiwanie kandydatów na diagnostyczne biomarkery blizn przerostających (keloidów) przy użyciu algorytmu uczenia maszynowego
W badaniu uwzględniono łącznie 283 genów związanych z metabolizmem hemu. Analiza ekspresji różnicowej zbioru danych GSE44270, porównująca tkanki keloidów i skóry prawidłowej, pozwoliła zidentyfikować 25 genów o istotnie różnej ekspresji (Ryc. 1A oraz Tabela uzupełniająca S3). W celu dalszego przesiewu biomarkerów związanych z chorobą, za pomocą regresji LASSO zidentyfikowano 9 genów kandydackich (Ryc. 1B,C oraz Tabela uzupełniająca S3), natomiast algorytm lasów losowych (RF) wybrał 11 genów o wysokiej istotności predykcyjnej (Ryc. 1D oraz Tabela uzupełniająca S3). Część wspólna wyników LASSO i RF została przedstawiona na wykresie Venna, co pozwoliło wyłonić sześć kluczowych biomarkerów, mianowicie: FLVCR1, TMCC2, EIF2AK1, XK, HPX oraz KEL (Ryc. 1E oraz Tabela uzupełniająca S3). Analiza charakterystyki operacyjnej odbiornika (ROC) w kohorcie GSE44270 wykazała korzystną skuteczność diagnostyczną dla wszystkich sześciu biomarkerów, z wartościami AUC wynoszącymi odpowiednio: 0,8016 dla FLVCR1, 0,7063 dla TMCC2, 0,7817 dla EIF2AK1, 0,7460 dla XK, 0,7500 dla HPX oraz 0,7857 dla KEL (Ryc. 1F). Na podstawie tych sześciu biomarkerów skonstruowano następnie nomogram diagnostyczny dla keloidów, wykorzystując pakiet rms w środowisku R (Ryc. 1G).
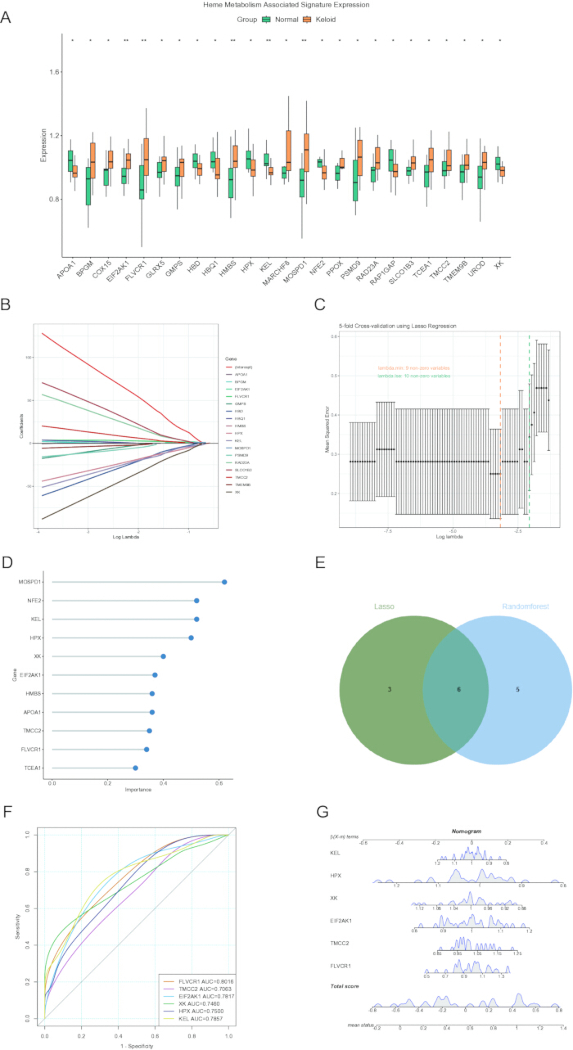
Rycina 1: Identyfikacja genów kandydatów związanych z metabolizmem hemu, powiązanych z keloidem, przy użyciu algorytmów uczenia maszynowego. (A) Wykres pudełkowy ilustrujący różnicową ekspresję genów związanych z metabolizmem hemu w tkance keloidowej i normalnej. (B,C) Analiza regresji logistycznej LASSO w celu przesiewania diagnostycznych markerów kandydatów. (D) Biomarkery kandydaci wybrane przez algorytm RF. (E) Diagram Venna przedstawiający wspólne geny zidentyfikowane przez dwa algorytmy uczenia maszynowego. (F) Analiza krzywej ROC oceniająca wydajność diagnostyczną biomarkerów kandydatów. (G) Nomogram do przewidywania keloidu na podstawie sygnatury sześciu genów. Skróty: LASSO, least absolute shrinkage and selection operator; RF, random forest; ROC, receiver operating characteristic. Istotność statystyczna: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; oraz ****, P < 0,0001. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
Wydajność predykcyjna nomogramu diagnostycznego została oceniona zarówno w kohorcie treningowej (GSE44270), jak i w kohorcie walidacyjnej (GSE7890). Model wykazał doskonałą dokładność diagnostyczną, osiągając odpowiednio wartości AUC wynoszące 0,984 (95% CI: 0,950–1,000) oraz 0,922 (95% CI: 0,806–1,000) (Rysunek 2A,D). Aby dalej ocenić odporność i potencjalne przeuczenie sześciogenowego sygnatury diagnostycznej, w kohorcie odkrywczej (GSE44270) przeprowadzono dodatkowe analizy walidacji wewnętrznej. Pięciokrotna walidacja krzyżowa wykazała spójną zdolność dyskryminacyjną w podzbiorach, ze średnim AUC wynoszącym 0,925, co wskazuje, że model zachował stabilną wydajność klasyfikacji pomimo różnic w próbkach treningowych. Ponadto walidacja metodą bootstrap z 1 000 iteracjami ponownego próbkowania dała średnie AUC wynoszące 0,930 (95% CI: 0,794–1,000). Po skorygowaniu o potencjalny optymizm spowodowany ograniczoną wielkością próby, skorygowane AUC pozostało na poziomie 0,930, co sugeruje, że wydajność diagnostyczna sześciogenowej sygnatury była stosunkowo stabilna po walidacji wewnętrznej. Co więcej, analiza krzywej decyzji (DCA) zasugerowała, że nomogram wykazuje wyższą potencjalną korzyść netto niż alternatywne strategie diagnostyczne w zakresie prawdopodobieństw progowych, choć wnioski te należy interpretować ostrożnie ze względu na ograniczoną wielkość próby (Rysunek 2B,E). Dodatkowo próbki keloidów wykazały znacząco wyższe wyniki ryzyka niż zdrowe kontrole zarówno w kohorcie treningowej, jak i walidacyjnej (Rysunek 2C,F), co dodatkowo potwierdziło stabilność i niezawodność modelu diagnostycznego.
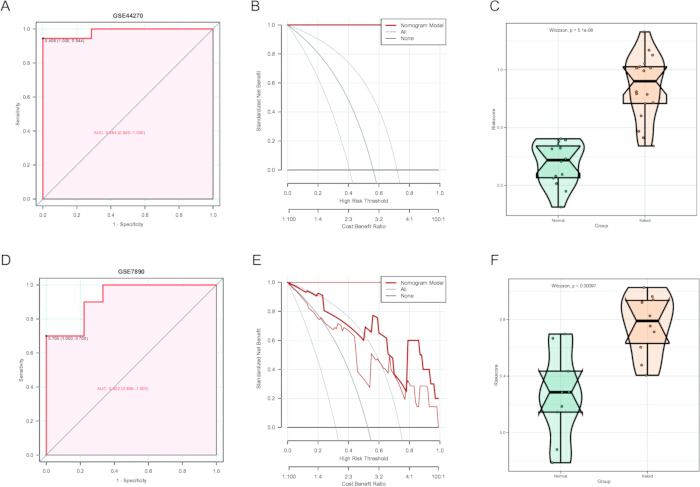
Rysunek 2: Walidacja nomogramu do przewidywania keloidów. (A) Krzywa ROC oceniająca wydajność prognostyczną nomogramu w zbiorze danych GSE44270. (B) DCA oceniająca użyteczność kliniczną nomogramu w GSE44270. (C) Rozkład wskaźnika ryzyka z porównaniem próbek z keloidami i próbek zdrowych w GSE44270. (D) Krzywa ROC oceniająca wydajność prognostyczną nomogramu w niezależnym zbiorze danych GSE7890. (E) DCA oceniająca użyteczność kliniczną nomogramu w GSE7890. (F) Rozkład wskaźnika ryzyka z porównaniem próbek z keloidami i próbek zdrowych w GSE7890. Skróty: ROC = charakterystyka pracy odbiornika; DCA = analiza krzywej decyzyjnej. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Biomarkery diagnostyczne są powiązane z charakterystyką immunologiczną keloidów
Aby zbadać związek między sześcioma biomarkerami diagnostycznymi a mikrośrodowiskiem immunologicznym, przeprowadzono analizę korelacji w celu oceny powiązań między ekspresją biomarkerów a infiltracją komórek odpornościowych. Wyniki wykazały, że wszystkie sześć biomarkerów było istotnie powiązanych z wieloma populacjami infiltrujących komórek immunologicznych (Rysunek 3A). W szczególności ekspresja FLVCR1 była ujemnie skorelowana z T folikularnymi komórkami pomocniczymi (Rysunek 3B). TMCC2 wykazało dodatnie korelacje z komórkami natural killer oraz aktywowanymi komórkami dendrytycznymi, natomiast ujemną korelację z niedojrzałymi komórkami dendrytycznymi i niedojrzałymi limfocytami B (Rysunek 3C–F). Dodatkowo ekspresja EIF2AK1 była ujemnie powiązana z komórkami natural killer CD56dim (Rysunek 3G), podczas gdy XK było ujemnie powiązane z eozynofilami (Rysunek 3H).
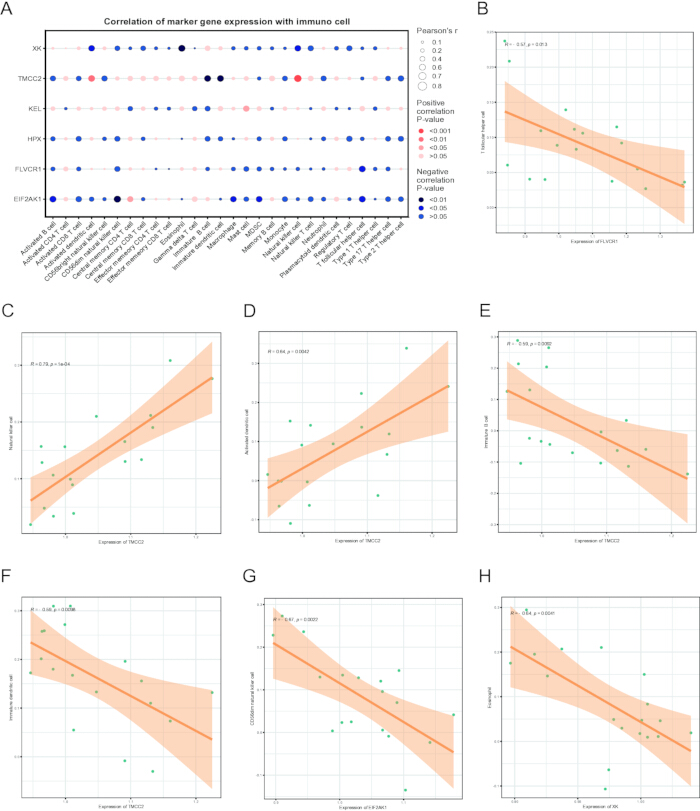
Rysunek 3Korelacja między kandydatami na geny związane z metabolizmem hemu a naciekiem komórek odpornościowych. (A) Mapa ciepła przedstawiająca korelacje między genami kandydackimi a populacjami komórek odpornościowych. Kolor czerwony oznacza korelacje dodatnie, natomiast kolor niebieski oznacza korelacje ujemne. (B). Korelacja pomiędzy FLVCR1 ekspresja i folikularne limfocy T pomocnicze (C-F) Korelacje pomiędzy TMCC2 ekspresja i odpowiednio: komórki natural killer, aktywowane komórki dendrytyczne, niedojrzałe komórki dendrytyczne oraz niedojrzałe limfocyty B. (GKorelacja między EIF2AK1 ekspresja i komórki natural killer CD56dim. (H). Korelacja pomiędzy XK ekspresja i eozynofile. Skróty: FLVCR1 = receptor 1 podgrupy C wirusa białaczki kotów; TMCC2 = domeny błonowe i zwinięte w spiralę 2; EIF2AK1 = eukariotyczny czynnik inicjacji translacji 2 kinaza alfa 1; CD56wymiar = niska ekspresja klastra różnicowania 56. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Analiza danych transkryptomicznych z pojedynczych komórek
Aby scharakteryzować wzorce ekspresji zidentyfikowanych biomarkerów diagnostycznych w mikrośrodowisku keloidów, przeanalizowano zestaw danych z sekwencjonowania RNA pojedynczych komórek GSE163973. Po kontroli jakości i integracji danych, do dalszych analiz zachowano 21 488 wysokiej jakości komórek. Wykluczono komórki z całkowitą liczbą unikalnych identyfikatorów molekularnych (UMI) mniejszą niż 200 lub większą niż 6 000, a potencjalne dublety zidentyfikowano i usunięto przy użyciu pakietu DoubletDetection. Wybrano 2 000 genów wykazujących największą zmienność ekspresji, a następnie przeprowadzono redukcję wymiarowości i wizualizację za pomocą metody Uniform Manifold Approximation and Projection (UMAP). Zidentyfikowano łącznie 10 głównych populacji komórek, w tym komórki śródbłonka, fibroblasty, włókna mięśniowe, keratynocyty, komórki odpornościowe, komórki śródbłonka limfatycznego, komórki gruczołowe, komórki nerwowe, melanocyty oraz niezaklasyfikowaną populację komórek (Rycyna 4A,B). Profilowanie ekspresji ujawniło wyraźne, specyficzne dla typu komórek wzorce rozkładu biomarkerów diagnostycznych. FLVCR1 był eksprymowany głównie w komórkach śródbłonka i melanocytach, podczas gdy EIF2AK1 wykazywał stosunkowo wysoką ekspresję w komórkach nerwowych, komórkach gruczołowych i fibroblastach. HPX był przede wszystkim wzbogacony w melanocytach, natomiast KEL wykazywał dominującą ekspresję w komórkach gruczołowych (Rycyna 4C,D).
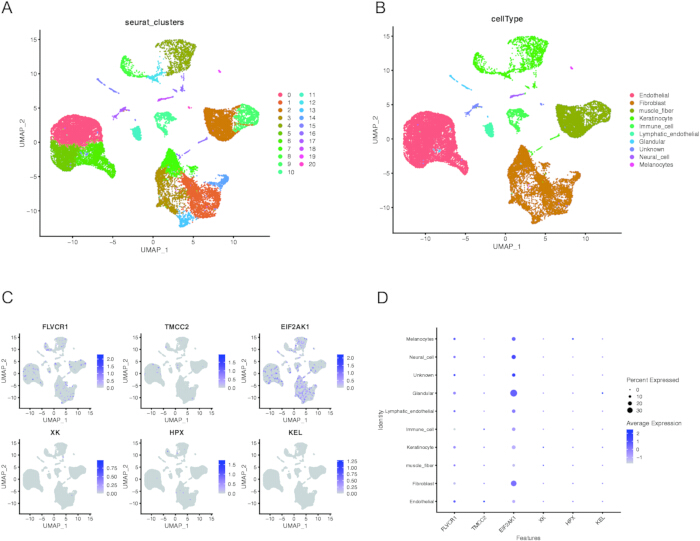
Rycina 4: Rozkład diagnostycznych biomarkerów związanych z metabolizmem hemu w transkryptomie pojedynczych komórek keloidu. (A) Wykres UMAP przedstawiający 21 klastrów komórkowych obejmujących 21 488 komórek z próbek keloidu. (B) Adnotacje typów komórek na podstawie adnotacji przedstawionych w oryginalnym badaniu. (C) Wykresy cech (feature plots) pokazujące ekspresję diagnostycznych biomarkerów związanych z metabolizmem hemu w różnych typach komórek. (D) Wykres bąbelkowy przedstawiający średnie poziomy ekspresji i procenty komórek wykazujących ekspresję diagnostycznych biomarkerów związanych z metabolizmem hemu w różnych typach komórek. Skrót: UMAP = uniform manifold approximation and projection. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
Identyfikacja i analiza sieci oddziaływań potencjalnych biomarkerów diagnostycznych
Aby zbadać mechanizmy regulacyjne leżące u podstaw kandydatów na biomarkery diagnostyczne, skonstruowano sieć regulacyjną miRNA–mRNA. W celu zwiększenia wiarygodności przewidywanych oddziaływań zidentyfikowano nakładające się miRNA celujące w kandydatów na biomarkery. Uzyskano łącznie 282 miRNA oddziałujące z sześcioma biomarkerami diagnostycznymi, a wynikowa sieć regulacyjna została przedstawiona na Rysunku 5. Warto zauważyć, że hsa-miR-34a-5p, hsa-let-7a-5p, hsa-let-7d-5p, hsa-let-7e-5p oraz hsa-miR-26b-5p zostały zidentyfikowane jako jednocześnie regulujące wszystkie sześć kandydatów na biomarkery.
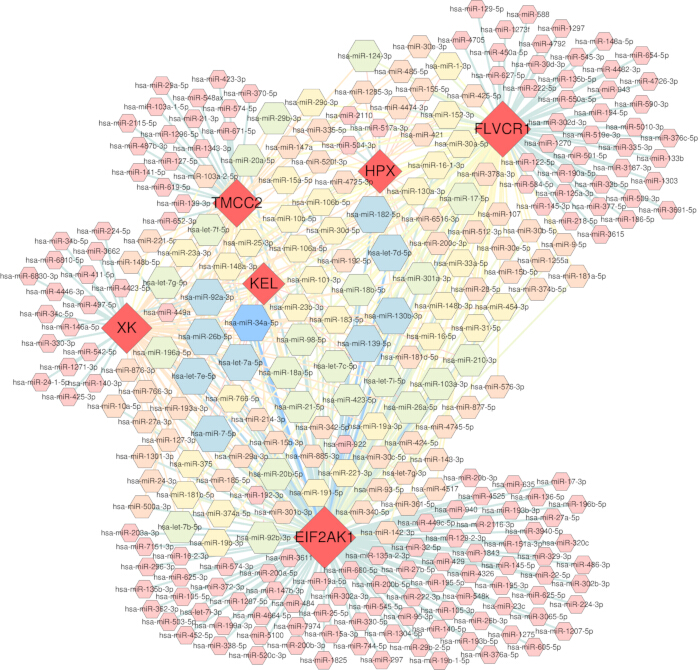
Rysunek 5: Sieć regulacyjna miRNA biomarkerów diagnostycznych związanych z metabolizmem hemu.Sieć ilustruje relacje regulacyjne między sześcioma genami biomarkerów diagnostycznych (FLVCR1, HPX, TMCC2, KEL, XK oraz EIF2AK1) a powiązanymi z nimi cząsteczkami miRNA. Węzły genów reprezentują biomarkery diagnostyczne, natomiast otaczające je węzły reprezentują miRNA. Krawędzie wskazują potwierdzone eksperymentalnie interakcje miRNA–mRNA. Skróty: FLVCR1 = receptor 1 podgrupy C wirusa białaczki kotów; HPX = hemopeksyna; TMCC2 = domeny transbłonowe i zwinięte w spiralę 2; KEL = metaloendopeptydaza Kell; XK = grupa krwi Kx sprzężona z chromosomem X; EIF2AK1 = eukariotyczny czynnik inicjujący translację 2 kinaza alfa 1; miRNA = mikro-RNA; mRNA = matrycowy RNA. Aby zobaczyć powiększoną wersję tego rysunku, kliknij tutaj.
Walidacja eksperymentalna ekspresji FLVCR1 oraz analiza dokowania molekularnego potencjalnych związków terapeutycznych
Aby zwalidować wyniki bioinformatyczne i potwierdzić funkcjonalne znaczenie zidentyfikowanego genu hubowego, eksperymentalnie oceniono ekspresję FLVCR1 w PKF i NHDF. Zarówno analizy qRT-PCR, jak i western blot konsekwentnie wykazały, że FLVCR1 była znacząco podregulowana w fibroblastach keloidowych w porównaniu z normalnymi kontrolami (Rycyna 6A–C, Rycina uzupełniająca S1 oraz Tabela uzupełniająca S4). Ta podwyższona ekspresja komórkowa wspiera hipotezę o potencjalnym udziale dysregulacji metabolizmu hemu związanej z FLVCR1 w patogenezie keloidów.
Biorąc pod uwagę potencjalny udział FLVCR1 w zmianach immunologicznych związanych z metabolizmem hemu, w następnym kroku podjęto próbę zidentyfikowania potencjalnych związków terapeutycznych, które mogłyby bezpośrednio oddziaływać na FLVCR1 w celu przerwania tej osi patogennej. Przeprowadzono wysokoprzepustowy screening wirtualny z wykorzystaniem biblioteki związków tradycyjnej medycyny chińskiej (TCM) oraz przygotowanej struktury białka. Do dalszej oceny wybrano 20 związków z najkorzystniejszymi wynikami dokowania (Tabela uzupełniająca S5). Generalnie niższa energia wiązania wskazuje na silniejsze powinowactwo wiązania, a energie dokowania poniżej −5 kcal/mol uznaje się za wskazujące na stabilne oddziaływania ligand–białko. Wśród przeszukanych związków (+)-gallocatechina, (−)-epikatechina, (−)-gallocatechina oraz cyjanidyny (chlorku) wykazały korzystne powinowactwo wiązania do FLVCR1. W szczególności (+)-gallocatechina wykazała najsilniejsze oddziaływanie z FLVCR1 poprzez tworzenie czterech wiązań wodorowych z GLU214, ASN245, GLN246 i GLN471, co sugeruje stabilny sposób wiązania ligandu z białkiem (Rycina 6D–G). Wyniki te wskazują na (+)-gallocatechinę jako obiecującego kandydata do ukierunkowanej na mechanizm interwencji terapeutycznej celującej w FLVCR1.
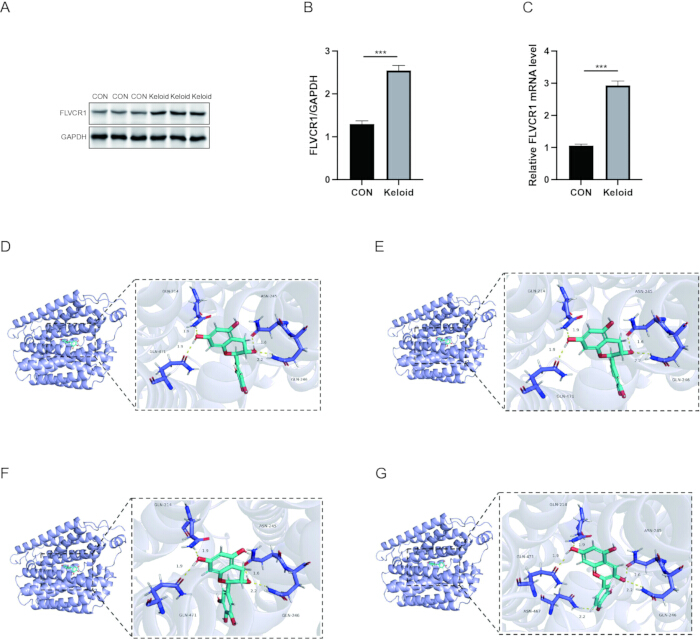
Rycina 6: Eksperymentalna walidacja ekspresji FLVCR1 i dokowanie molekularne potencjalnych związków celujących w FLVCR1. (A) Reprezentatywne obrazy western blot wykazujące ekspresję białka FLVCR1 w grupie CON i w keloidzie. GAPDH służył jako kontrola ładowania. (B) Ilościowe oznaczenie poziomu białka FLVCR1 znormalizowane do GAPDH. (C) Względne poziomy ekspresji mRNA FLVCR1 w fibroblastach CON i keloidowych określone za pomocą qRT-PCR. GAPDH zastosowano jako referencję wewnętrzną. (D–G) Trójwymiarowe reprezentacje przewidywanych trybów wiązania między FLVCR1 a wybranymi związkami małocząsteczkowymi: (D) (+)-Gallocatechin. (E) (-)-Epicatechin. (F) (-)-Gallocatechin. (G) Cyanidin (Chloride). Skróty: FLVCR1 = feline leukemia virus subgroup C receptor 1; CON, kontrola; GAPDH, dehydrogenaza glikolizowa (glyceraldehyde-3-phosphate dehydrogenase); qRT-PCR, ilościowa reakcja polimerazy w łańcuchu z odwrotną transkrypcją; SD, odchylenie standardowe. Dane przedstawiono jako średnia ± SD. Istotność statystyczna: ns, P > 0.05; *, P < 0.05; **, P < 0.01; ***, P < 0.001; oraz ****, P < 0.0001. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Potwierdzenie stabilności kompleksu FLVCR1–(+)-gallocatechina za pomocą symulacji dynamiki molekularnej
Aby zbadać wiarygodność przewidywanego trybu wiązania ligandu z białkiem, przeprowadzono symulację dynamiki molekularnej (MD) dla kompleksu FLVCR1–(+)-gallocatechiny. Analiza skupiała się na tym, czy kompleks pozostał stabilny strukturalnie w czasie oraz czy wiązanie ligandu zmieniło zachowanie konformacyjne białka, z wykorzystaniem RMSD, RMSF, promienia żyracji (Rg), SASA, analizy wiązań wodorowych oraz obliczeń MM/GBSA. Analiza RMSD (Rycina 7A) wykazała, że zarówno apo-białko, jak i kompleks związany z ligandem uległy początkowym fluktuacjom w ciągu pierwszych 20 ns, po których nastąpiła stopniowa stabilizacja, co wskazuje, że układy osiągnęły stan równowagi podczas symulacji. Po etapie równoważenia wartość RMSD kompleksu FLVCR1–(+)-gallocatechiny pozostała poniżej 0,2 nm, co sugeruje, że wiązanie ligandu przyczyniło się do utrzymania stabilności strukturalnej FLVCR1. Analiza RMSF (Rycina 7B) wykazała, że większość reszt wykazywała ograniczone fluktuacje w trakcie symulacji, co wskazuje na zachowanie ogólnej integralności białka, podczas gdy kilka obszarów elastycznych może reprezentować regiony pętli zaangażowane w akomodację ligandu. Ponadto stabilne profile Rg i SASA (Rycina 7C,D) wskazały, że kompleks utrzymał kompaktową konformację, bez wyraźnej ekspansji strukturalnej lub zmian w ekspozycji na rozpuszczalnik. Analiza wiązań wodorowych (Rycina 7E) ujawniła, że kompleks FLVCR1–(+)-gallocatechiny utrzymywał trwałe oddziaływania międzycząsteczkowe, z utworzeniem około 3–4 wiązań wodorowych podczas symulacji, co potwierdza stabilność asocjacji ligand–białko. Analiza MM/GBSA wykazała ponadto, że kompleks FLVCR1–(+)-gallocatechiny charakteryzował się korzystną wolną energią wiązania (ΔGtotal = −34,87 ± 4,13 kcal/mol) (Tabela uzupełniająca S6). Analiza dekompozycji energii wskazała, że głównymi korzystnymi czynnikami sprzyjającymi wiązaniu były oddziaływania van der Waalsa (ΔVDWAALS = −46,34 ± 2,16 kcal/mol) i oddziaływania elektrostatyczne (ΔEelec = −14,09 ± 3,45 kcal/mol), mimo niekorzystnego wkładu energii solwatacji polarnej (ΔGsolvation = 25,55 ± 0,74 kcal/mol) (Tabela uzupełniająca S6). Zbiorczo wyniki tych symulacji MD wykazały, że (+)-gallocatechina utworzyła stabilny kompleks z FLVCR1, co dodatkowo potwierdziło wiarygodność trybu wiązania przewidzianego przez dokowanie.
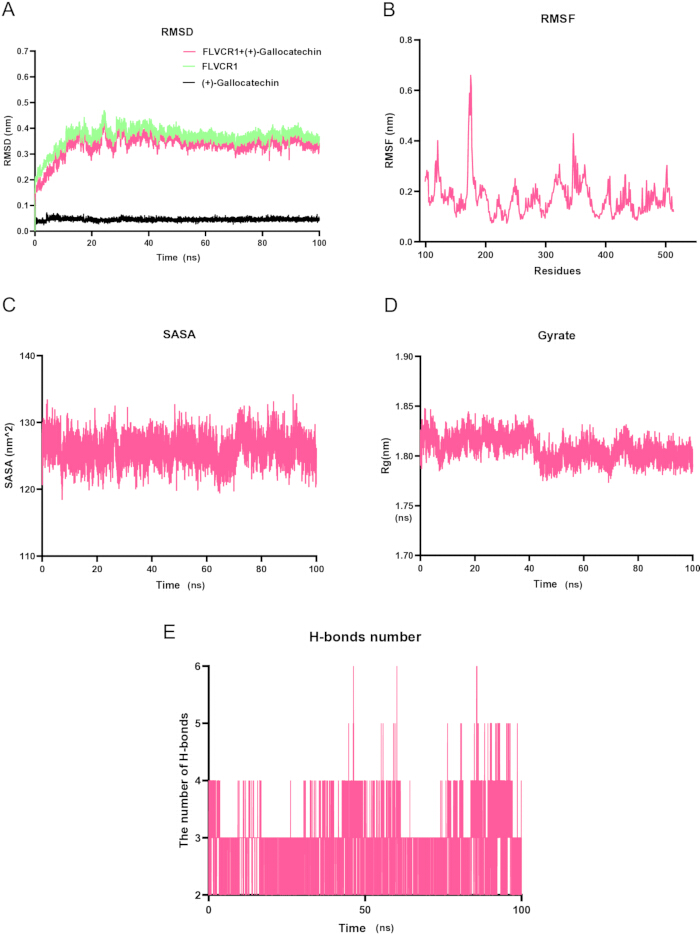
Rysunek 7: Analiza symulacji dynamiki molekularnej kompleksu FLVCR1–(+)-Gallocatechin. (A) Profile RMSD dla apo FLVCR1 oraz kompleksu FLVCR1–(+)-Gallocatechin podczas 100 ns symulacji dynamiki molekularnej. (B) Profil RMSF pokazujący fluktuacje na poziomie poszczególnych reszt białka FLVCR1 podczas symulacji. (C) Profil SASA pokazujący zmiany w powierzchni dostępnej dla rozpuszczalnika kompleksu FLVCR1–(+)-Gallocatechin. (D) Profil Rg oceniający zwartość kompleksu FLVCR1–(+)-Gallocatechin podczas symulacji. (E) Analiza wiązań wodorowych pokazująca dynamiczne oddziaływania międzycząsteczkowe między FLVCR1 a (+)-Gallocatechin w trakcie symulacji. Skróty: FLVCR1 = feline leukemia virus subgroup C receptor 1; RMSD = root mean square deviation; RMSF = root mean square fluctuation; SASA = solvent-accessible surface area; Rg = promień bezwładności. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
Dostępność danych:
Publicznie dostępne zbiory danych transkrypomicznych analizowane w niniejszym badaniu są dostępne w bazie Gene Expression Omnibus (GEO) pod numerami dostępu GSE44270, GSE7890 oraz GSE163973. Dane źródłowe wygenerowane w tym badaniu, stanowiące podstawę walidacji eksperymentalnej, w tym pomiary qRT-PCR, oryginalne obrazy western blot oraz dane z kwantyfikacji western blot, zostały przedstawione jako Supplementary Figure S1, Supplementary Table S1, Supplementary Table S2, Supplementary Table S3 oraz Supplementary Table S4. Wyniki dokowania molekularnego oraz dane dotyczące wolnej energii wiązania MM/GBSA zostały również zamieszczone w Supplementary Table S5 i Supplementary Table S6.
Rysunek dodatkowy S1: Oryginalne dane z western blottingu.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca S1: Geny związane z metabolizmem hemu.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca S2: Sekwencje starterów wybranych genów. Aby pobrać ten plik, kliknij tutaj.
Tabela uzupełniająca S3: Podejścia uczenia maszynowego w identyfikacji potencjalnych biomarkerów diagnostycznych w keloidach. Prosimy kliknąć tutaj, aby pobrać ten plik.
Tabela uzupełniająca S4: Surowe dane potwierdzające eksperymentalną walidację ekspresji FLVCR1. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca S5: 20 najlepszych związków kandydackich zidentyfikowanych za pomocą dokowania molekularnego z FLVCR1.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca S6: Analiza wolnej energii wiązania MM/GBSA kompleksu FLVCR1–(+)-gallocatechiny.Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Niniejsze badanie identyfikuje potencjalny związek między rozregulowanym metabolizmem hemu, ekspresją FLVCR1 a zmianami w mikrośrodowisku immunologicznym podczas tworzenia się keloidów. Integrując transkryptomikę masową (bulk) i jednokomórkową, wykazaliśmy, że FLVCR1 stanowi molekularny węzeł łączący niedobór eksportu hemu z patologicznym przeprogramowaniem immunologicznym, co sytuuje keloidy w obrębie wyłaniającego się spektrum zaburzeń „metabo-fibrotycznych”23,24,25. Potencjalna rola FLVCR1 jest wsparta zbieżnymi dowodami z wielu poziomów analizy. Transkryptomika masowa ujawniła jego znaczną nadekspresję w tkankach keloidów z silną wartością diagnostyczną, podczas gdy mapowanie w rozdzielczości jednokomórkowej zlokalizowało jego ekspresję głównie w komórkach śródbłonka i melanocytach — dwóch typach komórek krytycznie zaangażowanych w patogenezę keloidów odpowiednio poprzez aberracyjną angiogenezę i hiperpigmentację26,27. Co najważniejsze, ekspresja FLVCR1 wykazywała silną ujemną korelację z limfocytami T pomocniczymi pęcherzykowymi (Tfh), podgrupą limfocytów coraz częściej rozpoznawaną jako promująca odporność ukierunkowaną na Th2 i odkładanie kolagenu w mikrośrodowiskach włóknistych28. Wcześniejsze badania wykazały, że zależny od FLVCR1 eksport hemu bierze udział w dojrzewaniu komórek dendrytycznych i prezentacji antygenów29, co sugeruje potencjalny związek między homeostazą hemu powiązaną z FLVCR1 a regulacją immunologiczną. Zaobserwowana nadekspresja FLVCR1 oraz jej ujemna korelacja z infiltracją komórek Tfh mogą zatem odzwierciedlać zmiany w homeostazie immunologicznej, potencjalnie obejmujące związane z Tfh cytokiny profibrotyczne, takie jak IL-4 i IL-1329,30,31.
Ponadto wewnątrzkomórkowa akumulacja hemu wynikająca z dysfunkcji FLVCR1 prawdopodobnie aktywuje inflamasom NLRP3 — mechanizm dobrze udokumentowany w włóknieniu wątroby, gdzie hem służy jako molekularny wzorzec powiązany z uszkodzeniem (DAMP), wyzwalający zapalenie sterylne32,33,34. Taka aktywacja inflamasomu promowałaby uwalnianie IL-1β/IL-18, napędzając polaryzację makrofagów M2 poprzez sygnalizację TLR4/NF-κB i tworząc samopodtrzymującą się pętlę stresu oksydacyjnego i aktywacji fibroblastów35,36. Zbiorczo dane te wskazują na FLVCR1 jako kandydata na biomarker i potencjalnego uczestnika interakcji między metabolizmem hemu a układem odpornościowym w keloidach; jednak zaproponowana kaskada mechanistyczna wymaga bezpośredniej walidacji funkcjonalnej. Wewnątrzkomórkowa retencja hemu najpierw indukuje uszkodzenia oksydacyjne i aktywuje inflamasom, co następnie prowadzi do dysfunkcji komórek dendrytycznych, promując tym samym przechył w stronę limfocytów T pomocniczych pęcherzykowych oraz odpowiedzi odpornościowych typu Th2; to odchylenie immunologiczne dodatkowo napędza polaryzację makrofagów w stronę fenotypu M2, co ostatecznie skutkuje aktywacją fibroblastów i progresją fibrogenezy.
Poza samodzielnym działaniem FLVCR1, synergistyczna dysregulacja wszystkich sześciu biomarkerów ujawnia skoordynowany rozpad homeostazy hemu w wielu węzłach regulacyjnych. TMCC2, dodatnio skorelowany z aktywowanymi komórkami dendrytycznymi, a jednocześnie ujemnie związany z podgrupami niedojrzałymi, może reprezentować mechanizm kompensacyjny próbujący przywrócić kompetencję immunologiczną w warunkach stresu hemowego37,38. EIF2AK1, silnie ekspresjonowany w fibroblastach keloidowych i komórkach gruczołowych, służy jako bezpośredni molekularny sensor nadmiaru hemu, który fosforyluje eIF2α, aby globalnie zahamować syntezę białek, jednocześnie selektywnie zwiększając ekspresję genów odpowiedzi na stres39,40,41. Ustawia to EIF2AK1 w roli krytycznego pomostu przekładającego akumulację hemu na zmianę fenotypową fibroblastów — co potencjalnie wyjaśnia, dlaczego fibroblasty keloidowe wykazują zwiększoną oporność na apoptozę i nadmierną produkcję kolagenu42,43,44. HPX, główny plazmatyczny scavenger hemu, wykazał ograniczoną ekspresję w melanocytach, co sugeruje komórkową próbę buforowania toksyczności hemu w przedziałach bogatych w pigment45,46,47. Równoczesna dysregulacja XK i KEL dodatkowo implikuje udział mechanizmów gospodarki hemowej linii erytroidalnej w patogenezie keloidów — odkrycie to ma intrygujące znaczenie dla zrozumienia, dlaczego keloidy często powstają w miejscach urazów z mikrokrwawieniami. Zamiast postrzegać te sześć genów jako niezależne markery, interpretujemy ich zbiorową dysregulację jako dowód systemowej niewydolności kompartymentalizacji hemu, w której zaburzony eksport (FLVCR1), sensing (EIF2AK1), usuwanie (HPX) oraz transport błonowy (XK, KEL) zbiegają się, tworząc pro-fibrotyczne, bogate w hem mikrośrodowisko.
Ten model metaboliczno-immunologiczny jest dodatkowo wzmocniony przez przekonującą warstwę epigenetyczną: zidentyfikowano sieć ceRNA, w której obniżona regulacja specyficznych miRNA (np. rodziny let-7 i miR-34a-5p) może jednocześnie znosić represję szlaków włóknienia oraz szlaków związanych z metabolizmem hemu, choć model regulacyjny ten wymaga dalszej walidacji23. Rozdzielczość przestrzenna zapewniona przez analizę pojedynczych komórek rzuca światło na choreografię komórkową leżącą u podłoża tego procesu, wykazując, w jaki sposób dysfunkcja metaboliczna w komórkach strukturalnych aktywnie inicjuje środowisko mikrośrodowiska bogate w komórki odpornościowe poprzez parakrynną sygnalizację hemową, przekształcając tym samym nasze rozumienie z perspektywy „tkanki zbiorczej” w dynamiczny model ekosystemu komórkowego48,49,50. Akumulacja hemu w śródbłonku może promować nieszczelność naczyń i ekstrawasację leukocytów poprzez indukcję oksygenazy hemu-1 i upregulację cząsteczek adhezyjnych, co prowadzi do powstania bogatego w komórki odpornościowe mikrośrodowiska obserwowanego w keloidach51,52,53. Jednocześnie ekspresja FLVCR1 w melanocytach koreluje z obserwacjami klinicznymi dotyczącymi hiperpigmentacji keloidów i sugeruje wspólne podatności metaboliczne między szlakami pigmentacyjnymi a włóknieniem — być może pośredniczone przez odpowiedzi na stres oksydacyjny54,55. Takie mapowanie przestrzenne zmienia nasze rozumienie z perspektywy „tkanki zbiorczej” na model ekosystemu komórkowego, w którym dysfunkcja metaboliczna w komórkach strukturalnych (śródbłonek, melanocyty) aktywnie kształtuje zachowanie komórek odpornościowych poprzez parakrynną sygnalizację hemową.
Z punktu widzenia translacyjnego nasz nomogram integrujący wszystkie sześć biomarkerów osiągnął niemal idealną dokładność diagnostyczną, znacząco przewyższając każdy pojedynczy marker i wykazując wyraźną kliniczną korzyść netto w analizie krzywych decyzyjnych. Co więcej, dokowanie molekularne zidentyfikowało (+)-gallocatechinę — bioaktywny polifenol występujący w dużych ilościach w zielonej herbacie i tradycyjnych chińskich ziołach leczniczych — jako ligand FLVCR1 o wysokim powinowactwie, tworzący stabilne wiązania wodorowe z GLU-214, ASN-245, GLN-246 i GLN-471. Wynik ten jest szczególnie przekonujący w świetle wcześniejszych dowodów wskazujących, że katechiny hamują syntezę kolagenu, blokują sekrecję czynnika wzrostu transformującego beta 1 i łagodzą stres oksydacyjny w fibroblastach bliznowców56,57,58. Stawiamy hipotezę, że (+)-gallocatechina może stabilizować konformację FLVCR1 w celu zwiększenia zdolności eksportu hemu, przerywając tym samym metaboliczny wyzwalacz włóknienia u jego źródła — co stanowi strategię zasadniczo odmienną od obecnych terapii, które jedynie hamują kaskadową produkcję kolagenu. To, czy tego rodzaju interwencja metaboliczna mogłaby wpłynąć na nawroty bliznowców, wymaga dalszej walidacji eksperymentalnej i klinicznej.
Oczywiście, niniejsze badanie posiada również pewne ograniczenia. Po pierwsze, nasze analizy mają w przeważającej mierze charakter obliczeniowy, a zaobserwowana korelacja między ekspresją FLVCR1 a infiltracją limfocytów T pomocniczych pęcherzykowych (Tfh) nie ustanawia bezpośredniego związku przyczynowo-skutkowego. Aby wyjaśnić potencjalną rolę FLVCR1 w regulacji odporności, konieczna jest walidacja komórek Tfh za pomocą cytometrii przepływowej oraz badania funkcjonalne obejmujące wyciszenie lub nadekspresję FLVCR1 w fibroblastach keloidów, wraz z analizami interakcji między fibroblastami a komórkami odpornościowymi lub testami z wykorzystaniem pożywki kondycjonowanej. Po drugie, stosunkowo mała liczebność próby może wprowadzać niepewność oraz nadmierny optymizm w ocenie wydajności sygnatury sześciogenowej. Mimo przeprowadzenia walidacji wewnętrznej, wiarygodna ocena wydajności diagnostycznej i kalibracji pozostaje ograniczona. W związku z tym panel sześciogenowy należy traktować jako eksploracyjną sygnaturę molekularną, wymagającą dalszej walidacji w większych, niezależnych kohortach. Po trzecie, zbiór danych z poziomu pojedynczych komórek wymaga rozszerzenia, aby lepiej uchwycić heterogeniczność między pacjentami oraz rzadkie populacje komórek. Po czwarte, walidacja ekspresji biomarkerów na poziomie białek oraz ich lokalizacji przestrzennej za pomocą immunohistochemii wzmocniłaby istotność kliniczną naszych odkryć. Wreszcie, choć dokowanie molekularne sugeruje potencjalne wiązanie (+)-gallocatechiny z FLVCR1, przed przełożeniem tych wyników na praktykę kliniczną niezbędne są badania wiązania in vitro oraz badania skuteczności in vivo. Pomimo tych ograniczeń, nasze wyniki dostarczają wielowymiarowych ram łączących metabolizm hemu związany z FLVCR1 z zaburzeniami odporności w keloidach oraz identyfikują potencjalne biomarkery molekularne i kandydatów terapeutycznych do dalszych badań.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Wkład autorów
Qiuyan Yang przyczyniła się do zaprojektowania badania. Jianping Zhang przyczynił się do gromadzenia danych. Qiuyan Yang i Xiaofang Sun przyczyniły się do analizy statystycznej. Qiuyan Yang i Jing Wang przyczyniły się do przygotowania schematów oraz sfinalizowania rękopisu. Wszyscy autorzy przeczytali i zatwierdzili ostateczną wersję rękopisu.
Podziękowania
Wyrażamy wdzięczność badaczom, którzy wygenerowali i udostępnili publicznie zbiory danych GSE44270, GSE7890 oraz GSE163973 za pośrednictwem bazy danych Gene Expression Omnibus (GEO).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| AmberTools | Amber Project | https://ambermd.org/AmberTools.php | Wersja 22; Generowanie parametrów ligandów przy użyciu pola siłowego GAFF |
| Przeciwciało anty-FLVCR1 | Proteintech | 26841-1-AP | |
| Przeciwciało anty-GAPDH | Proteintech | 60004-1-Ig | |
| AutoDock Vina | The Scripps Research Institute | https://vina.scripps.edu/ | Wersja 1.2.3; Dokowanie molekularne i przewidywanie powinowactwa wiązania ligandów |
| AutoDockTools | The Scripps Research Institute | https://ccsb.scripps.edu/autodocksuite/adt/ | Wersja 1.5.6; Przygotowanie ligandów i receptorów do dokowania molekularnego |
| Zestaw do oznaczania białek metodą BCA | Servicebio | G2026 | |
| Mieszanina do syntezy cDNA dla qPCR z dsDNazą | UnionScript | Transkrypcja odwrotna dla qRT-PCR | |
| ChemBio3D | PerkinElmer | https://revvitysignals.com/products/research/chemdraw | Wersja 14.0; Optymalizacja konformacyjna 3D i minimalizacja energii ligandów |
| System obrazowania chemiluminescencyjnego | Wizualizacja prążków western blot | ||
| Pakiet DoubletDetection | GitHub / JonathanShor | https://github.com/JonathanShor/DoubletDetection | Wykrywanie i usuwanie przewidywanych dubletów w analizie scRNA-seq |
| Substrat chemiluminescencyjny ECL | Detekcja sygnału western blot | ||
| Płodowa surowica bydlęca | Stężenie końcowe 2%; Suplement do pożywki dla hodowli fibroblastów | ||
| Pożywka do wzrostu fibroblastów 2 (Fibroblast Growth Medium 2) | PromoCell | C-23020 | |
| Startery FLVCR1 i GAPDH | Tabela uzupełniająca S2 | Amplifikacja genów docelowych i referencyjnych metodą qRT-PCR | |
| Gaussian | Gaussian, Inc. | https://gaussian.com/ | Gaussian 16W; Obliczanie ładunków atomowych RESP dla parametryzacji ligandów |
| Aparat do elektroforezy żelowej | Rozdział białek metodą SDS-PAGE | ||
| Pakiet GEOquery | Bioconductor | https://bioconductor.org/packages/GEOquery/ | Wersja 2.68.0; Pobieranie danych o ekspresji genów i metadanych z bazy danych GEO |
| Pakiet ggplot2 | CRAN | https://cran.r-project.org/package=ggplot2 | Wersja 4.0.2; Wizualizacja danych |
| Pakiet glmnet | CRAN | https://cran.r-project.org/package=glmnet | Wersja 4.1.10; Selekcja cech metodą LASSO |
| GROMACS | GROMACS Development Team | https://www.gromacs.org/ | Wersja 2022.3; Symulacje dynamiki molekularnej i analiza trajektorii |
| GS AntiQ qPCR SYBR Green Fast Mix (Universal) | Genesand | SQ410 | |
| GSE163973 | Baza danych GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE163973 | 3 próbki keloidów; Analiza ekspresji na poziomie pojedynczych komórek |
| GSE44270 | Baza danych GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE44270 | 18 próbek keloidów i 14 próbek normalnych; Analiza ekspresji różnicowej i screening biomarkerów |
| GSE7890 | Baza danych GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE7890 | 10 próbek keloidów i 9 próbek normalnych; Niezależna walidacja biomarkerów diagnostycznych |
| Pakiet GSVA | Bioconductor | https://bioconductor.org/packages/GSVA/ | Wersja 1.48.3; Analiza infiltracji komórek odpornościowych oparta na ssGSEA |
| Koniugowany z HRP kozia anty-mysia IgG | Abcam | ab97040 | |
| Koniugowany z HRP kozia anty-krolicza IgG | Abcam | ab97051 | |
| Inkubator z nawilżonym CO2 | 37 °C, 5% CO2; Utrzymanie komórek NHDF i PKF | ||
| ImageJ | National Institutes of Health | https://imagej.nih.gov/ij/ | Kwantyfikacja intensywności prążków western blot |
| Insulina | Stężenie końcowe 5 μg/mL; Suplement do pożywki dla hodowli fibroblastów | ||
| Baza danych Sygnatur Molekularnych (MSigDB) | Broad Institute | https://www.gsea-msigdb.org/gsea/msigdb | Wersja 2024.1.Hs; Źródło zestawów genów związanych z metabolizmem hemu |
| NetworkAnalyst | NetworkAnalyst | https://www.networkanalyst.ca/ | Wersja 3.0; Konstrukcja sieci interakcji miRNA-mRNA |
| NHDF | Procell | CP-H106 | |
| Beztłuszczne mleko w proszku | Roztwór 5%; Blokowanie membrany dla analizy western blot | ||
| Optyczna folia uszczelniająca lub nakrętki | Uszczelnianie reakcji qRT-PCR | ||
| PBS | Procell | PB180327 | |
| PDB ID: 8UBZ | RCSB PDB | https://www.rcsb.org/structure/8UBZ | Struktura ludzkiego białka FLVCR1; Źródło struktury białka FLVCR1 dla wirtualnego screeningu opartego na strukturze |
| Inhibitory fosfataz | Suplement do buforu do lizy białek | ||
| PKF | Procell | GCP-H235 | |
| PMSF | Servicebio | G2008-1ML | |
| Pakiet pROC | CRAN | https://cran.r-project.org/package=pROC | Wersja 1.19.0.1; Analiza krzywych ROC i AUC |
| Koktajl inhibitorów proteaz | Roche | 4693124001 | |
| Aparat do transferu białek | Transfer białek na membranę PVDF | ||
| Membrana PVDF | Millipore | IPVH08100 | |
| PyMOL | Schrödinger, LLC | https://pymol.org/ | Wersja 2.6.1; Wizualizacja i analiza póz dokowania białko-ligand oraz oddziaływań molekularnych |
| Płytki lub probówki do qRT-PCR | Przygotowanie reakcji qRT-PCR | ||
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Wersja 4.3.1; Analizy statystyczne i bioinformatyczne |
| Pakiet randomForest | CRAN | https://cran.r-project.org/package=randomForest | Wersja 4.7.1.2; Selekcja cech metodą lasów losowych |
| REACTOME_HEME_BIOSYNTHESIS; REACTOME_HEME_DEGRADATION; WIKIPATHWAYS_HEME_BIOSYNTHESIS; REACTOME_SCAVENGING_HEME_FROM_PLASMA; HALLMARK_HEME_METABOLISM | Baza danych Sygnatur Molekularnych (MSigDB) | https://www.gsea-msigdb.org/gsea/msigdb | Wersja 2024.1.Hs; 283 unikalne geny po scaleniu; Definicja genów związanych z metabolizmem hemu |
| System PCR w czasie rzeczywistym | Amplifikacja i detekcja qRT-PCR | ||
| Rekombinowany ludzki podstawowy czynnik wzrostu fibroblastów | Stężenie końcowe 1 ng/mL; Suplement do pożywki dla hodowli fibroblastów | ||
| Bufor RIPA | Servicebio | G2002 | |
| Pakiet rms | CRAN | https://cran.r-project.org/package=rms | Wersja 6.7.1; Konstrukcja nomogramu |
| Odczynniki do SDS-PAGE lub gotowe żele | Rozdział białek metodą SDS-PAGE | ||
| Pakiet Seurat | CRAN | https://satijalab.org/seurat/ | Wersja 5.4.0; Przetwarzanie wstępne, klasteryzacja i wizualizacja scRNA-seq |
| TarBase | DIANA Tools | https://carolina.imis.athena-innovation.gr/diana_tools/ | Wersja 9.0; Źródło eksperymentalnie potwierdzonych interakcji miRNA-mRNA |
| Total RNA Kit II | Omega | R6934-01 | |
| Biblioteka aktywnych związków tradycyjnej medycyny chińskiej | Źródło związków kandydackich do wirtualnego screeningu | ||
| Bufor solny z Tween/Tris | Przygotowanie buforu blokującego i przemywanie membrany | ||
| UnionScript First-strand cDNA Synthesis Mix for qPCR (with dsDNase) | Genesand | SR511 |
Bibliografia
- Dirand Z, et al. Macrophage phenotype is determinant for fibrosis development in keloid disease. Matrix Biol. 2024;128:79-92.
- Fang X, et al. Hypertrophic scarring and keloids: epidemiology, molecular pathogenesis, and therapeutic interventions. MedComm (2020). 2025;6(10):e70381.
- Adler R, et al. Pentoxifylline and long-term risk of keloid formation: a real-world 10-year outcomes study using TriNetX. J Am Acad Dermatol. 2026;94(5):1561-3.
- Banerjee P, et al. Anti-fibrotic properties of a decellularized extracellular matrix scaffold from porcine small intestinal submucosa in normal human and keloid fibroblasts. Int J Mol Sci. 2025;26(24):11764.
- Chang YH, McGrath JA, Hsu CK. Regression of extensive keloids during imatinib therapy for gastrointestinal stromal tumor. JAMA Dermatol. 2025;161(12):1293-4.
- Wang QR, et al. CCL17 drives fibroblast activation in the progression of pulmonary fibrosis by enhancing the TGF-β/Smad signaling. Biochem Pharmacol. 2023;210:115475.
- Higuchi Y, et al. Cavin-2 promotes fibroblast-to-myofibroblast trans-differentiation and aggravates cardiac fibrosis. ESC Heart Fail. 2024;11(1):167-78.
- Zhang H, et al. Plasma apolipoprotein E protein attenuates pulmonary fibrosis through LRP1 and PLAU dual receptor-mediated TGF-β/Smad inhibition. J Adv Res. 2025. doi:10.1016/j.jare.2025.12.045.
- Chen Q, et al. Immune imbalance drives keloid pathogenesis: emerging targets for precision immunotherapy. Adv Wound Care (New Rochelle). 2026:21621918261417702.
- Deng CC, et al. Single-cell RNA-seq reveals immune cell heterogeneity and increased Th17 cells in human fibrotic skin diseases. Front Immunol. 2024;15:1522076.
- Wang Q, et al. Weighted gene co-expression network analysis and machine learning identified the lipid metabolism-related gene LGMN as a novel biomarker for keloid. Exp Dermatol. 2024;33(1):e14974.
- Zhang W, et al. New insights into keloid pathogenesis: biomarker potential for CDK7 and DDB2. Front Cell Dev Biol. 2025;13:1718189.
- Li W, et al. Altered arginine metabolism affects proliferation and radiosensitivity of keloids. Exp Dermatol. 2025;34(3):e70077.
- Jiang J, et al. Ambient fine particulate matter induces cardiac fibrosis through triggering ferroptosis by heme degradation induced-iron overload. Ecotoxicol Environ Saf. 2025;297:118227.
- Lin W, et al. Heme oxygenase-1 overexpression activates the IRF1/DRP1 signaling pathway to promote M2-type polarization of spinal cord microglia. Drug Dev Res. 2024;85(8):e70033.
- Knez J, Kovačič B, Goropevšek A. The role of regulatory T-cells in the development of endometriosis. Hum Reprod. 2024;39(7):1367-80.
- Voltarelli VA, et al. Heme: the lord of the iron ring. Antioxidants (Basel). 2023;12(5):1074.
- Wilks A, Egoshi R. Heme trafficking and the importance of handling nature's most versatile cofactor. Chem Rev. 2025;125(23):11358-78.
- Bertino F, et al. Dysregulation of FLVCR1a-dependent mitochondrial calcium handling in neural progenitors causes congenital hydrocephalus. Cell Rep Med. 2024;5(7):101647.
- Kumar A, et al. Iron regulates the quiescence of naive CD4 T cells by controlling mitochondria and cellular metabolism. Proc Natl Acad Sci U S A. 2024;121(17):e2318420121.
- Jiang H, et al. Gut microbiota dysbiosis in diabetic nephropathy: mechanisms and therapeutic targeting via the gut-kidney axis. Front Endocrinol (Lausanne). 2025;16:1661037.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-62.
- Chen Y, et al. 5-ALA photodynamic metabolite-powered zero-waste ferroptosis amplifier for enhanced hypertrophic scar therapy. Nat Commun. 2025;16(1):8321.
- Li X, et al. Hypericin-mediated photodynamic therapy promotes apoptosis and inhibits fibrosis by inducing HMOX1-mediated ferroptosis in hypertrophic scar fibroblasts. J Photochem Photobiol B. 2025;273:113303.
- Chen Y, et al. Functional transdermal nanoethosomes enhance photodynamic therapy of hypertrophic scars via self-generating oxygen. ACS Appl Mater Interfaces. 2021;13(7):7955-65.
- Oh S, et al. Revealing the pathogenesis of keloids based on the status: active vs inactive. Exp Dermatol. 2024;33(5):e15088.
- Zhao S, et al. New anti-fibrotic strategies for keloids: insights from single-cell multi-omics. Cell Prolif. 2025;58(6):e13818.
- Yasujima T, et al. The role of FLVCR1 and FLVCR2 in choline transport in the Caco-2 intestinal epithelial cell model and rat small intestine. Biochim Biophys Acta Mol Basis Dis. 2025;1871(6):167883.
- Zhang M, Chen H, Qian H, Wang C. Characterization of the skin keloid microenvironment. Cell Commun Signal. 2023;21(1):207.
- Wang Y, et al. FoxC1 activates Notch3 signaling to promote the inflammatory phenotype of keloid fibroblasts and aggravates keloid. Exp Cell Res. 2025;444(2):114402.
- Zhang J, et al. ERG transcriptionally activates SFRP1 to promote apoptosis of keloid fibroblasts and inhibit epithelial-mesenchymal transition and fibrosis through the Wnt3a/β-catenin pathway. Arch Dermatol Res. 2025;317(1):467.
- Ramos-Tovar E, Muriel P. NLRP3 inflammasome in hepatic diseases: a pharmacological target. Biochem Pharmacol. 2023;217:115861.
- Brahadeeswaran S, et al. NLRP3: a new therapeutic target in alcoholic liver disease. Front Immunol. 2023;14:1215333.
- Xiao Y, et al. STING mediates hepatocyte pyroptosis in liver fibrosis by epigenetically activating the NLRP3 inflammasome. Redox Biol. 2023;62:102691.
- Paolucci T, et al. Quantum molecular resonance inhibits NLRP3 inflammasome/nitrosative stress and promotes M1 to M2 macrophage polarization: potential therapeutic effect in osteoarthritis model in vitro. Antioxidants (Basel). 2023;12(7):1358.
- Wei J, et al. FERM domain containing kindlin 1 knockdown attenuates inflammation induced by intracerebral hemorrhage in rats via NLR family pyrin domain containing 3/nuclear factor kappa B pathway. Exp Anim. 2023;72(3):324-35.
- Tao L, Zhou Y, Wu L, Liu J. Comprehensive analysis of sialylation-related genes and construct the prognostic model in sepsis. Sci Rep. 2024;14(1):18110.
- Sun Q, et al. Identification of hub genes and key pathways associated with sepsis progression using weighted gene co-expression network analysis and machine learning. Int J Mol Sci. 2025;26(9):4433.
- Chen JJ. HRI protein kinase in cytoplasmic heme sensing and mitochondrial stress response: relevance to hematological and mitochondrial diseases. J Biol Chem. 2025;301(5):108494.
- Chakrabarty Y, Yang Z, Chen H, Chan DC. The HRI branch of the integrated stress response selectively triggers mitophagy. Mol Cell. 2024;84(6):1090-100.e6.
- Bora P, et al. Drug repurposing screen identifies an HRI activating compound that promotes adaptive mitochondrial remodeling in MFN2-deficient cells. Proc Natl Acad Sci U S A. 2025;122(48):e2517552122.
- Zhang C, et al. CaMKII suppresses proteotoxicity by phosphorylating BAG3 in response to proteasomal dysfunction. EMBO Rep. 2024;25(10):4488-514.
- Chaabani H, et al. Trifloxystrobin induces oxidative stress-dependent activation of the OMA1-DELE1-HRI integrated stress response leading to apoptosis in human neuroblastoma cells. Environ Pollut. 2026;390:127562.
- Das R, et al. CMT2A-linked MFN2 mutation, T206I promotes mitochondrial hyperfusion and predisposes cells towards mitophagy. Mitochondrion. 2024;74:101825.
- De Simone G, et al. Heme scavenging and delivery: the role of human serum albumin. Biomolecules. 2023;13(3):575.
- Turilli-Ghisolfi ES, Lualdi M, Fasano M. Ligand-based regulation of dynamics and reactivity of hemoproteins. Biomolecules. 2023;13(4):683.
- Zhang P, et al. Risk factors and prediction models for cardiotoxicity induced by anthracyclines in malignant chemotherapy. Cancer Chemother Pharmacol. 2025;95(1):73.
- Petrillo S, et al. Endothelial cells require functional FLVCR1a during developmental and adult angiogenesis. Angiogenesis. 2023;26(3):365-84.
- Fiorito V, Tolosano E. Unearthing FLVCR1a: tracing the path to a vital cellular transporter. Cell Mol Life Sci. 2024;81(1):166.
- Manco M, et al. FLVCR1a controls cellular cholesterol levels through the regulation of heme biosynthesis and tricarboxylic acid cycle flux in endothelial cells. Biomolecules. 2024;14(2):149.
- Shi X, et al. Increased melanin induces aberrant keratinocyte-melanocyte-basal-fibroblast cell communication and fibrogenesis by inducing iron overload and ferroptosis resistance in keloids. Cell Commun Signal. 2025;23(1):141.
- Khunger N, Dash A. Impact of air pollution on skin pigmentation: mechanisms and protective strategies. Int J Dermatol. 2025;64(10):1788-801.
- Ahuja K, Raju S, Dahiya S, Motiani RK. ROS and calcium signaling are critical determinant of skin pigmentation. Cell Calcium. 2025;125:102987.
- Dutta A, Chakraborty S, Roy A, Mittal A, et al. Tissue fibrosis in cardiorenal syndrome: crosstalk between heart and kidneys. Nephrol Dial Transplant. 2025;40(7):1273-83.
- Noah AA, et al. Reversal of fibrosis and portal hypertension by empagliflozin treatment of CCl4-induced liver fibrosis: emphasis on gal-1/NRP-1/TGF-β and gal-1/NRP-1/VEGFR2 pathways. Eur J Pharmacol. 2023;959:176066.
- Murakami T, Shigeki S. Pharmacotherapy for keloids and hypertrophic scars. Int J Mol Sci. 2024;25(9):4674.
- Jin J, Zheng Z. Gut microbiota-derived metabolites in keloid and hypertrophic scarring. Front Microbiol. 2025;16:1644758.
- Aubert A, et al. Potential implications of granzyme B in keloids and hypertrophic scars through extracellular matrix remodeling and latent TGF-β activation. Front Immunol. 2024;15:1484462.