Um protocolo de mineração de genoma guiado por espectrometria em massa é estabelecido e descrito aqui. Baseia-se em informações de seqüência de genomas e análise sustal e tem como objetivo facilitar a identificação de moléculas de extratos microbianos e vegetais complexos.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Mineração de genoma guiada por espectrometria em massa como ferramenta para descobrir novos produtos naturais
Neste artigo
Resumo
Resumo
O espaço químico coberto por produtos naturais é imenso e amplamente não reconhecido. Portanto, são desejadas metodologias convenientes para realizar uma avaliação abrangente de suas funções na natureza e potenciais benefícios humanos (por exemplo, para aplicações de descoberta de medicamentos). Este protocolo descreve a combinação de mineração de genoma (GM) e rede molecular (MN), duas abordagens contemporâneas que combinam anotações codificadas por genes em sequenciamento de genoma inteiro com assinaturas de estrutura química a partir de extratos metabólicos brutos. Este é o primeiro passo para a descoberta de novas entidades naturais. Esses conceitos, quando aplicados em conjunto, são definidos aqui como mineração de genoma guiada por MS. Neste método, os principais componentes são previamente designados (usando MN), e novos candidatos estruturalmente relacionados estão associados a anotações de seqüência de genoma (usando GM). A combinação de GM e MN é uma estratégia lucrativa para atingir novos backbones de moléculas ou perfis metabólicos de colheita, a fim de identificar análogos de compostos já conhecidos.
Introdução
As investigações do metabolismo secundário consistem frequentemente na triagem de extratos brutos para atividades biológicas específicas seguidas de purificação, identificação e caracterização dos constituintes pertencentes a frações ativas. Esse processo tem se mostrado eficiente, promovendo o isolamento de diversas entidades químicas. No entanto, hoje em dia isso é visto como inviável, principalmente devido às altas taxas de redescoberta. Como a indústria farmacêutica revolucionou sem o conhecimento dos papéis e funções dos metabólitos especializados, sua identificação foi realizada em condições laboratoriais que não representavam com precisão a natureza1. Hoje, há uma melhor compreensão das influências de sinalização natural, secreção e presença da maioria dos alvos em concentrações indetectavelmente baixas. Além disso, a regulamentação do processo ajudará a comunidade acadêmica e a indústria farmacêutica a aproveitar esse conhecimento. Também beneficiará pesquisas envolvendo o isolamento direto dos metabólitos relacionados a aglomerados genéticos biossintéticos silenciosos (BGCs)2.
Nesse contexto, os avanços no sequenciamento genômico têm renovado o interesse em triagem de metabólitos de microrganismos. Isso porque a análise das informações genômicas de aglomerados biossintéticos descobertos pode revelar genes codificando novos compostos não observados ou produzidos em condições laboratoriais. Muitos projetos ou rascunhos de genoma sumidos microbianos estão disponíveis hoje, e o número está crescendo a cada ano, fornecendo perspectivas maciças para descobrir novas moléculas bioativas através da mineração de genomas3,4.
O Atlas de Clusters Genéticos Biossintéticos é a maior coleção atual de aglomerados genéticos minerados automaticamente como um componente da Plataforma Integrada de Genomas Microbianos do Instituto De genoma conjunto (JGI IMG-ABC)2. Mais recentemente, a Iniciativa de Padronização de Clusters Genéticos Biossintéticos (MIBiG) promoveu a renotação manual dos BGCs, fornecendo um conjunto de dados de referência altamente curado5. Atualmente, muitas ferramentas estão disponíveis para permitir a mineração computacional de dados genéticos e sua conexão com metabólitos secundários conhecidos. Estratégias diferentes também foram desenvolvidas para acessar novos produtos naturais bioativos (ou seja, expressão heteróloga, exclusão de genes alvo, reconstituição in vitro, seqüência genômica, triagem guiada por isótopos [abordagem genomisotópica], manipulação de reguladores locais e globais, mineração baseada em alvos de resistência, mineração independente de cultura e, mais recentemente, abordagens guiadas por MS/código2,6,7,8,9, 10,,11,,12,,13,,14,,15).
A mineração do genoma como estratégia singular requer esforços para anotar um único ou pequeno grupo de moléculas; assim, permanecem lacunas no processo em que novos compostos são priorizados para isolamento e elucidação de estrutura. Em princípio, essas abordagens visam apenas uma via biossintética por experimento, resultando assim em uma lenta taxa de descoberta. Nesse sentido, o uso da GM juntamente com uma abordagem de rede molecular representa um importante avanço para a pesquisa de produtos naturais14,15.
A versatilidade, a precisão e a alta sensibilidade da espectrometria de massa cromatografia líquida (LC-MS) fazem dele um bom método para identificação composta. Atualmente, várias plataformas têm investido algoritmos e suítes de software para metabolômicas não direcionadas16,,17,,18,,19,,20. O núcleo desses programas inclui detecção de recursos (captação de pico)21 e alinhamento de pico, que permite a correspondência de características idênticas em um lote de amostras e a busca de padrões. Algoritmos baseados em padrões de MS22,23 comparam padrões de fragmentação característicos e combinam semelhanças ms2 gerando famílias moleculares compartilhando características estruturais. Essas características podem então ser destacadas e agrupadas, conferindo a capacidade de descobrir rapidamente moléculas conhecidas e desconhecidas a partir de um complexo extrato biológico por tandem MS2,24,25. Portanto, tandem MS é um método versátil para obter informações estruturais de vários quimiotipos contidos em uma grande quantidade de dados simultaneamente.
O algoritmo Global Natural Products Social Molecular Networking (GNPS)26 usa a intensidade de íons fragmentos normalizados para construir vetores multidimensionais, nos quais as semelhanças são comparadas usando uma função cossena. A relação entre diferentes íons-pais é plotada em uma representação de diagrama, na qual cada fragmentação é visualizada como um nó (círculos), e a relação de cada nó é definida por uma borda (linhas). A visualização global de moléculas de uma única fonte é definida como uma rede molecular. Moléculas estruturalmente divergentes que se fragmentam exclusivamente formarão seu próprio aglomerado ou constelação específico, enquanto moléculas relacionadas se agrupam. O agrupamento de quimiotipos permite a conexão hipotética de características estruturais semelhantes às suas origens biossintéticas.
A combinação tanto do quimiotipo ao genótipo quanto das abordagens genótipo-quimiotipo é poderosa ao criar ligações bioinformática entre os BGCs e seus produtos de pequenas moléculas27. Portanto, a mineração de genoma guiada por ESM é um método rápido e uma estratégia de baixo consumo de material, e ajuda a ponte de íons-mãe e vias biossintéticas reveladas pelo WGS de uma ou mais cepas diversas condições metabólicas e ambientais.
O fluxo de trabalho deste protocolo (Figura 1) consiste em alimentar dados WGS em uma plataforma de anotação de cluster genético biossintético, como antiSMASH28,,29,,30. Ajuda a estimar a variedade de compostos e classe de compostos codificados pelo genoma. Uma estratégia para atingir um aglomerado genético biossintético codificando uma entidade química de interesse deve ser adotada, e extratos de cultura de uma cepa de tipo selvagem e/ou cepa heteróloga contendo o BGC podem ser analisados para gerar íons agrupados com base em semelhanças usando GNPS26,31. Consequentemente, é possível identificar novas moléculas que se associam ao BGC direcionado e não estão disponíveis no banco de dados (principalmente análogos desconhecidos, às vezes produzidos em títulos baixos). É relevante considerar que os usuários podem contribuir para essas plataformas e que a disponibilidade de dados de bioinformática e MS/MS está aumentando rapidamente, levando a um constante desenvolvimento e atualização de ferramentas e algoritmos computacionais eficazes para orientar conexões eficientes de extratos complexos com moléculas.
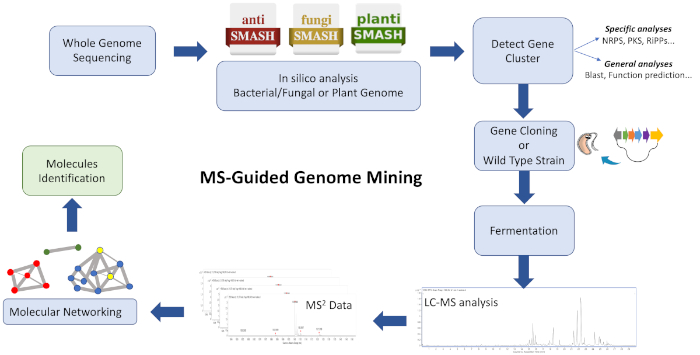
Figura 1: Visão geral de todo o fluxo de trabalho. Mostrada é uma ilustração das etapas bioinformática, clonagem e rede molecular envolvidas na abordagem descrita de mineração de genoma sustal para identificar novos metabólitos. Clique aqui para ver uma versão maior desta figura.
Este protocolo descreve um fluxo de trabalho rápido e eficiente para combinar mineração de genoma e rede molecular como ponto de partida para o pipeline de descoberta de produtos naturais. Embora muitas aplicações sejam capazes de visualizar a composição e a relação de moléculas detectáveis em MS em uma rede, várias são adotadas aqui para visualizar moléculas agrupadas estruturalmente semelhantes. Utilizando essa estratégia, novos produtos de ciclodepsipeptídeos observados em extratos metabólicos de Estreptomices sp. CBMAI 2042 são identificados com sucesso. Guiado pela mineração do genoma, toda a codificação de aglomerados genéticos biossintéticos para valinomicinas é reconhecida e clonada na cepa produtora Streptomyces coelicolor M1146. Finalmente, seguindo uma rede molecular baseada em padrão de MS, as moléculas detectadas por MS estão correlacionadas com os BGCs responsáveis por sua biogênese32.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
1. Mineração de genoma para aglomerados genéticos biossintéticos
- Realizar o sequenciamento de genomainteiro (WGS) como o primeiro passo para eleger um cluster genético biossintético (BCG) para a mineração de genoma suscitado por MS. Todo o esboço de genoma da cepa de interesse (bactérias) pode ser obtido pela tecnologia Illumina MiSeq usando o seguinte com DNA genômico de alta qualidade: shotgun TruSeq PCR-Free library prep e Nextera Mate Pair Library Preparation Kit33.
NOTA: Após o sequenciamento, a biblioteca de espingardas Illumina e a biblioteca do par de companheiros de Illumina podem ser montadas usando o Newbler v3.0 (Roche, 454) programa de montagem (encontrado em ) e anotado usando um pipeline baseado em FgeneSB (encontrado em ), como descrito anteriormente33. Microbiologia Resource Announcements (MRA) é uma revista de acesso totalmente aberto com artigos que publicam a disponibilidade de qualquer recurso microbiológico depositado em um repositório disponível (encontrado em ). Os genes de codificação de proteínas do candidato são identificados usando a anotação do servidor RAST34, e o projeto Whole Genome Shotgun (WGS) é depositado nas seqüências ddbj/ena/genbank (encontradas em ) e Gold (encontrado em ). - Para obter em sílico informações sobre anotações de clusters genéticos do metabolismo secundário a partir de um genoma seqüenciado completo, envie o arquivo de seqüência (formato GenBank/EMBL ou FASTA) para uma plataforma antiSMASH (encontrada em ).
- Selecione o cluster genético de interesse a partir dos dados de saída(Figura 2)com base no cluster conhecido mais semelhante.
NOTA: Primeiro, é rotineiro explorar gene por gene e realizar pesquisas individuais (blastp) para avaliar quais funções estão associadas aos grupos genéticos biossintéticos desejados. Este procedimento também pode ajudar a determinar qual BGC provavelmente está associado à produção de um composto desejado, mesmo que seja uma porcentagem baixa. Uma previsão antiSMASH considera todos os genes dentro de um cluster para fazer uma cobertura percentual, o que pode representar um baixo percentual global de similaridade para o BGC destinado. No entanto, ao analisar gene por gene, é possível obter informações mais precisas usando o cluster mais semelhante conhecido. Em segundo lugar, o antiSMASH tem duas opções para refinar uma pesquisa: 1) rigidez de detecção: o grau de rigidez a que o cluster genético biossintético deve ser considerado um hit. Para esta opção, o usuário deve utilizar os seguintes parâmetros: a) rigoroso: detecta clusters exclusivamente bem definidos contendo todas as regiões requeridas, insuscetíveis a erros sobre informações genéticas; b) relaxado: detecta aglomerados parciais faltando uma ou mais região funcional, que também funciona para detectar o recurso rigoroso; ou c) solto: detecta clusters e clusters mal definidos que provavelmente correspondem a metabólitos primários, o que pode levar ao aparecimento de falsos positivos ou BGCs mal definidos. A outra opção é 2) recursos extras: o tipo de informação que a plataforma deve procurar e mostrar na saída. Em geral, essas duas opções podem economizar tempo após a previsão. No entanto, o trabalho antiSMASH requer um período de tempo mais longo.
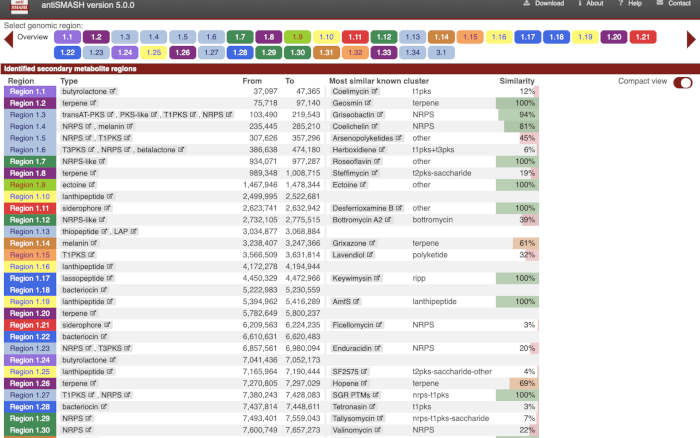
Figura 2: Saída da plataforma antiSMASH. Metabolismo secundário na análise de sílico de anotação de seqüência de genoma inteiro. Clique aqui para ver uma versão maior desta figura.
- Com base nas informações da seqüência de DNA do BGC, primers de design (20-25 nt) flanqueando o cluster genético para eSAC(E. coli/Streptomyces Artificial Chromosome) triagem da biblioteca.
NOTA: Diferentes métodos35,36 podem ser usados para capturar todo o aglomerado genético biossintético a partir do DNA. Aqui, o método utilizado é a construção de uma biblioteca ESAC representativa37,38 de Streptomyces sp. CBMAI 2042 contendo clones com fragmentos de tamanho médio de ~95 kb.
2. Expressão heteróloga de todo o cluster genético biossintético da biblioteca ESAC
- Mova o vetor ESAC de E. coli DH10B para E. coli ET12567 por conjugação triparental32.
- Inoculado E. coli ET12567 (CamR), TOPO10/pR9604 (CarbR), DH10B/ESAC4H (AprR) em 5 mL de Luria-Bertani (LB) meio contendo clorofenicol (25 μg/mL), carbenicina (100 μg/mL) e apramicina (50 μg/mL).
- Incubar a cultura durante a noite a 37 °C e 250 rpm.
- Inocular 500 μL da cultura noturna em 10 mL de meio LB contendo meia-concentração de antibióticos.
- Incubar a cultura a 37 °C e 250 rpm até atingir um A600 de 0,4-0,6.
- Colher as células por centrifugação a 2.200 x g por 5 min.
- Lave as células duas vezes com 20 mL de meio LB.
- Resuspenda as células em 500 μL de meio LB.
- Misture 20 μL de cada cepa em um tubo de microcentrífuga e escorra em uma placa de ágar com meio LB sem antibióticos.
- Incubar as placas a 37 °C durante a noite.
- Estique as células cultivadas em uma placa de ágar LB fresco contendo antibióticos e incubar a 37 °C durante a noite.
3. Conjugação de Estreptomices/E. coli
- Para obter o organismo heterologore recombinante, realize a conjugação32 entre E. coli ET12567 contendo o vetor ESAC, o plasmídeo auxiliar pR9604 e a coptomyceselicolor Streptomyceselicolor M1146 ou outra cepa de hospedeiro selecionada39.
- Dia 1: Inoculaas colônias isoladas de S. coelicolor M1146 em 25 mL de meio TSBY em um frasco erlenmeyer de 250 mL equipado com mola inox a 30 °C e 200 rpm por 48 h.
- Dia 2/3: Inoculado ET12567/ESAC/pR9604 em 5 mL de meio LB contendo clorofenicol (25 μg/mL), carbenicina (100 μg/mL) e apramicina (50 μg/mL) durante a noite a 37 °C e 250 rpm.
- Dia 3/4: Inocular 500 μL da cultura noturna em 10 mL de 2TY (em um tubo cônico de 50 mL) contendo concentrações de meio-trabalho de antibióticos. Incubar a 37 °C e 250 rpm até atingir um A600 de 0,4-0,6.
- Centrifugar as culturas (ET12567/ESAC/pR9604 e M1146) a 2200 x g por 10 min.
- Lave as pelotas 2x em 20 mL de meio 2TY e resuspenda em 500 μL de 2TY.
- Alíquota 200 μL da suspensão S. coelicolor M1146 e diluir em 500 μL de 2TY (suspensão A).
- Alíquota 200 μL de suspensão A e diluir em 500 μL de 2TY (suspensão B).
- Alíquota 200 μL de suspensão B e diluir em 500 μL de 2TY (suspensão C).
- Alíquota 200 μL da suspensão ET12567/ESAC/pR9604 e misture com 200 μL de suspensão C.
- Placa de 150 μL da mistura de conjugação em uma placa de ágar SFM sem antibióticos.
- Incubar a 30 °C por 16 horas.
- Placas de cobertura com 1 mL de solução antibiótico (de acordo com a resistência plasmídea). Após a secagem, incuba r$ 30 °C durante 4-7 dias.
NOTA: Aqui, foi preparada uma solução contendo 1,0 mg/mL de thiostrepton e 0,5 mg/mL de ácido nalidírico. - Exconjugantes putativos de listras em placas de ágar SFM contendo thiostrepton (50 mg/mL) e ácido nalidixic (25 mg/mL). Incubar a 30 °C.
- Estrias exconjugadas em um ágar SFM contendo apenas ácido nalidixic.
- Realizar análises de PCR com colônias isoladas para confirmar que todo o aglomerado genético foi transferido para o hospedeiro S. coelicolor M1146.
4. Cultivo de cepas
- Para obter o perfil metabólico, inocule 1/100 da pré-cultura da cepa em meios de fermentação adequados e as condições de cultura adequadas.
- Culturas centrífugas a 2200 x g por 10 min.
- Realizar a extração de acordo com a classe do composto de juros40.
5. Aquisição de espectros de massa e preparação para análise do GNPS
- Para adquirir dados MS/MS, programe métodos de espectrometria HPLC adequados e de massa usando o software de controle. Tanto a análise de espectrometria de massa (DDA) dependente de dados de alta e baixa resolução pode ser analisada.
NOTA: Geralmente, uma solução de 1 mg/mL de amostras complexas de extrato bruto é ideal. Diluições são necessárias para extratos menos complexos. Deve-se notar que a rede MS/MS é a rede molecular detectável as condições espectrométricas de massa dadas. - Converta espectrode massa em formato .mzXML usando MSConvert do Proteowizard (encontrado em ). Os parâmetros de entrada para a conversão são ilustrados na Figura 3. Os dados de software de quase todas as empresas são compatíveis.
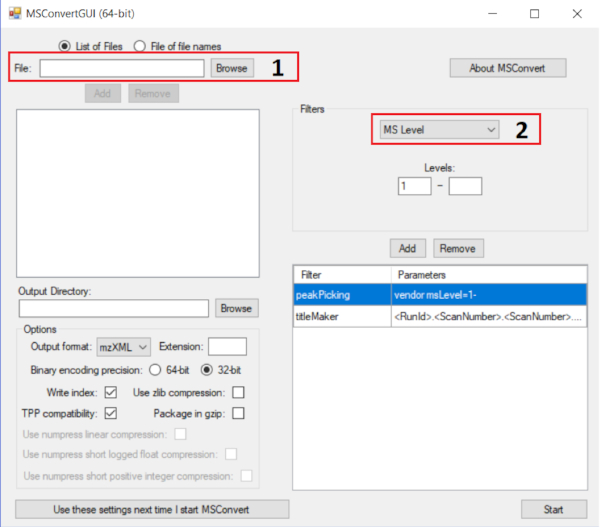
Figura 3: Usando msConvert para converter arquivos MS para extensão mzXML. O parâmetro correto para análise de GNPS é exibido. As instruções são as seguintes: adicione todos os arquivos MS na caixa 1 e adicione o filtro Peak Picking na caixa 2; para este filtro, use o fornecedor de algoritmos; pressione iniciar e os processos de conversão seguirão. Clique aqui para ver uma versão maior desta figura.
- Carregue os arquivos LC-MS/MS convertidos no banco de dados do GNPS. Duas opções estão disponíveis: usar um protocolo de transferência de arquivos (FTP) ou diretamente em um navegador através da plataforma online.
NOTA: Informações detalhadas sobre como instalar e transferir dados para o GNPS estão disponíveis em .
6. Análise do GNPS
- Depois de criar uma conta no GNPS (encontrado em ), faça login na conta criada selecione Criar Rede Molecular. Adicione um título de trabalho.
- Opções básicas: selecione os arquivos mzXML para executar a rede molecular. Eles podem ser organizados em até seis grupos. Selecione as bibliotecas para a rotina de desreplicação(Figura 4).
NOTA: Esses grupos não interferem na construção de redes moleculares. Essas informações serão usadas apenas para a representação gráfica.
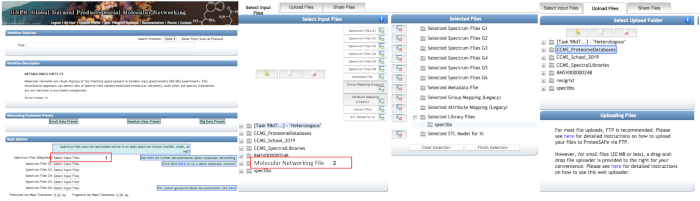
Figura 4: Utilização da plataforma GNPS online para realizar análises de rede molecular. A seleção de arquivos mzXML é feita clicando na caixa 1. Na caixa de diálogo aberta, os arquivos podem ser selecionados a partir da pasta pessoal (caixa 2) ou serem carregados na segunda guia usando o uploader de arquivo arrastar e soltar (menos de 20 MB). Os arquivos podem ser agrupados em até seis grupos. Clique aqui para ver uma versão maior desta figura.
- Selecione a tolerância de massa de íonprecursor e a tolerância de massa de íons de fragmento de 0,02 Da e 0,05 Da, respectivamente.
NOTA: O GNPS tem diferentes tipos de rigor disponível com base em 1) quão precisos são os dados de MS/MS e 2) quão precisa a associação deve ser. Opções básicas: nesta pasta, é possível definir a tolerância de massa precursora e a tolerância de massa de íons fragmentados. Esses parâmetros são usados como um guia para determinar quão preciso o íon precursor e o íon fragmento devem ser. As tolerâncias de massa selecionadas dependem da resolução e precisão do espectrômetro de massa utilizado. - Opções avançadas de rede: selecione os parâmetros de acordo com a Figura 5. Esses parâmetros influenciam diretamente o tamanho e a forma do cluster de rede. Outro parâmetro na seção de guias restantes são para usuários avançados; assim, deixe os valores padrão.
NOTA: Parâmetros avançados podem ser lidos na documentação do GNPS (encontrado em ).
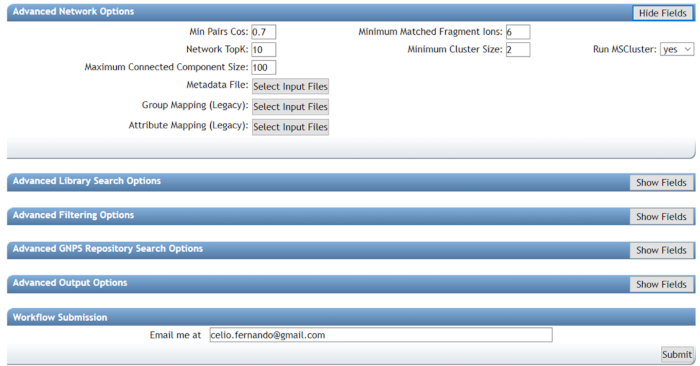
Figura 5: Utilização do GNPS para realizar análise de rede molecular (opções avançadas). O Min Pair Cos influenciará diretamente o tamanho dos clusters, pois os valores elevados resultarão na combinação de compostos intimamente relacionados e valores baixos na combinação de compostos relacionados à distância. Deve-se evitar o uso de valores muito baixos. Íons fragmentos com correspondência mínima representam o número de fragmentos compartilhados entre dois espectros de fragmentação a serem ligados na rede. Juntos, ambos os parâmetros orientam o formato da rede; valores mais baixos agruparão compostos mais distantes e vice-versa. Usar os valores adequados ajudará muito a elucidação composta. Clique aqui para ver uma versão maior desta figura.
- Escolha um endereço de e-mail para receber um alerta quando o trabalho estiver pronto e envie o trabalho.
7. Análise dos resultados do GNPS
- Faça login no GNPS. Selecione Jobs > Publicado job > Feito para abrir o trabalho. Uma página web será aberta conforme ilustrado na Figura 6. Todos os resultados obtidos a partir de rede molecular serão exibidos.
- Selecione Exibir Famílias Espectrais (No Visualizador de Rede do Navegador) para ver todos os clusters de rede (caixa vermelha, Figura 6).
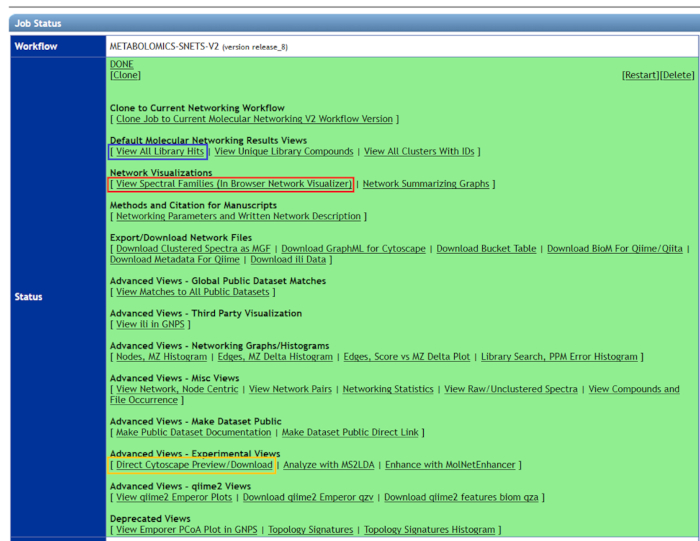
Figura 6: Utilização do GNPS para visualizar os resultados da rede molecular. Todos os agrupamentos compostos relacionados podem ser vistos à vista de famílias espectrais (caixa vermelha). Para visualizar apenas os hits da biblioteca, "ver todos os acessos da biblioteca" (caixa azul) deve ser selecionado. Para uma melhor representação gráfica dos resultados da rede molecular, "Direct Cytoscape Preview" (caixa amarela) deve ser baixado, e a versão mais recente do Cytoscape deve ser usada. Clique aqui para ver uma versão maior desta figura.
- Uma lista será exibida com todos os clusters de rede molecular gerados. Se uma pesquisa de biblioteca for selecionada para gerar os achados, a identificação de moléculas provisórias será exibida em AllIDs. Selecione Mostrar para visualizá-los.
NOTA: As análises de dados podem ser conduzidas para outros resultados (ou seja, mineração de genomas, ensaios biológicos, moléculas de desreplicação de bibliotecas, etc.). - Para analisar o cluster de rede molecular, selecione Rede Visualizalizante.
NOTA: Cada aglomerado é composto de nódulos (círculos) e bordas, o que representa moléculas e similaridade molecular, respectivamente. Moléculas desreplicadas serão destacadas como um nó azul no visualizador de rede do navegador on-line. - Na caixa de etiquetas do nó, selecione a massa dos pais (caixa vermelha, Figura 7).
- Na caixa de etiquetas de borda, selecione Cosseno ou DeltaMZ para observar a semelhança do nó ou a diferença de massa entre os nós, respectivamente (caixa amarela, Figura 7).
- No caso de análises multigrupos, clique em Desenhar tortas na caixa de colorir nó para observar a freqüência em que cada nó aparece em cada grupo (caixa azul, Figura 7).
NOTA: Outras opções são possíveis, mas as sugeridas acima são ideais para anotar nós de cluster e desvendar suas estruturas.
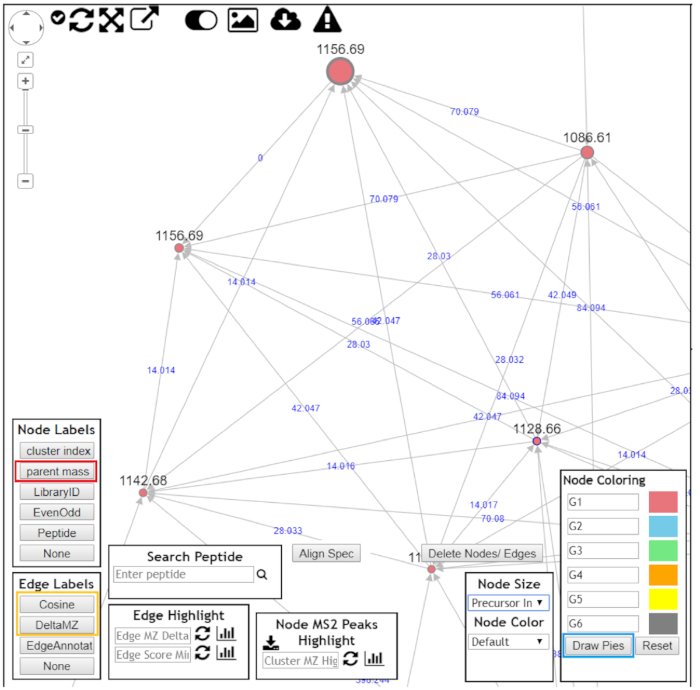
Figura 7: Usando GNPS para visualizar resultados de cluster molecular. Após a abertura dos clusters moleculares para melhor visualização de dados, devem ser escolhidos os seguintes: "Massa dos pais" como rótulos de nó (caixa vermelha); "DeltaMZ" como etiquetas de borda (caixa amarela); e "Desenhar tortas" como corante de nó (caixa azul). Navegue pelo aglomerado molecular e tente anotar todos os nós. Clique aqui para ver uma versão maior desta figura.
- Para ver todos os acessos da biblioteca, selecione Exibir todos os hits da biblioteca (caixa azul, Figura 7).
NOTA: Além disso, o MNW pode ser baixado em "Direct Cytoscape Preview/Download" (caixa amarela, Figura 7), e o arquivo pode ser aberto na plataforma Cytoscape (encontrado em ) para mais opções em estrutura gráfica. - São necessárias confirmação manual de compostos replicados e elucidação estrutural de compostos relacionados. Abra os espectros de fragmentações diretamente na plataforma GNPS ou em arquivos brutos originais.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
O protocolo foi exemplificado com sucesso usando uma combinação de mineração de genoma, expressão heteróloga e abordagens guiadas por MS/código para acessar novas moléculas análogas especializadas de valinomicina. O fluxo de trabalho genoma-molécula para o alvo, valinomicina (VLM), está representado na Figura 8. Estreptomices sp. CBMAI 2042 foram analisados em sílico, e o aglomerado genético VLM foi então identificado e transferido para um hospedeiro heterólogo. Cepas heterostióloga...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
A maior vantagem deste protocolo é sua capacidade de dispor rapidamente perfis metabólicos e unir informações genômicas com dados de MS, a fim de elucidar as estruturas de novas moléculas, especialmente análogos estruturais2. Com base em informações genômicas, diferentes quimiotipos de produtos naturais podem ser investigados, como poliketidas (PK), peptídeos não ribossômicos (NRP) e produtos naturais glicosilados (GNP), bem como BGCs enigmáticos. A triagem metabolômica produz evidências de perfis...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm nada para revelar.
Agradecimentos
O apoio financeiro para este estudo foi fornecido pela Fundação de Amparo à Pesquisa do Estado de São Paulo - FAPESP (2019/10564-5, 2014/12727-5 e 2014/50249-8 para L.G.O; 2013/12598-8 e 2015/01013-4 para R.S.; e 2019/08853-9 para C.F.F.A). B.S.P, C.F.F.A., e L.G.O. receberam bolsas do Conselho Nacional de Desenvolvimento Científico e Tecnológico - CNPq (205729/2018-5, 162191/2015-4 e 313492/2017-4). L.G.O. também agradece pelo apoio à bolsa do programa Para Mulheres na Ciência (2008, Edição Brasileira). Todos os autores reconhecem a CAPES (Coordenação de Aperfeiçoamento de Pessoal de Nível Superior) por apoiar os programas de pós-graduação no Brasil.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Acetonitrila | Tedia | AA1120-048 | HPLC grau |
| Agar | Oxoid | LP0011 | NA |
| Apramicina | Sigma Aldrich | A2024 | NA |
| Carpenicilina | Sigma Aldrich | C9231 | NA |
| Centrífuga | Eppendorf | NA | 5804 |
| Cloranfenicol | Sigma Aldrich | C3175 | NA |
| Coluna C18 | Agilent Technologies | NA | ZORBAX RRHD Extend-C18, 80Å, 2.1 x 50 mm, 1.8 µ m, limite de pressão de 1200 bar P/N 757700-902 |
| Kanamycin | Sigma Aldrich | K1377 | NA |
| Manitol P.A.- A.C.S. | Synth | NA | NA |
| Microcentrífuga | Eppendorf | NA | 5418 |
| Ácido nalidíxico | Sigma Aldrich | N4382 | NA |
| Phusion Flash PCR de alta fidelidade Master Mix | ThermoFisher Scientific | F548S | NA |
| Q-TOF espectrômetro de massa | Agilent technologies | NA | 6550 iFunnel Q-TOF LC/MS |
| Sacarose P.A.- A.C.S. | Synth | NA | |
| NA Shaker/Incubadora | Marconi | MA420 | NA |
| Cloreto de Sódio | Synth | NA | P. A. - ACS |
| Extrato de soja | NA | NA | NA |
| Sacarose | Synth | NA P | . A. - ACS |
| Thermal Cycles | Eppendorf | NA | Mastercycler Nexus Gradient |
| Thiostrepton | Sigma Aldrich | T8902 | NA |
| Triptona | Oxóide | LP0042 | NA |
| Triptona Caldo de Soja | Oxóide | CM0129 | NA |
| UPLC | Agilent Technologies | NA | 1290 Infinity LC Sistema |
| Extrato de levedura | Oxóide | LP0021 | NA |
Referências
- Davies, J. Specialized microbial metabolites: functions and origins. The Journal of Antibiotics. 66 (7), Tokyo. 361-364 (2013).
- Ziemert, N., Alanjary, M., Weber, T. The evolution of genome mining in microbes - a review. Natural Product Reports. 33 (8), 988-1005 (2016).
- Zerikly, M., Challis, G. L. Strategies for the Discovery of New Natural Products by Genome Mining. ChemBioChem. 10 (4), 625-633 (2009).
- Gomez-Escribano, J. P., Bibb, M. J. Heterologous expression of natural product biosynthetic gene clusters in Streptomyces coelicolor: from genome mining to manipulation of biosynthetic pathways. Journal of Industrial Microbiology & Biotechnology. 41 (2), 425-431 (2014).
- Medema, M. H., et al. Minimum Information about a Biosynthetic Gene cluster. Nature Chemical Biology. 11 (9), 625-631 (2015).
- Lautru, S., Deeth, R. J., Bailey, L. M., Challis, G. L. Discovery of a new peptide natural product by Streptomyces coelicolor genome mining. Nature Chemical Biology. 1 (5), 265-269 (2005).
- Chiang, Y. -M., et al. Molecular Genetic Mining of the Aspergillus Secondary Metabolome: Discovery of the Emericellamide Biosynthetic Pathway. Chemistry & Biology. 15 (6), 527-532 (2008).
- Huang, T., et al. Identification and Characterization of the Pyridomycin Biosynthetic Gene Cluster of Streptomyces pyridomyceticus NRRL B-2517. Journal of Biological Chemistry. 286 (23), 20648-20657 (2011).
- Udwary, D. W., et al. Genome sequencing reveals complex secondary metabolome in the marine actinomycete Salinispora tropica. Proceedings of the National Academy of Sciences. 104 (25), 10376-10381 (2007).
- Gross, H., et al. The Genomisotopic Approach: A Systematic Method to Isolate Products of Orphan Biosynthetic Gene Clusters. Chemistry & Biology. 14 (1), 53-63 (2007).
- Spohn, M., Wohlleben, W., Stegmann, E. Elucidation of the zinc-dependent regulation in Amycolatopsis japonicum enabled the identification of the ethylenediamine-disuccinate ([S,S ]-EDDS) genes. Environmental Microbiology. 18 (4), 1249-1263 (2016).
- Thaker, M. N., Waglechner, N., Wright, G. D. Antibiotic resistance-mediated isolation of scaffold-specific natural product producers. Nature Protocols. 9 (6), 1469-1479 (2014).
- Katz, M., Hover, B. M., Brady, S. F. Culture-independent discovery of natural products from soil metagenomes. Journal of Industrial Microbiology & Biotechnology. 43, 129-141 (2016).
- Quinn, R. A., et al. Molecular Networking as a Drug Discovery, Drug Metabolism, and Precision Medicine Strategy. Trends in Pharmacological Sciences. 38 (2), 143-154 (2017).
- Yang, J. Y., et al. Molecular Networking as a Dereplication Strategy. Journal of Natural Products. 76 (9), 1686-1699 (2013).
- Lommen, A. MetAlign: Interface-Driven, Versatile Metabolomics Tool for Hyphenated Full-Scan Mass Spectrometry Data Preprocessing. Analytical Chemistry. 81 (8), 3079-3086 (2009).
- Katajamaa, M., Miettinen, J., Oresic, M. MZmine: toolbox for processing and visualization of mass spectrometry based molecular profile data. Bioinformatics. 22 (5), 634-636 (2006).
- Pluskal, T., Castillo, S., Villar-Briones, A., Orešič, M. MZmine 2: Modular framework for processing, visualizing, and analyzing mass spectrometry-based molecular profile data. BMC Bioinformatics. 11 (1), 395(2010).
- Tautenhahn, R., Patti, G. J., Rinehart, D., Siuzdak, G. XCMS Online: A Web-Based Platform to Process Untargeted Metabolomic Data. Analytical Chemistry. 84 (11), 5035-5039 (2012).
- Kuhl, C., Tautenhahn, R., Böttcher, C., Larson, T. R., Neumann, S. CAMERA: An Integrated Strategy for Compound Spectra Extraction and Annotation of Liquid Chromatography/Mass Spectrometry Data Sets. Analytical Chemistry. 84 (1), 283-289 (2012).
- Katajamaa, M., Orešič, M. Data processing for mass spectrometry-based metabolomics. Journal of Chromatography A. 1158, 318-328 (2007).
- Liu, W. -T., et al. Interpretation of Tandem Mass Spectra Obtained from Cyclic Nonribosomal Peptides. Analytical Chemistry. 81 (11), 4200-4209 (2009).
- Ng, J., et al. Dereplication and de novo sequencing of nonribosomal peptides. Nature Methods. 6 (8), 596-599 (2009).
- Liaw, C., et al. Vitroprocines, new antibiotics against Acinetobacter baumannii, discovered from marine Vibrio sp. QWI-06 using mass-spectrometry-based metabolomics approach. Scientific Reports. 5 (1), 1-11 (2015).
- Kang, K. B., et al. Targeted Isolation of Neuroprotective Dicoumaroyl Neolignans and Lignans from Sageretia theezans Using in Silico Molecular Network Annotation Propagation-Based Dereplication. Journal of Natural Products. 81 (8), 1819-1828 (2018).
- Wang, M., et al. Sharing and community curation of mass spectrometry data with Global Natural Products Social Molecular Networking. Nature Biotechnology. 34 (8), 828-837 (2016).
- Doroghazi, J. R., et al. A roadmap for natural product discovery based on large-scale genomics and metabolomics. Nature Chemical Biology. 10 (11), 963-968 (2014).
- Medema, M. H., et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Research. 39, 339-346 (2011).
- Weber, T., et al. antiSMASH 3.0-a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Research. 43, 237-243 (2015).
- Blin, K., et al. antiSMASH 5.0: updates to the secondary metabolite genome mining pipeline. Nucleic Acids Research. 47, 81-87 (2019).
- Watrous, J., et al. Mass spectral molecular networking of living microbial colonies. Proceedings of the National Academy of Sciences. 109 (26), 1743-1752 (2012).
- Paulo, B. S., Sigrist, R., Angolini, C. F. F., De Oliveira, L. G. New Cyclodepsipeptide Derivatives Revealed by Genome Mining and Molecular Networking. ChemistrySelect. 4 (27), 7785-7790 (2019).
- Gonzaga de Oliveira, L., Sigrist, R., Sachetto Paulo, B., Samborskyy, M. Whole-Genome Sequence of the Endophytic Streptomyces sp. Strain CBMAI 2042, Isolated from Citrus sinensis. Microbiology Resource Announcements. 8 (2), 1-2 (2019).
- Aziz, R. K., et al. The RAST Server: Rapid Annotations using Subsystems Technology. BMC Genomics. 9 (1), 75(2008).
- Nah, H. -J., Pyeon, H. -R., Kang, S. -H., Choi, S. -S., Kim, E. -S. Cloning and Heterologous Expression of a Large-sized Natural Product Biosynthetic Gene Cluster in Streptomyces Species. Frontiers in Microbiology. 8, 1-10 (2017).
- Zhang, J. J., Tang, X., Moore, B. S. Genetic platforms for heterologous expression of microbial natural products. Natural Product Reports. 36 (9), 1313-1332 (2019).
- Alduina, R., et al. Artificial chromosome libraries of Streptomyces coelicolor A3(2) and Planobispora rosea. FEMS Microbiology Letters. 218 (1), 181-186 (2003).
- Jones, A. C., et al. Phage P1-Derived Artificial Chromosomes Facilitate Heterologous Expression of the FK506 Gene Cluster. PLoS One. 8 (7), 69319(2013).
- Gomez-Escribano, J. P., Bibb, M. J. Engineering Streptomyces coelicolor for heterologous expression of secondary metabolite gene clusters. Microbial Biotechnology. 4 (2), 207-215 (2011).
- Cannell, R. J. P. Natural Products Isolation. , Humana Press. Totowa, NJ. (1998).
- Kersten, R. D., et al. A mass spectrometry-guided genome mining approach for natural product peptidogenomics. Nature Chemical Biology. 7 (11), 794-802 (2011).
- Kersten, R. D., et al. Glycogenomics as a mass spectrometry-guided genome-mining method for microbial glycosylated molecules. Proceedings of the National Academy of Sciences. 110 (47), 4407-4416 (2013).
- Liu, W., et al. MS/MS-based networking and peptidogenomics guided genome mining revealed the stenothricin gene cluster in Streptomyces roseosporus. The Journal of Antibiotics. 67 (1), Tokyo. 99-104 (2014).
- Duncan, K. R., et al. Molecular Networking and Pattern-Based Genome Mining Improves Discovery of Biosynthetic Gene Clusters and their Products from Salinispora Species. Chemistry & Biology. 22 (4), 460-471 (2015).
- Cao, L., et al. MetaMiner: A Scalable Peptidogenomics Approach for Discovery of Ribosomal Peptide Natural Products with Blind Modifications from Microbial Communities. Cell Systems. , (2019).
- Chen, L. -Y., Cui, H. -T., Su, C., Bai, F. -W., Zhao, X. -Q. Analysis of the complete genome sequence of a marine-derived strain Streptomyces sp. S063 CGMCC 14582 reveals its biosynthetic potential to produce novel anti-complement agents and peptides. PeerJ. 7 (1), 6122(2019).
- Kim Tiam, S., et al. Insights into the Diversity of Secondary Metabolites of Planktothrix Using a Biphasic Approach Combining Global Genomics and Metabolomics. Toxins. 11 (9), 498(2019).
- Özakin, S., Ince, E. Genome and metabolome mining of marine obligate Salinispora strains to discover new natural products. Turkish Journal of Biology. 43 (1), 28-36 (2019).
- Trivella, D. B. B., de Felicio, R. The Tripod for Bacterial Natural Product Discovery: Genome Mining, Silent Pathway Induction, and Mass Spectrometry-Based Molecular Networking. mSystems. 3 (2), 00160(2018).
- Maansson, M., et al. An Integrated Metabolomic and Genomic Mining Workflow To Uncover the Biosynthetic Potential of Bacteria. mSystems. 1 (3), 1-14 (2016).
- Blin, K., Kim, H. U., Medema, M. H., Weber, T. Recent development of antiSMASH and other computational approaches to mine secondary metabolite biosynthetic gene clusters. Briefings in Bioinformatics. 20 (4), 1103-1113 (2019).
- Fisch, K. M. Biosynthesis of natural products by microbial iterative hybrid PKS-NRPS. RSC Advances. 3 (40), 18228-18247 (2013).
- Tatsuno, S., Arakawa, K., Kinashi, H. Analysis of Modular-iterative Mixed Biosynthesis of Lankacidin by Heterologous Expression and Gene Fusion. The Journal of Antibiotics. 60 (11), Tokyo. 700-708 (2007).
- Helfrich, E. J. N., Piel, J. Biosynthesis of polyketides by trans-AT polyketide synthases. Natural Product Reports. 33 (2), 231-316 (2016).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Reimpressões e permissões
