Esta pesquisa teve como objetivo fazer uma comparação entre L1-L2-Inglês e L1-L2 Português para verificar o quanto o efeito de um sotaque estrangeiro é responsável tanto pela métrica quanto pelos parâmetros prosódico-acústicos, bem como pela escolha da voz-alvo em uma formação de voz.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Sotaque estrangeiro e identificação forense de locutores em escalações de voz: a influência de características acústicas baseadas em prosódia
Neste artigo
Resumo
Resumo
Esta pesquisa tem como objetivo examinar tanto as características prosódicas-acústicas quanto os correlatos perceptuais do inglês com sotaque estrangeiro e do português brasileiro com sotaque estrangeiro e verificar como as produções de sotaques estrangeiros e nativos dos falantes estão correlacionadas com a percepção dos ouvintes. Na Metodologia, realizamos um procedimento de produção de fala com um grupo de falantes americanos de L2 Português Brasileiro e um grupo de falantes brasileiros de L2 Inglês, e um procedimento de percepção de fala no qual realizamos alinhamentos de voz para ambas as línguas. Para a análise estatística da produção de fala, foram executados Modelos Aditivos Generalizados para avaliar o efeito dos grupos linguísticos em cada classe (métrica ou prosódico-acústica) de características controladas para o efeito de suavização da(s) covariável(is) da classe oposta. Para a análise estatística da percepção de fala, foi realizado um teste de Kruskal-Wallis e um teste post-hoc de Dunn para avaliar o efeito das vozes das formações sobre os escores julgados pelos ouvintes. No entanto, foram realizados testes de similaridade acústica (vocal) com base nas distâncias cosseno e euclidiana. Os resultados mostraram diferenças acústicas significativas entre os grupos linguísticos em termos de variabilidade do f0, duração e qualidade vocal. Para as escalações, os resultados indicaram que as características prosódicas de f0, intensidade e qualidade de voz se correlacionaram com os julgamentos percebidos pelos ouvintes.
Introdução
O sotaque é um aspecto saliente e dinâmico da comunicação e fluência, tanto na língua nativa (L1) quanto em uma língua estrangeira (L2)1. O sotaque estrangeiro representa as características fonéticas de L2 de um idioma de destino e pode mudar (ao longo do tempo) em resposta à experiência de L2 do falante, estilo de fala, qualidade de entrada, exposição, entre outras variáveis. Um sotaque estrangeiro pode ser quantificado como um grau (escalar) de diferença entre a fala L2 produzida por um falante estrangeiro e um sotaque local ou de referência do idioma de destino2,3,4,5.
Esta pesquisa tem como objetivo examinar tanto as características prosódicas-acústicas quanto os correlatos perceptuais do inglês com sotaque estrangeiro e do português brasileiro (PB) com sotaque estrangeiro, bem como verificar em que medida as produções de sotaques estrangeiros e nativos dos falantes estão correlacionadas com a percepção dos ouvintes. Pesquisas anteriores no campo forense demonstraram a robustez das vogais e consoantes na identificação de sotaques estrangeiros como sendo estáveis para uma análise de longo prazo de um indivíduo (The Lo Case6) ou referindo-se à alta precisão de ID de um falante (The Lindbergh Case7). No entanto, a exploração de características prosódico-acústicas baseadas na duração, frequência fundamental (f0, ou seja, o correlato acústico da altura), intensidade e qualidade de voz (VQ) tem ganhado cada vez mais atenção8,9. Assim, a escolha por características prosódico-acústicas neste estudo representa um caminho promissor no campo da fonética forense8,10,11,12,13.
A presente pesquisa está apoiada em estudos dedicados aos sotaques estrangeiros como forma de disfarce de voz em casos forenses14,15, bem como na elaboração de lineups de voz para reconhecimento de locutores16,17. Por exemplo, a velocidade de fala desempenhou um papel importante na identificação de falantes de inglês, italiano, japonês e brasileiro de inglês18,19,20,21,22. Além da velocidade de fala, as características espectrais de longo prazo e f0 desafiam falantes proficientes em L2 com familiaridade com o idioma-alvo, pois o cérebro e as bases cognitivas sofrem um déficit de memória, atenção e emoção, refletindo no desempenho fonético do falante durante longos turnos de fala23. A visão dos sotaques estrangeiros no campo forense é que a definição do que realmente soa como um sotaque estrangeiro depende muito da falta de familiaridade do ouvinte, em vez de ter um grau zero a extremo de fala24.
No domínio perceptivo, uma ferramenta forense comum usada desde meados da década de 1990 para o reconhecimento de criminosos é o Voice Lineup (reconhecimento auditivo), que é análogo ao reconhecimento visual usado para identificar um perpetrador em uma cena de crime16,25. Em uma linha de voz, a voz do suspeito é apresentada ao lado de contrastes - vozes semelhantes em aspectos sociolinguísticos, como idade, sexo, localização geográfica, dialeto e status cultural - para identificação por uma testemunha auditiva. O sucesso ou falha de uma programação de voz dependerá do número de amostras de voz e das durações da amostra25,26. Além disso, para amostras do mundo real, considera-se que a qualidade do áudio afeta consistentemente a precisão do reconhecimento de voz. A baixa qualidade de áudio pode distorcer as características exclusivas de uma classe voice27. No caso de similaridade de voz, detalhes fonéticos finos baseados em f0 podem confundir o ouvinte durante o reconhecimento de voz28,29. Tais características acústicas se estendem além de f0 e abrangem elementos de duração e características espectrais de intensidade e classe VQ30. Essa visão de vários recursos prosódicos é crucial no contexto da comparação forense de voz para garantir a identificação precisa do falante9,14,15,29,31.
Em resumo, estudos em fonética forense mostraram alguma variação em relação à identificação de sotaque estrangeiro nas últimas décadas. Por um lado, um sotaque estrangeiro não parece afetar o processo de identificação de um falante32,33 (especialmente se o falante não estiver familiarizado com o sotaque estrangeiro alvo34). Por outro lado, há achados na direção oposta12,34,35.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este trabalho recebeu aprovação de um comitê de ética em pesquisa com seres humanos. Além disso, foi obtido consentimento informado de todos os participantes envolvidos neste estudo para o uso e publicação de seus dados.
1. Produção da fala
OBSERVAÇÃO: Coletamos a fala de uma tarefa de leitura em ambos os casos de 'L1 inglês-L2 PB' produzidos por Grupo 1: O American Einglês (dos Estados Unidos da América) Salto-falantes (AmE-S), e em ambos os 'L1 BP-L2 Inglês' produzidos por Grupo 2: O Brabrasileiro Salto-falantes (Bra-S). Veja Figura 1 para um fluxograma para a produção da fala.

Figura 1: Fluxograma esquemático da produção da fala. Clique aqui para visualizar uma versão maior desta figura.
- Participantes
- Determine o número de participantes, o idioma (L1 inglês, L2 português brasileiro; L1 português brasileiro, L2 inglês), o sexo (feminino ou masculino), o idade (média, desvio padrão), o características do grupo (profissionais ou estudantes de graduação), e o Nível de proficiência em L2 (avançado ou bem-avançado) para cada grupo.
OBSERVAÇÃO: Para a presente pesquisa, tanto o AmE-S quanto o Bra-S foram considerados proficientes em L2 (ambos os grupos foram classificados como B2-C1)36). O AmE-S havia morado no Brasil por dois anos quando os procedimentos foram realizados. O Bra-S havia morado mais de dois anos nos Estados Unidos quando os procedimentos foram realizados. Durante a estadia no exterior, ambos os grupos costumavam falar seu L2 com finalidades acadêmicas e profissionais pelo menos seis dias por semana, cerca de 4-5 horas por dia. - Aloque os participantes em uma sala confortável e silenciosa e apresente o material de leitura para cada grupo.
- Determine o número de participantes, o idioma (L1 inglês, L2 português brasileiro; L1 português brasileiro, L2 inglês), o sexo (feminino ou masculino), o idade (média, desvio padrão), o características do grupo (profissionais ou estudantes de graduação), e o Nível de proficiência em L2 (avançado ou bem-avançado) para cada grupo.
- Coleta de dados
OBSERVAÇÃO: Os dados de fala devem ser coletados por meio de uma tarefa de leitura nas seguintes línguas: L1-inglês e L2-português brasileiro; L1-português brasileiro e L2-inglês. Permita que os participantes leiam os textos previamente, se necessário.- Procedimentos de gravação
- Grave os dados de fala em um local silencioso com condições acústicas adequadas.
- Use um gravador de voz digital (consulte o Tabela de Materiais)37 e um microfone cardióide unidirecional com isolamento eletromagnético (consulte o Tabela de Materiais)38.
- Grave os dados de áudio em '.wav' formulário.
- Configure a taxa de amostragem em 48 kHz e a taxa de quantização em 16 bits.
OBSERVAÇÃO: O formato de áudio e a configuração das taxas de amostragem e quantização descritas nas etapas 1.2.1.3 e 1.2.1.4 são aplicadas para garantir alta qualidade e redução de ruído, preservando assim as características espectrais utilizadas na análise acústica posterior.
- Procedimentos de gravação
- Análise acústica
OBSERVAÇÃO: Divida os procedimentos de análise acústica em três etapas: alinhamento forçado, realinhamento e extração de características acústicas.- Escreva a transcrição linguística (em um '.txt' arquivo) para cada arquivo de áudio.
- Marque o par de '.txt'/'.wavarquivos com o mesmo nome (ou seja, 'my_file.wav'/ 'meu_arquivo.txt').
OBSERVAÇÃO: Para aprimorar o desempenho do procedimento descrito na seção 1.3.7, recomenda-se fortemente que os três caracteres iniciais das etiquetas dos arquivos ‘.txt/.wav’ representem os Idioma, Dialeto, ou Acento, enquanto o quarto ao sexto caracteres indicam o Sexo por exemplo, EL1FEM para EInglês L1 Fêmeaale). A partir do sétimo caractere, o usuário deve indicar o número do orador (por exemplo, 001 para o primeiro locutor). Consequentemente, o primeiro par ‘.txt/.wav’ é EL1FEM001. - Crie uma pasta para cada idioma L1-L2.
OBSERVAÇÃO: Uma pasta para L1-L2 Inglês e uma pasta para L1-L2 PB. - Certifique-se de que todos os pares de arquivos do mesmo idioma estejam na mesma pasta.
- Realize o alinhamento forçado.
- Acesse a interface web do alinhador forçado Munich Automatic Segmentation (MAUS)webMAUS39 em https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline.
- Arraste e solte cada par de .wav / .txt arquivos do pasta até o retângulo tracejado em Arquivos (ou clique dentro do retângulo, Figura 2A).
- Clique no Carregar botão para carregar os arquivos no alinhador (veja a seta vermelha em Figura 2A).
- Selecione as seguintes opções na Opções de serviço menuFigura 2B): G2P-MAUS-PHO2SYL para Nome do pipeline; Inglês (EUA) (para Idioma) se Dados em inglês L1-L2; Italiano (IT) (para Idioma) se Dados de BP L1-L2.
OBSERVAÇÃO: Optamos por 'italiano' para os dados do PB porque o webMAUS não fornece modelos acústicos pré-treinados para alinhamento forçado do PB. A literatura fonética sugere que a fonologia do italiano possui um inventário de sete vogais simétrico, de certa forma comparável ao do PB.40, bem como semelhanças acústicas consonantais41,42. - Mantenha as opções padrão para 'Formato de saída' e 'Manter tudo'.
- Verifique o Executar caixa de seleção para aceitar os termos de uso (veja a seta verde em Figura 2C).
- Clique no Serviço Web de Execução botão para executar os arquivos carregados no alinhador.
OBSERVAÇÃO: Para cada arquivo de áudio, o alinhador MAUS retorna um Praat TextGrid objeto (um arquivo '.txt' pré-formatado pelo Praat contendo a anotação de palavras, sílabas fonológicas e fonemas com base na transcrição linguística extraída do arquivo '.txt' descrito na etapa 1.3.1). - Clique no Baixar como arquivo ZIP botão para baixar os arquivos TextGrid como um arquivo compactado (zip)Figura 2C).
OBSERVAÇÃO: Certifique-se de que os arquivos TextGrid compactados sejam baixados na mesma pasta dos arquivos de áudio. - Extraia os arquivos TextGrid para realinhamento posterior no software de análise fonética43.
- Realinhar.
- Acesse e baixe o script para o Praat VVUnitAligner44 de https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat
- Certifique-se de que todos os pares de arquivos do mesmo idioma e o VVUnitAligner os scripts estão na mesma pasta.
OBSERVAÇÃO: Uma pasta para os arquivos em inglês L1-L2 e o VVunitAligner, e uma pasta para os arquivos BP L1-L2 e o VVunitAligner. - Abra o software de análise fonética.
- Clique Praat | Abrir script do Praat… para chamar o script a partir do janela do objeto.
- Clique no Executar botão uma vez.
OBSERVAÇÃO: Um formulário chamado Alinhamento silábico fonético contendo as configurações para usar o script aparecerá na tela (Figura 3A). - Clique no Idioma botão para escolher entre os idiomas 'Inglês (EUA)', 'Português (BR)', 'Francês (FR)' ou 'Espanhol (ES)'.
- Clique no Segmentação em blocos botão para escolher entre os procedimentos de segmentação 'Automático', 'Forçado (manual)' ou 'Nenhum'.
- Verifique o Salvar arquivos TextGrid opção para salvar automaticamente os novos arquivos TextGrid.
- Clique Ok | Executar botões para um realinhamento das unidades fonéticas da etapa 1.3.5.7
OBSERVAÇÃO: Para cada arquivo de áudio, o VVUnitAligner gerará um novo arquivo TextGrid para a seção 1.3.7Figura 3B).
- Realize a extração automática das características acústicas.
- Acesse e baixe o script SpeechRhythmExtractor45 de https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat para extração automática das características prosódico-acústicas.
- Crie uma nova pasta e coloque o SpeechRhythmExtractor junto com todos os pares de arquivos de áudio e TextGrid de todas as línguas.
- Abra o software de análise fonética.
- Clique Praat | Abrir script do Praat… para chamar o script a partir do janela do objeto.
- Clique no Executar pressione o botão apenas uma vez.
OBSERVAÇÃO: Um formulário contendo as configurações do script será exibido na tela. Nas caixas dos nomes dos arquivos de saída '.txt', renomeie os arquivos conforme necessário ou mantenha os nomes padrão. - Verifique o parâmetros de qualidade vocal opção para salvar o Arquivo de saída VQ para qualidade vocal (Figura 3C).
OBSERVAÇÃO: Este segundo arquivo de saída (o Arquivo de saída VQ) contém os parâmetros da diferença entre o 1st e o 2nd harmônicos (H1-H2) e o Pico de Proeminência Cepstral (CPP)9. - Verifique o Alvo linguístico opção para escolher entre as etiquetas 'Idioma', 'Dialeto' ou 'Sotaque' (Figura 3C).
- Verifique o Unidade opção de escolher as características de f0 em Hz ou em Semitons (Figura 3C).
- Defina os valores para limiar F0, os limiares mínimo e máximo de f0 (Figura 3C).
OBSERVAÇÃO: A menos que a pesquisa tenha objetivos específicos ou características de áudio pré-definidas, recomenda-se fortemente manter os parâmetros do passo 1.3.7.9 com os valores padrão. - Clique Ok | Executar para a extração automática das características acústicas.
NOTA: O script SpeechRhythmExtractor retorna um arquivo '.txt' delimitado por tabulação (Arquivo de saída / Arquivo de saída VQ) contendo as características acústicas extraídas dos falantes.
- Análise estatística
- Carregue a planilha contendo as características acústicas no R46 ambiente (ou qualquer software/ambiente estatístico de sua escolha).
- Realize estatísticas não paramétricas de Modelos Aditivos Generalizados (GAMs).
- Realize GAMs em R.
- Digite os seguintes comandos e pressione Entrar.
library(mgcv)
modelo = gam(the característica métrica/prosódica-acústica na análise ~ o Idioma + s(a escolhida característica métrica, por = o Idioma) + outros características métricas/prosódicas-acústicas, dados = o quadro de dados)
NOTA: Decidimos realizar as estatísticas de teste do protocolo na linguagem de programação R devido à sua crescente popularidade entre fonetistas (e linguistas) na comunidade acadêmica. O R tem sido amplamente utilizado em pesquisas fonéticas de campo47. Tenha em mente que a etapa 1.4.2.2 contém um pseudocódigo. Escreva o código de acordo com as variáveis da pesquisa.

Figura 2: Captura de tela do alinhamento fonético usando o alinhador forçado MAUS. (A) O retângulo tracejado serve para arrastar e soltar arquivos 'my_file.wav'/'my_file.txt' ou clicar dentro para procurar esses arquivos na pasta; o botão de upload é indicado pela seta vermelha. (B) Os arquivos enviados do painel A (veja a seta azul), o pipeline a ser usado, o idioma para os pares de arquivos, o formato de arquivo a ser retornado e um botão 'verdadeiro/falso' para manter todos os arquivos. (C) Os termos de uso com caixa de seleção (veja a seta verde), o botão Executar Serviços Web e os resultados (arquivos TextGrid para serem baixados). Clique aqui para visualizar uma versão maior desta figura.
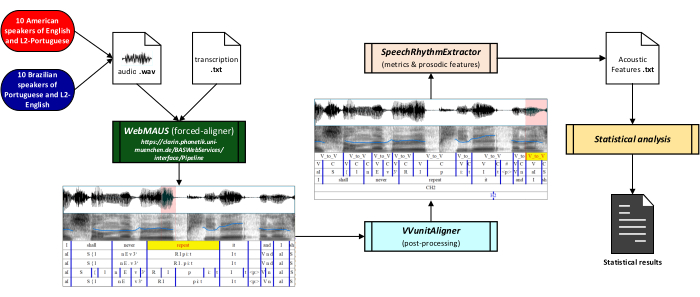
Figura 3: Captura de tela do procedimento de realinhamento. (A) Formulário de configurações de entrada para o procedimento de realinhamento. (B) Forma de onda parcial, espectrograma de banda larga com contorno de f0 (azul) e seis camadas segmentadas (e rotuladas) como camada 1: unidades do início da vogal até o início da próxima vogal (V_para_V); início da vogal (V_para_V); camada 2: unidades de vogal (V), consoante (C) e pausa (#); camada 3: representações fônicas V_para_V; camada 4: algumas palavras do texto; camada 5: alguns segmentos (CH) da fala do texto; camada 6: camada tonal contendo o tom mais alto (H) e o tom mais baixo (L) de cada segmento de fala produzido por uma falante feminina de AmE-S. (C) Configurações de entrada para a extração automática das características acústicas. Clique aqui para visualizar uma versão maior desta figura.
2. Percepção da fala
OBSERVAÇÃO: Realizamos quatro rodadas de reconhecimento vocal em inglês com ouvintes americanos e quatro rodadas em PB com ouvintes brasileiros. Veja Figura 4 para um fluxograma da percepção da fala.
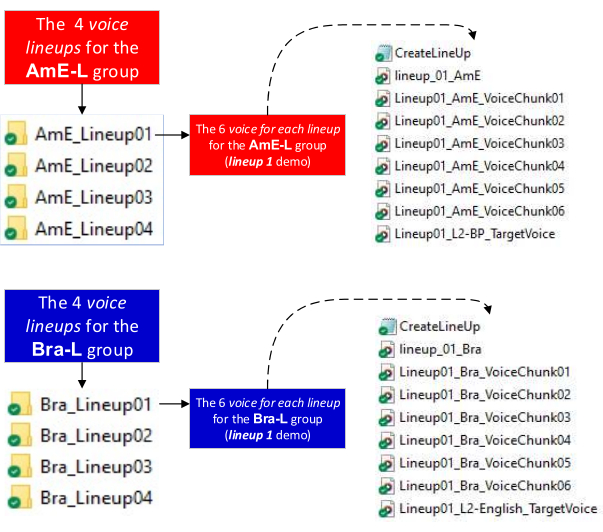
Figura 4: Fluxograma esquemático da percepção da fala. Clique aqui para visualizar uma versão maior desta figura.
- Participantes
- Escolha participantes diferentes para cada grupo em relação aos que participaram do protocolo de produção da fala.
NOTA: Dois grupos de participantes foram selecionados para esta parte do protocolo: Grupo 1: Os ouvintes de Inglês Americano (dos Estados Unidos da América) (IA-O) e Grupo 2: Os ouvintes Brasileiros (Bra-O). Para a presente pesquisa, tanto os IA-O quanto os Bra-O foram considerados proficientes no segundo idioma (ambos os grupos foram classificados como B2-C136. Os IA-O tinham morado dois anos no Brasil quando os procedimentos foram realizados. Os Bra-O tinham morado mais de dois anos nos Estados Unidos da América quando os procedimentos foram realizados. Durante a estadia no exterior, ambos os grupos costumavam falar seu L2 com fins acadêmicos e profissionais (pelo menos seis dias por semana, cerca de 4 a 5 horas por dia). - Determine o número de participantes, a língua (L1 inglês, L2 PB; L1 PB, L2 inglês), o sexo (feminino ou masculino), a idade (média, desvio padrão), as características do grupo (profissionais ou estudantes universitários) e o nível de proficiência no L2 para cada grupo.
- Escolha participantes diferentes para cada grupo em relação aos que participaram do protocolo de produção da fala.
- Os conjuntos de vozes
NOTA: Divida os procedimentos dos conjuntos de vozes em duas etapas distintas: preparação e execução dos conjuntos de vozes.- Prepare quatro conjuntos de vozes para o inglês e quatro para o PB.
- Obtenha arquivos de áudio dos falantes da seção 1: Produção da fala.
- Verifique se os arquivos de áudio de cada fator linguístico estão em pastas separadas.
- Escolha aleatoriamente seis segmentos de voz em inglês L1 ou PB L1.
NOTA: Seis vozes no conjunto representam uma voz-alvo e cinco vozes distratoras. - Escolha um segmento de voz em inglês L2 ou PB L2 de um dos falantes incluídos na etapa 2.2.1.3.
NOTA: O segmento de voz na etapa 2.2.1.4 é a voz de referência. Os segmentos devem ter aproximadamente 20 s de duração.8. - Acesse e baixe o script para Praat CreateLineup48 de https://github.com/pabarbosa/prosody-scripts-CreateLineUp.
- Verifique se a voz de referência L2, as vozes distratoras L1 e a voz-alvo L1 estão na mesma pasta antes de executar o script CreateLineup (Figura 5).
- Abra o software de análise fonética.
- Na janela de objetos, clique em Praat | Abrir script do Praat… para chamar o script.
- Clique em Executar | Executar.
NOTA: O script retorna um arquivo na seguinte ordem: (a voz de referência L2) + (a voz-alvo L1 e as vozes distratoras distribuídas aleatoriamente) (Figura 5).
- Execução dos conjuntos de vozes
- Crie um espaço online para hospedar os conjuntos em qualquer plataforma de sua escolha (por exemplo, SurveyMonkey. Veja a Tabela de Materiais) para realizar os conjuntos de vozes remotamente.
- Acesse o link do espaço online.
- Carregue os arquivos retornados pelo script CreateLineup na plataforma.
- Execute o procedimento antes dos participantes para testar cada etapa.
NOTA: Recomenda-se acessar previamente o link e executar os conjuntos para verificar se tudo está funcionando normalmente.
- Prepare quatro conjuntos de vozes para o inglês e quatro para o PB.
- Análise estatística
- Carregue a planilha contendo as pontuações dos julgamentos dos ouvintes no ambiente R (ou qualquer software/ambiente estatístico de sua escolha).
- Realize o teste de Kruskal-Wallis no R.
- Digite os seguintes comandos e pressione Enter.
modelo = kruskal.test(julgamentos ~ cada conjunto de vozes, dados = o data frame)
- Realize um teste post-hoc de Dunn.
- Realize o teste de Dunn no R.
- Digite os seguintes comandos e pressione Enter.
library(FSA)
modelo = dunnTest(julgamentos ~ cada conjunto de vozes, dados = dados, metodo = "bonferroni")
NOTA: Os códigos nas etapas 2.3.1.2 e 2.3.2.2 são pseudocódigos (veja NOTA 1.4.2.2).
- Carregue a planilha contendo as pontuações dos julgamentos dos ouvintes no ambiente R (ou qualquer software/ambiente estatístico de sua escolha).
- Análise de similaridade acústica
- Selecione os conjuntos de vozes (cf. NOTA na etapa 2.2.1.3) que apresentaram diferenças não significativas entre a voz-alvo e qualquer uma das vozes distratoras.
- Repita os procedimentos das etapas 1.3.1 a 1.3.7.5 e das etapas 1.3.7.8 a 1.3.7.10.
- Acesse e baixe o script para Python49, AcousticSimilarity_cosine_euclidean50 de https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py.
NOTA: O script retorna três matrizes (em '.txt' e '.csv'): uma para a similaridade cosseno51,52, uma para a distância euclidiana52,53 e uma para os valores transformados da distância euclidiana, bem como uma comparação par a par entre a voz-alvo e cada voz distratora. - Verifique se o script foi baixado na mesma pasta do conjunto de dados.
- Clique no botão Abrir arquivo… para chamar o script.
- Clique nos botões Executar | Executar Sem Depuração.
NOTA: O segundo botão Executar pode estar rotulado como Executar ou Executar Sem Depuração ou Executar Script. Todos executam os mesmos comandos. Isso depende simplesmente do ambiente Python utilizado. - Realize testes de similaridade vocal com base em características acústicas.
NOTA: A similaridade cosseno (ou distância cosseno) é uma técnica aplicada em Inteligência Artificial (IA), particularmente em aprendizado de máquina em sistemas de reconhecimento automático de fala (RAF). É uma medida de similaridade entre zero e um. Uma similaridade cosseno próxima de um indica que duas vozes são muito provavelmente semelhantes. Uma similaridade cosseno próxima de zero indica que as vozes são muito provavelmente diferentes52. A distância euclidiana, muitas vezes referida como similaridade euclidiana, também é amplamente utilizada em IA, aprendizado de máquina e RAF. Representa a distância em linha reta entre dois pontos no espaço euclidiano53, ou seja, quanto mais próximos os pontos (menores os valores de distância), mais semelhantes são as vozes. Para uma compreensão mais clara dos resultados relatados por ambas as técnicas, realizamos uma transformação dos escores brutos da distância euclidiana em valores de zero (menor similaridade vocal) a um (maior similaridade vocal)54.

Figura 5: Configuração do diretório para percepção da fala. Pastas de identificação. Cada pasta contém seis vozes de falantes nativos (L1), a voz-alvo de falante não nativo (L2), o script "CreateLineup" e o arquivo de áudio com a identificação vocal (gerado após a execução do script). Clique aqui para visualizar uma versão maior desta figura.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Resultados para a produção da fala
Nesta seção, descrevemos o desempenho das características prosódico-acústicas e métricas rítmicas estatisticamente significativas. Tais características prosódicas foram as taxas de fala, de articulação e de pausas, que estão relacionadas à duração, e o tremor, que está relacionado à qualidade vocal. As métricas rítmicas foram o desvio padrão (DP) da duração da sílaba, DP do consonante, DP da duração vocálica ou consonantal e o coeficiente de variação da duração da...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
O protocolo atual apresenta uma novidade no campo da fonética (forense). Está dividido em duas fases: uma baseada na produção (análise acústica) e outra baseada na percepção (análise do julgamento). A fase de análise de produção compreende a preparação de dados e alinhamento forçado, realinhamento e extração automática de características prosódicas-acústicas, além das estatísticas. Este protocolo conecta a etapa de coleta de dados à análise de dados de forma mais rápida e eficiente do que os protocolos tradicionais basea...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm conflitos de interesse a declarar.
Agradecimentos
Este estudo foi financiado pelo Conselho Nacional de Desenvolvimento Científico e Tecnológico - CNPq, processo nº 307010/2022-8 para o primeiro autor e processo nº 302194/2019-3 para o segundo autor. Os autores gostariam de expressar sua sincera gratidão aos participantes desta pesquisa por sua generosa cooperação e contribuições inestimáveis.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| CreateLineup | Coleção pessoal | # | Script para praat para preparação de lineups de voz |
| Dell I3 (com unidade de estado sólido - SSD) | Dell | # | Computador portátil |
| Praat | Paul Boersma & David Weenink | # | Software para análise fonética |
| Python 3 | Python Software Foundation | # | Linguagem de programação interpretada, de alto nível e de uso geral |
| R | The R Project for Statistical Computing | # | Linguagem de programação para computação estatística |
| Shure Beta SM7B | Shure | # | Microphone |
| SpeechRhythmExtractor | Personal collection | # | Script para praat para extração automática de recursos acústicos |
| SurveyMonkey | SurveyMonkey Inc. | # | Montagem de pesquisas personalizáveis gratuitas, bem como um conjunto de programas de back-end que incluem análise de dados, seleção de amostras, eliminação de vieses e representação de dados. |
| Tascam DR-100 MKII | Tascam | # | Gravador de voz digital |
| O Sistema de Segmentação Automática de Munique MAUS | Universidade de Munique | # | Alinhador forçado de arquivos de áudio (.wav) e informações linguísticas (.txt) |
| VVUnitAligner | Coleção pessoal | # | Script para praat para realinhamento automático e pós-processamento de unidades fonéticas |
Referências
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Reimpressões e permissões
