O estudo atual descreve um fluxo de trabalho para sequenciamento nanoporoso de plasmídeos quando a sequência cromossômica já é conhecida ou não tem interesse. Uma etapa inicial de enriquecimento de DNA plasmídico garante a profundidade ótima da sequência plasmídica e maximiza o número de amostras que podem ser sequenciadas por célula de fluxo.
Artigo de método
Sequenciamento e montagem de plasmídeos de leitura longa usando fluxos de trabalho baseados em sequenciamento nanopore
* These authors contributed equally
Neste artigo
Resumo
Resumo
O presente estudo descreve um fluxo de trabalho para sequenciamento nanoporoso projetado para maximizar o rendimento do DNA plasmídico e a precisão do sequenciamento. Os pesquisadores cobrem cada etapa do processo, que inclui extração de DNA plasmídico, preparação de bibliotecas com codificação rápida de barras e ligação de adaptadores, carregamento da biblioteca em uma célula de fluxo para sequenciamento, chamada de base (em tempo real ou pós-hoc) e montagem de sequências usando Autocycler. Os autores também especificam os requisitos do computador, que dependem em grande parte de se a basecalling é feita em tempo real. Os autores sequenciaram plasmídeos purificados de dez cepas clínicas usando esse fluxo de trabalho. Para remover as diferenças entre cepas e células hospedeiras como variável, os autores também conjugaram essas cepas clínicas com uma cepa comum do receptor e sequenciaram os transconjugantes. Esses experimentos produziram conjuntos de plasmídeos que correspondem aos tamanhos dos plasmídeos inferidos pela mobilidade do gel e que, em 2/3 dos casos, também correspondem a conjuntos polidos de leitura curta ou estão dentro de 0,05% de identidade de sequência por pares. O enriquecimento de sequências de DNA plasmídico também maximiza a eficiência do sequenciamento plasmídeo, permitindo o sequenciamento paralelo de até 24 amostras com cobertura ideal. Este protocolo é adequado para plasmídeos que variam de 4 a 174 kb e tolera até 72% de contaminação cromossômica sem afetar a precisão. Esse protocolo é ideal para situações em que a sequência cromossômica já é conhecida ou não tem interesse, como para verificação de sequências plasmidárias, melhoria da precisão das sequências plasmidas já obtidas pelo WGS ou sequenciamento de plasmídeos capturados por conjugação. O organismo usado para ilustrar esse trabalho é Escherichia coli, que representa hospedeiros usados para expressão gênica recombinante e captura de plasmídeos por conjugação.
Introdução
Plasmídeos são pedaços autorreplicantes de DNA encontrados em todas as bactérias. Eles são altamente variáveis em tamanho, variando de <800 pb a 2,5 Mbp, e tipicamente seguem uma distribuição bimodal, com um pico menor correspondente a plasmídeos multicópias não conjugativas e um pico maior correspondente a plasmídeos de baixa cópia, frequentementeconjugativos, 1,2. Os plasmídeos desempenham um papel fundamental na ecologia microbiana, carregando genes que ajudam seus hospedeiros a se adaptarem a desafios ambientais ou acessar novos nichos ecológicos. Plasmídeos também servem como plataformas para uma evolução acelerada, proporcionando maior plasticidade genética e mediando a transferência horizontal de genes entre cepas, espécies, gêneros e atéfamílias 3,4. Análises genômicas em rede e comparativas confirmaram o papel do resistoma ambiental como reservatório persistente para genes de resistência a antibióticos (ARGs) clinicamente relevantes, facilitando assim sua manutenção e disseminação em ambientesecológicos 5. Rastrear plasmídeos e sua carga de genes de resistência a antibióticos e virulência ajuda a identificar as rotasde transmissão 6. Portanto, a identificação e caracterização de plasmídeos é de grande interesse para uma variedade de aplicações em saúde pública, microbiologia clínica e biotecnologia.
A introdução de tecnologias de sequenciamento de próxima geração (NGS), que permitem o sequenciamento de alto rendimento de modelos de DNA desconhecidos, abriu a porta para a caracterização genômica de isolados microbianos. O sequenciamento do genoma completo (WGS) permite rastrear o surgimento, disseminação e transmissão de novos patógenos, cepas resistentes a medicamentos e variantes que evitam vacinas. Também está sendo cada vez mais utilizado para ajudar a identificar rotas de transmissão durante surtos clínicos, potencialmente informando intervenções para a prevenção de futurossurtos 7. Por fim, o WGS permite o perfilamento dos ARGs, o que pode informar decisões terapêuticas8, embora a vinculação dos ARGs a fenótipos qualitativos e quantitativos de resistência a antibióticos ainda seja um trabalho emandamento 9.
No entanto, os dados de sequenciamento de leitura curta (SR) tipicamente produzidos pelo WGS em escala geralmente estão na faixa de 400–500 bp. Esse tamanho é menor que o tamanho da maioria dos Elementos Genéticos Móveis (MGEs) e, portanto, não poderesolvê-los 10. A identificação in silico de sequências plasmídicas em dados WGS é ainda mais complicada pela cobertura incompleta e devido à compartilhamento de sequências entre plasmídeos e entre cromossomos bacterianos e outrosplasmídeos 10. Como consequência, as assemblagens são frequentemente extensivamente fragmentadas e incompletas, tornando impossível atribuir sua localização subgenômica (cromossômica ou plasmídea).
A tecnologia de sequenciamento de leitura longa (LR) gera conjuntos altamente contíguos que abrangem mais repetições, facilitando muito a produção de conjuntos completos de plasmídeos. Existem essencialmente dois tipos de tecnologias de leitura longa e de molécula única disponíveis: 11,12. Uma dessas abordagens, o sequenciamento nanoporoso, está se tornando popular na genômica microbiana devido ao seu baixo custo, tempos de resposta rápidos e adequação para ambientes com recursoslimitados 13,14.
Dispositivos de sequenciamento nanoporos utilizam células de fluxo contendo matrizes de milhares de nanoporos. O DNA é carregado na célula de fluxo, aberto por uma proteína motora com atividade helicase, e passa pelo nanoporo impulsionado por um diferencial de corrente. À medida que os nucleotídeos em uma dada fita única passam por nanoporos individuais, a corrente é interrompida para produzir um sinal característico que é medido por um sensor eletrônico conectado a cada poro. Esse sinal é decodificado usando algoritmos basecalling, e os dados resultantes são reunidos e analisados posteriormente usando várias ferramentas de bioinformática.
Comparado às abordagens de sequenciamento SR, o sequenciamento por nanoporos tende a produzir menor qualidade de leitura (Q-scores menores) e a gerar inserções/deleções em sequências homopoliméricas durante a análise de dados de sinais elétricos (basecalling)15. Também foi observado que a metilação próxima no DNA nativo pode causar erros sistemáticos de chamadade base 16. Uma solução comumente adotada tem sido incluir dados de leitura curta para correção de erros pós-montagem. No entanto, esse processo (conhecido como "polimento") aumenta o custo e a complexidadedo custo 17. Aumentar a cobertura de sequenciamento também pode melhorar a precisão, mas nem sempre é tecnicamente possível.
Em 2024, foi demonstrado que as células de fluxo Oxford Nanopore Sequencing (ONT) R10.4.1 e a química V14 produzem conjuntos de alta qualidade e contíguos para as bactérias G-, enquanto análises em escala mais fina em níveis de nucleotídeo único ainda se beneficiam dos dados de sequenciamento SR18. No entanto, a diferença entre a precisão do sequenciamento LR e SR está sendo gradualmente reduzida. Diversas melhorias recentes incluem um processo de amostragem de dados mais preciso com maior velocidade de sequenciamento, a introdução de um novo basecaller adaptado para DNA bacteriano nativo e metilação, que proporcionou maior precisão no chamado de base19, e ferramentas de análise atualizadas, como novos algoritmos para faseamento, chamada variante e chamada estrela-alelo. Note também que o algoritmo mais recente do Dorado, V.0.9.0 ONT (2025), pode ser usado para chamar rebase de dados brutos de rabisco. De fato, alguns estudos do WGS já relatam a geração de genomas microbianos por sequenciamento nanoporo de uma qualidade para a qual o polimento de leitura curta não deve melhorar significativamente a sequênciaconsensual 20,21.
Plasmídeos frequentemente contêm a maior parte dos genes de resistência adquiridos, especialmente nos isolados22 de Enterobacteriaceae. Portanto, a resolução de sequências plasmídicas permite a contextualização dos genes AR, o que é fundamental para rastrear a transmissão daAMR 23,24. O sequenciamento nanoporo já foi usado para examinar a microevolução de blaKPC que abrigaplasmídeos 25. Dispositivos MinION também foram usados para sequenciamento em tempo real de plasmídeos em laboratório e detecção de genes de resistência em isolados clínicos em ambienteshospitalares 26. Dito isso, a interrogação com plasmídeos ainda não faz parte da prática rotineira de controle de infecção.
Apesar da melhora substancial do LR-sequenciamento na capacidade de resgatar plasmídeos da sequênciagenômica 27 em relação ao SR-sequenciamento, alguns problemas permanecem. Montadores de leitura longa como Flye28, Canu29 e Raven30 produzem conjuntos cromossômicos de alta qualidade, mas têm dificuldade em montar sequências plasmídicas. Isso se deve em parte à profundidade insuficiente de cobertura, pois o DNA plasmídico está sub-representado nos dados de sequenciamentoWGS 31. Note que, devido à sua estrutura modular, abundância de estruturas secundárias e presença frequente de repetições, a montagem de alta qualidade para sequência de DNA plasmidal requer maior cobertura do que o DNA cromossômico (50x profundidadede leitura 32).
Enriquecer as amostras de DNA com sequências plasmídicas é uma abordagem eficaz para aumentar a profundidade da cobertura, mas o isolamento ou enriquecimento do DNA plasmídico antes do sequenciamento é caro ou trabalhoso demais para aplicações diagnósticas clínicas e pode introduzir viés ao enriquecer sequências de DNA selecionadas. Em 2017, o DNA enriquecido com plasmídeos foi utilizado para tentar a montagem completa do DNA plasmídico em amostras clínicas para a detecção dosARGs 24. Oito isolados de seis espécies diferentes de Enterobacteriaceae foram sequenciados para maximizar a diversidade estrutural populacional e de plasmídeos. Após testar vários montadores, foi demonstrado que Canu/Canu+Pilon claramente superava outros; Esse grupo de pesquisa também tentou uma abordagem de meta-montagem que alcançou a resolução de estruturas adicionais de plasmídeos, resultando na montagem completa de 78% de todos os plasmídeos conhecidos nas amostras sequenciadas. No entanto, a presença de estruturas de grande repetição e (em menor grau) problemas na extração de DNA ainda representavam problemas significativos para a detecção de todas as montagens de plasmídeos de contigúnico 24.
Mais recentemente, a amostragem adaptativa como abordagem complementar para o enriquecimento de sequências de plasmídeos de baixa abundância tem sido examinada rejeitando sequências cromossômicas em amostras de isolados bacterianos, embora esse método exija sequências de referênciaconhecidas 33.
Aqui, os autores descrevem protocolos para sequenciamento ONT que são personalizados para amostras enriquecidas em DNA plasmídeo. Combinando maior representação do DNA plasmídico com protocolos atualizados de preparação de bibliotecas, tecnologia de células de fluxo e ferramentas de montagem de sequências, o fluxo de trabalho produziu montagens que correspondiam aos tamanhos inferidos pela mobilidade do gel e, em 2/3 dos casos, correspondiam ao polimento por sequenciamento SR ou estavam dentro de 0,05% de identidade de sequência dupla. O enriquecimento de sequências de DNA plasmídico também maximiza a eficiência do sequenciamento plasmídeo, permitindo o sequenciamento paralelo de até 24 amostras com cobertura ideal. Os protocolos não têm a intenção de substituir as abordagens padrão do WGS por nanoporos, mas sim de maximizar a precisão e eficiência do sequenciamento de plasmídeos em situações onde a sequência cromossômica já é conhecida ou não de interesse.
O fluxo de trabalho inclui extração de DNA plasmídico, preparação de biblioteca com código de barras, ligação de adaptador a uma proteína motora, verificação da célula de fluxo, carregamento da biblioteca em uma célula de fluxo para sequenciamento, análise de dados dos sinais elétricos (em tempo real ou post hoc), montagem de sequências usando Autocycler34 e várias análises a jusante (Figura 1).
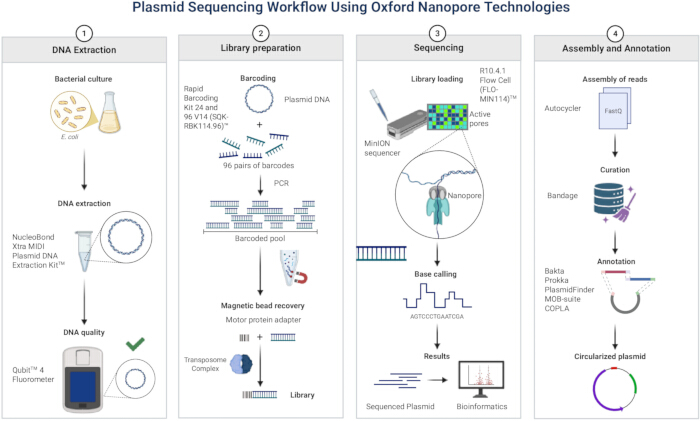
Figura 1: Fluxo de trabalho de sequenciamento de plasmídeos usando a Oxford Nanopore Technologies. Passo 1: extração de DNA; Passo 2: Preparação para a biblioteca; Passo 3: Sequenciamento; Passo 4: Montagem e anotação. Criado no BioRender. Cortés, G. (2026) https://BioRender.com/u3b15st. Por favor, clique aqui para ver uma versão ampliada desta figura.
Protocolo
1. Extração de DNA plasmídico
NOTA: Este protocolo foi usado para extrair DNA plasmídico de uma cepa clínica de Escherichia coli e seus transconjugantes correspondentes, utilizando um Kit de Extração de DNAPlasmídico comercial 35. Protocolos detalhados para conjugação podem ser encontrados no36. O protocolo é adequado tanto para plasmídeos de alta e baixa cópia, variando de ~3 kb até ~200 kb. Plasmídeos grandes exigem atenção especial porque tendem a ter um número baixo de cópias (apenas 1–2 cópias por célula), limitando a produção de DNA. Para compensar, o protocolo recomenda aumentar a massa celular e os volumes de tampões de lise e neutralização para garantir DNA plasmídico suficiente para a ligação das colunas. Plasmídeos de até 200 kb ainda podem ser recuperados usando esse protocolo; No entanto, sua aplicabilidade a megaplasmídeos (>200 kb) é limitada.
- Extração de plasmídeos
- Dia 1: Amostras de estrias nas placas de ágar Luria–Bertani (LB) suplementadas com o antibiótico apropriado para selecionar o respectivo marcador de resistência transmitido por plasmídeos e incubar a 37 °C por 24 horas.
NOTA: Adicione carbenicilina (ou antibiótico apropriado) ao LB em uma concentração final de 100 μg/mL, adicionando 1 μL de uma solução estocada de 100 mg/mL por mL de meio. - Dia 2: Inocular 3–5 mL de LB com o meio antibiótico apropriado com uma única colônia isolada desde o primeiro dia. Incube com agitação a 37 °C por ~8 horas, ou até que a cultura atinja um OD₆₀₀ de 1–2.
NOTA: Medição do OD600: Apague o espectrofotômetro com meio LB fresco contendo o antibiótico apropriado, depois transfira 1 mL de cultura para uma cubeta limpa e meça o OD a 600 nm. Se a leitura exceder a faixa linear, dilua a amostra e meça novamente. - Inocule 400 mL de LB suplementados com o meio antibiótico apropriado com 400 μL de cultura inicial do Dia 2. Incubar com tremores a 37 °C por 8–12 horas, ou até que o OD600 atinja 1–2 (como descrito anteriormente).
NOTA: Aumente o volume de cultura além de 400 mL se o OD600 não atingir 1–2 dentro de 12 horas. Para reduzir o risco de perda ou rearranjo de plasmídeos, limite a passagem em cultura ao máximo e mantenha a seleção de antibióticos em todas as etapas do crescimento. Aumente o volume de cultivo apenas quando se deseja um rendimento de DNA maior. - Dia 3: Transfira a cultura para frascos centrífugas adequados ao volume da cultura. Centrifuge a 4200 x g por 10 min., depois resuspenda o pellet usando os volumes de reagentes recomendados pelo fabricante de acordo com a seguinte fórmula:
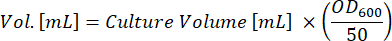
NOTA: Exemplo: Para que 400 mL de uma cultura bacteriana de baixa cópia (OD600 = 2) sejam lisados, os volumes apropriados de tampões de lise RES, LYS e NEU são de 16 mL cada.
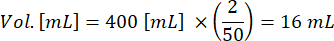
NOTA: se os volumes de reagentes para ressuspensão, lise ou neutralização não forem devidamente escalados para a biomassa total da cultura (OD600 × Volume, ou ODV), a lise pode ser incompleta, a neutralização ineficiente e a formação de precipitados excessiva. Isso pode levar a menor rendimento plasmídico, redução da pureza e potencial entupimento das colunas de purificação. Escalar os volumes do buffer proporcionalmente, usando a fórmula do fabricante (passo 1.1.4), garante lisagem eficiente, neutralização completa e recuperação consistente de DNA plasmídico de alta qualidade. - Realize a lise celular, filtrar a molhação usando o tampão apropriado e neutralizar conforme instruído pelo kit.
NOTA: Empilhe dois filtros se o volume de precipitado for grande, ajustando o buffer proporcionalmente. Realize etapas adicionais de centrifugação se o sobrenadante permanecer opaco. Após a neutralização, o alto volume de precipitado pode exigir etapas adicionais de centrifugação. Isso ocorre na maioria das amostras clínicas de E. coli, possivelmente porque tendem a formar biofilme na cultura37, que envolve a secreção de uma matrizespessa 38. Precipitado excessivo no lisado pode entupir a coluna, prolongar o tempo de drenagem e potencialmente contaminar a amostra com proteínas. Se o sobrenadante estiver claro, essas etapas extras podem não ser necessárias. - Centrifuge o lisado a 4200 x g por 30 minutos. Transfira o sobrenadante para um tubo novo e centrifuge novamente por 30 minutos. Se o sobrenadante permanecer opaco após esses spins (Figura 2), realize uma centrifugação extra a 4200 x g.
NOTA: Transferir o lisato para um tubo de cultura de 50 mL durante a centrifugação pode facilitar a remoção do sobrenadante, já que o precipitado às vezes pode falhar em pelletar corretamente e ficar preso próximo ao topo do tubo. Devido aos grandes volumes processados, uma única coluna pode ficar saturada e incapaz de acomodar amostras adicionais. Para aumentar a velocidade de filtração ou maximizar o rendimento de DNA, o lisato pode ser dividido entre duas colunas. - Execute os passos EQU, WASH e ELU conforme as instruções do kit.
- Precipite DNA usando isopropanol.
NOTA: Incube a -20 °C por ~10 minutos se o pellet não estiver visível. No entanto, geralmente é melhor remover cuidadosamente o sobrenadante, confiando que o pellet permaneça colado às paredes do tubo, mesmo que não seja visível. - Lave o DNA com etanol conforme instruído. Faça lavagem adicional se o precipitado proteico persistir.
- Secar o DNA em temperatura ambiente (~20 °C) por 15–30 minutos.
- Ressuspender o DNA em 100 μL de água livre de nuclease; esse pequeno volume ajuda a maximizar a concentração para a preparação da biblioteca Nanopore.
NOTA: Este é um ponto conveniente para parar. O DNA plasmídico pode ser armazenado por vários meses a –20 °C. O kit de extração usado neste protocolo foi projetado para minimizar a contaminação pelo DNA cromossômico (genômico) por meio de química tampão otimizada, lisis suave e etapas de clarificação do lisado, embora não possa ser excluída contaminação substancial por DNA cromossômico, e os autores a encontraram nos preparativos (veja resultados).
- Dia 1: Amostras de estrias nas placas de ágar Luria–Bertani (LB) suplementadas com o antibiótico apropriado para selecionar o respectivo marcador de resistência transmitido por plasmídeos e incubar a 37 °C por 24 horas.
- Rendimento de DNA e controle de qualidade
Quantifique o DNA e avalie sua qualidade usando corantes fluorescentes, que oferecem maior especificidade e sensibilidade para baixas concentrações de DNA em comparação com métodos de absorção UV. Neste protocolo, utilize um dispositivo de fluorômetro para quantificar amostras de DNA, RNA ou proteínas de forma precisa econveniente.- Fluxo de trabalho do fluorômetro
- Leve amostras de DNA para temperatura ambiente. Prepare tubos para padrões e amostras.
NOTA: Calcule os volumes apropriados de corante e tampão a serem incluídos na solução de trabalho com base no número de amostras. Para cada padrão e amostra, 200 μL de solução de trabalho devem ser preparados diluindo o corante no tampão em uma proporção de 1:200. O dispositivo possui uma Calculadora de Reagentes embutida que também pode ser usada para esses cálculos. - Prepare os tubos de ensaio conforme a Tabela 1.
- Faça vórtice em cada tubo por alguns segundos antes de incubar por 2 minutos em temperatura ambiente.
- Calibre o fluorômetro usando os padrões. Insira tubos de amostra e registre as leituras. Para instruções detalhadas, consulte o manualdo Fluorômetro 39.
NOTA: Para preparações típicas de plasmídeos Midi, espera-se que os rendimentos de DNA variem de ~50 a 150 μg por cultura de 100–400 mL, dependendo do tamanho do plasmídeo, número de cópias e condições de crescimento. Os comprimentos típicos de leitura dos nanoporos variam de ~2 kb a 20 kb, com leituras medianas frequentemente em torno de 5–10 kb para plasmídeos padrão. Kits baseados em ligação podem produzir leituras mais longas (mediana de >20 kb) para plasmídeos maiores, mas o kit rápido proporciona preparação mais rápida ao custo de leituras um pouco mais curtas.
- Leve amostras de DNA para temperatura ambiente. Prepare tubos para padrões e amostras.
- Fluxo de trabalho do fluorômetro
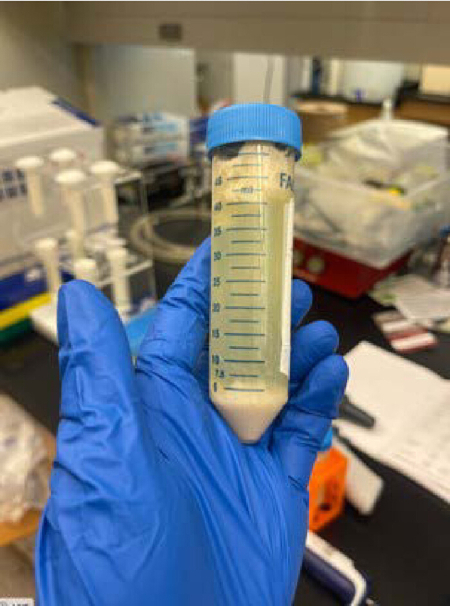
Figura 2: Sobrenadante do lisado turvo após um passo de centrifugação. A centrifugação em série é necessária até que o sobrenadante esteja limpo para evitar entupimento da coluna de filtração. Por favor, clique aqui para ver uma versão ampliada desta figura.
| Tubos de ensaio padrão | Tubos de ensaio de amostra de usuário | |
| Solução de trabalho (corante e tampão, 1:200) | 190 μL | 180–199 μL |
| Standard (a partir do kit) | 10 μL | – |
| Exemplo de usuário | – | 1–20 μL |
| Volume total em cada tubo de ensaio | 200 μL | 200 μL |
Tabela 1: Volumes e quantidades de reagentes para fluorômetro. As quantidades são mostradas para uma única amostra; Um pool pode ser preparado com base no número de amostras a serem analisadas.
2. Método 2: Preparação da biblioteca
NOTA: Considerações. A preparação da biblioteca para sequenciar os plasmídeos extraídos foi realizada de acordo com as instruções fornecidas com o Kit de Códigode Barras 40. Esse protocolo utiliza um kit que emprega uma abordagem baseada em transposase para fragmentar e fragmentar simultaneamente o DNA com código de barras, proporcionando um fluxo de trabalho rápido e eficiente que reduz o tempo de trabalho prático e simplifica a preparação da biblioteca.
- Preparação de DNA
- Dia 1: Programe um ciclador térmico: 30 °C por 2 minutos, depois 80 °C por 2 minutos.
- Descongelar componentes do kit em temperatura ambiente, centrifugar e misturar conforme a Tabela 2.
NOTA: Se estiver usando uma centrífuga, vire para baixo em uma velocidade lenta que não ultrapasse 330 x g. - Preparação do DNA em água sem nuclease: Transfira 200 ng de DNA para tubos PCR de 0,2 mL e adicione um volume apropriado de água sem nuclease a cada amostra para levar o volume final a 10 μL. Misture pipeteando suavemente 10–15 vezes. Centrifuge brevemente em uma microfuge ou centrífuga a 330 x g para facilitar a pipetagem nas etapas seguintes.
- Prepare as misturas em tubos PCR conforme descrito na Tabela 3.
- Misture pipetando e depois centrifuge brevemente.
- Incube tubos de PCR usando o programa de ciclo térmico do Passo 1. Coloque tubos no gelo para esfriar.
- Gira brevemente.
- Ligação de código de barras nativo
- Amostras com código de barras em piscina em um tubo Eppendorf limpo de 1,5 mL. Certifique-se de que o volume total não ultrapasse 1000 μL.
- Resuspenda as Contas por meio de vórtice. Adicione um volume igual de Contas às amostras agrupadas com código de barras e misture fazendo um flick.
- Incube os tubos por 10 minutos em temperatura ambiente em uma batedeira Hula.
- Prepare 2 mL de etanol 80% em água sem nuclease.
- Centrifuge a amostra e o pellet segurando o tubo contra um ímã. Mantendo o tubo no ímã, a pipeta para tirar o sobrenadante como resíduo.
NOTA: Qualquer ímã de força e tamanho adequados, incluindo ímãs de neodímio, pode servir como uma alternativa eficaz ao uso de um suporte de ímãs caro. Ímãs com força de fixação de aproximadamente 5–12 lb e diâmetro de 0,3–1 polegada são tipicamente adequados para tubos padrão de 0,2–1,5 mL, permitindo a remoção limpa do sobrenadante durante as etapas de limpeza à base de esferas. - Lave as esferas com 1 mL de etanol 80% enquanto estiver no ímã. Remova etanol. Lavagem repetida.
NOTA: Alterar a posição do tubo em relação ao ímã pode melhorar a facilidade de remoção do etanol. Utilize um giro adicional em baixa velocidade para garantir o pelleting completo das esferas caso o pellet seja perturbado acidentalmente. - Gire rapidamente para baixo e coloque o tubo de volta no ímã. Pipete qualquer etanol residual. Seque por 30 segundos, mas não seque o pellet a ponto de rachar.
- Remova o ímã e resuspenda as esferas no buffer de elução. Veja a Tabela 4 para os volumes apropriados de EB a serem usados, dependendo do número de códigos de barras em uso.
- Incube o tubo por 10 minutos em temperatura ambiente.
- Devolva o tubo ao ímã até que o eluato esteja livre.
- Quantifique a concentração de DNA usando 1 μL da amostra eluída no Fluorômetro para garantir que a preparação da biblioteca foi executada com sucesso e evitar o desperdício de uma célula de fluxo em uma biblioteca com falha.
- Ligação de adaptadores
- Transfira 11 μL da biblioteca de DNA para um novo tubo e marcador.
NOTA: Armazene DNA extra a -20 °C para futuras execuções de sequenciamento, se necessário. - Dilua o Rapid Adapter descongelado em um tubo novo conforme a Tabela 5 e pipete para cima e para baixo até misturar.
- Adicione 1 μL de AR diluído à biblioteca de DNA de 11 μL.
- Faça um movimento no tubo para misturar, vire para baixo brevemente para garantir que o volume completo se acumule no fundo do tubo.
- Incube por 5 minutos no banco de bancada.
- Transfira 11 μL da biblioteca de DNA para um novo tubo e marcador.
| Reagente | Descongelação em temperatura ambiente | Gire para baixo | Misture por pipeteamento |
| Códigos de Barras Rápidos | Não Congelado | ✓ | ✓ |
| Adaptador Rápido | Não Congelado | ✓ | ✓ |
| Contas AMPure XP | ✓ | ✓ | Misture pipetando ou fazendo vórtice imediatamente antes do uso |
| Amortecedor de Elução | ✓ | ✓ | ✓ |
| Buffer Adaptador | ✓ | ✓ | Mistura por vórtice |
Tabela 2: Volumes e quantidades de reagentes para preparação da biblioteca de nanoporos. As ações a serem realizadas com cada reagente são marcadas (✓).
| Reagente | Volume/sample |
| DNA molde de 10 μL (200 ng da etapa anterior) | 10 μL |
| Códigos de barras rápidos de 1,5 μL, um para cada amostra | 1,5 μL |
| Volume total | 11,5 μL |
Tabela 3: Reagentes e volumes para codificação rápida de barras. Os volumes são mostrados por amostra de DNA; uma mistura em pool pode ser preparada e o DNA adicionado separadamente.
| Códigos de barras 1-24 | 48 códigos de barras | 72 códigos de barras | 96 códigos de barras | |
| Volume do Buffer de Elução | 15 μL | 30 μL | 45 μL | 60 μL |
Tabela 4: Volumes de buffer de elução usados para cada 24 códigos de barras. Os volumes são indicados de acordo com o número de códigos de barras.
| Reagente | Volume |
| Adaptador Rápido (RA) | 1,5 μL |
| Buffer Adaptador (ADB) | 3,5 μL |
| Total Volume | 5μL |
Tabela 5: Reagentes e quantidades para adaptador. Os volumes podem ser ajustados dependendo do número de amostras.
3. Funcionamento da célula de fluxo
NOTA: Escolha uma célula de fluxo de saída padrão ao sequenciar um pequeno número de plasmídeos com necessidades moderadas de cobertura. A Nanopore recomenda realizar uma verificação de célula de fluxo para determinar a contagem de poros ativos; As células de fluxo dos dispositivos Nanopore devem ter pelo menos 800 poros ativos, conforme definido pelos critérios de garantia. Uma única célula de fluxo MinION fornece saída suficiente para sequenciamento de múltiplas amostras de DNA enriquecidas em DNA plasmídico (veja mais detalhes sobre multiplexação na seção de discussão), oferecendo menor custo e maior flexibilidade do que uma célula de fluxo GRIDion ou Promethean.
- Preparação e carregamento da célula de fluxo
NOTA: Células de fluxo R10.4.1 (lançadas em 2022) foram usadas para desenvolver este protocolo. Essas células de fluxo possuem poros mais longos com cabeça leitora dupla, resultando em melhor sequenciamento de homopolímeros20,21. Esse protocolo de sequenciamento e o Kit de Codificação de Barras não são compatíveis com outras células de fluxo. Opte por uma célula de fluxo de alta saída ao realizar multiplexação em larga escala, buscar alta cobertura ou trabalhar com plasmídeos ou genomas maiores. Considere o número de amostras e a profundidade do alvo para equilibrar custo, taxa de transferência e qualidade do sequenciamento.- Remova reagentes do armazenamento a frio, incluindo buffer de sequenciamento (SB), esferas de biblioteca (LIB) ou solução de biblioteca (LIS), albumina sérica bovina (BSA), cabo de célula de fluxo (FCT) e lavagem da célula de fluxo (FCF). Descongela no gelo em temperatura ambiente. Depois que os reagentes descongelaram, o vórtice é misturado, centrifugado rapidamente e armazenado no gelo.
- Prepare o primer da célula de fluxo misturando um tubo de DNA fresco usando os reagentes listados na Tabela 6. Misture por inversão e pipeteamento.
- Levante a tampa do dispositivo e insira a célula de fluxo. Aplique uma pressão suave para garantir a colocação correta.
- Exponha a porta de priming empurrando a tampa para o lado.
- Verifique se há bolhas de ar dentro ou ao lado da porta de priming. Recue 20–30 μL de fluido para remover bolhas.
NOTA: Não remova mais de 20–30 μL de buffer. Os poros devem permanecer submersos no tampão o tempo todo. Poros expostos ao ar podem se tornar inutilizáveis. Certifique-se de que o buffer seja contínuo por todo o canal visível. - Retire 800 μL de mistura de priming e dispense na porta de priming. Evite introduzir bolhas de ar. Deixe o aparelho descansar por 5 minutos.
- Resuspenda o liberal pipetando para cima e para baixo.
NOTA: Resuspenda imediatamente antes do uso, pois a liberação se estabiliza rapidamente. - Misture a biblioteca de DNA com o volume apropriado de contas de biblioteca em um novo tubo, conforme indicado na Tabela 7.
NOTA: O kit Rapid Barcoding que os autores usam emprega uma abordagem baseada em transposase para fragmentar DNA e anexar códigos de barras sem seleção intencional de tamanho, então os comprimentos de leitura refletem principalmente o DNA original de entrada. Ao contrário de kits baseados em ligação, como os Kits Nativos de Barcode, o kit Rápido de Codificação de Barras não inclui buffers separados de fragmentos curtos ou longos. Embora DNA mais longo ainda possa gerar leituras longas, a distribuição é mais variável e geralmente mais curta do que com bibliotecas baseadas em ligação, que usam o Long Fragment Buffer para enriquecer fragmentos longos. A ausência de buffers simplifica o fluxo de trabalho e reduz o tempo de trabalho manual, mas oferece menos controle sobre a distribuição do tamanho da biblioteca, o que pode impactar a qualidade da montagem. Kits baseados em ligação, ao enriquecer seletivamente grandes fragmentos e remover os curtos, normalmente geram comprimentos medianos de leitura mais altos e melhora continuidade da montagem, especialmente para montagens de novo e genomas complexos. - Ajuste a tampa da porta da amostra para revelar a porta. Carregue 200 μL de mistura de priming na porta de priming da célula de fluxo.
- Misture cuidadosamente a biblioteca de DNA preparada antes de carregar.
- Dispense 75 μL da biblioteca de DNA com esferas na porta da amostra, uma gota de cada vez, permitindo que cada gota seja absorvida antes de adicionar a próxima.
- Reaplique a tampa da porta da amostra e feche a porta de priming.
- Adicione o escudo de luz à célula de fluxo alinhando a borda de ataque do blindado com o clipe e depois abaixe o restante para cobrir a célula de fluxo. Não tente colocar a proteção de luz sob o clipe. O blindagem de luz deve ficar ao redor da tampa, protegendo toda a parte superior da célula de fluxo da exposição à luz.
NOTA: Instale o escudo de luz na célula de fluxo assim que a biblioteca for carregada para obter a saída de sequenciamento ideal. Deixe-a ligada em quaisquer etapas subsequentes até que a biblioteca seja removida da célula de fluxo. O escudo de luz não está fixado de forma segura ao dispositivo; Manuseie com cuidado para evitar deslocá-lo. - Tranque a tampa do dispositivo e inicie a execução de sequenciamento.
- Iniciando os requisitos computacionais de execução sequenciados:
Mínimo: CPU de 8 threads, 16 GB de RAM, GPU NVIDIA 1070, SSD de 500 GB
Recomendado: CPU de 16 threads, 32 GB de RAM, GPU NVIDIA 2070, SSD de 1 TB
NOTA: Certifique-se de que tanto o software quanto o computador estejam atualizados e tenham pelo menos 500 GB de armazenamento livre para acomodar novos arquivos. Atualizações de software e outros programas podem interferir na execução do sequenciamento. Certifique-se de rodar o software em um sistema operacional Windows ou Ubuntu.- Defina o limite de tempo de execução: dependendo de quantos plasmídeos estão sendo multiplexados, defina o limite de execução. O padrão é 48 horas, com um tempo máximo de 72 horas que pode ser executado. Para instruções detalhadas, consulte o manual.
NOTA: o tempo de execução depende da multiplexação e do tamanho do plasmídeo, e não do número de plasmídeos. O número de amostras ou plasmídeos que podem ser multiplexados depende da profundidade de sequenciamento desejada e da saída da célula de fluxo. Para o sequenciamento típico de plasmídeos, multiplexar 20–24 amostras por célula padrão de fluxo nanoporo geralmente oferece cobertura suficiente para montagem precisa e detecção de variantes, assumindo tamanhos de plasmídeos inferiores a ~200 kb. Plasmídeos maiores ou requisitos de cobertura maiores podem exigir menos amostras por célula de fluxo. Células de fluxo de maior saída podem suportar muito mais amostras (até 96 ou mais) por execução, tornando-as adequadas para sequenciamento de plasmídeos de alta capacidade ou projetos que exigem cobertura muito profunda. Os usuários devem equilibrar o número de códigos de barras, o tamanho do plasmídeo e a profundidade do alvo para garantir que cada plasmido receba leituras adequadas para a montagem completa. - Ative o corte de código de barras se estiver realizando a demultiplexação durante o sequenciamento.
NOTA: Monitore as leituras por código de barras e interrompa a execução quando a cobertura for atingida para preservar a vida útil da célula de fluxo. - Selecione o modo de chamada de base super-preciso.
NOTA: Não selecione amostragem adaptativa/balanceamento de código de barras. Essa opção reduz muito a leitura-saída e degrada os poros em um ritmo mais rápido. Se você não tem GPU, é melhor esperar para fazer chamadas de base depois do fim da execução. - Selecione o kit de código de barras rápido apropriado (24 ou 96).
- Certifique-se de que o dispositivo esteja nivelado e inicie a execução de sequenciamento com as configurações padrão (pontuação mínima Q: 10)
NOTA: Este é um ponto conveniente para parar. O dispositivo pode ser usado durante a noite. - Chamadas pós-hoc (caso o computador não tenha capacidade suficiente para chamadas ao vivo ou para melhorar a precisão das chamadas base, reanalisando os dados brutos com ferramentas analíticas aprimoradas): abra a execução de sequenciamento concluída no software
NOTA: Os próximos passos só se aplicam se você não selecionou a chamada ao vivo na base. - Selecione Basecalling e escolha o modelo de super-precisão (SUP).
- Selecione os dados brutos do FAST5/POD5 e defina um diretório de saída.
- Comece a fazer chamadas de base.
- Defina o limite de tempo de execução: dependendo de quantos plasmídeos estão sendo multiplexados, defina o limite de execução. O padrão é 48 horas, com um tempo máximo de 72 horas que pode ser executado. Para instruções detalhadas, consulte o manual.
| Reagentes | Volume por célula de fluxo |
| Lavagem por célula de fluxo (FCF) | 1.170 μL |
| Albumina sérica bovina (BSA) a 50 mg/mL | 5 μL |
| Cabo de Célula de Fluxo (FCT) | 30 μL |
| Volume total final em tubo | 1.205 μL |
Tabela 6: Reagentes e volumes para preparação e carregamento da célula de fluxo. Os volumes de reagentes são indicados por célula de fluxo.
| Reagentes | Volume por célula de fluxo |
| Buffer de sequenciamento (SB) | 37,5 μL |
| Contas de biblioteca (LIB) ou solução de biblioteca (LIS), se usar | 25,5 μL |
| Biblioteca de DNA | 12 μL |
| Total | 75 μL |
Tabela 7: Reagentes e volumes para carregamento da biblioteca. Os volumes são mostrados para a biblioteca de DNA; As contas da biblioteca (BID) devem ser misturadas imediatamente antes do uso.
4. Método 4: montagem usando um autociclador
NOTA: Existem muitas opções para montar leituras em contigs. Cada montador tem seus pontos positivos e seus vieses. Esse protocolo recomenda o uso do Autocycler, que utiliza muitos conjuntos diferentes e os combina em um único monte. Isso é mais trabalhoso, e você pode usar um único montador para economizar tempo. Por favor, instale o Conda no terminal para baixar o software apropriado. O documento de comandos suplementares contém um link para um arquivo ambiental para configurar o sistema.
- Avalie a qualidade da execução: Verifique a qualidade da execução pelo software Minknow ou pelo arquivo .html relatório de execução para anotar métricas de qualidade (rendimento, Q-scores, duração, distribuição). Opcionalmente, avalie arquivos FASTQ usando o NanoPlot para confirmar a distribuição do comprimento de leitura, N50 e perfis de pontuação de qualidade para cada código de barras. Prossiga somente se as distribuições de rendimento e comprimento de leitura do sequenciamento forem consistentes com os tamanhos esperados dos plasmídeos.
- Remover códigos de barras: Verifique se o corte de código de barras foi ativado durante a execução do sequenciamento. Se os códigos de barras não foram removidos, corte arquivos FASTQ usando Porechop (v0.2.4) e verifique com sucesso a remoção das sequências de adaptadores de código de barras antes da análise posterior.
- Leituras de trim: Corte leituras longas usando Filtlong (v0.3.1), removendo aproximadamente 5–10% das leituras de menor qualidade enquanto retém ~90% do rendimento total. Gerar um arquivo FASTQ filtrado para montagem. Se montagens subsequentes produzirem contigs quiméricos, aumente a stringência de filtragem impondo um limiar mínimo de comprimento de leitura de ≥3.000 bp e regenere as leituras filtradas.
- Subamostras e montar readsubsets: Subamostras lês usando o Autocycler de acordo com as configurações recomendadas e montam cada subconjunto de leitura usando Raven (v1.8.3), Flye (v2.9.6), Canu (v2.3.0), miniasm (v0.3.0), Myloasm (v0.2.0), NECAT (v0.0.1), Plassembler (v1.8.1) e quaisquer outros assemblies de escolha. Note os comprimentos contiguos e o status de circularização de cada montagem. Montadores que relatam circularização (Raven, Flye, miniasm, Myloasm e Plassembler) devem ser priorizados para reconstrução de plasmídeos. Para assemblagens Canu e NECAT, identifique contigs de plasmídeos candidatos com base no tamanho esperado do plasmídeo a partir de contigs circulares em montagens anteriores.
- Inspecionar e curar montagens: visualize cada arquivo de grafo de montagem (.gfa) usando Bandage (v0.9.0) e avalie contigs quanto à circularidade, consistência de tamanho entre montadores e evidências de uniões quiméricas. Remova contigs lineares sem suporte entre múltiplos assemblers e mantenha contigs circulares com estimativas de tamanho consistentes. Se muitos montes contêm junções quiméricas, retorne ao passo 4.3 e aumente o limite mínimo de comprimento de leitura (recomendado ≥3.000 bp). Nos casos em que os plasmídeos principais são circularizados, mas restam contigs menores sem suporte, remova-se contigs menores antes da geração por consenso. Prossiga para a geração de consenso e as etapas de polimento podem ser executadas em lote, após curadoria manual.
- Gerar consenso e montagem final: Após a curadoria manual, prossiga com a geração de consenso do Autocycler usando as montagens selecionadas. Execute os comandos restantes do Autocycler para produzir a sequência final de plasmídeo consensual. Instruções detalhadas na linha de comando e configurações de parâmetros são fornecidas no Material Suplementar.
- Polimento: Depois de gerar um conjunto completo, polia o conjunto usando as leituras longas cortadas com Medaka (v2.1.1) para melhorar significativamente a precisão do consenso.
NOTA: Embora munições extras de polimento possam ajudar na precisão consensual, elas também podem introduzir erros. É boa prática usar um programa como o DNAapler para girar o novo contig antes de polir; comandos podem ser encontrados na seção de comandos suplementares.
5. Método 5: Anotação
NOTA: Existem muitas ferramentas eficazes de anotação para bactérias. Os seguintes programas são recomendados para uma anotação detalhada.
- Bakta é ótimo para análises proteômicas porque atualmente é mantido ativamente e serve como sucessor espiritual do Prokka 41,42.
- Para tipagem de replicões, tipagem de mobilidade plasmídica e tipagem por conjugação, o MOB-suite é confiável6. O MOB-suite pode inferir a filogenia plasmídica usando distanciamento do mash e pode identificar elementos43 da sequência de inserção (IS).
- O COPLA também é uma ferramenta útil para a taxonomia dos plasmídeos. A abordagem única de Copla, que classifica os plasmídeos em unidades taxonômicas de plasmídeos, é recomendada nocampo 44.
NOTA: A filogenia dos plasmídeos historicamente apresentou desafios significativos porque a estrutura modular dos plasmídeos e a alta frequência de recombinação dificultam o alinhamento de sequências. O COPLA aborda esses desafios calculando as identidades médias dos nucleotídeos (ANI).
Resultados
Cepas clínicas de E. coli
Para ilustrar o uso do ONT para o sequenciamento de plasmídeos de cepas clínicas, os autores sequenciaram 10 cepas, que foram uma doação generosa do Dr. Stephen Salipante, da Universidade de Washington. Essas cepas faziam parte de uma coleção de 312 isolados derivados de sangue ou urina de E. coli patogênico extraintestinal (ExPEC), obtidos durante o curso de cuidados clínicos rotineiros no University of WashingtonMedical Center 45.
Conjugação e caracterização de plasmídeos por ensaio de mobilidade em gel
Pesquisadores também realizaram um ensaio de conjugação usando a cepa E. coli LMB100 como receptor. Conjugação é um processo que leva à transferência de um plasmídeo presente em uma célula (o doador) para outra célula (chamada de receptor)46. A transferência requer contato físico entre as duas células e normalmente é detectada por marcadores que indicam a presença do plasmídeo conjugativo nas células receptoras. Isso permitiu aos autores eliminar diferenças na cepa do hospedeiro como variável e ilustrar o uso do protocolo para o sequenciamento de plasmídeos obtidos por captura de plasmídeos (um método usado para perfilar plasmídeos de um determinado nicho ecológico). Todos os ensaios de conjugação produziram transconjugantes, confirmando a presença de um plasmídeo conjugativo nos doadores. O protocolo seguido pelos autores é descrito no36. O grupo identificou os plasmídeos presentes nas cepas doadoras e receptoras e estimou sua mobilidade por eletroforese em gel de campo pulsado (PFGE). Uma lista de dez cepas representativas de doadores é apresentada na Tabela 8, e os tamanhos estimados dos plasmídeos presentes nelas estão listados na terceira coluna. Plasmídeos fora da faixa de resolução do gel PFGE são excluídos desta tabela, mas os pesquisadores conseguiram montar vários plasmídeos menores em torno de ~4kb (não mostrado).
| Cepa doadora | Plasmídeo | Tamanho estimado do PFGE | Comprimento de Montagem | Profundidade média | bp Profundidade Zero | Cobertura % | Posições Alteradas | % de Precisão Pré-SR |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
Tabela 8: Estimativas do tamanho do plasmídeo e métricas de precisão do sequenciamento para um painel de 10 cepas doadoras. Estimativas do tamanho do plasmídeo baseadas em PFGE ou sequências de plasmídeos doadores de ONT montados são listadas. As comparações par a par entre os montagens de plasmídeos polidos apenas ONT e sequência SR também são apresentadas como indicador de precisão. As métricas incluem: comprimento de montagem, profundidade média, regiões de profundidade zero, porcentagem de cobertura, posições alteradas e porcentagem de precisão pré-SR.
Métricas de saída de sequenciamento plasmídico baseadas em ONT
A sequência foi definida para 24 horas. Um total de 24 amostras foram multiplexadas. Os dados técnicos de cada amostra, incluindo pontuação de qualidade (Q), duração e cobertura, estão listados na Tabela 9. O sequenciamento nanopore produziu leitura suficiente e qualidade para todas as amostras analisadas. Em todas as bibliotecas, o sequenciamento gerou uma média de 134.115 leituras por amostra, correspondendo a um rendimento médio de 576,2 Mb. As leituras tinham um comprimento médio de 8.797 bp com uma média N50 de 3.693 bp, proporcionando continuidade suficiente para a montagem do plasmídeo. A pontuação média de qualidade de leitura foi Q16,0 com mediana de Q16,6, e as corridas individuais variaram de Q13,7 a Q18,0.
| Deformação sequenciada | Leituras (kb) | Bases (Mb) | Comprimento médio | Comprimento máximo | Comprimento mínimo | N50 | Comprimento mediano | Médio Q | Mediana Q | |
| Blood_08_0081 doador | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 doador | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 doador | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 doador | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 doador | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 doador | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 doador | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 doador | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 doador | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 doador | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 transconjugante LMB100 | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 transconjugante LMB100 | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 transconjugante LMB100 | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 transconjugante LMB100 | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 transconjugante LMB100 | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 transconjugante LMB100 | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 transconjugante LMB100 | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 transconjugante LMB100 | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 transconjugante LMB100 | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 transconjugante LMB100 | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
Tabela 9: Relatório NanoQ das métricas de saída de sequenciamento para um painel de 10 cepas doadoras. As métricas de saída de sequenciamento estão listadas. Estes incluem leituras, bases, comprimento (média, mediana, máximo e mínimo), comprimentos, N50 e valores Q (média e mediana) de doadores e transconjugantes.
Montagem de plasmídeos e precisão
Sequências plasmídicas foram montadas usando o Autocycler34. Os tamanhos das sequências plasmídicas montadas para 10 das amostras estão listados na Tabela 8, quarta coluna, e em todos os casos foram congruentes com estimativas baseadas na mobilidade do PFGE (listadas na terceira coluna). A precisão foi avaliada comparando montagens de leitura longa polidas com Medaka (v2.2.0) mais conjuntos polipolacos (v0.6.1). A identidade da sequência foi calculada usando dnadiff do MUMmer (v3.2.4) (Tabela 8). Em todos os plasmídeos analisados (n = 12), as assembleias tinham comprimento médio de 120,4 kb e eram suportadas por uma profundidade média de sequenciamento de 109x, com uma cobertura média de 97,9% nas sequências plasmídicas. Antes do polimento, os montagens apresentavam uma identidade média de sequência de 99,74% em relação à montagem polida pela sequência SR.
Estimativa da contaminação cromossômica
Para estimar a cobertura de plasmídeos e a contaminação cromossômica, as leituras foram mapeadas para sequências plasmidárias montadas e para a sequência cromossômica LMB100 de E. coli. As leituras basecalled Nanopore foram alinhadas usando o minimap2 (v2.2.6). Os alinhamentos resultantes eram processados usando SAMtools (v1.1.7) para gerar arquivos BAM ordenados e calcular estatísticas de mapeamento. A cobertura de plasmídeos e a profundidade média foram estimadas usando a cobertura do SAMtools. A profundidade do sequenciamento plasmídico variou entre as amostras, mas permaneceu bem acima da cobertura mínima exigida para montagem precisa (50–70 x). Uma fração das leituras mapeava para o cromossomo, indicando a transferência do DNA do hospedeiro durante a extração do plasmídeo (Tabela 10).
| Plasmídeos | Total de Leituras | Leituras cromossômicas | % de leituras cromossômicas | Cobertura cromossômica média | Cobertura Média de Plasmídeos | Relação P:C |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
Tabela 10: Estimativas de contaminação por DNA cromossômico. A contaminação cromossômica em plasmídeos purificados de cepas receptoras foi quantificada como a proporção de leituras mapeadas para a sequência cromossômica LMB100 em relação às leituras de plasmídeos. Para cada plasmídeo, são listadas as leituras do plasmídeo, leituras totais, leituras cromossômicas, cobertura cromossômica média, cobertura média de plasmídeos e razão P:C. Note que pBlood_08_0081_1 está ausente porque não pôde ser recuperada no receptor, e essas estimativas foram realizadas nos receptores devido ao seu fundo cromossômico uniforme.
A contaminação cromossômica foi quantificada como a proporção de leituras mapeadas para a sequência cromossômica LMB100 montada em relação às leituras plasmidárias. As taxas de contaminação cromossômica variaram entre 72,1% e 28,0%, com uma média de 46,9% (Tabela 10). O método provavelmente superestima a contaminação cromossômica, pois leituras que mapeiam tanto o plasmídeo quanto o cromossomo são contadas como apenas cromossômicas, mas ainda indica uma transferência cromossômica substancial. Apesar dessa transferência cromossômica, o fluxo de trabalho de montagem reconstruiu com sucesso sequências completas de plasmídeos, que ainda eram consistentes com o tamanho previsto pela mobilidade do PFGE em todas as amostras (Tabela 8, terceira e quarta colunas).
Pares representativos doador-receptor de plasmídeos conjugativos
A cepa upec271 foi isolada de uma amostra urinária entre 2011 e 2013 e foi atribuída ao filogrupo B2 e ao tipo de sequência ST131. A análise do PFGE revelou a presença de uma faixa correspondente a um plasmídeo de aproximadamente 145 kb [Figura 3A, (Doador)]. A análise de sequência de leitura curta identificou a presença de um réplicon IncF.
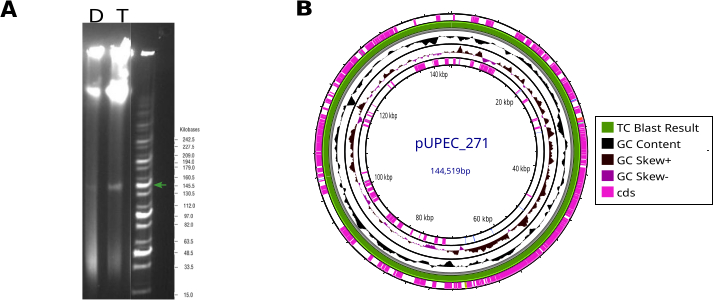
Figura 3: Caracterização do pUPEC271. (A) PFGE de doador e transconjugante. As bandas PFGE para o doador (D) e o transconjugante (T) são mostradas; as setas verdes indicam a faixa plasmídica correspondente a pUPEC271. O protocolo utilizado para a PFGE é descrito em um estudo36. (B) Mapa do pUPEC271. O transconjugante foi atacado contra o doador, e o consenso (que é 100% idêntico) é mostrado como o anel verde. Essa representação foi gerada usando o Proksee48. O anel mais externo mostra a localização do CDS, dois anéis internos mostram o conteúdo e o environamento de GC, e o anel mais interno mostra a localização dos genes de tRNA. Por favor, clique aqui para ver uma versão ampliada desta figura.
A transferência desse plasmídeo, que os autores chamaram de pUPEC271, foi ainda confirmada por análise de PFGE usando o protocolo anteriormente descrito em36 [Figura 3A, T(transconjugante)]. DNA plasmídico purificado da cepa doadora upec271 (pUPEC271_donor) foi sequenciado usando nanoporos. Consistente com o tamanho de sua faixa no gel PFGE, a sequência pUPEC271_donor revelou um plasmídeo de 144.519 pb (Figura 3B). Esse plasmídeo possuía um réplicon do tipo IncF e possuía genes de resistência a seis classes distintas de antibióticos (ver Tabela Suplementar 1). Os autores também purificaram o DNA de um dos transconjugantes (pUPEC271_TC) e obtiveram uma sequência idêntica à do doador. A montagem final, comparada com pUPEC271_donor, é representada na Figura 3B. Isso confirmou que o plasmídeo conjugativo presente no doador foi transferido para a cepa transconjugante. Os dados técnicos estão apresentados na Tabela 9.
A Blood_10_0913 de deformação é um exemplo de cepa com mais de um plasmídeo. Essa amostra foi coletada do sangue entre 2008 e 2013, e o sequenciamento de leitura curta indicou a presença de dois réplicons, um IncF e um IncY. A análise por PFGE dessa cepa identificou dois plasmídeos de aproximadamente 70 e 110kb, respectivamente (Figura 4A). Isso foi confirmado pelo sequenciamento por nanoporos, que produziu duas montagens, de 71.182 pb e 111.226 pb, respectivamente. Os autores nomearam esses dois plasmídeos pBlood_10_0913_1 e pBlood_10_0913_2 (Figura 4B). No entanto, as assembleias inicialmente não circularizaram devido à extensa homologia de sequências na seção dos plasmídeos que carregavam a maquinaria de conjugação (a seção da homologia extensiva é destacada na Figura 4B). O diagrama de montagem com falha, gerado usando o Bandage47 , é mostrado na Figura 4C. A montagem completa dos dois plasmídeos só foi possível após um eliminamento agressivo de leitura de sequências de leitura mais curta (< 3000 pb).
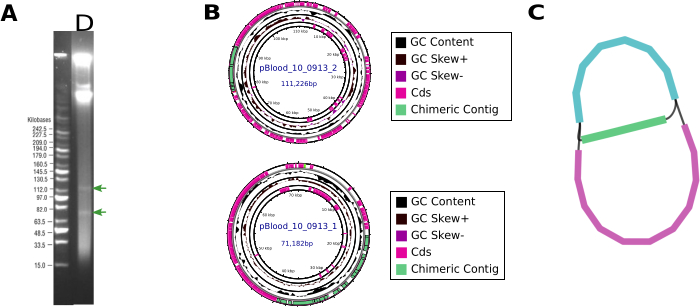
Figura 4: Identificação e montagem dos plasmídeos de Blood_10_0913 cepa. (A) PFGE. As setas verdes indicam faixas plasmídicas. O protocolo usado para o PFGE é descrito na montagemde sequência 36 (B). Montagem dos dois plasmídeos menores presentes na amostra pBlood_10_0913, pBlood_10_0913_2 e pBlood_10_0913_2. (C) Montagem falhada. Representação da falha de montagem devido à presença de uma sequência compartilhada entre dois montagens distintas. Essa representação foi gerada usando o Bandage47. Por favor, clique aqui para ver uma versão ampliada desta figura.
Tabela suplementar 1: Genes de resistência transportados pelo pUPEC271. O tamanho do plasmídeo, os réplicons e os genes de resistência associados ao pUPEC271 são mostrados. Por favor, clique aqui para baixar este arquivo.
Comandos Suplementares. Por favor, clique aqui para baixar este arquivo.
Discussão
A identificação e caracterização dos plasmídeos é de grande interesse para saúde pública, microbiologia clínica e ecologia microbiana, pois facilitam a manutenção e disseminação de genes adaptativos em ambientes ecológicos 1,5 e servem como plataformas para a evoluçãoacelerada 4. A introdução das tecnologias NGS permitiu o sequenciamento de alto rendimento de genomas de isolados microbianos e de populações, embora a identificação pós-montagem de plasmídeos completos ou de contigs derivados de plasmídeos geralmente exija sequências de leitura longa, pois dados de sequenciamento de leitura curta não conseguem resolver regiões repetidas maiores que o tamanho das leituras. O ONT tornou-se uma abordagem muito popular de sequenciamento de leitura longa, com aplicações que vão além do sequenciamento genômico completo e da metagenômica, incluindo verificação de sequências plasmídicas, detecção e caracterização de modificações epigenéticas, sequenciamento de RNA e avaliação da instabilidade intrínseca de matrizes genéticas em tandem (revisado em12,49).
Aqui, os pesquisadores apresentam um fluxo de trabalho para sequenciamento ONT de plasmídeos, projetado para situações em que a sequência cromossômica já é conhecida ou não tem interesse. A razão é que a extração de plasmídeos é trabalhosa, custosa e demorada (já que a população hospedeira precisa ser cultivada e processada), e sequenciar todo o genoma usando tecnologia de nanoporos é frequentemente suficiente para obter conjuntos de plasmídeos completos enquanto fornece seu contexto genômico. Exemplos em que o protocolo é útil incluem a verificação de uma sequência plasmídica no contexto da engenharia genéticaplasmídica 50,51, a melhoria da precisão das sequências plasmídicas já obtidas pelo WGS24, ou a caracterização de plasmídeos capturados de amostras clínicas ou ambientais por conjugação.
A extração de DNA de amostras clínicas e ambientais pode precisar de alguma personalização. Aqui, os autores relatam que algumas das cepas clínicas que usaram produziram uma matriz de biofilme que entupia os filtros, exigindo múltiplas etapas de pelletagem e, às vezes, a adição de dois filtros. Além disso, para sequenciar plasmídeos conjugativos, é necessário um volume maior de cultura em relação ao sequenciamento de plasmídeos multicópia, pois plasmídeos de médio e grande porte naturalmente tendem a ter um número de cópiasde plasmídeo baixo 2.
O protocolo permitiu o sequenciamento de plasmídeos entre 4 kb e 173 kb de tamanho. Essa faixa está totalmente dentro das especificações do fabricante (entre 2 e 200 kb). Recentemente, um estudo analisou 23.000 sequências de plasmídeos depositadas no NCBI e encontrou diferenças significativas de tamanho dependendo da fonte, com plasmídeos de origem humana tendo o menor tamanho mediano (76 kb), e plasmídeos de solo e plantas os maiores (215 e 427 kb); Plasmídeos de todas as outras fontes tinham tamanho mediano entre 79 e 147 kB, então esse protocolo deve cobrir a maioria dos plasmídeos, sendo possível exceção dos megaplasmídeos52 e plasmídeos de origem soloou vegetal 3.
Os autores incluem uma etapa de enriquecimento de DNA plasmídico para melhorar a precisão das assembleias de DNA plasmídico. A presença de grandes quantidades de DNA cromossômico inunda os poros celulares na célula de fluxo sequenciante com leituras não alvo, reduzindo substancialmente a profundidade do DNA plasmídico. Uma etapa de enriquecimento de DNA plasmídico já foi implementada para tentar a montagem completa do DNA plasmídico em amostras clínicas para a detecção dosARGs 24. Isso mostrou melhorias substanciais na eficácia de completar a montagem de plasmídeos com sequência apenas de nanoporos (78% das montagens completas em relação ao benchmark). Outros exemplos vieramem seguida 50, 53, 54.
Para melhorar a precisão da leitura, dois desses estudos usaram uma técnica desenvolvida pela nanopore chamada "chamada de base pareada em leituras pseudopareadas"50,53. Essa abordagem envolve alinhar os sinais elétricos brutos das cadeias sensoriais e antissenso da mesma molécula de DNA, resultando em uma melhoria na precisão de cerca de uma ordem de magnitude. A chamada de bases pareada em leituras pseudopareadas é compatível com multiplexação, desde que a estratégia permita a identificação das cadeias direta e reversa da mesma molécula. Assim, não pode ser usado em plasmídeos purificados de amostras de complemento plasmídico desconhecido ou contendo uma mistura de plasmídeos. Note que o número de plasmídeos em um genoma normalmente varia entre 0 e 7 plasmídeos (particularmente em isolados clínicos)2,55.
Os pesquisadores notaram um alto nível de contaminação cromossômica nas amostras (Tabela 10). O nível de contaminação de 10 amostras analisadas variou entre 28 e 72% com base no mapeamento de leitura. No entanto, quando os pesquisadores normalizaram essa sequência ao tamanho do cromossomo em relação ao dos plasmídeos presentes, descobriu-se que as sequências plasmídicas eram em média 144 vezes mais abundantes do que as cromossômicas. Traduzir esse número para o nível de enriquecimento de DNA plasmídico exigiria conhecer o número de cópias plasmídicas dos plasmídeos em cada amostra.
Células de fluxo MinION normalmente produzem uma saída de sequenciamento de ~30 GB, possibilitando teoricamente o sequenciamento de bem mais de 96 plasmídeos por execução. Na prática, a multiplexação também é limitada pelo limite de 96 códigos de barras, tornando 96 plasmídeos o limite superior prático por célula de fluxo. No entanto, a contaminação por DNA cromossômico e o desequilíbrio natural do código de barras reduzem a profundidade efetiva de leitura por amostra. Para garantir profundidade de leitura suficiente para cada amostra, uma abordagem mais conservadora é multiplexar aproximadamente 24 plasmídeos por célula de fluxo. A profundidade recomendada para a montagem precisa da sequência plasmídica é entre 50 e70x32,56. Nos exemplos ilustrativos apresentados neste artigo, os autores analisaram 21 amostras multiplexadas em uma célula de fluxo e obtiveram uma profundidade média (109x), que está bem alinhada com o ótimo recomendado para amostras por célula de fluxo.
Note que, com profundidade de leitura excessiva, partições de leitura aprovadas/reprovadas são menos informativas para avaliar a qualidade geral da leitura. Em vez disso, métricas derivadas da distribuição de comprimento fornecem uma representação mais clara da qualidade do conjunto de dados. Uma dessas métricas é o N50, definido como o comprimento de leitura no qual leituras desse comprimento ou mais representam 50% do total de bases. Esse valor é altamente sensível a etapas de controle de qualidade. Por exemplo, filtrar leituras de baixa qualidade ou curtas com ferramentas como Filtlong remove uma fração substancial da cauda mais curta da distribuição, inflando assim o N50. Esse efeito é evidente na Tabela 9.
Os autores usaram o kit Rapid Barcode do ONT, que utiliza um transpósomo para fragmentar o DNA do plasmídeo, e portanto não requer conhecimento prévio do padrão de restrição do plasmídeo. Um estudo anterior constatou que, para plasmídeos pequenos (<20 kb), a fragmentação enzimática é necessária porque pequenos plasmídeos permanecem circularizados durante a maioria das extrações de DNA e, portanto, não contêm extremidades livres para a ligaçãoadaptadora 54. Esse estudo não usou códigos de barras, que geram extremidades livres adicionais por amplificação por PCR, então, neste caso, isso provavelmente não tem importância. O OnRamp, um dos procedimentos avançados para validação rotineira de plasmídeos, evita o uso de códigos de barras ao utilizar leituras de plasmídeos de comprimento total para montagem, simplificando a preparação daamostra 54. Neste caso, os autores preferiram códigos de barras por três razões. A primeira é construir um conjunto independentemente do comprimento do plasmídeo. A segunda é tolerar a contaminação por DNA cromossômico. A terceira é que isso abre a possibilidade de multiplexar várias amostras, como mencionado acima.
Um estudo anterior observou que a agregação de diferentes montadores melhorou o resultado final ao cancelar vieses incorporados nas plataformas de montagemindividuais 24. Essa meta-análise é um recurso incorporado ao programa de montagem que os autores utilizam, o Autocycler34. Em relação à sua versão anterior, chamada Trycycler57, o Autocycler é um pouco mais automatizado; ele utiliza vários subconjuntos das leituras e (como mencionado antes) realiza assemblies com múltiplos montadores para criar uma montagem de consenso mais precisa. No entanto, a maioria dos montadores, mesmo os melhores, como Flye28, Canu29 e Raven30, tem dificuldade com a presença de plasmídeos com homologia de sequências extensa, fundindo erroneamente sequências de plasmídeos ou gerando múltiplas cópias de um único plasmídeo, e tendem a perder pequenosplasmídeos 58,59 (veja também a Figura 4C). Quando isso acontece, cortar leituras de qualidade inferior e remover leituras curtas pode levar à resolução de contigs quiméricos.
Para estabelecer a precisão geral dos protocolos de sequenciamento, os autores compararam os montagens apenas ONT com montagens polidas combinando leituras longas e curtas, que (sem os dados do PacBio) são o padrão ouro atual. Os autores também tinham dados de gel mostrando o número de plasmídeos presentes e seus tamanhos estimados (Tabela 8, terceira coluna). Os pesquisadores montaram com sucesso todos os 13 plasmídeos encontrados nas 10 amostras e obtiveram tamanhos consistentes com as sequências montadas. Isso é um grande sucesso, já que montadores de sequências LR frequentemente falham em montar plasmídeos com sequências estruturalmente complexas. Em um nível mais detalhado, comparações par a par entre os dois conjuntos de sequências indicaram um nível variável de precisão (Tabela 8). Cinco dos conjuntos plasmídicos tinham áreas sem cobertura nos montagens ONT, presumivelmente resultado da sequência adicionada artificialmente durante a montagem de sequências apenas com ONT. Dos outros sete, três apresentaram polimorfismos de nucleotídeo único, com diferenças entre dois e pares variando entre 0,0023 e 0,05%, e quatro apresentaram concordância perfeita. O nível de precisão não parece correlacionar-se com o nível de enriquecimento do DNA plasmídico ou profundidade de sequenciamento, mas a presença de mais de um plasmídeo em uma amostra dada sim, possivelmente porque ter mais de um plasmídeo tende a amplificar o nível de complexidade da sequência (Tabela 8). Em suma, o fluxo de trabalho é projetado para otimizar o rendimento e a precisão das sequências plasmídicas. Embora seja capaz de montar sequências de plasmídeos, produz um nível variável de precisão no nível dos nucleotídeos. O protocolo pode ser usado para sequenciar plasmídeos de uma ampla gama de tamanhos, tolera pelo menos 72% de contaminação por DNA cromossômico e pode acomodar (dependendo do tamanho do plasmídeo e do estado da célula de fluxo) pelo menos 24 plasmídeos em uma única célula de fluxo.
Divulgações
Os autores não têm nada a revelar.
Agradecimentos
Somos muito gratos a Steve Salipante (Universidade de Washington) por compartilhar generosamente um conjunto de cepas clínicas de E. coli publicadas em45. Esse trabalho foi parcialmente apoiado por fundos de apoio à pesquisa para uma nomeação de Diretoria em Inovação e Desenvolvimento Empreendedor da UCSC para MC e pela bolsa Alianza MX da Universidade da Califórnia "Perfil genômico de isolados de tuberculose entre populações de alta carga e vulneráveis no México: insights sobre transmissão e resistência a medicamentos" para MC.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | Pode ser substituído por outra marca |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | Pode ser substituído por outra marca |
| 15 mL conical tubes | FALCON | 352096 | Pode ser substituído por outra marca |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | Pode ser substituído por outra marca |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | Pode ser substituído por outra marca |
| 250 mL sterile flasks | PYREX | 5320 | Pode ser substituído por outra marca |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | Pode ser substituído por outra marca |
| Centrifuge | Eppendorf | 5424R-PR-R | Pode ser substituído por outra marca |
| Centrifuge | Eppendorf | 5810R-P-R | Pode ser substituído por outra marca |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | Pode ser substituído por outra marca |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | Pode ser substituído por outra marca |
| Electronic Digital Scale | Denver Instrument | APX-2001 | Pode ser substituído por outra marca |
| Ethanol | Fisher Scientific | 04-355-720 | Pode ser substituído por outra marca |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | Pode ser substituído por outra marca |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | Qualquer marca de luvas de nitrilo funciona |
| Ice bucket | Thermo Fisher Scientific | 432128 | Pode ser substituído por outra marca |
| Isopropanol | Fisher Scientific | BP26184 | Pode ser substituído por outra marca |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | Pode ser substituído por outra marca |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | Pode ser substituído por outra marca |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit™ 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit™ Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 μL (P10), 2 – 20 μL (P20), 20 – 200 μL (P200) and 200 – 1000 μL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Micropipettes devem ser calibradas |
| Spectrophotometer | Thermo Scientific | 335905P | Pode ser substituído por outra marca |
| Sterilized tips for 10 μL, 200 μL and 1000 μL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | Pode ser substituído por outra marca |
| Water bath | Thermo Scientific | 51221052 | Pode ser substituído por outra marca |
Referências
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
Reimpressões e permissões
