Este artigo apresenta um protocolo passo a passo para coleta de dados de rastreamento ocular com alta precisão em experimentos de leitura humana, abrangendo seleção de hardware e exibição, configuração do laboratório, gerenciamento de participantes, calibração e validação, controle de qualidade online e pré-processamento (detecção de eventos e correção de deriva) para obter dados com alta exatidão e precisão, bem como resultados reprodutíveis.
Artigo de método
Protocolo Metodológico para a Coleta de Dados de Alta Qualidade durante o Rastreamento Ocular na Leitura Humana
Neste artigo
Resumo
Resumo
O rastreamento ocular é uma abordagem metodológica central para o estudo da atenção e do processamento da linguagem durante a leitura. A validade e a reprodutibilidade dos resultados dependem da qualidade dos dados, de uma metodologia clara e de um pré-processamento consistente. Este artigo apresenta um protocolo abrangente e passo a passo para coletar dados de rastreamento ocular de alta qualidade em estudos de leitura. O protocolo começa com a preparação do ambiente laboratorial e a configuração do equipamento, seguido pela seleção e configuração do hardware e software de rastreamento ocular, e pela preparação dos estímulos e do delineamento experimental. São realizados o gerenciamento dos participantes, o consentimento informado e a documentação das características linguísticas e psicométricas. Em seguida, são realizados procedimentos de calibração e validação, com o conforto do participante e a qualidade dos dados sendo monitorados continuamente durante a coleta. O pipeline de pré-processamento inclui a exportação dos dados brutos em formatos padrão, a limpeza dos dados, a detecção de fixações e sacadas (utilizando algoritmos baseados em velocidade e em dispersão) com parâmetros claramente definidos, a inspeção visual para identificação de perda de sinal e controle de ruído, a correção de deriva vertical em textos com múltiplas linhas e a extração de medidas padrão de leitura (duração da fixação, métricas de sacada, omissão de palavras e taxas de regressão). Ao longo do protocolo, destaca-se especialmente a alinhamento entre as perguntas de pesquisa e as especificações do hardware, o gerenciamento da deriva por meio de verificações regulares e a descrição detalhada de todos os parâmetros e decisões críticas. A coleta bem-sucedida de dados geralmente resulta em uma precisão de validação estável dentro dos limites estabelecidos, baixas taxas de perda de dados e distribuições interpretáveis de duração das fixações e comportamento das sacadas, que reproduzem efeitos bem conhecidos relacionados ao comprimento, frequência e previsibilidade das palavras. O protocolo é compatível com rastreadores oculares de mesa, ambientes de software comuns e configurações com estabilização da cabeça ou sem ela, abordando questões práticas como condições de iluminação, reflexos em óculos e mudanças na postura do participante. Este estudo apresenta um protocolo claro e prático que consolida orientações metodológicas em um fluxo de trabalho unificado. Tem como objetivo apoiar a coleta confiável de dados de rastreamento ocular em pesquisas de leitura, promover a reprodutibilidade e meta-análises, melhorar a consistência entre laboratórios e grupos e, em última instância, fortalecer a credibilidade científica da pesquisa em leitura.
Introdução
O rastreamento ocular é um método central para o estudo da atenção e do processamento da linguagem durante a leitura, pois as fixações e os sacadas indicam a alocação momento a momento dos recursos visuais e cognitivos aos estímulos. Revisões clássicas e contemporâneas documentam relações robustas entre os movimentos oculares e construtos teóricos, como o campo perceptivo, o benefício de pré-visualização e modelos de controle dos movimentos oculares1,2. Para realizar estudos confiáveis que examinem essas relações, é essencial o rigor metodológico na escolha do equipamento, no delineamento experimental, na calibração e validação e no pré-processamento; caso contrário, a degradação da qualidade dos dados enviesa as estimativas e compromete a reprodutibilidade3.
Na última década, diversos artigos introdutórios e de boas práticas consolidaram o conhecimento metodológico da área. Uma série recente de fundamentos conecta a teoria às medidas, discute a operacionalização e a variabilidade algorítmica, e fornece orientações para a escolha de rastreadores oculares adequados a perguntas de pesquisa específicas4,5,6,7,8. Diretrizes complementares apresentam boas práticas para seleção de equipamentos, garantia de precisão e exatidão, definição de medidas e relato, com recomendações para reduzir ameaças à validade9. Recursos introdutórios para pesquisas em leitura também oferecem visões gerais acessíveis de planejamento experimental, medidas comuns e fluxos de análise10,11. Em linguística aplicada e leitura, revisões específicas da área resumem a seleção de medidas e rastreadores e destacam as restrições dependentes da tarefa12,13,14,15,16,17.
Este artigo traduz essas orientações em um protocolo passo a passo para a coleta de dados de rastreamento ocular com alta precisão em estudos de leitura. Diferentemente dos recursos existentes, que oferecem principalmente diretrizes teóricas amplas de boas práticas ou se concentram exclusivamente em técnicas analíticas específicas, este protocolo opera esses conceitos em um fluxo de trabalho completo e acionável. O objetivo é facilitar a prática diária em laboratório, fornecendo instruções concretas e sequenciais. Em termos de aplicabilidade, este protocolo é especificamente otimizado para experimentos de leitura em laboratório altamente controlados, utilizando rastreadores oculares de alta frequência e baseados em desktop (por exemplo, 500-2000 Hz) com configurações de estabilização da cabeça (suporte para queixo ou testa). É mais adequado para pesquisas que exigem restrições rigorosas de qualidade dos dados, alta precisão espacial e exatidão — como estudos que analisam fixações precisas ao nível da palavra ou métricas finas de sacadas.
O uso de configurações sem restrição da cabeça ou naturalistas também tem ganhado popularidade, inclusive na pesquisa de leitura, embora limitemos o escopo do artigo a estudos laboratoriais. Abordamos a seleção de hardware e software, montagem do laboratório, preparação de estímulos, gerenciamento de participantes, calibração e validação, controle de qualidade online e pré-processamento (incluindo detecção de eventos e correção de deriva). Ao seguir o protocolo, os pesquisadores podem documentar e alcançar qualidade de dados compatível com os padrões atuais, melhorando assim a transparência, credibilidade e reprodutibilidade dos achados relacionados à leitura.
Protocolo
A permissão ética para a coleta de dados do COST CA21131 foi concedida pelo Comitê de Ética em Pesquisa da Faculdade de Filosofia da Universidade Jaguelônica, Polônia, com o número de protocolo 221.0042.18_2024. O consentimento informado foi obtido de todos os participantes.
1. Preparando o ambiente do laboratório e configurando o equipamento
- Preparação do ambiente do laboratório
- Verifique as condições de iluminação e ruído ambiental. Janelas no ambiente do laboratório podem causar mudanças súbitas na dilatação da pupila e reflexos de luz na câmera do rastreador ocular e no monitor. Se possível, colete os dados em uma sala sem janelas ou use cortinas bloqueadoras para impedir a entrada da luz solar. Utilize iluminação artificial e elimine fontes de luz refletida. Verifique se não há reflexos no monitor; ajuste persianas ou ângulos até que desapareçam completamente. Certifique-se de que o ambiente esteja silencioso e evite interrupções (por exemplo, sinalização, fechamento de portas). Use sinais externos para evitar interrupções (por exemplo, coloque um aviso do lado de fora com a mensagem: “Experimento em andamento. Por favor, não bata na porta nem entre na sala.”)
- Verifique a ergonomia física. Utilize uma cadeira estável e sem giro; ajuste a altura da mesa (se possível) para manter a postura e evitar perda de calibração devido à rotação da cadeira.
- Evite presença social. A presença de um experimentador na mesma sala pode distrair o participante. Separe a sala de controle da sala do participante, ou mantenha o experimentador fora do campo de visão, para minimizar os efeitos da presença social.
- Verifique a ventilação do ar. Realize a ventilação antes e após as sessões experimentais. Verifique a temperatura ambiente, já que os participantes precisarão permanecer imóveis por algum tempo.
- Seleção do equipamento de rastreamento ocular
- Verifique a compatibilidade entre os objetivos da pesquisa e as medidas. Os objetivos de um estudo específico, e, portanto, as medidas-alvo (variáveis dependentes), devem estar alinhados com as capacidades do equipamento de rastreamento ocular. A disponibilidade institucional do equipamento pode impor limitações ao escopo do estudo pretendido. Verifique as três características principais do sistema de rastreamento ocular (taxa de amostragem, precisão e exatidão) e seu potencial para atender às necessidades da pesquisa. O ponto principal é garantir que a capacidade do equipamento de rastreamento ocular seja compatível com os objetivos do estudo.
NOTA: Taxa de amostragem = A taxa de amostragem é expressa em Hz e reflete o tamanho das amostras coletadas pelo rastreador ocular durante um período: um rastreador ocular de 60 Hz coleta amostras a cada 16 ms, enquanto um rastreador de 500 Hz coleta amostras a cada 1 ms. Isso afeta os diferentes tipos de medidas, pois rastreadores de baixa frequência podem classificar saccades iniciados durante um período de 16 ms como fixações, ou vice-versa. A amostragem às vezes é confundida com a exatidão dos dados, mas são propriedades distintas.
Precisão = A consistência com que o rastreador ocular consegue coletar dados ao longo do tempo.
Exatidão = O grau de erro entre o ponto de olhar detectado pelo rastreador ocular e o ponto de olhar real.
Por exemplo, em estudos sobre os locais de pouso das fixações em palavras, descritos em termos da posição do olhar nas letras de uma palavra, é necessária uma taxa de amostragem (≥500-2000 Hz), precisão e exatidão muito mais altas do que em um estudo que se concentre apenas na porcentagem de saccades regressivos (em comparação com saccades progressivos) durante a leitura. - Defina a metodologia de registro de movimentos oculares. Utilize um rastreador ocular de bancada com alta taxa de amostragem, precisão e exatidão. Utilize estabilização da cabeça com suporte de queixo ou testa. No caso de uso de rastreamento ocular sem fixação da cabeça (rastreamento remoto), utilize adesivos, se disponíveis, na testa do participante para melhorar o rastreamento facial; evite também adesivos refletivos, a menos que recomendado pelo fabricante do rastreador.
NOTA: O uso de equipamentos de rastreamento ocular portáteis tem sido raro em estudos de leitura devido à sua taxa de amostragem, precisão e exatidão relativamente baixas em comparação com rastreadores de bancada, bem como aos desafios na análise de dados de movimentos oculares. No entanto, configurações sem fixação da cabeça ou naturalísticas vêm ganhando popularidade na última década, acompanhadas de melhoria na qualidade dos dados e em pipelines automatizados de análise, ampliando assim o escopo dos estudos sobre movimentos oculares durante a leitura para ambientes naturalísticos e leitura em ambientes de realidade virtual (VR).
- Verifique a compatibilidade entre os objetivos da pesquisa e as medidas. Os objetivos de um estudo específico, e, portanto, as medidas-alvo (variáveis dependentes), devem estar alinhados com as capacidades do equipamento de rastreamento ocular. A disponibilidade institucional do equipamento pode impor limitações ao escopo do estudo pretendido. Verifique as três características principais do sistema de rastreamento ocular (taxa de amostragem, precisão e exatidão) e seu potencial para atender às necessidades da pesquisa. O ponto principal é garantir que a capacidade do equipamento de rastreamento ocular seja compatível com os objetivos do estudo.
- Configuração de hardware e software
- Configuração do hardware. Meça as distâncias entre o rosto do participante, o monitor e o rastreador ocular. Defina a distância de visualização conforme o fabricante (por exemplo, ~60–70 cm) e a geometria de configuração necessária, preferencialmente usando um monitor LCD plano de 21–27 polegadas (por exemplo, 24 polegadas a 60 cm, campo de visão de ~48° x 28°), de modo que todo o texto permaneça dentro do campo visual central e da faixa eficaz do rastreador. Verifique a inclinação e rotação do monitor, e o alinhamento entre o vetor de olhar e sua localização correspondente na tela. Defina o tamanho e a taxa de atualização do monitor para os valores desejados. Defina a resolução da tela para o valor especificado. Meça a luminância do monitor em um fundo branco à distância especificada. Registre o valor de luminância no relatório da sessão.
- Quando necessário, prefira monitores LCD com altas taxas de atualização (120 Hz ou superior, por exemplo, 144–240 Hz), especialmente para tarefas dependentes do olhar e para verificação de sincronização temporal. Desative tecnologias de atualização variável (G-Sync/FreeSync). Se o rastreador ocular for usado por diferentes pesquisadores para diferentes experimentos, é importante registrar todas as alterações feitas durante cada coleta de dados. Ao final de cada coleta, a configuração deve ser restaurada ao seu estado original no início da sessão, ou conforme definido pelo protocolo do laboratório.
- Configuração do software. A maioria dos fabricantes de rastreadores oculares fornece softwares relevantes, Kits de Desenvolvimento de Software (SDKs) e/ou bibliotecas para compatibilidade e integração com softwares de código aberto.
NOTA: Recentemente, configurações específicas permaneceram como desafios técnicos que exigem soluções personalizadas. Por exemplo, a sincronização temporal de um rastreador ocular com métodos complementares de medição, como EEG e fNIRS, exige soluções especiais de hardware e/ou software para garantir um nível adequado de sincronização entre o relógio do rastreador ocular e o relógio de apresentação do estímulo, e/ou desincronização com a atualização da tela. Assim, a maioria das ferramentas dos fabricantes oferece um ambiente para o planejamento de experimentos que atende às necessidades básicas dos pesquisadores, como apresentar estímulos e registrar movimentos oculares. Uma lista dos pacotes de software atualmente disponíveis é apresentada na Tabela de Materiais.
- Configuração do hardware. Meça as distâncias entre o rosto do participante, o monitor e o rastreador ocular. Defina a distância de visualização conforme o fabricante (por exemplo, ~60–70 cm) e a geometria de configuração necessária, preferencialmente usando um monitor LCD plano de 21–27 polegadas (por exemplo, 24 polegadas a 60 cm, campo de visão de ~48° x 28°), de modo que todo o texto permaneça dentro do campo visual central e da faixa eficaz do rastreador. Verifique a inclinação e rotação do monitor, e o alinhamento entre o vetor de olhar e sua localização correspondente na tela. Defina o tamanho e a taxa de atualização do monitor para os valores desejados. Defina a resolução da tela para o valor especificado. Meça a luminância do monitor em um fundo branco à distância especificada. Registre o valor de luminância no relatório da sessão.
2. Elaboração e realização piloto do experimento
- Preparação dos estímulos
- Prepare os materiais de leitura. Os materiais de leitura geralmente são apresentados na forma de frases ou parágrafos, dependendo dos objetivos do estudo. Considere extrair os materiais de leitura de fontes disponíveis em vez de criar manualmente o texto, desde que esse método esteja alinhado com o objetivo do estudo.
- Verifique as condições de licenciamento para reutilização do texto. Verifique as condições de licenciamento de todos os textos. Se os materiais de experimentos publicados forem de código aberto e, portanto, publicamente acessíveis a qualquer pessoa que deseje utilizá-los, então a permissão não é necessária. Caso contrário, obtenha as permissões exigidas antes do uso. É importante verificar se os estímulos podem ser usados no experimento e se podem ser compartilhados como materiais suplementares.
- Prepare os estímulos formatados. A formatação dos estímulos textuais exige o uso de propriedades adequadas de fonte (tipo, tamanho, espaçamento entre letras, palavras e linhas). Utilize uma fonte monoespaçada com tamanho e espaçamento apropriados, considerando as configurações usadas na literatura.
NOTA: Fontes monoespaçadas, como a Courier New, são recomendadas em experimentos de leitura que utilizam Áreas de Interesse (AOIs) baseadas em palavras, pois essas fontes fornecem o mesmo tamanho em pixels para diferentes caracteres e símbolos alfanuméricos do alfabeto latino. O pesquisador deve verificar a compatibilidade da fonte, da interface e das propriedades específicas dos estímulos, como a apresentação de estímulos em caracteres não latinos ou direções de leitura da direita para a esquerda, e se as ferramentas de software do experimento oferecem uma metodologia para realizar a especificação automática de IA (Área de Interesse) ou AOI (Área de Interesse).
- Planejamento do procedimento do experimento
- Preparação das instruções
NOTA: As instruções são importantes, pois têm um impacto significativo nos movimentos oculares durante a leitura. O uso de instruções de tarefa, mesmo na forma mínima, é crucial. A ausência de instruções explícitas pode causar consequências indesejadas que afetam o comportamento de fixação dos participantes. Por exemplo, um participante pode ter uma suposição implícita de leitura cuidadosa, enquanto outro pode realizar uma leitura rápida em vez de uma leitura natural para compreensão.- Apresente instruções padronizadas na tela e registre o tempo de início e a duração das instruções; evite estímulos verbais durante a gravação. Uma prática comum é pedir ao participante que leia para compreensão. Caso se espere que os participantes leiam como fazem em situações cotidianas, informe-os de que devem ler naturalmente; ou seja, não precisam evitar piscar ou reler. Informe também os participantes se houver alguma tarefa adicional, como questões de compreensão (que são importantes para garantir que os participantes estejam lendo para compreensão). As instruções podem variar não apenas conforme a tarefa, mas também conforme a fase do experimento (por exemplo, treinamento versus tarefa principal). Para ilustrar isso, um exemplo de instruções usadas durante uma fase de treinamento é fornecido abaixo18.
Agora iniciaremos uma sessão de treinamento. Para isso, você precisará das quatro teclas marcadas (A, B, C, D). Mais instruções serão mostradas a você em breve. Após o treinamento, seu desempenho será avaliado, o que levará um a dois minutos. Se o seu desempenho no treinamento não for suficiente, a última parte do treinamento será repetida. Se for suficiente, retornarei à sala. Quando estiver pronto, pressione simplesmente a barra de espaço. - Cabe ao pesquisador decidir se usará tais instruções nas sessões de treinamento de experimentos projetados para estudar a leitura. No entanto, utilize as instruções para a sessão do experimento. Um exemplo de instruções usadas na fase do experimento em uma condição de instrução de relevância geral (tanto com quanto sem uma pergunta no texto) pode ser semelhante ao abaixo19.
Você lerá um conjunto de textos expositivos curtos. Queremos que você leia o texto com atenção, compreendendo o máximo possível do conteúdo. Mais tarde, após a leitura, será solicitado que você forneça um resumo oral das ideias principais do texto, para verificar o quanto você entendeu o que leu.
Outro exemplo de instrução é dado abaixo para um experimento que utiliza tarefas de leitura de frases20.
Seja bem-vindo ao nosso estudo de leitura. Neste estudo, você será apresentado a aproximadamente cem frases. Elas foram selecionadas aleatoriamente de várias fontes e serão apresentadas em ordem aleatória. Leia-as silenciosamente, buscando compreender o significado, no seu próprio ritmo natural de leitura, de forma semelhante à leitura de frases em um livro. Após algumas das frases, você poderá responder a perguntas de compreensão. Por favor, responda às perguntas de compreensão. Se não souber a resposta, pule a pergunta. Haverá uma pausa no meio da sessão. Você poderá solicitar uma pausa ou encerrar a sessão a qualquer momento se se sentir desconfortável. Se tiver alguma dúvida, informe o experimentador. Caso contrário, pressione um botão para iniciar o procedimento.
- Apresente instruções padronizadas na tela e registre o tempo de início e a duração das instruções; evite estímulos verbais durante a gravação. Uma prática comum é pedir ao participante que leia para compreensão. Caso se espere que os participantes leiam como fazem em situações cotidianas, informe-os de que devem ler naturalmente; ou seja, não precisam evitar piscar ou reler. Informe também os participantes se houver alguma tarefa adicional, como questões de compreensão (que são importantes para garantir que os participantes estejam lendo para compreensão). As instruções podem variar não apenas conforme a tarefa, mas também conforme a fase do experimento (por exemplo, treinamento versus tarefa principal). Para ilustrar isso, um exemplo de instruções usadas durante uma fase de treinamento é fornecido abaixo18.
- Planeje as tentativas e blocos. Planeje o fluxo do experimento considerando a apresentação das tentativas em blocos e a aleatorização da ordem das tentativas dentro e entre os blocos. Utilize uma cruz de fixação antes de cada tentativa (500-800 ms) para garantir que as fixações iniciais dos participantes estejam no mesmo local da tela e distantes de qualquer parte do texto.
O planejamento de um experimento de rastreamento ocular, no qual o tamanho da pupila é uma variável dependente, exige ajustar o fluxo do experimento de forma apropriada, pois o tamanho da pupila não é uma resposta momentânea como uma sequência fixação-sacada. Especificamente, no caso do uso do tamanho da pupila como variável dependente, é necessário introduzir uma janela de linha de base prévia e intervalos de tela preta com durações adequadas para garantir a estabilização do tamanho da pupila antes da apresentação dos estímulos e da tentativa subsequente. O pesquisador deve consultar estudos recentes sobre orientações em pupilometria para assegurar que os dados de pupila registrados possam ser interpretados adequadamente como uma variável dependente21,22. - Planeje pausas entre blocos. Introduza telas de correção de deriva e pausas curtas opcionais entre os blocos do experimento para garantir a qualidade dos dados e reduzir a fadiga. Insira verificações de deriva após um número pré-definido de tentativas ou quando a precisão visivelmente degradar (verifique se há teclas de atalho para forçar a calibração/validação durante o experimento); revalide se a deriva for >1° do ângulo visual (média das coordenadas x e y).
- Identifique as variáveis independentes-alvo. Em estudos de leitura, propriedades específicas do texto, como frequência da palavra e a previsibilidade sentencial das palavras, compõem as principais variáveis independentes-alvo. Liste as variáveis independentes do experimento, dependendo dos objetivos do estudo. Nas análises estatísticas, as métricas de variáveis independentes podem exigir normalização de valores. Avalie a relevância de cada variável com base nas propriedades dos estímulos.
- Exclua as palavras no início da linha de texto da análise, pois as fixações nessas palavras geralmente não são precisas: podem refletir a primeira fixação tentativa no texto/frase ou a primeira fixação após uma quebra de linha (o chamado "return-sweep"), que, em qualquer caso, não são precisas e geralmente são seguidas por fixações corretivas. Exclua a última palavra de cada linha porque essas palavras estão sujeitas a menos congestionamento visual (de palavras subsequentes) e porque as fixações nas palavras finais de linha frequentemente refletem o término de uma tentativa ou o planejamento de um "return sweep" para a próxima linha do texto.
NOTA: A duração da primeira fixação pode ser menos significativa em idiomas com muitas palavras funcionais, como artigos antes de substantivos (a região de análise deve incluir o artigo e o substantivo, mas a primeira fixação será menos importante, pois pode refletir apenas o processamento do artigo).
- Exclua as palavras no início da linha de texto da análise, pois as fixações nessas palavras geralmente não são precisas: podem refletir a primeira fixação tentativa no texto/frase ou a primeira fixação após uma quebra de linha (o chamado "return-sweep"), que, em qualquer caso, não são precisas e geralmente são seguidas por fixações corretivas. Exclua a última palavra de cada linha porque essas palavras estão sujeitas a menos congestionamento visual (de palavras subsequentes) e porque as fixações nas palavras finais de linha frequentemente refletem o término de uma tentativa ou o planejamento de um "return sweep" para a próxima linha do texto.
- Identifique as variáveis dependentes-alvo. Em estudos de leitura, um conjunto de métricas de movimento ocular, como duração da primeira fixação, duração da fixação única, duração do olhar, porcentagem de regressão e probabilidade de pular palavras, compõem as principais variáveis dependentes-alvo em conexão com os objetivos do estudo. Especifique as métricas de movimento ocular a serem analisadas. Utilize essas métricas como base da análise estatística.
NOTA: Evite usar qualquer tarefa que exija que o participante digite no teclado, pois isso pode exigir que ele abandone o apoio de queixo, perdendo assim a calibração. Em vez disso, os participantes podem usar o mouse para selecionar suas respostas. Nos casos em que for necessária resposta oral do participante durante a gravação de movimentos oculares, use um apoio de testa em vez de um apoio de queixo e peça ao participante que responda verbalmente ou permita respostas de tecla única permanecendo no apoio de testa.
- Preparação das instruções
- Implementação do procedimento do experimento
- Selecione o software de apresentação de estímulos. Configure o experimento usando um software apropriado de apresentação de estímulos. Ferramentas fornecidas pelo fabricante e ferramentas gerais de design de experimentos podem ser usadas para apresentar texto e registrar movimentos oculares. Ao escolher o software, considere as integrações de hardware disponíveis (por exemplo, suporte nativo para o rastreador ocular), o grau de precisão temporal exigido e o nível preferido de uso de scripts versus design baseado em interface gráfica (GUI). Independentemente da plataforma, o software deve suportar sincronização confiável entre eventos de estímulo (por exemplo, início de palavra, início de frase) e o fluxo de dados de rastreamento ocular, para que fixações e sacadas possam ser alinhadas com os elementos textuais correspondentes durante a análise. Se usar software externo, verifique a compatibilidade entre o software do rastreador ocular e o software externo, especialmente para visualização e exportação de dados.
NOTA: Exemplos de software: o Experiment Builder (SR Research, para sistemas EyeLink) oferece uma interface gráfica com suporte integrado para verificações de deriva, rotinas de calibração e mensagens de eventos enviadas ao computador de gravação. Plataformas de código aberto como PsychoPy e OpenSesame oferecem funcionalidades semelhantes e são independentes de hardware, permitindo o design de tentativas por meio de interface gráfica ou scripts (por exemplo, Python no caso do PsychoPy), controle do tempo de apresentação dos estímulos e definição de regiões de interesse, também conhecidas como Áreas de Interesse (IAs ou AOIs), ao redor de palavras ou linhas de texto. Às vezes, a ligação entre visualização e exportação de dados não é direta para pesquisadores no início de suas carreiras, e, portanto, pode ser mais fácil usar o software do fabricante. Consequentemente, uma consideração importante na escolha de rastreadores oculares é o nível de suporte fornecido pelos diferentes fabricantes ou pela comunidade de desenvolvedores. - Realize um estudo piloto. Teste o procedimento do experimento implementado e verifique os dados registrados para garantir que o experimento funcione conforme o esperado. Realize estudos pilotos no ambiente do laboratório para assegurar que o experimento funcione conforme o esperado, monitorando critérios de sucesso pré-definidos. Verifique os dados registrados para confirmar que tudo necessário para o estudo está sendo registrado.
- Selecione o software de apresentação de estímulos. Configure o experimento usando um software apropriado de apresentação de estímulos. Ferramentas fornecidas pelo fabricante e ferramentas gerais de design de experimentos podem ser usadas para apresentar texto e registrar movimentos oculares. Ao escolher o software, considere as integrações de hardware disponíveis (por exemplo, suporte nativo para o rastreador ocular), o grau de precisão temporal exigido e o nível preferido de uso de scripts versus design baseado em interface gráfica (GUI). Independentemente da plataforma, o software deve suportar sincronização confiável entre eventos de estímulo (por exemplo, início de palavra, início de frase) e o fluxo de dados de rastreamento ocular, para que fixações e sacadas possam ser alinhadas com os elementos textuais correspondentes durante a análise. Se usar software externo, verifique a compatibilidade entre o software do rastreador ocular e o software externo, especialmente para visualização e exportação de dados.
3. Recrutamento e informação aos participantes
- Seleção dos participantes
- Determine os requisitos relacionados ao estado da visão. Recrute participantes com visão normal ou corrigida para normal. É possível acomodar óculos e lentes de contato, que apresentem mínimas reflexões (antirreflexo, ângulo do monitor), conforme orientação do fabricante. Documente o tipo de correção (óculos, lentes de contato) para verificações de covariáveis.
NOTA: Geralmente, as lentes de contato rígidas (atualmente pouco comuns) são muito difíceis de rastrear. Embora as lentes de contato não sejam um problema, às vezes pode formar-se uma bolha de ar entre a lente e a córnea, causando reflexões que interferem no rastreamento. Óculos com armações brilhantes também podem interferir no rastreamento. Para armações de vidro brilhantes, reduza a detecção do campo de visão no software do rastreador ocular. - Triagem dos participantes com base em características individuais específicas, como idade, proficiência em leitura, origem linguística, lateralidade e critérios comuns de inclusão e exclusão, como dislexia, bilinguismo ou transtornos de leitura, que podem influenciar os dados de movimento ocular. Portanto, dependendo dos objetivos da pesquisa, especifique as condições sob as quais um leitor é um participante adequado para o experimento, definindo assim os critérios de inclusão e exclusão (ver Discussão).
- Avalie condições de deficiência visual. Certifique-se de que o participante não tenha deficiência visual não corrigível, como catarata (mesmo após cirurgia), glaucoma ou degeneração macular.
- Avalie condições neurológicas. Certifique-se de que o participante não tenha qualquer condição que o deixe desconfortável com gravações de movimento ocular. A maioria dos rastreadores oculares utiliza LEDs/lasers de infravermelho próximo ou iluminação NIR certificada (LED/VCSEL), considerados seguros para os olhos. Confirme a certificação de segurança ocular do dispositivo (por exemplo, Classe 1 IEC 60825-1, IEC/EN 62471 ou similar). Informe o participante sobre as normas de segurança do equipamento (como a disponibilidade de um certificado CE emitido pelo fabricante, comumente conhecido como Declaração UE de Conformidade, documento emitido pelo fabricante para certificar que um produto está em conformidade com todas as regulamentações europeias necessárias de saúde, segurança e meio ambiente).
- Determine os requisitos relacionados ao estado da visão. Recrute participantes com visão normal ou corrigida para normal. É possível acomodar óculos e lentes de contato, que apresentem mínimas reflexões (antirreflexo, ângulo do monitor), conforme orientação do fabricante. Documente o tipo de correção (óculos, lentes de contato) para verificações de covariáveis.
- Estabelecimento de higiene
- Adote precauções relacionadas à distância pessoal. Se necessário, use luvas descartáveis e máscara, pois os protocolos do experimento podem exigir redução da distância pessoal.
- Desinfecção do equipamento. Desinfete o suporte de queixo e outros acessórios usando lenços umedecidos com álcool, conforme orientação institucional vigente. Tenha cuidado para não usar produtos químicos que possam danificar o equipamento. Consulte as especificações do fabricante. Os participantes podem se sentir mais confortáveis se a limpeza for realizada na presença deles, especialmente no suporte de queixo e na cabeça, no mouse ou em qualquer outra parte do equipamento com a qual entrarão em contato.
- Informação ao participante
- Informar o participante sobre o ambiente do laboratório. Elabore uma sessão verbal em que o pesquisador apresente ao participante o ambiente do laboratório e o equipamento de rastreamento ocular.
- Informar o participante sobre o experimento. Apresente uma explicação clara sobre o contexto do experimento (objetivo e duração aproximada do estudo; isso deve ser verificado durante os testes pilotos), o procedimento de incentivo ou pagamento, a contribuição do participante para o experimento e seus direitos de acompanhar os resultados do estudo a longo prazo. Informe o participante sobre o que deve e o que não deve fazer durante uma sessão de gravação. Peça ao participante para tentar não mover muito a cabeça durante a gravação (no caso de ausência de estabilizador de cabeça) ou para não sair do suporte de queixo, explicando que essas precauções são necessárias para garantir uma gravação de alta qualidade dos dados (caso contrário, os participantes podem sempre interromper o experimento e encerrar a sessão sem fornecer motivo).
- Obtenção do consentimento informado. Forneça aos participantes os documentos de aprovação ética e de consentimento e explique-os antes do início da sessão. Para adultos, obtenha o consentimento escrito informado após garantir que compreendam o objetivo do estudo, o que ocorrerá e seus direitos, incluindo a opção de participar voluntariamente, a privacidade dos dados e o direito de se retirar. Para menores participantes, obtenha o consentimento escrito de um pai ou responsável e o assentimento do menor. Prossiga com a calibração e gravação somente após a conclusão de todos os formulários de consentimento e assentimento necessários. Os procedimentos de consentimento informado variam consideravelmente entre participantes adultos e menores. Portanto, o pesquisador deve seguir as orientações institucionais locais.
NOTA: Se ocorrer uma pausa ou intervalo durante o experimento, é necessária a revalidação da calibração; se a revalidação falhar, será necessária uma nova calibração.
4. Realizando Calibração e Validação
- Posicionamento do participante e ajuste do equipamento
- Posicione o participante. Peça ao participante que se sente confortavelmente. Ajuste a cadeira/mesa e/ou o suporte de queixo para manter uma posição estável da cabeça. Informe o participante de que essa é a posição esperada da cabeça durante as fases de calibração, validação e gravação.
- Ajuste o equipamento. Ajuste o equipamento de rastreamento ocular alinhando a câmera do rastreador de olhos de modo que as pupilas do participante sejam claramente visíveis e detectáveis. Alguns sistemas de rastreamento ocular realizam esse alinhamento automaticamente, enquanto outros podem exigir ajuste manual do foco da câmera.
NOTA: O pesquisador deve praticar o ajuste do equipamento e a calibração antes de iniciar a coleta real de dados para evitar sobrecarregar o participante com essas etapas.
- Execução da calibração
- Informe o participante. Informe o participante sobre o procedimento de calibração (por exemplo, diga que uma série de marcadores-alvo será exibida e que o participante deverá segui-los por aproximadamente um minuto).
NOTA: Recomenda-se cautela com a linguagem utilizada durante os ajustes. Por exemplo, o pesquisador deve enfatizar que o procedimento serve para calibrar o rastreador ocular para o participante, e não para calibrar o participante para o rastreador ocular. Além disso, é importante garantir que nenhum vídeo/imagem seja gravado com o equipamento de rastreamento ocular. Embora o olho do participante seja visível, apenas a posição do olho, convertida em coordenadas, será registrada. - Execute o procedimento de calibração. Instrua o participante a acompanhar os marcadores-alvo e a manter a posição da cabeça constante; por exemplo, a não se inclinar para trás após o término do procedimento de calibração. Instrua os participantes a fixarem o olhar no centro do símbolo de calibração e a não moverem os olhos até que o símbolo se desloque. Os participantes tendem a antecipar o movimento do símbolo, especialmente durante a validação, o que pode aumentar os erros e levar a etapas desnecessárias de calibração. Inclua essa explicação nas instruções ou na explicação do processo de calibração/validação.
NOTA: Os fabricantes oferecem diferentes tipos de símbolos para o procedimento de calibração (pontos, símbolos infantis, símbolos estáticos ou que diminuem de tamanho, etc.) e diferentes configurações de calibração (ou seja, o número de pontos de calibração). É importante verificar as diferenças de calibração com essas diferentes configurações e escolher aquela que melhor atenda às necessidades de um estudo específico. Por exemplo, se os estímulos utilizam toda a tela (por exemplo, um texto com vários parágrafos), é importante ter uma configuração de calibração que garanta boa calibração de cima a baixo, incluindo os cantos. No entanto, se os estímulos forem frases apresentadas no centro da tela, uma configuração com menos pontos pode ser suficiente. Além disso, a precisão da calibração na coordenada horizontal, ou coordenada x, é mais importante para o último caso do que para o primeiro, que exige boa precisão tanto nas coordenadas verticais quanto horizontais. - Finalize o procedimento de calibração. Informe o participante sobre o procedimento de validação após a conclusão do procedimento de calibração.
NOTA: Em caso de falha persistente na calibração, verifique o alinhamento da câmera do rastreador ocular, as condições de iluminação e o posicionamento do participante. Em participantes adultos, maquiagem refletiva, óculos ou lentes de contato podem interferir no rastreamento. Tranquilize o participante, permita pausas curtas ou repita a calibração conforme necessário. Se os problemas persistirem, considere reiniciar o sistema de rastreamento ocular. Se os problemas continuarem após a reinicialização do sistema e nenhuma causa for identificada para a falha de calibração após verificar os parâmetros de configuração, informe o participante de que a tecnologia de rastreamento ocular ainda não foi suficientemente desenvolvida e que se trata de um problema relacionado ao estado atual da tecnologia, e não ao participante.
- Informe o participante. Informe o participante sobre o procedimento de calibração (por exemplo, diga que uma série de marcadores-alvo será exibida e que o participante deverá segui-los por aproximadamente um minuto).
- Realização da validação
- Execute o procedimento de validação. Execute o procedimento de validação imediatamente após a calibração.
- Verifique os erros. Verifique o erro médio da posição do olhar e certifique-se de que esteja dentro dos limites aceitáveis. Normalmente, deseja-se um ângulo visual inferior a 1 grau (<1°), o que corresponde a aproximadamente 4 caracteres (ou seja, 0,5 corresponde a cerca de 2 caracteres). Realize nova calibração se os erros estiverem fora desses limites. Por exemplo, aceite a calibração se o erro médio for ≤0,5–1,0° e o erro máximo/por ponto for ≤1,5–2,0°; caso contrário, recalcibre. Especifique a frequência de revalidação (por exemplo, após cada bloco ou interrupção). Como exemplo de critérios do fabricante para avaliar a qualidade de uma calibração, segundo a SR Research, os erros são considerados aceitáveis para a maioria das tarefas quando o erro médio é <1° e o erro máximo é <1,5°; razoáveis quando o erro médio é <1°-1,5° e o erro máximo é <1,5°-2°; e ruins quando superiores a esses valores.
- Informe o participante. Instrua o participante a manter sua posição o mais semelhante possível e informe-o sobre o início da sessão de gravação.
5. Coleta de dados
- Execução do procedimento de coleta de dados
- Iniciar sessão de gravação. Inicie a sessão de gravação e evite interromper o participante enquanto ele estiver realizando a tarefa, como fornecer instruções verbais.
- Monitorar o participante. Acompanhe o conforto do participante durante a gravação dos dados. Certifique-se de que o participante mantenha uma postura estável, sem esforço ou fadiga. Fique atento a sinais de distração, ressecamento ocular ou desconforto causado pelo apoio de queixo/ou testa.
- Monitorar gravação dos dados. Acompanhe a qualidade dos dados durante a gravação. Reexecute a calibração se o erro médio de validação ou a precisão em tempo real exceder 1° (ou um limiar de precisão previamente definido), ou se o participante mudar de postura.
- Manter um registro. Mantenha um registro da sessão de gravação anotando quaisquer anomalias observadas durante o experimento (por exemplo, um procedimento de calibração anormalmente longo ou uma interrupção não intencional durante a gravação), para inspeção posterior ao experimento, utilizando um esquema de registro de sessão para acompanhar o horário dos eventos, interrupções, número de recalibrações realizadas e seus erros, verificações de desvio e mudanças na iluminação.
- Fim da sessão
- Salvar dados. Salve os dados brutos de fixação ocular ao final da sessão do experimento, preferencialmente utilizando um método sistemático para rotular a sessão (por exemplo, a data do experimento e o número do participante, como 25071801 ou 250718-P01 para o participante 01 em 18 de julho de 2025; evite usar informações pessoais identificáveis do participante).
- Despedida. Agradeça ao participante e esclareça quaisquer dúvidas que ele possa ter sobre o experimento; sanitize o equipamento (veja o passo 3.2.2).
- Verificar dados. Verifique os dados e os registros para garantir que a sessão foi concluída corretamente.
6. Pré-processamento dos dados e verificação da qualidade
- Exportação, organização e limpeza dos dados brutos
- Exportar dados. Exporte os dados brutos de olhar em um formato padrão (por exemplo, .csv, .tsv, .edf) e padronize seu ID de sessão (por exemplo, 25071801 ou 250718-P01, veja 5.2.1).
- Limpar dados. Limpe os dados brutos aplicando algoritmos para detecção de piscadas e detecção de dados ausentes, utilizando ferramentas integradas fornecidas pelo software do fabricante ou scripts personalizados, ajustados ao dispositivo ou taxa de amostragem.
NOTA: Crie cópias de segurança dos dados brutos ao executar as rotinas de limpeza.
- Detecção de eventos de movimento ocular
- Selecionar algoritmo de detecção de movimento ocular. Selecione e execute os procedimentos para detecção de fixações, ajustando os parâmetros dos algoritmos conforme necessário. Os algoritmos representativos para identificação de fixações envolvem principalmente algoritmos baseados em velocidade (por exemplo, Identificação por Limiar de Velocidade I-VT) e algoritmos baseados em dispersão (por exemplo, Identificação por Limiar de Dispersão I-DT), entre outros23. Cada algoritmo possui seus próprios parâmetros.
NOTA: O software do fabricante geralmente assume por padrão um algoritmo específico e um conjunto específico de parâmetros comumente utilizados. É responsabilidade do pesquisador selecionar um algoritmo apropriado e seus parâmetros e relatá-los na descrição da metodologia do estudo, como limiares de dispersão/velocidade, um limiar mínimo de duração de fixação (por exemplo, 60 ms ou 100 ms) para eliminar fixações mais curtas que esse valor, um limiar máximo de duração de fixação (por exemplo, 1000 ms) para eliminar fixações mais longas que esse valor, a janela de suavização utilizada e as regras de mesclagem para fixações adjacentes23. - Identificar fixações ilegítimas. Remova ou rotule as fixações fora da região de exibição. Remova ou rotule fixações mais curtas que um limiar mínimo pré-definido e mais longas que um limiar máximo pré-definido.
- Inspecionar visualmente os dados. Inspecione visualmente os dados utilizando ferramentas de visualização disponíveis para garantir a validade dos dados. Verifique perda de sinal, ruído excessivo, amostras ausentes ou fixações desalinhadas. Após cada sessão de gravação, inspecione visualmente os dados utilizando as ferramentas de visualização fornecidas com o software de rastreamento ocular (por exemplo, gráficos de olhar, scanpaths, traçados em série temporal). Esta etapa ajuda a garantir que os dados tenham qualidade suficiente antes de prosseguir para o pré-processamento e análise.
- Em particular, verifique perda de sinal e problemas de rastreamento observando longas lacunas nos padrões de olhar ou regiões nos estímulos onde nenhuma amostra de olhar é registrada. Perda frequente ou prolongada de rastreamento pode indicar que a sessão deve ser excluída ou repetida.
- Para verificar ruído excessivo, examine os traçados brutos de posição x/y em busca de saltos súbitos ou amostras errôneas que não correspondam ao layout do estímulo. Ruído excessivo pode indicar má calibração, posição instável da cabeça ou problemas de hardware.
- Para identificar amostras ausentes ou irregulares, verifique se a taxa de amostragem é aproximadamente a esperada (por exemplo, 500 Hz) e se há agrupamentos inesperados de amostras ausentes além das piscadas normais.
- Para identificar fixações desalinhadas, sobreponha as fixações aos estímulos apresentados e verifique se elas caem sobre as linhas e palavras pretendidas. Desvios sistemáticos (por exemplo, fixações consistentemente fora do texto) podem indicar deriva na calibração ou um mapeamento incorreto entre coordenadas de olhar e coordenadas da tela. Os padrões registrados de olhar devem seguir aproximadamente a estrutura do texto (por exemplo, progressões da esquerda para a direita, linha por linha), com fixações agrupadas sobre palavras e sacadas relativamente suaves entre elas. Um desvio sistemático desse padrão, ou perda frequente de dados utilizáveis, pode exigir a exclusão dos dados afetados da análise subsequente.
- Realizar correção de deriva. Realize correção de erro de deriva vertical quando necessário. Aplique correção de deriva vertical por linha para textos com múltiplas linhas. Verifique a aplicabilidade de métodos validados21.
NOTA: Figura 1 apresenta uma representação das etapas envolvidas no projeto de uma configuração de experimento de rastreamento ocular e no fluxo de análise de dados, conforme descrito na seção do protocolo. A seção seguinte apresenta resultados representativos de sessões gravadas.
- Selecionar algoritmo de detecção de movimento ocular. Selecione e execute os procedimentos para detecção de fixações, ajustando os parâmetros dos algoritmos conforme necessário. Os algoritmos representativos para identificação de fixações envolvem principalmente algoritmos baseados em velocidade (por exemplo, Identificação por Limiar de Velocidade I-VT) e algoritmos baseados em dispersão (por exemplo, Identificação por Limiar de Dispersão I-DT), entre outros23. Cada algoritmo possui seus próprios parâmetros.
Resultados
Qualidade e validação dos dados
Sessões bem-sucedidas normalmente apresentam acurácia de validação com erro médio ≤0,5–1,0° e erro máximo/por ponto <1,0–1,5° entre os alvos; informe tanto os valores médios quanto os valores por ponto. Forneça um histograma do erro por ponto e uma tabela resumindo a média ± DP e o erro máximo por sessão. Esses critérios estão de acordo com a prática comum e recomendações do fabricante; sessões que excedam esses limites devem ser parcial ou totalmente excluídas, dependendo das regras do estudo. Figura 2 demonstra um exemplo de histograma de erro por ponto para a acurácia de calibração em uma calibração de 9 pontos, envolvendo três tentativas de calibração.
Precisão e perda de dados
Relate a precisão (por exemplo, dispersão média quadrática – RMS – entre amostras durante a fixação) e a perda de dados (% de amostras ausentes por ensaio/sessão). Ensaios adequados geralmente apresentam baixa dispersão durante a fixação e baixa perda de dados (por exemplo, <5–10%, dependendo do equipamento e configuração de rastreamento ocular). Forneça distribuições percentuais de perda de dados e um gráfico de dispersão por ensaio de precisão versus perda para identificar valores atípicos. Consulte a literatura atual sobre definições e itens mínimos de relato3,4,5,6,7,8,9,10,11.
Comportamento da deriva (antes/depois da correção)
Ensaios bem-sucedidos exibem pequenos desvios verticais quase constantes, que são substancialmente reduzidos pela correção linha a linha, seja por algoritmos automatizados de correção de deriva21 ou manualmente. Por outro lado, ensaios problemáticos apresentam deriva residual não monotônica ou acentuada. Inclua o erro vertical absoluto mediano antes e depois da correção. Verifique a aplicabilidade dos métodos automatizados de correção de deriva.
Distribuições de medidas comuns de leitura
Forneça distribuições resumidas para a duração da primeira fixação (FFD), duração da fixação única (SFD), duração da primeira passagem (FP) e duração total/ocular (GD), tempo de avanço, probabilidade de pulo e probabilidade de regressão. Na leitura de texto alfabético por adultos proficientes, as durações de fixação geralmente se concentram em torno de ~200–250 ms (com assimetria substancial), e os sacadas abrangem em média ~7–9 caracteres. Valores muito fora dessas faixas ou distribuições de sacadas altamente bimodais devem ser verificados para determinar se indicam sacadas progressivas e regressivas esperadas devido a restrições da tarefa ou dificuldades de processamento, e não erros de temporização. A escolha e a faixa de medidas podem variar conforme a população, idioma específico e ortografia. Figura 3 mostra um protocolo de distribuição de duração de fixação amostral de uma sessão representativa.
Verificações de consistência
Um aumento no comprimento das palavras (palavras longas) geralmente leva à redução da taxa de pulos e a durações de fixação visual mais longas nessas palavras. Por outro lado, palavras funcionais (por exemplo, artigos ou preposições) geralmente são puladas. Palavras de alta frequência e palavras altamente previsíveis com base no contexto linguístico (dentro do texto ou da frase) tipicamente resultam em durações mais curtas da primeira fixação e da fixação contínua, bem como em taxas mais altas de pulos (o oposto é esperado para palavras de baixa frequência e baixa previsibilidade). Verifique se os dados replicam alguns desses padrões, pelo menos em um sentido. Grandes inversões podem indicar erros de deriva, desalinhamento entre palavras e fixações ou erros no processamento dos dados.
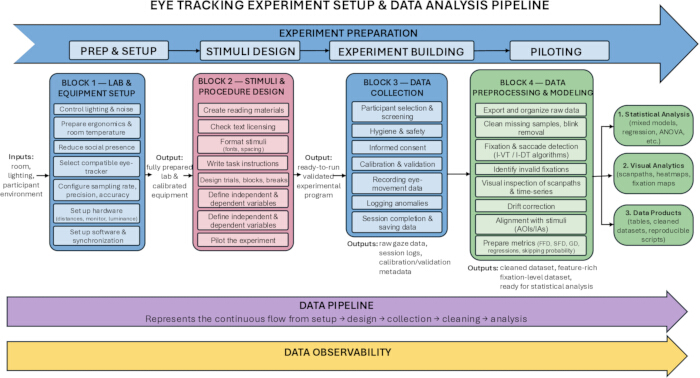
Figura 1. Uma representação das etapas envolvidas na concepção de uma configuração de experimento de rastreamento ocular e no fluxo de análise de dados. Clique aqui para visualizar uma versão maior desta figura.
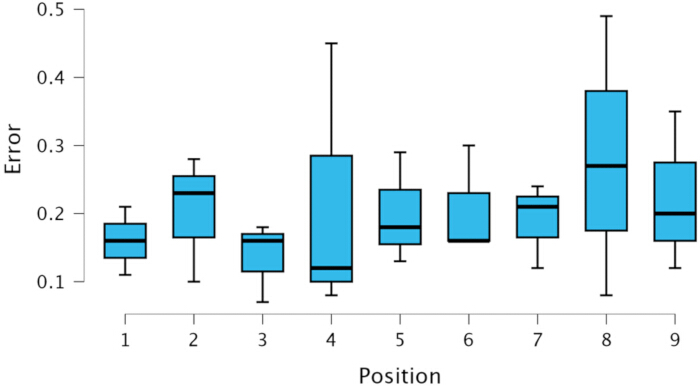
Figura 2. Histograma de erro por ponto para a precisão de calibração em uma calibração de nove pontos, envolvendo três tentativas de calibração. Clique aqui para visualizar uma versão maior desta figura.
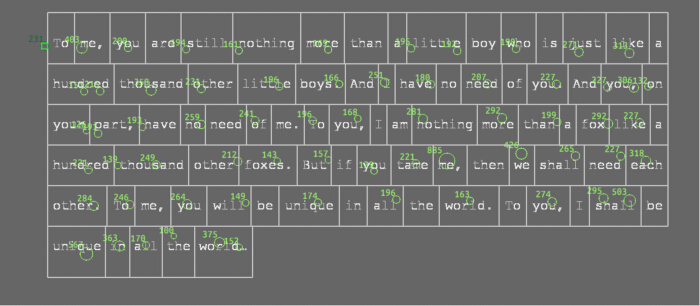
Figura 3. Protocolo de distribuição da duração da fixação de uma sessão representativa; um participante lendo um trecho do romance O Pequeno Príncipe. A posição e o tamanho dos círculos indicam, respectivamente, as localizações e as durações das fixações. Os números ao lado dos círculos indicam as durações das fixações em ms. Clique aqui para visualizar uma versão maior desta figura.
Discussão
O protocolo apresentado aqui resume as principais etapas necessárias para obter dados confiáveis de rastreamento ocular em pesquisas de leitura. Embora muitas dessas etapas possam ser bem conhecidas por pesquisadores experientes, elas geralmente estão dispersas em artigos metodológicos separados, documentação de fornecedores e práticas informais de laboratório. Ao organizá-las em um único fluxo de trabalho, desde a preparação do laboratório até o pré-processamento, nosso objetivo é oferecer um guia prático para pesquisadores que estão iniciando em estudos de rastreamento ocular aplicados à leitura. Em comparação com diretrizes gerais de rastreamento ocular ou recursos voltados principalmente aos algoritmos de detecção de movimentos oculares, este protocolo fornece uma estrutura completa, como resposta às exigências da pesquisa em leitura, que demanda gravação de dados com alta resolução espacial e alta frequência de amostragem.
Um tema central em todas as etapas do fluxo de trabalho é a importância da gestão proativa da qualidade dos dados, começando pelo controle ambiental e configuração dos equipamentos. Pequenos problemas, como reflexos na tela, instabilidade da cadeira ou distâncias de visualização inconsistentes, podem gerar vieses sistemáticos na localização ou precisão da fixação. Abordar esses fatores precocemente minimiza a necessidade de correções pós-hoc intensivas e favorece uma acurácia de validação mais consistente (erro médio ≤ 0,5–1°).
O protocolo também enfatiza a importância da alinhamento entre as questões de pesquisa e as características do equipamento. Muitos estudos sobre leitura dependem de medidas precisas no espaço e no tempo de fixações, posições de pouso dos sacades e regressões1,2. Portanto, escolher um rastreador ocular com taxa de amostragem, precisão e exatidão adequadas é essencial, especialmente para medidas como posição de pouso ou pré-visualização paracentral, que são sensíveis a pequenos erros espaciais. Dependendo das restrições específicas do estudo, esses métodos podem ser modificados. Por exemplo, ao trabalhar com populações neurodivergentes que não toleram suporte para o queixo, os pesquisadores podem optar por rastreadores remotos e sem suporte para a cabeça, compensando a perda de precisão espacial com o uso de fontes maiores, espaçamento maior entre linhas e Áreas de Interesse mais amplas. Quando são utilizados sistemas sem suporte para a cabeça, os pesquisadores devem considerar o aumento de movimentação e a possibilidade de perda de dados. Embora os rastreadores remotos permitam configurações mais naturalistas, a estabilização da cabeça ainda é preferível na maioria das tarefas de leitura atualmente.
O planejamento do experimento é outro fator fundamental que afeta tanto a qualidade quanto a interpretabilidade dos dados. Instruções padronizadas na tela, randomização de ensaios e uma estrutura de blocos apropriada ajudam a manter um comportamento estável dos participantes ao longo da sessão. Incluir verificações de deriva em intervalos regulares é especialmente importante em experimentos de leitura, pois pequenos desvios graduais podem se acumular ao longo das linhas de texto. O protocolo também permite o uso de normas lexicais dependentes do idioma e a divulgação transparente das variáveis independentes e dependentes, o que facilita a replicação e a comparação entre estudos.
Durante a coleta de dados, o monitoramento contínuo da precisão, postura e conforto do participante ajuda a prevenir perdas extensivas de dados. A solução ativa de problemas é frequentemente necessária para lidar com dificuldades comuns. Por exemplo, a calibração pode falhar nos cantos da tela; nesse caso, ajustar a altura do monitor ou da cadeira pode resolver a perda de rastreamento periférico. Problemas causados por óculos reflexivos ou lentes de contato às vezes podem ser resolvidos ajustando a iluminação ambiente ou alterando os ângulos do monitor. Manter um registro detalhado da sessão auxilia na solução de problemas posterior e reforça a transparência ao documentar interrupções, recalcibrações e eventos inesperados. Isso é cada vez mais importante porque muitos estudos publicados agora exigem relatos explícitos de métricas de qualidade, incluindo precisão e porcentagem de perda de dados.
A seção de pré-processamento enfatiza escolhas consistentes e bem documentadas na detecção de eventos, correção de deriva e rotinas de limpeza. Como os algoritmos e limiares de classificação de fixações podem influenciar fortemente as medidas resultantes, os pesquisadores devem especificar todos os parâmetros utilizados e justificá-los quando diferirem dos valores padrão comuns. A inspeção visual continua sendo uma etapa crítica, mesmo quando ferramentas automatizadas são aplicadas. O protocolo também incentiva a apresentação de indicadores padrão de qualidade, como precisão de validação, exatidão, perda de dados e comportamento de deriva, para que os estudos possam ser comparados de forma mais confiável.
Além disso, o protocolo recomenda verificações simples do comportamento de leitura, como os efeitos do comprimento, frequência ou previsibilidade da palavra. A reprodução desses padrões canônicos fornece uma proteção adicional contra problemas de alinhamento não detectados, deriva problemática ou erros de pré-processamento. Essas verificações não substituem uma análise estatística completa, mas oferecem um feedback rápido sobre se os dados estão se comportando como esperado para uma leitura habilidosa.
Além dos detalhes do protocolo experimental já mencionados, é importante descrever as características linguísticas e psicométricas dos participantes. A principal justificativa para isso é o desafio que pesquisadores experimentais enfrentam quanto à comparabilidade entre diferentes estudos. Isso é particularmente relevante na era da ciência aberta, em que conjuntos de dados disponibilizados publicamente podem ser utilizados por pesquisadores que não os coletaram originalmente e, portanto, podem não estar cientes de possíveis particularidades decorrentes de variações nos contextos (socio)linguísticos dos participantes.
Quanto ao histórico linguístico, deve-se observar a língua materna dos participantes e coletar informações sobre os dialetos que utilizam, a fim de considerar eventuais diferenças dialetais que possam impactar os resultados. Se os participantes falarem mais de um idioma – uma situação comum no mundo atual –, o nível de proficiência no segundo idioma deve ser registrado. Em estudos sobre bilingualismo ou processamento de segunda língua, a proficiência no segundo idioma deve ser avaliada por meio de testes validados de nivelamento em segunda língua. Além disso, aspectos relevantes do status socioeconômico podem ser registrados (por exemplo, hábitos de leitura dos participantes).
Devem ser realizados testes para avaliar as características psicométricas dos participantes, como amplitude da memória de trabalho e flexibilidade cognitiva (especialmente em estudos bilíngues). Do ponto de vista metodológico, deve-se considerar quais testes selecionar, suas exigências cognitivas e temporais, e quando aplicar essas medidas dentro do protocolo experimental – antes, após a sessão de rastreamento ocular ou em uma sessão separada.
É essencial lembrar que, em estudos de leitura, o comportamento linguístico é medido e explicado utilizando tanto as características linguísticas do estímulo quanto as características psicométricas dos leitores (ou quaisquer outras características relevantes para o comportamento linguístico dos participantes)11,12,17,20. Para permitir a comparação entre estudos, todos os fatores que possam ser relevantes para a interpretação dos dados devem ser incluídos. A escolha das características a serem incluídas dependerá do objetivo do estudo. Os dados devem ser comparáveis. Em resumo, os dados devem ser coletados e descritos com detalhes suficientes para permitir a qualquer usuário potencial a maior flexibilidade possível em seu uso. Essas considerações podem não fazer parte do protocolo em si, mas são relevantes para cada estudo individual. No ambiente científico global atual, esses detalhes aumentam o potencial futuro de uso dos dados coletados.
Este protocolo apresenta limitações, notavelmente a compensação entre qualidade dos dados e validade ecológica, já que a leitura em um monitor estático com a cabeça restringida não captura completamente o comportamento de leitura naturalista, e critérios visuais estritos de inclusão podem limitar a representatividade da amostra. Além disso, os rastreadores oculares diferem substancialmente na escala de coordenadas, precisão dos carimbos de tempo e classificação de eventos. Uma limitação do protocolo atual é que ele não esclarece como essa variabilidade afeta a reprodutibilidade entre laboratórios ou marcas de equipamentos. Criar diretrizes para validação entre dispositivos e para aplicações futuras realistas, como adaptar paradigmas de laboratório para ambientes de leitura em Realidade Virtual ou Realidade Aumentada imersivas, e desenvolver biomarcadores digitais para transtornos cognitivos ou de atenção, preencheria uma lacuna importante.
No geral, o protocolo consolida as orientações metodológicas existentes em um fluxo de trabalho claro e transparente para coletar dados de rastreamento ocular de alta qualidade na leitura. Ao seguir os passos e relatar as métricas de qualidade associadas, os pesquisadores podem melhorar a reprodutibilidade e a credibilidade dos estudos de leitura e ajudar a estabelecer uma consistência metodológica mais robusta em todo o campo.
Agradecimentos
Financiamento: Este projeto foi apoiado pelo COST – Cooperação Europeia em Ciência e Tecnologia (CA21131 – Habilitação da coleta de dados de rastreamento ocular multilíngue para pesquisa em processamento de linguagem humana e de máquinas (MultiplEYE), https://www.cost.eu/actions/CA21131)24, pela Fundação para a Ciência e a Tecnologia, Portugal (bolsas: UID/214/2025, UI/BD/154500/2022) e pelo programa estratégico da Universidade Jaguelônica, Iniciativa de Excelência, Área Prioritária de Pesquisa DigiWorld (ID.UJ), projeto “Aspectos Cognitivos da Interação e Comunicação em Agentes Naturais e Artificiais”. Agradecemos a Anna Maria Wilkosz pelo apoio técnico prestado.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Lenços de álcool (70% isopropílico) | Material de limpeza | Fornecimento local do laboratório | |
| Apoiador de queixo com altura ajustável | Dispositivo de estabilização da cabeça | Vários fornecedores de laboratório | |
| Formulário de consentimento e materiais de encerramento | Documentação | Modelos aprovados pela instituição | |
| Rastreador ocular (por exemplo, SR Research EyeLink 1000 Plus, Tobii Pro Fusion) | Hardware de rastreamento ocular | SR Research Ltd., Tobii AB | |
| Software de análise de dados de rastreamento ocular (Data Viewer, Tobii Pro Lab) | Software de análise de dados de movimento ocular | SR Research Ltd., Tobii AB | |
| Software de rastreamento ocular (por exemplo, Experiment Builder, Tobii Pro Lab, PsychoPy) e seus SDKs | Software de apresentação de estímulos e kits de desenvolvimento de software | SR Research Ltd., Tobii AB, Código aberto | |
| Software genérico para análise de dados (R com lme4, ggplot2, JASP, Python com Pandas, NumPy, Matplotlib) | Pré-processamento e análise de dados | Código aberto, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| Software genérico para o planejamento de experimentos (PsychoPy) | Software de apresentação de estímulos | Código aberto, https://www.psychopy.org | |
| Outros softwares de terceiros (por exemplo, E-Prime) | Software de apresentação de estímulos | Psychology Software Tools, Inc. | |
| Sala com atenuação acústica | Controle ambiental | Infraestrutura institucional | |
| Monitor LCD padrão de 24 polegadas (ou menor) | Dispositivo de exibição | Qualquer fabricante conforme norma ISO |
Referências
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).