Este artigo propõe um método de monitoramento de segurança em linhas de produção que integra a versão 11 do You Only Look Once (YOLOv11) com redes neurais convolucionais. O método alcançou precisão média em 0,91 no limiar de interseção sobre união de 0,5 (mAP@0,5), mAP@0,5:0,95 de 0,82 e 120 quadros por segundo em uma unidade de processamento gráfico, superando os modelos de referência avaliados.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Monitoramento de Segurança de Linha de Produção em Tempo Real Utilizando Detecção de Objetos Baseada em Deep Learning e Aprimoramento de Características
Neste artigo
Resumo
Resumo
Com o aprofundamento da Indústria 4.0, os níveis de automação e inteligência das linhas de produção melhoraram significativamente, exigindo maior desempenho em tempo real, precisão e segurança no monitoramento. Os sistemas tradicionais de monitoramento, que dependem de inspeções manuais ou decisões baseadas em limiares simples, geralmente apresentam tempos de resposta lentos, altas taxas de falsos alarmes e inteligência limitada. Portanto, este artigo propõe um sistema de monitoramento de segurança em linhas de produção que integra a versão 11 do You Only Look Once (YOLOv11) com uma rede neural convolucional (CNN). Primeiro, as imagens adquiridas foram pré-processadas. Em seguida, o YOLOv11 foi utilizado para identificar trabalhadores, equipamentos e potenciais riscos em tempo real. Depois, introduziu-se uma rede CNN aprimorada com fusão de características em múltiplas escalas e mecanismos de atenção para melhorar a capacidade de extração de características de alvos pequenos e ocluídos. Por fim, os resultados da detecção foram fundidos com as características aprimoradas pela CNN para avaliar o estado de segurança. Experimentos foram realizados utilizando um conjunto de dados de segurança em linha de produção criado pelos autores, empregando o otimizador de descida de gradiente estocástico (SGD) com momento 0,9, taxa de aprendizado inicial de 0,01, decaimento de peso de 0,0005, ajuste da taxa de aprendizado com resfriamento cosseno, tamanho de lote de 32 e treinamento por 200 épocas. A mAP@0,5 e a velocidade de detecção em quadros por segundo (FPS) foram utilizadas como métricas de avaliação para comparação com os algoritmos de referência avaliados. Os resultados mostram que o sistema proposto alcançou uma mAP@0,5 de 0,91 e uma velocidade de detecção de 120 FPS. O sistema também demonstrou desempenho robusto em condições complexas, como sombreamento e variações de iluminação, evidenciando sua eficácia e potencial de aplicação prática no monitoramento de segurança em linhas de produção.
Introdução
Na produção industrial moderna, a segurança é a pedra angular para garantir a eficiência da produção e o bem-estar das pessoas. O ambiente da linha de produção geralmente envolve equipamentos mecânicos de alta velocidade, processos tecnológicos complexos e operações colaborativas que incluem múltiplas tarefas. Qualquer pequeno risco potencial à segurança pode provocar acidentes graves na produção, resultando em perdas econômicas significativas e até mesmo fatalidades. Portanto, é fundamental estabelecer um sistema inteligente, eficiente e em tempo real de monitoramento da segurança para aprimorar a segurança na produção industrial1,2.
Os métodos tradicionais de monitoramento de segurança dependem principalmente de vigilância manual por vídeo e diversos sensores (como sensores infravermelhos, de fumaça e de vibração)3. O monitoramento manual não é apenas ineficiente, mas também propenso a detecções não realizadas devido à fadiga da equipe de monitoramento, e não consegue fornecer cobertura contínua e abrangente. Embora os sensores possam oferecer certa função de alerta precoce, seu alcance de detecção é limitado e eles são sensíveis a interferências ambientais, resultando em problemas acentuados de falsos alarmes4. Os sistemas inteligentes de monitoramento tornaram-se um foco crescente de pesquisa. A análise em tempo real de um fluxo de vídeo por meio de um algoritmo de aprendizado profundo pode identificar automaticamente eventos anormais, comportamentos inseguros e riscos potenciais, melhorando assim significativamente a inteligência do sistema de monitoramento4,5.
A detecção de objetos é uma tecnologia fundamental em monitoramento inteligente. Como representantes dos detectores de objetos de única etapa, os algoritmos da série You Only Look Once (YOLO) demonstram vantagens significativas. Do YOLOv1 ao YOLOv8, esse conjunto de algoritmos passou por um desenvolvimento contínuo, com aprimoramentos na arquitetura da rede, função de perda e metodologia de treinamento, entre outros aspectos6,7. O YOLOv11, em particular, alcançou maior precisão na detecção mantendo uma alta taxa de quadros, especialmente quando confrontado com fundos complexos e alvos densamente agrupados8.
No entanto, apesar do seu excelente desempenho em tarefas gerais de detecção de objetos, o YOLOv11 ainda enfrenta desafios em cenários específicos de monitoramento de segurança em linhas de produção9. Por exemplo, a precisão de detecção do YOLOv11 pode diminuir quando os trabalhadores estão parcialmente ocultos por equipamentos ou quando os sinais de segurança são pequenos e se assemelham muito à cor do fundo. Isso exige que o modelo possua capacidades mais fortes de extração de características e compreensão semântica10.
As redes neurais convolucionais (CNNs) possuem grandes capacidades na extração de características de imagens11. Ao projetar arquiteturas de rede mais profundas e complexas, as CNNs podem aprender características de imagem mais ricas e abstratas. Combinar uma CNN com o YOLOv11 aproveita as capacidades rápidas de detecção do YOLOv11 e a extração profunda de características da CNN, construindo assim um sistema de monitoramento de segurança mais robusto e inteligente.
Com base nisso, este artigo propõe um sistema de monitoramento de segurança em linha de produção utilizando YOLOv11 e uma CNN. Os aspectos inovadores deste estudo incluem: (1) propor uma arquitetura de fusão profunda de YOLOv11 e uma CNN aprimorada; (2) introduzir fusão de características em múltiplas escalas e um mecanismo de atenção composto para aprimorar o reconhecimento de características-chave de segurança; e (3) verificar as vantagens de desempenho do modelo em um conjunto de dados de cenas complexas construído pelo próprio autor.
Desenvolvimento dos algoritmos da série YOLO
Desde sua introdução inicial por Redmon et al. em 201512, o algoritmo You Only Look Once (YOLO) tem despertado grande interesse. Diferentemente dos detectores de duas etapas que dependem de propostas de regiões, o YOLO trata a detecção de objetos como uma tarefa de regressão. Ao prever diretamente as classes e posições dos objetos em uma imagem, o YOLO aumenta significativamente a velocidade de detecção, tornando-o adequado para uso em tempo real13.
Como o trabalho pioneiro desta série, o YOLOv1 alcança pela primeira vez a detecção de alvos de ponta a ponta14. O YOLOv1 envolve particionar a imagem de entrada em uma estrutura de grade, na qual cada célula da grade, geralmente organizada em um formato S × S, tem a tarefa de detectar objetos que se encontram dentro de seus limites.
Especificamente, a saída do YOLOv1 é um tensor. Dentro do S × S × (B × 5 + C), a predição de cada caixa delimitadora contém 5 elementos: coordenada do ponto central (x,y), largura w, altura h e confiança c. O processo de cálculo é ilustrado na Equação (1):
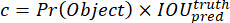 (1)
Entre eles, Pr(Object) representa a probabilidade de haver um alvo na grade, e IOU representa a razão entre a interseção e a união entre a caixa delimitadora prevista e a caixa real. Cada célula da grade também prevê um conjunto de probabilidades de classe, Pr representando a probabilidade de o alvo pertencer à i-ésima classe na presença de um alvo. A função de perda do YOLOv1 é composta por três componentes principais: a perda para a predição de coordenadas, a perda para a estimativa de confiança e a perda para a predição de categoria15.
O YOLOv2 introduz a normalização por lotes, um classificador de alta resolução e uma estratégia de treinamento em múltiplas escalas, o que melhora a estabilidade e a precisão16. O YOLOv3 utiliza o Darknet-53 como sua rede de base e se inspira no conceito da Rede de Pirâmide de Características (FPN) para aprimorar a detecção de alvos17.
O YOLOv4 realizou diversas otimizações com base no YOLOv3, introduzindo tecnologias como a Cross Stage Partial Network (CSPNet)18, a Path Aggregation Network (PANet)19 e o aumento de dados Mosaic para melhorar ainda mais o desempenho do modelo. O YOLOv5 trouxe contribuições significativas para a engenharia, oferecendo uma implementação mais fácil de usar e mais eficiente20.
Nos últimos anos, a série YOLO continuou a evoluir, com versões como YOLOv6, YOLOv7 e YOLOv8 sendo lançadas uma após a outra. Ao introduzir a estrutura Extended Efficient Layer Aggregation Network (E-ELAN) e técnicas de reparametrização de modelos, o YOLOv7 alcança novos avanços tanto em velocidade quanto em precisão. Essas melhorias não apenas aumentam a eficiência da aprendizagem de características, mas também otimizam o desempenho de inferência da rede, permitindo que o YOLOv7 supere versões anteriores e muitos detectores convencionais em diversas tarefas de detecção de objetos em tempo real. O YOLOv8 aprimora ainda mais a estrutura da rede, adota um design livre de âncoras, simplifica o modelo e melhora sua capacidade de generalização21.
Com base nas vantagens das versões anteriores, o YOLOv11, utilizado neste estudo, foi otimizado para cenários industriais complexos. Suas principais melhorias incluem uma rede de extração de características, um módulo de fusão de características mais eficiente e um design de função de perda mais robusto. Essas melhorias permitem que o YOLOv11 apresente um desempenho superior ao lidar com oclusões, alvos pequenos e fundos complexos em ambientes de produção. O YOLOv11 é uma versão da série YOLO lançada pela Ultralytics. Em comparação com o YOLOv8, ele aprimora o módulo C3K2 e o caminho de fusão de características, além de introduzir uma estratégia adaptativa de caixas âncora, proporcionando assim uma robustez de detecção mais forte em cenários industriais.
Base e progresso da rede neural convolucional (CNN)
A rede neural convolucional (CNN) é um modelo fundamental que influenciou profundamente o sucesso do aprendizado profundo na visão computacional. Ela opera extraindo características locais da imagem por meio de operações convolucionais e, posteriormente, reduzindo a dimensionalidade das características por meio de operações de agrupamento, alcançando assim uma abstração hierárquica da imagem22.
Uma CNN típica é composta por múltiplas camadas convolucionais, de agrupamento e totalmente conectadas. A camada convolucional varre a imagem de entrada com um kernel de convolução, calcula produtos escalares sobre regiões locais e produz um mapa de características. O processo de cálculo é mostrado na Equação (2):
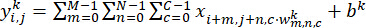 (2)
Onde x é a imagem de entrada, wk e bk são os pesos e o viés do kernel de convolução, respectivamente, e  são os valores do mapa de características de saída na posição (i,j). A camada de agrupamento geralmente utiliza Max Pooling ou Average Pooling. A camada totalmente conectada é responsável por extrair características e prever probabilidades de classificação.
Com base nisso, este artigo propõe um módulo de realce de características CNN para o YOLOv11, composto por dois ramos paralelos: um ramo de convolução multi-escala que utiliza kernels de convolução 3 × 3 e 5 × 5 para extrair características em múltiplas escalas; e um ramo de atenção que conecta sequencialmente os módulos de atenção de canal (Squeeze-and-Excitation) e de atenção espacial, a fim de realçar as características discriminativas dos alvos principais. As saídas dos dois ramos são fundidas por meio de adição elemento a elemento, e a função de perda correspondente de realce de características é apresentada na fórmula (3):
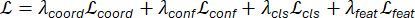 (3)
Lcoord é a perda de regressão das coordenadas da caixa delimitadora; Lconf é a perda de confiança do alvo; Lcls é a perda de classificação de categoria; Lfeat é a perda de realce de características, utilizada para restringir as características discriminativas de alvos pequenos e alvos ocluídos extraídas pelo módulo de realce da CNN; λcoord, λconf, λcls, λfeat são os coeficientes de peso dos termos de perda correspondentes. Para esta tarefa, define-se λfeat = 0,05, e os demais pesos são balanceados de acordo com os requisitos da tarefa de detecção.
Estruturas clássicas de CNN, como VGGNet23 e ResNet24, obtiveram grande sucesso em tarefas de classificação de imagens. Entre essas arquiteturas, a ResNet mitiga efetivamente o problema do gradiente que desaparece no treinamento de redes profundas, facilitando assim a construção de estruturas de rede mais profundas e complexas.
Em tarefas de detecção de objetos, a CNN geralmente é usada como extrator de características (backbone). Por exemplo, Darknet, Darknet parcial em múltiplos estágios (CSPDarknet), etc., na série de algoritmos YOLO, são todos baseados na CNN25. Para aprimorar as capacidades de extração de características, os pesquisadores propuseram diversas estruturas aprimoradas de CNN. Por exemplo, o módulo Inception extrai características em paralelo por meio de kernels de convolução de múltiplas escalas. A DenseNet potencializa a reutilização de características com conexões densas. A Rede Squeeze-and-Excitation ajusta adaptativamente a importância dos canais de características por meio de mecanismos de atenção26.
Neste estudo, projetamos um módulo CNN aprimorado para aumentar as capacidades de extração de características do YOLOv11. Este módulo combina a fusão de características em múltiplas escalas com um mecanismo de atenção para capturar de forma mais eficaz as informações-chave de segurança em cenários de linha de produção.
Situação da aplicação do aprendizado profundo no monitoramento de segurança industrial
O aprendizado profundo tem obtido grande destaque no monitoramento de segurança industrial. Algoritmos baseados em CNN são empregados para determinar se os trabalhadores estão usando corretamente capacetes de segurança, detectar intrusões não autorizadas em zonas perigosas e monitorar o estado de equipamentos com defeito27.
Em termos de reconhecimento de comportamento, CNNs 3D e redes neurais recorrentes são utilizadas para analisar o comportamento operacional dos trabalhadores e identificar ações potencialmente inseguras. Por exemplo, ao analisar as sequências de postura dos trabalhadores, pode-se determinar se eles estão violando os procedimentos operacionais de segurança28.
YOLO e Faster R-CNN são amplamente utilizados para detecção de pessoal e equipamentos em vídeos de vigilância em tempo real. Por exemplo, um sistema de detecção em tempo real de capacetes baseado no YOLOv5 foi proposto na literatura, melhorando efetivamente a inteligência na gestão da segurança em canteiros de obras29.
Embora alguns avanços tenham sido feitos nas pesquisas existentes, vários desafios permanecem. Primeiro, as cenas industriais geralmente apresentam iluminação complexa, oclusão e interferência de fundo, o que impõe requisitos rigorosos quanto à robustez do algoritmo. Segundo, o desempenho em tempo real é um requisito fundamental, e o algoritmo deve alcançar inferência de alta velocidade mantendo a precisão. Por fim, as pesquisas existentes concentram-se principalmente na detecção de tarefa única e carecem de exploração da fusão de informações multissensoriais e de análises abrangentes30.
Neste estudo, o modelo proposto de fusão YOLOv11 e CNN tem como objetivo enfrentar os desafios mencionados e alcançar um monitoramento abrangente e em tempo real dos riscos à segurança na linha de produção, melhorando as capacidades de extração e fusão de características.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Algoritmo YOLOv11 e CNN
Arquitetura geral do sistema
O sistema de monitoramento de segurança em linha de produção proposto neste artigo adota uma arquitetura híbrida que combina o YOLOv11 com uma CNN aprimorada para alcançar monitoramento de segurança em tempo real com alta precisão e alta velocidade. Conforme mostrado na Figura 1, o sistema é composto principalmente por um módulo de pré-processamento de entrada, um módulo de detecção de objetos YOLOv11, um módulo de aprimoramento de características por CNN e um módulo de decisão por fusão. A imagem de entrada é inicialmente normalizada e aumentada pelo módulo de pré-processamento para melhorar a capacidade de generalização do modelo. Em seguida, as características são extraídas pelo backbon CSPDarknet, e o campo receptivo é ampliado pelo módulo de agrupamento piramidal espacial rápido (SPPF). As características em múltiplas escalas são fundidas após o aumento da resolução, e a atenção de canal e a atenção espacial são aplicadas sequencialmente às características fundidas para aprimorar ainda mais a representação discriminativa dos alvos principais. O módulo de aprimoramento de características por CNN é inserido após as saídas das camadas C3, C4 e C5 da rede principal do YOLOv11, recebendo mapas de características em múltiplas escalas com tamanhos de 80 × 80 × 256, 40 × 40 × 512 e 20 × 20 × 1.024, respectivamente. O módulo de aprimoramento de características por CNN aprimora ainda mais a extração de características para alvos pequenos e ocluídos. Por fim, o módulo de decisão por fusão combina os resultados de detecção do YOLOv11 com as características aprimoradas pela CNN e os otimiza conjuntamente por meio de uma função de perda projetada para gerar a localização precisa, a categoria e a pontuação de confiança do alvo.
Estrutura de detecção YOLOv11
O YOLOv11 introduziu várias melhorias essenciais que aproveitam os pontos fortes da estrutura de detecção de única fase da série YOLO. Sua arquitetura é dividida em três componentes principais: uma rede de base (backbone), uma rede de fusão de características e uma cabeça de detecção. A rede de base utiliza uma estrutura CSPDarknet aprimorada. A rede de fusão de características incorpora conexões locais entre estágios e convoluções separáveis por profundidade, inspirando-se em redes piramidais de características e redes de agregação de caminhos para mesclar efetivamente características de múltiplas escalas.
Módulo de realce de características
O módulo de realce de características tem como objetivo melhorar a sensibilidade do modelo a características-chave de segurança. Ele processa os mapas de características produzidos por cada camada da rede principal YOLOv11, fundindo informações em diferentes escalas por meio de operações de interpolação para cima e para baixo. Especificamente, o ramo multi-escala captura a diversidade espacial de escala, enquanto o ramo de atenção realça dinamicamente os canais e respostas posicionais principais. Esses dois ramos não atuam de forma independente, mas são complementares e fundidos por meio de conexões residuais e realocação de características. O mapa de características processado pelo módulo de realce em cada escala é ajustado para corresponder ao número original de canais do mapa de características por meio de uma convolução 1 × 1, e então fundido com o mapa de características original do YOLOv11 por meio de adição elemento a elemento. O mapa de características fundido é então encaminhado para a rede piramidal de características subsequente (FPN) para fusão multi-escala, formando assim uma representação hierárquica de características de segurança. Para garantir uma integração perfeita entre os módulos, adota-se uma estratégia de treinamento conjunto de ponta a ponta, sendo a função de perda composta pela perda de detecção do YOLOv11 e pela perda de realce de características do módulo CNN.
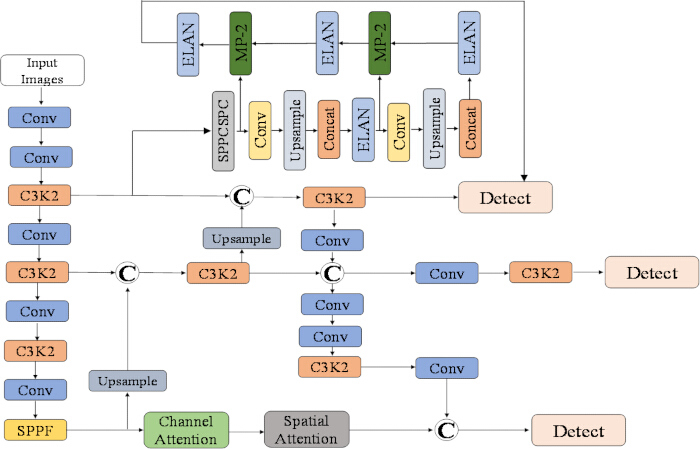
Figura 1. Algoritmo YOLOv11-CNN. O módulo de realce de características tem como objetivo amplificar a sensibilidade do modelo a características críticas de segurança. Ele processa mapas de características provenientes de várias camadas do modelo principal YOLOv11, fundindo características de diferentes escalas por meio de operações de interpolação para cima e para baixo. Além disso, incorpora mecanismos de atenção espacial e de canal. Para garantir uma integração perfeita entre os módulos YOLOv11 e CNN, é empregada uma estratégia de treinamento conjunto. Durante o treinamento, os parâmetros de ambos os módulos são otimizados de ponta a ponta. A função de perda combina a perda de detecção do YOLOv11 com a perda de realce de características do módulo CNN. Clique aqui para visualizar uma versão maior desta figura.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Para verificar a eficácia do modelo proposto de fusão YOLOv11 e CNN no monitoramento de segurança em linhas de produção, foi construído um conjunto de dados que abrange diversos cenários de riscos à segurança. Este conjunto contém 12.000 imagens de cenas de linhas de produção, divididas em conjuntos de treinamento, validação e teste na proporção 7:1,5:1,5, com uma semente aleatória fixa de 42. Ele abrange diversas condições de trabalho, incluindo iluminação normal, baixa iluminação, oclusão parcial, oclusão acentuada, de...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Os resultados experimentais mostram que o modelo proposto de fusão YOLOv11–CNN melhora a precisão de detecção e o desempenho em tempo real para monitoramento de segurança em linhas de produção. Aproveitando a detecção eficiente em estágio único do YOLOv11 e o realce de características do módulo CNN, o sistema identificou trabalhadores, equipamentos e áreas perigosas sob condições complexas de iluminação e oclusão. A fusão de características em múltiplas escalas e os mecanismos de atenção aprimoraram a capacidade de focar...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm conflitos de interesse a declarar.
Agradecimentos
Este trabalho foi patrocinado em parte pela Fundação de Pesquisa Científica da Universidade de Taizhou para Talentos Avançados "Pesquisa sobre tecnologias-chave de detecção de precisão para manufatura inteligente" (TZXY2020QDJJ006).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| API COCO | N/A | Ferramenta de avaliação utilizada para a avaliação da precisão na detecção de alvos e análise estatística. | |
| CUDA 11.4 | NVIDIA | N/A | Plataforma de computação paralela utilizada com o framework PyTorch 1.12. |
| Edge TPU | N/A | Plataforma de implantação utilizada para testes de latência e consumo de energia; a latência relatada foi de 18 ms e o consumo de energia foi de 15 W. | |
| Dispositivo de computação edge Jetson Xavier | NVIDIA | Dispositivo de computação edge utilizado para testes de taxa de transferência; a velocidade de processamento relatada foi de 70 FPS com latência do percentil 99 dentro de 50 ms. | |
| GPU NVIDIA Tesla V100 | NVIDIA | GPU utilizada no servidor de treinamento/avaliação. | |
| PyTorch 1.12 | N/A | Framework de aprendizado profundo utilizado para treinamento e avaliação do modelo. | |
| scikit-learn | N/A | Ferramenta de avaliação/análise estatística utilizada para avaliação do modelo. | |
| Conjunto de dados de segurança de linha de produção construído internamente | N/A | N/A | Conjunto de dados com 12.000 imagens de cenas de linha de produção no formato VOC, abrangendo iluminação padrão, baixa iluminação, oclusão parcial, oclusão acentuada, borrão de movimento e fundos complexos; seis categorias de anotação: trabalhadores, capacetes de segurança, braços robóticos, áreas perigosas, ferramentas e veículos. |
| Servidor de treinamento | Servidor equipado com GPU NVIDIA Tesla V100 e sistema operacional Ubuntu 20.04. | ||
| Sistema operacional Ubuntu 20.04 | N/A | Sistema operacional utilizado no servidor de treinamento/avaliação. | |
| Formato de anotação VOC | N/A | N/A | Formato de anotação utilizado para o conjunto de dados de segurança de linha de produção construído internamente. |
| Modelo de detecção de objetos YOLOv11 | Ultralytics | N/A | Modelo de detecção de objetos utilizado para detectar trabalhadores, equipamentos e potenciais riscos em tempo real. |
Referências
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.