Este estudo apresenta uma estrutura automatizada para prototipagem de interfaces de usuário, integrando princípios de design cognitivo, modelagem perceptual de cores e aprendizado profundo. O sistema melhora a acessibilidade, a clareza do layout, a harmonia de cores e a consistência entre telas, resultando em designs de interface coerentes e centrados no usuário.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Estrutura de Prototipagem Automatizada de Interface do Usuário Integrando Princípios de Design Cognitivo e Visual para Melhorar a Usabilidade e a Clareza do Layout
Neste artigo
Resumo
Resumo
O design eficaz de interface do usuário (IU) exige um equilíbrio harmônico entre apelo visual, usabilidade cognitiva e consistência de layout. No entanto, as abordagens atuais de geração automática de IU focam principalmente na aparência visual ou na detecção de componentes, carecendo de um framework unificado que integre princípios cognitivos, inteligência de cor e raciocínio estrutural. Além disso, os métodos existentes sofrem com generalização limitada de layout, baixa interpretabilidade, seleção estática de cores e comportamento inconsistente entre telas. Nesse contexto, este trabalho propõe um framework automatizado de prototipagem de IU que integra a detecção de componentes baseada na rede neural convolucional com região proposta mais rápida (Faster R-CNN) e a modelagem perceptual de cores orientada pelo espaço de cor uniforme CIECAM02 (CAM02-UCS), enriquecidos com princípios de design cognitivo e visual. O Faster R-CNN é utilizado para identificar componentes de IU e inferir estruturas hierárquicas a partir de conjuntos de dados de interfaces em larga escala. Um módulo aprimorado de geração de cores analisa imagens de marca ou de referência para garantir temas cromáticos perceptualmente uniformes, harmônicos e compatíveis com usabilidade, utilizando o CAM02-UCS. Essas saídas são ainda otimizadas por meio de regras de design cognitivo, incluindo agrupamento Gestalt, leis de Fitts e Hick, espaçamento baseado em atenção e modelagem de hierarquia visual, para gerar automaticamente layouts de IU refinados e orientados a tarefas. Experimentos realizados nos conjuntos de dados RICO, ENRICO e Guo’s UI Color mostram que o sistema proposto alcança 92,4% de precisão na detecção de componentes, melhora a clareza do layout e a precisão da ordem de leitura em 18,7% e produz paletas de cores consideradas 24,5% mais harmônicas por designers, em comparação com métodos de referência. Avaliações por usuários também indicam uma redução de 31% na carga cognitiva percebida e um aumento de 28% na consistência do design entre telas. Esses resultados demonstram que a combinação da compreensão estrutural baseada em aprendizado profundo com modelagem de cores fundamentada na percepção e princípios de design cognitivo produz protótipos de IU altamente eficientes, esteticamente coerentes e amigáveis ao usuário. Este framework estabelece uma nova abordagem completa e centrada no ser humano para a prototipagem automatizada e inteligente de IU.
Introdução
As interfaces gráficas do usuário (GUIs) atuam como um meio fundamental de comunicação entre humanos e sistemas computacionais, influenciando significativamente a usabilidade, acessibilidade e a experiência geral do usuário (UX)1,2. Sistemas de software modernos dependem de interfaces intuitivas e visualmente atraentes para atrair e reter usuários. Tradicionalmente, o design de interfaces envolve a criação de layouts gráficos que posteriormente são convertidos em código front-end por engenheiros. No entanto, as diferenças em protocolos específicos de plataforma entre sistemas operacionais exigem adaptações repetidas, aumentando a complexidade e o esforço de desenvolvimento. Assim, a geração automatizada de código de interface emergiu como uma direção de pesquisa importante, reduzindo o esforço manual e melhorando a eficiência do desenvolvimento.
As primeiras abordagens para geração automatizada de interfaces gráficas combinavam técnicas tradicionais de processamento de imagens com modelos de aprendizado profundo para detecção e classificação de regiões3,4. Atualmente, as estratégias predominantes para geração de código de interfaces gráficas aplicam técnicas de visão computacional para analisar imagens de interfaces e convertê-las em representações estruturadas de front-end5,6,7. Enquanto métodos de processamento de imagens dependem de características manualmente projetadas, abordagens de aprendizado profundo extraem representações hierárquicas a partir de conjuntos de dados em larga escala. Como resultado, pesquisadores têm explorado abordagens híbridas que combinam aprendizado profundo com técnicas específicas de domínio de processamento de imagens para melhorar a robustez e a precisão.
A cor é outro fator crítico no design de interfaces, influenciando a percepção do usuário, a usabilidade e o apelo estético1. Manter a consistência entre o conteúdo da imagem e os esquemas de cores da interface torna-se desafiador quando as entradas visuais variam em matiz e contexto8,9,10. Consequentemente, uma quantidade significativa de pesquisa tem se concentrado na geração automatizada de paletas de cores e na modelagem perceptual de cores. Os métodos existentes para geração de cores incluem técnicas baseadas no espaço de cor CIELAB11. Outras abordagens utilizam algoritmos de agrupamento, como o k-means, para extrair as cores dominantes de imagens12. Como resultado, trabalhos recentes têm adotado cada vez mais abordagens baseadas em dados e em aprendizado de máquina para modelagem de cores.
Paralelamente, as abordagens de aprendizado profundo melhoraram significativamente a detecção de componentes de interface e a compreensão de layout. Redes neurais permitiram uma análise estrutural mais precisa de interfaces móveis.13No entanto, esses métodos concentram-se principalmente na precisão de detecção e muitas vezes negligenciam aspectos de nível superior, como usabilidade cognitiva, hierarquia de layout e eficiência de interação. Também foram propostos modelos generativos para a síntese de layout de interface de usuário14,15, mas enfrentam desafios na manutenção da consistência entre telas e na fornecimento de decisões de design interpretáveis16Outras abordagens concentram-se na similaridade visual ou na qualidade de renderização, mas carecem de um framework unificado que combine semântica dos componentes, harmonia de cores e restrições de usabilidade17O reconhecimento de texto também é importante para a compreensão do conteúdo da interface do usuário (UI). Técnicas como redes neurais recorrentes convolucionais (CRNNs) permitem o reconhecimento preciso de padrões de texto complexos em telas de interface.18,19,20.
Vários sistemas foram propostos para gerar código de interface do usuário (UI) a partir de esboços ou imagens. O Sketch2Code utiliza detecção de objetos para converter esboços em representações de código21,22, mas é sensível à qualidade da imagem. O REDRAW fornece um pipeline automatizado para coleta de dados e treinamento de modelos, combinando redes neurais convolucionais e recorrentes para gerar representações estruturadas de interfaces do usuário23,24. Trabalhos posteriores introduziram métricas de avaliação aprimoradas para avaliar a qualidade das interfaces do usuário geradas25. Abordagens mais recentes incluem modelos baseados em difusão e em transformadores para geração de layouts, como transformadores de layout por difusão sem métodos de autoencoder, geração de layout de interface gráfica do usuário (GUI) usando grafos de organização de GUI baseados em transformadores e geração de layout de interface do usuário orientada por modelos de linguagem grandes26,27,28. Uma visão geral comparativa dessas abordagens é apresentada na Tabela 1.
| Referências e Método(s) Principal(is) | Objetivo | Vantagens | Desvantagens |
| Geração Automatizada de Temas de Cores em Interface de Usuário Baseada em Imagem: extração de cores predominantes + modelagem perceptual de cores CAM02-UCS¹ | Gerar automaticamente temas de cores para interfaces de usuário a partir de imagens de referência, otimizando harmonia e usabilidade. | Forte base perceptual (CAM02-UCS); equilibra explicitamente harmonia e usabilidade (contraste e diversidade); inclui implementação baseada na web e avaliação por designers. | Foca apenas em cores/temas (não em layout ou estrutura de componentes); baseado em regras/heurísticas, em vez de síntese de interface de usuário aprendida de ponta a ponta. |
| Unificação da Geração de Layout com um Modelo de Difusão Desacoplado (LDGM)²⁵ | Geração unificada e flexível de layout para cenas gráficas e interfaces de usuário. | Diversidade e controlabilidade de estado da arte na geração de layout; suporta geração condicional e múltiplos tipos de atributos. | Saídas baseadas em difusão podem apresentar problemas de alinhamento ou detalhes finos no layout, a menos que sejam restritas; maior complexidade do modelo e custo de inferência. |
| Transformadores de Layout por Difusão sem Métodos de Autoencoder: transformador + difusão para geração de layout (sem autoencoder)²⁶ | Melhorar fidelidade e alinhamento em benchmarks de geração de layout (métricas FID, alinhamento e sobreposição). | Melhor capturação de correlações semânticas entre objetos vizinhos; desempenho robusto nas métricas FID e de alinhamento. | Foca principalmente na geometria do layout (posições, tamanhos, categorias), e não na semântica da interface de usuário. |
| Geração de Layout de GUI com Modelos Baseados em Transformador a Partir de Grafos de Organização de GUI (GUI-AGs)²⁷ | Criar layouts de GUI a partir de restrições posicionais/gráficas para auxiliar designers. | Representações em grafo capturam restrições relacionais; o transformador permite geração flexível condicionada a restrições. | Pode exigir grafos de restrição explícitos dos designers; ênfase limitada em métricas de cor e usabilidade. |
| Geração de Layout de UI com Modelos de Linguagem de Grande Porte (LLMs) Guiados por Gramática de UI: Modelos de Linguagem de Grande Porte (LLMs) + gramática hierárquica de UI²⁸ | Explorar LLMs para geração de layout e melhorar explicabilidade/controle por meio de representações gramaticais. | Alta controlabilidade e explicabilidade em nível superior; pode aproveitar o aprendizado em contexto de LLMs (tipo GPT). | Trabalho em estágio inicial com validação empírica limitada; design da gramática e robustez em diferentes interfaces de usuário |
Tabela 1: Comparação dos métodos existentes de modelagem de cores de interface e geração de layout. A tabela resume abordagens representativas para o design de interface de usuário, incluindo geração de tema de cores, geração de layout baseada em difusão, métodos baseados em transformadores e geração de layout orientada por modelos de linguagem grandes. Para cada método, são apresentadas a técnica subjacente, o objetivo, as vantagens e as limitações, destacando as diferenças nos aspectos de modelagem perceptual, capacidade de geração de layout, controlabilidade e considerações de usabilidade.
Apesar desses avanços, uma limitação fundamental permanece: nenhum sistema existente integra conjuntamente a detecção de componentes, a modelagem perceptual de cores, os princípios cognitivos de design e a consistência de layout em múltiplas telas dentro de um único framework ponta a ponta1. As abordagens atuais normalmente otimizam apenas um ou dois aspectos — como detecção, layout ou cor — sem considerar suas interdependências. Essa fragmentação evidencia uma lacuna crítica na pesquisa para o desenvolvimento de sistemas unificados de prototipagem automatizada de interfaces centradas no ser humano. Em particular, os princípios de design cognitivo, como as leis de Gestalt, a lei de Fitts e a lei de Hick, muitas vezes são tratados de forma conceitual, em vez de serem formalmente integrados em modelos computacionais.
Para superar essas limitações, este estudo propõe um framework automatizado de prototipagem de interface do usuário (UI) de ponta a ponta que integra detecção de componentes, modelagem de cor perceptual e princípios de design cognitivo em um sistema unificado. O framework foi projetado para melhorar a qualidade do layout, reduzir a carga cognitiva, aprimorar a harmonia de cores e aumentar a usabilidade geral. Essas melhorias são validadas por meio de experimentos nos conjuntos de dados RICO, ENRICO e Guo’s UI Color Datasets, demonstrando a eficácia da combinação de aspectos estruturais, perceptuais e cognitivos em um único pipeline automatizado de prototipagem de UI. Levanta-se a hipótese de que a integração da detecção de componentes baseada em aprendizado profundo, modelagem de cor perceptual e princípios de design cognitivo em um framework unificado melhorará significativamente a qualidade do protótipo de UI em comparação com abordagens existentes. Especificamente, H1 propõe que o framework aprimora a qualidade do layout, incluindo alinhamento, agrupamento e ordem de leitura. H2 postula que o framework reduz a carga cognitiva do usuário. H3 sugere que a modelagem de cor perceptual melhora a coordenação de cores e a harmonia visual. H4 afirma que a usabilidade geral e a qualidade estética dos protótipos de UI são aprimoradas.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo utiliza conjuntos de dados de acesso público e não envolve seres humanos ou animais.
O framework proposto de prototipagem automatizada de interface com o usuário integra a compreensão estrutural baseada em aprendizado profundo, a modelagem de cores perceptualmente uniforme e os princípios de design cognitivo para gerar protótipos de interface coerentes e centrados no usuário. A metodologia inicia com uma arquitetura Faster R-CNN treinada nos conjuntos de dados RICO e ENRICO para detectar componentes de interface e extrair suas relações hierárquicas, permitindo a interpretação precisa de diversos layouts de tela. Os componentes detectados são então processados por um módulo de inteligência de cor, que extrai pistas de cor baseadas em marca ou imagem, modela a similaridade perceptual usando CAM02-UCS e gera paletas de cores harmônicas, sensíveis ao contraste e compatíveis com acessibilidade. Posteriormente, são aplicados princípios de design cognitivo — incluindo as leis de agrupamento de Gestalt, a lei de Fitts, a lei de Hick, o espaçamento baseado em atenção e restrições de hierarquia visual — por meio de um mecanismo de otimização cognitiva para aprimorar a organização espacial e o alinhamento dos componentes. Por fim, uma camada de raciocínio de layout integra restrições estruturais, perceptuais e cognitivas para gerar protótipos de interface com múltiplas telas coerentes, que equilibram usabilidade, estética e clareza funcional. Este pipeline integrado garante coerência perceptual, reduz a carga cognitiva e adere aos princípios de design centrado no ser humano. O fluxo de trabalho completo do método proposto é ilustrado na Figura 1.
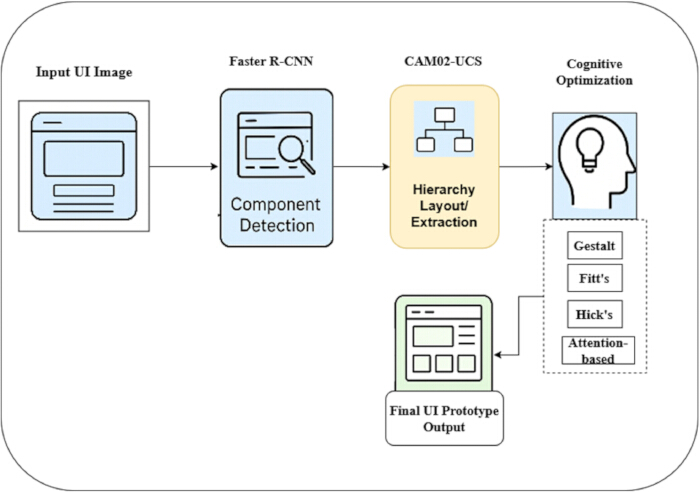
Figura 1. Arquitetura geral do framework proposto para prototipagem automatizada de interface de usuário. O diagrama ilustra o pipeline completo, partindo de uma imagem de interface de usuário de entrada. A detecção de componentes é realizada usando Faster R-CNN para identificar os elementos da interface. Os componentes detectados são então processados utilizando modelagem perceptual baseada em CAM02-UCS para extração de hierarquia e layout. Em seguida, é aplicada a otimização cognitiva com base nos princípios de Gestalt, na lei de Fitts, na lei de Hick e em ajustes baseados na atenção. As setas indicam o fluxo de dados entre os módulos, resultando na saída do protótipo final da interface de usuário. Clique aqui para visualizar uma versão maior desta figura.
Visão geral do framework
Figura 1 ilustra o fluxo de trabalho completo do framework proposto de prototipagem automatizada de interface do usuário (UI), que transforma uma captura de tela bruta de uma UI em um protótipo refinado cognitivamente. O processo inicia com a imagem de entrada da interface, que é enviada ao módulo de detecção de componentes baseado no Faster R-CNN. Este módulo identifica elementos da interface, como botões, ícones, campos de texto e contêineres, e gera suas caixas delimitadoras e rótulos de classe correspondentes. Os componentes detectados são então processados na etapa de extração de hierarquia e layout. Com base em relações espaciais e padrões estruturais, o sistema constrói uma árvore hierárquica de layout que reflete a forma como os usuários percebem naturalmente a organização da tela. Essa representação captura o agrupamento visual e as dependências estruturais entre os elementos da interface. O layout extraído é posteriormente refinado por meio de otimização cognitiva mediante a aplicação de princípios de design centrado no ser humano. Entre eles estão o agrupamento de Gestalt para agrupamento visual, a lei de Fitts para otimizar o tamanho e a acessibilidade de alvos táteis, a lei de Hick para reduzir a complexidade de decisão e o espaçamento baseado na atenção para melhorar a hierarquia visual. Como resultado, o layout torna-se mais intuitivo, legível e eficiente para a interação do usuário. Por fim, o layout otimizado é combinado com modelagem perceptual de cores para gerar um protótipo de interface coerente. A interface resultante é estruturalmente precisa, visualmente harmônica e compatível com as expectativas humanas de usabilidade.
O framework foi implementado usando PyTorch 2.0 no Ubuntu 22.04. Os experimentos foram realizados em um sistema equipado com uma GPU NVIDIA RTX 4090 (24 GB de VRAM). O modelo Faster R-CNN utilizou uma estrutura ResNet-50 pré-treinada no conjunto de dados ImageNet. O treinamento foi realizado usando o otimizador stochastic gradient descent (SGD) com uma taxa de aprendizado de 0,001, tamanho de lote de 16 e até 60 épocas. A parada antecipada foi aplicada para evitar overfitting, utilizando um conjunto de validação composto por 20% dos dados. Embora o treinamento tenha sido realizado por até 60 épocas, a convergência geralmente foi alcançada anteriormente por meio da parada antecipada com base na perda de validação. O momento e a redução de peso foram definidos como 0,9 e 0,0005, respectivamente. A ampliação dos dados incluiu normalização, inversão horizontal aleatória e recorte e redimensionamento aleatórios.
Preparação do conjunto de dados
Para apoiar o framework proposto de prototipagem automatizada de interface do usuário (UI), foram utilizados três conjuntos de dados complementares: ENRICO29, RICO30 e o Guo’s UI Color Dataset1. O conjunto de dados RICO contém 66.261 telas de interface do usuário do Android coletadas de 9.700 aplicações, fornecendo diversidade em larga escala para detecção de componentes e extração de layout hierárquico. O ENRICO inclui 1.464 capturas de tela de alta qualidade manualmente categorizadas em 20 padrões de design, permitindo uma generalização aprimorada para raciocínio estrutural e modelagem de consistência de layout. O Guo’s UI Color Dataset consiste em 128 imagens de interface do usuário curadas com temas de cores anotados, utilizadas para modelagem perceptual de cores e avaliação de paletas. No entanto, devido ao seu tamanho relativamente menor, este conjunto de dados pode introduzir alguma variabilidade nas características de layout. Para este estudo, foi preparado um conjunto combinado de 5.128 telas para treinamento e avaliação. Especificamente, aproximadamente 4.000 imagens do RICO foram usadas para treinar o modelo Faster R-CNN para detecção de componentes, 1.000 imagens do ENRICO foram utilizadas para aprendizado de padrões de layout e modelagem de consistência estrutural, e 128 imagens do conjunto de dados de Guo foram empregadas para tarefas de avaliação de cores. Todas as imagens foram normalizadas para uma resolução de 480 × 800 pixels, convertidas para um espaço de cor sRGB uniforme e reanotadas com caixas delimitadoras padronizadas e metadados hierárquicos para garantir compatibilidade entre os conjuntos de dados. Uma visão geral dos conjuntos de dados utilizados neste estudo é apresentada na Tabela 2. O conjunto de dados RICO apoia a detecção em larga escala de componentes de interface do usuário e análise estrutural, enquanto o ENRICO aprimora a capacidade do modelo de reconhecer padrões de layout e impor consistência entre telas. O Guo’s UI Color Dataset, embora menor em tamanho, desempenha um papel crítico na avaliação da harmonia perceptual de cores e modelagem de contraste. Juntos, esses conjuntos de dados fornecem uma base abrangente e bem equilibrada para treinamento, validação e avaliação do framework proposto de prototipagem automatizada de interface do usuário.
| Conjunto de Dados | Total de Imagens Disponíveis | Imagens Utilizadas no Estudo | Finalidade na Estrutura Proposta |
| RICO Dataset30 | 66.261 | 4.000 | detecção de componentes de interface, extração de layout estrutural |
| ENRICO Dataset29 | 1.464 | 1.000 | aprendizado de padrões de design, modelagem de consistência de layout |
| Guo’s UI Color Dataset1 | 128 | 128 | extração de tema de cor, avaliação perceptual de cor |
| Total Combinado | 67.853 | 5.128 | conjunto de dados abrangente para detecção, layout e modelagem de cor |
Tabela 2: Resumo dos conjuntos de dados utilizados na estrutura proposta. A tabela apresenta os conjuntos de dados utilizados para treinamento e avaliação, incluindo os conjuntos de dados RICO, ENRICO e Guo’s UI Color. São relatados o número total de imagens disponíveis, o subconjunto utilizado neste estudo e o papel específico de cada conjunto de dados na detecção de componentes, modelagem de layout e análise perceptual de cores dentro da estrutura proposta.
Uma estratégia de amostragem estratificada foi empregada para preservar a diversidade em componentes de interface do usuário, estruturas de layout e distribuições de cores nos conjuntos de dados RICO, ENRICO e Guo. O conjunto de dados foi dividido em subconjuntos de treinamento (70%), validação (15%) e teste (15%) utilizando amostragem estratificada. As imagens foram normalizadas usando média (0.485, 0.456 e 0.406) e desvio padrão (0.229, 0.224 e 0.225). Aumento de dados incluiu inversão horizontal aleatória (probabilidade = 0.5) e recorte aleatório (faixa de escala: 0.8–1.0), seguido por redimensionamento para 224 × 224 pixels aplicado durante o treinamento.
Anotação dos componentes e pré-processamento
Os conjuntos de dados RICO, ENRICO e Guo’s UI Color Dataset apoiam coletivamente os três componentes funcionais principais do framework proposto de prototipagem automatizada de interfaces: detecção de componentes, modelagem de layout e otimização perceptual de cores. O conjunto de dados RICO contém uma coleção em larga escala de mais de 66.000 telas de interfaces móveis e é usado principalmente para treinar o módulo de detecção de componentes. Sua diversidade permite que o modelo Faster R-CNN aprenda representações robustas de elementos comuns de interfaces, como botões, imagens e campos de texto, em uma ampla variedade de aplicações. Isso garante a detecção e localização precisas dos componentes da interface sob diferentes condições de design. O conjunto de dados ENRICO fornece telas de interfaces de alta qualidade com padrões rotulados, destinadas ao aprendizado de relações estruturais e padrões de layout. Ele permite que o sistema compreenda as relações entre componentes, a organização hierárquica e os modelos de design comuns. Esse conjunto de dados desempenha um papel fundamental na modelagem de estruturas de layout e na imposição de consistência entre telas, permitindo que o framework gere layouts alinhados às convenções de design estabelecidas. Em contraste, o Guo’s UI Color Dataset é especificamente utilizado para modelagem de cores perceptual e cognitiva. Diferentemente dos conjuntos RICO e ENRICO, que enfocam aspectos estruturais, este conjunto contém imagens de interfaces cuidadosamente selecionadas com temas de cores anotados. Essas anotações são usadas para treinar módulos de extração de cores e avaliação de harmonia. Ao mapear as relações de cores em espaços de cor perceptuais, como o CAM02-UCS, o framework aprende a gerar paletas de cores que equilibram contraste, acessibilidade e coerência estética. Juntos, esses conjuntos de dados formam um pipeline integrado: o RICO apoia a detecção de componentes, o ENRICO permite a compreensão de padrões de layout e a consistência estrutural, e o conjunto de dados de Guo facilita a otimização perceptual de cores. Essa integração garante que os protótipos de interfaces gerados sejam estruturalmente precisos, visualmente harmônicos e otimizados cognitivamente.
A normalização foi realizada utilizando uma média de [0,485, 0,456, 0,406] e um desvio padrão de [0,229, 0,224, 0,225]. Técnicas de aumento de dados, incluindo recorte aleatório, inversão horizontal e rotação, foram aplicadas para melhorar a generalização do modelo. Além disso, os valores dos pixels foram escalonados para a faixa [0, 1], e todas as imagens foram redimensionadas para uma resolução de 480 × 800 pixels para garantir consistência entre os conjuntos de dados. Imagens redimensionadas para 224 × 224 pixels são utilizadas para aumento durante o treinamento, enquanto a resolução original de 480 × 800 pixels é mantida para análise de layout. As caixas delimitadoras foram ajustadas para filtrar anotações irrelevantes usando limiares predefinidos. Para alcançar uniformidade entre os conjuntos de dados, todos os elementos de interface foram anotados manualmente utilizando a ferramenta de anotação LabelImg. Um esquema predefinido foi estabelecido antes da anotação para classificar os elementos de interface em categorias como botão, texto, imagem, ícone e contêiner. Para a representação das caixas delimitadoras, foi aplicado um sistema de coordenadas uniforme, e a informação hierárquica foi construída com base nas relações espaciais entre os elementos e suas associações pai-filho dentro da árvore de layout. Além disso, diretrizes foram estabelecidas para garantir anotação consistente dos elementos, tratamento adequado de componentes sobrepostos e aplicação de limiares mínimos de tamanho nos conjuntos de dados RICO, ENRICO e Guo.
Formulações matemáticas detalhadas para o treinamento de detecção de componentes e extração de padrões de layout são fornecidas no Arquivo Suplementar 1.
O modelo Faster R-CNN foi treinado usando SGD com um momento de 0,9 e uma taxa de decaimento de peso de 0,0005. A taxa de aprendizado inicial foi definida como 0,001 e ajustada usando uma política de decaimento em etapas com base no desempenho na validação. O treinamento foi realizado por até 60 épocas com um tamanho de lote de 16. A parada antecipada foi aplicada para evitar overfitting, utilizando um conjunto de validação composto por 20% dos dados de treinamento.
A função de mapeamento f(.) recebe como entrada elementos de interface de usuário detectados e produz como saída uma representação hierárquica do layout. Ela calcula as relações de adjacência entre os elementos da interface com base em critérios de distância espacial e alinhamento, e constrói uma matriz de adjacência para representar essas relações. Um algoritmo de agrupamento, como o DBSCAN, é então aplicado para agrupar componentes relacionados. Por fim, os elementos agrupados são organizados em estruturas hierárquicas com base em relações de pai–filho, formando uma representação estruturada do layout.
As formulações detalhadas para a modelagem de harmonia de cores e o objetivo de otimização unificado são fornecidas no Arquivo Suplementar 1.
Essa função objetiva formaliza matematicamente a integração da detecção estrutural, do raciocínio de layout e da modelagem perceptual de cores, garantindo que todos os componentes do framework contribuam conjuntamente para gerar protótipos de interface de usuário coerentes e centrados no usuário. A otimização é realizada de maneira modular para cada componente do framework. SGD é utilizado para treinar o módulo de detecção de componentes, enquanto o otimizador Adam é empregado durante a otimização conjunta do objetivo unificado. O objetivo combinado é usado para orientar o desempenho geral do sistema. Nas etapas de otimização conjunta, a função objetiva é minimizada usando o otimizador Adam com uma taxa de aprendizado de 0,001 e um tamanho de lote de 16. O treinamento é realizado por até 60 épocas, com parada antecipada aplicada quando a variação da perda de validação for inferior a 10−4 durante cinco épocas consecutivas.
Detecção de componentes usando Faster R-CNN
O framework proposto utiliza o Faster R-CNN para detecção automática de componentes de interface (UI), incluindo botões, ícones, campos de texto, imagens e contêineres. O Faster R-CNN é adequado para esta tarefa porque combina alta precisão na detecção de objetos com geração eficiente de propostas de região, o que é essencial para lidar com layouts de interface complexos que contêm elementos densamente agrupados. O modelo utiliza uma estrutura ResNet-50 pré-treinada no conjunto de dados ImageNet para extrair mapas de características convolucionais de cada tela de interface. Durante o treinamento, as camadas iniciais foram congeladas para manter características visuais gerais, enquanto as camadas superiores (conv4_x e conv5_x) foram ajustadas finamente para detecção de componentes específicos da interface. Esses mapas de características capturam estruturas visuais, bordas, texturas e limites dos componentes. Durante a detecção, a rede de proposta de região (RPN) identifica regiões candidatas (âncoras) que provavelmente contenham componentes de interface. As âncoras são definidas utilizando múltiplas escalas (128, 256 e 512) e proporções de aspecto (1:1, 1:2 e 2:1) para acomodar elementos de interface de tamanhos variados. Durante o treinamento, âncoras com uma interseção sobre união (IoU) maior que 0,7 em relação às caixas reais são rotuladas como positivas, enquanto aquelas com IoU menor que 0,3 são rotuladas como negativas; âncoras com valores intermediários de IoU são ignoradas. Cada âncora recebe uma probabilidade indicando a presença de um componente. A supressão não máxima (NMS) é então aplicada para remover propostas redundantes e sobrepostas, garantindo uma localização eficiente de elementos de interface significativos, mesmo em interfaces poluídas. Uma vez geradas as regiões candidatas, cada proposta é classificada em categorias predefinidas de componentes e suas coordenadas de caixa delimitadora são refinadas. Uma operação de alinhamento de região de interesse (ROI) extrai representações de características de tamanho fixo para cada proposta, que são então processadas por camadas totalmente conectadas para classificação e regressão. O ramo de classificação gera probabilidades de classe, enquanto o ramo de regressão prevê coordenadas precisas da caixa delimitadora. Todo o modelo Faster R-CNN é treinado de ponta a ponta pela otimização de uma função de perda conjunta que combina a perda da RPN com a perda final de detecção. Isso permite que o sistema não apenas reconheça com precisão os componentes de interface, mas também os localize com exatidão em diversas estruturas de interface. Uma descrição detalhada da detecção de componentes pelo Faster R-CNN, incluindo a etapa da RPN, classificação de ROI, refinamento da caixa delimitadora e objetivo final de otimização, é fornecida no Arquivo Suplementar 1.
Algoritmo S1 fornece o fluxo de trabalho detalhado de detecção de componentes e extração estrutural (Arquivo Suplementar 1). Ele descreve o processo completo de detecção automática de componentes de interface do usuário (UI) e extração estrutural a partir de uma imagem bruta da tela. A imagem de entrada é primeiramente pré-processada e encaminhada por meio de uma estrutura de CNN para extrair características visuais profundas. Essas características são utilizadas pela RPN para gerar caixas delimitadoras candidatas, que são então refinadas por meio de classificação e regressão. A supressão não máxima (NMS) remove detecções redundantes para garantir uma localização precisa. Após a detecção, os componentes são agrupados com base na proximidade espacial, utilizando o agrupamento espacial baseado em densidade de aplicações com ruído (DBSCAN). Esta etapa de agrupamento permite a construção de uma árvore hierárquica de UI que captura as relações pai-filho e os agrupamentos lógicos entre os componentes. Essa representação hierárquica constitui a base para análises posteriores de layout e compreensão da interface. Figura 2 ilustra o processo de detecção de componentes por Faster R-CNN em uma tela de interface móvel. A interface de entrada (à esquerda) contém elementos de UI, como botões e blocos de texto, que são automaticamente delimitados por caixas. Essas regiões detectadas são então classificadas em categorias de componentes (por exemplo, Botão e Texto), conforme indicado pelas conexões rotuladas. O módulo de detecção Faster R-CNN (à direita) refina as coordenadas das caixas delimitadoras, atribui rótulos semânticos e gera informações estruturadas em nível de componente. Esta etapa serve como fundamento essencial para processos subsequentes, incluindo extração de layout, otimização cognitiva e geração de protótipos de interface, ao fornecer representações precisas e semanticamente significativas dos componentes da interface.
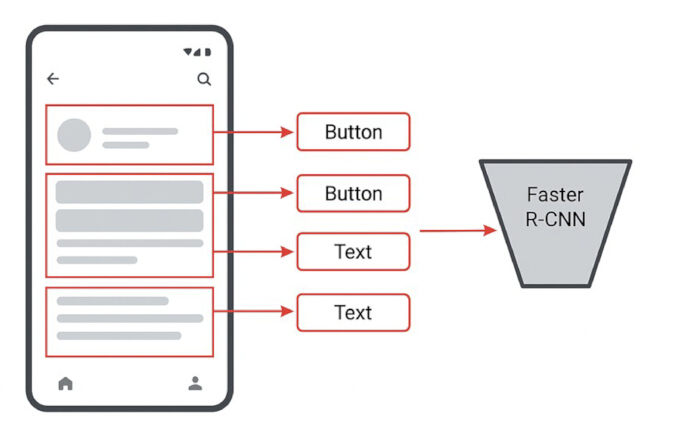
Figura 2. Detecção de componentes de elementos da interface do usuário utilizando Faster R-CNN. A figura ilustra a detecção de componentes da interface a partir de uma captura de tela da interface de entrada. Regiões de interesse são identificadas por meio de caixas delimitadoras, e elementos como botões e campos de texto são classificados utilizando Faster R-CNN. Setas indicam o mapeamento dos componentes detectados para seus rótulos semânticos correspondentes. Clique aqui para visualizar uma versão maior desta figura.
Extração do padrão de layout e modelagem hierárquica
Após a detecção de componentes usando Faster R-CNN, cada elemento de interface é representado por uma caixa delimitadora. No entanto, essas caixas delimitadoras isoladamente não indicam como os elementos estão organizados estruturalmente dentro da interface, por exemplo, quais elementos pertencem a cabeçalhos, barras de navegação ou regiões de conteúdo agrupado. Para superar essa limitação, os componentes detectados são transformados em uma árvore lógica de interface, na qual cada componente é tratado como um nó e componentes relacionados funcional ou visualmente são agrupados sob nós pais comuns. Para identificar grupos de layout significativos, são aplicadas técnicas de agrupamento, como DBSCAN ou agrupamento hierárquico aglomerativo. Esses métodos analisam padrões de proximidade espacial e alinhamento entre componentes para detectar relações entre elementos de interface. De maneira análoga às práticas humanas de design, o sistema aprende a reconhecer padrões estruturais comuns, como cabeçalhos, rodapés, grades e blocos de conteúdo. Uma vez estabelecido o agrupamento, propriedades estruturais adicionais — incluindo alinhamento, organização em grade e ordem de leitura — são analisadas para construir uma representação abrangente do layout. Por exemplo, componentes alinhados em colunas de largura igual podem indicar um layout baseado em cartões, enquanto elementos empilhados verticalmente podem indicar uma interface baseada em formulários ou em feed. Ao integrar agrupamento, raciocínio espacial e regras de alinhamento, a estrutura constrói uma árvore hierárquica de interface que captura tanto o agrupamento visual quanto as relações funcionais. Essa representação hierárquica serve como base para o refinamento subsequente do layout e para a modelagem de consistência entre telas, permitindo que o sistema gere designs de interface estruturados, coerentes e centrados no usuário.
Formulações detalhadas para distância espacial e similaridade de alinhamento são fornecidas no Arquivo Suplementar 1.
Agrupamento para agrupamento de layout (DBSCAN)
Para identificar grupos de layout, aplica-se o DBSCAN. O DBSCAN utiliza dois parâmetros: (1) ε = distância máxima entre componentes vizinhos e (2) = número mínimo de componentes necessários para formar um agrupamento. Para esta análise, os parâmetros do DBSCAN foram selecionados empiricamente com base na resolução normalizada da interface do usuário (480 × 800 pixels). O parâmetro de distância de vizinhança foi definido como ε = 50 pixels para capturar a proximidade espacial entre componentes da interface do usuário adjacentes. O número mínimo de pontos necessário para formar um agrupamento foi definido como MinPts = 3 para evitar a formação de grupos insignificantes ou espúrios de componentes da interface do usuário.
A formulação detalhada da construção da árvore lógica de interface do usuário é fornecida no Arquivo Suplementar 1.
Modelagem de cor perceptual com CAM02-UCS
A modelagem perceptual de cores garante que as cores utilizadas na interface gerada sejam harmoniosas, legíveis e cognitivamente eficientes. Cores dominantes são extraídas de fontes de entrada, como imagens de interfaces, usando técnicas de agrupamento. Especificamente, o agrupamento K-médias com inicialização K-médias++ é aplicado por 300 iterações para obter paletas de cores representativas. No entanto, o espaço de cores RGB não reflete com precisão a percepção visual humana, o que significa que cores numericamente semelhantes podem parecer perceptualmente diferentes. Para superar essa limitação, todas as cores extraídas são transformadas em CAM02-UCS, que é perceptualmente uniforme. Nesse espaço, distâncias iguais correspondem a diferenças de cor percebidas iguais, tornando-o adequado para modelar harmonia e contraste de cores. Uma vez mapeadas no CAM02-UCS, as diferenças perceptuais de cor são calculadas usando a distância euclidiana, permitindo ao sistema quantificar contraste, harmonia e variação entre as cores. Cores muito semelhantes são separadas para melhorar a legibilidade, enquanto cores excessivamente contrastantes são moderadas para evitar desconforto visual. A paleta gerada também segue padrões de acessibilidade, como WCAG AA e AAA, assegurando contraste suficiente entre elementos de primeiro e segundo plano. Além disso, a harmonia de cores é garantida ao restringir as relações da paleta a esquemas complementares, análogos ou triádicos, dependendo do tema pretendido para a interface. Isso assegura que a paleta de cores resultante seja não apenas visualmente agradável, mas também funcionalmente acessível e otimizada cognitivamente. Para refinar ainda mais a paleta, um processo de otimização é aplicado sob as restrições de similaridade perceptual, contraste, harmonia e consistência da marca. Uma cor primária é selecionada (por exemplo, a partir da identidade da marca), e as cores secundárias são ajustadas em termos de luminância e croma para preservar a hierarquia visual. Um mecanismo de avaliação baseado em regras avalia paletas candidatas com base em distâncias perceptuais e métricas de acessibilidade, minimizando a carga cognitiva enquanto mantém o equilíbrio estético. Como resultado, o framework produz esquemas de cores para interfaces que exibem coerência, legibilidade e consistência perceptual em nível profissional.
Expressões matemáticas detalhadas para a modelagem de cor perceptual baseada em CAM02-UCS são fornecidas no Arquivo Suplementar 1.
Algoritmo S2 (Arquivo Suplementar 1) descreve o fluxo de trabalho de extração e otimização de cores perceptuais baseado no CAM02-UCS, sujeito a restrições de harmonia e acessibilidade. Inicialmente, as cores dominantes são extraídas da imagem de entrada e transformadas para o espaço CAM02-UCS, garantindo que as diferenças de cor correspondam à percepção humana. As distâncias perceptuais entre as cores são então calculadas e limitadas a intervalos predefinidos, mantendo clareza e harmonia. Em seguida, a acessibilidade é garantida mediante a avaliação das relações de contraste de luminância de acordo com as diretrizes WCAG. A paleta final é obtida pela otimização de uma função objetivo combinada, que equilibra o espaçamento perceptual, os requisitos de contraste e as restrições de harmonia cromática. Isso assegura que os esquemas de cores de interface gerados sejam não apenas visualmente agradáveis, mas também legíveis, acessíveis e perceptualmente consistentes.
Otimização do design cognitivo
A otimização do design cognitivo garante que os protótipos de interface gerados automaticamente sejam não apenas visualmente consistentes, mas também fáceis de compreender e de interagir. Este módulo integra princípios-chave de design cognitivo, incluindo os princípios de Gestalt, a lei de Fitts e a lei de Hick, para orientar o arranjo, o agrupamento e o espaçamento dos componentes da interface. As formulações matemáticas detalhadas para a otimização do design cognitivo estão disponíveis no Supplementary File 1.
Objetivo integrado de otimização cognitiva
A expressão matemática para o objetivo integrado de otimização cognitiva é fornecida no Arquivo Suplementar 1. Os coeficientes que representam a importância do agrupamento visual, da eficiência da interação e da complexidade da decisão são denotados por alfa, beta e gama, respectivamente. Neste estudo, os valores de alfa, beta e gama foram determinados empiricamente utilizando o conjunto de dados de validação. Para o presente experimento, os coeficientes foram definidos da seguinte forma: α = 0,5, β = 0,3 e γ = 0,2. Essa configuração proporciona um equilíbrio eficaz entre agrupamento visual, eficiência da interação e simplicidade da decisão.
Consistência entre várias telas e geração de interface do usuário
A modelagem de consistência multitetela garante que diferentes telas dentro de um aplicativo compartilhem uma identidade visual coerente, layout estrutural e padrão de interação. À medida que os usuários navegam entre telas, desenvolvem expectativas quanto ao posicionamento de elementos, tipografia, espaçamento e hierarquia visual. Para atender a essas expectativas, o sistema analisa padrões entre telas usando modelos derivados dos conjuntos de dados RICO e ENRICO. Esses modelos capturam estruturas comuns de interface, como layouts inicial–detalhe, padrões lista–detalhe, formulários em múltiplas etapas e fluxos de painel. Ao comparar o posicionamento e o agrupamento de componentes, o sistema constrói um perfil estrutural entre telas que identifica quais elementos devem permanecer consistentes e quais podem variar. Uma vez identificados os padrões estruturais, a estrutura assegura consistência nas escalas tipográficas, nas proporções de espaçamento, nos layouts de grade e nos pontos de navegação. Por exemplo, barras de cabeçalho mantêm altura constante, botões principais preservam tamanho e alinhamento uniformes, e blocos de conteúdo seguem uma ordem visual previsível. Isso é alcançado por meio de um processo de regularização de layout que avalia cada tela com base em restrições estruturais globais. Se uma tela se desviar dos modelos aprendidos—como preenchimento inconsistente ou títulos desalinhados—o sistema ajusta automaticamente o layout para restaurar a coerência. Essas correções ajudam a garantir uma experiência de usuário contínua e reduzem os custos cognitivos de troca entre telas. A estrutura analisa ainda o grafo de navegação entre telas para manter a consistência no fluxo de interação. Padrões comuns de navegação, incluindo transições para frente/para trás, navegação por abas e fluxos de trabalho em etapas múltiplas, são identificados e aplicados. Cada transição é validada para assegurar alinhamento com o modelo mental do usuário, melhorando assim a usabilidade e reduzindo a confusão. Como resultado, o modelo de consistência multitetela minimiza o ruído visual, aumenta a familiaridade e promove uma experiência de interação unificada.
Formulações matemáticas detalhadas para a consistência entre telas múltiplas e a geração de interface de usuário são fornecidas no Arquivo Suplementar 1.
Por fim, o mecanismo de renderização gera saídas visuais em formatos como estruturas vetoriais SVG, protótipos em HTML/CSS ou maquetes de interface baseadas em pixels. As telas de interface resultantes exibem ordem correta de leitura, relações harmônicas de cores, alinhamento preciso à grade e hierarquia visual consistente entre múltiplas telas.
Algoritmo S3 fornece a otimização do layout cognitivo-visual e o fluxo de trabalho de consistência entre telas (Arquivo Suplementar 1). O Algoritmo S3 descreve o processo integrado de otimização cognitiva e estrutural utilizado para gerar layouts de interface de usuário fáceis de usar. Ele combina agrupamento perceptual (princípios da Gestalt), eficiência de interação (lei de Fitts) e simplicidade de decisão (lei de Hick) dentro de um quadro unificado de otimização. Inicialmente, as relações espaciais entre os componentes são avaliadas para estabelecer agrupamentos perceptuais. Em seguida, a eficiência de interação é otimizada ajustando o tamanho e o posicionamento dos componentes, enquanto a complexidade de decisão é controlada limitando o número de opções apresentadas aos usuários. Além disso, o algoritmo garante a consistência entre telas alinhando cada tela aos modelos de layout aprendidos, assegurando uniformidade na tipografia, espaçamento e organização estrutural. Uma função de otimização multiobjetivo então aperfeiçoa o layout equilibrando alinhamento, espaçamento e custo cognitivo, resultando em uma interface que é ao mesmo tempo visualmente coerente e cognitivamente eficiente. No geral, este algoritmo assegura que os layouts multiscreen gerados mantenham altos níveis de consistência visual, usabilidade e clareza perceptual.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
A estrutura automatizada de prototipagem de interface foi avaliada usando um conjunto de dados integrado de 5.128 telas de interface provenientes de três fontes: 4.000 imagens do RICO, 1.000 telas do ENRICO e 128 amostras de interfaces anotadas por cores do Conjunto de Dados de Cores de Interface de Guo. Esse conjunto de dados combinado fornece um benchmark bem equilibrado para avaliar a precisão na detecção de componentes, a clareza estrutural do layout, a consistência entre telas e a harmonia perceptual das cores.
...Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Os resultados demonstram melhorias estatisticamente significativas na usabilidade, organização estrutural e qualidade perceptual (p < 0,05), confirmando a eficácia da incorporação de princípios de design cognitivo na prototipagem automatizada de interfaces. Diferentemente dos sistemas tradicionais de geração de interfaces, que dependem principalmente de detecção visual ou heurísticas baseadas em regras, a estrutura proposta integra agrupamento gestáltico, modelagem de hierarquia, restrições de espaçamento e legibilid...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm conflitos de interesse.
Agradecimentos
Os autores agradecem o apoio acadêmico e institucional fornecido pelo Colégio de Línguas Estrangeiras de Wuhan & Relações Internacionais, Universidade Keimyung e Instituto de Comércio e Línguas Estrangeiras de Xangai durante a realização desta pesquisa.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| CPU (Processador) | AMD Ryzen 9 7950X (16 núcleos, 32 threads, 4,5–5,7 GHz) | Advanced Micro Devices (AMD), EUA | Ryzen 9 7950X |
| CUDA Toolkit | Versão 11.8 | NVIDIA Corporation, EUA | CUDA Toolkit 11.8 |
| cuDNN | Versão 8.9 | NVIDIA Corporation, EUA | cuDNN v8.9 |
| Faster R-CNN | Modelo de Detecção de Objetos (com Rede de Proposta de Região) | Pesquisa da Meta AI / Detectron2 | Framework Detectron2 |
| Matplotlib | Versão 3.7 | Equipe de Desenvolvimento do Matplotlib | v3.7.0 |
| GPU NVIDIA RTX 4090 | Placa de vídeo de 24 GB GDDR6X | NVIDIA Corporation, Santa Clara, CA, EUA | RTX 4090 |
| NumPy | Versão 1.24 | Desenvolvedores do NumPy | v1.24.0 |
| OpenCV | Versão 4.8 | Fundação OpenCV | v4.8.0 |
| PyTorch | Versão 2.0 | Fundação PyTorch (Meta AI) | v2.0.0 |
| ResNet-50 com FPN | CNN de base com Rede de Pirâmide de Características | Pesquisa da Microsoft / Detectron2 | ResNet-50-FPN |
| Scikit-learn | Versão 1.3 | Desenvolvedores do Scikit-learn | v1.3.0 |
| SciPy | Versão 1.10 | Comunidade SciPy | v1.10.0 |
| Memória do Sistema (RAM) | 64 GB DDR5 | Corsair / Kingston (ou equivalente) | Kit DDR5 64 GB |
| Sistema Operacional Ubuntu | Versão 22.04 LTS | Canonical Ltd., Reino Unido | Ubuntu 22.04 LTS |
Referências
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.