Este protocolo descreve o desenvolvimento e avaliação de um chatbot de geração aumentada baseada em diretrizes de recuperação, que recupera e resume conteúdos de diretrizes clínicas de prática oncênica baseadas na web para gerar respostas baseadas em referências às dúvidas dos usuários.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Desenvolvimento de um chatbot de geração aumentada baseada em diretrizes de recuperação, referenciando diretrizes clínicas de prática clínica de câncer baseadas na web
Neste artigo
Resumo
Resumo
A ampla disponibilidade de informações médicas na Internet melhorou o acesso ao conhecimento relacionado à saúde para os pacientes; No entanto, também aumentou a exposição a informações médicas imprecisas. O cuidado oncológico envolve informações complexas, dificultando para os pacientes identificarem fontes precisas e baseadas em evidências. Grandes modelos de linguagem possibilitam interação com linguagem natural, mas frequentemente geram alucinações, limitando sua aplicação na entrega de informações médicas. A geração aumentada por recuperação (RAG) tem o potencial de mitigar esses riscos ao fundamentar as respostas em fontes de referência externas. Este estudo descreve o desenvolvimento e avaliação de um chatbot RAG baseado em diretrizes que utiliza diretrizes de prática clínica de câncer disponíveis publicamente e baseadas na web. O sistema extrai URLs das páginas de sumário de uma diretriz, processa o texto das páginas usando análise morfológica e similaridade cosseno com base na frequência de termos–frequência inversa do documento, e constrói informações de referência a partir de páginas altamente relevantes. Um grande modelo de linguagem usa essas referências para gerar respostas restritas a conteúdo de diretrizes. O Guia do JLCS para Pacientes e Famílias com Câncer de Pulmão foi usado como referência diretriz. Os conjuntos de questões incluíam tanto tipos de câncer dentro do escopo cobertos pela diretriz quanto tipos de câncer fora do escopo para avaliar o controle da resposta. Informações médicas foram extraídas com sucesso das páginas de sumário, com 98% dos URLs extraídos contendo conteúdo médico referencial. Para perguntas dentro do escopo, o chatbot gerou respostas resumindo o conteúdo das diretrizes, e nenhuma alucinação foi identificada durante a revisão manual sob as condições de teste definidas. Para perguntas fora do escopo, o chatbot consistentemente se recusou a responder e indicou que as informações disponíveis eram insuficientes. A estrutura web da diretriz facilitou a extração eficiente e a organização do conteúdo de referência no nível da URL. Esse protocolo fornece orientações práticas para construir sistemas de inteligência artificial que fornecem informações médicas utilizando diretrizes de prática clínica baseadas na web.
Introdução
O uso generalizado da internet e das redes sociais facilitou o acesso dos pacientes às informaçõesmédicas 1,2. As informações sobre o cuidado do câncer são frequentemente complexas e extensas, tornando particularmente difícil para os pacientes identificarem fontes precisas, relevantes e baseadas em evidênciascientíficas 3. Embora os recursos online possam ajudar na compreensão do paciente, eles também contêm uma quantidade substancial de informações médicasincorretas 3, o que pode afetar negativamente as decisões dos pacientes sobre seu cuidado4. Como a desinformação relacionada ao câncer pode afetar os desfechos dos pacientes5, há uma necessidade crescente de sistemas de inteligência artificial (IA) que possam ajudar usuários individuais a buscar, resumir e interpretar informaçõesmédicas 6.
Grandes modelos de linguagem (LLMs) permitem que os usuários acessem informações por meio de conversas em linguagemnatural 7; No entanto, a geração de desinformação (ou seja, alucinações) continua sendo uma preocupação séria no campomédico 8,9,10,11. Uma fonte chave de desinformação é a qualidade e precisão dos dados de treinamento usados para desenvolver o chatbot. Além disso, a natureza estática do treinamento de modelos significa que o conhecimento pode se tornar desatualizado com o tempo, limitando a capacidade dos LLMs de fornecer informações atuais e contextualmenteapropriadas 12,13. Essas limitações destacam a importância de estratégias eficazes de gestão do conhecimento para garantir que as respostas dos chatbots permaneçam precisas, relevantes e atualizadas. Em particular, sistemas que possam acessar e referenciar facilmente recursos atuais baseados em evidências, como diretrizes de prática clínica, são desejáveis em ambientes médicos, onde recomendações e padrões de cuidado evoluem continuamente. Para enfrentar esse desafio, a geração aumentada por recuperação (RAG), que gera respostas incorporando informações de fontes externas de conhecimento, tem recebido atenção crescente 10,13,14,15,16,17.
Embora o RAG tenha sido cada vez mais aplicado a chatbots médicos, pouca atenção tem sido dada a como as diretrizes de prática clínica devem ser incorporadas sistematicamente como fontes de informaçãode referência 18. Muitas diretrizes de prática clínica estão disponíveis publicamente na web; no entanto, ainda não está claro se a estrutura web existente pode servir diretamente como uma estrutura de recuperação para os sistemasRAG 18. Além disso, métodos práticos para construir informações de referência sem desenvolvimento manual de base de conhecimento ainda não foram bem estabelecidos.
Neste estudo, nosso objetivo foi estabelecer princípios de design para sistemas de IA de referência de diretrizes na área médica, desenvolvendo e avaliando um chatbot RAG baseado em diretrizes que utilize diretrizes clínicas de prática clínica de câncer disponíveis publicamente na web, permitindo assim acesso simples e oportuno a informações baseadas em diretrizes. Como prova de conceito, avaliamos a viabilidade técnica da recuperação de diretrizes, geração de resposta e restrição de resposta utilizando a estrutura web existente das diretrizes de prática clínica públicas disponíveis, com o objetivo de propor um protocolo de desenvolvimento reproduzível para sistemas RAG referenciados por diretrizes.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo não envolve sujeitos humanos que necessitam de proteção contra riscos envolvidos na pesquisa. Portanto, não exige revisão por um conselho institucional de revisão, de acordo com as diretrizes éticas japonesas para pesquisa médica envolvendo sujeitoshumanos 19. Este estudo é relatado de acordo com as diretrizes TRIPOD-LLM (Relatório Transparente de um Modelo Multivariável para Prognóstico ou Diagnóstico Individual)(TRIPOD) 20.
Consulte a Figura 1 para uma visão geral esquemática do protocolo de chatbot RAG baseado em diretrizes.
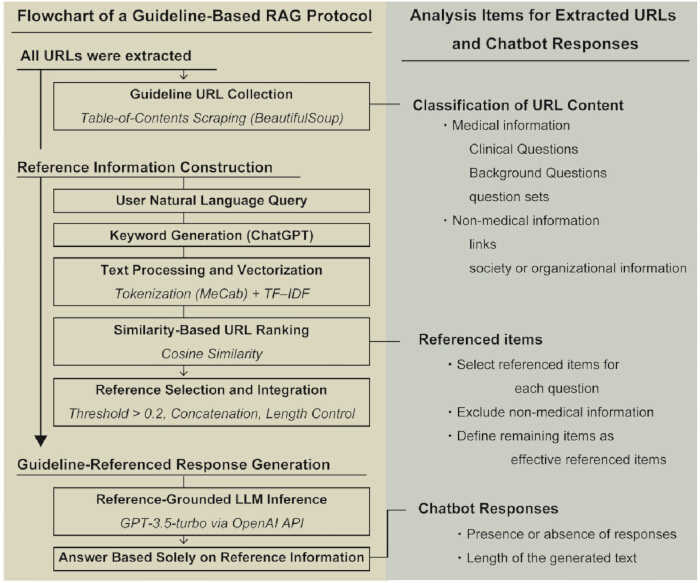
Figura 1. Fluxo de trabalho do protocolo de Geração Aumentada de Recuperação Baseada em Diretrizes (RAG ). Visão esquemática do fluxo de trabalho de chatbot RAG baseado em diretrizes. URLs são extraídas da página de sumário de uma diretriz de prática clínica baseada na web e usadas para construir informações de referência. As consultas dos usuários são convertidas em palavras-chave, e o conteúdo da página web é processado por meio de tokenização, vetorização frequência de termos–frequência inversa do documento e análise de similaridade cosseno para identificar páginas de diretrizes relevantes. Informações de referência selecionadas são integradas e fornecidas a um grande modelo de linguagem para gerar respostas baseadas exclusivamente no conteúdo da diretriz referenciada. O painel à direita resume os itens de avaliação usados para URLs extraídas, informações de referência e respostas de chatbots. Por favor, clique aqui para ver uma versão ampliada desta figura.
1. Preparação de Informações de Referência a partir de Diretrizes Baseadas na Web
- Extraia todas as URLs das páginas de índice das diretrizes de prática clínica baseadas na web usando o BeautifulSoup 4 (biblioteca de análise sintática HTML) implementado na linguagem de programação Python (versão 3.12).
NOTA: Implemente o script de extração de URL usando a linguagem de programação com os seguintes pacotes: biblioteca de análise sintática HTML (versão 4.12.3) e requisições (biblioteca de recuperação de páginas; versão 2.32.3). Instale pacotes usando pip. O código-fonte completo para extração de URL é fornecido no Arquivo Suplementar 1. Consulte a Tabela de Materiais para detalhes do software. - Revise manualmente todas as URLs extraídas para confirmar o acesso bem-sucedido e a relevância para a diretriz de prática clínica alvo.
- Classifique cada URL como contendo informações médicas ou não médicas. Realize a classificação de URL por um autor (S.N.).
NOTA: Informações médicas foram definidas como conteúdo referencial de diretrizes, incluindo perguntas clínicas (CQs), perguntas de contexto e conjuntos de perguntas. Informações não médicas incluíam links, páginas de sociedades ou organizações e outros conteúdos auxiliares que não eram adequados para referência. - Compile as URLs validadas em um livro de exercícios do Microsoft Excel (formato .xlsx), com uma URL registrada por linha. Armazene a lista de URLs resultante como o conjunto de dados de entrada para recuperação de texto subsequente, pré-processamento e análises de similaridade.
2. Geração de palavras-chave a partir de consultas de usuários
- Insira a consulta em linguagem natural no ChatGPT (Generative Pre-trained Transformer, versão 4o; modelo de geração de palavras-chave).
- Peça ao modelo para extrair duas palavras-chave correspondentes à consulta do usuário.
- Use o seguinte prompt, escrito em japonês, para geração de palavras-chave:
"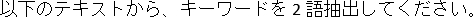 "
(Tradução em inglês: "Extraia duas palavras-chave do texto a seguir.") - Anexe a consulta de linguagem natural do usuário a essa instrução e submeta ao modelo de geração de palavras-chave para geração de palavras-chave.
- Não modifique manualmente nenhum parâmetro do modelo. Realize a geração de palavras-chave usando as configurações padrão do modelo de geração de palavras-chave.
- Gerar duas palavras-chave para cada consulta de usuário. Mantenha ambas as palavras-chave sem modificações, filtros ou seleção manual adicionais, e utilize-as para cálculos subsequentes de similaridade.
- Armazene as palavras-chave geradas em um livro de exercícios do Microsoft Excel (formato .xlsx). Para cada registro, armazene a consulta original do usuário e suas respectivas palavras-chave geradas para recuperação subsequente baseada em similaridade.
3. Processamento de Texto e Cálculo de Similaridade
- Recupere o texto completo de cada URL extraída usando a biblioteca de recuperação da página web e a biblioteca de análise sintática HTML. Extraia o conteúdo de texto da fonte HTML usando a função BeautifulSoup get_text().
- Pré-processe o texto extraído da página web e as palavras-chave geradas removendo tags HTML e caracteres não japoneses.
- Realizar análise morfológica japonesa usando MeCab (versão 0.996; Analisador morfológico japonês) com o dicionário padrão. Mantenha apenas substantivos e concatene-os em uma cadeia de texto delimitada por espaço.
- Combine as palavras-chave geradas em uma única string de texto e aplique os mesmos procedimentos de pré-processamento e tokenização usados para o texto da página web.
- Gerar vetores frequência–frequência inversa de documento (TF–IDF) a partir do texto processado da página web e do texto das palavras-chave usando a implementação TfidfVectorizer na biblioteca scikit-learn (versão 1.6.1) com configurações padrão de parâmetros.
NOTA: Todos os parâmetros do TfidfVectorizer foram mantidos em seus valores padrão, e nenhuma configuração personalizada de parâmetros foi aplicada. - Calcule a semelhança cosseno entre cada vetor de página web e o vetor de palavra-chave usando a função de similaridade cosseno.
- Classifice URLs em ordem decrescente de acordo com as pontuações de similaridade cosseno. Não aplique critérios adicionais de desempate.
- Selecione páginas com pontuação de similaridade cosseno de ≥0,2 como informações de referência candidata.
NOTA: O limiar de similaridade cosseno (0,2) foi selecionado empiricamente durante o desenvolvimento do sistema para priorizar a recuperação e evitar excluir conteúdos de diretrizes potencialmente relevantes. - Mantenha todas as páginas de candidatos que atendam ao limite de similaridade.
4. Construção das Informações de Referência
- Extraia sequencialmente o conteúdo do texto das páginas selecionadas do topo da lista ranqueada.
- Concatene os textos extraídos para formar um único documento de referência.
- Antes de submeter ao LLM, substitua os caracteres de nova linha e os caracteres consecutivos de espaço em branco no texto de referência por um único espaço.
- Trunque o texto de referência concatenado para os primeiros 4.096 caracteres antes de fornecê-lo ao LLM.
NOTA: O limite de truncamento era baseado em caracteres, e não em fichas. Um limite de 4.096 caracteres foi selecionado empiricamente para garantir que a informação combinada de prompt e referência permanecesse dentro da capacidade de entrada do modelo de geração de resposta GPT-3.5-turbo-16k.
5. Geração de Respostas Baseada em IA
- Forneça as informações de referência construídas e a consulta original do usuário ao modelo de geração de resposta via interface de programação de aplicações (API).
- Instrua a IA usando o seguinte prompt (escrito inteiramente em japonês) para garantir que as respostas sejam geradas exclusivamente com base nas informações de referência fornecidas:
"Você é um assistente de informação médica que orienta pacientes com câncer. Gere respostas baseadas apenas nas seguintes informações de referência e não use seu próprio conhecimento geral ou raciocínio. As respostas devem ser detalhadas e fáceis de entender, com aproximadamente 500 caracteres de extensão. Se a informação de referência não contiver informações suficientes para responder à pergunta, responda: 'Não há informação suficiente no texto', sem usar qualquer especulação ou conhecimento geral." - Forneça as informações de referência e a consulta do usuário em uma única mensagem de usuário. Estruture a entrada como: "Informação de Referência: [texto de referência]" seguido de "Pergunta: [consulta do usuário]".
- Gerar respostas usando o modelo de geração de respostas com as seguintes configurações: temperatura = 0,1, comprimento máximo de saída = 1.024 tokens, n = 1 e stop = Nenhum.
- Obtenha a resposta gerada por IA para avaliação posterior.
NOTA: Envie as informações de referência e a consulta do usuário como uma única mensagem de usuário. Forneça as instruções de geração de resposta separadamente como uma mensagem do sistema.
6. Diretrizes de Referência e Formulação de Perguntas
- Selecione o Guia JLCS para Pacientes e Famílias com Câncer de Pulmão (Lung Guidebook)21, que está disponível gratuitamente online, como informação de referência para o sistema de chatbot RAG baseado em diretrizes.
- Crie duas categorias de perguntas de avaliação baseadas no tipo de câncer: tumores tímicos, que estão dentro do escopo da diretriz, e glioma pediátrico, que está fora do escopo das informações referenciadas.
- Formule quatro perguntas sobre diagnóstico e tratamento para cada tipo de câncer:
"Quais métodos diagnósticos estão disponíveis para tumores XX (por exemplo, glioma tímico ou pediátrico)?"
"Quais são as abordagens diagnósticas patológicas para tumores XX?"
"Quais opções de tratamento estão disponíveis para tumores XX?"
"Quais são as opções de tratamento cirúrgico para tumores XX?" - Envie perguntas relacionadas aos tipos de câncer cobertos pela diretriz web referenciada para o chatbot. Por exemplo, envie uma pergunta sobre diagnóstico de tumor tímico usando o Guia do Pulmão como informação de referência.
- Envie perguntas fora do escopo da diretriz de referência ao chatbot para avaliar sua capacidade de se abster de usar informações externas ou não relacionadas. Por exemplo, envie uma pergunta sobre glioma pediátrico usando o Guia do Pulmão como informação de referência.
- Avalie cada pergunta em uma sessão de chat independente. Não carregue o histórico de conversa entre as perguntas.
- Registre as respostas geradas pela IA para avaliação subsequente.
7. Avaliação de Resposta
- Realize uma revisão manual de todas as respostas geradas.
- Avalie se cada resposta contém alucinações.
- Avalie se cada resposta é apoiada por informações contidas na diretriz de referência.
NOTA: Alucinações foram definidas como respostas contendo eventos, nomes ou termos inexistentes que poderiam potencialmente causar danos médicos14. Todas as respostas geradas foram revisadas quanto à precisão e ausência de alucinações por um autor com 8 anos de experiência em um hospital universitário, incluindo suporte ao paciente e comunicação médica para pacientes com câncer. Qualquer incerteza sobre a classificação da resposta foi resolvida por meio de uma discussão com um médico coautor com mais de 20 anos de experiência em serviços de informação sobre câncer no Centro Nacional de Câncer do Japão. - Considere uma resposta como sendo apoiada apenas quando todas as afirmações clinicamente relevantes podem ser confirmadas diretamente a partir da diretriz de referência recuperada, sem exigir conhecimento adicional ou inferência não fundamentada.
- Classifique cada resposta usando rótulos de resultado pré-definidos. Classifique respostas contendo apenas informações apoiadas pela diretriz de referência como "alucinação ausente". Classifique respostas contendo informações não fundamentadas ou fabricadas como "alucinações presentes".
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Recuperação de Conteúdo Médico por Páginas de Índice
A arquitetura de raspagem web coletava URLs da página de índice da diretriz. Do Lung Guidebook, 106 URLs foram extraídas da página de sumário, das quais 104 (98%) continham informações médicas (Tabela Suplementar 1). A eficácia das respostas do chatbot com base nas páginas de conteúdo das diretrizes é resumida na Tabela 1. O chatbot gerou respostas para toda...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Neste estudo, examinamos a utilidade de um chatbot RAG baseado em diretrizes que utilizava uma diretriz de prática clínica baseada na web — o Guia JLCS para Pacientes e Famílias com Câncer de Pulmão — como fonte de informação de referência. O chatbot gerava respostas baseadas no conteúdo da diretriz, explorando a estrutura web da diretriz e recuperando páginas com base em sua semelhança com as consultas dos usuários. Essa abordagem demonstrou que a recuperação baseada em similaridade, co...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram não haver interesses concorrentes.
Agradecimentos
Os autores agradecem a Kenichi Inoue, MD, PhD (Shonan Memorial Hospital Breast Center), por seu extenso suporte técnico no desenvolvimento do chatbot de geração aumentada baseada em orientações. Os autores também agradecem a Chikako Yamaki, PhD, e a todos os membros da equipe de pesquisa do Instituto de Controle do Câncer, Centro Nacional de Câncer do Japão (Tóquio, Japão), por fornecer conselhos valiosos sobre o tema abordado neste artigo. Além disso, os autores agradecem à Editage pela edição em inglês. Esse trabalho foi apoiado por uma Bolsa de Pesquisa em Ciências da Saúde e do Trabalho (R6–Controle do Câncer–23EA1026).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
```html
```
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Beautiful Soup 4 (versão 4.12.3) | Beautiful Soup Project | N/A | Biblioteca Python usada para extração de URL e análise de HTML |
| ChatGPT versão 4o | OpenAI | N/A | Usado para geração de palavras-chave |
| GPT-3.5-turbo | OpenAI | N/A | Usado para geração de resposta |
| Guia JLCS para Pacientes e Familiares com Câncer de Pulmão | Sociedade Japonesa de Câncer de Pulmão | N/A | Diretriz de prática clínica baseada na web usada como informação de referência |
| MeCab (versão 0.996) | Projeto MeCab | N/A | Analisador morfológico japonês |
| OpenAI API | OpenAI | N/A | Usado para geração de resposta baseada em IA |
| Python (versão 3.12) | Fundação de Software Python | N/A | Ambiente de programação |
| Requests (versão 2.32.3) | Projeto Requests | N/A | Biblioteca Python usada para recuperação de páginas da web |
| scikit-learn (versão 1.6.1) | Desenvolvedores scikit-learn | N/A | Usado para vetorização TF–IDF e cálculo de similaridade cosine. |
| urllib.parse | Fundação de Software Python | N/A | Biblioteca Python usada para normalização e junção de URL |
Referências
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.