O trabalho propõe um framework de análise multimodal de emoções de ponta a ponta que utiliza codificadores transformer, representações de emoções desacopladas e atenção intermodal baseada em grafos com mapeamento visual para melhorar a precisão do reconhecimento de emoções em dois conjuntos de dados.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Mapeamento Visual de Características Multimodais de Emoção para o Design de Interação Inteligente
Neste artigo
Resumo
Resumo
Ao permitir que máquinas compreendam, interpretem e reajam aos estados afetivos humanos, o mapeamento visual de traços emocionais multimodais é crucial para o design de interfaces inteligentes. No entanto, os algoritmos atuais de detecção emocional multimodal concentram-se principalmente no desempenho preditivo, oferecendo pouca compreensão sobre interpretabilidade, percepção de interação ou interações cruzadas entre modalidades em nível de características. Este trabalho apresentou uma estrutura para o mapeamento visual de aspectos emocionais multimodais que combina visualização orientada à interação, aprendizado de representações interpretáveis e predição emocional. Sem utilizar características criadas manualmente, codificadores baseados em transformadores foram usados para extrair incorporações emocionais de alto nível a partir de modalidades textual, de áudio e visual. Para melhorar a robustez, informações específicas da emoção e específicas da modalidade foram separadas por meio de uma técnica de aprendizado de representação desacoplada. Além disso, foi criada uma rede de atenção cruzada baseada em grafos para simular, por meio de ponderação adaptativa de atenção, relações emocionais sutis entre modalidades. Um módulo de mapeamento visual multivisão foi desenvolvido para representar trajetórias emocionais temporais, distribuições de atenção cruzada entre modalidades e incorporações emocionais latentes, a fim de aumentar a transparência. O conjunto de dados Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) e o conjunto de dados chinês de análise de sentimento multimodal (CH-SIMS) foram utilizados para avaliar a estrutura proposta. De acordo com os resultados experimentais, a estrutura sugerida proporcionou maior interpretabilidade em nível de características e visualização com percepção de interação, superando consistentemente técnicas de referência representativas em termos de acurácia, pontuação F1, correlação e erro absoluto médio. Além disso, o módulo de mapeamento visual facilitou a interpretação qualitativa de representações emocionais multimodais, interações cruzadas entre modalidades e dinâmicas emocionais temporais, apoiando a visualização e análise com percepção de interação.
Introdução
A capacidade de identificar e compreender corretamente a emoção humana tornou-se crucial para melhorar a interação entre humanos e máquinas. Além de ser essencial para aprimorar a interação humano-computador, a análise de emoções tem o potencial de revolucionar diversas áreas, incluindo diagnóstico médico pré-diagnóstico1, análise comportamental em sala de aula2, acompanhamento psicológico de pacientes3, identificação de fadiga em veículos4 e gerenciamento inteligente em ambientes domésticos inteligentes5. Avanços recentes na computação afetiva e no aprendizado profundo6 aumentaram o interesse na criação de sistemas em tempo real capazes de capturar a complexidade da emoção humana.
Muitos métodos atuais baseiam-se principalmente em dados unimodais, como sinais textuais, gráficos ou auditivos7,8,9Essas abordagens falham repetidamente em detectar sinais refinados, como sarcasmo ou nuances específicas do contexto. A pesquisa avançou para a avaliação multimodal de emoções, que incorpora dados complementares de múltiplas fontes para superar essas limitações.10,11,12. As vantagens de combinar múltiplas modalidades foram demonstradas por modelos de referência, como a fusão precoce com memória de longo e curto prazo (EF-LSTM)13 e redes neurais profundas leves e FM (LF-DNN)14, redes de fusão tensorial (TFN) e abordagens de fusão multimodal de baixa ordem. No entanto, a maioria dessas abordagens depende da geração offline de características e não é adequada para situações dinâmicas do mundo real.
Para acomodar os estados emocionais, a pesquisa e as aplicações em identificação multimodal de emoções têm crescido nos últimos dez anos15. Uma das áreas de pesquisa mais desafiadoras e significativas atualmente é o monitoramento contínuo de estados emocionais utilizando diversas fontes de dados16. A ideia de multimodalidade surgiu de forma bastante natural com o surgimento de um sistema de conhecimento tão variado, levando a muitos avanços na aplicação das emoções em áreas como computação emocional, interação humano-computador (HCI), aprendizagem, videogames, atendimento ao consumidor, cuidados médicos, avaliação de experiência do usuário (UX), etc. No entanto, nem sempre tem sido simples aplicar técnicas de reconhecimento de emoções na avaliação de experiência do usuário.
Uma das principais razões para focar no reconhecimento multimodal em vez de métodos unimodais são as desvantagens inerentes de depender de uma única fonte de informação. Sistemas de detecção de emoções unimodais podem apresentar menor precisão devido a dados ausentes ou ambíguos, enquanto os esquemas de MER são mais confiáveis e oferecem uma compreensão mais abrangente e elaborada dos estados expressivos ao integrar múltiplas fontes de dados17. Por exemplo, a linguagem facial isoladamente pode não ser suficiente para classificar com precisão os sentimentos, especialmente quando os gestos são complexos ou pouco claros. No entanto, combinar expressões faciais com outras formas de comunicação, como linguagem ou pistas físicas, pode aumentar a precisão no reconhecimento de sentimentos.
Pesquisas extensivas sobre reconhecimento de emoções foram conduzidas em várias modalidades. Estudos iniciais concentraram-se na identificação de características distintivas de diferentes modalidades, como entradas gráficas, acústicas ou baseadas em texto. Embora esteja se tornando cada vez mais evidente que a integração de diversas modalidades pode fornecer informações emocionais equilibradas, levando à detecção de sentimentos mais confiável e precisa. Este segmento revisa os principais avanços na análise de emoções unimodal e multimodal, com foco em abordagens básicas, suas limitações e a justificativa para o nosso método.
O estudo inicial sobre reconhecimento de emoções concentrou-se principalmente em uma única modalidade. Na área visual, pesquisas pioneiras levaram à categorização de movimentos faciais prototípicos20. Avanços subsequentes incluíram técnicas para capturar dinâmicas temporais, como movimento visual21 e modelos ocultos de Markov22, enquanto as respostas faciais foram divididas em unidades de ação utilizando o Sistema de Codificação de Ação Facial (FACS)23. LSTMs e redes neurais convolucionais (CNNs) têm sido usados com sucesso para extrair características significativas diretamente de sinais de áudio brutos; as metodologias para identificação de emoções baseadas em áudio evoluíram do processamento convencional de sinais até o aprendizado profundo24. A extração de sinais de sentimento contextual em análises de emoção baseadas em texto foi grandemente aprimorada por redes neurais recorrentes (RNNs) que incorporam mecanismos de atenção e, mais recentemente, por modelos baseados em transformadores. Apesar de seus avanços, técnicas unimodais são intrinsecamente incapazes de representar com precisão as complexidades que as pessoas experimentam, pois carecem das informações complementares presentes em outras modalidades.
Alguns modelos baseados em mecanismos de atenção, como o modelo DialogXL²⁵, foram propostos em 2021 para coletar dados ambientais de longo prazo na área de identificação de sentimentos em conversas. Kim et al.26 introduziu o modelo EmoBERTa em 2021 para aumentar a precisão da ERC. Este modelo utiliza dados dos falantes para melhorar as características dos interlocutores nas conversas e suas interações mútuas. Em 2022, Li et al.27 apresentou o método CoG-BART. A organização utiliza aprendizado contrastivo supervisionado para melhorar a capacidade do modelo de interpretar dados relevantes. Deve-se observar que o aprendizado supervisionado requer uma quantidade substancial de dados rotulados.
Um exemplo típico desse tipo de trabalho é o framework de Representação com Percepção Multimodal de Interação (MIAR)28, que utiliza tokens de interação de características e alinhamento contrastivo para melhorar a generalização entre modalidades. O MIAR aprimora o alinhamento entre modalidades e alcança um desempenho robusto em diversos conjuntos de dados; no entanto, ele se concentra principalmente na precisão preditiva, sem abordar o mapeamento visual. De forma semelhante, o modelo de Fusão Áudio-Visual com Attenção Cruzada29 capta efetivamente interações áudio-visuais de grão fino para a predição de valência e arousal, mas está limitado a duas modalidades e carece de capacidades de visualização. Abordagens de modelagem temporal baseadas em redes LSTM e fusão por autoencoder capturam com sucesso a dinâmica temporal das emoções, mas fornecem pouca compreensão sobre as interações entre modalidades e as representações emocionais aprendidas. Mais recentemente, métodos baseados em transformadores, como a Transformer-based Multimodal Fusion Network (TMFN)30 demonstraram alto desempenho em CMU-MOSI e CMU-MOSEI por meio de fusão multimodal aprimorada e aprendizado contrastivo. No entanto, essas abordagens permanecem principalmente orientadas ao desempenho e oferecem suporte limitado à explicabilidade, interpretação em nível de características e visualização orientada à interação.
Para aprimorar a integração de dados textuais, acústicos e visuais, diversas técnicas de reconhecimento multimodal de emoções foram propostas. Embora não tenham conseguido capturar interações intrincadas entre modalidades, técnicas de fusão inicial, como EF-LSTM e LF-DNN, demonstraram as vantagens do uso de informações multimodais para análise de sentimento e emoção. Embora o TFN tenha melhorado o desempenho em conjuntos de dados de referência como CMU-MOSI e CMU-MOSEI e introduzido modelagem explícita de interações intermodais, sua baixa interpretabilidade e alta complexidade computacional limitaram sua utilidade. Para melhorar o alinhamento entre modalidades e a fusão dinâmica de características, técnicas mais modernas, como MIAR, modelos de fusão com atenção cruzada, TMFN e transformadores multimodais adaptativos, têm utilizado topologias de transformadores e mecanismos de atenção. Esses métodos concentraram-se principalmente no desempenho preditivo, oferecendo pouca compreensão sobre representações emocionais em nível de características e dependências intermodais, apesar de alcançarem resultados competitivos em métricas de avaliação comuns, como acurácia, pontuação F1 e erro absoluto médio. Além disso, poucos estudos desenvolveram técnicas de visualização capazes de revelar incorporações latentes de emoções, distribuições de atenção e dinâmicas temporais de emoção, ou que tenham integrado modelagem baseada em grafos para interações intermodais. A abordagem proposta incorpora mapeamento visual multivisão, fusão de atenção intermodal baseada em grafos e aprendizado de representações desacopladas para superar essas limitações e aprimorar o desempenho no reconhecimento multimodal de emoções.
Da mesma forma, o Transformador Multimodal Adaptativo32 propõe uma fusão baseada em troca para mitigar de forma adaptativa informações modais ruidosas ou ausentes, aumentando assim o desempenho na classificação de sentimentos. Embora esta abordagem possa lidar eficazmente com discrepâncias na distribuição das informações modais, seu design é específico para análise de sentimentos e fornece pouca compreensão sobre as representações emocionais aprendidas. Outra contribuição significativa é o Modelo de Fusão Multimodal33, que integra CNNs, LSTMs multiplicativos e atenção baseada em transformador para reconhecimento multimodal em tempo real de emoções. O modelo realiza fusão completa nas modalidades de vídeo, áudio e texto e demonstra desempenho robusto no reconhecimento. No entanto, como outros modelos existentes, ele se concentra principalmente na precisão preditiva e carece de características explícitas para visualização e interpretabilidade orientada à interação.
Em conclusão, embora as atuais abordagens multimodais de última geração para reconhecimento de emoções tenham obtido sucesso considerável ao capturar interações intermodais e aprimorar a precisão das previsões, a maioria delas concentra-se em tarefas orientadas ao reconhecimento. As áreas de interpretabilidade em nível de características, visualização de representações emocionais no espaço da imagem e incorporação da estrutura proposta ao design de interação inteligente receberam pouca atenção. É com esses desafios em mente que a estrutura proposta é apresentada.
A maioria dos métodos atuais concentra-se principalmente em melhorar o desempenho preditivo, oferecendo pouca interpretabilidade das representações emocionais aprendidas e das interações cruzadas entre modalidades, apesar dos avanços notáveis no reconhecimento multimodal de emoções28,29. Interações complexas entre modalidades textuais, acústicas e visuais frequentemente são difíceis de modelar para as estratégias atuais de fusão, especialmente quando ocorrem discrepâncias entre modalidades e escassez de informações 28,31. Embora os designs baseados em transformadores e mecanismos de atenção tenham aprimorado a aprendizagem de representações, sua transparência e interpretabilidade muitas vezes são reduzidas pela ausência de separação explícita entre informações específicas da emoção e informações específicas da modalidade31,32,33. Além disso, apenas um pequeno número de estudos investigou a modelagem baseada em grafos das interações intermodais ou desenvolveu estruturas de visualização capazes de revelar dinâmicas temporais das emoções, distribuições de atenção e incorporações emocionais. Essas limitações demonstram a necessidade de uma estrutura multimodal interpretável para interação inteligente entre humanos e máquinas, que combine mapeamento visual orientado à interação com um forte aprendizado cruzado entre modalidades.
Este trabalho apresenta um framework interpretável para o mapeamento visual de aspectos multimodais de emoções no design de interfaces inteligentes. Sem a necessidade de características criadas manualmente, o sistema utiliza aprendizado profundo de ponta a ponta para extrair representações emocionais de alto nível a partir de modalidades textuais, auditivas e visuais. As interações emocionais cruzadas são modeladas por meio de um mecanismo de fusão com atenção baseado em grafos que separa informações específicas da emoção e específicas da modalidade, permitindo um aprendizado de representação desacoplado e melhorando a interpretabilidade e a robustez. Além disso, um módulo de visualização multivisão é criado para mostrar a dinâmica temporal das emoções, os padrões de atenção cruzada entre modalidades e os embeddings emocionais. A eficácia e adequação do framework proposto em sistemas inteligentes de interação humano-máquina são avaliadas por meio de validação em conjuntos de dados de referência para reconhecimento emocional multimodal.
Este trabalho oferece uma estrutura única para a mapeamento visual de aspectos multimodais de emoções que vai além das abordagens tradicionais orientadas à predição, superando a modelagem inadequada das interações cruzadas entre modalidades e a interpretabilidade limitada nos atuais sistemas de identificação de emoções multimodais. Em uma única arquitetura, a abordagem proposta combina aprendizado de representação multimodal baseado em transformadores, modelagem de características desacopladas com consciência emocional, fusão de atenção cruzada baseada em grafos e visualização orientada à interação. O framework separa claramente representações específicas da emoção e específicas da modalidade, a fim de melhorar a interpretabilidade, robustez e consistência cruzada entre modalidades, diferentemente das abordagens atuais que se concentram principalmente no desempenho de classificação. Além disso, apresenta-se um mecanismo de atenção baseado em grafos para permitir a modelagem adaptativa das interações intermodais, capturando a interdependência emocional em nível fino entre as modalidades textual, áudio e visual. Um módulo de mapeamento visual multivisão é criado para aumentar a transparência, revelando trajetórias temporais das emoções, padrões de atenção cruzada entre modalidades e incorporações latentes de emoções, que oferecem insights intuitivos sobre o processo de tomada de decisão do modelo. Além de fornecer visualização e interpretabilidade aprimoradas da dinâmica emocional multimodal, a avaliação experimental nos conjuntos de dados de referência CH-SIMS e CMU-MOSEI demonstrou desempenho competitivo em termos de acurácia, pontuação F1, erro absoluto médio e correlação.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
O trabalho proposto tem como objetivo aprimorar o design de interação inteligente ao oferecer um framework interpretável para o mapeamento visual de características emocionais multimodais. Os bancos de dados CH-SIMS e CMU-MOSEI, que são de acesso público, foram utilizados neste trabalho. Ambos os conjuntos de dados foram obtidos de suas fontes oficiais e utilizados em conformidade com as diretrizes de uso, padrões de pesquisa e termos de licenciamento estabelecidos por seus respectivos criadores. O conteúdo multimodal dos conjuntos de dados, incluindo dados de texto, áudio e vídeo, foi inicialmente coletado e anotado pelos provedores dos conjuntos de dados, conforme suas permissões autorizadas para participantes e protocolos de coleta de dados. Não houve interação humana direta, recrutamento de novos participantes nem coleta de informações pessoais identificáveis neste estudo. Todas as análises foram realizadas utilizando conjuntos de dados de pesquisa de domínio público. Consequentemente, nossa análise secundária de dados não exigiu aprovação ética adicional nem revisão por parte de uma Junta de Revisão Institucional (IRB). O estudo foi conduzido em conformidade com as normas institucionais apropriadas que regulam o uso de conjuntos de dados de acesso público, procedimentos éticos de pesquisa e políticas aplicáveis de uso de dados.
Um mecanismo de atenção cruzada baseado em grafos foi empregado para aprender caracterizações emocionais entre modalidades, utilizando características específicas de emoção ou modalidade para aprimorar a compreensão. Um componente de mapeamento visual multivisão é usado para aprimorar o design interativo com percepção emocional em tempo real, e sua eficiência é estimada para o reconhecimento de emoções. Os resultados mostram que o método proposto melhora tanto a interpretabilidade quanto a eficiência de interfaces inteligentes de usuário com percepção emocional no mundo real. Figura 1 mostra o fluxo arquitetural do trabalho proposto. Figura 1 mostra o fluxo completo do framework de mapeamento visual sugerido para aprendizado de características emocionais multimodais no contexto de sistemas interativos inteligentes. O fluxo inicia com três modalidades de entrada sincronizadas, a saber, texto, áudio e vídeo, que capturam informações emocionais complementares das modalidades linguística, prosódica e de expressão facial, respectivamente. Um codificador transformer específico à modalidade processa cada modalidade para obter representações de alto nível dos dados brutos de entrada. As representações são então inseridas em um módulo de aprendizado de representação desacoplado, no qual os embeddings específicos à emoção são separados das características específicas à modalidade, garantindo consistência nas emoções aprendidas entre fontes de dados heterogêneas. Os embeddings específicos à emoção de cada modalidade são então agregados por uma rede de atenção cruzada baseada em grafos, que modela as dependências emocionais intermodais e atribui pesos dinâmicos de importância a cada modalidade com base no contexto da interação. Por fim, o framework fornece tanto saídas de classificação emocional quanto insights de interação, o que facilita a tomada de decisões transparente com percepção emocional e o design adaptativo de interação inteligente.
Aquisição de dados multimodal
Os conjuntos de dados CH-SIMS e CMU-MOSEI são dois conjuntos multimodais de domínio público já existentes que coletaram informações multimodais, como vídeo, áudio e texto sincronizados. O conjunto de dados CH-SIMS compreende exames multimodais de pessoas chinesas, incluindo 2.281 segmentos de vídeo, derivados de múltiplos segmentos de filmes, novelas de televisão e programas de variedades. Os estudos sobre análise multimodal de emoções utilizando dados multimodais tornam-se mais envolventes e viáveis com a adição de áudio e texto correspondentes a esses segmentos de vídeo. No entanto, um dos maiores conjuntos de dados multimodais para o exame de opinião, sentimentos e emoções é o conjunto de dados CMU-MOSEI, coletado a partir de mais de 23.000 clipes de vídeo de frases proferidas por mais de 1.000 oradores sobre uma variedade de temas. O conjunto de dados foi dividido aleatoriamente em subconjuntos de treinamento (70%), validação (15%) e teste (15%), mantendo a distribuição das classes.
Transcrições textuais, sinais de áudio e quadros de vídeo são obtidos e alinhados por carimbo de tempo para coincidir em um nível temporal refinado. A integração em nível de quadro garante que os mecanismos propostos de aprendizado de representação e fusão baseada em grafos possam conjuntamente modelar e aproveitar o conteúdo emocional proveniente de expressões visuais, tons vocais e conteúdo linguístico. A extração eficaz das dinâmicas emocionais intermodais é viabilizada por esse tipo de técnica de aquisição multimodal, essencial para o design de interação inteligente e mapeamento visual compreensível.
Tabela 1 apresenta as principais estruturas dos conjuntos de dados multimodais de emoções utilizados no método proposto. Para obter uma gama mais ampla de sentimentos relacionados, como palavras faladas, entonações vocais e expressões faciais, CH-SIMS e CMU-MOSEI integram modalidades de vídeo, áudio e texto provenientes desses conjuntos de dados. Além disso, um número limitado de amostras de dados está disponível no CH-SIMS, permitindo uma análise minuciosa das interações entre modalidades e da variação emocional na China. Por outro lado, o conjunto de dados CMU-MOSEI é mais importante para avaliar a robustez dos algoritmos de aprendizado de representação e visualização relacionados abordados neste trabalho, pois contém uma grande quantidade de dados em diversos idiomas, sujeitos e níveis de emoção anotados. Adicionalmente, em comparação com pesquisas anteriores, ele reduz as dificuldades na seleção de informações durante os testes de modelos.
Pré-processamento e sincronização multimodal
As anotações de carimbo de data/hora dos conjuntos de dados CH-SIMS e CMU-MOSEI foram utilizadas para sincronizar as modalidades textual, auditiva e visual, garantindo uma aprendizagem consistente da representação multimodal. Cada enunciado funcionou como unidade fundamental de análise e foi associado a segmentos de áudio e vídeo correspondentes dentro do mesmo intervalo temporal. O alinhamento foi realizado no nível do enunciado. A transcrição foi dividida em segmentos com base nos carimbos de data/hora de início e fim de cada enunciado. A correspondência entre transcrição, áudio e vídeo foi estabelecida mediante a extração dos quadros de vídeo e sinais de áudio correspondentes que ocorreram dentro do mesmo intervalo de tempo. Enquanto os segmentos de áudio foram processados usando o Wav2Vec 2.0 para gerar representações acústicas, os quadros visuais do segmento de vídeo foram amostrados a uma taxa predeterminada e codificados usando o Vision Transformer (ViT). O codificador RoBERTa foi utilizado para criar incorporações textuais a partir das transcrições dos enunciados. A sincronização temporal foi alcançada ao alinhar todas as características das modalidades a um único limite de enunciado, já que as três modalidades produziram sequências de características de comprimentos variados. Um formato de comprimento fixo foi usado para normalizar sequências de comprimentos diferentes. Sequências mais longas foram reduzidas ao comprimento máximo permitido, enquanto sequências mais curtas foram preenchidas com zeros. Durante o treinamento, máscaras de atenção foram utilizadas para separar elementos preenchidos de posições legítimas de características. As incorporações específicas de cada modalidade foram projetadas em um espaço latente comum antes da fusão, a fim de superar os diferentes comprimentos de sequência entre as modalidades. Isso garantiu consistência dimensional e permitiu que o mecanismo de atenção baseado em grafos facilitasse a aprendizagem eficaz da interação cruzada entre modalidades. Para preservar a qualidade dos dados e a integridade da sincronização, amostras com arquivos corrompidos, anotações ausentes ou informações incompletas de modalidade foram excluídas dos estudos.
Extração de características baseada em transformador
Um método de aprendizado profundo é utilizado para aprender representações de características de alto nível com percepção emocional a partir de informações de múltiplas modalidades, como visão, áudio e texto, de maneira end-to-end, após o alinhamento dos dados multimodais e qualquer pré-processamento necessário. Ao usar um codificador transformer para aprender representações de características intrinsecamente discriminativas a partir de dados multimodais brutos, o método proposto elimina a necessidade de engenharia de características. Para facilitar a consistência entre os conjuntos de dados utilizados na abordagem proposta, um embedding de tamanho fixo é aprendido para cada modalidade. Por exemplo, embeddings de características de 768 dimensões são aprendidos em cada uma das modalidades individuais, incluindo imagens, áudio e texto, formando coletivamente um espaço de características unificado utilizado em toda a abordagem, particularmente uma abordagem de extração de características aplicada ao conjunto de dados CH-SIMS proposto e ao conjunto de dados CMU-MOSEI para aprender características de alto nível em dados de diversos tamanhos.
Modalidade visual: Transformador de visão para incorporações de quadros com reconhecimento emocional
Um modelo Vision Transformer (ViT-Base) foi utilizado para extrair informações visuais de quadros de vídeo com o objetivo de obter representações espaciais relevantes para emoções. Antes da extração de características, os quadros de cada segmento de vídeo foram redimensionados para (224 × 224) pixels e amostrados em intervalos temporais regulares. Utilizando um tamanho de patch de 16 × 16 pixels, a arquitetura ViT-Base produz uma série de tokens visuais que são processados por 12 camadas codificadoras do transformer. As representações por quadro recuperadas foram projetadas em um espaço de incorporação de 768 dimensões usando um modelo ViT pré-treinado como base visual. Os embeddings por quadro foram agregados usando pooling médio para criar a representação visual final de cada segmento. Durante o treinamento, foram utilizadas normalização de imagem e métodos comuns de aumento de dados, como recorte aleatório e inversão horizontal, para melhorar a generalização. Em seguida, o framework proposto de fusão multimodal foi usado para combinar esses embeddings visuais com representações textuais e auditivas.
Para manter a dinâmica temporal da emoção, amostras de vídeo dos conjuntos de dados CH-SIMS e CMU-MOSEI serão amostradas uniformemente para a modalidade visual. Os quadros de cada vídeo, 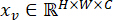 , podem ser divididos em N seções de tamanho fixo, que são então achatadas e inversamente transformadas para um espaço de incorporação latente com dimensão
 . Uma série é criada pela adição de incorporações posicionais e um token de agrupamento ajustável:
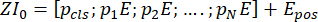 (1)
onde  representa a codificação posicional e
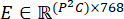 é a matriz de incorporação de fragmentos.
Camadas codificadoras de transformador empilhadas, compostas por redes feed-forward e autoatenção multi-cabeça, são usadas para processar a sequência de segmentos incorporados. A transformação na camada l é descrita como:
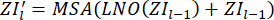 (2)
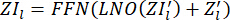 (3)
Para obter o vetor de características visuais com percepção emocional, a saída equivalente ao token de classe é extraída como o vetor de características  . Para abordar representações visuais de emoção consistentes, apesar das diferenças de idioma e conteúdo entre conjuntos de dados, os embeddings em nível de quadro de cada segmento de vídeo são combinados para capturar expressões faciais e a evolução das emoções.
Modalidade de áudio usando Wav2Vec 2.0 para embeddings acústicos semânticos e de prosódia Embeddings de fala contextualizados foram gerados utilizando um codificador pré-treinado Wav2Vec 2.0 como base acústica. Um vetor de características acústicas de comprimento fixo para cada frase foi obtido ao agregar as representações ocultas de saída usando média de agrupamento. O modelo Wav2Vec 2.0 foi utilizado para extrair representações acústicas de sinais de áudio, capturando características da fala contextuais e relevantes para emoção. Antes da extração de características, as gravações de áudio foram normalizadas e reamostradas para 16 kHz. Para garantir a sincronização entre as modalidades textual e visual, cada segmento de áudio no nível da enunciação foi isolado usando os limites de carimbo de tempo fornecidos pelas anotações do conjunto de dados. O codificador acústico pré-treinado foi ajustado durante o treinamento do modelo para melhorar a adaptação específica à tarefa, permitindo que as representações derivadas representassem com maior precisão os aspectos emocionais dos sinais de fala. Em seguida, foi realizada a fusão de atenção intermodal baseada em grafos e a aprendizagem de representações desacopladas utilizando os embeddings finais de áudio.
Na modalidade de áudio, o Wav2Vec-2.0 é utilizado para modelar sinais de fala derivados das informações iniciais de fala dos conjuntos de dados CH-SIMS e CMU-MOSEI, extraindo diretamente características de áudio relacionadas à emoção. Existe uma codificação de características convolucional para cada sinal de fala de entrada  :
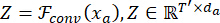 (4)
em que Z representa características prosódicas de baixo nível, como melodia, tom e energia. Uma rede de contexto baseada em transformador é útil para as estruturas mencionadas anteriormente, representando dependências temporais de longo alcance:
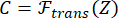 (5)
Dados acústicos prosódicos e semânticos, essenciais para expressar emoção, estão incluídos nessas representações acústicas contextuais. Um embedding de áudio de comprimento específico é criado ao realizar um procedimento de agrupamento temporal:
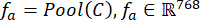 (6)
O design evita o uso de características acústicas, como MFCCs, e alcança robustez utilizando dados de fala em inglês do CMU-MOSEI e dados de fala em chinês do CH-SIMS, simplesmente extraindo representações das formas de onda.
Modalidade de texto usando RoBERTa para incorporações contextuais de emoção
Para a modalidade textual, o transformador bidirecional profundo RoBERTa é aplicado às transcrições de fala dos dois conjuntos de dados para gerar semântica contextual e significado afetivo. Codificadores de transformadores baseados no RoBERTa foram utilizados para extrair representações textuais dos dados das transcrições, a fim de capturar informações semânticas contextuais e emocionais. Um modelo pré-treinado de RoBERTa foi usado para o conjunto de dados CMU-MOSEI em língua inglesa, enquanto uma variante chinesa do RoBERTa foi empregada para o conjunto de dados CH-SIMS em chinês, para melhor considerar características linguísticas específicas do idioma. O pré-processamento do texto incluiu tokenização utilizando o tokenizador RoBERTa apropriado para cada idioma e normalização do texto. Para garantir um processamento consistente por lotes, as sequências de entrada foram convertidas em incorporações de tokens e, posteriormente, preenchidas ou truncadas até um comprimento máximo de sequência predeterminado. De acordo com o formato de entrada do RoBERTa, foram introduzidos tokens especiais de classificação e separadores. Uma incorporação textual de comprimento fixo foi obtida por meio da agregação das representações de tokens contextualizadas produzidas pelo codificador de transformador, utilizando a representação final da sentença equivalente a [CLS]. Para adaptar as representações aprendidas à tarefa de reconhecimento de emoções, os codificadores pré-treinados do RoBERTa foram refinados por meio de treinamento multimodal. Em seguida, o framework proposto de fusão multimodal foi utilizado para combinar as incorporações textuais com as características de áudio e vídeo.
Os embeddings de tokens e as codificações posicionais podem ser combinados para cada entrada tokenizada, 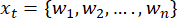 , para criar a representação de entrada na técnica de transformação bidirecional profunda conhecida como
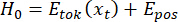 (7)
Essa forma é representada pelas camadas do transformador L, que utiliza a autoatenção para descobrir as dependências contextuais entre palavras:
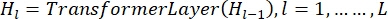 (8)
O embedding emocional contextual é obtido utilizando o estado oculto final do token de classificação:
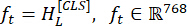 (9)
Polaridade de sentimento, emoções intensas e implicações associadas são exemplos de características linguísticas relacionadas a emoções que serão representadas por esse embedding. O RoBERTa facilita a modelagem independente de idioma. Isso permite que o sistema utilize o mesmo tamanho de embedding para textos em inglês do conjunto de dados CMU-MOSEI e para textos em chinês do conjunto de dados CH-SIMS.
Três vetores de características específicos de modalidade com 768 dimensões, cada um referente às modalidades visual fv, áudio fa e textual ft , são extraídos pela etapa proposta de aprendizado de representação de características profundas. No design de interação inteligente, essas representações aprendidas criam um espaço unificado de características multimodal que serve como base para a mapeamento visual em nível de características, fusão cruzada de modalidades baseada em grafos e aprendizado de representações desacopladas.
Aprendizado de representação desemaranhado
Após aprender uma representação de características profundas, um processamento adicional dos vetores de características multimodais provenientes das modalidades visual, auditiva e textual pode gerar uma descrição emocional desvinculada. Se os incorporamentos de características específicas de cada modalidade — auditiva, visual e textual — utilizados na etapa anterior forem representados por fv, fa e ft, respectivamente, de modo que  e
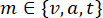 , o objetivo desta etapa é fatorar todas as características modais em duas representações latentes distintas, que incluem as representações emocionais levando em consideração a semântica anterior de cada uma das diferentes modalidades.
Isso é realizado alimentando cada característica de modalidade, fm, em duas redes de projeção paralelas: um codificador de emoção  e um codificador de modalidade
 , onde as duas codificações são produzidas.
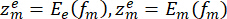 (10)
Onde  representa a característica latente associada à emoção e
 representa uma característica latente específica a uma modalidade. Isso permite que incorporações específicas de emoções se comuniquem com um espaço repetidamente ao longo de múltiplas entradas, incluindo áudio, visual e texto, mantendo ao mesmo tempo os dados estruturais únicos associados a cada modalidade.
Uma separação eficaz é garantida pela reconstrução com restrições de independência. A reconstrução da característica da modalidade original é dada por:
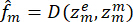 (11)
em que  é uma rede decodificadora. A perda de reconstrução preserva os seguintes dados:
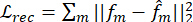 (12)
Além disso, a ortogonalidade, ou decorrelação, entre emoção e representações específicas da modalidade frequentemente limita a sobreposição de informações:
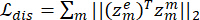 (13)
Ao atingir esses objetivos, o modelo pode aprender representações de emoções que são confiáveis, compreensíveis e resistentes à variabilidade de modalidade. Fusões cruzadas modais baseadas em grafos e características de mapeamento visual, especialmente para o design de interação inteligente, dependem fortemente de representações de emoções interpretáveis e estruturadas.
Consistência emocional entre modalidades
A inclusão da consistência emocional melhora claramente a eficácia da fusão entre as modalidades. Isso ocorre porque as estratégias de fusão não precisam compensar grandes lacunas entre as duas representações, já que os embeddings emocionais específicos de cada modalidade compartilham um espaço latente. A ilustração combinada das duas emoções é descrita a seguir  . A fusão ponderada será mais estável quando as representações específicas da emoção forem consistentes, pois as variações entre os sinais provenientes de diferentes modalidades não afetarão mais o resultado.
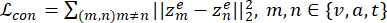 (14)
Ao impor o alinhamento semântico das informações emocionais, este objetivo minimiza discrepâncias entre modalidades e garante que a percepção emocional permaneça consistente, independentemente da modalidade utilizada para expressá-la. Consequentemente, um espaço de representação coeso e afetivo é criado ao projetar pistas emocionais obtidas de sinais de fala, expressões faciais e conteúdo linguístico.
Impacto na fusão cruzada de modalidades
A fusão multimodal torna-se mais eficaz quando a consistência emocional é introduzida entre as modalidades. Os mecanismos de fusão não precisam mais compensar grandes lacunas nas representações intermodais, pois os embeddings específicos à emoção são alinhados em um espaço latente comum. A representação emocional fundida é definida da seguinte forma:
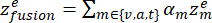 (15)
Onde αm representa o peso da atenção atribuída à modalidade m. A fusão ponderada torna-se mais estável e compreensível quando as representações específicas de emoção são consistentes, já que o resultado da fusão mostra evidências emocionais complementares em vez de sinais contraditórios das modalidades.
Matematicamente, reduzir  variância entre vários tipos de representações específicas de emoções em relação a é equivalente a:
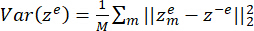 (16)
onde  representa a expressão média de emoção. A variância reduzida faz com que as modalidades de entrada sejam ponderadas de acordo com sua significância emocional precisa, em vez do ruído da modalidade, garantindo uma convergência melhorada da rede e uma avaliação de atenção mais precisa.
O objetivo final de aprendizado das visualizações emocionais desacopladas é combinar fragmentação, reconstrução e uniformidade emocional:
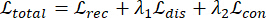 (17)
em que dois hiperparâmetros, λ1 e λ2, controlam a relação entre confiabilidade emocional cruzada e dissociação. O modelo proposto adquire representações emocionais invariantes à modalidade, interpretáveis e passíveis de fusão para alcançar esse objetivo, com ênfase em fornecer uma base sólida para a fusão baseada em grafos e representação em nível de características no design de interfaces inteligentes.
Fusão de atenção multimodal baseada em grafos
Uma rede de atenção cruzada baseada em grafos foi utilizada para simular relações emocionais finamente detalhadas entre modalidades. Para facilitar o fluxo de informações entre as modalidades, foi construído um grafo multimodal totalmente conectado, no qual cada incorporação específica de modalidade (texto, áudio e visual) foi representada como um nó do grafo. As relações entre modalidades foram usadas para estabelecer a matriz de adjacência do grafo, a qual foi posteriormente aprimorada por meio de um método de atenção treinável. Um espaço latente compartilhado foi criado pela concatenação e projeção das saídas de múltiplos cabeçotes de atenção. Uma representação unificada de emoção multimodal foi então produzida ao agregar as representações dos nós utilizando um agrupamento ponderado pela atenção. Essa representação fundida foi então fornecida aos módulos de predição e visualização para análise sensível à interação e reconhecimento de emoções. O módulo de fusão por grafo possuía uma dimensão de representação oculta de 256 e duas camadas de atenção em grafos, cada uma com oito cabeçotes de atenção. Para determinar a importância relativa das modalidades vizinhas, os coeficientes de atenção entre nós conectados foram calculados e padronizados utilizando a função softmax. Cada camada de atenção em grafo foi seguida por normalização de camada, conexões residuais e uma taxa de dropout de 0,2 para aumentar a estabilidade do treinamento e reduzir o sobreajuste. Após a concatenação e projeção das saídas de diversos cabeçotes de atenção em um espaço latente comum, as representações dos nós foram combinadas em um único vetor de incorporação emocional multimodal por meio de agrupamento ponderado pela atenção. Em seguida, a representação fundida foi utilizada para mapeamento visual multivisão e predição de emoções.
Diversas interações cruzadas foram capturadas usando atenção gráfica multi-cabeça. A função softmax foi utilizada para normalizar os coeficientes de atenção entre os nós conectados para cada nó. Para aumentar a estabilidade do treinamento e evitar overfitting, as camadas empilhadas de atenção gráfica do módulo de fusão gráfica foram seguidas por conexões residuais, normalização de camada e regularização por dropout.
Vamos, os termos representam individualmente as representações correspondentes às emoções específicas coletadas pelas modalidades visual, áudio e textual; cada componente reside no espaço latente compartilhado  . Os modelos para os nós de modalidade utilizam uma notação para o grafo
 , com os nós da coleção
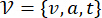 correspondendo diretamente aos três nós de modalidade, a fim de reforçar explicitamente as dependências emocionais compartilhadas entre as diversas representações de modalidade.
Após atribuir um vetor de características específico à emoção a cada nó no grafo, temos:
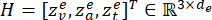 (18)
Diferentemente dos métodos tradicionais de fusão, que utilizam pesos de fusão predeterminados ou fixos, o método proposto aprende pesos de borda adaptativos com base em sua significância e interdependências, tanto entre canais quanto entre situações emocionais.
Uma rede de atenção baseada em grafos (GAT) é utilizada para fusão intermodal. Um coeficiente de atenção é calculado para cada nó i e seus nós vizinhos, ou seja, nó j:
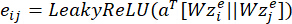 (19)
O efeito emocional da troca do modo j para a modalidade i é medido pelos pesos normalizados αij.
Em seguida, a aparência fundida de cada nó de modalidade é calculada como um agrupamento ponderado de seus vizinhos:
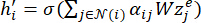 (20)
onde a função de ativação  é não linear. Em última análise, as características atualizadas de cada nó são combinadas para obter uma representação emocional global fundida:
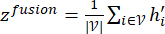 (21)
É uma técnica útil para modelagem de emoções interpretável e mapeamento visual subsequente, pois capta informações complementares de diversas modalidades, ao mesmo tempo que preserva as complexas relações intermodais.
O Algoritmo 1 (Arquivo Suplementar 1) fornece o esquema geral para realizar a fusão cruzada baseada em grafos. Inicialmente, cria-se um grafo com as características específicas de emoção associadas a cada uma das modalidades visual, auditiva e textual. Em seguida, calculam-se as pontuações de atenção para cada par de nós do grafo, que representam a combinação da dependência emocional. As pontuações de atenção são então normalizadas para indicar a contribuição relativa de cada modalidade no contexto emocional especificado, permitindo a aprendizagem dos pesos de atenção. O embedding geral de emoção é produzido na última etapa pela agregação das características associadas aos nós do grafo. Nesse sentido, a fusão geral do algoritmo das características multimodais ligadas às emoções especificadas mostra potencial para adaptabilidade, interpretabilidade e inteligência contextual.
Figura 2 mostra a estrutura e o funcionamento da rede proposta de atenção cruzada modal para fusão de sentimentos multimodal. Os embeddings específicos para emoções, derivados independentemente para as modalidades textual, auditiva e de vídeo, são inicialmente passados por mecanismos de atenção em nível de modalidade que aprendem a importância relativa das informações linguísticas, vocais e faciais em um determinado contexto emocional. As representações ponderadas pela atenção das modalidades são então combinadas para formar um embedding emocional unificado, no qual a matriz de atenção captura as dependências intermodais e as intensidades de interação. A matriz de atenção aprendida pela rede modula dinamicamente as contribuições das modalidades, permitindo que ela se concentre na modalidade instrucional mais forte enquanto ignora aquelas ruidosas e menos informativas. A representação emocional fundida permite o reconhecimento preciso de emoções e a análise fina de estados emocionais, como neutro, abraço e preocupação.
Módulo de mapeamento visual
Com a ajuda da seção de mapeamento visual, criada especificamente para esse fim, um designer de interação inteligente pode converter a representação unificada do estado emocional em uma forma visual compreensível e prontamente utilizável após o processo de fusão cruzada de modalidades, com base no gráfico.
Para facilitar a compreensão das representações emocionais latentes, foram utilizadas técnicas de redução de dimensionalidade para visualizar os embeddings multimodais de emoção aprendidos. Após reduzir a dimensionalidade das características mantendo a maior parte da variância usando Análise de Componentes Principais (PCA), os embeddings foram projetados em um espaço bidimensional para exibição, utilizando o t-SNE (t-distributed Stochastic Neighbor Embedding). Foram utilizados um valor de perplexidade de 30, uma taxa de aprendizado de 200 e 1.000 iterações de otimização para o t-SNE. Os agrupamentos específicos de emoções e as relações entre modalidades foram visualizados por meio das projeções obtidas. Os pesos normalizados de atenção cruzada obtidos pela rede de atenção baseada em grafos foram utilizados para criar mapas de calor de atenção. As contribuições relativas das modalidades textual, áudio e visual durante a predição da emoção são representadas nesses mapas de calor. Os coeficientes de atenção aprendidos foram usados como pesos das arestas para criar grafos de interação cruzada, o que permitiu a análise visual das relações intermodais e do fluxo de informação dentro do framework de fusão. Gráficos de trajetória emocional foram criados monitorando a evolução dos embeddings latentes de emoção ao longo de enunciados sucessivos, a fim de examinar a dinâmica emocional temporal. Essas trajetórias fornecem insights sobre como os estados emocionais e as contribuições das modalidades evoluem ao longo do tempo. Matplotlib e Scikit-learn são dois pacotes Python utilizados para criar todas as visualizações. Para avaliar a interpretabilidade, a formação de agrupamentos, as contribuições modais e a dinâmica emocional temporal, foram realizadas análises qualitativas das visualizações de embeddings, grafos de interação e mapas de calor de atenção.
Seja a variável 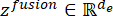 representar a representação fundida do estado emocional pela função da rede de atenção em grafos. Em contraste com a visualização no nível de saída dos gráficos de estado emocional, o objetivo principal do módulo é converter as representações de estado emocional e os pesos correspondentes do mecanismo de atenção em uma forma visual compreensível.
Usando o αji aprendido, cria-se um mapa de calor de atenção para examinar visualmente a contribuição de cada modalidade. Os pesos de atenção recebidos são então somados para determinar uma pontuação de importância composta para cada modalidade:
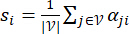 (22)
em que si representa a contribuição emocional relativa da modalidade I. Para auxiliar na criação de um mapa de calor de atenção, os valores obtidos são normalizados e mapeados para um mapa de cores que facilita ao usuário identificar a modalidade predominante em diferentes etapas temporais ou estados interativos. Por meio de diversas modalidades de entrada visual, auditiva ou textual, tal interface ajuda o usuário a compreender como o mecanismo de atenção do sistema opera.
O grafo aprendido é modelado especificamente como um "grafo de interação ponderado" para representar a dependência cruzada de modalidades nas emoções humanas. A própria modalidade é representada por cada nó no grafo, e a intensidade das interações envolvendo emoções humanas é representada pelos pesos na forma de αji nas arestas que os conectam. O grafo ponderado acima ilustra a intensidade das interações emocionais humanas. A definição de i e j é:
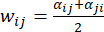 (23)
A espessura ou transparência da linha na visualização do grafo é exibida corretamente graças a esses pesos. Isso facilita a compreensão de como as modalidades interagem. O projetista pode entender melhor como os indicadores emocionais interagem durante o processo de fusão com a ajuda dos gráficos de interação cruzada entre modalidades.
Os embeddings de emoção fundidos  em diferentes etapas temporais são reduzidos a um espaço de menor dimensionalidade por meio de um algoritmo de redução de dimensionalidade, como PCA ou t-SNE, com o objetivo de exibir a evolução das emoções ao longo do tempo:
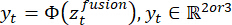 (24)
onde a função de projeção é representada por  . O surgimento de trajetórias emocionais 2D/3D, que mostram transições emocionais, intensidades e estabilidade nas interações, pode ser interpretado como uma representação intuitiva da evolução dos estados emocionais ao longo do tempo. Esses aspectos podem ser utilizados para interação inteligente, tomada de decisão e monitoramento em tempo real.
Diferentemente dos sistemas convencionais de emoção que simplesmente fornecem mapeamentos para classes ou pontuações específicas, este sistema enfatiza demonstrar como as emoções humanas se formam dentro dele. Ele revela seu processo de tomada de decisão ao oferecer visualizações de características intermediárias, incluindo fatores de ponderação, interações entre modelos e seus caminhos correspondentes. Isso permite ao usuário compreender como cada fator — visual, vocal ou linguístico — o influencia na produção de suas respostas às emoções humanas.
Mapear emoções em formas compreensíveis por meio de representações visuais pode, portanto, preencher a lacuna entre a análise de emoções usando métodos de aprendizado profundo e sua integração para o design de interfaces inteligentes. Os dados coletados a partir de ambas as abordagens podem então ser utilizados para criar interfaces de usuário mais precisas. Assim, a abordagem proposta pode fornecer aos designers de interação informações essenciais para desenvolver interfaces de usuário mais precisas. Em outras palavras, a compreensão das emoções torna-se uma parte muito ativa do design de interação. A precisão só pode aumentar quando a compreensão das emoções é incorporada ativamente ao design de interação.
O módulo de mapeamento visual possibilita a explicabilidade de várias maneiras interconectadas, porém distintas: a explicabilidade em nível de característica revela as representações subjacentes de emoção criadas pela DNN, permitindo-nos compreender a semântica utilizada para descrever cada característica relacionada à emoção; a explicabilidade em nível de modalidade utiliza dados dos gráficos de interação e dos mapas de calor de atenção visual para descrever como cada modalidade — visual, áudio ou textual — contribui para as decisões tomadas para expressar emoções; e, finalmente, as trajetórias resultantes do embedding de emoção permitem-nos entender como cada modalidade visual e textual muda ao longo do tempo sob uma perspectiva de interação dinâmica. Consulte o Algoritmo 2 (Arquivo Suplementar 1).
As características emocionais multimodais fundidas são mapeadas em representações visualmente significativas para o design de interação inteligente, utilizando o Algoritmo 2 de mapeamento visual sugerido. Os pesos de atenção multimodal baseados em grafos são usados para quantificar as diferenças entre os elementos visuais, sonoros e textuais de entrada em cada passo temporal. Essas diferenças são então mapeadas em representações visuais para destacar as principais fontes que influenciam as emoções, utilizando elementos visuais de mapa de calor. Para fornecer uma visão elucidativa da interação entre os elementos de entrada e transmitir a evolução emocional gerada pelos elementos de entrada multimodais, são calculadas as intensidades de interação par a par, criando assim os pesos de interação multimodal. Ao mesmo tempo, uma visão da evolução emocional é criada ao mapear os elementos emocionais fundidos acumulados ao longo do tempo em um espaço de baixa dimensionalidade, produzindo uma evolução contínua do elemento emocional.
Previsão de emoções e feedback de interação
O resultado da representação de emoção fundida, representado como , é então utilizado como uma função tanto para feedback de interação quanto para predição de emoção. Além disso, a predição de emoção é descrita como um modelo multitarefa que compreende uma tarefa de regressão para reconhecimento de intensidade emocional contínua e uma tarefa de classificação para reconhecimento de emoção discreta. O seguinte modelo de classificação baseado em softmax é utilizado para reconhecimento de emoção discreta:
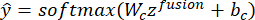 (25)
onde  representa as probabilidades esperadas das classes emocionais e Wc e bc são restrições ajustáveis. A perda de entropia cruzada é utilizada para aprimorar o objetivo de classificação:
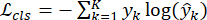 (26)
em que yk é a marcação real, e K é o número de classes de emoção. Um ramo de regressão é utilizado para estimar a intensidade da emoção em paralelo, produzindo uma predição de diversos atributos afetivos contínuos, incluindo valência e arousal. Dê a ele a seguinte definição:
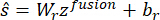 (27)
onde a pontuação esperada de intensidade emocional é indicada por  . A perda do erro quadrático médio é utilizada para aprimorar a tarefa de regressão:
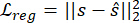 (28)
Em geral, as duas tarefas são combinadas no objetivo de previsão:
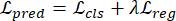 (29)
em que os objetivos de regressão e classificação são equilibrados por λ. Isso sugere uma modificação dinâmica do módulo de visualização com base no estado emocional identificado, para permitir esse tipo de feedback consciente da interação. O contexto de interação em um determinado momento t é representado por ct. A resposta do módulo de visualização é fornecida por:
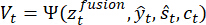 (30)
onde a função de adaptação de visualização é representada por  . Isso torna possível ajustar as mapas térmicos de modalidade, gráficos de interação e trajetórias emocionais em tempo real com base em mudanças e emoções previstas. Isso indica que o sistema oferece suporte substancial para feedback, além de apresentar bom desempenho na predição de estados emocionais.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Este trabalho valida o framework proposto de mapeamento visual para características emocionais multimodais em termos de interpretabilidade sensível à interação e desempenho preditivo, utilizando dois conjuntos de dados de referência, CH-SIMS e CMU-MOSEI. De acordo com os resultados experimentais, a abordagem sugerida apresenta desempenho consistentemente superior ao das técnicas atuais de reconhecimento emocional multimodal em diversas métricas, incluindo correlação, acurácia, pontuação F1 e erro absoluto médio (MAE). A ...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Os resultados experimentais demonstram que, nas bases de dados CH-SIMS e CMU-MOSEI, o framework proposto de mapeamento visual para características emocionais multimodais supera as técnicas atuais de reconhecimento emocional multimodal. Em comparação com modelos de fusão precoce e tardia, como EF-LSTM e TFN, a técnica proposta alcança maior precisão e pontuações F1, demonstrando sua robustez no tratamento de informações emocionais diversas. A melhoria no método pode ser atribuída à representação emocional desacoplada, que...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm conflitos de interesse.
Agradecimentos
Os autores gostariam de agradecer o apoio fornecido pela Escola de Habitação, Construção e Planejamento, Universiti Sains Malaysia, Penang, Malásia, e pela Escola de Arte e Design, Universidade de Ciência e Tecnologia de Changsha & Technology, Changsha, China. Os autores também expressam sua gratidão à Academia de Artes e Design da Universidade de Fuzhou, Xiamen, China, pelo apoio acadêmico e de pesquisa ao longo deste trabalho.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Adam | Biblioteca de Otimizadores do PyTorch | https://pytorch-optimizers.readthedocs.io/en/latest/ (Taxa de Aprendizado = 1 × 10⁻⁴) | Otimização de parâmetros durante o treinamento do modelo |
| CH-SIMS | Repositório do Conjunto de Dados Original | Última Versão Pública | Conjunto de dados de referência para análise multimodal de sentimento/emoção em chinês |
| CMU-MOSEI | Repositório do CMU Multimodal SDK | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (Última Versão Pública) | Conjunto de dados de referência para reconhecimento multimodal de sentimento e emoção |
| Codificador de Emoção Desacoplado | Implementação Personalizada | https://pytorch-geometric.readthedocs.io/en/latest/(Arquitetura de Codificador Duplo) | Separar representações latentes específicas de emoção e específicas de modalidade |
| Camada de Atenção Multimodal Baseada em Grafos (GAT) | PyTorch Geometric | GAT de múltiplos cabeçalhos (https://pytorch-geometric.readthedocs.io/en/latest/) | Modelagem de relações emocionais entre modalidades e fusão adaptativa de características |
| Camada de Atenção Multimodal Baseada em Grafos | Implementação Personalizada | Fusão de Atenção de Múltiplos Cabeçalhos | Aprendizado de dependências emocionais finas entre modalidades |
| Matplotlib | Projeto Matplotlib | 3.7+ | Geração de gráficos e análises visuais |
| NetworkX | Projeto NetworkX | 3.0+ | Construção e visualização de grafos de interação multimodal |
| GPU NVIDIA | Corporação NVIDIA | GPU com suporte a CUDA | Aceleração do treinamento de transformadores e redes neurais baseadas em grafos |
| Análise de Componentes Principais (PCA) | Scikit-learn | sklearn.decomposition.PCA | Redução inicial de incorporações emocionais de alta dimensão |
| Python | Fundação Python | 3.8+ | Linguagem de programação principal para implementar o framework de análise de emoção multimodal |
| PyTorch | Fundação PyTorch | 2.0+ | Desenvolvimento, treinamento e otimização de redes neurais profundas |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, incorporações de 768 dimensões) | Extração de representações linguísticas e semânticas contextuais de emoção |
| Seaborn | Projeto Seaborn | 0.12+ | Geração de mapas de calor de atenção e visualizações estatísticas |
| Embutimento Estocástico Distribuído em vizinhança-t (t-SNE) | Scikit-learn | scikit-learn.org (Perplexidade = 30, Iterações = 1000) | Visualização de agrupamentos e trajetórias emocionais latentes |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS ou posterior | Ambiente experimental de execução |
| Transformador de Visão (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, incorporações de 768 dimensões | Extração de representações visuais sensíveis à emoção a partir de quadros de vídeo |
| Wav2Vec 2.0 | Pesquisa da Meta AI | Modelo Base, incorporações de 768 dimensões | Extração de características acústicas e de fala contextuais de emoção |
Referências
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.