Esse protocolo implementa uma rede de aprendizado profundo em formato de U que integra convolução de catavento, atenção dupla e fusão multiescala para segmentar pólipos colorretais.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Rede de Segmentação de Pólipos Baseada em Convolução de Cataventos e Atenção Dupla para Diagnóstico de Lesão Pré-cancerosa Colorretal
* These authors contributed equally
Neste artigo
Resumo
Resumo
A segmentação precisa dos pólipos colorretais é crucial para a prevenção precoce e o diagnóstico do câncer colorretal. No entanto, devido à alta heterogeneidade dos pólipos em termos de forma, tamanho e textura, bem como à complexidade do ambiente intestinal (como dobras, reflexões especulares e resíduos fecais), os métodos existentes ainda enfrentam desafios significativos na localização de limites e na detecção de pólipos pequenos. Para abordar essas questões, este artigo propõe uma Rede de Segmentação de Pólipos baseada em Convolução em Pinwheel e Atenção Dupla (PWD-Net). A rede proposta adota uma arquitetura codificador–decodificador em formato de U, onde um ResNet pré-treinado é empregado como codificador para extrair características locais multinível. Especificamente, um Módulo de Convolução Pinwheel (PCM) é introduzido na camada de gargalo para capturar a estrutura geométrica global e informações contextuais multidirecionais dos pólipos por meio de núcleos de convolução rotacionados em múltiplos ângulos. Um Mecanismo de Atenção Dupla (DAM) que integra a atenção do canal e a atenção espacial foi projetado para suprimir de forma adaptativa o ruído de fundo e aprimorar as características da região dos pólipos. Além disso, uma estratégia de Fusão de Características Multiescala (MSF) é empregada para combinar informações semânticas profundas com detalhes de fronteira superficiais, garantindo tanto a completude quanto a precisão dos resultados de segmentação. Experimentos realizados com os conjuntos de dados Kvasir-SEG e CVC-ClinicDB demonstram que o PWD-Net alcança coeficientes médios de Dice de 0,865 e 0,944, e escores IoU de 0,765 e 0,892, respectivamente, superando significativamente os métodos de ponta existentes. Estudos de ablação verificam a eficácia de cada módulo, e avaliações cruzadas de conjuntos de dados confirmam a forte capacidade de generalização do modelo. Este estudo oferece uma solução robusta e de alta precisão para segmentação clínica de pólipos, oferecendo valor significativo para o diagnóstico precoce de lesões pré-cancerosas colorretais e apoiando a intervenção assistida por computador.
Introdução
O câncer colorretal é um dos tumores malignos mais comuns no mundo, com taxas consistentemente altas de incidência e mortalidade. Estudos mostraram que a maioria dos cânceres colorretais se desenvolve a partir de pólipos adenomatosos, um processo que normalmente leva de 10 a 15 anos, proporcionando uma janela de tempo valiosa para detecção precoce e intervenção. Um aumento de 1% na taxa de detecção de adenoma (ADR) pode reduzir o risco de câncer colorretal em aproximadamente 3%, diminuindo significativamente a mortalidadedos pacientes. A colonoscopia, considerada o padrão ouro para rastreamento do câncer colorretal, permite a remoção direta de pólipos durante o exame, reduzindo assim efetivamente a incidência e a mortalidade por câncer.
No entanto, a colonoscopia convencional depende fortemente da experiência e do nível de habilidade dos endoscopistas. Fatores como julgamento subjetivo, fadiga visual e distração podem levar a uma taxa de falhas de 20% a 30%, o que afeta diretamente a eficácia datriagem 2. Portanto, desenvolver sistemas de detecção assistida por computador (CAD) para segmentação automática de pólipos colorretais tem considerável importância para melhorar a ADR e reduzir diagnósticos perdidos. Pesquisas clínicas recentes destacaram ainda mais o interesse em integrar inteligência artificial nos fluxos de trabalho de avaliação endoscópica de lesões, reforçando a necessidade de métodos de segmentação robustose reprodutíveis 3.
Nos últimos anos, o deep learning alcançou progressos notáveis na análise médica de imagens, especialmente redes neurais convolucionais (CNNs), que demonstram forte capacidade na extração de características e representação para tarefas de segmentaçãode imagens 4. Como modelo clássico de segmentação de imagens médicas, o U-Net emprega uma arquitetura codificador-decodificador simétrica e conexões de salto para alcançar segmentação precisa em nível de pixel, tornando-se um padrão nessecampo 5. Com base no U-Net, muitas arquiteturas aprimoradas foram propostas para lidar com tarefas complexas de segmentação de imagens médicas. O UNet++ reduz a lacuna semântica entre os mapas de características do codificador e do decodificador ao introduzir conexões de salto aninhadoe denso 6. O ResUNet++ integra blocos residuais, módulos de compressão e excitação, convoluções dilatadas e mecanismos de atenção, alcançando forte desempenho na segmentaçãode pólipos 7. O U2-Net adota uma estrutura aninhada em dois níveis em formato de U para capturar informações de características multiescala8. Mais recentemente, foi proposta uma rede de segmentação profunda baseada em duplo codificador-decodificador de pólipos, aproveitando caminhos paralelos de codificação e decodificação para melhorar ainda mais a precisão dasegmentação 9.
Enquanto isso, a introdução de mecanismos de atenção traz novas soluções para aprimoramento de características e supressão de ruído. O Attention U-Net utiliza portas de atenção para focar nas regiões-alvo enquanto suprime informações de fundo irrelevantes10. A Rede de Atenção Dupla (DANet) pondera adaptativamente características tanto do canal quanto das dimensõesespaciais 11, melhorando a percepção de características críticas. Redes de Atenção Tríplice (TANet) aprimoram ainda mais o desempenho da segmentação por meio da seleção adaptativa de recursos multiescala12.
Com o sucesso das arquiteturas Transformer em processamento de linguagem natural e visãocomputacional 13, pesquisadores começaram a explorar sua aplicação na segmentação de imagens médicas. O TransUNet foi o primeiro a empregar um Transformer como codificador para modelar dependências de longo alcanceefetivamente 14. A Swin-UNet adota uma arquitetura puramente Transformer e alcança agregação global eficiente de informações por meio de um mecanismo de janeladeslocada 15. A UTNet propõe uma arquitetura híbrida que combina a capacidade de extração local de características das CNNs com a capacidade global de modelagem do Transformers16.
No campo da segmentação de pólipos, o Polyp-PVT utiliza um Transformer de visão piramidal para capturar informações semânticas globaisem múltiplas escalas 17, enquanto o UNet aninhado em múltiplas escalas aprimora a compreensão contextual ao integrar o Transformers18. Estudos recentes também exploraram estratégias de aprendizagem de correlação negativa para segmentação de pólipos cruzadosem domínios 19, aprimoramento de segmentação aumentada porGompertz 20 e arquiteturas baseadas em atenção que incorporam orientação de limites21. Embora essas abordagens melhorem em certa medida o desempenho da segmentação, a segmentação de pólipos ainda enfrenta vários desafios. Primeiro, os pólipos exibem alta heterogeneidade em morfologia, tamanho e textura, variando de micro-pólipos menores que 5 mm a pólipos grandes que ultrapassam 30 mm, com formas que variam de circulares e elípticas a formas altamente irregulares. Segundo, o ambiente intestinal é complexo e variável, onde pregas mucosas, reflexões especulares, resíduos fecais e detritos alimentares introduzem interferência severa de fundo. Terceiro, muitos pólipos têm limites borrados, podem estar parcialmente oclusos por pregas ou submersos em fluidos intestinais, tornando a localização precisa dos limites extremamentedesafiadora 22.
Os métodos existentes ainda apresentam limitações claras para enfrentar esses desafios. CNNs tradicionais são eficazes na extração de texturas locais e características das bordas; No entanto, núcleos de convolução quadrada fixa não são adequados para capturar formas geométricas diversas23, especialmente para pólipos altamente irregulares, e não podem modelar efetivamente características geométricas multidirecionais. Métodos baseados em transformadores podem modelar dependências globais, mas são menos eficazes em capturar detalhes locais finos e informações de fronteira. Além disso, sua alta complexidade computacional os torna menos adequados para aplicações clínicas em temporeal 24. Abordagens recentes de segmentação de pólipos, como PraNet, que usa módulos de atenção reversa para refinar asregiões-chave 25, redes de atenção em cascata guiadas por fronteiras que aprimoram a extração de características de fronteira26, e CAFE-Net, que funde características codificadoras e decodificadoras por meio de mecanismosde atenção cruzada 27, ainda encontram representação insuficiente de características e localização imprecisa dos limites ao lidar com pequenos pólipos28, limites borrados e fundos complexos. Além disso, a maioria dos métodos negligencia a morfologia geométrica e não explora totalmente a informação contextual multidirecional, resultando em segmentação subótima de pólipos de formato irregular.
Em resumo, os métodos atuais baseados em CNN não têm a capacidade de capturar características geométricas multidirecionais devido à sua dependência de núcleos de convolução quadrada fixa. Abordagens baseadas em transformadores oferecem modelagem global, mas sacrificam a precisão local de fronteira e impõem altos custos computacionais. Enquanto isso, as estratégias existentes de fusão aprimoradas e multi-escala não foram otimizadas conjuntamente dentro de um quadro unificado especificamente adaptado para segmentaçãode pólipos 29. Essas lacunas motivam o desenvolvimento de um método que aborda simultaneamente modelagem geométrica de características, supressão adaptativa de ruído e integração de características em escala cruzada.
Para resolver essas questões, este protocolo apresenta uma Rede de Segmentação de Pólipos baseada em Convolução Pinwheel e Atenção Dupla (PWD-Net). A rede proposta integra modelagem geométrica de características, aprimoramento multidimensional da atenção e fusão de características em múltiplas escalas, permitindo segmentação precisa de pólipos complexos. As principais contribuições deste trabalho são resumidas da seguinte forma: o módulo de convolução do cata-vento (PCM), inspirado na estrutura de um catavento, é proposto um novo design de núcleo de convolução rotacional que captura características geométricas multidirecionais dos pólipos por meio de operações de convolução em múltiplos ângulos (0°, 45°, 90°, 135°, 180°, 225°, 270° e 315°). Este módulo substitui a camada convencional de convolução na etapa de gargalo, permitindo uma percepção eficaz de diversas orientações de arestas e melhorando significativamente a representação de pólipos de formato irregular. O mecanismo de dupla atenção (DAM) aborda ruídos de fundo, como dobras, reflexões e resíduos fecais em imagens de colonoscopia. Um módulo de dupla atenção que integra a atenção por canal e a atenção espacial foi projetado. Incorporado em conexões de salto, este módulo suprime de forma adaptativa a interferência de fundo e aprimora as respostas das características nas regiões de pólipos ao identificar conjuntamente o "que" é importante (dimensão do canal) e "onde" o alvo está localizado (dimensão espacial), garantindo que apenas características refinadas estejam envolvidas na fusão subsequente. A estratégia de fusão de características multiescala (MSF) preserva tanto informações semânticas profundas quanto detalhes superficiais de fronteira por meio de um mecanismo hierárquico introduzido no decodificador. Ao integrar progressivamente características do codificador aprimorado por DAM com características do decodificador upamostrado, essa estratégia compensa efetivamente a perda de detalhes espaciais causada pela amostragem descendente, permitindo a detecção precisa de pequenos pólipos e delimitação precisa dos limites.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo utiliza apenas conjuntos de dados de imagens de colonoscopia anonimizadas e disponíveis publicamente (Kvasir-SEG). Nenhum novo dado de sujeitos humanos foi coletado. A aprovação ética institucional e o consentimento informado do paciente não foram necessários, conforme confirmado pelas políticas de revisão institucional para análises retrospectivas de conjuntos de dados públicos desidentificados.
1. Preparação de Dados
- Baixe o conjunto de dados Kvasir-SEG do repositório oficial33 (https://datasets.simula.no/kvasir-seg/). O conjunto de dados contém 1.000 imagens de pólipos com máscaras de verdade em nível de pixel correspondentes.
- Divida aleatoriamente o conjunto de dados em conjuntos de treinamento (800 imagens), validação (100 imagens) e teste (100 imagens) com uma razão de 8:1:1 usando uma semente aleatória fixa (semente = 42). Verifique se nenhuma imagem se sobrepõe entre os três subconjuntos para evitar vazamento de dados.
- Redimensione todas as imagens e máscaras correspondentes para 352 x 352 pixels usando interpolação bilinear para imagens e interpolação de vizinho mais próximo para máscaras.
- Normalize os valores dos pixels para [0, 1] dividindo por 255, depois aplique a subtração média canal a canal do ImageNet (0,485, 0,456, 0,406) e a normalização do desvio padrão (0,229, 0,224, 0,225).
- Aplique as seguintes transformações de aumento apenas ao conjunto de treinamento (não aos conjuntos de validação ou teste): inversão horizontal aleatória (probabilidade = 0,5); inversão vertical aleatória (probabilidade = 0,5); rotação aleatória (alcance: −30° a +30°, probabilidade = 0,5); Redimensionamento aleatório multiescala (fator de escala: 0,75 a 1,25, probabilidade = 0,5)
NOTA: Aplique transformações espaciais idênticas tanto à imagem quanto à sua máscara correspondente para manter o alinhamento. Verifique a correção dos aumentos inspecionando visualmente vários pares imagem–máscara aumentados antes de iniciar o treinamento.
2. Arquitetura Geral
NOTA: Consulte a Figura 1 para a espinha dorsal codificadora-decodificadora em nível macro do PWD-Net, e a Figura 2 para a integração e interação dos módulos centrais dentro do fluxo de características. A arquitetura geral segue um design codificador-decodificador em formato de U para lidar com variações de escala de pólipos e interferência de fundo em imagens de colonoscopia.
- Backbone e Caminho de Codificação (Figura 1)
- Use um ResNet-50 pré-treinado no ImageNet (proveniente do modelo oficial do zoológico PyTorch) como o codificador da espinha dorsal 30. Ajuste finamente todas as camadas de codificadores durante o treinamento.
- Alimente a imagem de colonoscopia de entrada (redimensionada para 352 x 352 pixels) através de cinco estágios de blocos convolucionais residuais para extrair características hierárquicas. A resolução espacial dos mapas de características é progressivamente reduzida de para os cinco estágios, enquanto as dimensões do canal aumentam correspondentemente (64 → 128 → 256 → 512 → 1024).
- No gargalo (a camada de codificadores mais profunda), substitua a camada convolucional padrão pelo Módulo de Convolução Pinwheel (PCM, descrito na Seção 3) para capturar a morfologia geométrica global e informações contextuais multidirecionais em baixa resolução.
NOTA: Os cinco estágios do codificador correspondem aos grupos padrão de camadas ResNet-50: conv1, camada 1, camada 2, camada 3 e camada 4. Os pesos pré-treinados proporcionam inicialização robusta de características de baixo e médio nível, reduzindo o tempo de convergência em pequenos conjuntos de dados médicos.
- Componentes-chave e interação de características (Figura 2 e Figura 3)
- Aplique o Mecanismo de Atenção Dupla (DAM, descrito na Seção 4) à saída de cada estágio do codificador antes de transmiti-lo ao decodificador por meio de conexões de salto. Essa etapa suprime adaptativamente o ruído de fundo gerado por pregas intestinais e reflexões especulares, enquanto potencializa a resposta das características nas regiões de pólipos. Apenas as características filtradas são passadas para a camada decodificadora correspondente.
- No decodificador, restaurar progressivamente a resolução espacial por meio de amostragem bilinear. Em cada camada de decodificador, concatene as características upamostradas do estágio anterior com as características do codificador aprimorado por DAM da mesma resolução espacial.
- Aplique duas camadas convolucionais consecutivas (cada uma seguida de normalização em lote e ativação ReLU) para fundir as informações multiescala. Isso constitui a estratégia de Fusão de Características Multiescala (MSF) descrita na Seção 5.
NOTA: O decodificador procede das camadas profundas para as superficiais (estágio 5 → estágio 1), garantindo que informações profundas de localização semântica e detalhes de fronteira rasa sejam efetivamente integradas em cada nível.
- Geração de Produção
- Aplique uma camada convolucional seguida de uma função de ativação Sigmoid na saída final do decodificador para gerar a máscara de previsão.
- Binarize a máscara de previsão usando um limiar de 0,5 para obter o resultado final de segmentação, onde pixels com probabilidade prevista ≥ 0,5 são classificados como pólipo e os demais pixels como fundo.
3. Módulo de Convolução do Pinwheel (Figura 3)
- O Módulo de Convolução Pinwheel (PCM) substitui a convolução padrão de gargalo para capturar características geométricas multidirecionais dos pólipos. Implemente este módulo da seguinte forma:
- Defina um núcleo de convolução base W de tamanho 3 x 3 com Cnos canais de entrada e Cnos canais de saída .
- Defina o conjunto de ângulos de rotação Θ = {0°, 45°, 90°, ..., 315°}. Para cada ângulo θ ∈ Θ, gere-se o núcleo rotacionado Wθ aplicando rotação baseada em interpolação bilinear a W. Todos os oito núcleos rotacionados compartilham os mesmos parâmetros base; apenas a disposição espacial dos pesos difere.
- Para cada ângulo θ, calcule o mapa de características específico para a direção:

onde X é o mapa de características de entrada. - Agregue os oito mapas de características direcionais por concatenação canal a canal ao longo do eixo do canal, produzindo um tensor de dimensão (8 xC para fora) x H x W. Depois, aplique uma convolução 1 x 1 para reduzir a dimensão do canal de volta para Cout, seguida de normalização em lote e ativaçãoReLU 31:

NOTA: A rotação e a interpolação são realizadas nos pesos do kernel, não no mapa de características de entrada. Esse design permite a extração de características multidirecionais eficiente em termos de parâmetros sem aumentar a resolução de entrada. Na implementação atual, Cin = 1024 e Cout = 1024 no estágio de gargalo, correspondendo à dimensão do canal de saída da camada 4 do ResNet-50. Consulte o pacote de código suplementar para a implementação completa.
4. Mecanismo de Dupla Atenção (Figura 4)
NOTA: O Mecanismo de Atenção Dupla (DAM) está embutido em cada conexão de salto para suprimir ruído de fundo e realçar características da região dos pólipos tanto das dimensões do canal quanto das dimensões espaciais.
- Atenção ao Canal
O ramo de atenção do canal identifica quais canais de destaque são mais informativos. Dado um recurso de entrada F ∈ RC×H×W:- Comprima as dimensões espaciais via Agrupamento de Média Global para obter um descritor de canal z ∈ RC×1×1.
- Passe z por uma MLP (camadas totalmente conexas) de duas camadas com uma razão de redução r = 16. A primeira camada reduz a dimensão de C para C/16 com ativação do ReLU; a segunda camada o restaura de C/16 para C com ativação sigmoide para produzir o vetor de peso do canal Ac:
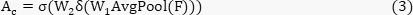
onde δ denota ReLU e σ denota Sigmoide.
- Atenção Espacial
O ramo de atenção espacial localiza onde estão as regiões alvo:- Aplique tanto o pool máximo quanto o pool médio ao longo da dimensão do canal para gerar dois mapas de características 2D de tamanho 1 x H x W.
- Concatene os dois mapas ao longo do eixo do canal para formar um tensor 2 x H x W. Aplique uma camada convolucional de 7 x 7 seguida de ativação sigmoide para produzir o mapa de pesos espaciais As ∈ R1×H×W:
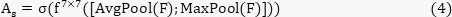
- Fusão de Características
- Fuda as saídas de canal e atenção espacial com a característica de entrada por meio da multiplicação elemento:

onde α e β são coeficientes de balanceamento aprendíveis, ambos inicializados para 0,5 e atualizados conjuntamente com os parâmetros da rede por meio de otimização baseada em gradiente durante o treinamento.
NOTA: Consulte o pacote suplementar de código (dam_module.py) para a implementação completa.
- Fuda as saídas de canal e atenção espacial com a característica de entrada por meio da multiplicação elemento:
5. Fusão de Características Multiescala
- Aplique a estratégia de fusão de características multiescala (MSF) no decodificador para lidar com a perda de detalhes espaciais em características profundas. Em cada estágio do decodificador, execute o seguinte:
- Faça upsampling do mapa de características do estágio decodificador anterior por um fator de 2 usando interpolação bilinear.
- Concatene as características upamostradas com as características do codificador aprimorado por DAM, com a resolução espacial correspondente ao longo do eixo do canal.
- Aplique duas camadas convolucionais consecutivas de 3 x 3 (cada uma seguida de normalização em lote e ativaçãoReLU 32) para fundir as características concatenadas.
NOTA: Essa fusão em níveis cruzados garante que os detalhes de fronteira dos pólipos (fornecidos por características superficiais do codificador) e a localização semântica (fornecida por características profundas) sejam preservados simultaneamente, gerando resultados de segmentação finos.
6. Função de Perda e Configuração de Treinamento
- Função de Perda
- Uma função de perda híbrida L_total é adotada para otimizar conjuntamente a rede, abordando o desequilíbrio onipresente entre primeiro plano e classe de fundo na segmentação de pólipos.
A Perda Binária de Entropia Cruzada (LBCE) mede a precisão da classificação em nível de pixel:
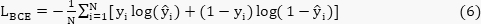
onde N é o número total de pixels, yi ∈ {0,1} é o rótulo de verdade fundamental, e ŷi ∈ [0,1] é a probabilidade prevista. - Perda de Dados (LDice) quantifica a similaridade entre as regiões previstas e as regiões de verdade:


onde ε é um fator de suavização (definido para 1 x 10⁻5) para evitar divisão por zero.
Defina λ = 0,5 para equilibrar as contribuições dos dois termos de perda.
- Uma função de perda híbrida L_total é adotada para otimizar conjuntamente a rede, abordando o desequilíbrio onipresente entre primeiro plano e classe de fundo na segmentação de pólipos.
- Configuração de Treinamento
- Inicialize o codificador com pesos ResNet-50 pré-treinados pelo ImageNet. Inicialize todas as camadas de decodificador, PCM e parâmetros DAM usando a inicialização uniforme de Kaiming.
- Configure o otimizador e o cronograma de treinamento da seguinte forma. Use o otimizador Adam com β₁ = 0,9 e β₂ = 0,999. Defina a taxa inicial de aprendizado para 1 x 10⁻⁴. Aplique um cronograma de taxa de aprendizagem por recozimento cosseno com Tmáximo = 50 e ηmínimo = 1 x 10⁻⁶. Use um lote de 16 e treine o modelo para 50 épocas.
- Treine o modelo por 50 épocas no conjunto de treinamento (800 imagens). Ao final de cada época, avalie o modelo no conjunto de validação (100 imagens) usando o coeficiente de Dice como principal métrica de monitoramento.
- Salve o checkpoint do modelo que atinge o maior coeficiente de dados no conjunto de validação. Use esse ponto de verificação como modelo final para todas as avaliações subsequentes no conjunto de teste.
NOTA: Parar precocemente não é aplicado explicitamente. A estratégia de seleção de checkpoint de validação dos dados serve como critério de seleção do modelo. Todos os experimentos são realizados utilizando o ambiente de hardware e software especificado na Tabela de Materiais. O treinamento para 50 épocas em 800 imagens leva aproximadamente 2 horas sob a configuração descrita. Todos os resultados reportados são obtidos em uma única execução de treinamento usando a semente aleatória especificada (semente = 42). Consulte o pacote suplementar de código para o script completo de treinamento.
7. Pseudocódigo
- Use o Algoritmo 1 como o mapa completo do fluxo de trabalho para a PWD Net. Compare os blocos PCM, DAM, arquitetura principal e pipeline de treinamento no algoritmo com os arquivos correspondentes no pacote de código suplementar.
- Implemente o bloco PCM mostrado nas Linhas 4 a 12. Defina um núcleo de convolução base 3 x 3 e gere oito núcleos rotacionados em 0°, 45°, 90°, 135°, 180°, 225°, 270° e 315° usando interpolação bilinear.
- Mantenha os mesmos parâmetros base aprendíveis para todos os kernels PCM rotacionados. Para cada ângulo de rotação, calcule um mapa de características específico para a direção.
- Concatene os oito mapas de características PCM ao longo da dimensão do canal. Aplique uma convolução 1 x 1, normalização em lote e ativação do ReLU para restaurar a dimensão original do canal.
- Implemente o bloco DAM mostrado nas linhas 14 a 19. Aplique o Global Average Pooling para gerar o descritor de canal, depois passe por um MLP de duas camadas com uma razão de redução de 16 para obter os pesos dos canais.
- Gere o mapa de atenção espacial aplicando o pool médio por canal e o pool máximo ao recurso de entrada. Concatene os dois mapas e processe-os com uma convolução 7 x 7 seguida pela ativação Sigmoide.
- Fuda o canal DAM e as saídas de atenção espacial com a característica de entrada usando multiplicação elemento a elemento. Pese os dois mapas de atenção com coeficientes aprendíveis α e β, ambos inicializados em 0,5.
- Construa a arquitetura principal PWD Net mostrada nas Linhas 21 a 32. Passe a imagem de entrada por cinco estágios de um codificador ResNet 50 pré-treinado para obter e1 a e5, com resolução espacial diminuindo de H x W para H/32 x W/32.
- Aplique PCM em e5 no gargalo. Aplique DAM ao e1 ao e4 antes de enviar esses recursos para o decodificador através de conexões de salto.
- Decodifique o mapa de características das camadas profundas para as superficiais. Em cada nível do decodificador, faça upsampling da característica anterior, concatene-a com a característica correspondente do codificador aprimorado DAM e aplique DoubleConv para fusão de características.
- Gerar a saída de segmentação com uma convolução 1 x 1 seguida pela ativação Sigmoide. Use o mapa de probabilidade pixel a pixel resultante como a máscara prevista.
- Implemente o ciclo de treinamento mostrado nas linhas 34 a 39. Em cada época, execute a propagação para frente através do PWD Net e calcule a máscara prevista.
- Calcule a perda de treinamento como 0,5 x perda BCE mais 0,5 x perda de dados. Atualize todos os parâmetros aprendíveis com o otimizador Adam por meio da retropropagação.
Algoritmo 1: Segmentação de Pólipos PWD-Net
1: Entrada: Imagem de colonoscopia I ∈R H×W×3
2: Saída: Máscara de segmentação M ∈ {0,1}(H×W)
3:
4: função Módulo de Convolução PCM(X) ▷ Pinwheel
5: Defina núcleo base W (3 x 3), ângulos Θ = {0°, 45°, ..., 315°}
6: para cada θ ∈ Θ fazer
7: Wθ ← BilinearRotate(W, θ) ▷ Rotate kernel
8: Yθ ← Conv2d(X,W θ) ▷ Características específicas de direção
9: fim para
10: Yout ← ReLU(BN(Conv1 x 1(Concat({Yθ})))) ▷ Aggregate
11: devolverY para fora
12: função final
13:
14: função DAM(F) ▷ Mecanismo de Atenção Dupla
15: Ac ← Sigmoide(MLP(AvgPool(F))) ▷ Atenção do canal (r=16)
16: As ← Sigmoid(Conv7 x 7([AvgPool(F); MaxPool(F)])) ▷ Atenção espacial
17: F' ← F ⊗ (α · Ac + β · As) ▷ Fuse com α aprendível, β (init=0,5)
18: retorno F'
19: função final
20:
21: função PWD-Net(I)
22: Codificador: e1,e 2,e 3,e 4, e5 ← ResNet50_Stages(I) ▷ codificador pré-treinado de 5 estágios
23: Gargalo: b ← PCM(e5) ▷ Aplique PCM no gargalo
24: Pular conexões: si ← DAM(e i) para i = 1, 2, 3, 4 ▷ Características do codificador do filtro
25: Decodificador:
26: d 4 ← DoubleConv(Concat(Up(b),s 4))
27: d 3 ← DoubleConv(Concat(Up(d4), s3))
28: d 2 ← DoubleConv(Concat(Up(d3), s2))
29: d 1 ← DoubleConv(Concat(Up(d2), s1))
30: M ← Sigmoid (Conv1 x 1(d1))
31: retorno M
32: função final
33:
34: Treinamento:
35: para cada época faça
36: M̂ ← PWD-Net(I)
37: L ← 0,5 · AC(M̂,M gt) + 0,5 · Perda de Dados(M̂,M gt) ▷ λ = 0,5
38: Atualizar parâmetros via retropropagação (Adamotimizar r)
39: fim para
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Configuração Experimental
Conjunto de dados
O conjunto de dados Kvasir SEG foi utilizado para avaliar o comportamento de segmentação do PWD Net em imagens de colonoscopia com aparições heterogêneas de pólipos. O conjunto de dados contém imagens de pólipos anotadas com 1.000 pixels e inclui variação no tamanho, forma, textura, iluminação e complexidade de fundo dos pólipos, tornando-o adequado para avaliar detecção de pequenos alvos, localiz...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Várias escolhas de design no protocolo PWD-Net são críticas para alcançar resultados de segmentação confiáveis e merecem atenção cuidadosa durante a implementação. Primeiro, a seleção e inicialização da espinha dorsal do codificador influenciam diretamente o comportamento de convergência e o desempenho final. O protocolo emprega um codificador ResNet-50 pré-treinado no ImageNet, que oferece inicialização robusta de características de baixo e médio nível. Isso é particularmente importante...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm nada a revelar.
Agradecimentos
Este estudo foi financiado pelo Programa Nacional de P&D da China (Programas nºs 2022YFC3500200 e 2022YFC3500204).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Adam Optimizer | — | — | Incluído no PyTorch |
| Albumentations | Albumentations Team | v1.0+ | Biblioteca de augmentação de dados |
| CUDA Toolkit | NVIDIA | v11.3+ | Aceleração de GPU |
| Kvasir-SEG dataset | SimulaMet | — | https://datasets.simula.no/kvasir-seg/ |
| Matplotlib | Matplotlib Community | v3.4+ | Visualização de curvas de treinamento |
| NumPy | NumPy Community | v1.21+ | Computação numérica |
| NVIDIA Tesla P100 | NVIDIA | P100-PCIE-16GB | GPU para treinamento e inferência |
| OpenCV | OpenCV Community | v4.5+ | Pré-processamento de imagens |
| Python | Python Software Foundation | v3.8+ | Linguagem de programação |
| PyTorch | Meta Platforms | v1.12+ | Framework de aprendizado profundo |
| ResNet-50 pretrained weights | PyTorch Model Zoo | — | Pré-treinado ImageNet-1K |
| Ubuntu | Canonical | 18.04+ | Sistema operacional |