Aqui, apresentamos um protocolo para montagem de coorte, harmonização laboratorial, desenvolvimento de modelo penalizado, validação e construção de escore à beira do leito para estratificação precoce de risco de síndrome de disfunção de múltiplos órgãos na pancreatite aguda.
Artigo de investigação
Um Protocolo Reprodutível de Pontuação Bioquímica-de Coagulação na Admissão para Síndrome de Disfunção de Múltiplos Órgãos na Pancreatite Aguda
Neste artigo
Resumo
Resumo
O reconhecimento precoce da síndrome de disfunção de múltiplos órgãos na pancreatite aguda permanece difícil porque a deterioração orgânica pode ocorrer antes da conclusão das avaliações convencionais de gravidade. Este artigo descreve um protocolo reprodutível para desenvolver, validar e aplicar um escore composto de bioquímica e coagulação baseado em exames laboratoriais de rotina obtidos nas primeiras 24 horas após a admissão hospitalar. A síndrome de disfunção de múltiplos órgãos foi escolhida como desfecho primário porque reflete disfunção clinicamente significativa em mais de um sistema orgânico e orienta diretamente a intensidade do monitoramento inicial, o planejamento de escalonamento e a alocação de recursos de terapia intensiva. O protocolo abrange a montagem de coorte multicêntrica, triagem de elegibilidade, adjudicação de desfechos, harmonização de unidades laboratoriais, processamento de dados ausentes, padronização de preditores, desenvolvimento de modelo de regressão penalizada, validação com conjunto de retenção, construção do escore, comparação com escores de gravidade estabelecidos e análises de sensibilidade. Variáveis laboratoriais contínuas são mantidas durante o desenvolvimento do modelo para reduzir a perda de informação, enquanto categorias clinicamente interpretáveis são utilizadas apenas ao traduzir o modelo final em um escore prático para uso à beira do leito. Pontos de verificação procedimentais incluem confirmação da montagem da coorte, limiares de ausência de dados, regras pré-definidas de pré-processamento, saídas da seleção do modelo, saídas de validação e interpretação do escore final. Utilizando este fluxo de trabalho, marcadores bioquímicos e de coagulação de rotina podem ser integrados em uma ferramenta estruturada de estratificação de risco na admissão para a síndrome de disfunção de múltiplos órgãos associada à pancreatite aguda. O escore tem como objetivo apoiar observação mais atenta, reavaliação laboratorial repetida e preparação para vias de suporte orgânico, mas deve complementar, e não substituir, o julgamento clínico ou estruturas de gravidade estabelecidas.
Introdução
A pancreatite aguda é uma emergência digestiva comum cujo curso clínico varia desde uma inflamação leve e autolimitada até uma doença rapidamente progressiva, complicada por disfunção orgânica. A avaliação atual da gravidade geralmente é orientada pela classificação revisada de Atlanta, que define a gravidade da doença com base em complicações locais, complicações sistêmicas e na presença e duração da falência orgânica1. Sistemas de pontuação clínica também são utilizados no início da internação hospitalar para apoiar a avaliação de risco e decisões de escalonamento. O Índice Clínico para a Gravidade na Pancreatite Aguda utiliza cinco variáveis disponíveis nas primeiras 24 horas e foi desenvolvido para estimar o risco de mortalidade hospitalar2. Diretrizes clínicas recentes continuam a enfatizar o reconhecimento precoce da doença grave, reavaliações repetidas, reanimação com fluidos adequada, planejamento de suporte orgânico e escalonamento oportuno do tratamento3.
A avaliação precoce de risco permanece difícil na prática rotineira. A resposta inflamatória na pancreatite aguda muda rapidamente, e alguns sistemas tradicionais de pontuação exigem medições repetidas, variáveis fisiológicas que evoluem após a admissão ou achados de imagem que podem não estar disponíveis no primeiro contato clínico4. Como resultado, a classificação de risco pode variar conforme o momento da amostragem, o fluxo de trabalho local e o percurso terapêutico. Essas incertezas podem levar a monitorização ou intervenções intensivas desnecessárias em pacientes de baixo risco, enquanto pacientes que se agravam rapidamente podem sofrer atraso na escalonamento terapêutico. Uma revisão recente sobre a predição de gravidade na pancreatite aguda observou que o desempenho das pontuações clínicas e dos biomarcadores individuais varia entre populações de pacientes, distribuições de gravidade da doença e janelas de avaliação5.
A maioria dos estudos recentes de predição tentou utilizar variáveis coletadas nas primeiras 24 horas após a admissão, frequentemente com falha orgânica persistente ou pancreatite aguda grave como desfecho alvo. Essa abordagem é clinicamente útil, mas muitos modelos publicados ainda são limitados pelo desenho monocêntrico, validação incompleta e relato insuficiente dos métodos de pré-processamento e de tratamento de dados ausentes6. O relato transparente é particularmente importante para modelos preditivos, pois critérios de elegibilidade, definições dos preditores, tamanho da amostra, tratamento de dados ausentes, decisões no desenvolvimento do modelo e procedimentos de validação afetam diretamente a reprodutibilidade e a interpretação clínica7. Para que um método baseado na admissão possa ser utilizado em diferentes instituições, ele deve basear-se em exames de rotina, definir procedimentos de conversão de unidades, explicar como os valores laboratoriais são harmonizados e especificar como os valores incompletos dos preditores são tratados antes do ajuste do modelo.
Anormalidades bioquímicas e de coagulação são ambas relevantes para a deterioração precoce na pancreatite aguda. A ativação inflamatória, lesão endotelial, hemoconcentração, hipoperfusão renal e distúrbios da microcirculação podem ocorrer precocemente e contribuir para a disfunção orgânica. A ativação da coagulação está estreitamente ligada à inflamação, e a coagulopatia associada à pancreatite aguda tem sido descrita como parte da progressão rumo à falência orgânica persistente e desfechos adversos8. O dímero D também foi relatado como um marcador de admissão associado à falência orgânica, complicações locais, internação em unidade de terapia intensiva e mortalidade na pancreatite aguda9. No entanto, os indicadores de coagulação são frequentemente interpretados separadamente, em vez de combinados com variáveis bioquímicas de rotina em um fluxo de trabalho estruturado de admissão.
A síndrome da disfunção orgânica múltipla foi selecionada como o desfecho primário neste protocolo porque representa uma disfunção clinicamente significativa em mais de um sistema orgânico. A falência orgânica persistente continua sendo central para a classificação da gravidade da pancreatite aguda, mas a síndrome da disfunção orgânica múltipla está mais próxima da questão prática de admissão: se é provável que o paciente precise de vigilância mais rigorosa, reavaliação laboratorial repetida, preparação para suporte orgânico ou recursos de terapia intensiva. Esse desfecho também permite que sinais bioquímicos e de coagulação sejam avaliados em relação a um padrão mais amplo de deterioração sistêmica, em vez de um desfecho baseado em um único órgão.
O artigo deste método descreve um protocolo reprodutível de pontuação bioquímica-coagulativa na admissão para a estratificação precoce de risco de síndrome de disfunção de múltiplos órgãos na pancreatite aguda. O protocolo utiliza variáveis laboratoriais de rotina obtidas nas primeiras 24 horas após a admissão, padroniza a harmonização de unidades e o tratamento de dados ausentes, aplica o desenvolvimento de modelo penalizado e traduz o modelo final em uma pontuação composta clinicamente interpretável. O objetivo não é substituir o julgamento clínico ou as estruturas de gravidade estabelecidas, mas fornecer um fluxo de trabalho transparente e replicável que ajude as instituições a organizar os dados laboratoriais da admissão em informações de risco acionáveis.
Protocolo
O protocolo do estudo foi aprovado pelo Comitê de Ética em Pesquisa Biomédica Envolvendo Seres Humanos do Primeiro Hospital Popular de Jiashan, Hospital Afiliado à Universidade Jiaxing (número de aprovação: 2026 Research Approval No. 005; número de aceitação: LW2026004; data de aprovação: 13 de janeiro de 2026). A exigência de consentimento informado individual foi dispensada porque este estudo retrospectivo utilizou dados clínicos desidentificados. Antes da análise, identificadores diretos, incluindo nome, número de identificação hospitalar, número de telefone, endereço e número de identificação nacional, foram removidos. O tratamento dos dados seguiu os requisitos institucionais de proteção de dados e a Declaração de Helsinque10.
Desenho do estudo e montagem da coorte multicêntrica
Este estudo retrospectivo de coorte multicêntrica utilizou dados bioquímicos e de coagulação na admissão para construir um fluxo de trabalho de pontuação reprodutível para a estratificação precoce de risco de síndrome de disfunção de múltiplos órgãos (SDMO) na pancreatite aguda (PA). A PA foi definida por pelo menos dois dos seguintes critérios: dor abdominal típica, amilase ou lipase sérica pelo menos três vezes acima do limite superior da normalidade ou achados de imagem compatíveis com PA. A janela basal foi definida como as primeiras 24 horas após a admissão hospitalar. Para cada preditor laboratorial, foi utilizado o valor elegível mais precoce dentro dessa janela. Valores obtidos após o primeiro registro da ocorrência de SDMO não foram utilizados para a construção dos preditores.
Internações consecutivas por pancreatite aguda (AP) provenientes dos centros participantes, de 1º de janeiro de 2023 a 20 de dezembro de 2025, foram triadas utilizando um registro padronizado de triagem, uma lista de verificação de elegibilidade, um dicionário de dados e um formulário de adjudicação de desfechos. O registro de triagem registrou o número total de admissões triadas, admissões duplicadas, exclusões por AP não confirmada, idade inferior a 18 anos, pancreatite crônica, pancreatite associada a malignidade pancreática, horário de admissão não confiável, dados laboratoriais indisponíveis nas primeiras 24 horas, registros de desfecho incompletos e a coorte analítica final. O registro de triagem fechado foi utilizado para gerar Figura 1. Os números de pacientes na Figura 1 foram verificados em comparação com o conjunto de dados analítico final antes da análise.
Após o fechamento da coorte analítica, os pacientes foram alocados em uma coorte de desenvolvimento e uma coorte de validação reservada em uma proporção de 7:3. A divisão foi realizada no R versão 4.3.2 utilizando o pacote caret versão 6.0-94, com a semente aleatória fixada em 20260420. A amostragem estratificada foi realizada com base no status de MODS e no centro. Se a distribuição por centro diferisse em mais de 5 pontos percentuais entre as coortes, foram utilizados estratos combinados centro-MODS. A alocação das coortes foi salva antes do ajuste do modelo e não foi modificada posteriormente. As regras de pré-processamento, configurações de imputação, ajuste do modelo, estimativa dos coeficientes, construção do escore e seleção do ponto de corte foram derivadas exclusivamente a partir da coorte de desenvolvimento. A coorte de validação reservada foi utilizada apenas para a avaliação do modelo fechado.
Critérios de elegibilidade e procedimentos de inscrição
Os pacientes elegíveis eram adultos com 18 anos ou mais, com diagnóstico confirmado de PA, horário de admissão hospitalar rastreável, pelo menos um painel laboratorial bioquímico ou de coagulação realizado nas 24 horas seguintes à admissão e prontuários hospitalares completos para a avaliação dos desfechos. Os pacientes foram excluídos se a PA não pudesse ser confirmada, se houvesse pancreatite associada à pancreatite crônica ou neoplasia pancreática, ou se o horário da primeira admissão hospitalar não pudesse ser reconstruído de forma confiável. Casos de transferência foram excluídos quando o horário da primeira admissão, o horário da primeira coleta laboratorial ou o estado de disfunção orgânica precoce não pudessem ser rastreados entre instituições. Para admissões repetidas do mesmo paciente durante o período do estudo, somente a primeira internação elegível foi mantida. Uma causa primária de exclusão foi registrada para cada caso excluído.
Resultados e adjudicação dos desfechos
O desfecho primário foi a disfunção multissistêmica (MODS) durante a internação hospitalar, definida como disfunção de dois ou mais sistemas orgânicos durante a hospitalização. A disfunção orgânica foi avaliada a partir dos registros respiratório, cardiovascular, renal, hepático, de coagulação e neurológico no prontuário eletrônico. Os mesmos critérios pré-especificados por sistema orgânico foram aplicados em todos os centros antes do desenvolvimento do modelo, e os critérios operacionais utilizados para a adjudicação dos desfechos estão resumidos na Tabela Suplementar 1.
Dois revisores treinados avaliaram independentemente cada registro desidentificado utilizando anotações de admissão, anotações de evolução, registros de unidade de terapia intensiva, registros de procedimentos, laudos laboratoriais, registros de sinais vitais e resumos de alta. O formulário de adjudicação registrou o código de estudo do paciente, o sistema orgânico envolvido, o registro fonte, a data e hora de início, o valor laboratorial ou fisiológico de apoio, a decisão do revisor e o status final da adjudicação. O consenso entre os revisores foi considerado definitivo. Os desacordos foram resolvidos por um terceiro revisor sênior. Os desfechos secundários incluíram admissão em unidade de terapia intensiva, ventilação mecânica invasiva ou não invasiva, terapia de substituição renal, mortalidade intra-hospitalar, necrose infectada ou procedimento de drenagem e tempo de permanência hospitalar. A duração da internação foi calculada como a data de alta subtraída da data de admissão, mais 1 dia.
Previsores candidatos na admissão
Os previsores candidatos foram restritos a variáveis de rotina disponíveis nas primeiras 24 horas após a admissão. Para exames repetidos dentro do período de 24 horas, foi mantido o valor elegível mais precoce. As variáveis bioquímicas incluíram contagem de leucócitos, proteína C-reativa, procalcitonina quando disponível, lactato, glicose, cálcio total, nitrogênio ureico no sangue, creatinina, alanina aminotransferase, bilirrubina total, albumina e desidrogenase láctica. As variáveis de coagulação incluíram contagem de plaquetas, tempo de protrombina, razão normalizada internacional do tempo de protrombina, tempo de tromboplastina parcial ativada, fibrinogênio e D-dímero.
As variáveis clínicas basais foram coletadas para a descrição da composição dos casos e o cálculo do escore de referência. Essas variáveis incluíram idade, sexo, índice de massa corporal, tempo entre o início dos sintomas e a admissão, etiologia da pancreatite aguda, status de tabagismo, episódios prévios de pancreatite, comorbidades, frequência cardíaca na admissão, pressão arterial média, status de síndrome inflamatória sistêmica, escore do Índice à Beira do Leito para Gravidade na Pancreatite Aguda, escore de Avaliação Fisiológica Aguda e Saúde Crônica II e escore de Avaliação de Falência Orgânica Sequencial. Quando tanto o tempo de protrombina quanto o tempo de protrombina com razão normalizada internacional estavam disponíveis, o tempo de protrombina com razão normalizada internacional foi utilizado para modelagem, e o tempo de protrombina foi mantido para relato descritivo. O arquivo de extração continha uma linha por internação hospitalar e mantinha o código do centro, código do paciente no estudo, horário da admissão, horário da coleta, valor bruto, unidade bruta, valor harmonizado, unidade harmonizada, tabela de origem e indicador de ausência de dados.
Harmonização laboratorial entre centros
Todas as variáveis laboratoriais foram convertidas para unidades-alvo previamente especificadas antes da análise: contagem de leucócitos e contagem de plaquetas, 109/L; proteína C-reativa, mg/L; procalcitonina, ng/mL; lactato, glicose, cálcio total e nitrogênio ureico no sangue, mmol/L; creatinina e bilirrubina total, µmol/L; alanina aminotransferase e lactato desidrogenase, U/L; albumina e fibrinogênio, g/L; tempo de protrombina e tempo de tromboplastina parcial ativada, segundos; razão normalizada internacional do tempo de protrombina, razão adimensional; e D-dímero, mg/L em unidades equivalentes ao fibrinogênio. Valores de D-dímero informados como µg/mL em unidades equivalentes ao fibrinogênio foram convertidos para mg/L em unidades equivalentes ao fibrinogênio utilizando uma conversão numérica 1:1. Valores de D-dímero informados como unidades de D-dímero foram convertidos apenas quando o laboratório local forneceu um fator de conversão validado. Valores sem um fator de conversão validado foram considerados ausentes na modelagem.
As unidades de relatório, faixas de referência, registros de ensaios e anotações do analisador de cada centro foram revisadas antes da consolidação. O arquivo de harmonização manteve a unidade original, a unidade-alvo, a regra de conversão e o revisor responsável pela verificação da conversão. Os valores laboratoriais não foram normalizados pelas faixas de referência específicas de cada centro na análise primária, pois a pontuação tinha como objetivo utilizar valores clínicos absolutos. O código do centro foi mantido durante a imputação e a análise de sensibilidade. Valores negativos para testes não negativos, unidades incompatíveis, carimbos de data/hora fora da janela de 24 h e valores não suportados pelos registros de origem foram sinalizados. Um valor foi corrigido apenas quando o registro de origem confirmou um erro de transcrição ou de conversão de unidade; caso contrário, foi definido como ausente.
Pré-processamento dos dados e tratamento de dados ausentes
A ausência de dados foi resumida por variável, centro e status de MODS antes do ajuste do modelo. Os preditores candidatos foram excluídos do desenvolvimento do modelo se a ausência geral excedesse 30% ou se a ausência excedesse 50% em qualquer centro individual. Pacientes foram excluídos do conjunto de dados de modelagem se mais de 40% dos preditores candidatos estivessem ausentes ou se o desfecho primário não pudesse ser determinado.
Os preditores contínuos foram limitados nos percentis 1º e 99º estimados na coorte de desenvolvimento. Os mesmos limiares foram aplicados à coorte de validação reservada. Os limiares não foram reestimados nos dados de validação. As variáveis com assimetria maior que 2 após a limitação foram transformadas utilizando o logaritmo natural; utilizou-se log(x + 0,01) para variáveis que poderiam conter zero. Os preditores contínuos foram padronizados utilizando a média e o desvio padrão da coorte de desenvolvimento, e os mesmos parâmetros foram aplicados aos dados de validação.
A imputação múltipla foi realizada utilizando equações encadeadas no R com o pacote mice versão 3.16.0. Vinte conjuntos de dados imputados foram gerados com 20 iterações por conjunto de dados. O pareamento preditivo de médias foi utilizado para variáveis contínuas, regressão logística para variáveis binárias e regressão logística politômica para variáveis categóricas nominais. O modelo de imputação incluiu preditores candidatos, código do centro, indicador da coorte e status de MODS para o desenvolvimento do modelo. Os resultados de validação não foram utilizados para modificar regras de pré-processamento, elegibilidade das variáveis ou limiares. As estimativas de regressão foram agrupadas utilizando as regras de Rubin quando relatadas. As métricas de predição foram calculadas dentro de cada conjunto de dados imputado e resumidas como estimativas agrupadas ou medianas com intervalos. Duas análises de sensibilidade foram pré-especificadas: análise de casos completos utilizando pacientes sem preditores ausentes no modelo final e análise do valor basal utilizando o pior valor laboratorial elegível nas primeiras 24 horas em vez do valor mais precoce.
Análise estatística e desenvolvimento do modelo
As características basais foram resumidas separadamente nas coortes de desenvolvimento e de validação de retenção. As variáveis contínuas foram apresentadas como média ± desvio padrão ou mediana com intervalo interquartílico, e as variáveis categóricas como n (%). As variáveis bioquímicas e de coagulação na admissão foram comparadas entre pacientes com e sem SDOM. O teste t de Student ou o teste de postos com sinal de Wilcoxon foram utilizados para variáveis contínuas, e o teste qui-quadrado ou o teste exato de Fisher foram utilizados para variáveis categóricas. Esses valores de P foram descritivos e não foram usados isoladamente para a seleção de preditores.
O desenvolvimento do modelo foi restrito à coorte de desenvolvimento. A regressão logística penalizada foi utilizada como modelo principal para reduzir o sobreajuste na presença de contagens limitadas de eventos e preditores laboratoriais correlacionados. O modelo foi ajustado no R versão 4.3.2 utilizando o pacote glmnet versão 4.1-8 com família binomial, preditores padronizados e penalização por operador de redução e seleção por mínimos absolutos (LASSO), especificada por alpha = 1. A validação cruzada com dez dobras repetida 10 vezes foi utilizada para ajuste da penalidade, com a semente aleatória fixada em 20260420. O parâmetro de penalidade foi selecionado utilizando a regra do erro-padrão único. O caminho dos coeficientes, os valores do erro de validação cruzada, o parâmetro de penalidade selecionado e os preditores mantidos foram salvos. O fluxo de análise é apresentado na Figura 2. O software, pacotes estatísticos, sistemas de banco de dados e plataformas laboratoriais utilizados no protocolo estão listados na Tabela de Materiais.
A regressão logística não penalizada não foi utilizada como modelo inferencial principal após a seleção penalizada. Se razões de chance foram relatadas para interpretação clínica, foram rotuladas como estimativas descritivas pós-seleção. A discriminação foi estimada usando a área sob a curva característica de operação do receptor, com intervalos de confiança de 95% calculados utilizando o método de DeLong no pacote pROC versão 1.18.5. A calibração foi avaliada usando intercepto de calibração, inclinação de calibração, escore de Brier e gráficos de calibração. A reamostragem por bootstrap com 1.000 repetições foi utilizada na coorte de desenvolvimento para estimar o desempenho corrigido para otimismo. A análise de curva de decisão não foi mantida no conjunto de análise revisado; portanto, as afirmações sobre benefício clínico líquido foram removidas do manuscrito.
Derivação e interpretação do escore
O escore composto bioquímico-coagulatório baseado em pontos foi derivado dos coeficientes do modelo penalizado fixado. Variáveis contínuas foram utilizadas durante o ajuste do modelo. Limiares categorizados foram introduzidos somente após a finalização do modelo para apoiar o cálculo à beira do leito. Os limiares foram selecionados com base em faixas de referência clínicas estabelecidas, limiares comumente usados para anormalidades laboratoriais ou pontos de corte baseados em coeficientes definidos na coorte de desenvolvimento antes da validação. Os limiares não foram otimizados na coorte de validação.
Pontos inteiros foram atribuídos de acordo com a direção e magnitude relativa dos coeficientes fixados. Pontuações mais altas indicavam perfis laboratoriais mais adversos. A pontuação total foi calculada somando-se os pontos dos componentes mantidos. Categorias de risco pré-especificadas foram usadas exclusivamente para estratificação de risco; elas não foram utilizadas para definir SMO. A pontuação tinha como objetivo identificar pacientes que poderiam necessitar de observação mais atenta, avaliação laboratorial repetida ou preparação para vias de suporte de órgãos. Ela não foi usada como uma regra diagnóstica isolada, gatilho para anticoagulação ou substituta para reavaliação clínica.
Validação com conjunto de retenção e comparação com padrões de referência
As regras fixadas de pré-processamento, estrutura de imputação, limiares de winsorização, parâmetros de padronização, coeficientes do modelo, regras de pontuação e cortes pré-especificados foram aplicados ao conjunto de validação de retenção. Nenhuma seleção adicional de preditores, refitagem do modelo, recálculo de coeficientes ou otimização de limiares foi realizada. O desempenho da validação foi resumido por meio de discriminação, calibração, escore de Brier, sensibilidade, especificidade, valor preditivo positivo e valor preditivo negativo.
As ferramentas de gravidade estabelecidas foram calculadas a partir da mesma janela de admissão, quando os dados estavam disponíveis, incluindo o Índice à Beira do Leito para Gravidade na Pancreatite Aguda, escore de Avaliação da Fisiologia Aguda e Saúde Crônica II, escore de Avaliação de Falência Orgânica Sequencial, escore de Ranson, escore de Pancreatite Aguda Inofensiva e critérios da síndrome da resposta inflamatória sistêmica. As comparações utilizaram o mesmo ponto final, população de análise e estrutura de validação. Foram realizadas comparações pareadas da área sob a curva utilizando testes de DeLong.
Todos os gráficos de validação e gráficos estratificados por escore foram gerados a partir do conjunto de dados analítico bloqueado. O tamanho da amostra em cada painel da figura foi verificado em comparação com a coorte analítica final, a coorte de desenvolvimento, a coorte de validação reservada ou o estrato de escore pré-especificado antes da preparação da figura. Métodos visuais projetados para ómica de alta dimensão, dados de contagem ecológica ou análise de abundância diferencial não foram utilizados para dados laboratoriais clínicos de rotina.
Resultados
Características da coorte e comparabilidade basal
Um total de 300 pacientes com pancreatite aguda foram incluídos na coorte analítica final. De acordo com a divisão estratificada pré-especificada de 7:3, 210 pacientes foram alocados para a coorte de desenvolvimento e 90 pacientes para a coorte de validação reservada. Todos os pacientes incluídos tinham medições bioquímicas e de coagulação elegíveis realizadas nas primeiras 24 horas após a admissão hospitalar.
As características basais são apresentadas na Tabela 1. Os grupos de desenvolvimento e validação de retenção foram semelhantes quanto à idade (54,0 anos ± 16,4 anos vs 55,3 anos ± 15,2 anos, P = 0,486), distribuição por sexo (masculino: 61,9% vs 61,1%, P = 0,898), índice de massa corporal (25,0 [22,6–27,9] kg/m2 vs 24,7 [22,2–27,5] kg/m2, P = 0,293), tempo entre o início dos sintomas e a admissão (13,2 [7,1–22,6] h vs 12,8 [6,8–21,7] h, P = 0,612) e etiologia da pancreatite aguda (P = 0,931). Comorbidades, sinais vitais na admissão, status da síndrome de resposta inflamatória sistêmica, escore do Índice à Beira do Leito para Gravidade na Pancreatite Aguda, escore de Avaliação de Falência Orgânica Sequencial e as variáveis bioquímicas e de coagulação listadas na admissão também foram equilibradas entre os dois grupos. Essas comparações confirmaram que a divisão por retenção não introduziu desequilíbrio basal clinicamente relevante.
Perfis bioquímicos e de coagulação na admissão por status de SDMO
Entre os 300 pacientes, 50 desenvolveram síndrome da disfunção orgânica múltipla (SDMO) durante a hospitalização e 250 não desenvolveram. Os perfis bioquímicos e de coagulação na admissão por status de SDMO são resumidos na Tabela 2. Em comparação com os pacientes sem SDMO, os pacientes que desenvolveram SDMO apresentaram contagem mais elevada de leucócitos (14,4 × 10⁹/L ± 5,2 × 10⁹/L vs 12,3 × 10⁹/L ± 4,6 ×10⁹/L, P = 0,008), razão neutrófilo-linfócito (13,4 [9,1–21,3] vs 9,0 [5,9–14,2], P < 0,001), proteína C-reativa (138,6 [86,9–226,7] mg/L vs 61,4 [29,2–123,8] mg/L, P < 0,001), procalcitonina (1,25 [0,56–3,28] ng/mL vs 0,43 [0,18–1,02] ng/mL, P < 0,001), lactato (2,7 [2,0–4,0] mmol/L vs 1,7 [1,2–2,4] mmol/L, P = 0,004) e glicose (11,2 [8,9–15,1] mmol/L vs 8,9 [7,3–11,4] mmol/L, P = 0,010).
O grupo MODS também apresentou níveis mais baixos de cálcio (1,96 mmol/L ± 0,21 mmol/L vs 2,06 mmol/L ± 0,17 mmol/L, P = 0,013) e albumina (32,5 g/L ± 5,6 g/L vs 35,9 g/L ± 4,8 g/L, P < 0,001), juntamente com níveis mais altos de ureia sanguínea (9,4 [7,4–13,2] mmol/L vs 6,6 [5,1–8,9] mmol/L, P < 0,001), creatinina (108,9 [84,7–163,4] µmol/L vs 77,1 [62,4–97,6] µmol/L, P < 0,001), bilirrubina total (22,1 [14,2–38,9] µmol/L vs 18,6 [12,3–31,7] µmol/L, P = 0,038) e desidrogenase láctica (372,4 [289,8–512,3] U/L vs 254,6 [203,2–329,1] U/L, P < 0,001). O tempo de protrombina, razão normalizada internacional do tempo de protrombina, tempo de tromboplastina parcial ativado e D-dímero também foram mais elevados no grupo MODS. A contagem de plaquetas (P = 0,096) e o fibrinogênio (P = 0,268) não diferiram significativamente entre os grupos. Essas comparações foram descritivas e não foram utilizadas isoladamente para a seleção de preditores.
Padrões precoces de desfecho e tendências relacionadas à pontuação
Os desfechos clínicos brutos de acordo com o status da síndrome de disfunção de múltiplos órgãos são apresentados na Figura 3. Pacientes que desenvolveram síndrome de disfunção de múltiplos órgãos tiveram uma internação hospitalar mais prolongada do que aqueles que não desenvolveram essa síndrome (Figura 3A). Eles também apresentaram maiores taxas de admissão em unidade de terapia intensiva (Figura 3B), ventilação mecânica (Figura 3C), terapia de substituição renal (Figura 3D), procedimentos por necrose infectada ou drenagem (Figura 3E) e mortalidade intra-hospitalar (Figura 3F). Todos os painéis foram gerados a partir da coorte analítica final de 300 pacientes.
Os desfechos clínicos observados nas estratas pré-especificadas com base no escore composto pontuado são apresentados na Figura 4. A incidência da síndrome de disfunção de múltiplos órgãos aumentou progressivamente entre os grupos de risco baixo, intermediário, alto e muito alto (Figura 4A). Aumentos ordenados semelhantes foram observados para admissão em unidade de terapia intensiva (Figura 4B), mortalidade hospitalar (Figura 4C) e procedimentos por necrose infectada ou drenagem (Figura 4D). A duração da internação hospitalar também aumentou ao longo das quatro estratas do escore (Figura 4E). Os gradientes foram mais acentuados para a incidência de síndrome de disfunção de múltiplos órgãos e para admissão em unidade de terapia intensiva. Todos os gráficos foram gerados a partir do conjunto de dados analíticos bloqueado, utilizando as categorias de escore pré-especificadas.
A distribuição do escore composto baseado em pontos entre as categorias de gravidade de Atlanta revisadas é apresentada na Figura 5. Os escores compostos medianos aumentaram progressivamente nas categorias de pancreatite aguda leve, moderadamente grave e grave, indicando concordância entre o escore bioquímico–coagulatório na admissão e as categorias clínicas estabelecidas de gravidade. A Figura 5 foi gerada a partir do mesmo coorte analítico fixo de 300 pacientes. Nenhuma visualização por ordenação, de abundância diferencial, de gráfico em forma de vulcão, de valor q, de distância de Bray–Curtis ou de análise de coordenadas principais foi utilizada.
Desenvolvimento do modelo penalizado e preditores mantidos
O desenvolvimento do modelo penalizado foi realizado exclusivamente na coorte de desenvolvimento. As trajetórias dos coeficientes dos preditores candidatos na admissão são mostradas na Figura 6A, e a curva de validação cruzada repetida de 10 dobras utilizada para selecionar o parâmetro de penalidade é apresentada na Figura 6B. No parâmetro de penalidade selecionado utilizando a regra do erro-padrão único, a penalização por operador de contração e seleção por mínimos absolutos manteve nove preditores na admissão: albumina, nitrogênio ureico no sangue, creatinina, cálcio, desidrogenase láctica, tempo de protrombina–razão normalizada internacional, D-dímero, contagem de plaquetas e glicose.
Os preditores mantidos e as estimativas descritivas pós-seleção são apresentados na Tabela 3. Essas estimativas foram relatadas para auxiliar a interpretação clínica e não foram tratadas como inferência confirmatória após a seleção penalizada. A direção da associação foi clinicamente coerente: menor albumina, maior nitrogênio ureico no sangue, maior creatinina, menor cálcio, maior desidrogenase láctica, maior tempo de protrombina–razão normalizada internacional, maior D-dímero, menor contagem de plaquetas e maior glicose estiveram associados ao aumento do risco de SDMO. As estimativas descritivas pós-seleção foram as seguintes: albumina por redução de 5 g/L, razão de chances 1,29 (intervalo de confiança de 95% 1,13–1,47); nitrogênio ureico no sangue por aumento de 1 mmol/L, razão de chances 1,12 (1,06–1,18); creatinina por aumento de 10 µmol/L, razão de chances 1,05 (1,02–1,09); cálcio por redução de 0,1 mmol/L, razão de chances 1,18 (1,07–1,30); desidrogenase láctica por aumento de 100 U/L, razão de chances 1,21 (1,07–1,37); tempo de protrombina–razão normalizada internacional por aumento de 0,1, razão de chances 1,14 (1,05–1,25); D-dímero por aumento de 1,0 mg/L em unidades equivalentes de fibrinogênio, razão de chances 1,09 (1,02–1,17); contagem de plaquetas por redução de 50 × 109/L, razão de chances 1,16 (1,01–1,34); e glicose por aumento de 1 mmol/L, razão de chances 1,05 (1,00–1,10).
Construção do escore composto baseado em pontos
As regras utilizadas para construir o escore composto bioquímico–coagulatório de admissão baseado em pontos são apresentadas na Tabela 4. O escore foi derivado dos coeficientes do modelo penalizado fixado e traduzido em categorias clinicamente interpretáveis para cálculo à beira do leito. Oito variáveis — albumina, nitrogênio ureico no sangue, creatinina, cálcio, desidrogenase láctica, tempo de protrombina, razão normalizada internacional, D-dímero e contagem de plaquetas — foram incluídas como componentes principais do escore. A glicose foi mantida como um modificador opcional porque sua contribuição foi menor do que a das variáveis bioquímicas e de coagulação principais, embora sua direção de associação com a síndrome de disfunção de múltiplos órgãos tenha permanecido consistente com o modelo fixado.
Um nomograma que incorpora todos os nove preditores mantidos pelo modelo penalizado travado é apresentado na Figura 7. O nomograma fornece uma estimativa individualizada da probabilidade de síndrome de disfunção de múltiplos órgãos com base nos valores de albumina, nitrogênio ureico no sangue, creatinina, cálcio, desidrogenase láctica, tempo de protrombina–razão normalizada internacional, D-dímero, contagem de plaquetas e glicose na admissão. Ele foi incluído como auxílio interpretativo, enquanto a pontuação composta baseada em pontos permaneceu a principal ferramenta prática à beira do leito, pois pode ser calculada diretamente a partir das medições laboratoriais de rotina disponíveis na admissão.
Desempenho do modelo e validação interna
O desempenho do modelo nas coortes de desenvolvimento e de validação de retenção é apresentado na Tabela 5. O modelo logístico penalizado com um termo de penalização alcançou uma área sob a curva da característica operacional do receptor de 0,873 (intervalo de confiança de 95% 0,820–0,926) na coorte de desenvolvimento e 0,836 (0,751–0,921) na coorte de validação de retenção. O escore de Brier foi de 0,117 na coorte de desenvolvimento e de 0,139 na coorte de validação de retenção. O intercepto e a inclinação da calibragem foram 0,04 (−0,08–0,16) e 0,97 (0,79–1,18) na coorte de desenvolvimento, e 0,08 (−0,14–0,30) e 0,91 (0,68–1,15) na coorte de validação de retenção.
No ponto de corte pré-especificado de risco previsto de 0,18, o modelo apresentou sensibilidade e especificidade de 0,82 e 0,77 na coorte de desenvolvimento e de 0,75 e 0,74 na coorte de validação mantida. Os valores preditivos positivo e negativo foram de 0,39 e 0,96 na coorte de desenvolvimento e de 0,39 e 0,93 na coorte de validação mantida. A pontuação composta baseada em pontos mostrou discriminação inferior ao modelo penalizado fixo, mas manteve desempenho útil para triagem, com valores da área sob a curva ROC de 0,823 na coorte de desenvolvimento e 0,783 na coorte de validação mantida. No ponto de corte pré-especificado de ≥8 pontos, a pontuação apresentou valores preditivos negativos de 0,93 e 0,91 nas coortes de desenvolvimento e de validação mantida, respectivamente.
Comparação com escores de gravidade estabelecidos
As comparações de referência com ferramentas de gravidade estabelecidas são apresentadas na Tabela 6. O modelo bioquímico-coagulatório de admissão bloqueado apresentou maior discriminação do que o escore de Ranson, o Escore de Pancreatite Aguda Inofensiva e os critérios da síndrome da resposta inflamatória sistêmica em ambas as coortes. Na coorte de desenvolvimento, o modelo não diferiu significativamente do escore de Avaliação Sequencial de Falência Orgânica segundo o teste de DeLong (P = 0,12), mas mostrou maior discriminação do que o escore de Avaliação da Fisiologia Aguda e Saúde Crônica II (P = 0,03), o Índice à Beira do Leito para Gravidade na Pancreatite Aguda (P = 0,01), o escore de Ranson (P < 0,001), o Escore de Pancreatite Aguda Inofensiva (P < 0,001) e os critérios da síndrome da resposta inflamatória sistêmica (P < 0,001). Na coorte de validação independente, as diferenças não foram significativas em comparação com o escore de Avaliação Sequencial de Falência Orgânica (P = 0,34), o escore de Avaliação da Fisiologia Aguda e Saúde Crônica II (P = 0,08) ou o Índice à Beira do Leito para Gravidade na Pancreatite Aguda (P = 0,05), mas permaneceram significativas em relação ao escore de Ranson (P = 0,02), ao Escore de Pancreatite Aguda Inofensiva (P = 0,01) e aos critérios da síndrome da resposta inflamatória sistêmica (P = 0,02).
Classificação de risco por escore baseado em pontos
Os resultados da estratificação de risco são apresentados na Tabela 7. Os pacientes foram categorizados em grupos de escore baixo (0–4 pontos), intermediário (5–8 pontos), alto (9–12 pontos) e muito alto (≥13 pontos). A incidência de SDMO aumentou de 3,5% (4/115) no grupo de baixo risco para 8,9% (9/101), 33,3% (20/60) e 70,8% (17/24) nos grupos de risco intermediário, alto e muito alto, respectivamente. A admissão em unidade de terapia intensiva aumentou de 8,7% para 23,8%, 60,0% e 83,3% ao longo dos quatro grupos. A mortalidade hospitalar aumentou de 0,9% para 2,0%, 10,0% e 25,0%, e a necrose infectada ou drenagem aumentou de 2,6% para 8,9%, 23,3% e 33,3%. A mediana do tempo de internação aumentou de 7,6 (5,2–10,4) dias no grupo de baixo risco para 11,4 (8,0–16,5), 18,6 (13,0–26,8) e 24,9 (17,5–37,2) dias nos grupos de maior risco.
Análises de sensibilidade
As análises de sensibilidade são resumidas na Tabela Suplementar 2. Essas análises avaliaram se os principais achados dependiam do tratamento de dados ausentes ou da atribuição de valores basais. Na análise de casos completos, os preditores mantidos e a direção da associação foram consistentes com a análise primária com dados imputados. A discriminação mudou apenas modestamente, com áreas sob as curvas de característica de operação do receptor de 0,861 na coorte de desenvolvimento e 0,821 na coorte de validação reservada. Na análise de sensibilidade do valor basal utilizando o pior valor laboratorial elegível nas primeiras 24 horas em vez do valor mais precoce, o modelo apresentou áreas sob a curva de característica de operação do receptor de 0,879 na coorte de desenvolvimento e 0,829 na coorte de validação reservada. A incidência de MODS estratificada por escore manteve-se ordenada entre os grupos de risco baixo, intermediário, alto e muito alto em ambas as análises de sensibilidade. Esses resultados indicam que o fluxo de trabalho bioquímico-coagulativo na admissão não foi substancialmente alterado pelas alternativas pré-especificadas de pré-processamento.
DISPONIBILIDADE DE DADOS:
O conjunto de dados anonimizado utilizado para reproduzir as principais análises, juntamente com o dicionário de dados, tabela de conversão de unidades e scripts de análise, foi depositado no Figshare com o identificador único de dados https://doi.org/10.6084/m9.figshare.32565768.v1. Os identificadores diretos dos pacientes foram removidos antes do depósito dos dados, e os identificadores dos centros foram codificados de acordo com os requisitos institucionais de proteção de dados. O repositório contém os arquivos necessários para reproduzir a descrição da coorte, o pré-processamento dos preditores, o desenvolvimento do modelo, a construção do escore, a validação com conjunto reservado, as análises de comparação, as análises de sensibilidade e as saídas por figura relatadas neste manuscrito.
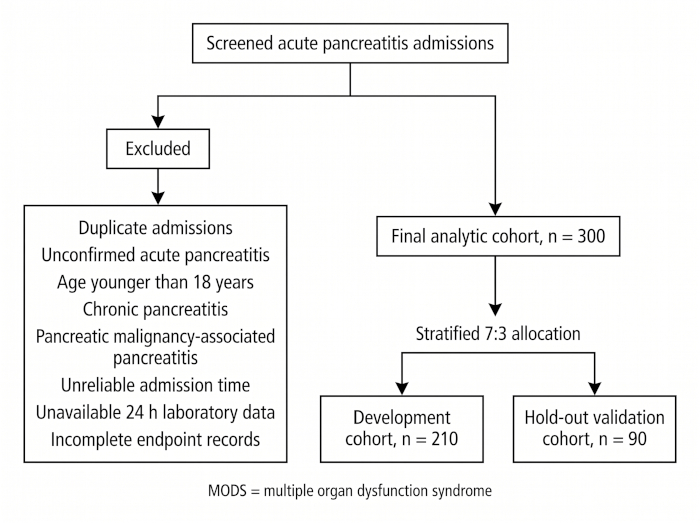
Figura 1: Rastreamento de pacientes e alocação da coorte. O fluxograma mostra as admissões consecutivas por pancreatite aguda rastreadas nos centros participantes, os motivos de exclusão, a coorte analítica final e a alocação estratificada na proporção de 7:3 entre as coortes de desenvolvimento e de validação independente. A coorte de desenvolvimento incluiu 210 pacientes, e a coorte de validação independente incluiu 90 pacientes. MODS indica síndrome de disfunção múltipla de órgãos. Clique aqui para visualizar uma versão maior desta figura.
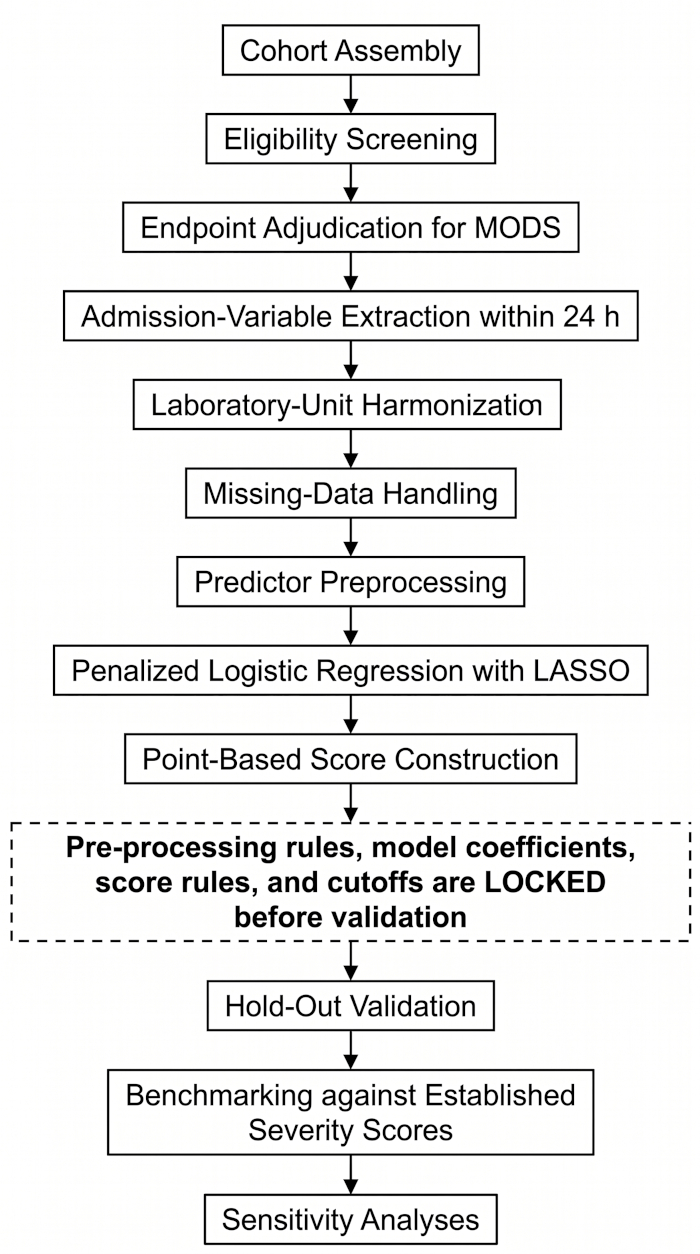
Figura 2: Fluxo de trabalho analítico reproduzível para o desenvolvimento do escore bioquímico–coagulativo na admissão. O esquema resume a montagem da coorte, triagem de elegibilidade, adjudicação do desfecho, extração de variáveis na admissão, harmonização de unidades laboratoriais, tratamento de dados ausentes, pré-processamento dos preditores, desenvolvimento do modelo penalizado, construção do escore baseado em pontos e validação externa com conjunto reservado. Todas as regras de pré-processamento, coeficientes do modelo, procedimentos de construção do escore e definições de pontos de corte foram estabelecidos na coorte de desenvolvimento antes da avaliação na coorte de validação reservada. Clique aqui para visualizar uma versão maior desta figura.
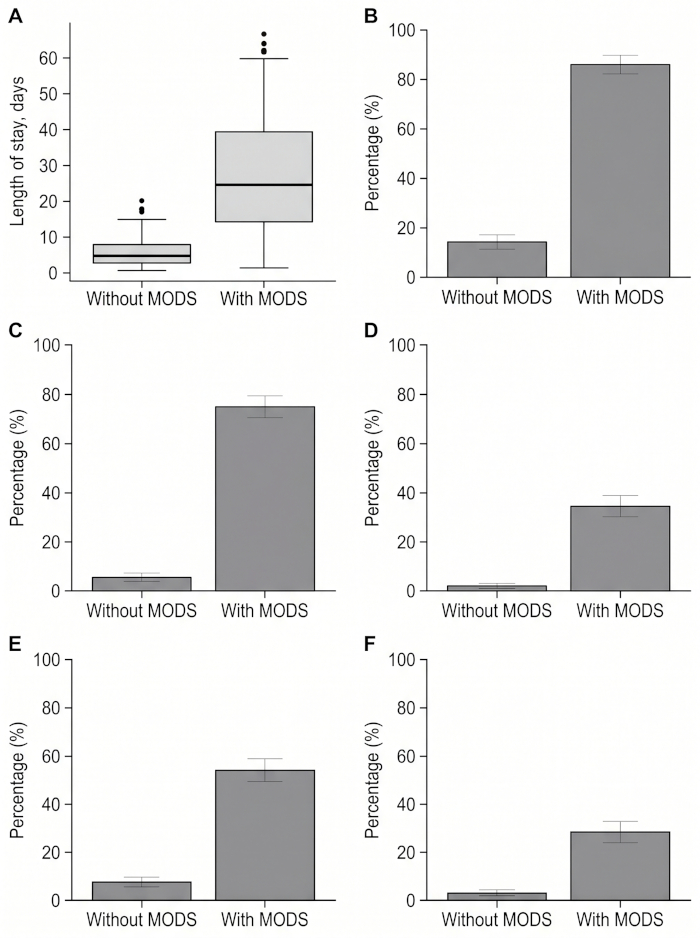
Figura 3: Resultados clínicos brutos de acordo com o status da síndrome da disfunção orgânica múltipla. (A) Tempo de internação hospitalar em pacientes sem e com síndrome da disfunção orgânica múltipla. (B) Taxas de admissão em unidade de terapia intensiva de acordo com o status da síndrome da disfunção orgânica múltipla. (C) Taxas de ventilação mecânica de acordo com o status da síndrome da disfunção orgânica múltipla. (D) Taxas de terapia de substituição renal de acordo com o status da síndrome da disfunção orgânica múltipla. (E) Taxas de necrose infectada ou procedimentos de drenagem de acordo com o status da síndrome da disfunção orgânica múltipla. (F) Taxas de mortalidade intra-hospitalar de acordo com o status da síndrome da disfunção orgânica múltipla. Todos os gráficos foram gerados a partir da coorte analítica finalizada com 300 pacientes. SDMO denota síndrome da disfunção orgânica múltipla; UTI, unidade de terapia intensiva. Clique aqui para visualizar uma versão maior desta figura.
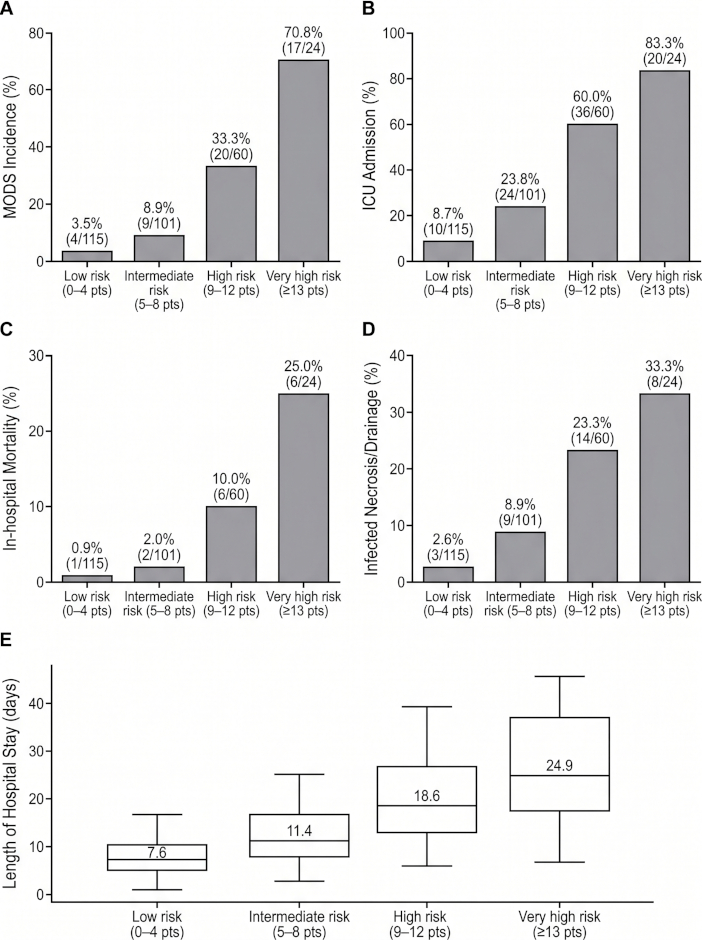
Figura 4: Taxas de desfechos observadas nas estratificações por escore composto baseado em pontos. (A) Incidência de síndrome de disfunção orgânica múltipla nos grupos de risco baixo, intermediário, alto e muito alto. (B) Taxas de admissão em unidade de terapia intensiva nas quatro estratificações de escore. (C) Taxas de mortalidade hospitalar nas quatro estratificações de escore. (D) Taxas de necrose infectada ou procedimentos de drenagem nas quatro estratificações de escore. (E) Duração da internação hospitalar nas quatro estratificações de escore. Todos os gráficos foram gerados a partir do conjunto de dados analítico bloqueado, utilizando as categorias de escore pré-especificadas: risco baixo (0–4 pontos), risco intermediário (5–8 pontos), risco alto (9–12 pontos) e risco muito alto (≥13 pontos). MODS indica síndrome de disfunção orgânica múltipla; UTI, unidade de terapia intensiva. Clique aqui para visualizar uma versão ampliada desta figura.
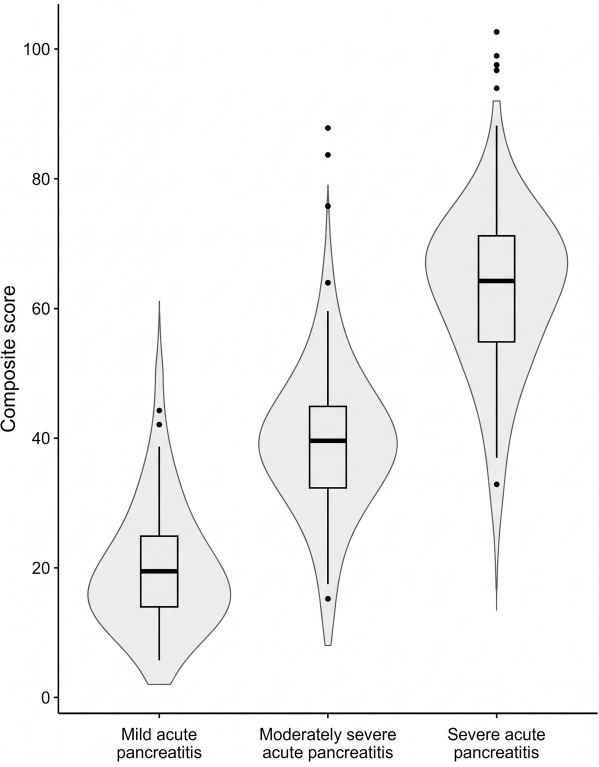
Figura 5: Distribuição do escore composto baseado em pontos entre as categorias de gravidade revisadas de Atlanta. A distribuição dos escores compostos é apresentada para pacientes com pancreatite aguda leve, moderadamente grave e grave. Os escores compostos aumentaram progressivamente ao longo das três categorias de gravidade, indicando concordância entre o escore bioquímico–de coagulação na admissão e a classificação de gravidade revisada de Atlanta. A figura foi gerada a partir da coorte analítica final de 300 pacientes. AP denota pancreatite aguda. Clique aqui para visualizar uma versão maior desta figura.
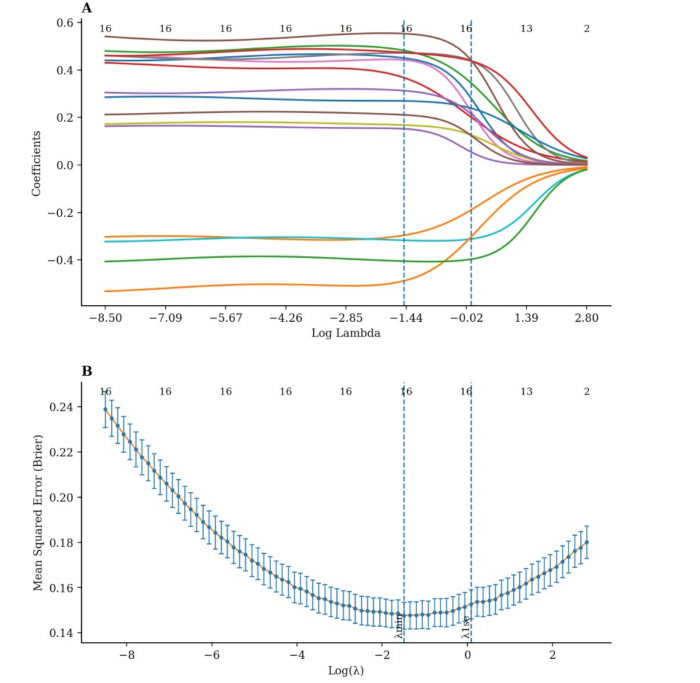
Figura 6: Desenvolvimento do modelo penalizado na coorte de desenvolvimento. (A) Trajetórias dos coeficientes do operador de contração e seleção por mínimos absolutos para os preditores bioquímicos e de coagulação candidatos na admissão. (B) Os resultados da validação cruzada repetida com 10 partições foram utilizados para selecionar o parâmetro de penalização. A regra do erro-padrão único foi aplicada para obter um modelo enxuto e fixo para a construção do escore e validação em conjunto separado. LASSO indica o operador de contração e seleção por mínimos absolutos; PT-INR, tempo de protrombina-razão normalizada internacional. Clique aqui para visualizar uma versão maior desta figura.
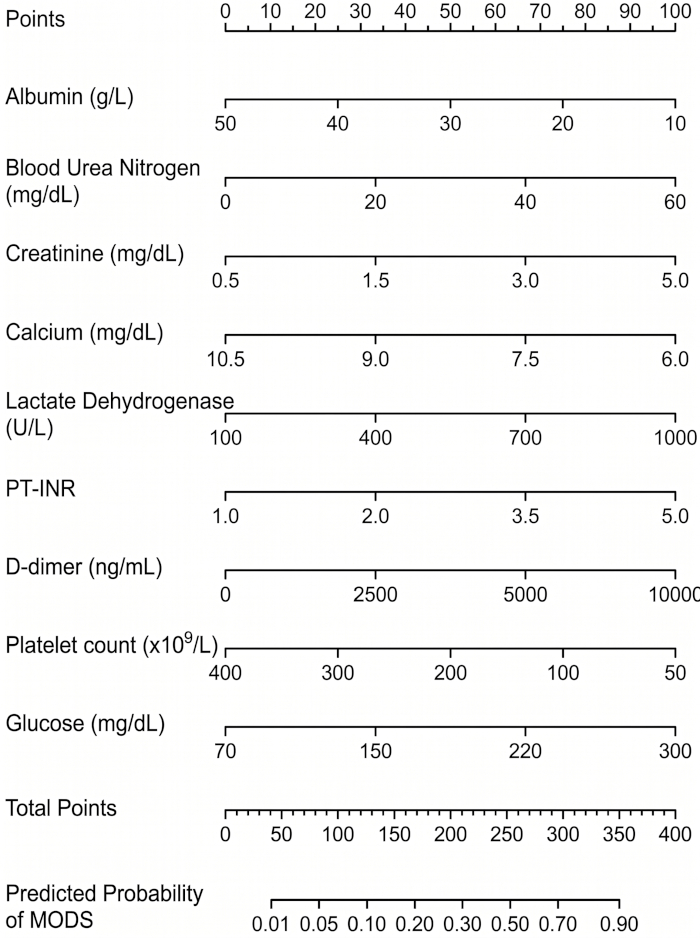
Figura 7: Nômograma baseado no modelo de predição fixado para estimativa de risco individualizada. O nômograma incorpora os nove preditores na admissão mantidos pelo modelo penalizado fixado: albumina, nitrogênio ureico no sangue, creatinina, cálcio, desidrogenase láctica, tempo de protrombina–razão normalizada internacional, D-dímero, contagem de plaquetas e glicose. Cada preditor contribui com pontos para uma pontuação total que corresponde à probabilidade estimada de síndrome de disfunção orgânica múltipla. O nômograma foi incluído como auxílio interpretativo, enquanto a pontuação composta baseada em pontos permaneceu a principal ferramenta prática à beira do leito. SDMO denota síndrome de disfunção orgânica múltipla; PT-INR, tempo de protrombina–razão normalizada internacional; FEU, unidades equivalentes à fibrinogênio. Clique aqui para visualizar uma versão maior desta figura.
| Variável | Cohorte de desenvolvimento n=210 | Cohorte de validação hold-out n=90 | Valor P |
| Idade, anos | 54,0 ± 16,4 | 55,3 ± 15,2 | 0,486 |
| Sexo masculino, n (%) | 130 (61,9) | 55 (61,1) | 0,898 |
| Índice de massa corporal, kg/m² | 25,0 (22,6–27,9) | 24,7 (22,2–27,5) | 0,293 |
| Tempo entre o início dos sintomas e a admissão, h | 13,2 (7,1–22,6) | 12,8 (6,8–21,7) | 0,612 |
| Etiologia, n (%) | 0,931 | ||
| Biliar | 89 (42,4) | 38 (42,2) | |
| Hipertrigliceridemia | 65 (31,0) | 29 (32,2) | |
| Relacionada ao álcool | 19 (9,0) | 8 (8,9) | |
| Idiopática | 25 (11,9) | 11 (12,2) | |
| Outra | 12 (5,7) | 4 (4,4) | |
| Pancreatite prévia, n (%) | 31 (14,8) | 12 (13,3) | 0,742 |
| Histórico de tabagismo, n (%) | 58 (27,6) | 24 (26,7) | 0,868 |
| Diabetes mellitus, n (%) | 37 (17,6) | 17 (18,9) | 0,795 |
| Hipertensão, n (%) | 62 (29,5) | 28 (31,1) | 0,784 |
| Doença renal crônica, n (%) | 8 (3,8) | 4 (4,4) | 0,797 |
| Frequência cardíaca na admissão, batimentos/min | 92,4 ± 15,8 | 93,1 ± 16,2 | 0,726 |
| Pressão arterial média, mmHg | 88,6 ± 12,4 | 87,9 ± 11,8 | 0,65 |
| Síndrome de resposta inflamatória sistêmica, n (%) | 72 (34,3) | 30 (33,3) | 0,871 |
| Pontuação no Índice à Beira do Leito para Gravidade na Pancreatite Aguda | 1,0 (0,0–2,0) | 1,0 (0,0–2,0) | 0,842 |
| Pontuação na Avaliação Sequencial de Falência de Órgãos | 1,0 (0,0–2,0) | 1,0 (0,0–2,0) | 0,796 |
| Pontuação no Sistema de Avaliação da Fisiologia Aguda e Saúde Crônica II | 7,0 (5,0–10,0) | 7,0 (5,0–10,0) | 0,884 |
| Síndrome de disfunção de múltiplos órgãos, n (%) | 35 (16,7) | 15 (16,7) | 1 |
| Contagem de leucócitos, ×10⁹/L | 12,8 ± 4,7 | 12,9 ± 4,9 | 0,865 |
| Proteína C-reativa, mg/L | 70,6 (32,8–141,5) | 72,4 (35,1–145,9) | 0,778 |
| Glicose, mmol/L | 9,1 (7,4–11,8) | 9,0 (7,2–11,6) | 0,691 |
| Cálcio total, mmol/L | 2,05 ± 0,18 | 2,04 ± 0,19 | 0,672 |
| Nitrogênio ureico no sangue, mmol/L | 6,9 (5,2–9,4) | 7,1 (5,3–9,6) | 0,584 |
| Creatinina, μmol/L | 80,2 (64,5–104,8) | 81,1 (65,1–106,2) | 0,731 |
| Albumina, g/L | 35,2 ± 5,1 | 35,0 ± 5,0 | 0,754 |
| Desidrogenase láctica, U/L | 270,8 (212,5–356,7) | 275,6 (216,2–361,4) | 0,637 |
| Razão normalizada internacional do tempo de protrombina | 1,09 (1,02–1,18) | 1,10 (1,03–1,19) | 0,694 |
| Dímero D, mg/L unidades equivalentes de fibrinogênio | 1,84 (0,92–3,82) | 1,91 (0,95–3,96) | 0,744 |
| Contagem de plaquetas, ×10⁹/L | 203,6 ± 68,4 | 201,8 ± 66,9 | 0,836 |
Tabela 1: Características basais dos pacientes nas coortes de desenvolvimento e de validação independente. As variáveis basais demográficas, clínicas, de escore de gravidade, bioquímicas e de coagulação são comparadas entre as coortes de desenvolvimento e de validação independente. Variáveis contínuas são apresentadas como média ± desvio padrão ou mediana (intervalo interquartil), e variáveis categóricas como n (%). Valores de P são utilizados para comparações descritivas entre as coortes.
| Variável | Grupo sem MODS n = 250 | Grupo com MODS n = 50 | Valor de p |
| Contagem de leucócitos, ×10⁹/L | 12,3 ± 4,6 | 14,4 ± 5,2 | 0,008 |
| Razão neutrófilo-linfócito | 9,0 (5,9–14,2) | 13,4 (9,1–21,3) | <0,001 |
| Proteína C-reativa, mg/L | 61,4 (29,2–123,8) | 138,6 (86,9–226,7) | <0,001 |
| Procalcitonina, ng/mL | 0,43 (0,18–1,02) | 1,25 (0,56–3,28) | <0,001 |
| Lactato, mmol/L | 1,7 (1,2–2,4) | 2,7 (2,0–4,0) | 0,004 |
| Glicose, mmol/L | 8,9 (7,3–11,4) | 11,2 (8,9–15,1) | 0,01 |
| Cálcio total, mmol/L | 2,06 ± 0,17 | 1,96 ± 0,21 | 0,013 |
| Nitrogênio ureico no sangue, mmol/L | 6,6 (5,1–8,9) | 9,4 (7,4–13,2) | <0,001 |
| Creatinina, μmol/L | 77,1 (62,4–97,6) | 108,9 (84,7–163,4) | <0,001 |
| Alanina aminotransferase, U/L | 46,2 (25,6–93,8) | 58,7 (31,5–119,4) | 0,084 |
| Bilirrubina total, μmol/L | 18,6 (12,3–31,7) | 22,1 (14,2–38,9) | 0,038 |
| Albumina, g/L | 35,9 ± 4,8 | 32,5 ± 5,6 | <0,001 |
| Desidrogenase láctica, U/L | 254,6 (203,2–329,1) | 372,4 (289,8–512,3) | <0,001 |
| Contagem de plaquetas, ×10⁹/L | 207,4 ± 67,2 | 190,3 ± 72,5 | 0,096 |
| Tempo de protrombina, s | 12,7 (11,8–13,9) | 14,1 (12,9–15,7) | 0,002 |
| Razão normalizada internacional do tempo de protrombina | 1,08 (1,02–1,16) | 1,22 (1,10–1,38) | 0,002 |
| Tempo de tromboplastina parcial ativada, s | 31,8 (28,4–36,5) | 36,9 (31,7–42,8) | 0,006 |
| Fibrinogênio, g/L | 4,12 ± 1,18 | 4,31 ± 1,29 | 0,268 |
| D-dímero, mg/L em unidades equivalentes de fibrinogênio | 1,48 (0,78–3,16) | 4,62 (2,10–8,95) | <0,001 |
Tabela 2: Perfil bioquímico e de coagulação na admissão de acordo com o status da síndrome de disfunção de múltiplos órgãos. Os índices laboratoriais representam a primeira medição elegível obtida nas 24 horas seguintes à admissão hospitalar. As variáveis contínuas são apresentadas como média ± desvio padrão ou mediana (intervalo interquartílico). Os valores de P correspondem a comparações descritivas entre pacientes que desenvolveram síndrome de disfunção de múltiplos órgãos e aqueles que não desenvolveram. Essas comparações foram utilizadas para caracterizar as diferenças na admissão e não foram usadas isoladamente para seleção de preditores.
| Preditor mantido no modelo bloqueado | Direção associada ao maior risco de MODS | Unidade padronizada para interpretação | Razão de chances descritiva | Intervalo de confiança de 95% | Papel na modelagem |
| Albumina | Valor mais baixo | Por redução de 5 g/L | 1,29 | 1,13–1,47 | Componente principal da pontuação |
| Nitrogênio ureico no sangue | Valor mais alto | Por aumento de 1 mmol/L | 1,12 | 1,06–1,18 | Componente principal da pontuação |
| Creatinina | Valor mais alto | Por aumento de 10 μmol/L | 1,05 | 1,02–1,09 | Componente principal da pontuação |
| Cálcio total | Valor mais baixo | Por redução de 0,1 mmol/L | 1,18 | 1,07–1,30 | Componente principal da pontuação |
| Desidrogenase láctica | Valor mais alto | Por aumento de 100 U/L | 1,21 | 1,07–1,37 | Componente principal da pontuação |
| Tempo de protrombina - razão normalizada internacional | Valor mais alto | Por aumento de 0,1 | 1,14 | 1,05–1,25 | Componente principal da pontuação |
| Dímero D | Valor mais alto | Por aumento de 1,0 mg/L em unidades equivalentes de fibrinogênio | 1,09 | 1,02–1,17 | Componente principal da pontuação |
| Contagem de plaquetas | Valor mais baixo | Por redução de 50 × 10⁹/L | 1,16 | 1,01–1,34 | Componente principal da pontuação |
| Glicose | Valor mais alto | Por aumento de 1 mmol/L | 1,05 | 1,00–1,10 | Modificador opcional |
Tabela 3: Preditores mantidos no modelo penalizado com penalização fixa e estimativas descritivas pós-seleção. A tabela mostra os preditores mantidos pelo modelo logístico penalizado com operador de contração e seleção por mínimos absolutos com penalização fixa e as estimativas descritivas pós-seleção para interpretação clínica. As razões de chances são apresentadas para as unidades padronizadas indicadas. Essas estimativas não são tratadas como inferência confirmatória após a seleção penalizada.
| Componente da Pontuação | Categoria | Pontos Atribuídos |
| Albumina, g/L | ≥38 | 0 |
| 34–37,9 | 1 | |
| 30–33,9 | 2 | |
| <30 | 3 | |
| Nitrogênio ureico no sangue, mmol/L | <6,5 | 0 |
| 6,5–8,9 | 1 | |
| 9,0–12,9 | 2 | |
| ≥13,0 | 3 | |
| Creatinina, μmol/L | <80 | 0 |
| 80–109 | 1 | |
| 110–169 | 2 | |
| ≥170 | 3 | |
| Cálcio total, mmol/L | ≥2,10 | 0 |
| 2,00–2,09 | 1 | |
| 1,90–1,99 | 2 | |
| <1,90 | 3 | |
| Desidrogenase láctica, U/L | <250 | 0 |
| 250–349 | 1 | |
| 350–499 | 2 | |
| ≥500 | 3 | |
| Tempo de protrombina - razão normalizada internacional | <1,10 | 0 |
| 1,10–1,19 | 1 | |
| 1,20–1,39 | 2 | |
| ≥1,40 | 3 | |
| D-dímero, mg/L em unidades equivalentes a fibrinogênio | <1,0 | 0 |
| 1,0–2,9 | 1 | |
| 3,0–5,9 | 2 | |
| ≥6,0 | 3 | |
| Contagem de plaquetas, ×10⁹/L | ≥200 | 0 |
| 150–199 | 1 | |
| 100–149 | 2 | |
| <100 | 3 | |
| Glicose, mmol/L | <10,0 | 0 |
| ≥10,0 | 1 |
Tabela 4: Construção do escore composto bioquímico–coagulativo de admissão.
A pontuação composta baseada em pontos foi derivada do modelo penalizado bloqueado e traduzida em categorias clínicas interpretáveis à beira do leito. Pontos foram atribuídos de acordo com a direção e contribuição relativa dos preditores mantidos. Os pontos totais são calculados somando-se todos os componentes da pontuação mantidos. A glicose foi mantida como um modificador opcional porque sua associação era mais fraca do que a dos componentes bioquímicos–coagulativos principais, mas permaneceu consistentemente direcional com o aumento do risco.
| Ferramenta | Cohorte | AUC | Pontuação de Brier | Intercepto de calibração | Inclinação da calibração | Valor de corte | Sensibilidade | Especificidade | VPV | VNV |
| (IC 95%) | (IC 95%) | (IC 95%) | ||||||||
| Modelo penalizado bloqueado | Cohorte de desenvolvimento | 0.873 (0.820–0.926) | 0.117 | 0.04 (−0.08 a 0.16) | 0.97 (0.79–1.18) | Risco previsto ≥0,18 | 0,82 | 0,77 | 0,39 | 0,96 |
| Modelo penalizado bloqueado | Cohorte de validação reservada | 0.836 (0.751–0.921) | 0.139 | 0.08 (−0,14 a 0,30) | 0.91 (0.68–1.15) | Risco previsto ≥0,18 | 0,75 | 0,74 | 0,39 | 0,93 |
| Pontuação composta baseada em pontos | Cohorte de desenvolvimento | 0.823 (0.758–0.888) | 0.132 | Não aplicável | Não aplicável | ≥8 pontos | 0,76 | 0,72 | 0,35 | 0,93 |
| Pontuação composta baseada em pontos | Cohorte de validação reservada | 0.783 (0.684–0.882) | 0.151 | Não aplicável | Não aplicável | ≥8 pontos | 0,7 | 0,69 | 0,31 | 0,91 |
Tabela 5: Desempenho do modelo penalizado fixado e do escore composto baseado em pontos. São apresentados o poder de discriminação, calibração e desempenho baseado em limiares para as coortes de desenvolvimento e validação independente. A discriminação é relatada como a área sob a curva ROC (característica de operação do receptor) com intervalo de confiança de 95%. A calibração é resumida pelo escore de Brier, intercepto de calibração e inclinação de calibração. As métricas de limiar são relatadas em pontos de corte pré-especificados: risco predito ≥0,18 para o modelo penalizado fixado e escore ≥8 pontos para o escore composto baseado em pontos.
| Ferramenta de Previsão | Desenvolvimento AUC | Valor P de DeLong versus modelo fixo | AUC da Validação por Conjunto de Retenção | Valor P de DeLong versus modelo fixo |
| (IC 95%) | (Desenvolvimento) | (IC 95%) | (Validação) | |
| Modelo bioquímico-coagulativo travado | 0.873 (0.820–0.926) | Referência | 0.836 (0.751–0.921) | Referência |
| Pontuação de Avaliação de Falência Orgânica Sequencial | 0.842 (0.780–0.904) | 0.12 | 0.810 (0.712–0.908) | 0.34 |
| Pontuação de Avaliação da Fisiologia Aguda e Saúde Crônica II | 0.812 (0.744–0.880) | 0.03 | 0.790 (0.682–0.898) | 0.08 |
| Pontuação do Índice Clínico para Gravidade na Pancreatite Aguda | 0.795 (0.724–0.866) | 0.01 | 0.765 (0.648–0.882) | 0.05 |
| escore de Ranson | 0.742 (0.661–0.823) | <0.001 | 0.701 (0.577–0.825) | 0.02 |
| Pontuação de Pancreatite Aguda Inofensiva | 0.701 (0.618–0.784) | <0.001 | 0.688 (0.560–0.816) | 0.01 |
| Critérios da síndrome da resposta inflamatória sistêmica | 0.684 (0.598–0.770) | <0.001 | 0.672 (0.541–0.803) | 0.02 |
Tabela 6: Comparação de referência com ferramentas estabelecidas de gravidade. O modelo bioquímico-coagulativo fixo na admissão é comparado com ferramentas estabelecidas de gravidade da pancreatite aguda ou disfunção orgânica, calculadas a partir da mesma janela de admissão, quando os dados estavam disponíveis. São apresentados os valores da área sob a curva ROC com intervalos de confiança de 95% para as coortes de desenvolvimento e de validação independente. Testes de DeLong pareados comparam cada ferramenta de referência com o modelo bioquímico-coagulativo fixo dentro de cada coorte.
| Categoria de risco | Faixa de pontuação | Pacientes, n | Incidência de MODS, n (%) | Admissão em UTI, n | Ventilação mecânica, n (%) | Terapia de substituição renal, n (%) | Mortalidade hospitalar, n (%) | Necrose infectada ou drenagem, n (%) | Tempo de internação, dias |
| (%) | |||||||||
| Risco baixo | 0–4 | 115 | 4 (3,5) | 10 (8,7) | 3 (2,6) | 1 (0,9) | 1 (0,9) | 3 (2,6) | 7,6 (5,2–10,4) |
| Risco intermediário | 5–8 | 101 | 9 (8,9) | 24 (23,8) | 9 (8,9) | 4 (4,0) | 2 (2,0) | 9 (8,9) | 11,4 (8,0–16,5) |
| Risco alto | 9–12 | 60 | 20 (33,3) | 36 (60,0) | 18 (30,0) | 10 (16,7) | 6 (10,0) | 14 (23,3) | 18,6 (13,0–26,8) |
| Risco muito alto | ≥13 | 24 | 17 (70,8) | 20 (83,3) | 13 (54,2) | 7 (29,2) | 6 (25,0) | 8 (33,3) | 24,9 (17,5–37,2) |
Tabela 7: Estratificação de risco por escore composto baseado em pontos. Os pacientes são categorizados em grupos de risco baixo, intermediário, alto e muito alto com base nos pontos totais do escore. São relatadas a incidência observada de síndrome de disfunção de múltiplos órgãos e os principais desfechos clínicos conforme as estratificações por escore. Os desfechos categóricos são apresentados como n (%), e o tempo de internação é apresentado como mediana (intervalo interquartil).
Tabela Suplementar 1: Critérios operacionais para a adjudicação do desfecho na síndrome de disfunção de múltiplos órgãos. A tabela define os critérios pré-especificados por sistema orgânico utilizados para adjudicar disfunções respiratória, cardiovascular, renal, hepática, da coagulação e neurológica. O desfecho final foi atribuído quando ocorreu disfunção de dois ou mais sistemas orgânicos durante a hospitalização. Dois revisores treinados avaliaram independentemente cada caso, e as discordâncias foram resolvidas por um terceiro revisor sênior.Clique aqui para baixar este arquivo.
Tabela Suplementar 2: Análises de sensibilidade para o tratamento de dados ausentes e atribuição de valores basais. A tabela resume a análise principal com dados imputados e análises de sensibilidade previamente especificadas, incluindo análise de casos completos, atribuição do pior valor basal nas primeiras 24 horas e verificação de desempenho ajustada por centro. As análises avaliam se a discriminação do modelo, o escore de Brier, o padrão de preditores mantidos e os gradientes de risco estratificados por escore foram substancialmente alterados por alternativas de pré-processamento.Clique aqui para baixar este arquivo.
Discussão
A síndrome da disfunção múltipla de órgãos (MODS) associada à pancreatite aguda pode evoluir em um curto período após a admissão hospitalar, especialmente em pacientes com inflamação sistêmica precoce, lesão endotelial, perfusão tecidual comprometida e instabilidade metabólica. O presente protocolo foi desenvolvido com base nesse período de admissão, pois as primeiras 24 horas frequentemente determinam se um paciente permanecerá sob observação de rotina na enfermaria ou necessitará reavaliação mais rigorosa, monitoramento aumentado ou preparação para vias de suporte orgânico. Os resultados mostraram que variáveis bioquímicas e de coagulação rotineiramente disponíveis, quando processadas por meio de um fluxo de trabalho de modelagem fixo e reprodutível, podem ser organizadas em um escore interpretável para estratificação precoce do risco de MODS na pancreatite aguda11. Essa abordagem está de acordo com a realidade clínica de que biomarcadores únicos ou classificações tardias de gravidade podem não captar plenamente o padrão de deterioração sistêmica precoce observado na pancreatite aguda de alto risco12.
A justificativa biológica para combinar variáveis bioquímicas e de coagulação é clinicamente plausível. A pancreatite aguda grave não é desencadeada por uma única via isolada; inflamação sistêmica, ativação endotelial, vazamento capilar, hipoperfusão renal, ativação da coagulação e distúrbio da microcirculação podem se reforçar mutuamente durante a deterioração inicial. Os preditores bioquímicos mantidos refletiram esse processo multifatorial. A albumina mais baixa pode indicar vazamento vascular relacionado à inflamação e reserva fisiológica reduzida, enquanto ureia e creatinina mais elevadas são compatíveis com hipovolemia, hipoperfusão renal ou lesão renal precoce. Cálcio mais baixo, desidrogenase láctica mais elevada e glicose mais alta podem refletir estresse metabólico, lesão tecidual e maior gravidade de desregulação inflamatória sistêmica13. Os preditores de coagulação acrescentaram um sinal complementar: tempo de protrombina com razão normalizada internacional prolongada, D-dímero elevado e contagem plaquetária mais baixa podem indicar ativação da coagulação, renovação de fibrina, consumo de plaquetas e comprometimento da microcirculação antes mesmo que a disfunção orgânica evidente esteja plenamente estabelecida14. O aumento progressivo na incidência de SDOM e nos desfechos secundários ao longo das estratificações do escore, portanto, sugere que o escore captou um padrão clinicamente coerente de deterioração sistêmica precoce, e não meras anormalidades laboratoriais isoladas.
Uma contribuição metodológica fundamental deste estudo é a ênfase na reprodutibilidade. O protocolo revisado fixou a janela de admissão, utilizou o valor laboratorial elegível mais precoce dentro de 24 h, aplicou regras explícitas de harmonização de unidades, definiu limiares de ausência de dados, padronizou o pré-processamento e restringiu o ajuste do modelo à coorte de desenvolvimento. Essas etapas afetam diretamente se o escore pode ser reproduzido entre instituições. Por exemplo, a notificação de D-dímero varia entre laboratórios, e unidades equivalentes a fibrinogênio não podem ser presumidas quando os laudos locais utilizam unidades de D-dímero sem um fator de conversão validado. Da mesma forma, a ausência de valores laboratoriais pode refletir os fluxos locais de testes, e não uma ausência aleatória de dados15. Várias etapas do protocolo são, portanto, críticas: a regra da linha de base de 24 h deve ser aplicada de forma consistente, valores laboratoriais pós-MODS não devem ser usados na construção dos preditores, a adjudicação do desfecho deve seguir critérios pré-especificados por sistema orgânico, os valores laboratoriais devem ser convertidos para unidades-alvo comuns antes da agregação e a coorte de validação reservada não deve ser utilizada para seleção de características, recálculo de coeficientes ou ajuste de pontos de corte16.
O fluxo de trabalho pode ser modificado para diferentes contextos institucionais, mas tais modificações devem permanecer previamente especificadas. Se uma variável candidata apresentar uma quantidade excessiva de dados ausentes porque não é rotineiramente medida na admissão, ela deve ser excluída do desenvolvimento do modelo em vez de ser imputada além de um limite justificável. Se as unidades de D-dímero não puderem ser harmonizadas para unidades equivalentes a fibrinogênio, o valor deve ser tratado como não harmonizável em vez de convertido com base em uma suposição não comprovada. Se os laboratórios locais utilizarem plataformas de ensaio diferentes, a análise principal pode manter os valores clínicos absolutos, enquanto análises de sensibilidade incluem o código do centro ou a plataforma do ensaio como fatores de ajuste. Se o número de eventos de SDOM for menor do que o esperado, a estratégia de modelagem deve favorecer uma redução mais acentuada, um número menor de preditores mantidos ou uma estrutura de escore mais simples, em vez de expandir o modelo para ajustar sinais instáveis17. A solução prática de problemas também deve incluir verificar se os testes de coagulação são rotineiramente solicitados na admissão, se as distribuições dos preditores diferem inesperadamente entre centros, se os limiares de validação foram inadvertidamente reajustados e se cada painel de figura corresponde ao conjunto de dados analítico fixado18.
Os resultados devem ser interpretados com várias limitações. A coorte de validação mantida foi derivada do mesmo conjunto de dados retrospectivo e multicêntrico e, portanto, representa uma validação interna mantida, e não uma validação externa independente. A contagem de eventos foi limitada, aumentando o risco de retenção instável de preditores mesmo com modelagem penalizada. As razões de chances descritivas após a seleção foram incluídas apenas para apoiar a interpretação clínica e não devem ser tratadas como inferência confirmatória. Alguns componentes do desfecho dependiam da qualidade da documentação nos prontuários eletrônicos, e diferenças não medidas entre centros nas práticas clínicas podem ter influenciado as decisões sobre suporte de órgãos. A análise de curva de decisão não foi mantida no conjunto de análises revisado; portanto, o manuscrito não afirma benefício clínico líquido ao longo de probabilidades limiares19. A pontuação também não deve substituir a avaliação estabelecida de gravidade, exames clínicos repetidos, exames de imagem quando indicados ou o julgamento clínico. Pontuações baixas podem apoiar a observação rotineira e a reavaliação padrão, mas não excluem deterioração posterior; pontuações mais altas devem ser interpretadas como estímulos para monitoramento mais próximo, reavaliação laboratorial repetida e preparação precoce para vias de suporte de órgãos, e não como prescrições fixas de tratamento20.
No geral, este estudo apresenta um fluxo de trabalho reprodutível de pontuação bioquímica–coagulativa na admissão para estratificação precoce de risco de SDMO na pancreatite aguda. O modelo penalizado fixo e a pontuação baseada em pontos demonstraram discriminação consistente e gradientes de risco ordenados nas coortes de desenvolvimento e de validação independente, enquanto as análises de sensibilidade sugeriram que os principais achados não foram substancialmente alterados por alternativas pré-especificadas de dados ausentes ou valores basais. O principal valor da abordagem reside na organização de dados laboratoriais de rotina disponíveis na admissão em um sinal de risco precoce interpretável, que pode apoiar a triagem, ajustar a intensidade da monitorização e preparar para vias de suporte orgânico21. Estudos futuros devem priorizar a validação externa prospectiva em hospitais com plataformas laboratoriais distintas, avaliação da calibração em tempo real, comparação com calculadoras eletrônicas de risco derivadas do mesmo modelo fixo e avaliação de se as vias de monitorização orientadas pela pontuação reduzem a escalada tardia sem aumentar o uso desnecessário de cuidados intensivos22.
Divulgações
Os autores declaram que não têm conflitos de interesse relevantes para este estudo.
Agradecimentos
Os autores gostariam de agradecer a todos os clínicos e funcionários de laboratório envolvidos no diagnóstico, tratamento e coleta de dados de pacientes com pancreatite aguda. Também somos gratos aos pacientes cujos dados clínicos permitiram este estudo. Sua contribuição é sinceramente apreciada.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Nome | Nome da empresa | Número do catálogo / URL | Comentários |
| Software estatístico R | Foundation for Statistical Computing | Versão 4.3.2 https://www.r-project.org/ | Ambiente de computação estatística utilizado para pré-processamento de dados, desenvolvimento de modelos, validação e geração de figuras. |
| Pacote R caret | CRAN / Max Kuhn | Versão 6.0-94 https://cran.r-project.org/package=caret | Utilizado para divisão estratificada 7:3 entre conjunto de desenvolvimento e validação com hold-out, usando a função createDataPartition. |
| Pacote R glmnet | CRAN / autores do glmnet | Versão 4.1-8 https://cran.r-project.org/package=glmnet | Utilizado para regressão logística com penalização LASSO, família binomial e alpha = 1. |
| Pacote R mice | CRAN / projeto amices | Versão 3.16.0 https://cran.r-project.org/package=mice | Utilizado para imputação múltipla por equações encadeadas com 20 conjuntos de dados imputados e 20 iterações. |
| Pacote R pROC | CRAN / autores do pROC | Versão 1.18.5 https://cran.r-project.org/package=pROC | Utilizado para análise ROC, estimativa da AUC, intervalos de confiança e comparações de DeLong. |
| Série de analisadores modulares cobas 8000 | Roche Diagnostics | 05641446001 / SYS_128 https://diagnostics.roche.com/global/en/products/systems/cobas-8000-analyzer-series-sys-128.html | Ensaios bioquímicos e imunoquímicos. Verifique o modelo do analisador e as informações do catálogo com os registros do laboratório participante antes do envio. |
| Analisador hematológico automatizado XN-1000 | Sysmex Corporation | Modelo XN-1000 https://www.sysmex.com/en-us/lab-solutions/hematology/xn-series/xn-1000 | Variáveis de contagem sanguínea completa, incluindo contagem de leucócitos e plaquetas. Verifique com os registros do laboratório participante antes do envio. |
| Analisador automatizado de coagulação sanguínea CS-5100 | Sysmex Corporation | Modelo CS-5100 https://www.sysmex.com/en-us/lab-solutions/hemostasis/sysmex-cs-5100 | Variáveis de coagulação, incluindo TP, TTPA, fibrinogênio e D-dímero. Verifique com os registros do laboratório participante antes do envio. |
| Analisador de gases sanguíneos ABL90 FLEX PLUS | Radiometer Medical ApS | Modelo ABL90 FLEX PLUS https://www.radiometer.com/en/products/blood-gas-testing/abl90-flex-plus-blood-gas-analyzer | Medição de lactato, caso esta plataforma tenha sido utilizada. Verifique com os registros do laboratório participante antes do envio. |
| Sistema de prontuário eletrônico | Hospitais participantes | Específico da instituição; não aplicável | Utilizado para recuperar anotações de admissão, evoluções, registros de UTI, procedimentos, sinais vitais e prontuários de alta. Substitua pelo nome real do fornecedor e do sistema quando disponível. |
| Sistema de informações laboratoriais | Hospitais participantes | Específico da instituição; não aplicável | Utilizado para recuperar carimbos de tempo laboratoriais, valores brutos, unidades e dados harmonizados. Substitua pelo nome real do fornecedor e do sistema quando disponível. |
| Formulário de adjudicação de desfecho | Equipe do estudo | Documento personalizado do estudo; não aplicável | Formulário padronizado utilizado por dois revisores e um terceiro revisor sênior para adjudicar o status e o início da SDMO. |
| Dicionário de dados e tabela de conversão de unidades | Equipe do estudo | Documento personalizado do estudo; não aplicável | Define nomes de variáveis, unidades-alvo, regras de conversão, indicadores de ausência, códigos dos centros e formatos prontos para análise. |
Referências
- Banks PA, et al. Classification of acute pancreatitis-2012: revision of the Atlanta classification and definitions by international consensus. Gut. 2013;62(1):102-111.
- Wu BU, et al. The early prediction of mortality in acute pancreatitis: a large population-based study. Gut. 2008;57(12):1698-1703.
- Tenner S, et al. American College of Gastroenterology Guidelines: Management of Acute Pancreatitis. Am J Gastroenterol. 2024;119(3):419-437.
- Lee DW, Cho CM. Predicting severity of acute pancreatitis. Medicina (Kaunas). 2022;58(6):787.
- Metri A, Bush N, Singh VK. Predicting the severity of acute pancreatitis: current approaches and future directions. Surg Open Sci. 2024;19:109-117.
- Efthimiou O, et al. Developing clinical prediction models: a step-by-step guide. BMJ. 2024;386.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162(1):55-63.
- Li L, et al. Coagulopathy and acute pancreatitis: pathophysiology and clinical treatment. Front Immunol. 2024;15:1477160.
- Wan J, et al. Serum D-dimer levels at admission for prediction of outcomes in acute pancreatitis. BMC Gastroenterol. 2019;19:67.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310(20):2191-2194.
- Garg PK, Singh VP. Organ failure due to systemic injury in acute pancreatitis. Gastroenterology. 2019;156(7):2008-2023.
- Wu BU. Prognosis in acute pancreatitis. CMAJ. 2011;183(6):673-677.
- Wang H, et al. Early predictive value of different indicators for persistent organ failure in acute pancreatitis: a systematic review and network meta-analysis. J Clin Gastroenterol. 2024;58(3):307-314.
- Dumnicka P, et al. The interplay between inflammation, coagulation and endothelial injury in the early phase of acute pancreatitis: clinical implications. Int J Mol Sci. 2017;18(2):354.
- Favaloro EJ, Dean E. Variability in D-dimer reporting revisited. Pathology. 2021;53(4):538-540.
- Wolff RF, et al. PROBAST: A tool to assess the risk of bias and applicability of prediction model studies. Ann Intern Med. 2019;170(1):51-58.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368.
- Collins GS, et al. Evaluation of clinical prediction models (part 1): from development to external validation. BMJ. 2024;384.
- Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Med Decis Making. 2006;26(6):565-574.
- Riley RD, van der Windt D, Croft P, Moons KGM, editors. Prognosis Research in Healthcare: Concepts, Methods, and Impact. Oxford University Press; Oxford; 2019.
- Wu H, Li J, Zhao J, Li S. A new scoring system can be applied to predict the organ failure related events in acute pancreatitis accurately and rapidly. Pancreatology. 2020;20(4):622-628.
- Riley RD, et al. Evaluation of clinical prediction models (part 2): how to undertake an external validation study. BMJ. 2024;384.