Este protocolo descreve um fluxo de trabalho de aprendizado profundo para segmentação semântica, reconstrução e síntese de estilo artístico de padrões do patrimônio cultural imaterial, utilizando extração de características baseada em transformadores, reconstrução adversarial e geração espacialmente adaptativa de imagens para apoiar a preservação digital e aplicações criativas do patrimônio.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Reconstrução Guiada por Segmentação Semântica e Síntese de Estilo Artístico de Padrões de Patrimônio Cultural Imaterial Utilizando um Framework de Deep Learning
Neste artigo
Resumo
Resumo
A preservação digital e a reconstrução de padrões do patrimônio cultural imaterial (PCI) têm atraído atenção crescente com o avanço das técnicas de síntese de imagens baseadas em aprendizado profundo. Abordagens existentes baseadas em SegCycle-SPADE demonstraram potencial para a segmentação estrutural e reconstrução artística de padrões de artesanato tradicional; no entanto, ainda existem limitações, como diversidade limitada nos conjuntos de dados, incorporação insuficiente de semântica cultural e preservação inadequada das características estruturais dos padrões durante a reconstrução. Para enfrentar esses desafios, este estudo propõe um framework SegCycle-SPADE aprimorado para a segmentação semântica e reconstrução artística de tipos de padrões do PCI. Um modelo de segmentação baseado em Transformer, o SegFormer, é empregado para identificar com precisão os limites dos motivos e as regiões dos padrões. Além disso, é introduzido um Módulo de Fusão de Recursos Culturais com Atención Cruzada para realçar motivos culturalmente significativos e melhorar a representação de características. A tradução e reconstrução de padrões são realizadas usando CycleGAN, enquanto a Denormalização Espacialmente Adaptativa (SPADE) é utilizada para a síntese de estilo artístico, mantendo a consistência semântica entre mapas de segmentação e imagens geradas. Para melhorar a generalização do modelo e a diversidade artística, o framework é treinado utilizando tanto o conjunto de dados de motivos culturais Miao Batik quanto o conjunto de dados WikiArt. Os resultados experimentais demonstram que o framework SegCycle-SPADE guiado por atenção proposto melhora a precisão da segmentação e o desempenho na reconstrução de padrões do patrimônio em comparação com métodos existentes de reconstrução baseados em redes adversárias generativas (GAN). O framework proposto oferece uma solução escalável para a documentação, reconstrução e revitalização artística assistidas por inteligência artificial em desenhos tradicionais de padrões.
Introdução
O patrimônio cultural, que inclui elementos intangíveis como costumes, línguas e crenças, e elementos tangíveis como obras de arte, edifícios e registros escritos, é uma manifestação fundamental da história, criatividade e identidade humanas1. A conservação do patrimônio busca permitir que comunidades se reconectem com suas origens e possibilita que gerações futuras se beneficiem de sua memória cultural coletiva. Também promove o entendimento intercultural, a apreciação de tradições e costumes diversos e o reconhecimento de diferentes narrativas históricas. Esses bens culturais nos ajudam a compreender os valores, perspectivas e experiências de gerações anteriores e contribuem para a formação de identidades sociais contemporâneas e para a continuidade cultural. Os princípios básicos da preservação do patrimônio cultural são ilustrados na Figura 1.
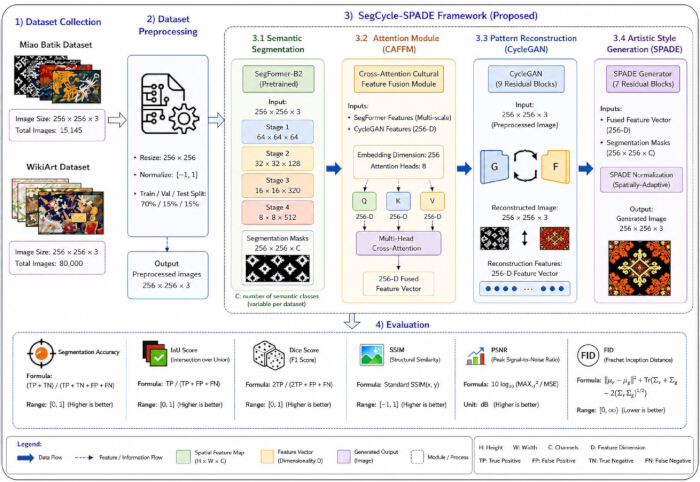
Figura 1. Visão Conceitual da Reconstrução de Padrões do Patrimônio Cultural Utilizando a Estrutura SegCycle-SPADE. Ilustração esquemática da abordagem proposta para reconstrução e aprimoramento de padrões do patrimônio cultural imaterial. O fluxo de trabalho inclui coleta de conjuntos de dados provenientes dos conjuntos Miao Batik e WikiArt, pré-processamento de imagens, segmentação semântica utilizando o SegFormer-B2, fusão de características utilizando o Módulo de Fusão de Características Culturais com Attenção Cruzada (CAFFM), reconstrução de padrões utilizando CycleGAN, síntese de estilo artístico utilizando SPADE e avaliação final utilizando métricas de segmentação e reconstrução. As setas indicam o fluxo de dados e representações de características ao longo da estrutura. Clique aqui para visualizar uma versão ampliada desta figura.
A memória coletiva e a herança cultural da sociedade humana estão incorporadas no patrimônio cultural imaterial (PCI), que atua como um importante meio de expressão artística e identidade cultural. No entanto, o PCI enfrenta desafios significativos devido aos efeitos da globalização e da digitalização2,3,4. Muitas práticas de PCI em perigo exigem novas abordagens para preservação e desenvolvimento, devido à diminuição do número de artesãos qualificados e à limitada adaptabilidade aos mercados modernos5,6. Como uma área importante da pesquisa em PCI, o design sustentável enfatiza o desenvolvimento integrado de cultura, sociedade e meio ambiente e fornece um caminho prático para a preservação contínua do PCI. Por meio de abordagens de design sustentável, o PCI pode ser revitalizado enquanto se adapta às necessidades da sociedade contemporânea7,8.
Neste estudo, o termo “padrões de patrimônio cultural imaterial” refere-se a representações de motivos visuais que comunicam e preservam valores culturais imateriais subjacentes. Consequentemente, a estrutura proposta tem como objetivo preservar e documentar as informações culturais associadas a esses motivos, ao mesmo tempo em que reconstrói suas formas visuais.
A bordadura Miao e o batique são formas significativas do patrimônio cultural imaterial chinês, refletindo a história, crenças e tradições da comunidade Miao por meio de motivos simbólicos como aves, borboletas e totens ancestrais9. Esses motivos estão profundamente enraizados nas vestimentas rituais e nas práticas festivas e contribuem para o desenvolvimento cultural e econômico local10,11. Os avanços nas tecnologias digitais, particularmente na inteligência artificial (AI) e na aprendizagem profunda (DL), criaram novas oportunidades para a preservação, análise, reconstrução e documentação do patrimônio cultural. O batique Miao de Guizhou, uma das tradições de batique melhor preservadas na China, serve como um importante meio de transmissão do conhecimento cultural, crenças, costumes e rituais do povo Miao12,13,14,15,16.
Estudos recentes demonstraram o potencial do aprendizado profundo (DL) para a preservação do patrimônio cultural e a reconstrução de padrões, alcançando maior precisão na segmentação (precisão por pixel = 88,6%, média da interseção sobre a união [IoU] = 78,1%) e desempenho aprimorado na reconstrução em comparação com o U-Net e o DeepLabV3+. No entanto, diversos desafios ainda permanecem. Abordagens existentes baseadas em redes adversárias generativas (GAN) frequentemente apresentam dificuldades em preservar detalhes estruturais finos em padrões complexos.17, enquanto a diversidade limitada dos conjuntos de dados restringe a generalização do modelo entre domínios culturais18Além disso, modelos de tradução de imagem para imagem, como o CycleGAN, podem não manter a consistência semântica entre mapas de segmentação e imagens geradas19, e a ausência de mecanismos de atenção pode resultar na perda de detalhes de motivos culturalmente significativos durante a reconstrução20Portanto, é necessário um framework aprimorado que integre segmentação baseada em transformadores, aprendizado de características guiado por atenção e treinamento com múltiplos conjuntos de dados para a reconstrução eficaz de padrões de HIC.
Novas oportunidades para a preservação do patrimônio cultural surgiram por meio da digitalização do bordado Miao e do rápido avanço da inteligência artificial generativa. Modelos de difusão, uma classe emergente de modelos generativos profundos, demonstraram desempenho notável em tarefas de visão computacional devido às suas poderosas capacidades de geração de conteúdo21,22,23,24,25. Durante o processo de difusão reversa, o modelo aprende gradualmente a reconstruir os dados de entrada originais a partir de representações ruidosas26,27,28. Estudos anteriores também exploraram a aplicação de tecnologias de reconstrução tridimensional e de design auxiliado por computador (CAD) para a preservação e disseminação do patrimônio cultural.
Embora as redes neurais convolucionais (CNNs) e as GANs apresentem bom desempenho na geração de imagens e na preservação de características, ainda enfrentam desafios relacionados a campos receptivos limitados, colapso de modos e instabilidade durante o treinamento29. Arquiteturas baseadas em transformadores, como SegFormer e Segmenter, destacam-se na captura de contexto global e relações semânticas; no entanto, são computacionalmente intensivas e podem ter dificuldades com detalhes finos. Embora modelos de difusão, como a Difusão Estável (Stable Diffusion), demonstrem fortes capacidades de geração de imagens, frequentemente carecem de controle preciso sobre as características estruturais e artísticas dos designs gerados. Além disso, a maioria das abordagens existentes utiliza estratégias de treinamento independentes, o que limita a troca eficaz de informações e a otimização colaborativa entre os componentes de segmentação e geração, resultando em um compromisso entre precisão estrutural e autenticidade artística30.
Modelos recentes baseados em difusão, como difusão latente e Difusão Estável, alcançam síntese de imagem de alta qualidade, mas exigem denoising iterativo, levando a um aumento no custo computacional e no tempo de inferência. Além disso, preservar motivos culturais finos e consistência estrutural permanece um desafio sem mecanismos especializados de condicionamento. Modelos gerativos baseados em Transformer capturam eficazmente relações contextuais globais, mas frequentemente exigem conjuntos de dados em larga escala e recursos computacionais substanciais. Em contraste, o framework proposto SegCycle-Normalização Adaptativa Espacial (SegCycle-SPADE) combina segmentação baseada em SegFormer, fusão de características com atenção cruzada, reconstrução CycleGAN e síntese guiada por SPADE para fornecer orientação estrutural explícita, melhorando assim a preservação de motivos, a consistência semântica e a reconstrução controlável de padrões do patrimônio cultural.
A maioria das técnicas atuais de segmentação semântica baseia-se em CNNs totalmente convolucionais (FCNNs) com arquiteturas em formato de U31. Durante a etapa de codificação, características profundas com grandes campos receptivos são extraídas por meio de uma série de operações de convolução e subamostragem. A etapa de decodificação restaura progressivamente a resolução espacial por meio da superamostragem, permitindo, em última instância, a predição semântica em nível de pixel. Ao compensar a perda de informações espaciais durante a subamostragem e melhorar o desempenho da segmentação em uma ampla gama de aplicações, as conexões de salto permitem que informações de alta resolução de diferentes níveis do codificador sejam diretamente integradas ao decodificador32.
Embora métodos recentes baseados em GAN, CNN e difusão tenham demonstrado resultados promissores na geração de imagens e na restauração do patrimônio cultural, muitas vezes enfrentam dificuldades para manter a consistência semântica, preservar motivos estruturais finos e garantir uma reconstrução reprodutível em diferentes padrões culturais. A maioria das abordagens existentes trata a segmentação, a reconstrução e a síntese de estilo como processos separados, o que pode resultar na perda de elementos culturalmente significativos e em saídas inconsistentes. Para preencher essa lacuna metodológica, este estudo propõe um framework unificado SegCycle-SPADE que integra segmentação semântica baseada em SegFormer, um novo Módulo de Fusão de Recursos Culturais com Attenção Cruzada (CAFFM), reconstrução baseada em CycleGAN e síntese de estilo orientada por SPADE. Ao integrar explicitamente informações de segmentação estrutural com aprendizado generativo de características, o framework proposto permite uma reconstrução mais confiável, semanticamente consistente e reprodutível de motivos do patrimônio cultural imaterial (ICH), preservando ao mesmo tempo a autenticidade cultural e a qualidade artística.
Três grandes limitações das abordagens atuais de reconstrução do patrimônio cultural são identificadas neste estudo: (i) preservação insuficiente de motivos estruturais finos em métodos de reconstrução baseados em GAN; (ii) generalização limitada resultante do treinamento com conjuntos de dados pequenos ou específicos de domínio; e (iii) consistência semântica inadequada entre as saídas de segmentação e as imagens geradas em estruturas de tradução imagem-a-imagem. Além disso, segmentação, reconstrução e síntese de estilo são comumente tratadas como processos separados, levando à perda de elementos culturalmente importantes durante o reconstrução. Ao combinar segmentação semântica baseada em transformadores, fusão de características com atenção cruzada, reconstrução CycleGAN e síntese artística guiada por SPADE dentro de uma arquitetura unificada, o framework proposto SegCycle-SPADE supera essas limitações e melhora a preservação de motivos, a consistência semântica e a autenticidade artística no reconstrução de padrões de patrimônio cultural imaterial (ICH).
O principal objetivo deste estudo é desenvolver um framework aprimorado SegCycle-SPADE para a reconstrução artística orientada por segmentação semântica de padrões de ICH. O framework integra o SegFormer para segmentação precisa de motivos culturais, o CycleGAN para reconstrução de padrões e o SPADE para síntese artística com consistência de estilo. Para melhorar a representação de características e preservar detalhes estruturais finos, um CAFFM é introduzido para facilitar a interação eficaz entre características de segmentação e gerativas. Treinado nos conjuntos de dados Miao Batik e WikiArt, o framework proposto aprimora a autenticidade da reconstrução, a consistência de estilo e a preservação de motivos culturalmente significativos.
Ao combinar segmentação semântica, fusão de características guiada por atenção, reconstrução de padrões e síntese de estilo dentro de uma arquitetura unificada, este estudo apresenta um novo framework SegCycle-SPADE para a reconstrução artística de padrões de CHI. As principais contribuições deste trabalho são as seguintes. Primeiro, um novo framework de reconstrução guiado por segmentação semântica é desenvolvido por meio da integração do SegFormer, permitindo a extração precisa e a preservação de motivos culturais intrincados e elementos estruturais. Segundo, um novo CAFFM é introduzido para fundir eficazmente características de segmentação com representações gerativas, permitindo que o modelo capture relações de longo alcance entre motivos culturais e padrões de estilo artístico. Terceiro, o CAFFM proposto melhora a preservação de elementos culturalmente significativos, ao mesmo tempo que aprimora o realismo visual e a coerência estrutural dos padrões do patrimônio reconstruídos. Quarto, ao integrar o CycleGAN para reconstrução de padrões culturais e o SPADE para síntese artística guiada por segmentação, o framework garante tanto a precisão semântica quanto a autenticidade estilística nas saídas geradas. Quinto, para melhorar a generalização e a diversidade artística, o modelo é treinado utilizando o conjunto de dados de motivos culturais Miao Batik para aprendizado de padrões culturais e o conjunto de dados WikiArt para representação de estilo artístico. O WikiArt atua como um conjunto de dados auxiliar para avaliar a capacidade de generalização do framework, a robustez na aprendizagem de características e a eficácia no controle de estilo em diversos contextos visuais, e não como um estilo-alvo para aplicação direta em produtos do patrimônio cultural Miao. Por fim, em comparação com métodos existentes baseados em GAN para reconstrução de patrimônio cultural, os resultados experimentais demonstram que o framework proposto SegCycle-SPADE alcança maior precisão na segmentação, qualidade de reconstrução e consistência estilística.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
O framework proposto, SegCycle-SPADE, foi projetado para reconstruir e aprimorar padrões tradicionais do patrimônio cultural por meio da segmentação semântica, realce de características com uso de atenção, reconstrução generativa e síntese de estilo artístico. Este estudo utilizou conjuntos de dados públicos de imagens artísticas e do patrimônio cultural, incluindo o conjunto de dados Miao Batik e o conjunto de dados WikiArt. Nenhum participante humano, dado de paciente, informação pessoal, sujeito animal ou registro clínico foi envolvido na pesquisa; portanto, não foi necessária aprovação do comitê de ética institucional nem consentimento informado. Inicialmente, os conjuntos de dados de motivos culturais Miao Batik e o conjunto de dados WikiArt foram utilizados para a avaliação. O conjunto de dados Miao Batik foi descrito em Quan et al. (2024)32 e contém 15.148 imagens anotadas de motivos tradicionais de batik Miao. As anotações existentes fornecidas pelos criadores do conjunto de dados foram utilizadas diretamente, e nenhuma anotação manual adicional foi gerada neste estudo. Em seguida, realiza-se o pré-processamento das imagens por meio do redimensionamento, normalização, remoção de ruído e criação de uma máscara de segmentação. Os parâmetros exatos de pré-processamento são descritos na subseção Pré-processamento dos Dados. O framework proposto utiliza um modelo baseado em transformador denominado SegFormer-B2 para a segmentação semântica dos dados. O método foi projetado para detectar regiões-chave dos motivos culturais e aprender suas estruturas. As características segmentadas são então realçadas por meio de um mecanismo de atenção, no qual as informações relevantes relacionadas aos motivos culturais são destacadas e as informações irrelevantes são descartadas. A configuração do mecanismo de atenção é descrita na subseção CAFFM. As características aprimoradas são então processadas pelo CycleGAN, onde estruturas danificadas são reconstruídas por meio de aprendizado cíclico. Durante o treinamento, amostras de motivos incompletos foram criadas artificialmente mediante aplicação de operações de mascaramento aleatório e oclusão parcial às imagens originais de Miao Batik. Esses procedimentos de degradação simularam regiões de motivos ausentes e danos estruturais comumente observados em artefatos culturais deteriorados. As imagens incompletas resultantes foram utilizadas como entradas para o módulo de reconstrução do CycleGAN, enquanto as imagens originais correspondentes serviram como alvos de reconstrução. Os padrões do patrimônio cultural reconstruídos são então aprimorados por meio do SPADE, onde o realce artístico é realizado com base nos mapas de segmentação gerados. O desempenho do framework proposto é avaliado por meio de métricas quantitativas de segmentação e qualidade de imagem, enquanto a autenticidade visual dos motivos culturais reconstruídos é avaliada qualitativamente. A autenticidade visual foi avaliada por meio de inspeção visual dos padrões culturais gerados e não foi utilizada como métrica quantitativa independente. A avaliação concentrou-se na preservação do motivo, consistência semântica, características culturais, coerência estrutural e aparência artística em relação aos motivos culturais de referência correspondentes. A avaliação quantitativa do desempenho do modelo foi realizada utilizando Acurácia de Segmentação, IoU, Coeficiente Dice, Índice de Similaridade Estrutural (SSIM), Relação Sinal-Ruído de Pico (PSNR) e Distância de Inception de Fréchet (FID). Figura 2 ilustra o fluxo de trabalho geral do framework proposto SegCycle-SPADE e resume as métricas de avaliação utilizadas neste estudo.
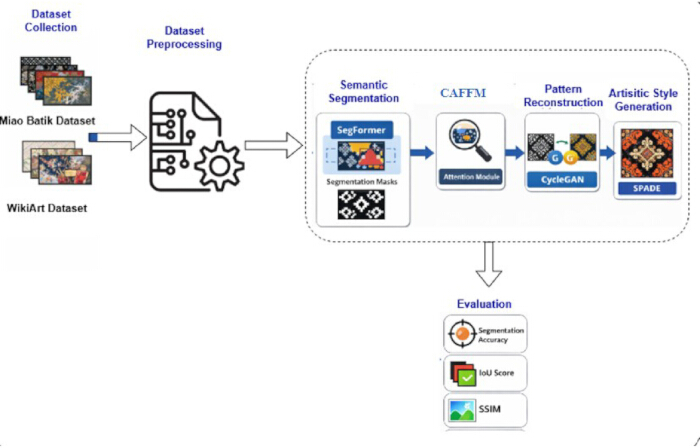
Figura 2. Fluxo da Arquitetura Geral do Framework Proposto SegCycle-SPADE. Visão geral do fluxo completo do SegCycle-SPADE. Imagens dos conjuntos de dados Miao Batik e WikiArt passam por pré-processamento antes de serem processadas por meio de segmentação semântica utilizando o SegFormer-B2, realce de características usando o CAFFM, reconstrução de padrão usando o CycleGAN e geração de estilo artístico usando o SPADE. O desempenho do modelo é avaliado por meio da Acurácia de Segmentação, Intersecção sobre União (IoU), Coeficiente Dice, Índice de Similaridade Estrutural (SSIM), PSNR e Distância Inception de Fréchet (FID), enquanto a autenticidade visual é avaliada qualitativamente. Clique aqui para visualizar uma versão maior desta figura.
O framework SegCycle-SPADE para a reconstrução de padrões do patrimônio cultural foi projetado para integrar múltiplos componentes de aprendizado profundo (DL) com o objetivo de realizar segmentação, reconstrução e aprimoramento artístico precisos de motivos, conforme ilustrado na Figura 2. Imagens do conjunto de dados de motivos culturais do Batik Miao e do conjunto de dados WikiArt são utilizadas para fornecer padrões culturais e estilos artísticos diversos. Inicialmente, as imagens são processadas por meio de um módulo de segmentação semântica baseado no SegFormer para identificar e delimitar os motivos culturais em relação ao fundo. A arquitetura geral consiste em quatro etapas principais. Primeiro, o modelo SegFormer extrai mapas de segmentação semântica a partir das imagens de padrões culturais. Segundo, o CAFFM integra características de segmentação com representações gerativas para aprimorar a aprendizagem de características. Terceiro, o módulo CycleGAN reconstrói os padrões culturais utilizando as representações de características fundidas. Por fim, o módulo SPADE gera saídas artisticamente aprimoradas, preservando a consistência estrutural por meio de síntese orientada por segmentação. Os mapas de características refinados são subsequentemente processados pelo módulo de reconstrução CycleGAN, que aprende a restaurar motivos culturais incompletos mapeando padrões degradados para suas formas completas correspondentes. Amostras de motivos incompletos foram geradas mediante a aplicação de operações aleatórias de mascaramento e oclusão parcial às imagens originais do Batik Miao, simulando assim regiões de padrão ausentes e degradação estrutural comumente observadas em artefatos culturais danificados. Cada imagem degradada foi emparelhada com sua imagem original correspondente, que serviu como alvo de reconstrução durante o treinamento. Essa estratégia permitiu que o módulo CycleGAN aprendesse a restaurar estruturas de motivos ausentes, preservando ao mesmo tempo a consistência semântica e características culturalmente significativas. Finalmente, o gerador SPADE produz saídas artísticas visualmente aprimoradas ao condicionar a síntese da imagem aos mapas de segmentação gerados, mantendo assim a integridade estrutural dos motivos culturais ao longo de todo o processo de aprimoramento artístico.
Os seguintes passos estão envolvidos no framework proposto SegCycle-SPADE.
Etapa 1: Coleta do Conjunto de Dados
Dois conjuntos de dados foram utilizados para alcançar os objetivos de aprendizado de padrões culturais e geração de estilo artístico. O Conjunto de Dados de Motivos Culturais do Batik Miao foi usado para fornecer informações sobre padrões culturais tradicionais. O conjunto de dados está publicamente disponível por meio do Zenodo (https://doi.org/10.5281/zenodo.20807658) e contém 15.148 imagens anotadas de motivos tradicionais de batik Miao. As anotações existentes fornecidas pelos criadores do conjunto de dados foram utilizadas diretamente, e nenhuma anotação manual adicional foi gerada neste estudo. O conjunto de dados WikiArt foi utilizado para fornecer informações diversas sobre estilo artístico para a geração de estilo artístico e foi obtido a partir do repositório publicamente acessível WikiArt (https://www.wikiart.org/).
Passo 2: Pré-processamento dos Dados
Todas as imagens foram pré-processadas por meio de redimensionamento, normalização e redução de ruído. As anotações existentes de motivos culturais obtidas das fontes originais do conjunto de dados foram utilizadas para apoiar a etapa de segmentação semântica. Nenhum procedimento adicional de anotação ou reclassificação foi realizado como parte deste estudo.
Passo 3: Segmentação de Padrão Semântico usando SegFormer
O modelo SegFormer foi utilizado para a segmentação de motivos culturais. O exato backbon e estratégia de inicialização do SegFormer são descritos na subseção Segmentação de Padrão Semântico Usando SegFormer. Especificamente, a arquitetura SegFormer-B2 com um backbon MIT-B2 pré-treinado no ImageNet foi empregada para a segmentação semântica de motivos. Esse modelo captura efetivamente informações contextuais globais ao mesmo tempo em que preserva os detalhes estruturais complexos dos padrões culturais tradicionais.
Passo 4: CAFFM
O CAFFM combina características de segmentação semântica com representações gerativas, permitindo que o framework aprenda tanto as características dos motivos estruturais quanto as informações de estilo artístico. Os detalhes de integração do CAFFM são fornecidos na subseção CAFFM. O módulo está posicionado entre a etapa de segmentação semântica baseada no SegFormer e a etapa de reconstrução gerativa, onde ele funde características estruturais derivadas da segmentação com características de reconstrução por meio de atenção cruzada com múltiplas cabeças. Esse processo melhora a preservação dos motivos culturais e aumenta o realismo das saídas reconstruídas.
Etapa 5: Reconstrução do Padrão (CycleGAN)
As características fundidas são subsequentemente processadas pelo módulo CycleGAN para reconstruir estruturas de padrões culturais. A arquitetura CycleGAN e a configuração de treinamento são descritas na subseção Reconstrução do Padrão Utilizando CycleGAN. O módulo de reconstrução consiste em dois geradores e dois discriminadores, utiliza uma arquitetura de gerador baseada em rede residual com nove blocos residuais, emprega um discriminador PatchGAN e é treinado utilizando perdas adversariais e de consistência cíclica. Essa configuração permite mapeamento bidirecional entre domínios e facilita a reconstrução de estruturas de padrões culturais incompletas.
Etapa 6: Geração de Estilo Artístico (SPADE)
Os padrões reconstruídos são então processados pelo módulo SPADE para realizar a síntese de estilo artístico orientada por segmentação. A configuração do gerador SPADE é descrita na subseção Artistic Style Generation Using SPADE. O módulo emprega blocos residuais SPADE, camadas de normalização adaptativa espacial e condicionamento semântico derivado dos mapas de segmentação do SegFormer e das representações de características do CAFFM. Ao condicionar a geração de imagens nos mapas de segmentação, as saídas sintetizadas mantêm o alinhamento estrutural com os motivos culturais originais, ao mesmo tempo que incorporam características de estilo artístico.
Etapa 7: Estimativa de Desempenho
A estrutura proposta foi avaliada utilizando múltiplas métricas de segmentação e avaliação da qualidade da imagem, incluindo Acurácia de Segmentação, IoU, Coeficiente de Similaridade Dice (Dice), SSIM, PSNR e FID. Para avaliar a consistência experimental, todos os experimentos foram repetidos cinco vezes utilizando diferentes sementes aleatórias, e os resultados são apresentados como média ± desvio padrão. A significância estatística foi avaliada por meio de testes t pareados, com um limiar de significância de p < 0,05.
Coleta do Conjunto de Dados
Na estrutura proposta do SegCycle-SPADE, dois conjuntos de dados são utilizados para a compreensão de padrões culturais e aprendizado de estilo. O primeiro conjunto de dados empregado na estrutura proposta é o conjunto de dados de motivos culturais do Batik Miao. Este conjunto contém motivos culturais do Batik Miao, geralmente imagens tradicionais do Batik Miao com motivos como animais, plantas e formas geométricas, usados na arte da etnia Miao. Este conjunto contém imagens com informações ricas em textura, as quais são geralmente importantes para a preservação do patrimônio cultural. O segundo conjunto de dados empregado na estrutura proposta do SegCycle-SPADE é o conjunto de dados WikiArt. Este conjunto contém um grande número de obras de arte, geralmente de estilos diferentes. Este conjunto é utilizado para o aprendizado de estilos complexos, o que é geralmente útil para aprimorar obras de arte. Este conjunto possui 80.000 obras de arte em alta definição, com 27 designs diferentes, tornando-o mais útil para tarefas baseadas em aprendizado profundo (DL) de geração ou transformação de estilo.
Conjunto de Dados Miao Batik:
O conjunto de dados Miao Batik (https://doi.org/10.5281/zenodo.20807658) compreende 15.148 imagens de padrões de batique que retratam motivos culturalmente significativos. As imagens incluem uma variedade de desenhos tradicionais, como motivos de animais (por exemplo, borboletas e peixes), padrões baseados em plantas e motivos geométricos que carregam simbolismo cultural. Este conjunto de dados é um componente importante da estrutura proposta, pois fornece estruturas culturais autênticas que permitem ao módulo de segmentação identificar e preservar com precisão os limites dos motivos durante a reconstrução do padrão (Tabela 1). Neste estudo, motivos culturalmente importantes referem-se a elementos visuais simbólicos comumente documentados na literatura sobre o patrimônio cultural Miao e representados nas anotações do conjunto de dados, incluindo aves, borboletas, padrões florais e totens ancestrais. Esses motivos foram selecionados com base em sua importância cultural documentada e presença recorrente nos desenhos tradicionais de batique e bordado Miao, e não apenas em sua frequência de ocorrência ou composição espacial. As anotações de motivos orientadas por especialistas e os rótulos de segmentação foram obtidos da fonte original do conjunto de dados Miao Batik e utilizados diretamente neste estudo. Os autores não realizaram nenhuma anotação manual adicional, reanotação ou procedimentos de anotação guiados por especialistas. As anotações existentes fornecidas pelos criadores do conjunto de dados foram utilizadas para o treinamento e avaliação da segmentação semântica.
| Parâmetro | Descrição |
| Nome do Conjunto de Dados | Miao Batik Cultural Pattern Dataset |
| Fonte do Conjunto de Dados | Repositório Zenodo (DOI: 10.5281/zenodo.20807658) |
| Domínio | Patrimônio Cultural Imaterial (PCI) / Análise de Padrões Têxteis |
| Número Total de Imagens | 15.148 imagens |
| Tipo de Imagem | Imagens digitais de padrões têxteis tradicionais de batique Miao |
| Categorias de Padrão | Motivos animais, motivos vegetais e motivos geométricos |
| Origem Cultural | Cultura étnica Miao, Província de Guizhou, China |
| Resolução Original das Imagens | Imagens de alta resolução (geralmente ≥ 1.000 pixels no lado mais curto) capturadas como digitalizações ou fotografias brutas antes do pré-processamento |
| Resolução para Treinamento | Imagens redimensionadas para 256 × 256 pixels durante o pré-processamento |
| Disponibilidade de Anotações | As anotações de segmentação existentes fornecidas pelos criadores do conjunto de dados foram utilizadas sem modificações para treinamento e avaliação. Nenhum procedimento adicional de anotação manual, rotulagem novamente ou confirmação por especialista foi realizado neste estudo. |
| Aplicação neste Estudo | Segmentação de motivos culturais, extração de características, preservação de motivos e reconstrução de padrões |
Tabela 1: Características do Conjunto de Dados dos Padrões Culturais de Batik Miao. Resumo do conjunto de dados de motivos culturais de batik Miao utilizado para segmentação semântica, análise de padrões culturais e reconstrução de motivos. A tabela descreve a origem do conjunto de dados, características das imagens, categorias de motivos, origem cultural, resolução das imagens e seu papel dentro do framework proposto SegCycle-SPADE.
Conjunto de Dados WikiArt:
O conjunto de dados WikiArt [https://www.wikiart.org/] é um repositório digital de arte em larga escala e amplamente utilizado, que compreende mais de 80.000 imagens de 27 estilos artísticos diferentes apresentados na Tabela 2. Os estilos incluem arte renascentista, impressionismo, cubismo e surrealismo. O conjunto de dados é muito importante na estrutura proposta, pois fornece conhecimento que permite ao módulo SPADE criar padrões enriquecidos culturalmente, ao mesmo tempo que mantém as informações estruturais obtidas a partir do processo de segmentação. O conjunto de dados é composto por 56.000 imagens para treinamento e 12.000 imagens para validação e testes. As imagens do conjunto de dados auxiliam efetivamente no treinamento do modelo de aprendizado profundo (DL).
| Parâmetro | Descrição |
| Nome do Conjunto de Dados | Conjunto de Dados WikiArt |
| Fonte do Conjunto de Dados | Repositório WikiArt (https://www.wikiart.org/) |
| Domínio | Arte Digital e Pinturas |
| Número Total de Imagens | Aproximadamente 80.000 obras de arte |
| Imagens de Treinamento | 56.000 |
| Imagens de Validação | 12.000 |
| Imagens de Teste | 12.000 |
| Estilos Artísticos | 27 estilos artísticos, incluindo Renascimento, Impressionismo, Cubismo, Surrealismo, Expressionismo, Realismo e Arte Abstrata |
| Resolução Original das Imagens | As resoluções originais das imagens variam entre as obras e fontes. As imagens foram redimensionadas para uma resolução uniforme de 256 × 256 pixels durante o pré-processamento. |
| Resolução de Treinamento | Imagens redimensionadas para 256 × 256 pixels durante o pré-processamento, anteriormente à aprendizagem de estilo artístico e à síntese de imagens orientada por segmentação. |
| Particionamento do Conjunto de Dados | Particionamento aleatório estratificado (70% treinamento, 15% validação e 15% teste) utilizando uma semente aleatória fixa de 42 |
| Estratégia de Amostragem de Estilo | Utilizou-se amostragem proporcional estratificada para preservar a distribuição dos 27 estilos artísticos nos subconjuntos de treinamento, validação e teste |
| Aplicação neste Estudo | Aprendizagem de estilo artístico, representação de estilo e síntese artística orientada por segmentação |
Tabela 2: Características do Conjunto de Dados WikiArt. Resumo do conjunto de dados WikiArt utilizado para aprendizado de estilo artístico e síntese de imagens guiada por estilo. A tabela descreve a origem do conjunto de dados, distribuição das imagens, cobertura de estilos artísticos, divisão do conjunto de dados, resolução das imagens e sua aplicação dentro do framework proposto SegCycle-SPADE.
O conjunto de dados Miao Batik contém 15.148 imagens representando motivos culturais tradicionais dos Miao.32 O conjunto de dados está publicamente disponível por meio do Zenodo (https://doi.org/10.5281/zenodo.20807658). Antes do treinamento do modelo, todas as imagens foram inspecionadas visualmente, redimensionadas para 256 × 256 pixels, normalizadas e examinadas quanto a amostras corrompidas ou duplicadas. A triagem de controle de qualidade não resultou na exclusão de nenhuma imagem; portanto, todas as 15.148 imagens foram mantidas para análises subsequentes. O conjunto de dados foi particionado aleatoriamente em subconjuntos de treinamento (70%), validação (15%) e teste (15%) utilizando uma semente aleatória fixa de 42 para garantir a reprodutibilidade das divisões do conjunto de dados. O conjunto de dados WikiArt foi acessado por meio do repositório oficial do WikiArt (https://www.wikiart.org/) e contém mais de 80.000 obras de arte abrangendo 27 estilos artísticos. Para experimentos de aprendizado de estilo, 56.000 imagens foram utilizadas para treinamento, 12.000 para validação e 12.000 para teste.
Pré-processamento dos Dados
Antes de treinar o framework proposto SegCycle-SPADE, o conjunto de dados de motivos culturais do Tingimento Miao e o conjunto de dados WikiArt foram submetidos a várias etapas de pré-processamento para garantir qualidade de imagem consistente e representação precisa de características. O mesmo pipeline básico de pré-processamento, incluindo remoção de ruído gaussiano, normalização, redimensionamento para uma resolução de entrada consistente e verificação da qualidade da imagem, foi aplicado a ambos os conjuntos de dados. No entanto, os conjuntos de dados desempenharam papéis distintos dentro do framework. O conjunto de dados WikiArt foi utilizado para aprendizado e síntese de estilo artístico, enquanto o conjunto de dados Miao Batik foi usado principalmente para segmentação e reconstrução de motivos culturais. Nenhuma alteração específica de pré-processamento foi feita além desses papéis específicos de tarefa. Para garantir um processamento consistente pelo modelo de aprendizado profundo, as imagens foram primeiramente redimensionadas para uma resolução fixa. Esta etapa foi necessária porque as imagens em ambos os conjuntos de dados variavam em resolução dependendo de sua origem. O redimensionamento melhorou a eficiência computacional e evitou inconsistências dimensionais que poderiam afetar o treinamento. A segunda etapa de pré-processamento foi a normalização, na qual os valores dos pixels foram escalonados para uma faixa padronizada para estabilizar as atualizações de gradiente durante o treinamento. Em seguida, as imagens foram processadas usando filtragem gaussiana para reduzir o ruído que poderia interferir nas estruturas dos motivos culturais. Para o conjunto de dados Miao Batik, máscaras existentes de segmentação de motivos culturais obtidas diretamente da fonte original do conjunto de dados foram utilizadas sem modificação para o treinamento e avaliação de segmentação semântica. Nenhuma nova máscara de segmentação foi gerada especificamente para este estudo.
Salvo indicação em contrário, as equações que descrevem métodos estabelecidos foram adaptadas de estudos anteriores e estão devidamente citadas. As equações que descrevem o CAFFM proposto e o framework de otimização composto SegCycle-SPADE foram desenvolvidas pelos autores para este estudo.
Considere uma imagem de entrada do conjunto de dados representada como Equação 1:
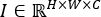 (1)
Aqui, H, W e C referem-se à altura da imagem, largura e número de canais de cor, respectivamente. Todas as imagens são redimensionadas para uma dimensão fixa H′ × W′, conforme mostrado na Equação 2:
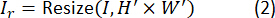
Aqui, Ir é a imagem redimensionada. Os valores normalizados dos pixels são calculados de acordo com a Equação 3:
 (3)
Isso ajuda a estabilizar o procedimento de treinamento. A filtragem de ruído é realizada usando um filtro gaussiano conforme mostrado na Equação 4:
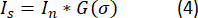
Aqui, G(σ) é um filtro gaussiano e * representa a convolução. Foi utilizado um filtro gaussiano com kernel 5 × 5 e desvio padrão de σ = 1.0. Foi aplicado preenchimento reflexivo aos pixels das bordas para reduzir artefatos de borda. Antes da escala e normalização, o processo de remoção de ruído foi realizado imediatamente após o carregamento da imagem. Para garantir um pré-processamento uniforme ao longo do estudo, a mesma configuração de filtro foi aplicada a todas as imagens dos conjuntos de dados Miao Batik e WikiArt. Para o conjunto de dados Miao Batik, as máscaras de segmentação são criadas de acordo com a Equação 5:

Aqui, M é uma máscara de segmentação utilizada para orientar o modelo SegFormer.
O pipeline de pré-processamento começa com a aquisição de imagens dos conjuntos de dados Miao Batik e WikiArt, conforme mostrado na Figura 3. Nenhuma técnica de aumento de dados foi empregada durante o treinamento. Após o pré-processamento, que incluiu redimensionamento, normalização, remoção de ruído gaussiano e preparação das máscaras de segmentação, as imagens foram usadas diretamente para o treinamento, validação e teste do framework proposto SegCycle-SPADE. O primeiro passo do pipeline de pré-processamento envolve o redimensionamento das imagens para um tamanho fixo, permitindo que o modelo de DL processe as imagens de forma mais eficiente. O segundo passo envolve a normalização, que converte os valores dos pixels para uma faixa numérica padronizada e facilita a convergência do modelo. O terceiro passo envolve a remoção de ruído, mediante o qual as imagens são limpas de ruídos indesejados para melhorar o reconhecimento de padrões. Além disso, para o conjunto de dados Miao Batik, as regiões de motivos culturais são anotadas, permitindo a geração de máscaras utilizadas no módulo de segmentação do modelo proposto, garantindo que os motivos culturais sejam preservados durante a geração. A saída final desta etapa é um conjunto de dados limpo, pronto para o treinamento dos módulos de segmentação e geração do modelo proposto.
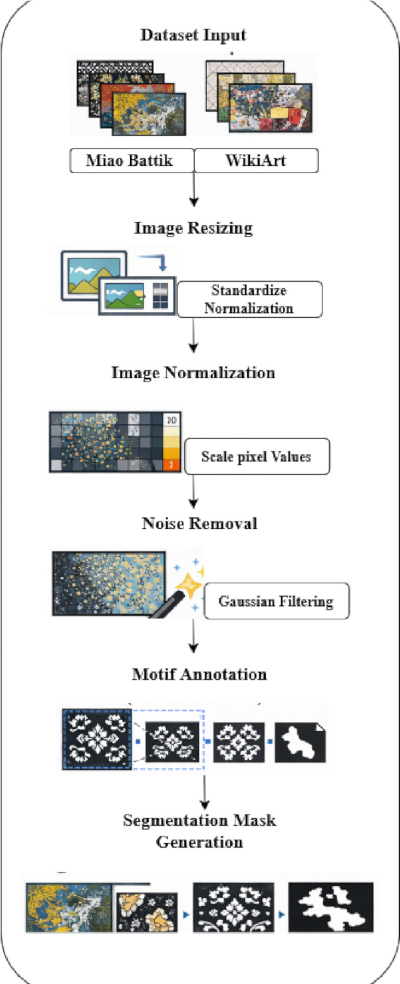
Figura 3. Pipeline de Pré-processamento de Dados para Imagens do Patrimônio Cultural. Fluxo de trabalho ilustrando os procedimentos de pré-processamento de imagens aplicados antes do treinamento do modelo. O pipeline inclui a aquisição do conjunto de dados, redimensionamento das imagens, normalização, redução de ruído gaussiano, anotações existentes de motivos culturais e preparação de máscaras de segmentação. As imagens e máscaras resultantes após o processamento são utilizadas como entradas para segmentação semântica e reconstrução de padrões. Clique aqui para visualizar uma versão maior desta figura.
Todas as imagens foram submetidas a um processo de controle de qualidade antes do treinamento do modelo. O conjunto de dados Miao Batik continha 15.148 imagens. Amostras corrompidas, duplicadas e de baixa qualidade já haviam sido tratadas pelos criadores originais do conjunto de dados; portanto, nenhuma imagem adicional foi excluída durante a triagem de controle de qualidade neste estudo. Consequentemente, todas as 15.148 imagens foram mantidas para análise. As imagens foram carregadas no formato RGB durante o pré-processamento e redimensionadas para 256 × 256 pixels utilizando interpolação bilinear. Os valores dos pixels foram escalonados do intervalo [0, 255] para [0, 1] dividindo-se por 255. Em seguida, foi aplicada normalização por canal utilizando valores médios de [0,485, 0,456, 0,406] e valores de desvio padrão de [0,229, 0,224, 0,225] para os canais vermelho, verde e azul, respectivamente. O pipeline de pré-processamento incluiu o carregamento das imagens, conversão para RGB, redimensionamento, escalonamento dos valores dos pixels, normalização e conversão em tensores. Quando necessário, imagens em escala de cinza foram convertidas para o formato RGB de três canais para manter a compatibilidade com os modelos de aprendizado profundo. Após o pré-processamento, as imagens foram divididas em subconjuntos de treinamento, validação e teste. Todas as etapas do framework SegCycle-SPADE — incluindo segmentação semântica, fusão de características, reconstrução de motivos e síntese artística baseada em SPADE — utilizaram uma resolução de entrada consistente de 256 × 256 pixels.
Segmentação por Padrão Semântico usando SegFormer
Após esta etapa de pré-processamento, as imagens limpas e normalizadas do conjunto de dados de motivos culturais do Tingimento Miao e do conjunto de dados WikiArt são inseridas no módulo de segmentação semântica com base na estrutura proposta do SegFormer-B2. O objetivo desta etapa é identificar e separar corretamente os motivos culturais presentes em padrões patrimoniais. A estrutura proposta do SegFormer baseia-se em uma arquitetura de transformador que incorpora um codificador Transformer hierárquico e um decodificador MLP leve para capturar com precisão informações contextuais globais, bem como informações estruturais detalhadas de padrões patrimoniais complexos. O modelo primeiro extrai representações de características em múltiplas escalas a partir da imagem de entrada, seguido pela fusão dessas representações por meio do decodificador para gerar padrões segmentados precisos. Isso garante que os padrões na imagem patrimonial sejam corretamente segmentados em motivos como padrões geométricos, padrões florais e padrões simbólicos, separando-os assim do fundo, ao mesmo tempo que mantém sua integridade estrutural. Essas informações estruturais são subsequentemente utilizadas nas etapas posteriores de geração de padrões dentro da estrutura SegCycle-SPADE.
Seja a imagem de entrada pré-processada representada como Equação 6:
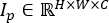 (6)
O codificador SegFormer divide a imagem em fragmentos e extrai características hierárquicas usando camadas de transformador, conforme mostrado na Equação 71:
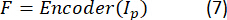
Aqui, F denota os mapas de características multiescala obtidos a partir do codificador transformer. Essas características codificam tanto padrões locais de textura quanto relações contextuais globais entre regiões de motivos. O modelo SegFormer extrai mapas de características em diferentes escalas conforme definido na Equação 8:
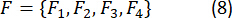
O uso de representações multiescala facilita a detecção de padrões de diferentes tamanhos dentro de motivos culturais. Por fim, as características são combinadas utilizando o decodificador MLP, conforme mostrado na Equação 91:
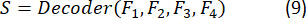
Aqui, S denota o mapa final de segmentação previsto.
A estrutura do SegFormer-B2 foi inicializada usando pesos pré-treinados no ImageNet e posteriormente ajustada no conjunto de dados Miao Batik para segmentação de motivos culturais. O ponto de controle pré-treinado foi obtido a partir da implementação oficial do SegFormer. Especificamente, o ponto de controle MIT-B2 pré-treinado no ImageNet-1K (mit_b2.pth) fornecido pelo repositório oficial do SegFormer foi utilizado para inicializar a estrutura do SegFormer-B2 antes do ajuste fino. Os pesos pré-treinados correspondem à estrutura MIT-B2 lançada pelos autores do SegFormer e serviram como modelo inicial para o treinamento de segmentação semântica. As demais camadas específicas da tarefa foram inicializadas utilizando os procedimentos padrão do PyTorch para inicialização de pesos antes do treinamento.
Um codificador Transformer hierárquico de quatro estágios com incorporações de fragmentos sobrepostos é utilizado na arquitetura. No estágio inicial, o tamanho do fragmento foi definido como 7 × 7 com um passo de 4. Para cada um dos quatro estágios do codificador, as dimensões de incorporação foram 64, 128, 320 e 512. Ao longo dos quatro estágios, houve 1, 2, 5 e 8 cabeças de autoatenção multihead, e as profundidades correspondentes do codificador foram de 3, 4, 6 e 3 camadas. As características multiescala recuperadas do codificador foram agregadas usando um decodificador leve baseado inteiramente em MLP. Antes de gerar o mapa final de segmentação, o decodificador projetou as características de cada estágio do codificador em um único espaço de incorporação. Todos os blocos Transformer utilizaram a função de ativação Gaussian Error Linear Unit (GELU). Uma taxa de dropout de 0,1 foi utilizada durante o treinamento para melhorar a generalização e reduzir o overfitting.
Durante a fase de treinamento, o framework SegFormer recebe as imagens pré-processadas de ambas as bases de dados. As imagens da base de dados Miao Batik contêm regiões de motivos que servem como rótulos para o aprendizado supervisionado do modelo de segmentação. O codificador Transformer processa a imagem inteira e captura relações de longo alcance entre os componentes da imagem, o que é particularmente importante para padrões tradicionais de batique que contêm motivos distribuídos espacialmente. O mecanismo hierárquico de extração de características captura simultaneamente estruturas locais, como texturas geométricas repetidas. O decodificador MLP processa essas características extraídas e produz uma máscara de segmentação destacando as regiões de motivos. Os mapas de segmentação gerados nesta etapa são subsequentemente utilizados como entradas estruturais para o módulo de atenção e a etapa de reconstrução do padrão, ajudando assim a preservar a autenticidade dos padrões gerados.
Os motivos culturais foram divididos em diferentes classes para segmentação semântica com base em suas características visuais e culturais. A taxonomia de segmentação compreendia motivos animais (por exemplo, borboletas, peixes, aves e outras fauna simbólicas), motivos vegetais (por exemplo, flores, folhas, videiras e padrões botânicos), motivos geométricos (por exemplo, formas repetidas, bordas e estruturas geométricas abstratas) e regiões de fundo que representam áreas sem motivos. Máscaras de segmentação em nível de pixel foram utilizadas para atribuir cada pixel a uma das classes predefinidas. Rótulos inteiros foram codificados da seguinte forma: Rótulo 0 = fundo, Rótulo 1 = motivos animais, Rótulo 2 = motivos vegetais e Rótulo 3 = motivos geométricos. As anotações de segmentação e os rótulos dos motivos foram obtidos diretamente da fonte original do conjunto de dados Miao Batik. Nenhum procedimento adicional de anotação manual, recodificação, verificação de contornos ou confirmação por especialista foi realizado neste estudo. As anotações existentes fornecidas pelos criadores do conjunto de dados foram utilizadas sem modificações para treinamento e avaliação.
O modelo SegFormer para segmentação de motivos culturais processa as imagens pré-processadas do conjunto de dados Miao Batik e do conjunto de dados WikiArt usando um mecanismo baseado em transformador para detecção precisa de regiões de padrões culturais, conforme mostrado na Figura 4. Primeiro, a imagem de entrada contendo motivos culturais tradicionais é fornecida ao modelo SegFormer. O codificador Transformer extrai informações contextuais globais e características estruturais locais a partir de fragmentos da imagem. As características em múltiplas escalas resultantes são fornecidas ao decodificador de segmentação, que utiliza uma Rede Alimentada Mista (Mix Feed-Forward Network) para refinar as representações de características e melhorar a detecção de motivos. A saída do modelo SegFormer é uma máscara de segmentação que destaca os pixels correspondentes aos padrões culturais, suprimindo ao mesmo tempo as informações irrelevantes do fundo. Os padrões culturais isolados servem então como orientação estrutural para as etapas subsequentes do framework SegCycle-SPADE.
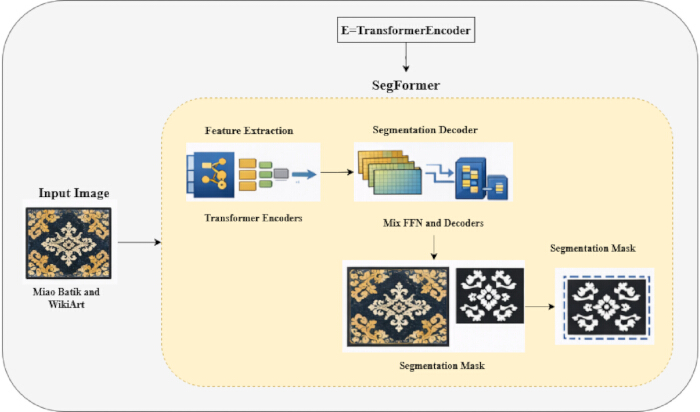
Figura 4. Segmentação Semântica Baseada no SegFormer-B2 de Motivos Culturais. Arquitetura do módulo de segmentação semântica SegFormer-B2 utilizado para extração de motivos culturais e treinado exclusivamente no conjunto de dados Miao Batik. A estrutura consiste em um codificador baseado em Transformador para extração de características em múltiplas escalas e um decodificador de segmentação leve para gerar máscaras de motivos. O modelo prevê quatro classes semânticas — animal, planta, geométrico e fundo — em que as máscaras de segmentação resultantes identificam regiões de motivos culturalmente significativos, suprimindo informações irrelevantes de fundo. Essas saídas de segmentação fornecem orientação estrutural para as etapas subsequentes de fusão de características, reconstrução e síntese artística do framework proposto SegCycle-SPADE. Clique aqui para visualizar uma versão ampliada desta figura.
Não é necessário criar novas anotações de segmentação na estrutura sugerida. O conjunto de dados Miao Batik foi obtido de uma fonte pública já existente, e o modelo foi treinado utilizando as informações de motivos fornecidas pelos criadores do conjunto de dados. Durante o processo de aprendizado, o modelo SegFormer produziu mapas de segmentação semântica. Como resultado, o presente estudo não exigiu nenhum software adicional de anotação manual, diretrizes de anotação ou procedimentos de controle de qualidade das anotações.
CAFFM
Para melhorar a interação entre as características da segmentação semântica e as representações da reconstrução generativa, o estudo também propôs um CAFFM. O codificador SegFormer-B2 fornece mapas de características semânticas ao módulo CAFFM, enquanto a etapa de reconstrução CycleGAN fornece mapas de características generativas. Primeiro, camadas de projeção linear são usadas para projetar ambos os fluxos de características em um espaço de incorporação comum. Para o cálculo da atenção cruzada, representações de consulta (Q), chave (K) e valor (V) são criadas utilizando os tensores de características gerados. As relações entre as informações de motivos estruturais e os elementos de estilo artístico são então modeladas usando atenção cruzada com múltiplos cabeçotes. A normalização por camada, conexões residuais e camadas de alimentação direta com ativação GELU são então aplicadas às representações de características fundidas. A etapa de síntese baseada em SPADE recebe a saída do módulo CAFFM, permitindo a preservação de temas culturalmente significativos sem comprometer a coerência artística.
Para garantir a compatibilidade de características, as características de entrada são inicialmente projetadas, por meio de camadas de projeção linear, em um espaço de incorporação compartilhado com uma dimensão de incorporação de 256. As interconexões entre as informações estruturais semânticas e as representações estilísticas gerativas são então modeladas utilizando um mecanismo de atenção cruzada MultiHead com oito cabeças de atenção. O cálculo da atenção cruzada utiliza vetores de Consulta (Q), Chave (K) e Valor (V), gerados por camadas específicas de transformação linear. Para aumentar a estabilidade durante o treinamento e manter a integridade das características, são empregadas conexões residuais e Normalização de Camada para aprimorar ainda mais as representações de características fundidas. A aprendizagem não linear de características é então aprimorada pela aplicação de uma rede feed-forward com a função de ativação Unidade Linear de Erro Gaussiana (GELU). Uma representação de característica de saída com dimensão 256 é gerada pelo módulo e enviada a outras etapas para síntese criativa. O CAFFM combina com sucesso dados de estilo artístico com estruturas de motivos culturais utilizando uma técnica de fusão baseada em atenção cruzada, o que melhora a preservação de motivos e a coerência visual nos padrões de patrimônio cultural reconstruídos.
No sistema proposto, as características estruturais são derivadas do conjunto de dados Miao Batik, enquanto as características estilísticas são aprendidas a partir do conjunto de dados WikiArt. Seja o mapa de características derivado da rede de segmentação SegFormer usando imagens do conjunto de dados Miao Batik denotado por Fs, enquanto o mapa de características derivado do ramo de extração de características estilísticas usando imagens do WikiArt é denotado por Fa. O CAFFM proposto combina os dois domínios de características usando um mecanismo de atenção cruzada para aprender tanto as dependências estruturais quanto estilísticas dos padrões culturais. Tabela 3 apresenta todas as características arquiteturais, incluindo dimensões de incorporação, camadas de normalização, funções de ativação e configuração de cabeças de atenção. Para um tamanho de imagem de entrada de 256 × 256 pixels, o codificador SegFormer-B2 gerou mapas de características semânticas de tamanho 64 × 64 × 128, enquanto o ramo de extração de características estilísticas gerou mapas de características de tamanho 64 × 64 × 128. Ambos os mapas de características foram projetados por meio de camadas lineares treináveis em um espaço de incorporação compartilhado de dimensão 256 antes da fusão por atenção cruzada.
| Parâmetro | Configuração |
| Framework Proposto | SegCycle-SPADE |
| Modelo de Segmentação Semântica | SegFormer-B2 |
| Etapas do Codificador SegFormer | 4 |
| Inicialização de Pesos | SegFormer-B2 pré-treinado no ImageNet-1K (Biblioteca MIT-B2) |
| Fonte do Checkpoint | Repositório Oficial NVIDIA SegFormer (https://github.com/NVlabs/SegFormer); checkpoint: segformer.b2.512x512.ade.160k |
| Estratégia de Ajuste Fino | Ajuste fino completo no conjunto de dados Miao Batik |
| Tamanho do Patch Embedding | 7 × 7 |
| Stride do Patch | 4 |
| Dimensões de Embedding | 64, 128, 320 e 512 |
| Profundidades do Codificador | 3, 4, 6 e 3 |
| Cabeças de Atenção | 1, 2, 5 e 8 |
| Tipo de Decodificador | Decodificador All-MLP |
| Função de Ativação | GELU |
| Taxa de Dropout | 0,1 |
| Módulo de Aprimoramento de Características | Módulo de Fusão de Características Culturais com Atenção Cruzada (CAFFM) |
| Dimensão de Embedding do CAFFM | 256 |
| Cabeças de Atenção do CAFFM | 8 |
| Escala de Fusão do CAFFM | 4 |
| Modelo de Reconstrução | CycleGAN |
| Modelo de Geração de Estilo | SPADE |
| Conjunto de Dados Cultural | Conjunto de Dados Miao Batik |
| Conjunto de Dados de Estilo | Conjunto de Dados WikiArt |
| Imagens Miao Batik | 15.148 |
| Imagens WikiArt | Aproximadamente 80.000 |
| Resolução da Imagem de Entrada | 256 × 256 pixels |
| Formato de Cor | RGB |
| Método de Interpolação | Interpolação Bilinear |
| Método de Remoção de Ruído | Filtragem Gaussiana |
| Tamanho do Kernel Gaussiano | 5 × 5 |
| Sigma Gaussiano (σ) | 1 |
| Intervalo de Normalização | [0, 1] |
| Tamanho do Lote | 16 |
| Número de Épocas | 100 |
| Otimizador | Adam |
| Taxa de Aprendizado | 0,0002 |
| Parâmetros do Adam | β₁ = 0,5, β₂ = 0,999, ε = 1 × 10⁻⁸, decaimento de peso = 0 |
| Funções de Perda | Perda de Segmentação, Perda Adversária, Perda de Consistência Cíclica, Perda de Reconstrução, Perda de Preservação de Motivo e Perda de Consistência de Estilo |
| Estratégia de Divisão do Conjunto de Dados | Treinamento / Validação / Teste |
| Conjunto de Treinamento | 70% |
| Conjunto de Validação | 15% |
| Conjunto de Teste | 15% |
| Semente Aleatória | 42 |
| Métricas de Avaliação | Precisão de Segmentação, IoU, Coeficiente Dice, SSIM, PSNR e FID |
| Linguagem de Programação | Python 3.8.10 |
| Framework de Aprendizado Profundo | PyTorch 1.10.0 |
| Plataforma de Hardware | GPU NVIDIA RTX 3090 (24 GB VRAM), Intel Core i7 (11ª Geração), 32 GB de RAM |
| Ambiente Operacional | Ubuntu 20.04 LTS |
Tabela 3: Configuração Experimental e Configuração do Modelo. Resumo dos componentes arquiteturais, configuração de treinamento, configurações de pré-processamento, conjuntos de dados, parâmetros de otimização, métricas de avaliação e ambiente computacional utilizados para implementação e avaliação do framework proposto SegCycle-SPADE.
O módulo de atenção mapeia inicialmente o mapa de características em representações de consulta, chave e valor usando a Equação 10:
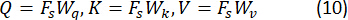
Aqui, Wq, Wk e Wv são matrizes de pesos ajustáveis. Os pesos de atenção são calculados com base na similaridade entre o vetor de consulta e o vetor-chave utilizando a Equação 1117:
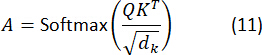
Aqui, dk é a dimensão do vetor de chave. A representação de características aprimorada é calculada multiplicando os pesos de atenção pela matriz de valor usando a Equação 12:
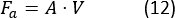
Aqui, Fa é a representação aprimorada da característica do mapa de características. A representação aprimorada da característica é calculada combinando as características originais de segmentação com as características aprimoradas obtidas usando o mecanismo de atenção por meio da Equação 13:
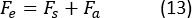
Aqui, Fe é o mapa de características aprimorado utilizado para a reconstrução do padrão. O CAFFM é estendido com um mecanismo de atenção cruzada em múltiplas escalas para extrair características de motivos culturais em diferentes escalas. Seja Fsi representando as características de segmentação na escala i, enquanto Faj representa as características de estilo artístico na mesma escala. A representação final das características é definida usando a Equação 14:
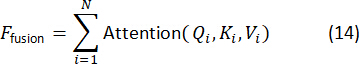
Aqui, Qi, Ki e Vi representam, respectivamente, as matrizes de consulta, chave e valor na escala i, e N denota o número de escalas de características. Neste estudo, N = 4, correspondendo aos mapas de características extraídos em resoluções espaciais de 1/4, 1/8, 1/16 e 1/32 do tamanho da imagem de entrada. Essas representações de características em múltiplas escalas foram fundidas utilizando pesos de atenção aprendíveis antes da reconstrução e da síntese artística. A extensão acima permite que o método extraia motivos culturais globais e texturas para reconstruir padrões culturais. O CAFFM está posicionado entre a etapa de segmentação baseada em SegFormer e a etapa de síntese criativa baseada em SPADE no sistema proposto SegCycle-SPADE. Primeiramente, enquanto o CycleGAN cria simultaneamente características de reconstrução com informações estilísticas e relacionadas a padrões, o SegFormer-B2 recupera mapas de características semânticas que descrevem as propriedades estruturais dos motivos culturais. O módulo CAFFM recebe esses dois fluxos de características e utiliza fusão baseada em atenção cruzada para identificar relações entre representações estruturais e artísticas. A fim de criar padrões culturalmente autênticos mantendo a consistência semântica e as características estruturais, os mapas de características fundidos resultantes são então enviados ao módulo SPADE para síntese criativa orientada por segmentação.
Reconstrução de Padrão usando CycleGAN
Uma vez concluída a etapa de realce de características baseada na atenção, os mapas de características conterão as estruturas aprimoradas dos motivos culturais. No entanto, os mapas de características ainda podem conter regiões de padrão incompletas ou danificadas. Portanto, para resolver o problema da reconstrução dos padrões, a estrutura proposta utilizará o modelo CycleGAN. Na estrutura proposta, os dois domínios serão os padrões originais de motivos culturais e os padrões reconstruídos de motivos culturais. Utilizando as características aprimoradas das etapas anteriores, o modelo CycleGAN reconstruirá os padrões culturais mantendo a consistência estrutural. Isso garantirá que padrões culturais, como padrões geométricos, florais e simbólicos, mantenham sua disposição espacial. As imagens originais de Batik Miao foram submetidas a operações de mascaramento aleatório e oclusão parcial para gerar motivos culturais incompletos ou danificados. Esses procedimentos de degradação simularam regiões de padrão ausentes e danos estruturais comumente observados em artefatos de patrimônio cultural deteriorados. As imagens degradadas foram utilizadas como entradas para o módulo de reconstrução, enquanto as imagens originais correspondentes serviram como imagens de referência para avaliação de desempenho e análise da qualidade da reconstrução. Essa estratégia permitiu que o modelo aprendesse a restaurar estruturas de motivos ausentes, preservando ao mesmo tempo a consistência semântica e as características culturais.
Seja X o domínio dos padrões culturais incompletos e Y o domínio dos padrões culturais reconstruídos. Os dois geradores aprendem a realizar a mapeamento bidirecional usando a Equação 15:
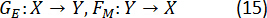
Aqui, GE é usado para reconstruir estruturas de motivos e FM é usado para mapear os padrões de volta ao domínio original. A perda adversária é utilizada para garantir que os padrões reconstruídos sejam realistas (Equação 16)30
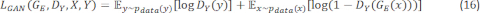
Aqui, DY é o discriminador usado para distinguir padrões reais e reconstruídos, e GE(x) denota o padrão reconstruído gerado. O CycleGAN também impõe consistência cíclica para preservar a disposição estrutural dos motivos culturais (Equação 17)30.
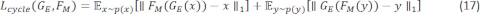
A função de perda final é definida utilizando a Equação 1830:
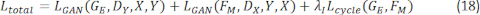
Aqui, λi denota o coeficiente de ponderação para a perda de consistência cíclica e foi definido como 10 durante o treinamento, em conformidade com a formulação original do CycleGAN. Esse valor foi escolhido para equilibrar a aprendizagem adversarial e a consistência de reconstrução entre os domínios de origem e destino.
O módulo de reconstrução CycleGAN consiste em dois geradores e dois discriminadores para tradução bidirecional de imagens. Cada gerador segue uma arquitetura de rede residual composta por uma camada convolucional inicial 7 × 7, seguida por duas camadas convolucionais de subamostragem, nove blocos residuais e duas camadas de superamostragem. Todas as operações convolucionais utilizam um tamanho de kernel de 3 × 3, exceto a camada de entrada, que utiliza um kernel 7 × 7 para melhorar a extração de características. A Normalização por Instância é aplicada após cada camada convolucional para melhorar a estabilidade do treinamento, enquanto a ativação ReLU é usada em toda a rede do gerador. A camada de saída emprega uma função de ativação Tanh para gerar saídas de imagem normalizadas. O discriminador segue uma arquitetura PatchGAN 70 × 70, composta por uma série de camadas convolucionais com tamanhos de kernel de 4 × 4 e canais de características progressivamente crescentes. A Normalização por Instância e a ativação LeakyReLU (inclinação negativa = 0,2) são empregadas no discriminador para melhorar a discriminação de características e o aprendizado adversarial. O módulo CycleGAN recebe como entrada imagens pré-processadas de motivos culturais e gera representações de padrões reconstruídos, que posteriormente são encaminhadas ao CAFFM para integração com características de segmentação. O treinamento do CycleGAN foi realizado utilizando o otimizador Adam (β₁ = 0,5, β₂ = 0,999) com uma taxa de aprendizado inicial de 0,0002. A taxa de aprendizado foi mantida constante durante as primeiras 100 épocas e posteriormente reduzida linearmente a zero ao longo do período restante de treinamento. Um buffer de replay contendo 50 imagens previamente geradas foi utilizado para estabilizar o treinamento do discriminador. Os geradores e discriminadores foram atualizados utilizando uma razão de atualização 1:1, com uma atualização do gerador seguida por uma atualização do discriminador em cada iteração de treinamento.
O processo de reconstrução do CycleGAN baseia-se nos mapas de características aprimorados obtidos utilizando o mecanismo CAFFM apresentado na Figura 5. Os mapas de características contêm motivos culturais aprimorados provenientes das etapas anteriores de segmentação e do CAFFM. Esses mapas são utilizados como entrada para o primeiro gerador GE. O primeiro gerador GE aprende o mapeamento necessário para reconstruir padrões culturais. As saídas são então encaminhadas ao discriminador DY para distinguir entre padrões culturais reais e padrões reconstruídos. O discriminador DY auxilia o gerador GE a produzir saídas realistas. Para garantir que os padrões culturais não sejam distorcidos durante a reconstrução, o segundo gerador FM realiza um mapeamento com consistência cíclica. O segundo gerador FM mapeia as saídas de volta ao domínio original. As saídas são então avaliadas pelo discriminador para assegurar realismo. As saídas finais são subsequentemente encaminhadas ao módulo SPADE para geração de estilo artístico na próxima etapa do framework proposto SegCycle-SPADE.
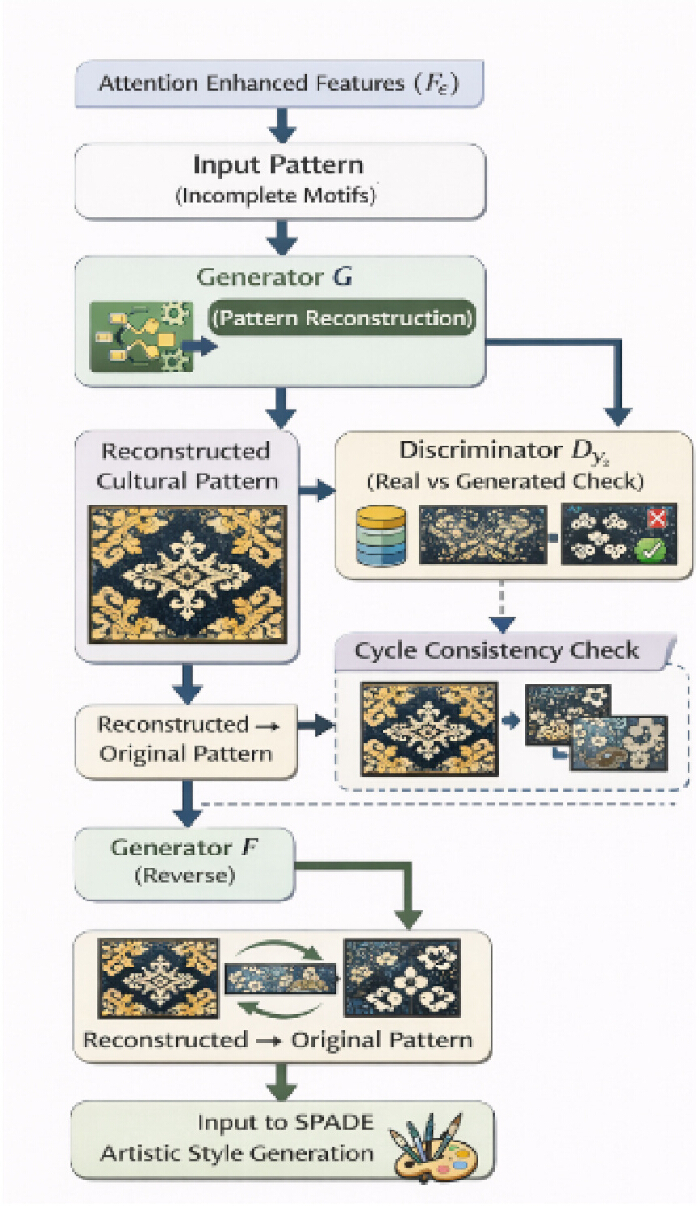
Figura 5. Fluxo de Trabalho de Reconstrução de Padrão Baseado em CycleGAN. Fluxo de trabalho do módulo de reconstrução CycleGAN. Representações de características com realce de atenção são fornecidas como entradas para a rede geradora, a fim de reconstruir motivos culturais incompletos. O discriminador avalia as saídas reconstruídas em relação aos padrões de referência, enquanto o mapeamento de consistência cíclica preserva a integridade estrutural durante a tradução bidirecional de imagens. Os motivos reconstruídos são posteriormente encaminhados ao módulo SPADE para síntese de estilo artístico. Clique aqui para visualizar uma versão maior desta figura.
Geração de Estilo Artístico usando SPADE
Posteriormente, os motivos culturais reconstruídos são submetidos ao módulo SPADE para a geração de estilo artístico. O objetivo principal do módulo SPADE é adicionar texturas visualmente ricas de estilo artístico aos motivos culturais reconstruídos, sem comprometer o layout estrutural dos motivos. O módulo SPADE é uma técnica de geração condicional de imagens que utiliza o conceito de segmentação de imagens para a criação de imagens. Mapas semânticos multicanal correspondentes às classes predeterminadas de motivos foram codificados a partir das máscaras de segmentação semântica produzidas pelo SegFormer-B2. O gerador SPADE recebeu esses mapas codificados como entradas condicionantes. Os parâmetros espacialmente adaptativos de escala (γ) e de deslocamento (β) foram gerados processando os mapas semânticos por meio de camadas convolucionais dentro de cada camada SPADE. Assim, o gerador pôde manter as bordas dos motivos, os layouts estruturais e as informações semânticas durante a síntese artística ao aplicar esses parâmetros às ativações de características normalizadas. A orientação semântica conseguiu influenciar tanto a reconstrução estrutural de alto nível quanto a síntese de texturas de baixo nível, já que o processo de condicionamento foi realizado em várias camadas do gerador SPADE. Como resultado, os padrões artísticos criados incorporaram características estilísticas obtidas do conjunto de dados WikiArt, ao mesmo tempo que preservaram as estruturas dos motivos culturais identificadas durante a etapa de segmentação.
O conjunto de dados WikiArt, que inclui obras de 27 categorias artísticas diferentes — como Renascença, Impressionismo, Cubismo, Expressionismo, Surrealismo, Realismo e Arte Abstrata —, foi utilizado como recurso principal para compreender estilos artísticos. A fim de expor o modelo a uma variedade de traços criativos e aprimorar a generalização de estilo, imagens de estilo foram selecionadas aleatoriamente dentre as diversas categorias durante o treinamento. O conjunto de dados foi dividido em subconjuntos de treinamento, validação e teste com representação equilibrada das categorias artísticas, a fim de reduzir o viés de estilo. Para garantir representação equilibrada de todas as 27 categorias artísticas, foi utilizada amostragem estratificada. As amostras de cada categoria foram alocadas proporcionalmente aos subconjuntos de treinamento, validação e teste, preservando a distribuição original das classes. O módulo CAFFM foi usado para mesclar os aspectos de estilo derivados das imagens do WikiArt com as características de reconstrução produzidas pelo CycleGAN. Para permitir que a rede de síntese transfira qualidades artísticas mantendo ao mesmo tempo a estrutura semântica e os limites dos motivos culturais derivados dos mapas de segmentação, as representações fusionadas resultantes foram fornecidas como informação de condicionamento ao gerador SPADE. A estrutura proposta foi capaz de produzir padrões artísticos culturalmente autênticos com representações estruturais e estilísticas consistentes graças a essa técnica de condicionamento por estilo.
O SPADE também introduz parâmetros espacialmente adaptativos que dependem do mapa de segmentação. Os parâmetros podem ser definidos conforme mostrado na Equação 191:
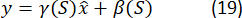
Aqui, γ(S) é o parâmetro de escala com variação espacial e β(S) é o parâmetro de viés com variação espacial. Os parâmetros podem ajudar o gerador a criar diferentes texturas e estilos dependendo da região semântica nas imagens. A obra de arte cultural final pode ser definida conforme mostrado na Equação 20:
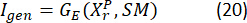
Aqui, GE é o gerador SPADE, XrP é o padrão reconstruído e SM é o mapa de segmentação. A obra final mantém a integridade estrutural dos motivos culturais, ao mesmo tempo que aprimora a aparência artística. Uma função de perda composta, que equilibra a precisão da segmentação semântica, a preservação de motivos culturais, a qualidade da reconstrução de padrões e a consistência do estilo artístico, foi utilizada para otimizar a arquitetura proposta SegCycle-SPADE. Uma mistura ponderada da perda de segmentação (Lseg), perda adversarial (Ladv), perda de consistência cíclica (Lcycle), perda de reconstrução (Lrecon), perda de preservação de motivo (Lmotif) e perda de consistência de estilo (Lstyle) foi utilizada para estabelecer o objetivo geral de treinamento. A função de perda total é definida na Equação 21:
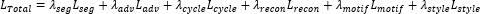 (21)
Para garantir a consistência estrutural entre os motivos culturais de entrada e os reconstruídos, o coeficiente da perda de consistência cíclica foi definido como 10. Para manter características finas dos motivos e aprimorar a precisão visual, o coeficiente da perda de reconstrução foi ajustado para 5. Para destacar a preservação de padrões estruturais culturalmente essenciais durante a síntese artística, utilizou-se um coeficiente de 2 para a perda de preservação do motivo. A fim de promover a transferência de estilo artístico sem distorcer excessivamente as estruturas semânticas dos motivos, o coeficiente da perda de consistência de estilo foi ajustado para 1. Para manter uma contribuição equilibrada entre a geração realista de imagens e a segmentação precisa dos motivos, pesos iguais foram atribuídos às perdas de segmentação e adversarial. As representações de estilo baseadas em características do conjunto de dados WikiArt foram utilizadas para calcular a perda de consistência de estilo. Em particular, as características de estilo artístico foram capturadas por meio de correlações de matrizes de Gram extraídas de mapas de características profundas. A diferença da norma de Frobenius entre as matrizes de Gram da imagem de estilo alvo e da imagem gerada foi utilizada para calcular a perda de estilo, conforme mostrado na Equação 22:
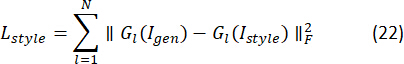
Aqui, Gl é a matriz de Gram calculada a partir da lª camada de características, Igen denota a imagem artística gerada, Istyle denota a imagem de estilo alvo do conjunto de dados WikiArt e F denota a norma de Frobenius. Essa formulação permite que o framework proposto preserve as características artísticas, ao mesmo tempo que mantém a integridade estrutural e semântica dos motivos culturais.
As representações de características fundidas produzidas pelo módulo CAFFM são utilizadas como entradas condicionantes para o módulo SPADE, que atua como o componente de síntese artística da estrutura proposta. O gerador SPADE é composto por sete blocos residuais SPADE com uma dimensão de características latentes de 256 canais e gera imagens de saída com resolução de 256 × 256 pixels. Os mapas de segmentação semântica obtidos a partir do módulo SegFormer–CAFFM são utilizados como entradas condicionantes ao longo de todas as camadas residuais SPADE. As camadas SPADE são aplicadas antes das funções de ativação dentro de cada bloco residual, permitindo um condicionamento semântico guiado pela segmentação. Por meio de operações sucessivas de interpolação e convolucionais, a representação de características latentes é refinada progressivamente para gerar padrões artísticos de alta resolução, preservando ao mesmo tempo a consistência semântica e a estrutura dos motivos. Funções de ativação LeakyReLU são utilizadas em todo o gerador, e uma função de ativação Tanh é aplicada na camada de saída para produzir imagens normalizadas.
Algoritmo e Fluxo de Trabalho
O framework SegCycle-SPADE integra segmentação semântica, fusão de características, reconstrução de padrões e síntese de estilo artístico em um único pipeline de treinamento. O fluxo de trabalho inicia com a aquisição e pré-processamento do conjunto de dados, incluindo redimensionamento de imagens, normalização, remoção de ruídos e preparação das máscaras de segmentação. As imagens pré-processadas são posteriormente processadas usando a rede de segmentação SegFormer-B2 para extrair representações semânticas de motivos. As características de segmentação resultantes são fundidas com características de reconstrução por meio do CAFFM, permitindo a interação entre informações de motivos estruturais e representações de características artísticas. Os mapas de características fundidos são então fornecidos ao módulo de reconstrução CycleGAN, que restaura estruturas de motivos culturais incompletas, preservando a consistência semântica. Os padrões reconstruídos são subsequentemente fornecidos ao gerador SPADE para síntese artística guiada por segmentação, permitindo aprimoramento estilístico enquanto mantém os limites dos motivos e a autenticidade estrutural. Durante o treinamento, os parâmetros do modelo são otimizados usando a função de perda composta descrita nas Equações 21 e 22, que equilibra a precisão da segmentação, a preservação de motivos, a qualidade de reconstrução e a consistência do estilo artístico. Um fluxo de implementação detalhado, passo a passo, incluindo carregamento do conjunto de dados, pré-processamento, inicialização do modelo, iterações de treinamento, procedimentos de validação, seleção de pontos de verificação e avaliação final, é fornecido no Arquivo Suplementar 1 (Algoritmo 1). O fluxo de trabalho algorítmico completo foi implementado usando um tamanho de lote de 16, uma taxa de aprendizado de 0,0002 e 100 épocas de treinamento. Uma semente aleatória fixa de 42 foi utilizada para a partição do conjunto de dados, inicialização do modelo e todos os experimentos de treinamento. A semente foi aplicada de forma consistente nos geradores de números aleatórios do Python, NumPy e PyTorch para garantir a reprodutibilidade. O otimizador Adam foi configurado com β₁ = 0,5, β₂ = 0,999 e sem decaimento de peso (weight decay = 0). Os pontos de verificação do modelo foram selecionados com base na maior pontuação de IoU de validação alcançada no conjunto de dados de validação.
Otimização da Função de Perda
Para preservar as estruturas dos motivos culturais durante a reconstrução e a síntese artística, a estrutura proposta emprega um objetivo de otimização composto que combina perdas de segmentação, adversarial, consistência cíclica, reconstrução, preservação de motivos e consistência de estilo. A formulação matemática completa, os coeficientes de ponderação e a definição da perda de estilo são fornecidos nas Equações 21 e 22 na subseção Geracao de Estilo Artistico usando SPADE. O componente de preservação de motivos penaliza desvios estruturais entre as regiões de motivos previstas e as máscaras de segmentação correspondentes do padrão-ouro, incentivando assim a preservação de estruturas de padrões culturalmente significativas ao longo do processo de reconstrução.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
A estrutura proposta SegCycle-SPADE foi avaliada utilizando dois conjuntos de dados: o conjunto de dados de motivos culturais Miao Batik e o conjunto de dados WikiArt. O conjunto de dados Miao Batik contém imagens de patrimônio cultural tradicional e foi utilizado principalmente para tarefas de segmentação semântica e reconstrução estrutural, enquanto o conjunto de dados WikiArt contém estilos artísticos diversos e foi usado para aprendizado e geração de estilos artísticos. As imagens de ambos os conjuntos de dados foram...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
A preservação e a reconstrução digital de padrões do patrimônio cultural imaterial (ICH) têm recebido atenção crescente nos últimos anos devido à perda gradual dos ofícios tradicionais. Estudos anteriores tentaram abordar a perda do patrimônio cultural por meio de técnicas de processamento de imagens baseadas em aprendizado profundo (DL). Por exemplo, Quan et al.32 propuseram um framework de preservação do patrimônio cultural baseado em grafos de conhecimento e DL para a cultura do tingimento em c...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Conflito de Interesses:
Os autores declaram não haver interesses conflitantes.
Agradecimentos
Os autores agradecem o apoio acadêmico e institucional fornecido pelo Guangdong Engineering Polytechnic e pela Universidade Normal do Sul da China durante a realização desta pesquisa. Esta pesquisa contou com o apoio do Projeto Geral do Fundo Nacional de Ciências Sociais de 2023 (nº 23BH161), intitulado “Museu de Regeneração Digital: Pesquisa sobre a Ativação e Comunicação de Relíquias Culturais Chinesas Clássicas de Caligrafia e Pintura”.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Otimizador Adam | Biblioteca de Otimizadores PyTorch | Adam | Algoritmo de otimização utilizado durante o treinamento do modelo. |
| Toolkit CUDA | Corporação NVIDIA | CUDA 11.3 | Aceleração por GPU para cálculos de aprendizado profundo. |
| cuDNN | Corporação NVIDIA | cuDNN 8.2 | Biblioteca de aceleração de redes neurais profundas utilizada para acelerar o treinamento e a inferência. |
| CycleGAN | Universidade da Califórnia, Berkeley / Código Aberto | Implementação Oficial em PyTorch (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | Rede generativa adversarial utilizada para reconstrução de motivos culturais. |
| Parâmetros Pré-treinados do ImageNet | ImageNet / Código Aberto | mit_b2.pth (Ponto de controle pré-treinado no ImageNet-1K) | Utilizado para inicializar a estrutura SegFormer-B2 antes do ajuste fino no conjunto de dados Miao Batik. |
| Processador Intel | Corporação Intel | Intel Core i7 (11ª Geração) | CPU utilizada para pré-processamento de imagens, suporte ao treinamento do modelo e inferência. |
| Matplotlib | Equipe de Desenvolvimento Matplotlib | Matplotlib 3.5.1 | Visualização de curvas de treinamento e resultados de avaliação. |
| Conjunto de Dados Miao Batik | Repositório Zenodo | DOI: 10.5281/zenodo.20807658 | Conjunto de dados de motivos culturais contendo 15.148 imagens, utilizado para segmentação semântica e reconstrução de padrões. |
| NumPy | Desenvolvedores NumPy | NumPy 1.21.5 | Computação numérica e processamento de conjuntos de dados. |
| GPU NVIDIA | Corporação NVIDIA | NVIDIA RTX 3090 (24 GB de VRAM) | Plataforma de hardware utilizada para treinamento e inferência do modelo. |
| OpenCV | Fundação OpenCV | OpenCV 4.5.5 | Pré-processamento de imagens, redimensionamento, interpolação e redução de ruído gaussiano. |
| Sistema Operacional | Canonical Ltd. | Ubuntu 20.04 LTS | Ambiente de execução experimental. |
| Pillow (PIL) | Biblioteca de Processamento de Imagens em Python | Pillow 8.4.0 | Carregamento e manipulação de imagens. |
| Python | Python Software Foundation | Python 3.8.10 | Linguagem de programação utilizada para implementação e experimentação. |
| PyTorch | Meta AI | PyTorch 1.10.0 | Framework de aprendizado profundo utilizado para treinamento e inferência do modelo. |
| Semente Aleatória | Configuração Experimental | 42 | Semente fixa utilizada para partição do conjunto de dados, inicialização do modelo e reprodutibilidade experimental. |
| Scikit-learn | Desenvolvedores Scikit-learn | Scikit-learn 1.0.2 | Partição de conjuntos de dados, análise estatística e métricas de avaliação. |
| Seaborn | Comunidade de Código Aberto | Seaborn 0.11.2 | Visualização estatística de dados. |
| SegFormer-B2 | Pesquisa NVIDIA / Código Aberto | SegFormer-B2 (Estrutura MIT-B2) | Modelo de segmentação semântica baseado em transformadores, utilizado para segmentação de motivos culturais. |
| Máscaras de Segmentação / Anotações | Conjunto de Dados Miao Batik | Incluído com o Conjunto de Dados | Rótulos de segmentação semântica em nível de pixel, utilizados para classificação de motivos e treinamento. |
| SPADE | Pesquisa NVIDIA / Código Aberto | Implementação Oficial em PyTorch (https://github.com/NVlabs/SPADE) | Modelo de síntese de imagens guiado por segmentação, utilizado para geração artística de padrões. |
| TorchVision | Meta AI | TorchVision 0.11.1 | Utilitários de processamento de imagens e transformações de conjuntos de dados utilizados com o PyTorch. |
| Conjunto de Dados WikiArt | WikiArt | https://www.wikiart.org/ | Conjunto de dados de estilos artísticos contendo mais de 80.000 obras em 27 estilos artísticos, utilizado para aprendizado e síntese de estilo. |
Referências
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.