Este estudo analisa a tomada de decisões e os comportamentos de revisão de estudantes de Letras Inglesas ao traduzirem narrativas com foco na China, integrando registros de digitação e um corpus de danmu para revelar como a saliência textual influencia o esforço de processamento e a qualidade da tradução.
Artigo de investigação
Comportamento de Tomada de Decisão e Revisão na Tradução de Chinês para Inglês: Evidências de Estudantes de Graduação em Inglês Traduzindo Narrativas Focadas na China
Neste artigo
Resumo
Resumo
À medida que narrativas centradas na China ganham cada vez mais circulação internacional, a tradução do chinês para o inglês tornou-se um espaço de negociação de significados, e não uma simples transferência linguística. Para estudantes de tradução, o principal desafio vai além da seleção léxica; envolve decidir como representar referências carregadas de cultura, posições avaliativas e posicionamentos narrativos para leitores fora do contexto de origem. Este estudo analisa a tomada de decisão em tempo real e os comportamentos de revisão de 72 estudantes de inglês ao traduzirem narrativas centradas na China. Utilizando um desenho processo-produto, a pesquisa integra dados de registro de digitação coletados com o Translog-II, avaliações dos produtos traduzidos e um corpus auxiliar de danmu (comentários sincronizados com o tempo) tratado como uma camada de saliência do público, e não como uma medida direta da dificuldade linguística em segmentos específicos. Os processos de tradução foram analisados com base na duração das pausas, frequência de revisões, localização das revisões e distribuição por etapas, enquanto a qualidade dos produtos foi avaliada por meio de classificações especializadas e codificação direcionada de segmentos relacionados à cultura. Um corpus de 18.642 comentários danmu de 24 vídeos do Bilibili foi utilizado para identificar temas narrativos de destaque público e expressões culturalmente sensíveis. Os resultados mostram que segmentos com forte carga cultural e densidade avaliativa provocaram pausas mais longas, aumento de revisões recursivas e reformulações mais intensas durante o processo. Traduções de maior qualidade estiveram associadas a revisões seletivas e estrategicamente temporizadas nos níveis do discurso e da adaptação cultural, e não a um número maior de revisões no total. A sobreposição entre gatilhos narrativos salientes no danmu e segmentos de tradução que exigiram maior esforço é interpretada como evidência convergente de saliência do público e pressão no processamento do tradutor, e não como evidência de causalidade. O estudo contribui para a pesquisa sobre o processo tradutório ao vincular o comportamento de revisão à tradução de narrativas culturalmente enraizadas, oferecendo implicações para o treinamento de tradutores na comunicação intercultural.
Introdução
Nos últimos anos, a tradução de discursos relacionados à China passou de uma preocupação relativamente especializada para uma questão central na comunicação internacional1. O que está em jogo nessa tradução não é simplesmente a transferência de conteúdo proposicional, mas a rearticulação de narrativas públicas que carregam posicionamentos políticos, enquadramentos culturais e estratégias de público-alvo. Os estudos sobre a tradução de discursos políticos chineses têm deixado esse ponto cada vez mais claro: quando textos são traduzidos para leitores fora da China, as escolhas de palavras, modalidades e ênfases textuais também se tornam decisões sobre como a China é narrada e interpretada no exterior2. Uma vez que o problema é formulado dessa maneira, uma abordagem baseada apenas no produto final torna-se insuficiente. Uma tradução concluída pode mostrar o que foi escolhido, mas não pode revelar quando surgiu a incerteza, onde começou a reformulação ou como soluções alternativas foram testadas e descartadas3.
Essas limitações ajudam a explicar por que a pesquisa empírica sobre processos de tradução tornou-se uma vertente importante nos estudos da tradução, utilizando ferramentas de rastreamento de processos para capturar pausas, exclusões, inserções e o formato temporal da tomada de decisões, em vez de inferi-las indiretamente a partir do texto final4. Isso não substitui abordagens baseadas no produto, sociológicas, culturais ou em corpora; ao contrário, acrescenta evidências sobre a formação momento a momento das decisões de tradução. Trabalhos recentes avançaram da descrição de pausas isoladas para modelar a tradução como uma atividade estruturada temporalmente. A taxonomia hesitação-orientação-fluxo, por exemplo, trata o comportamento tradutório como uma alternância padronizada entre incerteza, busca e produção fluente, explicando por que certos trechos de uma tarefa tornam-se instáveis e desencadeiam reformulações5. Essa mudança é especialmente relevante na tradução realizada por estudantes, nos quais proficiência linguística, conhecimento temático e controle estratégico ainda estão em desenvolvimento simultâneo6.
Evidências provenientes da combinação de rastreamento ocular e registro de pressionamento de teclas mostram que tradutores iniciantes não distribuem a atenção de forma uniforme e que a produção do texto-alvo frequentemente se torna um ponto principal de carga cognitiva durante a tradução do chinês para o inglês7. Consequentemente, o que parece ser um problema local de escolha de palavras no produto pode, na verdade, refletir uma reorganização mais ampla da atenção e do esforço durante o processo em tempo real8. Evidências recentes sugerem ainda que tradutores estudantes podem produzir textos com adequação superficial semelhante, embora diferindo substancialmente na quantidade de esforço, incerteza e autorregulação necessários. Uma versão final satisfatória ainda pode basear-se em um caminho de decisões frágil ou ineficiente, que só pode ser capturado por meio de medidas sensíveis ao processo9. Além disso, estudos comparativos indicam que a expertise em tradução envolve um controle metacognitivo estável sobre quando pausar, buscar informações, continuar redigindo ou retornar para revisão10.
A revisão é exatamente o ponto em que esse processo cognitivo oculto se torna mais visível. É onde tradutores retornam à redação anterior, testam alternativas e decidem se um problema é lexical, sintático, discursivo ou cultural. Consequentemente, a revisão não deve ser tratada como uma etapa final de polimento, mas como um indicador fundamental do desenvolvimento do tradutor. Resultados melhores estão ligados à forma como as alternativas são consolidadas durante a produção, demonstrando que uma revisão eficaz é seletiva, estrategicamente cronometrada e responsiva às demandas textuais mais amplas, e não simplesmente um acúmulo de edições11,12,13.
A complexidade da tomada de decisões e revisão torna-se mais acentuada quando o texto-fonte é uma narrativa focada na China, em vez de um trecho informativo neutro. Tais textos frequentemente dependem de pressupostos carregados culturalmente, expressões historicamente situadas e pistas avaliativas cujo significado depende de um contexto compartilhado, em vez de uma exposição explícita14,15,16. A dificuldade do texto altera a própria granularidade do processamento; textos narrativos com densidade cultural ou avaliativa obrigam os tradutores a trabalhar em unidades menores, realizar operações não lineares e envolver-se em reestruturações locais repetidas8. Para tradutores estudantes, o problema central é decidir até que ponto desvendar ou reorganizar esse contexto implícito para leitores fora da comunidade discursiva original, sem anular a especificidade cultural.
Três lacunas específicas motivam o presente estudo. Primeiro, métricas do processo de tradução, como duração de pausas, frequência de pausas longas, interrupções do cursor e consultas a dicionários, são frequentemente examinadas separadamente das tipologias de revisão, dificultando a compreensão de como a pressão decisória se manifesta posteriormente em reformulações. Segundo, categorias narrativas culturalmente específicas receberam menos atenção baseada em processos do que textos acadêmicos gerais ou expositivos, embora narrativas centradas na China exijam frequentemente que tradutores lidem simultaneamente com carga cultural, densidade avaliativa e implicações contextuais comprimidas14,15,16. Neste estudo, carga cultural refere-se à densidade de referências ligadas à cultura e pressuposições compartilhadas; densidade avaliativa refere-se à tomada de posição explícita ou implícita, intensidade afetiva e enquadramentos carregados de valor; e compressão narrativa refere-se ao grau em que informações de fundo, relações causais ou posicionamentos sociais são condensados em segmentos textuais breves. Terceiro, as tarefas de tradução geralmente são concebidas unicamente com base em análise interna do texto, sem grande consideração sobre se segmentos identificados como difíceis coincidem com pontos que atraem atenção pública na circulação digital. Danmu (comentários em vídeo sincronizados no tempo) podem funcionar como paratexto e discurso participativo, destacando o que o público percebe, contesta e reinterpretar17,18; no entanto, a saliência do danmu deve ser tratada como um indicador em nível semântico do engajamento do público, e não como substituto direto da dificuldade linguística em nível de segmento.
Para preencher essas lacunas, o presente estudo analisa como estudantes de Letras Inglês tomam decisões e realizam revisões ao traduzir narrativas com foco na China do chinês para o inglês. Ao integrar dados do processo de tradução e discurso digital do público no mesmo quadro analítico, o estudo busca explicar não apenas onde os tradutores estudantes enfrentam dificuldades, mas também por que essas dificuldades se concentram em determinados tipos de significado narrativo.
Especificamente, este estudo aborda quatro perguntas de pesquisa: (1) Quais padrões de tomada de decisão caracterizam a tradução do chinês para o inglês, feita por estudantes de inglês, de narrativas com foco na China? (2) Como os comportamentos de revisão variam entre segmentos com diferentes níveis de carga cultural e densidade narrativa? (3) Quais dimensões do comportamento de revisão estão associadas a uma qualidade superior da tradução? e (4) Os pontos culturalmente relevantes identificados no discurso danmu coincidem com os segmentos que geram o maior esforço de processamento durante a tradução?
Correlacionadamente, o estudo testa quatro hipóteses interligadas em uma única sequência analítica: H1 propõe que segmentos com maior carga cultural provocarão pausas mais longas, maior incerteza decisória e revisão mais frequente do que segmentos com menor carga cultural; H2 distingue dois caminhos, prevendo que a densidade avaliativa aumentará a revisão tardia, enquanto a compressão narrativa aumentará a reformulação em nível discursivo; H3 prevê que a qualidade da tradução será explicada de forma mais acentuada pela seletividade e pelo momento da revisão do que apenas pelo número total de revisões; e H4 prevê que os segmentos com destaque em danmu coincidirão com os segmentos de tradução de alto esforço, representando uma convergência associativa entre a saliência do público e a pressão do processamento do tradutor.
Protocolo
Todos os métodos envolvendo seres humanos foram conduzidos em conformidade com as diretrizes institucionais e foram aprovados pela comissão de ética institucional (IRB) ou pelo comitê de ética em pesquisa com seres humanos da Universidade Normal Hanshan. O consentimento informado foi obtido de todos os participantes antes do experimento.
Estrutura conceitual e desenho da pesquisa
Este estudo utilizou um delineamento de pesquisa processo-produto com uma camada discursiva auxiliar para examinar como os comentários danmu gerados pelo público influenciam a tradução de legendas. A estrutura analítica integrou características textuais, indicadores do processo de tradução e resultados de qualidade da tradução. Especificamente, investigou-se se a atenção do público, refletida pela densidade dos danmu, direcionava os recursos cognitivos dos tradutores para características textuais específicas e se essa alocação de atenção afetava posteriormente a qualidade da tradução.
Para operacionalizar esse quadro, o estudo primeiro estabeleceu características textuais em nível de segmento com base em quatro dimensões: carga cultural, densidade avaliativa, compressão narrativa e saliência do danmu. A carga cultural referia-se à presença de referências especificamente culturais que exigiam adaptação ou explicação. A densidade avaliativa mensurava a concentração de linguagem carregada emocionalmente ou em termos de atitude dentro de um segmento. A compressão narrativa capturava o grau em que o conteúdo semântico era condensado sob as restrições das legendas. A saliência do danmu representava o grau de atenção do público direcionada a cada segmento de legenda, quantificado pelo volume de comentários danmu sincronizados. Diferentemente das medidas convencionais de dificuldade de tradução, a saliência do danmu refletia a atenção socialmente distribuída, e não a complexidade textual intrínseca. Um segmento que recebia intenso engajamento do público não era necessariamente mais difícil de traduzir; ao contrário, representava um ponto de significado comunicativo acentuado dentro da experiência de visualização.
A estrutura analítica compreendia três conjuntos de dados interconectados. O conjunto de dados em nível de participante incluía características demográficas individuais e nível de experiência em tradução. O conjunto de dados processo-produto vinculava cada segmento de legenda a indicadores comportamentais extraídos do registro de digitação, juntamente com avaliações especializadas da qualidade da tradução. O conjunto de dados danmu continha comentários sincronizados do público alinhados ao tempo das legendas, a partir dos quais foram calculados os valores de saliência dos danmu. Esses conjuntos de dados foram vinculados por meio de identificadores de participantes e segmentos, permitindo a análise simultânea de cada segmento de legenda traduzido em relação às características do tradutor, ao comportamento de processamento cognitivo, à atenção do público e aos resultados da tradução. A base de dados integrada final compreendia 216 sessões completas de tradução e 3.168 observações de participante–texto–segmento, fornecendo a base empírica para as análises processo-produto subsequentes.
Triagem de participantes e perfilamento de fundo
A amostra foi composta por 72 estudantes de Letras Inglês recrutados em uma universidade pública no sul da China, distribuídos igualmente entre o segundo, terceiro e quarto ano do ensino de graduação (24 participantes por grupo anual). Todos os participantes eram falantes nativos de chinês que recebiam instrução formal em escrita e tradução em inglês. Para garantir comparabilidade dentro da população de tradutores em formação, foram excluídos indivíduos que tivessem residido em um país de língua inglesa por mais de 6 meses ou que possuíssem certificação profissional em tradução. Os participantes não foram estratificados em grupos experimentais separados de acordo com experiência em tradução, familiaridade cultural ou proficiência na segunda língua. Em vez disso, o nível acadêmico, pontuações recentes em testes de proficiência em inglês, disciplinas prévias de tradução, grau de familiaridade autoavaliado com temas culturais relacionados à China e o engajamento médio semanal em prática bilíngue foram registrados e incluídos como covariáveis no nível dos participantes nos modelos estatísticos. Essa explicação também resolve a inconsistência no número de participantes levantada durante a revisão por pares: tanto o manuscrito quanto o conjunto de dados de replicação incluem 72 participantes, 216 sessões de tarefas e 3.168 observações no nível de segmento.
Seleção do texto-fonte e construção da tarefa
Os materiais de tradução consistiram em três textos narrativos contemporâneos focados na China, desenvolvidos especificamente para este estudo, com o objetivo de refletir o discurso público autêntico e evitar a reprodução de materiais protegidos por direitos autorais. Cada texto continha entre 205 e 225 caracteres chineses, mas diferia sistematicamente em suas características internas. O Texto A apresenta uma narrativa sobre a viagem de retorno para casa durante o Festival da Primavera, com carga cultural moderada e sintaxe relativamente simples. O Texto B relata uma lembrança do Festival do Barco do Dragão e contém maior densidade de expressões específicas da cultura e conhecimento contextual implícito. O Texto C descreve uma narrativa sobre transmissões ao vivo e comércio eletrônico no meio rural, caracterizada por linguagem avaliativa densa e posicionamento narrativo condensado.
Os textos foram segmentados sistematicamente utilizando limites de cláusulas, seguidos por limites de unidades de significado, resultando em 44 unidades analisáveis ao longo das três tarefas de tradução (Tabela 1). Antes da codificação formal, um manual de codificação definiu carga cultural, densidade avaliativa e compressão narrativa utilizando escalas ordinais de 1 a 5. Um estudo piloto envolvendo 12 estudantes que não participaram do experimento principal confirmou a calibração pretendida de dificuldade, a clareza das instruções da tarefa e a estabilidade dos limites dos segmentos para o alinhamento de batidas de tecla.
Construção do corpus auxiliar e mapeamento de saliência
Para identificar pistas narrativas de destaque público, um corpus auxiliar de danmu foi compilado a partir de 24 vídeos do Bilibili publicados entre janeiro de 2023 e dezembro de 2025. Os vídeos foram incluídos apenas se corresponderem a um dos três domínios semânticos representados nos textos fonte, tiverem acumulado mais de 50.000 visualizações, apresentarem interação densa de danmu e permitirem a exportação e a associação temática de comentários sincronizados no tempo. Após a remoção de duplicatas e a filtragem de emojis, marcadores onomatopaicos e fragmentos irrelevantes, o corpus final continha 18.642 comentários.
As palavras-chave foram padronizadas e agrupadas utilizando âncoras de palavras-chave relacionadas ao texto-fonte. Cada segmento do texto-fonte foi então atribuído a uma pontuação contínua de saliência danmu com base em uma composição ponderada da frequência normalizada do agrupamento de palavras-chave, concentração de comentários dentro do agrupamento temático correspondente e intensidade avaliativa média. Este procedimento permite comparações entre o esforço de processamento do tradutor e a saliência do público no nível do agrupamento semântico, em vez de por meio de correspondência lexical direta. Como o danmu reflete as respostas do público a vídeos online e não à tarefa experimental de tradução em si, a saliência danmu é interpretada como um indicador externo de engajamento do público, e não como evidência direta da dificuldade linguística de um segmento-fonte.
Procedimento experimental e captura de dados
As sessões de tradução foram conduzidas individualmente em um laboratório de informática controlado, sob condições padronizadas de hardware, software e acesso à internet (Figura 2). Após uma orientação de cinco minutos enfatizando a produção de um inglês legível para um público internacional, os participantes realizaram um aquecimento de digitação em inglês com duração de três minutos, com o objetivo de minimizar os efeitos da adaptação ao teclado. As três tarefas de tradução foram aplicadas sequencialmente utilizando o Translog-II, com a ordem das tarefas balanceada segundo um delineamento em quadrado latino, de modo a distribuir uniformemente entre os participantes os possíveis efeitos de fadiga e de ordem. Foi alocado aos participantes um tempo máximo de 20 minutos por texto, com intervalos de descanso de cinco minutos entre eles.
Embora o dicionário bilíngue embutido fosse permitido, sistemas de tradução automática e mecanismos de busca externos foram proibidos. Todos os pressionamentos de teclas, pausas e movimentos do cursor foram registrados automaticamente e complementados por gravações síncronas da tela para verificar episódios de revisão não lineares. Após a conclusão de cada tarefa, os participantes preencheram uma avaliação subjetiva de dificuldade utilizada exclusivamente para auxiliar na interpretação de casos limítrofes de codificação.
Medição de processos e codificação de variáveis
Os registros de teclas pressionadas foram alinhados com a estrutura predefinida dos segmentos. Um episódio de alinhamento iniciou-se com a primeira tecla pressionada no idioma-alvo correspondente a um segmento e terminou quando o participante avançou definitivamente para o próximo segmento. Revisões sobrepostas foram reassinaladas utilizando registros cronometrados de rastreamento do cursor.
O comportamento de tomada de decisão foi quantificado utilizando cinco indicadores: duração da primeira pausa antes da tradução do segmento inicial, duração média das pausas dentro dos segmentos, frequência de pausas superiores a dois segundos, número de consultas ao dicionário e contagem de interrupções baseadas no cursor, indicando desvios do rascunho linear (Tabela 2). O comportamento de revisão foi classificado em duas dimensões: tempo e função. O critério temporal distinguiu revisões locais imediatas de revisões tardias realizadas após o avanço do rascunho para além do segmento atual. A codificação funcional classificou as revisões como revisões superficiais (correções em nível de forma sem mudança semântica), revisões de significado (modificações lexicais ou sintáticas), revisões em nível de discurso (ajustes nas relações entre orações ou na coerência) e revisões de adaptação cultural (reformulações orientadas para o público-alvo). Dois codificadores treinados analisaram independentemente cada episódio de revisão antes da mediação, atribuindo uma única categoria funcional primária a cada evento. A confiabilidade entre avaliadores foi elevada em todas as medidas codificadas. O kappa de Cohen indicou concordância substancial na codificação categórica das funções de revisão (ĸ = 0.84, p < 0,001). Para as variáveis ordinais em nível textual, os coeficientes de correlação intraclasse (CCI, modelo misto de dois fatores, acordo absoluto) demonstraram alta confiabilidade para carga cultural (CCI = 0,86), densidade avaliativa (CCI = 0,78) e compressão narrativa (CCI = 0,82). Quaisquer discrepâncias iniciais na codificação foram posteriormente resolvidas mediante mediação conjunta.
Avaliação da qualidade da tradução
A qualidade da tradução foi avaliada independentemente dos dados de processo por dois avaliadores com formação em nível de doutorado e ampla experiência no ensino de tradução. Sem conhecimento das identidades dos participantes e das medidas de processo, os avaliadores aplicaram uma rubrica de 100 pontos, distribuída igualmente em cinco dimensões: precisão semântica, fluência linguística, coerência narrativa, adequação cultural e adequação de registro (Tabela 3). Discrepâncias de pontuação superiores a oito pontos acionavam uma revisão conjunta e uma nova pontuação por consenso, sendo a média adjudicada utilizada como pontuação final de qualidade da tradução. Os registros de avaliação pré-adjudicação foram mantidos para facilitar a divulgação transparente da confiabilidade entre avaliadores nos materiais de replicação.
Modelagem estatística
As análises prosseguiram em três etapas sequenciais. Primeiro, foram calculadas estatísticas descritivas para resumir todas as variáveis entre os grupos etários e os tipos de texto. Segundo, o esforço de processamento em nível de segmento foi analisado por meio de modelos de regressão de efeitos mistos para levar em conta a estrutura aninhada dos segmentos dentro dos textos e as observações repetidas de participantes individuais. Variáveis dependentes, incluindo a duração da primeira pausa e a frequência de revisão, foram modeladas como funções da carga cultural, densidade avaliativa, compressão narrativa e saliência de danmu, controlando o nível de proficiência dos participantes. Foram incluídas correlações entre preditores, diagnósticos de inflação de variância, intervalos de confiança de 95%, estimativas de tamanho de efeito e índices de ajuste do modelo para melhorar a transparência estatística.
Por fim, a qualidade da tradução foi modelada para avaliar as contribuições preditivas do momento da revisão e da função da revisão em relação à frequência geral de revisão. A sobreposição entre os segmentos salientes de danmu e os segmentos de tradução de alto esforço foi avaliada utilizando o quinto superior de cada distribuição, um índice composto padronizado de esforço e uma análise de sobreposição ao acaso. Nenhuma análise fatorial exploratória ou modelagem de equações estruturais foi realizada. Assim, as figuras apresentadas são fornecidas apenas como resumos conceituais, descritivos ou baseados em regressão.
Resultados
Perfil geral das sessões de tradução
Todos os 72 participantes concluíram as três tarefas de tradução sob condições experimentais padronizadas, resultando em 216 sessões completas de tradução. Após o alinhamento dos segmentos, o conjunto de dados analítico final compreendeu 3.168 observações de participante-texto-segmento. O tempo médio de conclusão da tarefa na amostra foi de 998,4 s por texto, com diferenças claras entre os grupos por ano e os textos fonte (Tabela 4; Figura 3). Assim, tanto o manuscrito quanto os dados complementares apoiam consistentemente um tamanho amostral de n = 72 participantes; quaisquer figuras que resumam subconjuntos devem identificar explicitamente esses subconjuntos.
Estudantes do quarto ano realizaram as tarefas de tradução mais rapidamente e com menos interrupções do que estudantes do segundo ano. Essa diferença foi além da velocidade de processamento. O grupo do quarto ano também apresentou durações médias menores da primeira pausa, menos pausas longas e um número total menor de revisões, ao mesmo tempo em que alcançou as pontuações mais altas de qualidade da tradução. Em contraste, estudantes do segundo ano produziram o maior número de revisões, sendo a maioria modificações superficiais e correções locais imediatas. Estudantes avançados demonstraram uma proporção maior de revisões tardias e revisões de adaptação cultural, indicando que um desempenho superior em tradução estava associado a estratégias seletivas de revisão, e não a um volume maior de revisões.
As diferenças entre os três textos fonte foram igualmente acentuadas. O Texto A gerou os menores tempos de conclusão, o menor número de pausas longas e a menor densidade de revisão. Os Textos B e C impuseram maiores demandas de processamento, embora por meio de mecanismos diferentes. O Texto B provocou o maior número de eventos de revisão relacionados à cultura, enquanto o Texto C produziu a maior frequência de revisões em nível discursivo e a maior duração média das pausas dentro dos segmentos. Assim, a origem da dificuldade de processamento diferiu entre os textos. No Texto B, a dificuldade concentrou-se em referências ligadas à cultura e pressupostos contextuais implícitos, enquanto no Texto C, estava principalmente associada à compressão narrativa e ao posicionamento avaliativo.
Uma análise de variância unidirecional confirmou diferenças significativas entre os grupos de anos na qualidade total da tradução, F (2, 69) = 31,84, p < 0,001, com um tamanho de efeito grande (η2 ≈ 0,48 com base nas médias por participante). Comparações post hoc mostraram que estudantes do quarto ano obtiveram pontuações significativamente mais altas do que estudantes do terceiro ano, que por sua vez superaram os estudantes do segundo ano. O mesmo padrão foi observado para a duração da primeira pausa, frequência de pausas longas e a proporção de revisão tardia. Em conjunto, esses achados preliminares estabelecem dois pontos importantes para as análises subsequentes. Primeiro, os três textos-fonte diferiram em dificuldade de processamento e não apenas em conteúdo temático. Segundo, uma qualidade de tradução mais alta esteve associada a uma reorganização dos processos de tradução e não a uma simples redução no esforço de processamento.
Efeitos da saliência textual na tomada de decisão e no comportamento de revisão
Para determinar se propriedades textuais em nível de segmento prediziam o esforço de processamento, foram estimados modelos de efeitos mistos para a duração da primeira pausa, frequência de pausas longas, densidade total de revisões e densidade de revisões tardias. A carga cultural, densidade avaliativa, compressão narrativa e saliência do danmu foram incluídas como efeitos fixos, com participante e segmento incluídos como interceptos aleatórios (Tabela 5; Figura 4). A seleção de preditores confirmou a ausência de multicolinearidade problemática, com todos os valores do Fator de Inflação da Variância (VIF) bem abaixo do limite conservador de 2,5 (VIF máximo = 1,45). Para avaliar o ajuste do modelo e a proporção da variância explicada, foram calculados os valores de R2 marginal e condicional para todos os modelos de efeitos mistos (R2 marginal variando de 0,08 a 0,19; R2 condicional variando de 0,46 a 0,64). Os componentes completos da variância para os efeitos aleatórios (interceptos de participante e segmento) e os índices correspondentes de ajuste do modelo estão detalhados na Tabela 5. As estimativas dos coeficientes são interpretadas juntamente com seus intervalos de confiança de 95%, e não apenas pelos valores de p.
A carga cultural exibiu o efeito mais forte e mais consistente entre os modelos. No modelo de primeira pausa, cada aumento de uma unidade no escore de carga cultural foi associado a um aumento de 0,91 s na duração da primeira pausa (b = 0,91, SE = 0,12, IC 95% [0,67, 1,15], p < 0,001). A carga cultural também aumentou significativamente a frequência de pausas longas (b = 0,19, SE = 0,04, IC 95% [0,11, 0,27], p < 0,001) e a densidade total de revisões (b = 0,27, SE = 0,06, IC 95% [0,15, 0,39], p < 0,001). Assim, segmentos com carga cultural não apenas atrasaram o processamento inicial, mas também aumentaram a probabilidade de reformulação subsequente.
A compressão narrativa demonstrou um padrão de efeitos igualmente robusto, mas distinto. Foi um forte preditor da revisão em nível discursivo (b = 0.31, SE = 0.07, IC 95% [0,17, 0,45], p < ,001) e aumentou significativamente a duração média das pausas dentro dos segmentos (b = 0,58, SE = 0,14, IC 95% [0,31, 0,85], p < ,001). Em termos práticos, segmentos que condensavam grandes quantidades de informações de fundo em extensões textuais breves tinham menor probabilidade de provocar substituição léxica imediata e maior probabilidade de exigir uma reconsideração estrutural mais ampla.
A densidade avaliativa também contribuiu significativamente, embora seu efeito principal tenha sido na revisão tardia, e não na latência da decisão inicial. No modelo de revisão tardia, a densidade avaliativa apresentou um coeficiente positivo (b = 0.23, SE = 0.05, IC 95% [0.13, 0.33], p < .001). Seu efeito na duração da primeira pausa foi comparativamente modesto (b = 0.34, SE = 0.13, IC 95% [0.09, 0.59], p = 0.010). Esses achados sugerem que os indicadores avaliativos nem sempre foram reconhecidos como gargalos no processamento durante a tradução inicial. Em vez disso, eles frequentemente se tornaram problemáticos apenas após a produção de um rascunho inicial, levando os tradutores a rever questões de postura, tom ou adequação narrativa.
A saliência do danmu manteve-se como um preditor significativo após o controle das variáveis internas ao texto. Ela predisse significativamente tanto a duração da primeira pausa (b = 0,36, SE = 0,14, IC 95% [0,09, 0,63], p = 0,011) quanto a densidade total de revisão (b = 0,17, SE = 0,06, IC 95% [0,05, 0,29], p = 0,006). Embora seu tamanho de efeito tenha sido menor do que os da carga cultural e da compressão narrativa, sua contribuição consistente sugere que segmentos que atraem maior atenção pública no corpus de danmu também tendem a exigir maior esforço de processamento durante a tradução. Esse achado é interpretado como evidência convergente de saliência semântica, e não como evidência de que a frequência de danmu cause diretamente dificuldade na tradução.
Comportamento na revisão e qualidade da tradução
As análises subsequentes examinaram se a qualidade da tradução era melhor explicada pela quantidade total de revisões ou por suas características temporais e funcionais. O modelo de qualidade (Tabela 5) produziu um padrão claro de resultados. O número total de revisões não previu significativamente a qualidade da tradução (b = 0,04, IC 95% [-0,06, 0,14], p = 0,412), enquanto tanto o momento das revisões quanto a função das revisões foram preditores significativos. Especificamente, a proporção de revisões tardias (b = 1,12, IC 95% [0,39, 1,85], p = 0,003), as revisões em nível discursivo (b = 1,76, IC 95% [0,96, 2,56], p < 0,001) e as revisões de adaptação cultural (b = 2,04, IC 95% [1,14, 2,94], p < 0,001) estiveram todas positivamente associadas à qualidade da tradução. Em contraste, as revisões superficiais exibiram uma pequena, mas estatisticamente significativa, associação negativa (b = -0,63, IC 95% [-1,18, -0,08], p = 0,028).
Esses resultados indicam que a quantidade de revisões, por si só, não consegue distinguir uma reformulação produtiva de uma redação instável (Figura 5). A análise qualitativa dos roteiros de tradução apoiou essa interpretação. Em traduções com pontuações mais baixas, as revisões tendiam a se concentrar em substituições lexicais locais e correções gramaticais, sem resolver discrepâncias mais profundas entre os indicadores narrativos chineses e a estrutura retórica em inglês. Em traduções com pontuações mais altas, revisões tardias frequentemente envolviam a reorganização da estrutura da informação, a introdução de explicitação seletiva ou o ajuste da linguagem avaliativa para melhorar a acessibilidade a um público internacional. Comentários representativos traduzidos de danmu — incluindo “essa expressão é muito chinesa”, “o contexto precisa ser explicado” e “públicos estrangeiros podem não entender essa referência” — ilustram os tipos de preocupações culturais relevantes do público associadas aos respectivos agrupamentos de segmentos. Esses exemplos são apresentados apenas para facilitar a interpretação e não devem ser interpretados como evidência das intenções dos participantes.
Sobreposição entre a saliência do danmu e os gargalos de tradução
A análise final examinou se segmentos publicamente salientes no corpus de danmu coincidiam com aqueles que geraram o maior esforço de processamento durante a tradução. Um índice composto de esforço foi calculado para cada segmento por meio da padronização e soma da duração da primeira pausa, da frequência de pausas longas e da densidade de revisões. Os 20% superiores dos segmentos com base nesse índice composto de esforço foram então comparados aos 20% superiores classificados pela saliência do danmu.
A sobreposição foi substancial: seis dos nove segmentos com maior esforço também apareceram entre os nove segmentos mais salientes em danmu, correspondendo a uma taxa de sobreposição de 66,7%. Como a comparação do quinto superior envolveu apenas nove segmentos, o intervalo de confiança de Wilson foi relativamente amplo (IC 95% aproximadamente 35,4%–87,9%). Apesar disso, uma análise exata de sobreposição ao acaso indicou que uma sobreposição de seis ou mais segmentos seria improvável sob alocação aleatória (p ≈ ,001). No nível dos segmentos, a saliência do danmu correlacionou-se positivamente com o índice composto de esforço (rho de Spearman = 0,41, p = 0,006). A maioria dos segmentos sobrepostos ocorreu nos Textos B e C e concentrou-se em referências culturalmente enraizadas, empreendedorismo digital e posicionamento avaliativo. Esses achados sugerem que o discurso público atua como um indicador externo dos pontos em que o significado narrativo se torna particularmente saliente, embora a relação permaneça correlacional e não causal.
Em conjunto, esses achados demonstram que o esforço de processamento na tradução de narrativas focadas na China é específico por segmento e moldado principalmente pela carga cultural, compressão narrativa e densidade avaliativa. A qualidade da tradução depende não do volume total de revisão, mas de estratégias de revisão diferidas, sensíveis ao discurso e orientadas culturalmente. Por fim, o alinhamento observado entre segmentos de tradução de alto esforço e pontos narrativos com alta saliência de danmu apoia uma relação associativa entre a saliência do público e o esforço de processamento do tradutor, sem implicar que a própria saliência de danmu cause dificuldade na tradução.
DISPONIBILIDADE DE DADOS:
Todos os dados brutos, arquivos de registro de pressionamentos de teclas, observações processadas em nível de segmento, observações em nível de sessão, metadados do vídeo danmu e os primeiros 5.000 comentários danmu exibidos são fornecidos na pasta do conjunto de dados de replicação. O arquivo completo de comentários danmu contém 18.642 comentários e está depositado junto com o pacote do conjunto de dados. O conjunto de dados pode ser acessado por meio do repositório Zenodo em https://doi.org/10.5281/zenodo.19289665.
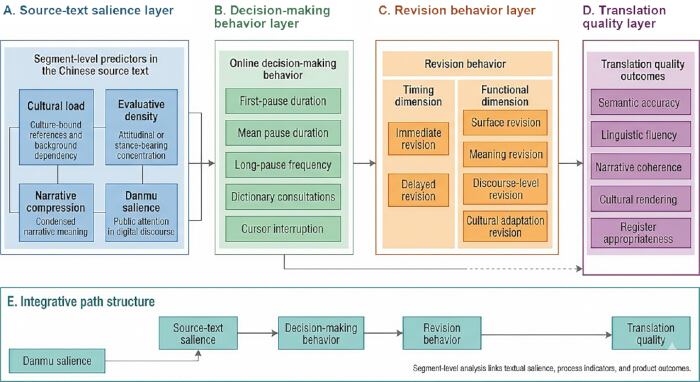
Figura 1: Estrutura conceitual do estudo. (A) Preditores textuais em nível de segmento, incluindo carga cultural, densidade avaliativa, compressão narrativa e saliência danmu. (B) Indicadores de processo utilizados para operacionalizar o comportamento de tomada de decisão online, incluindo duração da primeira pausa, duração média das pausas, frequência de pausas longas, consultas a dicionários e interrupções do cursor. (C) Classificação bidimensional do comportamento de revisão de acordo com o momento da revisão e sua função. (D) Cinco dimensões utilizadas para avaliar a qualidade da tradução: precisão semântica, fluência linguística, coerência narrativa, representação cultural e adequação de registro. (E) Estrutura analítica geral mostrando as relações entre a saliência do texto-fonte, o comportamento de tomada de decisão, o comportamento de revisão e a qualidade da tradução, com a saliência danmu servindo como indicador externo da proeminência semântica do público. Nenhuma análise fatorial exploratória (EFA) nem modelagem por equações estruturais (SEM) foi realizada ou apresentada neste estudo. Clique aqui para visualizar uma versão maior desta figura.
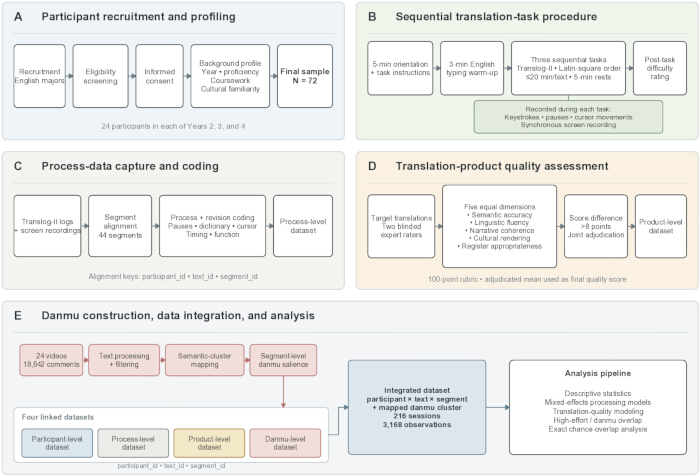
Figura 2: Fluxo de coleta e alinhamento de dados. (A) Recrutamento dos participantes, triagem de elegibilidade, consentimento informado e coleta de informações de fundo. (B) Aplicação das três tarefas de tradução no Translog-II sob condições experimentais padronizadas. (C) Coleta de dados de processo, incluindo pressionamentos de teclas, pausas, movimentos do cursor, episódios de revisão e gravações sincronizadas da tela. (D) Avaliação cega por especialistas dos produtos de tradução, seguida de mediação das discrepâncias nas pontuações. (E) Construção do corpus auxiliar danmu e seu alinhamento com conjuntos de dados em nível de participante, texto, segmento, processo e produto, para gerar o conjunto de dados integrado final utilizado nas análises inferenciais. Clique aqui para visualizar uma versão maior desta figura.
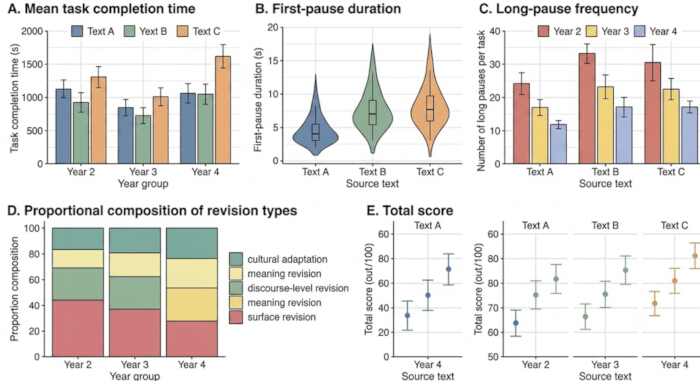
Figura 3: Distribuição das medidas de processo e produto entre os grupos por ano e textos fonte. (A) Tempo médio de conclusão da tarefa por texto fonte e grupo por ano. (B) Distribuição da duração da primeira pausa nos três textos fonte. (C) Frequência de pausas longas por texto fonte e grupo por ano. (D) Distribuição proporcional das categorias de revisão entre os grupos por ano, incluindo revisões superficiais, revisões de significado, revisões em nível discursivo e revisões de adaptação cultural. (E) Pontuações totais de qualidade da tradução por grupo por ano para cada texto fonte. Em conjunto, os painéis mostram que níveis mais avançados de escolaridade estão associados a menos interrupções no processamento, estratégias de revisão mais seletivas e maior qualidade na tradução, enquanto os Textos B e C impõem demandas de processamento maiores do que o Texto A. Clique aqui para visualizar uma versão maior desta figura.
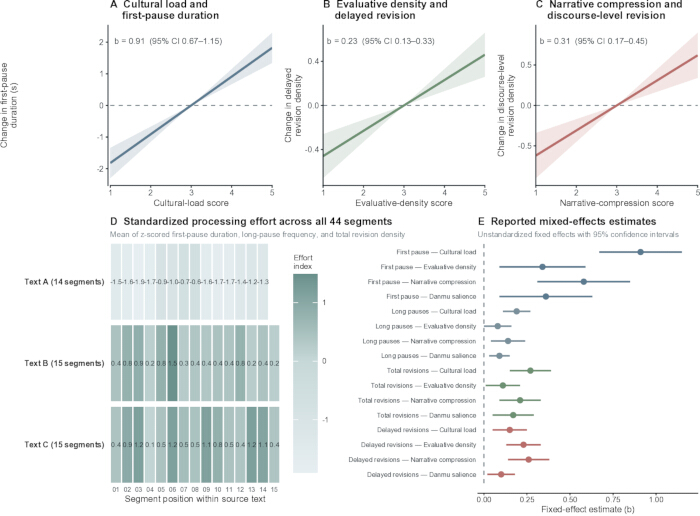
Figura 4: Efeitos da saliência textual no nível do segmento sobre o comportamento do processo de tradução. (A) Efeito marginal ajustado da carga cultural sobre a duração da primeira pausa. (B) Efeito marginal ajustado da densidade avaliativa sobre a densidade de revisão tardia. (C) Efeito marginal ajustado da compressão narrativa sobre a densidade de revisão em nível discursivo. (D) Mapa térmico do índice padronizado de esforço de processamento em todos os segmentos do texto-fonte, agrupados por texto-fonte. (E) Coeficientes padronizados de efeitos fixos estimados a partir dos modelos de regressão de efeitos mistos. A figura demonstra que diferentes características textuais ativam vias de processamento distintas, sendo que carga cultural, densidade avaliativa e compressão narrativa contribuem para hesitação e revisão por meio de mecanismos parcialmente diferentes. Clique aqui para visualizar uma versão maior desta figura.
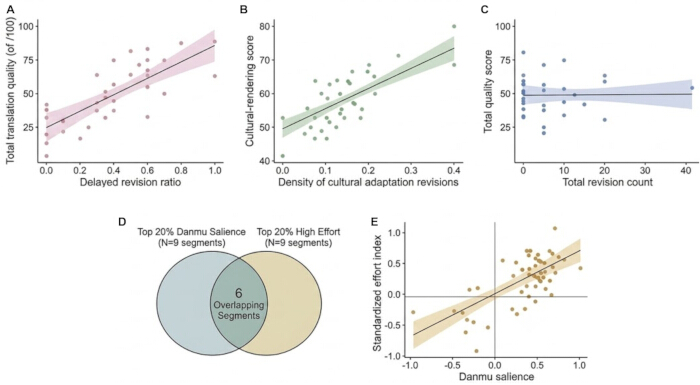
Figura 5: Relações entre o processo de tradução, a qualidade da tradução e a saliência dos danmu. (A) Associação entre a proporção de revisão tardia e a pontuação total de qualidade da tradução. (B) Relação entre revisões para adaptação cultural e a pontuação de representação cultural. (C) Associação entre o número total de revisões e a qualidade geral da tradução, demonstrando o valor preditivo limitado da quantidade de revisões isoladamente. (D) Sobreposição entre os 20% superiores dos segmentos com maior saliência de danmu e os 20% superiores dos segmentos de tradução de alto esforço. (E) Associação no nível do segmento entre a saliência dos danmu e o índice padronizado de esforço de processamento. Em conjunto, os painéis mostram que o desempenho bem-sucedido na tradução está associado a revisões estrategicamente cronometradas e direcionadas funcionalmente, e não apenas ao volume de revisões, e que segmentos narrativos publicamente salientes tendem também a coincidir com gargalos na tradução. Clique aqui para visualizar uma versão maior desta figura.
| ID do texto | Tópico narrativo | Caracteres chineses | Número de segmentos | Pontuação de carga cultural (1–5) | Pontuação de densidade avaliativa (1–5) | Pontuação de compressão narrativa (1–5) | Dificuldade prevista | Nota de validação |
| Texto A | Narrativa sobre o retorno para casa no Festival da Primavera | 212 | 14 | 3 | 2 | 3 | Moderada | Testado em estudo piloto com 12 estudantes não participantes |
| Texto B | Narrativa de memória sobre o Festival do Barco-Dragão | 219 | 15 | 5 | 3 | 4 | Alta | Testado em estudo piloto com 12 estudantes não participantes |
| Texto C | Narrativa sobre transmissão ao vivo no campo e desenvolvimento da cidade natal | 223 | 15 | 4 | 5 | 4 | Alta | Testado em estudo piloto com 12 estudantes não participantes |
Tabela 1: Perfil do texto-fonte e estrutura dos segmentos.
| Variável | Nível | Definição operacional | Unidade de medida |
| Duração da primeira pausa | Segmento | Tempo entre o início do segmento e a primeira tecla relevante no idioma-alvo | Segundos |
| Duração média das pausas dentro do segmento | Segmento | Duração média de todas as pausas ocorridas dentro do segmento | Segundos |
| Frequência de pausas longas | Segmento | Número de pausas com duração superior a 2 segundos | Contagem |
| Consultas ao dicionário | Segmento | Número de ativações da janela de dicionário durante o processamento do segmento | Contagem |
| Interrupções com o cursor | Segmento | Número de desvios baseados no cursor em relação à redação linear antes da conclusão estável | Contagem |
| Revisão imediata | Segmento | Revisão realizada antes de a redação avançar para além da área de texto local atual | Contagem / densidade |
| Revisão tardia | Segmento | Revisão realizada após a redação ter avançado para uma área de texto posterior | Contagem / densidade |
| Revisão de superfície | Função de revisão | Correção em nível formal sem alteração semântica | Contagem / densidade |
| Revisão de significado | Função de revisão | Alteração léxica ou sintática que afeta a expressão do significado | Contagem / densidade |
| Revisão em nível de discurso | Função de revisão | Ajuste nas relações entre orações, coerência ou ordem da informação | Contagem / densidade |
| Revisão de adaptação cultural | Função de revisão | Reformulação ou explicitação orientada ao público-alvo de significados ligados à cultura | Contagem / densidade |
| Índice composto de esforço | Segmento | Composição padronizada da duração da primeira pausa, frequência de pausas longas e densidade de revisão | z-score |
| SalIÊncia do Danmu | Segmento / agrupamento semântico | Indicador ponderado baseado na frequência normalizada de agrupamentos de palavras-chave, concentração de comentários e intensidade avaliativa | Pontuação contínua |
Tabela 2: Definições operacionais das variáveis do processo.
| Precisão semântica | Faixa de pontuação | Foco da pontuação |
| Precisão semântica | 1-20 | Fidelidade ao significado da fonte, precisão do conteúdo transferido e ausência de distorções significativas |
| Fluência linguística | 1-20 | Gramaticalidade, naturalidade, uso idiomático e legibilidade em nível de frase |
| Coesão narrativa | 1-20 | Fluxo de informação, ligação entre orações, progressão e estabilidade textual |
| Representação cultural | 1-20 | Tratamento de referências ligadas à cultura, explicitação, enquadramento e acessibilidade interpretativa |
| Adequação de registro | 1-20 | Conformidade com o público-alvo, adequação estilística e controle do tom |
Tabela 3: Rubrica de avaliação da qualidade da tradução.
| Seção | Variável | Ano 2 (n = 24), média ± DP | Ano 3 (n = 24), média ± DP | Ano 4 (n = 24), média ± DP |
| Perfil da sessão por participante | Tempo de conclusão da tarefa (seg) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| Perfil da sessão por participante | Duração média da primeira pausa (seg) | 7,09 ± 0,50 | 6,65 ± 0,40 | 6,38 ± 0,41 |
| Perfil da sessão por participante | Frequência de pausas longas por tarefa | 21,04 ± 0,32 | 18,47 ± 0,30 | 16,31 ± 0,19 |
| Perfil da sessão por participante | Número total de revisões por tarefa | 28,65 ± 2,87 | 26,24 ± 2,63 | 24,59 ± 2,42 |
| Configuração da revisão | Razão de revisão tardia | 0,45 ± 0,01 | 0,54 ± 0,01 | 0,63 ± 0,01 |
| Configuração da revisão | Razão de revisão em nível discursivo | 0,37 ± 0,01 | 0,40 ± 0,01 | 0,45 ± 0,01 |
| Configuração da revisão | Razão de revisão para adaptação cultural | 0,38 ± 0,01 | 0,42 ± 0,00 | 0,48 ± 0,01 |
| Configuração da revisão | Razão de revisão superficial | 0,04 ± 0,00 | 0,02 ± 0,00 | 0,00 ± 0,00 |
| Qualidade do produto | Pontuação total de qualidade | 77,82 ± 4,65 | 84,03 ± 4,44 | 88,27 ± 4,56 |
| Qualidade do produto | Pontuação de representação cultural | 77,73 ± 4,49 | 83,95 ± 4,85 | 88,18 ± 4,86 |
Tabela 4: Estatísticas descritivas para variáveis de processo e de produto.
| Variável resultado | Preditor | b | EP | IC 95% | t/z | p |
| Duração da primeira pausa | Carga cultural | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| Duração da primeira pausa | Densidade avaliativa | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| Duração da primeira pausa | Compressão narrativa | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| Duração da primeira pausa | Salência do Danmu | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| Frequência de pausas longas | Carga cultural | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| Frequência de pausas longas | Densidade avaliativa | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| Frequência de pausas longas | Compressão narrativa | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| Frequência de pausas longas | Salência do Danmu | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| Densidade total de revisões | Carga cultural | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| Densidade total de revisões | Densidade avaliativa | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| Densidade total de revisões | Compressão narrativa | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| Densidade total de revisões | Salência do Danmu | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| Densidade de revisões tardias | Carga cultural | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| Densidade de revisões tardias | Densidade avaliativa | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| Densidade de revisões tardias | Compressão narrativa | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| Densidade de revisões tardias | Salência do Danmu | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| Pontuação total de qualidade | Revisões totais | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| Pontuação total de qualidade | Razão de revisões tardias | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| Pontuação total de qualidade | Revisões em nível discursivo | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| Pontuação total de qualidade | Revisões de adaptação cultural | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| Pontuação total de qualidade | Revisões superficiais | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| Pontuação total de qualidade | Grupo do ano | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
Tabela 5: Modelos de efeitos mistos prevendo o comportamento do processo em nível de segmento e a qualidade da tradução.
Discussão
Os resultados atuais demonstram que a dificuldade na tradução do chinês para o inglês de narrativas centradas na China não está uniformemente distribuída ao longo de um texto. Em vez disso, concentra-se em segmentos onde referências culturais, posições avaliativas e significados narrativos condensados convergem. Isso apoia uma visão baseada no processo, e não na deficiência vocabular, da dificuldade de tradução. A pesquisa empírica sobre o processo de tradução enfatiza que a tradução é uma atividade organizada no tempo, na qual hesitação, orientação e produção estão distribuídas de forma desigual19. A concentração de esforço observada neste estudo reflete como segmentos específicos exercem maior pressão interpretativa, interrompendo a redação linear de forma mais acentuada do que outros. O teste de hipóteses pode ser resumido da seguinte maneira: H1 foi confirmada, pois a carga cultural aumentou a hesitação inicial e a densidade de revisão; H2 foi refinada, pois a densidade avaliativa e a compressão narrativa atuaram por meio de diferentes vias de revisão; H3 foi confirmada, pois o momento e a função da revisão predisseram a qualidade com mais força do que o número total de revisões; e H4 foi confirmada como uma sobreposição associativa entre a saliência do danmu e os segmentos de alto esforço, e não como uma relação causal.
Em relação ao comportamento de revisão, os dados revelam que o número total de revisões não prediz a qualidade da tradução; ao contrário, as revisões adiadas, em nível discursivo e de adaptação cultural são os principais fatores responsáveis por um desempenho superior. Essa distinção sugere que a revisão é produtiva apenas quando realizada como uma reavaliação estruturada, e não como uma repetida correção local. Em consonância com pesquisas de rastreamento ocular e registro de digitação que indicam que tradutores novatos alocam esforços de maneira diferente quando as tarefas se tornam difíceis, os alunos mais proficientes neste estudo não foram meramente mais ativos7. Eles interromperam seletivamente soluções provisórias, reavaliaram-nas em estágios posteriores e direcionaram as revisões para adequação narrativa ou cultural. Consequentemente, as pontuações do produto final são insuficientes para explicar o desempenho do tradutor, já que pontuações finais comparáveis muitas vezes emergem de trajetórias processuais radicalmente diferentes9.
Esse fenômeno é melhor compreendido à luz da conversão de esforço. Em traduções com pontuações mais baixas, o esforço cognitivo permaneceu preso ao nível local — os alunos faziam pausas, substituíam itens lexicais ou ajustavam artigos, mas não conseguiam resolver discrepâncias mais profundas entre as implicações do texto-fonte e a estruturação do texto-alvo. Em contrapartida, os textos com pontuações mais altas demonstraram um esforço convertido em decisões estruturais que otimizaram o texto para o leitor-alvo. Paralelamente a pesquisas sobre o desempenho de estudantes em pós-edição, esses resultados confirmam que o esforço do processo não é automaticamente benéfico; seu valor depende da conversão em melhorias textuais interpretáveis20.
Além disso, diferentes propriedades textuais ativam mecanismos de processamento distintos. A carga cultural aumentou de forma confiável a hesitação inicial e a densidade de revisão, enquanto a compressão narrativa previu fortemente a revisão em nível discursivo. Essa distinção esclarece por que segmentos difíceis se manifestam de maneira diferente durante o processo de tradução: alguns interrompem o acesso cognitivo na fase inicial de formulação, enquanto outros tornam-se problemáticos apenas durante a manutenção da coerência ao longo de extensões mais amplas do discurso. Em consonância com estudos que mostram que textos difíceis produzem unidades de processamento menores e interrupções mais densas, esses achados enfatizam como significados culturais e avaliativos comprimidos forçam os tradutores a oscilar entre a expressão local e a estruturação narrativa global8.
Uma contribuição metodológica significativa deste estudo é a integração da saliência do danmu como uma camada de discurso do público. A substancial sobreposição entre segmentos de tradução de alto esforço e segmentos com saliência de danmu indica que os gargalos enfrentados pelos estudantes frequentemente coincidem com pontos que atraem atenção acentuada do público na circulação digital. Isso conecta a dificuldade de tradução ao discurso participativo sem confundir os dois constructos. Os comentários em danmu revelam o que os públicos percebem ou contestam na circulação mediada por vídeo, enquanto os registros de teclas digitadas e revisões revelam como os tradutores estudantes processam segmentos semanticamente relacionados do texto-fonte. A interpretação mais plausível é, portanto, uma explicação baseada em estímulos comuns: referências carregadas culturalmente, pressupostos contextuais condensados e posicionamentos avaliativos podem simultaneamente atrair a atenção do público e aumentar a pressão de processamento do tradutor21.
Do ponto de vista pedagógico, essa sobreposição sugere que narrativas centradas na China circulam em contextos nos quais o significado é negociado publicamente e de forma rápida, regido por prioridades conflitantes, como imediatismo, inteligibilidade e alinhamento com o público22. Consequentemente, o treinamento de tradutores deve deixar de encarar a revisão como uma etapa genérica de correção para enfatizar intervenções funcionais e estrategicamente temporais. Os gargalos observados raramente eram causados apenas pela terminologia; surgiam nos pontos em que o significado narrativo dependia de pressupostos culturalmente enraizados, estruturação relacional e acesso seletivo do público. De forma semelhante à disseminação da literatura narrativa étnica chinesa, a transferência dessas narrativas exige ir além da fidelidade lexical para determinar como o significado cultural local deve ser reestruturado para uma circulação global mais ampla23. O método pode ser aplicado no ensino da tradução por meio do uso de registros de digitação, gravações de tela e exemplos de discursos públicos, ajudando os alunos a identificar quando um segmento exige explicitação, reordenação, enquadramento cultural ou ajuste de registro, em vez de simples substituição lexical.
Várias limitações restringem a interpretação desses achados. Primeiro, a saliência do danmu é um indicador baseado em agrupamento semântico do engajamento do público, não uma medida direta da dificuldade linguística, e o presente delineamento correlacional não permite estabelecer causalidade entre saliência pública e esforço de tradução. Estudos futuros poderiam manipular experimentalmente a carga cultural, a densidade avaliativa e a compressão narrativa para testar caminhos causais. Segundo, a amostra limita-se a tradutores em formação de uma única universidade, e a experiência dos participantes, o grau de familiaridade cultural e a proficiência na segunda língua foram controlados estatisticamente, em vez de por meio de amostragem plenamente estratificada. A replicação com tradutores profissionais, estudantes de múltiplas instituições e faixas mais amplas de proficiência fortaleceria a generalização dos resultados. Terceiro, os textos-fonte foram elaborados pelos pesquisadores e testados previamente para calibrar a tarefa, mas estudos futuros deveriam incluir validação adicional com textos públicos autênticos e grupos independentes de elaboração de materiais. Quarto, a codificação da carga cultural, da densidade avaliativa, da compressão narrativa e das funções de revisão depende de definições operacionais transparentes, registros de codificadores independentes e confiabilidade interobservador verificável, juntamente com o arquivo de codificação consensual. Pesquisas futuras também poderiam combinar o registro de digitação com rastreamento ocular, entrevistas retrospectivas, protocolos de pensamento em voz alta ou tarefas de pós-edição para triangular os mecanismos cognitivos subjacentes às decisões de revisão.
Em última análise, este estudo esclarece a base processual do desempenho dos estudantes na tradução do chinês para o inglês de narrativas centradas na China. Ao conectar dados de registro de pressionamento de teclas, avaliação do produto e discurso digital do público, os resultados demonstram que os gargalos na tradução surgem em pontos de significado narrativo carregado publicamente. O fator decisivo na tradução intercultural não é o volume total de revisões, mas a capacidade do tradutor de reconhecer segmentos que exigem reestruturação interpretativa e de atrasar estrategicamente o fechamento até que uma solução estável e apropriada ao público seja formulada.
Divulgações
Os autores têm nada a declarar.
Contribuições dos Autores
Weijia Chen: Conceituação, metodologia, análise formal, investigação, redação do rascunho original.
Chunming Wu: Concepção do estudo, orientação sobre procedimentos de análise formal e tratamento de dados, e revisão e feedback sobre revisões em resposta aos comentários dos revisores.
Agradecimentos
Esta pesquisa foi financiada por duas subvenções da Universidade Normal de Hanshan. Especificamente, constitui um resultado parcial do programa de 2023 de Curso de Graduação de Primeira Classe (Curso Presencial de Primeira Classe) para "Teoria e Prática da Tradução Chinês–Português II" (Número de Aprovação: YHS [2023] 172). Além disso, o estudo foi apoiado pelo Projeto de Qualidade do Ensino e Reforma Pedagógica de 2025, designado como Curso Modelo para Educação Ideológica e Política Baseada em Currículo para "Tradução Chinês–Português" (Número de Aprovação: YHSJ〔2025〕126). Os autores agradecem sinceramente o apoio institucional fornecido para a conclusão desta pesquisa.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Corpus de danmu do Bilibili | Bilibili | 24 vídeos; 18.642 comentários;https://www.bilibili.com | Construção do corpus auxiliar de danmu e cálculo da saliência de segmentos de danmu |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | Limpeza de dados, organização de codificação e gerenciamento preliminar de dados |
| R | Fundação R para Computação Estatística | R 4.3.1;https://www.r-project.org | Modelagem de efeitos mistos, análise de correlação e geração de figuras |
| Software de gravação de tela | Estação de trabalho do laboratório | Utilitário local da estação de trabalho; sem número de catálogo | Verificação de episódios de revisão não lineares e backup dos dados de processo |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | Estatísticas descritivas, ANOVA e análises estatísticas básicas |
| Translog-II | Escola de Negócios de Copenhague / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | Registro de pressionamento de teclas e gravação de pausas, movimentos do cursor e episódios de revisão durante tarefas de tradução |
Referências
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.