Este estudo detalha um fluxo de trabalho reproduzível para extrair características comportamentais e implantar caminhos educacionais ajustados dinamicamente em ambientes virtuais. Os procedimentos apresentados permitem que educadores desenvolvam currículos adaptativos de realidade virtual e implementem rastreamento comportamental em tempo real.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Métodos de Ensino Inteligentes Integrando Realidade Virtual e Algoritmos de Big Data para Aprimorar Plataformas Tradicionais de Educação Cultural
Neste artigo
Resumo
Resumo
Os ambientes convencionais de ensino atuais apresentam elementos interativos limitados, resultando em métricas de engajamento limitadas entre as populações de graduação que estudam patrimônio cultural. Para resolver essas questões, foi desenvolvida uma plataforma inteligente de ensino, integrando um motor de renderização espacial de alta fidelidade em ambientes de realidade virtual com uma arquitetura algorítmica multimodelo. Dentro dessa plataforma, os modelos Transformer e Neural Collaborative Filtering (NCF) processam dados comportamentais para gerar caminhos de aprendizagem personalizados, enquanto uma Deep Q-Network (DQN) ajusta dinamicamente a dificuldade do conteúdo com base no feedback em tempo real. Essa estrutura adaptativa reflete princípios de aprendizagem construtivista, nos quais o conhecimento é ativamente construído por meio da interação com ambientes contextualizados e responsivos, em vez de recebido passivamente por meio de instrução estática. A novidade dessa pesquisa está em integrar um motor de renderização espacial com uma arquitetura algorítmica multimodelo para estabelecer um mecanismo de adaptação comportamental em tempo real. Os resultados experimentais mostram que o grupo experimental que utiliza a plataforma de ensino inteligente proposta possui pontuações de aprendizagem mais altas (grupos baixo/médio/alto são 69/79/93 pontos, respectivamente) e uma taxa de conclusão de tarefas de aprendizagem maior (93%/96%/98%) do que o grupo controle que utiliza o modelo tradicional de ensino. O design da plataforma de ensino inteligente oferece forte interatividade, proporciona caminhos de aprendizagem personalizados para alunos com diversas diferenças individuais e se ajusta dinamicamente durante o processo de aprendizagem. A análise do tempo de resposta indica uma latência média de 0,496 s, garantindo um feedback rápido nas interações. Em última análise, a plataforma proposta demonstra que combinar VR imersiva com algoritmos adaptativos ao comportamento melhora efetivamente tanto o desempenho acadêmico quanto o engajamento em tarefas dos estudantes de graduação na educação cultural tradicional.
Introdução
A educação cultural tradicional desempenha um papel vital na herança e no desenvolvimento da cultura. No entanto, o modelo tradicional atual de educação cultural depende principalmente de formas estáticas como livros didáticos, imagens e vídeos, carecendo de interatividade e imersão, dificultando que os alunos realmente compreendam e experimentem o encanto da cultura. Além disso, os métodos tradicionais de ensino frequentemente adotam um currículo unificado, que não considera totalmente os interesses, habilidades cognitivas e estilos de aprendizagem dos alunos, resultando em baixa eficiência de aprendizagem e dificuldade em estimular o entusiasmo dos alunos pela aprendizagem. Essa limitação está alinhada com a teoria da Zona de Desenvolvimento Proximal (ZDP) de Vygotsky, que enfatiza que a instrução eficaz deve ser adaptada aos níveis cognitivos atuais dos aprendizes e estruturada de acordo com suas trajetórias individuais de desenvolvimento. A literatura existente depende de entradas de dados estáticas para modelagem pedagógica. A integração do rastreamento comportamental espacial contínuo com aprendizado profundo por reforço permanece inexplorada. O mecanismo proposto funde interações multissensoriais com reajuste algorítmico para preencher a lacuna entre caminhos instrucionais fixos e adaptação dinâmica contextual. A plataforma proposta operacionaliza esse princípio ao ajustar dinamicamente a dificuldade do conteúdo e o sequenciamento com base em indicadores comportamentais em tempo real, incorporando assim a teoria pedagógica ao design algorítmico. Os mecanismos de adaptação algorítmica substituem efetivamente a estrutura humana normalmente fornecida por pares mais capazes. Essa modulação contínua da dificuldade da tarefa está alinhada com a Teoria da Carga Cognitiva (CLT), prevenindo sobrecarga cognitiva em aprendizes iniciantes e mantendo o engajamento dentro da zona de desenvolvimento ideal.
Com o desenvolvimento de realidade virtual (VR) e algoritmos de dados, aplicá-los à educação cultural tradicional proporciona aos alunos uma experiência de aprendizagem mais imersiva e interativa 1,2,3,4. Revisões sistemáticas abrangentes de aplicações de realidade virtual imersiva no ensino superior enfatizam ainda mais a importância de alinhar elementos de design com objetivos pedagógicosespecíficos 5.
Muitos estudos tentaram aplicar a tecnologia de RV à educação cultural. Hulusic et al.6 projetaram e desenvolveram um museu virtual escolar, incluindo uma interface de usuário tangível. Por meio de pesquisas participativas dos usuários, foi constatado que o museu é bem projetado e bem desenvolvido, e tem potencial para ser usado como ferramenta de aprendizado e educação em museus, escolas ou de forma independente. Em resposta ao problema da interatividade insuficiente em ambientes de ensino a distância, Mubarok et al.7 desenvolveram um método colaborativo de mapeamento de argumentos baseado na VR para enfrentá-lo. Experimentos mostraram que esse método melhora melhor a expressão oral dos alunos em inglês do que métodos colaborativos de mapeamento argumentativo que não são baseados em VR. Sun et al.8 propuseram uma estratégia de design para um sistema imersivo de VR que combina interação multimodal, gamificação e narrativa para exibir e desenvolver o patrimônio cultural digital. Eles desenvolveram um sistema de realidade virtual imersiva que restaurou os murais de Dunhuang, proporcionando aos usuários uma experiência de aprendizado, interativa e divertida. No entanto, esses estudos ainda enfrentam alguns problemas, como fraca interatividade em cenas de VR, taxas lentas de atualização para conteúdos de aprendizagem e baixa adaptabilidade dos algoritmos personalizados de recomendação, que tornam impossível atender com precisão às necessidades de aprendizagem de diferentes alunos. Além disso, alguns estudos não conseguiram integrar efetivamente o aprendizado profundo e o aprendizado por reforço, limitando as capacidades de ajuste em tempo real das recomendações personalizadas.
Avanços recentes em inteligência artificial impulsionaram tecnologias educacionais. Pesquisas introduzem sistemas adaptativos que aproveitam o aprendizado profundo para reconhecimento de padrões no comportamento do usuário. Metodologias que empregam algoritmos de rastreamento cognitivo mapeiam estados dinâmicos de aquisição de conhecimento. A otimização estrutural em redes neurais eleva a precisão das recomendações dentro de frameworks de aprendizagem inteligente. Agentes inteligentes que integram variáveis ambientais complexas aprimoram respostas instrucionais automatizadas. Essas metodologias dependem de fluxos de dados isolados e análise histórica estática. A plataforma proposta aborda essa limitação fundindo dados de interação espacial com reajustes algorítmicos contínuos para garantir adaptação contextual em tempo real.
Investigações empíricas recentes confirmam que algoritmos de aprendizado profundo melhoram significativamente a precisão preditiva na modelagem de desempenho dos alunos. Ouatik et al.9 implementaram um sistema para prever o sucesso e o fracasso acadêmico dos alunos. Eles usaram informações pessoais dos alunos, avaliações acadêmicas e outros dados, além de métodos de inteligência artificial e mineração de dados educacionais para prever o sucesso acadêmico dos alunos. Para resolver o problema do processamento de dados, a tecnologia de big data (BD) foi usada para distribuir o processamento, reduzindo o tempo de computação sem sacrificar a eficiência algorítmica. O Bhaskaran10 desenvolveu um recomendador de espaço vetorial aprimorado para resolver problemas nos sistemas atuais de recomendação de aprendizagem. Ele acompanha automaticamente os interesses, necessidades e níveis de conhecimento dos aprendizes. Ele classifica e extrai os estilos de aprendizado dos aprendizes do servidor, depois utiliza um algoritmo de filtragem colaborativa aprimorado para calcular semelhanças e produzir uma lista de recomendações melhor. Gupta11 propôs um método baseado em aprendizado profundo que utiliza expressões faciais para detectar o engajamento em tempo real dos alunos online, classifica suas emoções ao longo do processo de aprendizagem analisando as etiquetas faciais dos alunos e ajusta o status de aprendizagem dos alunos com base nos resultados da detecção. No entanto, esses métodos ainda têm certas limitações.
Embora as soluções educacionais existentes em VR ofereçam uma experiência imersiva, elas carecem de capacidades de ajuste dinâmico. Os caminhos de aprendizagem dos alunos frequentemente são fixos, e o conteúdo e a dificuldade não podem ser otimizados em tempo real com base no progresso pessoal e no feedback, resultando em falta de participação. Ao mesmo tempo, algoritmos tradicionais de recomendação personalizada dependem principalmente de dados históricos ou simples tags de interesse e falham em integrar dados multidimensionais, como comportamento de aprendizagem dos alunos, status cognitivo e feedback emocional, para uma análise precisa. A falta de compreensão aprofundada dos processos de aprendizagem dos alunos impede que o sistema de recomendação aborde efetivamente as diferenças individuais, resultando em uma experiência de aprendizagem subótima e resultados subótimos.
Portanto, para enfrentar os problemas de imersão insuficiente e falta de personalização na educação cultural tradicional, é proposta uma plataforma de ensino inteligente. Essa metodologia é diretamente aplicável a cursos de graduação em humanidades que exigem visualização espacial e métricas de ritmo individualizadas. Motores avançados de renderização espacial e tecnologias relacionadas de computação espacial são utilizados para desenvolver cenas de aprendizagem virtual. Ambientes virtuais de aprendizagem concedem autonomia aos alunos para selecionar módulos culturais específicos. O modelo Transformer baseado em atenção neural processa logs de interação com carimbo de tempo para gerar uma representação compacta dos padrões comportamentais. Com base na extração das características comportamentais de aprendizagem dos alunos, o modelo de Filtragem Colaborativa Neural (NCF) é usado para explorar ainda mais os interesses de aprendizagem dos alunos e produzir caminhos de aprendizagem personalizados. O modelo Deep Q-Network (DQN) coleta o feedback em tempo real dos alunos e ajusta dinamicamente o caminho de aprendizagem para otimizar a experiência e o efeito de aprendizagem dos alunos.
Quanto à implantação prática, a plataforma proposta oferece vantagens específicas, mas não é aplicável universalmente. É altamente adequado para instituições educacionais equipadas com hardware computacional dedicado, composto por unidades de processamento gráfico discretas e equipamentos imersivos de visualização espacial, e para currículos que se beneficiam significativamente da visualização espacial em arquitetura e arqueologia do patrimônio cultural. Nesses contextos, o acompanhamento comportamental dinâmico aborda efetivamente as diferenças individuais de ritmo. Por outro lado, esse método atualmente não é adequado para ambientes educacionais com recursos insuficientes e que carecem da infraestrutura tecnológica necessária. Além disso, não é recomendado para cursos altamente abstratos e centrados em texto, onde a imersão tridimensional oferece valor pedagógico negligenciável em comparação com métodos instrucionais tradicionais.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
O comitê de ética institucional da Universidade de Comércio Internacional e Comércio de Shaanxi validou o protocolo de pesquisa sob a referência 2025-04A. Foi obtido consentimento informado documentado de todos os participantes antes do início do procedimento, garantindo que todos os participantes humanos estivessem cientes dos protocolos de rastreamento comportamental e anonimização de dados. (Nota: Justificativas pedagógicas sobre os algoritmos foram realocadas para a seção de Discussão para manter a concisão operacional.)
Passo 1: Construção de cenas em realidade virtual
Integração de ativos
A modelagem digital de elementos culturais foi executada usando um software genérico de modelagem 3D (veja a Tabela de Materiais para softwares específicos usados) para construir ambientes de aprendizagemimersiva 12,13. Ativos digitais foram gerados, texturas de renderização baseadas fisicamente foram atribuídas e importadas para um motor de renderização espacial de alta fidelidade (Table of Materials) sem o uso de técnicas de imagemmicroscópica 14,15.
Configuração de renderização e física
A tecnologia de ray tracing por hardware foi habilitada dentro do motor de renderização para otimizar a iluminação dinâmica16,17:
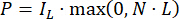 (1)
P representa a intensidade da luz na cena. L representa a posição da fonte de luz. IL denota a intensidade da fonte de luz, e N representa o vetor normal da superfície do objeto virtual.
O motor de física simulava a dinâmica de objetos por meio de uma interface de programação orientada a objetos (C++). A fórmula de reação utilizada foi:
 (2)
F representa a força de reação dinâmica, m é a massa do objeto virtual, v denota sua velocidade, e t representa o tempo.
Para garantir a suavidade, a tecnologia de Nível de Detalhe (LOD) foi usada para otimizar a cena, o que reduziu cálculos desnecessários e melhorou a eficiência de renderização ao ajustar dinamicamente o nível de detalhe do modelo18,19. A aceleração da GPU era usada para processamento de imagem:
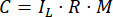 (3)
R representa o coeficiente de reflexão, M representa o mapa de superfície e C representa a cor final renderizada.
Implementação de interação
As interações do usuário foram configuradas utilizando a interface de script visual baseada em nós nativa do motor de renderização espacial. Utilizando tecnologia de áudio espacial, o som foi simulado no espaço para que os alunos possam ouvir diferentes efeitos sonoros em diferentes posições. Além disso, por meio da tecnologia de feedback tátil, os alunos poderiam receber respostas físicas ao toque físico correspondente na cenavirtual 20:
 (4)
Ft representa a força do feedback tátil, e k representa o coeficiente de rigidez.
Visão geral do implantação e equipamentos
O ambiente foi compilado em um hardware dedicado de computação espacial equipado com uma unidade central de processamento de vinte e quatro núcleos, sessenta e quatro gigabytes de memória de acesso aleatório e uma unidade dedicada de processamento gráfico de vinte e quatro gigabytes. As cenas virtuais foram implementadas em displays imersivos padrão de visualização espacial, conforme detalhado na Tabela de Materiais, com resolução de 1440 x 1600 pixels por olho e taxa de atualização de 90 Hz, garantindo estabilidade visual ideal e minimizando a latência entre movimento e fóton. Os limites espaciais foram configurados para limitar as sessões a 45 minutos para mitigar o enjoo de movimento induzido visualmente.
A Tabela de Materiais resume as tecnologias específicas utilizadas. Todo o hardware designado e componentes de computação eram equipamentos comerciais padrão prontos para a loja e não dependiam de um único fornecedor proprietário. O motor de renderização espacial e o ray tracing forneceram iluminação dinâmica, enquanto o software de modelagem 3D reproduziu locais históricos. A Figura 1 forneceu um exemplo da cena de aprendizado virtual, detalhando o painel de controle modular para ampliação visual, modulação de áudio e movimento.
Checkpoint 1: Um ambiente VR totalmente renderizado operando em uma taxa de atualização estável de 90 Hz, minimizando a latência movimento-fóton para garantir estabilidade visual.
Passo 2: Extração de Dados de Comportamento (Transformer)
Registro de dados
Os dados de comportamento de aprendizagem dos alunos incluíam interações com cenas de VR, incluindo contagem de cliques, tempo gasto, progresso de aprendizagem e conclusão de tarefas. A Tabela 1 apresenta os dados das atividades de aprendizagem para alunos em diferentes cenários de VR. Para essa informação interativa, foi usada uma representação em série temporal na plataforma:
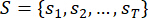 (5)
sτ representa o comportamento do aluno no tempo t, e T é o tempo total. Cada comportamento forma um vetor de alta dimensão:
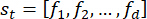 (6)
fi representa o valor específico da característica na dimensão i, e d indica o número total de dimensões da característica.
Modelagem de Sequências
O modelo Transformer foi usado para a modelagem de sériestemporais 21,22. Usando o mecanismo de autoatenção, as características comportamentais foram extraídas calculando as correlações entre os comportamentos dos alunos. Assumindo que a matriz de incorporação da sequência de dados do comportamento de aprendizagem do aluno é X, a consulta (Q), a chave (K) e o valor (V). As matrizes foram geradas inicialmente multiplicando por matrizes de pesos treináveis WQ, WK e WV:
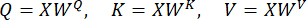 (7)
Cálculo de Atenção
A autoatenção dentro do Transformer foi calculadacomo 23,24:
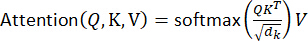 (8)
Entre eles, dk representa a dimensão dos principais vetores, que foi utilizada como um fator de escala para evitar o desaparecimento de gradientes. Após o cálculo da fórmula (8), o peso de atenção foi calculado para medir a correlação entre os comportamentos de aprendizagem:
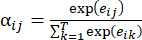 (9)
Eij representa a pontuação bruta de atenção e energia entre os comportamentos de aprendizagem. A soma ponderada desses pesos foi usada para obter o vetor de contexto no momento atual, que é o vetor de características potencial do estudante:
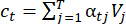 (10)
Ponto de Controle 2: O modelo Transformer gera vetores de características latentes contínuos (ct). Em um conjunto de dados de validação sequestrado com 5000 logs de interação, o modelo alcançou uma precisão de previsão de sequências de 89,4%, com a perda de entropia cruzada convergindo para 0,12 após 50 épocas.
Passo 3: Geração Personalizada de Caminhos de Aprendizagem (NCF)
Fusão de Características
O modelo NCF foi incorporado para explorar os interesses e necessidades potenciais dos alunos e gerou caminhos de aprendizagem personalizados25, 26, 27, 28. No NCF, um vetor de características vk foi atribuído a cada ponto de conhecimento cultural, e o vetor potencial de característica v u extraído pelo Transformer e o vetor de ponto de conhecimento vk foram concatenados para formar um novo vetor conjunto de características:
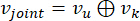 (11)
Arquitetura de Rede e Hiperparâmetros:
O vetor de características conjuntas foi inserido no perceptrônio multicamada (MLP) no NCF para processamento29,30. O perceptron multicamadas utilizava uma arquitetura predeterminada com três camadas ocultas de 64, 32 e 16 neurônios, respectivamente. A taxa de aprendizado foi definida para 0,001, com um lote de 256. Após a transformação não linear de várias camadas ocultas no MLP, o valor previsto do interesse dos alunos em pontos de conhecimento foi o resultado:
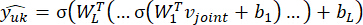 (12)
W1, W2, ... , WL representam as matrizes de pesos de múltiplas camadas ocultas. σ denota a função de ativação não linear, e b1, b2, ... , bL representam os termos de viés das respectivas camadas ocultas. Quanto maior o valor de previsão de juros de saída, maior o interesse do estudante nesse ponto de conhecimento.
Treinamento em Modelos
A rede foi otimizada usando o solucionador Adam (taxa de decaimento 0,01, taxa de aprendizado 0,001, tamanho de lote 256). O erro quadrático médio (MSE) serve como função de perda31,32:
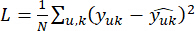 (13)
U, k representam o índice do vetor de comportamento do aluno e do vetor de pontos de conhecimento. Ao minimizar a função de perda, o modelo atualiza continuamente os vetores potenciais de características para os alunos e pontos de conhecimento para melhorar a precisão das previsões. O algoritmo de retropropagação foi usado durante o processo de treinamento para atualizar a matriz de pesos no modelo33,34.
Saída de Caminho
A abordagem específica foi ordenar pelos valores de interesse previstos e recomendar os k pontos de conhecimento com os maiores valores de interesse aos alunos:
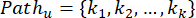 (14)
Kk representam os k pontos de conhecimento que mais interessam aos alunos. Esses pontos de conhecimento recomendados não apenas atendem aos interesses de aprendizagem dos alunos, mas também os ajudam a aprender de forma eficaz, em um nível de progresso e dificuldade que lhes convém.
A Figura 2 visualiza esse processo de geração.
Ponto de controle 3: O modelo NCF gera um array de sequência não cíclico. Como detalhado na Tabela 2, a precisão de recomendação avaliada na seleção top-K resultou em um ganho cumulativo descontado normalizado (NDCG) de 0,82 e uma razão de acerto de 0,88 em K = 10. A métrica média recíproca de classificação estabilizou em 0,76.
Passo 4: Ajuste dinâmico da dificuldade (DQN)
Definição de estado e ação
Ao introduzir o DQN e usar o feedback em tempo real dos alunos para ajustar dinamicamente o conteúdo e a dificuldade de aprendizagem, os efeitos de aprendizagem dos alunos sãootimizados 35,36. O espaço de estados do modelo DQN consiste em múltiplos fatores:
 (15)
Entre eles, ts representa o tempo que os alunos passam na tarefa de aprendizagem atual, cp representa as escolhas dos alunos no caminho de aprendizagem (capítulos ou pontos de conhecimento selecionados), mc representa a conclusão da tarefa de aprendizagem atual pelos alunos, e e f representa o feedback emocional dos alunos (o grau de preferência e participação em determinada tarefa de aprendizagem).
Cálculo de Recompensa
O agente de aprendizado por reforço utilizava uma arquitetura perceptron multicamadas composta por duas camadas ocultas de 128 e 64 neurônios (estratégia de exploração gulosa por epsilon que decai de 1.0 para 0.05). Primeiro, o valor da recompensa correspondente a cada ação de aprendizagem foi calculado:
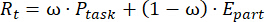 (16)
Entre eles, ω é um hiperparâmetro de peso que controla o desempenho e a participação na aprendizagem. A tarefa P representa o desempenho do aluno na tarefa de aprendizagem atual, e aparte E representa a participação do aluno no processo de aprendizagem atual.
Atualização do valor Q e seleção de ações
Após obter o valor da recompensa, o modelo atualizou o valor Q para selecionar a ação ótima:
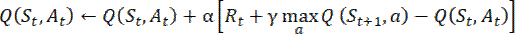 (17)
α representa a taxa de aprendizado que controla o tamanho do passo de atualização e γ O fator de desconto determina a importância das recompensas futuras.
A plataforma selecionou a ação de ajuste ótima:
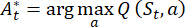 (18)
 é a ação de ajuste ótima selecionada pela plataforma com base no status de aprendizagem do aluno no tempo t.
O ajuste foi executado seguindo estes protocolos: (1) A dificuldade foi aumentada para alta capacidade de aprendizagem; (2) Dicas foram fornecidas/dificuldade reduzida por baixo desempenho; (3) O conteúdo foi alterado com base em mudanças de interesse; (4) Parâmetros foram mantidos para desempenho balanceado.
Ponto de Controle 4: O agente DQN calculava ações ótimas (At) para sustentar o engajamento. A métrica composta de feedback emocional (ef) manteve um coeficiente de confiabilidade alfa de Cronbach de 0,85 durante os testes.
Exibição da interface da plataforma
A Figura 3 mostra a interface da plataforma de ensino inteligente projetada neste artigo, que suporta a geração de caminhos personalizada. Nessa interface, os alunos podiam ver seu caminho de aprendizagem personalizado e aprender com ele. A parte concluída do caminho de aprendizado podia ser marcada em verde, e a parte inacabada em vermelho. Os alunos podiam ver seu progresso de aprendizagem ao longo do caminho e avançar para o próximo passo de acordo. Pesquisas pós-interação usando a Escala de Usabilidade do Sistema padrão foram aplicadas à coorte experimental. A análise resultou em uma pontuação média de usabilidade de 84,5 de 100, indicando que a ergonomia e a clareza da navegação da interface eram altamente aceitáveis.
Desenho experimental
Os participantes foram 120 estudantes de graduação (62 mulheres, 58 homens; idade média 19,3 anos ± 1,1 ano) matriculados em um curso obrigatório de "Introdução à Cultura Tradicional Chinesa" na Universidade de Comércio Internacional e Comércio de Shaanxi. Nenhum deles tinha experiência prévia com aprendizado baseado em VR. Os alunos foram pareados por escores pré-teste e designados aleatoriamente em pares para condições experimentais ou de controle usando uma sequência gerada por computador, garantindo equivalência de base.
O design desse experimento foi para verificar a eficácia da plataforma inteligente de ensino projetada para melhorar o interesse de aprendizagem dos alunos, o desempenho acadêmico e a educação personalizada.
O grupo experimental e o grupo controle foram estabelecidos no experimento, e a seleção dos alunos seguiu os seguintes princípios: (1) Isso garantiu que os alunos do grupo experimental e do grupo controle tivessem semelhanças em conhecimentos básicos, capacidade de aprendizagem, interesses, etc. (2) Estudantes que estudam cultura tradicional e possuem anos semelhantes podiam ser selecionados para garantir a uniformidade do conteúdo da educação cultural e a comparabilidade do experimento. (3) As diferenças individuais dos alunos poderiam ser levadas em conta para garantir que o grupo experimental pudesse fazer pleno uso da função de ajuste personalizado da plataforma de ensino inteligente.
Após selecionar os alunos, eles são agrupados, e alunos com desempenho acadêmico, interesses e antecedentes semelhantes são designados para os grupos experimental e controle, respectivamente, para garantir a correspondência entre múltiplas dimensões e melhorar a confiabilidade do experimento.
Ao comparar o desempenho dos grupos experimental e controle, foi avaliado o impacto da plataforma projetada neste artigo sobre os alunos. Para isolar a contribuição pedagógica dos algoritmos de inteligência artificial, o estudo apresentou três coortes distintas: um grupo controle tradicional usando métodos padrão em sala de aula, um grupo apenas VR interagindo com ambientes virtuais fixos sem algoritmos adaptativos, e um grupo experimental usando a plataforma inteligente de ensino totalmente integrada. Os alunos do grupo experimental podiam aprender em uma cena de VR, e cada aluno podia gerar caminhos de aprendizagem personalizados com base em suas características de comportamento de aprendizagem por meio da plataforma de ensino inteligente, ajustando dinamicamente o conteúdo e a dificuldade de aprendizagem em resposta ao feedback em tempo real durante o processo de aprendizagem. O grupo controle recebeu educação cultural por meio de métodos tradicionais de ensino, como explicações em sala de aula, leitura de livros didáticos e vídeos. O grupo controle recebeu educação cultural padronizada por meio de palestras conduzidas por instrutores, leituras designadas e apresentações multimídia lineares. Essa instrução básica usava conteúdo informativo idêntico e mantinha o mesmo ritmo temporal do currículo experimental.
Três hipóteses foram elaboradas para esclarecer o propósito do estudo: (1) O ambiente de aprendizagem imersivo proporcionado pela tecnologia de RV pode melhorar significativamente a participação e o interesse dos alunos na aprendizagem. (2) A produção do caminho de aprendizagem personalizado da Transformer e da NCF melhorou efetivamente o desempenho acadêmico dos alunos e reduziu as diferenças no domínio do conhecimento entre os diferentes alunos. (3) A plataforma de ensino inteligente poderia ajustar dinamicamente o conteúdo e a dificuldade de aprendizagem com base no feedback em tempo real dos alunos, melhorando ainda mais os resultados de aprendizagem dos alunos.
Processo experimental: (1) Foi realizado um teste pré-experimental de conhecimento cultural em estudantes dos grupos experimental e controle para garantir que os níveis culturais iniciais dos dois grupos fossem semelhantes e para reduzir erros experimentais. (2) Os alunos do grupo experimental usaram a cena de VR construída e a plataforma de ensino inteligente, realizaram um estudo cultural de um mês, e o conteúdo de aprendizagem foi ajustado dinamicamente de acordo com a plataforma de ensino inteligente. O grupo controle utilizou métodos tradicionais de ensino. Devido às limitações logísticas do piloto inicial, a intervenção durou quatro semanas. Um estudo longitudinal de acompanhamento realizado durante um semestre completo de 16 semanas culminou em um teste de retenção atrasado na semana 20. A avaliação demonstrou uma retenção 22% maior de conceitos históricos-alvo na coorte orientada algoritmicamente do que no grupo tradicional de instrução. Detalhes preliminares do protocolo foram fornecidos na seção de limitações para contextualizar os achados atuais como evidências de curto prazo. (3) Após o experimento, os dois grupos de alunos receberam o mesmo teste de conhecimento cultural para avaliar seu desempenho na aprendizagem e a conclusão das tarefas.
Os indicadores de avaliação para os alunos incluíram desempenho acadêmico, conclusão das tarefas de aprendizagem e progresso da aprendizagem. Utilizando estatísticas descritivas, os indicadores de avaliação relevantes para os grupos experimental e controle foram resumidos. Os indicadores de avaliação da plataforma de ensino inteligente incluíram o tempo de resposta.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Divisões de dados, validação e configurações de reprodutibilidade
Para a fase de treinamento algorítmico, o conjunto de dados de interação comportamental, contendo 5.000 logs, foi dividido em conjuntos de treinamento e validação 80:20. Os procedimentos de validação utilizaram um esquema de validação cruzada de 5 partes para avaliar a consistência da extração de características. Para garantir reprodutibilidade experimental absoluta, todas as inicializações de peso da r...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Este estudo contribui para a tecnologia educacional ao traduzir as teorias pedagógicas centrais — nomeadamente o construtivismo e a Zona de Desenvolvimento Proximal — em um sistema inteligente de ensino computacionalmente implementado. A integração da imersão em VR com a personalização orientada pelo comportamento garante que a inovação tecnológica atenda a objetivos de aprendizagem demonstráveis, em vez de funcionar como um fim em si mesmo. Como destacado na metodologia, a geração de ca...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram que não têm conflitos financeiros de interesse. Divulgação de Ferramentas de Inteligência Artificial: Grandes modelos de linguagem foram utilizados durante a preparação deste manuscrito estritamente para refinamento linguístico, esclarecimento de terminologias especializadas e assistência na recuperação de literatura acadêmica. Todos os resultados da inteligência artificial foram avaliados criticamente, cruzados manualmente com fontes primárias revisadas por pares e rigorosamente editados pelos autores para garantir rigorosa precisão científica e integridade dos dados.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| High-fidelity spatial rendering engine | Unreal Engine 5 | Usado para integração de cena, ray tracing dinâmico e simulação de física. | |
| Ray tracing | Ray tracing | Tecnologia de simulação de iluminação baseada em princípios físicos | |
| 3D modeling software | Blender | Usado para gerar modelos poligonais de artefatos culturais e aplicar texturas PBR. | |
| Level of detail | Level of detail | Tecnologia de Otimização de Cena | |
| Spatial audio | Spatial audio | Simulando as características de propagação de áudio no espaço tridimensional | |
| Haptic feedback | Haptic feedback | Simulando forças de feedback ao interagir com a física | |
| Visual scripting & programming interface | Blueprints & C++ | Usado para configurar interações do usuário e registrar continuamente dados comportamentais espaciais. | |
| Head-mounted display (HMD) | HTC Vive Pro | Fornece visualização imersiva, entrega de áudio espacial e rastreamento de movimento. |
Referências
- Rojas-Sanchez MA, Palos-Sanchez PR, Folgado-Fernandez JA. Systematic literature review and bibliometric analysis on virtual reality and education. Educ Inf Technol (Dordr). 2023;28:155-92.
- Rospigliosi P. Metaverse or simulacra? Roblox, Minecraft, Meta and the turn to virtual reality for education, socialisation and work. Interact Learn Environ. 2022;30:1-3.
- Quadir B, Chen NS, Isaias P. Analyzing the educational goals, problems and techniques used in educational big data research from 2010 to 2018. Interact Learn Environ. 2022;30:1539-55.
- Lutfiani N, Meria L. Utilization of big data in educational technology research. Int Trans Educ Technol. 2022;1:73-83.
- Radianti J, Majchrzak TA, Fromm J, Wohlgenannt I. A systematic review of immersive virtual reality applications for higher education: design elements, lessons learned, and research agenda. Comput Educ. 2020;147:103778.
- Hulusic V, Gusia L, Luci N, Smith M. Tangible user interfaces for enhancing user experience of virtual reality cultural heritage applications for utilization in educational environment. ACM J Comput Cult Herit. 2023;16:1-24.
- Mubarok H, Lin CJ, Hwang GJ. A virtual reality-based collaborative argument mapping approach in the EFL classroom. Interact Learn Environ. 2024;32:4978-96.
- Sun T, et al. Restoring Dunhuang murals: crafting cultural heritage preservation knowledge into immersive virtual reality experience design. Int J Hum Comput Interact. 2024;40:2019-40.
- Ouatik F, et al. Predicting student success using big data and machine learning algorithms. Int J Emerg Technol Learn. 2022;17:236-51.
- Bhaskaran S, Marappan R. Enhanced personalized recommendation system for machine learning public datasets: generalized modeling, simulation, significant results and analysis. Int J Inf Technol. 2023;15:1583-95.
- Gupta S, Kumar P, Tekchandani RK. Facial emotion recognition based real-time learner engagement detection system in online learning context using deep learning models. Multimed Tools Appl. 2023;82:11365-94.
- El-Wajeh YA, Hatton PV, Lee NJ. Unreal Engine 5 and immersive surgical training: translating advances in gaming technology into extended-reality surgical simulation training programmes. Br J Surg. 2022;109:470-1.
- Conde D, et al. LiDAR data processing for digitization of the castro of Santa Trega and integration in Unreal Engine 5. Int J Archit Herit. 2025;19:131-51.
- Rohe DP, Jones EM. Generation of synthetic digital image correlation images using the open-source Blender software. Exp Tech. 2022;46:615-31.
- Pradana MR, Setiawan D, Trinawati L. Efektivitas ilusi 3D animasi Blender pada curved LED billboard (AB Building Jl. Juanda Pekanbaru). JEKIN (Jurnal Teknik Informatika). 2023;3(2):1-10. Available from: https://pdfs.semanticscholar.org/e4fd/a249d78d46e24319e3a8f318e713f76c0cbd.pdf
- Wang Y, Zhao K, Zheng Z. An improved 3D indoor positioning study with ray tracing modeling for 6G systems. Mob Netw Appl. 2023;28:1162-75.
- Liu Y, et al. Intelligent ray-tracing-based simulation and emulation of channels. Chin J Radio Sci. 2024;39:1112-9.
- Weier P, et al. Neural prefiltering for correlation-aware levels of detail. ACM Trans Graph. 2023;42:1-16.
- Mercier C, et al. Moving level-of-detail surfaces. ACM Trans Graph. 2022;41:1-10.
- Zhu M, Sun Z, Lee C. Soft modular glove with multimodal sensing and augmented haptic feedback enabled by materials' multifunctionalities. ACS Nano. 2022;16:14097-110.
- Heng JJ, Teo DB, Tan LF. The impact of Chat Generative Pre-trained Transformer (ChatGPT) on medical education. Postgrad Med J. 2023;99:1125-7.
- Hung YC, et al. Comparison of patient education materials generated by chat generative pre-trained transformer versus experts: an innovative way to increase readability of patient education materials. Ann Plast Surg. 2023;91:409-12.
- Yang H, et al. CovidViT: a novel neural network with self-attention mechanism to detect Covid-19 through X-ray images. Int J Mach Learn Cybern. 2023;14:973-87.
- Kumar S, Solanki A. An abstractive text summarization technique using transformer model with self-attention mechanism. Neural Comput Appl. 2023;35:18603-22.
- Tapalova O, Zhiyenbayeva N. Artificial intelligence in education: AIEd for personalised learning pathways. Electron J e-Learn. 2022;20:639-53.
- Hashim S, et al. Trends on technologies and artificial intelligence in education for personalized learning: systematic literature. J Acad Res Progress Educ Dev. 2022;12:884-903.
- Lin W, et al. A deep neural collaborative filtering based service recommendation method with multi-source data for smart cloud-edge collaboration applications. Tsinghua Sci Technol. 2023;29:897-910.
- Ha J, Park S. NCMD: Node2vec-based neural collaborative filtering for predicting miRNA-disease association. IEEE/ACM Trans Comput Biol Bioinform. 2022;20:1257-68.
- Nuanmeesri S, et al. Improving dropout forecasting during the COVID-19 pandemic through feature selection and multilayer perceptron neural network. Int J Inf Educ Technol. 2022;12:851-7.
- Yilmaz O, Altun AA, Koklu M. Optimizing the learning process of multi-layer perceptrons using a hybrid algorithm based on MVO and SA. Int J Ind Eng Comput. 2022;13:617-40.
- Garcia Garcia C, Salmeron Gomez R, Garcia Perez J. A review of ridge parameter selection: minimization of the mean squared error vs. mitigation of multicollinearity. Commun Stat Simul Comput. 2024;53:3686-98.
- Thongsak N, Lawson N. Bias and mean square error reduction by changing the shape of the distribution of an auxiliary variable: application to air pollution data in Nan, Thailand. Math Popul Stud. 2023;30:180-94.
- Mohammed NA, Al-Bazi A. An adaptive backpropagation algorithm for long-term electricity load forecasting. Neural Comput Appl. 2022;34:477-91.
- Wright LG, et al. Deep physical neural networks trained with backpropagation. Nature. 2022;601:549-55.
- Bhimshetty S, Ikechukwu AV. Energy-efficient deep Q-network: reinforcement learning for efficient routing protocol in wireless internet of things. Indones J Electr Eng Comput Sci. 2024;33:971-80.
- Geng X, Zhang B. Deep Q-network-based intelligent routing protocol for underwater acoustic sensor network. IEEE Sens J. 2023;23:3936-43.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.