Este estudo integrou farmacologia de rede, acoplamento molecular, dinâmica molecular e MM-PBSA para priorizar possíveis interações proteicas de pró-fármacos sensíveis ao glutationato que aprisionam sítios abásicos em CCRP. O composto 5 foi priorizado para acompanhamento com MMP9 e SRC; no entanto, estes permanecem como candidatos computacionais. Os resultados geram hipóteses e requerem validação bioquímica e com base em células.
Artigo de investigação
Priorização In Silico de Potenciais Interações Proteicas para Pródrugas de Captura de Sítios Abásicos Responsivas à Glutationa no Câncer de Pulmão de Não Pequenas Células
Neste artigo
Resumo
Resumo
O câncer de pulmão de células não pequenas (CPCNP) continua sendo uma causa importante de mortalidade relacionada ao câncer, e a eficácia do tratamento é frequentemente limitada pela resistência adquirida e pela toxicidade sistêmica. Pró-fármacos com resposta à glutationa que aprisionam sítios abásicos demonstraram atividade antineoplásica seletiva em estudos experimentais anteriores, mas ainda não está estabelecido se seus metabólitos liberados também apresentam interações significativas com proteínas relevantes para o câncer. Neste trabalho, foi utilizado um fluxo de trabalho integrado in silico, combinando farmacologia de rede, acoplamento molecular, dinâmica molecular (DM) e análise de área de superfície de Poisson-Boltzmann pela mecânica molecular (MM-PBSA), para priorizar hipóteses testáveis de interação proteica para dois pró-fármacos sensíveis à glutationa (Composto 1 e Composto 2), seus produtos contendo aminooxi (Composto 4 e Composto 5) e um par controle correspondente sem atividade de aprisionamento (Composto 3 e Composto 6). Foram identificados vinte e um alvos comuns associados aos compostos e à doença, sendo que a proteína quinase serina/treonina AKT1 (AKT1), o receptor do fator de crescimento epidérmico (EGFR), o fator de necrose tumoral (TNF), a metaloproteinase 9 da matriz (MMP9) e a tirosina quinase proto-oncogênica não receptora SRC (SRC) foram priorizados com base na topologia da interação proteína-proteína. O Composto 5 apresentou a pontuação mais favorável no AutoDock Vina com a MMP9 (-8,418 kcal·mol⁻1) e mostrou poses derivadas do acoplamento comparativamente persistentes ao longo das trajetórias de DM com MMP9 e SRC. No entanto, a pose principal com MMP9 não demonstrou coordenação direta com o íon Zn2⁺ catalítico nem interação direta com His401, Glu402, His405 ou His411, portanto não pode ser atribuído um modo de ligação inibitório canônico para MMP9. As análises de DM e MM-PBSA caracterizam apenas o comportamento das trajetórias e a classificação energética relativa desses complexos; elas não demonstram o engajamento intracelular do alvo, inibição enzimática ou regulação de vias. Assim, a atividade comprovada de aprisionamento de sítios abásicos e as novas interações proteicas previstas são tratadas como hipóteses separadas, potencialmente paralelas, e não como uma cadeia mecanicista demonstrada. De modo geral, os resultados priorizam pares específicos de composto-alvo para testes futuros, mas não estabelecem um mecanismo multialvo contra o CPCNP.
Introdução
O câncer de pulmão de células não pequenas (CPCNP) é o subtipo histológico mais comum de câncer de pulmão e continua sendo uma das principais causas de mortalidade relacionada ao câncer em todo o mundo1. Embora tenham sido alcançados progressos substanciais na terapia direcionada e na oncologia de precisão, a eficácia do tratamento a longo prazo ainda é frequentemente comprometida pela resistência adquirida, durabilidade limitada da resposta e toxicidade associada ao tratamento2. Agentes direcionados ao receptor do fator de crescimento epidérmico (EGFR) melhoraram os resultados em pacientes selecionados molecularmente, mas a resistência quase inevitavelmente se desenvolve durante o tratamento, criando uma necessidade urgente de estratégias terapêuticas que atuem por meio de mecanismos alternativos ou complementares3,4. A quimioterapia convencional baseada em platina continua sendo um componente importante do tratamento, mas seu benefício clínico é limitado pela toxicidade cumulativa e resistência durante o uso prolongado5,6. Em conjunto, essas limitações destacam a necessidade de identificar agentes antitumorais que sejam mecanisticamente distintos e seletivamente ativados no microambiente tumoral.
Entre as lesões endógenas no DNA, os sítios apúricos ou apirimidínicos são altamente abundantes e biologicamente significativos, com milhares de lesões geradas em cada célula todos os dias7. Quando essas lesões não são reparadas de forma eficiente, podem ser convertidas em quebras de fita, o que pode promover instabilidade genômica e morte celular8,9. A endonuclease apurínica/apyrimidínica 1 é uma enzima central na via de reparo por excisão de bases, pois cliva os sítios apúricos e permite o processamento downstream do reparo10,11. Essa dependência de reparo tornou os danos associados a sítios apúricos um alvo atrativo para o desenvolvimento de fármacos anticâncer12. Com base nesse raciocínio, pró-fármacos sensíveis ao glutatião capazes de aprisionar sítios apúricos foram previamente desenvolvidos para explorar o ambiente elevado de glutatião nas células tumorais. Seus produtos ativados pelo glutatião contêm uma funcionalidade aminooxi capaz de aprisionar sítios apúricos na forma aldeídica, e trabalhos experimentais anteriores demonstraram citotoxicidade seletiva, parada do ciclo celular e apoptose em células H129913. Esses dados apoiam o componente do design do composto relacionado ao aprisionamento de lesões no DNA. No entanto, eles não demonstram que MMP9, SRC, EGFR, AKT1 ou TNF sejam regulados downstream do aprisionamento de sítios apúricos. Qualquer interação proteína-alvo identificada na presente análise computacional deve, portanto, ser considerada uma hipótese distinta, a menos que ambos os processos sejam demonstrados no mesmo sistema biológico.
O presente estudo foi planejado com base nessa distinção. O primeiro nível da lógica biológica é a química previamente estabelecida de liberação sensível ao glutationa e aprisionamento em sítios abásicos14. O segundo nível, examinado aqui, é uma questão exploratória: se os pró-fármacos originais ou seus produtos liberados são computacionalmente compatíveis com proteínas associadas ao câncer selecionadas. A farmacologia de rede foi utilizada para priorizar proteínas candidatas, seguida por análises de docking, MD e MM-PBSA para examinar complexos proteína-ligante selecionados15,16. Esses cálculos não tinham como objetivo demonstrar que as proteínas previstas mediam o fenótipo conhecido de dano ao DNA, nem estabelecer uma ligação causal entre o aprisionamento em sítios abásicos e a sinalização oncogênica. Em vez disso, o fluxo de trabalho foi usado para gerar um conjunto ordenado de hipóteses passíveis de teste experimental, que posteriormente podem ser avaliadas por ensaios de ligação direta, atividade enzimática, vias metabólicas, dano ao DNA e fenótipos.
Protocolo
A aprovação do comitê de ética não foi necessária porque este estudo foi inteiramente computacional e não envolveu participantes humanos, animais vertebrados, biospecimens derivados de pacientes ou dados pessoais identificáveis. O consentimento informado, portanto, não se aplica. Todos os bancos de dados, pacotes de software, campos de força e recursos computacionais utilizados neste protocolo estão listados na Tabela de Materiais.
Compostos de estudo e fluxo de trabalho analítico
Compostos relatados anteriormente que respondem à glutationa e aprisionam sítios apurínicos foram utilizados como moléculas de estudo17. O Composto 1 e o Composto 2 foram selecionados como pró-fármacos pais porque a clivagem induzida pela glutationa gera os produtos contendo grupo aminoxi, Composto 4 e Composto 5, respectivamente. O Composto 4 e o Composto 5 foram selecionados para análise estrutural porque representam as espécies liberadas que retêm o grupo aminoxi reativo ao sítio apurínico. O Composto 3 foi incluído como controle estrutural pareado com resposta à glutationa; seu produto de clivagem, o Composto 6, não possui a funcionalidade aminoxi necessária para o aprisionamento covalente de aldeídos de sítios apurínicos. Assim, os Compostos 1–3 foram incluídos na previsão reversa de alvos para comparação dos esqueletos pais, os Compostos 4 e 5 foram avaliados frente às proteínas priorizadas, e o Composto 6 foi utilizado como ligante controle negativo na comparação de dinâmica molecular com SRC. A trajetória SRC–Composto 6 foi incluída para fornecer um comparador estrutural pareado ao sistema do Composto 5 contendo grupo aminoxi, e não como evidência de que o próprio grupo aminoxi determine a ligação à SRC. As estruturas químicas e as relações de ativação dos Compostos 1–6 são apresentadas na Figura 1. Este delineamento mantém intencionalmente a química estabelecida de aprisionamento de lesões no DNA separada da análise geradora de hipóteses sobre possíveis interações proteicas.
Previsão de alvos associados a compostos
As estruturas bidimensionais do Composto 1, Composto 2 e Composto 3 foram salvas no formato MDL MOL e convertidas em sequências canônicas do sistema simplificado de entrada de linhas moleculares (SMILES) usando o Open Babel versão 3.1.1 com o formato de saída SMILES canônico18. Cada sequência exportada foi reimportada, e a estrutura regenerada foi verificada visualmente em comparação com a estrutura bidimensional correspondente antes do envio ao SwissTargetPrediction, com a espécie restrita a Homo sapiens19. Foram mantidos os alvos preditos com valores de probabilidade não nulos. As listas de alvos obtidas para os três compostos foram combinadas, entradas duplicadas foram removidas e os alvos restantes foram padronizados para os símbolos oficiais dos genes humanos antes da análise adicional. Os pares padronizados de composto-alvo foram importados para um software de visualização e análise de redes como uma tabela de rede, com compostos e alvos preditos representados como nós e as relações entre compostos e alvos representadas como arestas, para visualizar as relações preditas entre os alvos20.
Recuperação de alvos relacionados à doença e identificação de alvos comuns
Os alvos associados à doença foram recuperados a partir do banco de dados GeneCards utilizando o termo de busca “lung cancer H1299”21. Foi aplicado um limiar de pontuação de relevância superior a 0,27 para reter genes com maior relevância para esta consulta. Os símbolos gênicos foram padronizados e entradas duplicadas foram removidas manualmente. A intersecção entre os alvos previstos pelo composto e os alvos associados à doença foi identificada utilizando uma ferramenta online de análise de diagrama de Venn/intersecção22. Apenas os alvos intersecionados foram mantidos para análises subsequentes de interação proteína-proteína (PPI), enriquecimento e priorização de alvos.
Análise de interação entre proteínas e triagem de alvos centrais
Os alvos interseccionados foram submetidos à Ferramenta de Busca para Recuperação de Genes/Proteínas Interagentes (STRING), versão 11.5, com a espécie restrita a Homo sapiens e a pontuação mínima de interação exigida definida em 0,40023. Os dados de PPI resultantes foram importados para o Cytoscape versão 3.10.0 para visualização e análise de topologia. Na análise de topologia de rede plugin, grau, centralidade de intermediação e centralidade de proximidade foram calculados para cada nó na rede original de PPI de 21 nós; os valores resultantes foram então utilizados para a filtragem sequencial baseada na mediana descrita abaixo24. As métricas de centralidade foram calculadas na rede original de interação proteína-proteína (PPI) de 21 nós e então utilizadas para filtragem sequencial. O grau mediano da rede original foi 12, e os nós com grau ≥ 12 foram mantidos, resultando em 13 candidatos. Dentre esses 13 candidatos, a centralidade de intermediação mediana foi 0,031293 e a centralidade de proximidade mediana foi 0,769231. O segundo filtro manteve os nós com centralidade de intermediação ≥ 0,031293 e centralidade de proximidade ≥ 0,769231, > 0,769231, gerando cinco candidatos a hub: AKT1, EGFR, TNF, MMP9 e SRC. Os valores de centralidade relatados foram mantidos a partir da rede original de 21 nós, em vez de serem recalculados após a subseção. Os cinco candidatos finais a hub foram utilizados para análise estrutural subsequente. As métricas de topologia originais correspondem a uma rede de interação proteína-proteína (PPI) não direcionada contendo 21 nós e 116 arestas.
Análise de enriquecimento da Ontologia Genética e da Enciclopédia de Kyoto de Genes e Genomas
Os alvos com interseção foram submetidos à análise de enriquecimento de Ontologia Genética (GO) e da Enciclopédia de Kyoto de Genes e Genomas (KEGG) utilizando o Banco de Dados para Anotação, Visualização e Descoberta Integrada (DAVID), com a espécie restrita a Homo sapiens25. O enriquecimento de GO foi avaliado para processo biológico (BP), componente celular (CC) e função molecular (MF), bem como para vias de sinalização KEGG. Para esta análise exploratória, um valor nominal de p < 0,10 foi utilizado como limiar de inclusão para manter as entradas de enriquecimento; valores de p ajustados por Benjamini, valores de Bonferroni, taxas de falsa descoberta e valores do teste exato de Fisher foram relatados nas tabelas suplementares, mas não foram utilizados para definir o conjunto mantido. As entradas mantidas foram ordenadas pelo valor nominal de p. Para visualização e interpretação posteriores, as 20 principais vias KEGG e os 10 principais termos de cada categoria GO foram mantidos. Gráficos de barras e gráficos de bolhas foram gerados utilizando uma ferramenta online de visualização bioinformática.
Preparação de receptores e ligantes para docking molecular
As estruturas cristalinas das proteínas priorizadas foram obtidas no Banco de Dados de Estruturas de Proteínas RCSB (PDB): AKT1, ID PDB 3O96; EGFR, ID PDB 5UWD; TNF, ID PDB 2AZ5; MMP9, ID PDB 1GKC; e SRC, ID PDB 2H8H. As estruturas proteicas utilizadas para o encaixe molecular foram preparadas em software de visualização molecular mediante a remoção de ligantes co-cristalizados e moléculas de água, seguida de processamento em software de preparação para encaixe. Para a MMP9, uma cópia não modificada do PDB 1GKC foi mantida separadamente como referência cristalográfica para o ambiente do Zn2⁺ catalítico e para o modo de ligação do N2-[(2R)-2-{[formil(hidroxi)amino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinamida (NFH). Na cadeia A do 1GKC, o Zn2⁺ catalítico é coordenado por His401, His405 e His411 a distâncias de 2,21, 2,23 e 2,22 Å, respectivamente, enquanto os dois átomos de oxigênio do NFH coordenam o Zn2⁺ a 2,07 e 2,38 Å; Glu402 é o resíduo ácido/base catalítico. Esses contatos cristalográficos foram utilizados como referência estrutural positiva para a avaliação do mapa de interação do encaixe do Composto 5. Para a SRC, o PDB 2H8H foi utilizado nos cálculos de dinâmica molecular (MD) da SRC. Essas comparações estruturais foram usadas apenas para interpretação e não foram consideradas evidência de inibição enzimática ou engajamento intracelular do alvo.
As estruturas tridimensionais do Composto 4 e do Composto 5 foram obtidas do PubChem e otimizadas por minimização de energia em software de modelagem molecular26. Os ligantes foram protonados em condições fisiológicas e minimizados utilizando o campo de força molecular Merck 94 (MMFF94) até que o gradiente de energia fosse inferior a 0,01 kcal·mol⁻1·Å⁻1. Átomos de hidrogênio foram adicionados, cargas de Gasteiger foram atribuídas e ligações rotatóveis foram definidas no software de preparação para docking. O Composto 6, o produto da clivagem da glutationa do controle não aprisionador Composto 3, foi preparado utilizando o mesmo fluxo de trabalho e acoplado à SRC apenas para gerar a pose inicial para a trajetória de dinâmica molecular (MD) do controle correspondente. Assim, o Composto 6 não foi introduzido como um ligante terapêutico previsto adicional nem utilizado para apoiar um mecanismo multialvo.
Procedimento de docking molecular
A ancoragem molecular foi realizada utilizando software de ancoragem molecular sob um protocolo de ancoragem semirrígido, mantendo os receptores rígidos e permitindo que os ligantes permanecessem flexíveis27,28. Para cada receptor, a caixa de ancoragem foi centralizada na posição do ligante cocrystalizado, de modo que a região de busca correspondesse ao bolsão de ligação definido experimentalmente. As dimensões da caixa de ancoragem foram definidas como 24 Å × 24 Å × 24 Å para AKT1, EGFR e SRC, 26 Å × 26 Å × 26 Å para MMP9 e 28 Å × 28 Å × 28 Å para TNF. A exaustividade foi definida como 32, o número de conformações de saída foi definido como 20 e a faixa de energia foi definida como 4 kcal·mol⁻1. A conformação com a melhor classificação de cada corrida de ancoragem foi mantida para análise de interação.
Para avaliar a confiabilidade interna da configuração de docking, cada ligante co-cristalizado foi redockeado em seu respectivo sítio receptor utilizando os mesmos parâmetros, sendo adotado um desvio padrão médio quadrático (RMSD) dos átomos pesados inferior a 2,0 Å como critério de aceitação. As poses finais foram inspecionadas em software de visualização molecular. Para o complexo MMP9–Composto 5, o mapa de interações retido foi analisado especificamente quanto à coordenação direta do ligante com o íon Zn2⁺ catalítico e aos contatos com His401, Glu402, His405 e His411, sendo a posição do ligante comparada com a pose cristalográfica do NFH no PDB 1GKC. Uma distância quantitativa de coordenação metálica foi relatada apenas quando a coordenação direta entre o ligante e o Zn2⁺ era evidente na pose retida; caso contrário, foi designada como não aplicável, em vez de inferida. Assim, uma pose de docking em MMP9 que não apresentasse essas características canônicas do sítio catalítico foi categorizada como não canônica e não foi interpretada como evidência de inibição enzimática de MMP9. De forma mais geral, as pontuações do AutoDock Vina e as poses de docking foram utilizadas para priorização relativa e geração de hipóteses, e não como prova de afinidade de ligação ou engajamento do alvo intracelular.
Protocolo de dinâmica molecular
Os complexos proteína-ligante selecionados para análise por dinâmica molecular foram construídos a partir das conformações de ligação obtidas por docking. Os cálculos de dinâmica molecular foram realizados com o GROMACS29. As proteínas foram parametrizadas utilizando o campo de força CHARMM36, enquanto os tipos de átomos e parâmetros do ligante foram atribuídos com o campo de força Amber Geral de segunda geração (GAFF2)30,31. As cargas parciais AM1-BCC (correção de carga de ligação do modelo Austin 1) foram geradas por meio de ferramentas de parametrização de pequenas moléculas e geração de topologia de ligante; em seguida, um software de geração de topologia do ligante produziu os arquivos de topologia do ligante compatíveis com o GROMACS32,33,34. Cada complexo foi posicionado em uma caixa de água TIP3P sob condições de contorno periódicas, com uma distância mínima entre o soluto e a borda da caixa de 1,0 nm. Íons sódio e cloreto foram adicionados para neutralizar a carga líquida de cada sistema, e NaCl adicional foi acrescentado para atingir uma força iônica final de 0,15 M.
A minimização de energia foi realizada utilizando o algoritmo de descida mais íngreme até que a força máxima caísse abaixo de 1000 kJ·mol⁻1·nm⁻1. Os sistemas minimizados foram então equilibrados sob condições constantes de número de partículas, pressão e temperatura (NPT) a 310 K e 1 bar, com restrições posicionais aplicadas à estrutura principal da proteína. A temperatura foi controlada com o termostato V-rescale e a pressão com o barostato de Parrinello-Rahman. As interações eletrostáticas de longo alcance foram calculadas utilizando o método de Ewald em malha de partículas. Os cortes de curto alcance para interações eletrostáticas e de van der Waals foram ambos definidos em 1,0 nm, e todas as ligações envolvendo átomos de hidrogênio foram fixadas utilizando o algoritmo resolvedor de restrições lineares (LINCS). Trajetórias de produção foram geradas por 150 ns com um passo de integração de 2 fs, e as coordenadas foram salvas a cada 10 ps para análises posteriores.
Análise de trajetória
As análises de trajetória foram realizadas nas partes equilibradas das trajetórias de produção. O RMSD da cadeia principal da proteína e o RMSD do ligante foram calculados após o ajuste por mínimos quadrados à conformação inicial de referência. Os valores de flutuação quadrática média (RMSF) foram calculados por resíduo utilizando os átomos Cα. A análise de ligação de hidrogênio entre cada ligante e seu receptor foi realizada utilizando um corte na distância doador-aceptor de 3,5 Å e um corte no ângulo doador-hidrogênio-aceptor de 30°. A ocupação da ligação de hidrogênio foi definida como a proporção de quadros analisados nos quais uma determinada ligação de hidrogênio estava presente. Essas métricas foram utilizadas para caracterizar a estabilidade estrutural, a flexibilidade em nível de resíduo e a persistência dos contatos intermoleculares ao longo das três trajetórias de dinâmica molecular.
Cálculo da energia livre de ligação por área de superfície Poisson-Boltzmann e mecânica molecular (MM-PBSA)
A energia livre de ligação foi calculada utilizando o método MM-PBSA implementado com o software de análise MM-PBSA em segmentos equilibrados das trajetórias de dinâmica molecular35. Para cada complexo proteína-ligante, os últimos 50 ns da trajetória de produção de 150 ns foram utilizados para a análise da energia livre. Um total de 500 quadros igualmente espaçados foi amostrado em intervalos de 100 ps, de 100,0 ns a 149,9 ns; o ponto final de 150,0 ns foi excluído do conjunto amostrado. A energia livre total de ligação foi calculada como a soma dos termos de energia de van der Waals, energia eletrostática, energia de solvatação polar e energia de solvatação não polar:
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
Nenhuma correção de entropia foi aplicada. As energias livres médias de ligação e os desvios padrão foram calculados em todos os quadros amostrados.
Controles de reprodutibilidade e validação computacional
Todos os nomes de genes utilizados nas etapas de predição de alvos, recuperação de doenças-alvo e análise de interseção foram padronizados para os símbolos oficiais dos genes humanos antes da análise subsequente. Os mesmos parâmetros de encaixe molecular foram mantidos em todos os pares receptor-ligante. A configuração do encaixe foi verificada tecnicamente por meio do reencaixe do ligante co-cristalizado correspondente em cada bolsa do receptor, utilizando as mesmas configurações de busca e o limiar pré-especificado de aceitação do RMSD de átomos pesados de <2,0 Å. O complexo cristalográfico MMP9–NFH foi mantido como referência estrutural positiva para o ambiente do Zn2⁺ catalítico, enquanto o SRC–Composto 6 serviu como comparador não retentivo correspondente para a análise da trajetória do SRC. As trajetórias de dinâmica molecular foram inspecionadas quanto à estabilidade de temperatura e pressão e à ausência de deriva anormal do volume da caixa antes de serem incluídas nas análises subsequentes. Todos os arquivos de entrada, estruturas dos receptores, arquivos de topologia dos ligantes, arquivos de configuração de encaixe, arquivos de parâmetros de dinâmica molecular e registros de seleção de quadros do MM-PBSA foram arquivados para apoiar a reprodutibilidade computacional.
Resultados
Previsão de alvos associados a compostos e identificação de alvos comuns
A previsão reversa de alvos para os Compostos 1–3 gerou 212 alvos humanos potenciais. Paralelamente, a recuperação de alvos associados à doença a partir do GeneCards, utilizando a palavra-chave “câncer de pulmão H1299” e um limiar de pontuação de relevância superior a 0,27, identificou 188 alvos associados ao CPMN. A análise de interseção entre os alvos previstos pelos compostos e o conjunto de alvos associados à doença revelou 21 alvos comuns, que foram mantidos para todas as análises subsequentes. A sobreposição entre os dois conjuntos de alvos é mostrada na Figura 2. Esses resultados indicam que os compostos em estudo convergiram para um subconjunto restrito de alvos relevantes para a doença, em vez de um espaço alvo difuso e inespecífico.
Análise de interação entre proteínas e triagem de alvos centrais
Os 21 alvos interseccionados foram importados para o STRING a fim de construir uma rede de interação proteína-proteína (PPI). A rede resultante continha 21 nós e 116 arestas. Os valores de grau dos nós na Tabela Suplementar 1 somam 232, consistente com 116 arestas não direcionadas. Os valores de centralidade foram calculados para esta rede original. O grau mediano foi 12; a aplicação de grau ≥ 12 manteve 13 candidatos. Dentre esses 13 candidatos, a centralidade de intermediação mediana foi 0,031293 e a centralidade de proximidade mediana foi 0,769231. Aplicando-se centralidade de intermediação ≥ 0,031293 juntamente com centralidade de proximidade > 0,769231 priorizou cinco candidatos a hub: AKT1, EGFR, TNF, MMP9 e SRC. Os valores apresentados para os subconjuntos mantidos são as métricas de centralidade da rede original de 21 nós, mantidas durante o processo de filtragem; eles não foram recalculados para sub-redes de 13 ou 5 nós. Sua centralidade na rede foi utilizada apenas para classificar os candidatos para avaliação subsequente baseada em estrutura e não deve ser interpretada como evidência de que sejam alvos biológicos dos compostos. Tabela Suplementar 1, Tabela Suplementar 2, e Tabela Suplementar 3 relatam as métricas para a rede inicial de 21 nós, os 13 candidatos mantidos após a primeira etapa de triagem e os cinco candidatos a hub finais, respectivamente. A triagem sequencial da rede de interação proteína-proteína e os cinco candidatos a hub finais são mostrados em Figura 3A, Figura 3B, Figura 3C, e Figura 3D.
Análise de enriquecimento da Ontologia Genética e da Enciclopédia de Kyoto de Genes e Genomas
A análise de enriquecimento funcional dos 21 alvos com interseção identificou 121 vias KEGG que atenderam aos critérios nominais de inclusão de p < 0,10. As 20 vias com as classificações mais altas são mostradas na Figura 4A. Dentre essas, resistência endócrina, vias do câncer, proteoglicanos no câncer, resistência ao inibidor da tirosina quinase do EGFR e via de sinalização ErbB foram particularmente proeminentes. Essas vias estão estreitamente relacionadas à proliferação tumoral, sobrevivência, invasão e resistência ao tratamento no CCRP. As estatísticas completas de enriquecimento para as 121 vias KEGG mantidas que atenderam ao valor nominal de p < 0,10 são fornecidas na Tabela Suplementar 4.
A análise de enriquecimento de GO identificou ainda 177 termos BP, 29 termos CC e 61 termos MF que atendem ao mesmo valor nominal p < 0,10 critério de inclusão. Os 10 termos com classificação mais alta de cada categoria são apresentados em Figura 4B, Figura 4C, e Figura 4D. Os principais processos biológicos incluíram a regulação positiva da proliferação de células musculares lisas associadas aos vasos sanguíneos, a transição G2/M do ciclo celular mitótico, o sinalização via receptor de fator de crescimento semelhante à insulina, fosforilação de proteínas, regulação negativa da apoptose e transdução de sinal. Os principais termos relacionados a componentes celulares foram núcleo, rafts de membrana, adesão focal, membrana plasmática e região telomérica do cromossomo. Em contraste, os principais termos de função molecular mostrados em Figura 4D atividade de proteína quinase, atividade de proteína serina quinase, ligação ao ATP, atividade de proteína serina/treonina quinase, atividade de proteína tirosina quinase, atividade de quinase da repetição de heptapeptídeo CTD da RNA polimerase II, atividade de quinase, atividade de quinase da histona H2AXY142, atividade de quinase da histona H3Y41 e ligação a proteína idêntica. As estatísticas completas de enriquecimento para BP, CC e MF são fornecidas em Tabela Suplementar 5, Tabela Suplementar 6, e Tabela Suplementar 7Em conjunto, esses resultados de enriquecimento indicam que o conjunto alvo comum está concentrado em processos de sinalização, regulação da sobrevivência e resposta oncogênica relevantes para a progressão do CCRP.
Ordenação baseada em docking molecular de complexos metabólito-alvo
Foi realizado um encaixe molecular entre o Composto 4 e o Composto 5 e as cinco proteínas priorizadas pela topologia da rede. Os valores relatados na Tabela 1 são pontuações de encaixe do AutoDock Vina e não correspondem à energia livre de ligação medida experimentalmente. O Composto 5 produziu a pontuação individual mais favorável com MMP9 (-8,418 kcal·mol⁻1), seguido pelo Composto 4 com MMP9 (-7,840 kcal·mol⁻1). O Composto 5 também obteve pontuações mais favoráveis do que o Composto 4 para AKT1 e EGFR, enquanto o Composto 4 obteve pontuações ligeiramente mais favoráveis para SRC (-6,549 versus -6,204 kcal·mol⁻1) e TNF (-5,436 versus -5,299 kcal·mol⁻1). Assim, o Composto 5 não apresentou uma vantagem uniforme nas pontuações em todas as cinco proteínas. Os resultados do encaixe foram utilizados apenas para priorizar complexos representativos para análises estruturais adicionais.
Conformações representativas de docking são mostradas na Figura 5. No mapa de interação MMP9–Composto 5 com classificação mais alta, os contatos exibidos estavam localizados próximos a Ala417 e Pro421, com distâncias de aproximadamente 3,0 Å e 2,4 Å, respectivamente. Nenhuma coordenação direta entre o Composto 5 e o ZN2⁺ foi anotada no mapa de interação da melhor posição retida, e nenhum contato direto com His401, Glu402, His405 ou His411 foi observado. Isso contrasta com a referência cristalográfica 1GKC, na qual His401, His405 e His411 coordenam o ZN2⁺ catalítico em distâncias de 2,21, 2,23 e 2,22 Å, respectivamente, e o inibidor tipo hidroxamato reverso NFH coordena o mesmo ZN2⁺ por meio de dois átomos de oxigênio em 2,07 e 2,38 Å. Como a coordenação direta entre o Composto 5 e o ZN2⁺ não foi anotada no mapa de interação retido, nenhuma distância de coordenação Composto 5-ZN2⁺ foi atribuída; isso é interpretado como ausência de coordenação direta demonstrada no mapa retido, e não como um valor medido de separação metálica. Uma comparação tridimensional com a referência cristalográfica MMP9–NFH é apresentada na Figura Suplementar 1. Assim, a geometria difere de um modo de ligação inibitória canônico dependente de zinco, e o presente resultado de docking não sustenta a classificação do Composto 5 como um inibidor de MMP9. A MMP9 foi mantida para análise de dinâmica molecular apenas para determinar se essa geometria de docking não canônica específica persistiu durante a trajetória. Para os demais complexos, o Composto 5 mostrou contatos previstos com AKT1 e SRC, enquanto o Composto 4 também formou interações definidas de docking com MMP9 e SRC. De acordo com a Figura 5F, essas observações descrevem interações previstas e pontuações relativas de docking, não afinidades verificadas experimentalmente.
Três complexos foram selecionados para análise por MD com finalidades comparativas, e não confirmatórias. O complexo MMP9–Composto 5 foi selecionado porque apresentou a pontuação de docking mais favorável, mas com uma conformação não canônica da MMP9 que exigia acompanhamento estrutural cauteloso. O complexo SRC–Composto 5 foi escolhido como segundo candidato, e o complexo SRC–Composto 6 foi incluído como trajetória de controle correspondente sem aprisionamento. As conformações iniciais correspondentes são mostradas na Figura 6A, Figura 6B, e Figura 6C. Esse delineamento permitiu a comparação da persistência das geometrias de docking selecionadas, sem considerar a estabilidade na MD como evidência de interação com o alvo ou regulação funcional.
Análise de dinâmica molecular
Para comparar a persistência de geometrias selecionadas derivadas do docking sob condições aquosas dinâmicas, foram geradas trajetórias de 150 ns de dinâmica molecular (MD) para os complexos MMP9–Composto 5 e SRC (PDB 2H8H)–Composto 5, incluindo SRC (PDB 2H8H)–Composto 6 como trajetória de controle negativo pareado. As conformações iniciais são mostradas na Figura 6A, Figura 6B, e Figura 6C. Ao longo dessas trajetórias, o Composto 5 apresentou menor RMSD do ligante (Figura 6D) nos sistemas MMP9 e SRC do que o Composto 6 no SRC. A trajetória MMP9–Composto 5 atingiu um regime comparativamente com baixa flutuação, a trajetória SRC–Composto 5 estabilizou-se após um período inicial de ajuste, e a trajetória SRC–Composto 6 exibiu flutuações maiores. Essas diferenças indicam maior persistência das poses de docking selecionadas para o Composto 5 durante a MD. Elas não demonstram que o Composto 5 se liga ao MMP9 ou ao SRC em células, e a trajetória do MMP9 não supera a ausência de uma interação canônica com o Zn2⁺ catalítico na pose inicial.
O RMSD da estrutura principal da proteína mostrou um padrão comparativo semelhante. A trajetória de MMP9–Composto 5 entrou em um regime relativamente estável da estrutura principal após aproximadamente 30 ns, enquanto a trajetória de SRC–Composto 5 apresentou uma platô mais tardio, e a trajetória de SRC–Composto 6 exibiu flutuações maiores. Essas observações descrevem apenas o comportamento das trajetórias. Uma trajetória estável da estrutura principal da proteína ou do ligante não pode comprovar a ocupação do alvo intracelular, inibição da enzima ou modulação da sinalização. Os perfis de RMSD da estrutura principal da proteína para os três sistemas estão apresentados na Figura Suplementar 2.
Análise de trajetória
As análises de ocupação de ligação de hidrogênio e flutuação de resíduos foram utilizadas para descrever a persistência de contato nas trajetórias de dinâmica molecular (Figura 7A). O composto 5 apresentou uma ligação de hidrogênio de alta ocupação com Arg95 na trajetória de MMP9 (>85%) e uma interação recorrente com Leu325 na trajetória de SRC (>70%), enquanto os contatos representativos no controle SRC–Composto 6 apresentaram ocupações mais baixas. Esses resíduos não são apresentados como evidência de modulação funcional do alvo; os valores de ocupação indicam apenas com que frequência os contatos especificados ocorreram durante as trajetórias analisadas.
A análise de RMSF dos resíduos da bolsa de ligação revelou diferenças específicas do sistema na flexibilidade local (Figura 7B). A trajetória da SRC–Composto 6 exibiu várias flutuações locais maiores do que a trajetória da SRC–Composto 5, enquanto a trajetória da MMP9–Composto 5 mostrou um perfil de flutuação comparativamente restrito dentro de seu próprio conjunto de resíduos da bolsa de ligação. Como MMP9 e SRC são proteínas diferentes, seus valores de RMSF em nível de resíduo não foram interpretados como uma comparação direta resíduo a resíduo. Juntamente com a ocupação de ligação de hidrogênio, esses resultados caracterizam a persistência do contato e a flexibilidade local, ajudando a priorizar complexos para testes experimentais. Eles não estabelecem MMP9 ou SRC como alvos intracelulares nem demonstram que qualquer uma das proteínas media o fenótipo anticâncer dos compostos.
Cálculo da energia livre de ligação por área de superfície de Poisson-Boltzmann na mecânica molecular
As estimativas de MM-PBSA calculadas a partir dos segmentos da trajetória equilibrada são mostradas na Figura 8. O complexo MMP9–Composto 5 apresentou uma estimativa de ΔG_bind de -19,65 ± 6,43 kcal·mol⁻1, o complexo SRC–Composto 5 apresentou -17,72 ± 6,84 kcal·mol⁻1, e o controle SRC–Composto 6 apresentou -10,37 ± 5,61 kcal·mol⁻1. Neste protocolo computacional, a classificação energética relativa foi, portanto, MMP9–Composto 5, seguida por SRC–Composto 5 e SRC–Composto 6. Esses valores são estimativas dependentes do método derivadas de um segmento finito de trajetória, e nenhuma correção de entropia foi aplicada. Eles foram, portanto, utilizados apenas para comparação dentro do estudo e não devem ser interpretados como afinidades de ligação medidas experimentalmente ou como evidência de modulação funcional da proteína.
Em análises de docking, MD, ocupação de contato, flutuação de resíduos e MM-PBSA, o Composto 5 foi priorizado computacionalmente para acompanhamento nos complexos MMP9 e SRC. A convergência entre esses cálculos reforça a justificativa para escolher esses pares para experimentos subsequentes, mas não valida MMP9 ou SRC como alvos intracelulares diretos. Em particular, a conformação não canônica do MMP9 e a ausência de coordenação demonstrada com o ZN2⁺ catalítico impedem a inferência de um mecanismo inibitório canônico do MMP9 a partir dos dados estruturais atuais.
Conclusões derivadas dos resultados
O fluxo de trabalho computacional priorizou 21 alvos associados a doenças sobrepostas e identificou AKT1, EGFR, TNF, MMP9 e SRC como candidatos a hubs topológicos. Análises baseadas na estrutura priorizaram ainda o Composto 5 para acompanhamento experimental nos complexos MMP9 e SRC. Esses achados não demonstram engajamento direto com os alvos, inibição de MMP9 ou SRC, regulação de vias ou uma conexão mecanicista causal entre interações proteicas e o efeito previamente estabelecido de aprisionamento de sítios abásicos. O estudo, portanto, apoia um conjunto de hipóteses computacionais testáveis, em vez de um mecanismo anti-NSCLC multialvo experimentalmente comprovado.
DISPONIBILIDADE DE DADOS:
O conjunto de dados que sustenta as descobertas deste estudo está publicamente disponível em Wang X, Peng Z, Xing Y, Xue L. Priorização in silico de interações proteicas potenciais para pró-fármacos ativados por sítios abásicos e responsivos ao glutationato no câncer de pulmão de não pequenas células [conjunto de dados]. Figshare; 2026. doi:10.6084/m9.figshare.33313620.v1.
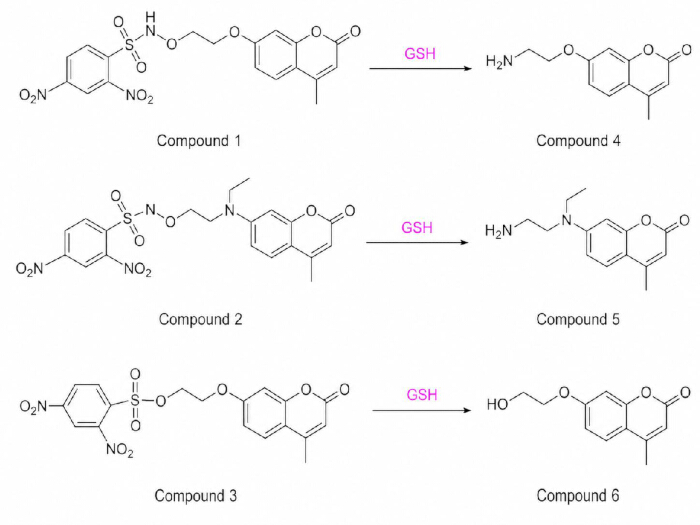
Figura 1: Estruturas químicas e relações de conversão desencadeadas por glutationa dos compostos estudados. O Composto 1 e o Composto 2 são pró-fármacos responsivos à glutationa que liberam os metabólitos contendo grupo aminoxi, Composto 4 e Composto 5, respectivamente. O Composto 3 é um controle estrutural pareado, responsivo à glutationa, que gera o Composto 6, o qual carece da funcionalidade de aprisionamento de sítios apurínicos com grupo aminoxi. Os Compostos 1–3 foram utilizados para predição reversa de alvos, os Compostos 4 e 5 para acoplamento molecular com alvos centrais (hub-target docking), e o Composto 6 como ligante controle negativo na comparação de dinâmica molecular de SRC. Abreviações: SRC, proto-oncogene SRC, tirosina quinase não receptora. Clique aqui para visualizar uma versão ampliada desta figura.
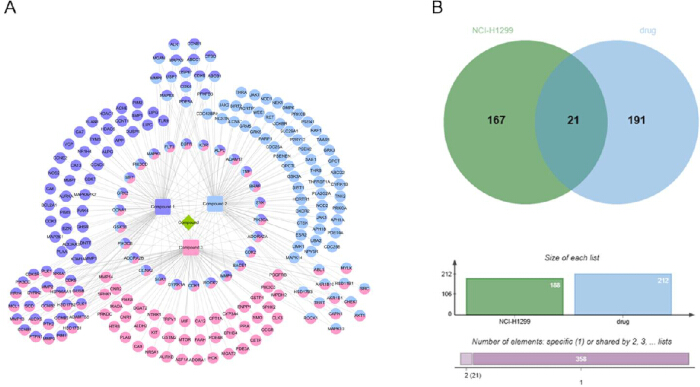
Figura 2: Interseção entre os alvos previstos pelos compostos e os alvos associados ao câncer de pulmão de células não pequenas. (A) Rede composto-alvo gerada a partir dos resultados da previsão reversa de alvos para os Compostos 1–3. (B) Diagrama de Venn mostrando a sobreposição entre os alvos previstos pelos compostos e os alvos associados à doença obtidos por meio da consulta com o câncer de pulmão H1299. Os 21 alvos comuns foram mantidos para análise de interação proteína-proteína, análise de enriquecimento e posterior priorização baseada em estrutura. Clique aqui para visualizar uma versão maior desta figura.
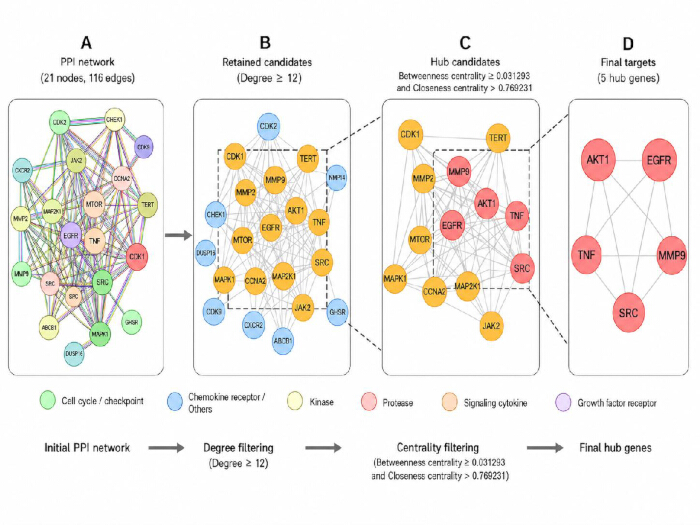
Figura 3: Rede de interação proteína-proteína e triagem de alvos centrais. (A) Rede de interação proteína-proteína dos 21 alvos com intersecção (116 conexões). (B) Primeira etapa de triagem utilizando Grau ≥ 12, que manteve 13 candidatos. (C) Segunda triagem dos 13 candidatos mantidos utilizando centralidade de intermediação ≥ 0,031293 e centralidade de proximidade > 0,769231, resultando em cinco candidatos centrais. (D) Os cinco candidatos centrais finais: AKT1, EGFR, TNF, MMP9 e SRC. Os valores de centralidade utilizados nos filtros sequenciais foram calculados na rede original de 21 nós e 116 conexões e mantidos, em vez de recalculados após a formação de cada subconjunto. Abreviações: AKT1, quinase serina/treonina AKT 1; EGFR, receptor do fator de crescimento epidérmico; TNF, fator de necrose tumoral; MMP9, metaloproteinase da matriz 9; SRC, proto-oncogene SRC, tirosina quinase não receptora. Clique aqui para visualizar uma versão maior desta figura.
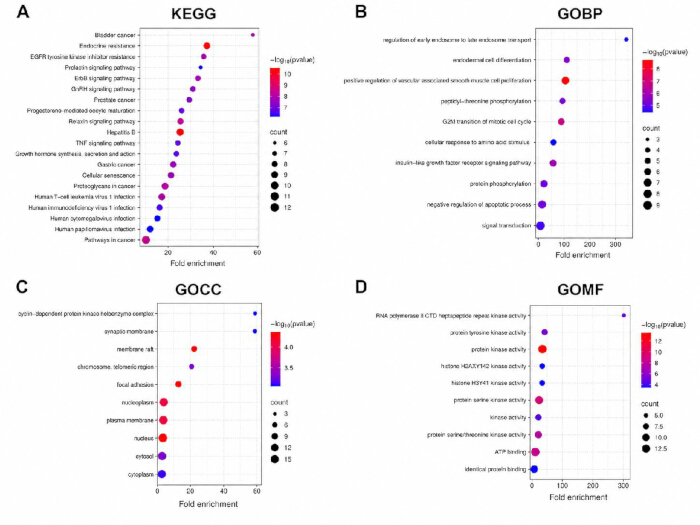
Figura 4: Análise de enriquecimento funcional dos alvos em interseção. (A) Gráfico de bolhas com os 20 principais caminhos enriquecidos do Kyoto Encyclopedia of Genes and Genomes. (B) Gráfico de barras com os 10 principais termos enriquecidos do processo biológico do Gene Ontology. (C) Gráfico de barras com os 10 principais termos enriquecidos do componente celular do Gene Ontology. (D) Gráfico de barras com os 10 principais termos enriquecidos da função molecular do Gene Ontology. O enriquecimento relativo é mostrado no eixo x na visualização final; o tamanho das bolhas no painel A reflete a contagem de genes. Todas as entradas subjacentes do KEGG e GO incluídas nas Tabelas Suplementares 4–7 atenderam ao critério nominal de inclusão de p < 0,10; os caminhos/termos plotados foram os com os menores valores nominais de p. Os valores ajustados para múltiplos testes são apresentados nas tabelas suplementares, mas não foram utilizados para inclusão. Clique aqui para visualizar uma versão maior desta figura.
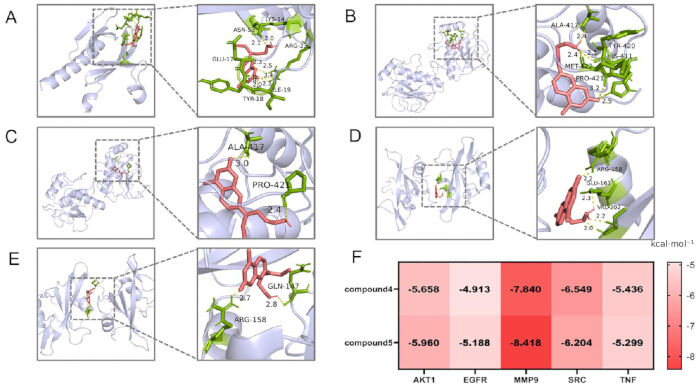
Figura 5: Posições de encaixe molecular e pontuações do AutoDock Vina do Composto 4 e Composto 5 com as proteínas priorizadas. (A) Posição prevista de encaixe do Composto 5 com AKT1. (B) Posição prevista de encaixe do Composto 4 com MMP9. (C) Posição prevista com maior classificação do Composto 5 com MMP9; os contatos exibidos estão próximos a Ala417 e Pro421, enquanto nenhuma coordenação direta com o ZN2⁺ catalítico ou contato direto com His401, Glu402, His405 ou His411 é anotado. A posição, portanto, não é apresentada como um modo de ligação inibitório canônico de MMP9. Uma comparação de referência com o mapa de interações da estrutura cristalográfica de MMP9 ligada ao NFH (PDB 1GKC), incluindo as distâncias de coordenação cristalográficas do ZN2⁺, é fornecida na Figura Suplementar 3. (D) Posição prevista de encaixe do Composto 4 com SRC. (E) Posição prevista de encaixe do Composto 5 com SRC. (F) Mapa de calor das pontuações de encaixe do AutoDock Vina (kcal·mol⁻1) do Composto 4 e Composto 5 frente às cinco proteínas priorizadas. Valores mais negativos indicam pontuações Vina mais favoráveis dentro deste protocolo de encaixe; eles não são afinidades de ligação medidas experimentalmente. Abreviações: AKT1, quinase serina/treonina AKT 1; MMP9, metaloproteinase da matriz 9; NFH, N2-[(2R)-2-{[formil(hidroxi)amino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinamida; SRC, proto-oncogene SRC, tirosina quinase não receptora; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, histidina; e Glu, glutamato. Clique aqui para visualizar uma versão maior desta figura.
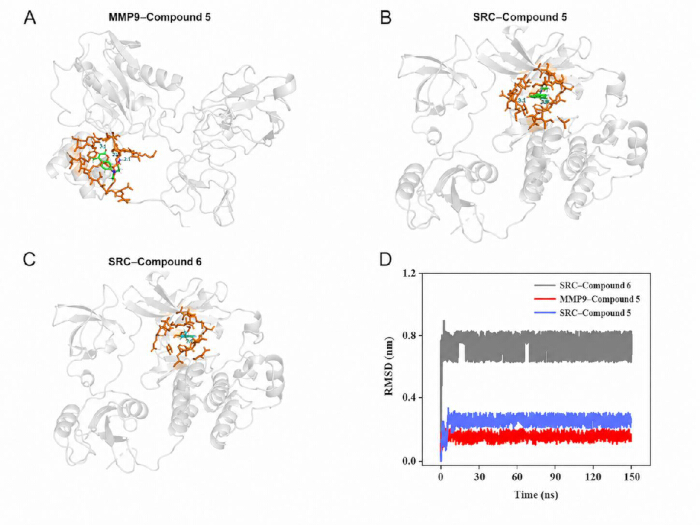
Figura 6: Visão estrutural geral e análise da estabilidade do ligante dos complexos de dinâmica molecular (MD). (A) Conformação inicial do acoplamento do Composto 5 com MMP9, utilizada como estrutura inicial para a dinâmica molecular (MD). (B) Conformação inicial do acoplamento do Composto 5 com SRC (PDB 2H8H). (C) Conformação inicial do acoplamento do Composto 6 com SRC (PDB 2H8H); o Composto 6 é o produto da clivagem da glutationa do Composto 3 controle e não possui a funcionalidade de aprisionamento do sítio abásico aminooxi. (D) Desvio quadrático médio (RMSD) do ligante em relação à pose inicial de acoplamento ao longo das trajetórias de 150 ns para MMP9–Composto 5, SRC–Composto 5 e SRC–Composto 6. O painel compara a persistência da pose durante a dinâmica molecular (MD) e não demonstra o engajamento do alvo intracelular. Abreviaturas: MD, dinâmica molecular; MMP9, metaloproteinase 9 da matriz; SRC, proto-oncogene SRC, tirosina quinase não receptora; PDB, Protein Data Bank; RMSD, desvio quadrático médio. Clique aqui para visualizar uma versão maior desta figura.
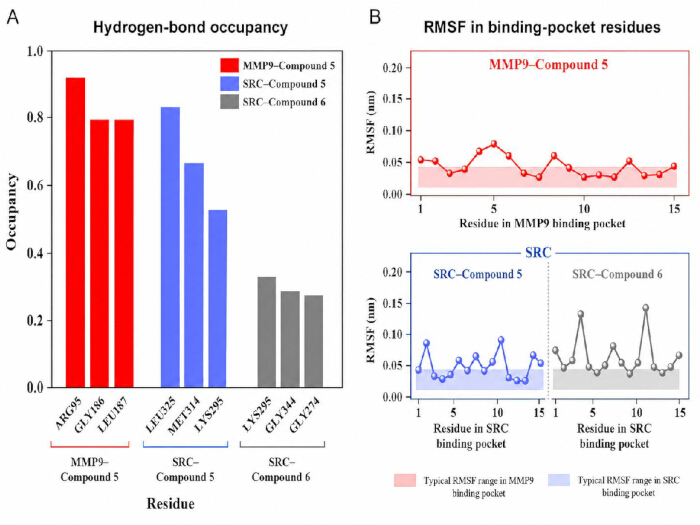
Figura 7: Características de interação dinâmica durante a análise de dinâmica molecular. (A) Ocupação de ligações de hidrogênio representativas entre ligante e proteína ao longo das trajetórias de 150 ns para MMP9–Composto 5, SRC–Composto 5 e SRC–Composto 6. (B) Flutuação quadrática média dos resíduos da bolsa de ligação. O perfil de MMP9 é interpretado dentro do sistema MMP9, enquanto os perfis de SRC–Composto 5 e SRC–Composto 6 fornecem uma comparação direta e equivalente dentro de SRC. Essas análises descrevem a persistência de contatos e a flexibilidade local durante a DM e não demonstram engajamento intracelular do alvo ou modulação funcional de MMP9 ou SRC. Abreviaturas: DM, dinâmica molecular; MMP9, metaloproteinase da matriz 9; SRC, proto-oncogene SRC, tirosina quinase não receptora; RMSF, flutuação quadrática média. Clique aqui para visualizar uma versão ampliada desta figura.
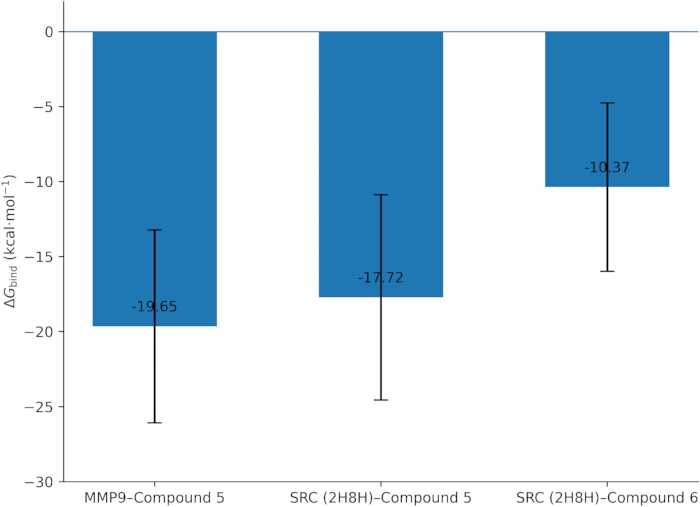
Figura 8: Estimativas energéticas por método mecânico-molecular de área superficial de Poisson-Boltzmann para os complexos analisados. Valores estimados de ΔG_bind obtidos pelo método de mecânica molecular com área superficial de Poisson-Boltzmann a partir dos segmentos de trajetória equilibrados dos complexos MMP9–Composto 5, SRC (PDB 2H8H)–Composto 5 e SRC (PDB 2H8H)–Composto 6. Os valores são apresentados como média ± desvio padrão e são utilizados para comparação relativa dentro do estudo, e não como afinidades de ligação medidas experimentalmente. A Figura 8 utiliza o rótulo do eixo y ΔG_bind (kcal·mol⁻1), consistente com a equação e a terminologia usadas nos Métodos e Resultados. Abreviações: MMP9, metaloproteinase da matriz 9; SRC, proto-oncogene SRC, tirosina quinase não receptora; PDB, Protein Data Bank; ΔG_bind, energia livre de ligação; MM-PBSA, mecânica molecular com área superficial de Poisson-Boltzmann. Clique aqui para visualizar uma versão maior desta figura.
| Composto | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| Composto 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| Composto 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
Tabela 1: Pontuações de encaixe do AutoDock Vina para o Composto 4 e o Composto 5 frente às cinco proteínas prioritárias. Pontuações de encaixe do AutoDock Vina (kcal·mol⁻1) para o Composto 4 e o Composto 5 com AKT1, EGFR, MMP9, SRC e TNF. Valores mais negativos indicam pontuações mais favoráveis dentro do protocolo de encaixe especificado. Esses valores são pontuações computacionais e não devem ser descritos como energias livres de ligação ou afinidades medidas experimentalmente. Abreviações: AKT1, quinase serina/treonina AKT 1; EGFR, receptor do fator de crescimento epidérmico; MMP9, metaloproteinase da matriz 9; SRC, proto-oncogene SRC, tirosina quinase não receptora; TNF, fator de necrose tumoral.
Figura Suplementar 1: Comparação estrutural da referência cristalográfica MMP9–NFH e da posição de encaixe (docking) do Composto 5 melhor classificada. (A) Ambiente do ZN2⁺ catalítico do complexo de referência MMP9–NFH (PDB 1GKC), mostrando His401, His405, His411, Glu402 e as distâncias de coordenação do NFH exibidas. (B) Posição de encaixe do Composto 5 melhor classificada, mostrando os contatos com Ala417 e Pro421 exibidos. (C) Vista tridimensional alternativa da mesma posição de encaixe do Composto 5. A comparação é fornecida como referência estrutural e não estabelece inibição da MMP9. Abreviaturas: MMP9, metaloproteinase da matriz 9; NFH, N2-[(2R)-2-{[formil(hidroxi)amino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinamida; PDB, Banco de Dados de Proteínas; Ala, alanina; Pro, prolina; His, histidina; Glu, glutamato.Clique aqui para baixar este arquivo.
Figura Suplementar 2: Desvio quadrático médio do esqueleto proteico durante a análise de dinâmica molecular. Perfis de desvio quadrático médio do esqueleto proteico para os sistemas MMP9–Composto 5, SRC (PDB 2H8H)–Composto 5 e SRC (PDB 2H8H)–Composto 6 ao longo das trajetórias completas de dinâmica molecular. O gráfico final utiliza as denominações padronizadas MMP9–Composto 5, SRC–Composto 5 e SRC–Composto 6, com os eixos indicados como RMSD (nm) e Tempo (ns). Os perfis descrevem o comportamento conformacional dependente do tempo durante a DM e não devem ser interpretados como evidência de ligação celular ou regulação proteica. Abreviações: MMP9, metaloproteinase da matriz 9; SRC, proto-oncogene SRC, tirosina quinase não receptora; PDB, Protein Data Bank; RMSD, desvio quadrático médio; DM, dinâmica molecular.Clique aqui para baixar este arquivo.
Figura Suplementar 3: Comparação do ambiente do ZN2⁺ catalítico da MMP9 no complexo de referência 1GKC-NFH e na posição de acoplamento do Composto 5 mais bem classificada. No complexo de referência cristalográfico MMP9–NFH (PDB 1GKC), His401, His405 e His411 coordenam o ZN2⁺ catalítico a distâncias de 2,21, 2,23 e 2,22 Å, respectivamente, e dois átomos de oxigênio do NFH coordenam o ZN2⁺ a 2,07 e 2,38 Å; Glu402 é o resíduo ácido/base catalítico. Em contraste, o mapa de interações mantido do Composto 5 mais bem classificado exibe contatos com Ala417 (3,0 Å) e Pro421 (2,4 Å), mas sem coordenação direta anotada com o ZN2⁺ ou contatos diretos com His401, Glu402, His405 ou His411. Consequentemente, nenhuma distância de coordenação entre o Composto 5 e o ZN2⁺ foi atribuída. Essa comparação apoia a classificação da posição do Composto 5 como uma associação prevista não canônica, ao invés de um modo de ligação inibitório canônico dependente de zinco. Abreviações: MMP9, metaloproteinase da matriz 9; PDB, Banco de Dados de Proteínas; Ala, alanina; Pro, prolina; His, histidina; Glu, glutamato.Clique aqui para baixar este arquivo.
Tabela Suplementar 1: Métricas topológicas para a rede inicial de interação proteína-proteína com 21 nós e 116 arestas. Parâmetros topológicos para todos os 21 nós-alvo interseccionantes antes da triagem baseada em centralidade, incluindo comprimento médio do caminho mais curto, centralidade de intermediação, centralidade de proximidade, coeficiente de agrupamento, grau, excentricidade, conectividade do vizinhança, radialidade, estresse e coeficiente topológico. A soma dos graus dos nós é 232, o que corresponde a 116 arestas não direcionadas.Clique aqui para baixar este arquivo.
Tabela Suplementar 2: Métricas topológicas da rede original para os 13 candidatos mantidos após a triagem baseada em grau. Parâmetros topológicos para os 13 nós mantidos após a aplicação do critério de grau à rede inicial de 21 nós e 116 arestas. Esses valores são as métricas da rede original de 21 nós e 116 arestas, mantidas para a etapa subsequente de filtragem por centralidade de intermediação e centralidade de proximidade; eles não foram recalculados em uma sub-rede de 13 nós.Clique aqui para baixar este arquivo.
Tabela Suplementar 3: Métricas topológicas da rede original para os cinco candidatos a hub finais mantidos após filtragem sequencial. Parâmetros topológicos da rede original de 21 nós e 116 arestas para os cinco candidatos a hub finais, AKT1, EGFR, TNF, MMP9 e SRC, mantidos após filtragem sequencial. Esses valores mantidos servem apenas para priorização baseada em rede e não representam métricas recalculadas em uma sub-rede de cinco nós nem estabelecem as proteínas como alvos terapêuticos validados experimentalmente. Abreviações: AKT1, quinase serina/treonina AKT 1; EGFR, receptor do fator de crescimento epidérmico; TNF, fator de necrose tumoral; MMP9, metaloproteinase da matriz 9; SRC, proto-oncogene SRC, tirosina quinase não receptora.Clique aqui para baixar este arquivo.
Tabela Suplementar 4: Resultados completos do enriquecimento do Kyoto Encyclopedia of Genes and Genomes para 121 vias que atenderam ao critério nominal de inclusão p < 0,10. Estatísticas completas de enriquecimento do Kyoto Encyclopedia of Genes and Genomes para todas as 121 vias mantidas entre os 21 alvos em interseção (valor nominal p < 0,10), incluindo razão gênica, contagens de genes, totais da lista, acertos na população, totais da população, valores de p, valores de Benjamini, enriquecimento relativo, valores de Bonferroni, taxas de falsa descoberta e valores do teste exato de Fisher. As 20 vias com as classificações mais altas são visualizadas na Figura 4A. O critério de valor nominal de p definiu a inclusão; os valores de Benjamini, Bonferroni e taxa de falsa descoberta são fornecidos por transparência e não foram utilizados para definir o conjunto mantido.Clique aqui para baixar este arquivo.
Tabela Suplementar 5: Resultados completos do enriquecimento de processos biológicos da Ontologia Genética (177 termos que atenderam ao critério nominal de p < 0,10). Estatísticas completas de enriquecimento para os 177 termos de processos biológicos da Ontologia Genética mantidos (p nominal < 0,10), incluindo razão gênica, contagem de genes, total da lista, acertos na população, total da população, valor de p, valor de Benjamini, enriquecimento relativo, valor de Bonferroni, taxa de falsa descoberta e valor do teste exato de Fisher. Os 10 termos com as classificações mais altas são visualizados na Figura 4B. O critério do valor nominal de p definiu a inclusão; os valores ajustados são apresentados para transparência e não foram utilizados para definir o conjunto mantido.Clique aqui para baixar este arquivo.
Tabela Suplementar 6: Resultados completos do enriquecimento de componentes celulares da Ontologia Genética (29 termos que atenderam ao critério nominal de p < 0,10). Estatísticas completas de enriquecimento para os 29 termos mantidos de componentes celulares da Ontologia Genética (valor nominal de p < 0,10), incluindo razão gênica, contagem de genes, total da lista, acertos na população, total da população, valor de p, valor de Benjamini, enriquecimento relativo, valor de Bonferroni, taxa de falsa descoberta e valor do teste exato de Fisher. Os 10 termos com as classificações mais altas são visualizados na Figura 4C. O critério de valor de p nominal definiu a inclusão; valores ajustados são apresentados por transparência e não foram utilizados para definir o conjunto mantido.Clique aqui para baixar este arquivo.
Tabela Suplementar 7: Resultados completos do enriquecimento da função molecular da Ontologia Genética (61 termos que atenderam ao critério nominal de p < 0,10). Estatísticas completas de enriquecimento para os 61 termos mantidos da função molecular da Ontologia Genética (valor nominal de p < 0,10), incluindo razão gênica, contagem de genes, total da lista, acertos na população, total da população, valor de p, valor de Benjamini, enriquecimento relativo, valor de Bonferroni, taxa de falsa descoberta e valor do teste exato de Fisher. Os 10 termos com as classificações mais altas são visualizados na Figura 4D. O critério do valor nominal de p definiu a inclusão; os valores ajustados são apresentados para transparência e não foram utilizados para definir o conjunto mantido.Clique aqui para baixar este arquivo.
Discussão
O presente estudo deve ser interpretado dentro de uma estrutura mecanicista de dois níveis. O primeiro nível é apoiado por trabalhos experimentais anteriores: a ativação sensível à glutationa libera uma espécie contendo aminooxi que pode capturar sítios apurínicos aldeídicos, e a classe de compostos demonstrou citotoxicidade seletiva, efeitos no ciclo celular e apoptose em células H1299. O segundo nível é exploratório e constitui o foco do trabalho atual: previsões computacionais de alvos e análises baseadas em estrutura sugerem que a mesma série química também pode ser compatível com proteínas associadas ao câncer selecionadas. Nenhum experimento deste estudo demonstra que as interações proteicas previstas ocorram nas células ou que sejam consequências downstream do aprisionamento de sítios apurínicos. Os dois níveis são, portanto, mantidos intencionalmente separados, em vez de serem combinados em um mecanismo multialvo comprovado.
No nível da rede, os 21 alvos interseccionados foram enriquecidos em vias relacionadas ao câncer e à resistência, e AKT1, EGFR, TNF, MMP9 e SRC ocuparam posições centrais na rede de interação proteína-proteína (PPI). Esses resultados são úteis para a priorização de candidatos, mas a centralidade na rede e o enriquecimento não demonstram que um composto interaja fisicamente com uma proteína ou altere uma via. As proteínas centrais devem, portanto, ser consideradas candidatas para validação direcionada. O estabelecimento de um papel funcional exigiria experimentos de perturbação direta ou de interação com o alvo na mesma linhagem celular de CBNP utilizada para medir o fenótipo celular.
A MMP9 ilustra por que essa distinção é importante. O composto 5 apresentou a pontuação de docking mais favorável com a MMP9, mas o mapa de interações da melhor conformação retida não indicou coordenação direta com o íon Zn2+ catalítico nem interação direta com His401, Glu402, His405 ou His411. Na referência cristalográfica 1GKC, His401, His405 e His411 coordenam o Zn2+ a 2,21, 2,23 e 2,22 Å, enquanto os dois átomos de oxigênio do NFH coordenam o Zn2+ a 2,07 e 2,38 Å; Glu402 é o resíduo ácido/base catalítico. O mapa do composto 5, ao contrário, mostrou contatos próximos a Ala417 e Pro421. Figura Suplementar 3 apresenta a comparação dos mapas de interação de referência. Como não foi indicada coordenação direta entre o composto 5 e o Zn2+, nenhuma distância de coordenação entre o composto 5 e o Zn2+ foi atribuída. Assim, o resultado estrutural atual é melhor descrito como uma associação prevista não canônica com a MMP9, e não como evidência de inibição do sítio catalítico. A trajetória subsequente de dinâmica molecular apenas testa se essa conformação específica de docking permanece estável ao longo do tempo; ela não pode transformar uma geometria de docking não canônica em prova de inibição enzimática36,37. A MMP9 deve, portanto, permanecer como candidata a testes bioquímicos, e não como alvo principal ou validado. A MMP9 tem sido amplamente discutida em relação à invasão por câncer, remodelação do microambiente tumoral e estratégias terapêuticas direcionadas à MMP938,39.
O mesmo limite de evidência se aplica à SRC. A trajetória da SRC–Composto 5 exibiu contatos mais persistentes do que o controle SRC–Composto 6, mas a estabilidade em dinâmica molecular não equivale à ocupação do alvo intracelular40,41. O uso do Composto 6 fornece uma comparação apropriada para o produto de clivagem não retentivo e fortalece a comparação estrutural interna, mas não comprova que a funcionalidade aminooxi seja responsável pela ligação à SRC ou que a sinalização da SRC seja alterada nas células. A avaliação direta da quantidade total de SRC, da relação p-SRC/SRC, de marcadores de sinalização downstream e de medidas ortogonais de engajamento do alvo seria necessária para sustentar tal afirmação.
O MM-PBSA fornece igualmente uma estimativa energeticamente relativa para as trajetórias amostradas, em vez de uma medida experimental de afinidade. As estimativas mais favoráveis para MMP9–Composto 5 e SRC–Composto 5 do que para SRC–Composto 6 são consistentes com as observações comparativas das trajetórias, mas os cálculos são sensíveis às conformações amostradas e às aproximações metodológicas, e a análise atual não incluiu uma correção entrópica. Assim, a concordância entre docking, MD e MM-PBSA aumenta apenas a consistência computacional interna; não estabelece a modulação funcional de MMP9 ou SRC.
A relação entre o aprisionamento de sítios apurínicos e as interações proteicas previstas permanece não resolvida. Uma possibilidade é que o esqueleto aminooxi liberado pela glutationa mantenha sua atividade estabelecida de aprisionamento de lesões no DNA, além de ter interações independentes e paralelas com proteínas selecionadas. Outra possibilidade é que algumas interações proteicas previstas não ocorram em concentrações biologicamente relevantes ou não contribuam para o fenótipo. Os dados atuais não conseguem distinguir essas possibilidades. Demonstrar uma conexão mecanicista exigiria a medição simultânea das respostas ao dano no DNA e das alterações nas vias proteicas após o tratamento com o composto, seguida por experimentos de perturbação que demonstrem que a alteração de um alvo candidato modifica o fenótipo anticâncer.
A validação experimental futura deve ser realizada em células H1299, o mesmo modelo celular utilizado na caracterização experimental anterior dessa série química. Uma estratégia em etapas compararia primeiro o Composto 5 com o veículo e o Composto 6 não capturador correspondente, utilizando ensaios de viabilidade, apoptose, ciclo celular, migração/invasão e γH2AX em resposta à concentração, para estabelecer o contexto fenotípico e de dano ao DNA42. Em seguida, a MMP9 deve ser examinada por zimografia de gelatina e análise de expressão proteica, enquanto a sinalização SRC deve ser avaliada por meio da SRC total e da SRC fosforilada na Tyr416, utilizando a razão p-SRC/SRC como leitura principal da sinalização. A associação direta entre o composto e a proteína deve ser avaliada independentemente utilizando um método ortogonal de engajamento do alvo, como ressonância de plasmones de superfície43. Uma interação candidata deve ser considerada apoiada experimentalmente apenas quando a evidência de ligação direta for concordante com a leitura funcional celular correspondente. A perturbação genética ou farmacológica da MMP9 ou SRC forneceria um teste adicional para determinar se algum dos candidatos contribui causalmente para o fenótipo em H1299. Esse enfoque em etapas preserva a distinção entre a atividade de captura em sítios abásicos previamente estabelecida e as hipóteses de interação MMP9/SRC priorizadas computacionalmente, ao mesmo tempo em que define um caminho direto para testes experimentais subsequentes.
Divulgações
Os autores declaram que não possuem interesses financeiros concorrentes nem outros conflitos de interesse relacionados a este trabalho. Os financiadores não tiveram papel no delineamento do estudo; na coleta, análise ou interpretação dos dados; na redação do manuscrito; ou na decisão de publicar os resultados.
Agradecimentos
Este trabalho foi apoiado pelo Projeto Jovem do Departamento de Educação da Província de Liaoning (JYTQN2023441), pelo Projeto de Iniciação de Pesquisa Doutoral do Fundo Conjunto da Província de Liaoning do Departamento de Ciência e Tecnologia (2023-BSBA-151) e pelo Projeto de Apoio a Jovens Talentos Científicos e Tecnológicos da Universidade Médica de Jinzhou (JYQT202305). O ChatGPT (OpenAI) foi utilizado durante a revisão do manuscrito para edição linguística, organização e apoio na revisão. Os autores analisaram e verificaram o conteúdo científico, a interpretação dos dados e a redação final, assumindo total responsabilidade pelo manuscrito.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| ACPYPE | Desenvolvedores do ACPYPE / Bio2Byte | Versão 2023.11.14 | Geração e conversão de arquivos de topologia de ligantes de pequenas moléculas para formato compatível com GROMACS. |
| AmberTools (Antechamber) | Equipe de Desenvolvimento do AMBER | AmberTools 23.3 | Atribuição de cargas parciais AM1-BCC e geração de parâmetros de ligantes com GAFF2. |
| AutoDock Vina | Laboratório Forli, Scripps Research | Versão 1.2.5 | Acoplamento molecular e geração de poses ranqueadas de proteína-ligante. |
| AutoDockTools (MGLTools) | Centro de Biologia Estrutural Computacional, Scripps Research | Versão 1.5.7 | Preparação de receptor e ligante, atribuição de cargas de Gasteiger, definição de ligações rotatóveis e conversão para PDBQT. |
| BIOVIA Discovery Studio Visualizer | Dassault Systèmes BIOVIA | Versão 2025 | Visualização de poses de acoplamento e inspeção de interações proteína-ligante. |
| Campo de força CHARMM36 | Laboratório MacKerell / Desenvolvedores do campo de força CHARMM | CHARMM36 | Parametrização de proteínas para cálculos de dinâmica molecular; o CHARMM36 foi usado consistentemente ao longo do estudo (não o CHARMM36m). |
| Chem3D Ultra (ChemOffice Professional) | Revvity Signals Software | Versão 22.2 | Minimização da energia do ligante utilizando o campo de força MMFF94. |
| Compostos 1–6 | Sintetizados previamente conforme descrito em Li et al., ACS Chemical Biology (2022) | N/A | Pró-fármacos parentais responsivos ao glutatione, produtos liberados e par controle não capturador correspondente usados no fluxo computacional. |
| cytoHubba | Desenvolvedores do cytoHubba / Cytoscape App Store | Versão 0.1 | Análise de grau, centralidade de intermediação e centralidade de proximidade para priorização de alvos centrais. |
| Cytoscape | Consortium Cytoscape | Versão 3.10.0 | Visualização de redes compostos-alvos e interações proteína-proteína (PPI) e análise de topologia. |
| Recursos Bioinformáticos DAVID | Laboratório de Retrovirologia Humana e Imunoinformática, Laboratório Nacional de Câncer de Frederick | Recurso web | Análise de enriquecimento de Ontologia Genética e KEGG; p nominal < 0,10 foi usado como critério exploratório de inclusão; valores ajustados foram relatados, mas não foram usados para definir o conjunto retido. |
| GAFF2 | Equipe de Desenvolvimento do AMBER | GAFF2 | Parametrização do campo de força do ligante. |
| Banco de Dados de Genes Humanos GeneCards | Suite GeneCards / LifeMap Sciences, Inc. / Instituto Weizmann de Ciência | Recurso web | Recuperação de alvos associados à doença usando a consulta 'câncer de pulmão H1299'. |
| gmx_MMPBSA | Equipe de Desenvolvimento do gmx_MMPBSA | Versão 1.6.3 | Cálculos de energia livre de ligação MM-PBSA a partir de trajetórias de dinâmica molecular do GROMACS; 500 quadros foram amostrados de 100,0–149,9 ns em intervalos de 100 ps, excluindo-se o ponto final de 150,0 ns; nenhuma correção de entropia foi aplicada. |
| GROMACS | Equipe de Desenvolvimento do GROMACS | Versão 2024.4 | Geração e análise de trajetórias de dinâmica molecular. |
| Plataforma online de visualização Microbioinfo | Shanghai Newcore Biotechnology Co., Ltd. / Microbioinfo | Recurso web | Geração de gráficos de barras de enriquecimento e gráficos de bolhas. |
| Open Babel | Equipe de Desenvolvimento do Open Babel | Versão 3.1.1 | Conversão de arquivos de estrutura para SMILES canônicos como entrada para o SwissTargetPrediction. |
| PubChem | Centro Nacional de Informação Biotecnológica, Biblioteca Nacional de Medicina dos EUA, NIH | Recurso web | Recuperação de estruturas tridimensionais de ligantes. |
| Sistema Gráfico Molecular PyMOL | Schrödinger, LLC | Versão 2.5.4 | Preparação da proteína, visualização estrutural e inspeção de poses de acoplamento. |
| Banco de Dados de Proteínas RCSB | Colaboratório de Pesquisa em Bioinformática Estrutural (RCSB) | IDs do PDB: 3O96; 5UWD; 2AZ5; 1GKC; 2H8H | Recuperação de estruturas proteicas para AKT1, EGFR, TNF, MMP9 e SRC, respectivamente. |
| STRING | Consortium STRING | Versão 11.5 | Construção de rede de interação proteína-proteína; Homo sapiens; pontuação mínima de interação requerida de 0,400; as métricas de topologia originais correspondem à rede PPI não direcionada com 21 nós e 116 arestas. |
| SwissTargetPrediction | Grupo de Modelagem Molecular, Universidade de Lausanne / Instituto Suíço de Bioinformática SIB | Recurso web | Predição reversa de alvos para os Compostos 1–3; espécie restrita a Homo sapiens. |
| Modelo de água TIP3P | Implementado no GROMACS | TIP3P | Modelo de água explícita com três sítios usado para solvatar complexos proteína-ligante. |
| Venny | BioinfoGP, Centro Nacional de Biotecnología (CNB-CSIC) | Versão 2.1 | Interseção das listas de alvos preditos pelos compostos e associados à doença. |
Referências
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.