Este protocolo apresenta um fluxo de trabalho reprodutível de aprendizado profundo utilizando dados cíclicos multicanal e características projetadas para prever o estado de saúde, a vida útil remanescente e o desempenho de armazenamento de energia de baterias de íon de lítio.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Um Fluxo de Trabalho de Aprendizado Profundo Reprodutível para Prever o Desempenho de Baterias de Íons de Lítio Utilizando Dados de Ciclagem Multicanal
Neste artigo
Resumo
Resumo
Este protocolo apresenta um fluxo de trabalho baseado em aprendizado profundo reproduzível para prever o desempenho de baterias de íon de lítio utilizando dados de ciclagem multicanal. Para superar limitações em modelos baseados em dados existentes relacionadas à integração de informações de múltiplas fontes e representação de características, o método utiliza cinco conjuntos de dados de baterias de acesso público. As entradas incluem sinais operacionais brutos, como tensão, corrente, capacidade, temperatura, resistência interna e eficiência coulombiana e energética, juntamente com características elaboradas, tais como capacidade incremental, tensão diferencial e throughput energético. O protocolo detalha procedimentos padronizados de pré-processamento para construir tensores temporais em nível de bateria ao longo de múltiplas janelas de observação. Para melhorar a reprodutibilidade, o fluxo de trabalho avalia arquiteturas candidatas de redes neurais, incluindo redes neurais profundas, redes neurais convolucionais (CNNs), redes de memória de curto e longo prazo (LSTM), CNN–LSTM e modelos baseados em transformadores, utilizando sementes aleatórias fixas, execuções repetidas de avaliação e rastreamento de ambiente. Resultados representativos demonstraram que a arquitetura CNN–LSTM com dados multicanal integrados e características elaboradas alcançou desempenho preditivo favorável entre os modelos avaliados. A configuração selecionada obteve um erro absoluto médio de 0,024 e um valor de R2 de 0,955 para a estimativa do estado de saúde, mantendo alto desempenho preditivo para a estimativa da vida útil remanescente e da energia descarregável. Análises de ablação e robustez demonstraram ainda a contribuição da integração de características multicanal e a estabilidade do fluxo de trabalho focado em reprodutibilidade ao longo de avaliações repetidas. Esta metodologia padronizada fornece um quadro reprodutível para o gerenciamento do ciclo de vida de baterias e modelagem preditiva sob diversas condições operacionais.
Introdução
As baterias de íons de lítio são fundamentais para a transição global rumo à energia renovável devido à sua alta densidade de energia, vida útil prolongada e baixas taxas de autodescarga em aplicações que vão desde eletrônicos portáteis até sistemas de armazenamento de energia em escala de rede. No entanto, o funcionamento prolongado leva inevitavelmente à degradação gradual da capacidade e ao aumento da resistência interna1. Essa queda de desempenho não apenas reduz a viabilidade econômica, mas também introduz riscos graves à segurança, incluindo a corrida térmica. À medida que a implantação de sistemas de armazenamento de energia em larga escala continua a acelerar, o gerenciamento do ciclo de vida das baterias tornou-se cada vez mais complexo2. Os protocolos tradicionais baseados em monitoramento por limiares e inspeção manual são insuficientes para ambientes operacionais dinâmicos3. Além disso, a dependência de um único parâmetro é inadequada para prever com precisão o estado de saúde (SOH) ou a vida útil remanescente (RUL) sob taxas variáveis de carga-descarga, temperaturas ambientes e variações na tensão de descarga4. Embora o fluxo de trabalho atual tenha sido validado principalmente usando conjuntos de dados de ciclagem controlados em laboratório, a arquitetura multicanal e o quadro de modelagem temporal podem permitir futuras adaptações às condições operacionais dinâmicas encontradas em aplicações de veículos elétricos e em ambientes ambientais variáveis.
A degradação de baterias é um processo eletroquímico altamente complexo e não linear, impulsionado pelo crescimento da interface sólido-eletrólito, perda de lítio ativo e deterioração estrutural dos materiais dos eletrodos. Historicamente, a estimativa de estado tem dependido de modelos de circuito equivalente ou equações diferenciais parciais eletroquímicas-físicas (PDEs)5. Embora esses modelos físicos forneçam informações valiosas sobre mecanismos, eles sofrem com uma sobrecarga computacional substancial e desafios na identificação de parâmetros ao processar sinais acoplados multicanal. Consequentemente, sua implementação em tempo real em sistemas embarcados de gerenciamento de bateria (BMSs) é severamente limitada pela cinética complexa de difusão e variabilidade ambiental sob condições de descarga em alta taxa6. Em contraste, o fluxo de trabalho proposto baseado em aprendizado profundo (DL) concentra a maior parte da demanda computacional na fase de treinamento offline, enquanto o modelo treinado realiza inferência comparativamente rápida durante a implantação. Esse framework pode, portanto, apoiar futuras implementações em BMSs com recursos limitados e ambientes de computação de borda.
Recentemente, abordagens de aprendizado profundo (DL) baseadas em dados surgiram como ferramentas poderosas devido às suas excepcionais capacidades de ajuste não linear. No entanto, as metodologias atuais de DL apresentam duas limitações principais. Primeiro, muitas abordagens baseiam-se principalmente em curvas individuais de degradação de capacidade ou em limiares específicos de descarga de tensão, negligenciando as correlações espaço-temporais inerentes entre respostas cíclicas multicanal, como tensão, corrente e temperatura. Essa limitação reduz a robustez do modelo em cenários operacionais multicondicionais7. Estudos anteriores demonstraram que desprezar os estados térmicos durante operações complexas pode acelerar o acúmulo de erros preditivos8,9. Segundo, existe um desafio persistente de reprodutibilidade no aprendizado de máquina (ML) aplicado. Variações nas condições experimentais, pipelines de pré-processamento insuficientemente descritos e hiperparâmetros arbitrariamente escolhidos para redes neurais frequentemente fazem com que modelos aparentemente robustos falhem durante a validação cruzada entre conjuntos de dados10. Para reduzir o risco de vazamento de informações durante o pré-processamento e a previsão em ciclos iniciais, o fluxo de trabalho proposto obtém fatores de escala de normalização e linhas de base de características derivadas exclusivamente a partir dos conjuntos de dados de treinamento, antes da validação externa e da avaliação cruzada entre conjuntos de dados.
Para abordar essas lacunas críticas, o objetivo geral deste protocolo é apresentar um fluxo de trabalho automatizado e altamente reprodutível baseado em aprendizado profundo (DL) para prever o desempenho de armazenamento de energia de baterias de íon lítio utilizando dados multicanal de ciclagem. A lógica por trás deste método é capturar explicitamente as complexas dependências de longo prazo associadas à degradação da bateria, integrando dados de séries temporais multimodais dentro de uma arquitetura de rede neural de alta dimensionalidade. Uma vantagem fundamental deste protocolo em relação às abordagens baseadas em física e em DL existentes é sua padronização abrangente, que estabelece um pipeline completo abrangendo o pré-processamento de sinais brutos, engenharia de características, treinamento do modelo e avaliação de incerteza. Embora arquiteturas híbridas de redes neurais já tenham sido investigadas anteriormente, o presente fluxo de trabalho enfatiza a integração multicanal padronizada, alinhando variáveis eletroquímicas de ciclagem com características de degradação projetadas dentro de um framework de treinamento focado em reprodutibilidade. Diferentemente de muitos fluxos de trabalho previamente relatados, este protocolo incorpora configurações padronizadas de parâmetros, sementes aleatórias fixas, execuções repetidas de avaliação e rastreamento abrangente do ambiente, a fim de melhorar a reprodutibilidade em diferentes conjuntos de dados de baterias e configurações laboratoriais. Além disso, o fluxo de trabalho compara sistematicamente múltiplas arquiteturas de redes neurais para avaliar a estabilidade preditiva e o desempenho em diferentes configurações de entrada. Nos conjuntos de dados e configurações experimentais avaliados, a arquitetura de rede neural convolucional–memória de curto prazo de longa duração (CNN–LSTM) demonstrou desempenho preditivo favorável em comparação com os modelos CNN isolados e baseados em transformadores avaliados, combinando extração de características locais com modelagem de sequências temporais de longo alcance, mantendo ao mesmo tempo uma complexidade computacional moderada. Este protocolo é especialmente adequado para pesquisadores e engenheiros que buscam desenvolver modelos preditivos reprodutíveis e adaptáveis ao ambiente para o gerenciamento do ciclo de vida de baterias.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
A aprovação ética institucional não foi necessária para este estudo porque a pesquisa utilizou exclusivamente conjuntos de dados públicos de ciclagem de baterias de íon de lítio e não envolveu participantes humanos, sujeitos animais ou amostras biológicas.
1. Aquisição e Organização de Dados
- Adquirir conjuntos de dados de ciclagem multicanal
- Baixe conjuntos de dados de ciclagem de baterias de íon de lítio a partir de repositórios públicos de baterias que contenham registros de carga-descarga. Obtenha os conjuntos de dados CALCE, SANYO, PANASONIC, KOKAM e GOTION diretamente dos repositórios de acesso aberto institucionais ou dos links de identificador de objeto digital correspondentes para manter a consistência da versão do conjunto de dados.
- Selecione amostras de baterias que contenham números completos de ciclos, medições de capacidade e pelo menos uma curva contínua de carga-descarga. Verifique a continuidade confirmando que não ocorra interrupção superior a duas horas dentro de um único ciclo e que ambas as fases — corrente constante e tensão constante — sejam totalmente registradas.
- Filtrar registros brutos de ciclagem
- Filtre os registros brutos de ciclagem para manter amostras contendo medições de temperatura, resistência interna, eficiência coulombiana e eficiência energética. Exclua células de bateria que não possuam esses canais de estado obrigatórios do fluxo de análise, pois a fusão subsequente de características multicanal exige um conjunto completo de variáveis físicas de entrada.
- Remova ciclos que contenham registros incompletos, carimbos de data/hora inconsistentes, procedimentos de teste indefinidos ou condições de término de carga-descarga ambíguas. Defina ciclos anômalos como aqueles que apresentam quedas súbitas de capacidade superiores a 5% entre ciclos adjacentes, medições de tensão fora da faixa operacional específica da química ou intervalos de carimbo de data/hora não monotônicos.
- Construir uma base de dados temporal de baterias
- Organize os registros de ciclagem mantidos em ordem cronológica para construir uma base de dados de séries temporais em nível de bateria.
- Armazene os conjuntos de dados processados usando o formato hierárquico de dados versão 5 (HDF5). Mantenha uma estrutura de diretórios padronizada organizada por fonte do conjunto de dados, sistema químico e identificador individual da célula da bateria.
- Atribua identificadores únicos às células individuais da bateria antes da partição do conjunto de dados. Implemente o agrupamento com base no identificador da célula da bateria durante a divisão treinamento-teste para garantir que todos os ciclos sequenciais de uma única bateria física permaneçam exclusivamente em um único subconjunto do conjunto de dados.
OBSERVAÇÃO: Preserve os conjuntos de dados brutos originais separadamente antes do pré-processamento, normalização, reamostragem ou engenharia de características.
- Definir janelas de observação
- Construa janelas de observação multicanal utilizando os primeiros 50 ciclos, os primeiros 100 ciclos e os primeiros 20% do ciclo de vida total da bateria. Calcule o limite de 20% do ciclo de vida multiplicando o ciclo de vida total antes da degradação de capacidade no fim da vida útil por 0,2.
- Alinhe as medições de tensão, corrente, capacidade, temperatura, resistência interna e eficiência dentro de cada janela de observação antes da construção do tensor.
- Formate a estrutura final de entrada como um tensor tridimensional composto pelo comprimento da janela de observação, 128 pontos de amostragem padronizados intra-ciclo e o conjunto ordenado de características multicanal.
2. Pré-processamento de Dados e Engenharia de Características
- Pré-processar dados brutos de ciclagem
- Realize um pré-processamento uniforme nos conjuntos de dados brutos de ciclagem para padronizar a qualidade dos dados provenientes de todas as fontes de baterias. Execute todos os procedimentos de pré-processamento, sincronização e padronização usando Python 3.10 com a biblioteca Pandas para manipulação de séries temporais e SciPy para interpolação numérica.
- Remova valores atípicos, detecte valores ausentes, calibre os carimbos de tempo, identifique as fases de carga e descarga e normalize as frequências de amostragem antes da análise subsequente. Aplique um método de limiar baseado no escore-Z modificado com critério de rejeição superior a 3,0 para detecção de anomalias.
- Detecte automaticamente valores ausentes por meio da identificação de indicadores NaN em todos os arrays numéricos. Diferencie as fases de carga e descarga de acordo com a polaridade da corrente, atribuindo valores positivos de corrente aos ciclos de carga e valores negativos aos ciclos de descarga.
- Reconstrua segmentos de sinal ausentes usando polinômios interpoladores cúbicos segmentados de Hermite para preservar a dinâmica eletroquímica temporal durante o alinhamento das transições de fase.
- Remostrar curvas de ciclagem
- Remostre as curvas de ciclagem quando forem detectadas variações na densidade de amostragem ou deriva de sinal entre os conjuntos de dados. Dispare a remostragem automatizada sempre que o intervalo entre medições consecutivas se desviar em mais de 10% em relação à frequência mediana de amostragem da fase de ciclagem correspondente.
- Padronize o número de pontos de amostragem em cada ciclo para reduzir variações de gravação específicas à plataforma. Mapeie todas as sequências temporais em uma grade espacial fixa usando interpolação linear unidimensional.
- Comprima ou expanda cada perfil de carga-descarga para exatamente 128 pontos de amostragem equidistantes antes da construção do tensor.
- Normalizar variáveis contínuas
- Normalize todas as variáveis contínuas antes do treinamento do modelo para estabilizar a convergência da rede e reduzir o viés relacionado à escala. Aplique a normalização Min-Max para transformar todas as variáveis contínuas em uma faixa numérica entre 0 e 1.
- Calcule todos os parâmetros de normalização exclusivamente a partir do conjunto de dados de treinamento. Aplique os parâmetros de escala congelados aos conjuntos de validação e teste para reduzir o risco de vazamento temporal de dados futuros durante a predição de ciclos iniciais.
- Construir tensores de entrada multicanal
- Divida os registros contínuos de ciclagem de cada bateria em segmentos temporais de comprimento fixo. Estruture os segmentos temporais de acordo com janelas de observação predefinidas correspondentes aos primeiros 50 ciclos, aos primeiros 100 ciclos ou aos primeiros 20% do ciclo de vida da bateria.
- Alinhe as medições de tensão, corrente, capacidade, temperatura, resistência interna e eficiência dentro de cada segmento temporal antes da construção do tensor.
- Concatene as matrizes de características alinhadas em um tensor tridimensional formatado como (N × 128 × C), em que N representa o comprimento da janela de observação, 128 indica os pontos de amostragem padronizados dentro do ciclo e C representa o número total de canais de características físicas e derivadas.
- Extrair características derivadas
- Extraia características eletroquímicas derivadas dos sinais brutos de ciclagem para melhorar a identificação de padrões de degradação. Calcule as características de capacidade incremental e tensão diferencial por meio das derivadas dQ/dV e dV/dQ na grade padronizada de amostragem.
- Aplique o filtro de Savitzky–Golay para gerar curvas suavizadas de capacidade incremental e tensão diferencial.
- Extraia indicadores de degradação, incluindo deslocamentos do pico de tensão, diferenças de tensão nas transições de fase e variações no rendimento energético ciclo a ciclo, a partir das características eletroquímicas filtradas.
3. Construção e Treinamento do Modelo DL
- Construir modelos preditivos candidatos
- Construa um framework padronizado de treinamento e avaliação para todos os modelos preditivos mostrados na Figura 1A. Implemente o fluxo de trabalho de DL usando o PyTorch versão 2.0 ou superior.
- Execute o fluxo de trabalho de treinamento usando scripts modulares em Python para carregamento de dados, inicialização do modelo, otimização e avaliação.
- Prepare modelos de linha de base de ML tradicionais, incluindo regressão linear, floresta aleatória e modelos de árvore de decisão com gradiente impulsionado. Configure o modelo de floresta aleatória com 100 árvores e uma profundidade máxima de 10.
- Configure o framework de árvore de decisão com gradiente impulsionado usando uma taxa de aprendizado de 0,1 e uma profundidade máxima de árvore de 5 por meio da biblioteca Scikit-learn.
- Prepare arquiteturas candidatas de DL, incluindo perceptron multicamadas, CNN unidimensional, rede LSTM, CNN–LSTM e modelos baseados em transformador.
- Padronize os hiperparâmetros principais em todas as arquiteturas de DL aplicando o otimizador AdamW, funções de ativação Gaussian error linear unit, uma dimensão oculta de 128 e uma taxa de dropout de 0,2.
- Configurar a arquitetura CNN–LSTM
- Configure a arquitetura CNN–LSTM para fundir informações multicanal de ciclagem a partir dos tensores de entrada (Figura 1B). Construa a arquitetura híbrida conectando em cascata o extrator de características convolucional a duas camadas recorrentes empilhadas, contendo 128 unidades ocultas cada.
- Finalize a arquitetura usando três cabeças de regressão totalmente conectadas em paralelo para predição simultânea de SOH, RUL e energia descarregável.
- Processe os tensores de entrada multicanal por meio de três camadas convolucionais unidimensionais consecutivas com tamanhos de kernel de 3, 5 e 7 para extrair características localizadas em múltiplas escalas.
- Aplique normalização por lote após cada camada convolucional para melhorar a estabilidade do gradiente durante a otimização.
- Remodele os mapas de características convolucionais em sequências temporais contínuas antes da modelagem de sequência.
- Alimente as sequências temporais codificadas nas camadas recorrentes empilhadas para capturar dependências de degradação de longo alcance ao longo das janelas de observação pré-definidas.
- Particionar conjuntos de dados para treinamento do modelo
- Divida os conjuntos de dados processados de células de bateria em subconjuntos de treinamento, validação e teste usando uma proporção de 70:15:15. Execute a divisão do conjunto de dados usando um valor fixo de semente aleatória igual a 42.
- Aplique amostragem estratificada com base na química da bateria para manter distribuições balanceadas de degradação em todos os subconjuntos de dados.
- Realize a partição do conjunto de dados estritamente no nível da célula de bateria, em vez de randomizar ciclos individuais, para preservar trajetórias sequenciais de degradação.
- Mantenha cada célula de bateria como uma unidade indivisível durante a partição para evitar vazamento de informações entre os conjuntos de dados.
- Verifique programaticamente o isolamento dos conjuntos de dados calculando a interseção dos identificadores de células de bateria entre os subconjuntos de treinamento, validação e teste e confirmando que não há sobreposição.
- Compile um conjunto de dados externo de teste usando o conjunto de dados completo de fosfato de ferro e lítio (LFP) da GOTION para avaliação fora da distribuição e avaliação de generalização entre conjuntos de dados.
- Torne o código-fonte, arquivos de configuração de ambiente e partições de conjunto de dados processadas publicamente disponíveis por meio de um repositório dedicado no GitHub para apoiar a transparência metodológica e a reprodutibilidade.
- Inicializar o treinamento do modelo
- Defina a função de perda de regressão como erro quadrático médio antes do treinamento. Calcule o objetivo global de treinamento agregando os valores de perda de cada alvo de predição usando pesos iguais.
- Defina a taxa de aprendizado inicial como 1 × 10⁻³ e selecione um tamanho de lote de 32 ou 64 de acordo com o tamanho do conjunto de dados.
- Use um tamanho de lote de 64 para conjuntos de dados contendo mais de 5.000 ciclos para melhorar a utilização de hardware. Use um tamanho de lote de 32 para conjuntos de dados menores para melhorar a estabilidade da otimização.
NOTA: Selecione esses hiperparâmetros por meio de avaliação preliminar de busca em grade para equilibrar velocidade de convergência e estabilidade do gradiente em diferentes janelas de observação.
- Aplicar controles de treinamento
- Aplique um escalonador dinâmico de taxa de aprendizado com base em mudanças na perda de validação. Reduza a taxa de aprendizado por um fator de 0,5 se a perda de validação não melhorar por 5 épocas consecutivas.
- Mantenha um limite mínimo de taxa de aprendizado de 1 × 10⁻⁵ durante a otimização.
- Interrompa o treinamento do modelo após um máximo de 100 épocas para reduzir o sobreajuste.
- Aplique interrupção antecipada se a perda de validação não diminuir por 15 épocas consecutivas. Restaure os pesos do modelo correspondentes à iteração de validação com melhor desempenho.
- Manter registros de reprodutibilidade
- Defina um valor fixo de semente aleatória igual a 42 antes da inicialização e do treinamento do modelo.
- Aplique a semente aleatória fixa de forma consistente nos módulos random do Python, NumPy e backend do PyTorch, desativando operações CUDA não determinísticas.
- Registre o ambiente de software, versões de dependências, configurações de parâmetros, partições de dados e saídas de treinamento para cada execução experimental.
- Execute todos os fluxos de trabalho de DL usando Ubuntu 22.04 com aceleração CUDA 11.8 em uma estação de trabalho equipada com unidade de processamento gráfico NVIDIA RTX 3090 ou hardware equivalente.
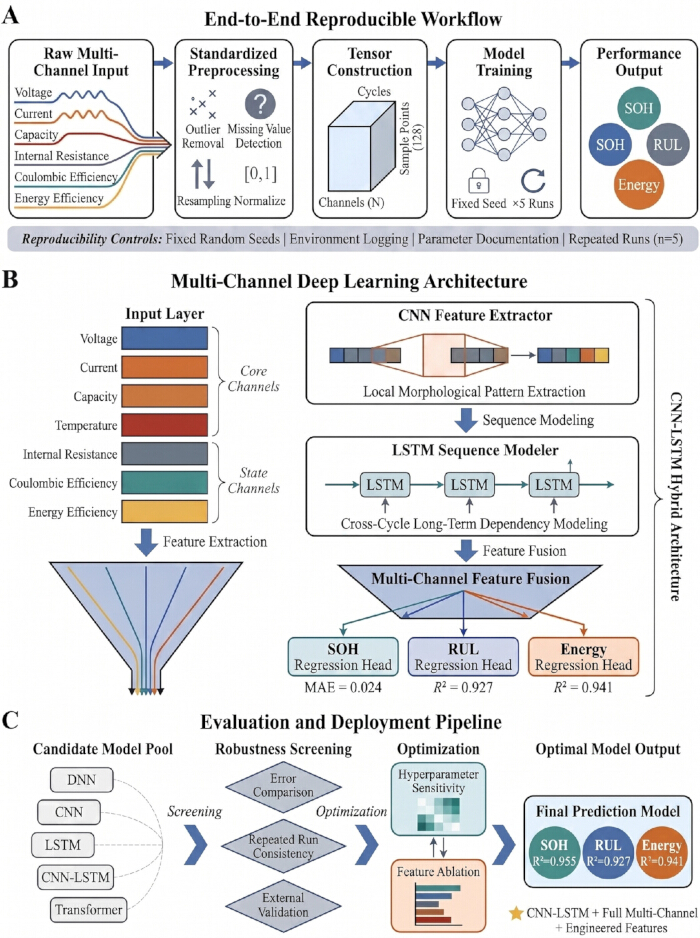
Figura 1. Fluxo de trabalho reprodutível de aprendizado profundo (DL) para previsão de desempenho de baterias de íon de lítio multicanal. (A) Fluxo de trabalho reprodutível de ponta a ponta ilustrando a aquisição de dados multicanal, pré-processamento padronizado, construção de tensores, treinamento do modelo e previsão de indicadores de desempenho da bateria. Os controles de reprodutibilidade incluem sementes aleatórias fixas, execuções repetidas de treinamento, rastreamento de parâmetros e registro de ambiente. (B) Arquitetura híbrida CNN–LSTM utilizada para extração de características multicanal, modelagem de sequências temporais, fusão de características e previsão do estado de saúde (SOH), vida útil remanescente (RUL) e energia descarregável. (C) Pipeline de avaliação e implantação mostrando a seleção inicial de modelos candidatos, avaliação de robustez, otimização de hiperparâmetros e seleção final do modelo. Clique aqui para visualizar uma versão maior desta figura.
4. Avaliação do Modelo e Previsão de Alvos
- Gerar previsões do modelo
- Processar os conjuntos de dados da bateria de testes-alvo por meio de cada modelo treinado. Carregar os conjuntos de dados de teste pré-processados como tensores serializados do PyTorch antes da inferência.
- Executar a passagem de inferência direta utilizando um gerenciador de contexto que desativa gradientes para evitar atualizações indesejadas de parâmetros durante a avaliação.
- Gerar previsões simultâneas para cada indicador de desempenho utilizando as cabeças de regressão treinadas.
- Extrair saídas simultâneas das três cabeças de regressão paralelas configuradas para previsão de SOH, RUL e energia descarregável.
- Calcular os valores-alvo das previsões
- Calcular o SOH comparando a capacidade disponível atual com a capacidade inicial da bateria.
- Definir a capacidade inicial da bateria como a capacidade máxima de descarga registrada durante os três primeiros ciclos de estabilização.
- Calcular o SOH como a razão entre a capacidade do ciclo atual e a linha de base da capacidade inicial estabelecida.
- Estimar o RUL identificando o limite operacional no qual a capacidade estável da bateria cessa.
- Definir o fim da vida útil como o número de ciclo no qual a capacidade da bateria diminui irreversivelmente abaixo de 80% da capacidade nominal.
- Calcular o RUL como a contagem de ciclos restantes a partir do ponto de observação atual até o limite definido de fim da vida útil.
- Prever a energia descarregável a partir das condições de descarga registradas.
- Calcular a energia descarregável real integrando numericamente o produto da tensão de descarga e da corrente de descarga ao longo do intervalo de descarga, utilizando o método de integração trapezoidal.
- Avaliar o desempenho preditivo
- Calcular o erro absoluto médio (MAE), o erro quadrático médio (RMSE), o erro percentual absoluto médio (MAPE) e o coeficiente de determinação (R2) para cada alvo de previsão.
- Calcular todas as métricas de avaliação utilizando o módulo de métricas do Scikit-learn com formulações estatísticas padronizadas.
- Aplicar cálculos idênticos de métricas em todos os modelos, conjuntos de dados e configurações de entrada para manter a consistência da avaliação.
- Agregar todas as métricas de desempenho nos diferentes exemplos de baterias agrupados dentro do conjunto de dados de teste independente para avaliar a generalização global do modelo.
- Relatar o desempenho estratificado
- Calcular a média e o desvio padrão para cada métrica de avaliação ao longo de execuções experimentais repetidas.
- Obter as medidas estatísticas relatadas a partir de cinco inicializações independentes do modelo.
- Relatar intervalos de confiança de 95% juntamente com as métricas médias de desempenho para quantificar a incerteza preditiva.
- Comparar o desempenho do modelo em diferentes comprimentos de janelas de observação e configurações de canais de entrada.
- Estratificar a análise comparativa utilizando janelas de observação correspondentes a 50 ciclos, 100 ciclos e 200 ciclos.
- Avaliar o desempenho preditivo em múltiplas configurações de entrada, variando desde entradas somente de capacidade até a integração completa do tensor multicanal. Consulte Figura 1C para o fluxo de trabalho de avaliação, triagem de robustez e seleção para implantação.
5. Análise de Reprodutibilidade, Robustez e Sensibilidade
- Verificar reprodutibilidade e robustez
- Mantenha partições de dados idênticas, fluxos de pré-processamento e procedimentos experimentais em todas as avaliações de reprodutibilidade mostradas na Figura 2A.
- Calcule o coeficiente de variação das métricas principais de avaliação em ensaios repetidos para avaliar a consistência da reprodutibilidade.
- Repita todos os procedimentos de avaliação utilizando o mesmo fluxo de trabalho padronizado de treinamento e teste.
- Inicie cada avaliação repetida usando pesos aleatórios da rede, preservando ao mesmo tempo os procedimentos determinísticos de carregamento e embaralhamento dos dados.
- Realizar experimentos de treinamento repetidos
- Treine os modelos preditivos repetidamente em condições experimentais idênticas, utilizando valores fixos predefinidos de semente aleatória para garantir a inicialização reprodutível dos pesos.
- Realize cinco execuções independentes de treinamento com partições idênticas do conjunto de dados para reduzir a variabilidade baseada nos dados.
- Calcule as métricas finais de desempenho fazendo a média das métricas de avaliação obtidas nas cinco execuções repetidas de treinamento.
- Agregue as métricas finais de robustez utilizando as pontuações médias de avaliação, em vez de combinar tensores brutos de predição.
- Avaliar a sensibilidade aos hiperparâmetros
- Modifique individualmente a taxa de aprendizado, o tamanho do lote, a dimensão da camada oculta e a taxa de dropout durante a análise de sensibilidade.
- Avalie taxas de aprendizado variando de 1 × 10⁻⁴ a 1 × 10⁻², tamanhos de lote de 32 a 128, dimensões ocultas de 32 a 256 e taxas de dropout de 0,1 a 0,5.
- Registre as alterações correspondentes na precisão preditiva após cada ajuste de hiperparâmetro.
- Quantifique a variação do desempenho preditivo utilizando RMSE e R2.
- Realizar análise de ablação de características
- Remova canais de entrada selecionados, incluindo temperatura, resistência interna e vetores de características projetadas, do fluxo de entrada multicanal.
- Realize a ablação de características usando uma estratégia leave-one-out, removendo um grupo de características por vez, mantendo inalterada a estrutura multicanal restante da entrada.
- Compare o desempenho preditivo resultante após cada experimento de remoção de características para avaliar a contribuição de cada grupo individual de características para a estabilidade e precisão do modelo.
- Quantifique a contribuição relativa de cada grupo de características calculando o aumento percentual no erro absoluto médio em relação ao modelo de referência multicanal totalmente integrado. Consulte a Figura 2B para o fluxo de trabalho de avaliação de robustez e análise de sensibilidade.
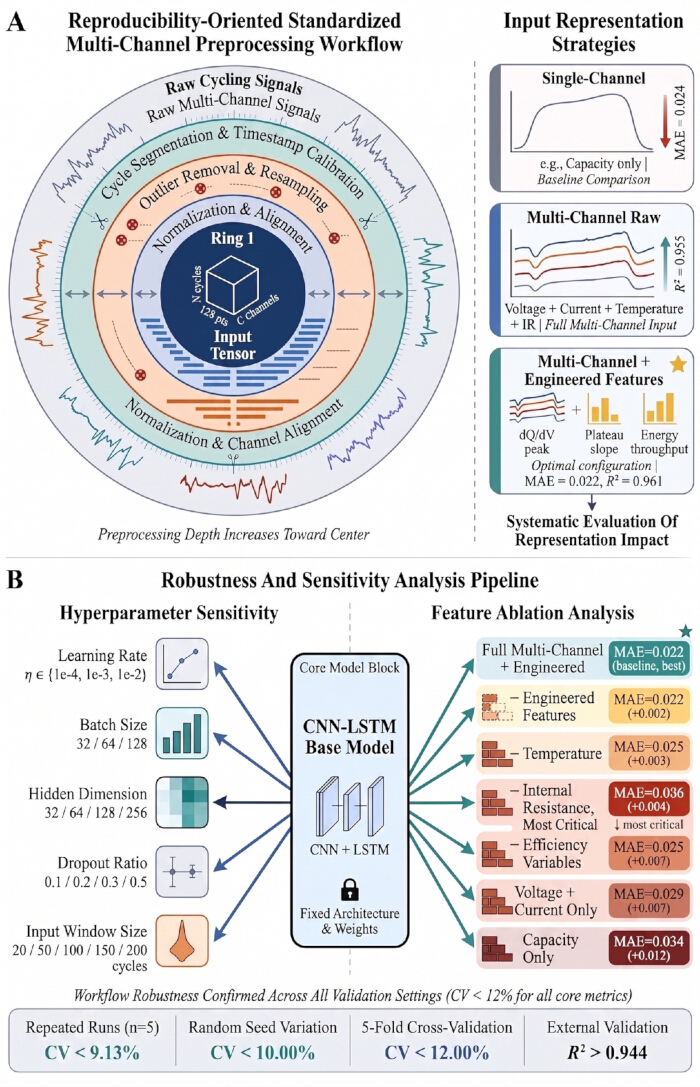
Figura 2. Pré-processamento padronizado, avaliação de robustez e fluxograma de análise de sensibilidade. (A) Fluxograma padronizado de pré-processamento multicanal ilustrando o processamento de sinais cíclicos brutos, calibração de carimbos de tempo, remoção de valores atípicos, reamostragem, normalização, alinhamento de canais e construção de tensores. As estratégias de representação da entrada comparam entradas de canal único, entradas multicanal brutas e entradas multicanal combinadas com características projetadas. (B) Pipeline de análise de robustez e sensibilidade mostrando perturbação sistemática de hiperparâmetros, avaliação de execuções repetidas, análise de ablação de características, validação cruzada e validação externa do fluxo de trabalho CNN–LSTM. Clique aqui para visualizar uma versão maior desta figura.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Sinais de Ciclagem Multicanal e Distribuição de Dados
Sinais representativos de ciclagem multicanal e distribuições de desempenho foram analisados para caracterizar o comportamento de resposta à ciclagem de baterias de íons de lítio. O estudo utilizou cinco conjuntos de dados de baterias de íons de lítio que representam múltiplos sistemas químicos, incluindo óxido de cobalto e lítio (LCO), óxido de níquel, cobalto e alumínio (NCA), óxido de níquel, manganês e cobalto (NMC) e L...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
O fluxo de trabalho de DL reprodutível descrito neste protocolo demonstrou previsão precisa do desempenho de baterias de íon lítio utilizando dados de ciclagem multicanal. O fluxo de trabalho alcançou um MAE de teste de 0,024 e um valor de R2 de 0,955 para a estimativa de SOH sob as condições experimentais avaliadas, apoiando seu potencial de utilidade para aplicações de gerenciamento do ciclo de vida de baterias e monitoramento de armazenamento de energia11,
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram não haver interesses financeiros concorrentes ou conflitos de interesses.
Agradecimentos
Os autores agradecem ao apoio institucional fornecido pelo Departamento de Física da Universidade de Ciência e Tecnologia do Sul da China e pelo Homerton College da Universidade de Cambridge, que proporcionaram o ambiente acadêmico e os recursos computacionais necessários para esta pesquisa. Os autores também agradecem às instituições de pesquisa e colaboradores que disponibilizaram publicamente os conjuntos de dados abertos de baterias de íon de lítio, incluindo CALCE, SANYO, PANASONIC, KOKAM e GOTION, permitindo assim esta análise multicanal abrangente.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Conjunto de dados da bateria CALCE | Centro de Engenharia do Ciclo de Vida Avançada (CALCE), Universidade de Maryland | https://calce.umd.edu/battery-data | Fonte de dados multicanal de ciclagem de baterias de íon lítio para treinamento e validação de modelos |
| CUDA Toolkit | NVIDIA | Versão 11.8 | Aceleração de GPU para treinamento de modelos de aprendizado profundo |
| Conjunto de dados GOTION IFP20100140A | Mendeley Data | https://doi.org/10.17632/vpw4t7ytbx.2 | Validação externa e análise multicanal de degradação de baterias |
| Conjunto de dados KOKAM SLPB533459H4 | Mendeley Data | https://doi.org/10.17632/7w4y4fzzbb.1 | Modelagem e validação multicanal da degradação de baterias |
| Matplotlib | Equipe de Desenvolvimento do Matplotlib | Versão 3.7.1 | Visualização do desempenho do modelo, análise de sensibilidade e resultados de reprodutibilidade |
| NumPy | Desenvolvedores do NumPy | Versão 1.24.3 | Computação numérica e construção de tensores |
| Conjunto de dados PANASONIC NCR18650BD | Mendeley Data | https://doi.org/10.17632/wykht8y7tg.1 | Fonte de dados de ciclagem multicanal e extração de características projetadas |
| Pandas | Desenvolvedores do Pandas | Versão 2.0.3 | Organização de dados, pré-processamento e gerenciamento de dados tabulares |
| PyTorch | Fundação PyTorch | Versão 2.0.1 | Construção e treinamento de arquiteturas de aprendizado profundo, incluindo o modelo CNN–LSTM |
| Python | Fundação Software Python | Versão 3.10.12 | Pré-processamento de dados, engenharia de características, treinamento e avaliação de modelos |
| Conjunto de dados SANYO UR18650E | Repositório de Dados de Prognóstico da NASA | https://ti.arc.nasa.gov/tech/dash/groups/pcoe/prognostic-data-repository/ | Fonte de dados de ciclagem multicanal para avaliação de reprodutibilidade e validação de modelos |
| Scikit-learn | Desenvolvedores do Scikit-learn | Versão 1.2.2 | Implementação de modelo de referência, particionamento de conjunto de dados e cálculo de métricas de desempenho |
Referências
- Lu J, Xiong R, Tian J. Deep learning to estimate lithium-ion battery state of health without additional degradation experiments. Nat Commun. 2023;14:2760.
- Zhang H, Li Y, Zheng S. Battery lifetime prediction across diverse ageing conditions with inter-cell deep learning. Nat Mach Intell. 2025;7:270–7.
- Zhang Y, et al. State-of-health estimation for lithium-ion batteries via incremental energy analysis and hybrid deep learning model. Batteries. 2025;11(6):217.
- Liu C, et al. Deep learning for state of health estimation of lithium-ion batteries in electric vehicles: A systematic review. Energies. 2025;18(6):1463.
- Chen C, Wei J, Li Z. Remaining useful life prediction for lithium-ion batteries based on a hybrid deep learning model. Processes. 2023;11(8):2333.
- Chen B, et al. Lithium-ion battery state of health estimation based on feature reconstruction and Transformer-GRU parallel architecture. Energies. 2025;18(5):1236.
- Zhao W, Ding W, Zhang S, Zhang Z. Enhancing lithium-ion battery lifespan early prediction using a multi-branch vision transformer model. Energy. 2024;302:131816.
- Hu J, et al. Early prediction of lithium-ion battery degradation with a generative pre-trained transformer. Nat Commun. 2026;17:126.
- Li Y, et al. Accurate and adaptive state of health estimation for lithium-ion battery based on patch learning framework. Measurement. 2025;250:117083.
- Geng M, et al. Interpretable deep learning with uncertainty quantification for lithium-ion battery SOH estimation. Energy. 2025;335:138027.
- Li Y, et al. State-of-health prediction of lithium-ion batteries using feature fusion and a hybrid neural network model. Energy. 2025;319:135163.
- Zhou J, et al. Deep learning estimation of state of health for lithium-ion batteries using multi-level fusion features of discharge curves. J Power Sources. 2025;653:237781.
- Wang Y, et al. A comprehensive review of machine learning-based state of health estimation for lithium-ion batteries: Data, features, algorithms, and future challenges. Renew Sustain Energy Rev. 2025;224:116125.
- Severson KA, et al. Data-driven prediction of battery cycle life before capacity degradation. Nat Energy. 2019;4(5):383–91.
- Wu R, et al. Confidence-aware quantile Transformer for reliable degradation prediction of battery energy storage systems. Reliab Eng Syst Saf. 2025;260:111019.
- Yang H, et al. Privacy-preserving collaborative battery fault warning for massive electric vehicles by heterogeneous data from charging stations. Nat Commun. 2026;17:974.
- Liu Y, et al. A hybrid deep learning approach for remaining useful life prediction of lithium-ion batteries based on discharging fragments. Appl Energy. 2024;358:122555.
- Bockrath S, Lorentz V, Pruckner M. State of health estimation of lithium-ion batteries with a temporal convolutional neural network using partial load profiles. Appl Energy. 2023;329:120307.
- Zhang Z, et al. Multi-cycle charging information guided state of health estimation for lithium-ion batteries based on pre-trained large language model. Energy. 2024;313:133993.
- Li Z, Zhang X, Gao W. State of health estimation of lithium-ion battery during fast charging process based on BiLSTM-Transformer. Energy. 2024;311:133418.
- Bao X, et al. Hybrid deep neural network with dimension attention for state-of-health estimation of lithium-ion batteries. Energy. 2023;278:127734.
- He N, et al. Early prediction of battery lifetime based on graphical features and convolutional neural networks. Appl Energy. 2024;353:122048.
- Rieger LH, et al. Uncertainty-aware and explainable machine learning for early prediction of battery degradation trajectory. Digit Discov. 2023;2(1):112–22.
- Li H, et al. A cross-material lithium-ion battery state of health estimation method based on three-stage domain adaptation. Energy. 2025;139376.
- Han T, et al. Source-free dynamic weighted federated transfer learning for state-of-health estimation of lithium-ion batteries with data privacy. IEEE Trans Power Electron. 2024;39(11):15085–100.
- Rhyu J, et al. Systematic feature design for cycle life prediction of lithium-ion batteries during formation. Joule. 2025;9(5):101884.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.