A estrutura proposta MSCNN-LSTM integra a extração multi-escala de características espaciais com a modelagem de sequências temporais para o reconhecimento de ações em vídeos esportivos, capturando características espaciais de alto detalhe e padrões de movimento temporais, ao mesmo tempo que alcança desempenho competitivo na classificação em conjuntos de dados de ações esportivas de referência.
Artigo de investigação
Reconhecimento de Ações em Vídeos Esportivos Utilizando Redes Convolucionais Multiescala com Modelagem Temporal Baseada em Memória de Longo Prazo de Curto Prazo (LSTM)
Neste artigo
Resumo
Resumo
O reconhecimento de ações em vídeos esportivos permanece desafiador devido à dinâmica complexa dos movimentos, oclusão e alta variabilidade intraclasse. Embora abordagens existentes baseadas em aprendizado profundo, incluindo CNN-BiLSTM e modelos baseados em transferência de aprendizagem, tenham demonstrado eficácia no reconhecimento de atividades humanas, seu desempenho pode ser limitado em cenários esportivos com movimentos rápidos e diversos. Muitos métodos existentes dependem de filtros convolucionais de única escala, o que pode não capturar efetivamente características de movimento finas e grosseiras simultaneamente. Para superar essa limitação, este estudo propõe uma Rede Neural Convolucional Multiescala (MSCNN) integrada a uma rede Long Short-Term Memory (LSTM) para o reconhecimento de ações em vídeos esportivos. A MSCNN extrai representações espaciais em múltiplos campos receptivos por meio de kernels convolucionais paralelos, permitindo a aprendizagem de características de movimento detalhadas e contextuais. Essas características são posteriormente processadas pela LSTM para capturar dependências temporais e continuidade do movimento entre quadros consecutivos. A avaliação experimental foi realizada nos conjuntos de dados de referência UCF11, UCF Sports e JHMDB. O modelo proposto MSCNN-LSTM alcançou precisões de classificação de 98,3%, 95,4% e 81,7%, respectivamente, superando as abordagens comparativas avaliadas neste estudo. Um estudo de ablação demonstrou ainda a contribuição da extração de características multiescala e da modelagem temporal para o desempenho geral. Esses resultados demonstram o potencial do framework proposto em combinar informações espaciais e temporais para o reconhecimento de ações em vídeos esportivos.
Introdução
O reconhecimento de atividades humanas possui amplas aplicações em diversos domínios do mundo real, incluindo vigilância inteligente, detecção de anomalias, recuperação audiovisual baseada em ações e monitoramento de pacientes em saúde1,2. O reconhecimento de ações, particularmente em fluxos de vídeo de sistemas de vigilância e plataformas de mídia social, apresenta grande potencial para detecção de anomalias e compreensão de eventos3. As ações humanas são identificadas na análise de vídeo por meio da observação de diferentes partes do corpo, como mãos e pernas. Diferentemente de imagens estáticas, um único quadro frequentemente é insuficiente para representar uma ação4. Por exemplo, a posição inicial de atividades como futebol e pular corda pode parecer semelhante em um único quadro. As diferenças entre essas ações tornam-se evidentes quando são observadas ao longo de uma sequência de quadros que capturam padrões de movimento e interações do corpo humano com seu entorno5,6,7. As abreviações utilizadas ao longo deste manuscrito são resumidas na Tabela 1 para melhorar a legibilidade e garantir consistência na terminologia.
| Abreviação | Forma Completa |
| AI | Inteligência Artificial |
| AUC | Área Sob a Curva |
| BiLSTM | Memória de Curto Prazo Bidirecional |
| CNN | Rede Neural Convolucional |
| CUDA | Arquitetura Unificada de Dispositivo de Cálculo |
| F1-score | Média Harmônica de Precisão e Revocação |
| GPU | Unidade de Processamento Gráfico |
| HAR | Reconhecimento de Atividade Humana |
| JHMDB | Banco de Dados de Movimento Humano Conjunto |
| LSTM | Memória de Longo Prazo |
| mAP-T | Precisão Média Temporal |
| MCC | Coeficiente de Correlação de Matthews |
| MSCNN | Rede Neural Convolucional Multiescala |
| ROC | Característica de Operação do Receptor |
| TSI | Índice de Estabilidade Temporal |
| UCF | Universidade da Flórida Central |
| VRAM | Memória de Acesso Aleatório de Vídeo |
Tabela 1: Lista de abreviações utilizadas no manuscrito. Abreviações e siglas comuns utilizadas ao longo do estudo e suas formas completas correspondentes.
A classificação rápida e precisa de vídeos esportivos é importante para uma ampla gama de aplicações8,9,10, incluindo análise esportiva, detecção de eventos, recuperação baseada em conteúdo e sistemas de recomendação11,12,13. Com o rápido crescimento do conteúdo de vídeo relacionado a esportes, as limitações das estruturas analíticas anteriores tornaram-se cada vez mais evidentes14. Consequentemente, existe uma demanda crescente por abordagens robustas capazes de lidar com a complexidade e a natureza dinâmica das atividades esportivas. Os métodos tradicionais de classificação de vídeos esportivos basearam-se amplamente em descritores manualmente elaborados, como fluxo óptico e Histograma de Gradientes Orientados (HOG), para caracterizar padrões de movimento e atividades em vídeos esportivos15.
As ConvNets, que obtiveram sucesso notável na classificação de imagens estáticas, também foram aplicadas à análise de vídeos. No entanto, o reconhecimento de ações permanece mais desafiador porque os vídeos contêm informações espaciotemporais dinâmicas. As abordagens atuais baseadas em aprendizado profundo podem ser geralmente categorizadas em três grupos: redes de dois fluxos16, redes convolucionais 3D e arquiteturas computacionalmente eficientes. Para aprender informações temporais a partir do fluxo óptico, as redes de dois fluxos utilizam uma ConvNet adicional17,18, embora essa abordagem seja computacionalmente onerosa. Embora arquiteturas convolucionais 3D, como C3D, I3D e R3D, possam modelar informações temporais diretamente, elas aumentam substancialmente o número de parâmetros, tornando a otimização mais desafiadora. Métodos computacionalmente eficientes tentam reduzir a complexidade do modelo explorando operações 3D decompostas.
Além disso, como as CNNs podem extrair características espaciais locais e as LSTMs podem capturar informações contextuais temporais, modelos híbridos conseguem aprender efetivamente padrões de movimento espaciotemporais a partir das entradas dos sensores. Estudos recentes que combinam arquiteturas de CNN e redes neurais recorrentes têm gerado resultados encorajadores18,19,20. No entanto, como as LSTMs comprimem informações durante o processamento de sequências, o ruído introduzido durante a extração de características pode afetar o desempenho do reconhecimento. Para resolver esse problema, diversos estudos incorporaram mecanismos de atenção21,22. Os mecanismos de atenção permitem que o modelo se concentre nas características mais relevantes para a tarefa de reconhecimento, melhorando assim o desempenho de classificação.
Embora modelos profundos bidirecionais de LSTM combinados com extração de características baseada em CNN tenham alcançado resultados promissores para o reconhecimento de atividades humanas, diversos desafios permanecem ao estender essas arquiteturas para o reconhecimento de ações em vídeos esportivos. Primeiramente, as arquiteturas CNN-LSTM existentes frequentemente empregam extração de características convolucionais em uma única escala, o que pode limitar sua capacidade de capturar ações que ocorrem em múltiplas resoluções espaciais e temporais, como o movimento simultâneo de jogadores e objetos em cenas esportivas. Redes convolucionais multi-escala, incluindo CNNs 3D23 e CNNs de duas vias, demonstraram a importância de capturar pistas espaciais e de movimento em diferentes escalas, embora este conceito permaneça menos explorado em sistemas híbridos baseados em LSTM. Segundo, a maioria dos modelos CNN-BiLSTM anteriores24 concentram-se principalmente em dependências temporais de curto prazo, enquanto a continuidade do movimento em longo alcance e as interações entre objetos comuns em esportes coletivos podem não ser adequadamente representadas. Muitas abordagens baseadas em aprendizado por transferência, como MobileNetV2 e ResNet, dependem de características estáticas de quadros individuais e não exploram plenamente mecanismos de atenção temporal ou fusão adaptativa de características em múltiplas escalas25Além disso, a maioria dos modelos existentes foi avaliada principalmente em conjuntos de dados de referência, como UCF11 e JHMDB. Conjuntos de dados mais recentes, específicos para esportes, que capturam movimentos complexos da câmera e padrões de atividade, como SoccerNet e FineGym, permanecem pouco explorados. Essas limitações destacam a necessidade de um framework multi-escala de extração de características convolucionais integrado a módulos de memória temporal, como redes LSTM ou BiLSTM, para captar de forma mais eficaz tanto representações espaciais finas quanto dependências temporais de longo alcance no reconhecimento de ações em vídeos esportivos.
Além disso, as CNNs podem extrair características espaciais locais, enquanto as LSTMs podem modelar o contexto temporal. Arquiteturas híbridas CNN-RNN, portanto, demonstraram desempenho promissor no reconhecimento de atividades humanas26,27. Estudos recentes ampliaram os frameworks convencionais CNN-LSTM incorporando estratégias complementares de aprendizado para melhorar o reconhecimento de atividades humanas. Por exemplo, mecanismos de atenção foram introduzidos para enfatizar características relevantes à tarefa e suprimir representações menos informativas, melhorando assim o desempenho do reconhecimento28. Outras abordagens adotaram o aprendizado multitarefa para otimizar conjuntamente as tarefas de reconhecimento de ações e segmentação temporal, aumentando a eficiência do aprendizado e a representação de características29. Apesar desses avanços, os métodos existentes ainda podem ter capacidade limitada de distinguir ações visualmente semelhantes, pois características espaciais e temporais finamente detalhadas nem sempre são capturadas de forma eficaz. Tabela 2 resume os pontos fortes e limitações das abordagens existentes30.
| Referência / Ano | Método Utilizado | Conjunto(s) de Dados | Métricas de Desempenho | Principais Pontos Fortes | Limitações |
| Hassan et al. (2024)1 | KFDI (Imagem Dinâmica de Quadros-Chave) | UCF11 | Precisão: 85,3% | Seleção eficiente de quadros-chave e representação aprimorada de imagem dinâmica. | Sensível a erros na seleção de quadros; modelagem temporal limitada. |
| Zhou et al. (2023)24 | CNN Dilatada + BiLSTM + Bloco Residual | UCF11, UCF Sports | Precisão: UCF11: 89% e UCF Sports: 92,2% | Integra aprendizado espacial e temporal; capta informações em múltiplas escalas. | Intensivo computacionalmente; risco de superajuste em conjuntos de dados pequenos. |
| Ullah et al. (2025)34 | Característica Local–Global + QSVM | UCF11 | Precisão: 82,6% | Combina características manuais e profundas para reconhecimento robusto. | Requer ajuste manual; escalabilidade limitada. |
| Shin et al. (2025)25 | ViT-ReT (Transformador de Visão + Transformador Recorrente) | UCF11, UCF50, UCF101 e JHMDB | Precisão: UCF11: 97,73%; UCF50: 98,81%; UCF101: 98,46%; JHMDB: 83,38% | Captura dependências espaciais e temporais de longo alcance. | Alto custo computacional e exigência de dados. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | Precisão: 85,1% | Aprendizado end-to-end de características espaço-temporais. | Altos requisitos de memória e GPU. |
| Karuppannan et al. (2024)35 | Autoencoder Profundo + CNN | UCF11 | Precisão: 96,2% | Aprende representações compactas de características. | Modelagem temporal de longo prazo limitada. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF Sports, JHMDB, UCF101 e HMDB51 | Precisão: KTH: 97,67%; UCF Sports: 95,00%; JHMDB: 73,13%; UCF101: 92,97%; HMDB51: 69,74% | Aprendizado temporal eficaz baseado em profundidade. | Requer estimativa precisa de profundidade e pré-processamento extensivo. |
Tabela 2: Comparação dos métodos de aprendizado profundo existentes para reconhecimento de ações em vídeos esportivos. Resumo das principais abordagens de aprendizado profundo, incluindo conjuntos de dados, características metodológicas, vantagens e limitações, destacando as lacunas de pesquisa abordadas pela estrutura proposta MSCNN-LSTM.
Foi proposto um framework para animação facial orientada por sincronização de áudio, combinando um Modelo de Dessanilização Facial (FDM) com um Modelo de Difusão Latente Local-para-Global (LG-LDM) para gerar animações faciais expressivas emocionalmente. Um Autoencoder Variacional Quantizado por Vetores Centrado em Emoção (EVQ-VAE) foi empregado para reconstruir a geometria facial tridimensional detalhada e variações sutis de expressão31. Também foi desenvolvido um framework de preensão robótica com percepção de oclusão utilizando visão estéreo binocular, capaz de realizar segmentação de alvo, localização, inferência de oclusão e estimativa de pose de preensão para múltiplos alvos em condições de oclusão32. Além disso, foi introduzido um framework em duas etapas para extração de solo de nuvens de pontos, utilizando projeção em grade e divisão adaptativa de compartimentos, no qual probabilidades de elevação e curvatura foram usadas para refinar os limites entre solo e obstáculos após uma extração inicial por meio de análise de características baseada em grade33.
Apesar dos avanços significativos no reconhecimento de ações baseado em aprendizado profundo, os métodos existentes ainda enfrentam dificuldades para lidar com a alta variabilidade e complexidade dos vídeos esportivos, incluindo movimentos rápidos, movimentação da câmera e interações entre múltiplos jogadores. Muitos modelos tradicionais baseados em CNN ou LSTM operam em uma única escala espacial e, portanto, podem ter dificuldade em capturar de forma eficaz padrões de movimento locais e globais. Além disso, manter a coerência temporal em sequências de longa duração ou ações sobrepostas permanece um desafio. Embora os métodos de transferência de aprendizado tenham melhorado a extração de características, sua adaptação a conjuntos de dados específicos de esportes ainda é relativamente pouco explorada.
Este estudo tem como objetivo desenvolver e avaliar um framework de rede neural convolucional em múltiplas escalas com memória de curto e longo prazo (MSCNN-LSTM) para reconhecimento de ações em vídeos esportivos, integrando a extração de características espaciais em múltiplas escalas com modelagem temporal baseada em LSTM, a fim de capturar tanto características espaciais de alto nível de detalhe quanto dependências temporais de longo prazo. O framework proposto utiliza kernels convolucionais complementares e fusão de características em múltiplos níveis para melhorar a representação de ações esportivas complexas em condições desafiadoras. Seu desempenho foi avaliado nos conjuntos de dados de referência UCF11, UCF Sports e JHMDB utilizando acurácia, precisão, revocação, pontuação F1, média da precisão média ao longo do tempo (mAP-T), índice de estabilidade temporal (TSI), coeficiente kappa de Cohen (κ), coeficiente de correlação de Matthews (MCC) e área sob a curva ROC (AUC). Os resultados experimentais demonstraram desempenho competitivo em comparação com os métodos avaliados neste estudo, destacando o potencial do framework para análise esportiva, monitoramento de desempenho de atletas, detecção automatizada de eventos e compreensão de vídeos esportivos.
Protocolo
Este estudo utilizou uma estrutura de aprendizado profundo em duas etapas para reconhecimento de ações em vídeos esportivos, integrando uma Rede Neural Convolucional em Múltiplas Escalas (MSCNN) com uma rede de Memória de Longo e Curto Prazo (LSTM). Foram utilizados conjuntos de dados de referência publicamente disponíveis, nomeadamente UCF11, UCF Sports e JHMDB, para o desenvolvimento e avaliação do modelo. Nenhum dado novo foi coletado de participantes humanos, e nenhuma informação pessoal identificável foi acessada ou processada. Como o estudo envolveu a análise secundária de conjuntos de dados anonimizados e de acesso público e não envolveu participação humana direta, a aprovação ética institucional e o consentimento informado não foram necessários.
O fluxo de trabalho consistiu na amostragem de quadros e normalização temporal, seguidas pela extração de características usando o módulo MSCNN. As características extraídas foram posteriormente processadas usando uma rede LSTM para modelagem temporal e então encaminhadas a uma camada de classificação multiclasse. Por fim, o modelo foi treinado e avaliado usando os conjuntos de dados de referência selecionados. Figura 1 ilustra a arquitetura geral do framework proposto.
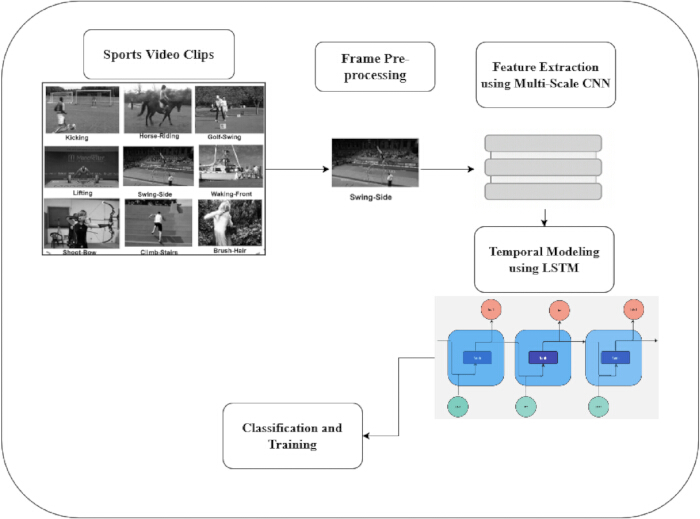
Figura 1: Estrutura proposta MSCNN-LSTM para reconhecimento de ações em vídeos esportivos. Fluxo geral ilustrando o pré-processamento de vídeo, extração de características espaciais em múltiplas escalas, aprendizado de sequência temporal e classificação de ações. Clique aqui para visualizar uma versão ampliada desta figura.
Figura 1 ilustra o fluxo de trabalho do framework proposto para reconhecimento de ações em vídeos esportivos com base em uma arquitetura híbrida MSCNN-LSTM. O processo inicia-se com clipes de vídeo esportivos contendo diversas ações atléticas, incluindo chutar, andar a cavalo e balançar no golfe. Os vídeos brutos foram decompostos em quadros individuais durante a etapa de pré-processamento, na qual os quadros são recortados, padronizados e preparados para a entrada no modelo. Os quadros pré-processados foram então inseridos no módulo MSCNN para extração de características. A arquitetura convolucional multi-escala captura características espaciais em diferentes campos receptivos, permitindo a extração de informações locais e contextuais dos quadros de vídeo esportivo. Os vetores de características extraídos foram então processados pela rede LSTM para modelar dependências temporais e a evolução do movimento ao longo de quadros consecutivos. Por fim, o módulo de classificação e treinamento utilizou as representações espaço-temporais aprendidas para prever a categoria de ação de cada clipe de vídeo. O framework proposto compreendeu quatro etapas sequenciais, começando pela coleta e pré-processamento de dados usando os conjuntos de dados de referência UCF11 (YouTube Actions), UCF Sports e JHMDB. Cada vídeo esportivo foi convertido em uma sequência de quadros, que foram redimensionados, normalizados e aumentados por meio de rotação, inversão e recorte para melhorar a robustez frente a variações ambientais. Os quadros pré-processados foram então processados pela Rede Neural Convolucional Multi-Escala (MSCNN) proposta, na qual ramificações convolucionais paralelas com kernels 3 × 3, 5 × 5 e 7 × 7 extraíram características espaciais locais e contextuais complementares. Essas características multi-escala foram concatenadas e refinadas usando normalização em lote e max pooling para gerar representações de características compactas. As características resultantes em nível de quadro foram subsequentemente fornecidas a uma rede Long Short-Term Memory (LSTM) para modelar dependências temporais entre quadros consecutivos. As saídas finais da LSTM foram aplainadas e passadas por camadas totalmente conectadas com ativação ReLU, seguidas por um classificador Softmax para prever a categoria de ação. A rede foi treinada usando o otimizador Adam com uma função de perda de entropia cruzada e regularização por dropout para reduzir o sobreajuste. O desempenho do modelo foi finalmente avaliado nos conjuntos de dados de referência UCF11, UCF Sports e JHMDB utilizando acurácia, precisão, revocação e pontuação F1.
1. Coleta e pré-processamento de dados
Três conjuntos de dados de referência disponíveis publicamente para esportes e ações humanas foram utilizados neste estudo. Esses conjuntos de dados contêm imagens de esportes do mundo real com movimento da câmera, pontos de vista e complexidade de fundo variados. Especificamente, o estudo utilizou o UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), que contém 11 categorias de ações coletadas a partir de 1.168 vídeos do YouTube gravados por aproximadamente 25 indivíduos, com múltiplas amostras por ação. O Banco de Dados de Movimento Humano com Anotação Conjunta (JHMDB)34,35 contém 21 classes de ações e 928 vídeos anotados. O conjunto de dados UCF Sports compreende 10 classes de ações e 150 sequências de vídeo capturadas a partir de fontes de transmissão com resolução de 720 × 480 pixels (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
Coletivamente, esses conjuntos de dados abrangem esportes individuais e coletivos e oferecem variação na duração temporal e na escala visual para avaliar o framework proposto de reconhecimento de ações MSCNN-LSTM. Como parte do processo de triagem de qualidade dos dados, os conjuntos de dados UCF11, UCF Sports e JHMDB foram examinados quanto a vídeos corrompidos, arquivos duplicados e clipes com anotações incompletas. Nenhuma amostra que atendesse a esses critérios de exclusão foi identificada; portanto, todos os vídeos disponíveis foram mantidos para análise subsequente. Os conjuntos de dados foram então divididos em subconjuntos de treinamento (70%), validação (15%) e teste (15%) utilizando uma estratégia consistente de divisão aleatória. Figura 2 apresenta imagens representativas utilizadas para treinamento e avaliação.
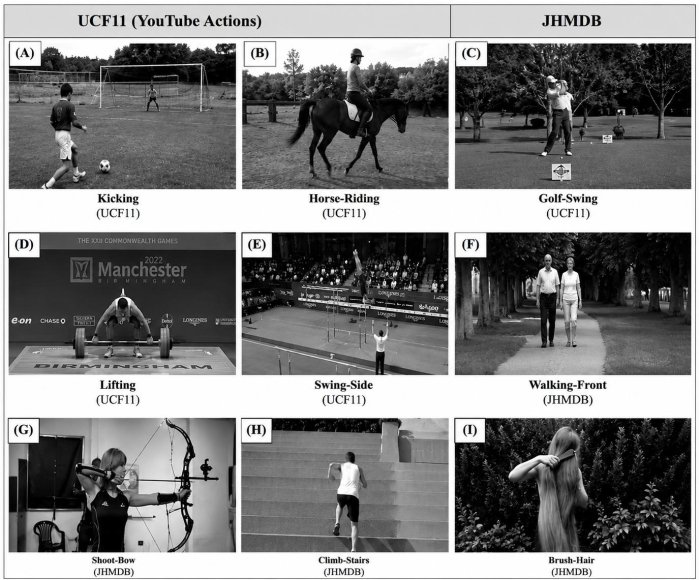
Figura 2: Quadros representativos dos conjuntos de dados de reconhecimento de ações esportivas usados como referência. Os painéis (A–D) mostram exemplos do conjunto de dados UCF11 (Ações do YouTube), os painéis (E–H) do conjunto de dados UCF Sports e os painéis (I–L) do conjunto de dados JHMDB. Os quadros ilustram variações nas classes de ações, pontos de vista, planos de fundo, condições de iluminação e complexidade do movimento. Clique aqui para visualizar uma versão maior desta figura.
O modelo proposto de reconhecimento de ações foi avaliado nos conjuntos de dados de referência UCF11, UCF Sports e JHMDB, conforme resumido na Tabela 3. Esses conjuntos de dados representam padrões diversos de movimento e condições ambientais desafiadoras. O conjunto de dados UCF11 (Ações do YouTube) contém ações esportivas de 11 classes adquiridas sob condições variadas de iluminação, ponto de vista e fundo. O conjunto de dados UCF Sports compreende 150 vídeos de esportes de campo provenientes de transmissões profissionais, com sequências de movimento realistas. O conjunto de dados JHMDB fornece anotações detalhadas de movimento humano para 21 categorias finas de ações e atua como um conjunto de dados de referência para reconhecimento de ações espaço-temporais. Em conjunto, esses conjuntos de dados foram utilizados para avaliar o desempenho do modelo em cenários de esportes e ações humanas. A rede foi treinada usando o otimizador Adam por 100 épocas com um tamanho de lote de 32, taxa de aprendizado inicial de 0,001 e função de perda de entropia cruzada. O modelo com a menor perda de validação foi selecionado para a avaliação final. Todos os experimentos utilizaram uma semente aleatória fixa de 42. Parada antecipada e redução da taxa de aprendizado em platô foram aplicadas para melhorar a convergência, e o corte de gradiente com um limite de 5,0 foi usado durante o treinamento do LSTM para prevenir gradientes explosivos. O modelo proposto MSCNN-LSTM continha aproximadamente 15 milhões de parâmetros treináveis. A configuração de hardware e software utilizada para a implementação está resumida na Tabela 4. Como as distribuições das classes eram suficientemente balanceadas, não foram aplicados procedimentos adicionais de ponderação de classes ou reamostragem. Os modelos comparadores foram implementados usando os hiperparâmetros relatados em seus estudos originais, com configurações de treinamento harmonizadas sempre que viável. Os valores de desempenho foram relatados como média ± desvio padrão de cinco execuções independentes com diferentes inicializações aleatórias. As diferenças entre o modelo proposto e os modelos comparadores foram avaliadas usando testes t pareados com um limiar de significância de p < 0,05.
| Conjunto de Dados | Nº de Classes | Nº de Vídeos | Resolução (px) | Fonte | Descrição |
| UCF11 (YouTube Actions) | 11 | 1168 | Variável (≈ 320×240) | University of Central Florida | Inclui 11 ações humanas de esportes (por exemplo, arremesso de basquete, mergulho, swing de golfe, malabarismo com futebol). Os vídeos foram coletados do YouTube com grande variação em iluminação, ponto de vista e fundo. |
| UCF Sports | 10 | 150 | 720×480 | UCF Sports Action Dataset | Contém atividades esportivas como mergulho, equitação, swing de golfe, corrida e levantamento de peso gravadas a partir de imagens reais de transmissões de TV (BBC, ESPN). |
| JHMDB | 21 | 928 | 320×240 | Max Planck Institute for Intelligent Systems | Inclui atividades diárias e esportivas, como pegar, pular, escovar o cabelo, atirar e correr, com anotações articulares para análise de movimento e postura. |
Tabela 3: Características dos conjuntos de dados de referência utilizados para treinamento e avaliação. Visão geral dos conjuntos de dados UCF11, UCF Sports e JHMDB, incluindo o número de classes de ações, amostras de vídeos, características dos conjuntos de dados e seus papéis no treinamento, validação e testes do modelo.
| Parâmetros Utilizados | Descrição |
| Linguagem de Programação | Python 3.8.18 [4] |
| Framework de Aprendizado Profundo | TensorFlow 2.15.0 [1] |
| Acelerador GPU | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| CPU | Intel Core i9 @ 3.5 GHz × 16 Núcleos |
| Sistema Operacional | Windows 11 |
| Memória (RAM) | 64 GB DDR4 |
| Otimizador | Adam (taxa de aprendizado = 0,001) |
| Tamanho do Lote | 32 |
| Número de Épocas | 100 |
| Funções de Ativação | ReLU (camadas CNN), Softmax (camada de saída) |
| Taxa de Dropout | 0,5 |
Tabela 4: Ambiente de simulação e configuração de hiperparâmetros do modelo MSCNN-LSTM proposto. Especificações de hardware, ambiente de software, configurações do otimizador, taxa de aprendizado, tamanho do lote, número de épocas, dimensões de entrada e outros hiperparâmetros utilizados durante o treinamento e avaliação do modelo.
2. Pré-processamento
Antes do treinamento, cada vídeo bruto foi convertido em uma sequência ordenada no tempo de quadros e, em seguida, normalizado, amostrado temporalmente e aumentado. Cada vídeo de entrada V foi inicialmente convertido em uma sequência de quadros e representado como um tensor 4D V ∈ RT×H×W×C, onde T é o número de quadros, H × W i denota o índice do quadro e C denota o número de canais de cor (3 para RGB). O pipeline de pré-processamento consistiu na extração de quadros, redimensionamento espacial seguido de recorte central ou aleatório para uma resolução fixa (H′, W′), normalização da intensidade por pixel e aumento opcional dos dados, incluindo inversão aleatória, redimensionamento e variação aleatória de cor, antes da extração de características. Concretamente, a normalização de intensidade foi implementada como normalização por escore padrão conforme na Equação (1).
 (1)
em que μ, σ são as médias e desvios padrão dos canais calculados ao longo do conjunto de treinamento, ou como normalização min–max conforme a Eq. (2).
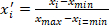 (2)
Após a normalização, cada quadro foi representado como F̃t ∈ RH′×W′×C′ e o tensor de vídeo resultante foi representado como V′ ∈ RT×H′×W′×C. Em uma interface frontal convolucional multi-escala, vários mapas de características espaciais com campos receptivos diferentes são obtidos mediante a aplicação de diversas convoluções 2-D (ou 3-D para as primeiras convoluções espaciotemporais) com tamanhos de kernel distintos; uma representação de características temporais foi então gerada para cada quadro ou trecho curto de vídeo e encaminhada ao módulo LSTM. O artigo original aplica o MobileNetV2 e, em seguida, o Deep BiLSTM para modelagem temporal; o mesmo pipeline de pré-processamento descrito é totalmente compatível com a substituição por uma arquitetura baseada em convolução multi-escala + LSTM.
3. Amostragem e normalização temporal
Como os comprimentos dos vídeos T variam entre e dentro dos conjuntos de dados, amostramos uniformemente ou reamostramos temporalmente os quadros para fornecer ao modelo de convolução em múltiplas escalas + LSTM um comprimento de entrada fixo N em termos de quadros ou segmentos curtos. Os índices uniformes dos quadros podem ser calculados conforme a Equação (3),
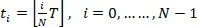 (3)
assim, a sequência de quadros amostrada é Vs = {F̃t0, …, F̃tN−1}. Quando é necessária uma fidelidade temporal mais refinada, realizamos interpolação temporal linear: para qualquer tempo fracionário reamostrado τ ∈ [0, T−1] calculado conforme a Equação (4).
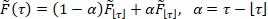 (4)
de modo que a sequência reamostrada Vs tenha exatamente N quadros e preserve o movimento suave. Alternativamente, o reamostragem por clipes curtos e contíguos (comprimento da janela temporal w com passo s) produz um conjunto de tensores de clipe em que cada clipe Cj ∈ RT×H′×W′×C e j = 0, …, ⌊(T − w)/s⌋. Para normalização temporal dentro da rede, um simples agrupamento temporal em múltiplas escalas é eficaz: dada uma sequência de características temporais X = {x1, …, xN} gerada por convoluções em múltiplas escalas, aplique as características agrupadas conforme a Eq. (5).
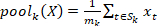 (5)
em que Sk é o suporte temporal para a escala k (por exemplo, Sk pode ser blocos não sobrepostos ou índices dilatados) e mk = |Sk|.
Antes da extração de características, todos os vídeos foram redimensionados para 224 × 224 pixels e amostrados a 25 quadros por segundo. Cada experimento utilizou um comprimento de sequência constante de 32 quadros. Entre as técnicas de aumento de dados estavam o recorte aleatório (escala = 0,8–1,0), rotação aleatória (±15°), inversão horizontal aleatória (probabilidade = 0,5) e modificação de brilho (±20%). Os valores médios do ImageNet [0,485, 0,456, 0,406] e os desvios padrão [0,229, 0,224, 0,225] foram utilizados para padronizar os valores dos pixels. Para cada sequência de vídeo, foi utilizada seleção uniforme de quadros para amostragem temporal. Filmes mais longos foram uniformemente recortados ou amostrados para manter um comprimento de sequência consistente, enquanto vídeos com menos de 32 quadros foram preenchidos com zeros. Durante todo o treinamento e avaliação, essas configurações foram constantemente utilizadas.
4. Extração de características usando MSCNN
Uma rede neural convolucional multi-escala (MSCNN) foi empregada para aprimorar a representação espacial de ações em vídeos esportivos. Redes neurais convolucionais convencionais que dependem de um único tamanho de kernel podem ter capacidade limitada para capturar características em múltiplas escalas espaciais. Como algumas ações esportivas exibem características visuais semelhantes, pode ser difícil para uma arquitetura convolucional de escala única capturar simultaneamente características locais e globais. Para superar essa limitação, o framework proposto utiliza kernels convolucionais de diferentes tamanhos para realizar extração multi-escala de características e fusão de características.
Na arquitetura de rede proposta, foram utilizados kernels de convolução 1 × 1 para organizar as informações entre os canais e reduzir a dimensionalidade dos mapas de características de entrada. Além disso, essas camadas aumentam a capacidade expressiva da rede ao introduzir transformações de características adicionais e representações não lineares. Kernels de convolução de diferentes tamanhos permitem a extração de informações espaciais em múltiplas escalas. A normalização sequencial é realizada após a fusão ponderada de características em múltiplas escalas para melhorar a estabilidade do treinamento. A fim de mitigar os problemas de desaparecimento e explosão de gradientes durante o treinamento de redes profundas, a arquitetura sugerida utiliza conexões residuais e modelagem temporal baseada em LSTM.
O design multiescala aprimora a capacidade da rede de captar características em diferentes resoluções espaciais e melhora a capacidade de representação de características. Além disso, o kernel convolucional convencional de N × N é decomposto em operações convolucionais de N × 1 e 1 × N. As convoluções de N × 1 e 1 × N empregadas no módulo MSCNN são projetadas para captar características espaciais multiescala e direcionais complementares de quadros de vídeo individuais. Essas operações convolucionais aprimoram a representação de características espaciais ao extrair padrões em diferentes escalas de campo receptivo. As relações temporais entre quadros consecutivos são posteriormente modeladas pelo módulo LSTM, que processa a sequência de características extraídas pelo MSCNN para aprender dependências temporais de longo prazo na reconhecimento de ações.
Cada vídeo esportivo V = {F1, F2, …, FT} é decomposto em T quadros. Para codificar variações espaciais, por exemplo, postura dos jogadores, borrão de movimento, trajetória da bola, ramificações convolucionais em três escalas diferentes operam em s ∈ {1, 2, 3}, correspondendo a tamanhos de kernel 3 × 3, 5 × 5 e 7 × 7. Cada ramificação extrai mapas de características conforme a Equação (6):
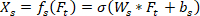 (6)
Onde Ws e bs são os pesos e os viéses da convolução na escala s, e σ é a ativação ReLU. A camada de fusão multi-escala agrega as características conforme a Eq. (7):
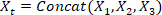 (7)
Esse tensor de características fundido incorpora tanto pistas de movimento finamente detalhadas quanto informações contextuais de grande área, como atividades em grupo. Figura 3 ilustra apenas o módulo de extração de características MSCNN. A camada LSTM (256 unidades ocultas), camada densa (128 neurônios) e camada de dropout (0,5) utilizadas para modelagem temporal e classificação são apresentadas separadamente na Figura 4.
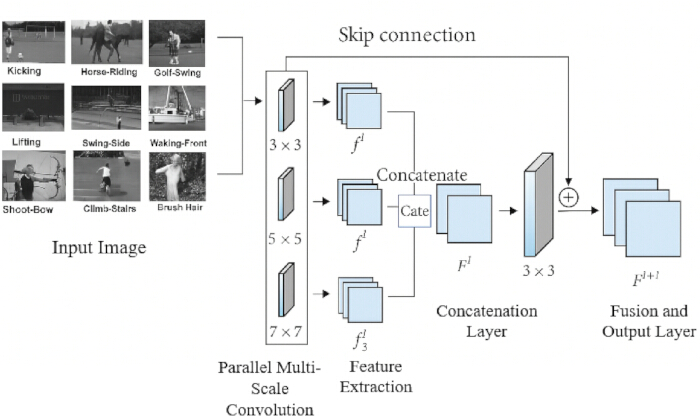
Figura 3: Módulo proposto de extração de características da rede neural convolucional multi-escala (MSCNN). Três ramificações convolucionais paralelas com tamanhos de kernel de 3 × 3, 5 × 5 e 7 × 7 extraem características espaciais multi-escala complementares, que são fundidas antes da modelagem temporal pela rede LSTM. Clique aqui para visualizar uma versão maior desta figura.
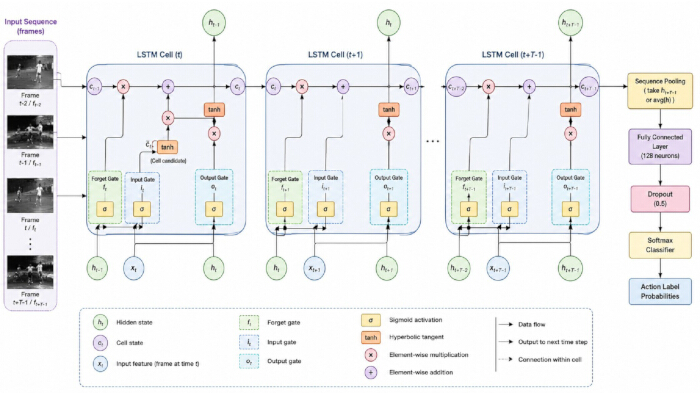
Figura 4: Arquitetura LSTM proposta para reconhecimento de ações em vídeos esportivos. O módulo LSTM modela dependências temporais por meio das operações das portas de entrada, esquecimento e saída em quadros de vídeo consecutivos. Clique aqui para visualizar uma versão maior desta figura.
Figura 3 ilustra o módulo proposto de extração de características da Rede Neural Convolucional Multiescala (MSCNN) para reconhecimento de ações em vídeos esportivos. Os quadros de vídeo de entrada foram processados em paralelo por meio de três ramificações convolucionais com tamanhos de kernel de 3 × 3, 5 × 5 e 7 × 7, cada uma contendo 64 filtros para capturar características espaciais finas e de granulação grossa complementares. As saídas foram refinadas usando normalização por lote (Batch Normalization), ativação ReLU e agrupamento máximo (max pooling) 2 × 2, concatenadas e fundidas por uma convolução 1 × 1 com 128 filtros. Uma conexão de salto residual preservou informações espaciais de baixo nível e melhorou o fluxo de gradientes. Os mapas de características fundidos foram aplainados e encaminhados a uma camada LSTM com 256 unidades ocultas para modelagem temporal, seguida por uma camada totalmente conectada com 128 neurônios, ativação ReLU e taxa de dropout de 0,5 antes da classificação final usando uma camada Softmax. Os mapas de características multiescala (f1l, f2l e f3l) foram concatenados para formar a representação fundida (Fl), que foi posteriormente refinada por uma convolução 3 × 3 para gerar o mapa de características de saída para a camada subsequente. Essa arquitetura hierárquica permitiu a aprendizagem de características espaciais complementares em múltiplos campos receptivos, melhorando o desempenho no reconhecimento de ações esportivas.
5. Modelagem temporal usando LSTM
Para modelar a evolução baseada no tempo ao longo das bordas do vídeo, a sequência de características agregadas foi fornecida ao sistema LSTM para capturar dependências dinâmicas e continuidade do movimento. Para cada vídeo de entrada, extraímos inicialmente características CNN em múltiplas escalas por quadro. Sejam os quadros do vídeo I1, …, IT. Para cada quadro t e cada escala s, o codificador convolucional em múltiplas escalas produz um vetor de características ft(s) ∈ Rd. Em seguida, fusione as escalas em um único descritor de quadro por meio de projeção + concatenação ou soma ponderada, conforme na Equação (8):
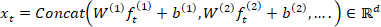 (8)
Em seguida, insira a sequência {xt}tT=1 em uma LSTM para modelar a dinâmica temporal. Na notação padrão da LSTM, no tempo t as portas e estados são dados pelas equações (9) a (13):
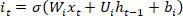 (9)
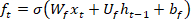 (10)
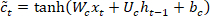 (11)
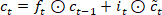 (12)
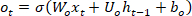 (13)
Aqui, σ é a ativação sigmoide, ⊙ é a multiplicação elemento a elemento. Embora arquiteturas LSTM bidirecionais possam ser usadas para capturar o contexto temporal passado e futuro, o framework proposto emprega um LSTM padrão para modelar dependências temporais ao longo de quadros de vídeo sequenciais. Essa escolha de design é consistente com a arquitetura MSCNN-LSTM apresentada neste estudo. Após o processamento do clipe, obteve-se uma representação do clipe (por exemplo, último estado oculto ou agrupamento temporal): z = Poolt(vt).
Figura 4 ilustra o fluxo de trabalho da arquitetura LSTM proposta para reconhecimento de ações esportivas. A rede recebeu uma sequência de quadros de vídeo ou características extraídas por CNN e as processou em etapas de tempo sucessivas (t−2, t−1 e t). Cada célula LSTM compunha-se de um portão de entrada, um portão de esquecimento e um portão de saída, que regulavam o fluxo de informações pela rede. O portão de entrada incorporava novas informações ao estado da célula, o portão de esquecimento descartava informações temporais irrelevantes e o portão de saída gerava o estado oculto propagado para a próxima etapa de tempo. O estado da célula preservava dependências temporais de longo prazo, enquanto o estado oculto capturava informações temporais de curto prazo. Após o processamento sequencial, as saídas do LSTM foram agrupadas para gerar uma representação de características temporais, que foi encaminhada a uma camada totalmente conectada e a um classificador Softmax para prever a ação esportiva correspondente. A rede foi treinada usando o otimizador Adam por 100 épocas com um tamanho de lote de 32, taxa de aprendizado inicial de 0,001 e função de perda de entropia cruzada. O modelo com menor perda de validação foi selecionado para avaliação final. Para garantir reprodutibilidade, todos os experimentos foram conduzidos usando uma semente aleatória fixa de 42. Parada antecipada e redução da taxa de aprendizado em platô foram utilizadas para melhorar a convergência, e o recorte de gradientes com um limite de 5,0 foi aplicado durante o treinamento do LSTM para evitar gradientes explosivos. O modelo proposto MSCNN-LSTM continha aproximadamente 15 milhões de parâmetros treináveis.
As pontuações finais das classes e as probabilidades utilizam uma camada linear + softmax conforme na Eq. (14):
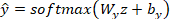 (14)
Treine minimizando a perda de entropia cruzada nos clipes rotulados conforme a Eq. (15):
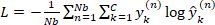 (15)
onde Nb é o tamanho do lote, C o número de classes e y(n) é a verdadeira classe codificada em one-hot. Aplica-se regularização (dropout nas saídas de xt/LSTM, decaimento de peso) e limitação do gradiente para melhorar a estabilidade em sequências longas de esportes.
Resultados
O modelo proposto MSCNN-LSTM foi treinado e avaliado nos conjuntos de dados UCF11 (YouTube Actions), UCF Sports e JHMDB, que incluíam diversas ações esportivas, pontos de vista e padrões de movimento. Como as distribuições das classes eram suficientemente balanceadas, não foram aplicados procedimentos adicionais de ponderação de classes ou reamostragem. Os modelos comparadores foram implementados utilizando os hiperparâmetros relatados em seus estudos originais, com configurações de treinamento harmonizadas sempre que viável. Os resultados foram apresentados como média ± desvio padrão de cinco execuções independentes com diferentes inicializações aleatórias. As diferenças entre o modelo proposto e os modelos comparadores foram avaliadas utilizando testes t pareados com um limiar de significância de p < 0,05.
Figura 5 compara a precisão de classificação entre os três conjuntos de dados. O modelo MSCNN-LSTM alcançou a maior precisão, atingindo 98,3% em UCF11, 95,4% em UCF Sports e 81,7% em JHMDB. Esses valores superaram os obtidos pelos modelos Dilated CNN–BiLSTM, Two-Stream LSTM e ViT-ReT. A menor precisão em JHMDB reflete a maior dificuldade em reconhecer ações finamente detalhadas em vídeos de menor resolução.
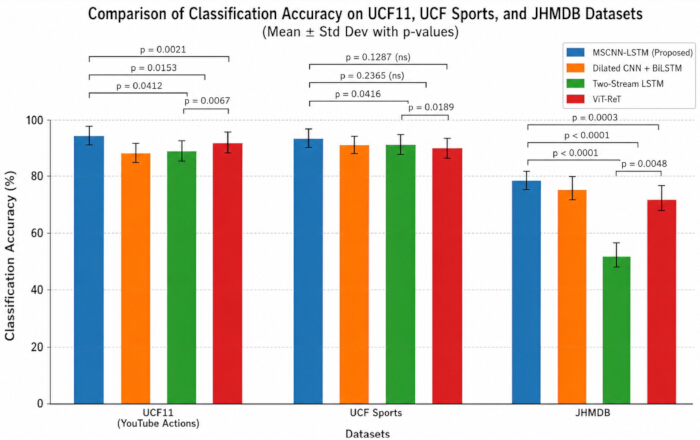
Figura 5: Comparação da precisão de classificação (%) de diferentes modelos de aprendizado profundo em conjuntos de dados de vídeos esportivos. Precisão de classificação do MSCNN-LSTM, ViT-ReT, Two-Stream LSTM e Dilated CNN + BiLSTM nos conjuntos de dados UCF11, UCF Sports e JHMDB. Os resultados são apresentados como média ± DP de cinco execuções independentes (n = 5). As barras de erro representam um desvio padrão. A significância estatística foi avaliada utilizando testes t pareados bicaudais (p < 0,05). Clique aqui para visualizar uma versão maior desta figura.
O modelo proposto também alcançou a maior precisão em todos os conjuntos de dados, com valores de aproximadamente 96% no UCF11, 93% no UCF Sports e 78% no JHMDB (Figura 6). Os valores de revocação foram aproximadamente 95%, 94% e 77%, respectivamente (Figura 7), enquanto as pontuações F1 correspondentes foram de aproximadamente 95,5%, 93,5% e 77,5% (Figura 8). Esses resultados indicaram que o modelo manteve um equilíbrio favorável entre identificar corretamente as classes de ação e limitar previsões falsas positivas.
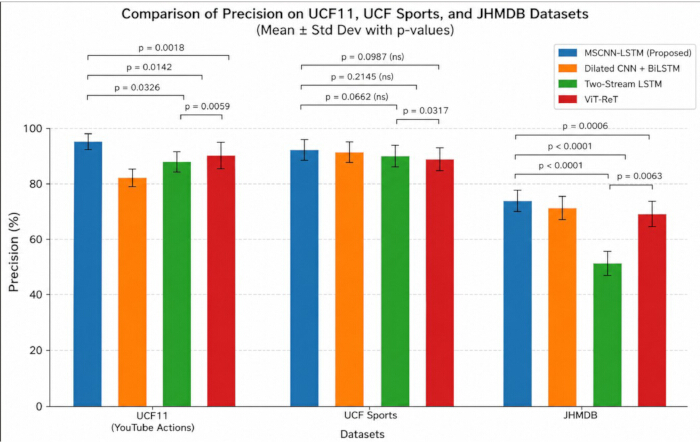
Figura 6: Comparação da precisão (%) de diferentes modelos de aprendizado profundo em conjuntos de dados de vídeos esportivos. Os valores de precisão são apresentados como média ± DP a partir de cinco execuções independentes (n = 5). As barras de erro representam um desvio padrão. A significância estatística foi avaliada utilizando testes t pareados bicaudais (p < 0,05). Clique aqui para visualizar uma versão maior desta figura.
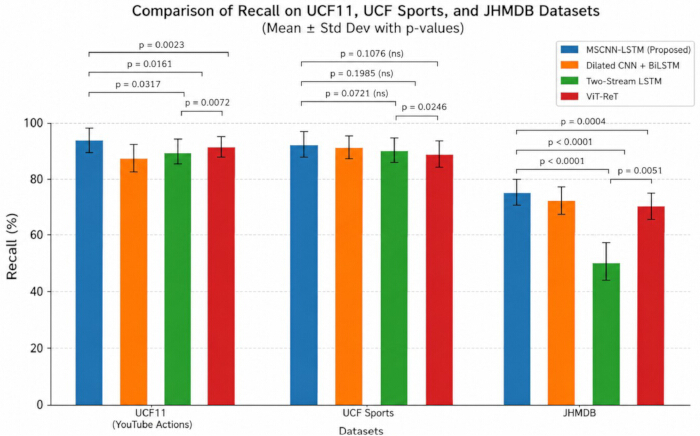
Figura 7: Comparação da taxa de recuperação (%) de diferentes modelos de aprendizado profundo em conjuntos de dados de vídeos esportivos. Os valores de recuperação são apresentados como média ± DP de cinco execuções independentes (n = 5). As barras de erro representam um desvio padrão. A significância estatística foi avaliada utilizando testes t pareados bicaudais (p < 0,05). Clique aqui para visualizar uma versão maior desta figura.
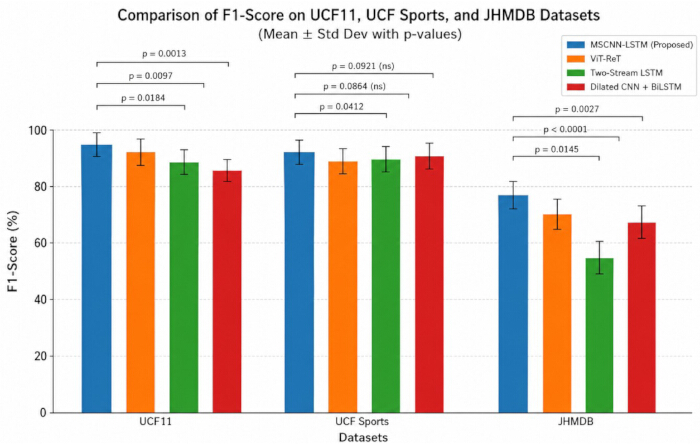
Figura 8: Comparação do escore F1 (%) de diferentes modelos de aprendizado profundo em conjuntos de dados de vídeos esportivos. Os escores F1 são apresentados como média ± DP de cinco execuções independentes (n = 5). As barras de erro representam um desvio padrão. A significância estatística foi avaliada utilizando testes t pareados bicaudais (p < 0,05). Clique aqui para visualizar uma versão maior desta figura.
Tabela 5 apresenta os resultados do kappa de Cohen e do coeficiente de correlação de Matthews. No UCF11, o modelo proposto alcançou κ = 0,96 e MCC = 0,96, em comparação com valores de κ/MCC de 0,92/0,92 para o ViT-ReT, 0,90/0,90 para o Two-Stream LSTM e 0,87/0,87 para o Dilated CNN–BiLSTM. No UCF Sports, o MSCNN-LSTM alcançou κ = 0,95 e MCC = 0,94, superando os valores correspondentes obtidos pelo ViT-ReT (0,90/0,90), Two-Stream LSTM (0,88/0,89) e Dilated CNN–BiLSTM (0,84/0,85). No JHMDB, o modelo proposto alcançou κ = 0,83 e MCC = 0,84, em comparação com 0,74/0,75 para o ViT-ReT, 0,70/0,71 para o Two-Stream LSTM e 0,71/0,72 para o Dilated CNN–BiLSTM. Esses resultados demonstraram maior concordância entre as etiquetas previstas e as etiquetas reais para o modelo proposto.
| Modelo | Conjunto de Dados | Kappa de Cohen (κ) | Coeficiente de Correlação de Matthews (MCC) |
| CNN com Dilatação + BiLSTM [4] | UCF11 (Ações do YouTube) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| LSTM de Duas Vias [38] | UCF11 (Ações do YouTube) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Transformador de Visão + Transformador Recorrente) [6] | UCF11 (Ações do YouTube) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| MSCNN–LSTM Proposto | UCF11 (Ações do YouTube) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
Tabela 5: Comparação do kappa de Cohen (κ) e coeficiente de correlação de Matthews (MCC) entre diferentes modelos de aprendizado profundo. Comparação de desempenho entre MSCNN-LSTM, ViT-ReT, Two-Stream LSTM e Dilated CNN + BiLSTM nos conjuntos de dados UCF11, UCF Sports e JHMDB. Valores mais altos indicam maior concordância entre rótulos previstos e reais e maior confiabilidade na classificação. Os valores são apresentados como média ± DP de cinco execuções independentes (n = 5).
Figura 9 apresenta as curvas de característica operacional do receptor. A MSCNN-LSTM proposta alcançou valores de AUC de 0,975 no UCF11, 0,961 no UCF Sports e 0,937 no JHMDB. Os valores consistentemente altos de AUC indicaram forte discriminação entre classes de ações em conjuntos de dados de complexidade variada.
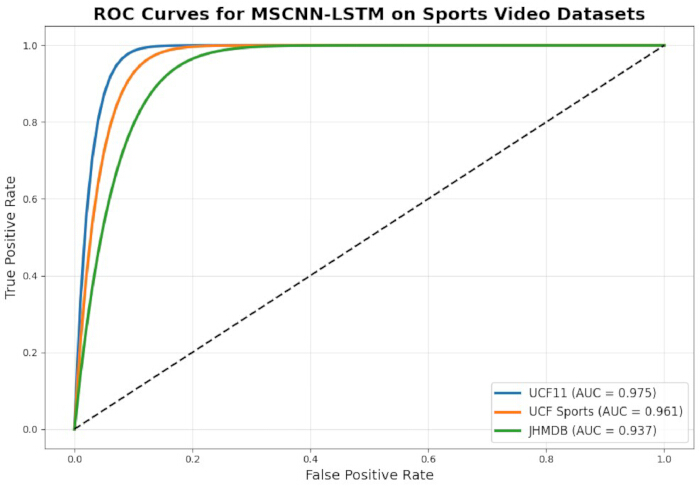
Figura 9: Curvas da característica operacional do receptor (ROC) do modelo proposto MSCNN-LSTM. Curvas ROC para os conjuntos de dados UCF11, UCF Sports e JHMDB, ilustrando o compromisso entre a taxa de verdadeiros positivos e a taxa de falsos positivos. A área sob a curva (AUC) resume o desempenho discriminativo do modelo em diferentes limiares de classificação. Clique aqui para visualizar uma versão maior desta figura.
Os resultados de desempenho temporal são resumidos na Tabela 6. No UCF11, o modelo proposto alcançou um mAP-T de 98,3%, acurácia ao nível dos quadros de 96,5% e TSI de 0,95. No UCF Sports, os valores correspondentes foram 95,4%, 94,0% e 0,93. No JHMDB, o modelo alcançou um mAP-T de 81,7%, acurácia ao nível dos quadros de 78,9% e TSI de 0,88 (Tabela 7). Esses valores foram superiores aos obtidos pelos modelos comparadores e indicaram maior coerência temporal e estabilidade de predição em sequências de ações de curta e longa duração.
| Método | Conjunto de Dados | mAP-T (%) | Acurácia por Quadro (%) | Índice de Estabilidade Temporal (TSI) |
| CNN Dilatada + BiLSTM4 | UCF11 (Ações do YouTube) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| UCF Sports | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| LSTM de Dois Fluxos38 | UCF11 (Ações do YouTube) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| UCF Sports | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Transformador de Visão + Transformador Recorrente)6 | UCF11 (Ações do YouTube) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| UCF Sports | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (Ações do YouTube) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| UCF Sports | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
Tabela 6: Comparação de métricas temporais de desempenho para reconhecimento de ações em vídeos esportivos. Resultados experimentais da média de Precisão Média sobre Segmentos Temporais (mAP-T), acurácia no nível de quadro e Índice de Estabilidade Temporal (TSI) para diferentes modelos de aprendizado profundo nos conjuntos de dados de referência. Os valores são apresentados como média ± DP a partir de cinco execuções independentes (n = 5).
| Configuração | CNN Multiescala (MSCNN) | LSTM | Exatidão (%) | Pontuação F1 (%) | mAP-T (%) |
| Linhas de base somente CNN | ✗ | ✗ | 90,4 ± 1,2 | 89,8 ± 1,3 | 88,9 ± 1,4 |
| CNN + LSTM | ✗ | ✓ | 93,1 ± 0,9 | 92,4 ± 1,0 | 91,7 ± 1,1 |
| Somente MSCNN | ✓ | ✗ | 94,2 ± 0,8 | 93,6 ± 0,9 | 92,8 ± 1,0 |
| MSCNN-LSTM proposto | ✓ | ✓ | 98,3 ± 0,5 | 97,8 ± 0,6 | 97,1 ± 0,6 |
Tabela 7: Estudo de ablação da estrutura proposta MSCNN-LSTM. Contribuição de desempenho dos componentes MSCNN e LSTM em configurações idênticas de treinamento e avaliação. Os valores são apresentados como média ± DP de cinco execuções independentes (n = 5).
Figura 10, Figura 11, Figura 12 apresentam as matrizes de confusão normalizadas por linha para UCF11, UCF Sports e JHMDB, respectivamente. As três matrizes mostraram uma clara dominância diagonal, indicando que a maioria das classes de ação foi corretamente identificada. Erros limitados fora da diagonal ocorreram principalmente entre ações com características visuais ou de movimento semelhantes. A matriz de JHMDB exibiu uma confusão de classes comparativamente maior, consistente com o desempenho quantitativo inferior observado neste conjunto de dados mais desafiador.
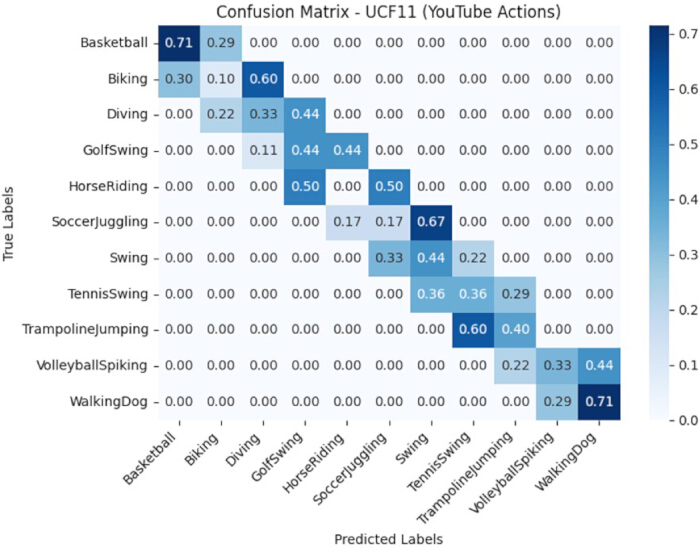
Figura 10: Matriz de confusão normalizada por linha do modelo proposto MSCNN-LSTM no conjunto de dados UCF11. Cada linha é normalizada para a unidade, e as entradas diagonais representam a taxa de acerto por classe, em vez da precisão geral de classificação, que é informada separadamente. Clique aqui para visualizar uma versão maior desta figura.
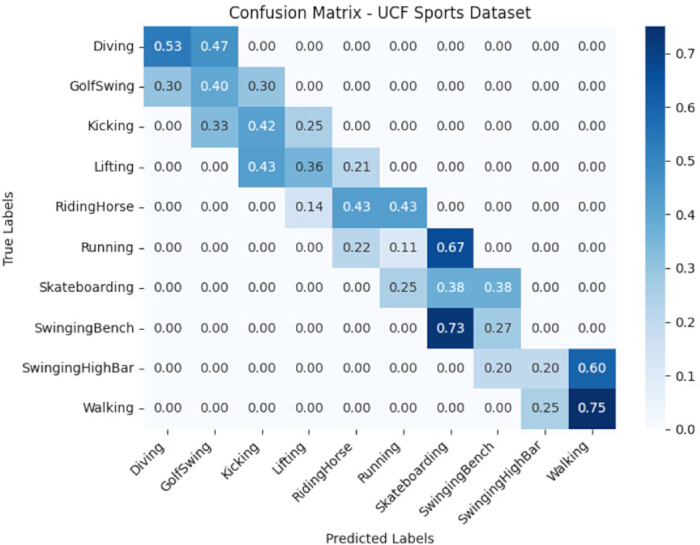
Figura 11: Matriz de confusão normalizada por linha do modelo proposto MSCNN-LSTM no conjunto de dados UCF Sports. Cada linha é normalizada em relação à unidade, e as entradas diagonais representam a taxa de recuperação por classe, em vez da precisão geral de classificação, que é informada separadamente. Clique aqui para visualizar uma versão maior desta figura.
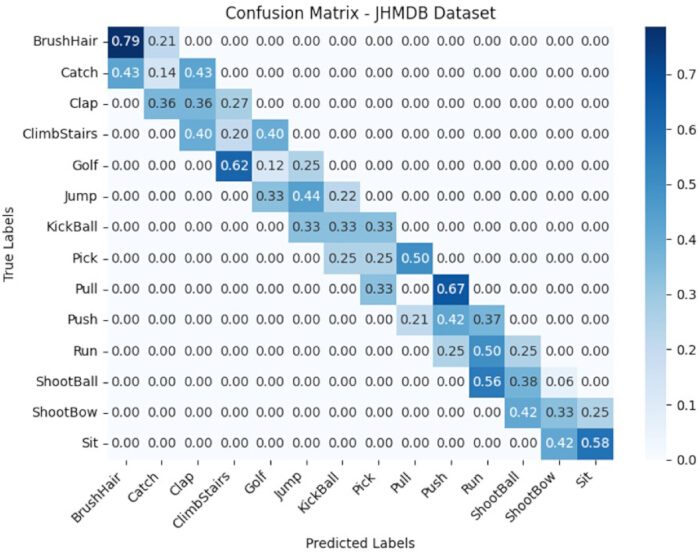
Figura 12: Matriz de confusão normalizada por linha do modelo proposto MSCNN-LSTM no conjunto de dados JHMDB. Cada linha é normalizada para a unidade, e as entradas diagonais representam a taxa de acerto por classe, em vez da precisão geral da classificação, que é informada separadamente. Clique aqui para visualizar uma versão maior desta figura.
No geral, o framework proposto MSCNN-LSTM superou consistentemente os modelos comparadores avaliados nas medidas de classificação, concordância, discriminação e estabilidade temporal. Os resultados apoiaram a hipótese de que a combinação da extração multi-escala de características espaciais com modelagem temporal baseada em LSTM aprimorou o reconhecimento de ações esportivas em conjuntos de dados com diferentes níveis de complexidade de movimento, qualidade de imagem e condições de ponto de vista.
DISPONIBILIDADE DE DADOS:
Os conjuntos de dados analisados durante o presente estudo estão disponíveis publicamente nas seguintes fontes: o conjunto de dados UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) e o conjunto de dados UCF Sports (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). Para apoiar a reprodutibilidade deste estudo, o pipeline de pré-processamento, a partição dos conjuntos de dados (geração da divisão treino/validação/teste), os arquivos de implementação, arquivos de configuração e a documentação complementar utilizados nos experimentos foram depositados no repositório Zenodo e estão disponíveis publicamente em https://doi.org/10.5281/zenodo.21020947.
Discussão
O framework proposto MSCNN-LSTM superou consistentemente as abordagens avaliadas nos conjuntos de dados de referência UCF11, UCF Sports e JHMDB. Métodos anteriores baseados em Dilated CNN–BiLSTM, arquiteturas Vision Transformer e CNNs 3D demonstraram aprendizado eficaz de características espaciais e temporais, mas podem ser limitados pela alta complexidade computacional, requisitos substanciais de treinamento ou representação insuficiente de padrões de movimento finos23,24,25. Em contraste, o framework proposto integrou a extração multi-escala de características espaciais com modelagem temporal baseada em LSTM, permitindo a captura de detalhes locais de movimento e dependências temporais de longo alcance. Essa integração melhorou o reconhecimento de ações esportivas complexas, reduziu a confusão entre classes e aumentou a consistência temporal, especialmente no conjunto de dados JHMDB, mais desafiador. Esses resultados indicam que o framework proposto forneceu uma representação equilibrada de informações espaciais e temporais em comparação com as abordagens baseadas em CNN, redes recorrentes e transformadores avaliadas.
Do ponto de vista teórico, o framework MSCNN-LSTM ofereceu uma abordagem unificada para a fusão de características em múltiplas escalas e o aprendizado sequencial temporal36,37. O uso de campos receptivos hierárquicos permitiu a extração de informações espaciais em diferentes escalas, enquanto a LSTM modelou as dependências entre quadros consecutivos de vídeo. Esse design ampliou o pipeline convencional CNN-LSTM ao preservar informações espaciais locais e contextuais antes da modelagem temporal. O desempenho consistente em conjuntos de dados contendo diferentes classes de ações, padrões de movimento e pontos de vista da câmera reforçou ainda mais a robustez da arquitetura proposta.
Do ponto de vista prático, a estrutura mostrou potencial para análise esportiva automatizada, avaliação do desempenho de atletas, detecção de eventos e compreensão de vídeos esportivos. No entanto, é necessária uma validação adicional em condições operacionais do mundo real antes da implantação. Embora a arquitetura tenha alcançado um desempenho robusto em reconhecimento, sua adequação para dispositivos com recursos limitados ou plataformas de análise baseadas em nuvem deve ser confirmada por meio de avaliação adicional do custo computacional, tempo de inferência, requisitos de memória e consumo de energia.
O estudo de ablação demonstrou as contribuições complementares dos componentes MSCNN e LSTM. A MSCNN aprimorou a extração de características espaciais ao aprender representações em múltiplas escalas de campo receptivo, enquanto o LSTM melhorou a modelagem temporal ao capturar dependências de movimento entre quadros consecutivos. A configuração completa MSCNN-LSTM alcançou o melhor desempenho, indicando que a extração multi-escalar de características espaciais e a modelagem de sequências temporais contribuíram conjuntamente para a melhoria observada no reconhecimento de ações.
No geral, o framework proposto MSCNN-LSTM combinou efetivamente a aprendizagem de representações espaciais e temporais para o reconhecimento de ações em vídeos esportivos. A avaliação nos conjuntos de dados UCF11, UCF Sports e JHMDB mostrou desempenho superior em comparação com as abordagens de aprendizagem profunda avaliadas. Esses resultados corroboram a hipótese de que a integração de características convolucionais em múltiplas escalas com modelagem temporal baseada em LSTM melhora o reconhecimento de ações esportivas complexas. Contudo, é necessária validação em conjuntos de dados maiores, mais diversos e de domínios distintos para estabelecer generalização e aplicabilidade no mundo real.
Várias limitações devem ser consideradas. Primeiro, a avaliação foi restrita a conjuntos de dados de referência de acesso público e pode não representar plenamente a diversidade e complexidade dos ambientes esportivos do mundo real. Segundo, embora tenham sido utilizadas partições fixas de treinamento, validação e teste, o viés do conjunto de dados e vazamentos não intencionais de dados não puderam ser completamente excluídos. Terceiro, o desempenho relatado pode variar de acordo com a composição do conjunto de dados, inicialização do modelo, procedimentos de pré-processamento e configurações de treinamento. Além disso, os componentes de modelagem convolucional e temporal em múltiplas escalas aumentaram os requisitos computacionais, o que pode afetar a implantação em dispositivos com recursos limitados. O framework também não foi avaliado utilizando conjuntos de dados externos ou cenários de produção em tempo real.
Modelos de vídeo baseados em transformadores demonstraram alto desempenho em conjuntos de dados de reconhecimento de ações em larga escala, mas frequentemente exigem recursos computacionais substanciais e grandes volumes de dados de treinamento. A estrutura proposta MSCNN-LSTM oferece uma abordagem alternativa combinando extração de características espaciais em múltiplas escalas com modelagem temporal recorrente. Trabalhos futuros devem investigar validação entre conjuntos de dados, inferência em tempo real, otimização computacional, estimativa de incerteza e arquiteturas híbridas que integrem mecanismos de atenção baseados em transformadores à estrutura proposta de CNN-LSTM em múltiplas escalas38.
Divulgações
Os autores declaram não haver conflitos de interesses.
Agradecimentos
Esta pesquisa foi conduzida no Centro de Tecnologia de Inteligência Artificial (CAIT), Faculdade de Ciência e Tecnologia da Informação, Universiti Kebangsaan Malaysia. Os autores agradecem sinceramente o apoio institucional e as instalações de pesquisa fornecidas. Este trabalho não recebeu financiamento específico de qualquer agência pública, comercial ou sem fins lucrativos.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| GPU GeForce RTX 3090 | NVIDIA Corporation | RTX 3090, 24 GB VRAM | Utilizado para treinamento e inferência de modelos de aprendizado profundo |
| Processador Intel Core i9 | Intel Corporation | 16 núcleos, 3,5 GHz | Utilizado para pré-processamento e computação de dados |
| Memória do sistema | Genérico | 64 GB de RAM DDR4 | Suporta processamento de vídeo em larga escala |
| Linguagem de programação Python | Python Software Foundation | Versão 3.8.18 | Linguagem de programação principal para implementação |
| TensorFlow | Versão 2.15 | Framework de aprendizado profundo utilizado para desenvolvimento de modelos | |
| Sistema operacional | Microsoft Corporation | Windows 11 | Desenvolvimento e experimentação de modelos |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | Aceleração da GPU para treinamento de modelos |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Biblioteca de aceleração para redes neurais profundas |
| OpenCV | Código aberto | Versão 4.8.1 | Extração e pré-processamento de quadros de vídeo |
| NumPy | Código aberto | Versão 1.24.4 | Computação numérica e processamento de arrays |
| Scikit-learn | Código aberto | Versão 1.3.2 | Avaliação de desempenho e análise estatística |
| Matplotlib | Código aberto | Versão 3.7.5 | Visualização dos resultados experimentais |
| Conjunto de dados UCF11 | Universidade da Flórida Central | Conjunto de dados público | Conjunto de dados de referência para reconhecimento de ações esportivas |
| Conjunto de dados UCF Sports | Universidade da Flórida Central | Conjunto de dados público | Conjunto de dados de referência para reconhecimento de ações esportivas |
| Conjunto de dados JHMDB | Instituto Max Planck de Informática | Conjunto de dados público | Conjunto de dados de referência para reconhecimento de movimento e ações humanas |
Referências
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543