Este estudo propõe um algoritmo que acopla de forma rígida as características visuais hierárquicas capturadas por um codificador transformador hierárquico de janela deslocada com a profundidade prévia da caixa delimitadora 3D Manhattan gerada pela detecção de segmentos de linha, alcançando assim a reconstrução semântica de alta precisão de cenas internas complexas.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Um método de análise semântica para imagens de cenas internas baseado em conhecimento prévio da estrutura do edifício
Neste artigo
Resumo
Resumo
Para abordar descontinuidades de predição semântica e distorções físicas de fronteira causadas pela oclusão de móveis em cenas internas complexas, este artigo propõe um método de análise semântica que aproveita os prévios estrutura-edifício. O esquema utiliza um codificador hierárquico de transformador com janelas deslocadas para extrair características visuais multiescala e combina um algoritmo de detecção de segmentos de linha com consistência gradiente-direção para construir uma caixa delimitadora 3D Manhattan. Essa caixa delimitadora é transformada em um campo de distância assinado (SDF) antes de codificar contornos geométricos discretos em um campo contínuo de potencial físico. Um mecanismo de atenção cruzada guiado pela estrutura força os sinais visuais a se alinharem com limites geométricos ortogonais 3D reais, restaurando a continuidade das características em áreas ocluidas. Um grafo de adjacência espacial construído a partir de nós superpixel impulsiona uma Rede Convolucional de Grafos (GCN) para agregar características, garantindo consistência semântica macroscópica dentro do plano físico de suporte. Uma combinação de perda de entropia cruzada em nível de pixel e uma perda estrutural de consistência projetada sob medida fortalece as restrições, penalizando previsões fora dos limites. Experimentos em múltiplas execuções independentes mostram que a interseção média sobre união (mIoU) atinge 68,7% com desvio padrão de 0,2%, e a pontuação F1 do limite estrutural chega a 76,4% com desvio padrão de 0,3%, confirmando o desempenho robusto dos módulos propostos. Com um único nó de imagem de 256, o tempo médio de inferência permaneceu em 61 ms.
Introdução
A análise semântica de imagens de cenas internas ocupa uma posição central em tarefas de cognição espacial tridimensional e raciocínio espacialinteligente 1,2. A extração de características visuais em ambientes físicos reais é frequentemente severamente prejudicada por layouts espaciaiscomplexos 3. Resolver a descontinuidade semântica e a distorção física dos limites da estrutura da fundação do edifício causada pela oclusão em grande escala de móveis é importante para a pesquisa em cogniçãoespacial 4,5. Remover com precisão interferências de objetos desordenados e restaurar a continuidade física da mesma parede e piso determinará diretamente a precisão da reconstrução tridimensional da cena e da análise lógica espacialglobal 6. A descontinuidade semântica causada pela oclusão em grande escala de móveis e o efeito de reparo estrutural da orientação prévia proposta para edifícios são ilustrados na Figura 1, onde a entrada ocluida vermelho-verde-azul (RGB) na Tabela 1A, a distorção da máscara de base na Figura 1B e o resultado de reparo prévio da estrutura na Figura 1C são comparados sob a mesma condição interna da cena.
Para atender aos requisitos de precisão do raciocínio lógico espacial, as redes visuais atuais baseadas em pixels enfrentam múltiplos obstáculos ao lidar com ambientes internoscomplexos 7,8. Os espaços internos costumam ser preenchidos com móveis densos e móveis bagunçados, resultando em uma perda significativa de sinais de limites visuais em baixo nível nasimagens 9. Mecanismos convencionais de extração de características dependem excessivamente de respostas locais bidimensionais de cor e textura, carecendo de uma compreensão macroscópica das leis ortogonais rígidas das estruturas tridimensionais feitaspelo homem 10. Essa limitação do campo receptivo local torna a propagação de características facilmente interrompida, dificultando a extensão da topologia global através dasoclusões 11. Atualmente, há uma necessidade urgente de resolver o problema central das descontinuidades da predição semântica e das distorções severas das fronteiras físicas causadas pela oclusão einterferência 12.
Para corrigir falhas estruturais nas fundações dos edifícios causadas por oclusão e interferência, a comunidade acadêmica desenvolveu uma variedade de medidas de intervençãodirecionadas 13. Redes de agregação de características intermodais compensam efetivamente as deficiências inerentes de uma única modalidade visual na percepção espacial ao introduzir mapas de profundidade ou priors de texto para auxiliar com imagens vermelho-verde-azul (RGB) 14,15. Estruturas de percepção de limites e seleção adaptativa de contexto injetam estratégias de aprimoramento físico de contornos na etapa de decodificação de características, o que melhora muito o ajuste das bordas dos resultados de previsão em cenascomplexas 16,17. Modelos de inferência baseados em GCNs e mecanismos de interação de características melhoram significativamente a suavidade das características e a consistência macrosemântica em regiões homogêneas ao construir conexões em nível denó 18,19. Integrar priors estruturais explícitos de Manhattan no pipeline de extração de características visuais impõe limites de consistência geométrica, o que resolve os desafios de descontinuidade causados pela extensa oclusão de objetos em primeiroplano 20.
Para enfrentar o desafio central das falhas de predição semântica e das distorções severas dos limites físicos associados à infraestrutura de construção, é proposto um arcabouço de análise semântica baseado em um mecanismo de acoplamento em malha fechada incorporando priors arquitetônicos. Essa estrutura transcende pipelines ingênuos de engenharia ao estabelecer um alinhamento bidirecional de mapeamento entre campos geométricos contínuos de potencial e variedades visuais discretas, formando uma sinergia não trivial que corrige erros de oclusão por meio de leis estruturais. Esse esquema depende de uma rede de espinha dorsal visual multiescala e de um algoritmo de detecção de segmentos de linha baseado na estimativa do ponto de fuga, para adquirir características de aparência local e priors ortogonais de arestas que representam a caixa delimitadora 3D Manhattan em paralelo, e então transformá-los em um SDF. O algoritmo emprega um mecanismo de atenção cruzada guiado pela estrutura, usando características visuais como vetores de consulta e tratando características SDF como chaves e valores para cálculos do produto escalar, forçando assim o sinal visual a se alinhar com a fronteira geométrica 3D real no espaço de características. Um grafo de adjacência espacial construído a partir de nós superpixel e características de borda de coplanaridade espacial é alimentado em um GCN para realizar agregação de características entre nós e passagem de mensagens. O processo de otimização de parâmetros de ponta a ponta emprega conjuntamente entropia cruzada em nível de pixel e uma função personalizada de perda de consistência estrutural, que restringe e penaliza estritamente os pixels previstos que cruzam a fronteira prévia do prédio. O pipeline completo de análise semântica é resumido na Figura 2, que conecta entrada de imagem RGB, extração geométrica de prévios, alinhamento de atenção cruzada, raciocínio de grafos superpixels e decodificação semântica de máscaras dentro de uma arquitetura unificada.
As primeiras redes de análise de cenas dependiam de operações convolucionais para capturar texturas de aparência local, mas devido a limitações nos campos receptivos locais, apresentavam coerência semântica insuficiente de alvosem grande escala 21,22. Estudos anteriores aplicaram o módulo de autoatenção da arquitetura visual Transformer para extrair informações contextuais globais e construir características de associação de pixels de longadistância 23,24. Estratégias de agregação de características multi-modais multi-view extraem as características geométricas espaciais tridimensionais da cena fundindo nuvens de pontos do mapa de profundidade e entradas de comandode texto 25,26. Mecanismos híbridos de atenção para fusão de características direcionando domínios específicos amadureceram gradualmente. Ao construir pontes de interação de características, elas reduziram significativamente a perda de energia e a escassez de características na transmissão multiescala de sinais visuais e melhoraram a robustez da análise sintática de estruturas complexas. Projetos de codificadores de ponta integram e inferem conjuntamente detalhes espaciais do domínio de alta frequência junto com características globais e locais, fortalecendo a capacidade da rede de distinguir categorias semânticas de grão fino com alta semelhança e melhorando a precisão da análise sintática interna27,28. Avanços recentes em arquiteturas de segmentação semântica fornecem referências valiosas para otimizar a eficiência computacional e a percepção espacial. Modelos projetados para previsão densa e agregação contextual em múltiplas escalas extraem características geométricas de grão fino de fundos complexos. Estratégias de desacoplamento de características e fusão sinérgica abordam a ambiguidade semântica nas regiões de fronteira. Mecanismos de atenção leves e módulos de agregação com gate otimizam a distribuição dos parâmetros, acelerando assim a inferência enquanto preservam os detalhes estruturais locais. A implementação desses projetos arquitetônicos eficientes oferece orientações teóricas para reduzir a sobrecarga computacional das operações de inferência topológica não euclidianas na análise sintática de cenas internas.
Os prévios da estrutura do edifício e a estimativa de layout 3D são usados para corrigir erros locais de análise visual29. Estudos anteriores extraíram características geométricas ortogonais e paralelas de edifícios internos como restrições de inferência para reduzir o viés de previsão de redes causado por fundos internossobrecarregados 30,31. Esquemas existentes utilizam algoritmos de detecção de segmentos de linha e técnicas de análise de pontos de ablação de imagem para gerar caixas delimitadoras 3D Manhattan, mapeando os limites físicos das salas e auxiliando na localização das características visuaissubjacentes 32. A arquitetura conjunta do módulo de consciência de fronteira e o contexto multiescala incorporam implicitamente informações estruturais prévias no processo de decodificação de características de alta dimensão, forçando a rede a produzir máscaras semânticas que correspondam de perto aos contornos físicos reais, melhorando efetivamente a irregularidade e o desfoque das bordas dos objetos33. Projetos de função de perda semi-supervisionados ou fracamente supervisionados com propriedades de realce de limites têm sido amplamente explorados. Baseando-se em fórmulas matemáticas rigorosas para punir comportamentos independentes de classificação de pixels que violam regras topológicas espaciais, a suavidade geométrica e a integridade estrutural do resultado final da segmentação são garantidas pela fonte da otimizaçãode gradiente 34.
Alguns estudos utilizaram redes neurais de grafos para realizar agregação cruz de domínios de características visuais e raciocínio sobre relações topológicas em espaços de altadimensão 35. O algoritmo de segmentação superpixel pré-agrega blocos de pixels adjacentes com resposta de cor e características de textura semelhantes em nós conectados independentes. O algoritmo de segmentação superpixel comprime a redundância computacional da estrutura do grafo no nível da imagem e preserva a topologia geométrica básica daimagem 36. O GCN, construído sobre o vetor de características de nós de alta dimensão, e a matriz de adjacência representando proximidade espacial, impulsiona a transmissão direcional eficiente e a fusão interativa de informações visuais multiescala ao longo do grafo físico conexo no domínioespacial 37,38. A aplicação do módulo de aprimoramento temporal de informações e do mecanismo híbrido de salto multiescala suprime o suavizamento excessivo e a homogeneização das características dos nós geradas no processo de passagem de mensagens profundas em múltiplascamadas 39. A tecnologia de transformação wavelet de grafo multiescala e a estratégia de otimização de aprendizado de elementos pseudo-rótulos otimizam o mecanismo anti-ruído de fundo da fórmula de atualização de características de nós, de modo que características com os mesmos atributos semânticos mantenham um modo de resposta cooperativa na topologia complexade rede 40. O mecanismo de raciocínio baseado em grafos mapeia grades de pixels regulares para espaços topológicos não euclidianos para realizar cálculos de agregação de características de estruturas edificais irregulares e componentesinternos 41.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Conjuntos de dados de cenas RGB internas e suas anotações semânticas foram preparados antes do treinamento em rede. O conjunto de dados 3D interno em grande escala e o conjunto de dados de cenas internas RGB-D (veja a Tabela de Materiais) foram obtidos de seus repositórios oficiais. Cenas de aquisição internas contendo oclusão de móveis, variação de iluminação, interrupção de limites de paredes e layouts espaciais complexos foram mantidas para corresponder ao cenário de análise alvo. Rótulos semânticos foram convertidos em máscaras de anotação PNG indexadas de canal único, e todas as imagens RGB e máscaras semânticas foram redimensionadas para 512 × 512 pixels. A ampliação de dados online foi aplicada durante o treinamento, com inversão horizontal aleatória com probabilidade de 0,5, escala aleatória de brilho entre 0,8 e 1,2, e rotação aleatória entre −10° e +10° para ampliar a distribuição estrutural. Os canais RGB foram normalizados com valores médios de 0,485, 0,456 e 0,406 e valores de desvio padrão de 0,229, 0,224 e 0,225. O benchmark 3D interno em grande escala seguiu a divisão oficial de lançamento usada neste estudo, com 1201 cenas de treinamento e 312 cenas de validação para desenvolvimento e validação do modelo. O benchmark RGB-D de cenas internas seguiu o protocolo oficial de avaliação, com 795 imagens de treinamento e 654 imagens de teste. Nenhuma divisão adicional baseada em porcentagem foi aplicada a esses dois parâmetros públicos.
Uma rede visual de backbone hierárquica de transformadores de janela deslocada (veja a Tabela de Materiais) foi inicializada como a espinha dorsal do codificador de transformador de janela móvel. O tamanho da incorporação do patch foi configurado como 4 x 4 pixels. As dimensões de embedding dos quatro estágios hierárquicos foram definidas para 128, 256, 512 e 1024, e o número de blocos transformadores nos quatro estágios foi definido para 2, 2, 18 e 2. O tamanho da janela de atenção local foi definido para 7 x 7, e o número de cabeças de atenção foi definido para 4, 8, 16 e 32 para os quatro estágios hierárquicos. Funções de ativação contínua não lineares foram usadas dentro de todas as camadas de perceptron multicamadas. A reamostragem espacial foi realizada por meio de operações de fusão de patches, com um passo de 2 após cada estágio hierárquico. A arquitetura central da rede e os hiperparâmetros do módulo de inferência convolucional foram resumidos na Tabela 1.
A extração de características de autoatenção por janela deslocada era então realizada nos mapas de características de entrada. Cada mapa de características foi dividido em janelas locais não sobrepostas com dimensões espaciais de 7 × 7. A atenção regular das janelas e a atenção das janelas deslocadas eram alternadas entre blocos adjacentes de transformadores de janela deslocada. A distância de deslocamento cíclico foi definida para 3 pixels, e a codificação de viés posicional relativo foi aplicada em cada janela de atenção local. As características visuais locais foram agregadas por meio de autoatenção multi-cabeças para gerar representações hierárquicas e multi-escala.
Os prévios estruturais de Manhattan foram extraídos de imagens RGB internas. Segmentos estruturais de aresta foram detectados usando um algoritmo de detecção de segmentos de linha com consistência de gradiente, direção. As direções estruturais dominantes foram agrupadas por meio de um algoritmo de consenso amostral aleatório (RANSAC) (veja a Tabela de Materiais) baseado na estimativa do ponto de fuga. Três direções Manhattan mutuamente ortogonais foram reconstruídas para gerar a representação da caixa delimitadora 3D de Manhattan. A fronteira estrutural reconstruída foi convertida em um mapa SDF calculando a distância euclidiana mínima de cada pixel até o segmento de linha de fronteira mais próximo.
Características de atenção cruzada guiadas por estruturas foram geradas após a obtenção dos prévios visuais e SDF. A variedade de características visuais foi mapeada para o tensor de consulta Q através da matriz de transformação linear W subelemento Q da tampa de dupla cunhada R para a matriz de formação W subelemento Q da tampa de dupla cunhagem R para a matriz 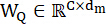 de formação. O campo de distâncias contínuas antes foi mapeado para o tensor chave K e o tensor de valores V através das matrizes
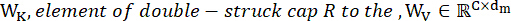 de transformação , e a dimensão do modelo foi definida para 512. A modulação multi-cabeça dividia o espaço de projeção em 8 subespaços independentes, com cada cabeça tendo uma dimensão de 64. O layout espacial anterior projetou coordenadas discretas de píxeis em um campo potencial contínuo e gerou a matriz de afinidade estrutural S como um viés espacial aditivo explícito para modular a matriz de similaridade do produto escalar. O tensor de características visuais foi usado como fonte de consulta porque a análise semântica exige que cada localização visual recupere ativamente evidências estruturalmente consistentes do espaço geométrico de prévio. O SDF prior foi usado como chave e fonte de valor porque armazena distâncias contínuas de fronteira e pistas estruturais de dentro e fora derivadas do layout Manhattan. O termo produto escalar media a compatibilidade entre a aparência semântica e o prior geométrico, enquanto o termo estrutural aditivo λS deslocava os pesos da atenção para pixels no mesmo plano físico ou próximos ao mesmo contorno arquitetônico. O coeficiente λ representava a confiança no prior estrutural extraído e controlava até que ponto restrições ortogonais rígidas eram incorporadas à distribuição de atenção. Essa formulação reduziu a difusão de características transfronteiriças causada pela oclusão dos móveis e manteve o relaxamento adaptativo em layouts fora do Manhattan. A distribuição de atenção guiada pela estrutura foi calculada de acordo com a Equação 1.
Equação 1: 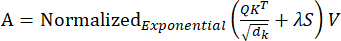
onde A denota a matriz de agregação de atenção guiada pela estrutura, Q denota o tensor de consulta gerado a partir de características visuais, K denota o tensor chave gerado a partir de características anteriores SDF, V denota o tensor de valores gerado a partir de representações a priori estruturais, dk denota a dimensão de características do tensor chave, λ denota o coeficiente de ponderação estrutural adaptativa usado para identificar a confiança geométrica de regiões locais e relaxar restrições ortogonais rígidas em espaços fora de Manhattan layouts, e S denota a matriz de afinidade SDF. A divisão por dk estabilizou a escala dos logits de atenção e impediu que grandes dimensões de características produzissem pesos de atenção excessivamente concentrados. A função exponencial normalizada (veja a Tabela de Materiais) transformava as pontuações de similaridade moduladas em uma distribuição espacial normalizada, permitindo que cada pixel agregasse informações estruturais a priori com base na consistência semântica e geométrica. Esse design explica por que a aparência visual e os priors de limites arquitetônicos são fundidos no nível de atenção, em vez de por concatenação direta de características.
O grafo de topologia superpixel foi construído a partir do mapa de características alinhado à estrutura. O mapa de características foi segmentado usando um algoritmo de geração de regiões espaciais. O número de superpixels foi definido para 256, o coeficiente de compacidade para 10, o coeficiente de suavização gaussiano para 1,0 e o número de iteração para 10. Restrições de proximidade espacial foram aplicadas ao definir o peso métrico de distância para uma razão constante de 1,0 em relação à distância entre espaço de cor e característica durante o agrupamento, mantendo assim uma geração uniforme de nós ao longo dos limites de denso clutter (clutter denso). Pixels com respostas semânticas homogêneas foram agregados em nós superpixel. As arestas dos grafos foram construídas de acordo com relações de adjacência espacial, força de afinidade SDF e restrições de consistência geométrica coplanar. O processo de construção da matriz de afinidade estrutural e da conectividade topológica é mostrado na Figura 3, que apresenta como a orientação SDF foi transformada em relações espaciais em nível de grafo.
A formulação de grafos foi introduzida para converter raciocínio denso pixelado em raciocínio espacial por nós sobre regiões estruturais homogêneas. Cada nó superpixel representava uma região local com resposta semântica e continuidade espacial semelhantes, enquanto cada aresta representava um caminho confiável para transmissão de características, sujeito a restrições de adjacência, afinidade de campo de distância e consistência coplanar. Esse design reduziu a influência de pixels isolados e ruidosos e permitiu que regiões obstruídas de paredes, pisos e tetos recebessem mensagens de nós fisicamente adjacentes. A construção de aresta, portanto, servia como uma ponte matemática entre a orientação contínua de SDF e o raciocínio discreto de grafos não euclidianos.
Uma rede de raciocínio convolucional de grafos de três camadas foi configurada com dimensões de características ocultas de 512, 256 e 128. A camada convolucional do grafo realizava suavização de características sobre a estrutura do grafo com base nas relações espaciais dos nós. A adjacência em auto-loop manteve o estado original de cada nó durante a passagem da mensagem, impedindo que as características de uma pequena região estrutural fossem apagadas por grandes regiões ao redor. A normalização simétrica escalou os elementos da matriz de adjacência pelo produto das raízes quadradas inversas dos graus dos nós, de modo que nós de alto e baixo grau contribuíram sob magnitudes numéricas comparáveis durante a propagação. A propagação por avanço realizou agregação espacial localizada, na qual cada estado do nó absorveu características de alta dimensão de agrupamentos coplanares adjacentes antes da aplicação da função de retificação não linear elemento a elemento. Essa formulação fazia com que a camada de convolução do grafo aproximasse a difusão semântica ao longo de planos internos fisicamente significativos, em vez de suavizar sem restrições sobre os limites de objetos não relacionados. As características dos nós do grafo foram avaliadas de acordo com a Equação 2.
Equação 2: 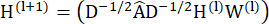
A projeção de características densas de pixels para nós superpixel, passagem de mensagens por convolução de grafos e retroprojeção de coordenadas são apresentadas na Figura 4, esclarecendo o caminho de agregação de características de grades de imagem regulares para uma topologia não euclidiana e de volta para uma representação semântica densa. A projeção de características de pixels densos na Figura 4A para nós superpixels na Figura 4B, a passagem de mensagens de convolução de grafo na Figura 4C e a retroprojeção de coordenadas na Figura 4D clarificam o caminho de agregação de características das grades regulares de imagem para uma topologia não euclidiana e de volta para uma representação semântica densa.
onde H(l) denota o tensor de características do nó da camada de convolução do grafo l, Â denota a matriz de adjacência com conexões de auto-laço, D denota a matriz de graus correspondente à matriz de adjacência, W(l) denota a matriz de pesos aprendível da camada de convolução do grafo l-ésimo, e σ denota a função de ativação da Unidade Linear Retificada. O termo ÂH(l) agregava características de nós superpixel adjacentes, enquanto D−1/2 e D−1/2 equilibravam a contribuição dos nós com diferentes densidades de conexão. A matriz aprendível W(l) projetava características agregadas do nó em um novo espaço semântico, permitindo que a camada do grafo distinguisse consistência estrutural da proximidade espacial comum. A ativação não linear preservou a diferença nas respostas entre regiões coplanares e não coplanares após a agregação de características.
As características de segmentação semântica foram decodificadas após o raciocínio de grafos. O decodificador foi construído usando três estágios bilineares de interpolação para upsampling e operações de fusão por conexão de salto entre camadas. Características superficiais do codificador espacial foram concatenadas com características semânticas de alto nível do decodificador por meio da fusão canal a canal. A resolução das características foi restaurada ao tamanho original da imagem, e o mapa final de previsão semântica de probabilidade foi gerado por meio de uma camada de convolução 1 × 1.
A rede semântica completa de análise sintática foi treinada usando um otimizador de decaimento de peso desacoplado (veja a Tabela de Materiais). A taxa inicial de aprendizado foi definida para 0,0001, o coeficiente de decaimento de peso para 0,01 e o tamanho do lote para 8 para ambos os benchmarks públicos. A taxa de decaimento do primeiro momento foi definida para 0,9, a taxa de decaimento do segundo momento foi fixada em 0,999, e o coeficiente numérico de estabilidade épsilon foi fixado em 1 × 10⁻8. A perda de validação era monitorada ao final de cada época, e os pontos de verificação eram salvos quando o mIoU no conjunto de validação aumentava. A rede foi treinada por 300 épocas usando uma estratégia de decaimento da taxa de aprendizado polinomial com um poder de decaimento de 0,9. Cinco treinamentos independentes foram realizados usando diferentes inicializações de semente aleatória para estabelecer uma linha de base de avaliação estatisticamente rigorosa. A rede foi otimizada conjuntamente usando perda de entropia cruzada em nível de pixel e perda de consistência estrutural. Todos os experimentos foram realizados em uma plataforma computacional equipada com hardware paralelo de alta memória, e informações detalhadas de hardware foram reportadas na Tabela de Materiais.
A otimização conjunta impôs o alinhamento geométrico dos limites calculando a magnitude do gradiente espacial do tensor de probabilidade de classe. A perda de consistência estrutural foi usada como regularizador, multiplicando a norma dos gradientes de predição espacial pelos valores contínuos de SDF. A justificativa matemática era que as mudanças semânticas de categorias deveriam se concentrar próximo a contornos arquitetônicos reais, onde a SDF se aproxima de zero, enquanto interiores planos de paredes, pisos e tetos deveriam manter respostas semânticas suaves. Quando um grande gradiente de previsão aparecia longe de uma fronteira estrutural, o termo campo de distância aumentava a penalidade e desencorajava transições semânticas falsas dentro de um plano físico homogêneo. Quando um gradiente de previsão aparecia próximo a um contorno de distância zero, a penalidade permanecia limitada e preservava transições legítimas de classe ao longo dos limites arquitetônicos. Regiões de transição semântica foram restringidas a se alinhar com os contornos de distância zero da SDF, conforme indicado pela Equação 3.
Equação 3: 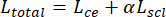
onde Ltotal denota a função objetivo final de otimização, Lce denota a perda cruzada de entropia em nível de pixel, Lscl denota a perda de penalidade de consistência estrutural e α denota o coeficiente de ponderação de perda estrutural. O termo de entropia cruzada fornecia supervisão semântica em nível de pixel por meio de máscaras de anotação, enquanto o termo de consistência estrutural impunha regularização geométrica usando priors arquitetônicos. O coeficiente de ponderação α reconhecimento de categorias balanceadas e alinhamento de fronteiras, impedindo que a otimização sobreajuste tanto a precisão local do rótulo quanto contornos estruturais rígidos. Esse objetivo conjunto ligava semântica visual, consistência física de fronteira e parâmetros de rede treináveis dentro de um alvo unificado de otimização.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Configuração Experimental
Este estudo utilizou dois conjuntos de dados padrão de análise de cenas internas, um conjunto de dados 3D interno em grande escala e um conjunto de dados RGB-D de cenas internas, para avaliar o desempenho e ajustar o modelo. O conjunto de dados 3D interno em grande escala contém cenas complexas de espaço físico escaneadas de forma realista e vistas RGB de alta resolução, fornecendo rótulos semânticos 3D de alta precis...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
O algoritmo deste artigo acopla de forma rígida as características visuais hierárquicas capturadas por um codificador transformador hierárquico de janela deslocada com a profundidade prévia da caixa delimitadora 3D Manhattan gerada pela detecção de segmentos de linha, alcançando assim a reconstrução semântica de alta precisão de cenas internas complexas. Um mecanismo de atenção cruzada guiado pela estrutura força o sinal visual a alinhar-se com a verdadeira fronteira geométrica calibrada...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram que não têm conflitos financeiros de interesse.
Agradecimentos
Financiamento: Programa Chave de Pesquisa e Desenvolvimento de Shaanxi (Programa nº 2024CY2-GJHX-76).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
Referências
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.