Este protocolo descreve a implementação de uma plataforma web interoperável que integra dados clínicos baseados em FHIR com Geração Reforçada por Recuperação e modelos linguísticos grandes multiagentes para suporte à decisão clínica. O fluxo de trabalho permite a implantação reprodutível, integração padronizada de dados e avaliação da análise de dados médicos assistida por inteligência artificial (AI).
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Plataforma Web Interoperável Baseada em Modelos de Linguagem de Grande Escala para Análise de Dados Médicos: Um Protocolo para Suporte à Decisão Clínica
Neste artigo
Resumo
Resumo
A tomada de decisões clínicas é frequentemente dificultada por registros eletrônicos de saúde fragmentados e interoperabilidade limitada entre sistemas heterogêneos de informação em saúde. Este artigo apresenta um protocolo passo a passo para a implementação de uma plataforma web interoperável que integra dados clínicos por meio do padrão Fast Healthcare Interoperability Resources (FHIR), juntamente com Geração Aumentada por Recuperação (RAG), Modelos de Linguagem de Grande Porte (LLMs) e um framework de raciocínio clínico baseado em múltiplos agentes, para apoiar a análise de dados médicos e o suporte à decisão clínica. O protocolo descreve todo o fluxo de trabalho, incluindo a configuração do ambiente computacional, pré-processamento de conjuntos de dados clínicos, integração de dados baseada em FHIR, construção de base de dados vetorial, configuração de recuperação, engenharia de prompts, orquestração de múltiplos agentes e avaliação do sistema. Resultados representativos demonstram a capacidade da plataforma de gerar respostas clinicamente relevantes e contextualmente consistentes, ao mesmo tempo que melhora a interoperabilidade semântica entre fontes de dados heterogêneas. O desempenho do sistema foi avaliado utilizando métricas quantitativas e semânticas complementares, incluindo BLEU, ROUGE, BERTScore e similaridade do cosseno. Uma avaliação qualitativa foi realizada utilizando conjuntos de dados de referência em saúde totalmente anonimizados e de acesso público, a fim de avaliar a reprodutibilidade do fluxo de trabalho metodológico proposto. A arquitetura proposta combina interoperabilidade padronizada em saúde com modelos de linguagem aprimorados por recuperação, visando melhorar o raciocínio contextual, reduzir alucinações e apoiar fluxos de trabalho clínicos inteligentes e reprodutíveis com assistência de IA. Este protocolo fornece um framework escalável e reprodutível para pesquisadores e desenvolvedores que buscam implementar sistemas de saúde interoperáveis, atentos à privacidade e inteligentes, destinados ao suporte à decisão clínica, análise de dados médicos e pesquisas translacionais futuras.
Introdução
Informações de saúde são rotineiramente geradas em hospitais, centros diagnósticos, laboratórios e clínicas ambulatoriais, frequentemente permanecendo distribuídas entre sistemas heterogêneos de informação. Essa fragmentação limita a interoperabilidade e restringe o acesso oportuno a registros completos dos pacientes, criando desafios persistentes para o atendimento clínico, integração de dados e gestão em saúde1,2,3,4.
As consequências dessa fragmentação tornam-se particularmente evidentes em fluxos de trabalho clínicos que dependem do acesso oportuno às informações do paciente. Quando os profissionais de saúde não conseguem recuperar prontuários médicos completos e integrados, a avaliação clínica torna-se mais difícil, aumentando o risco de tomada de decisões incompletas e reduzindo a eficiência na prestação de cuidados, especialmente em situações de emergência5,6.
Desenvolvimentos recentes na Inteligência Artificial (AI), particularmente Modelos de Linguagem de Grande Porte (LLMs), ampliaram o leque de abordagens computacionais disponíveis para aplicações em saúde. Esses modelos têm sido investigados em tarefas como auxílio diagnóstico, triagem clínica e suporte à decisão. Por exemplo, Jahan et al.5 avaliaram o uso de LLMs em tarefas biomédicas, enquanto Taylor et al.7 investigaram modelos ajustados para triagem digital em saúde mental, relatando resultados encorajadores em ambientes clínicos especializados.
A aplicação de LLMs também se expandiu para domínios clínicos mais especializados. Song et al. 49exploraram seu uso no diagnóstico de pneumoconiose, enquanto Chien et al.8 aplicaram esses modelos para analisar padrões de carga de trabalho entre cuidadores informais. Em oftalmologia, Xue et al.9 propuseram um sistema de questionamento e resposta para o diagnóstico de glaucoma, enquanto Tan et al.3 e Wu et al.10 relataram o uso de LLMs em sistemas diagnósticos híbridos e em consultas de medicina tradicional chinesa.
O uso de LLMs não se limita a aplicações clínicas diretas. Zhang et al.11 investigaram sua aplicação no reconhecimento de emoções em cenários de saúde mental, enquanto Sarzaeim et al.12 exploraram sistemas de policiamento inteligentes que também podem contribuir para análises relacionadas à saúde pública. Esses estudos ilustram a ampla aplicabilidade de abordagens baseadas em LLMs em diferentes domínios relacionados à saúde.
Embora os LLMs tenham ampliado as possibilidades para aplicações na área da saúde, sua integração em ambientes clínicos ainda está associada a desafios técnicos, organizacionais e regulatórios importantes. A implantação prática exige infraestrutura computacional adequada, governança eficaz dos dados e conformidade com frameworks regulatórios, como o Regulamento Geral sobre a Proteção de Dados (GDPR) e a Lei Geral de Proteção de Dados Brasileira (LGPD). Esses frameworks estabelecem requisitos para o processamento seguro e ético de informações sensíveis de saúde, abordando questões relacionadas à privacidade, confiabilidade e viés algorítmico em sistemas de saúde assistidos por IA13,14.
A interoperabilidade entre fontes heterogêneas de dados em saúde, incluindo Registros Eletrônicos de Saúde (EHRs), sistemas de imagens médicas e dispositivos da Internet das Coisas (IoT), continua representando um grande desafio técnico para a implantação de soluções de saúde assistidas por IA. Nesse contexto, frameworks padronizados de interoperabilidade, como o HL7 FHIR, fornecem um mecanismo estruturado para trocar informações clínicas entre diferentes sistemas, preservando a consistência semântica e permitindo integração escalável.
Este trabalho apresenta uma plataforma web interoperável que integra modelos linguísticos grandes com padrões de interoperabilidade em saúde para apoiar a análise de dados médicos em ambientes clínicos heterogêneos. A arquitetura proposta combina a integração de dados baseada em HL7 FHIR com geração aumentada por recuperação (RAG) e um framework de processamento multiagente para fornecer análises assistidas por IA com consciência de contexto, mantendo-se alinhada aos requisitos aplicáveis de proteção de dados, incluindo a Lei Geral de Proteção de Dados (LGPD).
Este protocolo descreve uma arquitetura interoperável para integrar dados clínicos heterogêneos utilizando padrões estabelecidos de interoperabilidade em saúde. Também detalha a implementação de um pipeline de processamento multiagente baseado em modelos de linguagem grandes e pequenos (LLMs e SLMs), juntamente com um framework de avaliação que combina métricas quantitativas e análises qualitativas para avaliar o comportamento da plataforma proposta.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo não envolveu a recrutamento de participantes humanos, acesso a registros de pacientes identificáveis ou experimentos envolvendo animais. O protocolo foi desenvolvido e avaliado exclusivamente utilizando conjuntos de dados anonimizados e totalmente disponíveis publicamente para validação metodológica. Nenhuma informação de saúde pessoal foi acessada ou processada. Portanto, não foi necessária a aprovação por um Comitê de Ética em Pesquisa (IRB) ou Comitê de Ética em Pesquisa. O protocolo foi desenvolvido de acordo com os princípios aplicáveis de proteção de dados, incluindo a Lei Geral de Proteção de Dados Brasileira (LGPD), para apoiar aplicações futuras envolvendo dados clínicos.
Seleção e pré-processamento do conjunto de dados
O protocolo proposto foi avaliado utilizando conjuntos de dados clínicos de acesso público e totalmente anonimizados, compreendendo prontuários eletrônicos estruturados (EHRs), dados de respostas a perguntas clínicas e conjuntos de dados de imagens médicas para validação metodológica. Antes da integração na plataforma, os conjuntos de dados passaram por procedimentos padronizados de pré-processamento, incluindo normalização dos dados, remoção de registros inconsistentes ou incompletos, mapeamento para recursos HL7 FHIR, limpeza de texto, segmentação em blocos de recuperação e geração de incorporações para indexação vetorial. Essas etapas de pré-processamento garantiram consistência semântica entre fontes de dados heterogêneas, facilitando a interoperabilidade e permitindo a reprodutibilidade do fluxo de trabalho proposto, ao mesmo tempo em que mantiveram a conformidade com os princípios aplicáveis de privacidade de dados.
Os conjuntos de dados foram obtidos de repositórios de referência publicamente disponíveis, comumente utilizados em pesquisas de inteligência artificial e saúde digital. Eles foram selecionados para representar informações clínicas heterogêneas, incluindo prontuários eletrônicos estruturados (EHRs), narrativas clínicas não estruturadas, tarefas de resposta a perguntas clínicas e metadados de imagens médicas. Em vez de avaliar uma coorte clínica específica, o protocolo enfoca a demonstração de um fluxo de trabalho de implementação reproduzível, que pode ser adaptado a diferentes conjuntos de dados de saúde. A diversidade desses conjuntos de dados de referência permite a validação do pipeline de interoperabilidade, da Geração Reforçada por Recuperação (RAG) e do framework de raciocínio multiagente em múltiplas modalidades de dados clínicos.
Configuração do ambiente experimental
O ambiente experimental foi configurado para avaliar a plataforma interoperável em condições controladas e reprodutíveis. A arquitetura compreende módulos de ingestão de dados, camadas de interoperabilidade, modelos linguísticos grandes (LLMs) e componentes de avaliação organizados em um único pipeline de processamento para análise de dados médicos. Figura 1 ilustra o fluxo de trabalho completo, desde a ingestão de dados clínicos até a geração de saídas diagnósticas.
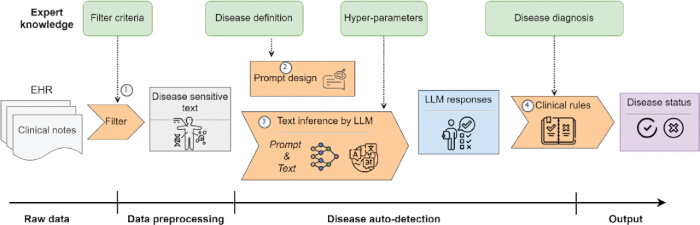
Figura 1: Fluxo geral do sistema ilustrando o pipeline de processamento desde os dados clínicos brutos até a saída do status da doença. O processo inicia com a ingestão de Prontuários Eletrônicos de Saúde (EHR), seguida por filtragem e pré-processamento dos dados para extrair informações sensíveis a doenças. Uma etapa de elaboração de prompts estruturados integra conhecimento especializado, definições de doenças e hiperparâmetros, permitindo uma interação eficaz com o Modelo de Linguagem de Grande Porte (LLM). O LLM realiza inferência textual para gerar respostas contextualizadas, que posteriormente são avaliadas por meio de regras clínicas para determinar o status final da doença. O fluxo de trabalho destaca a integração do pré-processamento de dados, uso de prompts baseados em conhecimento e inferência baseada em IA para apoiar a tomada de decisões clínicas. Clique aqui para visualizar uma versão maior desta figura.
Arquitetura de interoperabilidade em saúde
A infraestrutura de back-end adota uma arquitetura modular baseada em APIs RESTful para apoiar a comunicação entre os componentes da plataforma (Figura 2). Essa arquitetura acomoda informações clínicas heterogêneas, incluindo prontuários eletrônicos estruturados (EHRs), anotações médicas e metadados derivados de sistemas de imagem médica. Como esses dados provêm de múltiplas fontes e formatos, a interoperabilidade é alcançada por meio de modelos padronizados de dados, particularmente o framework Fast Healthcare Interoperability Resources (FHIR)15,16,17.. A adoção do FHIR favorece a troca de informações estruturadas, ao mesmo tempo que preserva escalabilidade e flexibilidade em ambientes clínicos distribuídos. Mecanismos de comunicação baseados no HL7 também foram incorporados para facilitar a integração com sistemas clínicos legados, que ainda são amplamente utilizados em instituições de saúde16,17.
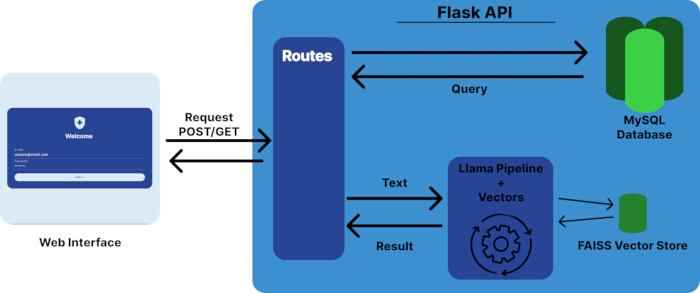
Figura 2: Arquitetura do sistema da plataforma interoperável proposta. A interface web se comunica com o backend por meio de uma API Flask utilizando requisições HTTP POST/GET. A API gerencia roteamento, processamento de consultas e interação com fontes de dados estruturadas e não estruturadas. Um banco de dados MySQL armazena dados clínicos estruturados, enquanto um armazenamento vetorial baseado em FAISS suporta busca por similaridade para operações de recuperação. O pipeline baseado em LLaMA processa entradas textuais e gera respostas utilizando representações vetoriais, permitindo a Geração Reforçada por Recuperação (Retrieval-Augmented Generation – RAG). A arquitetura destaca a integração de serviços web, gerenciamento de banco de dados, recuperação vetorial e inferência de modelos de linguagem grandes em um sistema unificado. Clique aqui para visualizar uma versão maior desta figura.
Configuração do fluxo de trabalho com múltiplos agentes
A arquitetura multiagente é organizada em agentes funcionais especializados, responsáveis por estágios distintos do fluxo de trabalho. Um agente de pré-processamento realiza a normalização dos dados e o mapeamento FHIR, seguido por um agente de recuperação responsável pela busca semântica dentro do banco de dados vetorial. Um agente de raciocínio integra o contexto recuperado com o LLM para gerar respostas, enquanto um agente de validação verifica a consistência e a formatação da saída antes que a resposta final seja retornada. A coordenação dos agentes segue uma estratégia de orquestração sequencial na qual a saída de cada agente serve como entrada para a etapa subsequente, garantindo uma implementação reprodutível e modular.
Integração de dados clínicos
A camada de integração de dados agrega informações de múltiplas fontes clínicas e as prepara para o processamento posterior. O pré-processamento inclui normalização de dados, tokenização e alinhamento de entidades para melhorar a consistência semântica entre conjuntos de dados heterogêneos. Como as informações clínicas variam em estrutura e qualidade, essas operações ajudam a reduzir o ruído e facilitam a interação com modelos de IA. Estratégias de mapeamento estruturado também foram aplicadas para harmonizar diferentes formatos de dados e manter a compatibilidade com o pipeline de processamento, conforme ilustrado na Figura 315,16,17.
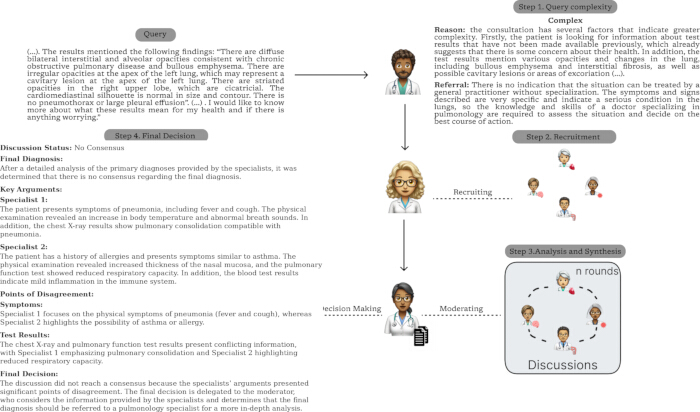
Figura 3: Exemplo detalhado do processo de raciocínio clínico com múltiplos agentes. A figura ilustra como uma consulta clínica é analisada por meio de múltiplas etapas, incluindo avaliação da complexidade, recrutamento de especialistas, discussão colaborativa e tomada final de decisão. Esse processo demonstra a capacidade do sistema de adaptar dinamicamente as estratégias de raciocínio com base na complexidade da consulta, melhorando tanto a eficiência quanto a precisão diagnóstica em cenários de suporte à decisão clínica. Clique aqui para visualizar uma versão maior desta figura.
Configurar o pipeline de geração aumentada por recuperação
A Geração Reforçada por Recuperação (Retrieval-Augmented Generation, RAG) é incorporada para fornecer uma análise com consciência de contexto, combinando recuperação de informações com as capacidades gerativas de modelos linguísticos grandes. As consultas do usuário são convertidas em representações vetoriais usando modelos de incorporação e comparadas com a base de dados vetorial por meio de busca semântica de similaridade para recuperar os trechos contextuais mais relevantes. Os documentos recuperados são então combinados com a consulta original antes da inferência pelo modelo linguístico grande (LLM). Essa estratégia ajuda a fornecer informações contextuais durante a geração da resposta e tem sido associada a uma maior consistência factual e redução de alucinações em aplicações intensivas em conhecimento, incluindo a área da saúde18,19. Figura 1 e Figura 3 ilustram o fluxo de trabalho geral de recuperação e o processo de raciocínio correspondente.
Para cada solicitação do usuário, o prompt final é construído dinamicamente combinando a consulta original com os trechos contextuais mais relevantes recuperados do banco de dados vetorial. As informações recuperadas são incorporadas como evidência contextual antes da inferência, permitindo que o modelo de linguagem gere respostas baseadas no conhecimento médico recuperado, preservando a consistência semântica e reduzindo gerações não suportadas.
Engenharia de prompts e raciocínio multiagente
O protocolo incorpora estratégias de estímulo estruturado para melhorar a interpretação contextual durante a geração de respostas. Essas técnicas de estímulo, juntamente com mecanismos avançados de inferência, ajudam a orientar o processo de raciocínio em cenários clínicos complexos e são compatíveis com os avanços recentes relatados na literatura20.
A arquitetura inclui um framework multiagente composto por módulos especializados que executam funções distintas dentro do pipeline de processamento, incluindo validação de dados, filtragem de contexto, suporte ao raciocínio clínico e verificação da saída. A organização modular permite que as tarefas sejam executadas sequencialmente ou em paralelo, proporcionando flexibilidade para diferentes requisitos de processamento (Figura 4). A distribuição dessas atividades entre múltiplos agentes reduz a dependência de um único modelo de linguagem e favorece um fluxo de trabalho de processamento mais robusto. Essa estratégia arquitetônica está alinhada com os avanços recentes em inteligência artificial distribuída e no design de sistemas inteligentes21,22.
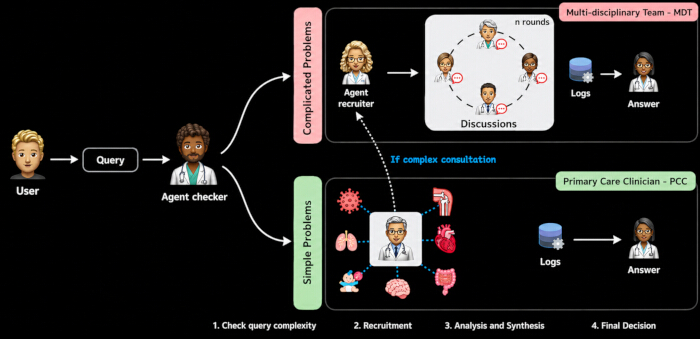
Figura 4: Estrutura de decisão com múltiplos agentes para raciocínio clínico. O processo inicia-se com uma consulta do usuário, que é avaliada por um agente verificador responsável por determinar a complexidade da consulta. Em casos complexos, o sistema recruta dinamicamente uma equipe multidisciplinar (EMD) composta por agentes especializados, que realizam rodadas iterativas de discussão para analisar o problema e sintetizar conhecimento antes de produzir uma decisão final. Em casos mais simples, a consulta é tratada por um agente clínico de atenção primária (CAP), permitindo uma resposta mais rápida. Essa arquitetura adaptativa equilibra eficiência e profundidade analítica, melhorando a qualidade das decisões e a escalabilidade do sistema em aplicações na área da saúde. Clique aqui para visualizar uma versão maior desta figura.
Avaliação de desempenho
O desempenho do sistema foi avaliado utilizando métricas complementares que capturam tanto a qualidade linguística quanto a consistência semântica das saídas geradas. O BLEU foi aplicado para medir a similaridade sintática com base na sobreposição de n-gramas23, enquanto o ROUGE avaliou a revocação e a cobertura de conteúdo, especialmente em tarefas de sumarização e extração de informações24. A similaridade semântica foi avaliada com o BERTScore, que utiliza incorporações contextuais derivadas de modelos baseados em transformadores para comparar textos gerados e textos de referência25. Análises adicionais incluíram perplexidade e similaridade do cosseno para examinar, respectivamente, a confiança do modelo e a coerência semântica26,27.
As métricas de avaliação selecionadas fornecem perspectivas complementares sobre o desempenho do sistema, combinando análises léxicas e semânticas. Essa combinação é particularmente relevante em aplicações na área da saúde, onde a interpretação contextual é tão importante quanto a similaridade léxica. A plataforma foi avaliada em um ambiente computacional controlado que suporta implantação baseada em nuvem e local. A execução local de LLMs foi incluída como uma opção para atender aos requisitos de privacidade de dados e reduzir a dependência de serviços externos ao processar informações clínicas sensíveis. Essa estratégia de implantação é compatível com as normas de proteção de dados e pode ser adaptada a diferentes ambientes operacionais4.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
O desempenho do sistema foi avaliado utilizando métricas quantitativas complementares juntamente com análise qualitativa para examinar tanto a precisão linguística quanto a consistência semântica das saídas geradas. Esta estratégia de avaliação combina medidas lexicais e semânticas para fornecer uma caracterização mais ampla do comportamento do modelo em tarefas de geração de linguagem relacionadas à saúde.
Tabela 1 apresenta os resultados quantitativos obtidos com BLEU, ROUGE...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
A avaliação apresentada neste estudo representa uma validação metodológica realizada utilizando conjuntos de dados de referência em saúde totalmente anonimizados e disponíveis publicamente. Nenhuma validação clínica prospectiva envolvendo profissionais de saúde ou recrutamento de pacientes foi conduzida, pois o objetivo deste trabalho é demonstrar um protocolo de implementação reproduzível, e não a eficácia clínica.
Os resultados deste estudo sugerem que a combinação de padrões de interoperabi...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram não haver interesses financeiros conflitantes ou relações pessoais que poderiam ter influenciado o trabalho descrito neste manuscrito. Ferramentas de inteligência artificial generativa (IA) foram usadas exclusivamente para auxiliar na edição linguística, correção gramatical e melhoria da legibilidade do manuscrito. Todo o conteúdo científico, o desenho do estudo, a metodologia, a análise de dados, a interpretação dos resultados e as decisões editoriais foram desenvolvidos, verificados e aprovados pelos autores, que assumem total responsabilidade pelo conteúdo deste manuscrito.
Agradecimentos
Os autores gostariam de agradecer ao Laboratório de Sistemas Embarcados e Distribuídos (LESC), da Universidade Federal do Ceará (UFC), pelo fornecimento do ambiente de pesquisa e das discussões técnicas que apoiaram o desenvolvimento deste trabalho. Os autores também agradecem aos desenvolvedores e mantenedores do software de código aberto, das normas de interoperabilidade e dos conjuntos de dados disponíveis publicamente utilizados ao longo deste estudo.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Version 1.8.0 | Banco de dados vetorial utilizado para busca de similaridade no pipeline de Geração Aumentada por Recuperação (RAG). |
| Padrão FHIR | HL7 International | Release 4 (R4) | Padrão de interoperabilidade em saúde adotado para troca estruturada de dados clínicos. |
| Flask | Pallets Projects | Version 3.0.3 | Framework web em Python utilizado para implementar a API backend RESTful. |
| Padrão HL7 | HL7 International | Version 2.x | Protocolo de mensagens legado utilizado para interoperabilidade com sistemas de informação hospitalar. |
| API REST HTTP | Implementação Personalizada | N/A | Camada de comunicação RESTful entre frontend, backend, banco de dados e serviços de IA. |
| LangChain | LangChain Inc. | Version 0.3.x | Framework utilizado para integrar LLMs, engenharia de prompts e fluxos de trabalho de Geração Aumentada por Recuperação. |
| LangGraph | LangChain Inc. | Version 0.2.x | Framework utilizado para orquestrar o fluxo de raciocínio clínico com múltiplos agentes. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Version 3.1 | Modelo de Linguagem de Grande Porte empregado para raciocínio clínico e geração de linguagem natural. |
| MySQL Community Server | Oracle Corporation | Version 8.0 | Banco de dados relacional utilizado para armazenar dados clínicos estruturados. |
| Ollama | Ollama Inc. | Version 0.9.x | Motor de inferência local utilizado para executar Modelos de Linguagem de Grande Porte preservando a privacidade do paciente. |
| Python | Python Software Foundation | Version 3.11 | Linguagem de programação utilizada para implementar a plataforma completa. |
| PyTorch | Linux Foundation | Version 2.4 | Framework de aprendizado profundo utilizado para inferência em Modelos de Linguagem de Grande Porte. |
| Pipeline de Geração Aumentada por Recuperação (RAG) | Implementação Personalizada | N/A | Framework de IA que combina recuperação semântica com inferência de LLM para geração de respostas com contexto. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Modelo de incorporação utilizado para gerar representações vetoriais densas para recuperação semântica de documentos. |
| Ubuntu Linux | Canonical Ltd. | Version 24.04 LTS | Sistema operacional utilizado para desenvolvimento e avaliação experimental. |
| Visual Studio Code | Microsoft Corporation | Version 1.100 | Ambiente de desenvolvimento integrado utilizado para implementação e depuração de software. |
Referências
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.