Este estudo apresenta uma estrutura em duas etapas para classificação de cobertura do solo com dados hiperespectrais e LiDAR, utilizando extração de características com MetaFormer e correspondência bidirecional de fluxo para alinhamento cruzado de modalidades antes da fusão. A avaliação em três conjuntos de dados públicos de referência demonstra desempenho competitivo na classificação segundo protocolos fixos de referência.
Artigo de investigação
Aprendizado Contínuo de Campo Vetorial Cross-Modal para Classificação de Cobertura Terrestre Hiperspectral e LiDAR
Neste artigo
Resumo
Resumo
A classificação multimodal de sensoriamento remoto desempenha um papel importante em aplicações como mapeamento urbano e monitoramento ambiental. No entanto, distribuições heterogêneas de características entre modalidades de sensoriamento podem resultar em desalinhamento de características e inconsistência semântica, limitando a eficácia da fusão multimodal. Abordagens existentes de fusão multimodal, incluindo métodos baseados em convolução, em grafos, em atenção, contrastivos, orientados por transporte e baseados em sequências, podem explorar informações complementares, mas podem não alinhar adequadamente as distribuições de características específicas de cada modalidade. Este estudo propõe o FlowErs, um framework de classificação multimodal em dois estágios que aborda esse desafio por meio da correspondência de fluxo multimodal. A hipótese de trabalho é que reduzir discrepâncias nas distribuições de características emparelhadas antes da fusão de características melhora a classificação de cobertura do solo sob protocolos de referência fixos. No primeiro estágio, codificadores MetaFormer específicos de modalidade extraem representações hierárquicas de dados de imagem hiperspectral (HSI) e de detecção e alcance por luz (LiDAR). Um módulo de correspondência de fluxo multimodal aprende então campos de velocidade condicionados ao tempo para transportar as distribuições de características emparelhadas em direção a uma representação latente compartilhada, utilizando um objetivo bidirecional de erro quadrático médio. No segundo estágio, o módulo de alinhamento pré-treinado é reutilizado para alinhar representações multimodais antes que uma cabeça de fusão leve realize classificação pixel a pixel. A avaliação em três conjuntos de dados de referência públicos demonstrou uma precisão geral máxima (OA) de 97,56% sob divisões fixas de referência. O desempenho variou entre classes individuais de cobertura do solo, e o estudo discute limitações específicas por classe e a influência do desequilíbrio de classes nas métricas agregadas. A avaliação atual limita-se a experimentos com divisões fixas, sem análise estatística de execuções repetidas ou perfil computacional. Trabalhos futuros investigarão a robustez estatística, a eficiência computacional e a generalização entre regiões.
Introdução
A classificação precisa do uso e cobertura da terra (LULC) utilizando imagens de sensoriamento remoto é essencial para uma ampla gama de aplicações do mundo real, incluindo desenvolvimento urbano, monitoramento ambiental, gestão de desastres e desenvolvimento sustentável1. Dados multimodais de sensoriamento remoto, incluindo imagens hiperspectrais (HSI), detecção luminosa e alcance (LiDAR) e radar de abertura sintética (SAR), tornaram-se cada vez mais disponíveis nos últimos anos. Essa maior disponibilidade expandiu substancialmente as capacidades do sensoriamento remoto para classificação detalhada da cobertura do solo2. Essas modalidades de sensoriamento capturam características distintas, mas complementares, da superfície terrestre. O HSI fornece rica informação espectral para caracterizar a composição dos materiais, enquanto o LiDAR fornece informações precisas sobre estrutura e elevação3. A integração dessas fontes heterogêneas de dados pode gerar representações de características mais discriminativas, tolerantes a ruídos e semanticamente abrangentes do que qualquer modalidade isoladamente4.
No entanto, a exploração eficaz de dados multimodais permanece um desafio de longa data5. Uma dificuldade principal surge da heterogeneidade inerente das modalidades de sensoriamento, que diferem em resolução espacial, características de ruído, distribuições estatísticas e semântica de características6. Por exemplo, o mesmo objeto de cobertura do solo pode ser representado como uma assinatura espectral de alta dimensionalidade em HSI e como estruturas geométricas esparsas em LiDAR7. Consequentemente, características específicas de cada modalidade frequentemente residem em variedades de características diferentes, tornando a fusão direta de características ineficiente ou potencialmente enganosa. Além disso, muitas abordagens existentes de fusão multimodal, incluindo métodos baseados em convolução, atenção e Transformer, assumem implicitamente que as características extraídas de sensores diferentes já estão alinhadas espacial e semanticamente8. No entanto, essa suposição geralmente não é válida em aplicações práticas. A simples concatenação de características ou fusão pixel a pixel não consegue capturar adequadamente as discrepâncias entre modalidades, o que pode resultar em otimização instável e desempenho reduzido de generalização. Além disso, embora os métodos de fusão baseados em atenção melhorem a interação entre características, eles podem oferecer modelagem limitada de dependências cruzadas de longo alcance necessárias para classificação de cobertura do solo em larga escala ou alta resolução9. Assim, o alinhamento eficaz de representações heterogêneas de características permanece um grande desafio no sensoriamento remoto multimodal, pois incorporações incompatíveis podem limitar a integração de informações complementares.
Para enfrentar esse desafio, o alinhamento cruzado de modalidades é formulado como um problema de transporte condicional de características. A correspondência de fluxo fornece uma estrutura matematicamente fundamentada para aprender mapeamentos contínuos e invertíveis entre distribuições heterogêneas de características10. Ela transporta uma distribuição em direção a outra por meio de um campo de velocidade dependente do tempo, parametrizado por uma equação diferencial ordinária (EDO), promovendo assim transformações contínuas entre variedades de características11. Diferentemente dos modelos baseados em difusão, que dependem de perturbações estocásticas de ruído ou correspondência implícita de distribuições por meio de treinamento adversarial, a correspondência de fluxo aprende transformações determinísticas e bijetivas entre espaços estruturados de características12. Essas características tornam a correspondência de fluxo particularmente adequada para sensoriamento remoto multimodal, no qual HSI, LiDAR e SAR representam, cada um, variedades de características de alta dimensão que capturam propriedades complementares da superfície terrestre13. Assim, a correspondência de fluxo oferece uma abordagem fundamentada para estabelecer correspondência cruzada de modalidades por meio do transporte contínuo de características, promovendo simultaneamente a consistência geométrica durante o alinhamento de características. Sob suposições adequadas de regularidade, um fluxo de EDO pode fornecer um mapeamento invertível; entretanto, a invertibilidade exata e a interpretabilidade física não foram avaliadas empiricamente no presente estudo. A hipótese de trabalho é que a redução das discrepâncias entre distribuições de características emparelhadas antes da fusão de características melhora a classificação agregada de cobertura do solo em divisões fixas de referência.
Motivado por essas considerações, o framework proposto, FlowErs, incorpora uma etapa de alinhamento baseada em fluxo dentro de uma arquitetura de duas etapas. Na primeira etapa, uma rede de fluxo bidirecional é treinada para alinhar as variedades de características de cada modalidade. Especificamente, estruturas MetaFormer específicas para cada modalidade extraem incorporações hierárquicas de características, e um objetivo de correspondência de fluxo é otimizado para transportar amostras entre distribuições de características específicas de cada modalidade. Esse processo fornece uma transformação suave e invertível entre os espaços de características, incentivando que representações pertencentes à mesma classe semântica se alinhem mais estreitamente dentro de um domínio latente compartilhado. Na segunda etapa, o alinhador de fluxo pré-treinado é congelado e novas entradas multimodais são transformadas antes de serem fundidas por um classificador leve. Essa estratégia de treinamento desacoplado separa o alinhamento geométrico da classificação semântica, permitindo que as duas etapas otimizem objetivos complementares. O módulo de alinhamento tem a finalidade de reduzir as discrepâncias nas distribuições de características antes da fusão de características, mas não afirma garantia comprovada de preservação de volume. Além disso, o FlowErs fornece uma formulação explícita de transporte de características para fusão multimodal, embora a robustez a erros de registro não tenha sido avaliada separadamente no presente estudo.
As principais contribuições deste estudo são resumidas a seguir. FlowErs é apresentado como uma estrutura em duas etapas para classificação multimodal de cobertura do solo. Na estrutura proposta, características específicas de cada modalidade são inicialmente extraídas usando codificadores MetaFormer e posteriormente alinhadas por meio de um módulo baseado em fluxo antes da fusão leve de características. Esse design desacoplado permite uma otimização eficiente, mantendo flexibilidade entre diferentes modalidades de sensoriamento. Além disso, este estudo investiga o casamento condicional de fluxo como um mecanismo de transporte de características para o alinhamento cruzado de pares de características em sensoriamento remoto multimodal. O módulo de fluxo bidirecional prevê alvos de velocidade opostos para representações de características em pares antes da fusão de características, fornecendo assim uma estratégia explícita de alinhamento prévia à integração multimodal. Além disso, a estrutura proposta é avaliada em três conjuntos de dados públicos de referência, alcançando uma precisão geral máxima (OA) de 97,56% sob as divisões fixas de referência fornecidas. Limitações em nível de classe e o escopo da avaliação atual também são explicitamente documentados.
Avanços recentes no fluxo de correspondência estabeleceram-no como uma poderosa estrutura de modelagem generativa que unifica modelos baseados em difusão, energia e transporte. Em vez de simular trajetórias estocásticas, como nos modelos de difusão, o fluxo de correspondência aprende uma EDO determinística que transporta uma distribuição anterior simples, como ruído gaussiano, até a distribuição dos dados-alvo por meio de um campo de velocidade aprendível15. Essa formulação relaciona diretamente a estimativa de score à evolução da densidade, resultando em trajetórias de probabilidade mais suaves e dinâmicas de treinamento mais estáveis. Uma vantagem fundamental do fluxo de correspondência é sua formulação determinística e computacionalmente eficiente. Modelos de fluxo retificados16 simplificam ainda mais as trajetórias de transporte em caminhos quase lineares, melhorando a estabilidade numérica e permitindo a geração de amostras de alta qualidade com relativamente poucos passos de integração. Estudos posteriores, incluindo modelos de consistência17, incorporaram objetivos inspirados na difusão a estruturas compactas baseadas em fluxo, alcançando qualidade de amostragem comparável ou superior com inferência eficiente. Além disso, o treinamento baseado em fluxo pode aproveitar estruturas pré-treinadas de difusão, facilitando o uso de priores generativos em larga escala enquanto reduz os custos de amostragem. Estudos recentes ampliaram o fluxo de correspondência para uma ampla gama de aplicações. Por exemplo, Hu et al.18 investigaram estruturas tipo transformador e manipulações no espaço latente para edição de imagens controlável e composicional usando fluxo de correspondência. Outras aplicações incluem síntese de imagens19, diagnóstico de falhas em rolamentos20 e soldagem robótica multialvo e multijunta21. Em conjunto, esses estudos demonstram que o fluxo de correspondência é aplicável além da síntese de imagens condicionais e de alta resolução, fornecendo ao mesmo tempo uma base teórica bem estabelecida com potencial para generalização de domínio. Ao aprender mapas de transporte contínuos e determinísticos, o fluxo de correspondência oferece um equilíbrio entre eficiência, controlabilidade e fidelidade generativa. Sua formulação baseada em EDO oferece uma perspectiva unificada sobre a modelagem generativa moderna e fornece uma base teórica para aplicações envolvendo representação multimodal de dados e alinhamento de características.
A classificação multimodal de sensoriamento remoto tem como objetivo superar as limitações de modalidades individuais de sensoriamento por meio da integração de informações complementares de HIS, imagens multiespectrais, LiDAR e SAR. Abordagens de fusão precoce baseavam-se em características manualmente elaboradas ou algoritmos baseados em kernel, como máquinas de vetores de suporte (SVMs), mas eram limitadas pela alta dimensionalidade e interação insuficiente entre modalidades22. Os avanços no aprendizado profundo permitiram estratégias de fusão estruturadas, incluindo fusão inicial, intermediária e tardia, sendo que a fusão no nível de características oferece um equilíbrio prático entre integração de informações e complexidade computacional23. Redes neurais convolucionais (CNNs) capturam efetivamente informações espaciais e espectrais locais, enquanto arquiteturas baseadas em Transformadores modelam dependências de longo alcance a um custo computacional mais elevado24. Consequentemente, arquiteturas híbridas CNN–Transformador tornaram-se cada vez mais populares, pois combinam os pontos fortes complementares de ambas as abordagens. Exemplos representativos incluem métodos de fusão em escalas adjacentes que aprimoram a informação contextual por meio de interações entre escalas25 e estruturas multinível que combinam características rasas de CNN com representações profundas de Transformadores usando mecanismos adaptativos de atenção26. Em conjunto, esses estudos destacam a importância de uma interação eficaz entre escalas e modalidades para reduzir a redundância de características e melhorar a representação semântica.
Desenvolvimentos recentes também exploraram estratégias complementares para aprendizado multimodal. Por exemplo, métodos de representação de baixa ordem, como o framework orientado pela curva de Ebbinghaus, reduzem o sobreajuste ao preservar a estrutura de variedade enquanto suprimem informações redundantes27. Em paralelo, o aprendizado multimodal distribuído tem sido investigado para enfrentar limitações de privacidade e comunicação em aplicações práticas. Por exemplo, o FedFusion projeta características rasas em subespaços de baixa ordem para permitir o aprendizado multimodal federado28. Em conjunto, esses estudos ilustram três direções de pesquisa complementares: arquiteturas híbridas CNN–Transformer para equilibrar a modelagem de características locais e globais, aprendizado de baixa ordem para reduzir redundância e ruído, e aprendizado distribuído para implantação escalável e preservação da privacidade. No entanto, desafios importantes permanecem, incluindo desequilíbrio entre modalidades, disponibilidade limitada de dados rotulados e o compromisso entre compressão do modelo e precisão de classificação. Esses desafios motivaram a continuidade da pesquisa em estruturas de fusão multimodal leves e generalizáveis. Abordagens recentes de alinhamento multimodal também incorporaram atenção intermodal, aprendizado contrastivo, fusão baseada em grafos, adaptação de domínio e estratégias de correspondência de distribuições. Em contraste, o FlowErs formula o alinhamento multimodal como transporte de características pareadas e condicionadas ao tempo, sendo apresentado como uma estratégia de alinhamento complementar, e não como substituição universal das abordagens existentes.
Protocolo
Este estudo utilizou exclusivamente conjuntos de dados de referência publicamente disponíveis (Houston2013, Augsburg e MUUFL) para classificação de cobertura do solo em sensoriamento remoto. Nenhum participante humano, experimento com animais ou amostras biológicas recém-coletadas foram envolvidos. Portanto, a aprovação ética institucional não foi necessária.
Visão Geral do Estudo
O framework proposto, FlowErs, realiza classificação multimodal de cobertura do solo por meio de uma estratégia de aprendizado em duas etapas. Seu fluxo de trabalho geral é ilustrado na Figura 1A–C. O framework compreende três componentes principais: (i) codificadores baseados em MetaFormer que extraem representações hierárquicas de características a partir de modalidades sensoriais heterogêneas, (ii) um módulo de correspondência de fluxo multimodal (MFM) que alinha explicitamente as distribuições de características entre modalidades e (iii) uma cabeça de classificação leve que prevê categorias de cobertura do solo a partir das representações de características fundidas. O fluxo de trabalho geral primeiramente extrai características específicas de cada modalidade, posteriormente alinha essas características em um espaço latente compartilhado por meio de correspondência de fluxo condicional e, finalmente, realiza a classificação de cobertura do solo pixel a pixel utilizando as representações multimodais alinhadas.
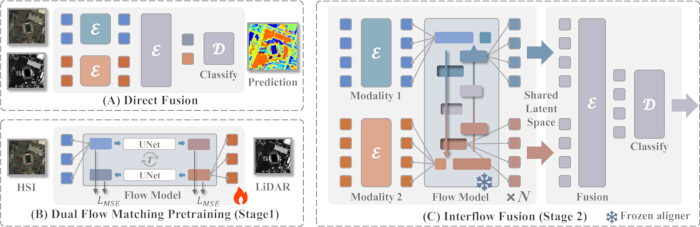
Figura 1: Visão geral do framework FlowErs proposto para classificação multimodal de cobertura do solo. (A) Fusão direta convencional de características, na qual características específicas de cada modalidade extraídas de imagens hiperspectrais (HSI) e dados de detecção e alcance de luz (LiDAR) são concatenadas diretamente antes da classificação. (B) Estágio 1: Pré-treinamento bidirecional de correspondência de fluxo multimodal. Uma U-Net condicionada ao tempo aprende o transporte contínuo bidirecional entre representações de características específicas de cada modalidade usando uma perda de erro quadrático médio para alinhar distribuições heterogêneas de características. (C) Estágio 2: Fusão interfluxo. O módulo pré-treinado de correspondência de fluxo é congelado e reutilizado para alinhar representações de características específicas de cada modalidade antes da fusão leve de características e classificação de cobertura do solo em nível de pixel. E, codificador; D, decodificador; T, incorporação temporal; , perda de erro quadrático médio; S, representação latente compartilhada. Clique aqui para visualizar uma versão ampliada desta figura.
O framework proposto separa o alinhamento de características da classificação semântica por meio de uma estratégia de treinamento em duas etapas. Na primeira etapa, o módulo MFM é treinado para aprender o transporte bidirecional de características entre variedades de características específicas de cada modalidade. Na segunda etapa, o módulo de alinhamento de fluxo pré-treinado é congelado e reutilizado para alinhar as representações de características multimodais antes da fusão leve de características e da classificação. Esse design desacoplado permite que o módulo de alinhamento e a rede de classificação otimizem objetivos complementares, ao mesmo tempo que reduzem as discrepâncias na distribuição de características antes da fusão multimodal.
Visão Teórica
O flow matching é um paradigma recentemente proposto de modelagem generativa que aprende uma transformação determinística contínua entre duas distribuições de probabilidade. Diferentemente dos modelos baseados em difusão, que introduzem estocasticidade por meio de perturbações de ruído, o flow matching parametriza diretamente um campo de velocidade aprendível que transporta continuamente uma distribuição de probabilidade em direção a outra. Essa formulação de transporte contínuo permite o alinhamento de características por meio de uma EDO, permitindo que representações de características emparelhadas provenientes de diferentes modalidades sensoriais evoluam ao longo de uma trajetória compartilhada antes da fusão de características. No presente estudo, utiliza-se o flow matching condicional para aprender o transporte bidirecional de características entre incorporações específicas de modalidade extraídas pelos codificadores MetaFormer. O modelo é treinado usando um objetivo de flow matching condicional que minimiza a discrepância entre os campos de velocidade previstos e os campos de velocidade alvo ao longo de representações de características interpoladas. A formulação matemática completa, a derivação teórica, as equações governantes e o objetivo de treinamento são fornecidos no Arquivo Suplementar 1.
Formulação do Problema
A classificação de cobertura do solo a partir de dados de sensoriamento remoto multissensorial envolve a aprendizagem de representações semânticas a partir de modalidades sensoriais heterogêneas, como HSI e LiDAR. Essas modalidades apresentam características sensoriais distintas. O HSI adquire informações espectrais ricas com centenas de canais ( ), enquanto o LiDAR fornece informações estruturais detalhadas com um número comparativamente menor de canais (
 ). Esse desequilíbrio entre riqueza espectral e escassez estrutural cria uma lacuna de domínio significativa nas distribuições de características, tornando a fusão direta de características subótima e potencialmente instável.
Formalmente, dada uma dupla de entradas multimodais, 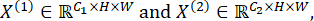 o objetivo é prever um mapa semântico pixel a pixel de acordo com a Equação 1:
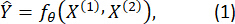
Aqui, 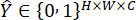 é o tensor de rótulo codificado em one-hot, C indica o número total de categorias de cobertura do solo e θ representa todos os parâmetros aprendíveis do modelo. O conjunto de dados Houston2013 possui um tamanho de imagem de 349 × 1905 pixels com 144 bandas hiperspectrais (HSI) e 1 banda LiDAR. O conjunto de dados Augsburg possui um tamanho de imagem de 1152 × 480 pixels com 224 bandas HSI e 1 banda LiDAR. O conjunto de dados MUUFL possui um tamanho de imagem de 325 × 220 pixels com 64 bandas HSI e 2 bandas LiDAR. Para todos os conjuntos de dados, os fragmentos de imagem de entrada foram redimensionados para 32 × 32 pixels antes do treinamento.
Abordagens multimodais convencionais fundem características específicas de cada modalidade por meio de concatenação ou mecanismos de atenção, assumindo implicitamente que diferentes modalidades residem em um espaço de características compatível. No entanto, essa suposição raramente é válida para dados de sensoriamento remoto, pois as distribuições estatísticas específicas de cada modalidade e as características espaciais e espectrais diferem substancialmente.
Para vincular explicitamente essa discrepância, um módulo de correspondência de fluxo,  é introduzido. O módulo é parametrizado por
 e aprende transformações contínuas bidirecionais entre variedades de características específicas de cada modalidade. Especificamente (Equação 2),
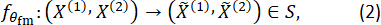
Aqui, S denota o espaço latente compartilhado no qual as representações de características específicas de cada modalidade são alinhadas geometricamente. Posteriormente, as representações de características alinhadas são fundidas e classificadas de acordo com a Equação 3 da seguinte forma:
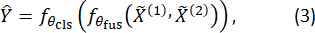
Aqui,  e
 denotam os módulos de fusão de características e de classificação, respectivamente. Esta formulação define o framework geral FlowErs. Em vez de depender exclusivamente da fusão estatística implícita de características, o framework proposto introduz um mecanismo explícito de alinhamento baseado em fluxo que transporta continuamente representações de características específicas de cada modalidade para um espaço latente compartilhado antes da fusão de características multimodais e da predição semântica.
Codificador MetaFormer
O FlowErs realiza o alinhamento de características multimodal utilizando codificadores leves específicos para cada modalidade, que aprendem representações de características informativas e geometricamente consistentes de cada modalidade sensorial. Conforme ilustrado na Figura 2, cada modalidade é processada por um codificador independente baseado na arquitetura MetaFormer. O MetaFormer generaliza o design fundamental do Transformer ao desacoplar a mistura de tokens da transformação de canal, sem calcular explicitamente a autoatenção. Esse design permite o processamento eficiente de HSI de alta dimensão, mantendo-se adaptável a modalidades de poucos canais, como o LiDAR.
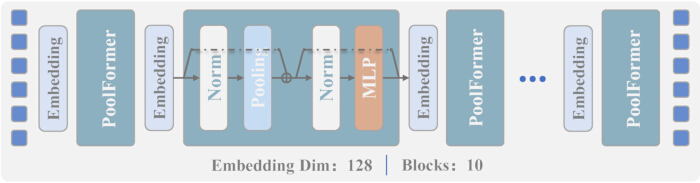
Figura 2: Arquitetura do codificador MetaFormer específico por modalidade utilizado no framework proposto FlowErs. O codificador transforma entradas específicas de cada modalidade em representações hierárquicas de características por meio de repetidas etapas de incorporação e blocos PoolFormer. Cada bloco PoolFormer consiste em normalização, mistura de tokens baseada em agrupamento (pooling), adição residual, normalização e um perceptron multicamadas (MLP). As representações hierárquicas de características resultantes são encaminhadas ao módulo multimodal de correspondência de fluxo para o alinhamento de características entre modalidades. Norm, normalização; MLP, perceptron multicamadas. Clique aqui para visualizar uma versão maior desta figura.
Para cada modalidade  , o codificador MetaFormer
 , transforma a entrada
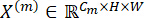 em uma hierarquia de representações latentes de características (Equação 4):
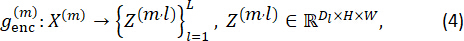
Aqui, L denota o número total de estágios do codificador, e Dl denota a dimensão do embedding no estágio l. O codificador MetaFormer compreende três estágios (N = 3) com dimensões de embedding de 64, 128 e 256, respectivamente. Os números correspondentes de blocos PoolFormer em cada estágio são 2, 6 e 2, seguindo a arquitetura hierárquica progressiva descrita no manuscrito.
Cada codificador começa com uma convolução 1 × 1 que projeta os canais de entrada em um espaço comum de incorporação (Equação 5):
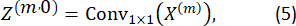
Essa camada de projeção é seguida por L blocos MetaFormer empilhados. Cada bloco consiste em duas operações residuais: (i) mistura de tokens por meio de agrupamento espacial para agregar informações contextuais e (ii) transformação de canal por meio de um perceptron multicamadas (MLP) para refinar as representações de características espectrais e espaciais. Essas operações são expressas pelas Equações 6 e 7 da seguinte forma:
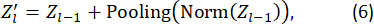

Aqui, Agrupamento(·) denota agregação de contexto espacial baseada em agrupamento médio e MLP(·) denota uma rede convolucional feed-forward de duas camadas que incorpora ativação GELU e regularização por dropout.
O codificador segue uma arquitetura hierárquica na qual a dimensão do embedding aumenta progressivamente ao longo dos estágios sucessivos (por exemplo, 64  128 256). Esse design progressivo permite que camadas mais profundas codifiquem informações espaciais e espectrais cada vez mais ricas, ao mesmo tempo que melhora a capacidade representacional das características aprendidas. A implementação utiliza um kernel de agrupamento 3 × 3, uma dimensão oculta da MLP de 128 e uma taxa de dropout de 0,1. Todas as camadas convolucionais dentro do codificador MetaFormer utilizam kernels 1 × 1 com stride de 1 e sem preenchimento. O operador de agrupamento utiliza média 3 × 3 com stride de 1 e preenchimento de 1. A normalização por lote (BatchNorm2d) é usada em todo o codificador. A MLP possui uma dimensão oculta de 128, emprega a função de ativação GELU e utiliza uma taxa de dropout de 0,1. Os três estágios do codificador contêm respectivamente 2, 6 e 2 blocos PoolFormer, e essas configurações arquiteturais são aplicadas de forma consistente em todos os estágios.
Em comparação com codificadores baseados em Transformer, o codificador MetaFormer elimina o custo computacional quadrático associado à autoatenção, ao mesmo tempo que reduz o viés específico à modalidade durante a extração de características. Seu misturador de tokens baseado em agrupamento (pooling) agrega eficientemente o contexto espacial local, enquanto o alinhamento entre modalidades é subsequentemente realizado pelo módulo de correspondência de fluxo. Consequentemente, as representações de características de nível mais alto produzidas pelo codificador fornecem entradas semanticamente informativas e geometricamente consistentes para o alinhamento de características multimodais.
Correspondência Multimodal de Fluxo
O principal desafio após a extração de características é o alinhamento de representações heterogêneas de características originadas de diferentes modalidades sensoriais que residem em variedades de características distintas. A concatenação direta de  e
 frequentemente apresenta mau desempenho devido a distribuições de características inconsistentes e vieses específicos da modalidade. O FlowErs aborda explicitamente esse desafio ao introduzir um módulo MFM que aprende transformações contínuas e bidirecionais entre os dois espaços de características, conforme ilustrado conceitualmente na Figura 1B.
Seja 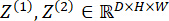 a representação de características extraída pelos codificadores MetaFormer. Um campo de fluxo contínuo parametrizado pelo tempo de interpolação
 é definido usando a Equação 8 da seguinte forma:
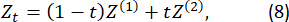
Aqui, t = 0 corresponde à modalidade de origem e t = 1 corresponde à modalidade de destino.
O modelo de correspondência de fluxo, , é implementado como uma U-Net condicionada ao tempo que prevê o campo de velocidade instantâneo que governa a transformação ao longo dessa trajetória de interpolação. Cada preditor de fluxo compreende três blocos de subamostragem (64 128 256 512) e três blocos correspondentes de superamostragem (512 256 128 64) utilizando convoluções 3 × 3, normalização por lote e ativação por unidade linear retificada (ReLU). Os embeddings intermediários de tempo têm dimensões 128, 256, 512, 256 e 128, respectivamente. O embedding de tempo utiliza uma codificação posicional senoidal fixa. A integração da EDO é realizada usando o método de Euler progressivo com um tamanho de passo fixo. Durante o treinamento, o número de passos de integração foi definido como 6, enquanto 5 passos de integração foram usados por padrão durante a inferência. O número real de iterações do laço de integração é calculado como 
O campo de velocidade previsto é dado pela Equação 9 da seguinte forma:
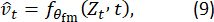
Aqui,  denota a velocidade instantânea prevista. O modelo aprende a aproximar o deslocamento
 estimulando assim transformações contínuas entre espaços de características específicos de cada modalidade. O objetivo de treinamento é formulado como uma perda bidirecional de erro quadrático médio condicionada ao tempo (MSE), conforme a seguir (Equação 10):
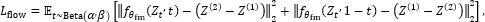 (10)
A amostragem de t a partir da distribuição Beta especificada expõe o modelo a estados intermediários de interpolação, mas não estabelece consistência exata de ciclo. Diferentemente dos métodos de alinhamento baseados em difusão, a formulação proposta de correspondência de fluxo é determinística, não requer amostragem estocástica durante a inferência e pode ser treinada utilizando dados rotulados e não rotulados.
Um modelo de fluxo treinado atua subsequentemente como um operador de alinhamento determinístico que projeta representações de características específicas de cada modalidade em um espaço latente compartilhado S. As representações alinhadas são obtidas da seguinte forma (Equação 11):
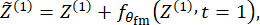
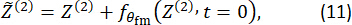
Aqui,  e
 denotam as representações de características alinhadas. O alinhamento baseado em fluxo é aplicado às representações de características intermediárias das duas primeiras etapas do codificador (Etapas 1 e 2), com dimensões de incorporação de 64 e 128, respectivamente. As características do codificador de nível mais alto (Etapa 3, dimensão de incorporação 256) não são processadas pelo módulo de correspondência de fluxo. Em vez disso, essas características são concatenadas diretamente e enviadas ao classificador para predição multimodal.
Esse mecanismo de alinhamento bidirecional transporta progressivamente representações de características específicas de cada modalidade em direção a um espaço latente compartilhado por meio de um campo de fluxo contínuo. Consequentemente, e tornam-se mais alinhados antes da fusão de características multimodais, fornecendo representações de características semanticamente consistentes e geometricamente compatíveis para a classificação subsequente.
Pipeline de Treinamento
O FlowErs explora dados rotulados e não rotulados, mantendo um alinhamento cruzado modal estável por meio de uma estratégia de treinamento em duas etapas, conforme ilustrado na Figura 1(B,C). Na primeira etapa, um módulo de alinhamento invariante à modalidade é aprendido por meio de correspondência não supervisionada de fluxo. Na segunda etapa, realiza-se classificação supervisionada utilizando as representações latentes alinhadas, reutilizando ao mesmo tempo o módulo de alinhamento de fluxo pré-treinado.
Fase 1: Pré-treinamento Não Supervisionado de Fluxo
Dadas pares de imagens multimodais,  representações de características específicas de cada modalidade,
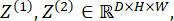 são extraídas utilizando os codificadores MetaFormer. Representações intermediárias de características são geradas usando a interpolação definida na Equação 8, onde
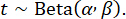 O módulo de correspondência de fluxo,
 , é otimizado mediante a minimização do objetivo bidirecional condicionado ao tempo definido na Equação 10, sem o uso de rótulos de classe. Nesta fase, apenas os parâmetros do módulo de correspondência de fluxo,
 , são atualizados, permitindo que o modelo aprenda correspondências com consciência geométrica a partir de amostras rotuladas e não rotuladas antes da classificação supervisionada. A Fase 1 (pré-treinamento do módulo de correspondência de fluxo) foi realizada utilizando o otimizador AdamW com uma taxa de aprendizado de 1 × 10⁻4, um decaimento de peso de 1 × 10⁻2 e um escalonamento de taxa de aprendizado com退elamento cosseno. Tamanhos de lote de 16 foram utilizados para os conjuntos de dados Houston2013 e Trento, enquanto tamanhos de lote de 32 foram utilizados para os conjuntos de dados Augsburg e MUUFL. O módulo de correspondência de fluxo foi pré-treinado por 2.000 épocas utilizando amostras rotuladas e não rotuladas. A semente aleatória foi fixada em 3407. Todos os experimentos foram conduzidos usando PyTorch em uma única GPU NVIDIA A100 (80 GB de memória).
Fase 2: Classificação supervisionada com um alinhador compartilhado
O módulo pré-treinado de correspondência de fluxo é reutilizado durante o treinamento supervisionado e é aplicado às duas primeiras etapas do codificador, em vez de a todos os níveis de características. As representações de características alinhadas são subsequentemente fundidas utilizando a cabeça de classificação para gerar previsões ao nível dos pixels. A otimização supervisionada minimiza a perda de entropia cruzada mascarada (Equação 12):
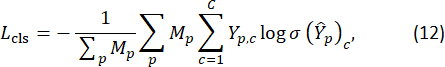
Aqui, M denota a máscara de rótulo, Y denota os rótulos verdadeiros codificados em one-hot e σ(·) denota a função softmax. Durante a Etapa 2 (treinamento supervisionado), o módulo pré-treinado de correspondência de fluxo permaneceu completamente congelado e atuou como um operador fixo de alinhamento cruzado-modal. Seus pesos pré-treinados foram carregados no início da Etapa 2 e não foram atualizados durante o treinamento supervisionado. Apenas os parâmetros do codificador MetaFormer e do classificador foram otimizados. O treinamento supervisionado foi realizado utilizando o otimizador AdamW com taxas de aprendizado específicas para cada conjunto de dados: 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL) e 1 × 10⁻5 (Trento). A penalidade de decaimento de peso foi definida como 1 × 10⁻2 para todos os conjuntos de dados, exceto para o MUUFL, para o qual foi utilizada um valor de 5 × 10⁻2. Tamanhos de lote de 16 ou 32 foram empregados, dependendo do conjunto de dados. Os modelos foram treinados por 100 épocas (Houston2013 e MUUFL), 200 épocas (Augsburg) e 20 épocas (Trento), utilizando um agendamento de taxa de aprendizado com resfriamento cosseno. A função de perda CrossEntropyLoss com redução média foi utilizada como função de perda. Nenhuma parada antecipada foi aplicada; em vez disso, o ponto de verificação do modelo que alcançou a maior acurácia geral (OA) no conjunto de teste foi selecionado como o modelo final. O fluxo de trabalho completo da implementação do procedimento de treinamento em duas etapas é resumido no Arquivo Suplementar S1 (Algoritmo S1).
Essa estratégia de treinamento desacoplada separa o alinhamento geométrico da discriminação semântica. Na Fase 1, o modelo aprende mapeamentos bidirecionais contínuos de características usando o objetivo de correspondência de fluxo. Na Fase 2, o módulo de alinhamento pré-treinado fornece uma operação comum de transporte de características antes da fusão de características multimodais, enquanto a rede de classificação aprende representações discriminativas por classe a partir do espaço latente alinhado. A reutilização do alinhador pré-treinado promove um alinhamento consistente de características antes da fusão, mas não é apresentada como uma garantia independente de melhor generalização.
Conjuntos de Dados Experimentais
O framework proposto foi avaliado utilizando três conjuntos de dados de referência representativos de sensoriamento remoto multimodal: Houston201329, Augsburg30 e MUUFL31.
O conjunto de dados Houston2013 foi lançado como parte do Desafio de Fusão de Dados do IEEE GRSS. Ele representa uma paisagem urbana diversificada em Houston, EUA, e contém 15 classes de cobertura do solo, incluindo áreas residenciais, vias, vegetação e corpos d'água. O conjunto de dados inclui HSI com 144 bandas espectrais que abrangem o espectro do visível ao infravermelho próximo, juntamente com um modelo digital de superfície (DSM) derivado de LiDAR de uma única banda, com resolução espacial de 2,5 m. As texturas urbanas complexas e a variabilidade espectral substancial intraclasse tornam este conjunto de dados desafiador para a classificação precisa da cobertura do solo.
O conjunto de dados de Augsburg foi adquirido sobre uma área urbana densamente construída na Alemanha. Ele compreende imagens hiperspectrais com 224 bandas espectrais que cobrem a faixa de comprimento de onda de 400–1000 nm, juntamente com dados de elevação LiDAR co-registrados. O conjunto de dados contém 17 classes anotadas de cobertura do solo, incluindo estruturas construídas, solo descoberto, asfalto, vegetação e sombra, com uma resolução espacial de 2 m. Em comparação com Houston2013, Augsburg apresenta correlações espectrais mais fortes e maior diversidade de classes, fornecendo um desafio significativo para avaliar o alinhamento de características multimodais e sua generalização.
O conjunto de dados MUUFL Gulfport foi coletado em um campus universitário e representa um ambiente semiurbano contendo vegetação abundante juntamente com pequenas estruturas artificiais. O conjunto de dados inclui imagens hiperespectrais com 64 bandas denoizadas, juntamente com medições LiDAR de duas bandas que consistem em informações de elevação e intensidade. Ele contém 11 classes de cobertura do solo e apresenta detalhes espaciais finos, pixels mistos e condições variáveis de iluminação, tornando-o adequado para avaliar a fusão de características multimodais na classificação de pequenos objetos.
Coletivamente, esses três conjuntos de dados de referência abrangem variações significativas na resolução espacial (1–2,5 m), dimensionalidade espectral (64–224 bandas), complexidade da cena e composição de cobertura do solo. Consequentemente, eles fornecem uma referência diversificada para avaliar a eficácia e a generalização de métodos multimodais de classificação de cobertura do solo. As principais características dos conjuntos de dados são resumidas na Tabela 1. As divisões treinamento/teste para os três conjuntos de dados correspondem às divisões oficiais fornecidas pelos provedores originais dos dados. Especificamente, o conjunto de dados Houston2013 utiliza a divisão oficial do IEEE GRSS Data Fusion Contest de 2013, compreendendo 2.832 amostras de treinamento e 12.197 amostras de teste. O conjunto de dados Augsburg utiliza as anotações oficiais mask_train e mask_test, resultando em 4.538 amostras de treinamento e 47.896 amostras de teste. O conjunto de dados MUUFL utiliza a divisão oficial train_test_gt.mat, contendo 28.645 amostras de treinamento e 24.283 amostras de teste. Para cada conjunto de dados, um recorte de imagem de 32 × 32 pixels, centrado em cada pixel rotulado, foi extraído como uma amostra individual de treinamento ou teste. Nenhuma divisão adicional de dados ou reamostragem foi realizada.
| Propriedade | Houston2013 | Augsburg | MUUFL |
| Tamanho da imagem HSI (pixels) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Tamanho da imagem LiDAR (pixels) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Bandas espectrais HSI | 144 | 224 | 64 |
| Bandas LiDAR | 1 | 1 | 2 |
| Intervalo de comprimento de onda HSI | 0,38–1,05 µm | 0,40–1,00 µm | 375–1050 nm |
| Intervalo de comprimento de onda LiDAR | Não aplicável | Não aplicável | Não aplicável |
| Resolução espacial (HSI) | 2,5 m | 2,0 m | 0,54 m × 1,00 m |
| Resolução espacial (LiDAR) | 2,5 m | 2,0 m | 0,60 m × 0,78 m |
| Número de classes de cobertura do solo | 15 | 17 | 11 |
Tabela 1: Características dos três conjuntos de dados de referência de sensoriamento remoto multiespectral utilizados na avaliação. A tabela resume as dimensões das imagens, características espectrais, resoluções espaciais e números de classes de cobertura do solo para os conjuntos de dados de referência Houston2013, Augsburg e MUUFL utilizados para avaliar o framework proposto FlowErs.
Detalhes da Implementação
O framework FlowErs foi implementado em PyTorch e treinado e avaliado usando uma unidade de processamento gráfico (GPU) com 80 GB de memória. O treinamento foi realizado durante 100 épocas usando um tamanho de lote de 16. O otimizador AdamW foi empregado com uma taxa de aprendizado inicial de 1 × 10⁻⁴ e uma taxa de decaimento de peso de 1 × 10⁻². Um escalonador de taxa de aprendizado com recozimento cosseno foi utilizado para atualizar a taxa de aprendizado ao longo do treinamento. Uma taxa de dropout de 0,1 foi aplicada para melhorar a generalização do modelo e reduzir o sobreajuste. A função de perda de entropia cruzada foi usada para otimização supervisionada. Para reprodutibilidade, todos os experimentos foram inicializados usando uma semente aleatória fixa de 3407. As partições de treinamento/teste fornecidas foram utilizadas sem criar uma divisão adicional de validação. Cada fragmento de entrada foi redimensionado para 32 × 32 pixels antes do treinamento. Nenhuma ampliação de dados, correção explícita de registro de imagem ou normalização adicional do carregador de dados foi aplicada. Os pixels associados a rótulos negativos foram excluídos do cálculo da perda supervisionada. O tratamento de pixels ausentes ou ruidosos não foi avaliado separadamente.
Métricas de Avaliação
Três métricas de avaliação amplamente adotadas foram utilizadas para avaliar o desempenho da classificação: OA, Acurácia Média (AA) e o coeficiente Kappa (k). OA mede a proporção de amostras corretamente classificadas entre todas as amostras, AA representa a acurácia média de classificação em todas as classes de cobertura do solo, e o coeficiente Kappa quantifica a concordância entre as classificações previstas e as de referência, ajustada pela concordância esperada por acaso. Valores mais altos para as três métricas indicam melhor desempenho de classificação. Todos os valores relatados nas Tabelas 2–6 são estimativas pontuais com divisão fixa obtidas utilizando a semente aleatória 3407. Não são informados intervalos de confiança, testes de significância estatística ou valores de p.
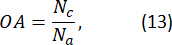
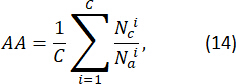
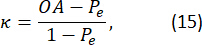
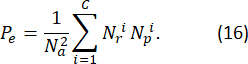
Aqui, Nc e Na indicam os números totais de amostras corretamente classificadas e de amostras avaliadas, respectivamente.  e
 indicam os números de amostras corretamente classificadas e o número total de amostras para a i-ésima classe, respectivamente. No cálculo do coeficiente Kappa, Pe indica a probabilidade de concordância ocorrer por acaso, e
 e
 indicam as contagens de amostras de referência e previstas para a i-ésima classe, respectivamente.
Resultados
O fluxo de trabalho geral da avaliação do framework proposto FlowErs é ilustrado na Figura 1, que resume a estratégia de classificação multimodal em duas etapas. O processo de extração de características específico por modalidade, baseado no codificador MetaFormer, é mostrado na Figura 2, e as características principais dos três conjuntos de dados de referência utilizados na avaliação são resumidas na Tabela 1. O desempenho de classificação foi posteriormente avaliado nos conjuntos de dados de referência MUUFL, Houston2013 e Augsburg utilizando a OA, AA e o coeficiente Kappa (κ) definidos na seção Protocolo.
Comparação com Outros Métodos
Várias redes de classificação multimodal de referência foram incluídas para fornecer uma comparação abrangente do framework proposto. DFINet32 integra informações hiperspectrais e multiespectrais usando um módulo de atenão cruzada por profundidade para melhorar a interação de características por meio de múltiplos objetivos de perda. DSHFNet33 introduz uma estratégia de fusão hierárquica dinâmica que combina progressivamente representações em escala fina e em escala grossa. MDL-Middle34 emprega uma estratégia de fusão de características em camadas intermediárias para equilibrar informações de múltiplas modalidades de sensoriamento. CMCL35 trata dados de HSI e LiDAR como vistas complementares da mesma cena e aplica aprendizado contrastivo juntamente com duplo ajuste fino para melhorar o alinhamento de características. Two-Branch36 utiliza uma arquitetura convolucional de dois caminhos que processa independentemente cada modalidade antes da fusão de características. ExViT37 realiza o processamento de fragmentos multimodais usando ramificações paralelas de Transformadores com módulos de atenção cruzada entre modalidades. DSymFuse38 estende a arquitetura de Transformador com duas ramificações por meio de fusão hierárquica de características locais e globais. CTPMSN39 combina arquiteturas convolucionais e de Transformador com alinhamento de prompts textuais e visuais para melhorar a consistência semântica e a discriminação de classes. Os valores de comparação foram obtidos a partir das publicações citadas ou de seus protocolos de avaliação relatados e não foram gerados usando uma implementação unificada ou um framework experimental comum. Portanto, essas comparações devem ser interpretadas como comparações descritivas de referência e não como avaliações controladas diretas.
Conjunto de dados MUUFL
Os resultados de classificação obtidos para o conjunto de dados MUUFL Gulfport são resumidos na Tabela 2, e mapas de classificação representativos são apresentados na Figura 3A–J. Na divisão fixa de referência relatada, o framework proposto alcançou uma OA de 95,24% e um coeficiente Kappa de 93,69%, comparados com 93,99% e 92,03%, respectivamente, para o CTPMSN. O desempenho por classe variou entre as categorias de cobertura do solo. Em comparação com o CTPMSN, o framework proposto obteve maiores precisões de classificação para as classes Árvores, Principalmente Grama e Superfície Mista, com aumentos de 2,73%, 3,16% e 1,86%, respectivamente. Em contraste, a classe Curb Amarelo permaneceu desafiadora devido ao número limitado de amostras disponíveis, e sua precisão relatada foi inferior à de vários métodos comparativos. Assim, a melhoria observada no desempenho agregado não deve ser interpretada como indicativa de desempenho superior em todas as classes individuais de cobertura do solo. A comparação qualitativa na Figura 3A–I mostra os mapas de classificação gerados pelos métodos avaliados, enquanto a Figura 3J apresenta o mapa de referência correspondente de referência, ilustrando a distribuição espacial das classes de cobertura do solo ao longo do conjunto de dados MUUFL Gulfport.
| Classe | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Árvores | 89,2 | 74,91 | 87,31 | 84,86 | 91,32 | 92,64 | 91,24 | 95,55 | 98,28 |
| Principalmente grama | 72,98 | 84,63 | 76,38 | 86,54 | 80,65 | 77,48 | 79,57 | 88,92 | 92,08 |
| Superfície mista | 69,22 | 34,77 | 68,33 | 54,75 | 67,92 | 82,07 | 82,23 | 87,92 | 89,78 |
| Terra/areia | 76,68 | 87,06 | 78,74 | 84,45 | 78,32 | 93,74 | 89,17 | 97,27 | 93,55 |
| Estrada | 86,68 | 81,09 | 83,76 | 86,25 | 84,34 | 90,35 | 85,6 | 94,52 | 95,94 |
| Água | 100 | 99,25 | 88,52 | 98,53 | 100 | 99,38 | 100 | 100 | 97,56 |
| Sombra | 83,29 | 90,65 | 92,12 | 97,72 | 84,89 | 91,47 | 91 | 95,98 | 90,54 |
| Edifício | 93,26 | 90,22 | 89,69 | 97,54 | 93,76 | 89,27 | 96,29 | 96,29 | 98,26 |
| Calçada | 57,34 | 53,09 | 77,06 | 77,98 | 71,32 | 73,54 | 79,62 | 88,07 | 79,61 |
| Borda amarela | 84,28 | 1,03 | 96,75 | 80,62 | 81,41 | 93,72 | 91,57 | 97,37 | 48,91 |
| Placas de tecido | 97,92 | 92,79 | 99,41 | 98,41 | 99,21 | 99,41 | 100 | 99,41 | 93,13 |
| Precisão geral (OA) | 83,87 | 74,29 | 83,54 | 82,45 | 85,61 | 89,94 | 88,78 | 93,99 | 95,24 |
| Precisão média (AA) | 82,76 | 73,23 | 84,37 | 85,9 | 85,1 | 90,12 | 89,54 | 94,68 | 88,88 |
| Coeficiente Kappa (κ × 100) | 79,82 | 67,92 | 78,84 | 78,37 | 81,22 | 85,37 | 85,37 | 92,03 | 93,69 |
Tabela 2: Desempenho de classificação (%) de diferentes métodos no conjunto de dados de referência MUUFL. Desempenho de classificação por classe juntamente com a exatidão geral (OA), exatidão média (AA) e coeficiente Kappa (κ) obtidos pelo framework proposto FlowErs e pelos métodos concorrentes no conjunto de dados de referência MUUFL.
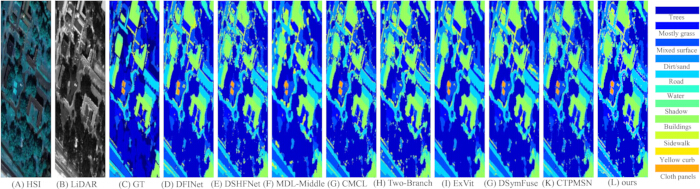
Figura 3: Resultados representativos da classificação de cobertura do solo para o conjunto de dados de referência MUUFL. (A) Imagem hiperspectral (HSI). (B) Imagem de detecção e alcance por luz (LiDAR). (C) Mapa de referência do solo (GT). (D–L) Mapas de classificação gerados por DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN e pela estrutura proposta FlowErs, respectivamente. A legenda de cores identifica as classes de cobertura do solo representadas em cada mapa de classificação.Clique aqui para visualizar uma versão maior desta figura.
Conjunto de dados Houston2013
Os resultados de classificação obtidos para o conjunto de dados Houston2013 são apresentados na Tabela 3, e mapas de classificação representativos são mostrados na Figura 4A–J. Na divisão fixa de referência relatada, o framework proposto alcançou uma OA de 97,56% e um coeficiente Kappa de 97,39%. Em comparação com os resultados reportados do CTPMSN, o framework proposto demonstrou uma OA aproximadamente 3,8 pontos percentuais maior. Melhorias também foram observadas para as classes Residencial e Rodovia, com aumentos relatados de aproximadamente 2,4 e 0,5 pontos percentuais, respectivamente. No entanto, a classe Comercial permaneceu comparativamente desafiadora e exibiu menor precisão de classificação do que vários métodos concorrentes, o que pode refletir a similaridade espectral e espacial com outras categorias de cobertura do solo urbano. De modo geral, os resultados agregados indicam um desempenho de classificação melhorado neste benchmark, ao mesmo tempo que demonstram que o desempenho variou entre as classes individuais. A comparação qualitativa na Figura 4A–I mostra os mapas de classificação gerados pelos métodos avaliados, enquanto a Figura 4J apresenta o mapa de referência correspondente do verdadeiro terreno, ilustrando a distribuição espacial das classes de cobertura do solo ao longo do conjunto de dados Houston2013.
| Classe | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Gramado saudável | 82,39 | 85,58 | 83,1 | 82,91 | 80,31 | 81,67 | 80,06 | 96,96 | 100 |
| Gramado estressado | 100 | 94,65 | 85,06 | 95,68 | 92,44 | 100 | 78,67 | 94,27 | 96,94 |
| Gramado sintético | 100 | 98,12 | 99,6 | 94,93 | 99,23 | 99,01 | 99,41 | 99,41 | 99,84 |
| Árvore | 100 | 93,09 | 91,57 | 93,37 | 98,75 | 98,96 | 95,55 | 96,21 | 99,6 |
| Solo | 98,76 | 99,91 | 98,86 | 99,43 | 99,2 | 99,91 | 98,67 | 99,43 | 100 |
| Água | 94,5 | 93,1 | 100 | 97,3 | 95,32 | 100 | 95,8 | 100 | 97,6 |
| Residencial | 87,5 | 66,65 | 97,64 | 92,58 | 90,87 | 93,28 | 87,22 | 86,86 | 99,29 |
| Comercial | 91,53 | 76,29 | 88,13 | 87,96 | 95,31 | 89,27 | 85,85 | 94,61 | 84,07 |
| Rua | 84,19 | 36,29 | 85,93 | 80,76 | 82,63 | 89,42 | 93,29 | 88,07 | 92,73 |
| Autoestrada | 69,32 | 89 | 74,42 | 57,41 | 66,69 | 71,33 | 67,95 | 81,66 | 99,74 |
| Ferrovia | 96,76 | 94,78 | 84,54 | 79,57 | 93,44 | 92,88 | 79,13 | 97,7 | 99,72 |
| Estacionamento 1 | 83,27 | 88,39 | 95,39 | 52,83 | 85,67 | 89,63 | 91,07 | 93,28 | 95,42 |
| Estacionamento 2 | 85,36 | 96,46 | 87,37 | 92,42 | 86,17 | 89,47 | 84,21 | 95,09 | 99,18 |
| Quadra de tênis | 100 | 97,3 | 95,14 | 83,04 | 98,72 | 97,89 | 100 | 100 | 99,72 |
| Pista de corrida | 99,21 | 100 | 100 | 97,02 | 100 | 97,97 | 100 | 100 | 99,83 |
| Precisão geral (OA) | 91,21 | 85,02 | 89,55 | 83,87 | 90,01 | 91,57 | 87,57 | 93,74 | 97,56 |
| Precisão média (AA) | 92,42 | 87,55 | 91,05 | 85,76 | 90,98 | 92,32 | 89,09 | 94,9 | 97,58 |
| Coeficiente Kappa (κ × 100) | 91,09 | 83,59 | 87,59 | 82,76 | 89,1 | 90,85 | 85,29 | 93,21 | 97,39 |
Tabela 3: Desempenho de classificação (%) de diferentes métodos no conjunto de dados de referência Houston2013. Desempenho de classificação por classe, juntamente com a exatidão geral (OA), exatidão média (AA) e coeficiente Kappa (κ) obtidos pelo framework proposto FlowErs e pelos métodos concorrentes no conjunto de dados de referência Houston2013.
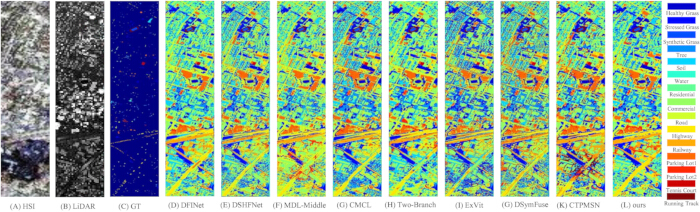
Figura 4: Resultados representativos da classificação de cobertura do solo para o conjunto de dados de referência Houston2013. (A) Imagens hiperspectrais (HSI). (B) Imagem de detecção luminosa e alcance (LiDAR). (C) Mapa de referência do solo verdadeiro (GT). (D–L) Mapas de classificação gerados por DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN e pela estrutura proposta FlowErs, respectivamente. A legenda de cores identifica as classes de cobertura do solo representadas em cada mapa de classificação. Clique aqui para visualizar uma versão maior desta figura.
Conjunto de dados de Augsburg
Os resultados de classificação obtidos para o conjunto de dados de Augsburg são resumidos na Tabela 4, e mapas representativos de classificação são apresentados na Figura 5A–J. Esse conjunto de dados é caracterizado por variação substancial dentro das classes e por uma estrutura de fundo complexa. Na divisão fixa de referência relatada, o framework proposto alcançou uma OA de 97,56% e uma AA de 89,21%. Em comparação com os métodos de referência listados, o framework proposto obteve acurácias de classificação superiores para as classes Industrial e Comercial em aproximadamente 14 e 45 pontos percentuais, respectivamente. A diferença entre OA e AA indica que o desempenho geral foi influenciado pela frequência das classes, enquanto AA reflete o desempenho médio em todas as classes. Assim, a OA relatada deve ser interpretada em conjunto com os resultados por classe, pois o desempenho da classificação variou entre as diferentes categorias de cobertura do solo. A comparação qualitativa na Figura 5A–I mostra os mapas de classificação produzidos pelos métodos avaliados, enquanto a Figura 5J apresenta o mapa de referência correspondente, ilustrando a distribuição espacial das classes de cobertura do solo ao longo do conjunto de dados de Augsburg.
| Classe | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Árvores | 96.41 | 98.21 | 91.72 | 94.27 | 95.85 | 93.64 | 90.58 | 93.36 | 99.57 |
| Residencial | 96.88 | 42.08 | 95.19 | 69.84 | 92.75 | 97.71 | 96.32 | 97.37 | 98.97 |
| Industrial | 58.2 | 47.29 | 62.61 | 35.22 | 72.66 | 65.82 | 72.45 | 64.6 | 86.41 |
| Plantas baixas | 92.22 | 51.75 | 87.76 | 80.27 | 88.9 | 84.88 | 89.65 | 96.72 | 99.58 |
| Hortas | 55.87 | 95.94 | 50.86 | 89.33 | 72.86 | 46.85 | 62.91 | 58.69 | 91.22 |
| Comercial | 10.98 | 50.91 | 24.24 | 45.59 | 20.32 | 24.49 | 17.22 | 29.73 | 74.3 |
| Água | 22.87 | 67.78 | 29.04 | 54.87 | 36.82 | 24.49 | 13.27 | 15.53 | 74.39 |
| Acurácia geral (OA) | 88.78 | 56.59 | 87.74 | 75.94 | 87.29 | 87.72 | 88.35 | 91.56 | 97.56 |
| Acurácia média (AA) | 62.29 | 65.47 | 63.06 | 67.61 | 67.78 | 62.56 | 63.2 | 65.14 | 89.21 |
| Coeficiente Kappa (κ × 100) | 84.32 | 46.78 | 82.69 | 67.83 | 82.58 | 82.49 | 83.36 | 87.88 | 96.48 |
Tabela 4: Desempenho de classificação (%) de diferentes métodos no conjunto de dados de referência Augsburg. Desempenho de classificação por classe juntamente com a acurácia geral (OA), acurácia média (AA) e coeficiente Kappa (κ) obtidos pelo framework proposto FlowErs e pelos métodos concorrentes no conjunto de dados de referência Augsburg.
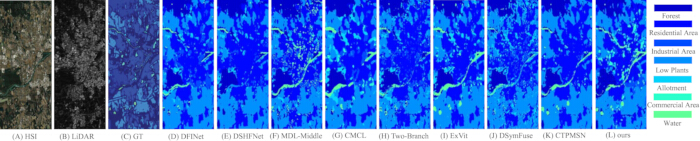
Figura 5: Resultados representativos da classificação de cobertura do solo para o conjunto de dados de referência de Augsburg. (A) Imagens hiperspectrais (HSI). (B) Imagem de detecção luminosa e alcance (LiDAR). (C) Mapa de referência do solo verdadeiro (GT). (D–L) Mapas de classificação gerados por DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN e pela estrutura proposta FlowErs, respectivamente. A legenda de cores identifica as classes de cobertura do solo representadas em cada mapa de classificação. Clique aqui para visualizar uma versão maior desta figura.
Para facilitar a comparação visual mais detalhada de regiões desafiadoras, são apresentadas vistas ampliadas de ROI representativas dos conjuntos de dados MUUFL, Houston2013 e Augsburg na Figura 6. Essas vistas ampliadas destacam os limites dos objetos e estruturas espaciais em escala fina que são menos evidentes nos mapas de classificação da cena inteira mostrados nas Figuras 3–5, fornecendo evidências qualitativas adicionais do desempenho da classificação nos três conjuntos de dados de referência.
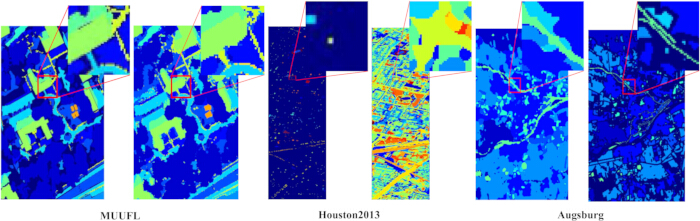
Figura 6: Visualizações ampliadas de regiões representativas de interesse (ROIs) dos conjuntos de dados MUUFL, Houston2013 e Augsburg. Regiões de interesse representativas dos conjuntos de dados MUUFL, Houston2013 e Augsburg são ampliadas para facilitar a comparação visual de detalhes de classificação em escala fina. Caixas vermelhas indicam as regiões selecionadas, e as respectivas visualizações ampliadas destacam contornos de objetos, estruturas pequenas e outras áreas desafiadoras que são difíceis de perceber nos mapas completos de classificação mostrados nas Figuras 3–5. Essas visualizações ampliadas fornecem uma avaliação qualitativa adicional dos resultados de classificação. Clique aqui para visualizar uma versão maior desta figura.
Estudo de Ablação
Efeito do módulo de correspondência de fluxo multimodal:
Para avaliar a contribuição do módulo MFM, foram realizados experimentos de ablação utilizando três configurações de modelo: o framework completo FlowErs (Baseline), um modelo sem o módulo MFM (w/o MFM) e um modelo simplificado que emprega alinhamento de fluxo unidirecional (Single Flow). Os resultados quantitativos correspondentes são resumidos na Table 5.
| Método | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| Baseline | 95,24 | 88,88 | 93,69 | 97,56 | 97,58 | 97,39 | 97,56 | 89,21 | 96,48 |
| sem MFM | 92,87 | 86,02 | 91,05 | 95,31 | 95,28 | 94,97 | 95,12 | 87,06 | 93,98 |
| Fluxo Único | 94,38 | 87,43 | 92,72 | 96,58 | 96,47 | 96,22 | 96,47 | 88,36 | 95,47 |
Tabela 5: Estudo de ablação do framework proposto FlowErs nos conjuntos de dados de referência MUUFL, Houston2013 e Augsburg. O desempenho de classificação é apresentado para o modelo completo (linha de base) e duas variantes de ablação, utilizando acurácia geral (OA), acurácia média (AA) e coeficiente Kappa (κ).
Em comparação com o modelo de Linha de Base, a remoção do módulo MFM resultou em valores menores de OA, AA e Kappa em todos os três conjuntos de dados de referência. A configuração de Fluxo Único produziu um desempenho intermediário entre o modelo completo e o modelo sem MFM, indicando que o alinhamento unidirecional de características manteve parte da melhoria de desempenho observada, embora não tenha alcançado o desempenho agregado da implementação bidirecional. Essas observações sugerem que o módulo de alinhamento de fluxo bidirecional contribuiu para o desempenho relatado nas condições de avaliação dos testes de referência. As diferenças relatadas representam estimativas pontuais de divisão fixa obtidas usando uma única semente aleatória e, portanto, devem ser interpretadas de forma descritiva, e não como evidência de significância estatística.
Nas três bases de dados de referência, as maiores diferenças agregadas de desempenho entre o modelo de linha de base e os modelos de ablação foram observadas na base de dados MUUFL, enquanto diferenças comparativamente menores foram observadas na base de dados Houston2013. Foram observadas melhorias tanto na OA quanto na AA para o modelo completo em relação às configurações de ablação, indicando um desempenho agregado de classificação mais alto, juntamente com um desempenho médio por classe aprimorado nas divisões de referência avaliadas. Esses achados são consistentes com a hipótese do estudo de que o alinhamento de características antes da fusão multimodal pode melhorar o desempenho da classificação; no entanto, experimentos repetidos e análises estatísticas não foram realizados no presente estudo.
Efeito do Número de Etapas de Integração de Fluxo:
Para avaliar mais detalhadamente a influência do número de etapas de integração de fluxo no módulo MFM, o número de etapas de integração foi variado de 2 a 10. Os resultados de classificação correspondentes são resumidos na Tabela 6. O parâmetro da etapa de integração controla a discretização do processo contínuo de transporte de características durante o alinhamento multimodal, em que valores menores representam uma discretização mais grosseira e valores maiores representam uma discretização mais refinada. Conforme mostrado na Tabela 6, as estimativas mais altas de ponto fixo nos métricos avaliados foram obtidas quando o número de etapas de integração era 6. O desempenho geralmente melhorou à medida que o número de etapas de integração aumentou de 2 para 6, após o que o desempenho relatado permaneceu relativamente estável ou diminuiu ligeiramente nos três conjuntos de dados de referência. Essas observações indicam que a configuração nominal de seis etapas de integração proporcionou o desempenho agregado mais alto sob as condições de referência avaliadas. Como os resultados relatados são baseados em uma única semente aleatória e divisões fixas de referência, essas diferenças devem ser interpretadas de forma descritiva, e não como evidência de diferenças de desempenho estatisticamente significativas.
| Etapas de integração de fluxo | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| 2 | 92,37 | 84,63 | 90,12 | 95,73 | 96,12 | 95,64 | 94,86 | 85,73 | 92,76 |
| 3 | 93,58 | 85,47 | 90,98 | 96,32 | 96,48 | 96,01 | 95,61 | 86,48 | 93,51 |
| 4 | 94,31 | 86,51 | 91,76 | 96,88 | 96,92 | 96,57 | 96,18 | 87,34 | 94,12 |
| 5 | 94,92 | 87,62 | 92,54 | 97,18 | 97,22 | 97,05 | 96,89 | 88,02 | 95,07 |
| 6 | 95,24 | 88,88 | 93,69 | 97,56 | 97,58 | 97,39 | 97,56 | 89,21 | 96,48 |
| 7 | 95,12 | 88,56 | 93,5 | 97,49 | 97,44 | 97,31 | 97,34 | 88,84 | 96,21 |
| 8 | 94,95 | 88,22 | 93,2 | 97,31 | 97,29 | 97,17 | 96,98 | 88,46 | 95,82 |
| 9 | 94,63 | 87,75 | 92,85 | 97,09 | 97,03 | 96,88 | 96,45 | 87,92 | 95,28 |
| 10 | 94,21 | 86,97 | 92,18 | 96,77 | 96,81 | 96,61 | 95,87 | 87,03 | 94,61 |
Tabela 6: Efeito do número de etapas de integração de fluxo no desempenho de classificação para os conjuntos de dados de referência MUUFL, Houston2013 e Augsburg. O desempenho de classificação é apresentado como precisão geral (OA), precisão média (AA) e coeficiente Kappa (κ) para diferentes números de etapas de integração de fluxo. Seis etapas de integração correspondem à configuração utilizada no framework final FlowErs.
Dentre os conjuntos de dados avaliados, o conjunto de dados MUUFL exibiu a maior variação no desempenho conforme o número de etapas de integração mudava, enquanto o conjunto de dados Houston2013 mostrou alterações comparativamente menores, alcançando também seu desempenho mais alto relatado em seis etapas de integração. O conjunto de dados Augsburg demonstrou uma tendência semelhante, com variação de desempenho relativamente modesta entre diferentes configurações de etapas. Em conjunto, essas observações sugerem que um número moderado de etapas de integração de fluxo proporcionou o desempenho de classificação mais alto relatado para os conjuntos de dados avaliados. A presente análise não inclui experimentos repetidos, estimativas de incerteza, perfil computacional, robustez a modalidades ausentes ou entradas com ruído, nem generalização entre regiões, e, portanto, nenhuma conclusão é extraída com relação a esses aspectos.
A avaliação nos três conjuntos de dados de referência demonstrou desempenho competitivo de classificação agregada sob as divisões fixas de referência relatadas, com uma OA máxima de 97,56%. Os experimentos de ablação mostraram que a configuração completa de correspondência de fluxo bidirecional alcançou consistentemente um desempenho agregado superior aos modelos de ablação correspondentes em todos os conjuntos de dados avaliados. As análises por classe indicaram que o desempenho da classificação variou entre as categorias de cobertura do solo, sendo que as classes minoritárias e categorias espectralmente semelhantes permaneceram comparativamente desafiadoras e contribuíram para a diferença observada entre OA e AA em conjuntos de dados desbalanceados. A avaliação atual baseia-se em estimativas pontuais com divisões fixas obtidas usando uma única semente aleatória e não inclui estimativas de incerteza de execuções repetidas, testes de significância estatística, perfil computacional, sensibilidade a desalinhamentos espaciais, robustez a modalidades ausentes ou ruidosas, ou generalização entre regiões. Esses aspectos requerem investigação adicional em estudos futuros.
Disponibilidade de Dados:
Os conjuntos de dados de referência públicos utilizados neste estudo estão disponíveis por meio de seus provedores originais. Os materiais de implementação, mapas de previsão e resultados da avaliação estão disponíveis publicamente no repositório Zenodo em https://doi.org/10.5281/zenodo.21395701.
Arquivo Suplementar 1: Formulação matemática e algoritmo de treinamento do framework FlowErs. Este arquivo suplementar apresenta a formulação matemática completa que fundamenta o framework FlowErs proposto, incluindo a formulação de fluxo contínuo (Equações S1–S2), equação de fluxo de probabilidade (Equação S3), caminho ótimo de fluxo (Equações S4–S5), objetivo de treinamento condicional por correspondência de fluxo (Equação S6) e as propriedades teóricas associadas. O arquivo também inclui o Algoritmo S1, que resume o fluxo de trabalho completo de treinamento em duas etapas, composto por pré-treinamento não supervisionado por correspondência de fluxo seguido por classificação multimodal supervisionada.
Discussão
O presente estudo apresenta o FlowErs, um framework multimodal de sensoriamento remoto que separa o alinhamento de características cruzadas de modalidades da classificação semântica por meio de uma estratégia de aprendizado em duas etapas. Em vez de fundir diretamente características específicas de modalidades heterogêneas, o framework proposto alinha primeiramente as representações de características usando correspondência condicional de fluxo, antes da fusão multimodal e da classificação. Esse design aborda o desafio de longa data das distribuições heterogêneas de características entre HSI e LiDAR, em que as diferenças nos mecanismos de sensoriamento frequentemente limitam a eficácia de estratégias convencionais de fusão baseadas em concatenação ou atenção23,26,35,36,37,38,39. Ao formular o alinhamento multimodal como um transporte contínuo de características, o FlowErs estende os avanços recentes na correspondência de fluxo, aplicando-os do modelamento generativo ao aprendizado de representações multimodais em sensoriamento remoto15,16,17,18,19,20,21. Nas condições de avaliação dos benchmarks, o framework proposto alcançou desempenho competitivo de classificação agregada nos conjuntos de dados Houston2013, Augsburg e MUUFL, enquanto o estudo de ablação complementar reforçou a contribuição do módulo de alinhamento de fluxo bidirecional para o desempenho obtido com divisão fixa.
Os resultados relatados sugerem que o alinhamento explícito de características antes da fusão multimodal pode melhorar a compatibilidade das representações heterogêneas de características extraídas a partir de diferentes modalidades sensoriais. Métodos anteriores de sensoriamento remoto multimodal basearam-se principalmente em redes convolucionais, arquiteturas baseadas em Transformador, mecanismos de atenção, aprendizado contrastivo ou fusão guiada por prompts para fortalecer a interação entre características23,26,35,36,37,38,39. Embora essas abordagens tenham demonstrado bom desempenho na classificação, a maioria assume que incorporações específicas de modalidade podem ser diretamente fundidas após a extração de características. Em contraste, o FlowErs introduz uma etapa intermediária de alinhamento geométrico que transporta continuamente características específicas de modalidade para um espaço latente compartilhado antes da classificação. A avaliação por classe demonstra que os ganhos agregados de desempenho não foram uniformemente distribuídos entre todas as categorias de cobertura do solo. Por exemplo, várias classes minoritárias e categorias urbanas espectralmente semelhantes continuaram relativamente difíceis de classificar, e a diferença observada entre OA e AA, particularmente para o conjunto de dados de Augsburg, reflete a influência do desequilíbrio entre classes juntamente com o desempenho variável em nível de classe. Assim, as métricas agregadas relatadas devem ser interpretadas em conjunto com os resultados por classe, e não como evidência de melhorias uniformes em todas as categorias.
Os experimentos de ablação reforçam ainda mais o design proposto. A remoção do módulo de correspondência multimodal de fluxo reduziu o desempenho agregado de classificação em todos os três conjuntos de dados de referência, enquanto a variante de fluxo unidirecional apresentou desempenho consistentemente entre o modelo completo e o modelo sem alinhamento de fluxo. Essas observações são compatíveis com a hipótese de trabalho de que o transporte bidirecional de características pode melhorar a correspondência entre modalidades antes da fusão de características sob as condições de avaliação estabelecidas. Da mesma forma, a análise de integração do fluxo demonstrou que a discretização intermediária da trajetória de transporte aprendida produziu o desempenho agregado mais alto, com seis etapas de integração representando o ponto de operação nominal na implementação atual. Os ganhos de desempenho tornaram-se marginais ou ligeiramente reduzidos com etapas adicionais de integração, sugerindo que discretizações cada vez mais finas podem apresentar retornos decrescentes sob as condições experimentais avaliadas. Se esse ponto de operação se generaliza para outros conjuntos de dados, modalidades sensoriais ou arquiteturas de rede permanece a ser investigado.
Várias limitações devem ser consideradas ao interpretar os resultados apresentes. Primeiro, a avaliação foi limitada a três conjuntos de dados de referência de acesso público, utilizando partições fixas de treinamento/teste e uma única semente aleatória. Consequentemente, a incerteza de execuções repetidas, intervalos de confiança, testes de significância estatística e variabilidade entre execuções não foram avaliados. Segundo, os métodos de comparação foram obtidos de suas respectivas publicações, em vez de serem reimplementados dentro de um quadro experimental comum; portanto, as comparações relatadas devem ser interpretadas de forma descritiva, e não como reproduções controladas diretas. Terceiro, a robustez a modalidades ausentes, observações ruidosas, má registrabilidade espacial e generalização entre regiões não foi investigada. Além disso, embora o casamento de fluxo forneça uma base teórica para transporte contínuo e potencialmente invertível de características15,16,17, a invertibilidade exata, preservação da topologia e interpretabilidade física das transformações aprendidas não foram verificadas empiricamente no presente estudo. As características computacionais, incluindo tempo de inferência, consumo de memória e complexidade de operações de ponto flutuante, também não foram analisadas separadamente.
Abordagens alternativas para estudar o alinhamento multimodal continuam a evoluir. Estudos recentes exploraram o aprendizado contrastivo, a fusão baseada em grafos, o aprendizado de representações de posto baixo, o aprendizado multimodal guiado por prompts, o aprendizado federado e arquiteturas híbridas convolucionais–Transformer para melhorar a integração de características multimodais23,26,27,28,35,36,37,38,39. Essas estratégias permanecem complementares em vez de mutuamente exclusivas, e trabalhos futuros podem investigar combinações de transporte explícito de características baseado em fluxo com esses paradigmas de alinhamento existentes. Além da classificação de cobertura do solo, o alinhamento contínuo de características também pode ser aplicável a tarefas relacionadas de sensoriamento remoto multimodal, incluindo segmentação semântica, detecção de mudanças, reconhecimento de objetos, monitoramento ambiental, avaliação de desastres, agricultura de precisão e mapeamento urbano, onde modalidades complementares de sensoriamento estão cada vez mais disponíveis2,3,4,5,6,7,8,9,23.
Investigações futuras devem avaliar o framework proposto sob condições experimentais mais diversas, incorporando análises estatísticas de execuções repetidas, perfil computacional, robustez a modalidades ausentes ou ruidosas, sensibilidade a erros de registro espacial e avaliação de transferência entre regiões. Estudos adicionais que examinem parametrizações alternativas de fluxo, arquiteturas diferentes de codificadores e conjuntos de dados de referência multimodais maiores esclareceriam ainda mais a generalização e a aplicabilidade prática da metodologia proposta. Em conjunto, os resultados atuais indicam que o alinhamento explícito de características por meio de correspondência condicional de fluxo representa uma estratégia complementar promissora para classificação multimodal em sensoriamento remoto, destacando ao mesmo tempo diversas oportunidades para desenvolvimento metodológico adicional e avaliação abrangente.
Divulgações
Conflito de Interesse:
Os autores declaram que não possuem conflitos de interesse.
Agradecimentos
This work was financially supported by the Scientific Research Fund Project of Shaanxi A&F University (Grant No. ZK25-38) and the Education Department of Shaanxi Province (Grant No. 24JK0734).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| otimizador AdamW | Fundação PyTorch | Incluído no PyTorch | Utilizado para a otimização do modelo. Foi utilizado o PyTorch 2.5.0. |
| Conjunto de dados de referência Augsburg | Hu J et al. (Earth System Science Data, 2022); Tecnologia de Sensoriamento Remoto, LMU Munich | https://doi.org/10.5281/zenodo.7185498 | Conjunto de dados público de referência multimodal de sensoriamento remoto utilizado para avaliação de modelos. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | Utilizado para treinamento e inferência de modelos acelerados por GPU. |
| Unidade de processamento gráfico (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | Utilizado para o treinamento e avaliação do modelo. |
| conjunto de dados de referência Houston2013 | Concurso de Fusão de Dados da Sociedade IEEE de Geociências e Sensoriamento Remoto | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | Conjunto de dados público de imagens hiperspectrais e LiDAR utilizado para avaliação de modelos. |
| conjunto de dados de referência MUUFL Gulfport | Universidade da Flórida (Gader P et al., Relatório Técnico REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | Conjunto de dados de referência público de imagens hiperspectrais e LiDAR utilizado para avaliação de modelos. |
| Sistema operacional | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | Ambiente computacional utilizado para o desenvolvimento, treinamento e avaliação do modelo. |
| PyTorch | PyTorch Foundation | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | Estrutura de aprendizado profundo utilizada para implementar, treinar e avaliar o modelo FlowErs. |
| Python | Fundação Python de Software | Python 3.11; https://www.python.org/downloads/release/python-3110/ | Linguagem de programação utilizada para implementar e executar o fluxo de trabalho computacional. |
Referências
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.