Este protocolo descreve uma metodologia estruturada de design de serviços para diagnosticar problemas complexos em processos de aplicação e consulta de serviços públicos de baixo risco. A abordagem integra mapeamento de partes interessadas, mapeamento de jornadas, co-design e prototipagem de baixa fidelidade, juntamente com avaliação simulada baseada em tarefas do comportamento do usuário, tomada de decisões e usabilidade de materiais de serviço antes da implementação.
Artigo de método
Um Protocolo de Visualização de Design de Serviço Sistêmico para Problemas Complexos em Processos de Consulta e Aplicação de Serviços Públicos de Baixo Risco
21 visualizações
⸱
11 de setembro de 2026
Neste artigo
Resumo
Resumo
Problemas complexos de serviços públicos com características semelhantes aos problemas intrincados, incluindo múltiplos atores, informações fragmentadas, fronteiras de responsabilidade pouco claras e ausência de uma única solução incontestável, são difíceis de estruturar em ambientes administrativos rotineiros. Este artigo apresenta um protocolo sistemático de visualização de design de serviços para aplicações e processos de consulta de baixo risco em serviços públicos, definidos como serviços administrativos que não determinam tratamento médico, status legal, elegibilidade financeira, proteção à criança, resultados disciplinares ou outras decisões de alto risco que afetem direitos. O protocolo integra o mapeamento de partes interessadas, o mapeamento da jornada do serviço público, o co-design Double Diamond e testes com protótipos de baixa fidelidade para transformar desafios administrativos fragmentados em conceitos de serviço acionáveis e co-projetados, avaliando-os por meio de tarefas simuladas. Em uma via representativa de aplicação administrativa de baixo risco, testes com tarefas simuladas realizados com 28 participantes (112 registros de tarefas iniciais e 112 registros pós-protótipo) mostraram tempos mais curtos de conclusão das tarefas (178,4 ± 49,6 s–121,7 ± 38,2 s), menos erros (1,86 ± 0,91–0,79 ± 0,63 erros por tarefa) e maior sucesso nas tarefas (62,5%–82,1%) após a exposição aos materiais gerados pelo protocolo. Esses resultados representam evidências de usabilidade baseadas em tarefas, pois a sequência fixa pré-/pós-teste pode incluir efeitos de aprendizado. Este protocolo reprodutível oferece uma abordagem estruturada e orientada visualmente para diagnosticar problemas complexos de serviços públicos e prototipar soluções em ambientes de serviços públicos de baixo risco.
Introdução
Organizações de serviço público enfrentam cada vez mais desafios complexos que resistem a ajustes administrativos simples. Esses problemas são caracterizados pela participação de múltiplos atores, responsabilidades fragmentadas, acesso desigual à informação e tensões entre procedimentos administrativos padronizados e necessidades diversas dos usuários. Em vez de afirmar que tais problemas possam ser resolvidos por meio de uma fórmula totalmente reprodutível, este protocolo os trata como problemas de serviço limitados e de baixo risco, com características semelhantes aos problemas complexos ("wicked problems"), que podem ser estruturados, visualizados e explorados por etapas reprodutíveis de facilitação1,2. Na prestação rotineira de serviços públicos, esses problemas se manifestam como falhas operacionais: cidadãos têm dificuldade em identificar os materiais necessários, funcionários de primeira linha enfrentam consultas repetitivas e administradores aplicam regras que não são facilmente visíveis para os usuários finais.
Para enfrentar essas complexidades, a inovação em serviços públicos deslocou-se de reformas internas de eficiência para abordagens participativas centradas no usuário. Pesquisas atuais indicam que a cocriação e a coprodução permitem que cidadãos, profissionais e organizações contribuam colaborativamente para a inovação em serviços3,4,5. No entanto, essa mudança participativa introduz um desafio metodológico. Embora diversas partes interessadas possam concordar que um serviço é ineficiente, raramente alcançam consenso sobre onde ocorre a falha estrutural, quem é mais afetado ou quais intervenções específicas são necessárias.
Este protocolo destina-se a pesquisadores de design de serviços, pesquisadores de administração pública, equipes de melhoria de serviços municipais ou universitários e facilitadores treinados que necessitam de uma abordagem repetível para traduzir reclamações de múltiplos atores em materiais diagnósticos visuais antes da implementação. É mais adequado para aplicações de baixo risco, como serviços de consulta, registro, verificação de status e acompanhamento, nos quais os usuários devem interpretar requisitos, preparar materiais, avançar por múltiplas etapas do serviço e coordenar-se com diversos atores. Não deve ser utilizado como método principal para tomada de decisões emergenciais, transações altamente padronizadas com procedimentos estabelecidos de uma única etapa, julgamentos legais, tratamentos médicos, proteção à criança, decisões sobre status migratório, determinações de auxílio financeiro, processos disciplinares ou qualquer contexto que exija acesso a arquivos de casos identificáveis.
Em comparação com análises isoladas de partes interessadas, mapeamento de jornadas ou oficinas participativas, o fluxo de trabalho proposto integra o mapeamento de atores, a análise específica por etapas dos serviços, a formulação conjunta de desafios e a testagem simulada de protótipos dentro de uma única sequência auditável. Essa integração ajuda a impedir que equipes passem diretamente da insatisfação geral para ideias de solução sem antes identificar quem é afetado, onde ocorre a falha e quais materiais podem ser testados com segurança. Revisões recentes sobre cocriação no setor público e em saúde pública também enfatizam a necessidade de processos transparentes, facilitação explícita e avaliação cuidadosa da participação e das dinâmicas de poder4,6,7,8,9.
O design de serviços oferece um framework prático para enfrentar esse desafio por meio de métodos visuais, participativos e orientados a protótipos6,8,10. Em vez de tratar falhas de serviço como déficits políticos abstratos, o design de serviços examina as interações entre usuários, funcionários, pontos de contato e processos operacionais. Consequentemente, o co-design é cada vez mais proposto na administração pública como um meio de envolver cidadãos na definição de problemas complexos4,7,11. No entanto, iniciativas de co-design frequentemente ficam aquém quando carecem de um mecanismo estruturado para traduzir experiências subjetivas das partes interessadas em materiais de serviços públicos testáveis ou quando falham em gerenciar explicitamente as diferenças de poder entre os participantes.
Uma transição metodológica rigorosa exige a integração sequencial de ferramentas analíticas específicas. O mapeamento de partes interessadas atua como a linha de base diagnóstica ao esclarecer o envolvimento dos atores, sua influência, dependências e assimetrias de informação12. Em seguida, o mapeamento da jornada é utilizado para identificar pontos críticos específicos e ambiguidades na responsabilidade ao longo das etapas sequenciais do serviço13. Posteriormente, o framework Double Diamond oferece um caminho estruturado para transformar essas falhas mapeadas em desafios de design acionáveis, separando a exploração divergente do problema do desenvolvimento convergente de soluções7,8,14. Por fim, a avaliação de protótipos de baixa fidelidade permite que conceitos co-projetados sejam testados com segurança antes da implementação — uma etapa essencial em serviços públicos, onde mudanças prematuras podem interromper o acesso dos cidadãos ou aumentar a carga administrativa15,16.
Apesar da crescente orientação metodológica sobre essas ferramentas, a reprodutibilidade continua sendo uma limitação crítica na literatura sobre cocriação de serviços públicos6,7,8,17. Muitos estudos descrevem oficinas de design em termos genéricos, ocultando os passos analíticos precisos necessários para replicação independente. Um método rigoroso deve estabelecer etapas fixas, alocações definidas de tempo, regras padronizadas de pontuação, saídas visuais consistentes e critérios de decisão transparentes. Além disso, deve distinguir claramente a avaliação da usabilidade em estágios iniciais, baseada em tarefas, de afirmações mais amplas sobre o desempenho real da agência no mundo prático.
Este artigo apresenta um protocolo sistemático de visualização de design de serviços desenvolvido para estruturar problemas complexos com múltiplos atores na inovação de serviços públicos de baixo risco4,6,16,17. Projetado especificamente para aplicações e processos de consultoria em serviços públicos, o protocolo integra sequencialmente o mapeamento de partes interessadas, o mapeamento de jornadas, um workshop de Double Diamond e a testagem de protótipos. O objetivo geral é fornecer aos pesquisadores e profissionais uma abordagem altamente reprodutível, passo a passo, para avançar de reclamações fragmentadas sobre serviços até o diagnóstico visual, a definição objetiva do problema e a testagem empírica de conceitos de serviços co-projetados.
Protocolo
A aplicação representativa relatada neste artigo foi aprovada pelo Comitê de Ética em Pesquisa com Seres Humanos, Universidade Municipal de Macau, Macau, China (Número de Aprovação: 2600AL2401; válido de 10 de janeiro de 2026 a 10 de janeiro de 2028). O consentimento informado escrito ou eletrônico foi obtido de todos os participantes antes de sua participação. O protocolo não envolveu intervenções médicas, populações vulneráveis, dissimulação, amostras biológicas, dados financeiros privados, avaliação de desempenho individual ou acesso a registros administrativos oficiais. As ferramentas de pesquisa utilizadas no protocolo estão listadas na Tabela de Materiais.
1. Recrutamento de participantes e definição do contexto
- Selecione uma aplicação de serviço público de baixo risco e seu processo de consulta para avaliação, como um caminho administrativo municipal, universitário ou comunitário que exija busca de informações, esclarecimento de elegibilidade, preparação de documentos, submissão do pedido, processamento, notificação e apoio pós-submissão.
- Exclua contextos que envolvam tratamento médico, tramitação de processos jurídicos, status migratório, proteção à criança, determinação de auxílio financeiro, procedimentos disciplinares, decisões emergenciais ou registros administrativos oficiais.
- Considere um problema de serviço público adequado para este protocolo quando apresentar pelo menos três características complexas ou semelhantes a problemas "wicked" (intratáveis): envolvimento de múltiplos grupos de partes interessadas, fronteiras de responsabilidade pouco claras, falhas recorrentes na coordenação entre atores, informações de serviço incompletas ou inconsistentes e ausência de uma solução única e consensual.
NOTA: Não apresente o protocolo como uma solução para um problema totalmente "wicked". Apresente-o como uma estruturação de um problema de serviço público limitado e de baixo risco, voltado para diagnóstico, cocriação e testes simulados. - Recrute 80 – 120 participantes para a fase do questionário, com base em seu conhecimento sobre o uso, prestação, coordenação ou gestão de serviços públicos.
- Utilize este tamanho amostral como uma meta prática de planejamento para permitir perfis estáveis de partes interessadas em diversos grupos de papéis, mantendo-se viável para um estudo de design de serviços não intervencionista.
- Selecione participantes que representem todas as funções principais de partes interessadas envolvidas no processo de serviço público.
- Monte um subgrupo de 20–30 participantes para participar das fases do workshop de cocriação e testes de protótipo.
- Forme 4–6 grupos com composição mista de funções, mantendo cada grupo pequeno o suficiente para permitir participação ativa.
- Garanta que cada grupo misto inclua pelo menos três categorias de partes interessadas, como cidadãos, funcionários de atendimento direto, trabalhadores comunitários ou administradores.
- Se forem esperadas desigualdades de poder, separe cidadãos e prestadores de serviços durante as discussões iniciais de mapeamento de partes interessadas.
- Realize a síntese em grupos mistos após as discussões iniciais. Durante a síntese mista, utilize rodízio estruturado de falas, escrita silenciosa de ideias, submissão anônima de cartões e votação anônima com pontos para evitar que administradores ou funcionários especializados dominem as contribuições dos cidadãos.
- Preste atenção cuidadosa ao recrutamento de participantes, preparação de papéis e condições que permitam aos usuários contribuir com ideias, em vez de meramente responderem a problemas definidos por especialistas7,9,18.
- Instrua todos os participantes a não divulgar nomes identificáveis, números de identidade, endereços residenciais, números de telefone, IDs de casos, prontuários médicos, registros jurídicos, comprovantes de renda ou arquivos de desempenho institucional.
- Atribua códigos de participantes não identificáveis (por exemplo, P001 e P002).
- Treine todos os facilitadores antes da coleta de dados utilizando o mesmo roteiro de facilitação, cartões de exemplo de pontos problemáticos, matriz de desafios de design e exemplos de pontuação de protótipos.
- ETAPA CRÍTICA: Calibre os facilitadores solicitando que classifiquem independentemente pelo menos cinco exemplos de pontos problemáticos e cinco versões preliminares de afirmações "Como poderíamos".
NOTA: Os facilitadores devem alcançar pelo menos 80% de concordância nas decisões de inclusão, agrupamento e revisão antes de prosseguir. - Discuta as discrepâncias até que os facilitadores alcancem pelo menos 80% de concordância nas decisões de inclusão, agrupamento e revisão.
- Utilize pelo menos dois facilitadores sempre que possível: um facilitador principal para conduzir a discussão e um observador para registrar cronometragem, equilíbrio de participação e desvios do protocolo.
- Se múltiplos facilitadores conduzirem grupos paralelos, realize uma reunião de avaliação de 15–20 minutos após cada etapa principal e documente quaisquer diferenças nos estímulos ou regras de interpretação na ficha de auditoria.
ATENÇÃO: Após a conclusão do recrutamento dos participantes, obtenção do consentimento, treinamento dos facilitadores e preparação dos materiais, os pesquisadores podem fazer uma pausa antes de iniciar a Etapa 1. Retome apenas após confirmar que todos os participantes receberam códigos e que todas as planilhas não contêm informações identificáveis.
2. Preparação dos materiais do protocolo
- Prepare os materiais do protocolo antes da implementação.
- Prepare a ficha informativa para o participante, o questionário anônimo baseado em papéis, a planilha de mapeamento de partes interessadas, a folha de classificação de partes interessadas em escala de cinco pontos, o modelo de mapeamento da jornada do serviço público, os cartões de pontos críticos, o modelo de desafio de design, os cartões de soluções, a folha de seleção de protótipos, a rubrica de calibração do facilitador, as fichas de tarefas simuladas, a lista de verificação de equivalência de conjuntos de tarefas, a rubrica de pontuação de protótipos, a ficha de codificação, as anotações de sintaxe ou fluxo de trabalho para análise e a lista de verificação de desidentificação.
- Atribua a cada material específico do estudo um identificador interno estável e um número de versão.
- Organize o modelo de mapeamento da jornada em sete etapas padrão: busca de informações, esclarecimento de elegibilidade ou requisitos, preparação de documentos, envio da solicitação, processamento interdepartamental, notificação do resultado e apoio pós-atendimento.
- Adapte os nomes das etapas somente após documentar como o serviço selecionado difere do caminho administrativo padrão de baixo risco.
- Mantenha a mesma sequência de pontos de contato, atores responsáveis, insumos de informação, produtos, pontos críticos e consequências posteriores.
- Elabore cenários simulados de serviços públicos para as fichas de tarefas de protótipo sem incluir dados reais de pessoas, administrativos ou institucionais.
- Consulte a Tabela 1 para obter as etapas, alocações de tempo, materiais e produtos pré-definidos necessários para o protocolo.
- Consulte a Tabela 2 para obter os itens de coleta de dados, regras de pontuação, limiares de validade e controles de proteção de dados.
- Utilize métodos de design de serviços para tornar visíveis, discutíveis e testáveis os problemas complexos de serviços públicos19.
Tabela 1: Estágios do protocolo, cronograma, materiais necessários e resultados pré-definidos. O fluxo de trabalho do protocolo inclui as atividades principais, os participantes, o tempo estimado para cada etapa, os materiais necessários e os resultados esperados em cada fase.Clique aqui para baixar esta tabela.
Tabela 2: Métricas de coleta de dados, métodos, critérios de exclusão e controles de proteção de dados. As métricas coletadas em cada estágio do protocolo, os métodos correspondentes de coleta de dados, os critérios de exclusão pré-definidos e as medidas implementadas para proteger a confidencialidade dos participantes e a integridade dos dados.Clique aqui para baixar esta Tabela.
3. Etapa 1: Mapeamento de partes interessadas
- Instrua os participantes a usar a planilha de mapeamento de partes interessadas para listar individualmente de cinco a oito atores envolvidos no processo de serviço público selecionado.
- Reserve de 25 a 35 minutos para a etapa de mapeamento de partes interessadas.
- Consulte Figura 1 para visualizar o fluxo geral do protocolo de visualização.
- Oriente os participantes a classificar cada ator listado em quatro dimensões, utilizando uma escala ancorada de cinco pontos (1 = muito baixo; 5 = muito alto): influência no resultado do serviço, dependência de outros atores, acesso às informações do serviço e pressão de coordenação.
- Forneça exemplos escritos antes de os participantes realizarem as classificações.
- Defina alta influência como um ator cuja decisão, atraso ou interpretação afeta substancialmente o resultado do serviço.
- Defina alta dependência como um ator que não consegue concluir o processo do serviço sem informações, confirmação ou ação de outros atores.
- Calcule a pontuação média de cada grupo de partes interessadas em cada dimensão.
- Destaque uma discrepância de dois pontos ou mais entre grupos de partes interessadas na mesma dimensão como uma lacuna de percepção, pois representa uma variação de pelo menos 40% na escala de cinco pontos e é suficientemente grande para fundamentar discussões no workshop, em vez de ruídos menores nas classificações.
- Leve cada lacuna de percepção identificada para a discussão no workshop.
- Utilize os resultados do mapeamento de partes interessadas para tornar visíveis os papéis dos atores, dependências, influências e assimetrias de informação antes do início do trabalho de reestruturação20.
- Elabore um perfil de relacionamento entre atores contendo categorias de partes interessadas, pontuações médias nas dimensões e lacunas de percepção destacadas.
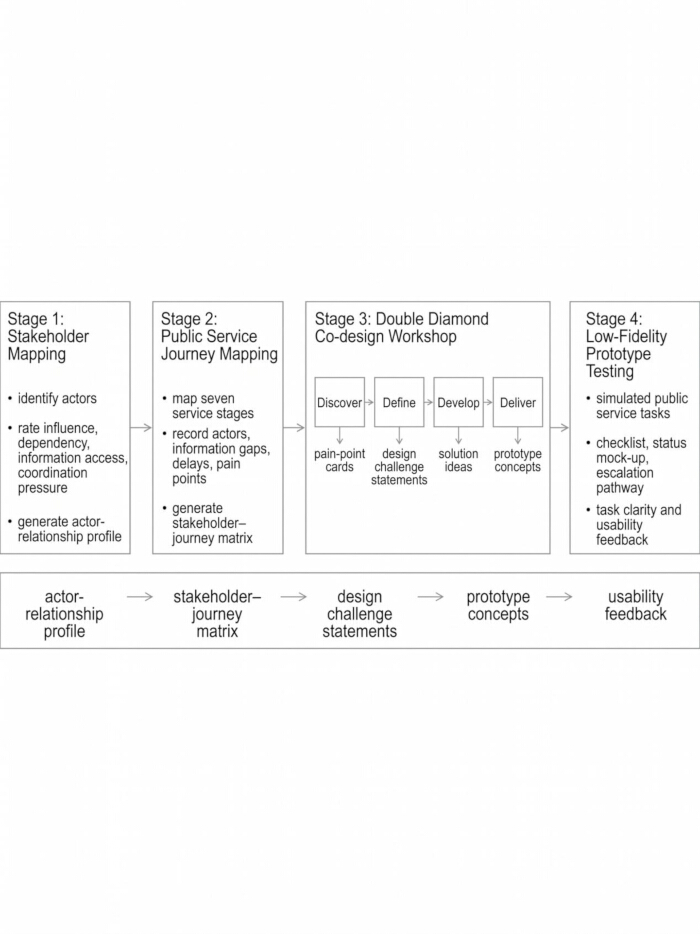
Figura 1: Fluxo geral do protocolo de visualização do design de serviços públicos. O fluxo de trabalho é composto por quatro etapas interligadas: mapeamento de partes interessadas, mapeamento da jornada do serviço público, co-projeto Double Diamond e testes de protótipo. Os resultados incluem perfis de atores e relações, matrizes de partes interessadas-jornada, declarações de desafios de design, conceitos de protótipos e feedback inicial sobre usabilidade. As fases Descobrir, Definir, Desenvolver e Entregar do modelo Double Diamond são destacadas para ilustrar a transição da exploração divergente para o desenvolvimento convergente de soluções. Clique aqui para visualizar uma versão maior desta figura.
4. Etapa 2: Mapeamento da jornada de serviços públicos
- Oriente o subgrupo do workshop a mapear o processo de serviço em sete etapas.
- Destine 45–60 min para esta etapa.
- Instrua os participantes a registrar o ator principal, as informações de entrada, as informações de saída, o canal de comunicação, o atraso típico, o ponto crítico, a gravidade e a consequência subsequente para cada etapa.
- Solicite aos participantes que avaliem a gravidade de cada ponto crítico em uma escala de cinco pontos (1 = inconveniente menor; 5 = falha grave, capaz de afetar o acesso ao serviço, provocar reclamação formal ou causar uma grande escalada).
- ETAPA CRÍTICA: Combine pontos críticos somente quando se referirem à mesma etapa do percurso, envolvam o mesmo tipo de lacuna de informação ou ambiguidade de responsabilidade e produzam uma consequência subsequente semelhante.
- Mantenha os pontos críticos relatados por apenas um participante no arquivo bruto de codificação. Não priorize esses pontos críticos, a menos que recebam uma pontuação de gravidade 4 ou 5.
- Elabore uma matriz integrada de trajetória das partes interessadas (Figura 2) para visualizar a presença de pontos críticos (P), lacunas de informação (I), ambiguidade de responsabilidade (R) e oportunidades de reestruturação (O) nas células da matriz.
- Utilize o mapeamento de jornada para identificar falhas no serviço ao longo dos pontos de contato sequenciais, em vez de tratar a insatisfação ou o atraso como um resultado único e agregado21.
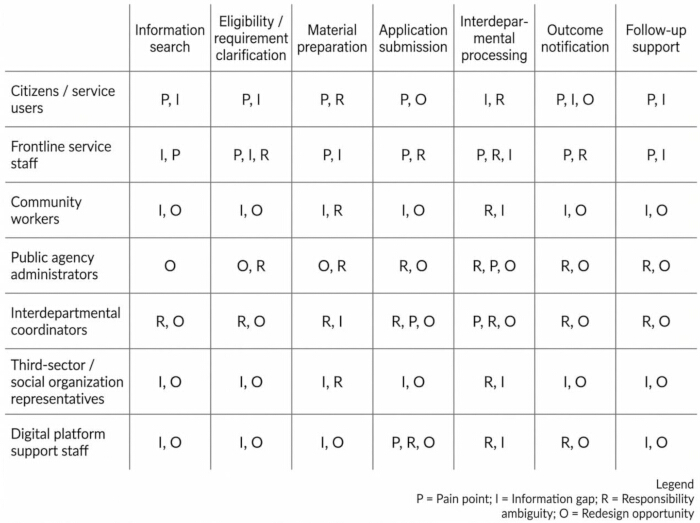
Figura 2: Matriz integrada de jornada das partes interessadas para visualização de problemas em serviços públicos. A matriz organiza sete etapas de serviços públicos no eixo horizontal e os principais grupos de partes interessadas no eixo vertical. Cada célula indica a presença de problemas específicos de serviço, denotados pelas seguintes abreviações: P = ponto de dor; I = lacuna de informação; R = ambiguidade de responsabilidade; O = oportunidade de reestruturação. A matriz atua como uma ponte visual entre o mapeamento das partes interessadas e o co-design, vinculando os papéis das partes interessadas e os problemas específicos de cada etapa do serviço. Clique aqui para visualizar uma versão maior desta figura.
5. Etapa 3: Workshop de cocriação Double Diamond
- Realize o workshop de cocriação Double Diamond em uma sessão de 2,5 a 3 horas.
- Adote o framework Double Diamond para separar a exploração divergente da tomada de decisões convergente7,8,14.
- Garanta que cidadãos, profissionais da linha de frente, administradores e organizações parceiras participem da cocriação ou codesign, em vez de depender exclusivamente de reformas internas lideradas por especialistas4,22.
- Execute a fase de Descoberta (30–40 min).
- Instrua os participantes a revisar a matriz de jornada das partes interessadas e adicionar cartões de pontos problemáticos ausentes.
- Certifique-se de que cada cartão de ponto de dor válido registre a etapa da jornada, o ator afetado, a falha no serviço, a lacuna de informação ou ambiguidade de responsabilidade e a consequência subsequente.
- Execute a fase Definir (40–50 min).
- Peça a cada participante que selecione silenciosamente as três cartas de pontos problemáticos que melhor representem falhas de serviço de alta gravidade e comuns a diversos atores.
- Utilize votação anônima por pontos ou classificação escrita antes da discussão aberta para reduzir efeitos de status e desigualdades de poder.
- Agrupe os cartões selecionados de acordo com a fase da jornada, o ator afetado, a lacuna de informação ou ambiguidade de responsabilidade e a consequência subsequente.
- Peça ao facilitador que leia cada agrupamento em voz alta e confirme se os participantes concordam que os cartões descrevem a mesma falha no serviço.
- Converter cada agrupamento em uma única declaração de desafio de design do tipo "Como poderíamos".
- Certifique-se de que cada enunciado do desafio de design especifique o ator afetado, a etapa problemática da jornada, a falha no serviço e a direção desejada de melhoria.
- Avalie cada desafio de design utilizando uma rubrica de quatro itens que avalie especificidade, clareza dos atores, vinculação com as evidências mapeadas e viabilidade para testes com protótipos de baixa fidelidade.
- Revise qualquer afirmação que omita um agente, combine várias falhas não relacionadas, proponha uma solução prematuramente ou não possa ser testada utilizando materiais simulados de serviço.
- Registre o rascunho original, o motivo da revisão e a declaração final validada na planilha de auditoria.
ATENÇÃO: Os pesquisadores podem fazer uma pausa após aprovar as declarações finais do desafio de design e retomar quando os cartões de solução e as folhas de seleção de protótipos tiverem sido preparados. - Execute a fase de Desenvolvimento (50–60 min).
- Instrua os participantes a gerar ideias de melhoria de serviços para cada desafio de design e registre-as em cartões de solução.
- Exclua ideias que exijam dados de casos reais, registros individuais de elegibilidade, mudanças legais ou políticas significativas ou arquivos administrativos identificáveis.
- Execute a fase de Entrega (30–40 min).
- Peça aos participantes que avaliem cada ideia de solução em uma escala de cinco pontos com base no impacto esperado no serviço, viabilidade de implementação, concordância das partes interessadas e adequação para testes de tarefas simuladas.
OBSERVAÇÃO: Selecione conceitos de protótipo com pontuação média de pelo menos 4,0 tanto para viabilidade quanto para testabilidade. Esse limite é necessário para garantir que os protótipos sejam viáveis para testes em tarefas simuladas, sem gargalos de implementação.
6. Etapa 4: Teste de protótipo de baixa fidelidade
- Desenvolva protótipos de baixa fidelidade para os conceitos priorizados.
- Prepare três formatos de protótipo: uma lista de verificação de requisitos do serviço em uma página, uma simulação de rastreamento do status do serviço e um fluxo de acompanhamento ou escalonamento.
- ETAPA CRÍTICA: Crie dois conjuntos de tarefas equivalentes antes dos testes. Certifique-se de que os conjuntos de tarefas sejam equilibrados em relação ao número de etapas de decisão, extensão da leitura, campos obrigatórios, complexidade do cenário e tempo esperado de conclusão.
- Equilibre os conjuntos de tarefas quanto ao número de etapas de decisão, extensão da leitura, campos obrigatórios, complexidade do cenário e tempo esperado de conclusão.
- Realize um teste piloto com os conjuntos de tarefas equivalentes utilizando três a cinco usuários não participantes do estudo.
- Revise os conjuntos de tarefas se a diferença média no tempo de conclusão for superior a 10%.
- Aplicar tarefas simuladas de serviços públicos para avaliar os protótipos.
- Sempre que viável, utilize um delineamento contrabalançado ou com grupo controle para distinguir familiaridade com a tarefa da exposição ao protótipo.
- Se todos os participantes completarem as tarefas iniciais antes das tarefas pós-protótipo, registre isso como um risco potencial de efeito de aprendizado nas seções Protocolo, Resultados e Discussão.
- Forneça a cada participante quatro cenários de tarefas iniciais antes da exposição ao protótipo.
- Após a exposição ao protótipo, forneça quatro cenários de tarefas comparáveis, mas não idênticos.
- Estabeleça um tempo máximo de 5 min para cada tarefa.
- Leia instruções idênticas para cada participante.
- Não forneça dicas durante a realização da tarefa. Limite esclarecimentos apenas a perguntas procedimentais.
- Meça o tempo de conclusão da tarefa em segundos, desde a apresentação até a resposta final.
- Registre a tarefa como incompleta, atribua um tempo de conclusão de 300 s e classifique o sucesso da tarefa como 0 se o participante não concluir a tarefa em 5 min.
- Classifique uma tarefa como bem-sucedida apenas quando o participante selecionar a resposta correta ou completar todas as etapas de decisão obrigatórias dentro do limite de tempo.
- Calcule a contagem de erros somando as etapas de decisão perdidas, incorretas ou desnecessárias.
- Meça a clareza percebida pelo participante imediatamente após cada tarefa, utilizando uma escala de cinco pontos (1 = muito confuso; 5 = muito claro).
- Após a conclusão de todas as tarefas, solicite aos participantes que avaliem a usabilidade do protótipo e a intenção de adoção.
NOTA: O teste de protótipo avalia a clareza e usabilidade baseadas em tarefas dos materiais gerados pelo protocolo, e não melhora o desempenho em serviços públicos23.
7. Análise de dados e controle de qualidade
- Exclua respostas do questionário concluídas em menos de 3 min, respostas com mais de 20% de valores ausentes, respostas idênticas em todos os itens da escala Likert ou respostas contendo informações inconsistentes sobre o papel desempenhado.
- Resuma os dados do questionário utilizando médias e desvios-padrão para variáveis contínuas, e frequências e porcentagens para variáveis categóricas.
- Codifique os dados de mapeamento de partes interessadas e de jornada utilizando a planilha de codificação estruturada. Dois pesquisadores devem codificar independentemente pelo menos 20% do material antes da discussão de consenso, e então informar a porcentagem de concordância e o kappa de Cohen ou uma estatística de confiabilidade equivalente.
- Analise as saídas dos workshops contando cartões válidos de pontos problemáticos, agrupamentos de problemas, declarações de desafios de design, ideias de soluções, classificações de viabilidade e conceitos de protótipos pré-selecionados.
- Calcule a pontuação de usabilidade do protótipo específica ao protocolo a partir de cinco itens de cinco pontos: clareza dos requisitos, visibilidade do status, clareza da próxima etapa, facilidade de conclusão da tarefa e confiança no uso do material. Transforme a pontuação bruta (variando de 5 a 25) em uma escala de 0 a 100 usando a fórmula:
usabilidade score = (raw score - 5) / 20 x 10017 - Analise os dados de testes de protótipos para extrair indicadores de clareza e usabilidade baseados em tarefas. Utilize o IBM SPSS Statistics (Analyze > Compare Means > Paired-Samples T Test; Analyze > Nonparametric Tests > Related Samples; Analyze > Descriptive Statistics > Crosstabs > Statistics > McNemar) ou comandos equivalentes em R (t.test(..., paired = TRUE), wilcox.test(..., paired = TRUE) e mcnemar.test()) para exportar a estatística do teste, valor P exato, intervalo de confiança de 95% quando disponível e tamanho do efeito.
- Interprete os valores P descritivamente com um alfa pré-definido de 0,05 e enfatize a direção, magnitude e consistência do efeito entre os indicadores24.
- Agregue registros repetidos de tarefas ao nível do participante ou utilize um modelo apropriado de medidas repetidas se quatro tarefas por condição forem analisadas simultaneamente.
NOTA: Não trate todos os registros de tarefas como estatisticamente independentes, a menos que essa suposição seja explicitamente justificada. - ETAPA CRÍTICA: Documente todas as decisões relativas à limpeza de dados, codificação, correspondência de conjuntos de tarefas e análise estatística em uma planilha de auditoria para manter a reprodutibilidade. Garanta que todos os dados anonimizados sejam armazenados em arquivos protegidos por senha, acessíveis apenas à equipe de pesquisa.
Resultados
Inclusão dos participantes e viabilidade do protocolo
O protocolo foi implementado com sucesso, obtendo 100 respostas válidas ao questionário (taxa de conclusão de 89,3%) e um subgrupo dedicado de 28 participantes que concluíram as etapas da oficina e dos testes de protótipo. Os participantes incluídos representaram sete categorias de partes interessadas envolvidas no processo de serviço público: cidadãos ou usuários do serviço (n = 32), funcionários de atendimento direto (n = 18), trabalhadores comunitários (n = 14), administradores de agências públicas (n = 12), coordenadores interdepartamentais (n = 8), representantes do setor terceiro (n = 10) e funcionários de suporte a plataformas digitais (n = 6).
Os 28 participantes do workshop foram divididos em cinco grupos com funções mistas, sendo que cada grupo incluía pelo menos três categorias de partes interessadas. Todos os grupos realizaram mapeamento de partes interessadas, mapeamento de jornada, co-projeto com a metodologia Double Diamond e testes de protótipos, produzindo perfis de relações entre atores, matrizes de jornada das partes interessadas, declarações de desafios de projeto validadas, conceitos de protótipos e registros simulados de testes de tarefas (Tabela 3). As etapas estruturadas de mapeamento exigiram menos intervenções do facilitador do que as fases de definição do problema.
Tabela 3: Inclusão de participantes, composição dos grupos de partes interessadas e estágios da implementação do protocolo. Recrutamento e inclusão de participantes, composição dos grupos de partes interessadas, participação nas oficinas, conclusão do protocolo e os resultados da implementação ao longo dos quatro estágios do protocolo. Clique aqui para baixar esta tabela.
Saídas de visualização: mapeamento de partes interessadas e de jornada
A etapa de mapeamento de partes interessadas identificou nove categorias de atores, sete das quais apareceram consistentemente em todos os grupos e formaram o eixo vertical da matriz de jornada de partes interessadas. Os administradores de agências públicas obtiveram as pontuações médias mais altas de influência, enquanto os cidadãos tiveram as pontuações mais altas de dependência e as mais baixas de acesso à informação. Foram identificadas nove lacunas de percepção, definidas como discrepâncias de avaliação de dois pontos ou mais. A maior lacuna ocorreu no acesso percebido à informação entre cidadãos e administradores.
A etapa de mapeamento da jornada gerou 126 declarações brutas de pontos problemáticos. Após fusão estruturada de acordo com a etapa da jornada e consequência subsequente, foram mantidas 38 falhas de serviço únicas, das quais 12 atenderam aos critérios predefinidos de priorização (frequência ≥10% ou gravidade ≥4,0). A maioria das falhas priorizadas ocorreu durante a preparação de materiais, esclarecimento de elegibilidade e processamento interdepartamental. Esses achados foram sintetizados na matriz integrada de jornada das partes interessadas (Figura 2).
Transformação da cocriação e geração de protótipos
Durante o workshop de cocriação Double Diamond, os participantes geraram 94 cartões válidos de pontos problemáticos, que foram agrupados em 14 áreas de problema. Das 17 declarações iniciais de desafio de design, seis precisaram de revisão porque não apresentavam uma direção clara de melhoria, definiam o ator afetado de forma muito ampla ou propunham uma solução antes de definir claramente o problema. Após revisão baseada em critérios, 11 declarações de desafio de design foram mantidas.
Durante a fase de Desenvolvimento, os participantes geraram 32 ideias de melhoria de serviço. A aplicação dos critérios predefinidos de viabilidade e testabilidade (pontuações ≥4,0) reduziu essas ideias a seis conceitos pré-selecionados. Três conceitos de protótipos de baixa fidelidade foram selecionados para testes baseados em tarefas: uma lista de verificação de requisitos de serviço em uma página, um protótipo de rastreamento do status do serviço e um caminho definido de escalonamento (Figura 3). As saídas numéricas de todas as etapas de visualização e cocriação são resumidas na Tabela 4.
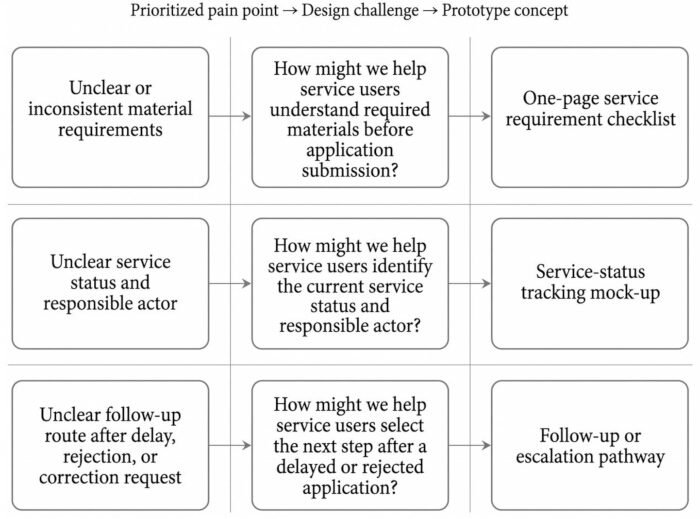
Figura 3: Caminho de transformação de pontos problemáticos em protótipos. A figura ilustra três caminhos de transformação, desde os pontos problemáticos priorizados até as declarações dos desafios de projeto e os conceitos de protótipos de baixa fidelidade. As declarações dos desafios de projeto são apresentadas no formato “Como poderíamos”, uma técnica colaborativa de design usada para enquadrar problemas como oportunidades abertas para a geração de soluções. Os exemplos mostrados incluem: (1) requisitos de material pouco claros ou inconsistentes transformados em uma lista de verificação de requisitos de serviço em uma página; (2) status do serviço e agente responsável pouco claros transformados em um protótipo de rastreamento do status do serviço; e (3) rotas de acompanhamento pouco claras após atrasos, rejeições ou solicitações de correção transformadas em um caminho de acompanhamento ou escalonamento. Clique aqui para visualizar uma versão maior desta figura.
Tabela 4: Resultados gerados pelo protocolo e resultados quantitativos dos testes baseados em tarefas. As saídas geradas em cada etapa do protocolo, juntamente com os resultados quantitativos da avaliação simulada baseada em tarefas do protótipo, incluem indicadores de usabilidade e desempenho. Clique aqui para baixar esta tabela.
Resultados dos testes com protótipo baseado em tarefas
O protocolo gerou 224 registros simulados de tarefas provenientes de 28 participantes, compreendendo 112 registros de linha de base e 112 registros pós-protótipo. Os materiais gerados pelo protocolo estiveram associados a um desempenho melhorado durante as tarefas simuladas. Realizamos uma análise de amostras pareadas ao nível do participante (n = 28) para levar em conta as correlações intra-individuais ao longo das tarefas repetidas. O tempo médio de conclusão da tarefa diminuiu significativamente de 178,4 ± 35,8 s na linha de base para 121,7 ± 28,4 s após o protótipo (diferença média = −56,7 s; IC 95%, −68,3 – −45,1 s; Cohen’s dz = −1,92; teste t pareado, P < 0,001). Da mesma forma, a contagem média de erros por participante reduziu-se de 1,86 ± 0,61 para 0,79 ± 0,44 (diferença média = −1,07 erros; IC 95%, −1,27 – −0,87; Cohen’s dz = −2,05; teste t pareado, P < 0,001). As taxas de sucesso nas tarefas foram analisadas utilizando um teste de postos com sinal de Wilcoxon nas proporções de sucesso ao nível do participante, demonstrando uma melhoria significativa (Z = −4,12, P < 0,001). As classificações médias de clareza também melhoraram significativamente ao nível do participante, aumentando de 3,1 ± 0,5 para 4,2 ± 0,4 (diferença média = 1,10 ponto; IC 95%, 0,94 a 1,26; Cohen’s dz = 2,71; teste t pareado, P < 0,001).
A taxa geral de sucesso da tarefa aumentou de 62,5% (70/112 registros de tarefas) na linha de base para 82,1% (92/112 registros de tarefas) após a exposição ao protótipo, representando um aumento de 19,6 pontos percentuais (IC 95%, 8,2 a 31,1 pontos percentuais; comparação de duas proporções, P = 0,001). Como as contagens agregadas indicam 22 registros de tarefas bem-sucedidas adicionais após a exposição ao protótipo, todas as tabelas de discordância pareadas viáveis produziram um resultado exato de sensibilidade de McNemar abaixo de P < 0,01, sustentando a mesma conclusão direcional, ao mesmo tempo que evita a reconstrução de pares discordantes em nível individual não disponíveis.
Os resultados relatados pelos participantes foram consistentes com essas descobertas operacionais. As médias das avaliações de clareza aumentaram de 3,1 ± 0,7 para 4,2 ± 0,5 na escala de cinco pontos (n = 112 registros de tarefas por condição; diferença média = 1,10 ponto; IC 95%, 0,94 a 1,26; diferença média padronizada em nível resumido = 1,81; P em nível resumido < 0,001). Os materiais finais alcançaram uma pontuação de usabilidade específica do protocolo de 78,4 ± 9,6 e uma avaliação de intenção de adoção de 4,1 ± 0,6 (Figura 4). Essas pontuações de usabilidade foram calculadas a partir dos cinco itens específicos do estudo do protocolo, e não a partir da escala padronizada de usabilidade do sistema (SUS). O feedback aberto apoiou esses achados: 21 dos 28 participantes relataram melhora na clareza visual da matriz de jornada das partes interessadas, 17 dos 28 relataram papéis dos atores mais claros, 19 dos 28 relataram estágios de serviço mais claros e 20 dos 28 confirmaram a usabilidade prática dos materiais do protótipo.
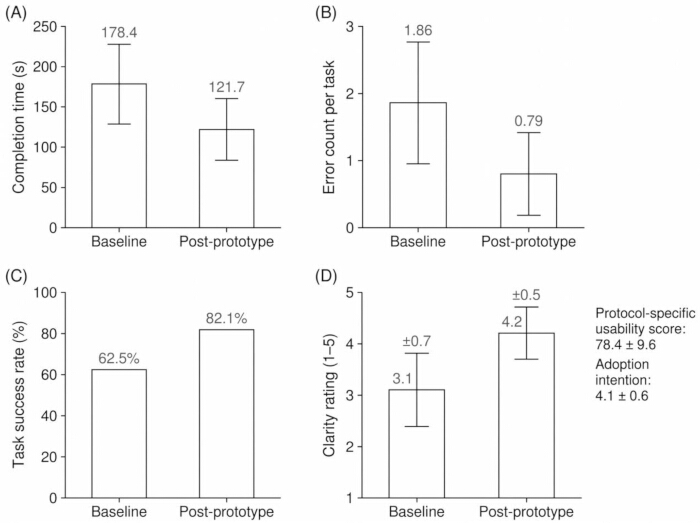
Figura 4: Resultados de clareza e usabilidade baseados em tarefas após a exposição ao protótipo. (A) Tempo médio de conclusão da tarefa (s). (B) Contagem média de erros por tarefa. (C) Taxa de sucesso na tarefa (%). (D) Clareza avaliada pelos participantes (escala de 1 a 5). Métricas adicionais no painel (D) incluem a pontuação de usabilidade específica ao protocolo e a intenção de adoção. As barras representam as médias por participante, e as barras de erro indicam o desvio padrão (DP). As comparações entre as condições inicial e pós-protótipo foram realizadas ao nível dos participantes e foram estatisticamente significativas (P < 0,001) para tempo de conclusão, contagem de erros, clareza e taxa de sucesso na tarefa. Clique aqui para visualizar uma versão maior desta figura.
Discussão
Este protocolo fornece um método sistemático e reprodutível para estruturar problemas complexos em ambientes de serviços públicos de baixo risco. Ao integrar sequencialmente o mapeamento de partes interessadas, o mapeamento de jornadas, o co-design Double Diamond e a testagem de protótipos de baixa fidelidade, o método transforma reclamações fragmentadas de múltiplos atores em intervenções de serviço testáveis, mantendo ao mesmo tempo uma distinção clara entre evidências simuladas de usabilidade e desempenho administrativo real. Os resultados representativos demonstram que os desafios dos serviços públicos raramente estão isolados em uma única etapa procedural; ao contrário, distribuem-se entre usuários, funcionários da linha de frente e administradores de escritório central. Uma contribuição fundamental deste protocolo é sua capacidade de tornar visíveis essas dependências entre múltiplos atores e as assimetrias de informação antes mesmo do início do desenvolvimento de soluções.
Um componente central deste protocolo é a matriz da jornada das partes interessadas. Em serviços públicos com múltiplos atores, as partes interessadas frequentemente têm interpretações diferentes sobre onde se originam as falhas no serviço. A matriz atua como um objeto-limite, um artefato tangível que é adaptável entre diferentes fronteiras conceituais, mantendo ao mesmo tempo uma identidade comum entre os grupos de participantes, facilitando assim o consenso entre diferentes funções e o design colaborativo25,26. Ao traduzir a insatisfação difusa dos usuários em eventos observáveis e específicos por etapa, a matriz reduz o risco de uma formulação vaga do problema e ajuda a impedir que os participantes do workshop recorram a ajustes administrativos familiares, mas ineficazes.
A aplicação estruturada do framework Double Diamond favorece uma transição controlada da exploração do problema ao redesenho prático do serviço. Os resultados indicam que a passagem de reclamações gerais a desafios de design específicos do tipo "Como poderíamos" é frequentemente a fase mais desafiadora do processo, exigindo facilitação ativa, critérios explícitos de seleção e revisões documentadas. Sem essas restrições estruturais (especificando o ator afetado, a etapa da jornada, a falha no serviço e a melhoria pretendida), sessões de cocriação podem gerar soluções genéricas que não abordam as falhas de serviço mapeadas. A ligação direta entre um ponto crítico priorizado (por exemplo, requisitos de materiais pouco claros) e seu protótipo correspondente (por exemplo, uma lista de verificação em uma página) ilustra a validade gerativa do protocolo.
É importante distinguir os resultados do teste de protótipos baseados em tarefas gerados por este protocolo de afirmações sobre melhoria organizacional real. As reduções observadas no tempo de conclusão da tarefa e nas taxas de erro indicam que os materiais co-projetados são claros e utilizáveis sob condições simuladas. No entanto, o prototipagem em estágio inicial no setor público destina-se principalmente a apoiar a aprendizagem e a mitigação de riscos antes da implementação16,27. A sequência fixa de testes antes/depois utilizada na aplicação representativa também pode introduzir familiaridade com a tarefa ou efeitos de aprendizagem, pois os participantes realizaram as tarefas de linha de base antes das tarefas pós-protótipo. Implementações futuras devem utilizar ordens de tarefas contrabalançadas, grupos controle pareados ou modelos de medidas repetidas para distinguir os efeitos do protótipo dos efeitos de aprendizagem.
A solução de problemas comuns de falhas no protocolo é essencial para a reprodutibilidade. Se o mapeamento de partes interessadas produzir apenas rótulos genéricos de atores, os facilitadores devem pedir aos participantes que especifiquem a decisão, a informação ou a dependência de coordenação associada a cada ator. Se os mapas de jornada se tornarem listas de reclamações, os facilitadores devem vincular cada cartão a uma etapa específica da jornada, ao ator afetado, à lacuna de informação e à consequência subsequente.
É esperada uma modificação do protocolo quando o fluxo de trabalho for transferido para diferentes ambientes de serviços públicos. Para serviços administrativos universitários, os rótulos das etapas podem enfatizar processos de inscrição, recursos e suporte. Para o redesenho de percursos ambulatoriais na área da saúde, as salvaguardas éticas e as aprovações de governança clínica devem ser ampliadas. Para a coordenação de assistência social, os requisitos interinstitucionais de proteção de dados podem exigir controles mais rigorosos de desidentificação e encaminhamento. Diferenças culturais, administrativas e governamentais também podem influenciar até que ponto os participantes criticam livremente os procedimentos, como a autoridade é distribuída dentro de grupos mistos e se é necessário votação anônima ou mapeamento separado entre usuários e prestadores.
Várias limitações devem ser consideradas ao aplicar este método. Primeiro, o protocolo foi projetado especificamente para serviços consultivos e administrativos de baixo risco. Aplicá-lo em ambientes de alto risco, como intervenções médicas ou decisões jurídicas, exigiria salvaguardas éticas substancialmente aprimoradas, expertise na área específica e protocolos de proteção de dados. Segundo, embora a separação dos grupos de usuários e provedores durante a fase inicial de mapeamento possa reduzir a supressão de feedback negativo, desequilíbrios de poder inerentes ainda podem influenciar a dinâmica colaborativa durante a síntese com funções mistas. Terceiro, o sucesso da fase Definir depende da expertise do facilitador. Portanto, grupos de pesquisa independentes devem utilizar treinamento padronizado de facilitadores, exercícios de calibração, listas de verificação de observação e sessões de avaliação pós-encontro antes de comparar resultados entre diferentes contextos.
Em conclusão, este protocolo sistemático de visualização oferece uma abordagem estruturada e limitada eticamente para diagnosticar e prototipar soluções para problemas complexos de serviços públicos. Ele impulsiona a inovação em serviços públicos para além de discussões políticas abstratas, fornecendo um kit de ferramentas reprodutível que une a reforma liderada por especialistas ao design centrado no usuário. Pesquisas futuras devem aplicar este protocolo a domínios adicionais de serviços públicos, incluindo serviços digitais municipais, serviços administrativos universitários, apoio educacional, reestruturação de percursos ambulatoriais em saúde e coordenação de assistência social. Estudos futuros também devem avaliar como os protótipos desenvolvidos em oficinas controladas se desempenham após a implementação em fluxos de trabalho administrativos rotineiros.
Divulgações
Os autores declaram não haver conflitos de interesses.
Agradecimentos
Os autores agradecem a todos os participantes, incluindo cidadãos, funcionários de serviços de primeira linha e administradores de agências públicas, pela participação nos questionários, oficinas de cocriação e sessões de testes de protótipos. Suas contribuições e percepções sobre experiências de serviços públicos com múltiplos atores apoiaram o desenvolvimento deste protocolo sistemático de visualização de design de serviços.
Os autores também agradecem o apoio institucional e acadêmico fornecido pela Faculdade de Inovação e Design, Universidade da Cidade de Macau; pela Faculdade de Arte e Design, Universidade de Shenzhen; e pela Faculdade de Arte e Design, Universidade Guangdong Baiyun. Esta pesquisa não recebeu nenhuma bolsa específica de agência de fomento nos setores público, comercial ou sem fins lucrativos.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Sintaxe de análise ou notas do fluxo de trabalho | Equipe de pesquisa | PSD-VP-S17 v1.1 | Documentar o fluxo de trabalho do SPSS ou equivalente em R para comparações pareadas, testes de Wilcoxon, verificações de sensibilidade de McNemar, tamanhos de efeito, intervalos de confiança e saídas de relatórios. |
| Questionário anônimo baseado em funções | Equipe de pesquisa | PSD-VP-S02 v1.1 | Coletar informações sobre o papel dos participantes e percepções iniciais do processo de serviço público selecionado. |
| Lista de verificação de desidentificação | Equipe de pesquisa | PSD-VP-S14 v1.1 | Garantir que nomes dos participantes, números de identificação, endereços, IDs de casos e registros administrativos não sejam coletados nem divulgados. |
| Modelo de desafio de design | Equipe de pesquisa | PSD-VP-S07 v1.1 | Converter pontos problemáticos agrupados em declarações estruturadas e testáveis do tipo "Como poderíamos". |
| Rubrica de calibração do facilitador | Equipe de pesquisa | PSD-VP-S15 v1.1 | Padronizar a preparação do facilitador, codificação de exemplos, revisão de declarações de desafio e consistência entre facilitadores. |
| Folha de avaliação de partes interessadas em escala de cinco pontos | Equipe de pesquisa | PSD-VP-S04 v1.1 | Avaliar a influência, dependência, acesso à informação e pressão de coordenação de cada parte interessada. |
| IBM SPSS Statistics | IBM Corporation | Version 26.0 or later | Realizar análises descritivas, testes t pareados, testes de Wilcoxon e testes de McNemar para os resultados do teste de protótipos. |
| Materiais de protótipo de baixa fidelidade | Equipe de pesquisa | PSD-VP-S10 v1.1 | Desenvolver e testar materiais iniciais de serviço, incluindo uma lista de verificação de requisitos, simulação de status do serviço e caminho de acompanhamento. |
| Microsoft Excel | Microsoft Corporation | Microsoft 365 or equivalent | Organizar dados do questionário, calcular estatísticas descritivas, gerenciar planilhas de codificação e preparar tabelas resumo. |
| Cartões de pontos problemáticos | Equipe de pesquisa | PSD-VP-S06 v1.1 | Registrar falhas no serviço, lacunas de informação, ambiguidade de responsabilidades, atores afetados e consequências subsequentes. |
| Folha de informações para o participante | Equipe de pesquisa | PSD-VP-S01 v1.1 | Explicar o objetivo do estudo, procedimentos, direitos dos participantes e requisitos de consentimento antes da participação. |
| Armazenamento de dados com senha | Sistema computacional institucional ou da equipe de pesquisa | Access restricted to research team | Armazenar com segurança dados do questionário desidentificados, saídas das oficinas, arquivos de codificação e registros de testes de tarefas. |
| Rubrica de avaliação de protótipos | Equipe de pesquisa | PSD-VP-S12 v1.1 | Avaliar clareza, usabilidade, sucesso na tarefa, contagem de erros e intenção de adoção do protótipo. |
| Folha de seleção de protótipos | Equipe de pesquisa | PSD-VP-S09 v1.1 | Selecionar conceitos de protótipos que atendam a limites pré-definidos de viabilidade e testabilidade. |
| Modelo de mapeamento da jornada do serviço público | Equipe de pesquisa | PSD-VP-S05 v1.1 | Mapear o processo de serviço público ao longo da busca por informações, esclarecimento de requisitos, preparação de materiais, submissão, processamento, notificação e apoio de acompanhamento. |
| Folhas de tarefas simuladas | Equipe de pesquisa | PSD-VP-S11 v1.1 | Avaliar a conclusão da tarefa, precisão das decisões e clareza antes e após a exposição ao protótipo. |
| Cartões de soluções | Equipe de pesquisa | PSD-VP-S08 v1.1 | Documentar ideias de melhoria do serviço geradas durante a oficina de cocriação Double Diamond. |
| Folha de trabalho de mapeamento de partes interessadas | Equipe de pesquisa | PSD-VP-S03 v1.1 | Identificar 5 a 8 atores envolvidos no processo de serviço público e visualizar papéis e dependências dos atores. |
| Folha de codificação estruturada | Equipe de pesquisa | PSD-VP-S13 v1.1 | Codificar dados de mapeamento de partes interessadas, saídas do mapeamento da jornada, agrupamentos de pontos problemáticos e resultados das oficinas. |
| Lista de verificação de equivalência de conjuntos de tarefas | Equipe de pesquisa | PSD-VP-S16 v1.1 | Documentar o pareamento de tarefas iniciais e pós-protótipo por etapas de decisão, extensão de leitura, campos obrigatórios, complexidade e tempo de conclusão no teste piloto. |
Referências
- Rittel HWJ, Webber MM. Dilemmas in a general theory of planning. Policy Sci. 1973;4(2):155-69.
- Suoheimo M, Vasques R, Rytilahti P. Deep diving into service design problems: Visualizing the iceberg model of design problems through a literature review on the relation and role of service design with wicked problems. Des J. 2021;24(2):231-51.
- Voorberg WH, Bekkers V, Tummers LG. A systematic review of co-creation and co-production: Embarking on the social innovation journey. Public Manag Rev. 2015;17(9):1333-57.
- Schwoerer K, Keppeler F, Mussagulova A, Puello S. CO-DESIGN-ing a more context-based, pluralistic, and participatory future for public administration. Public Adm. 2022;100(1):72-97.
- Edelmann N, Mergel I. Co-production of digital public services in Austrian public administrations. Adm Sci. 2021;11(1):https://doi.org/10.3390/admsci11010022
- Blomkamp E. Systemic design practice for participatory policymaking. Policy Des Pract. 2022;5(1):12-31.
- Vargas C, et al. Exploring co-design: A systematic review of concepts, processes, models, and frameworks used in public health research. J Public Health. 2025;47(4):https://doi.org/10.1093/pubmed/fdaf084
- Wacnik P, Daly SR, Verma A. Participatory design: A systematic review and insights for future practice. Des Sci. 2025;11:https://doi.org/10.1017/dsj.2025.10009
- Udoewa V. An introduction to radical participatory design: Decolonising participatory design processes. Des Sci. 2022;8:https://doi.org/10.1017/dsj.2022.24
- Stickdorn M, Schneider J. This is service design thinking: Basics, tools, cases. BIS Publishers; Amsterdam; 2011. https://www.wiley.com/en-us/This+is+Service+Design+Thinking%3A+Basics%2C+Tools%2C+Cases-p-9781118156308
- Blomkamp E. The promise of co-design for public policy. Aust J Public Adm. 2018;77(4):729-43.
- Bryson JM. What to do when stakeholders matter: Stakeholder identification and analysis techniques. Public Manag Rev. 2004;6(1):21-53.
- Folstad A, Kvale K. Customer journeys: A systematic literature review. J Serv Theory Pract. 2018;28(2):196-227.
- Design C. Eleven lessons: Managing design in eleven global brands. Design Council; London; 2007. https://www.idi-design.ie/content/files/ElevenLessons_Design_Council_2.pdf
- Steen M, Manschot M, De Koning N. Benefits of co-design in service design projects. Int J Des. 2011;5(2):53-60.
- Not E, et al. Designing a digital environment to support the co-production of public services: Balancing multiple requirements and governance concepts. Digit Gov: Res Pract. 2024;5(3):https://doi.org/10.1145/3603632
- Excellence UGCfPS. Design thinking for public service excellence. UNDP Global Centre for Public Service Excellence; Singapore; 2014. https://www.undp.org/publications/designthinking-public-service-excellence
- Osborne SP. The new public governance? Public Manag Rev. 2006;8(3):377-87.
- Hartley J. Innovation in governance and public services: Past and present. Public Money Manage. 2005;25(1):27-34.
- Freeman RE. Strategic management: A stakeholder approach. Pitman; Boston; 1984.
- Stickdorn M, Hormess ME, Lawrence A, Schneider J. This is service design doing: Applying service design thinking in the real world. O'Reilly Media; Sebastopol; 2018. https://www.thisisservicedesigndoing.com/
- Bovaird T. Beyond engagement and participation: User and community coproduction of public services. Public Adm Rev. 2007;67(5):846-60.
- Donetto S, Pierri P, Tsianakas V, Robert G. Experience-based co-design and healthcare improvement: Realizing participatory design in the public sector. Des J. 2015;18(2):227-48.
- Tomczak M, Tomczak E. The need to report effect size estimates revisited: An overview of some recommended measures of effect size. Trends Sport Sci. 2014;21(1):19-25.
- Sanders EBN, Stappers PJ. Co-creation and the new landscapes of design. CoDesign. 2008;4(1):5-18.
- Star SL, Griesemer JR. Institutional ecology, 'translations' and boundary objects: Amateurs and professionals in Berkeley's Museum of Vertebrate Zoology, 1907-39. Soc Stud Sci. 1989;19(3):387-420.
- Liedtka J. Why design thinking works. Harv Bus Rev. 2018;96(5):72-9.