Este protocolo de ciência comportamental e avaliação psicológica padroniza a aplicação de questionários online, pontuação, triagem da qualidade dos dados e análise reproduzível para avaliar a dependência da internet e dificuldades na regulação emocional entre estudantes universitários.
Artigo de método
Um Protocolo de Questionário Padronizado para a Avaliação da Dependência da Internet e da Regulação Emocional em Estudantes Universitários
Neste artigo
Resumo
Resumo
O uso da internet está profundamente integrado à vida universitária, mas o uso problemático da internet não pode ser avaliado adequadamente apenas pelo tempo de exposição. Evidências indicam que padrões maladaptativos ou compulsivos de uso da internet estão associados a dificuldades na regulação emocional, embora inconsistências na ordem dos questionários, critérios de elegibilidade, limiares de triagem, procedimentos de pontuação e relatos analíticos continuem limitando a comparabilidade entre estudos. Este artigo metodológico apresenta um protocolo padronizado de questionário para estudos de ciências comportamentais e avaliação psicológica que investigam a dependência da internet e dificuldades na regulação emocional entre estudantes universitários. O fluxo de trabalho inclui uma sequência fixa de questionários, critérios de elegibilidade pré-especificados, configurações obrigatórias de resposta, limiares de tempo de conclusão baseados em estudo piloto, triagem sequencial da qualidade dos dados, pontuação padronizada do Teste de Dependência da Internet e da Escala de 16 Itens de Dificuldades na Regulação Emocional, além de análises descritivas, correlacionais e de regressão multivariável reproduzíveis. O protocolo também especifica o arquivamento das respostas brutas, registros de triagem, arquivos README/manual de código e o conjunto de dados final pronto para análise. Uma implementação representativa é relatada para demonstrar a execução do protocolo, e não para validar os instrumentos ou estabelecer prevalência. Nessa implementação, 520 estudantes foram convidados e 480 questionários foram devolvidos. Após exclusão sequencial de submissões duplicadas, respostas muito rápidas, falhas nos testes de atenção, padrões de resposta sistemáticos, inconsistências lógicas e dados principais ausentes, 452 questionários válidos foram mantidos. A demonstração analítica pré-definida examinou a associação entre a pontuação total do Teste de Dependência da Internet e a pontuação total da Escala de Dificuldades na Regulação Emocional. A amostra mantida apresentou uma pontuação média total de 51,94 no Teste de Dependência da Internet e uma pontuação média total de 35,95 na Escala de Dificuldades na Regulação Emocional. A dificuldade na regulação emocional aumentou ao longo dos grupos de gravidade da dependência da internet, e a associação permaneceu evidente após ajuste para covariáveis demográficas e comportamentais. Este protocolo fornece um fluxo de trabalho transparente que pode ser repetido, auditado e adaptado para futuros estudos transversais, de medidas repetidas ou longitudinais em populações universitárias.
Introdução
O uso da internet tornou-se uma parte comum da vida universitária, incluindo trabalho acadêmico, comunicação social, entretenimento, busca de informações e enfrentamento emocional. Por essa razão, o comportamento dos estudantes na internet não deve ser interpretado simplesmente como exposição à tela ou tempo online. Evidências anteriores mostraram que o uso problemático da internet já era visível em populações jovens e universitárias antes mesmo de o ambiente atual baseado em plataformas móveis tornar-se altamente saturado1. Estudos mais recentes realizados em universidades indicam ainda que o uso problemático da internet é suficientemente comum para exigir avaliação sistemática, em vez de descrição informal2.
Estudantes universitários representam uma população particularmente relevante para avaliação padronizada, pois a pressão acadêmica, a transição social, a vida independente e o aumento da autonomia frequentemente ocorrem no mesmo estágio de desenvolvimento. Essas demandas são comumente gerenciadas por meio dos mesmos dispositivos e plataformas digitais que também podem tornar-se difíceis de regular. Uma revisão metanalítica mostrou que o uso problemático da internet entre estudantes está associado a múltiplos desfechos de saúde mental, o que sustenta sua interpretação como uma preocupação comportamental e psicológica mais ampla, e não apenas como um problema restrito ao uso da tecnologia3. O estresse percebido também tem sido associado a padrões de vício na internet entre estudantes universitários, sugerindo que pressões emocionais e contextuais devem ser consideradas ao elaborar estudos baseados em questionários nessa área4.
O presente protocolo utiliza o termo “vício em internet” ao se referir especificamente ao constructo medido pelo teste de vício em internet e suas categorias estabelecidas de pontuação. O termo mais amplo “uso problemático da internet” é empregado ao discutir a literatura mais abrangente sobre comportamentos relacionados à internet que sejam desadaptativos, excessivos ou que comprometam funcionalmente o indivíduo. “Uso compulsivo da internet” é usado apenas quando a literatura citada enfatiza perda de controle, impulsos ou uso repetitivo apesar de consequências negativas. Esses termos são, portanto, relacionados, mas não são tratados como completamente intercambiáveis. Quando o protocolo é implementado com o Teste de Vício em Internet, mantém-se o termo “vício em internet” como terminologia específica ao instrumento; ao utilizar instrumentos alternativos ou revisados, a terminologia deve ser alinhada aos rótulos do constructo e às premissas diagnósticas da medida selecionada.
A regulação emocional fornece um ponto de entrada psicológico plausível para compreender por que alguns estudantes transicionam do uso frequente da internet para um uso adaptativo da internet. Um estudo prospectivo de um ano mostrou que a dificuldade na regulação emocional estava relacionada tanto à ocorrência posterior quanto à remissão do vício em internet entre estudantes universitários5. Esse achado é importante para o desenho de protocolos, pois a regulação emocional não é meramente um correlato adicional; pode influenciar a forma como os estudantes utilizam a internet para evitar, reduzir ou gerenciar o sofrimento psicológico. Ao mesmo tempo, o funcionamento social permanece relevante. O uso problemático da internet tem sido associado às habilidades sociais entre estudantes universitários, indicando que fatores interpessoais e emocionais devem ser avaliados juntamente com variáveis de uso digital6. Durante o período da COVID-19, o uso problemático da internet também coocorreu com dificuldades psicológicas mais amplas entre estudantes universitários chineses, reforçando ainda mais a necessidade de uma avaliação estruturada em ambientes universitários7.
Um desafio adicional é que o comportamento digital é heterogêneo. Os estudantes podem usar plataformas digitais para estudo, contato social, entretenimento, informações sobre saúde ou alívio emocional temporário, e nem todo uso de alta frequência é prejudicial. Uma revisão sistemática sobre o uso digital relacionado à saúde mental em estudantes universitários mostrou que o envolvimento digital pode atender a múltiplos propósitos psicológicos8. O campo, portanto, necessita de procedimentos que distingam o uso comum de alta frequência do uso problemático ou disregulado. Evidências recentes sobre o uso problemático de smartphones em estudantes universitários sugerem igualmente que o risco depende do padrão comportamental, da função e do contexto, e não apenas da duração9. Por essa razão, o presente protocolo combina a duração do uso da internet, o uso durante a madrugada, a atividade online principal e uma pontuação padronizada de sintomas, em vez de depender de um único indicador de exposição.
A medição é outra fonte importante de inconsistência. O teste de dependência da internet continua sendo um dos instrumentos mais amplamente utilizados para avaliar sintomas de dependência da internet, mas sua dimensionalidade e interpretação têm variado entre diferentes contextos. Evidências psicométricas sistemáticas indicam que o instrumento tem sido extensivamente utilizado, embora ainda levante questões sobre a estrutura fatorial e a interpretação da pontuação10. Preocupações semelhantes foram relatadas em amostras de estudantes universitários, nas quais o uso disseminado da escala não resolveu completamente a incerteza quanto ao construto que está sendo medido11. Estudos de validação em populações universitárias espanholas e peruanas também mostram que o instrumento pode apresentar desempenho adequado, mas que seu comportamento psicométrico deve ser considerado dentro da população-alvo em que é aplicado12,13.
O protocolo é, portanto, projetado para ser estável no fluxo de trabalho, mas adaptável na seleção de instrumentos. O teste de vício em internet é utilizado aqui devido ao seu uso histórico, limiares disponíveis e comparabilidade com pesquisas anteriores com estudantes universitários. No entanto, o protocolo não exige que o teste de vício em internet permaneça como o instrumento preferido indefinidamente. Se as estruturas diagnósticas evoluírem ou se novos instrumentos se tornarem mais apropriados para uma população específica, o mesmo fluxo de trabalho poderá ser mantido, substituindo-se o módulo específico da escala, a faixa de pontuação, os limiares de gravidade, as entradas do código e a documentação do arquivo LEIAME. Qualquer substituição desse tipo deve ser feita antes do início da coleta formal de dados e deve ser relatada como uma modificação do protocolo, e não como uma alteração analítica ad hoc.
O problema metodológico abordado por este artigo não é meramente o fato de estudos sobre vício na internet e regulação emocional chegarem a conclusões diferentes. Muitos estudos diferem quanto à sequência de questionários, critérios de elegibilidade, configurações da plataforma de pesquisa, tratamento de respostas duplicadas, procedimentos de verificação de atenção, limiares de tempo de conclusão, regras para dados ausentes, verificação de pontuação e relato de arquivos prontos para análise. Essas diferenças dificultam a comparação, reprodução e inclusão dos resultados em sínteses de evidências posteriores. O presente protocolo responde a essa lacuna ao fixar a sequência de aplicação, a lógica de triagem, a estrutura de pontuação e o caminho analítico de forma que possam ser repetidos, auditados e modificados de maneira transparente. Sua contribuição é, portanto, orientada ao protocolo: fornece um fluxo de trabalho reprodutível para estudos observacionais em ciências comportamentais e avaliações psicológicas em populações universitárias, em vez de propor um novo constructo psicológico ou apresentar um estudo de prevalência como resultado principal.
Protocolo
O estudo, intitulado “Um Protocolo Padronizado de Questionário para Avaliação da Dependência da Internet e Regulação Emocional em Estudantes Universitários”, foi revisado e aprovado pelo Comitê de Ética e Acadêmico da Universidade de Economia e Negócios de Zhengzhou sob o número de aprovação 20260113004 antes do início da recrutamento dos participantes14. O estudo utilizou um delineamento transversal com questionário online anônimo envolvendo estudantes universitários em tempo integral com idades entre 18 e 24 anos e foi conduzido de acordo com os requisitos éticos institucionais e a Declaração de Helsinque. O consentimento informado eletrônico foi obtido antes do acesso ao questionário. Os participantes receberam uma ficha informativa eletrônica descrevendo os objetivos do estudo, os procedimentos, a natureza voluntária da participação e as medidas de proteção dos dados, e tinham liberdade para se retirar a qualquer momento, sem penalidade. Nenhuma informação pessoal diretamente identificável, incluindo nome, número de identificação estudantil, endereço exato, número de telefone, endereço de e-mail pessoal ou conta de mídia social, foi coletada no arquivo principal da pesquisa. Identificadores gerados pela plataforma foram usados apenas para triagem de respostas duplicadas e foram removidos antes da análise do conjunto de dados. Todos os dados foram armazenados com segurança e analisados de forma desidentificada. Este fluxo de trabalho do questionário não foi registrado prospectivamente antes do recrutamento dos participantes. No entanto, todos os componentes principais do protocolo, incluindo a versão finalizada do questionário, o arquivo README/manual de codificação, o registro de triagem, as regras de pontuação, a sintaxe de análise e os arquivos do fluxo de trabalho prontos para análise, foram arquivados e são fornecidos como materiais complementares do fluxo de trabalho para apoiar a reprodutibilidade e a auditabilidade.
Identificadores de resposta gerados pela plataforma e identificadores técnicos limitados por dispositivo ou conta foram utilizados apenas para triagem de respostas duplicadas e foram removidos do conjunto de dados analítico final anonimizado. As variáveis principais e as regras de pontuação são resumidas na Tabela 1, e o dicionário completo de variáveis está disponível na Tabela Suplementar 1. Os arquivos do questionário, o código de variáveis, o registro de triagem, o plano de saída e os materiais de fluxo de trabalho prontos para análise estão disponíveis no Arquivo Suplementar 1.
| Domínio | Variável | Codificação/Pontuação | Papel no protocolo |
| Eligibilidade | Idade | Anos; faixa elegível 18–24 | Variável de elegibilidade e covariável |
| Demográficos | Sexo | 1 = masculino; 2 = feminino; 3 = prefiro não dizer | Variável descritiva e covariável de regressão |
| Demográficos | Ano acadêmico | 1 = primeiro ano; 2 = segundo ano; 3 = terceiro ano; 4 = quarto ano ou superior; 5 = pós-graduação | Variável descritiva |
| Demográficos | Categoria de disciplina | 1 = humanidades e ciências sociais; 2 = ciências e engenharia; 3 = negócios e administração; 4 = artes e design; 5 = outro | Variável descritiva |
| Demográficos | Tipo de residência | 1 = dormitório no campus; 2 = aluguel fora do campus; 3 = residência familiar; 4 = outro | Variável descritiva |
| Demográficos | Despesas mensais de vida | 1 = <1.000 CNY; 2 = 1.000–1.999 CNY; 3 = 2.000–2.999 CNY; 4 = ≥3.000 CNY | Variável descritiva |
| Comportamento de uso da internet | Uso da internet em dias de semana | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Covariável comportamental |
| Comportamento de uso da internet | Uso da internet nos fins de semana | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Covariável comportamental |
| Comportamento de uso da internet | Atividade online principal | 1 = estudo; 2 = redes sociais; 3 = jogos; 4 = entretenimento/vídeo; 5 = compras; 6 = uso misto; 7 = outro | Variável descritiva |
| Comportamento de uso da internet | Dispositivo principal de acesso | 1 = smartphone; 2 = tablet; 3 = laptop/desktop; 4 = dispositivos mistos | Variável descritiva |
| Comportamento de uso da internet | Uso noturno após às 23h | 1 = nunca; 2 = menos de uma vez por semana; 3 = 1–2 noites/semana; 4 = 3–5 noites/semana; 5 = quase todas as noites | Covariável comportamental e variável de triagem de consistência lógica |
| Escala principal | Pontuação total do IAT | Soma de 20 itens; cada item pontuado de 1 a 5; pontuação total entre 20 e 100 | Variável independente principal |
| Escala principal | Grupo de gravidade do IAT | 20–39 = uso normal; 40–69 = uso problemático; 70–100 = uso problemático grave | Variável de agrupamento |
| Escala principal | Pontuação total do DERS-16 | Soma de 16 itens após inversão obrigatória de pontuação; pontuação total entre 16 e 80 | Variável dependente principal |
| Escala principal | Subescalas do DERS-16 | Calculadas conforme a chave de pontuação fixa do DERS-16 | Resultados descritivos de regulação emocional |
| Covariável | Duração do sono | 1 = <6 h; 2 = 6–6,9 h; 3 = 7–7,9 h; 4 = ≥8 h | Variável de ajuste |
| Covariável | Atividade física semanal | 0 = nenhuma; 1 = 1–2 sessões; 2 = 3–4 sessões; 3 = ≥5 sessões | Variável de ajuste |
| Covariável | Estresse acadêmico | 1 = baixo; 2 = moderado; 3 = alto | Variável de ajuste |
| Controle de qualidade | Verificação de atenção | 1 = aprovado; 0 = reprovado | Critério de exclusão |
| Controle de qualidade | Tempo de conclusão | Duração da conclusão em segundos | Variável de triagem baseada no tempo |
| Controle de qualidade | Contagem de respostas em sequência longa | Comprimento máximo de respostas idênticas nos 36 itens da escala pontuada | Variável de triagem de resposta padronizada |
| Controle de qualidade | DP intra-indivíduo | Desvio padrão intra-indivíduo nos 36 itens da escala pontuada | Variável de triagem de resposta invariável |
| Controle de qualidade | Sinalizador de consistência lógica | 0 = sem inconsistência; 1 = inconsistência detectada | Variável de triagem de consistência lógica |
Tabela 1: Variáveis principais, estrutura de codificação e regras de pontuação utilizadas no protocolo padronizado do questionário. Esta tabela resume as variáveis principais de elegibilidade, demográficas, uso da internet, escalas, covariáveis e de controle de qualidade utilizadas no fluxo de trabalho principal. Inclui os valores de codificação, intervalos de pontuação, regras de pontuação e funções das principais variáveis utilizadas na aplicação do questionário, triagem, pontuação e análise. Abreviações: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Clique aqui para baixar esta tabela.
1. Configure a população do estudo, a estrutura do questionário e o fluxo da pesquisa
- Defina a população-alvo e a amostra válida
- Recrute estudantes de graduação e pós-graduação em regime integral com idades entre 18 e 24 anos que possam preencher o questionário de forma independente em um telefone celular ou computador. Registre a versão linguística do questionário e utilize versões de escalas que tenham sido validadas ou adequadamente adaptadas para a população estudantil-alvo.
- Documente qualquer modificação de acessibilidade ou idioma antes da coleta de dados, quando estudantes internacionais, estudantes com deficiência ou grupos estudantis multilíngues forem incluídos.
- Restrinja a participação a uma resposta concluída por participante. Utilize a restrição de dispositivo, restrição de conta, restrição de cookie ou função de link autenticado da plataforma de pesquisa, quando disponível.
NOTA: Quando a mesma conta de participante gerar respostas a partir de múltiplos dispositivos, identifique e reconcilie esses registros durante a triagem de duplicatas, utilizando o identificador limitado por conta, carimbo de data/hora, status do questionário e similaridade no padrão de respostas. - Defina a amostra final mínima válida em 450 questionários e continue o recrutamento até que o conjunto de dados limpo permaneça acima desse limite após a triagem.
NOTA: Quando o uso problemático grave da internet ou outro subgrupo pequeno for o alvo principal da análise, defina um objetivo maior de recrutamento antes do início da coleta de dados. - Registre o número de convites enviados, o número de respostas recebidas, o número excluído em cada etapa pré-especificada de triagem e o número final retido, de modo que o fluxo de participantes possa ser posteriormente resumido na Figura 1.
- Construa o questionário em ordem fixa
- Organize o questionário na seguinte sequência: consentimento informado, informações demográficas, comportamento de uso da internet, Teste de Vício em Internet, Escala de Dificuldades na Regulação Emocional – versão reduzida, duração do sono, atividade física semanal e estresse acadêmico percebido. Mantenha essa ordem inalterada para todos os participantes. Não randomize a ordem das escalas principais.
- Registre idade, sexo, ano acadêmico, categoria da disciplina, tipo de residência e despesas mensais de manutenção utilizando categorias de resposta fechadas. Marque todos os itens demográficos como obrigatórios.
NOTA: Para sexo, inclua masculino, feminino e prefiro não informar. Mantenha a opção “prefiro não informar” nas análises descritivas. Nas análises de regressão, codifique o sexo utilizando variáveis indicadoras com masculino como categoria de referência, incluindo indicadores separados para feminino e prefiro não informar. Não exclua participantes exclusivamente por selecionarem “prefiro não informar”. - Registre a duração do uso da internet em dias úteis, a duração do uso da internet nos fins de semana, a atividade online principal, o dispositivo principal de acesso e o uso noturno da internet após as 23h. Codifique o uso noturno como 1 = nunca, 2 = menos de uma vez por semana, 3 = 1–2 noites por semana, 4 = 3–5 noites por semana e 5 = quase todas as noites.
- Registre o período acadêmico em que o questionário é aplicado. Na implementação representativa, a pesquisa foi aplicada durante um semestre letivo regular, fora das semanas de exames finais, especificamente nas semanas 6–7 do semestre.
- Aplicar e pontuar os instrumentos principais
- Aplicar o Teste de Vício em Internet de 20 itens como uma escala obrigatória e pontuar cada item de 1 a 5. Some os 20 itens para obter uma pontuação total variando de 20 a 100, classificando então 20–39 como uso normal, 40–69 como uso problemático e 70–100 como uso problemático grave15.
- Utilize “vício em internet” ao relatar pontuações e grupos de gravidade baseados no IAT. Utilize “uso problemático da internet” apenas ao se referir à literatura mais ampla ou a construtos não baseados no IAT.
- Aplicar a versão reduzida de 16 itens da Escala de Dificuldades na Regulação Emocional imediatamente após o Teste de Vício em Internet e pontuar cada item de 1 a 5. Recodifique os itens 1, 6 e 8 antes da soma, e então calcule uma pontuação total variando de 16 a 80, em que pontuações mais altas indicam maior dificuldade na regulação emocional16.
- Gere cinco pontuações de subescalas para não aceitação, metas, impulso, estratégias e clareza após a verificação da recodificação inversa.
- Verifique novamente a direção de codificação de todos os itens invertidos antes de calcular as pontuações totais e de subescala. Utilize a mesma chave de pontuação do DERS-16 para todos os participantes e documente a chave de pontuação no README/manual de código.
- Quando um instrumento revisado ou alternativo de vício em internet for utilizado, substitua o módulo específico da escala antes do início da coleta de dados e atualize os nomes dos itens, faixa de pontuação, limiares de gravidade, sintaxe de pontuação, README/manual de código, capturas de tela do questionário e Tabela de Materiais.
- Adicione covariáveis e um item de verificação de atenção
- Registre a duração do sono como <6 h, 6–6,9 h, 7–7,9 h e ≥8 h. Registre a frequência semanal de atividade física como 0, 1–2, 3–4 e ≥5 sessões. Registre o estresse acadêmico percebido como baixo, moderado ou alto. Defina uma sessão de atividade física como ≥20 min de atividade moderada ou vigorosa.
- Insira um item direcionado de verificação de atenção na seção comportamental e exija que o participante selecione uma opção de resposta especificada. O item de verificação de atenção utilizado na implementação representativa foi: “Para confirmar que você está lendo com atenção, selecione ‘3 = às vezes’ para este item”. Marque qualquer questionário que não atenda a este item para exclusão durante a limpeza17.
ETAPA CRÍTICA: Não altere a redação do item, âncoras de resposta, ordem da escala, limiares de exclusão, configurações da plataforma de pesquisa, regras de codificação ou regras de análise estatística após o início formal da coleta de dados.
NOTA: Resuma as variáveis principais, valores de codificação, faixas de pontuação e regras de pontuação na Tabela 1. Forneça o dicionário completo de variáveis, campos de status do arquivo, flags de triagem, campos de identificadores técnicos, variáveis de rastreamento do conjunto de dados, nomes de arquivos e versões de software na Tabela Suplementar 1 e no README/manual de código.
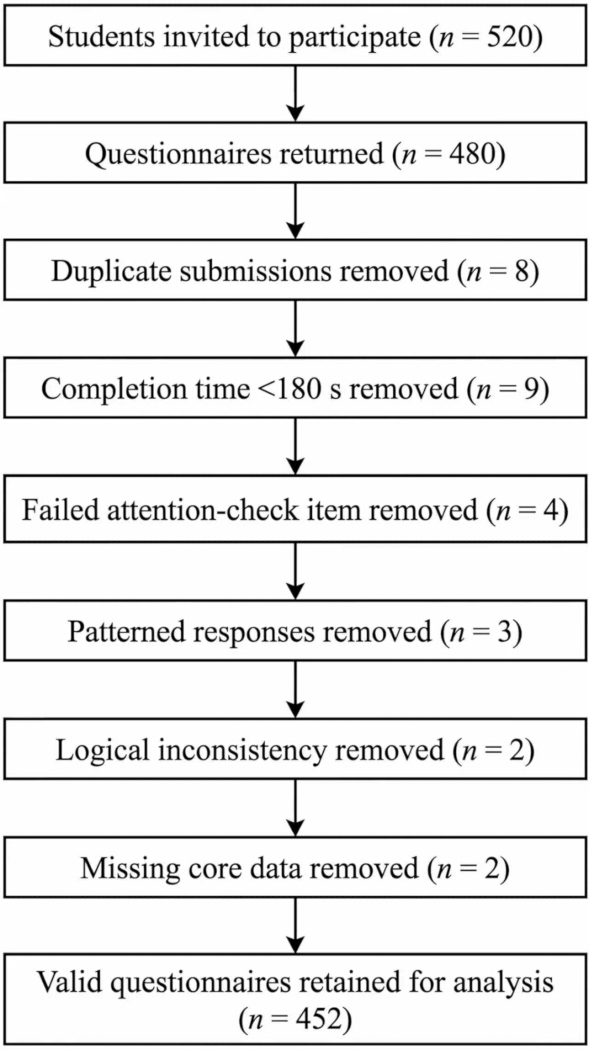
Figura 1: Fluxograma do questionário para recrutamento, triagem, exclusão e retenção analítica final. Este diagrama de fluxo mostra a progressão dos estudantes convidados até os questionários devolvidos, passando por triagens sequenciais de qualidade dos dados e exclusões com base em critérios pré-especificados, até a retenção final dos questionários válidos para análise. A figura apresenta o número de estudantes convidados, questionários devolvidos, registros excluídos em cada etapa de triagem e a amostra analítica final. Clique aqui para visualizar uma versão maior desta figura.
2. Teste piloto do questionário e travamento da versão final de campo
- Teste piloto do questionário completo
- Aplicar o questionário completo a 20–30 estudantes que atendam aos critérios formais de inclusão, mas que não sejam incluídos no conjunto final de dados.
- Registrar o tempo de conclusão e o feedback escrito sobre clareza, carga de resposta, acesso técnico, ordem dos itens, compreensão dos itens de verificação de atenção e qualquer ambiguidade nas opções de resposta demográficas ou comportamentais.
- Registrar o tamanho da amostra piloto, o tempo mediano de conclusão, a amplitude interquartil, os tempos mínimo e máximo de conclusão e todas as alterações de redação feitas após o teste piloto.
- Na implementação representativa, o teste piloto incluiu 25 estudantes, o tempo mediano de conclusão foi de 540 s e o tempo esperado de conclusão foi definido em 6–8 min.
- Revisar redações ambíguas, significados duplicados, opções de resposta pouco claras ou problemas de exibição no software identificados durante o teste piloto e, em seguida, fixar a versão final do questionário antes da liberação formal.
NOTA: Se o estudo incluir estudantes multilíngues, adultos mais velhos, adolescentes ou estudantes com deficiência, realizar testes cognitivos adicionais ou testes piloto em subgrupos antes da liberação formal.
- Definir as configurações operacionais e regras de exportação
- Criar um novo projeto de pesquisa na plataforma online de questionários selecionada. Inserir a página de consentimento como a primeira página e definir o item de consentimento como um item obrigatório de ramificação.
- Configurar a pesquisa para que participantes que não fornecerem consentimento sejam automaticamente encerrados sem visualizar o corpo do questionário.
- Inserir todos os itens demográficos, de uso da internet, IAT, DERS-16, covariáveis e de verificação de atenção utilizando a redação e âncoras de resposta fixadas. Definir todos os itens principais como obrigatórios.
- Ativar o registro automático do horário de início, horário de término, duração da conclusão, status da resposta e identificador de resposta gerado pela plataforma.
- Habilitar controles de uma resposta por participante quando disponíveis, incluindo links de pesquisa autenticados, restrição por dispositivo, prevenção de repetição baseada em cookies, prevenção de repetição baseada em conta ou configurações de revisão de respostas duplicadas. Registrar os controles habilitados no README/manual de código.
- Desativar a coleta de identificadores diretos desnecessários. Se a plataforma registrar o endereço IP por padrão, desativar o armazenamento de IP ou substituí-lo por um campo de triagem de duplicatas não identificável, quando permitido pela política institucional.
NOTA: Quando endereços IP ou metadados do dispositivo forem temporariamente retidos para triagem de duplicatas, armazená-los apenas no arquivo bruto criptografado, restringir o acesso ao analista do estudo e removê-los antes de gerar o conjunto final de dados analíticos. - Especificar se pausar e retomar é permitido. Neste protocolo, uma função formal de salvar e retornar em sessões diferentes não é habilitada. Os participantes podem pausar apenas dentro da mesma sessão aberta do navegador, e o tempo registrado de conclusão inclui todo o tempo decorrido.
- Exportar o arquivo bruto de respostas em formatos de planilha e de valores separados por vírgula ao encerrar a pesquisa18. Também exportar um arquivo de pesquisa para documento ou cópia em PDF/A contendo a redação final do questionário, ordem dos itens, configurações de ramificação, configurações de itens obrigatórios e estrutura de codificação. Salvar esses arquivos com nomes controlados por versão.
- Calcular o tempo mediano de conclusão do teste piloto e definir o limite mínimo de conclusão válida em aproximadamente um terço desse valor. Fixar o limite inferior final em 180 s e aplicá-lo uniformemente durante a triagem formal.
- Como esse limite é derivado da amostra piloto, redefinir o limiar quando o protocolo for implementado em uma população substancialmente diferente, plataforma, versão linguística ou ambiente institucional.
NOTA: Arquivar capturas de tela do questionário final, exportação final do questionário, README/manual de código, registro do teste piloto, redação dos itens de verificação de atenção, modelo de registro de triagem, configurações de exportação e sintaxe estatística como arquivos complementares ou de auditoria.
3. Libere o questionário e preserve o conjunto de dados bruto
- Recrutar participantes por meio de canais fixos
- Distribuir um convite padronizado por meio de grupos de comunicação estudantil, canais de turma ou listas de e-mail institucionais durante uma janela fixa de 14 dias para coleta.
- Informar na mensagem de convite e na página de consentimento o objetivo do estudo, o tempo esperado de conclusão de 6–8 min, o tratamento anônimo dos dados, a participação voluntária e a ausência de penalidade ou recompensa acadêmica por não participar.
- Exibir a página de consentimento antes do aparecimento de qualquer item do questionário e exigir concordância ativa antes da entrada. Não permitir acesso ao corpo do questionário sem uma resposta afirmativa de consentimento.
- Informar na página de consentimento que os participantes podem interromper o preenchimento antes da submissão final e que respostas incompletas não serão utilizadas na análise final.
- Utilizar a mesma versão bloqueada do questionário em todos os canais de recrutamento. Se forem utilizados vários canais de recrutamento, registrar o canal apenas quando este tiver sido pré-especificado como variável do estudo.
- Preservar o arquivo bruto de retorno
- Manter todos os registros recebidos, incluindo submissões incompletas e posteriormente excluídas, no arquivo de exportação bruta. Exportar o conjunto completo de dados imediatamente após o encerramento da pesquisa e armazená-lo como raw_returns_YYYYMMDD.csv e raw_returns_YYYYMMDD.xlsx.
- Preservar no arquivo bruto o horário original da submissão, duração da conclusão, status da resposta, identificador de resposta gerado pela plataforma e identificador técnico limitado por dispositivo ou conta. Não sobrescrever esses campos durante etapas posteriores de limpeza.
- Salvar uma cópia somente leitura dos dados brutos antes do início da triagem. Armazenar o arquivo bruto, o registro de triagem e o conjunto de dados analítico final em pastas separadas. Restringir o acesso ao arquivo bruto contendo identificadores técnicos apenas ao pessoal do estudo devidamente autorizado.
CAUTION: Não coletar informações diretamente identificáveis, como nome completo, número de identificação estudantil, endereço exato do dormitório, número de telefone pessoal, endereço de e-mail pessoal ou conta de mídia social, no arquivo principal da pesquisa.
NOTE: Pausar o fluxo de trabalho após a exportação bruta, salvar uma cópia somente leitura do conjunto de dados bruto e reiniciar a limpeza apenas a partir dessa cópia preservada.
4. Analisar os questionários devolvidos e gerar o conjunto de dados analítico final
- Aplicar a sequência de triagem em ordem fixa
- Ordenar todos os registros retornados por identificador limitado ao dispositivo, identificador limitado à conta (quando disponível), carimbo de data/hora, status do questionário e similaridade das respostas. Identificar primeiro as submissões duplicadas. Manter o registro completo mais antigo quando duas ou mais submissões forem originadas do mesmo participante dentro do mesmo ciclo de coleta.
- Se forem detectadas múltiplas submissões a partir da mesma conta autenticada, mas em dispositivos diferentes, tratá-las como submissões duplicadas do mesmo participante. Manter o registro completo mais antigo e excluir registros completos posteriores. Se o registro mais antigo estiver incompleto e um registro posterior for completo, manter o registro completo mais antigo.
- Remover registros com tempo de conclusão <180 s, revisar registros concluídos em 180–240 s e remover registros que falharem no quarto item de verificação de atenção com resposta direcionada. Documentar o número de registros removidos em cada etapa no arquivo screening_log_v1.xlsx19.
- Para registros concluídos em 180–240 s, realizar revisão manual utilizando o resultado da verificação de atenção, sinalizador de resposta em cadeia longa, desvio padrão intra-individual e sinalizador de consistência lógica.
- Manter um registro com velocidade limítrofe somente quando nenhuma outra bandeira de qualidade dos dados estiver presente. Registrar cada decisão relativa à velocidade limítrofe no log de triagem.
- Remover registros padronizados, inconsistentes ou incompletos
- Remover todos os questionários que apresentem resposta em cadeia longa, definida como 18 ou mais respostas idênticas consecutivas nos 36 itens da escala pontuada, ou desvio padrão intra-individual ≤0,25 nesses itens.
- Remover qualquer questionário que apresente combinações comportamentais impossíveis. Definir “categoria de resposta mais alta em quase todos os itens do teste de vício em internet” como pontuação 5 em pelo menos 18 dos 20 itens do IAT.
NOTA: A regra de inconsistência lógica é acionada quando um respondente relata uso da internet em dias úteis e fins de semana na categoria de menor duração (<2 h por dia), uso da internet no período noturno codificado como “quase todas as noites” e pontuação 5 em pelo menos 18 dos 20 itens do IAT. Aplicar esta regra somente após a conclusão da triagem de duplicatas, tempo de conclusão, verificação de atenção e respostas padronizadas. - Remover todos os questionários com valores ausentes em qualquer item do IAT, qualquer item do DERS-16 ou qualquer covariável previamente especificada.
NOTA: Esta regra de caso completo é utilizada porque a pesquisa online utiliza itens principais obrigatórios e porque o modelo de regressão representativo exige um conjunto fixo de covariáveis. Quando os dados ausentes em covariáveis excederem 5%, utilizar um método pré-especificado alternativo para dados ausentes, como imputação múltipla. - Atribuir um ID de estudo anônimo a cada registro mantido e salvar o arquivo restante como analytic_dataset_v1.csv e analytic_dataset_v1.xlsx.
- Remover identificadores de resposta gerados pela plataforma, identificadores limitados ao dispositivo, identificadores limitados à conta, endereços IP (se mantidos durante a triagem), carimbos de data/hora e notas de revisão em texto livre do conjunto de dados analítico final. Manter apenas o ID de estudo anônimo e as variáveis de análise.
ETAPA CRÍTICA: Aplicar a sequência de triagem na mesma ordem a todos os registros e não reinserir casos previamente excluídos em etapas posteriores. Atribuir o primeiro critério de exclusão acionado como razão principal de exclusão e registrar bandeiras secundárias apenas como anotações no log de triagem.
NOTA: Resumir as contagens finais de exclusão por motivo na Tabela 2 e manter essas contagens idênticas ao fluxo de participantes relatado posteriormente na Figura 1.
| Ordem de triagem | Item de triagem | Regra operacional | Ação de triagem | Regra de documentação |
| Etapa 1 | Preservação da exportação bruta | Exportar todos os registros retornados imediatamente após o encerramento da pesquisa e salvá-los como raw_returns_YYYYMMDD.csv e raw_returns_YYYYMMDD.xlsx | Preservar uma cópia somente leitura antes de iniciar qualquer limpeza | Arquivar na pasta de dados brutos |
| Etapa 2 | Verificação de consentimento e acesso | Identificar registros sem consentimento informado eletrônico ativo antes do acesso ao questionário | Excluir registros sem consentimento do fluxo de trabalho analítico | Registrar registros excluídos ou inacessíveis no arquivo screening_log_v1.xlsx quando mantidos na exportação da plataforma |
| Etapa 3 | Triagem de duplicatas | Identificar registros que compartilham o mesmo identificador limitado por dispositivo ou identificador limitado por conta dentro do mesmo ciclo de coleta e que coincidam em sexo, idade, ano acadêmico e pelo menos 80% das respostas ao questionário | Manter o registro completo mais antigo e excluir todas as duplicatas posteriores | Registrar a contagem de exclusões e os valores de raw_record_id afetados no arquivo screening_log_v1.xlsx; atribuir primary exclusion_reason = 1 |
| Etapa 4 | Reconciliação de duplicatas em múltiplos dispositivos | Identificar múltiplos envios completos do mesmo participante autenticado em contas diferentes em dispositivos distintos | Tratar esses registros como envios duplicados; manter o registro completo mais antigo | Registrar o identificador limitado por conta e o raw_record_id mantido no arquivo screening_log_v1.xlsx; atribuir aos registros posteriores primary exclusion_reason = 1 |
| Etapa 5 | Triagem por tempo de conclusão | Identificar todos os questionários com tempo de conclusão <180 s | Excluir automaticamente todos esses registros | Registrar a contagem de exclusões no arquivo screening_log_v1.xlsx; atribuir primary exclusion_reason = 2 |
| Etapa 6 | Revisão de velocidade limítrofe | Identificar todos os questionários com tempo de conclusão entre 180 e 240 s | Revisar manualmente cada registro usando indicadores de atenção, sequências longas, desvio padrão intra-indivíduo e flags lógicas; manter apenas se nenhum flag adicional estiver presente | Registrar cada caso como retained_after_manual_review = 1 ou excluded_after_manual_review = 1 no arquivo screening_log_v1.xlsx |
| Etapa 7 | Triagem por verificação de atenção | Identificar todos os registros que falharam no item de verificação de atenção com resposta direcionada | Excluir todos os registros reprovados que ainda não tenham sido excluídos em etapas anteriores | Registrar a contagem de exclusões no arquivo screening_log_v1.xlsx; atribuir primary exclusion_reason = 3 |
| Etapa 8 | Triagem por padrão de resposta | Identificar registros com 18 ou mais respostas idênticas consecutivas nos 36 itens da escala pontuada, ou desvio padrão intra-indivíduo ≤0,25 nesses itens | Excluir todos esses registros que ainda não tenham sido excluídos em etapas anteriores | Registrar a contagem de exclusões no arquivo screening_log_v1.xlsx; atribuir primary exclusion_reason = 4 |
| Etapa 9 | Triagem por consistência lógica | Identificar registros que apresentam a combinação comportamental impossível previamente especificada: weekday_internet_use e weekend_internet_use ambos codificados como <2 h, late_night_use codificado como quase todas as noites e pontuação 5 em pelo menos 18 dos 20 itens do IAT | Excluir todos esses registros que ainda não tenham sido excluídos em etapas anteriores | Registrar a contagem de exclusões e nota de revisão no arquivo screening_log_v1.xlsx; atribuir primary exclusion_reason = 5 |
| Etapa 10 | Triagem por ausência de dados essenciais | Identificar registros com qualquer valor ausente em IAT_1–IAT_20, DERS_1–DERS_16, idade, sexo, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity ou academic_stress; a opção “prefiro não responder” para sexo é considerada resposta válida, não como ausente | Excluir todos esses registros que ainda não tenham sido excluídos em etapas anteriores | Registrar a contagem de exclusões no arquivo screening_log_v1.xlsx; atribuir primary exclusion_reason = 6 |
| Etapa 11 | Atribuição de exclusão primária | Identificar registros que atendem a mais de um critério de exclusão | Atribuir o primeiro critério acionado na sequência pré-especificada de triagem como razão primária de exclusão | Registrar flags secundários apenas nas notas de revisão; não atribuir múltiplas razões primárias |
| Etapa 12 | Remoção de identificadores técnicos | Identificar identificadores de resposta gerados pela plataforma, identificadores limitados por dispositivo, identificadores limitados por conta, carimbos de data/hora e quaisquer metadados técnicos temporariamente mantidos no arquivo limpo | Remover esses campos do conjunto de dados analítico final após a conclusão da triagem | Documentar a remoção no arquivo screening_log_v1.xlsx |
| Etapa 13 | Retenção final | Manter todos os registros que passaram por todas as etapas anteriores de triagem | Atribuir um ID de estudo anônimo a cada registro mantido | Salvar como analytic_dataset_v1.csv e analytic_dataset_v1.xlsx |
| Etapa 14 | Resumo da triagem | Contar o número de registros removidos em cada etapa e o número final retido | Resumir as contagens finais para relato no manuscrito | Manter as contagens na Tabela 2 idênticas às do Gráfico 1 |
| Etapa 15 | Preservação do histórico de auditoria | Preservar o arquivo bruto, o log de triagem e o conjunto de dados analítico final como arquivos separados | Não sobrescrever, mesclar ou editar manualmente arquivos-fonte arquivados | Armazenar em pastas separadas: dados brutos, triagem e analítico |
Tabela 2: Sequência predefinida de triagem, limiares de exclusão, ações de triagem e regras de documentação para a limpeza do questionário. Esta tabela resume a ordem fixa de triagem utilizada para limpar os questionários devolvidos, incluindo verificações de consentimento e acesso, triagem de duplicatas, reconciliação de múltiplos dispositivos, triagem do tempo de conclusão, revisão de velocidade limítrofe, falha no teste de atenção, respostas padronizadas, inconsistência lógica, ausência de dados essenciais, remoção de identificadores técnicos, retenção final e preservação do histórico de auditoria. Abreviaturas: IAT = teste de dependência da internet; DERS-16 = escala de dificuldades na regulação emocional com 16 itens. Clique aqui para baixar esta tabela.
5. Avaliar variáveis, verificar confiabilidade e preparar o arquivo pronto para análise
- Gerar pontuações totais, pontuações de subescalas e variáveis categóricas derivadas
- Somar as pontuações dos 20 itens do IAT para gerar a pontuação total de vício em internet, depois armazenar tanto a pontuação contínua quanto a classe de gravidade de três níveis no arquivo pronto para análise.
- Recodificar os itens 1, 6 e 8 do DERS-16, calcular a pontuação total e as cinco pontuações de subescala e acrescentar todas as variáveis derivadas ao mesmo conjunto de dados por participante.
- Executar uma verificação de intervalo antes do cálculo das pontuações. Confirmar que todos os valores dos itens do IAT e do DERS-16 estão entre 1 e 5, que todos os valores recodificados estão entre 1 e 5, que as pontuações totais do IAT estão entre 20 e 100 e que as pontuações totais do DERS-16 estão entre 16 e 80. Registrar a saída da verificação de intervalo no registro de pontuação.
- Recodificar covariáveis em categorias analíticas fixas
- Recodificar a duração do uso da internet em dias úteis e finais de semana como <2 h, 2–3,9 h, 4–5,9 h e ≥6 h. Recodificar o uso da internet durante a madrugada como nunca, <1 noite/semana, 1–2 noites/semana, 3–5 noites/semana e quase todas as noites.
- Recodificar duração do sono, frequência de atividade física e estresse acadêmico percebido usando as regras de categorização pré-especificadas definidas na Seção 1.4 e armazenar os valores recodificados sob nomes fixos de variáveis no mesmo conjunto de dados.
- Recodificar o sexo para regressão usando duas variáveis indicadoras: feminino versus masculino e prefiro não informar versus masculino. Relatar a codificação na nota de rodapé da tabela e no README/manual de variáveis.
- Verificar a integridade da pontuação e a consistência interna
- Calcular o alfa de Cronbach para a pontuação total do IAT e para a pontuação total do DERS-16 antes da análise inferencial. Revisar a codificação dos itens, a recodificação inversa e intervalos de itens impossíveis se qualquer valor de alfa for <0,7020. Relatar os valores do alfa de Cronbach na seção Resultados Representativos.
- Calcular correlações item-total ou valores de alfa-se-o-item-for-excluído caso alguma escala apresente consistência interna inesperadamente baixa. Não remover itens da escala da análise primária a menos que a remoção tenha sido pré-especificada ou o estudo tenha sido explicitamente projetado como um estudo de validação psicométrica.
- Salvar o conjunto de dados final pronto para análise juntamente com um arquivo README listando nomes das variáveis, regras de codificação, limiares de exclusão, nomes dos arquivos, versões do software, versão do questionário, sintaxe de pontuação, especificação do modelo de regressão e procedimentos necessários para regenerar o mesmo conjunto de dados.
6. Analisar os dados e preservar as saídas reproduzíveis
- Gerar estatísticas descritivas e comparações entre grupos
- Apresentar variáveis contínuas como média ± desvio padrão e variáveis categóricas como frequência e porcentagem. Resumir as características demográficas, o comportamento de uso da internet e os escores das escalas utilizando a estrutura de saída predefinida.
- Informar o tamanho da amostra utilizado em cada análise. Utilizar a amostra analítica retida como denominador, salvo indicação em contrário em uma tabela.
- Comparar os escores totais e dos subescalas do DERS-16 entre os três grupos de gravidade do IAT e utilizar testes bilaterais com α = 0,05 nas análises principais. Apresentar tamanhos de efeito padronizados quando apropriado.
NOTA: Para comparações entre grupos, informar η2 ou η2 parcial para análise de variância, ou um tamanho de efeito não paramétrico equivalente se um teste não paramétrico for utilizado. Interpretar com cautela comparações do subgrupo com uso problemático grave quando o subgrupo for pequeno. - Calcular a correlação de Pearson entre o escore total do IAT e o escore total do DERS-16 quando ambas as variáveis apresentarem comportamento distribucional aceitável; caso contrário, utilizar a correlação de Spearman como análise de sensibilidade. Apresentar n, r ou ρ, intervalo de confiança de 95% se gerado pelo software estatístico, valor de p e interpretação da magnitude.
- Ajustar o modelo de regressão e arquivar as saídas
- Utilizar o escore total do DERS-16 como variável dependente e o escore total do IAT como variável independente principal. Incluir idade, sexo, uso da internet em dias úteis, uso da internet nos fins de semana, duração do sono, atividade física e estresse acadêmico percebido como covariáveis. Este modelo é a demonstração analítica predefinida do fluxo de trabalho padronizado.
- Antes de interpretar o modelo de regressão ajustado, avaliar os pressupostos da regressão e a estabilidade do modelo. Examinar gráficos de resíduos versus valores ajustados para verificar linearidade e homocedasticidade, examinar um gráfico Q-Q ou teste de normalidade para a distribuição dos resíduos e calcular os fatores de inflação da variância para avaliar multicolinearidade.
- Apresentar esses diagnósticos na seção Resultados Representativos ou na saída da análise suplementar.
- Se for detectada heterocedasticidade dos resíduos, apresentar erros-padrão robustos à heterocedasticidade como análise de sensibilidade.
- Se houver observações influentes, informar se o coeficiente principal para o escore total do IAT permanece substancialmente inalterado após os diagnósticos de influência. Não remover observações influentes a menos que uma regra predefinida de qualidade dos dados seja atendida.
- Apresentar coeficientes não padronizados, erros-padrão, coeficientes padronizados, valores de p, R2 do modelo, R2 ajustado, estatística F do modelo e intervalo de VIF para o modelo ajustado. Incluir o tamanho da amostra no título da tabela ou em nota de rodapé.
- Se forem testadas interações, efeitos de subgrupo ou caminhos de mediação, especificar essas análises antes da coleta de dados ou rotulá-las como exploratórias. O protocolo principal não exige testes de interação, salvo se diferenças de subgrupo forem um objetivo predefinido do estudo.
- Salvar toda a sintaxe estatística, tabelas de saída, gráficos de resíduos, saídas de VIF, saídas de confiabilidade e figuras geradas com nomes de arquivos sob controle de versão. Regenerar todas as saídas relatáveis diretamente de analytic_dataset_v1, e não de arquivos editados manualmente.
NOTA: Manter o texto do protocolo focado na replicação do fluxo de trabalho. Apresentar as estatísticas representativas detalhadas, figuras de subgrupos, diagnósticos de regressão, avaliação de multicolinearidade e saídas do modelo na seção Resultados Representativos.
Resultados
Fluxo do estudo e retenção analítica final
Os resultados demonstram a execução do fluxo de trabalho padronizado do questionário, e não a validação independente do teste de dependência da internet ou do DERS-16. Durante o período de 14 dias da pesquisa, 520 estudantes universitários foram convidados a participar, e 480 questionários foram devolvidos. A triagem foi conduzida na ordem previamente especificada. Primeiro, foram removidas 8 submissões duplicadas, seguidas por 9 questionários com tempo de conclusão inferior a 180 s, 4 questionários que não passaram no item de verificação de atenção com resposta direcionada, 3 questionários que apresentaram respostas padronizadas, 2 questionários com inconsistência lógica e 2 questionários com dados essenciais ausentes. Após a conclusão da sequência completa de triagem, 452 questionários válidos foram mantidos no conjunto final de dados analíticos. A taxa final de retenção foi de 94,2% entre os questionários devolvidos e de 86,9% entre os estudantes convidados. O fluxo do questionário, desde o convite até a retenção analítica final, é apresentado na Figura 1.
Características dos participantes
A amostra analítica final incluiu 452 estudantes, com idade média de 20,41 ± 1,58 anos. As respondentes do sexo feminino constituíram a maior parte da amostra, incluindo 279 estudantes do sexo feminino, 167 do sexo masculino e 6 estudantes que optaram por "preferir não informar". Os participantes foram recrutados de todos os anos acadêmicos e de múltiplas disciplinas, sendo os estudantes do segundo e terceiro ano os que apresentaram as maiores proporções. A maioria dos respondentes residia em dormitórios no campus, e as despesas mensais de manutenção concentraram-se nas categorias de 1.000–1.999 e 2.000–2.999. A amostra retida também apresentou exposição substancial à internet como rotina. Em dias úteis, a distribuição concentrou-se principalmente nas categorias de 2–3,9 h e 4–5,9 h, enquanto o uso nos fins de semana aumentou, com 322 dos 452 estudantes relatando pelo menos 4 h por dia. O acesso por meio de smartphones foi o modo predominante. As atividades online primárias mais frequentemente relatadas foram redes sociais, entretenimento/vídeos e uso relacionado aos estudos. O uso noturno após as 23h era comum, com 228 dos 452 estudantes relatando uso noturno em pelo menos 3 noites por semana. A duração do sono concentrou-se entre 6 e 7,9 h, a atividade física ocorreu mais frequentemente na categoria de 1–2 sessões por semana, e a resposta modal foi estresse acadêmico moderado. O perfil demográfico e comportamental da amostra retida é apresentado na Tabela 3.
| Característica | Categoria | n | % |
| Sexo | Masculino | 167 | 36,9 |
| Feminino | 279 | 61,7 | |
| Prefere não informar | 6 | 1,3 | |
| Ano acadêmico | Primeiro ano | 88 | 19,5 |
| Segundo ano | 124 | 27,4 | |
| Terceiro ano | 131 | 29 | |
| Quarto ano ou superior | 79 | 17,5 | |
| Pós-graduação | 30 | 6,6 | |
| Categoria da disciplina | Humanas e ciências sociais | 118 | 26,1 |
| Ciência e engenharia | 96 | 21,2 | |
| Administração e negócios | 104 | 23 | |
| Artes e design | 82 | 18,1 | |
| Outra | 52 | 11,5 | |
| Tipo de residência | Residência no campus | 301 | 66,6 |
| Aluguel fora do campus | 79 | 17,5 | |
| Casa da família | 58 | 12,8 | |
| Outra | 14 | 3,1 | |
| Despesas mensais de vida, CNY | <1.000 | 61 | 13,5 |
| 1.000–1.999 | 176 | 38,9 | |
| 2.000–2.999 | 149 | 33 | |
| ≥3.000 | 66 | 14,6 | |
| Uso da internet em dias úteis | <2 h | 52 | 11,5 |
| 2–3,9 h | 157 | 34,7 | |
| 4–5,9 h | 166 | 36,7 | |
| ≥6 h | 77 | 17 | |
| <2 h | 29 | 6,4 | |
| 2–3,9 h | 101 | 22,3 | |
| 4–5,9 h | 178 | 39,4 | |
| ≥6 h | 144 | 31,9 | |
| Atividade online principal | Estudo | 74 | 16,4 |
| Redes sociais | 126 | 27,9 | |
| Jogos | 61 | 13,5 | |
| Entretenimento/vídeo | 102 | 22,6 | |
| Compras | 28 | 6,2 | |
| Uso misto | 47 | 10,4 | |
| Outra | 14 | 3,1 | |
| Dispositivo principal de acesso | Smartphone | 323 | 71,5 |
| Tablet | 18 | 4 | |
| Computador portátil ou desktop | 67 | 14,8 | |
| Dispositivos mistos | 44 | 9,7 | |
| Uso noturno após às 23h | Nunca | 48 | 10,6 |
| Menos de uma vez por semana | 57 | 12,6 | |
| 1–2 noites/semana | 119 | 26,3 | |
| 3–5 noites/semana | 141 | 31,2 | |
| Quase todas as noites | 87 | 19,2 | |
| Duração do sono | <6 h | 83 | 18,4 |
| 6–6,9 h | 146 | 32,3 | |
| 7–7,9 h | 157 | 34,7 | |
| ≥8 h | 66 | 14,6 | |
| Atividade física semanal | Nenhuma | 91 | 20,1 |
| 1–2 sessões | 176 | 38,9 | |
| 3–4 sessões | 128 | 28,3 | |
| ≥5 sessões | 57 | 12,6 | |
| Estresse acadêmico | Baixo | 73 | 16,2 |
| Moderado | 241 | 53,3 | |
| Alto | 138 | 30,5 | |
| Idade, anos | Média ± DP | 20,41 ± 1,58 | — |
Tabela 3: Características demográficas e comportamentais basais da amostra retida. Esta tabela apresenta o perfil demográfico e as características de uso da internet da amostra final retida após triagem pré-especificada. As variáveis incluem sexo, ano acadêmico, categoria de disciplina, tipo de residência, despesas mensais de manutenção, uso da internet em dias úteis e finais de semana, atividade online principal, dispositivo principal de acesso, uso noturno após as 23h, duração do sono, atividade física semanal, estresse acadêmico e idade. Abreviações: CNY = yuan chinês; SD = desvio padrão. Clique aqui para baixar esta tabela.
Gravidade da dependência da internet, resultados da regulação emocional e confiabilidade
Na amostra total retida (n = 452), a pontuação média total no teste de vício em Internet foi de 51,94 ± 16,58. De acordo com os limiares de gravidade pré-especificados, 200 respondentes foram classificados como usuários normais, 239 como usuários problemáticos e 13 como usuários com problemas graves, tornando o grupo de uso problemático o maior subgrupo. A pontuação média total no DERS-16 na amostra retida foi de 35,95 ± 8,89. O teste de vício em Internet apresentou consistência interna aceitável, com um alfa de Cronbach de 0,91, e o DERS-16 também apresentou consistência interna aceitável, com um alfa de Cronbach de 0,88. Ao analisar as pontuações totais do DERS-16 nos três grupos de gravidade do IAT, observou-se que o grupo de uso normal apresentou a média mais baixa, o grupo de uso problemático apresentou uma média mais alta e o grupo de uso problemático grave apresentou a média mais elevada. A comparação entre grupos para a pontuação total do DERS-16 foi estatisticamente significativa na amostra retida (n = 452; F = 72,80, p < 0,001; η2 = 0,245). O mesmo padrão direcional foi observado nos resumos das subescalas do DERS-16. Como o subgrupo de uso problemático grave era pequeno (n = 13), os valores desse subgrupo são apresentados como parte do padrão distribucional geral, e não como base para inferências detalhadas sobre o subgrupo grave. A gravidade do vício em Internet e os resultados relacionados à regulação emocional estão resumidos na Tabela 4.
| Medida | Uso normal | Uso problemático | Uso problemático grave | Total |
| n = 200 | n = 239 | n = 13 | n = 452 | |
| Pontuação total no IAT | 34,20 ± 3,90 | 65,33 ± 6,90 | 78,70 ± 6,20 | 51,94 ± 16,58 |
| Pontuação total no DERS-16 | 31,20 ± 7,10 | 39,24 ± 8,30 | 48,50 ± 9,60 | 35,95 ± 8,89 |
| DERS-16 não aceitação | 5,90 ± 1,90 | 7,29 ± 2,10 | 8,90 ± 2,40 | 6,72 ± 2,16 |
| DERS-16 metas | 6,20 ± 1,80 | 7,82 ± 2,00 | 9,10 ± 2,30 | 7,14 ± 2,09 |
| DERS-16 impulso | 5,80 ± 1,70 | 7,72 ± 2,10 | 9,40 ± 2,50 | 6,92 ± 2,19 |
| DERS-16 estratégias | 9,60 ± 2,90 | 12,29 ± 3,30 | 15,10 ± 3,80 | 11,18 ± 3,44 |
| DERS-16 clareza | 3,70 ± 1,30 | 4,18 ± 1,40 | 5,00 ± 1,60 | 3,99 ± 1,41 |
| Alfa de Cronbach do IAT | — | — | — | 0,91 |
| Alfa de Cronbach do DERS-16 | — | — | — | 0,88 |
| Comparação total entre grupos no DERS-16 | — | — | — | F = 72,80; p < 0,001; η² = 0,245 |
| Correlação de Pearson entre pontuação total no IAT e pontuação total no DERS-16 | — | — | — | n = 452; r = 0,524; IC 95%: 0,45–0,59; p < 0,001 |
Tabela 4: Grupos de gravidade da dependência da internet, resultados da regulação emocional, confiabilidade e correlação na amostra analítica final. Esta tabela apresenta os escores totais do IAT, os escores totais do DERS-16 e os valores dos subscales do DERS-16 nos grupos de uso normal, uso problemático e uso problemático grave. Também são apresentadas as médias gerais da amostra, os valores alfa de Cronbach para o IAT e o DERS-16, a comparação entre grupos quanto ao escore total do DERS-16 e a correlação de Pearson entre o escore total do IAT e o escore total do DERS-16. Abreviações: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale; CI = intervalo de confiança; DP = desvio padrão. Clique aqui para baixar esta tabela.
Associação entre vício em internet e regulação emocional
A associação pré-definida com pontuação contínua foi avaliada entre a pontuação total do IAT e a pontuação total do DERS-16 na amostra analítica retida (n = 452). A correlação de Pearson entre a pontuação total do IAT e a pontuação total do DERS-16 foi positiva e de magnitude moderada (r = 0.524, 95% CI: 0.45–0.59, p < 0.001). Portanto, estudantes com pontuações totais mais altas no IAT tenderam a relatar maior dificuldade geral na regulação emocional. Esse resultado foi consistente com a distribuição por grupo de gravidade e não dependeu exclusivamente da classificação categórica do IAT, conforme mostrado na Tabela 4.
Análise de regressão multivariável
O modelo de regressão ajustado incluiu a amostra analítica retida (n = 452). A pontuação total do DERS-16 foi inserida como variável dependente, e a pontuação total do IAT foi inserida como variável independente principal. Idade, sexo, uso da internet em dias úteis, uso da internet nos fins de semana, duração do sono, atividade física semanal e estresse acadêmico foram incluídos como covariáveis no mesmo modelo. O sexo foi inserido utilizando codificação pré-especificada por variável indicadora, com masculino como categoria de referência e indicadores separados para feminino e prefere não informar. Após o ajuste, a pontuação total do IAT manteve-se positivamente associada à pontuação total do DERS-16 (B = 0,21, SE = 0,02, β = 0,39, p < 0,001). Dentre as covariáveis, o estresse acadêmico mostrou associação positiva com a pontuação total do DERS-16 (B = 2,36, β = 0,23, p < 0,001), enquanto a duração do sono (B = -1,12, β = -0,13, p < 0,001) e a atividade física semanal (B = -0,84, β = -0,10, p = 0,003) apresentaram associação negativa com a pontuação total do DERS-16. O uso da internet em dias úteis manteve um coeficiente positivo menor após o ajuste (B = 0,71, β = 0,09, p = 0,015), enquanto o uso da internet nos fins de semana não permaneceu estatisticamente robusto no modelo ajustado (B = 0,49, β = 0,07, p = 0,071). A idade e ambos os indicadores de sexo não foram preditores independentes significativos na mesma especificação. O modelo explicou 39,8% da variância na pontuação total do DERS-16, com um R2 ajustado de 0,386, e o modelo geral foi estatisticamente significativo, F(9, 442) = 32,47, p < 0,001. Não houve evidência de multicolinearidade, com fatores de inflação da variância variando de 1,03 a 1,42. Os diagnósticos dos resíduos não indicaram violação grave dos pressupostos de linearidade ou homocedasticidade na inspeção do gráfico de resíduos versus valores ajustados. O gráfico Q-Q dos resíduos não mostrou desvios substanciais da normalidade aproximada. O teste de Breusch-Pagan não foi estatisticamente significativo, p = 0,214. A distância máxima de Cook foi 0,18, e nenhuma observação excedeu uma distância de Cook de 0,50. O modelo de regressão ajustado é apresentado na Tabela 5.
| Preditor | B | EP | β | t | p | VIF |
| Constante | 18,42 | 2,11 | — | 8,73 | <0,001 | — |
| Pontuação total no IAT | 0,21 | 0,02 | 0,39 | 9,84 | <0,001 | 1,42 |
| Idade | 0,18 | 0,11 | 0,03 | 1,64 | 0,102 | 1,08 |
| Sexo, feminino versus masculino | 0,62 | 0,54 | 0,04 | 1,15 | 0,252 | 1,05 |
| Sexo, prefiro não informar versus masculino | 0,28 | 1,89 | 0,01 | 0,15 | 0,882 | 1,03 |
| Uso da internet em dias úteis | 0,71 | 0,29 | 0,09 | 2,45 | 0,015 | 1,36 |
| Uso da internet nos fins de semana | 0,49 | 0,27 | 0,07 | 1,81 | 0,071 | 1,31 |
| Duração do sono | -1,12 | 0,31 | -0,13 | -3,61 | <0,001 | 1,18 |
| Atividade física semanal | -0,84 | 0,28 | -0,1 | -3 | 0,003 | 1,12 |
| Estresse acadêmico | 2,36 | 0,39 | 0,23 | 6,05 | <0,001 | 1,27 |
Tabela 5: Regressão linear multivariável da pontuação total do DERS-16 sobre a pontuação total do IAT e covariáveis na amostra analítica final. Esta tabela apresenta o modelo de regressão ajustado com a pontuação total do DERS-16 como variável dependente e a pontuação total do IAT como variável independente principal. Foram incluídas idade, sexo, uso da internet em dias úteis, uso da internet nos fins de semana, duração do sono, atividade física semanal e estresse acadêmico como covariáveis. A tabela também informa os coeficientes padronizados, os fatores de inflação da variância e os diagnósticos do modelo. Abreviaturas: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale; VIF = variance inflation factor. Clique aqui para baixar esta tabela.
Tabela Suplementar 1: Dicionário completo de variáveis, presença de arquivos, estrutura de codificação e campos de gerenciamento de dados utilizados no fluxo de trabalho do questionário padronizado. Esta tabela suplementar fornece o dicionário completo de variáveis para o protocolo, incluindo variáveis de ética e consentimento, variáveis de configuração do questionário, variáveis demográficas, variáveis de uso da internet, indicadores de controle de qualidade, itens de escalas, escores derivados, covariáveis, campos técnicos de identificação, variáveis de rastreamento de conjunto de dados, informações sobre status de arquivos e regras de codificação. Abreviações: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale.Clique aqui para baixar este arquivo.
Arquivo Suplementar 1: Materiais complementares do fluxo de trabalho do questionário. Este arquivo suplementar contém os arquivos do questionário, o código de variáveis, o registro de triagem, o plano de saída e os materiais do fluxo de trabalho prontos para análise, utilizados para reproduzir o fluxo de trabalho padronizado de aplicação do questionário, triagem, pontuação e análise.Clique aqui para baixar este arquivo.
Discussão
A principal contribuição deste artigo é o fluxo de trabalho padronizado do questionário, e não a associação representativa observada entre vício na internet e dificuldade na regulação emocional. A implementação mostrou que uma sequência fixa de consentimento eletrônico, itens demográficos, comportamento de uso da internet, pontuação no IAT, pontuação no DERS-16, coleta de covariáveis, triagem sequencial da qualidade dos dados e análise de regressão reproduzível pode ser executada em uma amostra de estudantes universitários. Essa ênfase procedimental é importante porque o uso problemático da internet frequentemente está associado à desregulação emocional na literatura, mas procedimentos inconsistentes de aplicação e limpeza dos dados podem dificultar a comparação dos resultados entre estudos21. O fluxo de trabalho atual, portanto, favorece a comparabilidade ao tornar explícita a ordem das medições, as regras de exclusão, os passos de pontuação e os resultados analíticos antes do início da interpretação.
Várias etapas do procedimento são especialmente críticas para a reprodutibilidade. Primeiro, o consentimento eletrônico deve ser concluído antes do acesso ao questionário, e os identificadores técnicos utilizados para a triagem de duplicatas devem ser separados do conjunto de dados analítico final anonimizado. Segundo, a triagem de duplicatas deve preceder a triagem com base no tempo de conclusão, a revisão dos testes de atenção, a triagem de respostas padronizadas, a revisão de consistência lógica e as verificações de dados ausentes, pois alterar essa ordem pode modificar a amostra final mantida. Terceiro, os procedimentos de pontuação do IAT e do DERS-16 devem ser definidos antes da coleta de dados, incluindo a inversão de itens e a classificação de gravidade. Essas etapas reduzem a variação evitável na pesquisa por meio de questionários online e estão de acordo com preocupações mais amplas de que os achados sobre vício na internet podem ser influenciados pelo estresse, pelo autocontrole e pela ansiedade, bem como por diferenças nos procedimentos de mensuração22.
O protocolo também exige várias verificações de solução de problemas durante a implementação. Se a plataforma de pesquisa não puder restringir submissões repetidas, a triagem de duplicatas deve se basear em uma combinação de identificadores limitados por conta, identificadores limitados por dispositivo, carimbos de data e hora, status do questionário e similaridade de padrão de respostas. Se muitos registros estiverem dentro da faixa de velocidade limítrofe, o resultado do teste de atenção, a contagem de respostas com sequência longa, o desvio padrão intra-individual e o indicador de consistência lógica devem ser revisados em conjunto, em vez de usar apenas o tempo de conclusão. Se o alfa de Cronbach for inesperadamente baixo, devem-se verificar a codificação dos itens, a codificação reversa e os intervalos de pontuação antes de tomar qualquer decisão em nível de item. Esses procedimentos são particularmente relevantes porque comportamentos relacionados à internet e ao uso de smartphones estão associados aos processos de sono e regulação emocional, tornando a triagem descuidada ou a codificação incorreta uma possível fonte de inferência distorcida23.
Os limiares de exclusão utilizados na implementação representativa devem ser tratados como padronizados dentro deste fluxo de trabalho, mas não como universalmente fixos para todas as populações futuras. O limiar inferior de tempo de conclusão de 180 s foi derivado de testes-piloto e deve ser recalibrado quando o protocolo for aplicado a adultos mais velhos, adolescentes, respondentes multilíngues, questionários adaptados para acessibilidade ou plataformas com formatos de exibição diferentes. A regra de inconsistência lógica e os critérios de resposta padronizada também podem exigir ajustes quando o comprimento da escala, a ordem dos itens ou os pontos de resposta forem diferentes. Da mesma forma, o subgrupo pequeno, mas com uso problemático grave, na implementação representativa indica que estudos projetados para comparações entre subgrupos devem aumentar as metas de recrutamento ou usar amostragem estratificada antes da coleta de dados. Essa flexibilidade é importante porque variáveis comportamentais e de estilo de vida, incluindo atividade física, podem interagir com atenção, ruminação e autorregulação de maneiras que variam entre grupos de estudantes24.
Várias limitações devem ser consideradas ao aplicar este protocolo. O fluxo de trabalho utiliza instrumentos de autorrelato, de modo que erros de recordação, viés de desejabilidade social e variância comum por método podem influenciar tanto as medidas de exposição quanto as de desfecho. Esses riscos podem ser reduzidos, mas não eliminados, utilizando redação neutra, ordem fixa do questionário, verificações de atenção, covariáveis pré-especificadas e relato transparente de omissões e exclusões. Estudos futuros também podem incorporar medidas objetivas digitais de comportamento, como registros de tempo de tela do smartphone, registros de uso de aplicativos ou resumos de uso baseados em plataformas, para fortalecer a validade de construto. No entanto, essas adições exigem linguagem de consentimento separada, salvaguardas de privacidade, procedimentos de minimização de dados e regras de vinculação. Assim, devem ser adicionadas como extensões planejadas do protocolo, e não como acréscimos informais ao fluxo de trabalho do questionário25.
O protocolo é adaptável, mas não deve ser transferido mecanicamente para todos os contextos. Em populações fora do ambiente universitário, os critérios de elegibilidade, canais de recrutamento, itens relacionados ao estresse acadêmico e categorias de uso da internet podem precisar ser revistos. Em estudos multinacionais multicêntricos, devem ser documentados previamente a tradução, a adaptação cultural, a equivalência entre plataformas, o tratamento de fusos horários, as regras de proteção de dados e o monitoramento em nível de centro antes da consolidação dos dados. Se o TAI for substituído por uma medida mais recente ou específica para determinada população, o fluxo de trabalho ainda poderá ser mantido, mas a faixa de pontuação, os limiares de gravidade, o código de variáveis, a sintaxe, Tabela de Materiais e o dicionário complementar de variáveis devem ser atualizados antes da coleta de dados. Essa distinção entre a duração do uso da internet e o uso desregulado é importante, porque o tempo online isolado pode não captar o mesmo constructo que o uso problemático ou compulsivo26.
Por fim, a implementação representativa foi transversal e não deve ser interpretada como evidência de direção temporal. A associação observada entre a pontuação total do IAT e a pontuação total do DERS-16 demonstra como o caminho analítico opera, e não se a dificuldade na regulação emocional causa o uso problemático da internet ou se o uso problemático da internet agrava a regulação emocional ao longo do tempo. Padrões transversais semelhantes foram relatados em outros ambientes universitários, mas são necessárias aplicações longitudinais ou com medidas repetidas para examinar a direcionalidade e as mudanças27. O valor do presente protocolo é que ele fornece um fluxo de trabalho estável e de linha de base para esse trabalho futuro. Padronizando consentimento, aplicação de questionários, triagem, pontuação, verificações de confiabilidade, diagnósticos de modelos, arquivamento de arquivos e documentação complementar, o protocolo pode apoiar estudos transversais mais reprodutíveis e pode ser estendido a desenhos longitudinais ou de intervenção quando questões temporais se tornarem o objetivo principal28. A inclusão de um dicionário de dados, registro de triagem, plano de saída e materiais de fluxo de trabalho prontos para análise também está alinhada aos princípios de documentação de software e fluxos de trabalho de pesquisa orientados ao FAIR29 e às recomendações mais amplas de ciência aberta para relatos transparentes e reprodutíveis30.
Divulgações
O autor não tem nada a declarar.
Agradecimentos
Este trabalho foi apoiado pelo Projeto de Ciência Macia da Província de Henan em 2025, “Pesquisa sobre o Impacto e Caminho de Otimização das Mudanças na População em Idade Escolar no Desenvolvimento de Alta Qualidade do Ensino Superior Particular na Província de Henan” (Número do Projeto: 252400410490), e pelo Projeto de Fundo de Pesquisa de Doutorado da Universidade de Economia e Negócios de Zhengzhou em 2025, “Pesquisa sobre o Mecanismo de Formação e Mecanismo de Orientação da Opinião Pública do Comportamento em Grupo na Rede dos Estudantes Universitários”. O autor agradece à Universidade de Economia e Negócios de Zhengzhou pelo apoio institucional.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Conjunto de dados pronto para análise | Documento interno específico do estudo | analytic_dataset_v1.csv e analytic_dataset_v1.xlsx | Conjunto de dados final anônimo utilizado em todas as análises descritivas, de confiabilidade, de correlação e de regressão passíveis de relato |
| Sintaxe de análise | Documento interno específico do estudo | analysis_syntax_v1.R ou arquivo de script equivalente | Utilizado para reproduzir a verificação de pontuação, verificações de confiabilidade, estatísticas descritivas, análise de correlação, modelagem de regressão, cálculo de VIF e saídas diagnósticas |
| Formulação do item de verificação de atenção | Documento interno específico do estudo | attention_check_v1.txt | Formulação fixa do item de verificação de atenção de resposta direcionada utilizado durante a aplicação do questionário |
| Questionário DERS-16 | Fonte original da escala ou versão autorizada/adaptada do questionário | Escalas de Dificuldades na Regulação Emocional de 16 itens, versão curta | Utilizado para avaliar dificuldades na regulação emocional; a pontuação segue a chave de pontuação DERS-16 fixa documentada no código |
| Folha eletrônica de informações e página de consentimento | Documento interno específico do estudo | consent_form_v1.pdf ou página de consentimento da plataforma | Utilizada para fornecer informações sobre o estudo e obter consentimento informado eletrônico antes do acesso ao questionário |
| Folha de convenção de nomenclatura de arquivos | Documento interno específico do estudo | file_naming_convention_v1.xlsx | Utilizada para padronizar nomes de arquivos brutos, limpos, analíticos, de registro de triagem, de código e de saída |
| Capturas de tela finais do questionário | Documento interno específico do estudo | questionnaire_screenshots_v1.pdf | Utilizada para documentar a exibição fixa da pesquisa, ordem dos itens, pontos de resposta e configurações de itens obrigatórios |
| Ambiente de desenvolvimento integrado | Posit | RStudio Desktop | Utilizado para gerenciar scripts, registros e fluxos de trabalho analíticos reprodutíveis |
| Questionário do Teste de Vício em Internet | Fonte original da escala ou versão autorizada/adaptada do questionário | Teste de Vício em Internet de 20 itens | Utilizado para avaliar sintomas de vício em internet e classificar uso normal, uso problemático e uso problemático grave |
| Plataforma online de pesquisa | Qualtrics | Plataforma XM; conta institucional ou licenciada | Utilizada para construir o questionário, impor itens obrigatórios, gerenciar acesso baseado em consentimento, restringir submissões repetidas quando habilitado e exportar dados de resposta |
| Pacote estatístico opcional com menu | IBM | SPSS Statistics | Utilizado quando um fluxo de trabalho de análise baseado em interface gráfica (GUI) é necessário para estatísticas descritivas, verificações de confiabilidade ou análise de regressão |
| Arquivo README/código | Documento interno específico do estudo | README_v1.txt ou codebook_v1.xlsx | Utilizado para documentar nomes de variáveis, regras de codificação, intervalos de pontuação, regras de inversão de codificação, limiares de exclusão, nomes de arquivos e versões de software |
| Cópia arquivada somente leitura | Formato de documento portátil | PDF/A ou PDF arquivado aprovado pela instituição | Utilizado para preservar o instrumento de pesquisa fixo, a página de consentimento e os documentos de apoio ao protocolo |
| Planilha de registro de triagem | Documento interno específico do estudo | screening_log_v1.xlsx | Utilizada para documentar triagem de duplicatas, triagem por tempo de conclusão, falhas no item de verificação de atenção, respostas padronizadas, inconsistências lógicas, dados ausentes, decisões de revisão manual e contagens finais retidas |
| Software de planilha eletrônica | Microsoft | Formato de pasta de trabalho do Microsoft Excel (.xlsx) | Utilizado para registros de triagem, dicionário de variáveis, registros de revisão manual e preparação de pastas de trabalho suplementares |
| Ambiente de computação estatística | Fundação R / CRAN | R 4.5.3 | Utilizado para verificação de pontuação, estatísticas descritivas, verificações de confiabilidade, análise de correlação, análise de regressão, cálculo de VIF e saídas diagnósticas |
| Arquivo Suplementar 1 | Arquivo suplementar específico do estudo | Arquivo Suplementar 1.xlsx | Contém materiais do fluxo de trabalho do questionário, código, registro de triagem, plano de saída e materiais do fluxo de trabalho prontos para análise |
| Tabela Suplementar S1 | Tabela suplementar específica do estudo | Tabela Suplementar S1 | Fornece o dicionário completo de variáveis, presença de arquivos, estrutura de codificação, campos de identificadores técnicos, variáveis de triagem e campos de rastreamento do conjunto de dados |
| Documento de exportação da pesquisa | Qualtrics | Exportação do tipo pesquisa para Word ou exportação em PDF | Utilizado para arquivar a formulação final do questionário, ordem dos itens, configurações de ramificação, configurações de itens obrigatórios e codificação de respostas |
| Formato de exportação da pesquisa | Qualtrics | Exportação CSV | Utilizado para preservação dos dados brutos e exportação de dados prontos para análise |
Referências
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.