Este estudo retrospectivo de centro único desenvolveu e validou internamente um modelo de regressão logística para isquemia cerebral tardia após hemorragia subaracnoidea aneurismática. Em 680 pacientes, seis variáveis clínicas, laboratoriais e de imagem precoces mostraram valor preditivo preliminar. É necessária validação externa adicional antes da aplicação clínica.
Artigo de investigação
Validação Interna de um Modelo de Predição Clínica para Isquemia Cerebral Tardia após Hemorragia Subaracnoide Aneurismática
Neste artigo
Resumo
Resumo
A isquemia cerebral tardia (ICT) é uma causa importante de lesão neurológica secundária após hemorragia subaracnoidea aneurismática (HSAA). Este estudo retrospectivo de centro único desenvolveu e avaliou modelos preditivos para ICT utilizando dados de 680 pacientes adultos com HSAA tratados entre julho de 2022 e dezembro de 2024. Os pacientes foram divididos, por meio de uma divisão estratificada por desfecho de 8:2, em uma coorte de treinamento com 544 pacientes e uma coorte de validação interna retida com 136 pacientes. A ICT ocorreu em 175 pacientes na coorte de treinamento e em 42 pacientes na coorte de validação interna. A seleção de preditores foi realizada na coorte de treinamento utilizando regressão com operador de encolhimento e seleção por mínimos absolutos com validação cruzada de 10 dobras. Seis variáveis foram mantidas: idade, edema cerebral, hipoalbuminemia, grau modificado de Fisher, grau de Hunt-Hess e grau da Federação Mundial de Neurocirurgiões. Modelos de regressão logística, boosting extremo por gradiente, máquina de boosting por gradiente leve, máquina de vetores de suporte e vizinho mais próximo k foram comparados. A regressão logística apresentou uma área sob a curva característica de operação do receptor de 0,832 (intervalo de confiança de 95%, 0,758–0,906) na coorte de validação interna. Sua inclinação de calibração, intercepto de calibração e escore de Brier foram 0,98, 0,02 e 0,168, respectivamente, embora os intervalos de confiança para essas estimativas de calibração não estivessem disponíveis. Os achados representam um desempenho preliminar em uma única coorte de validação interna retida. Registros de reprodutibilidade incompletos, a ausência do intercepto do modelo, a falta de correção de otimismo baseada em reamostragem e a ausência de validação externa atualmente impedem o cálculo de probabilidade em nível individual de pacientes e a implementação clínica.
Introdução
Vários modelos preditivos para DCI após aSAH foram propostos, mas muitos foram limitados por tamanhos amostrais pequenos, avaliação incompleta de calibração, relato insuficiente dos procedimentos de desenvolvimento do modelo e ausência de validação externa. Muitos estudos focaram-se principalmente na discriminação, enquanto calibração, reprodutibilidade e avaliação do impacto clínico foram relatadas de forma menos consistente. Portanto, o desempenho do modelo deve ser avaliado usando métodos transparentes e interpretado com cautela quando a validação estiver limitada a um único centro.
O presente estudo teve como objetivo desenvolver e avaliar internamente modelos preditivos para DCI utilizando variáveis clínicas, laboratoriais e de imagem rotineiramente disponíveis e obtidas precocemente. Cinco abordagens de modelagem foram comparadas utilizando o mesmo conjunto de preditores selecionados. O ponto temporal pretendido para a predição foi após a avaliação inicial de admissão, laboratorial e de imagem, mas antes do período principal de risco de DCI. Os modelos foram desenvolvidos para estimativa de risco com base em pesquisa e não tinham a finalidade de diagnosticar DCI, substituir o julgamento clínico ou determinar independentemente o tratamento. Validação externa, recodificação e testes de impacto clínico são necessários antes da aplicação clínica.
A isquemia cerebral tardia (ICT) é um desses agravos secundários que tem sido um dos quadros clinicamente mais significativos e potencialmente preveníveis após a HSAa. A ICT é uma complicação que geralmente surge vários dias após o evento inicial, tipicamente entre 3 e 14 dias, e está associada a novos déficits neurológicos focais, piora do nível de consciência e/ou surgimento de infarto cerebral na neuroimagem subsequente. Embora existam algumas diferenças nas práticas diagnósticas entre instituições, a ICT está sempre relacionada a uma longa permanência na unidade de terapia intensiva, alto consumo de recursos e mau prognóstico neurológico. A incidência relatada de ICT é tipicamente de 30–40 por cento, destacando sua prevalência e implicações prognósticas significativas1,2,3,4,5,6. Notavelmente, a ICT não é um processo de via única. Embora o foco tenha sido historicamente a vasoespasmofia cerebral em vasos de grande calibre, evidências crescentes mostram também que lesão cerebral precoce, despolarização cortical alastrante, neuroinflamação, microtrombose, disfunção endotelial, autoregulação prejudicada e falha da microcirculação são todos fatores que contribuem para o risco isquêmico. Essa fisiopatologia multifatorial ajuda a explicar por que tratamentos direcionados à vasoespasmofia podem não prevenir completamente o infarto associado à ICT e por que pacientes de alto risco são difíceis de identificar no cenário clínico habitual.
A estratificação de risco de ICD após HSA é uma prioridade porque, com a identificação rápida de pacientes de alto risco, pode ser possível monitorá-los mais de perto e intensificar medidas preventivas ou de resgate prontamente7. Planos de monitoramento na prática clínica podem envolver o uso de testes neurológicos mais frequentes, ultrassonografia Doppler transcraniana, técnicas de imagem sofisticadas, como a perfusão por tomografia computadorizada, otimização hemodinâmica e do volume intravascular, adesão rigorosa à terapia com nimodipina e identificação precoce de deterioração neurológica, como hidrocefalia, re-sangramento, convulsões, infecção ou desequilíbrio metabólico. No entanto, escalas de gravidade global e a experiência dos clínicos tendem a influenciar as decisões clínicas mais do que estimativas personalizadas e baseadas em dados da probabilidade de ICD8,9,10. Um dos motivos é que a literatura indica que os fatores de risco são heterogêneos, e a interação entre fatores do paciente, carga de hemorragia, alterações fisiológicas e escalas de classificação neurológica pode ser não linear e complexa. Pesquisadores anteriores investigaram preditores potenciais de ICD, incluindo idade, hipertensão, estado neurológico basal, características do aneurisma, índices laboratoriais (como sódio sérico e albumina), achados de imagem indicativos da carga hemorrágica e fatores relacionados ao período perioperatório ou ao tratamento. Técnicas convencionais de regressão têm sido úteis, mas podem ser limitadas quando os preditores estão correlacionados, quando a relação entre os preditores e o risco é não linear ou quando há interações entre as variáveis11. Paralelamente, múltiplos instrumentos (mais comumente nomogramas) foram propostos para avaliar o risco de ICD. Embora os nomogramas sejam viáveis e visualmente atraentes, a maioria deles é baseada em amostras pequenas, inclui poucas variáveis e pode estar superajustada ou mal validada. Além disso, modelos desenvolvidos e testados em um único centro podem não ser facilmente transferíveis para outras instituições devido a diferenças na composição dos pacientes, interpretação de imagens, tratamento e limiares diagnósticos para ICD.
Métodos de aprendizado de máquina podem complementar modelos tradicionais de predição clínica, pois permitem explorar mais dimensões de dados clínicos e observar tendências mais complexas, sem a necessidade de fazer suposições lineares rígidas. Modelos preditivos baseados em aprendizado de máquina têm encontrado aplicações crescentes no campo das doenças cerebrovasculares nos últimos anos, incluindo a predição de desfechos e complicações, bem como o suporte à tomada de decisão12,13,14Algoritmos de aprendizado de máquina comumente utilizados incluem métodos de árvores de ensemble, como o Extreme Gradient Boosting (XGBoost) e a Light Gradient Boosting Machine (LightGBM), classificadores baseados em kernel, como máquinas de vetores de suporte (SVMs), e classificadores baseados em distância, como o k-vizinhos mais próximos (KNN). Os modelos são, em princípio, capazes de modelar não linearidades. e interações mais do que as abordagens tradicionais15No entanto, existem também preocupações práticas associadas aos modelos de aprendizado de máquina, como o risco de superajuste, a reduzida interpretabilidade e a necessidade de lidar com pré-processamento, ajuste, calibração, avaliação e validação. Vale ressaltar que, em uma ampla gama de cenários clínicos, uma regressão logística bem especificada pode desempenhar um desempenho tão bom quanto, ou até mais eficaz do que, algoritmos mais complexos, especialmente quando o número de preditores é pequeno e a relação sinal-ruído é moderada. Assim, é necessário realizar uma análise comparativa de diversos algoritmos utilizando preditores e métricas de avaliação semelhantes, a fim de identificar um modelo que se correlacione com desempenho e aplicabilidade clínica.16,17,18.
Vários modelos preditivos para isquemia cerebral tardia já foram previamente propostos; no entanto, muitos apresentam limitações importantes, incluindo tamanhos amostrais pequenos, avaliação limitada de calibração, ausência de comparação direta entre algoritmos e validação insuficiente. Além disso, estudos anteriores frequentemente enfatizam a discriminação, mas subnotificam métricas de calibração e utilidade clínica, as quais são essenciais para aplicabilidade no mundo real. O presente estudo aborda essas lacunas ao desenvolver um modelo preditivo em uma coorte comparativamente grande, implementando seleção sistemática de preditores por meio da regressão com operador de contração e seleção por mínimos absolutos (LASSO), comparando múltiplos algoritmos de aprendizado de máquina dentro de uma estrutura unificada de modelagem e avaliando de forma abrangente o desempenho em discriminação, calibração e análise de decisão.
Vários modelos preditivos para DCI após aSAH foram propostos, mas muitos apresentam limitações importantes, incluindo coortes pequenas, avaliação limitada de calibração, relato incompleto do desenvolvimento do modelo e ausência de validação externa ou temporal. Além disso, muitos estudos relatam apenas discriminação, enquanto análise de calibração e análise de curva de decisão são apresentadas de forma menos consistente. O presente estudo não resolve o problema da validação externa. Em vez disso, fornece um estudo de desenvolvimento em centro único e validação interna utilizando variáveis clínicas, laboratoriais e de imagem rotineiramente disponíveis. O caso de uso pretendido é a estratificação precoce de risco após a admissão e tratamento inicial do aneurisma, antes da janela principal de risco de DCI. O modelo pode ajudar os clínicos a identificar pacientes que necessitam de monitoramento neurológico mais rigoroso, vigilância com imagem vascular, correção de anormalidades fisiológicas e avaliação precoce pela equipe de cuidados neurocríticos. Ele não tem a intenção de substituir o julgamento clínico, diagnosticar DCI ou orientar o tratamento sem validação externa e testes de impacto clínico. Estudos anteriores propuseram diversos modelos para prever DCI após aSAH, mas muitos foram limitados por tamanhos amostrais pequenos, relato incompleto de calibração, comparações limitadas entre métodos de modelagem ou ausência de validação externa. O presente estudo não afirma fornecer uma ferramenta de decisão clinicamente validada. Em vez disso, tem como objetivo desenvolver e validar internamente um modelo preditivo utilizando variáveis clínicas, laboratoriais e de imagem precoces e rotineiramente disponíveis de uma coorte de centro único. O caso de uso pretendido é a estratificação precoce de risco após a admissão e tratamento inicial do aneurisma, antes do período principal de risco de DCI. Nesse contexto, um risco predito alto apoiaria uma avaliação neurológica mais atenta, monitoramento vascular, correção de anormalidades fisiológicas e revisão precoce pelos cuidados neurocríticos. O modelo não tem a intenção de diagnosticar DCI ou substituir o julgamento do clínico.
Protocolo
The study was approved by the Institutional Ethics Committee of Yulin First Hospital, Shaanxi Province, China. Because this was a retrospective analysis of routinely collected hospital data, and because all data were anonymized before analysis, the requirement for written informed consent was waived. The study was conducted in accordance with institutional data-protection requirements and the principles of the Declaration of Helsinki.
Data and Methods
Study Population and Design
This was a retrospective single-center cohort study conducted at Yulin First Hospital, Shaanxi Province, China. The hospital records of patients admitted with aSAH between July 2022 and December 2024 were screened. Eligible patients were adults aged 18 years or older with a diagnosis of aSAH confirmed by cranial and intracranial vascular imaging. Patients were required to have been admitted within 72 h after symptom onset and to have undergone aneurysm treatment during the index hospitalization.
Patients were excluded if they had traumatic subarachnoid hemorrhage, non-aneurysmal subarachnoid hemorrhage, severe pre-existing hematological disease, other major intracranial disease affecting outcome assessment, insufficient records for DCI evaluation, or in-hospital death before an adequate DCI assessment period. Excluding early in-hospital deaths may introduce survivorship bias because the most severe cases may be removed from analysis. Therefore, the findings should be interpreted as applying mainly to patients who survived long enough for DCI evaluation.
Data Collection
Clinical, laboratory, imaging, and treatment-related variables were extracted from the electronic medical record using a predefined data-extraction form. The extracted variables included demographic factors, medical history, aneurysm features, early neurological grade, early imaging findings, laboratory results, treatment approach, and hospital complications. The intended prediction time point was after completion of the initial admission and perioperative assessment, but before the main DCI risk window.
Age, sex, body mass index, smoking status, alcohol use, hypertension, diabetes, aneurysm size, aneurysm location, modified Fisher grade, Hunt-Hess grade, World Federation of Neurological Surgeons grade, intraventricular hemorrhage, and rebleeding were taken from admission records and initial imaging. Laboratory variables, including hemoglobin, serum albumin, and serum sodium, were obtained from the earliest available blood test prior to the prediction time point. Cerebral edema was assessed using baseline or immediate post-treatment imaging available before DCI diagnosis. Variables recorded only after DCI onset were not used for model development to reduce information leakage.
Anemia was defined as hemoglobin <110 g/L in female patients and <120 g/L in male patients. Hypoalbuminemia was defined as serum albumin <35 g/L. Hyponatremia was defined as serum sodium <130 mmol/L.
Patients were managed according to the institutional aSAH care pathway. Standard management included early aneurysm securing, neurological observation, blood pressure control, fluid and electrolyte management, and surveillance for complications including hydrocephalus, rebleeding, seizure, infection, vasospasm, and DCI. Nimodipine was used unless contraindicated. Vasospasm monitoring was performed using neurological examination, vascular imaging, and transcranial Doppler ultrasonography when clinically indicated. Hydrocephalus was managed with cerebrospinal fluid diversion when required. Hemodynamic optimization and rescue therapy were applied according to the treating team’s assessment. Because treatment intensity and rescue-therapy details were not completely captured in the retrospective dataset, these factors could not be fully adjusted in the model and were considered a limitation.
Diagnosis of DCI
DCI was defined as a new focal neurological impairment, a decrease in level of consciousness, or a new cerebral infarction on follow-up computed tomography or magnetic resonance imaging occurring during the expected DCI risk window and not explained by another cause. The DCI risk window was defined as days 3–14 after the hemorrhage ictus. Alternative explanations, including rebleeding, hydrocephalus, seizure, infection, metabolic disturbance, sedative effect, and procedure-related infarction, were reviewed before classifying an event as DCI.
Outcome adjudication was performed by two clinicians with experience in the management of aSAH, including one neurosurgeon and one neurologist/neurocritical care physician. The adjudicators reviewed clinical notes, neurological examinations, imaging reports, and follow-up imaging. They were blinded to the final model output during outcome assessment. Disagreements were resolved through consensus discussion with review of the relevant imaging and clinical timeline. Formal inter-rater agreement was not measured, and this limitation was added because DCI classification may involve clinical judgment.
Sample Size Calculation
The sample size was estimated using the 10-events-per-variable (EPV) rule of thumb11. With 20 candidate predictor variables and an expected DCI incidence of approximately 35%, a minimum sample size of 20 × 10 / 0.35 ≈ 572 patients was required. Our final cohort of 680 patients exceeded this requirement. Although the events-per-variable (EPV) rule was applied as a general guideline, modern predictive modeling, particularly machine learning algorithms, may require more flexible sample-size considerations. The final cohort size was considered adequate to ensure model stability, minimize the risk of overfitting, and enable reliable estimation of model performance metrics.
Model development and validation
Patients were allocated to a training cohort of 544 patients and a hold-out internal validation cohort of 136 patients using an outcome-stratified 8:2 split. Outcome stratification was used to maintain a similar proportion of DCI events in the two cohorts. DCI occurred in 175 of 544 patients in the training cohort and 42 of 136 patients in the internal-validation cohort. The 8:2 hold-out design was retained because it was the prespecified model-development strategy and provided a separate cohort for preliminary internal performance assessment.
Predictor selection was performed only in the training cohort using least absolute shrinkage and selection operator regression with 10-fold cross-validation. The selected penalty parameter was λ = 0.031. Six predictors were retained: age, cerebral edema, hypoalbuminemia, modified Fisher grade, Hunt-Hess grade, and World Federation of Neurological Surgeons grade.
Logistic regression, extreme gradient boosting, light gradient boosting machine, support vector machine, and k-nearest neighbor models were developed using the same set of selected predictors. All preprocessing, predictor selection, and model-development procedures were restricted to the training cohort. The internal-validation cohort was not used during predictor selection or model tuning and was evaluated only after model development.
The numerical random seed used for the original cohort allocation was not retained in the archived analysis records and could not be retrospectively verified. Bootstrap optimism correction and repeated k-fold internal validation were also not available. Therefore, the present analysis is described as a single hold-out internal validation rather than an optimism-corrected or repeated cross-validated performance assessment.
Machine-learning reproducibility
LASSO predictor selection used 10-fold cross-validation within the training cohort. Continuous predictors were standardized when required by the modeling algorithm, and categorical predictors were represented using predefined binary clinical categories. The validation cohort was not used for tuning or model selection.
The archived analysis materials did not retain the final tuning grids, selected hyperparameters, complete package versions, original random seed, or a confirmed class-imbalance procedure for XGBoost, LightGBM, SVM, and KNN. These settings were therefore not reconstructed or estimated. The machine-learning comparisons should consequently be interpreted as exploratory comparisons of algorithms rather than fully reproducible model-development experiments. Reproducibility information, both available and unavailable, should be summarized in Supplementary Table 1.
Bias Control & Sensitivity Analysis
Consecutive eligible patients were included to reduce selection bias. Standardized variable definitions and a structured data-extraction form were used to reduce information bias. Predictors were restricted to information available before the intended DCI prediction time point to reduce information leakage. Predictor selection, preprocessing, and model development were performed only in the training cohort.
Modified Fisher grade, Hunt-Hess grade, and WFNS grade represent related aspects of hemorrhage burden and neurological severity. Although all three variables were retained after LASSO selection, the numerical variance inflation factor values and the results from a sensitivity model excluding overlapping severity scales were not included in the archived analysis output. These analyses could not be reconstructed from the aggregate tables because patient-level correlations and fitted model outputs are required. Therefore, the individual coefficients of these severity measures were not interpreted as independent or causal effects. They were retained only as components of the prediction model selected in the training cohort.
Model Interpretability
Clinical applicability was believed to require model interpretability as a crucial element. In the most effective model, the effects of predictors were considered to assess the clinical plausibility and conformity with existing pathophysiological knowledge of delayed cerebral ischemia. This method enabled a clear assessment of model behavior and improved the potential for clinical translation.
Missing Data
Variable-level missingness was assessed during data preparation. However, the original pre-imputation missing counts and percentages for each candidate variable were not retained in the archived analysis records and could not be accurately reconstructed from the aggregate tables. Consequently, no assumption of complete data was made, and no unverified missingness percentages were reported.
A verified supplementary missing-data table should be generated directly from the original deidentified patient-level dataset. Supplementary Table 2 should report, for every candidate variable, the number and percentage of missing observations before data handling, the method used to address missingness, and the number of observations included in the final analysis. The inability to recover the original variable-specific missingness pattern was considered a limitation of the present report.
Statistical Analysis
Predictor selection was performed in the training cohort using LASSO regression with 10-fold cross-validation. Discrimination was assessed using the area under the receiver operating characteristic curve with 95% confidence intervals. Calibration was described using calibration plots and point estimates of the calibration slope, calibration intercept, and Brier score. Bootstrap confidence intervals for calibration measures were not available.
Threshold-dependent classification measures were calculated from the available internal-validation confusion matrices. The exact numerical probability threshold used to generate the archived confusion matrices was not retained and could not be verified. Therefore, these measures were interpreted descriptively and were not used as the primary basis for model selection. Decision-curve analysis was also considered exploratory because the exact prespecified threshold range and patient-level net-benefit output were not retained. A two-sided P value below 0.05 was considered statistically significant.
Resultados
Comparação das características basais entre as coortes de treinamento e de validação interna
Um total de 680 pacientes com HSAa foram incluídos. A coorte de treinamento continha 544 pacientes, dos quais 175 desenvolveram ICD, enquanto a coorte de validação interna continha 136 pacientes, dos quais 42 desenvolveram ICD. A taxa de eventos de ICD foi de 32,2% na coorte de treinamento e de 30,9% na coorte de validação interna. As características basais são apresentadas na Tabela 1. Como algumas entradas arquivadas da tabela continham inconsistências nos denominadores, a tabela deve ser verificada em relação ao conjunto de dados original em nível de paciente antes da submissão final.
| Variável | Coorte de treinamento (n = 544) | Coorte de validação interna (n = 136) | t/χ²/Z | Valor P | DMP | Nota de correção |
| Idade, anos | 62,88 ± 9,41 | 63,25 ± 9,52 | 0,409 | 0,693 | 0,039 | |
| Sexo | 0,429 | 0,512 | 0,063 | |||
| Masculino | 180 (33,09) | 41 (30,15) | ||||
| Feminino | 364 (66,91) | 95 (69,85) | ||||
| IMC, kg/m² | 23,46 ± 3,56 | 23,61 ± 3,65 | 0,437 | 0,662 | 0,042 | |
| Histórico de tabagismo | 0,118 | 0,731 | 0,033 | |||
| Sim | 101 (18,57) | 27 (19,85) | ||||
| Não | 443 (81,43) | 109 (80,15) | ||||
| Uso de álcool | 0,417 | 0,518 | 0,062 | |||
| Sim | 118 (21,69) | 33 (24,26) | ||||
| Não | 426 (78,31) | 103 (75,74) | ||||
| Histórico de hipertensão | 0,348 | 0,555 | 0,057 | |||
| Sim | 329 (60,48) | 86 (63,24) | ||||
| Não | 215 (39,52) | 50 (36,76) | ||||
| Histórico de diabetes | 0,116 | 0,733 | 0,033 | Contagem de 'Não' na validação corrigida para somar 136. | ||
| Sim | 70 (12,87) | 19 (13,97) | ||||
| Não | 474 (87,13) | 117 (86,03) | ||||
| Diâmetro do aneurisma, mm | 0,213 | 0,645 | 0,044 | |||
| >10 | 288 (52,94) | 75 (55,15) | ||||
| ≤10 | 256 (47,06) | 61 (44,85) | ||||
| Localização do aneurisma | 0,980 | 0,322 | 0,095 | |||
| Circulação anterior | 448 (82,35) | 107 (78,68) | ||||
| Circulação posterior | 96 (17,65) | 29 (21,32) | ||||
| Edema cerebral | 0,612 | 0,434 | 0,075 | |||
| Sim | 125 (22,98) | 27 (19,85) | ||||
| Não | 419 (77,02) | 109 (80,15) | ||||
| Hemoglobina baixa | 0,684 | 0,408 | 0,079 | Contagem de 'Não' na validação corrigida para somar 136. Contagem do treinamento conflita com a Tabela 2; verificar com o conjunto de dados final. | ||
| Sim | 147 (27,02) | 32 (23,53) | ||||
| Não | 397 (72,98) | 104 (76,47) | ||||
| Hipoalbuminemia | 0,367 | 0,545 | 0,058 | |||
| Sim | 115 (21,14) | 32 (23,53) | ||||
| Não | 429 (78,86) | 104 (76,47) | ||||
| Hiponatremia | 0,186 | 0,666 | 0,041 | |||
| Sim | 331 (60,85) | 80 (58,82) | ||||
| Não | 213 (39,15) | 56 (41,18) | ||||
| Classificação de Fisher modificada | 0,249 | 0,618 | 0,048 | |||
| ≥III | 259 (47,61) | 68 (50,00) | ||||
| I–II | 285 (52,39) | 68 (50,00) | ||||
| Classificação de Hunt-Hess | 0,178 | 0,673 | 0,040 | Contagem de ≥III na validação corrigida de 53 para 63 para somar 136; verificar com o conjunto de dados final. | ||
| ≥III | 263 (48,35) | 63 (46,32) | ||||
| I–II | 281 (51,65) | 73 (53,68) | ||||
| Classificação de WFNS | 0,249 | 0,618 | 0,048 | |||
| ≥III | 277 (50,92) | 66 (48,53) | ||||
| I–II | 267 (49,08) | 70 (51,47) | ||||
| Abordagem cirúrgica | 0,717 | 0,397 | 0,081 | |||
| Tratamento endovascular | 449 (82,54) | 108 (79,41) | ||||
| Clipping | 95 (17,46) | 28 (20,59) | ||||
| Tempo cirúrgico, h | 2,78 ± 0,81 | 2,81 ± 0,79 | 0,388 | 0,698 | 0,037 | |
| Hemorragia intraventricular | 0,383 | 0,536 | 0,059 | |||
| Sim | 134 (24,63) | 37 (27,21) | ||||
| Não | 410 (75,37) | 99 (72,79) | ||||
| Re-sangramento | 0,784 | 0,376 | 0,085 | |||
| Sim | 98 (18,01) | 29 (21,32) | ||||
| Não | 446 (81,99) | 107 (78,68) |
Tabela 1: Características basais das coortes de treinamento e de validação interna. Variáveis contínuas são apresentadas como média ± desvio padrão e variáveis categóricas como n (%). Valores de P e diferenças padronizadas das médias comparam as duas coortes. Abreviações: BMI, índice de massa corporal; SMD, diferença média padronizada. Clique aqui para baixar esta Tabela.
Comparação das características basais entre os grupos sem DCI e com DCI no conjunto de treinamento
Na coorte de treinamento, a isquemia cerebral tardia (ICT) ocorreu em 175 pacientes (32,17%), enquanto 369 pacientes (67,83%) não desenvolveram ICT. A incidência de ICT na coorte de validação interna foi comparável, indicando uma prevalência estável dos desfechos. As análises comparativas entre os grupos sem ICT e com ICT revelaram várias diferenças estatisticamente significativas (Tabela 2). Os pacientes que desenvolveram ICT eram significativamente mais idosos (P = 0,026), sugerindo uma suscetibilidade associada à idade frente à lesão isquêmica secundária. Evidências radiológicas de lesão cerebral precoce, particularmente edema cerebral, foram acentuadamente mais prevalentes entre os pacientes com ICT (P = 0,001). Anormalidades laboratoriais, incluindo hipoalbuminemia (P = 0,007), hiponatremia (P = 0,048) e níveis baixos de hemoglobina (P < 0,001), estiveram significativamente associadas à ocorrência de ICT. Os marcadores de gravidade neurológica demonstraram as associações mais fortes. O grau modificado de Fisher elevado (≥III) foi significativamente mais frequente entre os pacientes com ICT (P < 0,001), indicando uma relação robusta entre a carga hemorrágica e as complicações isquêmicas tardias. De forma semelhante, graus mais altos na escala de Hunt–Hess e na escala da World Federation of Neurological Surgeons (WFNS) estiveram fortemente associados ao desenvolvimento de ICT (ambos P < 0,001). Em contraste, variáveis demográficas, fatores de estilo de vida, morfologia do aneurisma, abordagem cirúrgica e duração da cirurgia não demonstraram diferenças estatisticamente significativas.
| Variável | Grupo sem DCI (n = 369) | Grupo com DCI (n = 175) | t/χ²/Z | Valor de P | Nota de correção |
| Idade, anos | 62,25 ± 9,54 | 64,22 ± 9,75 | 2,234 | 0,026 | |
| Sexo | 0,638 | 0,424 | |||
| Masculino | 118 (31,98) | 62 (35,43) | |||
| Feminino | 251 (68,02) | 113 (64,57) | |||
| IMC, kg/m² | 23,43 ± 3,56 | 23,52 ± 3,72 | 0,271 | 0,786 | |
| Histórico de tabagismo | 0,351 | 0,554 | |||
| Sim | 66 (17,89) | 35 (20,00) | |||
| Não | 303 (82,11) | 140 (80,00) | |||
| Uso de álcool | 0,046 | 0,837 | |||
| Sim | 81 (21,95) | 37 (21,14) | |||
| Não | 288 (78,05) | 138 (78,86) | |||
| Histórico de hipertensão | 2,960 | 0,085 | |||
| Sim | 214 (57,99) | 115 (65,71) | |||
| Não | 155 (42,01) | 60 (34,29) | |||
| Histórico de diabetes | 0,463 | 0,496 | |||
| Sim | 45 (12,20) | 25 (14,29) | |||
| Não | 324 (87,80) | 150 (85,71) | |||
| Diâmetro do aneurisma, mm | 0,380 | 0,538 | |||
| >10 | 192 (52,03) | 96 (54,86) | |||
| ≤10 | 177 (47,97) | 79 (45,14) | |||
| Localização do aneurisma | 3,602 | 0,058 | |||
| Circulação anterior | 296 (80,22) | 152 (86,86) | |||
| Circulação posterior | 73 (19,78) | 23 (13,14) | |||
| Edema cerebral | 10,410 | 0,001 | |||
| Sim | 70 (18,97) | 55 (31,43) | |||
| Não | 299 (81,03) | 120 (68,57) | |||
| Hemoglobina baixa | 23,965 | <0,001 | Total difere da Tabela 1; verificar com o conjunto de dados final. | ||
| Sim | 122 (33,06) | 82 (46,86) | |||
| Não | 247 (66,94) | 93 (53,14) | |||
| Hipoalbuminemia | 7,283 | 0,007 | |||
| Sim | 66 (17,89) | 49 (28,00) | |||
| Não | 303 (82,11) | 126 (72,00) | |||
| Hiponatremia | 3,914 | 0,048 | |||
| Sim | 214 (57,99) | 117 (66,86) | |||
| Não | 155 (42,01) | 58 (33,14) | |||
| Classificação modificada de Fisher | 58,679 | <0,001 | |||
| ≥III | 134 (36,31) | 125 (71,43) | |||
| I–II | 235 (63,69) | 50 (28,57) | |||
| Classificação de Hunt-Hess | 39,909 | <0,001 | |||
| ≥III | 144 (39,02) | 119 (68,00) | |||
| I–II | 225 (60,98) | 56 (32,00) | |||
| Classificação WFNS | 28,137 | <0,001 | |||
| ≥III | 159 (43,09) | 118 (67,43) | |||
| I–II | 210 (56,91) | 57 (32,57) | |||
| Abordagem cirúrgica | 0,691 | 0,406 | |||
| Tratamento endovascular | 308 (83,47) | 141 (80,57) | |||
| Clipping | 61 (16,53) | 34 (19,43) | |||
| Tempo cirúrgico, h | 2,74 ± 0,82 | 2,85 ± 0,76 | 1,496 | 0,135 | |
| Hemorragia intraventricular | 0,163 | 0,687 | |||
| Sim | 89 (24,12) | 45 (25,71) | |||
| Não | 280 (75,88) | 130 (74,29) | |||
| Re-sangramento | 1,168 | 0,280 | |||
| Sim | 71 (19,24) | 27 (15,43) | |||
| Não | 298 (80,76) | 148 (84,57) |
Tabela 2: Características basais de pacientes com e sem isquemia cerebral tardia na coorte de treinamento. Variáveis contínuas são apresentadas como média ± desvio padrão e variáveis categóricas como n (%). Os valores de P comparam pacientes com e sem DCI. Abreviações: DCI, isquemia cerebral tardia; WFNS, Federação Mundial de Neurocirurgiões. Clique aqui para baixar esta Tabela.
Distribuição dos resultados na coorte de validação interna
Na coorte de validação interna (n = 136), a isquemia cerebral tardia (ICT) ocorreu em 42 pacientes (30,9%), enquanto 94 pacientes (69,1%) não desenvolveram ICT. A prevalência de resultados foi comparável à observada no conjunto de dados de treinamento, o que sustenta a estabilidade da distribuição de eventos entre os conjuntos de dados.
Seleção de Características
A seleção de preditores foi realizada na coorte de treinamento utilizando regressão LASSO com validação cruzada de 10 dobras. O parâmetro de penalidade selecionado foi λ = 0,031. Seis preditores mantiveram coeficientes não nulos: idade, edema cerebral, hipoalbuminemia, grau modificado de Fisher, grau de Hunt-Hess e grau de WFNS. Todos os preditores selecionados estavam disponíveis antes do ponto temporal pretendido para a predição. Figura 1A,B apresenta as trajetórias dos coeficientes e a curva de validação cruzada utilizadas na seleção dos preditores.
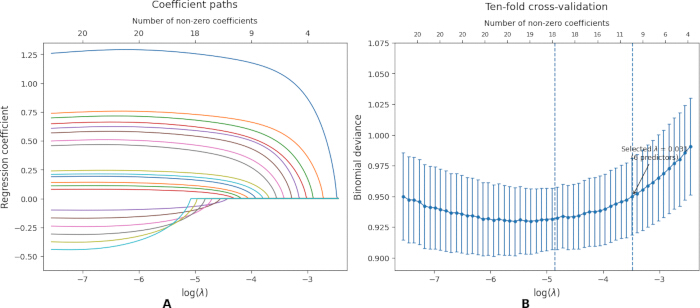
Figura 1: Seleção baseada em LASSO de preditores para isquemia cerebral tardia após hemorragia subaracnoidea aneurismal. (A) Trajetórias dos coeficientes dos preditores candidatos ao longo dos valores de log(λ). Cada curva representa um preditor candidato, e os números no eixo superior indicam o número de coeficientes não nulos mantidos em cada valor de penalidade. (B) Curva de validação cruzada com dez dobras para desvio binomial. Os pontos indicam o desvio médio validado cruzadamente, as barras de erro indicam os erros padrão, e as linhas verticais tracejadas indicam os valores de penalidade com erro mínimo e com um erro padrão. O parâmetro de penalidade final selecionado foi λ = 0,031. LASSO, operador de seleção e redução absoluta mínima; DCI, isquemia cerebral tardia. Clique aqui para visualizar uma versão maior desta figura.
Desenvolvimento e avaliação do modelo
Todos os cinco modelos foram desenvolvidos utilizando os mesmos seis preditores selecionados. Na coorte de validação interna, a regressão logística apresentou uma AUC de 0,832 (IC 95%, 0,758–0,906), a SVM apresentou uma AUC de 0,811 (IC 95%, 0,729–0,893), o XGBoost apresentou uma AUC de 0,777 (IC 95%, 0,690–0,864), o LightGBM apresentou uma AUC de 0,755 (IC 95%, 0,672–0,838) e o KNN apresentou uma AUC de 0,708 (IC 95%, 0,613–0,803) (Tabela 3).
| Conjunto de dados | Modelo | AUC | IC 95% | Acurácia | Sensibilidade | Especificidade | Pontuação F1 | Nota de correção |
| Treinamento | XGBoost | 0.916 | 0.888–0.944 | 0.848 | 0.853 | 0.847 | 0.682 | |
| Treinamento | Regressão logística | 0.833 | 0.794–0.872 | 0.816 | 0.71 | 0.81 | 0.594 | |
| Treinamento | LightGBM | 0.751 | 0.707–0.794 | 0.69 | 0.781 | 0.669 | 0.489 | |
| Treinamento | SVM | 0.807 | 0.762–0.852 | 0.809 | 0.704 | 0.833 | 0.583 | |
| Treinamento | KNN | 0.915 | 0.896–0.935 | 0.754 | 0.878 | 0.696 | 0.607 | AUC do KNN corrigida a partir da legenda da Figura 2 para corresponder ao valor da tabela. |
| Validação | XGBoost | 0.777 | 0.690–0.864 | 0.755 | 0.608 | 0.794 | 0.507 | |
| Validação | Regressão logística | 0.832 | 0.758–0.906 | 0.809 | 0.714 | 0.851 | 0.698 | Métricas de classificação recalculadas a partir da matriz de confusão da Tabela 6. |
| Validação | LightGBM | 0.755 | 0.672–0.838 | 0.696 | 0.799 | 0.669 | 0.522 | |
| Validação | SVM | 0.811 | 0.729–0.893 | 0.779 | 0.69 | 0.819 | 0.659 | Métricas de classificação recalculadas a partir da matriz de confusão da Tabela 6. |
| Validação | KNN | 0.708 | 0.613–0.803 | 0.647 | 0.715 | 0.629 | 0.456 |
Tabela 3: Desempenho de discriminação e classificação dos modelos de predição nas coortes de treinamento e validação interna. Os valores de AUC são apresentados com intervalos de confiança de 95%. A acurácia, sensibilidade, especificidade e pontuação F1 foram calculados no limiar de classificação previamente especificado. Abreviações: AUC, área sob a curva ROC; CI, intervalo de confiança; KNN, k-vizinhos mais próximos; LightGBM, máquina de boosting gradiente leve; SVM, máquina de vetores de suporte; XGBoost, boosting gradiente extremo. Medidas de classificação dependentes de limiar não foram utilizadas como base principal para comparação dos modelos porque o limiar de probabilidade exato utilizado na análise arquivada não pôde ser verificado. Clique aqui para baixar esta Tabela.
Os intervalos de confiança se sobrepuseram, e a regressão logística não foi interpretada como estatisticamente superior aos outros modelos. A regressão logística foi mantida como o modelo principal porque forneceu discriminação interna estável e uma estrutura de modelo diretamente interpretável. Os resultados representam o desempenho em uma única coorte interna de validação reservada e não constituem validação corrigida para otimismo, temporal ou externa (Figura 2A–D).
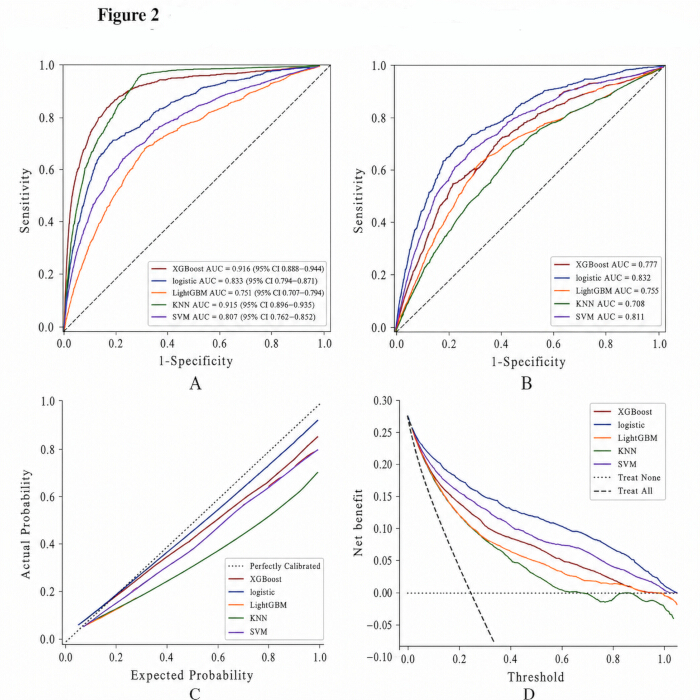
Figura 2: Desempenho dos modelos preditivos em discriminação, calibração e curva de decisão.
(A) Curvas de característica operacional do receptor na coorte de treinamento. (B) Curvas de característica operacional do receptor na coorte de validação interna. As legendas das curvas indicam a área sob a curva de característica operacional do receptor (AUC) com intervalos de confiança de 95%. (C) Curvas de calibração comparando as probabilidades previstas e observadas de isquemia cerebral tardia (DCI); a linha pontilhada diagonal indica calibração perfeita. (D) Análise da curva de decisão mostrando o benefício líquido ao longo das probabilidades de limiar. A linha pontilhada horizontal representa a estratégia de não tratar nenhum paciente, enquanto a linha tracejada representa a estratégia de tratar todos os pacientes. AUC, área sob a curva de característica operacional do receptor; DCI, isquemia cerebral tardia; KNN, k-vizinhos mais próximos; LightGBM, máquina de reforço gradiente leve; SVM, máquina de vetores de suporte; XGBoost, reforço gradiente extremo. Clique aqui para visualizar uma versão maior desta figura.
Análise exploratória de curva de decisão
A análise de curva de decisão foi realizada como uma avaliação exploratória do benefício líquido. No entanto, a faixa exata pré-especificada de probabilidade de limiar e a saída do benefício líquido em nível individual do paciente não foram mantidas nos registros arquivados da análise. Consequentemente, os resultados da curva de decisão não podem comprovar a utilidade clínica nem definir um limiar de intervenção clinicamente apropriado.
Qualquer vantagem aparente de benefício líquido em comparação com as estratégias de tratar todos ou de não tratar ninguém deve ser interpretada apenas como um padrão preliminar dentro do presente conjunto interno de dados. É necessária uma validação externa, seleção prospectiva de limiares, avaliação das consequências clínicas e um estudo formal de impacto clínico antes que o modelo possa ser considerado útil para decisões de manejo de pacientes (Figura 3).
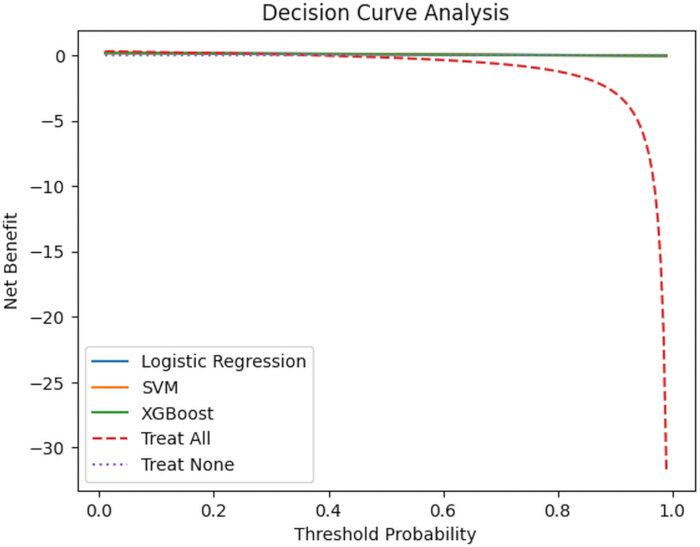
Figura 3: Análise de curva de decisão dos modelos preditivos selecionados na coorte de validação interna. O benefício líquido é representado em função da probabilidade limite para os modelos de regressão logística, SVM e XGBoost. A linha tracejada "tratar todos" representa a estratégia de monitorar todos os pacientes, enquanto a linha pontilhada "não tratar nenhum" representa a ausência de monitoramento em todos os pacientes. Um modelo é considerado clinicamente útil nas probabilidades limite em que sua curva de benefício líquido está acima de ambas as estratégias de referência. SVM, máquina de vetores de suporte; XGBoost, boosting de gradiente extremo. Clique aqui para visualizar uma versão maior desta figura.
Modelo de regressão logística multivariável
O modelo final de regressão logística incluiu idade, edema cerebral, hipoalbuminemia, grau de Fisher modificado, grau de Hunt-Hess e grau de WFNS. Os coeficientes de regressão, razões de chance, intervalos de confiança de 95% e valores de P são apresentados na Tabela 4. A idade teve um coeficiente de 0,038, enquanto os coeficientes para edema cerebral, hipoalbuminemia, grau de Fisher modificado ≥ III, grau de Hunt-Hess ≥ III e grau de WFNS ≥ III foram respectivamente 0,842, 0,615, 1,274, 0,933 e 0,781.
| Preditor | Coeficiente β | Razão de chances (OR) | IC 95% | Valor P | Nota de interpretação |
| Intercepto | [inserir a partir da saída do modelo final] | — | — | — | Necessário para o cálculo do risco por paciente. |
| Idade | 0,038 | 1,039 | 1,012–1,067 | 0,004 | Associação preditiva apenas; não causal. |
| Edema cerebral | 0,842 | 2,321 | 1,541–3,496 | <0,001 | Medido antes do diagnóstico de DCI. |
| Hipoalbuminemia | 0,615 | 1,85 | 1,206–2,837 | 0,005 | Valor mais precoce disponível de albumina antes do ponto temporal de predição. |
| Classificação de Fisher modificada ≥III | 1,274 | 3,575 | 2,401–5,324 | <0,001 | Indicador de gravidade; interpretar com cautela quanto à colinearidade. |
| Classificação de Hunt-Hess ≥III | 0,933 | 2,542 | 1,674–3,861 | <0,001 | Indicador de gravidade; interpretar com cautela quanto à colinearidade. |
| Classificação de WFNS ≥III | 0,781 | 2,184 | 1,447–3,298 | <0,001 | Indicador de gravidade; interpretar com cautela quanto à colinearidade. |
Tabela 4: Modelo final de regressão logística multivariável para prever isquemia cerebral tardia. São apresentados os coeficientes de regressão, razões de odds, intervalos de confiança de 95% e valores-P para os preditores mantidos após a seleção por LASSO. Todos os preditores foram avaliados antes do ponto temporal previsto para a predição. Abreviaturas: CI, intervalo de confiança; DCI, isquemia cerebral tardia; OR, razão de odds; WFNS, Federação Mundial de Neurocirurgiões. O intercepto numérico da regressão logística não estava disponível na saída arquivada do modelo. Portanto, os coeficientes relatados não podem ser utilizados para calcular probabilidades preditas individuais. Os coeficientes representam associações preditivas e não devem ser interpretados como efeitos causais independentes. Clique aqui para baixar esta tabela.
Esses coeficientes descrevem associações preditivas dentro da coorte de desenvolvimento. Eles não devem ser interpretados como efeitos causais independentes, porque o grau de Fisher modificado, o grau de Hunt-Hess e o grau de WFNS representam dimensões sobrepostas da gravidade da doença, e os diagnósticos numéricos de colinearidade não estavam disponíveis. As variáveis foram mantidas como componentes do modelo de predição, em vez de fatores de risco independentes confirmados.
Desempenho da calibração
A calibração foi resumida na coorte de validação interna usando estimativas pontuais da inclinação de calibração, intercepto de calibração e pontuação de Brier. A regressão logística apresentou uma inclinação de calibração de 0,98, um intercepto de calibração de 0,02 e uma pontuação de Brier de 0,168. Os valores correspondentes foram 0,94, 0,05 e 0,182 para SVM; 0,88, 0,09 e 0,201 para XGBoost; 0,91, 0,07 e 0,194 para LightGBM; e 0,92, 0,06 e 0,190 para KNN (Tabela 5).
Intervalos de confiança bootstrap para essas medidas de calibração não estavam disponíveis porque as probabilidades preditas individuais necessárias para a reamostragem não foram mantidas na saída de análise arquivada. Portanto, os resultados de calibração são apresentados como estimativas pontuais preliminares dentro da coorte de validação interna e não devem ser interpretados como evidência de calibração em outras instituições ou populações de pacientes (Figura 4).
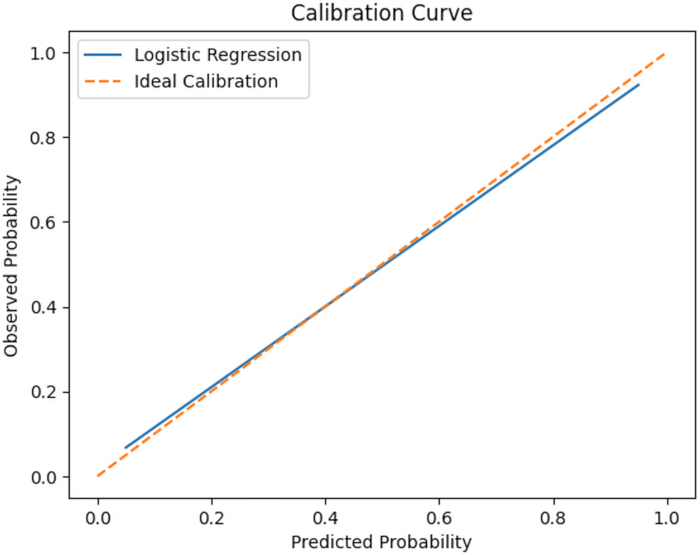
Figura 4: Calibração do modelo de regressão logística na coorte de validação interna. A linha sólida mostra a relação entre as probabilidades previstas e observadas de isquemia cerebral tardia. A linha tracejada diagonal representa a calibração perfeita; quanto maior a concordância entre as duas linhas, melhor o desempenho da calibração. DCI, isquemia cerebral tardia. Clique aqui para visualizar uma versão maior desta figura.
| Modelo | Inclinação da calibração | IC 95% da inclinação da calibração | Intercepto da calibração | IC 95% do intercepto da calibração | Pontuação Brier | IC 95% da pontuação Brier | Nota de correção |
| Regressão logística | 0.98 | [insert bootstrap 95% CI] | 0.02 | [insert bootstrap 95% CI] | 0.168 | [insert bootstrap 95% CI] | Adicione os ICs bootstrap da análise final, se disponíveis. |
| SVM | 0.94 | [insert bootstrap 95% CI] | 0.05 | [insert bootstrap 95% CI] | 0.182 | [insert bootstrap 95% CI] | |
| XGBoost | 0.88 | [insert bootstrap 95% CI] | 0.09 | [insert bootstrap 95% CI] | 0.201 | [insert bootstrap 95% CI] | |
| LightGBM | 0.91 | [insert bootstrap 95% CI] | 0.07 | [insert bootstrap 95% CI] | 0.194 | [insert bootstrap 95% CI] | |
| KNN | 0.92 | [insert bootstrap 95% CI] | 0.06 | [insert bootstrap 95% CI] | 0.19 | [insert bootstrap 95% CI] |
Tabela 5: Desempenho de calibração dos modelos preditivos na coorte de validação interna. Uma inclinação de calibração de 1,0 e um intercepto de calibração de 0 indicam calibração ideal. Pontuações de Brier mais baixas indicam melhor precisão geral da predição. Abreviações: KNN, k-vizinhos mais próximos; LightGBM, máquina de aumento de gradiente leve; SVM, máquina de vetores de suporte; XGBoost, aumento extremo de gradiente. A inclinação de calibração, o intercepto de calibração e a pontuação de Brier são apresentados como estimativas pontuais. Intervalos de confiança gerados por reamostragem bootstrap não estavam disponíveis. Esses resultados descrevem apenas a calibração preliminar dentro da coorte de validação interna mantida. Clique aqui para baixar esta Tabela.
Métricas derivadas da matriz de confusão.
A matriz de confusão disponível para validação interna da regressão logística continha 30 verdadeiros positivos, 80 verdadeiros negativos, 14 falsos positivos e 12 falsos negativos. A acurácia recalculada foi de 0,809, a sensibilidade foi de 0,714, a especificidade foi de 0,851, o valor preditivo positivo foi de 0,682, o valor preditivo negativo foi de 0,870 e o escore F1 foi de 0,698.
Para a SVM, a matriz de confusão continha 29 verdadeiros positivos, 77 verdadeiros negativos, 17 falsos positivos e 13 falsos negativos. A acurácia recalculada foi de 0,779, a sensibilidade foi de 0,690, a especificidade foi de 0,819, o valor preditivo positivo foi de 0,630, o valor preditivo negativo foi de 0,856 e o escore F1 foi de 0,659 (Tabela 6).
| Métrica | Regressão logística | SVM | Nota de cálculo |
| Verdadeiros positivos | 30 | 29 | Cohorte de validação |
| Verdadeiros negativos | 80 | 77 | Cohorte de validação |
| Falsos positivos | 14 | 17 | Cohorte de validação |
| Falsos negativos | 12 | 13 | Cohorte de validação |
| Exatidão | 0.809 | 0.779 | (VP + VN) / total |
| Sensibilidade | 0.714 | 0.69 | VP / (VP + FN) |
| Especificidade | 0.851 | 0.819 | VN / (VN + FP) |
| Valor preditivo positivo | 0.682 | 0.63 | VP / (VP + FP) |
| Valor preditivo negativo | 0.87 | 0.856 | VN / (VN + FN) |
| Pontuação F1 | 0.698 | 0.659 | 2VP / (2VP + FP + FN) |
Tabela 6: Medidas de desempenho derivadas da matriz de confusão para regressão logística e SVM na coorte de validação interna. As métricas foram calculadas a partir das matrizes de confusão arquivadas; no entanto, o limiar exato não foi mantido. Indique o limiar exato na nota de rodapé da tabela. Abreviações: NPV, valor preditivo negativo; PPV, valor preditivo positivo; SVM, máquina de vetores de suporte. As matrizes de confusão foram obtidas a partir da coorte de validação interna. A acurácia, sensibilidade, especificidade, valor preditivo positivo, valor preditivo negativo e pontuação F1 da regressão logística recalculados foram, respectivamente, 0.809, 0.714, 0.851, 0.682, 0.870 e 0.698. Os valores correspondentes para SVM foram 0.779, 0.690, 0.819, 0.630, 0.856 e 0.659. O limiar exato de classificação utilizado na análise original não foi mantido e deve ser verificado antes da submissão final. Clique aqui para baixar esta Tabela.
Esses valores foram recalculados diretamente a partir das mesmas matrizes de confusão para garantir a consistência numérica. No entanto, o limiar exato de probabilidade utilizado na análise original de classificação não foi mantido. Portanto, as medidas dependentes do limiar são relatadas de forma descritiva e não devem ser usadas como base principal para comparação de modelos até que o limiar seja verificado a partir do código original da análise (Table 7).
| Subgrupo | AUC (Regressão Logística) |
| Idade ≥65 anos | 0.821 |
| Idade <65 anos | 0.836 |
| Índice de Fisher Modificado ≥III | 0.844 |
| Índice de Fisher Modificado I–II | 0.801 |
| Clipping | 0.825 |
| Tratamento endovascular | 0.835 |
Tabela 7: Análise exploratória de discriminação por subgrupo do modelo de regressão logística. Os valores de AUC são apresentados por idade, grau modificado de Fisher e subgrupo de tratamento. Essas análises são exploratórias e não devem ser interpretadas como evidência de generalização do modelo. Adicione o tamanho da amostra do subgrupo, a contagem de eventos de ICD e o intervalo de confiança de 95% para cada subgrupo.
Abreviações: AUC, área sob a curva característica de operação do receptor; DCI, isquemia cerebral tardia. Clique aqui para baixar esta Tabela.
Avaliação Exploratória de Subgrupo
A saída do subgrupo arquivado continha estimativas pontuais de AUC de acordo com a idade, grau de Fisher modificado e abordagem de tratamento. No entanto, os tamanhos das amostras dos subgrupos, as contagens de eventos de ICD nos subgrupos, os intervalos de confiança de 95% e os testes formais de interação ou heterogeneidade não estavam disponíveis. Portanto, os resultados dos subgrupos foram considerados incompletos e exploratórios. Eles não foram utilizados para afirmar que o desempenho do modelo era robusto, consistente ou generalizável entre os subgrupos de pacientes.
Desempenho da estratificação de risco
A saída arquivada de estratificação de risco relatou porcentagens observadas de DCI de 10,2%, 33,6% e 69,1% para as categorias propostas de baixo, intermediário e alto risco, respectivamente. No entanto, os denominadores dos grupos correspondentes, as contagens de eventos de DCI, os intervalos de confiança e uma justificativa clínica ou estatística pré-especificada para os pontos de corte de probabilidade não estavam disponíveis. Portanto, a análise foi considerada exploratória e não foi utilizada para sustentar alegações de separação de risco validada ou aplicabilidade clínica (Tabela 8).
| Categoria de risco | Intervalo de probabilidade | Incidente observado de DCI |
| Baixo risco | <0.20 | 10,2% |
| Risco intermediário | 0,20–0,50 | 33,6% |
| Alto risco | >0,50 | 69,1% |
Tabela 8: Incidência observada de isquemia cerebral tardia nas categorias de risco derivadas do modelo na coorte de validação interna. As categorias de risco foram definidas com base nas probabilidades preditas pelo modelo final de regressão logística. Clique aqui para baixar esta tabela.
Modelo Final de Regressão Logística
A saída de regressão arquivada continha os coeficientes para os seis preditores selecionados, mas não continha o intercepto numérico do modelo. Como o intercepto é necessário para calcular uma probabilidade predita individual, uma equação completa de predição em nível de paciente não pôde ser informada. A equação incompleta foi, portanto, removida em vez de ser completada com um valor assumido ou reconstruído.
Os coeficientes apresentados na Tabela 4 podem ser usados para descrever a direção e a magnitude relativa das associações dos preditores dentro do modelo ajustado, mas não devem ser utilizados para calcular probabilidades de DCI em nível individual de pacientes. Uma equação completa de predição só pode ser fornecida após a recuperação do intercepto a partir do modelo ajustado original ou sua regeneração mediante reanálise do conjunto de dados autêntico em nível individual de pacientes.
Logit(DCI) = [intercepto] + 0,038 × idade + 0,842 × edema cerebral + 0,615 × hiperalbuminemia + 1,274 × grau modificado de Fisher ≥III + 0,933 × grau de Hunt-Hess ≥III + 0,781 × grau da World Federation of Neurological Surgeons ≥III.
A probabilidade prevista de DCI foi calculada como:
P(DCI) = 1 / [1 + exp(−Logit)].
Os preditores binários foram codificados como 1 quando a condição estava presente e 0 quando ausente. A classificação modificada de Fisher ≥III, a classificação de Hunt-Hess ≥III e a classificação da World Federation of Neurological Surgeons ≥III foram codificadas como 1 quando o paciente atingia o limiar e 0 caso contrário. O intercepto não é informado porque é necessário para o cálculo da probabilidade em nível individual do paciente. Esta equação deve ser usada apenas para interpretação em pesquisa até que a validação externa e a recodificação sejam concluídas.
A escala modificada de Fisher, a escala de Hunt-Hess e a escala da World Federation of Neurological Surgeons refletem a gravidade da doença e podem apresentar parcial sobreposição em seu significado clínico. Como os diagnósticos de colinearidade numérica e um modelo de sensibilidade completo excluindo escalas de gravidade sobrepostas não estavam disponíveis, o manuscrito não interpreta essas variáveis como preditores causais independentes. Elas são mantidas apenas como componentes de um modelo preditivo selecionado na coorte de treinamento. Essa limitação reduz a confiança na contribuição independente de cada escala de gravidade e deve ser abordada em futuros estudos de validação externa.
DISPONIBILIDADE DE DADOS:
O conjunto completo de dados hospitalares em nível de paciente não está disponível publicamente porque contém informações clínicas sensíveis e está sujeito a requisitos éticos institucionais e de proteção de dados. O acesso a um conjunto de dados analíticos anonimizados pode ser considerado pelo Comitê de Ética Institucional do Hospital Yulin First após a submissão de uma proposta de pesquisa justificada metodologicamente, comprovante de aprovação ética e um acordo apropriado de uso de dados. O conjunto de dados compartilhado exclui nomes, números de identificação hospitalar, datas exatas, informações de contato e outros identificadores diretos ou indiretos. Um dicionário de variáveis verificado, scripts de análise, Tabela Suplementar 1 descrevendo informações sobre desenvolvimento e reprodutibilidade do modelo e Tabela Suplementar 2 relatando ausência específica por variável são fornecidos, conforme permitido pela política institucional. Conjuntos de dados demonstrativos ou sintéticos não são representados como os dados originais do estudo clínico.
Tabela Suplementar 1: Detalhes de reprodutibilidade e hiperparâmetros finais para o desenvolvimento do modelo. Esta tabela relata a semente aleatória, o software e as versões dos pacotes, etapas de pré-processamento, procedimento de imputação, abordagem de validação cruzada, grade de ajuste e hiperparâmetros finais para XGBoost, LightGBM, SVM e KNN.Clique aqui para baixar este arquivo.
Tabela Suplementar 2: Resumo da ausência de dados e estratégia de tratamento para preditores candidatos. Para cada preditor candidato, são relatados o número e a porcentagem de observações ausentes, o método de imputação e se a variável foi mantida para análise.Clique aqui para baixar este arquivo.
Discussão
Este estudo desenvolveu e validou internamente um modelo preditivo para isquemia cerebral tardia (DCI) após hemorragia subaracnoidea aneurismática (aSAH) utilizando variáveis clínicas, laboratoriais e de imagem obtidas precocemente. Seis variáveis foram mantidas após a seleção de preditores: idade, edema cerebral, hipoalbuminemia, grau modificado de Fisher, grau de Hunt-Hess e grau da World Federation of Neurological Surgeons. Dentre os modelos avaliados, a regressão logística apresentou discriminação interna estável e calibração aceitável. Como a coorte de validação foi retirada do mesmo centro e período da coorte de treinamento, os resultados devem ser interpretados apenas como uma validação interna preliminar.
Os preditores selecionados são clinicamente plausíveis no contexto de HSA. Um grau de Fisher modificado mais alto reflete uma maior carga hemorrágica, enquanto os graus Hunt-Hess e WFNS descrevem a gravidade neurológica na apresentação14,15. O edema cerebral pode representar lesão cerebral precoce, enquanto a idade avançada pode indicar reserva fisiológica reduzida. A hipoalbuminemia pode refletir doença sistêmica, inflamação, estado nutricional ou vulnerabilidade endotelial19,20. No entanto, essas associações foram identificadas para fins preditivos e não devem ser interpretadas como causais. Além disso, os graus de Fisher modificado, Hunt-Hess e WFNS medem aspectos relacionados da gravidade da doença. Como os valores de VIF e as análises numéricas de sensibilidade não estavam disponíveis, a contribuição independente de cada escala de classificação não pôde ser estabelecida.
Métodos mais complexos de aprendizado de máquina não demonstraram uma vantagem clara em relação à regressão logística na coorte de validação interna com retenção. A regressão logística apresentou a maior AUC de validação, mas os intervalos de confiança se sobrepuseram aos dos demais modelos. Algoritmos complexos podem capturar padrões não lineares, mas também podem apresentar superajuste quando o conjunto de preditores é pequeno e os dados provêm de um único centro. A regressão logística foi, portanto, mantida como o modelo principal devido à sua interpretabilidade e discriminação interna estável. Contudo, registros incompletos de hiperparâmetros e versões de software limitam a reprodutibilidade das comparações de aprendizado de máquina.
O modelo atual não possui um papel clínico estabelecido. Embora um risco estimado mais alto possa teoricamente justificar uma observação neurológica mais rigorosa ou uma avaliação especializada precoce, as probabilidades em nível individual não podem ser calculadas atualmente, pois o intercepto do modelo não está disponível. Além disso, a faixa de limiar da curva de decisão, o desempenho em subgrupos e os resultados por categoria de risco foram documentados de forma incompleta. Portanto, o modelo não deve ser utilizado como instrumento diagnóstico isolado, regra de monitoramento ou base para decisões terapêuticas. É necessário um reconstrução completa do modelo, validação externa, recalibração e avaliação prospectiva do impacto clínico antes que sua implementação possa ser considerada.
Este estudo possui várias limitações. Primeiramente, foi retrospectivo e conduzido em um único centro, o que limita a generalização dos resultados. Em segundo lugar, o desempenho do modelo foi avaliado utilizando uma divisão de retenção 8:2 estratificada por desfecho, mas não foram possíveis a correção de otimismo por bootstrap, a validação cruzada repetida com k partições, a validação temporal nem a validação externa. Terceiro, a semente aleatória original, os hiperparâmetros finais de aprendizado de máquina, as grades de ajuste, o procedimento para desequilíbrio de classes e as versões completas dos pacotes de software não foram mantidos, limitando assim a reprodutibilidade computacional. Quarto, o intercepto numérico da regressão logística não estava disponível, impedindo o cálculo das probabilidades preditas individuais. Quinto, a classificação modificada de Fisher, a classificação de Hunt-Hess e a classificação da WFNS são medidas relacionadas de gravidade, enquanto os diagnósticos de FIV e as análises numéricas de sensibilidade, excluindo escalas sobrepostas, não estavam disponíveis. Sexto, os intervalos de confiança para a inclinação de calibração, o intercepto de calibração e o escore de Brier não foram calculados. Sétimo, o limiar exato de classificação e a faixa de limiar da análise de decisão clínica (DCA) não puderam ser verificados. Oitavo, as análises de subgrupos e de estratificação de risco careciam de denominadores completos, contagens de eventos, intervalos de confiança e testes formais de interação. Nono, o padrão original de ausência de dados específico por variável não foi mantido. Por fim, foram excluídas mortes precoces no ambiente hospitalar, o que pode ter introduzido viés de sobrevivência. Essas limitações indicam que o modelo deve ser considerado preliminar e não deve ser utilizado para tomada de decisões clínicas antes de uma reanálise completa e de uma validação externa independente.
Este estudo desenvolveu e avaliou modelos preditivos para isquemia cerebral tardia (ICT) após hemorragia subaracnoidea aneurismática (HSAA) utilizando variáveis clínicas, laboratoriais e de imagem obtidas precocemente21. Seis preditores foram mantidos após seleção por LASSO: idade, edema cerebral, hipoalbuminemia, grau modificado de Fisher, grau de Hunt-Hess e grau da WFNS22,23,24,25,26,27,28,29. A regressão logística alcançou uma AUC de 0,832 (IC 95%) na coorte interna de validação reservada e gerou uma estrutura de modelo interpretável29,30. No entanto, a análise baseou-se em uma única divisão interna, e não estavam disponíveis validação completa baseada em reamostragem, validação externa nem informações sobre reprodutibilidade computacional. Os achados devem, portanto, ser interpretados como resultados preliminares de desenvolvimento de modelo, e não como evidência de uma ferramenta preditiva clinicamente validada.
Este estudo retrospectivo de centro único desenvolveu e avaliou modelos preditivos para isquemia cerebral tardia (ICT) após hemorragia subaracnoidea aneurismática (HSAA) utilizando seis variáveis clínicas, laboratoriais e de imagem obtidas precocemente. A regressão logística mostrou discriminação preliminar em uma única coorte interna de validação de retenção e gerou uma estrutura de modelo interpretável31,32,33,34. No entanto, registros incompletos de reprodutibilidade, ausência de intercepto numérico, indisponibilidade de validação baseada em reamostragem, avaliação incompleta da incerteza e falta de validação externa impedem o cálculo de probabilidade em nível individual de pacientes e o uso clínico. Uma reanálise utilizando o conjunto de dados autêntico em nível individual de pacientes, relato completo das configurações de desenvolvimento do modelo e validação multicêntrica independente são necessárias.
Agradecimentos
Os autores agradecem o apoio da equipe de prontuários médicos do Primeiro Hospital de Yulin na recuperação dos dados clínicos anonimizados. Esses membros da equipe não participaram do desenho do estudo, da adjudicação dos desfechos, da modelagem estatística, da interpretação dos resultados, da elaboração do manuscrito ou da aprovação do manuscrito final e, portanto, não preencheram os critérios para autoria.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Sistema eletrônico de prontuário médico | Yulin First Hospital | Não aplicável | Fonte de dados clínicos retrospectivos; a plataforma comercial exata não foi mantida nos registros arquivados. |
| IBM SPSS Statistics | IBM Corporation | Versão 25.0 | Análise estatística descritiva e inferencial. |
| Implementação do k-vizinhos mais próximos | Pacote/fonte não mantido | Não disponível | Modelo exploratório de aprendizado de máquina; o pacote e a versão exatos devem ser recuperados do ambiente original do código. |
| LightGBM | Microsoft / projeto de código aberto | Versão não disponível | Modelo exploratório de boosting por gradiente; a versão exata do pacote e os hiperparâmetros não foram mantidos. |
| Software estatístico R | R Foundation for Statistical Computing | Versão 4.3.2 | Modelagem estatística e avaliação interna de desempenho. |
| Implementação da máquina de vetores de suporte | Pacote/fonte não mantido | Não disponível | Modelo exploratório de aprendizado de máquina; o pacote exato, as configurações do kernel e a versão não foram mantidos. |
| XGBoost | Projeto de código aberto | Versão não disponível | Modelo exploratório de boosting por gradiente; a versão exata do pacote e os hiperparâmetros não foram mantidos. |
Referências
- Caylor MM, MacDonald RL. Pharmacological prevention of delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2024;40(1):159–169.
- Shah VA, Gonzalez LF, Suarez JI. Therapies for delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2023;39(1):36–50.
- Clarke JV, et al. Microvascular platelet aggregation and thrombosis after subarachnoid hemorrhage: a review and synthesis. J Cereb Blood Flow Metab. 2020;40(8):1565–1575.
- Dodd WS, et al. Pathophysiology of delayed cerebral ischemia after subarachnoid hemorrhage: a review. J Am Heart Assoc. 2021;10(15). doi:10.1161/JAHA.121.021845.
- Stragier H, et al. Pathophysiological mechanisms underlying early brain injury and delayed cerebral ischemia in the aftermath of aneurysmal subarachnoid hemorrhage: a comprehensive analysis. Front Neurol. 2025;16:1587091. doi:10.3389/fneur.2025.1587091.
- Xiao ZK, et al. Risk factors for the development of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage: a systematic review and meta-analysis. World Neurosurg. 2025;193:427–446.
- Sirsat MS, Fermé E, Câmara J. Machine learning for brain stroke: a review. J Stroke Cerebrovasc Dis. 2020;29(10):105162. doi:10.1016/j.jstrokecerebrovasdis.2020.105162.
- Mao M, et al. Construction of a nomogram model for predicting delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage patients. Sci Rep. 2025;15(1):17739. doi:10.1038/s41598-025-01693-w.
- Connolly ES Jr, et al. Guidelines for the management of aneurysmal subarachnoid hemorrhage: a guideline for healthcare professionals from the American Heart Association/American Stroke Association. Stroke. 2012;43(6):1711–1737.
- Vergouwen MD, et al. Definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage as an outcome event in clinical trials and observational studies: proposal of a multidisciplinary research group. Stroke. 2010;41(10):2391–2395.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368. doi:10.1136/bmj.m441.
- Veldeman M, et al. Delayed cerebral ischaemia prevention and treatment after aneurysmal subarachnoid haemorrhage: a systematic review. Br J Anaesth. 2016;117(1):17–40.
- Azzam AY, et al. Prediction of delayed cerebral ischemia followed aneurysmal subarachnoid hemorrhage: a machine-learning based study. J Stroke Cerebrovasc Dis. 2024;33(4):107553. doi:10.1016/j.jstrokecerebrovasdis.2023.107553.
- Jeong TS, et al. Factors related to the development of shunt-dependent hydrocephalus following subarachnoid hemorrhage in the elderly. Turk Neurosurg. 2018;28(2):226–233.
- Becerril-Gaitan A, et al. The effect of age on cerebral vasospasm and delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage. World Neurosurg. 2024;187–e1024.
- Hayman EG, et al. Mechanisms of global cerebral edema formation in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2017;26(2):301–310.
- Fistouris P, et al. The impact of intracranial blood clearance on brain edema as a predictor of delayed cerebral infarction following subarachnoid hemorrhage. Cerebrovasc Dis. Published online June 28, 2025:1–8.
- Liu JP, et al. Analysis of risk factors for delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage [in Chinese]. Chin J Cerebrovasc Dis. 2017;14(1):10–14.
- Guo X, et al. Admission albumin-globulin ratio associated with delayed cerebral ischemia following aneurysmal subarachnoid hemorrhage. Front Neurol. 2024;15:1438728. doi:10.3389/fneur.2024.1438728.
- Sanicola HW, et al. Pathophysiology, management, and therapeutics in subarachnoid hemorrhage and delayed cerebral ischemia: an overview. Pathophysiology. 2023;30(3):420–442.
- Wang L, et al. Risk factors and predictive models of poor prognosis and delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage complicated with hydrocephalus. Front Neurol. 2022;13:1014501. doi:10.3389/fneur.2022.1014501.
- Raatikainen E, et al. Prognostic value of the 2010 consensus definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage. J Neurol Sci. 2021;420:117261. doi:10.1016/j.jns.2020.117261.
- Shah AH, Snow R, Wendell LC, et al. Association of hemoglobin trend and outcomes in aneurysmal subarachnoid hemorrhage: a single center cohort study. J Clin Neurosci. 2023;107:77–83.
- Jiang C, et al. Risk and prognostic factors for rupture of intracranial aneurysms during endovascular embolization. World Neurosurg. 2019;129–e649.
- Naraoka M, et al. Role of microcirculatory impairment in delayed cerebral ischemia and outcome after aneurysmal subarachnoid hemorrhage. J Cereb Blood Flow Metab. 2022;42(1):186–196.
- Hu P, et al. Effect of surgical clipping versus endovascular coiling on the incidence of delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage: a multicenter observational cohort study with propensity score matching. World Neurosurg. 2023;172–e388.
- Ching T, et al. Opportunities and obstacles for deep learning in biology and medicine. J R Soc Interface. 2018;15(141):20170387. doi:10.1098/rsif.2017.0387.
- Jiang F, et al. Artificial intelligence in healthcare: past, present and future. Stroke Vasc Neurol. 2017;2(4):230–243.
- Coulibaly AP, Provencio JJ. Aneurysmal subarachnoid hemorrhage: an overview of inflammation-induced cellular changes. Neurotherapeutics. 2020;17(2):436–445.
- Gris T, et al. Innate immunity activation in the early brain injury period following subarachnoid hemorrhage. J Neuroinflammation. 2019;16(1):253. doi:10.1186/s12974-019-1629-7.
- Wu Z, et al. Study on the predictive value of laboratory inflammatory markers and blood count-derived inflammatory markers for disease severity and prognosis in COVID-19 patients: a study conducted at a university-affiliated infectious disease hospital. Ann Med. 2024;56(1):2415401. doi:10.1080/07853890.2024.2415401.
- Okugawa Y, et al. Lymphocyte–C-reactive protein ratio as a promising new marker for predicting surgical and oncological outcomes in colorectal cancer. Ann Surg. 2020;272(2):342–351.
- Xie L, et al. The systemic inflammation response index as a significant predictor of short-term adverse outcomes in acute decompensated heart failure patients: a cohort study from southern China. Front Endocrinol (Lausanne). 2024;15:1444663. doi:10.3389/fendo.2024.1444663.
- Yan F, et al. Association between the stress hyperglycemia ratio and 28-day all-cause mortality in critically ill patients with sepsis: a retrospective cohort study and predictive model establishment based on machine learning. Cardiovasc Diabetol. 2024;23(1):163. doi:10.1186/s12933-024-02265-4.