Este estudo apresenta um fluxo de trabalho bioinformático reprodutível que integra transcriptômica, aprendizado de máquina e análise de infiltração imune para identificar biomarcadores diagnósticos potenciais e redes regulatórias na doença pulmonar obstrutiva crônica (DPOC).
Artigo de investigação
UPP1 como Biomarcador Diagnóstico: Percepções a partir de Bioinformática Integrativa e Análises de Infiltração Imune na DPOC
* These authors contributed equally
Neste artigo
Resumo
Resumo
A DPOC é uma desordem respiratória progressiva caracterizada por limitação persistente do fluxo aéreo e inflamação crônica, porém o papel da modificação de RNA por N4-acetilcitidina (ac4C) em sua patogênese permanece amplamente inexplorado. Este estudo teve como objetivo realizar uma triagem sistemática de genes relacionados à ac4C (ac4C-RGs) a partir de uma base de dados publicada e investigar suas redes regulatórias na DPOC, identificando assim possíveis biomarcadores para estudos mecanicistas adicionais, sem presumir uma relação regulatória direta entre qualquer gene específico e a modificação por ac4C. Genes diferencialmente expressos (DEGs) foram identificados a partir de perfis transcriptômicos, e a análise de rede de coexpressão gênica ponderada (WGCNA) foi aplicada para revelar módulos-chave de coexpressão. Foi realizada uma análise cruzada entre DEGs, módulos significativos e ac4C-RGs. Os genes-chave foram selecionados utilizando regressão LASSO, algoritmos XGBoost e floresta aleatória, seguidos pela construção de um modelo diagnóstico baseado em regressão logística. O desempenho do modelo foi avaliado por meio de análise da curva ROC (característica operacional do receptor), área sob a curva (AUC) com intervalos de confiança de 95%, avaliação da curva de calibração e análise da curva de decisão (DCA). Foram identificados um total de 160 genes sobrepostos, e seis genes centrais (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B e B4GALT2) foram consistentemente selecionados pelos três algoritmos de aprendizado de máquina. O modelo diagnóstico demonstrou bom desempenho discriminativo, com AUCs de 0,766, 0,759 e 0,723 nos conjuntos de treinamento, teste interno e validação externa, respectivamente. A análise da rede regulatória sugeriu possíveis eixos ceRNA e interações com fatores de transcrição, enquanto o perfil de infiltração imune revelou correlações significativas entre os genes-chave e múltiplos subconjuntos de células imunes. A análise de interação droga-gene e o encaixe molecular indicaram que fluorouracila, capecitabina e 5-benzilacilouridina podem exibir afinidades de ligação previstas favoráveis com UPP1. Em conclusão, PTRF, PRKCDBP, UPP1, TOR3A, FAM168B e B4GALT2 foram identificados como biomarcadores potenciais relacionados à ac4C na DPOC, possivelmente envolvidos na regulação imune e metabólica, fornecendo uma base para futuras investigações funcionais e exploração terapêutica.
Introdução
A DPOC é uma desordem respiratória crônica e heterogênea caracterizada por limitação progressiva do fluxo aéreo resultante de anormalidades nas estruturas alveolares e das vias aéreas1,2. Um desequilíbrio protease-antiprotease, estresse oxidativo, inflamação crônica e senescência celular constituem os mecanismos fisiopatológicos centrais da DPOC, levando à destruição estrutural e prejuízo funcional do tecido pulmonar3,4. Além disso, a DPOC é influenciada por múltiplos fatores de risco, incluindo tabagismo prolongado, poluição ambiental, exposição ocupacional, infecções respiratórias e suscetibilidade genética5,6. A DPOC tem imposto um fardo significativo à economia global. Projetou-se que ela represente 0,111% do PIB mundial anualmente entre 2020 e 20507. Embora as estratégias terapêuticas atuais, como broncodilatadores, corticosteroides inalatórios, reabilitação pulmonar e oxigenoterapia de longo prazo, possam aliviar os sintomas, interromper a progressão da doença permanece desafiador. Devido à acentuada heterogeneidade clínica, os desfechos em pacientes variam amplamente8. Portanto, biomarcadores diagnósticos e indicadores prognósticos inovadores são urgentemente necessários para aprimorar o manejo da DPOC e melhorar a sobrevida dos pacientes.
A modificação de RNA refere-se à alteração química de moléculas de RNA, o que pode mudar a estrutura e a função do RNA para regular a expressão gênica9,10. As modificações comuns de RNA incluem N6-metiladenosina (m6A), pseudouridina (Ψ), 5-metilcitidina (m5C) e ac4C11. A modificação ac4C desempenha um papel crucial na preservação da estabilidade do mRNA e na promoção da tradução do mRNA12,13. NAT10 é a única enzima eucariótica conhecida que catalisa a modificação ac4C, e sua atividade é essencial para a formação dessa modificação14. Estudos demonstraram uma forte correlação entre estresse oxidativo, senescência celular, inflamação e modificação ac4C. Por exemplo, linfócitos T CD4+ em tecidos do cólon de indivíduos com doença inflamatória intestinal (DII) apresentam níveis acentuadamente elevados de NAT1015. NAT10 aumenta a acetilação ac4C das quimiocinas CCL2 e CXCL1, promovendo assim a infiltração de macrófagos e neutrófilos e agravando os danos inflamatórios16. A resposta celular ao estresse oxidativo pode envolver a modificação ac4C, como evidenciado pelo aumento acentuado nos níveis de ac4C sob estresse oxidativo. Além disso, NAT10 promove a fibrose pulmonar induzida por PM2.5 ao estabilizar o mRNA de TGFB1 por meio da modificação ac4C, desencadeando assim a transição epitelial-mesenquimal17. No entanto, o papel da modificação ac4C na DPOC permanece amplamente inexplorado, destacando a necessidade de pesquisas adicionais nessa área.
O banco de dados GEO foi utilizado neste estudo para identificar genes diferencialmente expressos (GDEs) entre pacientes com DPOC e controles. Uma lista publicada de genes reguladores de ac4C (ac4C-RGs), compilada a partir de dados multiômicos18, foi então integrada aos GDEs para identificar candidatos sobrepostos. Considerando que a modificação ac4C é conhecida por influenciar processos inflamatórios e estresse oxidativo—processos centrais na DPOC—formulamos a hipótese de que genes associados à rede regulatória de ac4C poderiam estar desregulados na DPOC. No entanto, os genes sobrepostos não foram considerados substratos diretos da NAT10 nem genes diretamente regulados pelo ac4C; ao invés disso, foram considerados candidatos associados à rede relacionada ao ac4C. Genes-chave foram selecionados utilizando múltiplos algoritmos de aprendizado de máquina, seguidos pela construção e validação de um modelo diagnóstico. Posteriormente, foram determinadas as vias relevantes envolvidas na patogênese da DPOC e previstos fármacos potencialmente direcionados. Por fim, ensaios de RT-qPCR foram realizados para confirmar os níveis de expressão dos genes-chave, fornecendo insights preliminares sobre a fisiopatologia da DPOC e possíveis vias para exploração terapêutica.
Protocolo
Declaração do comitê de ética em pesquisa
Este estudo foi conduzido de acordo com a Declaração de Helsinque. O protocolo foi aprovado pelo Comitê de Ética do Hospital Shenzhen Luohu de Medicina Tradicional Chinesa (número de aprovação: 2024-LHQZYYYXLL-KY-039), e o consentimento informado por escrito foi obtido de todos os participantes antes da inscrição. Os detalhes das ferramentas e materiais de pesquisa utilizados neste protocolo estão fornecidos na Tabela de Materiais.
Fonte e processamento de dados
Conjuntos de dados de expressão gênica relacionados à DPOC foram obtidos no Gene Expression Omnibus (GEO). O conjunto de dados GSE54837 foi utilizado como conjunto de transcriptoma, e o conjunto de dados GSE112811 serviu como conjunto de validação (Tabela 1). Os genes regulados por ac4C (ac4C-RGs) foram coletados da literatura18. Genes diferencialmente expressos (DEGs) entre os grupos DPOC e controle foram identificados utilizando o pacote R limma. Consideraram-se estatisticamente significativos os DEGs com |log2FC| > 0 e p < 0,05. Foram gerados gráficos de vulcão para visualizar a distribuição geral das alterações na expressão gênica.
Construção do WGCNA
A WGCNA foi realizada no conjunto de dados GSE54837 utilizando o R para identificar módulos relacionados à DPOC. Antes da construção da rede, amostras discrepantes foram identificadas e removidas por meio de análise de agrupamento hierárquico utilizando a função hclust com o método de ligação média e uma métrica de distância euclidiana. A potência ótima de limiarização suave (β = 10) foi selecionada para alcançar um índice de ajuste à topologia livre de escala R2 ≥ 0,85, equilibrando topologia livre de escala e conectividade média. Uma matriz de adjacência foi construída e transformada em uma matriz de sobreposição topológica (TOM). Os módulos de genes foram identificados utilizando o algoritmo dinâmico de corte de árvore (deepSplit = 2, minClusterSize = 50). Módulos com correlações de eigengene > 0,75 foram posteriormente agrupados utilizando a função mergeCloseModules. Os eigengenes dos módulos foram então correlacionados com características clínicas (estado de DPOC, idade, sexo e status de tabagismo) utilizando coeficientes de correlação de Pearson para identificar módulos associados à DPOC para análises subsequentes.
Triagem, análise de enriquecimento e análise da rede de interação de proteínas (PPI) de genes sobrepostos
Um diagrama de Venn foi gerado utilizando o pacote R ggvenn para identificar os genes que se sobrepõem entre os DEGs, os genes do módulo MEsalmon e os ac4C-RGs. A análise de enriquecimento funcional dos genes sobrepostos foi realizada utilizando as bases de dados Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) com o pacote R clusterProfiler. Informações sobre interação proteína-proteína (PPI) foram obtidas a partir da base de dados STRING (https://string-db.org/) para analisar as interações ao nível proteico entre os genes sobrepostos. O software Cytoscape foi utilizado para visualizar a rede PPI resultante.
Identificação de genes-chave por meio de aprendizado de máquina
Três técnicas de aprendizado de máquina foram aplicadas: regressão com operador de encolhimento e seleção por mínimos absolutos (LASSO), gradiente de reforço extremo (XGBoost) e floresta aleatória (RF). A regressão LASSO foi implementada usando o pacote glmnet com validação cruzada de 10 dobras para determinar o parâmetro de penalidade ótimo λ. O parâmetro type.measure foi definido como "deviance", e o parâmetro family foi definido como "binomial". O valor ótimo de λ foi selecionado usando o critério λmin, que minimiza o desvio validado por cruzamento, resultando em 17 genes. O XGBoost foi realizado usando o pacote xgboost com os seguintes hiperparâmetros: nrounds = 100, max_depth = 6, eta = 0,3, subsample = 0,8, colsample_bytree = 0,8 e eval_metric = "logloss". A importância das características foi classificada pela métrica de ganho, e os 30 principais genes foram selecionados. A floresta aleatória foi implementada usando o pacote randomForest com ntree = 200. A importância das características foi classificada pela diminuição média na medida de Gini, e os 30 principais genes foram selecionados. Os genes selecionados pelos três métodos de aprendizado de máquina foram intersectados para identificar genes-chave para análises subsequentes.
Construção e avaliação do modelo de regressão logística para predição de risco
O conjunto de dados GSE54837 foi dividido aleatoriamente em um conjunto de treinamento (70%) e um conjunto de teste (30%). Um modelo de regressão logística foi construído com base no conjunto de treinamento utilizando a função glm do pacote MASS, com os níveis de expressão dos genes-chave como variáveis de entrada. O desempenho do modelo foi avaliado por meio de curvas ROC geradas com o pacote pROC. Os intervalos de confiança de 95% para a AUC foram calculados por meio de 2.000 réplicas bootstrap. A calibração do modelo foi avaliada utilizando curvas de calibração geradas com 1.000 reamostragens bootstrap (pacote rms). A análise de decisão clínica (DCA) foi realizada utilizando o pacote dca para avaliar o benefício clínico líquido em uma variedade de probabilidades limite. Um nomograma foi construído utilizando a função nomogram do pacote rms para facilitar a estimativa individualizada de risco.
A equação de regressão foi:
logit(P) = 0,5823 + 0,6010 × UPP1 - 0,6563 × PTRF + 0,3853 × B4GALT2 - 0,3972 × FAM168B + 0,1848 × PRKCDBP - 0,4787 × TOR3A. (1)
Aqui, P representa a probabilidade prevista de DPOC, e cada coeficiente representa a contribuição do valor correspondente de expressão gênica para o logaritmo das chances de DPOC.
Análise de expressão, rede GeneMANIA e rede regulatória molecular
Os níveis de expressão gênica entre os grupos com DPOC e controle no conjunto de dados GSE54837 foram comparados utilizando o teste de soma de postos de Wilcoxon. Gráficos de caixa foram gerados com o pacote ggplot2 para visualizar a distribuição dos níveis de expressão, com mediana, intervalo interquartil (IIQ) e pontos de dados individuais sobrepostos. O GeneMANIA foi utilizado para construir redes gênicas e prever interações funcionais. A busca foi realizada com parâmetros padrão: espécie = Homo sapiens, número máximo de genes relacionados = 20. A rede resultante foi baixada e visualizada, com as cores das arestas indicando os tipos de interação. Uma rede de RNA endógeno competitivo (ceRNA) foi construída para investigar mecanismos regulatórios pós-transcricionais. As miRNAs que visam os seis genes-chave foram previstas utilizando duas bases de dados independentes: DIANA-microT (pontuação ≥ 0,8) e miRanda (pontuação ≥ 140, energia ≤ −20 kcal/mol). A interseção de miRNAs identificadas por ambas as bases de dados foi utilizada para construir pares miRNA-mRNA. Posteriormente, as lncRNAs que visam essas miRNAs foram previstas utilizando a base de dados StarBase. Uma rede regulatória lncRNA-miRNA-mRNA foi construída e visualizada utilizando o Cytoscape. As relações regulatórias transcricionais foram previstas utilizando a Análise de Enriquecimento ChIP-X Versão 3 (ChEA3). Para cada gene-chave com fatores de transcrição previstos, os 10 principais fatores de transcrição com as maiores pontuações de enriquecimento foram selecionados. Uma rede regulatória TF-alvo foi construída no Cytoscape.
Análise de enriquecimento de conjuntos de genes e avaliação da infiltração de células imunes
A análise de enriquecimento de conjuntos de genes (GSEA) foi realizada utilizando o pacote clusterProfiler para investigar as funções biológicas de cada gene-chave. Para cada gene-chave, as amostras foram divididas em grupos de alta e baixa expressão com base no valor mediano. A análise de expressão diferencial entre os dois grupos foi realizada utilizando o limma, e a lista resultante de genes foi ordenada pelo log₂ da razão de expressão com sinal. O GSEA foi conduzido utilizando a função gseGO para termos do processo biológico da Ontologia Genética (GO) e a função gseKEGG para vias KEGG, com os seguintes parâmetros: minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0,05 e nPerm = 1.000. A abundância relativa de 28 tipos de células imunes foi estimada utilizando a análise de enriquecimento de conjuntos de genes por amostra única (ssGSEA) implementada no pacote GSVA. Uma matriz de assinatura de conjunto de genes curada, composta por genes marcadores para 28 tipos de células imunes, foi obtida da literatura anterior19. Para cada amostra, a função gsva foi aplicada com method = "ssgsea", ssgsea.norm = TRUE e kcdf = "Gaussian". Os coeficientes de correlação de Spearman entre os escores de enriquecimento do ssGSEA e os níveis de expressão dos seis genes-chave foram calculados utilizando a função cor.test. Os valores de p foram ajustados para testes múltiplos utilizando o método de Benjamini-Hochberg. A matriz de correlação foi visualizada como um mapa de calor utilizando o pacote pheatmap.
Previsão de fármacos, docking molecular e análise de associação com doenças
Compostos terapêuticos potenciais direcionados a genes-chave foram identificados utilizando a base de dados DrugBank. Uma rede de interação "fármaco direcionado ao gene-chave" foi construída no Cytoscape para visualizar as interações previstas entre fármacos e genes. O encaixe molecular foi realizado utilizando a plataforma CB-Dock2 para avaliar as afinidades de ligação. A estrutura tridimensional da proteína humana UPP1 foi obtida no Protein Data Bank (PDB ID: 7B8T). As estruturas moleculares dos fármacos (formato SMILES) foram obtidas do PubChem. O encaixe foi realizado utilizando o mecanismo AutoDock Vina, e os resultados foram classificados pela energia livre de ligação (ΔG, em kcal/mol). Os complexos de encaixe foram visualizados utilizando o PyMOL. As associações entre os genes-chave e doenças humanas relacionadas a exposições ambientais foram investigadas utilizando a base de dados Comparative Toxicogenomics Database (CTD). Cada gene foi pesquisado individualmente, e as dez doenças com associação mais forte foram extraídas e visualizadas utilizando gráficos de radar.
Protocolo de RT-qPCR
Amostras de sangue venoso periférico foram coletadas de oito pacientes com DPOC e oito controles saudáveis no Hospital Shenzhen Luohu de Medicina Tradicional Chinesa. A DPOC foi diagnosticada de acordo com os critérios da Iniciativa Global para Doença Pulmonar Obstrutiva Crônica (GOLD), definida como uma relação VEF1/CVF pós-broncodilatador inferior a 0,7. < 0,70. O grupo controle era composto por voluntários saudáveis pareados por idade e sexo, sem histórico de doenças respiratórias e com testes de função pulmonar normais (VEF1% previsto ≥ 80% e VEF1/CVF ≥ 0,70). As informações basais dos pacientes estão apresentadas em Tabela 2. O RNA total foi extraído de amostras de sangue de DPOC utilizando um kit de extração de RNA de sangue. Para a síntese de cDNA, 500 ng de RNA total foram transcritos reversamente utilizando um kit de síntese de cDNA com remoção de DNA genômico, conforme o protocolo fornecido. O cDNA resultante foi diluído para 150 ng/μL.
A RT-qPCR foi realizada utilizando uma mistura mestra de qPCR baseada em SYBR Green em um sistema de PCR em tempo real. Cada reação de 10 μL continha 5 μL de mistura mestra 2x de SYBR Green, 0,5 μL de cada iniciador (primers) direto e reverso (10 μM), 1 μL de cDNA diluído (15 ng/μL) e 3 μL de água livre de nucleases. As condições de ciclagem foram desnaturação inicial a 95 °C por 5 min, seguida por 40 ciclos de 95 °C por 10 s e 60 °C por 30 s, com uma análise final de curva de dissociação de 60 °C a 95 °C para verificar a especificidade da amplificação. Todas as reações foram realizadas em triplicatas técnicas. β-actina foi utilizada como gene de referência interno. A eficiência dos primers para cada gene alvo foi validada utilizando série de diluições em curva padrão e variou de 90% a 110%. Os níveis de expressão gênica foram normalizados em relação à β-actina, e a expressão relativa foi calculada pelo método 2-ΔΔCt. As comparações estatísticas entre os grupos com DPOC e controle foram realizadas utilizando o teste Mann-Whitney U.
Análise estatística
As visualizações de rede foram criadas usando o Cytoscape, e as análises estatísticas foram realizadas usando o software R. Salvo indicação em contrário, o teste U de Mann-Whitney foi utilizado para dados com distribuição não normal, e o teste t de Student foi utilizado para dados com distribuição normal para comparar dois grupos. Um valor de p < 0,05 foi considerado estatisticamente significativo.
Resultados
Identificação de genes sobrepostos, análise de enriquecimento e construção da rede de interação proteína-proteína
Do conjunto de dados GSE54837, foram identificados 3.371 genes diferencialmente expressos (DEGs), incluindo 1.675 DEGs superexpressos e 1.696 DEGs subexpressos. Os 10 principais genes com maior significância de superexpressão e subexpressão são apresentados em Figura 1A. Foi realizada uma análise de agrupamento hierárquico dos dados do GSE54837 (Figura Suplementar 1A) e foi aplicada uma potência de limiarização suave de 10 para garantir uma topologia de rede livre de escala (Figura 1B). Módulos de coexpressão gênica foram construídos utilizando o método de corte dinâmico de árvores com um tamanho mínimo de módulo de 50 genes, e cada módulo recebeu uma cor distinta (Figura Suplementar 1B). Módulos com correlações de eigengenes > 0,75 foram posteriormente mesclados (Figura Suplementar 1C, Figura 1C), resultando em 14 módulos distintos. Com base na análise de correlação de Pearson entre os eigengenes dos módulos e as características clínicas, o módulo MEsalmon (composto por 5.226 genes) apresentou a correlação positiva mais significativa com DPOC (r = 0,35, p = 7 x 10⁻8, Figura 1D). A análise de Venn identificou 160 genes sobrepostos entre os 3.371 DEGs, os 5.226 genes do módulo MEsalmon e os 2.118 ac4C-RGsFigura 1E). A análise de enriquecimento funcional desses 160 genes mostrou que os termos GO significativos incluíram ligação ao RNA de fita simples, regulação do processo metabólico de mRNA e via de sinalização RIG-I (Figura 1F). Além disso, a análise KEGG demonstrou que esses genes foram principalmente enriquecidos na fagocitose mediada por receptores Fc gama R, na via de vigilância de mRNA e na adesão focal (Figura 1G). A rede PPI dos genes sobrepostos continha 118 nós e 196 arestas (Figura 1H).
Identificação de seis genes-chave na DPOC
Para identificar ainda mais os genes-chave potenciais entre os 160 candidatos sobrepostos, foram aplicados três algoritmos de aprendizado de máquina. Primeiramente, foi aplicada a regressão LASSO, utilizando validação cruzada para determinar o parâmetro de penalidade ótimo (λ) ≈ 0,091 (Figura 2A). O gráfico do perfil dos coeficientes indicou que 17 genes foram mantidos no valor ótimo de λ (Figura 2B). A análise XGBoost identificou os 30 principais genes com maior ganho, dentre os quais PTRF, WBP11 e LDOC1L apresentaram alto valor preditivo (Figura 2C). O algoritmo RF classificou de forma semelhante os 30 principais genes com base em suas pontuações de importância de Gini, sendo PTRF, RFX5 e PRKCDBP os mais preditivos (Figura 2D). A análise de interseção dos genes selecionados pelos três métodos identificou seis genes-chave sobrepostos: PTRF, PRKCDBP, UPP1, TOR3A, FAM168B e B4GALT2 (Figura 2E).
Construção do modelo diagnóstico e análise da expressão de genes-chave
Utilizando 70% do conjunto de dados GSE54837 como conjunto de treinamento, foi estabelecido um modelo de regressão logística que incorpora os seis genes-chave. A análise da curva ROC indicou desempenho diagnóstico moderado, com AUCs de 0,766 (IC 95%: 0,691–0,8417), 0,759 (IC 95%: 0,6368–0,8817) e 0,723 (IC 95%: 0,6085–0,8596) para os conjuntos de treinamento, teste interno e validação externa, respectivamente (Figura 3A–C). A análise de calibração confirmou alta confiabilidade, e a DCA indicou benefício clínico líquido claro em uma ampla faixa de probabilidades de limiar, tanto nos conjuntos de treinamento (Figura 3D–E) quanto de validação (Figura 3F–G). Foi construído um nomograma para visualizar a contribuição de cada gene e facilitar a estimativa de risco individualizada (Figura 3H). A análise de expressão revelou que B4GALT2, PRKCDBP e UPP1 estavam significativamente superexpressos em amostras de DPOC, enquanto FAM168B, PTRF e TOR3A estavam subexpressos (Figura 3I).
Rede regulatória e análise funcional dos genes-chave na DPOC
Foi construída uma rede de interação funcional composta pelos 20 principais genes mais relacionados aos genes centrais identificados, utilizando a análise GeneMANIA (Figura 4A). As interações físicas representaram a maioria das conexões, seguidas por correlações de coexpressão e domínios proteicos compartilhados. A anotação funcional indicou enriquecimento significativo em processos como processo catabólico de molécula pequena contendo nucleobase, processo catabólico de nucleosídeo e microdomínio de membrana plasmática. A regulação pós-transcricional foi investigada por meio da interseção de predições de miRNAs provenientes dos bancos de dados DIANA-microT e miRanda, identificando oito miRNAs sobrepostos (Figura 4B). Um eixo regulatório lncRNA-miRNA-mRNA foi posteriormente construído. De acordo com o diagrama de Sankey, dois dos miRNAs identificados, ambos associados à regulação de FAM168B, foram preditos como alvos de sete lncRNAs; nenhuma interação regulatória desse tipo foi identificada para os cinco genes centrais restantes (Figura 4C). A regulação transcricional foi ainda explorada utilizando a plataforma ChEA3, que predisse fatores de transcrição (FTs) upstream para B4GALT2, UPP1, FAM168B e TOR3A. Os dez principais FTs para cada gene foram selecionados para a construção de uma rede regulatória FT-alvo (Figura 4D). A GSEA foi realizada para investigar as funções biológicas dos seis genes-chave. UPP1 apresentou enriquecimento significativo em processos biológicos como processo metabólico de diacilglicerol e processo biossintético de trifosfato de nucleosídeo de purina, bem como em vias incluindo proteassoma e metabolismo de xenobióticos pelo citocromo P450 (Figura 4E–F). Os resultados de enriquecimento para os cinco genes-chave restantes estão apresentados na Figura Suplementar 2A–J.
Infiltração imune de UPP1 e predição de alvos farmacológicos na DPOC
Os níveis de infiltração imune de 28 tipos de células imunes foram avaliados nos grupos controle e DPOC utilizando o algoritmo ssGSEA. Em pacientes com DPOC, células B de memória, células supressoras derivadas de mieloides e células dendríticas ativadas apresentaram escores de enriquecimento significativamente mais altos. Em contraste, células T auxiliares tipo 1, células B ativadas e células B imaturas apresentaram escores de enriquecimento significativamente mais baixos (Figura 5A). Deve-se observar que o ssGSEA fornece estimativas relativas de enriquecimento de células imunes com base em dados transcriptômicos, e não em medições diretas das proporções de células imunes. A análise de correlação revelou que os seis genes-chave exibiram padrões diferenciais de associação com subconjuntos de células imunes. Especificamente, UPP1, PRKCDBP e B4GALT2 correlacionaram-se positivamente com os níveis de infiltração de células B de memória, células dendríticas ativadas e células supressoras derivadas de mieloides (Spearman ρ > 0,4, p < 0,05), enquanto PTRF, TOR3A e FAM168B mostraram correlações negativas com células T auxiliares tipo 1 e células B ativadas (Spearman ρ < −0,3, p < 0,05). A matriz completa de correlação é apresentada no mapa de calor (Figura 5B). A análise de predição de fármacos identificou UPP1 como o único gene entre os seis candidatos com interações previstas com moléculas pequenas. Três compostos, incluindo fluorouracila, capecitabina e 5-benzilacilouridina, foram identificados no banco de dados como compostos potencialmente interagentes com UPP1 (Figura 5C). Esses compostos são principalmente utilizados em oncologia ou em contextos experimentais, e sua relevância para a DPOC exige investigação adicional. Os cálculos de energia livre de ligação revelaram que a 5-benzilacilouridina exibiu a maior afinidade de ligação, sugerindo uma afinidade de ligação prevista relativamente mais alta (Table 3). As visualizações de encaixe molecular para os três compostos indicaram conformações de ligação previstas favoráveis com UPP1, consistentes com previsões computacionais de encaixe molecular e não com validação experimental (Figura 5D–F). Adicionalmente, a análise CTD indicou que os seis genes-chave estavam fortemente associados a diversos fenótipos de doenças, incluindo efeitos tardios da exposição pré-natal, perda de peso, hepatomegalia e inflamação (Figura 5G–L).
Validação por RT-qPCR de genes diagnósticos-chave em amostras clínicas
Para validar os níveis de expressão de genes-chave, amostras de sangue foram coletadas de oito pacientes com DPOC e oito indivíduos controle, e esta análise foi considerada uma validação preliminar devido ao tamanho limitado da amostra. Conforme mostrado na Figura 6A–F, PTRF, TOR3A e FAM168B foram significativamente subexpressos, enquanto PRKCDBP e UPP1 foram significativamente superexpressos nas amostras de DPOC, o que está de acordo com as tendências observadas na análise de bioinformática. Em contraste, nenhuma diferença significativa foi observada na expressão de B4GALT2 entre os dois grupos. Essa discrepância pode ser atribuída ao tamanho limitado da amostra ou às diferenças nos tipos de amostras entre os conjuntos de dados e os espécimes clínicos.
DECLARAÇÃO DE DISPONIBILIDADE DE DADOS:
Todos os dados de sequenciamento de RNA foram obtidos do banco de dados Gene Expression Omnibus (GEO, https://www.ncbi.nlm.nih.gov), sendo o conjunto GSE54837 selecionado como conjunto de treinamento e o GSE112811 como conjunto de validação. O código utilizado nesta análise pode ser obtido em https://doi.org/10.5281/zenodo.21771476.
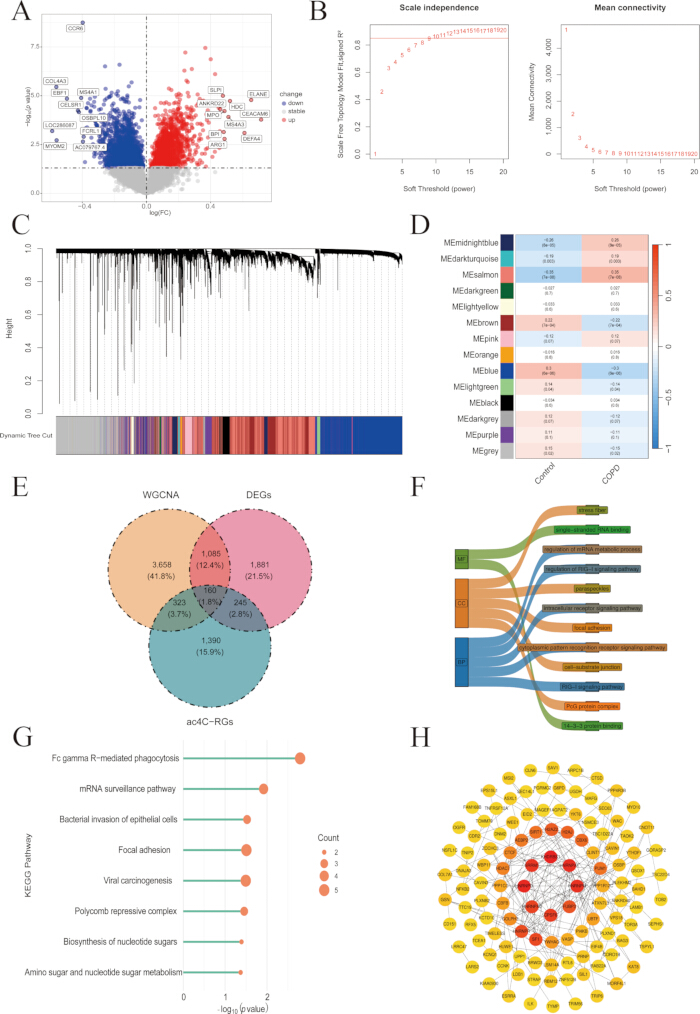
Figura 1: Identificação de genes sobrepostos, análise de enriquecimento e construção da rede PPI. (A) Gráfico de vulcão dos genes diferencialmente expressos (DEGs) no conjunto de dados GSE54837. (B) Seleção do limiar suave. (C) Dendrograma de agrupamento por módulos (após fusão). (D) Mapa de calor da correlação entre módulos e características. (E) Diagrama de Venn para identificação de genes sobrepostos. (F) Diagrama de ameixa-mulberry da análise de enriquecimento GO, mostrando os principais resultados de enriquecimento dos genes de interseção em MF, CC e BP. (G) Diagrama de pirulito da análise de enriquecimento de vias de sinalização KEGG, em que o tamanho da bolha representa o número de genes enriquecidos. (H) Rede PPI dos genes sobrepostos; os nós representam proteínas e as arestas representam interações proteína-proteína. Abreviações: DEGs = genes diferencialmente expressos; PPI = interação proteína-proteína; GO = Ontologia Genética; MF = função molecular; CC = componente celular; BP = processo biológico; KEGG = Enciclopédia de Genes e Genomas de Quioto; ac4C-RGs = genes relacionados à N4-acetilcitidina. Clique aqui para visualizar uma versão maior desta figura.
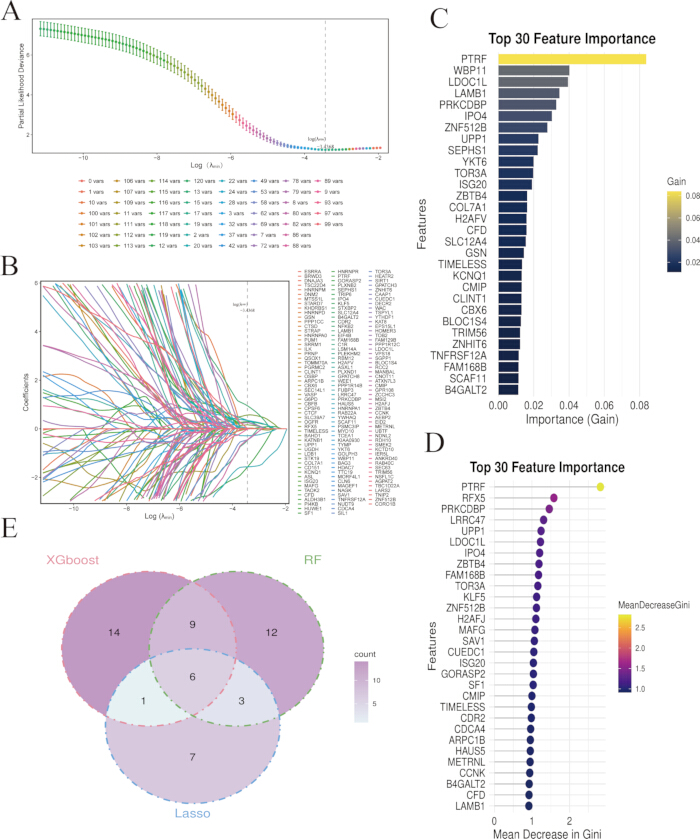
Figura 2: Identificação de seis genes-chave na DPOC. (A) Curva de validação cruzada LASSO. (B) Diagrama do caminho dos coeficientes da regressão LASSO. À medida que λ aumenta, os coeficientes dos genes não importantes convergem para 0. (C) Classificação da importância das características pelo XGBoost. O eixo x representa o valor de ganho, o eixo y representa o nome do gene e a intensidade da cor representa a importância. (D) Classificação da importância das características pela RF. O eixo x representa a diminuição média no índice de Gini. (E) O diagrama de Venn dos genes sobrepostos obtidos pela análise cruzada dos três algoritmos. Abreviações: LASSO = operador de redução e seleção por módulo mínimo; XGBoost = reforço gradiente extremo; RF = floresta aleatória. Clique aqui para visualizar uma versão maior desta figura.
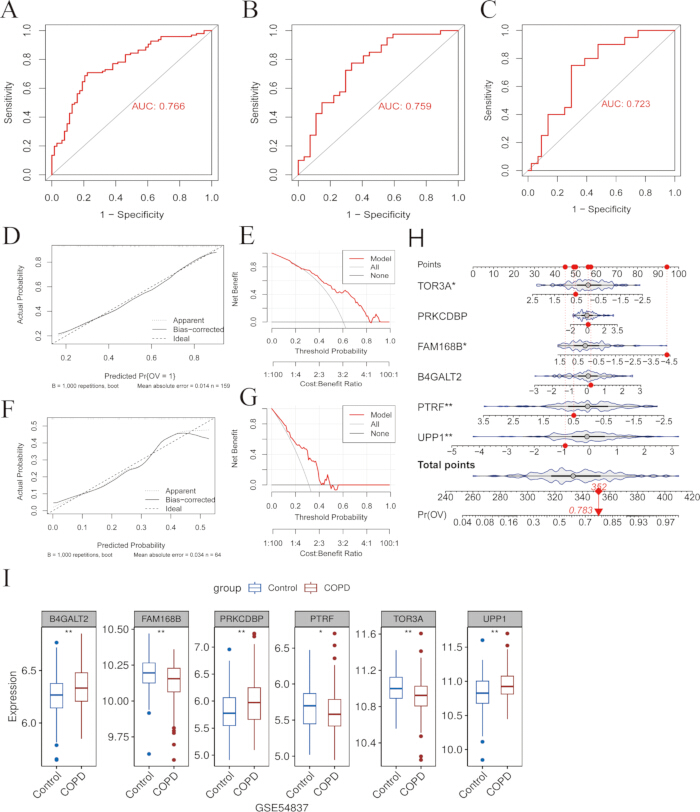
Figura 3: Construção de um modelo diagnóstico e análise da expressão de genes-chave. (A) Curva ROC do conjunto de treinamento. (B) Curva ROC do conjunto de teste interno. (C) Curva ROC do conjunto de validação externa. (D) Curva de calibração do conjunto de treinamento. (E) Análise da curva de decisão (DCA) do conjunto de treinamento. (F) Curva de calibração do conjunto de validação externa. (G) Análise da curva de decisão (DCA) do conjunto de validação externa. (H) Nômograma de seis genes-chave. Para a predição do risco individual de DPOC, cada gene recebe uma pontuação correspondente. (I) Análise da expressão de seis genes-chave em amostras de DPOC e controles do conjunto de dados GSE54837. Abreviações: ROC = característica operacional do receptor; AUC = área sob a curva; DCA = análise da curva de decisão; DPOC = doença pulmonar obstrutiva crônica. Clique aqui para visualizar uma versão maior desta figura.
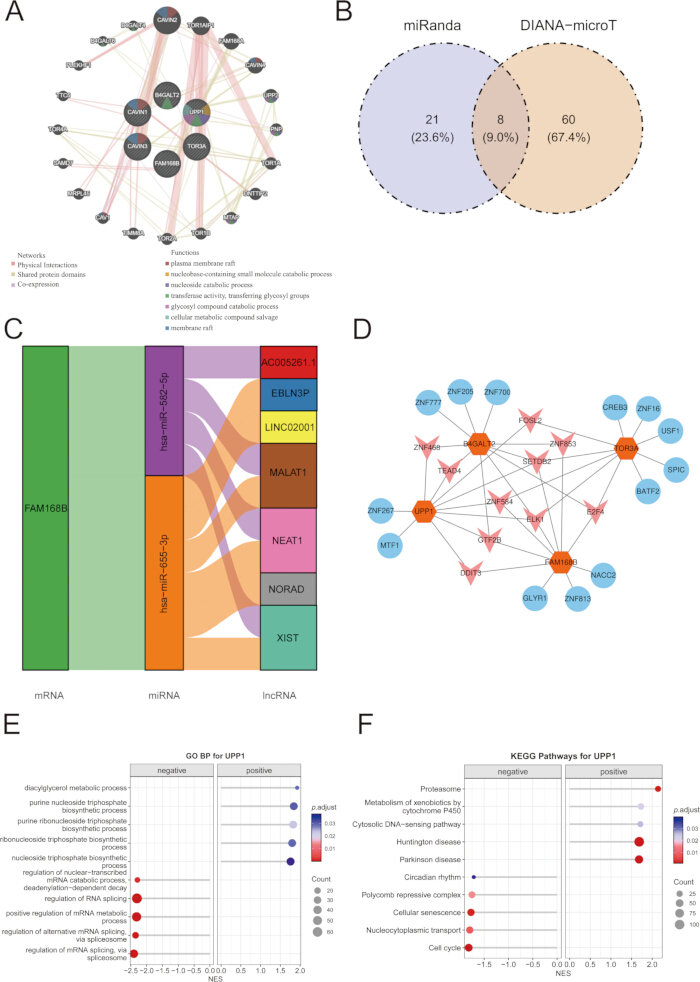
Figura 4: Rede regulatória e significado funcional dos genes-chave na DPOC. (A) Resultados da análise GeneMANIA de 6 genes-chave. A cor das linhas indica a correlação entre os genes, e a cor dos nós indica diferentes categorias funcionais. (B) Diagrama de Venn da análise cruzada dos bancos de dados DIANA-microT e miRanda. (C) Diagrama de ameixeira da rede regulatória ceRNA. (D) Rede regulatória potencial de fatores de transcrição. Nós azuis representam fatores de transcrição e nós laranjas representam genes alvo. (E) Análise de enriquecimento GSEA de gene único para UPP1, incluindo GO. (F) Análise de enriquecimento GSEA de gene único para UPP1, incluindo KEGG. Abreviações: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Clique aqui para visualizar uma versão maior desta figura.
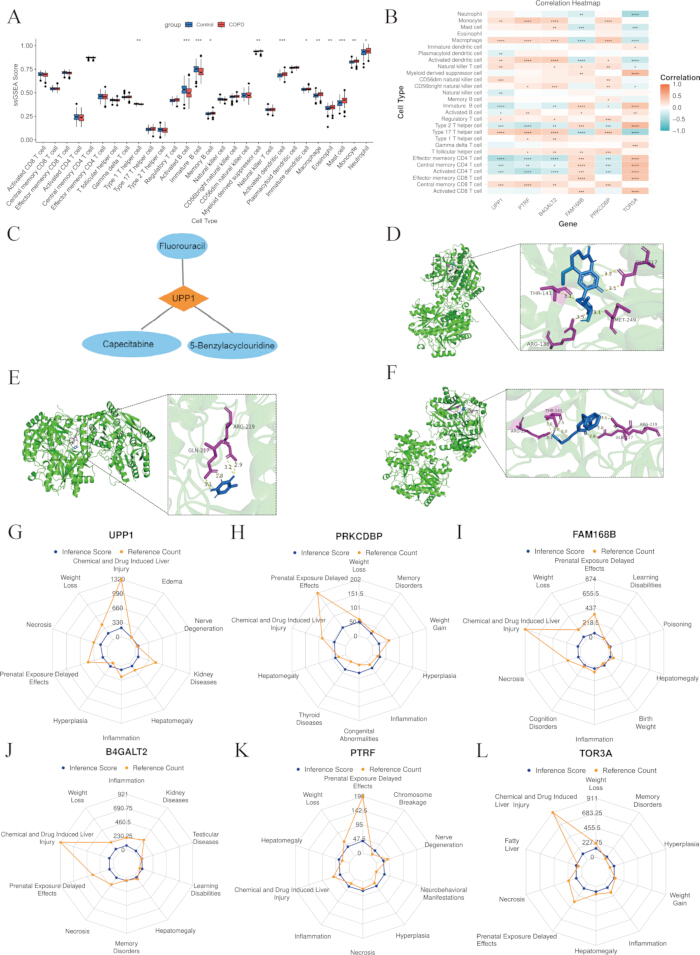
Figura 5: Infiltração imune de genes-chave e predição de alvos farmacológicos na DPOC. (A) Diferenças na abundância de células imunes entre os grupos. (B) Mapa de calor da correlação entre células imunes e genes-chave. (C) Rede de interação entre genes-chave e fármacos preditos. (D) Encaixe molecular da fluorouracila com UPP1. (E) Encaixe molecular da capecitabina com UPP1. (F) Encaixe molecular do 5-benzilacilouridina com UPP1. Para cada composto, a imagem à esquerda mostra a conformação geral do encaixe, e a imagem à direita mostra as interações locais de ligação. (G) Análise CTD de B4GALT2. (H) Análise CTD de FAM168B. (I) Análise CTD de PRKCDBP. (J) Análise CTD de PTRF. (K) Análise CTD de TOR3A. (L) Análise CTD de UPP1. Clique aqui para visualizar uma versão maior desta figura.
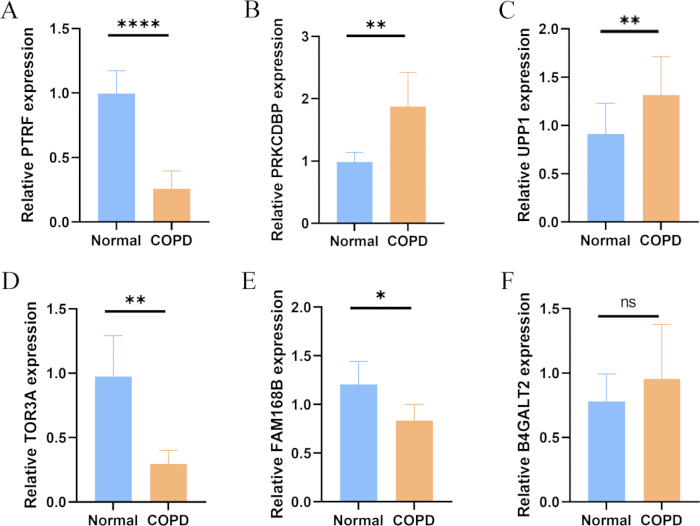
Figura 6: Validação por RT-qPCR da expressão gênica chave em amostras de DPOC e controles. (A) Expressão relativa de PTRF. (B) Expressão relativa de PRKCDBP. (C) Expressão relativa de UPP1. (D) Expressão relativa de TOR3A. (E) Expressão relativa de FAM168B. (F) Expressão relativa de B4GALT2. ns = não significativo, p > 0,05; * p < 0,05; ** p < 0,01; *** p < 0,001; **** p < 0,0001. Abreviação: RT-qPCR = reação em cadeia da polimerase quantitativa com transcrição reversa. Clique aqui para visualizar uma versão maior desta figura.
Figura Suplementar 1: Amostras do conjunto de dados GSE54837 e agrupamento de módulos gênicos. (A) Diagrama de agrupamento de amostras do conjunto de dados GSE54837. (B) Dendrograma de agrupamento de módulos antes da fusão. Os genes foram agrupados utilizando o método de corte de árvore dinâmico para identificar módulos distintos. (C) Dendrograma de agrupamento hierárquico de eigengenes dos módulos. Módulos com padrões de expressão semelhantes foram agrupados com base na similaridade de seus eigengenes.Clique aqui para baixar este arquivo.
Figura Suplementar 2: Análise de enriquecimento GSEA. (A) Análise GO do PRKCDBP. (B) Análise KEGG do PRKCDBP. (C) Análise GO do PTRF. (D) Análise KEGG do PTRF. (E) Análise GO do TOR3A. (F) Análise KEGG do TOR3A. (G) Análise GO do FAM168B. (H) Análise KEGG do FAM168B. (I) Análise GO do B4GALT2. (J) Análise KEGG do B4GALT2. Abreviações: GO = Ontologia Genética; KEGG = Enciclopédia de Kyoto de Genes e Genomas.Clique aqui para baixar este arquivo.
| Conjunto de dados | Controles | Pacientes | Plataforma de sequenciamento |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Tabela 1: Conjuntos de dados de expressão gênica utilizados no estudo. Características dos conjuntos de dados GSE54837 e GSE112811 utilizados para o desenvolvimento/teste interno do modelo e para a validação externa, respectivamente.
| Paciente | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Sexo (F/M) | M | M | M | F | M | M | M | M |
| Idade (anos) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Estado de tabagismo | Sim | Sim | Parou de fumar (2 anos) | Não | Sim | Sim | Sim | Parou de fumar (5 anos) |
| Maços-ano | 20 por dia / 30 anos | 15 por dia / 35 anos | 20 por dia / 50 anos | 20 por dia / 40 anos | 30 por dia / 40 anos | 15 por dia / 40 anos | 20 por dia / 30 anos | |
| Grupo de DPOC | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Tabela 2: Características basais dos participantes do estudo. Características demográficas e clínicas basais dos pacientes com DPOC e controles saudáveis incluídos na validação por RT-qPCR.
| Nome molecular | Gene | Pontuação (kcal/mol) |
| 5-Benzilacilouridina | UPP1 | -9.6 |
| Capecitabina | UPP1 | -6.1 |
| Fluorouracila | UPP1 | -5.5 |
Tabela 3: Resultados da simulação de ligação molecular para UPP1 e compostos candidatos.
Resultados preditos da simulação de ligação molecular para a interação de UPP1 com fluorouracil, capecitabina e 5-benzilacilouridina, incluindo suas afinidades de ligação.
Discussão
A modificação conservada de RNA ac4C, que ocorre predominantemente em RNA mensageiro (mRNA) e RNA transportador (tRNA), aumenta a estabilidade do mRNA e a eficiência de tradução20. NAT10 é a única acetiltransferase de RNA conhecida que media a modificação ac4C21. Estudos demonstraram que NAT10 está sobreexpressada em células epiteliais pulmonares de pacientes com DPOC. A supressão de NAT10 prejudica a função mitocondrial e as respostas transcriptômicas22. Com base em uma análise integrada de múltiplos ômicas, este estudo identificou seis genes-chave estreitamente associados à DPOC e desenvolveu um modelo diagnóstico, que apresentou desempenho diagnóstico moderado e valor potencial para investigações futuras. Análises adicionais revelaram os papéis centrais desses genes na regulação transcricional, nas redes ceRNA e no microambiente imunológico. Além disso, foram previstos fármacos alvo potenciais, fornecendo novas perspectivas sobre a patogênese da DPOC e facilitando o desenvolvimento de estratégias de tratamento personalizadas e precisas. Identificamos genes que apresentavam expressão diferencial na DPOC e estavam presentes em uma lista previamente publicada de genes relacionados ao ac4C, utilizando análise de WGCNA e de expressão diferencial. É importante ressaltar que esses genes foram selecionados com base em sua associação com a rede reguladora de ac4C, e não em ligações mecanicistas comprovadas com NAT10 ou com a acetilação de ac4C, resultando em um total de 160 genes candidatos. Seis genes-chave (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B e B4GALT2) foram identificados por meio de algoritmos de aprendizado de máquina. Dentre eles, o PTRF desempenha um papel crítico na inflamação das vias aéreas induzida por ácaros da poeira doméstica (HDM), regulando a necroptose de macrófagos mediada pelo eixo IL-33-ZBP1, sugerindo que pode estar envolvido em condições pulmonares inflamatórias crônicas, como a DPOC23. Lai et al.24 demonstraram que a administração exógena de uridina inibe a ferroptose em macrófagos por meio da via Nrf2/SLC7A11/GPX4, aliviando assim a lesão pulmonar aguda causada pela sepse. Embora a sobreexpressão de UPP1, uma enzima-chave no metabolismo da uridina, tenha sido observada em tecido pulmonar de modelos de lesão pulmonar aguda, seu papel exato — e se essa sobreexpressão representa uma resposta protetora ou uma consequência do dano tecidual — permanece a ser elucidado. No entanto, essa descoberta sugere que UPP1 pode ter uma associação potencial com os processos fisiopatológicos de doenças pulmonares inflamatórias, como a DPOC, justificando investigações adicionais. Os quatro genes-chave restantes foram menos estudados em doenças pulmonares, mas com base em suas funções em outras doenças e em nossas descobertas atuais, hipotetizamos vias potenciais pelas quais eles podem contribuir para a patogênese da DPOC.
Com base nos seis genes-chave, construímos um modelo diagnóstico para DPOC e validamos seu bom desempenho preditivo. A análise de expressão mostrou que UPP1, B4GALT2 e PRKCDBP estavam significativamente superexpressos, enquanto FAM168B, PTRF e TOR3A estavam acentuadamente subexpressos na DPOC. Embora B4GALT2 tenha sido identificado como superexpresso na análise dos conjuntos de dados, nenhuma diferença significativa foi observada na validação por RT-qPCR. Essa discrepância pode ser atribuída ao tamanho limitado da amostra, à heterogeneidade da coorte e às diferenças nas fontes das amostras entre os conjuntos de dados públicos e as amostras clínicas de sangue. A análise de enriquecimento de conjuntos de genes revelou que esses genes-chave estavam significativamente enriquecidos no splicing de RNA e no processamento de mRNA, bem como em vias como o ciclo celular e a dependência da nicotina. O bloqueio irreversível do ciclo celular tem sido reconhecido como um mecanismo primário subjacente à senescência celular, o que pode contribuir substancialmente para a fisiopatologia da DPOC25,26. A análise adicional indicou que o fenótipo secretório associado à senescência (SASP) induzido por danos ao DNA pode promover a progressão persistente da DPOC ao manter a inflamação crônica e agravar a lesão do tecido pulmonar27. Um estudo anterior também revisou as ligações genéticas subjacentes à dependência da nicotina e à DPOC28. Embora o tabagismo seja o fator de risco primário para a DPOC, apenas uma pequena proporção de fumantes desenvolve a doença, sugerindo que fatores genéticos desempenham um papel importante tanto na DPOC quanto na dependência da nicotina. Liu et al.29 resumiram os papéis das proteínas ligadoras de RNA (RBPs) na DPOC e na hipertensão pulmonar (HP), enfatizando sua participação no remodelamento vascular pulmonar e nas respostas inflamatórias por meio da regulação do splicing de mRNA e da expressão gênica pós-transcricional, destacando assim seu potencial como biomarcadores e alvos terapêuticos. Em resumo, os genes-chave e as vias associadas identificados neste estudo não apenas aprofundam nossa compreensão da patogênese da DPOC, mas também fornecem uma base sólida para o desenvolvimento de biomarcadores diagnósticos futuros e estratégias terapêuticas direcionadas.
A rede ceRNA envolve várias espécies de RNA, incluindo lncRNAs, circRNAs e mRNAs, que se ligam competitivamente a miRNAs compartilhados, formando assim relações regulatórias mútuas e influenciando a expressão gênica30. Essa rede complexa participa de inúmeros processos fisiológicos e patológicos e contribui para elucidar os mecanismos regulatórios gênicos e a patogênese de doenças como câncer e distúrbios inflamatórios crônicos. Por exemplo, Wang et al. construíram uma rede de coexpressão ceRNA composta por 11 lncRNAs, cinco miRNAs e 16 mRNAs, na qual a sub-rede central estava associada a alterações nas proporções de células imunes e na função pulmonar na DPOC31. De forma semelhante, Zhang et al.32 desenvolveram uma rede ceRNA circRNA-miRNA-mRNA com base em células mononucleares do sangue periférico de homens fumantes, identificando circRNAs desregulados e vias-chave relacionadas à DPOC. Nossa análise de rede de coexpressão revelou que os genes-chave estabeleciam principalmente conexões funcionais por meio de interações físicas, coexpressão e domínios proteicos compartilhados, e estavam significativamente enriquecidos em múltiplas vias relacionadas ao metabolismo. Com base nesses achados, construímos ainda uma rede regulatória fator de transcrição (TF)-alvo e um eixo regulatório miRNA-lncRNA-mRNA. Esses resultados sugerem que os genes-chave podem ser regulados cooperativamente por meio de mecanismos multilayer envolvendo lncRNAs, fatores de transcrição e miRNAs na DPOC.
A infiltração imune reflete o estado imunológico ao indicar a distribuição e atividade de células imunes nos tecidos ou no sangue. Com base nisso, drogas candidatas potenciais foram previstas por meio de triagem computacional, seguida de simulações de encaixe molecular para avaliar a afinidade e estabilidade de ligação com proteínas-alvo. Em conjunto, essas análises facilitam a identificação de novos agentes terapêuticos e fornecem insights mais profundos sobre os mecanismos da doença. Neste estudo, seis genes-chave apresentaram correlação positiva com a maioria das infiltrações de células imunes. A predição de fármacos identificou interações potenciais entre UPP1 e fluorouracil, capecitabina e 5-benzilacilouridina, sendo esta última a que exibiu maior afinidade de ligação, conforme confirmado adicionalmente pelo encaixe molecular. Notavelmente, o fluorouracil e a capecitabina são utilizados principalmente como agentes antitumorais e foram identificados neste estudo como compostos preditos por banco de dados que interagem com UPP1, e não como opções terapêuticas validadas para DPOC. Estudos anteriores relataram que a administração local de fluorouracil pode melhorar a perviedade das vias aéreas em casos de obstrução severa33. No entanto, outras evidências indicam que o fluorouracil e a capecitabina podem induzir toxicidade pulmonar, particularmente em pacientes com condições pulmonares preexistentes34. Portanto, sua relevância potencial para a DPOC exige verificação experimental e de segurança adicional. Além disso, a análise CTD indicou que todos os seis genes-chave estavam associados a múltiplos processos patológicos. Em conjunto, a análise integrada de infiltração imune, predição de fármacos e encaixe molecular fornece novos alvos moleculares e uma base teórica para o tratamento preciso da DPOC, promovendo assim o desenvolvimento e a tradução clínica de fármacos relacionados.
No entanto, várias limitações devem ser reconhecidas. O estudo baseou-se em conjuntos de dados públicos com fontes de amostras relativamente limitadas, o que pode introduzir efeitos de lote e potencial sobreajuste do modelo. A validação por RT-qPCR foi realizada em uma pequena coorte, e a inconsistência observada na expressão de B4GALT2 sugere possível heterogeneidade da coorte. Além disso, as análises de infiltração imune e predição de fármacos foram de natureza computacional e requerem validação experimental adicional. Além disso, como uma investigação bioinformática na fase de descoberta, nosso modelo diagnóstico foi avaliado principalmente por meio de valores de AUC com intervalos de confiança de 95%. Métricas abrangentes de desempenho, como sensibilidade, especificidade, valores preditivos e estatísticas detalhadas de calibração, não foram totalmente avaliadas devido à natureza retrospectiva dos conjuntos de dados públicos e aos tamanhos limitados das amostras. Portanto, nosso modelo deve ser considerado uma ferramenta de prova de conceito, e sua utilidade clínica exige validação adicional em coortes prospectivas maiores.
Por meio de análises integrativas de bioinformática e aprendizado de máquina, este estudo identificou seis genes-chave significativamente associados à DPOC. Um modelo diagnóstico robusto foi estabelecido, demonstrando desempenho preditivo confiável em múltiplas coortes. Análises funcionais revelaram que esses genes participam de redes regulatórias críticas envolvendo regulação transcricional e pós-transcricional, infiltração de células imunes e vias relacionadas à dependência da nicotina e ao ciclo celular. Análises de predição de fármacos e de ancoragem molecular destacaram a UPP1 como um alvo terapêutico promissor, com vários compostos candidatos exibindo fortes afinidades de ligação. No geral, essas descobertas ampliam nossa compreensão da fisiopatologia da DPOC e fornecem alvos moleculares valiosos para o desenvolvimento futuro de terapias e estratégias de medicina de precisão.
Divulgações
Os autores declaram não haver conflitos de interesse. O consentimento informado foi obtido de todos os indivíduos participantes do estudo.
Agradecimentos
Agradecemos ao Hospital Shenzhen Luohu de Medicina Tradicional Chinesa por fornecer as instalações clínicas e o apoio administrativo essenciais para este estudo. Por fim, somos gratos a todos os pacientes e voluntários saudáveis que participaram desta pesquisa; sua contribuição foi indispensável para este trabalho. Este trabalho foi apoiado pelo Projeto Sanming de Medicina em Shenzhen (nº SZZYSM202401018), pelos Fundos de Especialidade Prioritária do Distrito de Luohu (nº LX202402021) e pelos Fundos de Especialidade Prioritária do Distrito de Luohu (nº LX202302064).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| β-actin primers | Tsingke | N/A | Forward: 5’-CATGTACGTTGCTATCCAGGC-3’ Reverse: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| Primers B4GALT2 | Tsingke | N/A | Forward: 5’-GGGCAGACTGCTGATCGAG-3’ Reverse: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | Online | Encaixe molecular |
| clusterProfiler | Bioconductor | v4.14.6 | Análise de enriquecimento |
| Cytoscape | Consortium Cytoscape | v3.8.3 | Visualização de rede |
| DrugBank | Universidade de Alberta | Online | Previsão de fármacos |
| Primers FAM168B | Tsingke | N/A | Forward: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Reverse: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | Regressão LASSO |
| GSVA | Bioconductor | v1.52.3 | Análise ssGSEA |
| Hifair III 1st Strand cDNA Synthesis Supermix | YEASEN | 11141ES | Síntese de cDNA |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | Amplificação qPCR |
| limma | Bioconductor | v3.54.0 | Expressão diferencial |
| LightCycler 480 II System | Roche | LightCycler 480 II | PCR em tempo real |
| Primers PTRF | Tsingke | N/A | Forward: 5’-GGGCCGTAGACCAGATCCA-3’ Reverse: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| Primers PRKCDBP | Tsingke | N/A | Forward: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Reverse: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| Software R | Fundação R | v4.4.2 | Computação estatística |
| randomForest | CRAN | v4.7 | Floresta Aleatória |
| RNA isolater MolPure Blood RNA Kit | YEASEN | 19241ES50 | Extração de RNA |
| Banco de dados STRING | EMBL | Online | Rede PPI |
| Primers TOR3A | Tsingke | N/A | Forward: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Reverse: 5’-CCCGTCCCGATACAGGTTC-3’ |
| Primers UPP1 | Tsingke | N/A | Forward: 5’-CTGTCAGTCATGGTATGGGCA-3’ Reverse: 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA | CRAN | v1.72 | Rede de coexpressão |
| xgboost | CRAN | v1.7 | Algoritmo XGBoost |
Referências
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.