Este protocolo integra dados transcriptômicos multidimensionais com aprendizado de máquina para identificar genes relacionados ao envelhecimento e às mitocôndrias na miocardiopatia dilatada, visando a descoberta de biomarcadores e a subtipagem molecular.
Artigo de investigação
Identificação de Genes Hub Relacionados ao Envelhecimento e às Mitocôndrias na Cardiomiopatia Dilatada
Neste artigo
Resumo
Resumo
A miocardiopatia dilatada (DCM) caracteriza-se por dilatação do ventrículo esquerdo e disfunção sistólica, estando associada à disfunção mitocondrial e à ativação imune-inflamatória. No entanto, as assinaturas moleculares relacionadas ao envelhecimento e as vias regulatórias mitocondriais na DCM ainda não são completamente compreendidas. Este estudo analisou seis conjuntos de dados transcriptômicos em grupo e um conjunto de dados de sequenciamento de RNA de célula única provenientes do banco de dados Gene Expression Omnibus. Após normalização dos dados, correção de lote e anotação de tipos celulares, genes candidatos relacionados ao envelhecimento e às mitocôndrias foram identificados por meio de análise de expressão diferencial, análise de rede de coexpressão gênica ponderada e construção de rede de interação proteína-proteína. Genes centrais foram posteriormente selecionados utilizando regressão por operador de redução e seleção absoluta mínima, floresta aleatória e eliminação recursiva de características por máquina de vetores de suporte. Foram realizadas análises de infiltração de células imunes, comunicação célula-célula e subtipagem molecular para caracterizar o microambiente imune cardíaco na DCM. Um total de 66 genes relacionados ao envelhecimento e 16 genes relacionados às mitocôndrias foram associados à DCM e estavam principalmente enriquecidos nas vias de sinalização do fator induzível por hipóxia-1, fosforilação oxidativa e vias relacionadas à óxido nítrico sintase. Análises de aprendizado de máquina e de sequenciamento de RNA de célula única identificaram SERPINE1, TGFB2, CYBB e TLR2 como genes centrais. CYBB e TLR2 foram altamente expressos em monócitos e macrófagos, enquanto SERPINE1 e TGFB2 foram predominantemente expressos em células estromais. A análise da paisagem imune mostrou ativação aumentada de macrófagos pró-inflamatórios e comunicação alterada entre células nas amostras de DCM. Com base na expressão dos genes centrais, as amostras de DCM foram divididas em dois subtipos moleculares associados à sinalização do fator de crescimento endotelial vascular e à biossíntese de ácidos biliares primários, respectivamente. Este protocolo fornece uma estrutura integrada para identificar biomarcadores candidatos e subtipos moleculares na DCM.
Introdução
A miocardiopatia dilatada (DCM) é uma desordem miocárdica caracterizada pela dilatação do ventrículo esquerdo e disfunção sistólica. É a terceira causa mais comum de insuficiência cardíaca e a principal indicação para transplante cardíaco em todo o mundo1. Estudos baseados em populações estimam uma prevalência de aproximadamente 1 em cada 250 adultos, com maior prevalência em homens e uma proporção substancial de casos atribuível a variantes monogênicas2. Esses achados indicam que tanto a suscetibilidade genética quanto fatores ambientais contribuem para o início e a progressão da DCM.
A patogênese da miocardiopatia dilatada envolve processos interconectados, incluindo ativação inflamatória, estresse oxidativo, apoptose de cardiomiócitos e sinalização profibrótica desregulada. Polimorfismos genéticos inflamatórios, incluindo variantes do promotor do fator de necrose tumoral-α, têm sido associados à suscetibilidade à miocardiopatia dilatada viral3. O aumento do estresse oxidativo também tem sido associado à morte de cardiomiócitos e à disfunção do ventrículo esquerdo em subtipos humanos de miocardiopatia dilatada4. Além disso, a ativação aberrante das vias de sinalização Wnt/β-catenina e calcineurina/fator nuclear de linfócitos T ativados promove hipertrofia miocárdica e fibrose intersticial, contribuindo assim para a progressão da doença5,6. A disfunção mitocondrial é outro componente importante da miocardiopatia dilatada, pois os cardiomiócitos possuem elevadas demandas energéticas. A desregulação da biogênese mitocondrial, da homeostase de cálcio, da mitofagia e da integridade do DNA mitocondrial pode prejudicar a fosforilação oxidativa e contribuir para a disfunção cardíaca progressiva7,8,9,10.
Apesar dessas descobertas mecanicistas, lacunas importantes de conhecimento permanecem. Em particular, as relações temporais e causais entre a remodelação estrutural mitocondrial e a disfunção bioenergética durante a iniciação e a progressão da miocardiopatia dilatada não foram totalmente definidas11. Várias estratégias terapêuticas já foram investigadas. A terapia com células-tronco demonstrou potencial regenerativo por meio de efeitos parácrinos, citoprotetores e imunomoduladores, mas ainda é necessário otimizar as fontes celulares, as vias de administração e a sobrevivência pós-transplante12. Abordagens de terapia gênica, incluindo a entrega baseada em vírus adeno-associados e a edição genômica baseada em repetições palindrômicas curtas agrupadas e regularmente espaçadas, também oferecem estratégias potenciais de tratamento preciso. No entanto, limitações relacionadas à tropismo cardíaco, imunogenicidade do vetor e segurança a longo prazo ainda permanecem sem solução13.
Conjuntos de dados transcriptômicos públicos de repositórios como o Gene Expression Omnibus (GEO) são amplamente utilizados na descoberta de biomarcadores na miocardiopatia dilatada (DCM). Esses recursos permitem o acesso a coortes clínicas multicêntricas, apoiam investigações com custo-efetivo e reprodutíveis, e podem melhorar o poder estatístico por meio da integração entre conjuntos de dados14. O perfilamento transcriptômico também permite a triagem de genes candidatos em todo o genoma, a subtipagem molecular e a análise em nível de vias metabólicas15. No entanto, os conjuntos de dados públicos apresentam limitações inerentes, incluindo efeitos técnicos de lote, heterogeneidade clínica e etiológica, capacidade limitada de inferência causal e informações longitudinais ou prognósticas incompletas16. Portanto, os achados derivados de conjuntos de dados transcriptômicos públicos são mais adequados para geração de hipóteses e priorização de biomarcadores candidatos, exigindo validação em coortes independentes e modelos experimentais.
Muitos estudos bioinformáticos da miocardiopatia dilatada (DCM) baseiam-se principalmente na análise de expressão diferencial, que pode gerar achados falsos positivos e não caracteriza completamente as redes de coexpressão gênica ou a heterogeneidade celular no tecido cardíaco. Para abordar essas limitações, o presente estudo empregou uma estratégia analítica integrada que combina métodos complementares. A análise transcriptômica em conjunto fornece perfis de expressão em nível tecidual, adequados para comparações entre casos e controles. A análise de rede de coexpressão gênica ponderada (WGCNA) identifica módulos de genes associados a traços fenotípicos e permite a priorização de conjuntos de genes funcionalmente relacionados, em vez de genes individualmente diferencialmente expressos. A análise de rede de interação proteína-proteína (PPI) identifica genes altamente conectados com base na topologia da rede. Três algoritmos de aprendizado de máquina — regressão com operador de contração e seleção por mínimos absolutos (LASSO), floresta aleatória e máquina de vetores de suporte com eliminação recursiva de características — foram utilizados para identificar biomarcadores candidatos nos conjuntos de dados integrados¹⁷. Em seguida, o sequenciamento de RNA em única célula (scRNA-seq) foi utilizado para examinar padrões de expressão específicos de tipo celular e redes de comunicação intercelular18.
Embora a disfunção mitocondrial e as alterações moleculares relacionadas ao envelhecimento tenham sido investigadas separadamente na miocardiopatia dilatada (DCM), suas associações combinadas com alterações transcricionais relacionadas à doença permanecem pouco exploradas. O presente estudo integrou múltiplos conjuntos de dados transcriptômicos em massa e de sequenciamento de RNA em células individuais (scRNA-seq) para identificar genes centrais relacionados ao envelhecimento e às mitocôndrias na DCM, caracterizar o microambiente imune cardíaco e examinar subtipos moleculares com base nos genes identificados. Essa abordagem integrada foi utilizada para priorizar biomarcadores candidatos e fornecer uma base para estudos mecanicistas e de validação subsequentes.
Protocolo
Todos os procedimentos com animais foram revisados e aprovados pelo Comitê de Ética em Experimentação Animal do Segundo Hospital Afiliado da Universidade de Medicina Chinesa de Henan (Número de Aprovação: HNSZYYYJS2023011150). Todos os procedimentos foram realizados de acordo com as Diretrizes para Revisão Ética do Bem-Estar de Animais de Laboratório (GB/T 35892-2018) e os princípios 3R de Substituição, Redução e Aperfeiçoamento. Os reagentes, bancos de dados, softwares e equipamentos utilizados neste estudo estão listados na Tabela de Materiais.
1. Recursos de dados e materiais experimentais
Camundongos transgênicos machos de linhagem SPF CTNTR141W com fenótipo de cardiomiopatia dilatada (DCM) espontânea e peso corporal de 25 ± 2 g foram utilizados como grupo modelo. Camundongos machos C57BL/6J de linhagem SPF, com idade correspondente e peso corporal de 25 ± 2 g, foram utilizados como grupo controle. Cada grupo incluiu 12 camundongos. Todos os animais foram obtidos de instituições detentoras de licenças válidas para produção de animais de laboratório e mantidos em ambiente com barreira de nível SPF a 22 ± 2 °C e umidade relativa de 40%–60%, sob ciclo de luz/escuridão de 12 h, com livre acesso a alimento e água esterilizados. Após uma semana de aclimatação, todos os camundongos foram mantidos nas mesmas condições por mais 4 semanas antes da avaliação da função cardíaca e coleta de amostras. Todos os camundongos tinham entre 6 e 8 semanas de idade no início do experimento. Os animais foram profundamente anestesiados e eutanasiados por dislocação cervical.
Sete conjuntos de dados transcriptômicos públicos de tecido miocárdico do ventrículo esquerdo de pacientes com miocardiopatia dilatada (DCM) foram obtidos do banco de dados Gene Expression Omnibus (GEO)19. Esses conjuntos de dados incluíram seis conjuntos de dados transcriptômicos em massa e um conjunto de dados de sequenciamento de RNA de célula única (scRNA-seq), GSE145154. As frações positivas e negativas para CD45 foram incluídas na análise. As frações celulares positivas e negativas para CD45 foram combinadas antes do agrupamento. A identidade da amostra foi utilizada como a principal variável de lote para a integração Harmony. Foram incluídas amostras normais do ventrículo esquerdo e amostras de DCM do ventrículo esquerdo do GSE145154, especificamente GSM4307515, GSM4307516, GSM4307520 e GSM4307521. Os conjuntos de dados utilizados neste estudo foram GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 e GSE141910. Todas as amostras que não eram de DCM foram excluídas, e somente amostras controle (grupo Controle) e amostras de DCM (grupo DCM) foram mantidas. Nenhuma amostra foi removida após o controle de qualidade. As informações das amostras dos conjuntos de dados GEO incluídos são resumidas a seguir: GSE5406 continha 102 amostras (16 controle e 86 amostras de DCM); GSE42955 continha 17 amostras (5 controle e 12 amostras de DCM); GSE57338 continha 231 amostras (136 controle e 95 amostras de DCM); GSE79962 continha 20 amostras (11 controle e 9 amostras de DCM); GSE116250 continha 51 amostras (14 controle e 37 amostras de DCM); e GSE141910 continha 322 amostras (161 controle e 161 amostras de DCM).
2. Pré-processamento dos dados de transcriptoma em massa
As matrizes de expressão bruta e os arquivos de anotação clínica para os seis conjuntos de dados em massa foram baixados utilizando o pacote GEOquery20. Os arquivos CEL brutos foram recuperados para os conjuntos de dados de micromatrizes Affymetrix, e as matrizes de contagem bruta foram recuperadas para os conjuntos de dados de RNA-seq. A correção de fundo, a normalização por quantis e o cálculo de expressão para os dados de micromatrizes foram realizados utilizando o algoritmo robust multi-array average implementado no pacote affy21.
Os dados de contagem de RNA-seq foram normalizados utilizando o método da média aparada de valores M no pacote edgeR22 e foram convertidos em valores log₂ transformados de contagens por milhão. Os identificadores de sondas foram convertidos em símbolos gênicos oficiais utilizando arquivos de anotação específicos da plataforma. Quando múltiplas sondas correspondiam ao mesmo gene, o valor médio de expressão foi calculado.
Os efeitos técnicos de lote entre conjuntos de dados foram removidos utilizando o algoritmo ComBat no pacote sva23. A origem do conjunto de dados e a plataforma de detecção foram especificadas como fatores de lote. A análise de componentes principais foi realizada antes e depois da correção de lote para avaliar a eficácia da remoção dos efeitos de lote.
3. Pré-processamento dos dados de transcriptoma de célula única e anotação celular
A matriz de expressão gênica de GSE145154 foi importada para o Seurat para construir um objeto Seurat utilizando a versão 5 do Seurat24. Células de baixa qualidade foram excluídas usando os seguintes limiares: 200–6.000 genes detectados por célula, contagem total de identificadores moleculares únicos superior a 500 e porcentagem de genes mitocondriais abaixo de 25%. Células fora desses limiares de controle de qualidade foram excluídas por serem consideradas de baixa qualidade ou rompidas. Excluímos células de baixa qualidade utilizando exclusivamente os limiares de controle de qualidade descritos acima.
A normalização logarítmica foi realizada utilizando a função NormalizeData com um fator de escala de 10.000. Os 3.000 genes altamente variáveis foram selecionados utilizando a função FindVariableFeatures com o método vst. Os dados foram normalizados utilizando ScaleData, seguido por análise de componentes principais para redução linear da dimensionalidade.
Os efeitos de lote foram corrigidos utilizando o algoritmo Harmony25 por meio da função RunHarmony, com a identidade da amostra especificada como a variável de agrupamento. Os primeiros 15 componentes principais foram utilizados para agrupar as células usando as funções FindNeighbors e FindClusters. O agrupamento foi realizado utilizando o algoritmo Leiden com uma resolução de 0,15. A redução não linear da dimensionalidade e a visualização foram realizadas utilizando a aproximação uniforme de variedades e projeção.
Os tipos celulares foram anotados utilizando genes marcadores canônicos juntamente com anotação automatizada usando o pacote SingleR26. Os genes marcadores foram os seguintes: linfócitos B, IGKC, MS4A1 e CD79A; cardiomiócitos, TNNI3, MYL2 e ACTC1; células endoteliais, VWF, PECAM1 e EGFL7; macrófagos, C1QC, C1QB e C1QA; monócitos, S100A8, S100A9 e G0S2; células natural killer, NKG7, GNLY e CCL5; células musculares lisas, MYL9, TAGLN e ACTA2; células estromais, FBLN1, LUM e DCN; e linfócitos T, CD3E, CD3G e CD3D.
4. Análise de expressão diferencial e pontuação de enriquecimento de conjuntos de genes
Um modelo linear foi construído utilizando o pacote limma27 para comparar a expressão gênica entre os grupos com miocardiopatia dilatada (DCM) e controles saudáveis. Genes com valor de P < 0,05 e uma razão de variação absoluta maior que 1,5, correspondente a uma razão de variação log₂ absoluta maior que 0,58, foram definidos como diferencialmente expressos de forma significativa.
Foi realizada uma análise de enriquecimento de conjunto de genes em amostra única para calcular os escores de enriquecimento dos conjuntos de genes relacionados ao envelhecimento e aos mitocôndrios em cada amostra28. As diferenças nos escores de enriquecimento entre os grupos com miocardiopatia dilatada (DCM) e controles saudáveis foram avaliadas utilizando o teste de soma de postos de Wilcoxon, considerando um valor de P < 0,05 como estatisticamente significativo.
Em nível de única célula, os escores dos módulos relacionados ao envelhecimento e mitocondriais foram calculados utilizando a função AddModuleScore no Seurat. As diferenças nos escores dos módulos entre os grupos foram avaliadas utilizando o teste de soma de postos de Wilcoxon.
Assinaturas gênicas relacionadas ao envelhecimento foram recuperadas do banco de dados CellAge (https://genomics.senescence.info/cells/), e conjuntos de genes relacionados às mitocôndrias foram obtidos do GeneCards (https://www.genecards.org/). As listas completas de genes utilizadas para pontuação estão fornecidas no Arquivo Suplementar 1.
5. Construção da rede de coexpressão gênica ponderada
Os 5000 principais genes codificadores de proteínas com maior variância de expressão em dados transcriptômicos de população celular foram mantidos para a construção da rede. A função pickSoftThreshold foi aplicada para calcular o índice de ajuste à topologia livre de escala sob múltiplas potências de limiarização suave. O limiar ótimo foi determinado como a potência mínima que produz uma rede livre de escala com valor de R2 acima de 0,9. Assim, adotou-se uma potência de limiarização suave de β = 5 para a análise subsequente da rede.
Uma rede de coexpressão ponderada com sinais foi construída utilizando a função blockwiseModules com um tamanho mínimo de módulo de 30. Os coeficientes de correlação de Pearson foram calculados entre cada eigengene do módulo e a pontuação de envelhecimento relacionado ou de enriquecimento mitocondrial. Módulos com coeficiente de correlação absoluto maior que 0,4 e P < 0,001 foram considerados módulos significativamente associados.
Genes dentro dos módulos significativamente associados foram cruzados com genes diferencialmente expressos para identificar genes candidatos ao envelhecimento associados à DCM e genes candidatos a mitocôndrias associados à DCM.
6. Análise de enriquecimento funcional
As análises de enriquecimento funcional, incluindo as análises de Ontologia Genética (GO) e de vias da Enciclopédia de Quioto de Genes e Genomas (KEGG), foram realizadas em genes candidatos utilizando o pacote clusterProfiler29. O enriquecimento GO abrangeu três categorias padrão: processo biológico, componente celular e função molecular.
Todas as análises foram realizadas com anotação da espécie humana, taxa de falsa descoberta (FDR) para correção do valor P e limiar de valor q de 0,05. Os conjuntos de genes foram restritos a uma faixa de tamanho de 10–500 genes, e os termos com FDR < 0,05 foram definidos como estatisticamente significativos. Por fim, os resultados de enriquecimento de GO foram visualizados via gráficos de barras agrupadas, enquanto os resultados de enriquecimento de KEGG foram exibidos utilizando gráficos de bolhas.
7. Construção da rede PPI e triagem de genes centrais
Os genes candidatos foram submetidos ao banco de dados STRING versão 11.530, com o organismo definido como Homo sapiens e o limiar de confiança da interação definido como um escore combinado maior que 0,7. Os nós desconectados foram ocultados e os dados de interação foram exportados no formato de valores separados por tabulação.
Os dados de interação foram importados para o Cytoscape versão 3.9.1 para visualização31. Os escores topológicos dos nós foram calculados utilizando o plugin CytoHubba32 com três algoritmos: Grau, componente máximo da vizinhança e centralidade de clique máximo.
Os módulos funcionais centrais dentro da rede foram identificados utilizando o plugin MCODE33 com os seguintes parâmetros padrão: limite de grau, 2; k-core, 2; limite de pontuação do nó, 0,2; e profundidade máxima, 100. Os genes classificados entre os 10 primeiros por todos os três algoritmos topológicos foram intersectados com os genes na sub-rede principal do MCODE para identificar os genes centrais definitivos de interação proteína-proteína.
8. Seleção de genes centrais baseada em aprendizado de máquina e construção de modelo diagnóstico
Para garantir reprodutibilidade e representação balanceada, o conjunto de dados transcriptômicos bulk integrado foi dividido aleatoriamente em conjuntos de treinamento e validação em uma proporção de 7:3, utilizando uma semente aleatória fixa (seed = 123456). Essa divisão foi estratificada por grupo de doença (DCM versus controle) para manter proporções de classes consistentes em ambos os conjuntos. Antes da divisão, os efeitos de lote provenientes de diferentes fontes de conjuntos de dados foram corrigidos usando o pacote sva, e as amostras integradas foram tratadas como uma única coorte durante a alocação aleatória.
Três algoritmos de aprendizado de máquina foram aplicados para triar genes candidatos. Primeiro, foi realizada uma regressão logística LASSO via a função cv.glmnet no pacote glmnet34Um modelo de classificação binária com validação cruzada de 5 dobras foi construído, adotando-se a AUC como métrica de avaliação. Os genes com coeficientes não nulos em lambda.min foram reservados como genes candidatos.
Em segundo lugar, foi construído um modelo de classificação por floresta aleatória com 500 árvores de decisão utilizando o pacote randomForest35. O número de variáveis amostradas para cada divisão foi definido como a raiz quadrada do número total de características. A importância dos genes foi quantificada com base no coeficiente de Gini, e os 10 principais genes com os escores de importância mais altos foram mantidos.
Terceiro, a análise SVM-RFE foi implementada utilizando a função rfe no pacote caret36. O número de características foi definido variando de 1 a 10, e foi adotada validação cruzada de 5 dobras para o treinamento do modelo. O subconjunto de genes com a melhor acurácia de validação cruzada foi finalmente selecionado.
Os genes identificados pelos três algoritmos foram definidos como os genes finais do núcleo relacionados ao envelhecimento e às mitocôndrias na miocardiopatia dilatada (DCM). Em seguida, modelos diagnósticos foram construídos utilizando 10 algoritmos de classificação: árvore de decisão, máquina de aumento de gradiente, modelo linear generalizado com reforço, k-vizinhos mais próximos, regressão logística, rede neural, mínimos quadrados parciais, floresta aleatória, máquina de vetores de suporte e gradiente extremo com reforço.
Curvas de característica operacional do receptor foram geradas utilizando o pacote pROC37. A área sob a curva, acurácia, sensibilidade e especificidade foram calculadas para avaliar o desempenho diagnóstico nos conjuntos de treinamento e validação.
A análise SHapley Additive exPlanations foi realizada para calcular a contribuição de cada gene principal nas previsões do modelo38. Foram gerados gráficos resumo e gráficos em cascata por amostra. Considerou-se que um modelo diagnóstico final com área sob a curva maior que 0,8 no conjunto de validação apresentava bom desempenho diagnóstico.
9. Inferência de comunicação célula-célula
As redes de comunicação célula-célula no microambiente cardíaco foram inferidas utilizando o pacote CellChat39. Um objeto CellChat foi construído usando a base de dados CellChatDB.human. Ligantes e receptores diferencialmente expressos foram identificados utilizando identifyOverExpressedGenes, e pares de interação significativos foram filtrados utilizando identifyOverExpressedInteractions.
As probabilidades de comunicação entre tipos celulares foram calculadas usando o computeCommunProb. A rede global de comunicação no nível de tipos celulares foi agregada usando o aggregateNet. O número de interações e a intensidade da comunicação entre cada par de tipos celulares foram quantificados e visualizados usando mapas de calor e gráficos de barras.
10. Quantificação da infiltração de células imunes
Pontuações de enriquecimento para 28 tipos de células imunes foram calculadas para cada amostra em bloco utilizando a análise de enriquecimento de conjunto de genes em amostra única28 e um conjunto de genes marcadores de células imunes40. O teste de soma de postos de Wilcoxon foi utilizado para comparar as pontuações de enriquecimento de células imunes entre os grupos com miocardiopatia dilatada e controles saudáveis. Um valor de P < 0,05 foi considerado estatisticamente significativo.
Foi realizada uma análise de correlação de Pearson para avaliar a associação entre os níveis de expressão gênica central e os escores de enriquecimento de células imunes. Todas as correlações com P < 0,05 foram consideradas estatisticamente significativas.
11. Agrupamento por consenso para subtipagem molecular
Agrupamento consensual não supervisionado de amostras de miocardiopatia dilatada foi realizado utilizando perfis de expressão gênica principais via o pacote ConsensusClusterPlus41Os parâmetros de agrupamento foram definidos como número máximo de agrupamentos igual a 6, 1000 iterações de reamostragem e proporção de reamostragem de 0,8. Foi adotado o particionamento em torno de medoides com distância euclidiana para o agrupamento, e uma semente aleatória fixa foi utilizada para garantir a reprodutibilidade.
O número ideal de subtipos foi determinado com base no gráfico de área delta e nos escores de estabilidade do agrupamento por consenso, sendo identificado finalmente K = 2. A análise de componentes principais foi realizada posteriormente para verificar a separação distinta entre os dois subtipos moleculares.
A análise de variação de conjunto de genes42 foi aplicada para calcular pontuações específicas por amostra de enriquecimento de vias KEGG. O pacote limma27 foi utilizado para detectar ativação diferencial de vias entre subtipos, e um valor de P inferior a 0,05 foi considerado estatisticamente significativo.
12. Avaliação ecocardiográfica da função cardíaca
Os camundongos foram anestesiados via injeção intraperitoneal de pentobarbital sódico a 1% (30 mg/kg) e fixado em posição supina sobre uma mesa cirúrgica termoestática. Após a remoção dos pelos do tórax, gel acoplante de ultrassom foi aplicado uniformemente na região precordial.
Realizou-se ecocardiografia modo-M guiada por imagem bidimensional ao nível dos músculos papilares do ventrículo esquerdo utilizando um sistema de ultrassom para pequenos animais. Três ciclos cardíacos estáveis consecutivos foram registrados para medir o diâmetro diastólico final do ventrículo esquerdo, diâmetro sistólico final, fração de ejeção e fração de encurtamento. Todas as avaliações ecocardiográficas foram realizadas cegamente por um ultrassonografista profissional.
Três camundongos foram selecionados aleatoriamente de cada grupo para exame ecocardiográfico, e esses 6 animais no total foram posteriormente sacrificados para coleta de tecido miocárdico e medição por ELISA. Os demais animais experimentais foram submetidos a ensaios laboratoriais paralelos adicionais, e seus dados não foram incluídos no presente estudo.
13. Coleta de tecido miocárdico, extração de proteínas e ensaio imunoenzimático
Após a avaliação ecocardiográfica, os camundongos foram eutanasiados sob anestesia profunda. Os tecidos cardíacos foram rapidamente coletados via toracotomia mediana, e o miocárdio do ventrículo esquerdo foi dissecado sobre gelo. Os tecidos isolados foram lavados cuidadosamente com solução salina tamponada com fosfato gelada para eliminar o sangue intracardíaco residual. Após a remoção do excesso de líquido com papel-filtro estéril, as amostras foram imediatamente congeladas em nitrogênio líquido e armazenadas a −80 °C para extração subsequente de proteínas, evitando-se rigorosamente ciclos repetidos de congelamento e descongelamento.
Tecidos miocárdicos congelados foram pesados e cortados em fragmentos de aproximadamente 1 mm3 sobre gelo. Os tecidos foram lisados em tampão de lise RIPA gelado contendo inibidores de protease e fosfatase em uma proporção padronizada de 100 µL de tampão por 10 mg de tecido. As amostras foram completamente homogeneizadas mecanicamente sobre gelo e incubadas por 30 min para obter a lise celular completa.
Os lisados foram centrifugados a 12.000 × g durante 15 min a 4 °C. Os sobrenadantes resultantes foram coletados em tubos livres de enzimas e a concentração total de proteína foi quantificada utilizando um kit de ensaio de proteína com ácido bicinconínico, conforme os protocolos do fabricante. Todas as amostras foram normalizadas para uma concentração idêntica de proteína com tampão de lise.
Os níveis de expressão proteica dos quatro genes centrais em lisados miocárdicos foram medidos utilizando os respectivos kits de ensaio imunoenzimático (ELISA). Padrões diluídos em série e lisados teciduais normalizados foram adicionados em duplicata (100 µL por poço) a microplacas pré-revestidas. As placas foram incubadas por 2 h à temperatura ambiente e lavadas cuidadosamente com o tampão de lavagem fornecido com o kit.
Cada poço foi suplementado com anticorpo conjugado a enzima e incubado por 1 h à temperatura ambiente, seguido por uma lavagem completa. Em seguida, foi adicionada a solução cromogênica de substrato, e as placas foram incubadas por 20 min à temperatura ambiente, no escuro. A reação colorimétrica foi interrompida com a solução de parada, e os valores de absorbância foram medidos a 450 nm (comprimento de onda de referência: 570 nm) utilizando um leitor de microplacas de comprimento de onda completo.
14. Análise estatística
Todas as análises estatísticas e visualizações de dados foram realizadas utilizando o R versão 4.2.3. Para as medições de concentração por ELISA de cada gene alvo (TGFB2, SERPINE1, CYBB, TLR2), o teste de Shapiro-Wilk foi inicialmente aplicado para avaliar a normalidade dos dados nos grupos Controle e DCM separadamente. Posteriormente, um teste F foi utilizado para avaliar a homogeneidade das variâncias entre os dois grupos. O método para comparação intergrupos foi determinado com base nos resultados do teste de homogeneidade de variâncias: se as variâncias fossem homogêneas (P ≥ 0,05), adotou-se o teste t de Student não pareado para comparar os valores médios entre os grupos; se as variâncias fossem heterogêneas (P < 0,05), utilizou-se o teste t de Welch corrigido para a análise. Todos os testes foram bicaudais, e o limiar de significância estatística foi estabelecido em P < 0,05. Os dados foram visualizados em gráficos de caixa (boxplots) sobrepostos com pontos individuais dispersos (jittered). Os valores de P de todos os testes e o tipo de teste t utilizado foram detalhadamente anotados em cada gráfico.
Resultados
Pré-processamento dos dados e análise de expressão diferencial
Todos os seis conjuntos de dados transcriptômicos em massa passaram por pré-processamento padronizado e correção de efeitos de lote antes da análise subsequente. Os dados de micromatrizes foram normalizados utilizando o algoritmo de média robusta de micromatrizes, enquanto os dados de contagem de RNA-seq foram normalizados utilizando o método da média aparada de valores M. O algoritmo ComBat foi aplicado para remover os efeitos técnicos de lote associados à origem do conjunto de dados e à plataforma de detecção. A análise de componentes principais mostrou que as amostras se agrupavam pela origem do conjunto de dados antes da correção, mas apresentavam distribuição mais uniforme após a correção, sem separação visível por lote.
A análise de expressão diferencial entre os grupos de miocardiopatia dilatada (DCM) e controle saudável (HC) foi realizada utilizando o pacote limma. O mapa térmico dos 20 genes com maior expressão diferencial mais significativa mostrou separação dos perfis de expressão entre os dois grupos (Figura 1A). Um total de 1.473 genes com expressão diferencial foi identificado utilizando limiares de valor de P < 0,05 e |mudança de razão log₂| > 0,58. Desses, 819 genes foram regulados positivamente e 654 foram regulados negativamente em amostras miocárdicas de DCM (Figura 1B).
A análise de enriquecimento de conjuntos de genes em amostra única foi então utilizada para calcular os escores de enriquecimento dos conjuntos de genes relacionados ao envelhecimento e à mitocôndria em cada amostra. Ambos os escores diferiram significativamente entre os grupos DCM e HC (Figura 1C).
Análise de rede de coexpressão gênica ponderada
A análise de rede de coexpressão gênica ponderada foi realizada para identificar módulos gênicos associados aos escores de envelhecimento relacionado e de enriquecimento mitocondrial. Os 5.000 genes codificadores de proteínas com maior variância de expressão no conjunto de dados em massa foram utilizados para construir a rede. Com uma potência de limiarização suave de β = 5, o índice de ajuste à topologia livre de escala excedeu R2 = 0,9, atendendo ao critério de rede livre de escala (Figura 1D).
A análise de agrupamento hierárquico e a fusão de módulos identificaram três módulos gênicos. Os três módulos apresentaram correlação significativa com o escore relacionado ao envelhecimento. O módulo turquesa mostrou a correlação mais forte com o escore relacionado ao envelhecimento (r = 0,69, P < 0,001). Para o escore mitocondrial, os módulos azul e cinza apresentaram correlação significativa, sendo que o módulo azul exibiu a associação mais forte (r = 0,56, P < 0,001; Figura 1E). Assim, o módulo turquesa foi selecionado para a triagem de genes relacionados ao envelhecimento, e o módulo azul foi selecionado para a triagem de genes relacionados às mitocôndrias.
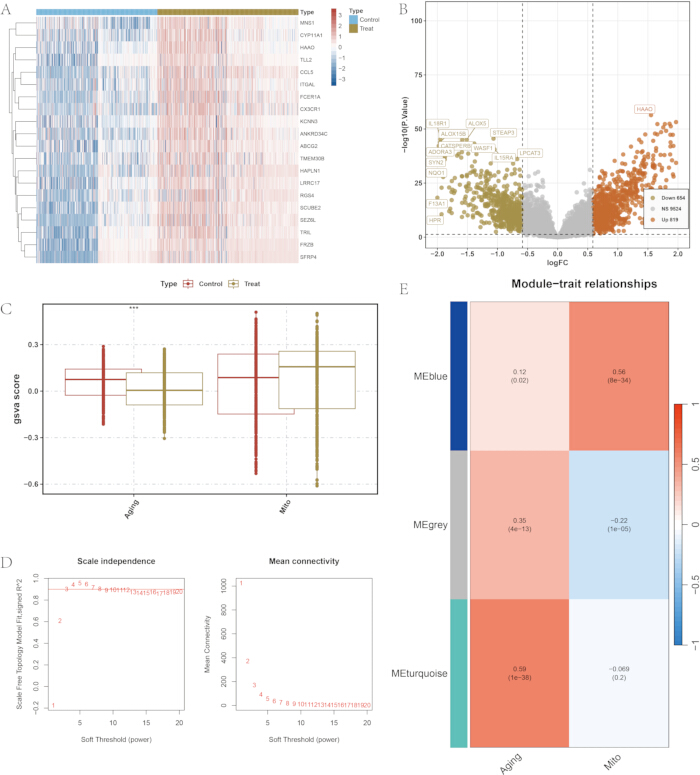
Figura 1: Análise de expressão diferencial e construção da rede de coexpressão gênica ponderada. (A) Mapa de calor dos 20 genes com maior significância em expressão diferencial entre os grupos com miocardiopatia dilatada (DCM) e controle saudável (HC). (B) Gráfico de vulcão de todos os genes com expressão diferencial. O vermelho indica genes superexpressos, o verde indica genes subexpressos e o cinza indica genes não significativos. Os limiares foram valor de P < 0,05 e |log₂ da razão de expressão| > 0,58. (C) Gráficos de caixa dos escores de enriquecimento de conjuntos gênicos em amostra única para os conjuntos de genes relacionados ao envelhecimento e à mitocôndria. (D) Seleção do limiar suave para análise da rede de coexpressão gênica ponderada, mostrando o índice de ajuste da topologia livre de escala e a conectividade média em diferentes potências de limiarização suave. (E) Mapa de calor das correlações entre os eigengenes dos módulos e os escores relacionados ao envelhecimento e à mitocôndria. Clique aqui para visualizar uma versão maior desta figura.
Identificação de genes candidatos relacionados ao envelhecimento e às mitocôndrias
Os genes candidatos foram identificados pela interseção entre os genes diferencialmente expressos, os genes nos módulos selecionados da análise de rede de coexpressão gênica ponderada e os conjuntos de genes de referência correspondentes. Essa análise identificou 66 genes candidatos associados ao envelhecimento em DCM (Figura 2A) e 16 genes candidatos associados às mitocôndrias em DCM (Figura 2B).
A análise de enriquecimento da Ontologia Genética mostrou que os genes candidatos relacionados ao envelhecimento estavam enriquecidos em processos biológicos, incluindo a biossíntese de óxido nítrico sintase e a organização da matriz extracelular contendo colágeno (Figura 2C). Os genes candidatos relacionados às mitocôndrias estavam enriquecidos em termos associados ao metabolismo energético mitocondrial, incluindo a membrana interna mitocondrial e o complexo da cadeia respiratória (Figura 2D).
A análise do Kyoto Encyclopedia of Genes and Genomes mostrou que os genes candidatos relacionados ao envelhecimento estavam enriquecidos nas vias de sinalização do fator indutível por hipóxia-1, fosfoinositídeo 3-quinase-proteína quinase B e produto final da glicação avançada-receptor para produtos finais da glicação avançada (Figura 2E). Os genes candidatos relacionados às mitocôndrias estavam enriquecidos em vias incluindo fosforilação oxidativa (Figura 2F).
Os padrões de expressão diferencial dos 66 genes candidatos relacionados ao envelhecimento entre os grupos DCM e HC foram visualizados utilizando um mapa térmico de expressão (Figura 2G). Os padrões de expressão dos 16 genes candidatos relacionados às mitocôndrias foram visualizados utilizando gráficos de caixa (Figura 2H).
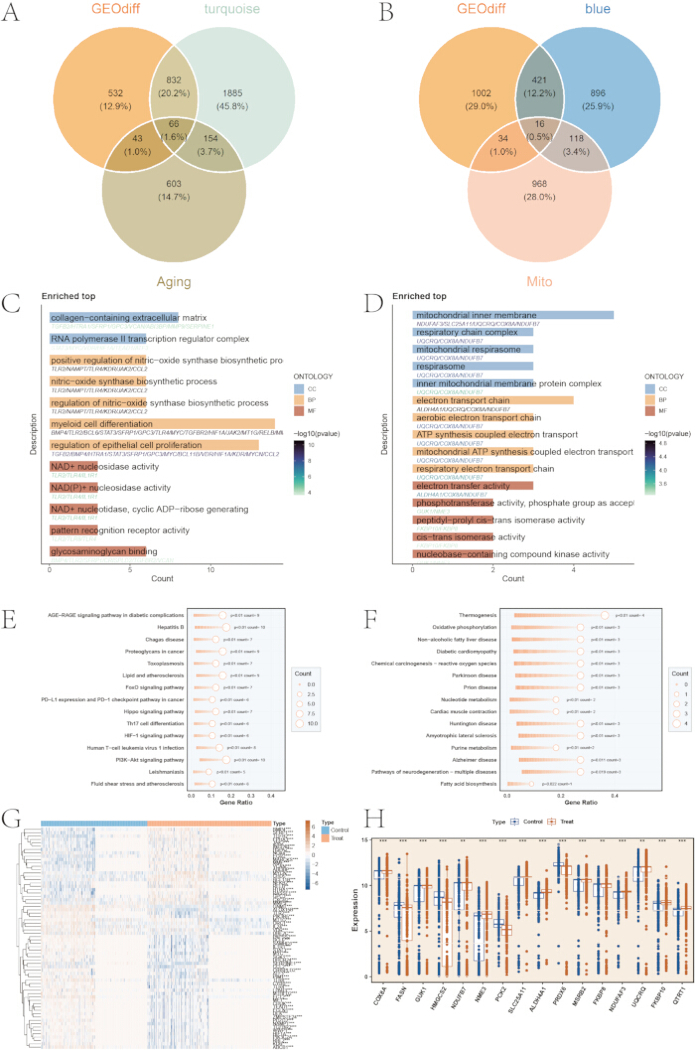
Figura 2: Triagem e enriquecimento funcional de genes candidatos. (A) Diagrama de Venn mostrando a interseção dos genes diferencialmente expressos, genes dos módulos da análise de rede de coexpressão gênica ponderada e o conjunto de referência de genes relacionados ao envelhecimento. (B) Diagrama de Venn mostrando a interseção dos genes diferencialmente expressos, genes dos módulos da análise de rede de coexpressão gênica ponderada e o conjunto de referência de genes relacionados às mitocôndrias. (C) Análise de enriquecimento da Ontologia Genética dos genes candidatos relacionados ao envelhecimento. (D) Análise de enriquecimento da Ontologia Genética dos genes candidatos relacionados às mitocôndrias. (E) Análise de enriquecimento de vias da Enciclopédia de Genes e Genomas de Kyoto (KEGG) dos genes candidatos relacionados ao envelhecimento. (F) Análise de enriquecimento de vias da Enciclopédia de Genes e Genomas de Kyoto (KEGG) dos genes candidatos relacionados às mitocôndrias. (G) Mapa térmico de expressão dos 66 genes candidatos relacionados ao envelhecimento nos grupos DCM e HC. (H) Gráficos de caixa de expressão dos 16 genes candidatos relacionados às mitocôndrias nos grupos DCM e HC. Clique aqui para visualizar uma versão maior desta figura.
Anotação de tipos celulares do conjunto de dados de sequenciamento de RNA de célula única
O conjunto de dados de sequenciamento de RNA de célula única GSE145154 foi utilizado para validação em resolução de célula única. Após filtragem de controle de qualidade, normalização logarítmica e correção de lote com Harmony, as células de diferentes amostras foram distribuídas no espaço de projeção e aproximação de variedade uniforme sem separação específica visível por amostra. Utilizando os primeiros 15 componentes principais e uma resolução de agrupamento de 0,15, as células foram divididas em 9 agrupamentos (Figura 3A).
Genes marcadores canônicos e a anotação automatizada usando o SingleR identificaram 9 tipos celulares principais: macrófagos, células natural killer, células T, células B, células endoteliais, células musculares lisas, monócitos, células estromais e cardiomiócitos (Figura 3B). Os padrões de expressão dos genes marcadores específicos de tipo celular apoiaram essas anotações (Figura 3C).
Os escores do módulo mitocondrial foram calculados para cada célula utilizando a função AddModuleScore e diferiram significativamente entre os grupos de miocardiopatia dilatada e controle saudável (P < 2,22 × 10⁻16; Figura 3D). Os escores do módulo relacionado ao envelhecimento também diferiram significativamente entre os dois grupos (P < 2,22 × 10⁻16; Figura 3E). A projeção dos escores mitocondriais no espaço de aproximação e projeção de variedade uniforme mostrou que escores elevados foram observados principalmente em cardiomiócitos (Figura 3F). Em contraste, escores elevados relacionados ao envelhecimento foram predominantemente observados em macrófagos (Figura 3G).
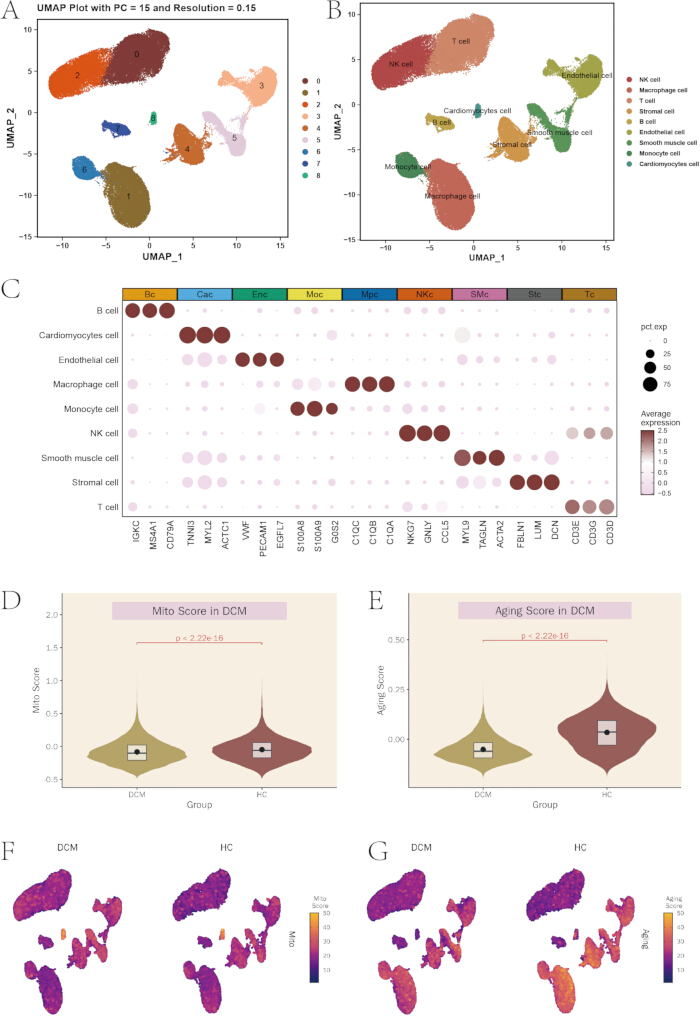
Figura 3: Anotação do transcriptoma de única célula e análise de pontuação por módulos. (A) Gráfico de projeção e aproximação uniforme de variedade com múltiplas dimensões dos agrupamentos celulares gerados utilizando os 15 primeiros componentes principais e uma resolução de agrupamento de 0,15. (B) Gráfico de projeção e aproximação uniforme de variedade dos tipos celulares anotados. (C) Gráfico de bolhas mostrando a expressão de genes marcadores canônicos entre os tipos celulares. (D) Gráfico de violino das pontuações dos módulos mitocondriais nos grupos DCM e HC. (E) Gráfico de violino das pontuações dos módulos relacionados ao envelhecimento nos grupos DCM e HC. (F) Gráfico de projeção e aproximação uniforme de variedade mostrando a distribuição das pontuações dos módulos mitocondriais entre as células. (G) Gráfico de projeção e aproximação uniforme de variedade mostrando a distribuição das pontuações dos módulos relacionados ao envelhecimento entre as células. Clique aqui para visualizar uma versão maior desta figura.
Construção da rede de interação proteína-proteína
O conjunto combinado de 66 genes candidatos relacionados ao envelhecimento e 16 genes candidatos relacionados às mitocôndrias foi submetido ao banco de dados STRING versão 11.5 para construir uma rede de interação proteína-proteína, utilizando um limiar de alta confiança com pontuação combinada > 0,7. A rede foi importada para o Cytoscape para visualização e análise topológica (Figura 4A).
As análises de grau, centralidade de clique máxima, componente máximo do vizinhança e MCODE foram utilizadas para identificar nós altamente conectados e sub-redes centrais. As sub-redes identificadas por esses métodos são mostradas na Figura 4B–E.
Os 10 principais genes classificados por Grau, centralidade de clique máxima e componente de vizinhança máxima foram cruzados com os genes na sub-rede principal MCODE. Esta análise identificou 10 genes candidatos: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 e CXCR2.
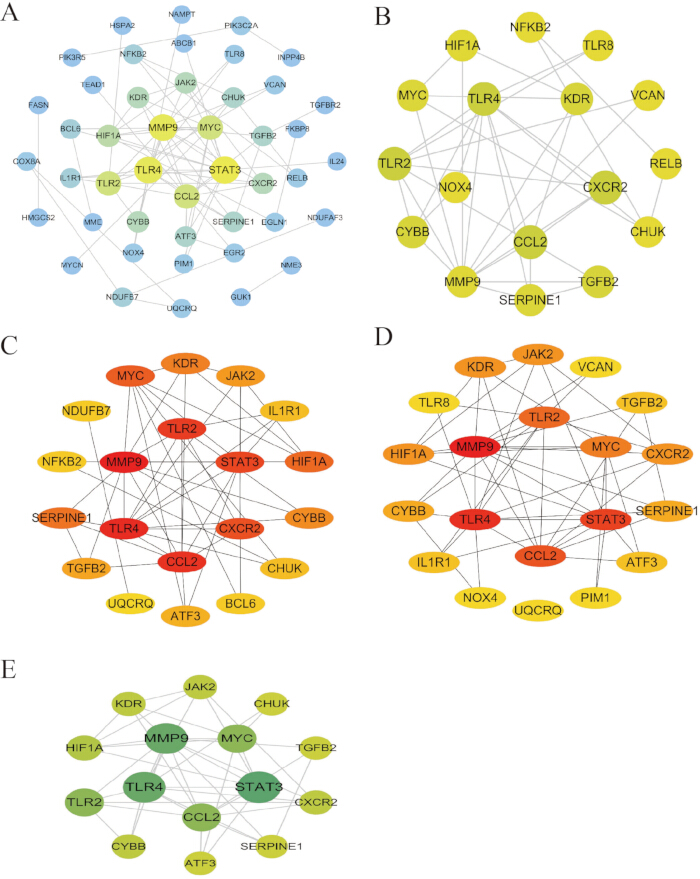
Figura 4Construção da rede de interação proteína-proteína e triagem de genes centrais.
(A) Rede geral de interação proteína-proteína dos genes candidatos.B) Sub-rede principal identificada utilizando o MCODE.C) Sub-rede principal identificada utilizando a centralidade de clique máxima. (D) Sub-rede principal identificada utilizando o componente de vizinhança máxima. (E) Sub-rede principal identificada utilizando o Grau. Clique aqui para visualizar uma versão maior desta figura.
Triagem de genes centrais baseada em aprendizado de máquina
Três algoritmos de aprendizado de máquina — regressão logística com operador de seleção e redução absoluta mínima (LASSO), floresta aleatória e máquina de vetores de suporte com eliminação recursiva de características — foram aplicados para triar genes centrais entre os 10 candidatos de interação proteína-proteína. Todas as análises foram realizadas utilizando uma semente aleatória fixa (set.seed(12345)) e validação cruzada de 5 dobras. No modelo LASSO, os genes com coeficientes não nulos no lambda ótimo (lambda.min) foram mantidos como candidatos (Figura 5A).
No modelo de máquina de vetores de suporte com eliminação recursiva de características, a maior precisão de validação cruzada de 0,859 foi alcançada ao incluir 10 características (Figura 5B), com uma taxa de erro mínima correspondente de 0,141 (Figura 5C). O modelo de floresta aleatória com 500 árvores de decisão mostrou convergência estável da taxa de erro fora da bolsa (Figura 5D). A classificação da importância dos genes com base no coeficiente de Gini posicionou TGFB2, TLR2, SERPINE1 e CYBB entre os genes com as classificações mais altas (Figura 5E). A interseção dos genes selecionados pelos três algoritmos resultou em quatro genes centrais finais: CYBB, SERPINE1, TGFB2 e TLR2 (Figura 5F).
Foi realizada uma análise de Explicações Aditivas de Shapley para avaliar a contribuição de cada gene central nas previsões do modelo. O gene TGFB2 apresentou o maior valor médio absoluto de Explicações Aditivas de Shapley, de 0,249, seguido por SERPINE1 com 0,103, CYBB com 0,083 e TLR2 com 0,078 (Figura 6A). O gráfico resumo mostrou a distribuição e a direção das contribuições dos genes entre as amostras (Figura 6B). Os gráficos de dependência ilustraram a relação entre os valores individuais dos genes e as contribuições do modelo (Figura 6C), enquanto os gráficos em cascata por amostra mostraram a contribuição de cada gene nas previsões individuais (Figura 6D).
Modelos de classificação diagnóstica baseados nos quatro genes centrais foram posteriormente construídos utilizando 10 algoritmos de classificação. No conjunto de treinamento, a maioria dos algoritmos alcançou valores de área sob a curva acima de 0,85 (Figura 6E). No conjunto de validação interno, a maioria dos algoritmos alcançou valores de área sob a curva acima de 0,78 (Figura 6F).
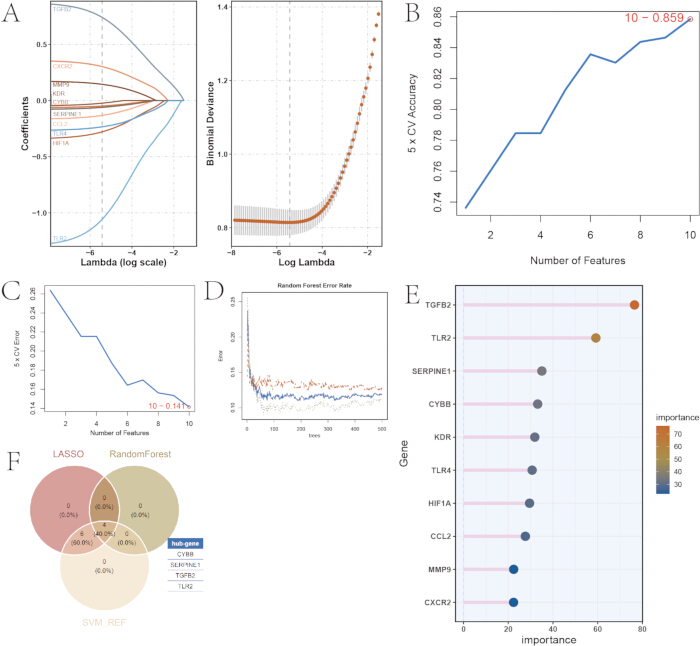
Figura 5: Triagem baseada em aprendizado de máquina de genes centrais. (A) Trajetória do coeficiente de regressão do operador de redução e seleção por módulo mínimo e seleção do lambda ótimo. (B) Curva de precisão da validação cruzada para o modelo de eliminação recursiva de características por máquina de vetores de suporte. (C) Curva de erro de validação cruzada para o modelo de eliminação recursiva de características por máquina de vetores de suporte. (D) Curva da taxa de erro fora da bolsa para o modelo de floresta aleatória. (E) Classificação da importância dos genes com base no coeficiente de Gini no modelo de floresta aleatória. (F) Diagrama de Venn mostrando os genes centrais identificados pelos três algoritmos de aprendizado de máquina. Clique aqui para visualizar uma versão maior desta figura.
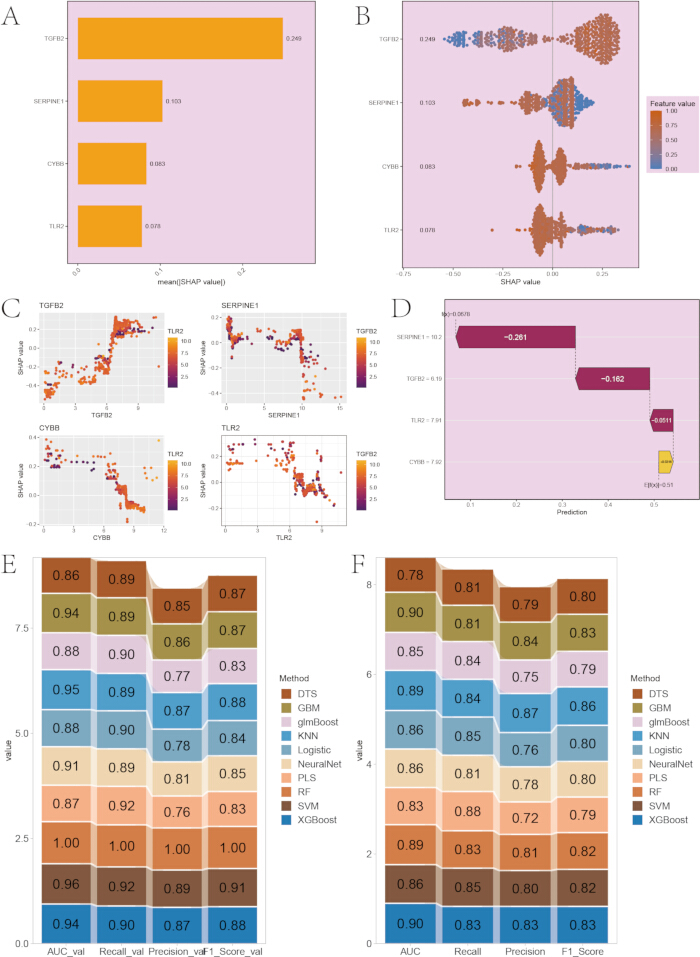
Figura 6: Avaliação do modelo diagnóstico e análise de Explicações Aditivas SHapley (SHAP). (A) Valores médios absolutos de Explicações Aditivas SHapley para os quatro genes centrais. (B) Gráfico resumo SHAP mostrando a distribuição e a direção das contribuições gênicas. (C) Gráficos de dependência SHAP para cada gene central. (D) Gráfico em cascata SHAP para uma amostra representativa. (E) Mapa de calor do desempenho diagnóstico de 10 algoritmos de classificação no conjunto de treinamento. (F) Mapa de calor do desempenho diagnóstico de 10 algoritmos de classificação no conjunto de validação. Clique aqui para visualizar uma versão maior desta figura.
Validação em nível de célula única e análise de comunicação entre células
Os padrões de expressão dos quatro genes centrais foram avaliados ao nível de célula única. A análise da distribuição por tipo celular mostrou que CYBB e TLR2 foram altamente expressos em monócitos e macrófagos, enquanto SERPINE1 e TGFB2 foram predominantemente expressos em células estromais (Figura 7A).
Os gráficos de violino mostraram que a expressão de CYBB diferiu significativamente entre os grupos com miocardiopatia dilatada e controles saudáveis (Figura 7B). SERPINE1 (Figura 7C), TGFB2 (Figura 7D) e TLR2 (Figura 7E) também diferiram significativamente entre os grupos. Os quatro genes foram significativamente superexpressos no grupo com miocardiopatia dilatada em relação aos controles saudáveis, com P < 0,0001 em cada comparação.
As redes de comunicação entre células no microambiente cardíaco foram inferidas usando o CellChat e uma base de dados de ligantes-receptores. O número e a intensidade geral das interações entre células diferiram entre os grupos com miocardiopatia dilatada e controle (Figura 7F). Também foi observada diferença na intensidade da comunicação entre os tipos celulares (Figura 7G). Monócitos, macrófagos, cardiomiócitos e células estromais foram os principais participantes na rede de comunicação.
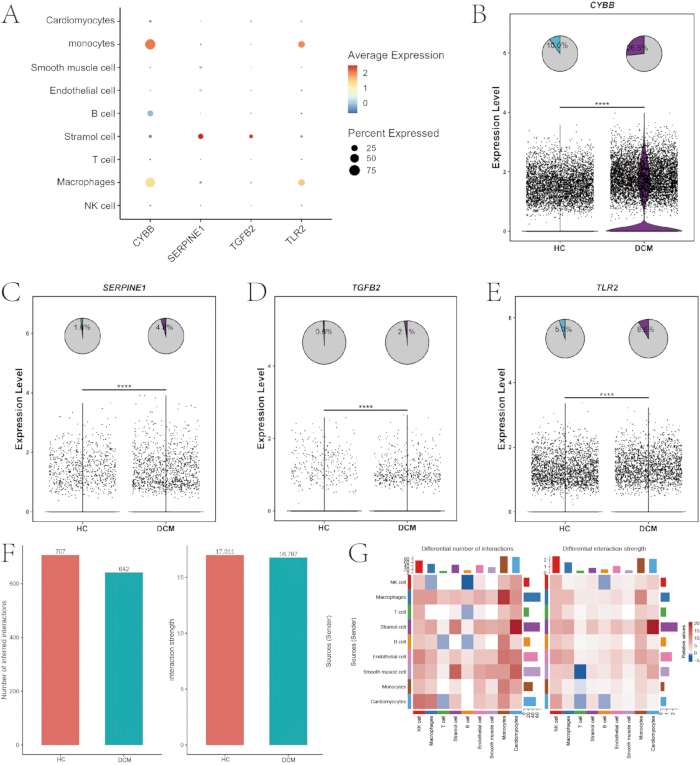
Figura 7: Validação em nível de única célula dos genes centrais e análise de comunicação entre células. (A) Gráfico de bolhas mostrando a expressão dos quatro genes centrais nos diferentes tipos celulares. (B) Gráfico de violino da expressão de CYBB nos grupos DCM e HC. (C) Gráfico de violino da expressão de SERPINE1 nos grupos DCM e HC. (D) Gráfico de violino da expressão de TGFB2 nos grupos DCM e HC. (E) Gráfico de violino da expressão de TLR2 nos grupos DCM e HC. (F) Gráfico de barras mostrando o número e a intensidade total das interações entre células. (G) Mapa de calor mostrando a intensidade diferencial da comunicação entre células entre os grupos. Clique aqui para visualizar uma versão maior desta figura.
Análise da infiltração de células imunes
Os escores de enriquecimento para 28 subconjuntos de células imunes foram calculados para cada amostra em conjunto utilizando a análise de enriquecimento de conjunto de genes de amostra única. A abundância da maioria dos tipos de células imunes diferiu significativamente entre os grupos com miocardiopatia dilatada e os grupos controle saudáveis (Figura 8A).
Foi então realizada uma análise de correlação de Pearson para avaliar a relação entre a expressão dos genes centrais e os escores de enriquecimento de células imunes. A expressão de CYBB correlacionou-se significativamente com a abundância de múltiplos tipos de células imunes (Figura 8B). Correlações semelhantes foram observadas para SERPINE1 (Figura 8C), TGFB2 (Figura 8D) e TLR2 (Figura 8E). CYBB, SERPINE1 e TLR2 apresentaram correlações positivas com diversas populações de células imunes inatas, incluindo monócitos e macrófagos.
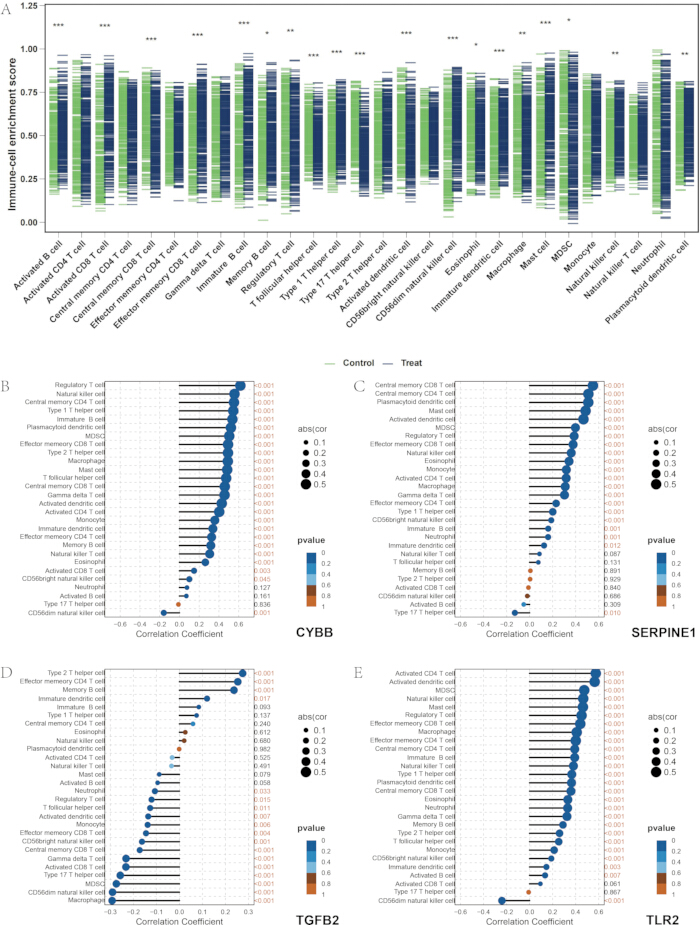
Figura 8: Infiltração de células imunes e análise de correlação. (A) Gráficos de caixa dos escores de enriquecimento para 28 tipos de células imunes nos grupos DCM e HC. (B) Gráfico de bala mostrando as correlações entre a expressão de CYBB e a abundância de células imunes. (C) Gráfico de bala mostrando as correlações entre a expressão de SERPINE1 e a abundância de células imunes. (D) Gráfico de bala mostrando as correlações entre a expressão de TGFB2 e a abundância de células imunes. (E) Gráfico de bala mostrando as correlações entre a expressão de TLR2 e a abundância de células imunes. Clique aqui para visualizar uma versão maior desta figura.
Subtipagem molecular da miocardiopatia dilatada
Foi realizada uma agrupamento por consenso não supervisionado em amostras de miocardiopatia dilatada com base nos perfis de expressão dos quatro genes centrais. A matriz de agrupamento por consenso apoiou a separação em K = 2 (Figura 9A). O gráfico de área delta reforçou ainda mais K = 2 como o número ideal de agrupamentos, dividindo as amostras em dois subtipos moleculares, C1 e C2 (Figura 9B).
Os níveis de expressão de CYBB, SERPINE1 e TLR2 diferiram significativamente entre os dois subtipos (Figura 9C). A abundância de múltiplos subconjuntos de células imunes também diferiu entre os subtipos (Figura 9D). A análise de variação de conjuntos de genes mostrou ativação relativa da via de sinalização do fator de crescimento endotelial vascular no subtipo C1, enquanto a biossíntese de ácidos biliares primários e a biossíntese de glicoesfingolipídios foram enriquecidas no subtipo C2 (Figura 9E). A análise de componentes principais mostrou separação entre as amostras atribuídas aos dois subtipos (Figura 9F).
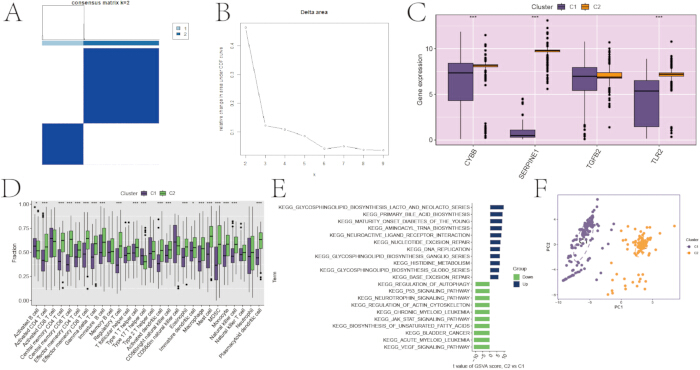
Figura 9: Agrupamento por consenso para subtipagem molecular da miocardiopatia dilatada. (A) Matriz de agrupamento por consenso em K = 2. (B) Gráfico de área delta utilizado para determinar o número ótimo de agrupamentos. (C) Boxplots da expressão dos genes centrais nos dois subtipos moleculares. (D) Boxplots da abundância de células imunes nos dois subtipos moleculares. (E) Mapa de calor dos caminhos enriquecidos diferencialmente no Enciclopédia de Genes e Genomas de Kyoto entre os dois subtipos moleculares. (F) Gráfico de análise de componentes principais mostrando a separação entre os dois subtipos moleculares. Clique aqui para visualizar uma versão maior desta figura.
In vivo validação no modelo murino de cardiomiopatia dilatada
Camundongos transgênicos CTNTR141W com fenótipo de cardiomiopatia dilatada espontânea foram utilizados para in vivo validação. Em comparação com camundongos controles selvagens C57BL/6J de idade correspondente, os camundongos transgênicos apresentaram diâmetro diastólico final do ventrículo esquerdo significativamente aumentado e fração de ejeção do ventrículo esquerdo reduzida, compatíveis com dilatação ventricular e disfunção sistólica (Figura 10A).
Proteínas totais foram extraídas do tecido miocárdico do ventrículo esquerdo, e as concentrações das quatro proteínas codificadas pelos genes centrais foram medidas por ensaio imunoenzimático (ELISA), após normalização da proteína total com base no ácido bicinconínico. Todos os ensaios foram realizados em duplicata. As curvas padrão apresentaram coeficientes de correlação (R2) ≥ 0,99, e os coeficientes de variação entre poços duplicados foram inferiores a 10%. A significância estatística entre os grupos Controle e miocardiopatia dilatada (DCM) foi avaliada utilizando o teste t de Student ou o teste t de Welch, dependendo da igualdade de variâncias avaliada pelo teste F (a normalidade foi confirmada pelo teste de Shapiro-Wilk). Os níveis miocárdicos de proteína correspondentes aos quatro genes centrais foram significativamente aumentados em camundongos com miocardiopatia dilatada (DCM) em comparação com os controles (Figura 10B). Para a validação por ELISA, foram incluídas 3 réplicas biológicas (camundongos individuais) em cada grupo. Para a validação por ELISA, foram incluídas três réplicas biológicas independentes por grupo. Esses achados devem ser considerados preliminares e requerem confirmação em uma coorte maior.
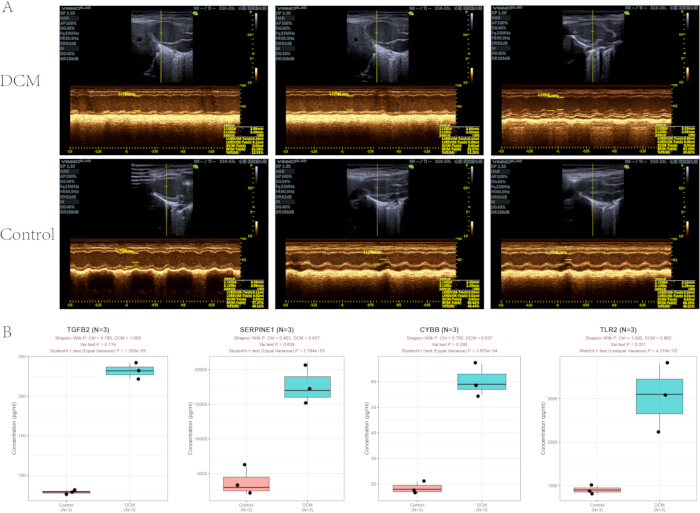
Figura 10: Validação in vivo no modelo de camundongo transgênico de miocardiopatia dilatada CTNTR141W. (A) Imagens ecocardiográficas representativas no modo M de camundongos transgênicos CTNTR141W com miocardiopatia dilatada (DCM) e camundongos controle do tipo selvagem. (B) Quantificação por ELISA de quatro proteínas derivadas de genes centrais em tecidos miocárdicos do ventrículo esquerdo de camundongos. Os gráficos de caixas e bigodes exibem as concentrações proteicas para os grupos Controle e DCM (n = 3 réplicas biológicas por grupo). Em cada gráfico de caixas: a linha horizontal sólida dentro da caixa indica o valor mediano; os limites superior e inferior da caixa representam os percentis 75 e 25 (intervalo interquartílico, IQR); os bigodes superior e inferior se estendem até os pontos de dados máximos e mínimos não considerados outliers dentro de 1,5 × IQR; os pontos pretos sólidos individuais correspondem a réplicas biológicas independentes provenientes de animais individuais. O eixo y indica a concentração absoluta de proteína: pg/mL para TGFB2 e CYBB, ng/mL para TLR2 e SERPINE1. As comparações estatísticas entre dois grupos foram realizadas utilizando o teste t de Student (variância igual) ou o teste t de Welch (variância desigual), com normalidade verificada pelo teste de Shapiro-Wilk e homogeneidade de variância avaliada pelo teste F. Declaração de limitação: Os resultados de ELISA obtidos com n = 3 réplicas são achados exploratórios preliminares, e uma validação futura com tamanho amostral maior é necessária. Clique aqui para visualizar uma versão ampliada desta figura.
Disponibilidade de Dados:
Os seis conjuntos de dados de transcriptômica em massa e um conjunto de dados de sequenciamento de RNA de célula única analisados neste estudo estão disponíveis publicamente no banco de dados Gene Expression Omnibus, com os números de acesso GSE5406, GSE42955, GSE57338, GSE79962, GSE116250, GSE141910 e GSE145154. A análise de célula única incluiu as amostras GSM4307515, GSM4307516, GSM4307520 e GSM4307521 do GSE145154. Todos os demais dados gerados ou analisados durante este estudo, juntamente com o código computacional, estão incluídos neste artigo publicado e nos arquivos de informações suplementares. Especificamente, Arquivo Suplementar 1 contém as listas completas de genes relacionados ao envelhecimento e às mitocôndrias, a assinatura imunológica de 28 células, os scripts analíticos personalizados, as matrizes de dados transcriptômicos normalizados, os dados brutos para os ensaios de ELISA e os dados brutos subjacentes a todas as figuras do manuscrito.
Arquivo Suplementar 1: Conjuntos de Genes Relacionados ao Envelhecimento e às Mitocondrias, Assinaturas Imunológicas, Scripts de Análise, Dados Transcriptômicos Normalizados e Dados de Origem das Figuras. Clique aqui para baixar este arquivo.
Discussão
O fluxo de trabalho integrado em múltiplas camadas combinou meta-análise de transcriptômica em massa, construção de rede de coexpressão gênica ponderada, aprendizado de máquina em conjunto, validação por transcriptômica de célula única e verificação em modelo animal in vivo. Quatro genes centrais relacionados ao envelhecimento e às mitocôndrias — CYBB, SERPINE1, TGFB2 e TLR2 — foram identificados como biomarcadores diagnósticos candidatos para cardiomiopatia dilatada (DCM). A integração de seis conjuntos de dados independentes de transcriptômica do ventrículo esquerdo provenientes do repositório Gene Expression Omnibus, incluindo plataformas de microarranjo e sequenciamento de RNA, reduziu o viés de conjuntos de dados individuais e aumentou a base estatística da análise43,44,45. A análise de rede de coexpressão gênica ponderada, combinada com conjuntos de genes pré-definidos relacionados ao envelhecimento e às mitocôndrias, permitiu a identificação de módulos funcionais associados ao traço fenotípico, em vez de depender exclusivamente da análise de expressão diferencial46. O aprendizado de máquina em conjunto reduziu o viés específico do algoritmo associado a métodos individuais de seleção de características47,48, enquanto a análise SHapley Additive exPlanations quantificou a contribuição de cada gene central nas previsões do modelo49. A validação em transcriptomas miocárdicos em massa, transcriptomas de célula única e um modelo de camundongo transgênico caracterizou ainda mais a distribuição celular e os níveis proteicos miocárdicos dos genes selecionados50.
A correção de lote foi uma etapa crítica na análise integrada, pois variações residuais específicas do conjunto de dados poderiam afetar a análise de expressão diferencial e as associações entre módulos e traços. A origem do conjunto de dados e a plataforma de detecção foram, portanto, incluídas como fatores de lote no modelo ComBat. A presença de agrupamento residual dependente do conjunto de dados em gráficos de análise de componentes principais indicaria uma correção incompleta e um possível viés sistemático44. A potência de limiarização suave também foi importante para a construção da rede de coexpressão gênica ponderada. Foi selecionado o valor mínimo que produziu um índice de ajuste à topologia livre de escala com R2 > 0,9, resultando em β = 5. Um valor mais baixo pode gerar módulos fragmentados ou funcionalmente pouco informativos, enquanto um valor mais alto pode enfraquecer a conectividade gênica e reduzir o poder estatístico da análise de correlação entre módulos e traços46. Os limiares de controle de qualidade para células únicas foram adaptados ao tecido cardíaco, pois os cardiomiócitos apresentam alta atividade metabólica. Foi implementada uma estratégia rigorosa de filtragem com um limite máximo de 25% para a porcentagem de genes mitocondriais e um intervalo de 200–6.000 genes detectados, a fim de remover células rompidas e de baixa qualidade, mantendo os cardiomiócitos50. Uma semente aleatória fixa, set.seed(12345), foi utilizada para divisão do conjunto de dados, treinamento do modelo e validação cruzada, a fim de reduzir a variação entre análises repetidas de aprendizado de máquina47.
A confirmação do genótipo, a criação padronizada e a mensuração ecocardiográfica consistente foram importantes para manter a estabilidade fenotípica nos experimentos com animais. Camundongos transgênicos CTNTR141W desenvolvem dilatação do ventrículo esquerdo e disfunção sistólica após o período especificado de aclimatação e alimentação51. A verificação do genótipo antes do agrupamento é necessária para excluir animais não transgênicos e prevenir a classificação incorreta do fenótipo. As mensurações ecocardiográficas devem ser obtidas de forma consistente ao nível dos músculos papilares do ventrículo esquerdo, com as medidas médias calculadas a partir de três ciclos cardíacos estáveis consecutivos. A variação na posição de imagem ou na profundidade da anestesia pode aumentar a variabilidade nas medidas da fração de ejeção do ventrículo esquerdo51. A qualidade do ensaio imunoenzimático foi avaliada por meio dos coeficientes de correlação da curva padrão, com R2 ≥ 0,99, e coeficientes de variação < 10% entre poços duplicados. Uma linearidade inadequada da curva padrão ou medidas duplicadas inconsistentes podem introduzir erros sistemáticos nas estimativas de concentração proteica.
Vários problemas analíticos podem surgir durante a implementação do fluxo de trabalho. A separação persistente por lote após a correção com ComBat pode refletir colinearidade entre variáveis de lote e fatores clínicos, filtragem insuficiente de genes de baixa expressão ou variação técnica não modelada. Covariáveis clínicas, como idade e sexo, podem ser incluídas como variáveis protegidas quando disponíveis, e genes com expressão zero em mais de 70% das amostras podem ser removidos para reduzir o ruído44. Uma correção complementar com removeBatchEffect pode ser considerada quando ainda houver separação residual. Um número inesperadamente alto ou baixo de genes diferencialmente expressos pode exigir avaliação da heterogeneidade das amostras, normalização, valores aberrantes e seleção de limiares27. Correlações baixas entre módulos e traços podem ser abordadas com a reavaliação do limiar de variância, da potência de limiarização suave e dos valores extremos dos traços. A expansão dos 5.000 para os 7.500 genes mais variáveis ou a substituição da análise de enriquecimento de conjuntos de genes em amostra única pela análise de variação de conjuntos de genes pode melhorar a detecção de módulos46. Um número excessivo de nós isolados na rede de interação proteína-proteína pode exigir ajuste do limiar de confiança do STRING ou expansão do conjunto de genes candidatos30. Desempenho insatisfatório em aprendizado de máquina pode refletir diferenças distribucionais entre os conjuntos de treinamento e validação, redundância de características ou desequilíbrio entre grupos. A amostragem estratificada, a redução de características redundantes ou a sobreamostragem da classe minoritária podem reduzir esses efeitos47. Um agrupamento ambíguo em células únicas pode exigir reavaliação da correção com Harmony, da seleção de componentes principais e da anotação de genes marcadores50.
Várias limitações devem ser consideradas. Os conjuntos de dados transcriptômicos foram obtidos retrospectivamente de repositórios públicos, e os delineamentos originais dos estudos e os fatores de confusão clínicos não puderam ser controlados. As anotações clínicas estavam incompletas entre os conjuntos de dados, e a maioria deles carecia de informações detalhadas sobre etiologia, histórico de medicação, idade dos pacientes e desfechos a longo prazo. Essas limitações impediram a avaliação de associações entre os genes selecionados e o prognóstico, resposta ao tratamento ou envelhecimento cronológico52. Pode ainda permanecer alguma variação técnica residual, apesar da correção de lotes. A análise baseou-se principalmente na expressão de RNA mensageiro e não incluiu dados integrados de epigenômica, proteômica ou metabolômica. Consequentemente, a atividade proteica, a regulação pós-traducional e os mecanismos upstream não puderam ser determinados. Apenas um único conjunto de dados de célula única foi incluído, limitando a avaliação da heterogeneidade celular entre as etiologias da miocardiopatia dilatada50. O modelo transgênico CTNTR141W representa principalmente a miocardiopatia dilatada hereditária associada a uma mutação na troponina T cardíaca e pode não reproduzir as formas idiopáticas, virais ou isquêmicas da doença51. As diferenças entre espécies de camundongos e humanos também limitam a transposição direta para a clínica. A validação no nível proteico foi restrita ao tecido miocárdico de camundongos, e não foram realizadas coortes clínicas amplas nem comparações com biomarcadores estabelecidos. Os quatro genes centrais não são específicos da miocardiopatia dilatada e também podem estar alterados em outras condições cardiovasculares ou inflamatórias. Além disso, a seleção de candidatos baseou-se em conjuntos de genes pré-definidos relacionados ao envelhecimento e às mitocôndrias. Essa estratégia baseada em hipóteses pode excluir genes fora dos conjuntos de referência selecionados, enquanto a intersecção entre três algoritmos de aprendizado de máquina pode omitir genes identificados por apenas um método48.
A estrutura analítica pode apoiar futuros estudos de subtipagem molecular, validação de biomarcadores e estudos multi-ômicos na miocardiopatia dilatada. O painel de quatro genes pode ser avaliado em coortes independentes de sangue periférico ou miocárdio antes da avaliação como ferramenta diagnóstica ou de subtipagem. Os subtipos C1 e C2 apresentaram perfis distintos de vias imunológicas e metabólicas, fornecendo uma base para a posterior validação de características biológicas específicas de cada subtipo15. Os genes selecionados também podem ser examinados em estudos de docking molecular, celulares e funcionais. TLR2 e CYBB estão associados à sinalização inflamatória e à produção de espécies reativas de oxigênio, enquanto TGFB2 e SERPINE1 estão associados à fibrose e ao remodelamento cardíaco53. A integração com dados proteômicos, metabolômicos, epigenômicos, de associação genômica ampla e de randomização mendeliana pode ajudar a avaliar relações regulatórias e possíveis associações causais54. O fluxo de trabalho também pode ser adaptado a estudos transcriptômicos da miocardiopatia hipertrófica, miocardiopatia isquêmica e insuficiência cardíaca, substituindo os conjuntos de dados específicos da doença e os conjuntos de genes de referência45. A futura incorporação de ensaios de única célula para sequenciamento de cromatina acessível à transposase e transcriptômica espacial pode fornecer informações adicionais sobre regulação celular e expressão espacial. O enriquecimento observado de assinaturas relacionadas ao envelhecimento em macrófagos e assinaturas mitocondriais em cardiomiócitos foi consistente com relatos anteriores sobre processos inflamatórios e mitocondriais nas doenças cardíacas55,56,57.
Este estudo apresenta várias limitações que devem ser reconhecidas. Notavelmente, os kits comerciais de ELISA utilizados para a quantificação de proteínas foram oficialmente validados para a detecção de proteínas-alvo em amostras de soro. No presente estudo, lisados de tecido miocárdico foram adotados como matriz de detecção em vez de soro. Embora procedimentos rigorosos de pré-tratamento das amostras e operações experimentais tenham sido estritamente implementados ao longo do ensaio para garantir a confiabilidade e comparabilidade dos dados experimentais, a ausência de validação oficial do fabricante para esses kits de ELISA em amostras de lisado de tecido miocárdico pode levar a possíveis pequenas discrepâncias nos resultados quantitativos das proteínas. Portanto, a aplicação de kits de ELISA específicos para soro em lisados de tecido miocárdico constitui uma limitação metodológica deste estudo.
Divulgações
O autor declara não haver conflitos de interesses.
Agradecimentos
Agradecemos os dados disponíveis publicamente fornecidos por meio do banco de dados Gene Expression Omnibus. Também agradecemos aos revisores e editores pelos seus comentários construtivos sobre o manuscrito. Este trabalho foi apoiado pelo Projeto Científico e de Pesquisa em Nível Departamental Provincial (Grant No. 2021JDZX2026), “Mecanismo da Fórmula Yiqi Huoxue na Atenuação da Remodelação Vascular Aterosclerótica via Regulação Inflamatória Mediada por KLF2-Nrf2.”
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Gel ultrassônico Aquasonic Clear | Parker Laboratories, Inc. | Mar-34 | Utilizado para imagem ecocardiográfica em pequenos animais. |
| Kit de ensaio de proteína BCA | Thermo Fisher Scientific | 23227 | Detecção em 562 nm; faixa, 20–2.000 µg/mL; utilizado para quantificação de proteína total em lisados de coração de camundongo. |
| Banco de dados CellAge | Recursos Genômicos do Envelhecimento Humano | https://genomics.senescence.info/cells/ | Fonte de assinaturas gênicas relacionadas ao envelhecimento. |
| CytoHubba, plugin do Cytoscape | Loja de Aplicativos do Cytoscape | Versão 0,1 | Utilizado para pontuação de topologia de nós em redes de interação proteína-proteína. |
| Cytoscape | Consortium Cytoscape | Versão 3,9,1 | Utilizado para visualização de redes de interação proteína-proteína. |
| Leitor de microplacas com espectro completo | Thermo Fisher Scientific | Multiskan FC | Utilizado para medir a absorbância em ensaios ELISA. |
| Gene Expression Omnibus | Centro Nacional de Informação Biotecnológica | https://www.ncbi.nlm.nih.gov/geo/ | Repositório público utilizado para obter conjuntos de dados transcriptômicos. |
| GeneCards | Instituto Weizmann de Ciência | https://www.genecards.org/ | Fonte de conjuntos de genes relacionados às mitocôndrias. |
| Cocktail inibidor de protease e fosfatase Halt, 100×, sem EDTA | Thermo Fisher Scientific | 78441 | Armazenado a 4 °C; adicionado ao tampão RIPA na proporção de 10 µL/mL imediatamente antes do uso. |
| Nitrogênio líquido | Fornecedor local de gases para laboratório | Não aplicável | Utilizado para congelamento rápido de tecido miocárdico. |
| Camundongos machos C57BL/6J de grau SPF, com 6–8 semanas de idade, 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Não aplicável | Licença de Produção Animal nº SCXK (Jing) 2021-0006; utilizados como controles normais. |
| Camundongos machos transgênicos SPF-grade CTNTR141W com DCM, com 6–8 semanas de idade, 25 ± 2 g | Instituto de Ciências de Animais de Laboratório, Academia Chinesa de Ciências Médicas | Não aplicável | Licença de Produção Animal nº SCXK (Jing) 2021-0065; utilizados como modelo espontâneo de DCM. |
| MCODE, plugin do Cytoscape | Loja de Aplicativos do Cytoscape | Versão 2,0,2 | Utilizado para identificar sub-redes funcionais centrais em redes de interação proteína-proteína. |
| Kit ELISA para CYBB de camundongo | Biogradetech | A-QEK09250-96wells | Utilizado neste estudo para medir CYBB em lisados de tecido miocárdico de camundongo. |
| Kit ELISA para PAI-1 de camundongo | EK-BIO | ML30970 | Utilizado neste estudo para medir PAI-1, a proteína codificada pelo gene SERPINE1, em lisados de tecido miocárdico de camundongo. |
| Kit ELISA para TGF-β2 de camundongo | ElaBoX | SEKM-0036 | Utilizado neste estudo para medir TGF-β2 em lisados de tecido miocárdico de camundongo. |
| Kit ELISA para TLR-2 de camundongo | Solarbio | SEKM-0163 | Utilizado neste estudo para medir TLR-2 em lisados de tecido miocárdico de camundongo. |
| Solução salina tamponada com fosfato, pH 7,4, sem cálcio e magnésio | Biological Industries | 02-024-1ACS | Solução estéril 1×; armazenada a 4 °C; utilizada para lavagem e diluição do tecido. |
| Pacote R: caret | CRAN | Versão 6,0-94 | Utilizado para eliminação recursiva de características por máquina de vetores de suporte. |
| Pacote R: CellChat | Desenvolvedores do CellChat | Versão 1,6,1 | Utilizado para inferência de comunicação entre células a partir de dados de sequenciamento de RNA de célula única. |
| Pacote R: clusterProfiler | Bioconductor | Versão 4,8,3 | Utilizado para análise de enriquecimento funcional. |
| Pacote R: ConsensusClusterPlus | Bioconductor | Versão 1,64,0 | Utilizado para agrupamento por consenso não supervisionado. |
| Pacote R: edgeR | Bioconductor | Versão 3,42,4 | Utilizado para normalização de dados de sequenciamento de RNA com o método da média aparada de valores M. |
| Pacote R: GEOquery | Bioconductor | Versão 2,68,0 | Utilizado para baixar dados do Gene Expression Omnibus. |
| Pacote R: glmnet | CRAN | Versão 4,1-8 | Utilizado para regressão logística com operador de contração e seleção absoluta mínima. |
| Pacote R: limma | Bioconductor | Versão 3,56,2 | Utilizado para análise de expressão diferencial e modelagem estatística. |
| Pacote R: pROC | CRAN | Versão 1,18,5 | Utilizado para análise de curva característica de operação do receptor. |
| Pacote R: randomForest | CRAN | Versão 4,7-1,2 | Utilizado para aprendizado de máquina com floresta aleatória. |
| Pacote R: Seurat | CRAN | Versão 5,0,1 | Utilizado para análise de dados de sequenciamento de RNA de célula única. |
| Pacote R: SingleR | Bioconductor | Versão 2,2,0 | Utilizado para anotação automatizada de tipos celulares. |
| Pacote R: sva | Bioconductor | Versão 3,48,0 | Utilizado para correção de efeito de lote com ComBat. |
| Centrífuga refrigerada | Sigma-Aldrich | SIGMA 3-K | Utilizada para centrifugação de lisados de tecido miocárdico. |
| Tampão de lise e extração RIPA | Thermo Fisher Scientific | 89900 | Solução pronta para uso 1×; armazenada a 4 °C; suplementada com inibidores de protease e fosfatase antes do uso. |
| Sistema de imagem ultrassônica para pequenos animais | VINNO Technology Co., Ltd. | VINN06LAB | Utilizado para avaliação ecocardiográfica da função cardíaca. |
| Pentobarbital de sódio | Sinopharm Chemical Reagent Co. | 20040428 | Preparado como solução a 1%, 10 mg/mL, em solução salina estéril; utilizado para anestesia intraperitoneal na dose de 30 mg/kg. |
| Banco de dados STRING | Consortium STRING | Versão 11,5 | Utilizado para construção de redes de interação proteína-proteína. |
| Homogeneizador de tecidos TGrinder H24 | TIANGEN | OSE-TH-01 | Utilizado para homogeneizar tecido miocárdico de camundongo em tampão RIPA a 6,0 m/s durante 30–60 s em 2–3 ciclos. |
| Plataforma térmica/ mesa cirúrgica aquecida para pequenos animais | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Utilizada para manter os camundongos a 37 °C durante a ecocardiografia; faixa de operação, da temperatura ambiente até 50 °C. |
Referências
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740