Este protocolo demonstra um fluxo de trabalho estruturado e auditável para o processamento de dados anonimizados de questionários de bem-estar de graduação, desde a exportação bruta e triagem de respostas até a pontuação de escalas, verificação de confiabilidade, diagnósticos de regressão, verificação de fontes das figuras e saídas analíticas prontas para visualização.
Artigo de método
Um Fluxo de Trabalho Estruturado para Triagem, Pontuação e Visualização de Dados de Questionários de Bem-Estar de Estudantes de Graduação
Neste artigo
Resumo
Resumo
Estudos baseados em questionários são amplamente utilizados para examinar o bem-estar de estudantes, mas a rota procedural dos dados brutos até variáveis analisáveis, tabelas estatísticas e saídas visuais geralmente não é suficientemente documentada. Este protocolo demonstra um fluxo de trabalho estruturado e auditável para processar dados anônimos de questionários sobre o bem-estar de estudantes de graduação, coletados com múltiplas seções em escalas tipo Likert. O fluxo de trabalho começa com a aprovação ética, documentação de consentimento, configuração do questionário e exportação dos dados brutos, e prossegue com triagem das respostas, revisão de respostas duplicadas, tratamento de dados ausentes, codificação dos itens, inversão de pontuação, avaliação de confiabilidade, análise descritiva, análise de correlação, comparação contrastiva entre grupos, modelagem de regressão, verificação diagnóstica e preparação das fontes para visualização. O questionário exemplo utiliza seções de escala documentadas na fonte e adaptadas ao estudo, baseadas nas Escalas Depressão Ansiedade Estresse-21, Escala de Procrastinação de Tuckman, Escala de Sentimento Psicológico de Pertencimento Escolar, literatura sobre mensuração de pensamento de ordem superior e documentação de escalas de bem-estar subjetivo. Emoção negativa, procrastinação acadêmica, sentimento de pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo são utilizados como variáveis de exemplo em nível de escala para demonstrar como respostas em nível de item podem ser convertidas em saídas analíticas rastreáveis. Saídas representativas incluem uma tabela de fluxo de triagem, resumo demográfico, estatísticas descritivas e de verificação de amplitude, estimativas de consistência interna, matriz de correlação, resultados de comparação contrastiva, coeficientes de regressão, diagnósticos de resíduos e influência, e arquivos fonte para figuras. O protocolo enfatiza regras de decisão pré-especificadas, um mapa de escalas vinculado, um registro de triagem pré-análise, verificação da inversão de pontuação e verificação da fonte numérica para figuras. Em vez de propor uma nova escala psicométrica, validar um modelo de mensuração ou estabelecer relações causais, este método fornece um procedimento prático e auditável para pesquisadores que precisam triar, pontuar, analisar e visualizar dados de bem-estar de estudantes de graduação baseados em questionários. O fluxo de trabalho pode ser adaptado a estudos relacionados baseados em questionários, desde que o mapa de escalas, aprovação ética, regras de pontuação, limiares de triagem de respostas e arquivos fonte para visualização sejam definidos antes da análise.
Introdução
O bem-estar subjetivo é um resultado importante na pesquisa com estudantes, pois reflete como os alunos avaliam suas vidas, experiências emocionais, relações sociais e funcionamento diário em ambientes de aprendizagem. No ensino superior, o bem-estar do estudante é multidimensional, não se limitando apenas à satisfação com a vida ou ao sofrimento psicológico1. Dados de questionários, portanto, continuam úteis quando os pesquisadores precisam examinar experiências emocionais, comportamentais, sociais, cognitivas e relacionadas ao bem-estar dentro de uma mesma estrutura analítica.
O valor dos dados de questionários depende não apenas dos construtos selecionados, mas também de como as respostas brutas são convertidas em variáveis analíticas. Muitos estudos relatam escores de escalas, matrizes de correlação, comparações entre grupos ou modelos de regressão sem mostrar as decisões intermediárias que conectam os registros brutos às tabelas e figuras finais. Respostas ausentes podem ser tratadas de forma inconsistente, itens invertidos podem ser codificados incorretamente, submissões duplicadas podem permanecer no conjunto de dados, e respostas desatentas podem ser tratadas como observações válidas. Assim, as decisões sobre dados ausentes devem ser planejadas, documentadas e relatadas, em vez de serem tratadas como uma etapa oculta e pós-hoc2. Dados de questionários online também exigem regras explícitas de qualidade de resposta, pois respostas rápidas excessivas (speeding), padrões de marcação linear (straight-lining), respostas inconsistentes e outros padrões de baixo esforço podem distorcer estatísticas descritivas, estimativas de confiabilidade e associações observadas3.
A novidade deste protocolo reside na sua trilha de auditoria vinculada, que vai da exportação bruta do questionário até as saídas finais estatísticas e visuais. Especificamente, o fluxo de trabalho inclui um mapa completo de escalas, um registro de triagem pré-análise, um ponto de verificação para inversão de pontuação, um registro de verificação de pontuação, verificação da fonte numérica das figuras e um rastreamento de auditoria que vincula cada tabela ou figura ao seu arquivo de origem. Isso distingue o método das práticas padrão de limpeza de questionários, pontuação de escalas, testes de confiabilidade ou visualização. Em vez de apenas afirmar que os dados do questionário foram limpos e analisados, o protocolo especifica qual arquivo está bloqueado, qual arquivo é triado, quais regras são aplicadas, quais pontuações de escala são geradas e qual tabela numérica verificada é utilizada para criar cada saída visual.
O fluxo de trabalho é demonstrado com dados anônimos de questionários respondidos por estudantes universitários, contendo cinco variáveis em escala: emoção negativa, procrastinação acadêmica, senso de pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo. Essas construções foram selecionadas para fornecer exemplos de natureza emocional, comportamental, contextual escolar, cognitiva e orientada a resultados dentro de um único fluxo de trabalho estruturado e auditável. A procrastinação acadêmica tem sido associada a dificuldades posteriores de saúde mental entre estudantes universitários, incluindo depressão, ansiedade e consequências relacionadas ao estresse4. O senso de pertencimento escolar e o bem-estar subjetivo também estão estreitamente relacionados em populações estudantis, o que apoia a inclusão de medidas relacionadas ao pertencimento e ao bem-estar dentro do mesmo framework de processamento de questionários5. No entanto, neste protocolo, essas construções são usadas para demonstrar o fluxo de trabalho, e não para estabelecer um modelo psicológico causal.
Um aspecto central do protocolo é a separação entre decisões de processamento de dados e interpretação substantiva. O mapa de escala é preparado antes da análise, os critérios de qualidade de resposta são definidos antes da pontuação da escala, a verificação da inversão de pontuação é concluída antes dos testes estatísticos e as figuras são geradas somente após a verificação das tabelas numéricas de origem. Essa sequência é importante porque escalas de resposta do tipo Likert exigem um alinhamento cuidadoso entre a redação dos itens, os pontos de ancoragem das respostas, o sentido da pontuação e o tratamento estatístico6. O protocolo também prioriza a complexidade do modelo após um pré-processamento transparente e verificação da pontuação. Modelos preditivos ou multivariáveis podem ser úteis em pesquisas com estudantes7, e resumos gráficos podem melhorar a interpretação quando permanecem vinculados a matrizes numéricas verificadas8, mas ambos dependem da preparação transparente das variáveis de entrada. Por essa razão, o fluxo de trabalho utiliza análise de correlação, comparação contrastiva entre grupos, modelagem de regressão, verificação diagnóstica e visualização como módulos exemplificativos, e não como afirmações substantivas obrigatórias.
Este protocolo destina-se a pesquisadores que precisam de um fluxo de trabalho prático para processamento de questionários com dados anônimos sobre o bem-estar de estudantes. É adequado quando as respostas aos itens do questionário são exportadas de uma plataforma online, variáveis em nível de escala devem ser calculadas a partir de itens do tipo Likert e o objetivo é produzir saídas descritivas, correlacionais, de comparação entre grupos, regressão, diagnóstico e visualizações prontas para uso. Ele não foi concebido para estabelecer relações causais, validar novas escalas, substituir análise fatorial confirmatória, substituir testes de invariância de medida ou servir como alternativa à modelagem de resposta ao item ou de variáveis latentes. Sua contribuição é procedural: torna clara, repetível e auditável a trajetória dos registros do questionário até as tabelas e figuras relatadas. Esse foco está alinhado às preocupações atuais sobre a qualidade dos dados de pesquisas online9, verificação de regressão e influência10 e fluxos de trabalho de análise baseados em questionários auditáveis11.
Protocolo
Este estudo envolvendo participantes humanos foi revisado e aprovado pelo Comitê de Ética do College of Aeronautics, Guizhou Open University (Número de Aprovação: GZOU-EDU-2024-015). O comitê determinou que o estudo se qualificava para isenção ética porque utilizava procedimentos de questionário anônimos e voluntários e não apresentava risco superior ao mínimo para os participantes. Todos os participantes forneceram consentimento informado eletrônico antes de responder ao questionário e podiam interromper as respostas a qualquer momento, sem penalidade. Como diversos itens abordavam emoções negativas, estresse, solidão, desamparo, insatisfação ou experiências relacionadas ao bem-estar, a página de consentimento e a página final do questionário forneceram informações de contato do pesquisador e da instituição para participantes que sentissem desconforto. O conjunto de dados utilizado neste protocolo foi anonimizado antes da triagem, pontuação, análise e visualização. O questionário completo está disponível como Arquivo Suplementar 1.
1. Prepare o questionário, os materiais de ética e os artefatos do fluxo de trabalho
- Defina a população elegível, o ambiente do estudo, os construtos do questionário e as saídas analíticas planejadas antes de programar o questionário.
- Prepare um pedido de ética que abranja a população-alvo, o canal de recrutamento, o conteúdo do questionário, o tempo estimado de conclusão, a proteção do anonimato, o armazenamento de dados, o procedimento de retirada, as informações de apoio aos participantes e as análises planejadas.
- Guarde no diretório do projeto o documento de aprovação ou isenção ética, a redação do consentimento, o texto de recrutamento, a versão do questionário, as informações de apoio aos participantes e o fluxo de trabalho planejado antes do início da coleta de dados.
- Defina a população-alvo como estudantes universitários em regime integral com pelo menos 18 anos de idade, atualmente matriculados no ensino superior, capazes de compreender o questionário e de fornecer consentimento informado.
- Defina os critérios de exclusão antes do recrutamento. Exclua respondentes que recusarem o consentimento, que não atendam à definição da população-alvo, que submeterem respostas duplicadas, que excedam o limite de dados ausentes ou que atendam aos critérios combinados de resposta inválida descritos na Etapa 1.4.
- Coloque a declaração de consentimento informado no início do questionário. Informe o objetivo do estudo, a natureza voluntária da participação, o tempo aproximado de conclusão de 12 minutos, a proteção do anonimato, o direito de retirada, o plano de uso dos dados, as informações de contato dos pesquisadores e as informações de contato para apoio.
- Não colete informações diretamente identificáveis, incluindo números de identificação estudantil, números de identificação nacional, números de telefone celular, endereços de e-mail pessoais, endereços de alojamentos ou outros identificadores pessoais.
- Organize o questionário nesta ordem: consentimento informado, informações demográficas, itens de emoção negativa, itens de procrastinação acadêmica, itens de pertencimento escolar, itens de pensamento de ordem superior e itens de bem-estar subjetivo.
- Selecione os instrumentos originais antes de programar o questionário. Neste protocolo, a emoção negativa foi avaliada usando a escala de depressão, ansiedade e estresse de 21 itens (DASS-21), a procrastinação acadêmica usando a escala de procrastinação de Tuckman de 16 itens, o pertencimento escolar usando a escala de senso psicológico de pertencimento escolar de 18 itens, o pensamento de ordem superior usando um conjunto de 20 itens adaptado da literatura publicada sobre mensuração do pensamento de ordem superior, e o bem-estar subjetivo usando uma escala de 20 itens de bem-estar subjetivo para pesquisas com estudantes universitários12,13,14,15,16.
- Prepare um mapa de escalas bloqueado antes de programar o questionário. Inclua o nome do construto, o nome original da escala, a citação original, a versão linguística, o status de permissão ou autorização, o procedimento de tradução ou adaptação, o código do item, a redação do item, a faixa de resposta, os pontos de ancoragem da resposta, a direção da pontuação, o status de inversão da pontuação, a variável final no nível da escala e a regra de pontuação.
- Descreva um conjunto de itens como uma escala validada apenas quando o instrumento original, a citação, as evidências de validação e o status de adaptação ou tradução forem documentados. Identifique qualquer conjunto de itens desenvolvido pelo autor ou específico ao estudo na Tabela 1 e no Arquivo Suplementar 1.
- Bloqueie a estrutura de mensuração antes da coleta de dados. Para instrumentos traduzidos ou adaptados, conclua a tradução, revisão, reconciliação e verificação piloto antes do início do recrutamento.
- Prepare um pacote de auditoria do fluxo de trabalho que inclua o arquivo do questionário bloqueado, o mapa de escalas, a lista de verificação para exportação de dados brutos, o registro de triagem, o registro de verificação de pontuação, o registro de análise, o modelo de tabela de fonte das figuras e o arquivo de sintaxe ou script de análise.
- Use nomes de arquivos com versão para todos os artefatos do fluxo de trabalho.
- Defina as colunas obrigatórias para cada arquivo de auditoria.
- O registro de triagem inclui ID do registro, critério de triagem, status da sinalização, status de exclusão, motivo da exclusão, data da decisão e iniciais do revisor.
- O mapa de escalas inclui nome do construto, fonte da escala, código do item, redação do item, faixa de resposta, pontos de ancoragem da resposta, status de inversão da pontuação, nome final da variável, regra de pontuação e status de permissão ou adaptação.
- O registro de verificação de pontuação inclui código do item, faixa de valores original, faixa de valores recodificados, fórmula de inversão da pontuação, resultado da verificação de faixa, status de discrepância, correção realizada e data da correção.
- A tabela de fonte das figuras inclui o número da figura, número do painel, tabela de origem, variáveis representadas, estatística exibida, tamanho da amostra e status de verificação.
- Defina o fluxo de trabalho analítico antes de programar o questionário: aplicação da pesquisa, exportação de dados brutos, triagem de respostas, pontuação das escalas, avaliação de confiabilidade, análise descritiva, análise de correlação, comparação entre grupos alto e baixo, modelagem de regressão, verificações diagnósticas e preparação de visualizações17.
- Estruture o protocolo em torno de decisões, operações e saídas de verificação, e não em torno de caminhos de menus de software.
- Forneça recursos do fluxo de trabalho quando permitido pelas políticas institucionais e editoriais, incluindo o arquivo do questionário, o mapa de escalas, o modelo de registro de triagem, o modelo de registro de pontuação, o arquivo de sintaxe ou script de análise e as tabelas de fonte das figuras.
NOTA: Figura 1 mostra o percurso desde a preparação do questionário até a exportação de dados brutos, triagem de respostas, pontuação das escalas, análise estatística, verificações diagnósticas e saída de visualizações. Tabela 1 relata o instrumento original, a quantidade de itens, a faixa de resposta, a estrutura de pontuação, a regra de inversão da pontuação, o status de permissão ou adaptação e a variável final no nível da escala para cada construto.
2. Configurar e distribuir o questionário
- Confirme se a plataforma do questionário suporta controle de consentimento, itens obrigatórios, revisão de submissões duplicadas, captura de carimbo de data/hora e registro da duração da resposta.
- Crie o questionário utilizando a plataforma de pesquisa online listada na Tabela de Materiais. Programe o questionário de acordo com o mapa de escalas fixado.
- Compare o questionário programado com o mapa de escalas fixado, item por item, antes de liberar o link da pesquisa. Registre quaisquer correções no diário do estudo.
- Defina o item de consentimento informado como o primeiro item obrigatório. Interrompa automaticamente o questionário quando um participante selecionar “Não concordo em participar”.
- Programe as seções de dados demográficos e escalas psicológicas de acordo com a ordem definida na Etapa 1.8. Utilize códigos de itens que correspondam ao mapa de escalas.
- Defina os itens das escalas psicológicas como obrigatórios somente quando permitido pela aprovação ou isenção ética e quando os participantes puderem se retirar sem penalidade. Se respostas forçadas não forem permitidas, registre a regra de dados ausentes antes da coleta de dados.
- Exiba os pontos de referência de resposta antes de cada seção de escala e mantenha os pontos de referência consistentes dentro de cada escala18.
- Desative submissões repetidas quando a plataforma de pesquisa oferecer essa função. Mantenha qualquer identificador anônimo de dispositivo, navegador, plataforma ou submissão necessário para revisão de respostas duplicadas.
- Habilite o registro automático do horário de submissão e da duração da conclusão.
- Defina o período de abertura do questionário como 7 dias corridos, ou utilize a janela de coleta aprovada pelo comitê de ética.
- Envie o link do questionário por meio do canal institucional de recrutamento aprovado. Forneça as mesmas instruções escritas a todos os participantes.
- Encerre o questionário após o término da janela de coleta previamente especificada.
OBSERVAÇÃO: Mantenha no diário do estudo o texto de recrutamento, link do questionário, datas de abertura e encerramento, configurações da plataforma, texto do consentimento, versão final do questionário e configurações de exportação da plataforma.
3. Exportar e proteger os dados brutos
- Exporte as respostas do questionário concluído como um arquivo de planilha imediatamente após o fechamento do período de coleta.
- Salve o primeiro arquivo exportado como o conjunto de dados bruto bloqueado. Não edite este arquivo.
- Crie uma cópia de trabalho para triagem, pontuação e análise. Nomeie o arquivo com a data, número da versão e identificador do projeto.
- Confirme que o arquivo exportado contém uma linha por respondente e uma coluna por variável demográfica, item do questionário, variável de carimbo de data/hora, variável da plataforma ou campo derivado da plataforma.
- Armazene o conjunto de dados bruto bloqueado, a cópia de trabalho, o mapa de escalas, o arquivo do questionário, o registro do estudo, o registro de triagem, o registro de verificação de pontuação, o registro de análise, as tabelas-fonte das figuras e o arquivo de sintaxe ou script em uma pasta do projeto protegida por senha.
- Verifique se o conjunto de dados não contém informações diretamente identificáveis. Remova qualquer campo identificável inesperado da cópia de trabalho antes da análise e registre o nome do campo, motivo da remoção, data da remoção e inicial do revisor responsável no registro do estudo.
- Verifique a identificabilidade indireta antes de compartilhar ou publicar dados em nível individual dos participantes. Revise pequenas células demográficas criadas por combinações de sexo, idade, ano letivo, categoria da instituição e categoria da área acadêmica. Se uma célula contiver menos de cinco respondentes, combine categorias, suprima a célula ou forneça apenas dados agregados.
- Registre o status de disponibilidade dos dados no registro do estudo, indicando se os dados em nível individual dos participantes estão disponíveis, restritos por exigências éticas ou de privacidade, ou substituídos por um conjunto de dados agregado do fluxo de trabalho.
- Crie um registro de triagem antes da limpeza dos dados. Registre o tamanho da amostra bruta, critério de triagem, número de registros sinalizados, número de registros removidos, número de registros mantidos, motivo da exclusão, data da decisão e iniciais do revisor.
- Crie um arquivo de rastreamento de análise antes da análise estatística. Registre o nome do software, versão do software, sistema operacional, nomes dos arquivos, versão dos dados, versão do script ou da sintaxe e data de cada execução da análise.
NOTA: Use o conjunto de dados bruto bloqueado apenas para verificação. Realize toda triagem, pontuação e análise utilizando a cópia de trabalho.
4. Analisar respostas e construir o conjunto de dados analítico
- Aplicar regras predefinidas de exclusão e controle de qualidade antes de calcular qualquer escore em nível de escala.
- Aplicar as regras de triagem à cópia de trabalho nesta ordem: status de consentimento, elegibilidade, submissões duplicadas, dados ausentes, duração da resposta, respostas em linha reta, valores fora da faixa e indicadores combinados de qualidade de resposta.
- Após cada operação de triagem, registrar o número de registros sinalizados, removidos e mantidos no log de triagem. Não sobrescrever versões anteriores do arquivo de trabalho.
- Remover todos os registros em que o item de consentimento informado estiver marcado como “Não” ou deixado sem resposta.
- Remover todos os registros que não atendam aos critérios de inclusão definidos na Etapa 1.4.
- Verificar submissões duplicadas usando identificadores anônimos de resposta, horário de envio, alertas da plataforma para submissões duplicadas e padrões de resposta repetidos.
- Manter a primeira submissão completa quando entradas duplicadas forem detectadas, exceto se houver justificativa documentada para manter uma submissão completa posterior.
- Corrigir todas as regras de qualidade de resposta antes de calcular os escores das escalas. Tabela 2 resume os limiares de exclusão, limiares de sinalização, justificativa, suporte na literatura e plano de análise de sensibilidade utilizados no fluxo de trabalho.
- Verificar dados ausentes. Remover um respondente quando mais de 20% de todos os itens da escala estiverem ausentes. Substituir um item isolado ausente pela média do respondente na mesma escala somente quando pelo menos 80% dessa escala já tenha sido preenchida. Não imputar variáveis demográficas, exceto se a variável não for usada em qualquer análise.
- Registrar o número de respondentes excluídos por terem mais de 20% de itens ausentes na escala e o número que recebeu imputação pela média dentro da escala. No conjunto de dados atual, 4 respondentes foram excluídos por terem mais de 20% de itens ausentes na escala, e 21 respondentes receberam imputação pela média dentro da escala para 37 itens ausentes isolados.
- Verificar a duração da resposta. Sinalizar respostas concluídas em menos de 180 s. Tratar esse valor como um indicador de resposta rápida, e não como regra automática de exclusão.
- Verificar respostas em linha reta. Sinalizar uma resposta quando a mesma opção for selecionada em mais de 90% de todos os itens de escala Likert. Tratar esse valor como um indicador de padrão de resposta, e não como regra automática de exclusão.
- Verificar indicadores adicionais de baixo esforço, incluindo evidência de submissões duplicadas, carimbos de tempo impossíveis, cadeias de respostas repetidas em submissões distintas ou conflitos entre metadados da plataforma e conteúdo do questionário.
- Remover uma resposta sinalizada somente quando pelo menos dois indicadores de controle de qualidade indicarem resposta inválida, como tempo extremamente curto de conclusão combinado com respostas em linha reta, evidência de submissão duplicada ou metadados da plataforma impossíveis19.
- Registrar todos os registros sinalizados, mesmo quando forem mantidos. No conjunto de dados atual, 19 respostas foram sinalizadas por duração de conclusão < 180 s, 8 respostas foram sinalizadas por >90% de respostas em linha reta e 13 registros foram excluídos por atenderem a dois ou mais indicadores de qualidade de resposta.
- Verificar valores fora da faixa. Confirmar que os itens de emoção negativa estejam entre 1–4, os itens de procrastinação acadêmica, pertencimento escolar e pensamento de ordem superior estejam entre 1–5 e os itens de bem-estar subjetivo estejam entre 1–6.
- Corrigir um valor somente quando a exportação original mostrar claramente um erro de formatação. Não alterar escores psicológicos válidos apenas porque pareçam incomumente altos ou baixos.
- Gerar uma tabela de fluxo de triagem relatando questionários submetidos, exclusões por consentimento e elegibilidade, exclusões por duplicidade, exclusões por dados ausentes, sinalizações por qualidade de resposta, exclusões combinadas por controle de qualidade, imputações de itens isolados, casos analíticos mantidos e tamanho final da amostra analítica.
- Preencher a tabela de fluxo de triagem usando o log de triagem bloqueado e manter um registro auditável exportado das decisões de triagem. No conjunto de dados atual, o fluxo de triagem foi o seguinte: questionários submetidos, n = 448; exclusões por consentimento ou elegibilidade, n = 6; submissões duplicadas removidas, n = 5; registros excluídos por >20% de itens ausentes na escala, n = 4; registros excluídos por dois ou mais indicadores de qualidade de resposta, n = 13; conjunto de dados analítico final, n = 420.
- Salvar os registros mantidos como o conjunto de dados analítico. Usar um novo nome de arquivo com versão e manter o log de triagem junto com o conjunto de dados analítico.
NOTA: Manter escores extremos válidos, exceto se houver um problema documentado de qualidade de resposta.
5. Avaliar as escalas psicológicas
- Converta as respostas em nível de item em variáveis em nível de escala somente após a conclusão da triagem das respostas e o salvamento do conjunto de dados analítico.
- Codifique todos os itens do tipo Likert de acordo com os pontos de resposta do questionário finalizado e as regras de pontuação no mapa da escala.
- Mantenha as variáveis originais dos itens inalteradas. Crie variáveis derivadas separadas para itens recodificados ou invertidos na pontuação.
- Pontue cada escala de acordo com o mapa de escala finalizado e o instrumento original correspondente ou manual de pontuação.
- Inverta a pontuação dos itens designados de bem-estar subjetivo antes de calcular a pontuação de bem-estar subjetivo. Para a escala de resposta de 1 a 6, calcule cada item invertido como 7 menos a pontuação original e adicione _R ao nome da variável derivada.
- Utilize as variáveis com pontuação invertida, e não as variáveis originais, ao calcular o bem-estar subjetivo.
- Calcule cada pontuação em nível de escala como a média de seus itens mantidos: emoção negativa, procrastinação acadêmica, sentimento de pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo.
- Nomeie as variáveis finais em nível de escala como Emoção negativa, Procrastinação acadêmica, Sentimento de pertencimento escolar, Pensamento de ordem superior e Bem-estar subjetivo.
- Verifique o valor mínimo e máximo de cada variável em nível de escala em relação à sua faixa teórica de resposta. Revise a codificação, a inversão de pontuação e o tratamento de valores ausentes se alguma pontuação estiver fora da faixa esperada.
- Verifique a direção de cada escala em relação ao mapa da escala antes da análise inferencial. Pontuações mais altas devem refletir a direção pretendida do constructo.
- Realize uma auditoria de inversão de pontuação antes da análise. Recalcule os itens com pontuação invertida para um subconjunto aleatório de registros ou para todos os itens com pontuação invertida quando viável, e registre o resultado da auditoria no log de verificação de pontuação.
- Se for detectado um erro na pontuação, corrija a variável derivada, gere novamente a pontuação da escala afetada, atualize o log de verificação de pontuação e refaça todas as análises subsequentes e tabelas de fonte para figuras com base no conjunto de dados analítico corrigido.
NOTA: Trate a inversão de pontuação e a verificação de faixa como pontos obrigatórios antes da análise de correlação, comparação entre grupos, modelagem de regressão ou visualização.
6. Avaliar a consistência interna e as propriedades descritivas
- Calcule a consistência interna, as correlações corrigidas item-total e as estatísticas descritivas para cada escala utilizando as variáveis dos itens definidas no mapa de escala fixado.
- Registre o alfa de Cronbach, o número de itens, o tamanho da amostra válida, as correlações corrigidas item-total e os valores de alfa-se-o-item-for-excluído para cada escala.
- Utilize o alfa de Cronbach igual a 0,70 como limite mínimo aceitável de confiabilidade para este fluxo de trabalho. Antes de remover qualquer item, verifique a redação do item, a direção da pontuação, a inversão da pontuação, o alinhamento com o construto e a documentação do instrumento original20.
- Calcule o ômega de McDonald como uma estimativa complementar de confiabilidade, quando o ambiente de análise o permitir. Relate o ômega juntamente com o alfa de Cronbach quando essas duas estimativas levarem a interpretações diferentes de confiabilidade.
- Examine cuidadosamente qualquer item com correlação corrigida item-total negativa ou muito baixa antes de considerar sua exclusão. Trate isso inicialmente como um possível problema de codificação, inversão de pontuação ou alinhamento com o construto.
- Não remova um item apenas para aumentar o alfa de Cronbach. A exclusão de itens deve ser justificada pelo manual de pontuação, pela redação do item, pela correlação corrigida item-total, pela adequação conceitual e pela verificação documentada da pontuação.
- Calcule as estatísticas descritivas para todas as cinco variáveis ao nível da escala, incluindo média, desvio padrão, mínimo, máximo, assimetria (skewness) e curtose (kurtosis).
- Verifique a concentração nos limites inferior (floor) ou superior (ceiling) registrando a proporção de respondentes com as pontuações mínimas e máximas possíveis para cada escala.
- Registre as estimativas de confiabilidade, os diagnósticos item-total, as estatísticas descritivas e quaisquer decisões de pontuação no registro de análise.
NOTA: O alfa de Cronbach é usado como um ponto de verificação de confiabilidade, e não como um procedimento completo de validação psicométrica. Quando for necessária uma avaliação formal de mensuração, complemente este fluxo de trabalho com o ômega de McDonald, análise fatorial confirmatória, testes de invariância de medida, modelagem de resposta ao item ou outros métodos baseados em variáveis latentes.
7. Realize a análise de correlação
- Utilize as cinco variáveis de nível escalar verificadas: emoção negativa, procrastinação acadêmica, pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo.
- Antes de calcular as correlações de Pearson, examine as distribuições e os diagramas de dispersão bivariados para cada par de variáveis de nível escalar.
- Avalie se as variáveis apresentam variação de pontuação aproximadamente contínua, assimetria acentuada, relações não lineares ou padrões influentes de valores discrepantes.
- Calcule os coeficientes de correlação de Pearson e os valores de p bicaudais para todos os pares de variáveis de nível escalar quando as premissas forem aceitáveis para análise descritiva de associação.
- Registre o coeficiente de correlação, valor de p, tamanho da amostra e direção da associação para cada par de variáveis.
- Relate os coeficientes de correlação com três casas decimais.
- Compare a direção de cada coeficiente com o mapa da escala. Reavalie a pontuação dos itens se um coeficiente contradizer a direção pretendida do construto.
- Salve a matriz de correlação verificada como tabela numérica de origem para o mapa de calor de correlação na seção Resultados Representativos.
- Quando as distribuições forem acentuadamente assimétricas, for necessária sensibilidade de escala ordinal ou os diagramas de dispersão sugerirem associações monótonas, mas não lineares, repita a análise utilizando a correlação de Spearman e compare a direção e a magnitude relativa das associações.
- Registre se os resultados de Pearson e Spearman levaram à mesma interpretação substantiva.
NOTA: Utilize a análise de correlação tanto como verificação descritiva de associação quanto como auditoria da direção de pontuação.
8. Criar grupos de alta e baixa bem-estar subjetivo
- Utilize o conjunto de dados analítico limpo e pontuado. Não retorne à exportação bruta para a construção dos grupos.
- Utilize a pontuação contínua de bem-estar subjetivo como desfecho primário para a modelagem de regressão. Utilize o agrupamento alto-baixo apenas para comparação contrastiva de perfis.
- Ordene os respondentes pela pontuação de bem-estar subjetivo, da mais alta para a mais baixa.
- Aplique a regra pré-especificada de grupos extremos de 27% para definir os grupos de alto e baixo bem-estar subjetivo. Documente a justificativa para este limiar na Tabela 2 e no registro de análise.
- Atribua os respondentes aos 27% superiores ao grupo de alto bem-estar subjetivo e os respondentes aos 27% inferiores ao grupo de baixo bem-estar subjetivo.
- Mantenha os 46% centrais no conjunto de dados analítico completo para estatísticas descritivas, análise de correlação, comparação por sexo e modelagem de regressão, mas exclua esses casos da comparação alto-baixo.
- Crie uma variável de agrupamento denominada Grupo de bem-estar subjetivo. Codifique o grupo superior como Alto, o grupo inferior como Baixo e os respondentes restantes como Médio.
- Verifique se os grupos alto e baixo contêm o número previsto de casos. Se houver empates nas pontuações no limite de 27%, aplique a regra pré-especificada para tratamento de empates e registre a decisão no registro de análise.
- Realize uma análise de sensibilidade quando o limite de 27% gerar pertinência instável aos grupos devido a empates nas pontuações ou a um tamanho amostral pequeno. Utilize uma regra alternativa pré-especificada, como o agrupamento em tercis, e informe se a interpretação permanece inalterada.
NOTA: O agrupamento alto-baixo é um procedimento descritivo de contraste. Ele não deve substituir a pontuação contínua de bem-estar subjetivo no modelo primário de regressão.
9. Compare os grupos de alta e baixa bem-estar subjetivo
- Filtre o conjunto de dados analítico para manter apenas os respondentes codificados como Alto ou Baixo na variável de agrupamento de bem-estar subjetivo.
- Compare os grupos alto e baixo em relação à emoção negativa, procrastinação acadêmica, pertencimento escolar e pensamento de ordem superior.
- Antes da comparação entre grupos, examine as distribuições específicas de cada grupo, os tamanhos das amostras e a igualdade de variâncias para cada variável.
- Utilize uma amostra independente t-teste quando as suposições de distribuição e variância forem aceitáveis. Utilize o de Welch t-teste quando a suposição de igualdade de variâncias não for atendida.
- Registre as médias dos grupos, desvios padrão, diferenças médias, tvalores, graus de liberdade, p-valores e intervalos de confiança de 95%.
- Calcule o d de Cohen para cada diferença entre grupos e interprete o tamanho do efeito com o valor de p.
- Verifique se a direção de cada diferença entre grupos é consistente com as definições dos construtos e com a matriz de correlação.
- Salve a tabela de comparação entre grupos verificada como a fonte numérica para qualquer visualização de comparação entre grupos.
- Relate esta análise como um contraste entre perfis extremos de bem-estar subjetivo.
OBSERVAÇÃO: Não interprete a comparação entre alto e baixo como evidência causal.
10. Examinar diferenças sexuais
- Remova o filtro de grupo alto-baixo e retorne ao conjunto completo de dados analíticos.
- Utilize o sexo como uma variável descritiva de agrupamento, em vez de como uma exposição causal.
- Compare respondentes femininos e masculinos em relação à emoção negativa, procrastinação acadêmica, pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo.
- Antes da comparação, examine os tamanhos amostrais específicos por grupo, ausência de dados, distribuições e igualdade de variâncias.
- Utilize o teste t para amostras independentes quando os pressupostos forem aceitáveis. Utilize o teste t de Welch quando o pressuposto de igualdade de variância não for atendido.
- Registre as médias por grupo, desvios padrão, diferenças médias, valores de t, graus de liberdade, valores de p, intervalos de confiança de 95% e valores de d de Cohen.
- Interprete as diferenças por sexo de forma descritiva e relate os tamanhos de efeito juntamente com os valores de p.
- Não utilize os resultados da comparação por sexo para justificar exclusões post hoc, modificações de escalas ou interpretações causais.
NOTA: As comparações por sexo são incluídas como verificações descritivas de subgrupos dentro deste fluxo de trabalho transversal com questionário.
11. Estime o modelo de regressão
- Utilize o bem-estar subjetivo como a variável dependente.
- Utilize emoção negativa, procrastinação acadêmica, sentimento de pertencimento escolar e pensamento de nível superior como preditores simultâneos em escala21.
- Utilize as variáveis contínuas em escala criadas durante a pontuação das escalas. Não substitua a pontuação contínua de bem-estar subjetivo pela variável categórica de alto-baixo.
- Ajuste o modelo principal utilizando regressão linear múltipla com entrada simultânea.
- Registre os coeficientes não padronizados, coeficientes padronizados, erros padrão, valores de t, valores de p, intervalos de confiança de 95%, R2, R2 ajustado, tolerância e fator de inflação da variância.
- Utilize valores de fator de inflação da variância inferiores a 5,00 como limiar para ausência de multicolinearidade grave.
- Examine gráficos de dispersão bivariados, gráficos parciais de regressão ou gráficos de componente-mais-resíduo para avaliar se as associações entre os preditores e o bem-estar subjetivo são aproximadamente lineares.
- Avalie a independência dos resíduos utilizando a estatística de Durbin-Watson.
- Avalie a normalidade dos resíduos utilizando um gráfico Q-Q dos resíduos e um teste formal de normalidade, quando apropriado para o tamanho da amostra.
- Avalie a homocedasticidade utilizando um gráfico dos resíduos padronizados contra os valores preditos padronizados.
- Salve os resíduos padronizados, os valores preditos padronizados, os valores de alavanca e a distância de Cook para verificação diagnóstica.
- Estime um modelo suplementar ajustado incluindo os quatro preditores psicológicos e as variáveis demográficas relatadas na descrição da amostra, incluindo sexo, idade, ano escolar, categoria da instituição e categoria da área acadêmica, quando essas variáveis estiverem disponíveis e adequadamente distribuídas.
- Compare o modelo principal com o modelo suplementar ajustado. Registre se a direção, magnitude e interpretação estatística dos quatro preditores psicológicos permanecem estáveis após o ajuste demográfico.
- Salve os coeficientes padronizados verificados e os intervalos de confiança de 95% do modelo principal como a tabela numérica de origem para o gráfico de coeficientes na seção Resultados Representativos22.
NOTA: Interprete os coeficientes de regressão como associações condicionais, não como efeitos causais. O modelo ajustado por variáveis demográficas é utilizado em uma análise de sensibilidade para avaliar se as conclusões do fluxo de trabalho permanecem estáveis após o controle das variáveis contextuais disponíveis.
12. Diagnosticar o modelo de regressão
- Examine os resíduos padronizados do modelo de regressão ajustado. Destaque os casos com resíduos padronizados absolutos maiores que 3,00.
- Examine os valores de alavanca e a distância de Cook para identificar observações influentes.
- Destaque observações com distância de Cook maior que 4/n como potencialmente influentes, em que n é o tamanho da amostra analítica. Considere distância de Cook maior que 1,00 como um limite de referência para influência severa, e não como o único critério de triagem.
- Examine o gráfico de resíduos versus valores preditos para detectar não linearidade, variância desigual e agrupamentos incomuns.
- Examine o gráfico Q-Q dos resíduos e o resultado do teste de normalidade dos resíduos. Registre se a avaliação de normalidade apoia o uso do modelo linear para análise descritiva de associação.
- Registre a estatística de Durbin-Watson e determine se a independência dos resíduos é aceitável.
- Revise todos os casos destacados com base no registro de triagem, no registro de verificação de pontuação e nos critérios de elegibilidade.
- Mantenha os casos destacados quando representarem observações válidas e não refletirem erros de entrada de dados, erros de pontuação, submissões duplicadas, violações de elegibilidade ou problemas documentados de qualidade de resposta.
- Corrija ou remova um caso destacado somente quando o histórico de auditoria identificar um erro documentado de procedimento, elegibilidade, codificação, pontuação ou entrada de dados.
- Refaça o modelo de regressão após qualquer correção documentada e compare os coeficientes, intervalos de confiança, R2, R2 ajustado e saídas diagnósticas com o modelo original.
- Realize uma verificação de sensibilidade à influência refazendo o modelo após excluir casos com distância de Cook maior que 4/n. Informe se a interpretação substantiva muda.
- Registre a decisão diagnóstica final no registro de análise, incluindo o número de casos destacados pelos resíduos padronizados, o número destacado pela distância de Cook maior que 4/n, a distância máxima de Cook, a estatística de Durbin-Watson e a conclusão dos testes de normalidade e linearidade dos resíduos.
NOTA: Não remova casos influentes apenas para melhorar o ajuste do modelo. A remoção ou correção deve basear-se em uma justificativa documentada no histórico de auditoria.
Resultados
Conjunto de dados analítico gerado após a triagem das respostas
O fluxo de trabalho de triagem gerou um conjunto de dados analítico composto por 420 registros anônimos de estudantes, provenientes de 448 questionários submetidos. O registro de triagem documentou cada ponto de decisão. Seis registros foram removidos porque os requisitos de consentimento ou elegibilidade não foram atendidos, cinco submissões duplicadas foram descartadas, quatro registros foram excluídos por apresentarem mais de 20% dos itens das escalas ausentes e 13 registros foram excluídos por atenderem a dois ou mais indicadores de qualidade de resposta. Dezenove respostas foram sinalizadas por apresentarem duração de conclusão <180 s, oito respostas foram sinalizadas por apresentarem >90% de respostas em linha reta e 21 respondentes tiveram imputação da média dentro da escala para 37 itens ausentes isolados. O conjunto de dados analítico final não continha informações diretamente identificáveis dos participantes, nenhum caso mantido excedia o limite de exclusão por dados ausentes e todas as respostas mantidas dos itens estavam dentro dos intervalos pré-definidos de resposta. O fluxo de triagem é resumido na Tabela 3.
A amostra retida incluiu 275 respondentes do sexo feminino e 145 do sexo masculino, correspondendo a 65,5% e 34,5% do conjunto de dados analítico, respectivamente. A idade média foi de 20,1 ± 1,2 anos. Os respondentes estavam distribuídos em quatro níveis acadêmicos de graduação, sendo que o 1º, 2º, 3º e 4º ano corresponderam a 27,1%, 27,4%, 25,5% e 20,0% da amostra, respectivamente. O conjunto de dados também incluiu três categorias institucionais e cinco categorias de área de formação acadêmica. Nenhuma célula demográfica publicada continha menos de cinco respondentes após a revisão das categorias. As características demográficas do conjunto de dados analítico são resumidas na Tabela 4.
Construção da escala, verificação da amplitude e exemplos de fluxo de trabalho subótimo
Após a codificação dos itens e inversão de pontuação, foram calculadas cinco variáveis no nível da escala: emoção negativa, procrastinação acadêmica, sentimento de pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo. Cada pontuação permaneceu dentro de sua faixa teórica de resposta. As pontuações de emoção negativa variaram de 1,048 a 3,143 numa escala de 1 a 4. A procrastinação acadêmica, o sentimento de pertencimento escolar e o pensamento de ordem superior variaram de 1,312 a 4,250, 2,333 a 4,444 e 2,350 a 4,850, respectivamente, em suas escalas de 1 a 5. O bem-estar subjetivo variou de 2,000 a 5,300 numa escala de 1 a 6. A verificação da inversão de pontuação não identificou discrepâncias entre as variáveis derivadas com pontuação invertida e a regra de pontuação fixa no conjunto final de dados analíticos. Essas verificações confirmaram que a codificação dos itens, a inversão de pontuação, o tratamento de itens ausentes e a agregação de pontuações foram realizadas sem erros detectáveis na amplitude.
O fluxo de trabalho também gerou exemplos subótimos de auditoria que ilustram como erros ou resultados questionáveis são detectados antes da análise final. Durante uma execução de auditoria, um valor invertido incorretamente derivado para bem-estar subjetivo foi detectado porque o registro de verificação de pontuação comparou o valor original, a fórmula esperada “pontuação invertida = 7 – pontuação original”, o valor derivado e o intervalo final da escala. A variável derivada foi corrigida, a pontuação de bem-estar subjetivo foi regenerada e todas as saídas downstream descritivas, de correlação, comparação, regressão, diagnóstico e de fonte para figuras foram reprocessadas. Em outro arquivo intermediário de trabalho, um valor de item fora do intervalo foi identificado durante a verificação de intervalo e rastreado até o manuseio da planilha, e não até a exportação bruta bloqueada. A cópia de trabalho foi corrigida e documentada sem alterar qualquer resposta extrema válida. Um alerta de confiabilidade também foi analisado quando um item apresentou uma correlação item-total corrigida menor do que os demais itens da mesma escala; como a redação do item, a direção da pontuação e o alinhamento com o construto estavam corretos, o item foi mantido. Uma discrepância em visualização preliminar foi identificada quando uma figura não correspondia à sua tabela numérica fonte verificada; a figura foi regenerada a partir da tabela verificada e o registro de fonte da figura foi atualizado. Esses exemplos demonstram que o fluxo de trabalho não apenas gera resultados bem-sucedidos, mas também detecta erros de codificação, problemas de intervalo, alertas de confiabilidade, discrepâncias entre figuras e suas fontes e questões relacionadas à qualidade das respostas por meio do rastro de auditoria.
Propriedades descritivas e consistência interna
As cinco variáveis em nível de escala apresentaram variação utilizável. A pontuação média de emoção negativa foi de 2,099 ± 0,391, e a pontuação média de procrastinação acadêmica foi de 2,639 ± 0,484. O sentimento de pertencimento escolar e o pensamento de ordem superior apresentaram valores médios moderadamente altos, de 3,343 ± 0,390 e 3,627 ± 0,418, respectivamente. A pontuação média de bem-estar subjetivo foi de 3,784 ± 0,543. Nenhuma escala apresentou padrão evidente de piso ou teto, e a proporção de respondentes no mínimo ou máximo teórico foi inferior a 2,0% em cada escala.
A consistência interna foi aceitável para todas as cinco escalas. Os valores do alfa de Cronbach variaram de 0,834 a 0,899, superando o limiar pré-especificado de 0,70. A emoção negativa apresentou a maior consistência interna, com alfa de Cronbach de 0,899, seguida pelo bem-estar subjetivo com valor de 0,895. Os valores de ômega de McDonald variaram de 0,842 a 0,906, e as estimativas de ômega não alteraram a interpretação da confiabilidade. A análise da correlação item-total corrigida não identificou nenhum item que necessitasse ser removido. As estatísticas descritivas e as estimativas de confiabilidade são apresentadas na Tabela 5.
Estrutura de correlação entre variáveis em nível de escala
A matriz de correlação foi utilizada como medida descritiva de associação e como verificação da direção dos escores. Antes do cálculo das correlações de Pearson, foram examinadas as distribuições das escalas e os diagramas de dispersão bivariados. Nenhuma variável apresentou assimetria ou curtose acentuadas, e nenhum gráfico bivariado exibiu um padrão fortemente não linear que invalidasse a análise descritiva de correlação de Pearson. O bem-estar subjetivo correlacionou-se negativamente com a emoção negativa (r = -0,496) e a procrastinação acadêmica (r = -0,294), e positivamente com o sentimento de pertencimento escolar (r = 0,481) e o pensamento de ordem superior (r = 0,386). As demais associações seguiram a mesma lógica de pontuação: a emoção negativa correlacionou-se positivamente com a procrastinação acadêmica (r = 0,270) e negativamente com o sentimento de pertencimento escolar (r = -0,346) e o pensamento de ordem superior (r = -0,205); a procrastinação acadêmica correlacionou-se negativamente com o sentimento de pertencimento escolar (r = -0,222) e o pensamento de ordem superior (r = -0,134); e o sentimento de pertencimento escolar correlacionou-se positivamente com o pensamento de ordem superior (r = 0,310). A matriz completa de correlação de Pearson é apresentada na Tabela 6.
Uma verificação de sensibilidade de Spearman produziu a mesma interpretação direcional para todos os pares de variáveis. As correlações de Spearman entre bem-estar subjetivo e os quatro preditores foram ρ = -0,502 para emoção negativa, ρ = -0,301 para procrastinação acadêmica, ρ = 0,477 para pertencimento escolar e ρ = 0,392 para pensamento de ordem superior. A matriz de Pearson verificada foi utilizada como tabela numérica de origem para visualização. Figura 2A apresenta o mapa de calor completo das correlações entre as cinco variáveis em escala. Figura 2B mostra as quatro correlações com o bem-estar subjetivo.
Demonstração contrastiva utilizando grupos de bem-estar subjetivo alto e baixo
A regra de agrupamento de 27% foi utilizada como uma demonstração metodológica contrastiva, e não como uma classificação substantiva de perfis reais de bem-estar. A regra gerou dois grupos de tamanho igual: 113 respondentes no grupo de alto bem-estar subjetivo e 113 no grupo de baixo bem-estar subjetivo. Os 194 respondentes intermediários foram mantidos no conjunto completo de dados analíticos, mas excluídos dessa comparação contrastiva. Nenhum empate limite alterou a atribuição ao grupo.
Este módulo demonstrou que o fluxo de trabalho poderia gerar uma variável de agrupamento predefinida, filtrar o conjunto de dados analítico, calcular estatísticas descritivas específicas para cada grupo, realizar comparações entre grupos apropriadas às suposições estatísticas e exportar uma tabela fonte verificada para visualização. O grupo com alta bem-estar subjetivo apresentou emoção negativa menor do que o grupo com baixo bem-estar subjetivo (1,864 ± 0,358 vs. 2,335 ± 0,343; diferença média = -0,472) e menor procrastinação acadêmica (2,455 ± 0,476 vs. 2,801 ± 0,483; diferença média = -0,346). A sensação de pertencimento escolar e o pensamento de ordem superior foram maiores no grupo com alto bem-estar subjetivo, com diferenças médias de 0,454 e 0,351, respectivamente. Todas as quatro comparações foram significativas (p < 0,001), com valores de d de Cohen de -1,346 para emoção negativa, -0,722 para procrastinação acadêmica, 1,279 para pertencimento escolar e 0,860 para pensamento de ordem superior. O teste t de Welch foi utilizado quando a suposição de igualdade de variâncias não foi atendida; caso contrário, manteve-se o teste t padrão para amostras independentes. Esses resultados não devem ser interpretados como evidência de que os preditores selecionados definem perfis reais de bem-estar estudantil, pois os grupos foram criados a partir da variável de resultado e depois comparados em variáveis correlacionadas. A comparação entre os grupos alto e baixo é resumida na Tabela 7.
Comparação descritiva por sexo
O sexo foi analisado como uma variável descritiva de agrupamento. Os respondentes do sexo feminino apresentaram uma pontuação média ligeiramente mais alta de emoção negativa do que os do sexo masculino (2,129 ± 0,380 vs. 2,042 ± 0,407). Essa diferença foi estatisticamente significativa, mas pequena em magnitude (p = 0,033; Cohen’s d = 0,224). A procrastinação acadêmica, a sensação de pertencimento escolar, o pensamento de ordem superior e o bem-estar subjetivo não apresentaram diferenças significativas com base no sexo. As médias de bem-estar subjetivo foram quase idênticas entre respondentes do sexo feminino e masculino (3,781 ± 0,521 vs. 3,789 ± 0,583; p = 0,887; d de Cohen d = -0,015). O teste de Welch tos testes de sensibilidade não alteraram a interpretação dos resultados da comparação entre sexos. Os resultados das diferenças entre sexos são apresentados em Tabela 8.
Modelo de regressão como exemplo de geração de modelo e verificação diagnóstica
O modelo de regressão linear múltipla foi utilizado como exemplo de geração, diagnóstico e verificação de um modelo a partir de dados de questionários pontuados. O bem-estar subjetivo foi inserido como variável dependente, enquanto emoção negativa, procrastinação acadêmica, senso de pertencimento escolar e pensamento de ordem superior foram inseridos simultaneamente como preditores em escala. O objetivo deste módulo foi demonstrar a extração de coeficientes, verificações de multicolinearidade, diagnósticos de resíduos, avaliação de influência, análise de sensibilidade ajustada por dados demográficos e a preparação de figuras e fontes.
O modelo explicou uma proporção moderada da variância no bem-estar subjetivo, com R2 = 0,411 e R2 ajustado = 0,406. A emoção negativa apresentou o maior coeficiente padronizado negativo (B = -0,450, β padronizado = -0,324). A procrastinação acadêmica também apresentou um coeficiente negativo (B = -0,130, β padronizado = -0,116). A sensação de pertencimento escolar e o pensamento de ordem superior apresentaram coeficientes padronizados positivos de β = 0,275 e β = 0,218, respectivamente. Os quatro preditores foram estatisticamente significativos no modelo ajustado: emoção negativa, sensação de pertencimento escolar e pensamento de ordem superior em p < 0,001, e procrastinação acadêmica em p = 0,004. Não houve indicação de multicolinearidade, já que todos os valores do fator de inflação da variância foram inferiores a 1,24. Essas saídas de regressão são resultados representativos da verificação do modelo, não uma explicação psicológica definitiva do bem-estar dos estudantes. Tabela 9 fornece a saída completa da regressão.
Um modelo suplementar ajustado por fatores demográficos foi estimado adicionando-se sexo, idade, ano letivo, categoria da instituição e categoria da área acadêmica aos quatro preditores psicológicos. O modelo ajustado explicou uma proporção semelhante de variância, com R2 = 0,427 e R2 ajustado = 0,414. A direção e a interpretação estatística dos quatro preditores psicológicos permaneceram inalteradas após o ajuste demográfico. O modelo de sensibilidade ajustado por fatores demográficos é resumido na Tabela 10. Figura 3A exibe os coeficientes padronizados e os intervalos de confiança de 95% para os quatro preditores. Figura 3B apresenta a exibição diagnóstica com base nos valores preditos padronizados, resíduos padronizados e distância de Cook.
Diagnósticos de regressão e retenção do modelo
Os diagnósticos de regressão não indicaram que o modelo ajustado fosse influenciado por um único registro influinte. Os gráficos bivariados e de regressão parcial não mostraram forte não linearidade. O gráfico de resíduos versus valores preditos não revelou heterocedasticidade acentuada ou agrupamento incomum. A estatística de Durbin-Watson foi de 1,93, indicando independência aceitável dos resíduos. O gráfico Q-Q dos resíduos não mostrou desvios acentuados da normalidade. Um teste formal de normalidade dos resíduos foi estatisticamente significativo, W = 0,992, p = 0,031, mas o gráfico Q-Q e o tamanho da amostra apoiaram a manutenção do modelo linear para análise descritiva de associação.
Dois registros apresentaram resíduos padronizados absolutos maiores que 3,00. Nenhum registro apresentou distância de Cook maior que 1,00. Utilizando o limiar mais sensível da distância de Cook >4/n, onde n = 420 e 4/n = 0,0095, 17 registros foram identificados como potencialmente influentes. A maior distância de Cook foi 0,037. Os casos com resíduos e influência identificados foram revisados com base no registro de triagem, no registro de verificação de pontuação e nos critérios de elegibilidade. Nenhum apresentou evidência de erros de entrada de dados, pontuação incorreta, respostas duplicadas, falhas de elegibilidade ou problemas documentados de qualidade de resposta; portanto, esses casos foram mantidos no modelo final. Uma verificação de sensibilidade à influência, excluindo casos com distância de Cook >4/n, produziu a mesma interpretação do fluxo de trabalho do modelo principal. A alteração máxima absoluta nos coeficientes padronizados foi de 0,026, e o ajustado R2 alterado de 0,406 para 0,405. Os resultados diagnósticos e de sensibilidade são resumidos em Tabela 11.
Verificação interna do pipeline analítico
O fluxo de trabalho foi repetido a partir do conjunto de dados analítico limpo e pontuado, utilizando as mesmas regras de pontuação, limiares de decisão e arquivo de rastreamento de análise. Foram repetidas as análises de consistência interna, estatísticas descritivas, análise de correlação, comparações entre grupos de alta e baixa pontuação, comparações por sexo, modelagem de regressão, verificação diagnóstica e preparação das fontes para visualização. As saídas repetidas corresponderam exatamente às estatísticas descritivas originais, matriz de correlação, valores das comparações entre grupos, coeficientes de regressão, saídas diagnósticas e arquivos fonte para visualização. Isso confirmou a estabilidade computacional do pipeline analítico quando aplicado ao mesmo conjunto de dados analítico fixado. Esta verificação não constitui reprodutibilidade procedural independente, que exigiria que um analista independente aplicasse todo o fluxo de trabalho a partir da exportação bruta fixada e obtivesse as mesmas saídas documentadas.
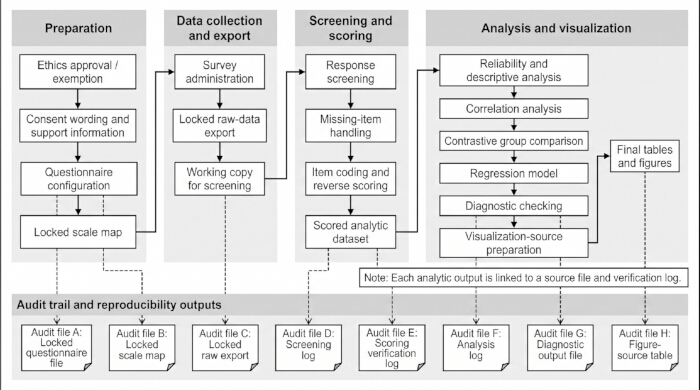
Figura 1: Fluxo de trabalho para o processamento de dados subjetivos de bem-estar baseados em questionário. O esquema mostra a sequência do protocolo e os principais produtos de auditoria, incluindo preparação ética, configuração do questionário, aplicação da pesquisa, exportação dos dados brutos, mapa de escalas, registro de triagem, conjunto de dados analíticos pontuados, tabelas de análise verificadas, diagnósticos de regressão, arquivos-fonte das figuras e saídas de visualização. Clique aqui para visualizar uma versão maior desta figura.
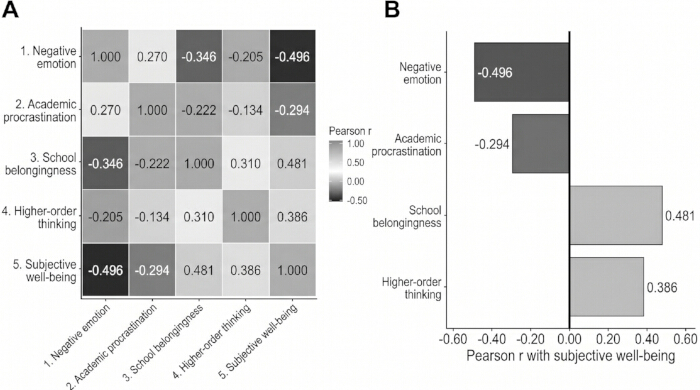
Figura 2: Estrutura de correlação entre as variáveis ao nível de escala. (A) Mapa de calor da correlação de Pearson gerado a partir da matriz de correlação verificada na Tabela 6. (B) Perfil de correlação centrado no bem-estar subjetivo, gerado a partir da mesma tabela fonte verificada. Todas as cinco variáveis ao nível de escala são exibidas: emoção negativa, procrastinação acadêmica, sentimento de pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo. Clique aqui para visualizar uma versão maior desta figura.
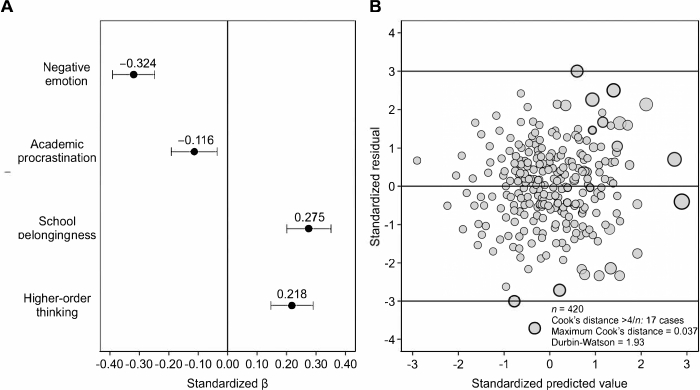
Figura 3: Coeficientes de regressão e visualização diagnóstica. (A) Coeficientes de regressão padronizados e intervalos de confiança de 95% gerados a partir da saída principal da regressão na Tabela 9. (B) Exibição do diagnóstico de regressão gerada a partir dos valores preditos padronizados, resíduos padronizados e valores de distância de Cook resumidos na Tabela 11. Valores maiores de distância de Cook indicam observações com maior potencial de influência no modelo ajustado. Clique aqui para visualizar uma versão maior desta figura.
Tabela 1: Estrutura do questionário e quadro de pontuação das escalas. Esta tabela resume o quadro de mensuração, incluindo o nome do construto, instrumento de origem, citação da fonte, status de adaptação ou documentação, número do item, amplitude de resposta, direção da pontuação, necessidade de inversão da pontuação, método de pontuação, variável final no nível da escala e função no protocolo. Clique aqui para baixar esta tabela.
Tabela 2: Critérios de triagem de respostas e decisões analíticas. Esta tabela lista os critérios pré-especificados para triagem de consentimento, triagem de elegibilidade, revisão de respostas duplicadas, tratamento de dados ausentes, sinalização de duração da resposta, detecção de respostas em linha reta, intervalos válidos de resposta, avaliação de confiabilidade, classificação em grupos alto-baixo, diagnósticos de regressão e verificações de sensibilidade. Clique aqui para baixar esta tabela.
Tabela 3: Fluxo de triagem dos questionários enviados até o conjunto de dados analítico final. Esta tabela apresenta o número de questionários enviados, registros sinalizados, registros removidos, registros mantidos e fontes de verificação em cada etapa da triagem. A duração da conclusão e as respostas em linha reta foram tratadas como indicadores de qualidade de resposta, e não como critérios automáticos de exclusão. Clique aqui para baixar esta tabela.
Tabela 4: Características demográficas do conjunto de dados analítico. Esta tabela resume os registros anônimos de estudantes mantidos após a triagem das respostas, incluindo sexo, idade, ano de graduação, categoria da instituição e categoria da área acadêmica. As células demográficas foram revisadas quanto ao risco de identificação indireta antes da divulgação. Clique aqui para baixar esta tabela.
Tabela 5: Estatísticas descritivas, verificação de faixa e consistência interna das cinco variáveis em nível de escala. Esta tabela apresenta o número de itens, faixa teórica, faixa observada, média, desvio padrão, alfa de Cronbach, ômega de McDonald e concentração de piso/teto para emoção negativa, procrastinação acadêmica, pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo. Clique aqui para baixar esta tabela.
Tabela 6: Matriz de correlação de Pearson das variáveis em escala. Esta tabela apresenta os coeficientes de correlação de Pearson entre emoção negativa, procrastinação acadêmica, senso de pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo. A matriz foi utilizada como um resultado descritivo de associação e como etapa de verificação da direção dos escores. Clique aqui para baixar esta tabela.
Tabela 7: Comparação contrastiva entre grupos de alta e baixa satisfação com a vida. Esta tabela compara emoção negativa, procrastinação acadêmica, senso de pertencimento escolar e pensamento de ordem superior entre respondentes nos 27% superiores e 27% inferiores dos escores de satisfação com a vida. A comparação demonstra o fluxo de trabalho de agrupamento e comparação, e não uma classificação substantiva de perfis de bem-estar. Clique aqui para baixar esta tabela.
Tabela 8: Comparação descritiva por sexo. Esta tabela apresenta comparações descritivas de emoção negativa, procrastinação acadêmica, pertencimento escolar, pensamento de ordem superior e bem-estar subjetivo por sexo. O sexo foi tratado como uma variável descritiva de agrupamento. Clique aqui para baixar esta tabela.
Tabela 9: Modelo primário de regressão linear múltipla prevendo bem-estar subjetivo. Esta tabela apresenta o modelo de regressão primário no qual o bem-estar subjetivo foi a variável dependente, e emoção negativa, procrastinação acadêmica, pertencimento escolar e pensamento de ordem superior foram inseridos simultaneamente como preditores em nível de escala. São incluídos os valores de erro padrão, intervalo de confiança e fator de inflação da variância. Clique aqui para baixar esta tabela.
Tabela 10: Modelo de sensibilidade de regressão ajustado por variáveis demográficas prevendo bem-estar subjetivo. Esta tabela apresenta os quatro preditores psicológicos após ajuste por sexo, idade, ano de graduação, categoria da instituição e categoria da área de formação acadêmica. As variáveis demográficas categóricas foram inseridas utilizando codificação dummy. Os valores de erro padrão, intervalo de confiança e fator de inflação de variância estão incluídos. Clique aqui para baixar esta tabela.
Tabela 11: Diagnósticos de regressão e verificações de sensibilidade à influência. Esta tabela resume os resultados dos diagnósticos do modelo, de resíduos e de influência, incluindo resíduos padronizados, distância de Cook > 1,00, distância de Cook > 4/n, distância máxima de Cook, estatística de Durbin-Watson, gráfico Q-Q dos resíduos, teste de normalidade dos resíduos, gráfico de resíduos versus valores preditos, verificação de linearidade e análise de sensibilidade à influência. Clique aqui para baixar esta tabela.
Arquivo Suplementar 1: Estrutura do questionário, origem das escalas e documentação de pontuação. Este arquivo suplementar fornece a ordem de aplicação do questionário, a redação do termo de consentimento informado, as variáveis demográficas, a documentação dos instrumentos de origem, os códigos dos itens, os pontos de ancoragem das respostas, informações sobre adaptação e status de documentação, a direção da pontuação, as regras de inversão de pontuação, a construção final das variáveis no nível da escala, as regras para tratamento de itens ausentes, os campos de vinculação da qualidade das respostas, as regras de verificação de intervalo e os vínculos de referência para os cinco construtos do questionário. Ele atua como suplemento do questionário/livro de códigos para documentar a programação, pontuação e verificação das escalas no fluxo de trabalho. Clique aqui para baixar este arquivo.
Discussão
Este protocolo padroniza um processo comum, mas muitas vezes pouco relatado, em estudos de bem-estar baseados em questionários: a transição de registros brutos de respostas para dados filtrados, variáveis de escala pontuadas, saídas estatísticas e arquivos prontos para visualização. Sua contribuição não reside no desenvolvimento de uma nova teoria do bem-estar subjetivo nem na proposta de um modelo causal. Em vez disso, o fluxo de trabalho fornece um caminho auditável para a configuração do questionário, filtragem de respostas, pontuação de escalas, verificação de confiabilidade, análise descritiva, análise de associações, diagnósticos de regressão e verificação da fonte das figuras. Essa distinção é importante porque a auditabilidade em pesquisas baseadas em questionários depende de decisões procedimentais frequentemente tomadas antes do início da interpretação estatística, incluindo quais registros são mantidos, como os itens ausentes são tratados, como os itens invertidos são processados e como as tabelas numéricas de origem são vinculadas às saídas visuais. Tornar essas decisões explícitas reduz práticas questionáveis de mensuração em pesquisas baseadas em escalas23 e apoia uma cultura de pesquisa mais transparente24.
Um aspecto central do protocolo é o uso de artefatos concretos de auditoria em vez de descrição verbal isolada. O fluxo de trabalho revisado vincula cada construto ao seu instrumento de origem, intervalo de itens, pontos de resposta, direção da pontuação, regra de inversão da pontuação, variável final no nível da escala e informações sobre adaptação ou status de documentação. O rastreamento de auditoria inclui o arquivo do questionário bloqueado, o mapa de escalas bloqueado, a exportação bruta bloqueada, o log de triagem, o log de verificação de pontuação, o log de análise, o arquivo de saída diagnóstica e a tabela de fontes das figuras. Esses arquivos esclarecem qual versão do questionário foi aplicada, quais registros foram excluídos ou mantidos, como as pontuações foram geradas e qual tabela verificada foi usada para criar cada figura. Quando os dados individuais dos participantes não puderem ser compartilhados publicamente, um conjunto de dados sintético com a mesma estrutura de variáveis e logs de triagem/pontuação completos pode permitir que os leitores testem o fluxo de trabalho computacional sem acessar registros identificáveis ou indiretamente identificáveis. Essa estrutura baseada em artefatos é compatível com o princípio FAIR de que saídas de pesquisa reutilizáveis exigem proveniência clara, estrutura e condições de acesso25.
Os resultados representativos devem ser interpretados como produtos do fluxo de trabalho, e não como evidência substancial sobre os determinantes psicológicos do bem-estar dos estudantes. A comparação entre bem-estar subjetivo alto e baixo foi incluída para demonstrar como uma regra predefinida de agrupamento pode ser implementada, verificada e relatada; ela não deve ser interpretada como uma classificação real de perfis de bem-estar. Da mesma forma, o modelo de regressão demonstra como dados pontuados de questionários podem ser modelados, verificados quanto à multicolinearidade, avaliados com diagnósticos de resíduos e influência, e vinculados a uma tabela fonte verificada. Ele não estabelece que emoção negativa, procrastinação acadêmica, sentimento de pertencimento escolar ou pensamento de ordem superior determinam causalmente o bem-estar subjetivo. Como todas as variáveis principais foram coletadas por meio do mesmo questionário autorreferido em um único momento, não é possível excluir vieses de método comum, efeitos de estilo de resposta e contexto compartilhado de mensuração26.
Este fluxo de trabalho também não substitui a validação psicométrica completa. O alfa de Cronbach, a ômega de McDonald, verificações da amplitude observada, revisão item-total e verificação de pontuação invertida são etapas úteis de controle de qualidade para um fluxo de pontuação auditável, mas não estabelecem validade fatorial, invariância de medida, propriedades de resposta dos itens ou comparabilidade entre grupos. Estudos que utilizem o questionário para testar teorias substantivas devem realizar análise fatorial confirmatória, testes de invariância de medida entre grupos demográficos ou institucionais relevantes e verificações adicionais de validade quando apropriado27. Portanto, o presente protocolo deve ser entendido como um arcabouço auditável de processamento e relato de dados, e não como um estudo completo de validação para as construções incluídas.
O fluxo de trabalho foi demonstrado em uma amostra composta por um estudante de graduação, utilizando dados de questionários autorrelatados coletados em um único momento, sem validação externa. Sua portabilidade para outras populações, disciplinas, instituições, idiomas e contextos culturais não deve ser presumida. Se o fluxo de trabalho for reutilizado em outro contexto, o mapa de escalas deve ser reconstruído em vez de copiado mecanicamente. Os pesquisadores devem revisar a procedência dos itens, o status de tradução ou adaptação, a dependência cultural e contextual dos itens de bem-estar, os pontos de resposta, as regras de inversão de pontuação, a interpretação dos escores e os requisitos éticos locais. Os procedimentos de tradução e adaptação exigem documentação explícita, em vez de alterações informais na redação28, e a interpretação de escores de testes educacionais e psicológicos deve permanecer vinculada a evidências relativas ao uso pretendido e à população específica29.
Na prática, o protocolo é mais útil como uma estrutura auditável para o processamento e relato de dados em pesquisas baseadas em questionários sobre bem-estar. Ele ajuda os pesquisadores a tornar visíveis as decisões sobre limpeza, pontuação, diagnósticos e visualização antes mesmo de iniciar a interpretação. Aplicações futuras devem testar o fluxo de trabalho em amostras independentes, diferentes contextos institucionais, delineamentos longitudinais e equipes de analistas replicadas independentemente. A validação externa, regras de decisão pré-registradas, conjuntos de dados sintéticos compartilhados, registros de triagem/pontuação exemplares concluídos e a replicação por analistas independentes fortaleceriam ainda mais a portabilidade e credibilidade do fluxo de trabalho.
Divulgações
Os autores não têm conflitos de interesse a declarar.
Agradecimentos
Os autores agradecem aos estudantes universitários que participaram da pesquisa por seu apoio durante a coleta de dados. Os autores também agradecem aos instrutores e assistentes de pesquisa envolvidos por sua ajuda na distribuição dos questionários, organização dos dados, verificação dos resultados e elaboração de tabelas e figuras. Este trabalho não recebeu financiamento específico.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| pacote R broom | CRAN | pacote R | Utilizado para converter saídas de regressão em tabelas estruturadas de coeficientes e resumos de modelos. |
| pacote R car | CRAN | pacote R | Utilizado para verificação do fator de inflação da variância e suporte ao diagnóstico de regressão. |
| documentação original das Escalas de Depressão, Ansiedade e Estresse-21 | Psychology Foundation of Australia | Lovibond e Lovibond, 1995 | Documentação original para a seção de emoção negativa. O fluxo de trabalho utilizou redação adaptada para o estudo, alinhada com avaliações recentes de estados emocionais negativos. |
| pacote R dplyr | CRAN | pacote R | Utilizado para filtragem de dados, recodificação, agrupamento, resumos do fluxo de triagem e preparação de tabelas analíticas. |
| pacote R ggplot2 | CRAN | pacote R | Utilizado para gerar o mapa de calor de correlação, o gráfico de correlação do bem-estar subjetivo, o gráfico de coeficientes de regressão e a exibição diagnóstica. |
| documentação original da medição do pensamento de ordem superior | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | Documentação original para a seção de pensamento de ordem superior. O fluxo de trabalho utilizou um conjunto de itens adaptado ao estudo, alinhado com pensamento analítico, avaliativo, reflexivo, integrativo e baseado em evidências. |
| IBM SPSS Statistics | IBM Corp. | Versão 29.0.2.0 | Utilizado para estatísticas descritivas, alfa de Cronbach’s, correlação de Pearson, testes t para amostras independentes e de Welch’s, regressão linear múltipla, estatística de Durbin-Watson, resíduos padronizados, valores de alavanca, distância de Cook’s e fatores de inflação da variância. |
| pacote R psych | CRAN | pacote R | Utilizado para resumos psicométricos, verificação do alfa de Cronbach’s e ômega de McDonald’s. |
| documentação original da Escala de Sentimento Psicológico de Pertencimento Escolar | Wiley | Psychol Sch. 1993;30(1):79-90 | Documentação original para a seção de pertencimento escolar. O fluxo de trabalho utilizou redação adaptada ao estudo, alinhada com a aceitação percebida, conexão, apoio e pertencimento no ambiente escolar. |
| ambiente estatístico R | R Foundation for Statistical Computing | Versão 4.4.2 | Utilizado para verificação analítica secundária, ômega de McDonald’s, verificações de sensibilidade de Spearman, preparação de saídas de regressão, preparação de saídas diagnósticas e preparação de fontes para visualização. |
| pacote R readxl | CRAN | pacote R | Utilizado para importar exportações de planilhas de questionários ao fluxo de trabalho de verificação no R. |
| documentação original da Escala de Bem-Estar Subjetivo para Cidadãos Chineses | Scientific & Academic Publishing | DOI: 10.5923/j.ijap.20190905.01 | Documentação original para a seção de bem-estar subjetivo. O fluxo de trabalho utilizou redação adaptada ao estudo e itens com pontuação invertida, alinhados com satisfação com a vida, sentido, apoio, progresso, insatisfação, desamparo e experiências de bem-estar relacionadas ao estresse. |
| Arquivo Suplementar 1: Estrutura do questionário e documentação das escalas | Autores | Arquivo Suplementar 1 | Fornece a estrutura do questionário aplicado, ordem dos construtos, origem das escalas, códigos dos itens, âncoras de resposta, direção de pontuação, regras de inversão de pontuação, construção da pontuação em nível de escala e informações sobre o status da documentação. |
| documentação original da Escala de Procrastinação de Tuckman | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Documentação original para a seção de procrastinação acadêmica. O fluxo de trabalho utilizou redação adaptada ao estudo, alinhada com atraso acadêmico e comportamento de adiamento de tarefas. |
| plataforma online de questionários Wenjuanxing | Changsha Ranxing Information Technology Co., Ltd. | plataforma baseada na web | Utilizada para consentimento eletrônico, programação de questionários, coleta de respostas aos itens, captura de carimbos de tempo, registro da duração da conclusão, revisão de submissões duplicadas e exportação de respostas brutas. |
Referências
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.