Este estudo apresenta um framework de colaboração ciberfísica para a Indústria 5.0 habilitado por IA Explicável, que utiliza uma CNN-transformer e SHAP para detecção de anomalias acústicas industriais no conjunto de dados MIMII. A integração com computação de borda apoia manutenção preditiva interpretável e centrada no ser humano.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Colaboração Ciber-Física Apoiada por IA Explicável para Manufatura Sustentável na Indústria 5.0
Neste artigo
Resumo
Resumo
Neste estudo, apresentamos uma abordagem inovadora para a fabricação sustentável de peças industriais utilizando um sistema colaborativo ciberfísico baseado em inteligência artificial explicável (XAI) para a Indústria 5.0. Verificou-se que os atuais sistemas ciberfísicos humanos (CPHSs) integram a IA apenas de forma limitada e frequentemente carecem de explicabilidade. Consequentemente, há uma necessidade de melhorar sua escalabilidade e flexibilidade, em conformidade com os princípios da Indústria 5.0: resiliência, viabilidade de longo prazo e centralidade humana. Para abordar essas deficiências, introduzimos uma arquitetura que integra aprendizado profundo e inteligência artificial explicável ao ecossistema do sistema ciberfísico (CPS), permitindo tomadas de decisão inteligentes e explicáveis. Especificamente, utilizamos o conjunto de dados Malfunctioning Industrial Machine Investigation and Inspection (MIMII) para detecção de falhas em máquinas a partir de sinais acústicos. Os sinais de áudio passam por uma transformação espectral para gerar imagens de espectrograma, que são então processadas por uma rede neural convolucional (CNN) para extração de características espaciais e por um codificador de transformador para características temporais. Para melhorar a transparência e facilitar a cooperação com o humano no laço, a abordagem baseada em explicações aditivas de Shapley (SHAP) ajuda os operadores a compreender o processo de tomada de decisão do sistema, destacando as características de entrada que influenciam as previsões do modelo. Além disso, a estrutura é aplicada em um sistema ciberfísico baseado em computação de borda para alcançar baixa latência e baixo consumo de energia, ao mesmo tempo que fornece respostas oportunas, contribuindo assim para garantir um ambiente de produção sustentável. Os resultados experimentais mostram que a arquitetura proposta CNN-Transformador alcança 98,5% de precisão e supera os sistemas CPHS existentes, mantendo baixa latência. O uso de inteligência artificial explicável em um sistema colaborativo ciberfísico desse tipo aumenta significativamente a confiança do operador e permite uma colaboração fluida entre homem e máquina.
Introdução
A transição do modelo da Indústria 4.0, que enfatizava tecnologia, mecanização e comunicação, para o novo modelo da Indústria 5.0, que combina avanço tecnológico com adaptabilidade, desenvolvimento sustentável e centralidade humana, influenciou a evolução dinâmica dos sistemas industriais1,2A Comissão Europeia define a Indústria 5.0 como um paradigma focado não apenas na produtividade e eficiência, mas também nos três pilares da centralidade humana, sustentabilidade e resiliência. É importante observar que pesquisas recentes destacaram o papel dos sistemas de inteligência artificial, da cooperação entre humanos e máquinas e da manufatura sustentável como os principais impulsionadores dos ambientes da Indústria 5.0.3,4. Métodos tradicionais de manutenção já não são suficientes neste ambiente industrial em evolução. Para garantir resiliência em contextos complexos e instáveis, a manutenção deve evoluir para uma forma mais adaptável e sistêmica5Desde 2011, a Indústria 4.0 tem sido o modelo dominante para a transformação industrial na Europa, incentivando a transformação digital das empresas para aprimorar operações e maximizar os recursos disponíveis.4. Aumentar a eficiência sem eliminar o trabalho humano na produção, ao mesmo tempo em que se protege a saúde e a segurança dos trabalhadores, é, portanto, imperativo. Por essa razão, empresas e acadêmicos começaram a definir os princípios do paradigma da Indústria 5.05,6,7, parcialmente motivado pela noção japonesa de Sociedade 5.08,9,10,11. Apesar do aumento do foco na manutenção sustentável na literatura recente, a maioria das avaliações sistemáticas existentes permanece fragmentada ou específica a determinado domínio, faltando um arcabouço abrangente que integre resiliência, sustentabilidade e inteligência artificial. Por exemplo, os autores examinam práticas de manutenção sustentável para sistemas ou estratégias específicas, incluindo a manutenção produtiva total sustentável (STPM), enquanto outros pesquisadores discutem a incorporação de temas de sustentabilidade nas técnicas de manutenção12,13,14. Autor realizou uma avaliação abrangente dos critérios de adoção de sustentabilidade e destacou os fatores tecnológicos que permitem à manufatura ter um impacto sustentável positivo15. No entanto, dentro do paradigma da Indústria 5.0, a sustentabilidade, a resiliência e a tomada de decisões baseada em IA não estão plenamente integradas em nenhum desses trabalhos. Como resultado, métodos de manutenção separados frequentemente abordam a sustentabilidade. O SHAP se destaca entre outras técnicas de inteligência artificial explicável (XAI) devido ao seu método teoricamente sólido de atribuição de características16,17,18.
A tomada de decisões baseada em dados é viabilizada pela IA, mas modelos precisos frequentemente exigem grandes quantidades de dados. Técnicas convencionais de aprendizado de máquina (ML), como árvores de decisão, regressão logística e regressão linear, muitas vezes apresentam desempenho insatisfatório em situações altamente não lineares, pois assumem distribuições de dados relativamente simples19. Ao aprender representações complexas de características a partir de grandes conjuntos de dados, as redes neurais profundas (DNNs) contornam essas limitações20. Estudos indicam que redes mais profundas frequentemente apresentam melhor desempenho do que estruturas rasas em tarefas complexas de tomada de decisão21, mas o aumento de sua profundidade e complexidade de parâmetros torna o modelo menos interpretável22.
Um Sistema Ciberfísico (CPS) é uma tecnologia habilitadora crucial para a manufatura da Indústria 5.0, pois combina inteligência distribuída, computadores embarcados, processos físicos e comunicação. Para viabilizar operações industriais flexíveis, inteligentes e em tempo real, os CPS modernos estão integrando rapidamente computação de borda, inteligência artificial de borda e Internet das Coisas verde (G-IoT)23,24. Sustentabilidade e resiliência têm sido destacadas em estudos recentes sobre Manutenção 4.0 e manutenção inteligente. Embora trabalhos anteriores tenham examinado a importância da tecnologia de Manutenção 4.0 na manufatura sustentável e sugerido estruturas de modelagem para manutenção sustentável, estudos bibliométricos e sistemáticos avaliaram tecnologias de manutenção inteligente25,26,27,28. Pesquisas adicionais investigaram a integração da manutenção sustentável em ambientes da Indústria 4.0 e sistemas produtivos orientados à sustentabilidade29,30,31,32. O conceito de Operador 4.033, estruturas humanocêntricas da Indústria 5.034 e perspectivas socioeconômicas35 têm atraído grande atenção para a manutenção centrada no ser humano. Além disso, avanços em manutenção digital36, manutenção preditiva e prescritiva37,38 e estratégias de manutenção sustentável39,40 foram enfatizados em estudos recentes. Apesar desses avanços, a pesquisa permanece fragmentada, e poucos estudos oferecem um paradigma coeso que integre inteligência artificial explicável, sustentabilidade, resiliência e cooperação ciberfísica centrada no ser humano. Os Sistemas Ciberfísicos (CPS) ainda não alcançaram autonomia total, apesar de sua crescente implantação, e o paradigma da Indústria 5.0 não o favorece. A Indústria 5.0, por outro lado, enfatiza mais fortemente a supervisão, cooperação e tomada de decisões humanas. Ao incorporar o pensamento e a cooperação humanos nos processos ciberfísicos, sistemas ciber-humanos, como CPS com humanos no laço (HiLCPSs)41, CPS Centrados no Ser Humano (HCPSs)42,43 e sistemas ciberfísicos humanos (CPHSs)44, estendem os CPS tradicionais. Essa integração melhora adaptabilidade, transparência, segurança e resiliência, permitindo colaboração em tempo real entre sistemas inteligentes e operadores humanos45,46.
A detecção industrial de anomalias de áudio foi grandemente aprimorada por novas arquiteturas, incluindo o Vision Transformer (ViT), o Audio Spectrogram Transformer (AST), o Conformer e o aprendizado auto-supervisionado; no entanto, sua integração com sistemas ciberfísicos explicáveis para a Indústria 5.0 permanece limitada. Sem integrar explicabilidade, implantação em borda e suporte à decisão com participação humana em um único framework, a pesquisa atual concentra-se principalmente na precisão de classificação ou na interpretabilidade baseada em XAI pós-hoc. Este estudo propõe uma nova arquitetura colaborativa ciberfísica CNN-Transformer habilitada por IA Explicável que combina computação em borda, modelagem de dependência temporal, explicabilidade baseada em SHAP, aprendizado de características espaciais e suporte à decisão centrado no ser humano, visando viabilizar uma manufatura sustentável na Indústria 5.0 e superar essas limitações.
Assim, ainda persiste um déficit substancial de pesquisa. As técnicas atuais de detecção acústica de anomalias baseadas em CNN/Transformers priorizam o desempenho de classificação, mas carecem de cooperação ciberfísica e explicabilidade. Embora as estruturas da Indústria 5.0 ofereçam modelos conceituais centrados no ser humano, elas não integram aprendizado profundo explicável, inteligência de borda e tomada de decisão assistida por operador em um único sistema; por outro lado, as técnicas de manutenção preditiva baseadas em XAI aumentam a transparência, mas operam de forma independente das arquiteturas CPHS. Portanto, ainda é inexistente um único sistema ciberfísico humano da Indústria 5.0 que integre detecção precisa de anomalias auditivas, explicabilidade baseada em SHAP, implantação habilitada para borda e cooperação com o ser humano no laço de controle.
Este artigo propõe um novo paradigma colaborativo ciberfísico baseado em IA Explicável com CNN-Transformer para a Indústria 5.0, com o objetivo de superar essas limitações. A arquitetura sugerida combina implantação em computação de borda, extração de características espaciais baseada em CNN, aprendizado de dependência temporal baseado em Transformer, explicabilidade baseada em SHAP e suporte à decisão com participação humana em um único framework CPHS. Em contraste com os métodos atuais, que tratam esses elementos de forma independente, o framework proposto oferece uma solução integrada que simultaneamente melhora o desempenho na detecção de anomalias, a transparência do modelo, a eficiência operacional e a colaboração centrada no ser humano para a manufatura sustentável.
O principal objetivo deste estudo é criar um sistema ciberfísico humano habilitado para IA Explicável (CPHS) para a manufatura sustentável da Indústria 5.0, combinando a explicabilidade baseada em SHAP, computação de borda e suporte à decisão com a participação humana, juntamente com uma abordagem híbrida de detecção de anomalias acústicas baseada em CNN-Transformer. Em particular, a estrutura proposta tem como objetivo melhorar a precisão na detecção de anomalias, fornecendo previsões claras e compreensíveis, facilitando a implantação eficiente na borda e promovendo a tomada de decisões cooperativa entre sistemas inteligentes e operadores humanos. Ao alcançar simultaneamente alto desempenho de detecção, explicabilidade, operação com baixa latência e colaboração ciberfísica centrada no ser humano, essa arquitetura integrada supera as limitações das atuais abordagens de detecção de anomalias acústicas, manutenção preditiva baseada em IA Explicável (XAI) e estruturas de CPHS.
A arquitetura proposta apresenta um sistema ciberfísico humano unificado com inteligência artificial explicável (CPHS) para a Indústria 5.0, em contraste com as técnicas atuais de detecção de anomalias acústicas, que se concentram principalmente na precisão de classificação. Em uma única arquitetura, combina extração de características espaciais baseada em CNN, modelagem temporal baseada em Transformer, explicabilidade baseada em SHAP, computação de borda e suporte à decisão com participação humana. A arquitetura proposta aborda questões-chave de transparência, assistência ao operador e cooperação ciberfísica ao integrar detecção precisa de anomalias com tomada de decisão compreensível e implantação em tempo real na borda. A principal contribuição científica deste trabalho é a integração em nível de sistema, o que diferencia a abordagem proposta das pesquisas anteriores, que se concentram isoladamente na detecção de anomalias, na inteligência artificial explicável ou em frameworks para a Indústria 5.0.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
A metodologia sugerida utiliza uma abordagem baseada em sistemas de Indústria 5.0 com sistema ciberfísico humano (CPHS) que combina aprendizado profundo explicável com um framework de colaboração ciberfísica habilitado por computação de borda, para apoiar processos de manufatura sustentáveis. Primeiro, o problema é abordado reconhecendo certas limitações das soluções atuais de CPHS, como a falta de inteligência impulsionada por IA, explicabilidade e colaboração centrada no ser humano. Para enfrentar esses desafios, a solução proposta utiliza o conjunto de dados MIMII para monitoramento de condições de máquinas industriais por meio de processamento de sinais acústicos.
O framework proposto começa alimentando os espectrogramas gerados em um modelo de CNN que extrai características espaciais ao reconhecer padrões de frequência significativos associados a diferentes condições da máquina. As características espaciais extraídas serão convertidas em sequências e fornecidas a um módulo codificador de transformador para capturar dependências temporais por meio de autoatenção. A representação de características transformada é posteriormente encaminhada a um módulo classificador totalmente conectado para classificar os estados da máquina como normais ou anormais. Além disso, para garantir transparência e facilitar a tomada de decisões centrada no ser humano, utiliza-se a abordagem de explicabilidade SHAP para explicar as previsões, selecionando regiões significativas no domínio tempo-frequência na saída do modelo. O modelo projetado será implementado em um ambiente de CPS habilitado para edge computing, permitindo inferência em tempo real com baixa latência computacional e baixo consumo energético. Adicionalmente, um esquema com participação humana será integrado para permitir que operadores humanos validem os resultados com base na explicabilidade. O desempenho é validado por meio de acurácia, precisão, revocação e pontuação F1, bem como outras métricas em nível de sistema, como latência e eficiência energética.
O framework proposto é um mecanismo CPHS orientado por XAI para a fabricação sustentável no contexto da Indústria 5.0, e seu fluxo de trabalho é apresentado como um pipeline que vai da aquisição de dados à tomada de decisões inteligentes e execução, conforme mostrado na Figura 1. Na fase inicial do procedimento de aquisição de dados, sinais sonoros são coletados de máquinas em indústrias, como motores, bombas e rolamentos, utilizando conjuntos de dados incluindo o MIMII. Os sinais de dados assim obtidos são encaminhados para a próxima etapa, denominada pré-processamento de dados, onde passam por filtragem, normalização e segmentação. Os sinais de dados segmentados são finalmente convertidos em um espectrograma utilizando a transformada de Fourier de curta duração (STFT) na camada de representação de características.
Em seguida, a camada do modelo de IA utiliza as imagens do espectrograma para extrair características por meio do módulo CNN, identificando padrões espaciais e anomalias. Então, as características extraídas são remodeladas e inseridas no codificador transformador, que aprende dependências temporais e relações de longo alcance por meio de mecanismos de autoatenção. Os vetores de características resultantes são classificados como normais ou anormais utilizando a camada de classificação. Para garantir transparência no processo de predição, a camada de explicabilidade utiliza o SHAP para destacar regiões significativas no domínio tempo-frequência do espectrograma.
Além disso, há um processo com intervenção humana no qual operadores interpretam e fornecem feedback sobre os resultados do modelo. Na camada de implantação, o modelo é executado em uma infraestrutura CPHS baseada em edge, garantindo inferência rápida e baixo consumo de energia, podendo opcionalmente se integrar a sistemas em nuvem para requisitos de armazenamento ou análises avançadas. Em conjunto, a estrutura garante detecção precisa de falhas, explicabilidade e operação eficiente em tempo real, em conformidade com os requisitos da Indústria 5.0.
Definição do problema e análise de requisitos
Sistemas ciberfísicos humanos (CPHS) em ambientes da Indústria 5.0 prometem inteligência, sustentabilidade e centralidade humana. No entanto, as estruturas contemporâneas para construção de CPHS são prejudicadas pela falta de capacidades avançadas habilitadas por IA, explicabilidade e suporte adequado à colaboração entre humanos e máquinas. De fato, os CPHS convencionais baseiam-se em modelos baseados em regras ou não interpretáveis, o que dificulta a adaptação a condições industriais em mudança e limita a confiança dos operadores na automação. Além disso, os CPHS convencionais não conseguem analisar eficazmente dados altamente sofisticados, como sinais acústicos industriais que contêm componentes espaciais (ou seja, frequência) e dependentes do tempo, os quais são importantes para a manutenção preditiva. Portanto, é necessário criar uma estrutura capaz de detectar anomalias em máquinas com alta precisão, fornecer explicações e operar na borda (edge), permitindo assim os sistemas ciberfísicos.
Aqui, x(t) é o sinal acústico de entrada, S(f,t) é a representação do espectrograma do sinal,  é o rótulo e θ é o conjunto de parâmetros da arquitetura CNN-Transformer. Os símbolos utilizados nas equações subsequentes são introduzidos logo após sua primeira aparição, a fim de preservar a correção matemática.
Do ponto de vista matemático, a tarefa pode ser formalizada como um problema de aprendizado supervisionado. Seja o sinal acústico industrial denotado por x(t). A TFCT de x(t) é calculada de acordo com a fórmula:
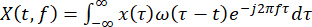 (1)
em que ω(.) é a função janela e f é a frequência. O espectrograma gerado 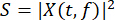 serve como entrada para o algoritmo de aprendizado profundo. O objetivo é treinar a função de mapeamento
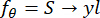 (2)
onde é o rótulo da classe (normal ou anormal), e onde S é a entrada do espectrograma, y é o rótulo de saída previsto e θ é o conjunto de parâmetros ajustáveis da arquitetura CNN-Transformer. O problema de otimização é formulado como a minimização da perda de classificação:
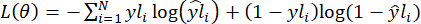 (3)
sujeito às restrições de latência mínima  , eficiência energética
 e interpretabilidade, na qual a explicação ∅(SHAP) captura a importância das características no processo de predição,
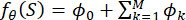 (4)
em que  é a contribuição de cada característica individual. De acordo com o exposto anteriormente, os requisitos de projeto incluem os seguintes: (i) detecção confiável de anomalias com base em aprendizado profundo híbrido, (ii) saídas interpretáveis para intervenção humana e (iii) implementação em uma estrutura de CPS com suporte a borda.
Aquisição e pré-processamento do conjunto de dados
A esse respeito, para avaliar o framework CPHS baseado em IA Explicável proposto, o conjunto de dados MIMII13 foi selecionado. Esse conjunto de dados é um benchmark amplamente utilizado para detecção de anomalias em máquinas industriais por meio de sinais acústicos. Esta base de dados contém gravações sonoras de várias máquinas, como trilhos deslizantes, ventiladores, bombas e válvulas, em condições normais e com falhas operacionais. Para cada máquina, as gravações variam conforme diferentes configurações e ambientes de ruído. Isso o torna adequado para treinar e avaliar modelos em condições industriais em tempo real.
Embora o conjunto de dados MIMII seja amplamente utilizado em estudos de detecção não supervisionada de anomalias que dependem exclusivamente de amostras normais durante o treinamento, ele inclui anotações explícitas de estados normais e anômalos da máquina. O problema é formulado como uma tarefa supervisionada de classificação binária para testar a capacidade da arquitetura proposta de CNN-Transformer baseada em IA Explicável de separar estados saudáveis dos estados com falhas. Especificamente, utilizam-se as etiquetas oficiais do MIMII, atribuindo o rótulo de classe 0 às amostras normais e o rótulo de classe 1 às amostras anômalas.
Tabela 1 mostra os detalhes da descrição do conjunto de dados. Aproximadamente 12.000 gravações de sinais acústicos são consideradas na presente pesquisa, incluindo operações de máquinas normais e com falhas. Conforme os requisitos, todas as gravações neste estudo foram capturadas a 16 kHz e têm duração de 10 s. Embora o conjunto de dados contenha aproximadamente 12.000 gravações, um subconjunto balanceado por classes de 2.000 gravações de teste foi selecionado exclusivamente para visualizar a matriz de confusão. Todas as métricas de desempenho relatadas foram calculadas utilizando o conjunto de teste completo (aproximadamente 2.400 gravações). Além disso, as amostras de treinamento e teste são separadas na proporção de 80:20 para o treinamento do modelo. Este banco de dados é muito adequado para aplicações da Indústria 5.0, pois inclui condições de ruído em tempo real. A distribuição das gravações utilizada neste estudo é apresentada na Tabela 2. A partir deste conjunto de dados, aproximadamente 12.000 gravações cobrindo todos os tipos de máquinas e condições de razão sinal-ruído (SNR) foram selecionadas para os experimentos de classificação binária supervisionada, utilizando uma divisão treino/teste de 80:20, mostrando os tipos de máquinas industriais, IDs correspondentes das máquinas, números totais de gravações acústicas normais e anômalas, condições de SNR e a partição treino/teste empregada para a classificação binária supervisionada.
O experimento foi realizado utilizando o conjunto de dados MIMII (Malfunctioning Industrial Machine Investigation and Inspection), versão 1.0, que compreende quatro tipos de máquinas industriais: ventiladores, bombas, válvulas e trilhos deslizantes. Os dados foram coletados a partir de diferentes IDs de máquinas (ID00–ID06, dependendo do tipo de máquina) e condições. O banco de dados MIMII contém dados adquiridos em razões sinal-ruído (SNRs) de −6 dB, 0 dB e +6 dB. Os dados normais correspondem ao estado saudável da máquina industrial, enquanto os dados anômalos correspondem a uma condição anômala. As classes foram rotuladas com base na anotação do banco de dados, sendo os dados normais rotulados como classe 0 e os dados anômalos rotulados como classe 1.
Um procedimento de avaliação justo exigia que a divisão entre conjuntos de treinamento e teste ocorresse no nível da gravação de áudio original, anterior a qualquer divisão, aumento ou criação de espectrogramas. Como resultado, segmentos de áudio da mesma gravação não podiam aparecer tanto no conjunto de treinamento quanto no de teste. Para o experimento de avaliação, foram utilizadas gravações com diferentes razões sinal-ruído (−6 dB, 0 dB e +6 dB), o que proporcionou a oportunidade de avaliar o framework proposto sob diversas condições industriais.
Para evitar vazamento de dados, a divisão entre treinamento e teste foi realizada utilizando o arquivo de áudio original como base, antes de qualquer segmentação ou geração de espectrogramas. Segmentos provenientes da mesma gravação de áudio de 10 s foram atribuídos exclusivamente ao conjunto de treinamento ou ao conjunto de teste, sem que houvesse segmentos presentes em ambos os conjuntos. Posteriormente, os espectrogramas foram gerados e aumentados separadamente para cada conjunto de dados. Dessa forma, evita-se o problema do vazamento de dados, impedindo uma avaliação excessivamente otimista do desempenho.
Pré-processamento do conjunto de dados
Os sinais acústicos não processados do conjunto de dados MIMII são então processados para melhorar a qualidade do sinal e permitir uma extração eficaz de características. O sinal de entrada é denotado por x(t), onde t é o tempo. O primeiro processo é a filtragem de ruído, em que ruídos de fundo são filtrados usando uma função de filtragem tal que:
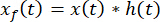 (5)
em que ∗ representa o processo de convolução e h(t) é a resposta ao impulso do filtro. Esse processo melhora a clareza do sinal acústico e minimiza os efeitos de ruído frequentemente prevalentes em ambientes industriais. A normalização do sinal é utilizada para garantir que as amplitudes de todos os sinais de áudio sejam comparáveis antes de serem inseridos no modelo de aprendizado profundo. O sinal normalizado, denotado como xn(t), é calculado da seguinte forma:
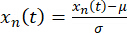 (6)
onde μ e σ são, respectivamente, o valor médio e o desvio padrão do sinal de entrada. Todos os sinais de entrada têm médias nulas e variâncias unitárias garantidas graças a este procedimento. Finalmente, para o processamento, o sinal de entrada normalizado é dividido em vários pedaços pequenos. Considerando que o comprimento do sinal inteiro é T, ele é dividido em N quadros sobrepostos, cada um com comprimento L, utilizando uma função de janela deslizante:
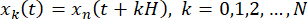 (7)
em que H é o tamanho do salto. O espectrograma pode ser definido pela fórmula abaixo:
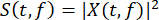 (8)
Os espectrogramas obtidos dessa maneira são inseridos no framework baseado em CNN-transformer para extrair características espaciais e temporais para detecção bem-sucedida de anomalias. Figura 2 mostra o pipeline de pré-processamento.
Figura 2 ilustra um pipeline de pré-processamento vertical que pode ser empregado para dados acústicos adquiridos na indústria. Primeiramente, os sinais de áudio brutos são extraídos do conjunto de dados MIMII e encaminhados para a etapa de remoção de ruído, a fim de reduzir o ruído. Em seguida, o sinal é normalizado para eliminar inconsistências de amplitude, garantindo que o sinal seja consistente. Posteriormente, o sinal é dividido em seções menores com sobreposição. Após a segmentação, serão aplicadas transformadas STFT aos dados para converter sinais no domínio do tempo em sinais no domínio tempo-frequência. Então, o espectro de potência é calculado como parte da geração do espectrograma do sinal. Os espectrogramas pré-processados serão, portanto, a saída gerada no processo e serão utilizados no modelo proposto de CNN-transformer.
Geração de espectrograma
Após a normalização e segmentação dos dados, os sinais acústicos são convertidos em uma representação no domínio tempo-frequência utilizando a Transformada de Fourier de Curta Duração (STFT). O espectrograma resultante fornece uma representação pictórica das alterações na composição de frequência ao longo do período de análise. Em ambientes industriais, falhas em máquinas geralmente se manifestam como padrões de frequência, tornando os espectrogramas mais úteis para a detecção de anomalias em máquinas.
Os dados processados resultantes são, portanto, convertidos em imagens de espectrogramas para distinguir entre instâncias normais e anormais dentro das máquinas. Os dados de áudio serão convertidos em múltiplos espectrogramas para permitir que o modelo de aprendizado analise componentes de frequência locais e mudanças temporais no processo da máquina. Essas imagens são usadas como dados de entrada para o modelo CNN-transformer, no qual a CNN lida com padrões espaciais (de frequência), enquanto os Transformadores lidam com relações temporais.
Algoritmo 1: Geração de Espectrograma a Partir de Sinais Acústicos
Entrada: sinal de áudio bruto x(t)
Saída: Espectrograma S(t, f)
Passo 1: Carregar o sinal de áudio x(t)
Passo 2: Aplicar filtragem de ruído
Passo 3: Normalizar o sinal xn(t)
Passo 4: Segmentar o sinal em quadros:
para k = 1 a N faça
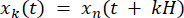
fim para
Passo 5: Aplique uma função de janela w(t) a cada segmento
Passo 6: Calcular a TFST:
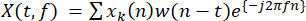 (9)
Passo 7: Calcular a magnitude:
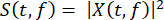 (10)
Passo 8: Armazenar o espectrograma S(t, f)
Passo 9: Retornar o conjunto de dados do espectrograma
O processo de geração de espectrogramas começa com a aquisição do sinal de áudio original, seguido por etapas de pré-processamento, como redução de ruído e normalização do sinal, para garantir a integridade e a qualidade do sinal. Em seguida, o áudio normalizado é dividido em várias janelas sobrepostas para capturar as características temporais de períodos longos e curtos. Para evitar vazamento espectral, cada segmento é multiplicado pela função de janela antes de ser submetido à Transformada de Fourier de Curto Prazo. Posteriormente, o sinal transformado é representado como uma função de valor complexo no domínio da frequência, e suas magnitudes são elevadas ao quadrado. Assim, a energia das frequências ao longo do tempo dado é representada pelos espectrogramas. Por fim, eles são armazenados como dados semelhantes a imagens e fornecidos à rede neural para treinamento.
Extração de características espaciais usando CNN
Após o processo de criação de espectrogramas, as imagens tempo-frequência resultantes são utilizadas como entradas e fornecidas a uma rede neural convolucional (CNN). Considerando o espectrograma de entrada como  , onde H é o domínio da frequência e W é o domínio do tempo. O objetivo de utilizar a CNN aqui é aprender características espaciais discriminativas a partir do espectrograma de entrada. Essas características espaciais discriminativas ajudarão a diferenciar o comportamento normal do anormal de máquinas em um ambiente industrial.
Uma operação básica realizada pela rede neural convolucional (CNN) é a convolução. A convolução com um filtro dado  é dada por:
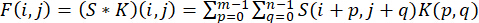 (11)
A operação descrita acima permite que a rede neural identifique características espaciais locais, como bordas, frequências e conteúdo harmônico, no espectrograma. Isso é feito por meio de múltiplas operações de filtragem que geram diversas representações de características, produzindo vários mapas de características. A convolução é seguida por uma função de ativação não linear, conforme mostrado abaixo:
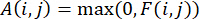 (12)
Essa não linearidade permite que a rede capture e represente relações complexas entre variáveis. A próxima etapa em uma rede neural convolucional envolve a aplicação de operações de agrupamento. A técnica comum de agrupamento máximo é expressa matematicamente da seguinte forma:
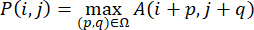 (13)
em que Ω refere-se à janela de agrupamento. O agrupamento ajuda a alcançar invariância à translação e a reter apenas as informações relevantes, descartando redundâncias. Desde variáveis de baixo nível, como frequências, até comportamentos complexos da máquina, características de alto nível podem ser extraídas de forma hierárquica usando uma rede neural convolucional. Consequentemente, os mapas de características podem ser usados para representar a saída final da rede:
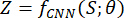 (14)
onde representa os parâmetros ajustáveis da CNN. Os mapas de características contêm informações espaciais ricas e são transformados em sequências para servir como entradas para o codificador do transformador na próxima fase. O processo de extração de características espaciais descrito acima é crucial para permitir que o modelo detecte anomalias mínimas em sinais acústicos industriais.
Figura 3 demonstra como características espaciais são extraídas horizontalmente a partir da entrada do espectrograma usando um modelo de CNN. O processo inicia com o espectrograma de entrada, que codifica as propriedades de tempo-frequência do sinal de áudio em forma pictórica. O espectrograma de entrada é então submetido a uma camada convolucional, na qual diversos tipos de filtros extraem características espaciais, como bandas de frequência, bordas e texturas, gerando assim mapas de características. Em seguida, os mapas de características extraídos passam por uma função de ativação não linear, a unidade linear retificada (ReLU), permitindo que a rede neural detecte dependências nos dados de entrada. Os mapas de características são então encaminhados a uma camada de agrupamento (pooling), onde o tamanho do mapa é reduzido, mantendo-se suas características mais importantes. Esse processo de camadas convolucionais, de ativação e de agrupamento se repete várias vezes, criando uma hierarquia de representação de características que começa com características simples e evolui para outras mais sofisticadas relacionadas às operações da máquina.
Modelagem temporal usando um codificador transformer
Uma vez que as características espaciais foram extraídas usando a CNN, o próximo passo é derivar mapas de características de alto nível que capturem padrões baseados em frequência aprendidos a partir do espectrograma. Os mapas de características resultantes são então aplanados e reformatados em sequências para capturar a informação temporal no sinal acústico. Assumindo que os mapas de características sejam representados por 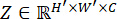 , onde H', W' e C são altura, largura e canais, respectivamente, a seguinte sequência é derivada:
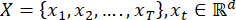 (15)
em que T representa o comprimento da sequência e d é a dimensão da característica. O Transformer utiliza então a sequência acima para modelar dependências de longo prazo por meio de um mecanismo de autoatenção. Diferentemente dos modelos recorrentes convencionais, o modelo Transformer processa cada elemento da sequência em paralelo e utiliza pesos de atenção para determinar a relevância relativa de cada parte. O funcionamento do mecanismo de atenção se dá por meio dos vetores Consulta Q, Chave K e Valor V gerados para cada entrada xt de acordo com:
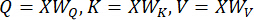 (16)
onde WQ, WK, WV são pesos treináveis. As semelhanças entre os elementos são determinadas por meio de:
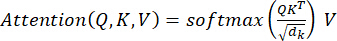 (17)
dk é a dimensão importante dos vetores. Este procedimento facilita a aprendizagem pelo modelo de dependências de etapas temporais distantes no sinal e permite concentrar-se apenas nos segmentos temporais pertinentes. Para aumentar a capacidade de aprendizagem da rede, utiliza-se a atenção multihead, que se refere ao processo em que várias cabeças de atenção aprendem a partir da entrada em paralelo:
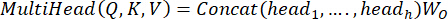 (18)
Cada cabeça atenta para características distintas da sequência de entrada temporal. Isso é seguido por redes neurais feed-forward e conexões residuais:
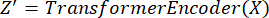 (19)
A sequência codificada resultante captura tanto as características espaciais quanto temporais da entrada. Essa sequência é enviada à camada classificadora para detectar anomalias.
Figura 4 mostra o processo geral de modelagem temporal utilizando um codificador Transformer sobre características extraídas da CNN. Primeiro, são utilizados os mapas de características extraídos da CNN, que contêm informações espaciais do espectrograma. Os mapas de características são aplainados em uma sequência, sendo que cada item corresponde a um instante no tempo. Em seguida, a sequência passa por uma transformação linear que mapeia os dados em vetores de uma dimensão específica. Como os modelos Transformer não possuem capacidade inerente de capturar dependências temporais, uma codificação posicional também é adicionada aos vetores de incorporação para preservar a estrutura temporal da sequência. Por fim, a sequência passa por um codificador Transformer, composto por uma pilha de múltiplas camadas, nas quais um mecanismo de autoatenção com múltiplos cabeçotes é empregado para permitir que o modelo aprenda as conexões entre os instantes no tempo da sequência. A rede neural de alimentação direta aprimora ainda mais essas incorporações, enquanto conexões residuais garantem que os gradientes se propaguem de forma eficiente. O processo é repetido ao longo das camadas empilhadas do codificador Transformer, que capturam interações temporais progressivamente mais complexas. No final, as incorporações da sequência são combinadas em uma representação de comprimento fixo por meio de agrupamento (por exemplo, agrupamento médio ou o token de classificação (CLS)), gerando uma representação global de características temporais.
Camada de classificação
Após a codificação temporal com o codificador Transformer, as saídas serão uma sequência de vetores codificados, cada um com características relacionadas aos aspectos espaciais e temporais do sinal de entrada. O primeiro passo rumo à classificação a partir das saídas codificadas é agregar todas essas características em um único vetor. Isso é alcançado aplicando-se um agrupamento médio (mean pooling) à sequência de vetores de características ou empregando o chamado "token de classificação". Suponha que a saída do Transformer seja 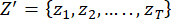 , onde cada
 . A característica agregada h é calculada como:
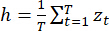 (20)
Em seguida, o vetor de características agregado h representa a entrada de forma compacta e serve como entrada para o classificador. A parte de classificação compreende uma ou mais camadas densas, que transformam a representação aprendida no espaço de saída. Uma camada densa implementa uma transformação definida da seguinte forma:
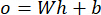 (21)
em que o é a saída (logits), b é o vetor de viés e W é a matriz de pesos. Estes últimos são as pontuações das classes em uma forma não normalizada. Para incorporar não linearidade ao modelo, funções de ativação como a ReLU são frequentemente utilizadas. Por fim, uma função de ativação softmax é aplicada aos logits para obter uma probabilidade para cada classe:
 (22)
em que C representa o número de classes, (C = 2; normal e anormal). A predição da classe será baseada no valor máximo de probabilidade. Durante o treinamento, os valores ótimos dos parâmetros do modelo são obtidos pela minimização da perda de entropia cruzada entre os rótulos reais e os preditos, alcançando assim uma classificação precisa dos estados da máquina. Em resumo, a camada de classificação desempenha uma função essencial na transformação das características temporais extraídas pela arquitetura Transformer em decisões práticas. Por meio da discriminação adequada entre estados saudáveis e defeituosos da máquina, a detecção de anomalias e a tomada inteligente de decisões tornam-se possíveis dentro do paradigma da Indústria 5.0.
Figura 5 mostra como funciona a camada de classificação, que vem após o Codificador Transformer. O processo começa com a saída da sequência codificada, na qual cada vetor contém informações temporais aprendidas a partir da entrada. Esses vetores são combinados em um único vetor, conhecido como vetor de características globais. O próximo passo é passar o vetor de características globais por várias camadas densas de rede neural. Em cada camada densa, são realizadas operações de multiplicação matricial para criar combinações lineares das entradas. Depois disso, pode-se aplicar uma função de ativação não linear, como a ReLU, para aumentar a flexibilidade na aprendizagem dos limites de decisão. Ao final da última camada densa, existem pontuações logit para cada classe. Essas pontuações logit podem ser usadas na função Softmax para calcular as pontuações de probabilidade para cada classe. Essas pontuações de probabilidade são utilizadas para determinar se a entrada pertence à Classe 0 (Normal) ou à Classe 1 (Anormal).
Explicabilidade usando SHAP
Após o modelo classificar os sinais de entrada, são geradas previsões com base em se a máquina opera normalmente ou de forma anormal. No entanto, no ambiente da Indústria 5.0, não basta produzir previsões; o sistema também deve fornecer transparência e explicabilidade para apoiar a tomada de decisões humanas. O seguinte framework utiliza o SHAP, um modelo baseado na teoria dos jogos que quantifica a importância de cada característica na determinação da previsão. Ao fazê-lo, o SHAP atribui pesos às características, permitindo avaliar a importância relativa de diferentes seções da entrada do espectrograma na previsão geral.
A formulação matemática do SHAP baseia-se em uma decomposição do modelo f(x):
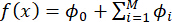 (23)
em que ∅0 é o valor de referência (saída média do modelo), ∅i é o efeito da i-ésima característica e M é o número de características de entrada. Para os fins deste estudo, as características são os compartimentos tempo-frequência do espectrograma. Os valores SHAP são positivos se contribuírem para a probabilidade do estado anormal e negativos caso contrário. Essa formulação garante uma explicação única e localmente consistente para cada previsão. O método SHAP pode ser aplicado a um modelo treinado de CNN-transformer para fornecer uma explicação com base na importância das características. A representação visual mostrará os compartimentos tempo-frequência mais importantes no espectrograma que afetam o processo de tomada de decisão. Por exemplo, o comportamento anormal do equipamento pode resultar em certas bandas de frequência de alta energia que o framework SHAP identifica como contribuintes importantes para o processo decisório.
Além disso, o SHAP pode fomentar a cooperação entre pessoas e máquinas em um ambiente ciberfísico. Isso ocorre porque as previsões podem ser explicadas por meio de representações visuais intuitivas, permitindo que os operadores e os sistemas de tomada de decisão verifiquem as previsões, analisem o problema e tomem as medidas apropriadas. Isso não apenas aumenta a confiança, mas também torna os processos de manufatura baseados em IA confiáveis e responsáveis. Ao integrar algoritmos de aprendizado profundo que atendem aos padrões de desempenho atuais com o SHAP, que fornece explicabilidade, a arquitetura proposta atende aos requisitos da Indústria 5.0.
Algoritmo 2: Explicabilidade baseada em SHAP para Previsão do Modelo
Entrada: modelo treinado f(x), espectrograma de entrada S
Saída: valores SHAP  e mapa de explicação
Passo 1: Insira o espectrograma S em um modelo treinado
Passo 2: Calcular a previsão: y = f(S)
Passo 3: Inicializar um explicador SHAP orientado ao aprendizado profundo
Passo 4: Calcular os valores SHAP:
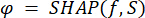
Passo 5: Para cada característica i em S:
Calcular a contribuição 
Passo 6: Gerar mapa de explicação:
Destaque as regiões com alta 
Passo 7: Visualizar a importância das características (mapa de calor)
Passo 8: Retornar os valores SHAP e o mapa de explicação
O algoritmo de explicabilidade baseado em SHAP inicia obtendo uma imagem de espectrograma pré-processada como entrada e a alimenta na arquitetura treinada de CNN-transformer para fazer previsões (por exemplo, condição normal ou anormal da máquina). Após realizar as previsões usando a arquitetura treinada, o método SHAP é utilizado para interpretar o modelo. Em particular, os valores SHAP (ϕ) são calculados para cada característica de entrada, a fim de identificar quais componentes tempo-frequência da entrada contribuem mais para a previsão. Para calcular esses valores, é necessário comparar as saídas do modelo para entradas com e sem determinadas características.
Após calcular os valores SHAP para cada característica, sua influência na previsão pode ser avaliada pelo sinal e magnitude do valor SHAP. Por exemplo, características com valores SHAP mais altos têm maior probabilidade de influenciar o resultado, e um sinal positivo ou negativo indica que a característica direciona a previsão para a classe normal/anormal, respectivamente. Com base nos resultados, pode-se criar um mapa de explicação na forma de um mapa de calor.
Por fim, o algoritmo gera tanto os valores SHAP quanto as visualizações, fornecendo uma compreensão de como os humanos podem analisar a decisão do modelo. A técnica torna o processo mais transparente e permite que os humanos participem da tomada de decisões, assegurando assim que tanto as previsões do algoritmo quanto sua confiabilidade sejam alcançadas na indústria orientada por IA. Amostras de teste representativas foram selecionadas a partir de instâncias anômalas corretamente diagnosticadas em diversos tipos de máquinas, a fim de melhorar a confiabilidade da análise de explicabilidade. Enquanto a análise global de importância de características SHAP foi realizada por meio da agregação dos valores SHAP ao longo do conjunto de dados de teste para identificar localizações tempo-frequência consistentemente influentes, explicações SHAP locais foram geradas para esses casos representativos. Sem necessidade de anotação por especialistas, essa análise integrada local e global oferece uma interpretação confiável das previsões do modelo.
Integração de CPS habilitada para borda
Esta solução proposta é utilizada dentro do CPS habilitado para edge, que tem como objetivo alcançar eficiência, sustentabilidade e operações industriais em tempo real. Uma vez que o modelo tenha sido treinado, a CNN-transformer será implantada por meio de uma abordagem de computação em edge. A camada de computação em edge em questão está próxima aos dispositivos da Internet Industrial das Coisas (IIoT), incluindo sensores e máquinas. Em vez de transmitir todos os dados coletados para a nuvem, o dispositivo de edge realiza inferência sobre o sinal acústico recebido sem antes transferi-lo para lá. Assim, o sistema pode detectar anomalias nas máquinas quase instantaneamente e tomar as medidas necessárias antes que a situação piore ainda mais. Outra vantagem dessa abordagem habilitada para edge é a melhoria na latência e eficiência, já que os dados são analisados próximo ao ponto de geração. Em outras palavras, diferentemente da abordagem em nuvem, onde o tempo de inferência Tinf
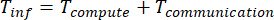 (24)
A latência, em geral, será consideravelmente reduzida por meio da diminuição de Tcommunication. Outro benefício é a redução do consumo de largura de banda e da energia gasta ao transmitir dados continuamente. Portanto, este sistema é escalável e sustentável para grandes instalações industriais com inúmeros dispositivos conectados. Além disso, o CPS permite a interação com a camada física (máquinas), a IA (camada computacional) e a camada humana.
Colaboração com participação humana
Um componente fundamental do CPS proposto para a Indústria 5.0, que inclui operadores humanos ativamente envolvidos no processo de tomada de decisão ao lado de modelos de IA, é a colaboração com o ser humano no laço. Ou seja, de acordo com a estrutura projetada, o sistema não se torna uma caixa preta autônoma, mas permite que os operadores interajam com ele e observem resultados de previsões explicáveis na forma de explicações SHAP. As previsões em questão referem-se aos resultados (normais/anormais), acompanhados por visualizações de partes dos espectrogramas utilizados para obtê-los.
Essa interação ajuda os operadores a compreenderem melhor como a previsão é formada e quais fatores contribuem para ela. A participação humana implica verificar os resultados do sistema e permitir que os operadores os anulem quando necessário, com base em seu julgamento profissional. A colaboração com operadores humanos torna o sistema mais confiável, eficiente, seguro e confiável, ajudando a prevenir erros.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
O sistema de colaboração ciberfísica integrado com inteligência artificial explicável apresentado foi testado experimentalmente em aproximadamente 12.000 gravações de áudio do Conjunto de Dados MIMII, que contém condições normais e anormais de máquinas. O conjunto de dados de treinamento consistiu em cerca de 9.600 registros, enquanto o conjunto de dados de teste incluiu aproximadamente 2.400 amostras de áudio. Com base nos resultados, o modelo proposto de CNN-transformer alcançou uma precisão de classificação de 98,5% n...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Os resultados experimentais demonstram que a arquitetura proposta de CNN-transformer supera algoritmos individuais ao integrar efetivamente a aprendizagem de características espaciais e temporais. De acordo com o estudo de ablação, embora a CNN extraia características discriminativas baseadas em frequência de espectrogramas, o codificador transformer melhora o desempenho do modelo ao capturar dependências temporais de longo alcance em sinais acústicos. Além disso, a matriz de confusão mostra poucos falsos negativos, indi...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Uma ferramenta de IA (ChatGPT) foi utilizada apenas para auxiliar na edição da linguagem e na melhoria da gramática, clareza e legibilidade. As ferramentas de IA não foram usadas para gerar dados científicos, realizar experimentos, analisar resultados, interpretar achados ou tirar conclusões científicas. Todo o conteúdo científico, análise de dados, interpretação e a versão final do manuscrito foram revisados, verificados e aprovados independentemente pelos autores, que assumem total responsabilidade pela precisão e integridade do trabalho. Os autores não têm conflitos de interesse a declarar.
Agradecimentos
FINANCIAMENTO: Este trabalho foi apoiado pelo Projeto-Chave sobre Reforma do Ensino Superior na Província de Shaanxi (Projeto nº 23BG053); pela Fundação de Pesquisa Científica para Talentos de Alto Nível da Universidade Politécnica de Shaanxi (Projeto nº BSJ-2023-08); e pelo Projeto de Pesquisa Científica da Universidade Politécnica de Shaanxi (Projeto nº 2024YKYB-006). Os autores agradecem sinceramente à Universidade Politécnica de Shaanxi, Xianyang, China, e à Universidade de Engenharia de Tráfego de Xi’an, Xi’an, China, pelo fornecimento de instalações e apoio institucional que permitiram esta pesquisa.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Escala de Apoio Social | Escala acadêmica publicada; originalmente desenvolvida por Park e revisada/complementada por Kim | versão de 25 itens; formato de resposta em escala Likert de 5 pontos; sem número de catálogo comercial | Avalia o apoio social percebido entre professores em formação na área da educação infantil, nas dimensões Apoio Emocional, Apoio Informacional, Apoio Material e Apoio Avaliativo. Coeficiente geral de Cronbach’s alfa = 0,96. |
| Escala de Autoeficácia do Professor | Escala acadêmica publicada; originalmente desenvolvida por Enochs e Riggs; versão adaptada para o chinês para estudo | versão de 25 itens; formato de resposta em escala Likert de 5 pontos; sem número de catálogo comercial | Avalia a eficácia docente no contexto chinês da formação inicial em educação infantil, nas dimensões Eficácia Geral do Professor e Eficácia Pessoal do Professor. Coeficiente geral de Cronbach’s alfa = 0,96. |
| Escala de Interação Professor-Criança | Escala acadêmica publicada; desenvolvida por Lee e revisada pelo painel de especialistas do estudo para uso na China | versão de 30 itens; formato de resposta em escala Likert de 5 pontos; sem número de catálogo comercial | Avalia a competência autorrelatada na interação professor-aluno, e não a qualidade observada da interação em sala de aula. Inclui Interação Emocional, Interação Verbal e Interação Comportamental; alfa de Cronbach geral’s alfa = 0,94. |
| Formulário de Informações Demográficas | Equipe de pesquisa, colaboração entre a Universidade de Artes e Ciências de Sichuan e a Universidade de Daegu | Seção personalizada do questionário do estudo; sem número de catálogo comercial | Coletou-se as características dos participantes, incluindo gênero, nível educacional, categoria profissional, local do estágio, duração do estágio, tipo de estágio e tipo de creche. |
| Informações ao Participante e Termo de Consentimento Informado | Equipe de pesquisa; aprovado pelo Comitê de Ética em Pesquisa da Universidade de Daegu | Número de aprovação ética: XXX; documento de aprovação local para verificação | Utilizado antes da distribuição do questionário para explicar o objetivo do estudo e o conteúdo da pesquisa, bem como obter o consentimento informado dos participantes professores em formação na área da educação infantil. |
| Pacote de Questionário de Pesquisa Piloto | Equipe de pesquisa e painel de especialistas | Versão piloto utilizada em junho de 1–5, 2024; sem número de catálogo comercial | Testou-se com um grupo-piloto a clareza e adequação da Escala de Percepções Profissionais, Escala de Apoio Social, Escala de Autoeficácia Docente, Escala de Interação Professor-Criança e dos itens demográficos em 50 futuros professores de educação infantil. |
| Procedimento de Revisão por Painel de Especialistas | Equipe de pesquisa; painel de especialistas composto por dois professores de educação infantil, um diretor de pré-escola, três supervisores de estágio e a equipe de pesquisa | Revisão de conteúdo baseada em consenso; sem número de modelo comercial | Utilizado para revisar os itens da escala quanto à ambiguidade, adequação, clareza semântica, adequação ao desenvolvimento e relevância cultural antes da aplicação formal da pesquisa. |
| Formulários Impressos de Questionário no Local | Equipe de pesquisa; materiais para pesquisa institucional local | Formulários de pesquisa em papel; sem número de catálogo comercial | Utilizado para a aplicação de questionários no local. Na amostra final, foram obtidos 336 questionários válidos no local antes da combinação com os questionários online. |
| Tencent | Aplicativo móvel WeChat; a versão deve ser verificada a partir do registro do dispositivo/aplicativo utilizado durante o mês de junho–Julho de 2024 | Utilizado como canal de distribuição online para a aplicação de questionários; 27 questionários preenchidos foram coletados por meio da via online/WeChat. | |
| Procedimento de Recrutamento por Telefone e Presencial | Equipe de pesquisa | Procedimento padronizado de recrutamento; sem número de catálogo comercial | Utilizado para entrar em contato com instituições/ participantes, explicar o objetivo do estudo e o conteúdo da pesquisa, e apoiar o consentimento informado antes da aplicação do questionário. |
| SPSS Statistics | IBM | Versão 27.0 | Utilizado para estatísticas descritivas, coeficientes de correlação de Pearson, alfa de Cronbach’análise de confiabilidade alfa de s, verificações de normalidade utilizando assimetria e curtose, e Harman’um teste de fator único para viés de método comum. |
| SPSS Amos | IBM | Versão 26.0 | Utilizado para análise fatorial confirmatória, modelagem de equações estruturais, teste de invariância de mensuração multigrupo, teste bootstrap de efeitos indiretos e comparações de modelos alternativos. |
| Microsoft Excel | Microsoft | Microsoft 365 Excel ou versão do Excel instalada localmente; verifique a versão local exata antes do envio | Recomendado/utilizado como ambiente de trabalho para organizar dados codificados de pesquisas, dicionário de dados, tabelas suplementares e a Tabela de Materiais do JoVE. A versão local exata deve ser verificada pelos autores. |
| Critérios de Índices de Ajuste em Modelagem por Equações Estruturais | Orientações metodológicas publicadas; referências de Schreiber et al. e Kline citadas no manuscrito | Sem número de catálogo comercial; critérios aplicados no plano de análise estatística | Define e relata índices de ajuste do modelo, incluindo estatística qui-quadrado, qui-quadrado dividido pelos graus de liberdade, Índice de Tucker-Lewis, Índice de Ajuste Comparativo, Índice de Ajuste da Bondade Ajustado, Índice de Ajuste Incremental, Raiz do Erro Quadrático Médio de Aproximação e Resíduo Padronizado da Raiz do Quadrado Médio. |
| Procedimento de Teste de Mediação com Reamostragem Bootstrap | SPSS Amos / plano de análise estatística da equipe de pesquisa | 5.000 amostras bootstrap; intervalos de confiança corrigidos para viés de 95% | Utilizado para testar associações indiretas por meio da eficácia do professor. Os efeitos indiretos foram considerados significativos quando o intervalo de confiança corrigido para viés de 95% não incluía o valor zero. |
| Procedimento de Teste de Invariância de Medida | SPSS Amos / plano de análise estatística da equipe de pesquisa | Análise fatorial confirmatória multigrupo ΔCFI &< 0,010 e ΔRMSEA &< .015 critérios | Utilizado para avaliar a invariância configuracional, métrica e escalar entre gênero, tipo de programa, duração do estágio e instituição antes da interpretação das estimativas de ECM agrupadas. |
Referências
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.