Este estudo avalia um protocolo de treinamento em realidade virtual colaborativa co-localizada em grande espaço, comparando presença espacial, coordenação em equipe, engajamento no aprendizado, carga cognitiva, segurança e resultados de aprendizado de curto prazo em três condições de treinamento.
Artigo de investigação
Avaliação Comparativa de Realidade Virtual Colaborativa Co-localizada em Desktop, Escala de Sala e Grandes Espaços em Treinamento Imersivo
Neste artigo
Resumo
Resumo
A realidade virtual colaborativa em grande espaço e co-localizada fornece um ambiente de treinamento no qual os participantes podem se mover, comunicar e coordenar ações dentro de um espaço imersivo compartilhado. No entanto, ainda são limitadas as evidências sobre se essa configuração melhora a presença espacial, a coordenação da equipe e o engajamento no aprendizado além da colaboração baseada em desktop ou da realidade virtual distribuída em escala de ambiente. Este estudo avaliou um protocolo experimental de centro único com três braços, envolvendo 126 participantes distribuídos em 42 equipes de três pessoas. As equipes foram randomizadas para simulação colaborativa em desktop, realidade virtual colaborativa distribuída em escala de ambiente ou realidade virtual colaborativa em grande espaço e co-localizada. Todas as equipes realizaram uma orientação de 8 minutos, uma tarefa colaborativa de logística emergencial e navegação espacial de 20 minutos, avaliações imediatas após o treinamento e um teste de retenção após duas semanas. Os desfechos primários foram presença espacial, coordenação da equipe autoavaliada, coordenação da equipe avaliada por observador e engajamento no aprendizado. Os desfechos secundários incluíram escores de conhecimento, carga cognitiva, desconforto no simulador e indicadores de processo da tarefa. O grupo de realidade virtual colaborativa em grande espaço e co-localizada apresentou maior presença espacial, coordenação da equipe e engajamento no aprendizado em comparação com os grupos de comparação. O ganho de conhecimento favoreceu a condição de grande espaço, enquanto o conhecimento ajustado após o treinamento e o conhecimento de retenção após duas semanas não diferiram significativamente entre as condições. A carga cognitiva não aumentou significativamente, e o desconforto no simulador permaneceu leve em média. Esses achados indicam que a realidade virtual colaborativa em grande espaço e co-localizada pode ser mais útil para tarefas de treinamento que exigem orientação espacial, coordenação baseada em papéis e engajamento ativo da equipe, e não apenas para a aquisição de conhecimento em curto prazo.
Introdução
A realidade virtual imersiva facilita o treinamento baseado em simulação em ambientes que de outra forma seriam perigosos ou inacessíveis, vinculando a atenção visual e o movimento corporal à prática situada1. Pesquisas recentes avançaram além das demonstrações de novidade, rumo à implementação baseada em evidências2, ainda permanece uma questão importante sobre quais configurações espaciais e equipamentos melhor apoiam comportamentos de aprendizagem colaborativa. A presença espacial influencia a atenção e a corporeidade3,4, enquanto a imersão subjetiva isoladamente pode ser insuficiente para operações complexas baseadas em equipe. A colaboração produtiva exige objetivos compartilhados, interdependência de tarefas e monitoramento mútuo em tempo real5.
Pesquisas recentes avançaram na compreensão da realidade virtual co-localizada e da colaboração encarnada no apoio ao trabalho em equipe. No entanto, as evidências empíricas permanecem desiguais quanto aos efeitos pedagógicos de diferentes estruturas espaciais6. A principal contribuição deste estudo é a avaliação sistemática de três ambientes colaborativos funcionalmente distintos: simulação colaborativa em desktop, realidade virtual distribuída em escala de sala e realidade virtual colaborativa co-localizada em grande espaço. Essas condições representam configurações distintas de simulação baseada em equipe e permitem a comparação da imersão visual e da locomoção física compartilhada entre ambientes de treinamento colaborativo. Os arranjos físicos das três configurações são ilustrados na Figura 1.
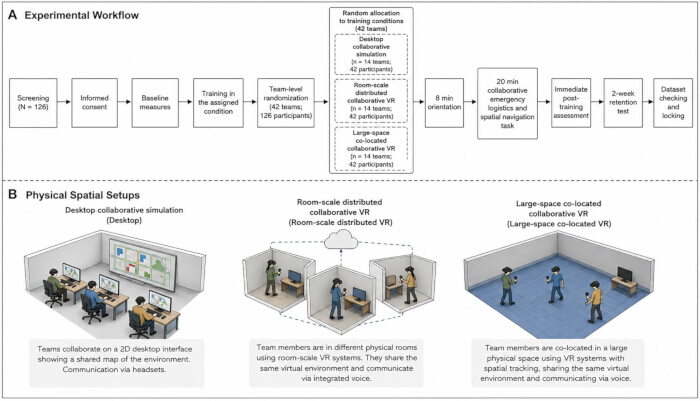
Figura 1: Fluxo de trabalho experimental e configurações espaciais físicas das três condições de treinamento colaborativo. (A) Visão geral do fluxo de trabalho experimental, desde a triagem dos participantes e randomização por equipe (N = 126 participantes; 42 equipes) até o teste de retenção de duas semanas. (B) Ilustração esquemática dos três ambientes de treinamento. Esquerda: simulação colaborativa em desktop, na qual os membros da equipe navegam usando estações de trabalho separadas e se comunicam por meio de canais de áudio designados, sem exposição visual imersiva. Centro: realidade virtual colaborativa distribuída em escala de sala, na qual os participantes experimentam imersão visual e comunicação em tempo real com a equipe, permanecendo em áreas físicas separadas de rastreamento de 3 m × 3 m. Direita: realidade virtual colaborativa em grande espaço co-localizado, na qual os membros da equipe compartilham um espaço livre de obstáculos de 8 m × 8 m, permitindo locomoção física sincronizada, referência espacial encarnada e co-navegação em tempo real. Clique aqui para visualizar uma versão maior desta figura.
O protocolo de treinamento utilizou um cenário colaborativo de logística emergencial e navegação espacial. Diferentemente do treinamento procedural individual, este cenário exige orientação física compartilhada, coordenação verbal em tempo real e ações espaciais encarnadas. Essas características proporcionam um ambiente estruturado para avaliar as possibilidades da realidade virtual colaborativa co-localizada em grande espaço. Figura 2 ilustra as interfaces e modos de interação utilizados nas condições de realidade virtual e desktop. A teoria da aprendizagem encarnada indica que a manipulação espacial pode apoiar a agência quando alinhada às exigências da tarefa7, enquanto a teoria da carga cognitiva indica que o trabalho em grupo eficaz depende da distribuição das demandas cognitivas sem introduzir encargos desnecessários de coordenação8.
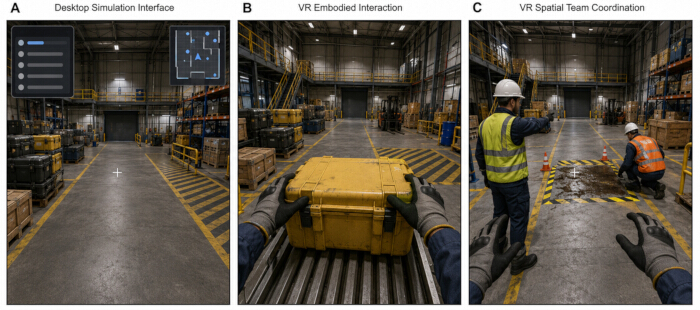
Figura 2: Comparação de interfaces e paradigmas de execução de tarefas entre as condições de treinamento. O cenário colaborativo de logística emergencial e navegação espacial foi padronizado em todos os grupos, diferindo principalmente na modalidade de interação. (A) Interface de simulação colaborativa em desktop, com visão em primeira pessoa. Os participantes navegam pelo ambiente industrial utilizando comandos de teclado e mouse e dependem de uma mira central e elementos gráficos bidimensionais da interface do usuário, incluindo um minimapa e uma lista de tarefas, para orientação espacial. (B) Interação encarnada em realidade virtual imersiva. Nas condições imersivas, os participantes executam tarefas, incluindo coleta e manipulação de recursos, por meio de manipulação física direta utilizando gestos manuais rastreados, em vez de cliques de mouse. (C) Coordenação espacial em equipe na condição de realidade virtual colaborativa imersiva em grande espaço. Os membros da equipe coordenam ações específicas de cada papel, incluindo as de navegador, gerenciador de recursos e verificador de segurança, por meio da visibilidade em tempo real dos avatares, gestos de apontamento espacial e orientação física compartilhada em torno de zonas de perigo. Clique aqui para visualizar uma versão maior desta figura.
Assim, os efeitos das três configurações de treinamento foram avaliados quanto à presença espacial, coordenação da equipe e engajamento na aprendizagem. Como ambientes imersivos podem gerar um forte envolvimento subjetivo9, esses resultados foram considerados juntamente com a aquisição de conhecimento após o treinamento e a retenção de curto prazo, a fim de distinguir o engajamento imediato da aprendizagem retida. Como a locomoção e a exposição imersiva também impõem demandas físicas, o desconforto no simulador foi monitorado como um resultado de implementação10.
Protocolo
Este estudo envolvendo participantes humanos foi conduzido de acordo com a Declaração de Helsinque e os requisitos institucionais para pesquisas comportamentais e educacionais. O protocolo do estudo foi aprovado pelo Comitê de Ética em Pesquisa com Seres Humanos da Universidade da Cidade de Shenyang (Número de Aprovação: SU1992837; Data de Aprovação: 18 de janeiro de 2025). Todos os participantes forneceram consentimento informado por escrito antes da inscrição. Os participantes foram informados de que o estudo envolvia exposição imersiva em realidade virtual, execução de tarefas em equipe, preenchimento de questionários, observação comportamental e testes de acompanhamento de curto prazo. A participação foi voluntária, e a desistência era permitida a qualquer momento, sem penalidade acadêmica, profissional ou institucional. Todos os registros do estudo foram desidentificados antes da análise. A cada participante foi atribuído um código numérico, e a cada equipe foi atribuído um código de equipe distinto. Nomes, números de estudante, números de telefone, imagens faciais ou gravações de áudio diretamente identificáveis não foram incluídos no conjunto de dados analítico. As categorias de equipamentos, versões de software e recursos associados de replicação estão listadas na Tabela de Materiais.
1. Desenho e local do estudo
Este estudo concluído utilizou um desenho experimental de grupo paralelo, com três braços e em centro único, para examinar se a realidade virtual colaborativa co-localizada em grande espaço estava associada a uma presença espacial mais forte, melhor coordenação da equipe e maior engajamento no aprendizado durante o treinamento imersivo. As três condições de treinamento foram simulação colaborativa em desktop, realidade virtual colaborativa distribuída em escala de ambiente e realidade virtual colaborativa co-localizada em grande espaço.
As condições foram projetadas como comparadores funcionais, e não como uma decomposição fatorial completa da imersão, colaboração e espaço para caminhar. A condição de desktop representou a colaboração sem exposição a um dispositivo de exibição montado na cabeça e imersivo. A condição de realidade virtual colaborativa distribuída em escala de sala representou a colaboração em equipe imersiva em áreas de rastreamento pequenas e separadas. A condição de realidade virtual colaborativa co-localizada em grande espaço combinou uma experiência visual imersiva, movimento físico compartilhado e interação em tempo real entre membros da equipe encarnados dentro de um único espaço de treinamento rastreado. As diferenças entre os grupos foram, portanto, interpretadas como diferenças entre as configurações completas de treinamento, e não como efeitos atribuíveis a qualquer componente isolado. Essa estrutura foi escolhida porque pesquisas sobre aprendizagem imersiva tratam a presença espacial, agência e engajamento como mecanismos pelos quais ambientes virtuais podem influenciar o comportamento de aprendizagem11.
O estudo foi conduzido no Laboratório de Aprendizagem Imersiva e Interação Humano-Computador da instituição participante de 3 de março a 18 de julho de 2025. A recrutamento e a avaliação basal foram realizados de 3 a 25 de abril de 2025. As sessões de intervenção ocorreram de 10 de março a 30 de maio de 2025. As avaliações de retenção de duas semanas foram concluídas entre 24 de março e 16 de junho de 2025. A verificação dos dados, a pontuação dos observadores e o bloqueio do conjunto de dados foram finalizados até 18 de julho de 2025.
Todas as sessões foram realizadas no mesmo complexo laboratorial para controlar a iluminação, temperatura, conectividade à internet, instruções da tarefa e supervisão dos pesquisadores. A condição de realidade virtual colaborativa co-localizada em grande espaço utilizou uma área de rastreamento desobstruída de 8 m × 8 m. A condição de realidade virtual colaborativa distribuída em escala de sala utilizou três áreas delimitadas separadas de 3 m × 3 m. A condição de simulação colaborativa em desktop utilizou estações de trabalho individuais separadas por divisórias acústicas, de modo que os participantes pudessem se comunicar apenas por meio do canal de comunicação designado.
Os participantes foram designados para equipes de três pessoas antes da randomização. A equipe foi utilizada como unidade de treinamento porque a tarefa exigia execução distribuída de funções, coordenação verbal, consciência situacional compartilhada e resolução conjunta de problemas. A randomização foi realizada no nível da equipe para evitar contaminação entre participantes dentro da mesma sessão. O fluxo geral do estudo e a configuração física das três condições são apresentados na Figura 1.
2. Participantes e triagem de elegibilidade
Os participantes foram recrutados a partir de programas de graduação e pós-graduação da instituição participante. Os anúncios de recrutamento descreviam o estudo como uma pesquisa de treinamento imersivo envolvendo realidade virtual, coordenação em equipe e avaliação de aprendizagem. Os anúncios não indicavam a superioridade esperada de qualquer condição de treinamento. Os participantes interessados preencheram um formulário online de triagem antes do agendamento no laboratório.
Os participantes eram elegíveis se tivessem entre 18 e 35 anos, visão normal ou corrigida para normal, pudessem compreender o idioma do treinamento, não tivessem participado anteriormente do mesmo cenário de treinamento virtual e pudessem permanecer em pé e se mover com segurança por pelo menos 30 minutos. Os participantes foram excluídos se relataram enjoo severo, epilepsia não controlada, lesão musculoesquelética recente que afetasse a marcha ou o equilíbrio, déficit visual não corrigido, vertigem severa, déficit auditivo severo não corrigido, doença aguda atual ou qualquer condição médica que tornasse a exposição à realidade virtual imersiva insegura. Os participantes também foram excluídos se tivessem ampla experiência prévia com o cenário exato de treinamento ou se já tivessem participado de testes piloto do mesmo sistema.
A elegibilidade foi verificada em duas etapas. Um assistente de pesquisa revisou primeiro o formulário de triagem online. Em seguida, o pesquisador da sessão confirmou verbalmente a elegibilidade no dia do teste, antes do consentimento. Os participantes que relataram desconforto leve prévio com movimento não foram excluídos automaticamente, mas foram monitorados com mais atenção e lembrados de que a participação poderia ser interrompida imediatamente caso ocorresse desconforto. O formulário completo de triagem, os itens de elegibilidade, o questionário basal, os formatos de resposta e as regras de codificação estão disponíveis no Arquivo Suplementar 1.
Um cálculo de potência a priori foi realizado utilizando o software G-Power para determinar o tamanho amostral necessário para o delineamento experimental. Considerando um tamanho do efeito médio esperado de f = 0,25 com base na literatura prévia sobre aprendizagem colaborativa imersiva, um nível alfa de 0,05 e uma potência estatística de 0,80 para uma análise com três grupos, foi necessário um mínimo de 111 participantes. Para acomodar a estrutura de equipes de três pessoas e manter a alocação equilibrada dos grupos entre as condições, a amostra final foi ampliada para 126 participantes, compreendendo 42 equipes independentes. Como a intervenção foi aplicada no nível da equipe, os identificadores das equipes foram mantidos para ajuste por agrupamento, pontuação da coordenação avaliada por observadores e análises de sensibilidade.
3. Randomização, ocultação de alocação e cegamento
Após todos os membros de uma equipe de três pessoas terem concluído a confirmação de elegibilidade, a equipe foi aleatoriamente designada para uma das três condições de treinamento utilizando uma lista de randomização por blocos gerada por computador, com tamanho fixo de seis equipes. A sequência de alocação foi gerada antes da coleta de dados usando um pacote de randomização no ambiente de computação estatística, com uma semente reprodutível de 20250301.
A ocultação da alocação foi mantida utilizando envelopes opacos, numerados sequencialmente e à prova de violação, preparados por um pesquisador independente do recrutamento dos participantes e da aplicação da intervenção. O arquivo de randomização foi armazenado em uma planilha protegida por senha e não estava acessível aos avaliadores dos desfechos.
A alocação foi revelada apenas após a conclusão do questionário basal e do teste prévio de conhecimento. O pesquisador da sessão abriu o próximo envelope lacrado de alocação imediatamente antes da configuração do equipamento. O mascaramento dos participantes em relação ao formato do treinamento físico não foi possível, pois as três condições eram visivelmente diferentes. Os participantes não foram informados sobre qual condição era esperada para ter melhor desempenho.
Dois observadores avaliaram a coordenação da equipe a partir de gravações padronizadas em tela. Os observadores estavam cegos quanto às hipóteses do estudo, aos rótulos das condições de treinamento e aos resultados dos questionários, e não participaram da aplicação do treinamento. Os arquivos de vídeo foram renomeados utilizando códigos neutros para as equipes antes da avaliação. Rótulos de interface que identificavam a condição foram recortados ou ocultados, sempre que possível, antes da avaliação pelos observadores.
4. Cenário e estrutura da tarefa de treinamento
O cenário de treinamento foi projetado como uma tarefa colaborativa de logística emergencial e navegação espacial em um ambiente de treinamento industrial simulado. Cada equipe de três pessoas precisava localizar recursos virtuais, interpretar pistas espaciais, comunicar informações de rota, coordenar ações específicas de cada função e concluir uma sequência de etapas da missão dentro de um tempo fixo.
Cada participante assumiu um dos três papéis: navegador, gerente de recursos ou verificador de segurança. O navegador interpretava a direção da rota e a sequência do destino. O gerente de recursos identificava e coletava itens virtuais relevantes para a tarefa. O verificador de segurança monitorava os riscos, confirmava a ordem dos procedimentos e alertava a equipe antes do envio final.
O cenário continha quatro zonas: zona de orientação, zona de recursos, zona de perigo e zona de conclusão. Cada equipe completou oito subtarefas obrigatórias: identificar o local-alvo, selecionar três recursos corretos entre seis recursos possíveis, evitar dois desvios incorretos na rota, responder a três alertas de perigo, transferir informações entre os membros da equipe e enviar a sequência final de tarefas. O tempo máximo para a tarefa era de 20 min. As equipes que não completaram todas as subtarefas obrigatórias dentro de 20 min foram interrompidas ao atingir o limite de tempo, e o número de subtarefas concluídas foi registrado.
Antes da tarefa principal, todos os participantes realizaram uma orientação padronizada de 8 min. Os primeiros 3 min apresentaram as regras do estudo e os procedimentos de segurança. Os próximos 3 min apresentaram os controles da interface. Os últimos 2 min permitiram que os participantes praticassem movimento, seleção e comunicação em um ambiente de prática neutro, que não continha objetos, rotas, riscos ou respostas utilizadas no cenário principal. Nenhum dado de desempenho do ambiente de prática foi analisado.
O mesmo conteúdo de aprendizagem, sequência de tarefas, respostas-alvo, estrutura do percurso, estímulos de perigo e critérios de pontuação foram utilizados nas três condições. As condições diferiram na modalidade de interação, grau de imersão, movimento físico e configuração espacial. Os ambientes imersivos foram desenvolvidos utilizando uma plataforma comercial de desenvolvimento tridimensional em tempo real. A rede multiplayer e a sincronização de estados espaciais foram implementadas usando uma estrutura dedicada de sincronização multiplayer operando sobre uma arquitetura Ethernet local de gigabit. Os participantes designados às condições de realidade virtual imersiva utilizaram dispositivos de exibição montados na cabeça de alta resolução, com fones de ouvido e microfones integrados. O rastreamento espacial utilizou um sistema de rastreamento baseado em laser infravermelho com quatro estações-base. A implementação do avatar utilizou algoritmos de cinemática inversa para mapear a telemetria em tempo real dos controladores de cabeça e mãos para avatares articulados de trabalhadores.
5. Verificação do procedimento e aprimoramento da medição antes do estudo
Antes da coleta formal de dados, todos os itens do questionário, itens do teste de conhecimento, regras de avaliação por observador e procedimentos da tarefa foram revisados por dois pesquisadores com experiência em aprendizagem imersiva e um pesquisador com experiência em mensuração educacional. A revisão concentrou-se na clareza dos itens, alinhamento entre papel e tarefa, consistência da pontuação, redação relativa à segurança e alinhamento com o construto.
Um teste piloto foi realizado de 17 a 21 de fevereiro de 2025, com seis participantes que atendiam aos mesmos critérios de elegibilidade da amostra formal. O estudo piloto examinou o tempo das tarefas, o conforto do headset, a segurança dos movimentos, a clareza das instruções, o tempo necessário para preencher o questionário, a precisão da exportação dos dados e a viabilidade da avaliação por observador. Os dados do estudo piloto foram utilizados apenas para aprimorar a redação, o tempo de configuração, as instruções de segurança e os procedimentos de exportação dos registros. Esses participantes não foram incluídos na amostra final, e seus dados não foram considerados na análise formal.
6. Condição de simulação colaborativa em desktop
Na condição de simulação colaborativa em desktop, cada participante utilizou uma estação de trabalho individual conectada a um monitor de 24 polegadas com resolução 1080p. Os dispositivos de entrada consistiam em um mouse e teclado de computador, e a comunicação de áudio era fornecida por meio de um fone de ouvido USB com microfone. Os participantes foram acomodados em estações de trabalho separadas e instruídos a não se comunicarem fora do sistema.
A simulação em desktop utilizou o mesmo ambiente virtual, objetos da tarefa, sequência de rota, estímulos de perigo e lógica de pontuação das condições de realidade virtual. A vista da câmera era em primeira pessoa. Conforme ilustrado na Figura 2A, os participantes do grupo de desktop navegaram utilizando entradas de teclado e interagiram com os recursos virtuais por meio de cliques de mouse através de um campo de visão fixo em duas dimensões. O campo de visão, velocidade de movimento, distância de interação e configurações de áudio foram fixados antes da coleta de dados e não foram alterados entre as sessões. Um pesquisador monitorou a estabilidade técnica durante cada sessão, mas não forneceu orientações sobre a tarefa após o início do cenário principal.
7. Condição de realidade virtual colaborativa distribuída em escala de ambiente
Na condição de realidade virtual colaborativa distribuída em escala de ambiente, os três participantes entraram no mesmo cenário virtual a partir de áreas de rastreamento separadas de 3 m × 3 m. Cada participante utilizou um visor montado na cabeça e controladores manuais. Os membros da equipe se comunicaram por meio do canal de voz designado e realizaram a mesma tarefa em equipe baseada em papéis, mas não puderam co-navegar fisicamente em um espaço de rastreamento compartilhado e amplo.
Antes da tarefa principal, o ajuste do fone de ouvido, a distância interpupilar, o sistema de limites e as tiras do controle foram ajustados. Os participantes foram instruídos a interromper imediatamente caso sentissem tontura, náusea, cansaço ocular, dor de cabeça, perda de equilíbrio ou ansiedade. Um pesquisador permaneceu a menos de 2 m de cada área ativa de rastreamento durante toda a sessão e monitorou a segurança sem fornecer orientações sobre a tarefa.
Se um participante ultrapassasse o limite marcado, a sessão era pausada e o participante era reposicionado. Se ocorresse desconforto moderado, definido como uma pontuação de desconforto autoavaliada igual ou superior a 5 em qualquer item de desconforto na escala de 0 a 10, a sessão era pausada e o participante era acomodado para se recuperar. Se qualquer item de desconforto atingisse 7 ou mais, a sessão era interrompida.
8. Condição de realidade virtual colaborativa co-localizada em espaço amplo
Na condição de realidade virtual colaborativa co-localizada em espaço amplo, cada equipe de três pessoas entrou na mesma área de treinamento rastreada de 8 m × 8 m. Cada participante usava um visor montado na cabeça, segurava dois controladores e era representado por um avatar específico para o papel, visível aos demais membros da equipe. Os membros da equipe se comunicavam verbalmente em tempo real enquanto se moviam fisicamente pelo espaço compartilhado de treinamento. O sistema sincronizava a localização dos participantes, movimentos das mãos, seleção de objetos e alterações no estado da tarefa. Conforme mostrado em Figura 2B e Figura 2C, os participantes nas condições imersivas executavam tarefas usando gestos manuais espaciais tridimensionais com controladores rastreados e rotação física da cabeça para obter um campo de visão de 360°.
A condição de grande espaço utilizou o mesmo conteúdo da tarefa e limite de tempo de 20 min, assim como as demais condições. O movimento físico foi calibrado para que a rota virtual permanecesse dentro da área de segurança demarcada. Um limite de segurança aparecia no headset quando os participantes se aproximavam da borda da zona de rastreamento. Antes da tarefa principal, foram verificados o espaço livre no piso, a movimentação sem cabos, o ajuste do headset, a estabilidade do rastreamento, a entrada de áudio e a resposta do controle. Os participantes foram instruídos a usar a marcha física natural, em vez de técnicas de locomoção artificial, para navegar no ambiente virtual. Era proibido o contato físico entre os membros da equipe. Se dois participantes se aproximassem a menos de 0,5 m um do outro, era fornecido um lembrete neutro de segurança, sem informações sobre a tarefa.
Cada sessão em espaço amplo foi supervisionada por dois pesquisadores. Um pesquisador monitorava o painel do sistema e o status da gravação. O segundo pesquisador permanecia fora da área de rastreamento ativa e monitorava a segurança do participante. A tarefa era pausada se o rastreamento fosse perdido por mais de 10 s, se um participante relatasse desconforto ou se cruzasse o limite de segurança. Se a interrupção durasse menos de 2 min e o participante desejasse continuar, a tarefa era retomada a partir do último estado salvo. Se a interrupção excedesse 2 min, a sessão era registrada como incompleta e mantida no conjunto de dados de intenção-de-tratar.
9. Medidas de desfecho e cronograma da avaliação
As avaliações foram realizadas no início do estudo, imediatamente após o treinamento e 2 semanas após o treinamento. As medidas basais incluíram dados demográficos, experiência prévia com realidade virtual e treinamento em equipe, familiaridade com jogos eletrônicos e um pré-teste de conhecimento com 30 pontos. As medidas imediatamente após o treinamento incluíram presença espacial, coordenação da equipe autoavaliada e avaliada por observadores, engajamento na aprendizagem, carga cognitiva, desconforto no simulador, conhecimento pós-treinamento e indicadores de desempenho na tarefa. No acompanhamento após 2 semanas, foi utilizado o mesmo teste de conhecimento com 30 pontos, com os itens reordenados e pequenas variações na redação. O cronograma das avaliações é apresentado na Tabela 1.
Tabela 1: Resumo das medidas primárias e secundárias. Esta tabela resume as variáveis, escalas de mensuração, momentos da avaliação e fontes de dados para os desfechos primários, desfechos secundários de aprendizagem e medidas de segurança e de processo avaliadas ao longo do protocolo experimental. Clique aqui para baixar esta tabela.
A presença espacial foi medida imediatamente após o treinamento utilizando uma escala de 8 itens e 7 pontos adaptada de dimensões de presença estabelecidas12. As pontuações foram médias quando pelo menos 80% dos itens foram preenchidos; caso contrário, a pontuação foi codificada como ausente. Todos os itens completos e as regras de pontuação estão fornecidos no Arquivo Suplementar 1.
A coordenação autopercebida da equipe foi medida utilizando uma escala personalizada de seis itens e sete pontos, abrangendo clareza na comunicação, consciência dos papéis, monitoramento mútuo, momento oportuno de assistência, compreensão compartilhada da tarefa e recuperação de erros. Um teste-piloto com 20 participantes avaliou a clareza e a estrutura dos itens, e uma análise fatorial exploratória identificou um único fator dominante. A consistência interna na amostra principal foi de α = 0,88 segundo Cronbach. Os escores dos participantes foram calculados como a média dos itens concluídos, e os escores em nível de equipe, como a média dos três escores dos participantes. Os itens completos e os critérios de pontuação estão disponíveis no Arquivo Suplementar 1.
A coordenação da equipe avaliada por observadores foi medida usando uma matriz personalizada que abrangeu o tempo da comunicação, execução de papéis, apoio mútuo, coordenação espacial e recuperação de erros. Cada domínio foi pontuado de 0 a 20, resultando em uma pontuação total de 0 a 100. A matriz foi submetida à revisão por especialistas, e dois observadores completaram 10 h de treinamento antes da pontuação formal. A confiabilidade entre avaliadores foi avaliada utilizando um coeficiente de correlação intraclasse (CCI) de efeitos aleatórios bidirecional para concordância absoluta, exigindo CCI ≥ 0,75 antes da pontuação final. Diferenças nas pontuações totais superiores a 12 pontos foram resolvidas por consenso; caso contrário, foi utilizada a média das duas pontuações. A matriz completa e o procedimento de reconciliação estão descritos no Arquivo Suplementar 1.
O engajamento na aprendizagem foi medido imediatamente após o treinamento utilizando uma escala reduzida de 12 itens e 7 pontos13. As pontuações foram médias dos itens concluídos, sendo que valores mais altos indicam um engajamento mais forte. A consistência interna foi avaliada utilizando o alfa de Cronbach. A carga cognitiva foi avaliada por meio de cinco classificações de 1 a 7 quanto à demanda mental, demanda física, pressão de tempo, esforço e frustração14. Os itens completos e as regras de pontuação estão fornecidos no Arquivo Suplementar 1.
A aquisição de conhecimento foi avaliada por meio de um teste com 30 pontos, composto por 20 itens de única melhor resposta e cinco itens curtos de julgamento de cenário. O mesmo delineamento foi utilizado para o pré-teste, pós-teste e teste de retenção após duas semanas, com os itens reordenados e alterações equivalentes na redação. Um ganho de pelo menos 3 pontos do pré-teste ao pós-teste foi definido como uma melhoria descritiva praticamente significativa. O delineamento do teste, as regras de pontuação e a matriz de julgamento estão fornecidos no Arquivo Suplementar 1.
O desconforto provocado pelo simulador foi avaliado antes da exposição, após a orientação e após a tarefa principal, utilizando cinco escalas de sintomas de 0 a 10. A média dos cinco itens formou o índice de desconforto. As sessões foram interrompidas se qualquer item atingisse 7 ou mais. Índices pós-tarefa acima de 6 exigiram pelo menos 15 minutos de monitoramento, e índices de 5 ou mais exigiram acompanhamento após 24 horas. As regras completas de pontuação de segurança estão descritas no Supplementary File 1.
Os indicadores de desempenho na tarefa incluíram status de conclusão, tempo de conclusão, recursos corretos selecionados, respostas corretas aos alertas de risco, erros de trajeto e interrupções de segurança. Equipes incompletas tiveram o tempo de conclusão definido em 1.200 s. As definições de resultados, cronometragem, intervalos de pontuação, fontes de dados e níveis de análise são resumidos na Tabela 1 e detalhados no Arquivo Suplementar 1.
10. Procedimento de coleta de dados
Cada sessão seguiu a mesma sequência. Os participantes chegavam 15 minutos antes do horário previsto para o treinamento. A identidade era confirmada usando a lista de agendamentos, a elegibilidade era verificada novamente, o termo de consentimento era explicado e perguntas sobre o procedimento eram respondidas. Em seguida, os participantes assinavam o termo de consentimento e recebiam códigos de participante. A superioridade esperada de qualquer condição não era discutida.
Os participantes preencheram o questionário inicial e o teste de conhecimento pré-treinamento em um tablet do laboratório. A fase inicial durou aproximadamente 12 min. Após a conclusão da fase inicial, a alocação em equipes foi revelada e o arranjo de treinamento designado foi preparado. O preparo do equipamento durou aproximadamente 5 min na condição de desktop, 8 min na condição de realidade virtual colaborativa distribuída em escala de ambiente e 10 min na condição de realidade virtual colaborativa co-localizada em grande espaço. O preparo do equipamento não foi contabilizado como exposição ao treinamento.
Todos os participantes então concluíram a orientação padronizada de 8 min. A tarefa principal iniciou-se imediatamente após a orientação e durou até 20 min. Nenhuma instrução, dica ou feedback corretivo foi fornecido durante a tarefa principal. A assistência técnica limitou-se à restauração do funcionamento do sistema, ajuste do posicionamento do fone de ouvido, reposicionamento dos participantes dentro do limite de segurança ou repetição das instruções de segurança previamente indicadas. Após a tarefa, os participantes removeram o equipamento e preencheram o questionário pós-treinamento e o teste de conhecimento pós-treinamento em estações individuais. A avaliação pós-treinamento durou aproximadamente 15 min.
O teste de retenção de 2 semanas foi aplicado online 14 dias após a sessão de treinamento, com uma janela aceitável de conclusão entre o 13º e o 16º dia. Os participantes receberam um lembrete 24 horas antes do prazo final e outro lembrete no 15º dia, caso o teste ainda não tivesse sido concluído. As respostas enviadas após o 16º dia foram mantidas no conjunto de dados bruto, mas excluídas da análise primária de retenção. O número efetivo de dias entre o treinamento e o acompanhamento foi registrado para análise de sensibilidade.
11. Controle de qualidade dos dados
Os questionários eletrônicos incluíam verificações de faixa para os resultados principais, enquanto os itens demográficos podiam ser ignorados. Os tempos de envio foram registrados, e os questionários concluídos em menos de um terço do tempo mediano de preenchimento foram sinalizados para revisão. Os registros do sistema foram exportados após cada sessão e comparados com os registros das sessões em até 48 horas; discrepâncias foram resolvidas mediante gravações com carimbo de data e hora.
Os escores de coordenação avaliados por observadores foram inseridos independentemente por dois observadores. Diferenças no escore total superiores a 12 pontos foram sinalizadas para revisão por consenso, e os escores finais foram fixados antes da análise em nível de grupo. Os escores de escalas com múltiplos itens foram calculados quando pelo menos 80% dos itens foram preenchidos; caso contrário, os escores foram codificados como ausentes. Os itens de conhecimento de única resposta correta não respondidos foram pontuados como 0. Os itens de julgamento em cenários curtos foram pontuados independentemente por dois avaliadores, com discrepâncias superiores a 1 ponto sendo revisadas por um terceiro avaliador.
O conjunto de dados final foi travado após a verificação dos registros de elegibilidade, códigos dos participantes e das equipes, intervalos dos questionários, escores de conhecimento, avaliações dos observadores, registros do sistema, validade do teste de retenção, fusões de dados e dados ausentes. Regras detalhadas para pontuação, limpeza e travamento do conjunto de dados são fornecidas no Arquivo Suplementar 1.
12. Monitoramento de segurança e critérios de interrupção
O monitoramento de segurança foi realizado durante todas as sessões de treinamento. Antes da exposição, os participantes foram informados de que desconforto poderia ocorrer durante o treinamento em realidade virtual e que podiam se retirar a qualquer momento. Durante a tarefa, foram monitorados postura, equilíbrio, velocidade de movimento e sinais verbais de desconforto. A tarefa foi interrompida imediatamente se um participante relatasse tontura severa, náusea, desconforto visual, dor de cabeça, ansiedade, perda de equilíbrio ou desejo de interromper.
Critérios pré-definidos de interrupção foram aplicados de forma consistente. A sessão era interrompida se qualquer item de desconforto atingisse 7 ou mais na escala de 0 a 10, se um participante cruzasse o limite de segurança duas vezes em uma mesma sessão, se a perda de rastreamento durasse mais de 2 min, se uma falha no equipamento impedisse a interação normal, ou se a continuação da participação fosse considerada um risco à segurança. As sessões interrompidas foram registradas usando um formulário de interrupção de sessão. Os participantes eram acomodados após a interrupção e monitorados até que os sintomas retornassem a um nível leve, definido como todos os itens de desconforto abaixo de 3. Nenhum participante podia deixar o laboratório enquanto relatasse desconforto moderado ou grave.
13. Gestão de dados e confidencialidade
Todos os dados foram armazenados em uma pasta de projeto com identificação removida em um disco institucional criptografado. O arquivo de vinculação que conecta as identidades dos participantes aos códigos dos participantes foi armazenado separadamente e era acessível apenas ao pesquisador principal. Os dados dos questionários, registros das tarefas, avaliações do observador e pontuações dos testes de conhecimento foram combinados usando apenas os códigos dos participantes e das equipes, e o conjunto de dados analítico não continha identificadores pessoais.
Os dados foram organizados nos níveis de participante e de equipe. Os arquivos no nível de participante continham identificadores, atribuição de condição, variáveis demográficas, resultados de questionários, resultados de conhecimento e variáveis relacionadas à tarefa. Os arquivos no nível de equipe continham identificadores da equipe, atribuição de condição, coordenação avaliada por observador, conclusão da tarefa, tempo de conclusão, seleção de recursos, manuseio de riscos, erros de rota e interrupções de segurança. As pontuações brutas dos observadores foram mantidas separadamente antes da média ou da resolução por consenso. As definições das variáveis, os intervalos de codificação e a estrutura do conjunto de dados são fornecidos no Arquivo Suplementar 1.
14. Análise estatística
Os desfechos primários foram presença espacial, coordenação da equipe autoavaliada, coordenação da equipe avaliada por observador e engajamento na aprendizagem. Os desfechos secundários incluíram conhecimento após o treinamento, retenção após 2 semanas, carga cognitiva, desconforto no simulador, conclusão da tarefa, tempo de conclusão e indicadores de processo da tarefa. As condições de treinamento compreenderam simulação colaborativa em desktop, realidade virtual colaborativa distribuída em escala de ambiente e realidade virtual colaborativa co-localizada em grande espaço.
As variáveis no nível dos participantes e das equipes foram resumidas utilizando estatísticas descritivas apropriadas. As características basais incluíram idade, gênero, experiência prévia com realidade virtual, familiaridade com jogos, experiência prévia com treinamento em equipe e conhecimento prévio ao treinamento. Como a randomização ocorreu no nível da equipe, foram calculados coeficientes de correlação intraclasse para avaliar a dependência dentro das equipes. Os desfechos primários no nível dos participantes foram analisados utilizando modelos lineares de efeitos mistos, com a condição de treinamento como efeito fixo e o identificador da equipe como intercepto aleatório. Os modelos utilizaram estimação por máxima verossimilhança restrita e incluíram os dados disponíveis sob a suposição de dados ausentes ao acaso. Nenhuma imputação foi aplicada aos desfechos primários dos questionários. As médias marginais estimadas foram comparadas utilizando contrastes pareados ajustados por Tukey. A coordenação avaliada por observadores foi analisada no nível da equipe.
O procedimento de taxa de falsa descoberta de Benjamini-Hochberg foi aplicado nas quatro variáveis primárias como uma análise de sensibilidade. Todas as equipes e participantes randomizados foram analisados de acordo com a alocação original. As pontuações das escalas compostas por múltiplos itens foram calculadas quando pelo menos 80% dos itens foram preenchidos; caso contrário, as pontuações foram codificadas como ausentes. A normalidade dos resíduos foi avaliada por meio de gráficos Q-Q e testes de Shapiro-Wilk, e a homogeneidade da variância foi avaliada utilizando o teste de Levene. Distribuições fortemente não normais foram examinadas com o teste de Kruskal-Wallis como análise de sensibilidade.
Os tamanhos do efeito foram relatados com valores de p. Os resultados da análise de variância incluíram eta ao quadrado e eta ao quadrado parcial; as comparações aos pares incluíram d de Cohen com intervalos de confiança de 95%; e os modelos de efeitos mistos relataram diferenças médias estimadas com intervalos de confiança de 95%. A significância estatística foi definida como p bicaudal < 0,05. As associações entre presença espacial, coordenação da equipe, engajamento na aprendizagem e resultados de conhecimento foram examinadas usando correlações de Pearson ou Spearman, conforme apropriado. A sintaxe estatística para análises descritivas, modelos de efeitos mistos, análise de coordenação em nível de equipe, ajuste de múltiplos resultados, verificações de pressupostos, análises de conhecimento e análises de correlação está disponível no Arquivo Suplementar 1.
Resultados
Fluxo de participantes e populações de análise
Um total de 126 participantes foram inscritos e distribuídos em 42 equipes de três pessoas. Cada condição de treinamento recebeu 14 equipes, resultando em 42 participantes no grupo de simulação colaborativa em desktop, 42 no grupo de realidade virtual colaborativa distribuída em escala de ambiente e 42 no grupo de realidade virtual colaborativa co-localizada em espaço amplo. Todas as equipes concluíram a sessão de treinamento designada e foram mantidas no conjunto de dados de intenção de tratar.
A ausência de dados foi baixa e não esteve concentrada em nenhuma condição. Os escores de presença espacial estavam disponíveis para 124 participantes, incluindo 41 no grupo desktop, 42 no grupo em escala de cômodo e 41 no grupo em grande espaço. Os escores de coordenação da equipe autoavaliados estavam disponíveis para 123 participantes, com 41 participantes em cada grupo. Os escores de engajamento na aprendizagem estavam disponíveis para 122 participantes, incluindo 40 no grupo desktop, 41 no grupo em escala de cômodo e 41 no grupo em grande espaço. Os escores de desconforto simulador estavam disponíveis para 124 participantes, incluindo 42 no grupo desktop, 41 no grupo em escala de cômodo e 41 no grupo em grande espaço. Escores válidos de retenção de conhecimento após 2 semanas estavam disponíveis para 122 participantes, incluindo 40 no grupo desktop, 41 no grupo em escala de cômodo e 41 no grupo em grande espaço. A coordenação da equipe avaliada por observadores estava disponível para as 42 equipes inteiras. O fluxo de participantes, alocação, avaliação imediata e conclusão do acompanhamento são resumidos na Figura 3.
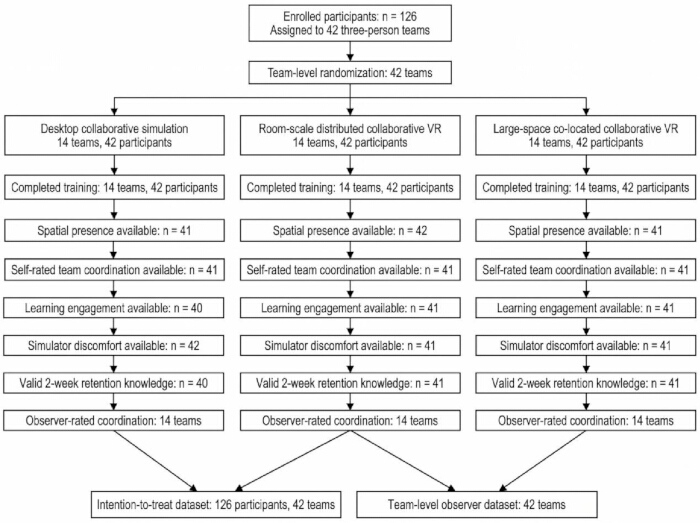
Figura 3: Fluxo dos participantes e populações para análise. O diagrama de fluxo mostra a inscrição, alocação de 126 participantes em 42 equipes de três pessoas, conclusão do treinamento, avaliação imediata, pontuação da coordenação avaliada por observadores e dados válidos de acompanhamento após duas semanas nas três condições de treinamento. Clique aqui para visualizar uma versão maior desta figura.
Características basais
As características demográficas e relacionadas ao treinamento na linha de base foram amplamente comparáveis entre as três condições. A amostra final consistiu de participantes adultos jovens, graduandos e pós-graduandos. Os três grupos foram semelhantes quanto à idade, exposição prévia à realidade virtual, familiaridade com jogos ou simulações, experiência prévia em treinamentos em equipe e treinamentos prévios em logística de emergência, navegação ou segurança industrial.
Os escores de conhecimento pré-treinamento também foram comparáveis entre os grupos. Os escores médios de conhecimento pré-treinamento foram 16,17 ± 3,09 no grupo de simulação colaborativa em desktop, 16,10 ± 3,61 no grupo de realidade virtual colaborativa distribuída em escala de ambiente e 15,55 ± 3,23 no grupo de realidade virtual colaborativa co-localizada em grande espaço. A comparação entre grupos sem ajuste não foi estatisticamente significativa, F(2, 123) = 0,44, p = 0,647, η2 = 0,007.
As características basais e as medidas pré-treinamento são apresentadas na Tabela 2. Antes dos testes inferenciais de hipóteses, avaliações diagnósticas indicaram que as variáveis contínuas principais atenderam às premissas de normalidade dos resíduos e homogeneidade da variância. A consistência interna foi alta em todos os instrumentos psicométricos, com coeficientes alfa de Cronbach de 0,86 para presença espacial, 0,88 para coordenação da equipe autoavaliada e 0,91 para engajamento na aprendizagem. Todas as diferenças significativas entre grupos nas principais variáveis desfecho permaneceram significativas após ajuste da taxa de descobertas falsas de Benjamini-Hochberg.
Tabela 2: Características basais e medidas pré-treinamento. Esta tabela relata dados demográficos dos participantes, experiência prévia com realidade virtual e treinamentos, familiaridade com jogos ou simulações, histórico prévio de treinamentos relacionados e escores de conhecimento pré-treinamento nas três condições experimentais. Clique aqui para baixar esta tabela.
Presença espacial
A presença espacial foi analisada utilizando um modelo linear de efeitos mistos com a condição de treinamento como efeito fixo e o código da equipe como intercepto aleatório. Os testes do modelo de efeitos mistos utilizaram graus de liberdade ajustados pelo método de Satterthwaite. O modelo revelou um efeito significativo da condição de treinamento sobre a presença espacial, F(2, 39) = 23,91, p < 0,001. As médias marginais estimadas foram 4,13 para o grupo de simulação colaborativa em desktop, 5,00 para o grupo de realidade virtual colaborativa distribuída em escala de sala e 5,42 para o grupo de realidade virtual colaborativa co-localizada em espaço amplo.
As comparações pareadas ajustadas por Tukey mostraram que a presença espacial foi maior no grupo de ambiente amplo do que no grupo de desktop, diferença média estimada = 1,29, IC 95%: 0,86 – 1,72, p < 0,001. A presença espacial também foi maior no grupo de ambiente amplo do que no grupo de escala reduzida, diferença média estimada = 0,42, IC 95%: 0,04 – 0,80, p = 0,027. O grupo de escala reduzida obteve pontuação maior do que o grupo de desktop, diferença média estimada = 0,87, IC 95%: 0,45 – 1,29, p < 0,001.
Para comparação descritiva, as médias não ajustadas ± desvio padrão (DP) foram de 4,13 ± 0,91 no grupo de ambiente de mesa, 5,00 ± 0,79 no grupo de ambiente em escala real e 5,42 ± 0,80 no grupo de grande espaço. A análise de variância (ANOVA) não ajustada mostrou o mesmo padrão, F(2, 121) = 25,68, p < 0,001, η2 = 0,298. As distribuições dos resultados primários são apresentadas na Figura 4, e as estatísticas descritivas e de efeitos mistos correspondentes estão resumidas na Tabela 3.
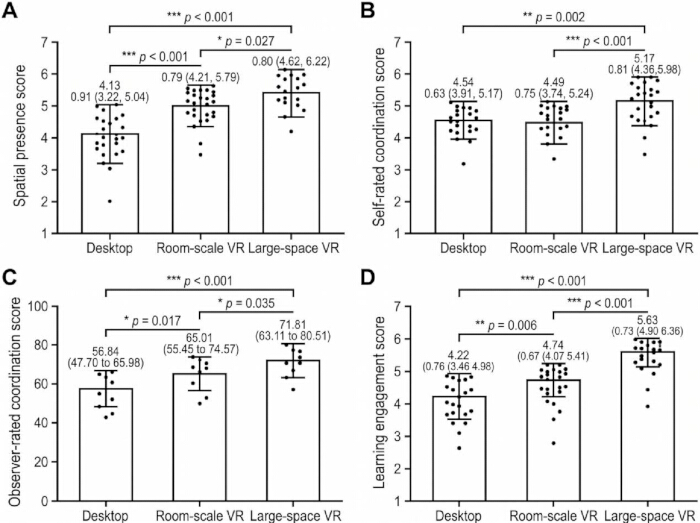
Figura 4: Resultados primários nas diferentes condições de treinamento. (A) Presença espacial. (B) Coordenação da equipe autoavaliada. (C) Coordenação da equipe avaliada por observador. (D) Engajamento na aprendizagem. A presença espacial, a coordenação da equipe autoavaliada e o engajamento na aprendizagem foram resultados ao nível dos participantes; a coordenação da equipe avaliada por observador foi analisada ao nível da equipe. As barras de erro indicam o desvio padrão. Clique aqui para visualizar uma versão maior desta figura.
Tabela 3: Resultados primários. Esta tabela resume a presença espacial, coordenação da equipe autoavaliada, coordenação da equipe avaliada por observador e engajamento na aprendizagem nas três condições de treinamento. Também são apresentados os modelos estatísticos inferenciais correspondentes e verificações de sensibilidade à taxa de descobertas falsas. Clique aqui para baixar esta tabela.
Coordenação da equipe
A coordenação da equipe autoavaliada foi analisada no nível do participante utilizando um modelo linear de efeitos mistos com a condição de treinamento como efeito fixo e o código da equipe como intercepto aleatório. O modelo revelou um efeito significativo da condição de treinamento, F(2, 39) = 9,96, p < 0,001. As médias marginais estimadas foram 4,54 no grupo desktop, 4,49 no grupo em escala de sala e 5,17 no grupo de grande espaço.
As comparações ajustadas por Tukey mostraram que a coordenação da equipe autoavaliada foi maior no grupo de espaço amplo do que no grupo de desktop, diferença média estimada = 0,63, IC 95%: 0,25 – 1,01, p = 0,002. O grupo de espaço amplo também obteve pontuação maior do que o grupo em escala de sala, diferença média estimada = 0,68, IC 95%: 0,29 – 1,07, p < 0,001. Os grupos de desktop e em escala de sala não diferiram significativamente, diferença média estimada = 0,05, IC 95%: −0,33 – 0,43, p = 0,942. Para comparação descritiva, as médias não ajustadas ± DP foram 4,54 ± 0,63 no grupo de desktop, 4,49 ± 0,75 no grupo em escala de sala e 5,17 ± 0,81 no grupo de espaço amplo. A ANOVA não ajustada produziu o mesmo padrão direcional, F(2, 120) = 10,84, p < 0,001, η2 = 0,153.
A coordenação da equipe avaliada pelo observador foi analisada no nível da equipe, conforme pré-especificado. A confiabilidade entre avaliadores ultrapassou o limiar pré-definido, com um coeficiente de correlação intraclasse de efeitos aleatórios bidirecionais de ICC = 0,84. Três gravações de equipes apresentaram diferenças totais nas pontuações dos observadores superiores a 12 pontos e foram resolvidas mediante revisão por consenso. A coordenação avaliada pelo observador diferiu significativamente entre as condições, F(2, 39) = 10,92, p < 0,001, η2 = 0,359. As pontuações médias no nível da equipe foram 56,84 ± 9,14 no grupo desktop, 65,01 ± 9,56 no grupo de escala ambiente e 71,81 ± 8,70 no grupo de grande espaço. Comparações ajustadas por Tukey mostraram coordenação avaliada pelo observador maior no grupo de grande espaço do que no grupo desktop, diferença média = 14,97, IC 95%: 7,33 – 22,61, p < 0,001. O grupo de grande espaço também obteve pontuação superior à do grupo de escala ambiente, diferença média = 6,80, IC 95%: 0,42 – 13,18, p = 0,035. O grupo de escala ambiente obteve pontuação superior à do grupo desktop, diferença média = 8,17, IC 95%: 1,31 – 15,03, p = 0,017. A coordenação autoavaliada e a avaliada pelo observador apresentaram a mesma ordenação entre os grupos, sendo que o grupo de grande espaço obteve as pontuações mais altas em ambas as medidas.
Comprometimento com a aprendizagem
O comprometimento com a aprendizagem foi analisado utilizando um modelo linear de efeitos mistos com a condição de treinamento como efeito fixo e o código da equipe como intercepto aleatório. O modelo revelou um efeito significativo da condição de treinamento, F(2, 39) = 37,46, p < 0,001. As médias marginais estimadas foram 4,22 no grupo desktop, 4,74 no grupo em escala de sala e 5,63 no grupo em espaço amplo. Comparações pareadas ajustadas por Tukey mostraram que o comprometimento foi maior no grupo em espaço amplo do que no grupo desktop, diferença média estimada = 1,41, IC 95%: 1,03 – 1,79, p < 0,001. O comprometimento também foi maior no grupo em espaço amplo do que no grupo em escala de sala, diferença média estimada = 0,89, IC 95%: 0,53 – 1,25, p < 0,001. O grupo em escala de sala obteve pontuação superior à do grupo desktop, diferença média estimada = 0,52, IC 95%: 0,15 – 0,89, p = 0,006.
Para comparação descritiva, as médias não ajustadas ± DP foram 4,22 ± 0,76 no grupo de ambiente de mesa, 4,74 ± 0,67 no grupo de ambiente em escala reduzida e 5,63 ± 0,73 no grupo de grande espaço. A ANOVA não ajustada mostrou o mesmo padrão, F(2, 119) = 40,00, p < 0,001, η2 = 0,402.
Verificações de sensibilidade da taxa de falsas descobertas para os desfechos primários
O procedimento de taxa de falsas descobertas de Benjamini-Hochberg foi aplicado nos quatro desfechos primários pré-especificados: presença espacial, coordenação da equipe autoavaliada, coordenação da equipe avaliada por observador e engajamento na aprendizagem. Todos os quatro desfechos primários permaneceram estatisticamente significativos após o ajuste. A verificação de sensibilidade da taxa de falsas descobertas produziu o mesmo padrão de desfechos primários observado nas análises principais.
Resultados do conhecimento e retenção
O conhecimento imediatamente após o treinamento foi analisado utilizando um modelo de efeitos mistos com a condição de treinamento como efeito fixo, o conhecimento pré-treinamento como covariável e o código da equipe como intercepto aleatório. O modelo ajustado mostrou um efeito de grupo não significativo para o conhecimento pós-treinamento, F(2, 39) = 2,14, p = 0,131. As médias marginais estimadas foram 20,12 para o grupo desktop, 20,96 para o grupo em escala de sala e 21,85 para o grupo em espaço amplo. Para comparação descritiva, as pontuações médias de conhecimento após o treinamento foram 20,09 ± 4,04 no grupo desktop, 21,00 ± 4,57 no grupo em escala de sala e 21,84 ± 3,95 no grupo em espaço amplo. A comparação entre grupos sem ajuste não foi estatisticamente significativa, F(2, 123) = 1,83, p = 0,165, η2 = 0,029.
O ganho de conhecimento da linha de base até a avaliação imediatamente após o treinamento foi avaliado como um resultado inferencial exploratório secundário. Os ganhos médios foram de 3,93 ± 2,88 pontos no grupo de desktop, 4,91 ± 2,12 pontos no grupo de escala ambiente e 6,30 ± 2,75 pontos no grupo de grande espaço. O efeito do grupo não ajustado foi significativo, F(2, 123) = 8,77, p < 0,001, η2 = 0,125. Comparações ajustadas por Tukey mostraram maior ganho de conhecimento no grupo de grande espaço em comparação com o grupo de desktop, diferença média = 2,37, IC 95%: 0,96 – 3,78, p < 0,001. O grupo de grande espaço também apresentou maior ganho do que o grupo de escala ambiente, diferença média = 1,39, IC 95%: 0,14 – 2,64, p = 0,026. Os grupos de escala ambiente e de desktop não diferiram significativamente, diferença média = 0,98, IC 95%: −0,31 – 2,27, p = 0,171.
Na avaliação de acompanhamento de duas semanas, o conhecimento de retenção foi analisado entre participantes com respostas válidas de retenção dentro da janela predeterminada entre o dia 13 e o dia 16. O modelo misto ajustado, controlando para o conhecimento prévio ao treinamento e incluindo o código da equipe como intercepto aleatório, mostrou um efeito de grupo não significativo, F(2, 39) = 1,68, p = 0,199. As pontuações médias de retenção foram 18,70 ± 4,55 no grupo desktop, 19,62 ± 4,37 no grupo em escala de cômodo e 20,42 ± 4,38 no grupo em grande espaço. A comparação entre grupos sem ajuste também não foi estatisticamente significativa, F(2, 119) = 1,53, p = 0,220, η2 = 0,025. Os desfechos secundários de aprendizagem são resumidos na Tabela 4.
Tabela 4: Resultados secundários de aprendizagem nas diferentes condições de treinamento. Esta tabela apresenta o conhecimento pré-treinamento, o conhecimento imediatamente após o treinamento, o ganho de conhecimento e a retenção do conhecimento após 2 semanas nas três condições de treinamento. São apresentados modelos mistos ajustados para os resultados secundários de aprendizagem. Clique aqui para baixar esta tabela.
Carga cognitiva e desconforto no simulador
A carga cognitiva foi analisada como um desfecho secundário. A carga cognitiva média foi de 4,22 ± 0,69 no grupo desktop, 4,49 ± 0,62 no grupo em escala ambiente e 4,13 ± 0,82 no grupo de grande espaço. O efeito do grupo não ajustado foi F(2, 123) = 2,92, p = 0,058, η2 = 0,045. Esse resultado não atingiu o limiar de significância pré-definido.
O desconforto no simulador variou entre as condições. O índice médio de desconforto pós-tarefa foi de 1,37 ± 0,71 no grupo desktop, 2,18 ± 0,79 no grupo de ambiente virtual em escala de sala e 2,42 ± 0,58 no grupo de grande espaço. O efeito do grupo sem ajuste foi significativo, F(2, 121) = 25,72, p < 0,001, η2 = 0,298. Os escores de desconforto foram mais altos nos dois grupos de realidade virtual do que no grupo desktop, embora os valores médios tenham permanecido na faixa leve. Nenhum participante atendeu ao critério pré-definido de interrupção de qualquer item de desconforto ≥7. Sete participantes apresentaram índice de desconforto pós-tarefa ≥5 e receberam contato para verificação da resolução dos sintomas em 24 h. Dentre esses participantes, quatro tinham índice de desconforto pós-tarefa >6 e também foram monitorados no laboratório por pelo menos 15 minutos antes de sair. Todos os sete participantes relataram resolução dos sintomas sem necessidade de encaminhamento médico. Nenhuma sessão foi interrompida devido ao desconforto no simulador, e nenhum evento adverso que exigisse cuidados clínicos foi registrado. A carga cognitiva e o desconforto no simulador são apresentadas na Figura 5.
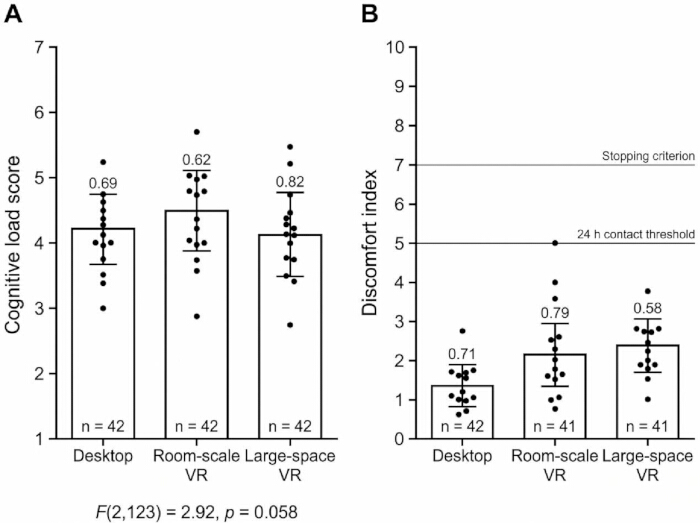
Figura 5: Carga cognitiva e desconforto no simulador ao longo das condições de treinamento. (A) Carga cognitiva, pontuada de 1 a 7, em que pontuações mais altas indicam maior carga de trabalho percebida. (B) Desconforto no simulador após a tarefa, pontuado de 0 a 10 e baseado em náusea, tontura, esforço ocular, dor de cabeça e desconforto no equilíbrio. As barras de erro indicam o desvio padrão. Clique aqui para visualizar uma versão maior desta figura.
Indicadores do processo da tarefa
Os indicadores do processo da tarefa foram utilizados para descrever o desempenho da equipe durante a tarefa colaborativa de treinamento de 20 min. A conclusão da tarefa foi de 71,4% no grupo desktop, 78,6% no grupo em escala de sala e 85,7% no grupo em grande espaço. O tempo médio de conclusão foi de 1.041,6 ± 162,4 s no grupo desktop, 984,3 ± 151,8 s no grupo em escala de sala e 931,7 ± 139,6 s no grupo em grande espaço. Como as equipes incompletas tiveram um limite de tempo de 1.200 s, o tempo de conclusão foi interpretado de forma descritiva.
O número médio de recursos corretos selecionados foi de 2,21 ± 0,70 no grupo de desktop, 2,43 ± 0,65 no grupo de escala ambiente e 2,64 ± 0,50 no grupo de grande espaço. O número médio de alertas de risco corretamente gerenciados foi de 1,93 ± 0,83, 2,21 ± 0,70 e 2,50 ± 0,65, respectivamente. O número médio de erros de trajeto foi de 2,07 ± 1,14 no grupo de desktop, 1,50 ± 0,94 no grupo de escala ambiente e 1,00 ± 0,78 no grupo de grande espaço. As interrupções por segurança foram infrequentes em todas as condições, com médias de 0,21 ± 0,43, 0,29 ± 0,47 e 0,36 ± 0,50, respectivamente. O status de conclusão da tarefa, tempo de conclusão, seleção correta de recursos, alertas de risco gerenciados corretamente, erros de trajeto e interrupções por segurança estão resumidos na Tabela 5.
Tabela 5: Indicadores do processo da tarefa e eventos de segurança. Esta tabela resume medidas objetivas de desempenho na tarefa, incluindo taxas de conclusão, erros de navegação no percurso e manuseio de riscos. Também são relatados o monitoramento de desconforto no simulador e eventos clínicos adversos registrados. Clique aqui para baixar esta tabela.
Associações entre presença, coordenação, engajamento e aprendizagem
As respostas psicométricas no nível dos participantes foram agregadas em médias de agrupamento no nível da equipe antes da integração com as medidas de coordenação avaliadas por observadores. A análise de correlação no nível da equipe revelou associações positivas entre presença espacial e engajamento na aprendizagem (r = 0.57), coordenação da equipe autoavaliada (r = 0.26) e coordenação avaliada por observadores (r = 0.32).
O padrão de correlação indicou sobreposição moderada entre presença, coordenação e engajamento, enquanto as correlações com o ganho de conhecimento foram menores. O padrão de correlação indicou sobreposição entre presença, coordenação e engajamento, enquanto as associações com o ganho de conhecimento foram menores. Essas análises foram exploratórias e não estabelecem trajetórias causais entre os resultados mensurados. A matriz de correlação é apresentada na Figura 6.
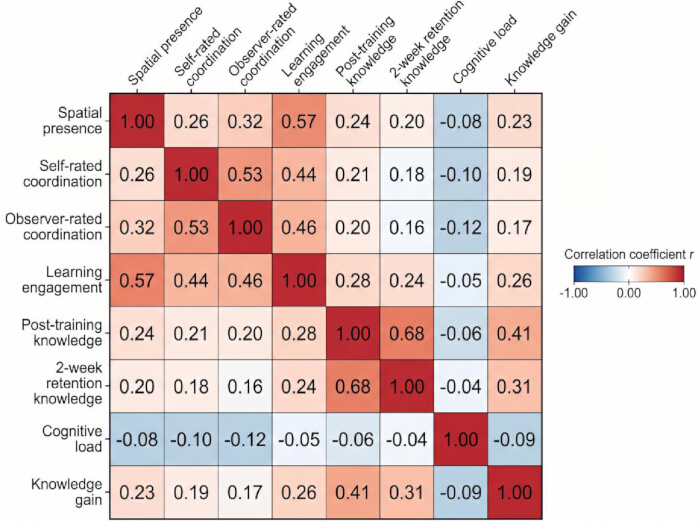
Figura 6: Matriz de correlação para presença, coordenação, engajamento e resultados de aprendizagem. O mapa de calor mostra os coeficientes de correlação de Pearson entre presença espacial, coordenação da equipe autoavaliada, coordenação da equipe avaliada por observador, engajamento na aprendizagem, conhecimento pós-treinamento, retenção do conhecimento após 2 semanas, carga cognitiva e ganho de conhecimento. Clique aqui para visualizar uma versão maior desta figura.
O grupo de realidade virtual colaborativa em grande espaço apresentou maior presença espacial, coordenação da equipe autoavaliada, coordenação da equipe avaliada por observador e engajamento na aprendizagem do que os grupos de comparação. Esses resultados principais permaneceram significativos após o controle do agrupamento por equipe e da correção da taxa de erro tipo I. Para os desfechos secundários, o ganho de conhecimento favoreceu o grupo de grande espaço, enquanto o conhecimento pós-treinamento ajustado e o conhecimento de retenção após duas semanas não diferiram significativamente entre as condições. A carga cognitiva não diferiu significativamente entre os grupos, e o desconforto simulador permaneceu leve em média, apesar dos escores mais elevados nas condições de realidade virtual.
DISPONIBILIDADE DE DADOS:
O conjunto de dados analítico com identificação removida, o dicionário de dados, as rubricas de pontuação e a sintaxe estatística utilizados para apoiar a reprodutibilidade estão disponíveis publicamente no repositório Zenodo - https://zenodo.org/records/21991446. Listas de verificação adicionais para relatórios, modelos dos instrumentos, regras de pontuação e documentação do conjunto de dados são fornecidos no Arquivo Suplementar 1.
Arquivo Suplementar 1: Materiais de Reprodutibilidade para o Estudo de Treinamento em Realidade Virtual Colaborativa em Ambiente Amplo. Este arquivo contém o questionário para participantes, o modelo do teste de conhecimento, a rubrica de coordenação avaliada por observador, o dicionário de dados, as regras de pontuação e limpeza, o esboço da sintaxe estatística, a estrutura do conjunto de dados analíticos com identificação removida e a lista de verificação para relatórios. Clique aqui para baixar este arquivo.
Discussão
Este estudo examinou se uma configuração de realidade virtual colaborativa co-localizada em grande espaço produzia experiências de treinamento diferentes da colaboração em desktop e da realidade virtual colaborativa distribuída em escala de sala. Os achados mais fortes e consistentes foram observados para presença espacial, coordenação da equipe e engajamento no aprendizado. Esses resultados são distintos: a presença espacial reflete o grau em que os participantes se percebiam localizados dentro do espaço de treinamento; a coordenação reflete a troca de informações, a execução de papéis e a recuperação de erros; e o engajamento reflete o envolvimento cognitivo e comportamental na tarefa. A condição de grande espaço produziu pontuações mais altas nos três domínios, após considerar o agrupamento em equipes e o ajuste da taxa de descoberta falsa. Esse padrão é consistente com a visão mais ampla de que a realidade virtual colaborativa atua não apenas como uma tecnologia de exibição, mas também como uma ecologia de tarefas na qual ação compartilhada, comunicação e estrutura ambiental conjuntamente moldam o comportamento de aprendizado15.
A presença espacial é relevante porque as três condições de treinamento diferiram na organização do movimento e na copresença. A condição com computador de mesa permitiu a colaboração sem posicionamento corporal imersivo. A condição distribuída em escala de sala ofereceu uma experiência visual imersiva e comunicação em tempo real entre a equipe, mas os participantes permaneceram em áreas de rastreamento separadas e pequenas. A condição em grande espaço acrescentou a cocomunicação física compartilhada, permitindo que os participantes se movessem, se orientassem e agissem dentro do mesmo ambiente rastreado. O aumento observado na presença espacial, portanto, não deve ser atribuído apenas ao espaço para caminhar, mas sim à configuração completa do treinamento, que combina movimento corporal, referência espacial compartilhada e visibilidade em tempo real da equipe. Essa interpretação está de acordo com pesquisas sobre presença, que mostram que sistemas imersivos podem fortalecer a presença quando contingências sensoriomotoras, atualização espacial e coerência ambiental reforçam a sensação de estar localizado dentro do ambiente mediado16. Os resultados de coordenação mostraram um padrão semelhante. O grupo em grande espaço demonstrou maior coordenação avaliada por si mesmos e por observadores. A coordenação autoavaliada pode ser influenciada pelo prazer ou pela novidade, enquanto a coordenação avaliada por observadores foi baseada no tempo visível da comunicação, execução de papéis, apoio mútuo, coordenação espacial e recuperação de erros. A informação espacial compartilhada pode, portanto, ter fornecido um campo de referência comum para organizar a ação da equipe. Esse padrão é consistente com pesquisas sobre aprendizagem colaborativa assistida por computador, indicando que a colaboração depende de canais de comunicação, representações compartilhadas, interdependência de tarefas e monitoramento do progresso da equipe17.
O engajamento na aprendizagem também aumentou no grupo do ambiente amplo, embora esse achado exija interpretação cautelosa em relação à eficácia da aprendizagem. A combinação de maior ganho imediato de conhecimento com resultados ajustados não significativos após o treinamento e na retenção indica que um engajamento experiencial mais forte não correspondeu a um conhecimento retido consistentemente mais sólido. Uma única exposição pode, portanto, produzir maior imersão e envolvimento comportamental sem necessariamente gerar diferenças duradouras na aquisição de conhecimento. As vantagens dos ambientes colaborativos em grande escala foram mais evidentes na coordenação espacial e no envolvimento situacional ativo, em vez da retenção cognitiva sustentada. O engajamento permanece como uma condição para a aprendizagem, e não como uma garantia de retenção. Pesquisas sobre aprendizagem imersiva indicam igualmente que a sensação de presença e o envolvimento podem apoiar a atenção e a participação na tarefa, enquanto a aprendizagem duradoura também depende do design instrucional, do feedback, do conhecimento prévio e das oportunidades para prática repetida18. A carga cognitiva não aumentou significativamente no grupo do ambiente amplo, apesar do movimento físico e da coordenação em equipe em tempo real exigidos por essa condição. A condição distribuída em escala de sala apresentou a carga cognitiva média mais alta, embora a diferença entre grupos não tenha atingido o limiar pré-definido de significância. A colaboração distribuída exigiu que os participantes se coordenassem por meio da fala enquanto atuavam em espaços pequenos e separados, o que potencialmente manteve as demandas de coordenação sem o referencial físico compartilhado disponível na condição de ambiente amplo. A teoria da carga cognitiva indica igualmente que a aprendizagem colaborativa é mais eficaz quando a estrutura da tarefa distribui o trabalho cognitivo sem acrescentar encargos comunicacionais desnecessários19.
O desconforto no simulador foi maior nas duas condições de realidade virtual do que na condição com desktop, embora as pontuações médias tenham permanecido leves. Nenhum participante atendeu ao critério de interrupção de qualquer item de desconforto atingindo 7, e nenhum evento adverso exigiu cuidados clínicos. A realidade virtual colaborativa em grande espaço co-localizado apresenta considerações de segurança porque combina exposição ao visor montado na cabeça, movimento corporal e proximidade entre membros da equipe. Os mecanismos de proteção implementados não eliminaram o desconforto, mas mantiveram os sintomas dentro de uma faixa gerenciável nesta amostra. Para uma implementação institucional mais ampla, são necessários procedimentos padronizados de solução de problemas. O ajuste adequado do fone de cabeça e a calibração da distância interpupilar são importantes para reduzir a fadiga ocular. A perda de rastreamento espacial ou o aumento da latência da rede exigem a imediata pausa da simulação, enquanto falhas nos canais de áudio exigem procedimentos locais de reinicialização de hardware. A segurança no movimento co-localizado também exige instruções restritas à locomoção por caminhada e limites físicos de delimitação para reduzir o risco de colisões. Esses procedimentos estão de acordo com a visão de que a ciberenjoo e o desconforto devem ser tratados como aspectos de projeto e monitoramento no treinamento em realidade virtual, e não como efeitos adversos incidentais20.
O estudo também possui valor metodológico, pois a comparação foi além de um simples contraste entre realidade virtual e não realidade virtual. A colaboração em desktop, a colaboração imersiva distribuída e a colaboração em grande espaço co-localizada foram avaliadas como configurações distintas. Esse delineamento permitiu examinar as mudanças associadas à colaboração imersiva compartilhada espacialmente, e não apenas à imersão visual ou à coordenação verbal isoladamente. As diferenças observadas foram mais acentuadas para presença, coordenação e engajamento, e menores para o conhecimento retido. Esse padrão não sustenta uma conclusão geral de que sistemas maiores ou mais imersivos melhorem todos os resultados de aprendizagem. A realidade virtual colaborativa em grande espaço co-localizada pode, portanto, ser mais aplicável quando o treinamento exigir orientação espacial, distribuição de papéis, monitoramento mútuo em tempo real e movimento coordenado, em vez de simples recordação de fatos21.
Várias limitações devem ser consideradas. O estudo foi conduzido em uma única instituição, com participantes jovens, graduandos e pós-graduandos, o que limita a generalização para treinandos mais velhos, equipes profissionais de emergência e aprendizes com pouca familiaridade com tecnologia. A tarefa envolveu logística de emergência estruturada e navegação espacial, e padrões diferentes podem ocorrer em domínios com menor dependência espacial. A avaliação do desempenho baseou-se em questionários subjetivos, pontuações atribuídas por observadores humanos e registros básicos do sistema. A telemetria comportamental detalhada, incluindo frequência de comunicação, tempo acumulado de fala, sincronização de movimentos e comportamento direcionado do olhar, não foi registrada, o que limita a quantificação dos mecanismos detalhados da interação em equipe e da eficiência da coordenação. Investigações futuras devem incorporar medidas fisiológicas, incluindo variabilidade da frequência cardíaca contínua e atividade eletrodérmica, juntamente com telemetria espacial abrangente. Grupos-controle com controle físico independente e não colaborativo de movimento também são necessários para distinguir os efeitos associados à colaboração interpessoal daqueles associados ao aumento da locomoção física. A coorte de participantes foi definida com base na viabilidade e recrutada a partir de uma única instituição acadêmica, e os instrumentos psicométricos e as rubricas observacionais foram desenvolvidos ou adaptados para este paradigma imersivo. Embora a confiabilidade interna e a validade de construto tenham sido avaliadas, medidas autorrelatadas permanecem suscetíveis a efeitos de novidade. A integração de dados de questionários em nível individual com pontuações observadas em nível de equipe também introduziu complexidade estrutural; a agregação por média de agrupamentos e modelagem de efeitos mistos foram utilizadas para alinhar os níveis analíticos, mas estudos futuros devem priorizar a coleta paralela de dados multimodais na mesma unidade operacional de análise. O período de acompanhamento de duas semanas não estabelece se os efeitos persistem por períodos mais longos ou se transferem para o desempenho no mundo real. Além disso, as três configurações de treinamento foram comparadores ambientais holísticos, e não componentes de um delineamento fatorial completo. A imersão visual, a locomoção física, a consciência corporal e a co-localização física compartilhada permaneceram confundidas, impedindo a atribuição das diferenças observadas a qualquer componente isolado. Estudos futuros devem separar esses fatores por meio de manipulação fatorial e incorporar exposições repetidas ao treinamento e tarefas de transferência operacional para determinar se as melhorias na coordenação persistem em ambientes clínicos ou industriais22.
Divulgações
Os autores não têm conflitos de interesse.
CONTRIBUIÇÃO DOS AUTORES:
Fu Bo concebeu o estudo, desenvolveu os protocolos experimentais, gerenciou a coleta de dados e redigiu a versão inicial do manuscrito. Meng Na supervisionou a implementação técnica das plataformas de simulação de realidade virtual, contribuiu com a programação estatística e co-revisou o manuscrito quanto ao conteúdo intelectual crítico. Ambos os autores aprovaram a versão final para submissão
Agradecimentos
Os autores gostariam de agradecer à Escola de Inteligência e Engenharia da Universidade Shenyang City pelo apoio a esta pesquisa. Um agradecimento especial é dirigido ao Laboratório Chave de Inovação Tecnológica em Interação Virtual-Real e Gêmeo Digital por fornecer os equipamentos e as instalações espaciais necessários para conduzir os experimentos de realidade virtual colaborativa em espaços amplos. Eles também expressam sua sincera gratidão a todos os estudantes de graduação e pós-graduação que se voluntariaram para participar das sessões de treinamento imersivas. O envolvimento e a cooperação deles foram essenciais para a conclusão bem-sucedida deste estudo. Este trabalho foi apoiado pelo Programa de Pesquisa Básica Aplicada de Liaoning 2025 (Grant No. 2025JH2/101330049); pela Fundação de Ciências Naturais da Província de Liaoning 2024 (Grant No. 2024-MS-255); pelos Fundos de Pesquisa Fundamental para Universidades do Departamento Provincial de Educação de Liaoning 2025 (Grant No. LJ212513220006); e pelos Fundos de Pesquisa Fundamental para Universidades do Departamento Provincial de Educação de Liaoning 2024 (Grant No. LJ212413220001).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Formulário de contato para resolução de sintomas em 24 h | Formulário de acompanhamento desenvolvido pelo estudo | Versão 1.0 | Utilizado para documentar a resolução de sintomas em participantes com índice de desconforto pós-tarefa ≥5 |
| Painéis acústicos divisórios | Fornecedor genérico de mobiliário laboratorial | Divisória acústica portátil padrão, altura aproximada de 160–180 cm | Utilizado para separar participantes em desktop e prevenir comunicação paralela |
| Lenços desinfetantes sem álcool | Fornecedor genérico de higiene laboratorial | Lenços desinfetantes seguros para dispositivos | Utilizados para limpar displays montados na cabeça, controles, microfones, teclados, mouses e superfícies compartilhadas entre sessões |
| Conjunto de dados analítico | Arquivo gerado pelo estudo | analytical_dataset.csv | Conjunto de dados anonimizado por participante, com uma linha por participante |
| Questionário basal | Questionário desenvolvido pelo estudo | Versão 1.0, finalizado em fevereiro de 2025 | Utilizado para coletar informações demográficas, experiência prévia com realidade virtual, familiaridade com jogos e experiência prévia em treinamento em equipe |
| Fita de demarcação de limites | Fornecedor genérico de segurança laboratorial | Fita adesiva antiderrapante para piso | Utilizada para marcar áreas em escala de ambiente de 3 m × 3 m e a área ampla de treinamento de 8 m × 8 m |
| Escala de carga cognitiva | Formulário adaptado pelo estudo para avaliação de carga de trabalho | Versão com 5 itens | Utilizada imediatamente após o treinamento; os itens abrangem demanda mental, demanda física, pressão de tempo, esforço e frustração |
| Mouse de computador | Fornecedor genérico de equipamentos de informática | Mouse padrão com fio ou sem fio | Utilizado para interação na condição de simulação colaborativa em desktop |
| Registro de limpeza de dados | Arquivo gerado pelo estudo | data_cleaning_log.xlsx | Registra correções de pontuações, verificações de dados ausentes, reconciliação de pontuações por observadores e decisões de bloqueio do conjunto de dados |
| Dicionário de dados | Arquivo gerado pelo estudo | Versão 1.0 | Define nomes de variáveis, rótulos, regras de codificação, intervalos de pontuação, regras para valores ausentes e níveis de análise |
| Monitor de desktop | Fornecedor genérico de equipamentos de informática | Monitor de 24 polegadas, resolução mínima de 1.920 × 1.080 | Utilizado na condição de simulação colaborativa em desktop |
| Estação de trabalho de desktop | Fornecedor genérico de equipamentos de informática | Configuração mínima: processador Intel i5 ou equivalente, 16 GB de RAM, placa de vídeo dedicada, Windows 10 ou posterior | Utilizada para simulação em desktop, monitoramento local, aplicação de questionários e processamento de dados |
| Coberturas descartáveis para fones de ouvido | Fornecedor genérico de produtos de higiene | Coberturas descartáveis padrão para displays montados na cabeça | Utilizadas pela higiene dos participantes durante as sessões de realidade virtual |
| Lista de verificação de parada de emergência | Formulário de segurança desenvolvido pelo estudo | Versão 1.0 | Utilizada para documentar critérios de interrupção, eventos de desconforto, interrupções de segurança e acompanhamento de resolução de sintomas |
| Armazenamento institucional criptografado | Instituição participante | Pasta de projeto criptografada com acesso controlado | Utilizada para armazenar conjuntos de dados anonimizados, arquivos de pontuação, gravações e arquivos de sintaxe |
| Rubrica de coordenação avaliada por observador | Rubrica de avaliação desenvolvida pelo estudo | Versão com 5 domínios e 100 pontos | Utilizada por dois observadores cegos para avaliar o momento da comunicação, execução de papéis, apoio mútuo, coordenação espacial e recuperação de erros |
| Conjunto de dados de pontuações por observador | Arquivo gerado pelo estudo | observer_scores.csv | Contém as pontuações por domínio antes da média ou revisão de consenso |
| Plataforma online de questionários | Sistema institucional ou licenciado de pesquisas | Versão ativa durante a coleta de dados em 2025 | Utilizada para triagem, questionário basal, questionário pós-treinamento e teste de retenção após duas semanas |
| Pacote de comparação par a par | Pacote R | emmeans versão compatível com R 4.3.2 | Utilizado para médias marginais estimadas e comparações par a par ajustadas por Tukey |
| Termo de consentimento do participante | Documento aprovado pelo estudo | Versão aprovada por ética | Utilizado antes da avaliação basal e randomização |
| Questionário do participante | Questionário desenvolvido pelo estudo | Versão 1.0 | Inclui itens de triagem, itens basais, presença espacial, coordenação em equipe autoavaliada, engajamento no aprendizado, carga cognitiva e escalas de desconforto |
| Cadeiras portáteis | Fornecedor genérico de mobiliário laboratorial | Cadeira laboratorial padrão | Utilizadas para acomodar os participantes durante o consentimento, preenchimento de questionários, recuperação e monitoramento pós-tarefa |
| Software estatístico R | Fundação R para Computação Estatística | R versão 4.3.2 | Utilizado para limpeza de dados, análise de confiabilidade, modelos de efeitos mistos, análise de correlação e preparação de figuras |
| Pacote de análise de confiabilidade | Pacote R | psych versão compatível com R 4.3.2 | Utilizado para calcular alfa de Cronbach’s e coeficiente de correlação intraclasse |
| Áreas de rastreamento em escala de ambiente | Laboratório da instituição participante | Três espaços separados de 3 m × 3 m demarcados | Utilizados para a condição de realidade virtual colaborativa distribuída em escala de ambiente |
| Formulário de monitoramento de segurança | Formulário desenvolvido pelo estudo | Versão 1.0 | Utilizado para registrar pontuações de desconforto, travessias de limites, interrupções de rastreamento e status de recuperação |
| Software de gravação de tela | Software comercial genérico ou de código aberto para gravação de tela | Versão ativa durante a coleta de dados em 2025 | Utilizado para gerar gravações padronizadas para avaliação de coordenação por observadores |
| Lista de verificação da sessão | Lista de verificação desenvolvida pelo estudo | Versão 1.0 | Utilizada para documentar presença, confirmação de elegibilidade, configuração de equipamentos, verificações de segurança, conclusão da tarefa e interrupções |
| Escala de desconforto do simulador | Lista de sintomas desenvolvida pelo estudo | Versão com 5 itens, de 0–10 | Utilizada antes da exposição, após a orientação e imediatamente após o treinamento |
| Escala de presença espacial | Questionário adaptado pelo estudo | Versão com 8 itens | Utilizada imediatamente após o treinamento; faixa de resposta de 1–7 |
| Software estatístico SPSS | IBM Corp. | IBM SPSS Statistics versão 29.0 | Utilizado para estatísticas descritivas, ANOVA, ANOVA de Welch, testes qui-quadrado e verificações de pressupostos |
| Arquivo de sintaxe estatística | Arquivo gerado pelo estudo | Arquivo de sintaxe R, Versão 1.0 | Utilizado para reproduzir a limpeza de dados, modelos de efeitos mistos, ANOVA, análise de correlação e geração de resultados |
| Módulo de exportação de logs do sistema | Função de exportação desenvolvida pelo estudo | Versão 1.0, travada antes da coleta formal de dados | Exporta horário de início da tarefa, horário de término da tarefa, status de conclusão, seleções de objetos, respostas a riscos, erros de rota e interrupções |
| Conjunto de dados em nível de equipe | Arquivo gerado pelo estudo | team_level_dataset.csv | Contém pontuações de coordenação avaliadas por observadores e indicadores de processo da tarefa no nível da equipe |
| Sistema de rastreamento de realidade virtual | Fornecedor comercial de hardware de realidade virtual | Compatível com o headset e controles selecionados | Utilizado para rastrear a posição do participante e movimentos das mãos |
| Ambiente virtual de treinamento | Software de treinamento personalizado | Versão 1.0, travado antes da coleta formal de dados | Apresenta o cenário colaborativo de logística de emergência e navegação espacial |
| Módulo de comunicação por voz | Módulo de comunicação integrado ou embutido | Versão travada antes da coleta formal de dados | Utilizado para canais de comunicação por voz designados para a equipe |
Referências
- Dede C. Immersive interfaces for engagement and learning. Science. 2009;323(5910):66-69.
- Radianti J, Majchrzak TA, Fromm J, Wohlgenannt I. A systematic review of immersive virtual reality applications for higher education: Design elements, lessons learned, and research agenda. Comput Educ. 2020;147:103778. https://doi.org/10.1016/j.compedu.2019.103778
- Cummings JJ, Bailenson JN. How immersive is enough A meta-analysis of the effect of immersive technology on user presence. Media Psychol. 2016;19(2):272-309.
- Makransky G, Petersen GB. The Cognitive Affective Model of Immersive Learning (CAMIL): A theoretical research-based model of learning in immersive virtual reality. Educ Psychol Rev. 2021;33(4):937-958.
- Dillenbourg P. What do you mean by collaborative learning In: Dillenbourg P, editor. Collaborative-learning: Cognitive and computational approaches. Oxford: Elsevier; 1999. p. 1-19.
- van der Meer N, van der Werf V, Brinkman WP, Specht M. Virtual reality and collaborative learning: A systematic literature review. Front Virtual Real. 2023;4:1159905. https://doi.org/10.3389/frvir.2023.1159905
- Johnson-Glenberg MC. Immersive VR and education: Embodied design principles that include gesture and hand controls. Front Robot AI. 2018;5:81. https://doi.org/10.3389/frobt.2018.00081
- Kirschner F, Paas F, Kirschner PA. A cognitive load approach to collaborative learning: United brains for complex tasks. Educ Psychol Rev. 2009;21(1):31-42.
- Fredricks JA, Blumenfeld PC, Paris AH. School engagement: Potential of the concept, state of the evidence. Rev Educ Res. 2004;74(1):59-109.
- Kourtesis P, Linnell J, Amir R, Argelaguet F, MacPherson SE. Cybersickness in virtual reality: The role of individual differences, cognitive functions, and virtual reality locomotion. Virtual Worlds. 2024;3(1):62-93.
- Dalgarno B, Lee MJW. What are the learning affordances of 3-D virtual environments Br J Educ Technol. 2010;41(1):10-32.
- Schubert T, Friedmann F, Regenbrecht H. The experience of presence: Factor analytic insights. Presence Teleoper Virtual Environ. 2001;10(3):266-281.
- O’Brien HL, Cairns P, Hall M. A practical approach to measuring user engagement with the refined User Engagement Scale (UES) and new User Engagement Scale Short Form (UES-SF). Int J Hum-Comput Stud. 2018;112:28-39.
- Hart SG, Staveland LE. Development of NASA-TLX (Task Load Index): Results of empirical and theoretical research. In: Hancock PA, Meshkati N, editors. Human mental workload. Amsterdam: North-Holland; 1988. p. 139-183.
- De Back TT, Tinga AM, Nguyen P, Louwerse MM. Learning in immersed collaborative virtual environments: Design and implementation. Interact Learn Environ. 2023;31(8):5364-5382.
- Slater M, Sanchez-Vives MV. Enhancing our lives with immersive virtual reality. Front Robot AI. 2016;3:74. https://doi.org/10.3389/frobt.2016.00074
- Roschelle J, Teasley SD. The construction of shared knowledge in collaborative problem solving. In: O’Malley C, editor. Computer supported collaborative learning. Berlin: Springer; 1995. p. 69-97.
- Merchant Z, Goetz ET, Cifuentes L, Keeney-Kennicutt W, Davis TJ. Effectiveness of virtual reality-based instruction on students' learning outcomes in K-12 and higher education: A meta-analysis. Comput Educ. 2014;70:29-40.
- Sweller J. Cognitive load during problem solving: Effects on learning. Cogn Sci. 1988;12(2):257-285.
- Stanney KM, Kennedy RS, Drexler JM, editors. Cybersickness is not simulator sickness. Proceedings of the Human Factors and Ergonomics Society Annual Meeting; 1997.
- Lindgren R, Johnson-Glenberg M. Emboldened by embodiment: Six precepts for research on embodied learning and mixed reality. Educ Res. 2013;42(8):445-452.
- Howard MC. A meta-analysis and systematic literature review of virtual reality rehabilitation programs. Comput Hum Behav. 2017;70:317-327.