Este estudo propõe um modelo híbrido de previsão de custos para redes elétricas que combina cotas de custos físicos com ajustes dinâmicos de fatores macroeconômicos e tecnológicos e compensação de resíduos baseada em XGBoost. Com precisão de 2,34% de MAPE, ele equilibra acurácia e interpretabilidade, atendendo às necessidades de transparência regulatória no estabelecimento de tarifas.
Artigo de investigação
Previsão Retrospectiva Utilizando Dados de Grade Provincial e um Modelo Híbrido Físico-IA Baseado em Cotas
Neste artigo
Resumo
Resumo
A transição energética global e as contínuas reformas do mercado de eletricidade exigem que as empresas de rede elétrica equilibrem o fornecimento confiável de energia com regulamentações tarifárias de transmissão e distribuição cada vez mais rigorosas. Os métodos tradicionais de orçamento baseados em extrapolação histórica frequentemente não refletem a base física das operações dos ativos, enquanto modelos de aprendizado de máquina orientados por dados alcançam alta precisão preditiva, mas carecem da transparência necessária para a verificação regulatória dos custos. Para abordar o compromisso entre precisão da previsão e interpretabilidade, este estudo propõe um modelo híbrido de previsão de custos baseado em cotas de custo. A estrutura utiliza cotas operacionais padronizadas como base física para o orçamento e incorpora um mecanismo dinâmico de evolução das cotas impulsionado por condições macroeconômicas e progresso tecnológico. O Extreme Gradient Boosting (XGBoost) é empregado para capturar os resíduos não lineares além das estimativas baseadas em cotas, enquanto o SHAP (Shapley Additive exPlanations) é utilizado para interpretar a contribuição dos principais fatores de custo. O modelo foi avaliado utilizando 16 anos de dados operacionais anônimos de uma rede elétrica provincial na China. Ele alcançou um erro percentual absoluto médio (MAPE) de 2,34%, reduzindo os erros de previsão em 61,8%, 46,6% e 34,1% em comparação com os modelos SARIMAX, XGBoost isolado e Attention-LSTM, respectivamente. A estrutura proposta integra princípios de cota de custo de engenharia com inteligência artificial explicável, fornecendo tanto previsões precisas de custos de longo prazo quanto uma ferramenta de apoio à decisão transparente para a verificação regulatória de custos permitidos.
Introdução
A transição energética global está remodelando a gestão de ativos e as práticas operacionais das redes elétricas por meio da integração de geração renovável distribuída, aumento de eventos climáticos extremos e implantação generalizada de tecnologias IoT, tudo o que exige maior flexibilidade operacional e recursos de manutenção para garantir a confiabilidade do sistema1,2. Ao mesmo tempo, os reguladores de eletricidade têm intensificado a supervisão das tarifas de transmissão e distribuição por meio de estruturas como a RIIO do Reino Unido e as revisões da taxa de retorno da Comissão Federal Reguladora de Energia dos EUA, enfatizando a transparência na justificativa de custos3. A China adotou de forma semelhante um mecanismo regulatório de "custo permitido mais retorno razoável", exigindo que as concessionárias demonstrem vínculos claros entre atividades de engenharia e despesas financeiras4. No entanto, as concessionárias frequentemente carecem de ferramentas quantitativas transparentes que conectem as operações físicas dos ativos com previsões de custos, limitando a eficácia da verificação regulatória de custos5.
As abordagens de previsão existentes apresentam limitações importantes neste ambiente6. Métodos tradicionais, incluindo orçamento incremental e modelos baseados em ARIMA, assumem padrões históricos relativamente estáveis e frequentemente apresentam desempenho insatisfatório diante de mudanças estruturais causadas por flutuações econômicas ou condições climáticas extremas7. Por outro lado, modelos modernos de aprendizado de máquina, como arquiteturas LSTM e Transformer, oferecem alta precisão preditiva para previsões de curto prazo, mas carecem da interpretabilidade engenheirada necessária para a tomada de decisões regulatórias8,9. Embora abordagens híbridas recentes de previsão combinem técnicas estatísticas e de aprendizado de máquina, geralmente ignoram as cotações padronizadas de custos de engenharia que sustentam os sistemas contábeis de redes elétricas10. Para superar essas limitações, este estudo propõe um framework híbrido orientado por cotas que combina a evolução dinâmica de cotas com correção de resíduos baseada em aprendizado de máquina, preservando a interpretabilidade engenheirada enquanto melhora a precisão da previsão.
Uma das principais linhas de pesquisa decorre da regulação por incentivos em setores de monopólio natural, incluindo o mecanismo RPI-X do Reino Unido e o quadro de verificação de custos permitidos da China11. Esses estudos avaliam principalmente a eficiência operacional utilizando a Análise de Envoltória de Dados (DEA) e a Análise Estocástica de Fronteira (SFA)12. Pesquisas anteriores examinaram as relações de longo prazo entre investimento em capital (CAPEX), despesa operacional (OPEX) e eficiência de custos para apoiar a regulação tarifária13,14. Embora essas abordagens forneçam insights valiosos em nível macroeconômico, seus resultados são geralmente expressos como escores de eficiência relativa, e não como previsões monetárias adequadas ao orçamento anual15,16. Além disso, os modelos de fronteira geralmente assumem estruturas de ativos físicos e condições operacionais relativamente estáveis, o que limita sua capacidade de capturar mudanças abruptas nos custos provocadas pelo envelhecimento dos ativos, substituição da infraestrutura ou crescimento rápido da demanda17,18.
Uma segunda linha de pesquisa concentra-se em modelos preditivos baseados em estatística e inteligência artificial. Estudos iniciais utilizaram regressão linear múltipla e modelos autorregressivos integrados de média móvel com variáveis exógenas (ARIMAX) para previsão de custos19. Mais recentemente, a regressão por vetores de suporte, florestas aleatórias, modelos XGBoost, LSTM e Transformer melhoraram substancialmente o desempenho da previsão ao explorar relações não lineares e espaços de características de alta dimensionalidade20,21,22. Essas abordagens frequentemente incorporam indicadores macroeconômicos, como demanda de eletricidade, índices de preços ao produtor (PPI) e variáveis climáticas23. No entanto, os custos operacionais da rede elétrica decorrem de atividades de engenharia, deterioração de ativos, programação de manutenção e decisões gerenciais, e não apenas de variáveis macroeconômicas24. Consequentemente, modelos puramente baseados em dados frequentemente funcionam como "caixas pretas", dificultando a explicação dos custos previstos durante revisões regulatórias ou verificação de custos permitidos25,26.
A gestão de cotações de custos de engenharia oferece uma solução potencial para esse desafio27. A contabilidade baseada em atividades (ABC) há muito depende de cotações operacionais padronizadas para estimar as necessidades de mão de obra, materiais, equipamentos e manutenção em operações rotineiras da rede elétrica28. Grandes concessionárias chinesas desenvolveram bancos de dados abrangentes de cotações que cobrem atividades de inspeção, manutenção, testes, reparos e substituição de equipamentos. No entanto, essas normas de engenharia são utilizadas principalmente para liquidação de projetos e auditorias, e não para previsões dinâmicas de longo prazo29,30. Além disso, as normas de cotação geralmente são revisadas apenas a cada vários anos, o que as torna insuficientemente responsivas às mudanças nos preços das commodities, ao progresso tecnológico e às práticas operacionais31. Aplicar sistemas de cotação em milhões de ativos distribuídos também apresenta desafios computacionais substanciais para previsões em larga escala32.
Apesar dos avanços significativos nas previsões estatísticas, aprendizado de máquina e gerenciamento de custos de engenharia, nenhuma estrutura existente integra efetivamente cotações padronizadas de custos de engenharia, ajuste dinâmico de macroeconomia e aprendizado de máquina explicável em um modelo unificado de previsão para verificação regulatória de custos. Levantou-se a hipótese de que a combinação de cotações de custos dinamicamente evolutivas com aprendizado residual baseado em XGBoost pode melhorar a precisão da previsão de longo prazo, ao mesmo tempo que preserva a transparência de engenharia necessária para a tomada de decisões regulatórias. Para testar essa hipótese, foi desenvolvida uma estrutura híbrida de previsão orientada por cotas, que integra modelagem física de custos, mecanismos de ajuste macroeconômico e tecnológico, compensação residual com XGBoost e interpretação do modelo baseada em SHAP. A abordagem proposta tem como objetivo fornecer tanto previsões precisas de custos de longo prazo quanto evidências transparentes para apoiar a verificação de custos permitidos sob a regulação moderna do mercado de eletricidade.
Protocolo
Este estudo utilizou dados operacionais e financeiros anonimizados coletados de uma rede elétrica provincial no leste da China. Todos os dados foram agregados e desidentificados antes da análise, e nenhuma informação pessoal identificável ou sensível em nível individual foi incluída. Portanto, não foi necessária aprovação ética. O acesso e a análise dos dados cumpriram as regulamentações aplicáveis de proteção de dados e os acordos institucionais que regem as informações do setor elétrico.
Visão geral da estrutura de previsão
Para integrar abordagens de previsão baseadas na física e orientadas por dados, foi desenvolvido um framework híbrido de previsão que combina cotações de custos de engenharia com aprendizado de máquina. Em vez de simplesmente combinar múltiplos algoritmos, o framework segue o princípio de que modelos físicos estabelecem a previsão de referência, enquanto o aprendizado de máquina compensa os erros residuais. Esse design garante que o processo de previsão seja fundamentado nos mecanismos físicos subjacentes às atividades de produção e operação da rede elétrica, em vez de depender exclusivamente da extrapolação de custos históricos.
A estrutura estabelece inicialmente um mapeamento hierárquico entre ativos da rede elétrica, atividades operacionais padronizadas e contas de custos financeiros. Os custos de produção e operação são tratados como representações monetárias dos recursos consumidos por ativos físicos — incluindo subestações, linhas de transmissão, alimentadores de distribuição, dispositivos de medição e equipamentos digitais de inspeção — durante atividades rotineiras, como inspeção, manutenção, testes, reparos e substituições. As cotas de custo funcionam como elo entre as cargas de trabalho de engenharia mensuráveis e as despesas financeiras correspondentes.
Conforme ilustrado na Figura 1, as cotas de custo funcionam como unidades contábeis padronizadas incorporadas em todo o processo de operação e manutenção de ativos, em vez de regras abstratas de alocação financeira. As cargas de trabalho dos ativos no nível inferior são convertidas em cotas operacionais padronizadas e posteriormente associadas a categorias de custo, incluindo mão de obra, materiais, equipamentos de construção, serviços terceirizados e suprimentos de emergência. Esse mapeamento hierárquico preserva a interpretabilidade técnica e a rastreabilidade regulatória durante todo o processo de previsão e fornece a base física para a construção do modelo estático de cota de referência.
Visão geral do fluxo de trabalho metodológico
A estrutura de previsão proposta consiste em três etapas sequenciais: (1) construção de uma linha de base física utilizando cotas de carga de trabalho por ativo, (2) evolução dinâmica das cotas de custo por meio de ajustes macroeconômicos e tecnológicos e (3) compensação baseada em aprendizado de máquina para capturar efeitos não lineares sistemáticos. Conforme ilustrado na Figura 1, a estrutura estabelece um mapeamento hierárquico dos ativos e atividades operacionais padronizadas no nível inferior até as previsões de custos de produção e operação. Os detalhes de implementação de cada etapa são descritos nas subseções a seguir.
Modelo de custo básico físico baseado em cargas de trabalho em nível de ativo
A produção e o custo operacional de uma rede elétrica, Ctotal, compreendem despesas associadas a múltiplas atividades comerciais, incluindo operação de subestações, manutenção de linhas de transmissão, gerenciamento da rede de distribuição, atendimento ao cliente e sistemas de apoio. Neste estudo, assume-se que o custo operacional de referência é determinado pela carga de trabalho gerada por cada atividade operacional padronizada e pela sua respectiva cota de custo.
O custo básico estático é calculado como:
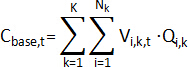 (1)
em que Vi,k,t denota a carga de trabalho associada à tarefa operacional ou ao ativo i dentro da categoria empresarial k durante o período t, e Qi,k representa o custo unitário padronizado correspondente definido pelo sistema de cota de custo de engenharia. A categoria empresarial inclui funções operacionais principais, como manutenção de subestações, inspeção de linhas de transmissão, operação da rede de distribuição e atendimento ao cliente. A dupla somatória agrega os custos de todas as atividades operacionais padronizadas para estimar a despesa teórica de referência necessária para manter a operação normal da rede.
A Equação (1) estabelece a relação física entre cargas de trabalho de engenharia e despesas financeiras ao associar atividades operacionais padronizadas diretamente a contas de custo. Diferentemente dos modelos puramente estatísticos de previsão, esta formulação fornece uma linha de base de engenharia interpretável que serve como fundamento para ajustes dinâmicos subsequentes de cotas e correção residual baseada em aprendizado de máquina. A equação foi desenvolvida a partir das práticas operacionais e do sistema de cotas de custo utilizados por empresas provinciais de rede elétrica na China. Tabela 1 resume a notação utilizada na Equação (1), incluindo carga de trabalho (Vi,k,t), custo unitário padronizado (Qi,k), número de tarefas operacionais (Nk) e índice de categoria de negócio (k).
Mecanismo dinâmico de evolução de cotas sob perturbações ambientais externas
As cotas de custo padronizadas (Qi,k) fornecem uma referência fisicamente interpretável, mas não levam em conta mudanças nas condições macroeconômicas ou no progresso tecnológico. Para melhorar sua aplicabilidade a longo prazo, foi introduzido um mecanismo de evolução dinâmica para ajustar as cotas de referência em resposta tanto à inflação de preços quanto aos ganhos de eficiência impulsionados pela tecnologia.
O primeiro ajuste leva em conta as alterações nos custos de aquisição decorrentes da inflação macroeconômica. A operação e manutenção da rede elétrica dependem fortemente de materiais em grande escala, incluindo cobre, alumínio e aço silício, cujos preços estão estreitamente relacionados às flutuações no Índice de Preços ao Produtor (PPI). Como  é um índice com valor base de 100, ele é inicialmente convertido em uma taxa de inflação padronizada:
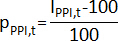 (2)
Com base nisso, a função de correção de preço  é definida como:
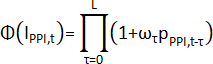 (3)
em que  é um vetor de pesos defasado de comprimento L que satisfaz
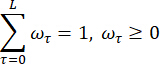
A estrutura de defasagem representa a transmissão retardada da inflação macroeconômica para os custos de aquisição na cadeia de suprimentos da rede elétrica. A conversão do índice IGP em uma taxa de inflação padronizada preserva o efeito cumulativo das alterações de preços, ao mesmo tempo que evita o viés de escala associado ao uso direto dos valores do índice. As equações (2) e (3) foram adaptadas de modelos estabelecidos de ajuste de inflação macroeconômica, com a estrutura de defasagem calibrada para os ciclos de aquisição do setor elétrico33,34.
O progresso tecnológico foi incorporado por meio de um fator de redução de custos que refletiu melhorias na eficiência operacional decorrentes de avanços como inspeção por veículos aéreos não tripulados, robótica inteligente e tecnologias digitais de manutenção. O fator de ajuste tecnológico é definido como:
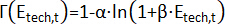 (4)
Nesta parte, α e β são coeficientes empíricos de elasticidade estimados a partir de dados históricos em painel utilizando mínimos quadrados não lineares. Para garantir que o fator de progresso tecnológico represente sempre uma redução razoável no custo unitário da cota, o processo de estimação de parâmetros restringe 0 < Γ(Etech,t) ≤ 1. Deve-se notar que esse fator reflete principalmente a melhoria de eficiência de longo prazo decorrente da substituição por tecnologia madura. A Equação (4) é original neste trabalho, adaptando o conceito de curva de aprendizado da literatura sobre custos de tecnologias energéticas35,36 para operações de manutenção de redes. Custos adicionais que podem surgir no estágio inicial de implantação de equipamentos digitais, como operação paralela de sistemas antigos e novos, integração de plataformas, testes de comunicação e manutenção extra, não são deduzidos obrigatoriamente da cota de referência; ao invés disso, são identificados pelo módulo subsequente de compensação por resíduos de aprendizado de máquina:
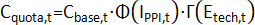 (5)
em que Cbase,t denota o custo de linha de base estático calculado a partir das cargas de trabalho dos ativos de nível inferior e das cotas padronizadas de custos operacionais; captura o efeito de transmissão das flutuações macroeconômicas de preços sobre os preços de materiais, equipamentos e serviços externos; e Γ(Etech,t) reflete a redução baseada na eficiência dos custos unitários de operação e manutenção após a maturidade tecnológica. Por meio do mecanismo de evolução dinâmica descrito acima, a linha de base da cota já não permanece em uma base contábil estática, mas pode ajustar-se adaptativamente às mudanças nos ambientes econômicos e nas condições tecnológicas. A Equação (5) é original deste trabalho e representa a integração inovadora das correções de preço e tecnologia ao interior do framework da linha de base de cotas.
Captura sistemática de resíduos não lineares sob restrições de cota
Apesar das correções evolutivas complexas, o modelo de cotação gera inevitavelmente desvios sistemáticos ao enfrentar interrupções climáticas imprevisíveis relacionadas a desastres e diretivas políticas súbitas, como custos aumentados no atendimento a reclamações de clientes durante períodos temporários de redução de tarifas. Esse desvio forma o termo residual em ambos os lados da equação:
Rt=Cactual,t-Ccota,t (6)
Como as regras físicas convencionais não conseguem explicar esse aspecto, a aprendizagem de máquina pode abordar essas limitações. Para evitar a maldição da dimensionalidade causada por características de alta dimensão, este estudo utiliza o algoritmo XGBoost baseado em conjuntos de árvores de decisão para modelar a relação não linear Rt37,38. Define-se uma matriz de características de forte perturbação Xt, incluindo características meteorológicas, como dias anuais extremos de congelamento Dice, e intensidade de políticas macroeconômicas.
Para um compensador não linear composto por árvores de regressão, a lógica de geração do resíduo previsto  pode ser expressa como39:
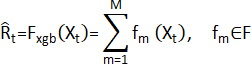 (7)
onde F denota o espaço de todas as estruturas possíveis de árvores de classificação e regressão. Para equilibrar a precisão do ajuste e a prevenção de sobreajuste, uma função objetivo regularizada contendo um termo de penalidade de complexidade estrutural é construída e minimizada na m-ésima iteração:
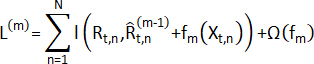 (8)
em que  é uma função de perda convexa que mede a diferença entre o resíduo verdadeiro e o resíduo previsto. Este artigo adota a Perda Huber para aumentar a robustez do modelo em relação a gastos máximos anômalos. O termo de regularização
 é usado para restringir a complexidade da estrutura da árvore e é definido como:
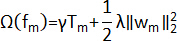 (9)
em que Tm representa o número de nós folha na m-ésima árvore, wm representa o vetor de pesos correspondente das folhas, e γ e λ denotam, respectivamente, o coeficiente de penalização do número de nós folha e o coeficiente de regularização de peso.
A equação final de previsão é:
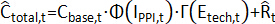 (10)
Ampliado ainda mais como:
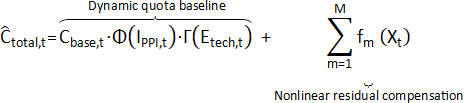 (11)
A fórmula acima representa matematicamente a estrutura de malha fechada do modelo de previsão proposto. A demanda final de custo de produção e operação não é gerada diretamente pelo modelo de aprendizado de máquina; ao invés disso, é obtida pela sobreposição da compensação residual não linear identificada pelo módulo de aprendizado de máquina sobre a linha de base dinâmica da cota. Dentre esses componentes, os fatores preço e tecnologia refletem principalmente a evolução dinâmica da linha de base da cota, enquanto fatores difíceis de caracterizar explicitamente por meio de regras, como choques climáticos, perturbações políticas e picos nos eventos de reparo, são capturados pelo módulo de compensação residual baseado em aprendizado de máquina. As equações (10) e (11) são originais deste trabalho e sintetizam a linha de base física com a captura residual baseada em ML em um quadro unificado de previsão.
Figura 2 mostra que os resultados de previsão do modelo proposto exibem uma lógica clara de geração hierárquica. Por um lado, a cota de referência fornece uma base física estável, transparente e auditável para a demanda de custos; por outro lado, os ajustes de preço, os efeitos tecnológicos e os resíduos de choques externos permitem que o modelo se adapte a mudanças dinâmicas em ambientes complexos. Em comparação com modelos caixa-preta que geram diretamente valores previstos, essa estrutura de decomposição pode revelar claramente "por que os custos aumentam ou diminuem", aumentando assim a interpretabilidade dos resultados do modelo na revisão orçamentária e na regulação das tarifas de transmissão e distribuição.
Fontes de dados e procedimentos de coleta
Modelos teóricos devem ser rigorosamente validados por meio de dados empíricos para demonstrar sua utilidade prática. Como os dados financeiros centrais do setor elétrico envolvem informações sensíveis relacionadas às operações de infraestrutura nacional, este estudo extrai dados contábeis mensais de alta precisão e anonimizados de uma rede elétrica provincial típica no leste da China, referida como E-Grid para facilitar a referência, abrangendo 16 anos consecutivos, de 2010 a 2025. Essa província passou por um ciclo econômico típico de transição de um crescimento impulsionado por indústrias pesadas tradicionais para a manufatura de alta tecnologia, com a taxa de crescimento anual composta da escala de ativos da rede alcançando 7,4%. A evolução complexa de sua estrutura de custos, portanto, possui relevância potencial para outros sistemas de rede em rápido desenvolvimento. Os dados originam-se de três fontes principais: (1) registros internos de operação e manutenção que registram cargas de trabalho em nível de ativo, frequências de inspeção e eventos de reparo; (2) sistemas de contabilidade financeira que fornecem demonstrativos mensais de custos em mão de obra, materiais, equipamentos e serviços terceirizados; e (3) bases de dados ambientais externas, incluindo registros meteorológicos da Administração Meteorológica da China e indicadores macroeconômicos do Escritório Nacional de Estatísticas.
Controle de qualidade e tratamento de dados ausentes
Para mais de 130 indicadores iniciais integrados a partir de sistemas múltiplos, foi implementado um procedimento rigoroso de controle de qualidade. Pontos de dados ausentes, correspondendo a menos de 3% do total de observações, foram tratados mediante interpolação linear para variáveis contínuas com tendências temporais e imputação pela moda para indicadores categóricos. Valores atípicos foram identificados utilizando o método do intervalo interquartílico (IIQ), sendo os valores que excediam 3,0 vezes o IIQ acima do terceiro quartil ajustados para o percentil 99 para preservar a integridade dos dados e mitigar distorções provocadas por valores extremos.
Considerações sobre o tamanho da amostra
O conjunto de dados compreende 192 observações mensais (janeiro de 2010 a dezembro de 2025), com 156 observações (2010–2022) alocadas para treinamento e validação e 36 observações (2023–2025) reservadas para testes fora da amostra. Embora este tamanho amostral seja relativamente modesto para aplicações de aprendizado profundo, é adequado para o algoritmo XGBoost, que foi especificamente projetado para apresentar bom desempenho com conjuntos de dados tabulares pequenos a médios por meio de seus mecanismos de regularização e poda de árvores. Para mitigar riscos potenciais de sobreajuste, (1) foram empregadas penalidades rigorosas de regularização (γ = 0,1, λ = 1,0), (2) parada antecipada com tolerância de 50 rodadas e (3) restrições conservadoras de profundidade das árvores (profundidade máxima = 5). Essas medidas garantem coletivamente a estabilidade e a capacidade de generalização do modelo, apesar do tamanho limitado da amostra.
Segmentação de dados e integração heterogênea de múltiplas fontes
Para testes rigorosos, os dados de janeiro de 2010 a dezembro de 2022 foram designados para o intervalo de treinamento-validação, contendo 156 observações, que é utilizado para treinar os fatores de evolução da cota e a rede residual de compensação de cota. O período de janeiro de 2023 a dezembro de 2025 é reservado como conjunto de teste mantido fora da amostra, contendo 36 observações. Por que este período foi selecionado como a arena final de testes? A razão é que esses três anos coincidiram com a aceleração da construção de sistemas elétricos de novo tipo, agravada por eventos em larga escala de altas temperaturas relacionados ao forte El Niño e pelo crescimento rápido e desigual da geração distribuída de energia renovável. A rede elétrica enfrentou pressões sem precedentes nas cadeias de suprimento de materiais e na alocação de mão de obra para reparos.
A seleção científica e a definição quantitativa de fatores impulsionadores de custos são a base para garantir que a rede residual de aprendizado de máquina possa capturar efetivamente flutuações sistemáticas. Com base na lógica de gestão dos custos operacionais padrão em sistemas de energia, este estudo ultrapassa a dimensão única da previsão financeira tradicional, que depende apenas de fluxos de caixa históricos, e reconstrói a engenharia de características a partir de quatro limites principais: escala de ativos físicos, condições de operação e manutenção, evolução macroeconômica e ambiente climático externo, utilizando registros operacionais originais e livros contábeis de sistemas externos. No processo real de modelagem, para mais de 130 indicadores originais resultantes da integração de sistemas múltiplos, este estudo utiliza testes de correlação de Pearson para eliminar variáveis redundantes altamente colineares, com um limiar de |r| > 0,85. Com base no conhecimento prévio de especialistas seniores em redes elétricas, 42 características de entrada principais são finalmente selecionadas para formar a matriz de características Xt. Para apresentar claramente a estrutura subjacente e a distribuição dos dados do tensor de entrada, Tabela 2 seleciona 12 características principais representativas das quatro dimensões de avaliação acima e resume suas estatísticas descritivas ao longo do período de observação.
Para ilustrar melhor a base espacial-topológica do sistema de características multissource, Figura 3 apresenta uma topologia esquemática anonimizada da rede elétrica provincial em estudo. A figura sobrepõe subestações por nível de tensão, corredores de transmissão, agrupamentos distribuídos de energias renováveis, centros de carga e zonas representativas de distúrbios ambientais. A topologia ajuda a explicar por que os custos de produção e operação são conjuntamente afetados pela escala dos ativos, estrutura da rede, intensidade de reparos emergenciais e choques climáticos externos. Também fornece uma base de interpretação espacial para as variáveis orientadas por resíduos utilizadas no módulo de compensação XGBoost.
Tabela 2 mostra que as variáveis explicativas em diferentes dimensões empresariais exibem formas estatísticas claramente distintas. As variáveis de ativos físicos que representam dinâmicas endógenas de desenvolvimento empresarial, como capacidade de subestação e comprimento de linha, possuem desvios-padrão relativamente estáveis e valores de assimetria concentrados entre 0,1 e 0,8. Sua estrutura geral de dados é aproximadamente normal, refletindo objetivamente o atributo de desenvolvimento estável da rede elétrica no ciclo de construção de infraestrutura. Em acentuado contraste estão as variáveis meteorológicas e de perturbação ambiental externa na parte inferior da tabela. Por exemplo, o número acumulado de dias com temperaturas elevadas em nível de alerta nos últimos 90 dias e o índice de impacto de desligamento de linha apresentam assimetria fortemente positiva, com valores de assimetria de 2,15 e 2,45, respectivamente. Essa distribuição típica com cauda pesada confirma um ponto crítico objetivo que não pode ser ignorado na operação e manutenção reais da rede elétrica: embora desastres climáticos extremos ocorram com relativa infrequência ao longo do ano, quando acionados, costumam provocar aumentos exponenciais na demanda de mão de obra para reparos e no consumo de peças de reposição. De outra perspectiva, a alta não uniformidade e a assimetria de valores extremos na distribuição dessas características multissensoriais revelam as limitações teóricas dos modelos tradicionais de séries temporais lineares, como o ARIMAX, que se baseiam nas suposições de normalidade e homocedasticidade ao rastrear custos complexos da rede elétrica. Isso não apenas reforça ainda mais a racionalidade de introduzir um módulo de aprendizado de máquina além da base contábil física, mas também fornece suporte estatístico sólido para a escolha, neste artigo, do modelo de árvore XGBoost, capaz de lidar eficientemente com distribuições esparsas de características e mapeamentos não lineares para aproximar os resíduos de custo.
Configuração do sistema de otimização e avaliação de hiperparâmetros
Após determinar o espaço de entrada das características, a definição dos hiperparâmetros do modelo afeta diretamente o desempenho de ajuste da rede de aproximação de resíduos. Como a rede de compensação XGBoost envolve múltiplos parâmetros, incluindo profundidade da árvore (max depth), taxa de aprendizado e termos de penalidade de regularização, e esses parâmetros apresentam interações não lineares, a busca convencional em grade não apenas possui alta complexidade computacional, mas também tende a ficar presa em mínimos locais em espaços de alta dimensão. Portanto, este estudo introduz o Estimador Parzen com Estrutura de Árvore (Tree-structured Parzen Estimator, TPE), um método de otimização bayesiana, no processo de ajuste de parâmetros. O algoritmo TPE pode orientar dinamicamente as direções de amostragem subsequentes utilizando o feedback da função de perda a partir de avaliações anteriores. Ao construir uma estimativa da densidade espectral posterior (KDE) da variável objetivo, ele reduz adaptativamente o espaço de busca de parâmetros, permitindo que o modelo aproxime a configuração globalmente ótima de hiperparâmetros sem incorrer em alto custo computacional. O objetivo da otimização TPE foi minimizar o RMSE de validação ao longo de 100 iterações, com interrupção antecipada após 50 rodadas sem melhoria.
Após a conclusão da otimização dos parâmetros no conjunto de validação interno, para avaliar de forma objetiva o desempenho final de cada modelo no conjunto de testes fora da amostra e atender aos requisitos quantitativos dos reguladores para verificação de custos, este estudo utiliza o erro percentual absoluto médio (MAPE) para quantificar o desvio relativo na sequência prevista. Ao mesmo tempo, para atender à necessidade prática de controlar falhas extremas nas previsões de custo durante as operações, o erro quadrático médio (RMSE) também é introduzido para impor penalidades mais severas a erros maiores. Por fim, o coeficiente de determinação, R2, quantifica o poder explicativo geral da regressão em relação à variância verdadeira do alvo.
As definições matemáticas dos indicadores são as seguintes:
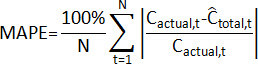 (12)
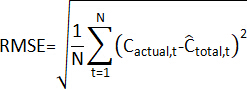 (13)
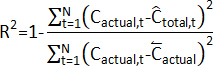 (14)
em que  representa o custo real de produção e operação no período t,
 representa o custo previsto pelo modelo,
 representa o custo real médio na amostra de teste e N é o número de amostras no conjunto de teste.
Resultados
Comparação panorâmica com redução de dimensionalidade da precisão de previsão
Quando todos os modelos otimizados pelo Estimador de Parzen com Estrutura de Árvore (TPE) foram avaliados no conjunto de teste fora da amostra de 2023–2025, que incluiu flutuações da recuperação pós-pandemia e eventos extremos de alta temperatura, foi possível comparar objetivamente o desempenho dos principais algoritmos de previsão. Para fornecer uma avaliação rigorosa e abrangente, foram incluídos quatro modelos de referência que representam diferentes abordagens metodológicas: Suavização Exponencial Tradicional, representando a previsão financeira convencional; SARIMAX, representando modelagem linear de séries temporais sazonais; regressão XGBoost isolada, representando uma abordagem puramente baseada em dados, sem restrições de cotas; e Attention-LSTM, uma rede com memória de longo e curto prazo aprimorada com mecanismo de atenção, amplamente utilizada para previsão de sequências longas.
Conforme mostrado na Tabela 3, o modelo Quota-ML proposto superou todos os modelos de referência na previsão de custos de produção e operação durante o período fora da amostra de 2023–2025. O modelo alcançou um MAPE de 2,34%, reduzindo o erro de previsão em 61,8% em comparação com o SARIMAX (6,12%) e em 34,1% em relação ao modelo Attention-LSTM (3,55%). Seu RMSE (15,69 milhões de CNY) e MaxAE (23,05 milhões de CNY) foram menos da metade dos do próximo melhor modelo de rede neural, enquanto um valor de R2 de 0,957 indicou que o modelo explicou mais de 95% da variância nos custos observados. Esses resultados demonstram que a integração de cotas de custos de engenharia, evolução dinâmica das cotas e compensação de resíduos baseada em XGBoost melhora substancialmente tanto a precisão quanto a robustez da previsão em comparação com métodos tradicionais de séries temporais e modelos puramente baseados em dados.
Conforme ilustrado na Figura 4, os custos reais de produção e operação exibiram flutuações sazonais claras e vários períodos de pico acentuados durante o intervalo de teste. Em particular, os custos aumentaram acentuadamente durante os eventos de temperaturas extremamente altas de julho e agosto de 2024. Embora o modelo Attention-LSTM tenha capturado a tendência sazonal geral, suas previsões foram relativamente suaves e subestimaram os aumentos bruscos de custos associados a reparos de emergência, sobrecarga de equipamentos pesados e aumento no consumo de suprimentos de emergência. O modelo XGBoost isolado respondeu de forma mais eficaz às flutuações locais, mas desviou-se da trajetória observada durante vários meses, pois não possuía restrições de cota de engenharia. Em contraste, o modelo Quota-ML proposto acompanhou de perto a trajetória de custos observada durante todo o período de teste e reproduziu com precisão tanto o aumento de custos no verão de 2024 quanto o pico secundário no verão de 2025.
O desempenho superior do modelo Quota-ML demonstra o benefício de combinar cotações de custo de engenharia com correção residual baseada em aprendizado de máquina. A cotação dinâmica de referência fornece uma base fisicamente interpretável que reflete a evolução dos ativos da rede elétrica e das cargas operacionais, evitando um aprendizado irrestrito a partir de séries temporais financeiras limitadas. A rede de compensação residual concentra-se então em perturbações não lineares difíceis de representar apenas por meio de regras de cotação de engenharia, incluindo eventos meteorológicos, picos no número de ordens de manutenção e mudanças relacionadas a políticas. Consequentemente, o modelo proposto alcançou os menores valores de MAPE e RMSE entre todos os métodos avaliados (Tabela 3) e forneceu o rastreamento mais preciso dos picos sazonais de custo e eventos extremos (Figura 4), demonstrando sua adequação para previsão de custos operacionais e de produção em longo prazo.
Validação por ablação de componentes arquiteturais centrais
Em uma estrutura híbrida complexa composta por submódulos aninhados, a principal preocupação acadêmica geralmente se concentra em saber se o modelo sofre de "engenharia excessiva". Realizar experimentos internos de ablação mediante a remoção de componentes centrais é necessário para explorar as verdadeiras inter-relações e níveis de contribuição de cada módulo. Este estudo define dois caminhos de degradação para a arquitetura. Primeiro, a Estrutura A, que remove o mecanismo de evolução dinâmica: a linha de base de cota é forçadamente confinada a padrões físicos estáticos do passado, eliminando a penetração dos fatores acumulados de inflação macroeconômica e deflação decorrente do progresso tecnológico dos últimos anos, conectando-se apenas à linha de base estática histórica  à rede residual. Segundo, a Estrutura B, que remove o módulo residual não linear de rastreamento: o modelo degrada-se completamente em uma abordagem atuarial, interrompendo o ciclo de captura de flutuações aleatórias orientado por IA e tomando diretamente o valor puro de cálculo dinâmico de cota
 , após correção do ambiente macroeconômico, como saída final. A razão de perda de variância explicada é calculada com base na diminuição relativa do R2 entre o modelo completo e o modelo degradado, definida como:
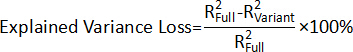 (15)
Tabela 4’s um estudo de ablação revela que ambos os componentes do framework proposto contribuem significativamente para a precisão da previsão, mas a compensação de resíduos baseada em aprendizado de máquina desempenha um papel mais crítico. A remoção do mecanismo de evolução dinâmica para preço e tecnologia (Variante A) aumenta o MAPE para 4,15% (uma degradação de 1,81 ponto percentual) e reduz o R2 para 0,837, explicando 12,5% menos variância do que o modelo completo. Em contraste, a eliminação da compensação residual de ML (Variante B) provoca uma queda muito mais acentuada: o MAPE aumenta para 5,62% (+3,28 p.p.), R2 cai para 0,686, e a razão de perda de variância explicada atinge 28,3%. Esses resultados demonstram que, embora a atualização dinâmica da cota melhore a precisão da linha de base, a correção de resíduos baseada em XGBoost é indispensável para capturar os fatores de custo não lineares, formando juntos uma arquitetura híbrida sinérgica.
Para facilitar a comparação do desempenho do modelo entre os experimentos de ablação, foi construído um gráfico de radar normalizado para visualizar cinco métricas de avaliação: MAPE, RMSE, R2, MaxAE e robustez. As métricas baseadas em erro (MAPE, RMSE e MaxAE) foram normalizadas de forma invertida, de modo que erros menores correspondessem a pontuações mais altas, enquanto as métricas positivas (R2 e robustez) foram normalizadas de forma que valores maiores correspondessem a pontuações mais altas. Após a normalização, todos os indicadores representam pontuações de desempenho comparáveis, sendo que valores mais próximos à borda externa indicam desempenho geral superior.
Como mostrado na Figura 5, o modelo completo Quota-ML alcançou pontuações consistentemente altas em todas as cinco dimensões de desempenho, formando o perfil de radar mais amplo e mais equilibrado. Esse resultado indica que o framework proposto fornece um equilíbrio eficaz entre o controle de erro relativo, a precisão geral da previsão, o poder explicativo, a supressão de erros extremos e a robustez sob condições operacionais variáveis.
Em contraste, a Versão A, que excluiu o mecanismo de evolução dinâmica das cotas, mas manteve a compensação de resíduos baseada em aprendizado de máquina, apresentou uma redução acentuada no desempenho geral. Esse resultado indica que uma base estática de cotas isoladamente não consegue explicar adequadamente as alterações estruturais provocadas por flutuações nos preços das commodities e pelo progresso tecnológico. Uma queda ainda maior no desempenho foi observada na Versão B, na qual o módulo de compensação de resíduos foi removido e a previsão passou a depender exclusivamente da base dinâmica de cotas. Nesse caso, o desempenho deteriorou-se substancialmente, especialmente em métricas relacionadas a erros e robustez.
Conforme resumido na Tabela 4, o MAPE da Variante B aumentou de 2,34% no modelo completo para 5,62%, representando um aumento de 3,28 pontos percentuais, enquanto o valor de R2 diminuiu em 28,3%. Esses resultados indicam que, embora o modelo de cota dinâmica incorpore ajustes de eficiência impulsionados pela inflação macroeconômica e pela tecnologia, ele não consegue capturar totalmente as variações abruptas de custo associadas a condições climáticas extremas, manutenção de emergência, mudanças de política e condições operacionais anormais.
No geral, a análise de ablação demonstra que ambos os componentes principais do framework proposto são essenciais. O mecanismo de evolução dinâmica da cota adapta a linha de base de engenharia às mudanças nas condições macroeconômicas e no progresso tecnológico, enquanto o módulo de compensação de resíduos baseado em aprendizado de máquina capta desvios não lineares que não podem ser explicitamente representados pelas regras de cota de engenharia. Juntos, esses componentes complementares formam um framework integrado de previsão que combina uma linha de base de cota fisicamente interpretável com aprendizado de resíduos orientado por dados para alcançar previsões precisas e robustas de custos de longo prazo.
Validação da interpretabilidade do modelo de compensação residual
Embora a comparação de precisão de previsão e os experimentos de ablação tenham demonstrado a importância do módulo de compensação de resíduos baseado em aprendizado de máquina, métricas de erro isoladas não podem determinar se as relações não lineares capturadas possuem interpretações físicas ou operacionais significativas. Portanto, o método SHAP (Explicações Aditivas de Shapley) foi aplicado para interpretar o modelo de resíduos XGBoost40. O SHAP tem sido amplamente adotado para explicar modelos de aprendizado de máquina em previsão de energia e potência e em sistemas complexos relacionados41,42. Ao quantificar a contribuição de cada característica de entrada nas previsões do modelo, o SHAP permite avaliar se os padrões de resíduos aprendidos são consistentes com o conhecimento de engenharia.
Conforme mostrado na Figura 6, variáveis externas de perturbação — incluindo o número acumulado de dias com temperatura elevada em nível de alerta nos últimos 90 dias, o índice de interrupção de linhas relacionado a convecção severa e tufões, a duração de chuva congelante e neve, e o número de eventos de reparo não planejados — exibiram valores SHAP fortemente positivos. Amostras com altos valores para essas variáveis concentraram-se na região positiva de SHAP, indicando que eventos climáticos extremos e atividades de manutenção emergenciais aumentaram consistentemente os custos reais além da linha de base da cota dinâmica. Esses resultados demonstram que o módulo de compensação residual capta perturbações ambientais e operacionais significativas, e não apenas ajusta ruídos aleatórios.
Várias variáveis adicionais, incluindo a duração da operação com carga pesada, o índice de preços de metais PPI, a proporção de investimento digital, a capacidade instalada de geração fotovoltaica distribuída e o comprimento da linha de transmissão, também apresentaram contribuições substanciais para as previsões residuais. Esses resultados indicam que os desvios em relação à linha de base da cota são conjuntamente influenciados por eventos climáticos de curto prazo, expansão de ativos, transmissão de preços de commodities, transformação do sistema elétrico e digitalização. Notavelmente, a proporção de investimento digital contribuiu positivamente para os custos residuais em algumas observações, sugerindo que a transformação digital em estágios iniciais pode temporariamente aumentar as despesas devido à integração de sistemas, manutenção de plataformas e operação paralela de sistemas legados e recém-implantados. De modo geral, a análise SHAP valida a interpretabilidade comercial do módulo de compensação residual e fornece suporte empírico para compreender os impactos de eventos climáticos extremos e da transformação digital sobre os custos de produção e operação.
Teste de significância estatística de melhorias nas previsões
Para determinar se as melhorias na previsão alcançadas pela estrutura proposta eram estatisticamente significativas, foram realizados testes formais de comparação de previsões. Seguindo a prática estabelecida na previsão de energia e em econometria, o teste de Diebold–Mariano (DM) foi utilizado para comparar a precisão preditiva do modelo proposto com cada referência. O teste DM é particularmente adequado para previsão de séries temporais, pois leva em conta a autocorrelação nos erros de previsão sem exigir resíduos normalmente distribuídos.
Para cada comparação, a hipótese nula assumiu que os modelos proposto e de referência tinham precisão preditiva igual, enquanto a hipótese alternativa assumiu que o modelo proposto produziu erros de previsão menores. Testes DM unilaterais foram realizados utilizando o erro quadrático de previsão como função de perda. Para levar em conta a heterocedasticidade e a autocorrelação na série de diferenças de perda, foram aplicados erros-padrão de Newey–West com seleção automática de defasagem. Além disso, o teste de postos com sinal de Wilcoxon foi realizado como uma alternativa não paramétrica que não depende de suposições distribucionais. Juntos, esses testes complementares fornecem uma avaliação robusta da significância estatística das melhorias observadas nas previsões.
Conforme resumido na Tabela 5, o framework de previsão proposto alcançou melhorias estatisticamente significativas em comparação com todos os modelos de referência. As estatísticas DM positivas indicam erros de previsão consistentemente menores do que os abordagens concorrentes. A maior melhoria foi observada em relação ao modelo ARIMA (DM = 3,842, p < 0,001), demonstrando a vantagem de incorporar cotações de custos de engenharia ao framework de previsão. Em comparação com o ARIMAX, que inclui variáveis exógenas, o modelo proposto também mostrou uma melhoria significativa (DM = 3,215, p < 0,001), destacando o valor adicional de combinar uma linha de base dinâmica de cotações com compensação de resíduos baseada em aprendizado de máquina.
O modelo proposto também superou significativamente os referenciais de aprendizado profundo. Os aperfeiçoamentos na previsão foram significativos em relação ao modelo LSTM (DM = 2,876, p = 0,002) e ao modelo Transformer (DM = 2,543, p = 0,011). Embora a melhoria em relação ao modelo XGBoost isolado tenha sido menor (DM = 2,187, p = 0,029), ela permaneceu estatisticamente significativa. Como ambos os modelos utilizam aprendizado baseado em árvores, esse resultado demonstra que a integração da linha de base de cota dinâmica proporciona valor preditivo adicional além de uma abordagem puramente baseada em dados. O teste de postos com sinal de Wilcoxon produziu níveis de significância consistentes com os do teste DM, fornecendo mais evidências de que os aperfeiçoamentos na previsão do framework proposto são estatisticamente robustos.
DISPONIBILIDADE DOS DADOS:
Os conjuntos de dados utilizados neste estudo foram carregados em um repositório público (DOI: https://doi.org/10.5281/zenodo.21645584).
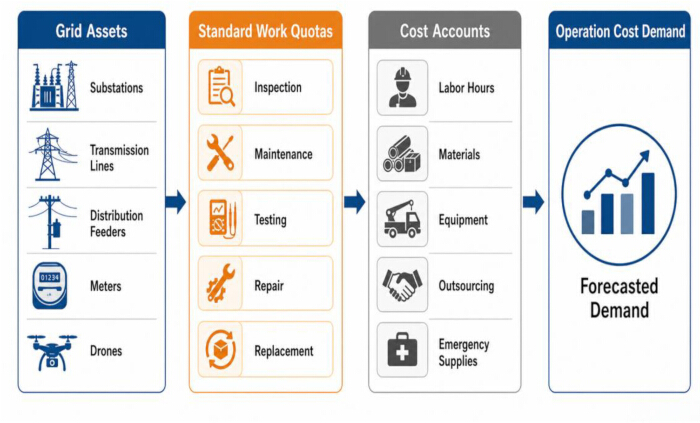
Figura 1: Mapeamento da relação entre ativos da rede elétrica, cotas de operação padrão e contas de custo. Esta figura mostra que as cotas de custo não são meras regras abstratas de alocação financeira, mas unidades contábeis padronizadas incorporadas em todo o processo de operação e manutenção dos ativos da rede elétrica. Clique aqui para visualizar uma versão maior desta figura.
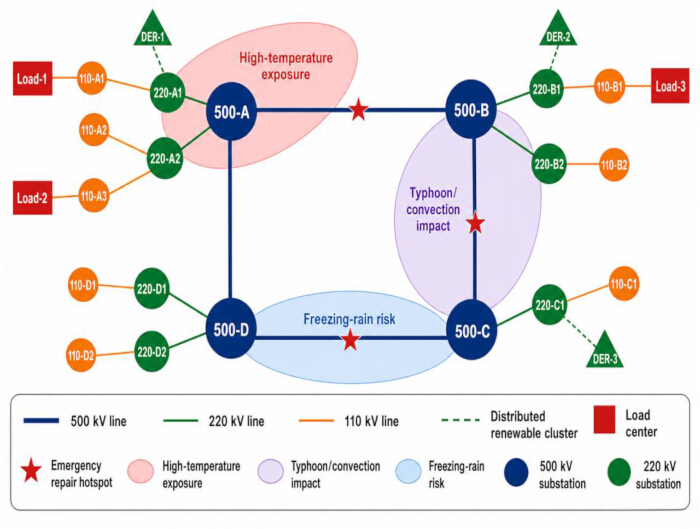
Figura 3: Topologia esquemática anônima da rede elétrica provincial estudada e camadas de perturbações que impactam os custos. Esta figura apresenta uma topologia esquemática anônima da rede elétrica provincial estudada. A figura sobrepõe subestações por nível de tensão, corredores de transmissão, agrupamentos distribuídos de energias renováveis, centros de carga e zonas representativas de perturbações ambientais. Clique aqui para visualizar uma versão ampliada desta figura.
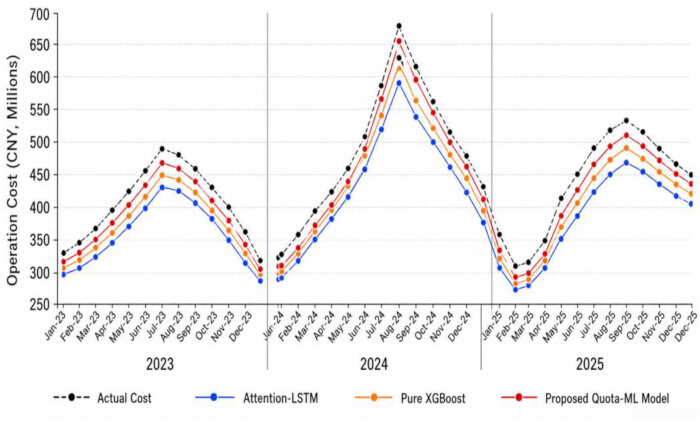
Figura 4: Trajetórias de previsão dos modelos principais e custos reais durante o intervalo de teste fora da amostra de 2023–2025. Esta figura mostra que os custos reais de produção e operação durante o período de teste exibem flutuações sazonais claras e picos repentinos. Durante o choque de temperatura extrema em julho e agosto de 2024, os custos reais aumentaram significativamente. Clique aqui para visualizar uma versão maior desta figura.
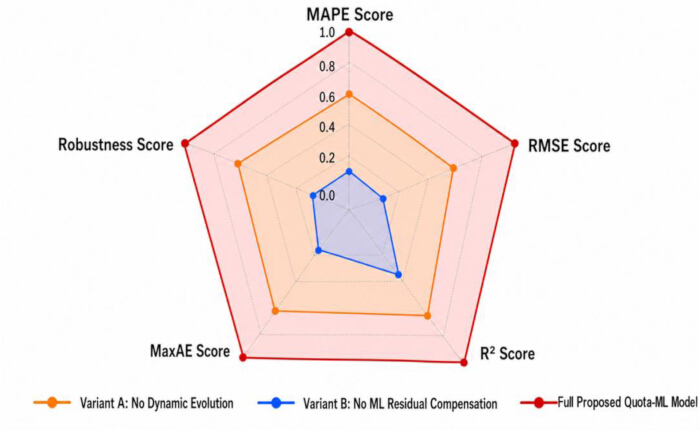
Figura 5: Comparação normalizada do desempenho de previsão entre variantes de ablação. Os gráficos de radar comparam o desempenho normalizado do modelo completo Quota-ML e de duas variantes de ablação utilizando cinco métricas de avaliação: pontuação MAPE, pontuação RMSE, pontuação R2, pontuação MaxAE e pontuação de robustez. As métricas baseadas em erro (MAPE, RMSE e MaxAE) foram reversamente normalizadas para que pontuações mais altas indiquem erros de previsão menores, enquanto R2 e robustez foram normalizadas de modo que pontuações mais altas indiquem melhor desempenho do modelo. O perfil de radar mais amplo do modelo completo Quota-ML demonstra desempenho geral superior de previsão em comparação com ambas as variantes de ablação. Clique aqui para visualizar uma versão maior desta figura.
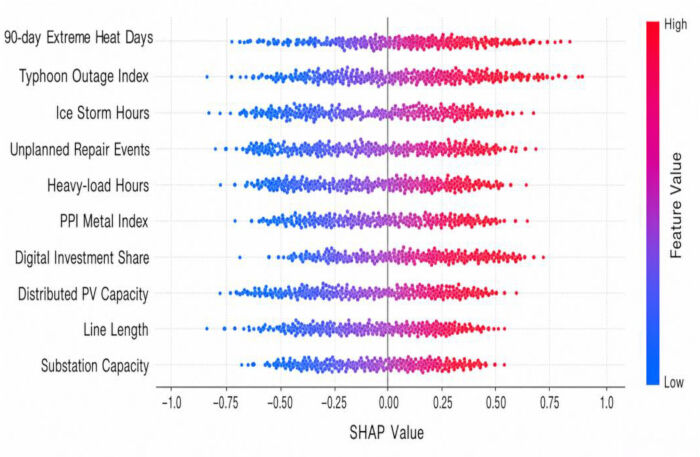
Figura 6: Gráfico resumo SHAP mostrando as contribuições das características para a previsão de custo residual. Gráfico resumo SHAP (Explicações Aditivas de Shapley) ilustrando as contribuições das variáveis mais influentes para o modelo de compensação residual XGBoost. Cada ponto representa uma observação, sendo que a cor indica o valor da característica (azul = baixo; vermelho = alto) e a posição horizontal representa o valor SHAP. Valores mais altos para variáveis como dias de calor extremo, índice de interrupção relacionado a tufões, duração de tempestades de gelo e eventos de reparo não planejados estão geralmente associados a valores SHAP mais positivos, indicando aumento nos custos residuais de produção e operação. O gráfico demonstra que tanto distúrbios ambientais quanto fatores operacionais contribuem significativamente para desvios em relação à linha de base da cota dinâmica. Clique aqui para visualizar uma versão maior desta figura.
Tabela 1: Descrição das variáveis e parâmetros principais do modelo. Esta tabela apresenta as variáveis-chave do modelo proposto de previsão de custos Quota-ML, distinguindo entre custos reais e previstos; bases de cota estáticas e dinâmicas; parâmetros de carga de trabalho e de cota; fatores de ajuste macroeconômico (IPCA e progresso tecnológico); e componentes residuais. Clique aqui para baixar esta tabela.
Tabela 2: Classificação e estatísticas descritivas das características principais de entrada do modelo de previsão.
Esta tabela mostra que as variáveis explicativas de diferentes dimensões empresariais exibem formas estatísticas distintas. Esta tabela resume as estatísticas descritivas de variáveis representativas de ativos físicos, operacionais, macroeconômicas e ambientais utilizadas como entradas do modelo. Clique aqui para baixar esta tabela.
| Modelos | MAPE % | RMSE (CNY, Milhões) | R² Ajuste de Qualidade | MaxAE (CNY, Milhões) |
| Suavização Exponencial Tradicional | 8.75 | 54.22 | 0.651 | 125.04 |
| Modelo de séries temporais SARIMAX | 6.12 | 38.54 | 0.768 | 84.21 |
| Regressão XGBoost pura | 4.38 | 29.16 | 0.852 | 51.06 |
| Rede neural Attention-LSTM | 3.55 | 24.02 | 0.894 | 40.53 |
| Modelo Quota-ML Proposto | 2.34 | 15.69 | 0.957 | 23.05 |
Tabela 3: Comparação geral do desempenho de diferentes modelos no conjunto de testes fora da amostra de 2023–2025. Esta tabela demonstra que o modelo Quota-ML proposto supera significativamente todos os modelos de referência na previsão dos custos de produção e operação da rede elétrica no período fora da amostra de 2023–2025.
| Variante Experimental | Componente Central Removido | Desempenho na Degradação do MAPE | R² | Razão de Perda de Variância Explicada |
| Variante A | Sem dinâmica de evolução de preço/tecnologia | 4,15% (+1,81 p.p.) | 0,837 | 12,50% |
| Variante B | Sem compensação de resíduos de ML | 5,62% (+3,28 p.p.) | 0,686 | 28,30% |
| Modelo Completo | Estrutura Proposta Completa com Cota-ML | 2,34% | 0,957 | Valor de referência |
Tabela 4: Resultados do experimento de ablação da estrutura integrada de cotação e aprendizado de máquina. Esta tabela mostra que ambos os componentes da estrutura proposta contribuem significativamente para a precisão da previsão, mas a compensação residual por aprendizado de máquina desempenha um papel mais crítico.
| Comparação | Teste Diebold-Mariano | Teste de Wilcoxon com Postos Sinalizados |
| Modelo Proposto vs. ARIMA | DM = 3,842*** (p < 0,001) | W = 486,0*** (p < 0,001) |
| Modelo Proposto vs. ARIMAX | DM = 3,215*** (p < 0,001) | W = 452,0*** (p < 0,001) |
| Modelo Proposto vs. LSTM | DM = 2,876** (p = 0,002) | W = 398,0** (p = 0,003) |
| Modelo Proposto vs. Transformer | DM = 2,543* (p = 0,011) | W = 364,0* (p = 0,014) |
| Modelo Proposto vs. XGBoost (apenas ML) | DM = 2,187* (p = 0,029) | W = 328,0* (p = 0,031) |
Tabela 5: Resultados dos testes de significância estatística para comparações de previsões. A estatística do teste Diebold-Mariano segue uma distribuição normal padrão sob a hipótese nula. Valores DM positivos indicam maior precisão da previsão do modelo proposto. Todos os testes são unilaterais, com a hipótese alternativa de que o modelo proposto apresenta um erro de previsão menor do que o modelo de referência. A estatística W do teste de postos com sinal de Wilcoxon é apresentada com os respectivos valores de p. Função de perda = erro quadrático de previsão.
Discussão
Este estudo demonstra que a integração de cotas de custo industriais com aprendizado de máquina fornece uma estrutura interpretável e precisa para previsão de custos de rede elétrica em longo prazo. Os resultados mostram que variáveis relacionadas ao clima, particularmente dias com temperaturas extremamente altas e índices de impacto de desligamento de linhas, são os principais fatores responsáveis pelos resíduos de custo, destacando a crescente influência de perturbações externas nas despesas das concessionárias. Esses achados sugerem que os custos relacionados ao clima não devem mais ser tratados como despesas operacionais incidentais, mas sim incorporados a reservas de contingência dedicadas, com a ativação dessas reservas vinculada aos riscos climáticos previstos. A identificação do impacto de desligamentos de linhas como principal fator de custo reforça ainda mais o valor de estratégias de manutenção preditiva e monitoramento de condição na redução de interrupções operacionais e da volatilidade de custos.
A análise também revela que a transformação digital pode aumentar os custos operacionais nas fases iniciais de implementação devido à operação dual de sistemas em transição, em vez de ganhos imediatos de eficiência. Esse resultado sugere que as concessionárias devem avaliar investimentos digitais utilizando a avaliação de custo do ciclo de vida, em vez do desempenho financeiro de curto prazo, e devem prever sobreposições temporárias de custos ao implantar monitoramento inteligente, gerenciamento avançado de distribuição ou subestações digitais. O framework proposto de compensação residual também poderia ser estendido para estimar o ponto em que os investimentos digitais começam a gerar economias líquidas de custos, apoiando assim decisões de planejamento tecnológico e de investimento mais eficazes.
Além das operações de utilidade, a estrutura proposta tem implicações regulatórias importantes. Ao quantificar os efeitos de fatores externos sobre os resíduos de custo, o modelo fornece uma base objetiva para estabelecer reservas de contingência ajustadas ao clima e para avaliar pedidos orçamentários das concessionárias. A separação entre custos baseados na cota básica e resíduos provocados por perturbações também favorece uma regulação baseada em desempenho mais eficaz, distinguindo a eficiência operacional controlável de choques externos incontroláveis. Além disso, a estrutura de previsão baseada em cotas oferece maior transparência e rastreabilidade do que modelos puramente estatísticos ou de inteligência artificial opacos, permitindo que os custos previstos sejam diretamente vinculados às condições operacionais físicas e parâmetros de engenharia durante revisões tarifárias e audiências regulatórias.
Várias limitações devem ser reconhecidas. A análise empírica baseia-se em uma única rede elétrica provincial no leste da China, o que pode limitar a generalização para regiões com condições climáticas, ambientes regulatórios ou estruturas de rede diferentes. Embora o conjunto de dados de 192 meses seja suficiente para o modelo XGBoost, ele permanece relativamente pequeno para capturar eventos raros, mas de alto impacto, e o desempenho da previsão depende da qualidade e consistência das bases de dados subjacentes de cota de custos. Além disso, o mecanismo de cota dinâmica depende do índice agregado de preços ao produtor e de fatores de progresso tecnológico que podem não captar plenamente as variações de custo regionais ou específicas de componentes. Embora a análise SHAP melhore a interpretabilidade do modelo, as contribuições de características relatadas representam associações preditivas, e não relações causais, e devem, portanto, ser interpretadas com a devida cautela.
Pesquisas futuras devem focar na integração de registros de manutenção não estruturados por meio de modelos de linguagem grandes específicos para o domínio, na incorporação de redes neurais gráficas espaço-temporais para capturar a propagação de perturbações em redes interconectadas, na extensão da validação para múltiplas regiões para melhorar a generalização e na introdução da quantificação de incerteza para apoiar decisões regulatórias com base no risco. Esses avanços estão alinhados com os recentes progressos nas previsões energéticas de médio e longo prazo e na integração de energias renováveis, que enfatizam a importância de combinar inteligência baseada em dados com estruturas de modelagem fisicamente informadas para a operação confiável de sistemas elétricos43,44.
Divulgações
Todos os autores declaram não haver conflitos de interesse.
CONTRIBUIÇÃO DOS AUTORES:
Xiaohui Wang concebeu e projetou o estudo, desenvolveu a metodologia, realizou a análise formal e redigiu o manuscrito original. Tong Li contribuiu com a curadoria dos dados, implementação de software e validação. Yanchao Lu contribuiu para o desenvolvimento da metodologia, investigação e interpretação dos dados. Quanfeng Lv forneceu recursos, supervisionou a aquisição de dados e revisou criticamente o manuscrito. Fan Liu supervisionou o projeto, contribuiu com a conceituação e interpretação dos resultados, obteve financiamento e revisou criticamente o manuscrito. Todos os autores revisaram e aprovaram a versão final do manuscrito
Agradecimentos
Este trabalho foi apoiado pelo Projeto Tecnológico da Corporação State Grid da China, com o nome de "Pesquisa sobre Análise de Alocação de Custos de Produção e Operação e Tecnologia de Otimização Assíncrona" (Número do Projeto:520600250029-183-ZN).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Conjunto de dados contábeis mensais anonimizados da E-Grid | Rede elétrica provincial no leste da China | N/A | Conjunto de dados anonimizados de produção e custos operacionais mensais (2010–2025) composto por 192 observações, incluindo dados de ativos físicos, operação e manutenção, macroeconômicos e ambientais. Utilizado para o desenvolvimento do modelo (156 observações) e testes fora da amostra (36 observações). |
| Biblioteca de plotagem Matplotlib | Equipe de desenvolvimento do Matplotlib | 3.5.2 | Utilizada para gerar figuras do manuscrito e saídas gráficas, incluindo gráficos de desempenho do modelo, visualizações de topologia, diagnósticos de resíduos, gráficos de radar e resumos visuais relacionados ao SHAP. |
| Biblioteca de computação numérica NumPy | Desenvolvedores do NumPy | 1.22.3 | Utilizada para operações com arrays numéricos, cálculos matriciais e controle de reprodutibilidade. Uma semente aleatória fixa de 42 foi aplicada quando relevante. |
| Biblioteca de manipulação de dados Pandas | Equipe de desenvolvimento do pandas | 1.4.2 | Utilizada para importação, integração, reestruturação, filtragem e pré-processamento de dados, incluindo imputação de valores ausentes, alinhamento de séries temporais e preparação das variáveis de entrada do modelo. |
| Ambiente de programação Python | Python Software Foundation | 3.9.13 | Ambiente de programação utilizado para implementar todo o fluxo de trabalho de previsão, incluindo pré-processamento de dados, engenharia de características, treinamento do modelo, otimização de hiperparâmetros, predição, testes estatísticos e avaliação de desempenho. |
| Biblioteca de aprendizado de máquina Scikit-learn | Colaboradores do scikit-learn | 1.0.2 | Utilizada para pré-processamento de dados, divisão entre treinamento e validação, avaliação de modelos auxiliares e procedimentos estatísticos, incluindo análise de correlação de Pearson e cálculo de métricas de desempenho selecionadas. |
| Biblioteca de computação científica SciPy | Colaboradores do SciPy | 1.9.0 | Utilizada para cálculos estatísticos, incluindo análise de correlação de Pearson e procedimentos auxiliares para tratamento de outliers e winsorização. |
| Implementação do Estimador Parzen Estruturado em Árvore | Colaboradores do Optuna | 3.1.0 | Implementação de otimização bayesiana utilizada para ajustar os hiperparâmetros do XGBoost, incluindo profundidade máxima da árvore, taxa de aprendizado e parâmetros de regularização. O Estimador Parzen Estruturado em Árvore foi implementado por meio do pacote de código aberto Optuna. |
| Biblioteca de software XGBoost | DMLC / Colaboradores do XGBoost | 1.7.1 | Biblioteca de aprendizado conjunto baseada em árvores de decisão utilizada para compensação não linear de resíduos. O modelo implementou uma função objetivo regularizada com perda Huber e penalidades de complexidade da árvore, conforme descrito nas Equações 7–9. |
Referências
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.