Este protocolo descreve um fluxo de trabalho híbrido quântico–clássico reproduzível para classificar a Doença de Parkinson a partir de gravações de voz humana, incluindo pré-processamento de dados, implementação de circuitos quânticos, treinamento de modelos e validação cruzada para replicação independente.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Um Protocolo Híbrido Quântico-Clássico Reproduzível para Classificar a Doença de Parkinson a partir de Gravações de Voz Humana
Neste artigo
Resumo
Resumo
A Doença de Parkinson é um distúrbio neurodegenerativo progressivo para o qual métodos de rastreamento acessíveis e de baixo custo continuam limitados. Gravações vocálicas sustentadas contêm biomarcadores acústicos mensuráveis associados à disfonia relacionada a doenças que podem ser adquiridos sem equipamentos especializados. Este protocolo descreve uma rede neural convolucional híbrida quântica–clássica de quatro qubits (QI-HCNN) que combina um circuito quântico parametrizado com uma camada rasa de classificação clássica para classificar a Doença de Parkinson usando características acústicas de voz dimensionalmente reduzidas. O protocolo também compara a abordagem proposta com uma rede neural clássica com dimensionalidade e classificadores de árvore com gradiente aprimorado, treinados tanto para conjuntos de recursos reduzidos quanto completos. Usando um conjunto de dados público e desidentificado, que compreende 195 gravações de voz de 31 indivíduos, o QI-HCNN alcançou uma área sob a curva característica operacional do receptor de 0,78 usando validação cruzada estratificada em três pontos, comparado a 0,87 para a rede neural clássica pareada e 0,94–0,95 para as linhas de base aumentadas por gradiente treinadas nos conjuntos de características reduzidas e completas, respectivamente. Uma análise de ablação controlada demonstrou que uma das duas operações de emaranhamento no circuito não podia influenciar a saída medida por design, enquanto a operação restante de emaranhamento reduziu, em vez de melhorar, o desempenho da classificação em relação a uma variante não emaranhada. A validação cruzada por grupos de pacientes mostrou ainda que as estimativas de desempenho variaram substancialmente dependendo dos indivíduos designados ao conjunto de testes, refletindo o tamanho limitado da coorte. Portanto, esse protocolo fornece uma linha base quântica–clássica totalmente especificada e reproduzível de forma independente, juntamente com uma avaliação apoiada em dados das forças e limitações do projeto atual do circuito, fornecendo uma base metodológica para investigações futuras, em vez de apoiar alegações de prontidão diagnóstica.
Introdução
A Doença de Parkinson é um distúrbio neurodegenerativo crônico causado pela perda progressiva de neurônios dopaminérgicos na substância negra, afetando mais de 10 milhões de pessoas no mundo e representando um fardo substancial e crescente para a saúdepública 1. A doença produz tanto sintomas motores, incluindo tremor, rigidez e bradicinesia, quanto sintomas não motores, como interrupção do sono e anosmia. O diagnóstico clínico baseia-se principalmente em exame neurológico usando escalas motoras padronizadas, complementadas, quando disponíveis, por imagens por transportador de dopamina; No entanto, ambas as abordagens exigem expertise especializada e infraestrutura que não são uniformemente acessíveis, e a avaliação clínica em estágio inicial permanecesubjetiva 2. Como atualmente não há terapia modificadora da doença disponível, a detecção precoce é valiosa principalmente porque permite o manejo sintomático mais precoce e o monitoramento longitudinal. Essa necessidade motivou o desenvolvimento de abordagens de triagem de baixo custo, escaláveis e não invasivas que podem complementar, em vez de substituir, a avaliação clínica.
A prejuízo vocal está entre as primeiras mudanças mensuráveis associadas à Doença de Parkinson e frequentemente precede sintomas motoresevidentes 3. A fonação sustentada de uma vogal mantida fornece um sinal controlado do qual características acústicas, incluindo jitter, cintilação, relação harmônico-ruído, entropia de densidade de períodos de recorrência e análise de flutuações destendências, podem ser extraídas. Esses recursos já foram repetidamente demonstrados como conter informações diagnosticamente relevantes e podem ser adquiridos usando equipamentos de gravação de nível consumidor 4,5. Um conjunto de dados de benchmark público derivado dessas gravações tornou-se um banco de testes padrão para essa tarefa, e métodos clássicos de aprendizado de máquina aplicados a todo o conjunto de características, incluindo máquinas de vetores de suporte, florestas aleatórias e árvores com gradiente aumentado, relataram valores de área sob a curva característica operando do receptor próximos de 0,99 6,7,8, sugerindo que a tarefa de classificação está próxima de ser resolvida quando o conjunto completo de características e estratégias apropriadas para lidar com o desequilíbrio de classes são usados. O aprendizado de máquina quântico surgiu como um paradigma computacional alternativo para tarefas de classificação biomédica, no qual circuitos quânticos parametrizados usam sobreposição e emaranhamento para representar interações de características com relativamente poucos parâmetros treináveis, e gradientes de circuito podem ser calculados analiticamente usando a regra do deslocamento de parâmetros em vez de aproximações de diferençasfinitas 9. No entanto, muitos estudos publicados descrevendo redes neurais "quânticas" ou "inspiradas em quânticos" para aplicações biomédicas implementam arquiteturas totalmente clássicas que adotam formalismos matemáticos inspirados no quântico sem executar um circuito quântico parametrizado real, seja em simulador ou hardwarequântico 10. Desenvolvimentos recentes na detecção da Doença de Parkinson também incluíram arquiteturas híbridas de rede neural convolucional transformador11, métodos de aprendizado profundo baseados em atenção para ressonância magnética (MRI)12, e redes neurais convolucionais leves projetadas para diagnóstico computacionalmenteeficiente 13, ilustrando a rápida expansão das abordagens de inteligência artificial em múltiplas modalidades de dados. De forma mais ampla, o diagnóstico assistido por computador não invasivo foi estendido com sucesso para outras aplicações biomédicas, incluindo pipelines híbridos de aprendizado de máquina e deep learning para imagemmédica 14. Avaliações comparativas de arquiteturas de deep learning no mesmo conjunto de dados público de voz demonstram ainda mais o forte desempenho alcançável usando modelos clássicos convencionais de fullfeature 15.
Esses desenvolvimentos destacam uma necessidade metodológica específica de um modelo reprodutível de rede neural convolucional híbrida quântica–clássica (QI-HCNN) que (i) execute um circuito quântico paramétrico genuíno e totalmente especificado; (ii) é comparado usando características de entrada idênticas tanto contra uma rede neural clássica arquitetonicamente ajustada quanto contra uma linha de base clássica forte; e (iii) é avaliado usando um protocolo que examina explicitamente as principais fontes de viés em pequenos conjuntos de dados biomédicos, incluindo desequilíbrio de classes, confusão demográfica e vazamento de dados em nível de paciente durante validação cruzada.
O objetivo geral deste protocolo é fornecer um fluxo de trabalho QI-HCNN totalmente reprodutível para a classificação da Doença de Parkinson usando gravações de voz humana. O protocolo descreve um circuito quântico parametrizado de quatro qubits que emprega codificação angular, duas camadas de emaranhamento baseadas em NOT controlado e uma camada variacional treinável otimizada usando a regra de deslocamento de parâmetros, combinada com uma cabeça de classificação clássica rasa e aplicada a uma representação principal-componente de quatro componentes de um conjunto de dados público de gravação de voz. O fluxo de trabalho especifica, em um nível suficiente para replicação independente, todos os procedimentos de pré-processamento, construção completa do circuito, configuração clássica de treinamento e procedimentos de avaliação, incluindo comparações com uma rede neural clássica com compatibilidade de dimensionalidade, linhas de base de árvore com compatibilidade de dimensionalidade e ampliação de gradiente em características completas, ablações controladas por componentes de circuito, validação cruzada agrupada por pacientes para avaliar a sensibilidade dos participantes afastados e estatística explícita Teste de significado. Em vez de apresentar apenas resultados favoráveis, o protocolo é projetado para reportar de forma transparente quando componentes individuais do circuito não melhoram mensurivelmente o desempenho, fornecendo assim uma estrutura metodológica reprodutível que pode informar o desenvolvimento futuro da arquitetura QI-HCNN para tarefas de classificação biomédica de pequenas coortes.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Esse protocolo utiliza um conjunto de dados de gravação de voz de terceiros, desidentificado e publicamente disponível. Nenhum novo dado de sujeitos humanos foi coletado pelos autores, e não foi necessária aprovação adicional do conselho de revisão institucional (IRB) para este estudo. O conjunto de dados descrito na subseção Aquisição de Conjunto de Dados e Manuseio de Dados em Nível de Participante foi originalmente coletado sob aprovação ética institucional por Little et al.3, não contém informações diretamente identificativas dos participantes (apenas identificadores anonimizados de registro) e está disponível publicamente para uso em pesquisa. Confirme, de acordo com suas políticas institucionais, se a análise secundária deste conjunto de dados disponível publicamente requer revisão ética. Na instituição dos autores, a análise secundária retrospectiva desse conjunto de dados totalmente desidentificado e arquivado publicamente foi considerada isenta da revisão completa do IRB.
Aquisição de Conjuntos de Dados e Manuseio de Dados em Nível de Participante
O conjunto de dados de Classificação da Doença de Parkinson (UCI Machine Learning Repository, Dataset ID 174), originalmente descrito por Little et al.3, foi baixado. O conjunto de dados continha 195 gravações de fonação /a/ com vogais sustentadas de 31 indivíduos (23 diagnosticados com Doença de Parkinson e 8 controles saudáveis; faixa etária, 46–85 anos). Como o repositório não fornece um DOI versionado, a data exata de download foi registrada e reportada na Tabela de Materiais. O conjunto de dados era fornecido como um arquivo de valores separados por vírgulas (CSV) (parkinsons.csv). Não era necessária descompressão ou conversão de arquivo, e o arquivo era importado diretamente usando a função read_csv da biblioteca Pandas (veja Tabela de Materiais).
O conjunto de dados baixado foi verificado como contendo 195 linhas e 24 colunas, compreendendo uma coluna de identificador de registro (formato: phon_R01_S  sujeito
 _ gravação), 22 colunas contínuas de características acústicas (Tabela 1) e uma coluna binária de rótulo de classe (status: 1 = Doença de Parkinson; 0 = controle saudável). A Tabela 1 foi usada como referência para todas as características acústicas e categorias de características ao longo do protocolo.
| Categoria | Recursos Representativos | Significado Clínico |
| Frequência fundamental | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | Frequência fundamental, média, máxima e mínima de fonação; reflete a estabilidade da vibração das pregas vocais. |
| Jitter (perturbação de frequência) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | Variação ciclo para ciclo no período de afinação, refletindo controle motor laríngeo comprometido. |
| Shimmer (perturbação de amplitude) | MDVP: Brilho, MDVP: Brilho (dB), Brilho: APQ3, Brilho: APQ5, MDVP: APQ, Brilho: DDA | Variação ciclo para ciclo na amplitude do sinal, refletindo fonação ofegante ou instável. |
| Medidas de ruído | NHR, HNR | Razão entre ruído e componentes harmônicos (tonais) do sinal de voz. |
| Dinâmica não linear / escalonamento fractal | RPDE, D2, DFA, spread1, spread2, PPE | Medidas de dinâmica vocal não linear, periodicidade e correlações temporais de longo alcance associadas à vibração das pregas vocais. |
Tabela 1: Categorias de características acústicas usadas para a classificação da Doença de Parkinson. As 22 características acústicas de voz extraídas do conjunto de dados da Classificação da Doença de Parkinson estão agrupadas em cinco categorias de características: frequência fundamental, jitter, cintilação, medidas de ruído e dinâmica não linear. Características representativas são listadas para cada categoria juntamente com sua respectiva importância clínica. MDVP, Programa de Voz Multidimensional; RAP, perturbação média relativa; PPQ, quociente de perturbação do período de pitch; APQ, quociente de perturbação de amplitude; DDP, diferença de diferenças de período; DDA, diferença absoluta média de amplitudes; NHR, relação ruído-harmônico; HNR, relação harmônicos-ruído; RPDE, entropia de densidade de períodos de recorrência; D2, dimensão de correlação; DFA, análise de flutuação destendênciada; EPI, entropia do período de altura.
Um identificador de participante era extraído para cada gravação analisando a substring anterior ao sublinhado final no nome da gravação. Por exemplo, phon_R01_S01_1 e phon_R01_S01_2 foram designados para o participante S01. Identificadores de participantes, em vez de identificadores de registro, foram posteriormente usados para todos os procedimentos de validação agrupada ou de exclusão de um participante descritos na subseção do Protocolo de Avaliação , pois as gravações obtidas do mesmo participante são correlacionadas acusticamente. Após a extração, uma tabela de frequências dos identificadores foi gerada e inspecionada para confirmar que todas as 195 gravações foram atribuídas a exatamente 31 participantes únicos, que nenhuma gravação permaneceu sem atribuição e que o número de gravações por participante correspondia à documentação do conjunto de dados de origem.
A distribuição das classes foi tabulada tanto no nível de registro (147 registros de Doença de Parkinson, 75,4%; 48 registros em controle saudável, 24,6%) quanto no nível de participantes (23 de 31 participantes, 74,2%, diagnosticados com Doença de Parkinson). Ambas as distribuições foram relatadas porque o desequilíbrio entre o nível de registro e o nível de classe entre participantes não são idênticos e influenciam a avaliação a jusante.
A ausência de grupos de doença de Parkinson e controles saudáveis com pares de idade ou sexo no conjunto de dados de origem foi documentada como uma limitação do estudo e levada adiante para a Discussão, pois essa característica reflete a coleta original dos dados e não pode ser corrigida por meio do pré-processamento posterior.
Pipeline de Pré-processamento
Todos os procedimentos de pré-processamento foram realizados independentemente dentro de cada dobra de treinamento do procedimento de validação cruzada descrito na subseção do Protocolo de Avaliação . Tanto os passos de normalização Min–Max quanto a análise de componentes principais (PCA) foram ajustados usando apenas a partição de treinamento de cada dobra. As transformações ajustadas foram posteriormente aplicadas à partição de teste correspondente sem reajustar, para evitar vazamento de informações da partição de teste para os parâmetros de pré-processamento.
As 22 características acústicas brutas em cada partição de treinamento foram normalizadas usando um escalador Min–Max com uma faixa de saída de [0, π]. O escalador ajustado foi então aplicado tanto nas partições de treinamento quanto de teste da dobra correspondente (Equação 1). A Equação 1 segue a formulação padrão de normalização Min–Max e foi definida para o protocolo atual. A normalização Min–Max foi realizada usando a classe MinMaxScaler do scikit-learn (versão 1.8.0) com feature_range=(0, π), copy=True e clip=False.
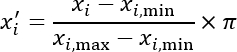 (1)
Um modelo PCA com n_components = 4 foi ajustado usando apenas os dados de treinamento normalizados. A transformação PCA ajustada foi então aplicada tanto às partições de treinamento quanto de teste. A proporção da variância total explicada pelos quatro componentes principais retidos foi registrada para cada dobra. Nas análises aqui relatadas, os quatro componentes principais retidos explicaram 81,5% da variância total (50,3%, 16,3%, 9,4% e 5,5%, respectivamente). A PCA foi realizada usando a classe PCA com n_components=4, svd_solver="cheio", whiten=Falso e random_state=42.
Como a PCA pode gerar escores de componentes de valor negativo, um segundo escalador Min–Max com faixa de saída de [0, π] foi instalado usando a partição de treinamento transformada na PCA. O escalonador ajustado foi posteriormente aplicado tanto nas divisórias de treinamento quanto nas de teste. Qualquer valor transformado da partição de teste que ficasse fora do intervalo [0, π] era cortado para a fronteira mais próxima porque o escalador havia sido ajustado usando apenas a partição de treinamento. Não havia características de variância zero presentes no conjunto de dados. A variedade de cada longa em todas as 195 gravações foi estritamente positiva; portanto, não surgiu a condição de divisão por zero. Isso foi confirmado verificando que a saída escalonada não continha nem NaN nem valores infinitos.
Os quatro componentes principais renormalizados foram atribuídos sequencialmente como ângulos de rotação para qubits 0, 1, 2 e 3 durante o procedimento de codificação angular descrito na subseção Construção de Circuitos Quânticos . O primeiro componente principal foi atribuído ao qubit 0, o segundo ao qubit 1, o terceiro ao qubit 2 e o quarto ao qubit 3. Isso completou o pipeline de pré-processamento e transferiu as características clássicas processadas para o circuito quântico. Após o segundo passo de escala Min–Max, todos os valores de saída foram confirmados como estando dentro do intervalo [0, π]. Valores de partição de teste que ficaram marginalmente fora desse intervalo devido ao arredondamento de ponto flutuante foram recortados para a fronteira mais próxima usando a função de corte do NumPy (versão 2.4.4). Esse procedimento garantia que todas as quatro entradas da camada de codificação de ângulos fossem ângulos de rotação válidos dentro do intervalo [0, π].
Construção de Circuitos Quânticos
O circuito de quatro qubits foi construído usando o simulador de vetores de estado listado na Tabela de Materiais e na sequência de portas descrita abaixo. O Arquivo de Codificação Suplementar 1 foi usado como a implementação completa do circuito executável, incluindo todas as funções auxiliares para construção de portões e cálculo de gradiente de deslocamento de parâmetro. A Figura 1 mostra o fluxo de trabalho completo desde o pré-processamento de gravação de voz até as quatro camadas de circuito, a cabeça clássica de pós-processamento e a classificação final.
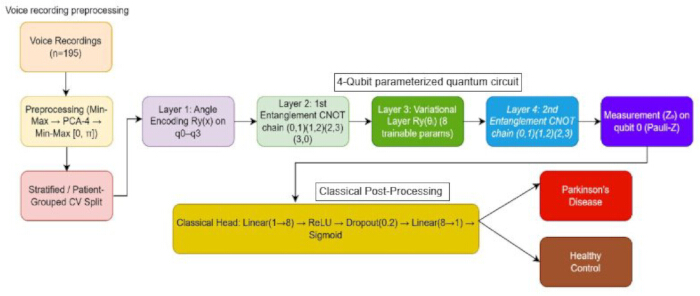
Figura 1. Arquitetura do sistema e fluxo de trabalho de circuitos quânticos. Fluxo de trabalho para classificação da Doença de Parkinson a partir de gravações de voz humana. O diagrama mostra pré-processamento de gravação de voz, validação cruzada estratificada ou agrupada por pacientes, execução de circuitos quânticos parametrizados com quatro qubits, medição Pauli-Z de um único qubit no qubit 0, pós-processamento clássico e classificação binária final como Doença de Parkinson ou controle saudável. CNOT, porta controlada-NOT; PCA, análise de componentes principais; ReLU, unidade linear retificada. Por favor, clique aqui para ver uma versão ampliada desta figura.
Um registrador de quatro qubits foi inicializado no estado base computacional ∣0000.
Para a camada de codificação de ângulos, uma porta de rotação Ry (x i) foi aplicada ao qubit i, onde i = 0,1,2,3, usando os quatro ângulos produzidos pelo pipeline de pré-processamento (Equação 2). A Equação 2 descreve o procedimento padrão de codificação angular usado em circuitos quânticos parametrizados, consistente com a estrutura de aprendizado de circuitos quânticos parametrizados de Mitarai et al.9, e foi aplicada aqui na configuração específica de quatro qubits definida para o protocolo atual.
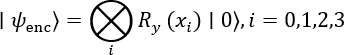 (2)
Para a primeira camada de emaranhamento, uma cadeia circular de portas controladas-NOT foi aplicada na seguinte ordem controle-alvo: (0,1), (1,2), (2,3) e (3,0).
Para a camada variacional, os oito parâmetros treináveis w0 a w 7 foram inicializados por amostragem independente a partir de uma distribuição normal com média 0 e desvio padrão de 0,3. A semente aleatória usada foi registrada na Tabela de Materiais. Os oito parâmetros quânticos variacionais foram inicializados usando numpy.random.default_rng(42 + fold_index).normal(0, 0,3, tamanho = 8), onde fold_index é o número de dobra baseado em zero, fornecendo assim inicializações específicas de dobra, mas reproduzíveis. Para cada qubit i = 0,1,2 e 3, uma porta R z(w i) era aplicada, seguida por uma porta R y(w i+4) (Equação 3). A Equação 3 descreve uma camada quântica variacional (treinável) consistente com o framework geral de aprendizado de circuitos quânticos parametrizados introduzido por Mitarai et al.9 e foi instanciada aqui usando a sequência específica de portas e parametrização definida para o protocolo atual.
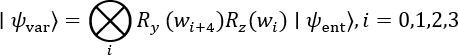 (3)
Para a segunda camada de emaranhamento, uma cadeia aberta de portas controladas-NOT foi aplicada na seguinte ordem controle-alvo: (0,1), (1,2) e (2,3). Essa cadeia não foi fechada de volta ao qubit 0.
O valor esperado do operador Pauli- apenas no qubit 0,  , foi calculado usando um produto interno de vetor de estado. A execução em circuito utilizava um simulador de vetores de estado personalizado implementado usando operações padrão de matriz numérica (Arquivo de Codificação Suplementar 1; qhcnn.py). A precisão Complex128 (numpy.complex128) foi usada em todo o processo. Os valores esperados foram calculados analiticamente a partir do produto interno do vetor de estado; portanto, nenhuma amostragem baseada em injeção foi realizada. Não era necessário um framework de computação quântica de terceiros. Se um simulador baseado em amostragem ou dispositivo quântico tivesse sido usado em vez do simulador de vetor de estado, medições repetidas em base computacional do qubit 0 teriam sido realizadas, e as frequências de bits resultantes teriam sido convertidas em um valor esperado (Equação 4). A equação 4 é a fórmula padrão de valor esperado da mecânica quântica e foi aplicada aqui ao observável de Pauli de qubit único definido para o protocolo atual. Como nenhuma amostragem baseada em tiros foi realizada, não foi necessária mitigação de erro de medição. O simulador usava indexação de qubits big-endian, com o qubit 0 correspondendo ao bit mais significativo do índice do vetor de estado. Essa convenção foi explicitamente considerada ao construir o observável de Pauli para garantir que o valor esperado correto fosse medido.
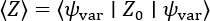 (4)
O gradiente de em relação a cada um dos oito parâmetros variacionais foi calculado usando a regra do deslocamento de parâmetro. O circuito foi avaliado duas vezes para cada parâmetro em cada cálculo de gradiente, uma vez em θ + π/2 e outra em θ - π/2 (Equação 5). A Equação 5 é a regra padrão do deslocamento de parâmetros introduzida por Mitarai et al.9 e foi aplicada aqui sem modificações.
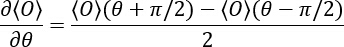 (5)
A segunda camada de emaranhamento, conforme especificado acima, nunca aplicou uma porta controlled-NOT com qubit 0 como alvo. Como uma porta controlled-NOT deixa o estado reduzido de seu qubit de controle inalterado, a segunda camada de emaranhamento não poderia alterar , independentemente dos valores dos parâmetros treináveis. Para permitir que a segunda camada de emaranhamento influencie a saída medida em um protocolo modificado, o qubit 0 precisaria ser incluído como alvo, por exemplo, fechando a cadeia com uma porta controlled-NOT adicional (3,0), ou um observável multiqubit precisaria ser medido em vez de um valor esperado de um único qubit. A segunda camada de emaranhamento originalmente especificada foi mantida neste protocolo, e sua contribuição medida foi reportada explicitamente na seção Resultados , em vez de ser corrigida silenciosamente, pois esse comportamento de circuito faz parte dos achados atuais.
Camada Clássica de Pós-Processamento
A etapa clássica de pós-processamento consistia em uma rede neural de avanço (feed-forward) implementada usando as operações numéricas padrão baseadas em arrays listadas na Tabela de Materiais. A saída do circuito escalar único,  , foi mapeada para oito unidades ocultas usando uma camada totalmente conectada, seguida por uma ativação de unidade linear retificada (ReLU). Durante o treinamento, uma camada de abandono com probabilidade de retenção de 0,8 (taxa de desistência = 0,2) foi aplicada. As oito unidades ocultas foram então mapeadas para uma única unidade de saída usando uma segunda camada totalmente conectada, e uma função de ativação sigmoide foi aplicada para gerar a probabilidade final da classe, ŷ (Equação 6). A Equação 6 define a arquitetura clássica específica de pós-processamento usada no protocolo atual e compreende operações lineares padrão, unidades lineares retificadas (ReLU) e sigmoides.
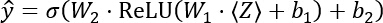 (6)
As matrizes de peso da primeira e segunda camada foram inicializadas por amostragem independente a partir de uma distribuição normal com média 0 e desvio padrão de 0,5, enquanto todos os termos de viés foram inicializados em 0. A mesma instância geradora de números aleatórios e semente usada para inicialização dos parâmetros variacionais quânticos também foram usadas para a camada clássica para garantir a reprodutibilidade de execução a execução. Especificamente, as matrizes clássicas de peso foram inicializadas usando numpy.random.default_rng(42 + fold_index).normal(0, 0,5, tamanho=...), enquanto todos os termos de viés foram inicializados a zero. Uma única instância geradora de números aleatórios seeded, inicializada com 42 + fold_index, foi criada no início de cada dobra de validação cruzada e reutilizada sequencialmente para inicialização de parâmetros quânticos, inicialização clássica de peso, embaralhamento em mini-lote e geração de máscaras dropout, em vez de usar fluxos seed independentes separados para cada processo.
Durante o treinamento, o dropout foi aplicado gerando uma máscara binária recém-amostrada a cada passagem para frente, usando a convenção de abandono invertido, na qual as unidades sobreviventes foram escaladas em 1/0,8. Durante a validação e os testes, o dropout foi completamente desativado, e a rede completa, não escalonada, foi usada para inferência.
O modelo combinado QI-HCNN continha 33 parâmetros treináveis: oito parâmetros variacionais quânticos do circuito quântico e 25 parâmetros clássicos. O componente clássico compreendia oito pesos e oito vieses na primeira camada totalmente conectada, juntamente com oito pesos e um viés na segunda camada totalmente conexa. As dimensões do tensor de peso e viés eram 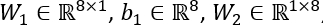 e
 . A camada clássica de pós-processamento foi implementada inteiramente usando operações padrão de array numérico, sem um framework adicional de aprendizado de máquina. Todos os cálculos clássicos eram realizados usando aritmética float64 (dupla precisão).
Treinamento em Modelos
O circuito quântico descrito na subseção Construção de Circuitos Quânticos e a camada clássica de pós-processamento descrita na subseção Camada Clássica de Pós-Processamento foram combinados em um único modelo treinável de ponta a ponta. Todos os 33 parâmetros treináveis foram otimizados conjuntamente usando o otimizador Adam com taxa inicial de aprendizado de 0,01 e decaimento de peso, implementado como uma penalidade L2 de , aplicada apenas às matrizes de pesos clássicas. O otimizador Adam foi implementado manualmente usando operações padrão de array numérico com as seguintes configurações: taxa de aprendizado = 0,01, β1 = 0,9, β2 = 0,999, ∈ = 1 × 10⁻⁸, e decaimento de peso = 1 × 10⁻⁴, aplicado apenas às matrizes de pesos clássicas e não aos termos de viés ou parâmetros variacionais quânticos.
A entropia binária cruzada foi usada como função de perda. Para o procedimento de balanceamento de classes pós-divisão descrito na subseção do Protocolo de Avaliação, a contribuição de perda de cada amostra de treinamento foi ponderada pela frequência inversa de sua classe dentro da partição de treinamento da dobra atual. Para o protocolo desbalanceado, foram atribuídos pesos amostrais uniformes. A entropia cruzada binária foi calculada como a perda média entre todas as amostras dentro de cada mini-lote usando a formulação padrão de entropia cruzada binária.
O modelo foi treinado por 30 épocas usando mini-lotes de 16 amostras. Amostras de treinamento foram embaralhadas aleatoriamente no início de cada época usando numpy.random.default_rng(42 + fold_index).permutação(n) para gerar uma ordem amostral. Quando o número de amostras de treinamento não era divisível uniformemente por 16, o mini-lote final menor era mantido e processado em seu tamanho real, em vez de descartado.
Um cronograma de taxa de aprendizado por etapas foi aplicado durante o treinamento. A taxa de aprendizado era multiplicada por 0,7 a cada 10 épocas concluídas, especificamente no início das épocas 11 e 21.
Gradientes para os oito parâmetros variacionais quânticos foram calculados usando a regra de deslocamento de parâmetros descrita na subseção Construção de Circuitos Quânticos . Os gradientes para os 25 parâmetros clássicos foram calculados usando diferenciação padrão em modo reverso apenas pela camada clássica. A saída do circuito quântico, , e seus gradientes de deslocamento de parâmetros serviam como interface entre o circuito quântico e a camada clássica. Todos os 33 parâmetros foram atualizados usando a mesma instância do otimizador Adam.
A parada precoce baseada em validação não foi utilizada. Cada modelo foi treinado para o cronograma fixo de 30 épocas, e o desempenho de partição de teste suspenso foi reportado após a conclusão da época final. Todos os parâmetros do modelo (parâmetros variacionais quânticos, matrizes clássicas de peso e termos de viés) foram reinicializados independentemente no início de cada dobra de validação cruzada, usando a semente aleatória específica da dobra (42 + fold_index). Os parâmetros não eram compartilhados entre dobras ou execuções de linha base.
O ambiente computacional, incluindo processador, memória, versões de software e tempo aproximado de treinamento de relógio de parede por dobra, foi registrado na Tabela de Materiais.
Protocolo de Avaliação
O desempenho do modelo foi avaliado utilizando procedimentos de validação cruzada tanto em nível de registro quanto em nível de participante, juntamente com comparações de modelos de base, análises de balanceamento de classes, experimentos de ablação de circuitos, testes de significância estatística e análises de importância de características.
Para a avaliação primária, as 195 gravações de voz foram divididas em três dobras estratificadas usando uma semente aleatória fixa, preservando a razão de doença de Parkinson em nível de gravação/controle saudável de 75,4%/24,6% dentro de cada dobra. O modelo descrito nas seções anteriores foi treinado usando duas dobras e avaliado na dobra restante que ficou estendida, e esse procedimento foi repetido até que cada dobra serviu uma vez como partição de teste. Precisão, precisão, recall, F1-score e área sob a curva característica operacional do receptor (AUC–ROC) foram calculadas para cada dobra e reportadas como a média ± desvio padrão entre as três dobras. A validação cruzada estratificada tripartita primária foi implementada usando a classe StratifiedKFold com n_splits=3, embaralhador=Verdadeiro e random_state=42.
Previsões de classe binária foram geradas aplicando um limiar de probabilidade fixo de 0,50 à probabilidade prevista da classe, ŷ, produzida pela camada clássica de pós-processamento. Precisão, precisão, recordação e pontuação F1 foram calculadas a partir dessas previsões com limiar, enquanto AUC–ROC foi calculado diretamente a partir dos valores de probabilidade contínua sem limiar. Precisão, recordação e pontuação F1 foram calculadas usando as funções métricas com zero_division=0, atribuindo um valor de 0,0 a qualquer métrica indefinida. Nenhuma condição indefinida desse tipo ocorreu durante os experimentos relatados.
Modelos de linha base foram avaliados usando as partições de dobra idênticas e a representação idêntica de características pré-processadas de quatro componentes gerada pelo pipeline de pré-processamento. Um perceptron clássico multicamada contendo uma camada oculta de oito unidades ativadas por ReLU, arquitetonicamente adaptado ao componente clássico do modelo híbrido, mas sem o circuito quântico, foi treinado usando o otimizador Adam com penalidade L2 de 1 × 10⁻⁴. Um classificador de árvore com gradiente também foi treinado usando a mesma representação de quatro componentes com 200 árvores, profundidade máxima de árvore de 3, taxa de aprendizado de 0,1 e ponderação de classe igual à frequência inversa de classe dentro de cada dobra de treinamento. Além disso, um segundo classificador de árvore com gradiente foi treinado usando a representação completa de 22 características gerada após a normalização inicial do Min–Max, sem aplicar PCA ou codificação quântica de características. Esse modelo usava 300 árvores, profundidade máxima de árvore de 4, taxa de aprendizado de 0,05 e a mesma estratégia inversa de ponderação de classes de treinamento. A linha base clássica do perceptrô multicamada foi implementada usando MLPClassifier com hidden_layer_sizes=(8,), activation="relu", solver="adam", alpha=1 × 10⁻4, batch_size="auto", learning_rate_init=0,001, max_iter=500, early_stopping=False, embaralhador=True e random_state=42. A inicialização padrão de peso uniforme Glorot (Xavier) fornecida pela implementação foi utilizada. As linhas de base da árvore impulsionadas por gradiente foram implementadas usando XGBoost 3.3.0 com objetivo = "binário:logístico", eval_metric = "logloss", tree_method = "auto", subamostra = 1.0, colsample_bytree = 1.0, reg_alpha = 0, reg_lambda = 1 e random_state = 42.
Para avaliar o efeito do balanceamento de classes pós-divisão, o procedimento primário de validação cruzada foi repetido para o modelo QI-HCNN com a ponderação amostral habilitada. Os pesos de balanceamento foram calculados exclusivamente a partir da partição de treinamento de cada dobra após a divisão train/test e não foram calculados a partir da partição de teste correspondente mantida para fora.
Experimentos de ablação por componentes de circuito foram realizados repetindo o fluxo completo de pré-processamento, treinamento e avaliação quatro vezes, modificando apenas as duas camadas de emaranhamento do circuito quântico. As quatro variantes de circuito compreendiam: (i) o circuito completo contendo ambas as camadas de emaranhamento; (ii) o circuito com a primeira camada de emaranhamento removida e a segunda retida; (iii) o circuito com a primeira camada de emaranhamento mantida e a segunda removida; e (iv) o circuito com ambas as camadas de emaranhamento removidas. Partições de dobra idênticas, sementes aleatórias e configurações de treinamento foram mantidas em todos os quatro experimentos para que quaisquer diferenças de desempenho observadas pudessem ser atribuídas exclusivamente à configuração da camada de emaranhamento.
Como avaliação de robustez, a validação cruzada por grupo de participantes foi realizada dividindo os 31 participantes, em vez das 195 gravações, em cinco grupos com seis a sete participantes cada. Durante cada iteração, o modelo foi treinado usando gravações de participantes em quatro grupos e avaliado usando gravações dos participantes do grupo restante, garantindo que nenhum participante contribuísse com gravações tanto para as partições de treinamento quanto para as de teste da mesma dobra. Precisão, precisão, recordação, escore F1 e AUC–ROC foram relatados como a média ± desvio padrão entre as cinco dobras agrupadas pelos participantes para o modelo QI-HCNN, o perceptron multicamadas clássico e a linha base aumentada por gradiente de quatro características. A validação cruzada agrupada por participantes foi implementada usando a classe GroupKFold com n_splits=5, onde os identificadores dos participantes serviam como variável de agrupamento. Como o GroupKFold não embaralha os grupos, os participantes foram designados de acordo com a ordem determinística padrão da implementação, resultando em folds contendo seis ou sete participantes cada.
A significância estatística foi avaliada aplicando testes de Wilcoxon por pares de rank por sinal aos valores de AUC–ROC por dobra obtidos para a avaliação primária e os modelos de linha de base. Valores p exatos e o número correspondente de observações pareadas foram reportados porque o poder estatístico desse teste é limitado quando apenas um pequeno número de dobras está disponível. Quatro comparações par a par AUC–ROC foram definidas a priori: (1) QI-HCNN versus o perceptron clássico multicamada; (2) QI-HCNN versus a linha base da árvore impulsionada por gradiente com PCA; (3) o perceptron multicamada clássico versus a linha base da árvore com gradiente aumentada por PCA; e (4) o modelo QI-HCNN desequilibrado versus o modelo QI-HCNN pós-desbalanceado dividido. Nenhuma correção por múltiplas comparações foi aplicada porque as análises eram exploratórias e o número limitado de dobras reduziu substancialmente o poder estatístico.
A análise de importância das características foi realizada usando o classificador de árvores com gradiente impulsionado, treinado na representação completa de 22 características. Pontuações de importância de destaque baseadas em ganho foram extraídas e classificadas para todas as características acústicas originais. Separadamente, a PCA foi ajustada ao conjunto de dados completo apenas para fins de relatórios e não foi utilizada durante a avaliação do modelo. Para cada característica acústica original, as cargas absolutas entre os quatro componentes principais mantidos foram somadas, e as características foram classificadas de acordo com esses valores. Ambos os métodos de classificação e sua sobreposição foram relatados. Para a análise de importância de características baseada em ganho, a implementação da árvore com gradiente impulsionado produziu valores únicos de ganho em ponto flutuante, e não ocorreram empates. Para as classificações de carga por componentes principais, os empates nos valores absolutos somados foram resolvidos de acordo com a ordem original por coluna de características no conjunto de dados.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Todos os valores numéricos relatados no texto são reconciliados e idênticos aos apresentados nas Figuras 2–8 e nas Tabelas 2–4. Cada figura era gerada diretamente a partir do código fornecido no Arquivo de Codificação Suplementar 1 , em vez de ser preparada manualmente, garantindo consistência entre os valores numéricos reportados e os dados plotados.
Desempenho Primário de Validação Cruzada
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Este protocolo especifica uma arquitetura QI-HCNN totalmente reprodutível para classificação da doença de Parkinson a partir de gravações de voz, na qual cada porta, escolha de inicialização de parâmetro, etapa de pré-processamento e procedimento de avaliação são descritos em um nível suficiente para implementação independente. O circuito proposto é comparado usando características de entrada idênticas e partições de dobra de validação cruzada idênticas contra um perceptron clássico mult...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Conflito de Interesses:
Os autores declaram que não possuem interesses financeiros ou não financeiros concorrentes relacionados a esta obra.
Agradecimentos
Esse trabalho não foi financiado por nenhuma agência ou organização, nem tecnicamente nem financeiramente. Os autores agradecem aos mantenedores do Repositório de Aprendizado de Máquina da UCI por fornecerem acesso público ao conjunto de dados de gravação de voz utilizado neste estudo.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Adam optimizer | Implementação numérica-padrão de otimização | Implementação personalizada; NumPy 2.4.4 | Otimização conjunta de parâmetros quânticos e clássicos; Treinamento de Modelo |
| Implementação de perda de entropia cruzada binária | Implementação personalizada usando NumPy | NumPy 2.4.4; perda média (redução média) em cada mini-batch | Função de perda de treinamento; Treinamento de Modelo |
| Classificador de árvore gradiente-boostado | Biblioteca open-source de gradiente-boosting XGBoost | XGBoost 3.3.0; objetivo="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | Linhas de base clássicas com PCA combinadas e com características completas; Protocolo de Avaliação |
| Biblioteca de aprendizado de máquina | Biblioteca open-source de aprendizado de máquina scikit-learn | scikit-learn 1.8.0 | Escala de Min–Max, análise de componentes principais, validação cruzada estratificada, validação cruzada agrupada por participante, linha de base de perceptron multicamada e métricas de avaliação |
| Biblioteca de computação numérica | Biblioteca open-source de computação numérica NumPy | NumPy 2.4.4 | Operações básicas de array, simulação de statevector, inicialização de parâmetros e cálculo manual de gradientes |
| Conjunto de dados de Classificação de Doença de Parkinson | Little, McSharry, Roberts, Costello e Moroz; distribuído pelo UCI Machine Learning Repository | ID do Dataset UCI 174; 195 gravações de 31 participantes; acessado em 19 de junho de 2025 | Fonte do conjunto de dados de gravação de voz de vogais sustentadas; https://archive.ics.uci.edu/dataset/174 |
| Biblioteca de computação científica | Biblioteca open-source de computação científica SciPy | SciPy 1.17.1 | Teste de significância estatística de Wilcoxon com sinal; Protocolo de Avaliação |
| Simulador de statevector | Simulador de statevector personalizado (Arquivo de Codificação Suplementar 1; qhcnn.py) | Implementação pura de NumPy; precisão complex128 (duplo); nenhum backend externo necessário | Execução do circuito quântico de quatro qubits; Construção do Circuito Quântico |
| Biblioteca de dados tabulares | Biblioteca open-source de análise de dados Pandas | Pandas 3.0.2 | Carregamento, inspeção e manipulação de dados tabulares |
| Ambiente computacional de workstation | Workstation de CPU local (contêiner Linux hospedado na nuvem) | CPU x86_64; Ubuntu Linux; Python 3; nenhum GPU ou hardware quântico usado; tempo de treinamento aproximado de 30–60 segundos por dobra | Ambiente computacional usado para todo o treinamento e avaliação; Simulação de statevector baseada em CPU; nenhum GPU ou hardware quântico necessário |
Referências
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.