Este estudo investiga a relação entre lúpus eritematoso sistêmico e perda gestacional recorrente e identifica o IFI27 como um biomarcador candidato para investigações futuras.
Artigo de investigação
Randomização Mendeliana e Bioinformática Identificam IFI27 como um Biomarcador Candidato para Perda Gestacional Recorrente no Lúpus Eritematoso Sistêmico
* These authors contributed equally
Neste artigo
Resumo
Resumo
O lúpus eritematoso sistêmico (LES) está associado a desfechos adversos na gravidez, mas sua relação causal com a perda gestacional recorrente (PGR) e suas características moleculares compartilhadas permanecem pouco claras. Este estudo integrou análise bidirecional de aleatorização mendeliana (AM) com duas amostras e bioinformática transcriptômica para investigar essa relação e identificar biomarcadores compartilhados candidatos. FinnGen e UK Biobank foram selecionados porque fornecem estatísticas sumárias de estudos de associação genômica ampla (GWAS) de grande porte, não sobrepostos e com ascendência europeia. Genes diferencialmente expressos (GDEs) foram identificados a partir de GSE61635 (sangue; |variação de log₂| > 1) e GSE165004 (endométrio; |variação de log₂| > 0,5) utilizando um valor de P ajustado < 0,05, seguido por enriquecimento funcional, análise de interação proteína–proteína (PPI), triagem de genes centrais, regressão por operador de redução e seleção por mínimos absolutos (LASSO), validação externa usando GSE50772 e GSE198700, análise de característica operacional do receptor (ROC) e análise de enriquecimento de conjunto de genes por amostra única (ssGSEA). O LES predito geneticamente mostrou associação com aumento estatisticamente significativo, mas quantitativamente modesto, de abortos espontâneos (razão de chances [OR] ponderada pela variância inversa [IVW] = 1,01, intervalo de confiança [IC] de 95% = 1,00–1,02; P < 0,001). A força do instrumento foi adequada, e análises de sensibilidade não detectaram heterogeneidade relevante, pleiotropia direcional ou variante única influente. Cinquenta e nove GDEs compartilhados foram enriquecidos em respostas imunes antivirais, adesão celular e processos relacionados à apoptose. IFI27 foi consistentemente superexpresso no sangue de pacientes com LES, mas subexpresso no endométrio e nas vilosidades coriônicas de PGR, enquanto CXCL11 não apresentou validação externa consistente. Análises retrospectivas de ROC geraram áreas sob a curva (AUCs) de 0,822 para LES e 0,872 para PGR. Pontuações de ssGSEA inferidas computacionalmente mostraram correlações entre a expressão de IFI27 e diversas assinaturas de células imunes, incluindo células T auxiliares tipo 2 (Th2). Esses achados identificam IFI27 como um biomarcador candidato compartilhado por LES e PGR; entretanto, estudos clínicos e experimentais prospectivos são necessários para validar seu significado biológico e clínico.
Introdução
O lúpus eritematoso sistêmico (LES) é uma doença autoimune complexa caracterizada por envolvimento multissistêmico e disfunção imunológica crônica1. As anormalidades patológicas no LES são atribuídas principalmente a respostas imunes adaptativas prejudicadas e ao depósito de complexos antígeno-anticorpo, levando a lesão tecidual mediada por autoimunidade e dano orgânico2,3. A incidência global do LES é de aproximadamente 5,14 (1,4–15,13) casos por 100.000 pessoas-ano, com uma incidência estimada de 8,82 (2,4–25,99) casos por 100.000 pessoas-ano entre mulheres4. O LES afeta indivíduos de todas as idades, mas ocorre predominantemente em mulheres em idade reprodutiva5,6. Pacientes grávidas com LES apresentam maior risco de desfechos gestacionais adversos, incluindo aborto recorrente, natimorto, parto prematuro e restrição do crescimento intrauterino7,8. A perda gestacional recorrente (PGR) é definida como dois ou mais abortos antes de 20–24 semanas de gestação9. Sua prevalência relatada é de aproximadamente 2,6%10, tornando-a uma complicação reprodutiva clinicamente significativa. Aproximadamente 20% das pacientes grávidas com LES experimentam aborto11, e o LES é reconhecido como um fator de risco importante para PGR12. Os mecanismos propostos incluem alterações hormonais e disfunção imunológica. Biomarcadores como anticorpos anticardiolipina e anticoagulante lúpico têm sido investigados como preditores potenciais de desfechos gestacionais adversos em pacientes com LES11. Esses autoanticorpos podem ligar-se às células trofoblásticas placentárias, alterar a sinalização, proliferação e invasão dos trofoblastos, modular a secreção de hormônios e citocinas e aumentar a apoptose, contribuindo assim para desfechos gestacionais prejudicados13. Além disso, a beta-2 glicoproteína I (β2-GPI), um antígeno importante na síndrome antifosfolípide, é expressa no tecido placentário. A ligação de anticorpos anti-β2-GPI à β2-GPI inibe o crescimento e a diferenciação do trofoblasto, resultando em defeitos placentários. Essa interação também promove um ambiente pró-inflamatório caracterizado pela produção de citocinas deletérias e ativação do complemento, contribuindo para trombose placentária e aborto recorrente14,15. No entanto, estudos anteriores frequentemente careceram de análises abrangentes de tecidos reprodutivos locais, como a decídua, limitando a capacidade de correlacionar biomarcadores sistêmicos com alterações patológicas locais. Além disso, o manejo da gravidez complicada por LES e a prevenção de desfechos gestacionais adversos permanecem desafiadores. A suscetibilidade genética contribui para o desenvolvimento do LES, e a variação genética também tem sido implicada na patogênese da PGR16,17. Contudo, se existe uma relação causal entre LES e PGR, bem como os mecanismos moleculares e os genes compartilhados que sustentam sua coexistência, permanece incerto.
A randomização mendeliana (MR) é uma abordagem estabelecida para inferência causal que utiliza variantes genéticas como variáveis instrumentais para estimar os efeitos causais de exposições sobre desfechos de doenças18. Ao explorar a relação entre genótipo e fenótipo, a MR reduz o viés proveniente de confundimento e causalidade reversa em comparação com estudos observacionais convencionais. Paralelamente, os avanços em plataformas de microarranjos genômicos e sequenciamento de alto rendimento permitiram que análises bioinformáticas identificassem biomarcadores diagnósticos candidatos e alvos terapêuticos por meio de perfis transcriptômicos. A integração dessas abordagens complementares pode proporcionar uma compreensão mais abrangente da relação entre LES e RPL, combinando evidências genéticas causais com padrões de expressão gênica associados à doença. Portanto, este estudo teve como objetivo investigar a possível relação causal entre LES e RPL, identificar biomarcadores e vias biológicas compartilhadas candidatas e priorizar alvos para validação futura. Para alcançar esses objetivos, o fluxo analítico foi previamente especificado da seguinte forma: MR bidirecional para avaliar a direção causal; análises independentes de expressão gênica diferencial seguidas de integração transcriptômica; análise de rede de interação proteína-proteína (PPI) e regressão por operador de contração e seleção por mínimos absolutos (LASSO) para priorização de biomarcadores; validação externa de expressão e análise de característica operacional do receptor (ROC); e análise de enriquecimento de conjunto de genes de amostra única (ssGSEA) para avaliar associações com assinaturas de células imunes. Esse fluxo de trabalho em etapas é resumido na Figura 1.
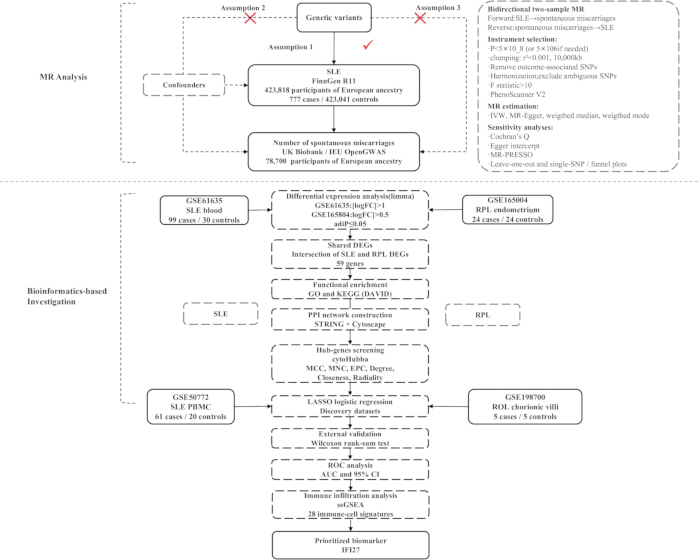
Figura 1. Desenho do estudo e fluxo analítico.
O painel superior ilustra a análise bidirecional de randomização mendeliana (MR) com duas amostras avaliando a associação entre lúpus eritematoso sistêmico (LES) e o número de abortos espontâneos, utilizando estatísticas resumidas de estudos de associação do genoma inteiro (GWAS). São apresentadas a seleção de instrumentos, a eliminação de desequilíbrio de ligação, as análises de randomização mendeliana (MR) e as análises de sensibilidade. O painel inferior descreve o fluxo de trabalho em bioinformática, incluindo análise de expressão diferencial, identificação de genes diferencialmente expressos (DEGs) compartilhados, análise de enriquecimento funcional, construção da rede de interação proteína-proteína (PPI), triagem de genes centrais, regressão por operador de contração e seleção por mínimos absolutos (LASSO), validação externa, análise da curva característica de operação do receptor (ROC), análise de enriquecimento de conjunto de genes por amostra única (ssGSEA) e priorização do biomarcador candidato IFI27. IVW, ponderado pela variância inversa; KEGG, Enciclopédia de Kyoto de Genes e Genomas; GO, Ontologia Genética. Clique aqui para visualizar uma versão maior desta figura.
Protocolo
A aprovação ética não foi necessária para o presente estudo porque ele envolveu apenas análises secundárias de estatísticas sumárias de estudos de associação genômica ampla (GWAS) e conjuntos de dados transcriptômicos anonimizados e disponíveis publicamente. Nenhum novo participante foi recrutado, nenhuma amostra biológica foi coletada e nenhuma informação identificável em nível individual foi acessada. Os estudos originais do FinnGen, UK Biobank e Gene Expression Omnibus relataram que a aprovação ética e o consentimento informado foram obtidos de acordo com os respectivos requisitos institucionais, nacionais e específicos dos bancos de dados. Todos os conjuntos de dados utilizados no presente estudo foram acessados e analisados de acordo com as políticas aplicáveis de uso dos bancos de dados, condições de acesso a dados e diretrizes éticas. Os autores não tentaram reidentificar nenhum participante. Assim sendo, não foi necessário consentimento informado adicional para esta análise secundária. O conteúdo deste estudo inclui duas partes: análise MR e análise bioinformática (Figura 1). Este estudo foi inteiramente computacional e utilizou conjuntos de dados sumários de GWAS e transcriptômicos disponíveis publicamente. Nenhum reagente ou material de consumo de laboratório experimental foi utilizado.
Análise de RM
Fontes de dados, aquisição e pré-processamento das estatísticas sumárias de GWAS:
As estatísticas sumárias de GWAS para lúpus eritematoso foram obtidas do FinnGen Release 11 (finngen_R11_L12_LUPUS; RRID:SCR_022254), uma coorte populacional finlandesa. O fenótipo foi definido utilizando o código CID-10 L93 e incluiu 423.818 participantes, compreendendo 777 casos e 423.041 controles. O arquivo de estatísticas sumárias do FinnGen foi baixado do portal público de dados do FinnGen em formato tabulado comprimido e importado para o R usando a função read_exposure_data() ou read_outcome_data() no TwoSampleMR, dependendo se o conjunto de dados foi usado como exposição ou desfecho. Foram mantidos o rsID, cromossomo, posição genômica, alelo de efeito, outro alelo, frequência do alelo de efeito, coeficiente beta, erro padrão e valor de P de associação.
Estatísticas resumidas para o número de abortos espontâneos foram obtidas do UK Biobank por meio do recurso IEU OpenGWAS (ukb-b-419; RRID:SCR_012815), compreendendo 78.700 participantes. Na análise direta, as associações dos polimorfismos de nucleotídeo único (SNPs) selecionados do FinnGen com o desfecho foram recuperadas usando extract_outcome_data(outcomes = "ukb-b-419", proxies = FALSE). Na análise reversa, SNPs associados ao lúpus eritematoso foram recuperados usando extract_instruments(outcomes = "finngen_R11_L12_LUPUS", clump = FALSE), após o que as associações correspondentes dos SNPs foram extraídas do arquivo de estatísticas resumidas do UK Biobank. As características dos conjuntos de dados de GWAS utilizados nas análises de MR bidirecional são resumidas na Tabela 1.
| Característica | Tamanho da amostra | Ancestralidade | Consortium | Ano | Identificador do conjunto de dados de GWAS |
| Lúpus eritematoso | 4,23,818 | Europeia | FinnGen (RRID: SCR_022254) | 2024 | finngen_R11_L12_LUPUS |
| Número de abortos espontâneos | 78.700 | Europeia | UK Biobank (RRID: SCR_012815) | 2018 | ukb-b-419 |
Tabela 1: Estatísticas sumárias de estudos de associação genômica ampla (GWAS) utilizadas para a análise de randomização mendeliana bidirecional.
A tabela resume os conjuntos de dados de estudos de associação genômica ampla disponíveis publicamente, utilizados como fontes de exposição e desfecho nas análises de randomização mendeliana direta e reversa, incluindo tamanho da amostra, ancestralidade, fonte dos dados, ano de disponibilização dos dados e identificador do conjunto de dados.
O FinnGen e o UK Biobank foram selecionados porque fornecem conjuntos de dados extensos, de acesso público e predominantemente de ascendência europeia, derivados de populações fonte não sobrepostas, e contêm cobertura suficiente de variantes para a MR de duas amostras. Não foi relatada sobreposição entre as amostras de exposição e desfecho. Como foram utilizados apenas dados resumidos, não houve acesso a dados genotípicos em nível individual, nenhuma normalização adicional em nível de participantes foi realizada, e nenhum participante foi excluído pelos investigadores do presente estudo. Baseamo-nos nos procedimentos de controle de qualidade em nível de amostra e em nível de variante implementados pelos consórcios originais de GWAS. Durante a presente análise, foi realizado controle de qualidade adicional em nível de variante por meio de filtragem de significância, agrupamento por desequilíbrio de ligação, harmonização de alelos, avaliação da força do instrumento e triagem de pleiotropia, conforme descrito abaixo.
O FinnGen Release 11 relata posições genômicas de acordo com GRCh38/hg38, enquanto os conjuntos de dados harmonizados do IEU OpenGWAS e o recurso de referência de desequilíbrio de ligação utilizam anotações de variantes compatíveis com GRCh37. Portanto, as variantes de exposição e desfecho foram emparelhadas principalmente por rsIDs estáveis, em vez de coordenadas cromossômicas. Nenhum emparelhamento posicional direto entre montagens foi realizado. Variantes sem um rsID inequívoco ou com informações alélicas inconsistentes entre os conjuntos de dados foram excluídas antes da análise de MR. As estatísticas sumárias do FinnGen Release 11 utilizam GRCh38, enquanto os dados do OpenGWAS são harmonizados com a convenção de sequência de referência usada para a Build 37. Assim, o emparelhamento por rsID é importante quando os dois recursos são combinados.
Desenho do estudo de MR:
Adotamos rigorosamente as diretrizes STROBE-MR (Arquivo Suplementar 1)19. Utilizou-se um delineamento de MR bidirecional com duas amostras para avaliar a relação entre lúpus eritematoso geneticamente predito e o número de abortos espontâneos. Na análise direta, o lúpus eritematoso foi considerado a exposição e o número de abortos espontâneos o desfecho. Na análise reversa, exposição e desfecho foram invertidos, e todo o fluxo de trabalho — seleção de instrumentos, agrupamento por desequilíbrio de ligação, harmonização de dados, estimativa causal e análises de sensibilidade — foi repetido. Polimorfismos de nucleotídeo único (SNPs) foram utilizados como variáveis instrumentais (IVs). O fluxo de trabalho completo foi realizado na seguinte ordem: obtenção e formatação das estatísticas sumárias de GWAS; seleção de SNPs associados à exposição; remoção de variantes duplicadas ou com anotação incompleta; agrupamento por desequilíbrio de ligação; extração das associações correspondentes ao desfecho; exclusão de SNPs diretamente associados ao desfecho; harmonização dos alelos da exposição e do desfecho; cálculo da força do instrumento; triagem para fenótipos de confundimento potenciais; estimativa dos efeitos causais; avaliação de heterogeneidade e pleiotropia horizontal; detecção de outliers pelo método Mendelian Randomization Pleiotropy RESidual Sum and Outlier (MR-PRESSO); e análises de sensibilidade leave-one-out e por SNP individual. Todas as análises de MR foram realizadas utilizando R versão 4.4.2 (RRID:SCR_001905), TwoSampleMR versão 0.6.6 (RRID:SCR_019010), MRPRESSO versão 1.0 (RRID:SCR_023697) e forestploter versão 1.1.2. A análise de MR baseou-se em três pressupostos fundamentais. Primeiro, segundo o pressuposto de relevância, os SNPs selecionados devem estar fortemente associados à exposição. Segundo, segundo o pressuposto de independência, os SNPs selecionados devem ser independentes de fatores que confundam a associação entre exposição e desfecho. Terceiro, segundo o pressuposto de exclusão-restrita, os SNPs selecionados devem influenciar o desfecho apenas por meio da exposição20 (Figura 1).
Métodos de seleção de SNP:
A seleção dos instrumentos foi realizada na seguinte ordem: (1) selecionar SNPs associados à exposição com P < 5 × 10⁻⁸; quando o número de instrumentos fosse insuficiente, utilizar P < 5 × 10⁻⁶; (2) utilizar a função clump_data() para realizar a agrupamento por desequilíbrio de ligação com R2 < 0,001 e uma distância genética de 10.000 kb, relaxando os critérios para R2 < 0,01 dentro de 5.000 kb apenas quando necessário para manter um conjunto de instrumentos analisável; (3) excluir SNPs significativamente associados ao desfecho utilizando um limiar de P = 5 × 10⁻⁵; (4) utilizar a função harmonise_data() para harmonizar os alelos da exposição e do desfecho e excluir variantes palindrômicas ou de outra forma ambíguas; (5) calcular a força do instrumento como F = β2/SE2 e excluir SNPs com F < 10; e (6) analisar os SNPs mantidos no PhenoScanner V2 em busca de fenótipos que poderiam confundir a relação entre LSE e perda gestacional21. Os anticorpos antifosfolípides (aPL) podem ser um fator de risco comum para LSE e para o número de abortos espontâneos. Cada SNP individual foi pesquisado no PhenoScanner V2. Todos os SNPs candidatos foram consultados no PhenoScanner V2 utilizando o catálogo GWAS padrão para recuperar todas as associações relatadas em estudos de associação genômica ampla (GWAS). O limiar de significância foi definido em P < 1 × 10⁻5, e foi utilizada a montagem padrão do genoma de referência (GRCh37). Como a população do estudo era de ascendência europeia, a busca por variantes substitutas foi habilitada utilizando o painel de referência europeu (proxies = "EUR"), com um limiar de LD de R2 > 0,8 dentro de uma janela de 1.000 kb. Todos os demais parâmetros de busca foram mantidos nos valores padrão. SNPs que apresentaram associações significativas com o fator de confusão pré-especificado, anticorpos antifosfolípides (aPL), foram considerados potencialmente pleiotrópicos e excluídos do conjunto final de variáveis instrumentais para minimizar a violação do pressuposto de exclusão na randomização mendeliana. Os SNPs instrumentais mantidos para as análises de RM direta e reversa estão listados nas Tabelas Suplementares 1 e 2, respectivamente.
Análise estatística:
Após a seleção dos instrumentos e a harmonização de alelos, as estimativas causais foram calculadas utilizando a função mr() no TwoSampleMR. O fluxo de trabalho analítico foi realizado na seguinte ordem. Primeiro, o efeito causal geral foi estimado utilizando quatro métodos de MR: ponderação pela inversa da variância (IVW), regressão MR-Egger, mediana ponderada e modo ponderado. As estimativas de efeito para o número de abortos espontâneos e Lúpus Eritematoso Sistêmico (LES) foram apresentadas como razões de chances com os respectivos intervalos de confiança de 95% e valores de P. O método IVW foi designado como análise principal, pois fornece alta potência estatística quando todos os SNPs incluídos são variáveis instrumentais válidas e a pleiotropia horizontal está ausente. No entanto, a estimativa IVW pode ser tendenciosa quando há pleiotropia horizontal22. A regressão MR-Egger foi utilizada principalmente para avaliar inferências causais na presença de pleiotropia horizontal potencial23. A abordagem da mediana ponderada exige que pelo menos 50% do peso analítico provenha de variáveis instrumentais válidas. Este método é ideal quando há heterogeneidade, mas ausência de pleiotropia horizontal24. O modo ponderado identifica agrupamentos de variáveis instrumentais com efeitos causais semelhantes e estima o efeito a partir do maior agrupamento25. As estimativas de efeito obtidas pelos quatro métodos de MR são apresentadas na Figura 2. Segundo, a heterogeneidade entre as estimativas causais específicas de cada SNP foi avaliada utilizando o teste Q de Cochran, implementado pela função mr_heterogeneity(). A estatística Q representa a soma ponderada dos desvios quadráticos das estimativas individuais de SNP em relação à estimativa causal geral. Um valor de P do teste Q < 0,05 foi considerado evidência de heterogeneidade, caso em que foi aplicado um modelo IVW de efeitos aleatórios. Na ausência de heterogeneidade significativa, foi utilizado um modelo IVW de efeitos fixos26. Terceiro, a pleiotropia horizontal direcional foi avaliada utilizando o teste do intercepto MR-Egger, implementado com a função mr_pleiotropy_test(). Um intercepto significativamente diferente de zero em P < 0,05 foi considerado evidência de pleiotropia horizontal direcional. Quarto, o procedimento MR-PRESSO foi realizado utilizando a função mr_presso() no pacote MRPRESSO (RRID:SCR_023697) para detectar SNPs com efeitos pleiotrópicos atípicos27. Quando foram detectados valores atípicos, estes foram removidos e a análise causal foi repetida utilizando os instrumentos restantes. O teste global MR-PRESSO foi usado para avaliar a pleiotropia horizontal geral, e o teste de distorção foi considerado ao avaliar se a remoção dos atípicos alterou substancialmente a estimativa causal. Quinto, foi realizada uma análise de sensibilidade leave-one-out utilizando a função mr_leaveoneout(). Nesta análise, cada SNP foi excluído sequencialmente e a estimativa causal agrupada foi recalculada utilizando os SNPs restantes. Os resultados foram visualizados com mr_leaveoneout_plot() para determinar se a associação geral era desproporcionalmente influenciada por um único instrumento. Sexto, foram geradas estimativas individuais específicas de SNP utilizando a função mr_singlesnp(). Essas estimativas foram usadas para construir gráficos de funil com mr_funnel_plot(), a fim de avaliar visualmente a assimetria potencialmente atribuível à pleiotropia horizontal direcional. Gráficos floresta resumidos foram gerados utilizando o forestploter (versão 1.1.2) para exibir as estimativas de efeito e os intervalos de confiança obtidos pelos diferentes métodos de MR. O gráfico de dispersão do MR direto, o gráfico floresta específico de SNP, a análise leave-one-out e o gráfico de funil são apresentados nas Figuras Suplementares 1–4, respectivamente.
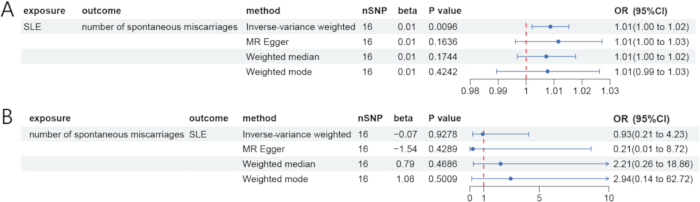
Figura 2. Resultados da análise de randomização mendeliana bidirecional.
(A) Gráfico floresta da análise de randomização mendeliana (MR) direta com lúpus eritematoso sistêmico (LES) como exposição e número de abortos espontâneos como desfecho. (B) Gráfico floresta da análise MR reversa com o número de abortos espontâneos como exposição e LES como desfecho. As estimativas de efeito são apresentadas como razões de chances (ORs) com intervalos de confiança de 95% (ICs) para os métodos ponderados pela variância inversa, MR-Egger, mediana ponderada e modo ponderado. SNP, polimorfismo de nucleotídeo único. Clique aqui para visualizar uma versão maior desta figura.
Considerou-se que uma associação causal era apoiada quando a estimativa IVW era estatisticamente significativa em P < 0,05, as estimativas do MR-Egger, mediana ponderada e moda ponderada mostravam direções consistentes com a estimativa IVW, e os resultados não eram substancialmente alterados pela heterogeneidade, pleiotropia, MR-PRESSO ou análises de sensibilidade leave-one-out. Todos os testes estatísticos foram bicaudais.
Análise de bioinformática
Dados de microarranjo:
Os conjuntos de dados transcriptômicos foram obtidos do banco de dados Gene Expression Omnibus (GEO; RRID:SCR_005012)28. Os arquivos Series Matrix processados, metadados das amostras e arquivos de anotação da plataforma foram baixados para GSE61635, GSE165004, GSE50772 e GSE198700. A plataforma, origem do tecido, tamanho da amostra e categoria de análise de cada conjunto de dados são resumidos na Tabela 2. Como os conjuntos de dados foram gerados a partir de tecidos diferentes e plataformas de microarranjo distintas, cada conjunto foi pré-processado e analisado independentemente. Matrizes de expressão de diferentes conjuntos de dados não foram diretamente mescladas, e nenhuma correção de lote entre plataformas foi aplicada. A integração entre conjuntos de dados foi realizada apenas ao nível do símbolo gênico, após a conclusão da análise de expressão diferencial de forma independente em cada conjunto de dados de descoberta.
| Conjunto de dados GEO | Doença | Plataforma | Tecido (Homo sapiens) | Casos | Controles | Tipo de experimento | Contribuinte | Categoria do conjunto de dados |
| GSE61635 | Lúpus eritematoso sistêmico (LES) | GPL570 | Sangue total | 99 | 30 | Microarranjo de expressão | Greidinger EL | Conjunto de dados de descoberta |
| GSE165004 | Perda gestacional recorrente (PGR) | GPL16699 | Endométrio | 24 | 24 | Microarranjo de expressão | Keleş ID29 | Conjunto de dados de descoberta |
| GSE50772 | Lúpus eritematoso sistêmico (LES) | GPL570 | Células mononucleares do sangue periférico (PBMCs) | 61 | 20 | Microarranjo de expressão | Kennedy WP30 | Conjunto de dados de validação |
| GSE198700 | Perda gestacional recorrente (PGR) | GPL13534 | Vilosidades coriônicas | 5 | 5 | Microarranjo de expressão | Li Y31 | Conjunto de dados de validação |
Tabela 2: Conjuntos de dados transcriptômicos utilizados nas análises de bioinformática.
A tabela resume os conjuntos de dados transcriptômicos do Gene Expression Omnibus (GEO) incluídos nas análises de descoberta e validação, incluindo doença, plataforma de microarranjo, origem do tecido, tamanho da amostra, tipo de experimento, pesquisador responsável pelo estudo original e categoria do conjunto de dados.
O GSE61635 foi gerado utilizando a plataforma Affymetrix Human Genome U133 Plus 2.0 Array (GPL570) e compreendia 99 matrizes de sangue total de pacientes com LÚPUS, incluindo visitas repetidas de alguns pacientes, e 30 matrizes de controles saudáveis independentes. A matriz de expressão depositada já havia passado por correção de fundo média robusta de múltiplas matrizes, normalização por quantis, resumo dos conjuntos de sondas e transformação log2 realizadas pelos investigadores originais. Portanto, nenhuma segunda correção de fundo ou normalização por quantis foi realizada. Os identificadores dos pacientes foram extraídos dos metadados do GEO e mantidos para modelagem de medidas repetidas.
O GSE165004 foi gerado utilizando a plataforma de microarranjo Agilent SurePrint G3 Human Gene Expression v2 8×60K (GPL16699). O conjunto completo de dados continha 24 controles férteis, 24 pacientes com aborto de repetição (RPL) e 24 pacientes com infertilidade inexplicada. Apenas as 24 amostras de RPL e 24 amostras de controles férteis coletadas nos dias 19–21 do ciclo menstrual foram incluídas; as 24 amostras de infertilidade inexplicada foram excluídas porque estavam fora da comparação pré-definida29. Foi utilizada a matriz de expressão normalizada pelo depositante, e nenhuma normalização adicional entre matrizes foi aplicada após a confirmação de distribuições comparáveis das amostras por meio de gráficos de caixa e gráficos de densidade.
O conjunto de dados GSE50772 foi utilizado como conjunto de validação independente de LÚP e incluiu amostras de células mononucleares do sangue periférico de 61 pacientes com LÚP e 20 controles saudáveis, geradas usando GPL57030. O conjunto GSE198700 foi gerado usando GPL13534 e contém amostras de vilosidades coriônicas de cinco pacientes com ARP e cinco controles submetidos a aborto eletivo31. A matriz de expressão depositada foi importada integralmente e transformada uma única vez usando log2(x + 1), pois os valores de expressão depositados foram fornecidos em uma escala não logarítmica. Essa transformação foi aplicada à matriz completa de expressão antes do controle de qualidade em nível de amostra, anotação de sondas, resumo em nível gênico, validação de genes candidatos, análise de expressão diferencial, testes de comparação entre grupos e análise ROC. Os genes candidatos não foram transformados separadamente, e nenhuma transformação logarítmica adicional foi realizada durante as análises subsequentes de validação. Para todos os conjuntos de dados, as identidades das amostras, o status da doença, a origem tecidual e os rótulos dos grupos foram verificados cruzadamente com os metadados correspondentes do GEO antes da análise. O controle de qualidade incluiu avaliação dos tamanhos das bibliotecas ou distribuições de expressão, boxplots por amostra, análise de componentes principais, agrupamento hierárquico e mapas de calor de distância entre amostras. Nenhuma amostra adicional foi excluída após a avaliação do controle de qualidade.
Análise de expressão diferencial:
As análises de expressão diferencial foram realizadas independentemente para GSE61635 e GSE165004 utilizando o limma versão 3.60.6 (RRID:SCR_010943). Todas as matrizes de expressão foram organizadas com genes nas linhas e amostras nas colunas. O limiar para expressão diferencial foi definido em |log₂ razão de variação| > 1 para GSE61635 e |log₂ razão de variação| > 0,5 para GSE165004, com um valor de P ajustado pelo método de Benjamini–Hochberg (BH) < 0,05. Os gráficos de vulcão foram gerados usando o ggplot2 versão 3.5.1 (RRID:SCR_014601). Mapas de calor dos 50 genes diferencialmente expressos (GDEs) mais significativos, ordenados pelo valor de P ajustado, foram gerados utilizando o pheatmap versão 1.0.12 (RRID:SCR_016418). Os GDEs compartilhados foram identificados pela interseção dos símbolos oficiais dos genes das listas significativas de GDEs de LSE e RPL, utilizando a função base R intersect() e foram visualizados usando o ggvenn versão 0.1.16 (RRID:SCR_025300). Os mapas de calor de expressão diferencial, gráficos de vulcão e a interseção das listas de GDEs de LSE e RPL são apresentados na Figura 3.
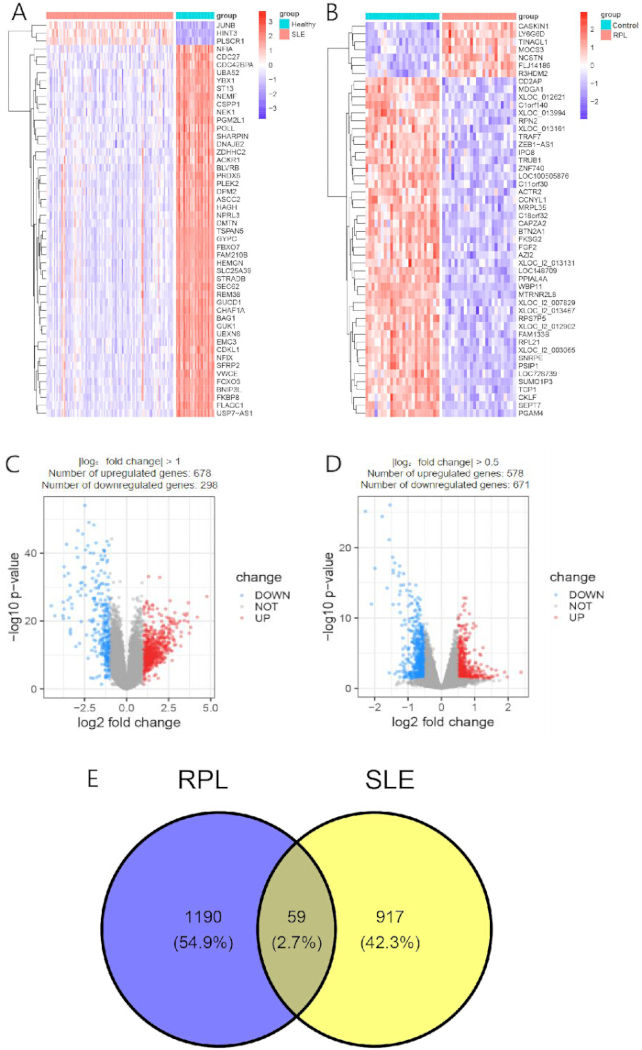
Figura 3. Genes diferencialmente expressos no lúpus eritematoso sistêmico e na perda gestacional recorrente.
(A) Mapa de calor dos 50 genes diferencialmente expressos (GDEs) mais significativos entre pacientes com lúpus eritematoso sistêmico (LES) e controles saudáveis no conjunto de dados GSE61635. (B) Mapa de calor dos 50 GDEs mais significativos entre pacientes com perda gestacional recorrente (PGR) e controles férteis no conjunto de dados GSE165004. (C) Gráfico de vulcão da expressão gênica diferencial no conjunto de dados GSE61635. (D) Gráfico de vulcão da expressão gênica diferencial no conjunto de dados GSE165004. (E) Diagrama de Venn mostrando a sobreposição entre as listas significativas de GDEs dos conjuntos de dados de descoberta do LES e da PGR. GDEs, genes diferencialmente expressos. Clique aqui para visualizar uma versão maior desta figura.
Análise de enriquecimento funcional dos DEGs da interseção:
Para análise em nível molecular das funções dos DEGs, a ferramenta online DAVID (versão 2021; RRID:SCR_001881)32 foi utilizada para realizar análises de enriquecimento funcional da Ontologia Genética (GO) e de vias da Enciclopédia de Kyoto de Genes e Genomas (KEGG). Os símbolos oficiais dos genes humanos foram carregados como tipo de identificador, e Homo sapiens foi selecionado como a espécie. A população de fundo personalizada consistiu na interseção de todos os genes que passaram pela anotação das sondas e controle de qualidade e que foram mensuráveis em ambos os conjuntos GSE61635 e GSE165004. O limite mínimo de contagem de genes foi definido como 2, e a pontuação máxima EASE, que representa o valor P exato de Fisher unicaudal modificado pelo DAVID, foi definida como 0,05. As comparações múltiplas foram controladas utilizando o procedimento de Benjamini–Hochberg informado na coluna “Benjamini” do DAVID. Os termos funcionais foram considerados estatisticamente significativos quando a pontuação EASE era < 0,05 e o valor P ajustado por Benjamini era < 0,05. A saída completa do DAVID, incluindo nomes dos termos, contagens de genes, pontuações EASE, valores P ajustados por Benjamini, mapeamentos dos genes de entrada e mapeamentos dos genes de fundo, foi exportada como um arquivo delimitado por tabulações. O site CNSknowall foi utilizado para visualizar os resultados filtrados do DAVID. Os resultados de enriquecimento GO e KEGG são apresentados na Figura 4A.
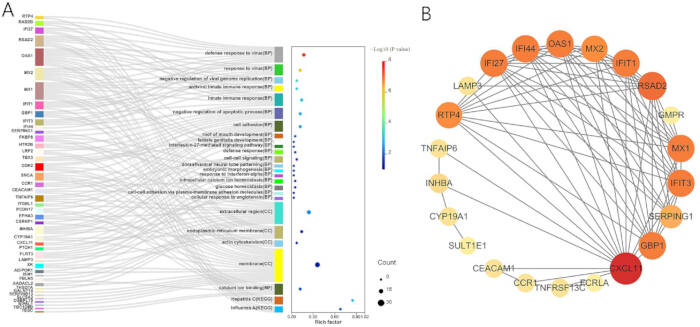
Figura 4. Análise de enriquecimento funcional e rede de interação proteína-proteína dos genes diferencialmente expressos compartilhados.
(A) Análises de enriquecimento Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) dos 59 genes diferencialmente expressos (GDEs) compartilhados. O diagrama de Sankey ilustra as relações entre os genes e os termos GO enriquecidos, e o gráfico de bolhas correspondente resume os termos GO e KEGG enriquecidos de acordo com o fator de riqueza, contagem de genes e significância estatística. (B) Rede de interação proteína-proteína (PPI) construída a partir dos 59 GDEs compartilhados utilizando o STRING e visualizada no Cytoscape. O tamanho e a cor dos nós refletem a conectividade da rede, e as arestas indicam associações proteína-proteína previstas. BP, processo biológico; CC, componente celular; MF, função molecular. Clique aqui para visualizar uma versão maior desta figura.
Rede PPI e identificação de genes centrais:
Os DEGs compartilhados foram enviados ao STRING versão 11.0 (RRID:SCR_005223)33 com Homo sapiens selecionado como o organismo (identificador taxonômico: 9606). A rede completa do STRING foi utilizada, permitindo associações proteicas funcionais e físicas. Todos os canais de evidência disponíveis foram ativados, incluindo evidência experimental, bancos de dados curados, coexpressão, mineração de texto, vizinhança gênica, fusão gênica e coocorrência gênica.
A pontuação mínima de interação exigida foi definida em 0,400, correspondendo a confiança média. Nenhum interator adicional da primeira ou segunda camada foi adicionado; portanto, a rede continha apenas proteínas codificadas pelos DEGs compartilhados submetidos. As arestas da rede foram exibidas no modo de confiança e exportadas como um arquivo de valores separados por tabulação contendo as proteínas interagentes e as pontuações combinadas do STRING. As pontuações de confiança do STRING representam a confiança de que uma associação existe, e não a magnitude ou a força de ligação da interação.
O arquivo da rede STRING foi importado para o Cytoscape versão 3.10.0 (RRID:SCR_003032)34. Os nós sem qualquer interação com outra proteína submetida foram removidos antes da análise da topologia da rede35. A rede restante foi tratada como uma rede não direcionada. Os escores combinados do STRING foram mantidos como atributos das arestas para visualização, enquanto os rankings do cytoHubba foram gerados utilizando as definições topológicas padrão não ponderadas. A rede de interação proteína-proteína (PPI) resultante é apresentada na Figura 4B.
Os genes centrais foram classificados usando o cytoHubba versão 0,1 (RRID:SCR_017677) com seis algoritmos: Centralidade de Clique Máxima (MCC), Componente Máximo da Vizinhança (MNC), Componente de Percolação de Arestas (EPC), Grau, Proximidade e Radialidade36. Para cada algoritmo, os genes foram classificados em ordem decrescente, e os 10 principais genes foram mantidos. Os candidatos a hubs da rede foram definidos usando a interseção rigorosa das seis listas dos 10 primeiros. Assim, um gene foi mantido como hub da rede apenas se aparecesse entre os 10 principais genes gerados por todos os seis algoritmos. Os rankings e o procedimento de interseção foram exportados e arquivados. Os 10 principais genes identificados por cada algoritmo do cytoHubba são apresentados na Tabela 3.
| Classificação | Centralidade de Clique Máxima (MCC) | Componente Máximo do Vizinho (MNC) | Componente de Percolação de Arestas (EPC) | Grau | Proximidade | Radialidade |
| 1 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 |
| 2 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 |
| 3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 |
| 4 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 |
| 5 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 |
| 6 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 |
| 7 | MX1 | MX1 | MX1 | MX1 | MX1 | MX1 |
| 8 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 |
| 9 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 |
| 10 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 |
Tabela 3: Os 10 principais genes hub identificados por seis algoritmos de classificação cytoHubba.
Os genes diferencialmente expressos compartilhados foram classificados utilizando seis algoritmos de topologia de rede implementados no plugin cytoHubba do Cytoscape. Os 10 principais genes classificados por cada algoritmo são apresentados para comparação entre Centralidade de Clique Máxima (MCC), Componente de Vizinhança Máxima (MNC), Componente de Percolação de Arestas (EPC), Grau, Proximidade e Radialidade.
Regressão LASSO para identificação de genes centrais:
A regressão logística LASSO foi realizada independentemente nos conjuntos de dados de descoberta de LÚPUS e RPE utilizando o glmnet versão 4.1-8 (RRID:SCR_015505). A matriz de preditores consistiu nos valores de expressão normalizados dos candidatos a hubs da rede, com amostras nas linhas e genes nas colunas. O status da doença foi codificado como 1 e o status de controle como 0. Um modelo linear generalizado binomial com penalidade pura LASSO foi ajustado utilizando family = "binomial" e alpha = 1. As variáveis preditoras foram padronizadas internamente usando standardize = TRUE, e foi incluído um intercepto. Atribuições estratificadas por classe em 10 grupos foram geradas separadamente para os conjuntos de dados de LÚPUS e RPE usando um código personalizado em R base. Dentro de cada estrato de status da doença, os índices das amostras foram permutados aleatoriamente e distribuídos de forma tão uniforme quanto possível entre os 10 grupos usando sample(rep(seq_len(10), length.out = n)). Uma semente aleatória de 123 foi definida antes da geração das atribuições de grupo para cada conjunto de dados, a fim de garantir reprodutibilidade. Como cada grupo de status da doença continha mais de 10 amostras, cada dobra da validação cruzada incluiu tanto casos quanto controles. Os vetores inteiros resultantes (foldid_sle e foldid_rpl) foram fornecidos ao argumento foldid do cv.glmnet(), e as mesmas atribuições de dobra foram utilizadas para todos os valores de λ avaliados dentro do conjunto de dados correspondente.
Os modelos foram ajustados utilizando family = "binomial", alpha = 1, nfolds = 10, type.measure = "deviance", standardize = TRUE, intercept = TRUE, nlambda = 100, thresh = 1 × 10⁻7, e maxit = 100000. O parâmetro de penalidade foi selecionado usando lambda.min, definido como o valor de lambda que produz o desvio binomial mínimo médio validado por cruzamento. O valor mais conservador lambda.1se, definido como o maior lambda dentro de um erro padrão do erro mínimo de validação cruzada, foi registrado como resultado de sensibilidade. O procedimento LASSO foi aplicado separadamente aos conjuntos de dados GSE61635 e GSE165004. Genes com coeficientes não nulos em ambos os modelos específicos da doença foram definidos como genes candidatos compartilhados selecionados pelo LASSO. Ao introduzir o termo de regularização L1, o método reduz efetivamente os coeficientes dos genes menos informativos a zero, realizando assim a seleção de características37. Os perfis de coeficientes e as curvas de validação cruzada de 10 dobras para os conjuntos de dados de descoberta de LER e RPL são apresentados na Figura 5.
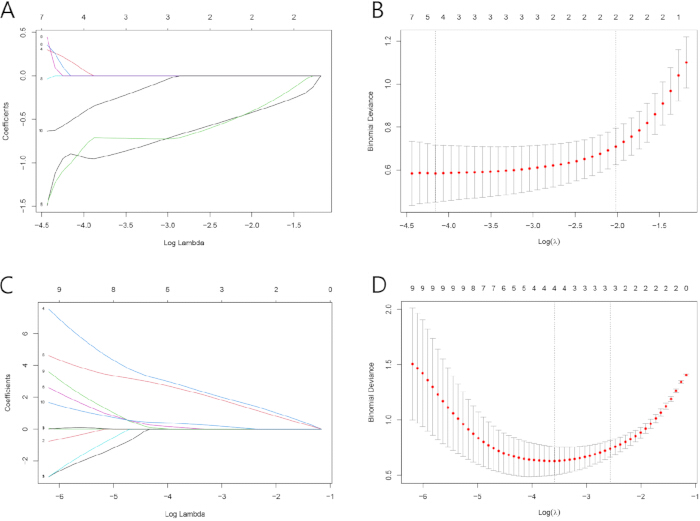
Figura 5. Análise de regressão por operador de contração e seleção de mínimos absolutos dos genes centrais da rede.
(A) Perfis de coeficientes gerados pela regressão logística por operador de contração e seleção de mínimos absolutos (LASSO) para o conjunto de dados de descoberta de lúpus eritematoso sistêmico (LES) (GSE61635). (B) Curva de validação cruzada com dez dobras utilizada para determinar o parâmetro de penalidade ótimo (λ) para o modelo de LES. (C) Perfis de coeficientes gerados pela regressão logística LASSO para o conjunto de dados de descoberta de aborto de repetição (AR) (GSE165004). (D) Curva de validação cruzada com dez dobras utilizada para determinar o parâmetro de penalidade ótimo (λ) para o modelo de AR. Os números ao longo do eixo x superior indicam o número de coeficientes de regressão não nulos em cada valor de λ. As linhas verticais tracejadas indicam λ_min e λ_1se. Clique aqui para visualizar uma versão maior desta figura.
Validação do valor diagnóstico dos genes centrais:
Os padrões de expressão dos genes candidatos selecionados pelo LASSO foram avaliados no conjunto de dados independente de LÚPUS (SLE) GSE50772 e no conjunto de dados independente de RPL GSE198700. Os conjuntos de dados externos foram utilizados somente após a seleção dos genes candidatos ter sido concluída nos conjuntos GSE61635 e GSE165004. Nenhuma seleção adicional de características ou ajuste de modelo foi realizada nos conjuntos de dados de validação. A expressão dos genes candidatos foi comparada entre casos e controles utilizando o teste de soma de postos de Wilcoxon bicaudal. Quando mais de um gene candidato foi testado dentro de um mesmo conjunto de dados, os valores de P resultantes foram corrigidos utilizando o procedimento de Benjamini–Hochberg. Um gene candidato foi considerado externamente replicado quando sua expressão diferiu significativamente entre casos e controles após a correção para múltiplos testes e sua direção foi consistente com o conjunto de dados de descoberta correspondente. Os padrões de expressão dos genes candidatos nos conjuntos de dados de descoberta e de validação são apresentados na Figura 6.
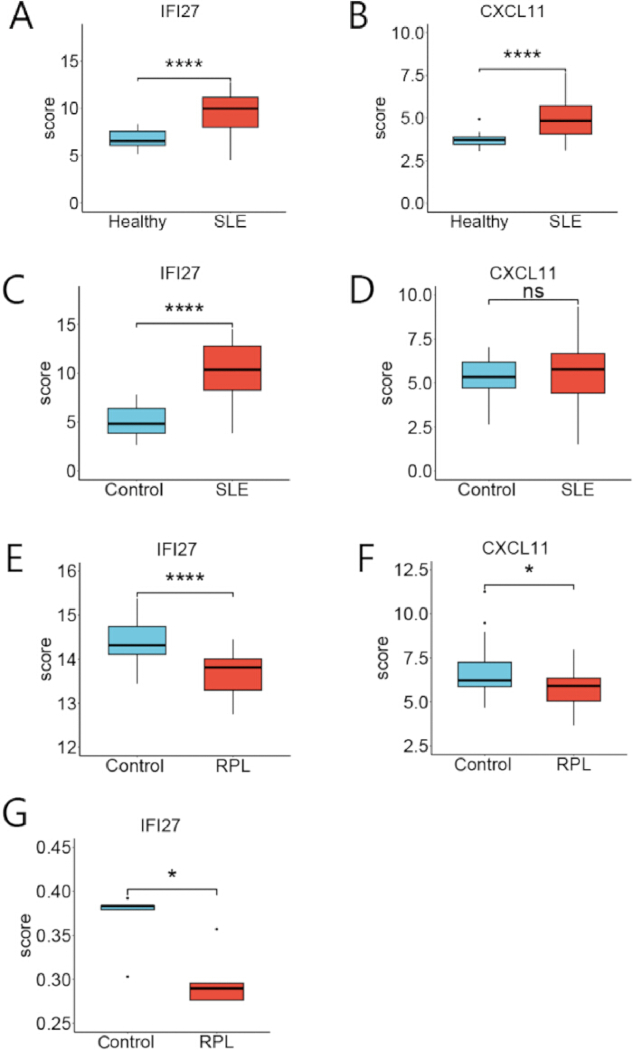
Figura 6. Expressão de IFI27 e CXCL11 nos conjuntos de dados de descoberta e validação.
(A,B) Expressão de IFI27 e CXCL11, respectivamente, no conjunto de dados de descoberta de lúpus eritematoso sistêmico (LES) (GSE61635). (C,D) Expressão de IFI27 e CXCL11, respectivamente, no conjunto de dados de validação independente de LES (GSE50772). (E,F) Expressão de IFI27 e CXCL11, respectivamente, no conjunto de dados de descoberta de aborto recorrente (AR) (GSE165004). (G) Expressão de IFI27 no conjunto de dados de validação independente de AR (GSE198700). A expressão gênica foi comparada entre grupos utilizando o teste de soma de postos de Wilcoxon bicaudal. Valores de P foram ajustados utilizando o método de Benjamini–Hochberg quando múltiplos genes candidatos foram testados dentro do mesmo conjunto de dados. P < 0,05; **** P < 0,0001; ns, não significativo. Clique aqui para visualizar uma versão maior desta figura.
Análises de característica operacional do receptor (ROC) foram realizadas utilizando o pROC versão 1.18.5 (RRID:SCR_024286)38. Curvas ROC separadas foram geradas para cada gene candidato em cada conjunto de dados de descoberta. A área sob a curva ROC (AUC) e seu intervalo de confiança bilateral de 95% foram calculadas utilizando o método de DeLong. O ponto de corte diagnóstico exploratório foi determinado usando o índice máximo de Youden. Os intervalos de confiança para o ponto de corte, sensibilidade e especificidade foram calculados utilizando 2.000 réplicas de reamostragem bootstrap estratificada com a semente aleatória definida como 123. A AUC foi utilizada como uma medida independente de limiar para discriminação39. Como os conjuntos de dados eram retrospectivos e gerados utilizando diferentes tecidos, plataformas e procedimentos de normalização, os pontos de corte derivados do índice de Youden foram calculados separadamente dentro de cada conjunto de dados e tratados como limiares exploratórios específicos a cada conjunto. Eles não foram considerados pontos de corte clínicos padronizados e não foram transferidos diretamente entre plataformas. Os resultados ROC externos representam validação transcriptômica, e não validação clínica prospectiva. O pROC suporta intervalos de confiança de DeLong para AUCs e otimização por índice de Youden por meio da função coords(), enquanto os intervalos de confiança para coordenadas ROC podem ser estimados utilizando reamostragem bootstrap estratificada. As curvas ROC e os resumos da discriminação dos genes candidatos nos conjuntos de dados de descoberta de LÚPUS e RPL são apresentados na Figura 7.
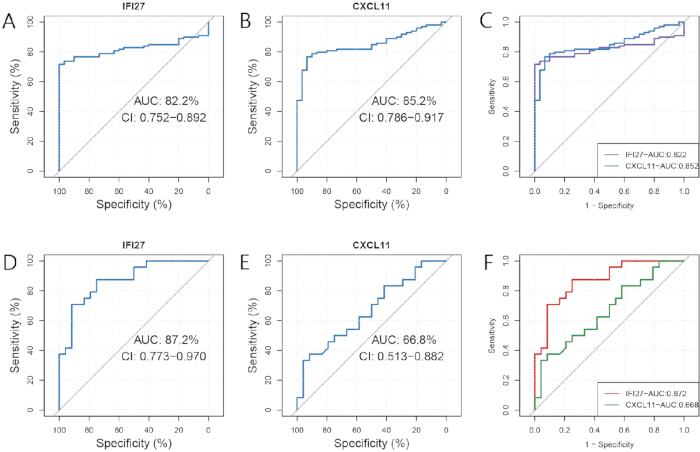
Figura 7. Análise da curva característica de operação do receptor dos genes candidatos.
(A) Curva característica de operação do receptor (ROC) para IFI27 no conjunto de dados de descoberta de lúpus eritematoso sistêmico (SLE). (B) Curva ROC para CXCL11 no conjunto de dados de descoberta de SLE. (C) Resumo do desempenho diagnóstico de IFI27 e CXCL11 no conjunto de dados de descoberta de SLE. (D) Curva ROC para IFI27 no conjunto de dados de descoberta de perda gestacional recorrente (RPL). (E) Curva ROC para CXCL11 no conjunto de dados de descoberta de RPL. (F) Resumo do desempenho diagnóstico de IFI27 e CXCL11 no conjunto de dados de descoberta de RPL. Os valores da área sob a curva (AUC) são apresentados com intervalos de confiança de 95% (ICs). Clique aqui para visualizar uma versão maior desta figura.
Infiltração imune por ssGSEA:
Considerando os papéis da desregulação das células imunes na patogênese do LES e da RPE40,41, a enriquecimento por células imunes foi inferido computacionalmente nos conjuntos de dados de descoberta GSE61635 e GSE165004. A análise foi realizada separadamente em cada conjunto de dados, e os conjuntos não foram combinados. A coleção de assinaturas gênicas de células imunes consistiu nos conjuntos de genes marcadores para 28 populações de células imunes descritas por Charoentong et al.42. A tabela original suplementar de assinaturas gênicas foi convertida em uma lista nomeada de conjuntos gênicos usando os símbolos oficiais dos genes humanos. Símbolos duplicados dentro de cada conjunto gênico foram removidos. Genes ausentes da matriz de expressão correspondente foram descartados, e conjuntos gênicos contendo menos de cinco genes correspondentes após o mapeamento de identificadores foram excluídos daquele conjunto de dados. A análise de enriquecimento de conjunto de genes em amostra única (ssGSEA) foi realizada usando o GSVA versão 1.52.3 (RRID:SCR_021058) e o GSEABase versão 1.66.0. Na versão 1.52.3 do GSVA, é necessário um objeto de parâmetro específico do método. Os seguintes parâmetros foram utilizados: minSize = 5, maxSize = 500, alpha = 0,25, normalize = TRUE e checkNA = "yes”.
O parâmetro alfa foi definido como 0,25 e a normalização final da pontuação ssGSEA foi habilitada. Os conjuntos de genes foram restritos a 5–500 genes após o pareamento com a matriz de expressão. A execução com uma única thread foi utilizada para garantir um cálculo consistente entre os sistemas. O parâmetro kcdf não foi utilizado porque não é um parâmetro do procedimento ssgseaParam() na versão 1.52.3 do GSVA. O ssGSEA produz pontuações relativas de enriquecimento de conjuntos de genes ao nível da amostra, em vez de contagens experimentais de células imunes ou frações celulares absolutas43. O fluxo de trabalho do GSVA 1.52.3 exige um objeto de parâmetros específico do método, e os parâmetros do ssGSEA incluem alfa, normalização da pontuação e limites de tamanho do conjunto de genes.
Para cada assinatura de célula imune, as pontuações de ssGSEA foram comparadas entre os grupos com doença e controle utilizando o teste de soma de postos de Wilcoxon bicaudal. Os valores de P para as 28 comparações de tipos celulares foram ajustados separadamente dentro de cada conjunto de dados utilizando o método de Benjamini–Hochberg. Assinaturas de células imunes com valor de P ajustado < 0,05 foram consideradas diferencialmente enriquecidas.
Foram calculadas as correlações de postos de Spearman entre a expressão dos genes candidatos e a pontuação ssGSEA de cada assinatura de célula imune dentro de cada conjunto de dados. Os valores de P de correlação foram ajustados utilizando o método de Benjamini–Hochberg em todas as combinações de gene candidato e célula imune dentro desse conjunto de dados. As correlações foram consideradas estatisticamente significativas com valor de P ajustado < 0,05. As matrizes de correlação foram visualizadas usando o pacote ggcorrplot versão 0.1.4.1, e os gráficos de comparação entre grupos foram gerados usando o ggplot2 versão 3.5.1.
Os escores ssGSEA normalizados brutos foram utilizados em todos os testes estatísticos. Mapas de calor e visualizações empilhadas foram usados apenas para apresentação descritiva. Os escores não foram descritos como proporções diretas de células imunes, e as associações observadas foram interpretadas como correlações computacionais, e não como interações célula-gene demonstradas experimentalmente. Os perfis de enriquecimento de assinaturas de células imunes, comparações entre grupos e correlações com a expressão de genes candidatos são apresentados na Figura 8.
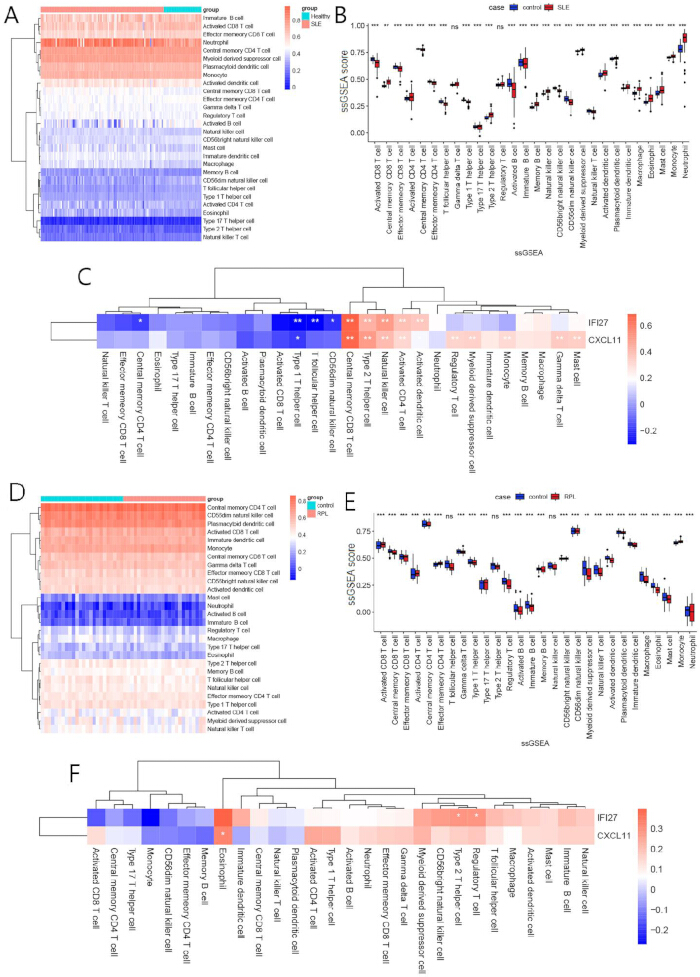
Figura 8. Enriquecimento da assinatura de células imunes e correlações com os genes candidatos compartilhados no lúpus eritematoso sistêmico e na perda gestacional recorrente.
(A) Mapa de calor de agrupamento hierárquico dos escores de análise de enriquecimento de conjunto de genes de amostra única (ssGSEA) para 28 assinaturas de células imunes no conjunto de dados de descoberta do lúpus eritematoso sistêmico (LES). (B) Comparação dos escores ssGSEA da assinatura de células imunes entre pacientes com LES e controles saudáveis. (C) Mapa de calor de correlação de Spearman mostrando as associações entre a expressão de IFI27 e CXCL11 e os escores ssGSEA das 28 assinaturas de células imunes no conjunto de dados de descoberta do LES. (D) Mapa de calor de agrupamento hierárquico dos escores ssGSEA para 28 assinaturas de células imunes no conjunto de dados de descoberta da perda gestacional recorrente (PGR). (E) Comparação dos escores ssGSEA da assinatura de células imunes entre pacientes com PGR e controles férteis. (F) Mapa de calor de correlação de Spearman mostrando as associações entre a expressão de IFI27 e CXCL11 e os escores ssGSEA das 28 assinaturas de células imunes no conjunto de dados de descoberta da PGR. As correlações foram calculadas usando o coeficiente de correlação de postos de Spearman, e os valores de P foram ajustados pelo método de Benjamini–Hochberg. P < 0,05; ** P < 0,01; *** P < 0,001; ns, não significativo. Clique aqui para visualizar uma versão maior desta figura.
Resultados
Análise de MR
Após a seleção dos instrumentos e a harmonização dos dados, 16 SNPs foram mantidos para a análise de MR direta, na qual o LÚP era considerado a exposição e o número de abortos espontâneos o desfecho. Informações detalhadas sobre as variáveis instrumentais estão fornecidas na Tabela Suplementar 1. Todos os SNPs mantidos apresentaram estatísticas F superiores a 10, indicando que o viés de instrumento fraco era improvável. Cada SNP mantido também foi analisado usando o PhenoScanner V2, e nenhum SNP associado ao aPL foi identificado. A análise MR-PRESSO não identificou outliers. O teste Q de Cochran não mostrou heterogeneidade significativa entre as estimativas específicas para cada SNP (Q = 16,12, P = 0,31); portanto, foi aplicado um modelo IVW de efeitos fixos. O teste do intercepto de MR-Egger não indicou pleiotropia horizontal direcional (P = 0,69). A análise IVW mostrou uma associação positiva estatisticamente significativa, mas quantitativamente modesta, entre LÚP predito geneticamente e o número de abortos espontâneos (razão de chances [OR] = 1,01, intervalo de confiança de 95% [IC] = 1,00–1,02, P < 0,01; Figura 2A). As estimativas de efeito obtidas por meio da regressão MR-Egger (OR = 1,01, IC 95% = 1,00–1,03, P = 0,16), do método da mediana ponderada (OR = 1,01, IC 95% = 1,00–1,02, P = 0,17) e do método da moda ponderada (OR = 1,01, IC 95% = 0,99–1,03, P = 0,42) foram consistentes em direção com a estimativa IVW, embora individualmente não tenham atingido significância estatística. A análise leave-one-out mostrou que a exclusão de qualquer SNP isolado não alterou substancialmente a estimativa agrupada, e o gráfico em funnel aproximadamente simétrico não forneceu evidência visual de que o resultado fosse impulsionado por pleiotropia direcional acentuada. O gráfico de dispersão correspondente, o gráfico floresta específico por SNP, a análise leave-one-out e o gráfico em funnel estão apresentados nas Figuras Suplementares 1–4.
Na análise MR reversa, 16 SNPs foram mantidos após a seleção do instrumento, e todos apresentaram estatísticas F maiores que 10 (Tabela Suplementar 2). A análise MR-PRESSO não identificou outliers. O teste Q de Cochran não mostrou heterogeneidade significativa (Q = 13.41, P = 0,50), e o teste do intercepto MR-Egger não forneceu evidência de pleiotropia horizontal direcional (P = 0,41). A estimativa IVW não apoiou uma associação entre o número geneticamente predito de abortos espontâneos e o risco de LÚPUS (OR = 0,93, IC 95% = 0,21–4,23, P = 0,93; Figura 2B). Em conjunto, os resultados de MR apoiam uma associação modesta na direção direta, do LÚPUS geneticamente predito para o número de abortos espontâneos, enquanto a análise reversa não apoiou uma associação do número geneticamente predito de abortos espontâneos para o risco de LÚPUS.
Análise de bioinformática
Análise de expressão diferencial:
A análise de expressão diferencial do GSE61635 identificou 976 genes diferencialmente expressos (GDEs) entre os grupos de Lúpus Eritematoso Sistêmico (LES) e controles saudáveis, incluindo 678 genes superexpressos e 298 genes subexpressos (Figura 3C). A análise do GSE165004 identificou 1.249 GDEs entre os grupos de Lúpus Eritematoso Recorrente (LER) e controles, incluindo 578 genes superexpressos e 671 genes subexpressos (Figura 3D). Os mapas de calor mostrando os 50 GDEs mais significativos nos dois conjuntos de dados de descoberta são apresentados nas Figuras 3A e 3B. Além disso, 59 GDEs comuns foram identificados entre os dois conjuntos de dados (Figura 3E). Esses GDEs comuns constituíram o conjunto de genes utilizado nas análises subsequentes de enriquecimento funcional e de rede.
Análise de enriquecimento funcional dos DEGs em interseção:
Os 59 DEGs compartilhados foram submetidos a análises de enriquecimento de vias GO e KEGG utilizando o DAVID. Na categoria de processo biológico, os DEGs compartilhados apresentaram enriquecimento em resposta de defesa ao vírus, resposta ao vírus, regulação negativa da replicação do genoma viral, resposta imune inata antiviral, regulação negativa do processo apoptótico e adesão celular. Os termos enriquecidos relacionados ao componente celular incluíram região extracelular, membrana do retículo endoplasmático, citoesqueleto de actina e membrana. A ligação ao íon cálcio foi identificada entre os termos enriquecidos de função molecular. A análise KEGG mostrou enriquecimento em vias relacionadas à hepatite C e à influenza A (Figura 4A). Esses achados indicam que os DEGs compartilhados estavam predominantemente associados a processos biológicos antivirais e relacionados à imunidade, fornecendo contexto funcional para os genes comuns aos conjuntos de dados de descoberta de LEP e RPL.
Rede de interação proteína-proteína e identificação de genes centrais
Os 59 DEGs compartilhados foram enviados ao STRING para construir uma rede de interação proteína-proteína (PPI) utilizando um escore mínimo de confiança de interação de 0,400. A rede resultante continha 59 nós e 80 arestas. A rede foi importada para o Cytoscape versão 3.10.0 para visualização, e os nós isolados foram removidos antes da análise topológica (Figura 4B). A classificação dos genes centrais foi realizada utilizando o plugin cytoHubba. Seis algoritmos foram aplicados: Centralidade de Clique Máxima (MCC), Componente Máximo da Vizinhança (MNC), Componente de Percolação de Arestas (EPC), Grau, Proximidade e Radialidade. Os mesmos 10 genes foram identificados entre os genes com as classificações mais altas geradas pelos seis algoritmos: RSAD2, RTP4, IFIT3, IFI27, IFI44, GBP1, MX1, OAS1, IFIT1 e CXCL11 (Tabela 3). Esses genes foram, portanto, mantidos como candidatos a genes centrais da rede para a regressão LASSO subsequente.
A regressão LASSO identificou IFI27 e CXCL11 como genes candidatos compartilhados
Os 10 genes centrais candidatos foram submetidos à análise de regressão LASSO nos conjuntos de dados de descoberta de LÚPUS e RPL. No conjunto de dados de LÚPUS, quatro genes mantiveram coeficientes não nulos no valor de lambda selecionado: IFIT3, IFI27, IFI44 e CXCL11, com coeficientes de 2,575, 0,057, 2,359 e 0,307, respectivamente (Figura 5A,B). No conjunto de dados de RPL, quatro genes mantiveram coeficientes não nulos: IFI27, GBP1, OAS1 e CXCL11, com coeficientes de −0,897, 0,167, −1,007 e −0,519, respectivamente (Figura 5C,D). A comparação dos genes selecionados pelos dois modelos específicos de doença identificou IFI27 e CXCL11 como os genes candidatos compartilhados selecionados pela LASSO. Esses dois genes foram posteriormente avaliados nos conjuntos de dados de descoberta e de validação externa.
Validação externa da expressão de IFI27 e CXCL11
Os padrões de expressão dos dois genes candidatos foram avaliados utilizando os conjuntos de dados de validação independentes GSE50772 e GSE198700 obtidos do banco de dados GEO. No GSE61635, tanto IFI27 quanto CXCL11 foram significativamente superexpressos no grupo de Lúpus Eritematoso Sistêmico (LES) em comparação com os controles saudáveis (Figura 6A,B). No conjunto de dados de validação independente de LES (GSE50772), IFI27 manteve-se significativamente superexpresso (Figura 6C), enquanto CXCL11 não diferiu significativamente entre os grupos (Figura 6D). No conjunto de dados de descoberta de RPL (GSE165004), tanto IFI27 quanto CXCL11 foram significativamente subexpressos no grupo de RPL em comparação com os controles (Figura 6E,F). No conjunto de dados de validação independente de RPL (GSE198700), IFI27 manteve-se significativamente subexpresso no grupo de RPL (Figura 6G), enquanto CXCL11 não foi detectado. No geral, IFI27 apresentou expressão diferencial consistente em todos os conjuntos de dados de descoberta e validação de LES e RPL. Em contraste, CXCL11 não foi consistentemente replicado nos conjuntos de dados de validação externa. Assim sendo, IFI27 foi priorizado como biomarcador candidato comum para as análises subsequentes.
Avaliação exploratória da discriminação diagnóstica
Foi realizada uma análise de característica operacional do receptor (ROC) para avaliar a capacidade da expressão de IFI27 e CXCL11 em distinguir amostras de doenças de controles nos conjuntos de dados transcriptômicos retrospectivos analisados. Para LÚPUS, IFI27 apresentou uma área sob a curva ROC (AUC) de 0,822 (IC 95% = 0,752–0,892; Figura 7A), enquanto CXCL11 apresentou um AUC de 0,852 (IC 95% = 0,786–0,917; Figura 7B). Uma comparação das curvas ROC para os dois genes candidatos no conjunto de dados de LÚPUS é mostrada na Figura 7C. Para RPL, IFI27 apresentou um AUC de 0,872 (IC 95% = 0,773–0,970; Figura 7D), enquanto CXCL11 apresentou um AUC de 0,668 (IC 95% = 0,513–0,882; Figura 7E). Uma comparação das curvas ROC para os dois genes candidatos no conjunto de dados de RPL é mostrada na Figura 7F. IFI27 demonstrou valores de AUC superiores a 0,80 em ambos os conjuntos de dados de doenças e mostrou uma validação externa mais consistente do que CXCL11 ao longo dos conjuntos de dados de expressão. Esses achados sustentam IFI27 como um biomarcador candidato para avaliação adicional. No entanto, como as análises ROC foram realizadas utilizando conjuntos de dados transcriptômicos públicos retrospectivos, os resultados devem ser interpretados como evidência exploratória de discriminação transcriptômica, e não como validação diagnóstica clínica prospectiva.
Avaliação computacional da infiltração imune
A ssGSEA foi realizada para avaliar o enriquecimento de 28 assinaturas de células imunes nos conjuntos de dados de descoberta GSE61635 e GSE165004. Os mapas de calor de enriquecimento de células imunes para os conjuntos de dados de LÚPUS e RPL são mostrados na Figura 8A,D, respectivamente, enquanto as comparações correspondentes entre grupos dos escores ssGSEA são apresentadas na Figura 8B,E. No conjunto de dados de LÚPUS, múltiplas assinaturas de células imunes diferiram significativamente entre pacientes com LÚPUS e controles saudáveis, incluindo aquelas que representam células T CD8+, células T CD4+, células B, células dendríticas, células T auxiliares tipo 1 (Th1), células T auxiliares tipo 2 (Th2), células T auxiliares tipo 17 (Th17), células natural killer, macrófagos, eosinófilos, mastócitos, monócitos e neutrófilos (Figura 8B). No conjunto de dados de RPL, os escores ssGSEA para células T CD8+ ativadas, células T CD4+ ativadas, células T CD4+ de memória efetora, células Th17 e monócitos foram mais altos no grupo de RPL do que no grupo controle. Em contraste, os escores ssGSEA para células T reguladoras (Treg) e macrófagos foram menores no grupo de RPL do que no grupo controle (Figura 8E). A análise de correlação mostrou que, no conjunto de dados de LÚPUS, a expressão de IFI27 e CXCL11 foi positivamente correlacionada com os escores ssGSEA de células T CD4+ ativadas, células natural killer, células Th2 e células T CD8+ de memória central, e negativamente correlacionada com o escore ssGSEA de células Th1 (Figura 8C). No conjunto de dados de RPL, a expressão de IFI27 foi positivamente correlacionada com os escores ssGSEA de Treg e células Th2, enquanto a expressão de CXCL11 foi positivamente correlacionada com o escore ssGSEA de eosinófilos (Figura 8F).
Disponibilidade de Dados:
Nenhum dado novo de participantes humanos foi gerado neste estudo. Todas as análises foram baseadas exclusivamente em estatísticas sumárias de estudos de associação genômica ampla (GWAS) e conjuntos de dados transcriptômicos disponíveis publicamente. As estatísticas sumárias do GWAS para lúpus eritematoso sistêmico (LES) foram obtidas do FinnGen Lançamento 11 (acesso: finngen_R11_L12_LUPUS). As estatísticas sumárias para o número de abortos espontâneos foram obtidas do recurso IEU OpenGWAS (acesso: ukb-b-419), que se baseia em dados do UK Biobank. Os conjuntos de dados transcriptômicos foram obtidos no Gene Expression Omnibus (GEO), do Centro Nacional de Informação Biotecnológica (NCBI), sob os números de acesso GSE61635, GSE165004, GSE50772 e GSE198700. Os conjuntos de dados disponíveis publicamente podem ser acessados nos seguintes repositórios:
-- FinnGen Lançamento 11: https://r11.finngen.fi/
-- IEU OpenGWAS: https://gwas.mrcieu.ac.uk/
-- Gene Expression Omnibus (GEO): https://www.ncbi.nlm.nih.gov/geo/
Os dados processados que sustentam as descobertas deste estudo estão incluídos no artigo e em seus Materiais Suplementares. Nenhum dado individual ou identificável dos participantes foi acessado ou retido. O fluxo de trabalho analítico foi realizado utilizando software e pacotes de acesso público, conforme descrito no Protocolo.
Arquivo Suplementar 1. Checklist preenchido do relato STROBE-MR.
Checklist preenchido do Strengthening the Reporting of Observational Studies in Epidemiology Using Mendelian Randomization (STROBE-MR) indicando onde cada item recomendado de relato é abordado no manuscrito. Clique aqui para baixar este arquivo.
Figura Suplementar 1. Gráfico de dispersão da análise de randomização mendeliana direta.
Gráfico de dispersão mostrando as associações entre os efeitos genéticos dos polimorfismos de nucleotídeo único (SNPs) instrumentais sobre o lúpus eritematoso sistêmico (LES) e o número de abortos espontâneos. Cada ponto representa um SNP, com barras de erro horizontais e verticais indicando os erros-padrão das estimativas do efeito do SNP. As linhas de regressão correspondem aos métodos de randomização mendeliana ponderados pela inversa da variância, MR-Egger, mediana ponderada e modo ponderado. Clique aqui para baixar este arquivo.
Figura Suplementar 2. Estimativas causais específicas de polimorfismos de nucleotídeo único a partir da análise de randomização mendeliana direta.
Gráfico em floresta mostrando a estimativa do efeito causal de cada polimorfismo de nucleotídeo único (SNP) instrumental sobre a associação entre lúpus eritematoso sistêmico (LES) e o número de abortos espontâneos. Os pontos pretos representam as estimativas de efeito específicas para cada SNP com intervalos de confiança de 95%. Os pontos vermelhos representam as estimativas globais de efeito causal obtidas pelos métodos ponderado pela variância inversa e MR-Egger. A linha tracejada vertical indica o efeito nulo. Clique aqui para baixar este arquivo.
Figura Suplementar 3. Análise de sensibilidade leave-one-out da análise de randomização mendeliana direta.
Gráfico floresta mostrando os resultados da análise de sensibilidade leave-one-out que avalia a associação entre lúpus eritematoso sistêmico (LES) e o número de abortos espontâneos. Cada ponto preto representa a estimativa global do efeito causal ponderada pela inversão da variância após a exclusão sequencial de um polimorfismo de nucleotídeo único (SNP) instrumental, com linhas horizontais indicando os respectivos intervalos de confiança de 95%. O ponto vermelho representa a estimativa global ponderada pela inversão da variância obtida utilizando todos os SNPs instrumentais. A linha tracejada vertical indica o efeito nulo. Clique aqui para baixar este arquivo.
Figura suplementar 4. Gráfico em funnel da análise de randomização mendeliana direta.
Gráfico em funnel mostrando a distribuição das estimativas de efeito causal específicas para SNP na associação entre lúpus eritematoso sistêmico (LES) e o número de abortos espontâneos. Cada ponto representa um polimorfismo de nucleotídeo único (SNP) instrumental. As linhas verticais indicam as estimativas globais de efeito causal obtidas pelos métodos ponderado pela variância inversa e MR-Egger. O eixo y representa o inverso do erro padrão (1/SE). Clique aqui para baixar este arquivo.
Tabela Suplementar 1. Polimorfismos de nucleotídeo único instrumentais selecionados para a análise de randomização mendeliana direta.
A tabela lista os polimorfismos de nucleotídeo único instrumentais (SNPs) utilizados para a análise de randomização mendeliana direta do lúpus eritematoso sistêmico e do número de abortos espontâneos, incluindo o gene anotado mais próximo, cromossomo, posição genômica, alelo de efeito, frequência do alelo de efeito, tamanho do efeito (Beta), erro padrão (SE), valor P e estatística F. As posições cromossômicas são baseadas no conjunto de montagem do genoma utilizado no estudo de associação genômica ampla. A estatística F foi calculada como Beta2/SE2. Clique aqui para baixar este arquivo.
Tabela Suplementar 2. Polimorfismos de nucleotídeo único instrumentais selecionados para a análise de randomização mendeliana inversa.
A tabela lista os polimorfismos de nucleotídeo único instrumentais (SNPs) utilizados para a análise de randomização mendeliana inversa, na qual o número de abortos espontâneos é a exposição e o lúpus eritematoso sistêmico é o desfecho, incluindo o gene anotado mais próximo, cromossomo, posição genômica, alelo de efeito, frequência do alelo de efeito, tamanho do efeito (Beta), erro padrão (SE), valor P e estatística F. As posições cromossômicas são baseadas no conjunto de montagem genômica utilizado no estudo de associação genômica ampla. A estatística F foi calculada como Beta2/SE2. Clique aqui para baixar este arquivo.
Discussão
Por meio da análise de MR bidirecional combinada com análises bioinformáticas multidimensionais, este estudo identificou uma associação causal positiva entre LÚPUS e RPP ao mesmo tempo em que realizou uma triagem sistemática de biomarcadores transcriptômicos compartilhados. Tanto quanto sabemos, este é o primeiro estudo a integrar MR bidirecional, análises transcriptômicas e análises de infiltração imune para investigar essa relação. Embora o tamanho do efeito observado na MR tenha sido modesto (OR IVW = 1,01), a associação foi consistentemente apoiada por múltiplos métodos complementares de MR e análises de sensibilidade, sem evidência de heterogeneidade substancial, pleiotropia horizontal ou valores atípicos influentes, sugerindo que a relação observada é estatisticamente robusta, mas quantitativamente pequena. Portanto, os achados atuais devem ser interpretados como evidência de uma contribuição genética modesta do LÚPUS para a suscetibilidade à RPP, e não como um efeito clínico acentuado. Ao integrar inferência causal com validação transcriptômica e análises de infiltração imune, este estudo fornece um arcabouço reproduzível para priorizar biomarcadores candidatos em distúrbios reprodutivos imunomediados complexos. Um estudo conduzido no Egito entre 2007 e 2021, que incluiu 123 mulheres com LÚPUS e um total de 201 gestações, relatou que 20,4% das gestações em mulheres com LÚPUS resultaram em perda fetal44. Estudos anteriores igualmente sugeriram que o LÚPUS é um fator de risco importante para RPP, pois a desregulação imunológica pode aumentar a probabilidade de perda gestacional12.
Análises bioinformáticas revelaram que os 59 genes diferencialmente expressos (GDEs) compartilhados foram principalmente enriquecidos em vias relacionadas às respostas imunes antivirais, adesão celular e regulação da apoptose. A infecção viral pode contribuir para a patogênese do LES. Pacientes com LES frequentemente apresentam disfunção tanto nas respostas imunes inata quanto adaptativa45,46, tornando-os mais suscetíveis a infecções virais. Essa maior suscetibilidade pode contribuir para a perda gestacional por meio de mecanismos como inflamação placentária e lesão das células placentárias47. Como componente essencial da placenta, alterações na autofagia e no comportamento biológico das células trofoblásticas também têm sido associadas à ocorrência de AFR48,49. Em conjunto, essas observações sugerem que a desregulação imunológica associada ao LES pode influenciar os desfechos gestacionais ao afetar a função das células trofoblásticas. Análises adicionais identificaram IFI27 e CXCL11 como genes centrais candidatos compartilhados pelo LES e AFR. No entanto, IFI27 foi priorizado para análises subsequentes porque demonstrou maior consistência biológica em conjuntos de dados independentes. Embora ambos os genes tenham sido selecionados pelo modelo LASSO, apenas IFI27 apresentou expressão diferencial consistente nos conjuntos de dados de descoberta e de validação externa, enquanto CXCL11 não foi replicado de forma consistente nos conjuntos de dados de validação. Além disso, IFI27 apresentou melhor discriminação diagnóstica para AFR e manteve-se significativamente desregulado em conjuntos de dados de sangue e de tecidos reprodutivos. Em conjunto, esses achados sustentam IFI27 como um biomarcador candidato mais robusto do que CXCL11, embora seja necessária validação experimental adicional. A validação utilizando o conjunto de dados de LES GSE50772 e o conjunto de dados de AFR GSE198700 demonstrou que a expressão de IFI27 permaneceu consistentemente desregulada nos conjuntos de dados de validação. Notavelmente, IFI27 foi superexpresso em amostras de sangue de pacientes com LES, o que está de acordo com estudos anteriores50, mas foi subregulado em amostras de endométrio e de vilos coriônicos de pacientes com AFR. Esse padrão contrastante pode refletir diferenças entre a desregulação imunológica sistêmica e o ambiente imune local na interface materno-fetal no LES complicado por AFR.
IFI27 é um gene estimulado por interferon envolvido na imunidade antiviral, sinalização por interferon e respostas imunes do hospedeiro após infecção viral51,52. Na gravidez normal, a expressão de IFI27 aumenta acentuadamente nas células trofoblásticas53, sugerindo um papel fisiológico importante na manutenção da função trofoblástica. Em contraste, nossas análises demonstraram redução da expressão de IFI27 no endométrio e nas vilosidades coriônicas de pacientes com aborto de repetição (RPL). Embora este achado difira de alguns estudos anteriores54, ele deve ser interpretado com cautela, pois o presente estudo integrou conjuntos de dados transcriptômicos derivados de tecidos diferentes, em vez de amostras materno-fetais pareadas. Uma possível explicação é que a ativação sistêmica crônica do interferon tipo I no lúpus eritematoso sistêmico (SLE) induz sinalização persistente por interferon em células imunes circulantes, ao mesmo tempo em que promove dessensibilização do receptor, exaustão imune ou mecanismos compensatórios de retroalimentação negativa na interface materno-fetal. Alternativamente, a regulação epigenética específica do tecido ou diferenças na composição celular entre o sangue periférico e os tecidos reprodutivos podem suprimir a expressão local de IFI27, apesar da ativação sistêmica do interferon. Essas hipóteses permanecem especulativas e exigem validação mecanicista utilizando amostras pareadas de sangue materno, tecido endometrial e trofoblastos, idealmente ao nível de célula única, para distinguir mecanismos regulatórios específicos de tecido e de tipo celular55.
A análise de infiltração imune indicou diferenças significativas nos perfis de células imunes tanto no LÚP quanto na RPL, caracterizadas principalmente por alterações nas populações relacionadas a linfócitos T CD4+. A expressão de IFI27 correlacionou-se positivamente com o enriquecimento de células Th2 em ambas as doenças; no entanto, esses achados representam correlações computacionais derivadas da ssGSEA, e não interações biológicas verificadas experimentalmente. Estudos anteriores demonstraram que o sangue periférico de pacientes com LÚP apresenta proporções reduzidas de células Th1 e Treg, mas proporções aumentadas de células Th256,57, o que está de acordo com nossos achados. Durante a gravidez normal, o equilíbrio imune Th1/Th2 na interface materno-fetal desloca-se para um estado dominante de Th258. Portanto, a redução da expressão de IFI27 nos tecidos reprodutivos pode refletir alterações na homeostase imune local associadas à tolerância materno-fetal prejudicada, embora ainda permaneça por ser determinado experimentalmente se IFI27 regula diretamente esse processo.
Várias limitações devem ser reconhecidas. Primeiro, embora as análises de MR tenham apoiado uma associação causal, o efeito genético estimado foi relativamente pequeno, sugerindo que o LSE representa apenas um componente da patogênese multifatorial da RPL. Segundo, a integração transcriptômica incluiu conjuntos de dados gerados a partir de diferentes tecidos (sangue periférico, endométrio e vilosidades coriônicas), plataformas de microarranjo e coortes independentes, o que pode introduzir heterogeneidade biológica e técnica, apesar da validação consistente de IFI27. Terceiro, a coorte de validação externa para vilosidades coriônicas incluiu um número limitado de amostras, o que pode ter reduzido o poder estatístico e a generalização dos resultados. Quarto, como os conjuntos de dados disponíveis publicamente continham informações clínicas limitadas, fatores importantes, incluindo atividade da doença, status de anticorpos antifosfolípides, exposição a medicamentos, estágio gestacional e outras covariáveis clínicas, não puderam ser plenamente avaliados. Por fim, embora a triagem com o PhenoScanner tenha minimizado o confundimento pleiotrópico potencial nas análises de MR, o confundimento residual não pode ser completamente excluído.
Do ponto de vista translacional, o IFI27 deve atualmente ser considerado um biomarcador candidato, e não um marcador diagnóstico clinicamente validado. Antes da implementação clínica, são necessários estudos prospectivos multicêntricos para validar seu desempenho diagnóstico em populações diversas, estabelecer plataformas padronizadas de ensaio e limiares diagnósticos, e determinar como o estágio da gravidez, a atividade da doença e o tratamento imunossupressor influenciam a expressão do IFI27. Experimentos funcionais, juntamente com análises de transcriptômica espacial e transcriptômica de célula única, também serão essenciais para esclarecer se o IFI27 contribui ativamente para a regulação imune materno-fetal ou simplesmente reflete a ativação imune induzida por interferon.
Divulgações
Conflito de Interesses:
Os autores declaram que não possuem interesses financeiros ou não financeiros concorrentes.
Agradecimentos
Este trabalho foi apoiado pelo Projeto-Chave de Integração da Medicina Tradicional Chinesa e da Medicina Ocidental para Doenças Graves e Complexas da Administração Municipal de Medicina Tradicional Chinesa de Pequim (2023BJSZDYNJBXTGG-003), pelo Fundo Nacional de Pesquisa Científica Pública para Atividades Básicas de Pesquisa de Institutos (ZZ16-XRZ-038) e pelo Projeto de Promoção de Hospitais Médicos Chineses de Alto Nível (HLCMHPP2023087). As fontes de financiamento não tiveram papel no desenho do estudo, na coleta de dados, na análise dos dados, na interpretação dos dados, na preparação do manuscrito ou na decisão de submeter o manuscrito para publicação. Os autores agradecem aos pesquisadores e participantes do estudo FinnGen, ao UK Biobank e ao Gene Expression Omnibus (GEO) do Centro Nacional para Informação Biotecnológica por disponibilizarem seus conjuntos de dados publicamente. Os autores também agradecem ao consórcio FinnGen, que integra amostras de biobancos finlandeses com dados de registros nacionais de saúde por meio de colaborações entre organizações de pesquisa finlandesas, biobancos e parceiros internacionais.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Coleção de 28 assinaturas gênicas de células imunes | Recurso suplementar de assinatura gênica publicado | Lista complementar de genes marcadores de células imunes descrita por Charoentong et al. (Referência 42) | Não aplicável RRID: Não disponível Propósito / observações: Assinaturas de células imunes utilizadas para ssGSEA. |
| CNSknowall | plataforma web CNSknowall | Arquivos de saída do DAVID | Não aplicável RRID: Não disponível Propósito / observações: Visualização dos resultados filtrados de enriquecimento funcional. |
| Estação de trabalho computacional | Ambiente computacional institucional | Não aplicável | Não aplicável RRID: Não aplicável Propósito / observações: Análises computacionais. |
| Materiais de consumo | Não aplicável | Não aplicável | Não aplicável RRID: Não aplicável Propósito / observações: Nenhum material de consumo para laboratório úmido foi utilizado. |
| Cytoscape | Consortium Cytoscape | Não aplicável | 3.10.0 RRID: SCR_003032 Propósito / observações: Proteína–visualização e análise topológica de rede de interação proteica |
| cytoHubba | Loja de Aplicativos Cytoscape | Não aplicável | 0.1 RRID: SCR_017677 Propósito / observações: Classificação de genes centrais utilizando MCC, MNC, EPC, Grau, Proximidade e Radialidade. |
| Ferramenta de Anotação Funcional DAVID | Institutos Nacionais de Saúde / Instituto Nacional do Câncer | Listas de DEG e de genes de fundo compartilhadas carregadas | 2021 RRID: SCR_001881 Propósito / observações: Análise de enriquecimento de vias KEGG e Ontologia Genética. |
| Painel de referência europeu para desequilíbrio de ligação | Projeto 1000 Genomas / IEU OpenGWAS | Painel europeu da Fase 3 (variantes compatíveis com GRCh37) | Fase 3 RRID: Não relatado Propósito / observações: Clumping por desequilíbrio de ligação por meio do fluxo de trabalho OpenGWAS/TwoSampleMR. |
| FinnGen | Consortium FinnGen | finngen_R11_L12_LUPUS | Liberação 11 RRID: SCR_022254 Propósito / observações: Estatísticas resumidas de GWAS para lúpus eritematoso. |
| forestploter | CRAN | Não aplicável | 1.1.2 RRID: Não disponível Propósito / observações: Visualização em gráfico floresta das estimativas de randomização mendeliana. |
| Gene Expression Omnibus (GEO) | Centro Nacional de Informação Biotecnológica | GSE61635; GSE165004; GSE50772; GSE198700 | Não aplicável RRID: SCR_005012 Propósito / observações: Fonte dos conjuntos de dados transcriptômicos de descoberta e validação. |
| Ontologia Genética | Consortium do Ontologia Genética | Termos GO acessados por meio do DAVID | Anotações DAVID 2021 RRID: SCR_002811 Propósito / observações: Anotação de processo biológico, componente celular e função molecular |
| ggcorrplot | CRAN | Não aplicável | 0.1.4.1 RRID: Não disponível Propósito / observações: Visualização do gene candidato–matrizes de correlação de células imunes |
| ggplot2 | CRAN | Não aplicável | 3.5.1 RRID: SCR_014601 Propósito / observações: Gráficos de vulcão, gráficos de caixa e outros gráficos estatísticos. |
| ggvenn | CRAN | Não aplicável | 0.1.16 RRID: SCR_025300 Propósito / observações: Visualização de genes diferencialmente expressos compartilhados. |
| glmnet | CRAN | Não aplicável | 4.1-8 RRID: SCR_015505 Propósito / observações: Regressão logística LASSO e validação cruzada. |
| GSE165004 | NCBI GEO | GSE165004 / GPL16699 | Matriz de Séries Processada RRID: SCR_005012 Propósito / observações: Conjunto de dados de descoberta do endométrio RPL |
| GSE198700 | NCBI GEO | GSE198700 / GPL13534 | Matriz de Série Processada RRID: SCR_005012 Propósito / observações: Conjunto de dados independente de validação de vilosidades coriônicas por RPL. |
| GSE50772 | NCBI GEO | GSE50772 / GPL570 | Matriz de Séries Processada RRID: SCR_005012 Propósito / observações: Conjunto de dados de validação independente de células mononucleares do sangue periférico de Lúpus Eritematoso Sistêmico. |
| GSE61635 | NCBI GEO | GSE61635 / GPL570 | Matriz de Séries Processada RRID: SCR_005012 Propósito / observações: Conjunto de dados de descoberta em sangue total de Lúpus Eritematoso Sistêmico. |
| GSEABase | Bioconductor | Não aplicável | 1.66.0 RRID: Não disponível Propósito / observações: Manejo de conjuntos de genes de células imunes para ssGSEA. |
| GSVA | Bioconductor | Não aplicável | 1.52.3 RRID: SCR_021058 Propósito / observações: Análise de enriquecimento de conjunto de genes em amostra única (ssGSEA). |
| IEU OpenGWAS | Unidade de Epidemiologia Integrativa do MRC | ukb-b-419; finngen_R11_L12_LUPUS | Não aplicável RRID: Não informado Propósito / observações: Recuperação de estatísticas sumárias de GWAS e dados harmonizados de associação genética. |
| Enciclopédia de Kyoto de Genes e Genomas (KEGG) | Laboratórios Kanehisa | Vias KEGG acessadas por meio do DAVID | anotações DAVID 2021 RRID: SCR_012773 Propósito / observações: Anotação de enriquecimento de vias metabólicas |
| limma | Bioconductor | Não aplicável | 3.60.6 RRID: SCR_010943 Propósito / observações: Análise de expressão diferencial. |
| MRPRESSO | Verbanck et al. | Não aplicável | 1 RRID: SCR_023697 Propósito / observações: Detecção de pleiotropia horizontal e variáveis instrumentais atípicas. |
| pheatmap | CRAN | Não aplicável | 1.0.12 RRID: SCR_016418 Propósito / observações: Mapas de calor de expressão. |
| PhenoScanner V2 | Consortium PhenoScanner | Consultas fenotípicas no nível de SNP | Versão 2 RRID: Não disponível Propósito / observações: Triagem de SNPs retidos quanto a associações potenciais com fenótipos de confusão. |
| pROC | CRAN | Não aplicável | 1.18.5 RRID: SCR_024286 Propósito / observações: Curvas ROC, AUCs, intervalos de confiança de DeLong, pontos de corte do índice de Youden e intervalos de confiança baseados em reamostragem bootstrap. |
| R | Fundação R para Computação Estatística | Não aplicável | 4.4.2 RRID: SCR_001905 Propósito / observações: Ambiente de computação estatística. |
| Reagentes | Não aplicável | Não aplicável | Não aplicável RRID: Não aplicável Propósito / observações: Nenhum reagente de laboratório úmido foi utilizado. |
| STRING | Consortium STRING | Homo sapiens (taxon 9606); pontuação mínima de interação 0,400 | 11 RRID: SCR_005223 Propósito / observações: Proteína–construção de rede de interação proteica |
| TwoSampleMR | Unidade de Epidemiologia Integrativa do MRC | Não aplicável | 0.6.6 RRID: SCR_019010 Propósito / observações: Retroalimentação bidirecional de dois grupos com aleatorização mendeliana, extração de dados, harmonização, estimativa causal e análises de sensibilidade. |
| UK Biobank | UK Biobank | ukb-b-419 | Conjunto de dados resumo de 2018 RRID: SCR_012815 Propósito / observações: Estatísticas resumidas de GWAS para o número de abortos espontâneos. |
Referências
- Petri M. Pregnancy and systemic lupus erythematosus. Best Pract Res Clin Obstet Gynaecol. 2020;64:24-30.
- Zhao X, et al. Advances in drug therapy for systemic lupus erythematosus. Curr Med Chem. 2021;28(7):1251-1268.
- Stanescu II, et al. Salivary biomarkers of inflammation in systemic lupus erythematosus. Ann Anat. 2018;219:89-93.
- Tian J, Zhang D, Yao X, Huang Y, Lu Q. Global epidemiology of systemic lupus erythematosus: A comprehensive systematic analysis and modelling study. Ann Rheum Dis. 2023;82(3):351-356.
- Palma Dos Reis CR, et al. Prediction of adverse pregnancy outcomes in women with systemic lupus erythematosus. Clin Rev Allergy Immunol. 2020;59(2):287-294.
- Venne K, Scott S, Bernatsky S, Vinet E. Induced abortions in women with systemic lupus erythematosus. Lupus. 2021;30(4):484-488.
- Kim JW, et al. Lupus low disease activity state achievement is important for reducing adverse outcomes in pregnant patients with systemic lupus erythematosus. J Rheumatol. 2021;48(5):707-716.
- Braga A, et al. Systemic lupus erythematosus and pregnancy: A Portuguese case-control study. Clin Rev Allergy Immunol. 2022;62(2):324-332.
- Dimitriadis E, Menkhorst E, Saito S, Kutteh WH, Brosens JJ. Recurrent pregnancy loss. Nat Rev Dis Primers. 2020;6(1):98.
- Quenby S, et al. Miscarriage matters: The epidemiological, physical, psychological, and economic costs of early pregnancy loss. Lancet. 2021;397(10285):1658-1667.
- Valeff NJ, Ventimiglia MS, Diao L, Jensen F. Lupus and recurrent pregnancy loss: The role of female sex hormones and B cells. Front Endocrinol (Lausanne). 2023;14:1233883.
- Gao R, Zeng X, Qin L. Systemic autoimmune diseases and recurrent pregnancy loss: Research progress in diagnosis and treatment. Chin Med J (Engl). 2021;134(17):2140-2142.
- Pantham P, Abrahams VM, Chamley LW. The role of anti-phospholipid antibodies in autoimmune reproductive failure. Reproduction. 2016;151(5):R79-R90.
- Meroni PL, et al. Updating on the pathogenic mechanisms of antiphospholipid antibody-associated pregnancy loss. Clin Rev Allergy Immunol. 2008;34(3):332-337.
- Blank M, Shoenfeld Y. Antiphospholipid antibody-mediated reproductive failure in antiphospholipid syndrome. Clin Rev Allergy Immunol. 2010;38(2–3):141-147.
- Babker A, et al. Frequency of ACE I/D and PAI-1 4G/5G polymorphisms in women with recurrent pregnancy loss in Sudan. Biomed Pharmacol J. 2025;18(3):1953-1961.
- Babker AM, et al. Detection of human platelet antigen polymorphisms (HPA-1 and HPA-3) and factor XIII mutation in Sudanese women with recurrent pregnancy loss. BMC Res Notes. 2024;17(1):66.
- Grover S, Del Greco MF, Stein CM, Ziegler A. Mendelian randomization. Methods Mol Biol. 2017;1666:581-628.
- Skrivankova VM, et al. Strengthening the reporting of observational studies in epidemiology using Mendelian randomization: The STROBE-MR statement. JAMA. 2021;326(16):1614-1621.
- Emdin CA, Khera AV, Kathiresan S. Mendelian randomization. JAMA. 2017;318(19):1925-1926.
- Burgess S, Thompson SG, CRP CHD Genetics Collaboration. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40(3):755-764.
- Hemani G, et al. The MR-Base platform supports systematic causal inference across the human phenome. eLife. 2018;7:e34408.
- Bowden J, Davey Smith G, Burgess S. Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression. Int J Epidemiol. 2015;44(2):512-525.
- Bowden J, Davey Smith G, Haycock PC, Burgess S. Consistent estimation in Mendelian randomization with some invalid instruments using a weighted median estimator. Genet Epidemiol. 2016;40(4):304-314.
- Hartwig FP, Davey Smith G, Bowden J. Robust inference in summary data Mendelian randomization via the zero modal pleiotropy assumption. Int J Epidemiol. 2017;46(6):1985-1998.
- Burgess S, Butterworth A, Thompson SG. Mendelian randomization analysis with multiple genetic variants using summarized data. Genet Epidemiol. 2013;37(7):658-665.
- Verbanck M, Chen CY, Neale B, Do R. Detection of widespread horizontal pleiotropy in causal relationships inferred from Mendelian randomization between complex traits and diseases. Nat Genet. 2018;50(5):693-698.
- Barrett T, et al. NCBI GEO: Archive for functional genomics data sets—update. Nucleic Acids Res. 2013;41(Database issue):D991-D995.
- Keleş İD, et al. Gene pathway analysis of the endometrium at the start of the window of implantation in women with unexplained infertility and unexplained recurrent pregnancy loss: Is unexplained recurrent pregnancy loss a subset of unexplained infertility? Hum Fertil (Camb). 2023;26(5):1129-1141.
- Kennedy WP, et al. Association of the interferon signature metric with serological disease manifestations but not global activity scores in multiple cohorts of patients with SLE. Lupus Sci Med. 2015;2(1):e000080.
- Matsumoto Y, et al. Characteristic DNA methylation profiles of chorionic villi in recurrent miscarriage. Sci Rep. 2022;12(1):11673.
- Sherman BT, Lempicki RA. Systematic and integrative analysis of large gene lists using DAVID bioinformatics resources. Nat Protoc. 2009;4(1):44-57.
- Szklarczyk D, et al. STRING v11: Protein–protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607-D613.
- Shannon P, et al. Cytoscape: A software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504.
- Jia P, Zheng S, Long J, Zheng W, Zhao Z. dmGWAS: Dense module searching for genome-wide association studies in protein–protein interaction networks. Bioinformatics. 2011;27(1):95-102.
- Chin CH, et al. cytoHubba: Identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11.
- Mohammadi M. A projection neural network for the generalized Lasso. IEEE Trans Neural Netw Learn Syst. 2020;31(6):2217-2221.
- Kumar R, Indrayan A. Receiver operating characteristic (ROC) curve for medical researchers. Indian Pediatr. 2011;48(4):277-287.
- de Hond AAH, Steyerberg EW, van Calster B. Interpreting area under the receiver operating characteristic curve. Lancet Digit Health. 2022;4(12):e853-e855.
- Xu H, et al. Single-cell transcriptomics reveals CCL3+ classical monocyte subset linked to autoimmune pathogenesis. J Inflamm Res. 2025;18:16273-16291.
- Zych M, et al. Surface immune checkpoints as potential biomarkers in physiological pregnancy and recurrent pregnancy loss. Int J Mol Sci. 2024;25(17):9378.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-262.
- Liu J, Lu J, Wang G, Gu L, Li W. Prognostic characteristics of a six-gene signature based on ssGSEA in sarcoma. Aging (Albany NY). 2024;16(2):1536-1554.
- Mokbel A, et al. Pregnancy outcomes among Egyptian women with systemic lupus erythematosus: A prospective cohort study. Lupus. 2023;32(4):521-530.
- Illescas-Montes R, Corona-Castro CC, Melguizo-Rodríguez L, Ruiz C, Costela-Ruiz VJ. Infectious processes and systemic lupus erythematosus. Immunology. 2019;158(3):153-160.
- Banko A, et al. Epstein-Barr virus infection as a potential indicator of the occurrence and clinical presentation of systemic lupus erythematosus. Front Immunol. 2023;14:1307589.
- Nigro G, et al. Role of infections in recurrent spontaneous abortion. J Matern Fetal Neonatal Med. 2011;24(8):983-989.
- Yang D, et al. YY1-PVT1 affects trophoblast invasion and adhesion by regulating mTOR pathway-mediated autophagy. J Cell Physiol. 2020;235(10):6637-6646.
- Guan D, et al. Immunologic insights in recurrent spontaneous abortion: Molecular mechanisms and therapeutic interventions. Biomed Pharmacother. 2024;177:117082.
- Zhao X, et al. Identification of key biomarkers and immune infiltration in systemic lupus erythematosus by integrated bioinformatics analysis. J Transl Med. 2021;19(1):35.
- Villamayor L, et al. The IFN-stimulated gene IFI27 counteracts innate immune responses after viral infections by interfering with RIG-I signaling. Front Microbiol. 2023;14:1176177.
- Lim FY, et al. High-frequency home self-collection of capillary blood correlates IFI27 expression kinetics with SARS-CoV-2 viral clearance. J Clin Invest. 2023;133(23):e173715.
- Apps R, et al. Genome-wide expression profile of first-trimester villous and extravillous human trophoblast cells. Placenta. 2011;32(1):33-43.
- Li Y, et al. RNA sequencing of decidua reveals differentially expressed genes in recurrent pregnancy loss. Reprod Sci. 2021;28(8):2261-2269.
- Dankers W, et al. Failing maternal-fetal tolerance in SLE (FaMaLE): A prospective cohort study for finding the molecular mechanisms behind pregnancy complications. Lupus Sci Med. 2025;12(1):e001668.
- Xiang S, et al. Imbalance of helper T cell type 1, helper T cell type 2, and associated cytokines in patients with systemic lupus erythematosus: A meta-analysis. Front Pharmacol. 2022;13:988512.
- Tu J, et al. UC-BSC exosomes regulate Th17/Treg balance in patients with systemic lupus erythematosus via miR-19b/KLF13. Cells. 2022;11(24):4123.
- Wang W, et al. T helper (Th) cell profiles in pregnancy and recurrent pregnancy loss: Th1/Th2/Th9/Th17/Th22/Tfh cells. Front Immunol. 2020;11:2025.