Este artigo estuda um algoritmo de otimização de escalonamento dinâmico que integra Transformer e aprendizado por reforço PPO, concentrando-se em conflitos frequentes de recursos e atrasos na resposta no escalonamento de atividades sindicais.
Artigo de investigação
Algoritmo de Escalonamento Dinâmico e Otimização de Recursos para Atividades Sindicais por meio da Integração de Transformer e Aprendizado por Reforço
Neste artigo
Resumo
Resumo
Para resolver o problema da redução da eficiência organizacional causado por conflitos frequentes na alocação de recursos e respostas tardias no agendamento no gerenciamento de atividades sindicais, este artigo propõe um algoritmo de agendamento dinâmico que integra Transformer e PPO (Otimização da Política Proximal). Na implementação específica, uma estrutura de modelagem unificada de cenários de agendamento é primeiramente projetada para converter os estados de atividades, pessoal e recursos em entradas tensoriais, permitindo assim a integração de múltiplas restrições. Em seguida, utiliza-se o mecanismo de atenção multi-cabeça do Transformer para codificar a série temporal de solicitações históricas de atividades e o status dos recursos, extrair características espaço-temporais multidimensionais e aprimorar a percepção de riscos de conflito. Posteriormente, com base nos resultados da codificação e na rede de estratégias do PPO, ações de agendamento são geradas a partir do estado atual, aumentando a adaptabilidade da estratégia a ambientes complexos. Por fim, por meio do mecanismo de atualização com poda e correção da função de vantagem, garante-se a estabilidade da estratégia durante a iteração e melhora-se o desempenho do agendamento. Experimentos demonstraram que, com densidade de tarefas igual a 1000, o tempo médio de decisão do algoritmo de agendamento é de 0,72 s e seu atraso médio de resposta é de 1,59 s, indicando alta velocidade de resposta e eficiência na tomada de decisão. Em sete tipos de atividades e níveis de complexidade, a taxa de conflito de recursos varia entre 0,05 e 0,12; a taxa média de utilização de recursos situa-se entre 0,75 e 0,86; e o índice de estabilidade do agendamento varia de 0,8 a 0,91, reduzindo efetivamente os conflitos frequentes na alocação de recursos e alcançando alta estabilidade no agendamento. Em condições de alta concorrência, os índices de equilíbrio de recursos e de robustez na transferência da estratégia são 0,88 e 0,85, respectivamente, indicando boa adaptabilidade às cargas de tarefas concorrentes.
Introdução
As atividades sindicais envolvem o agendamento complexo de múltiplas tarefas e recursos, exigindo que o sistema possua capacidades eficientes de resposta dinâmica1,2. Os requisitos das atividades mudam com frequência, e a distribuição de pessoal e recursos de espaços é complexa, o que pode facilmente levar a conflitos de agendamento e ao desperdício de recursos3,4. Capturar com precisão o histórico das atividades e o status atual dos recursos, bem como aprimorar a capacidade de identificar e responder a conflitos potenciais, é essencial para aumentar a eficiência operacional da organização5,6. A integração de tecnologias avançadas de modelagem de séries temporais e algoritmos de aprendizado por reforço pode proporcionar uma compreensão profunda e uma otimização inteligente em ambientes complexos de agendamento, ajudando a maximizar a utilização dos recursos, acelerar a resposta no agendamento e promover a modernização inteligente da gestão de atividades sindicais.
No entanto, as abordagens de agendamento existentes na prática são amplamente baseadas em regras e estáticas, falhando em se adaptar a mudanças frequentes nas tarefas e flutuações de recursos, o que frequentemente resulta em tempos prolongados de resposta e graves conflitos de recursos. No agendamento de atividades sindicais, os tipos de tarefas são altamente diversos; o uso de recursos é altamente restrito e muda com frequência; e as dependências entre atividades e a competitividade entre recursos constituem um mapa complexo de agendamento7,8. Na prática, o cronograma de atividades não pode ser eficientemente ajustado às janelas de tempo disponíveis para recursos como pessoal e locais9,10, e conflitos frequentemente ocorrem, enfraquecendo a coerência geral das operações organizacionais11,12. O sistema de agendamento não enfrenta um único objetivo de otimização, mas sim um equilíbrio entre indicadores multidimensionais, como minimização de conflitos de recursos, maximização da velocidade de resposta, estabilidade da estratégia de agendamento e taxa de conclusão de tarefas13,14, os quais exibem características típicas de otimização multiobjetivo. Além disso, as atividades sindicais apresentam fases e ciclos distintos, e as estratégias de agendamento devem se adaptar dinamicamente às estruturas variáveis de demanda de recursos em diferentes estágios das tarefas. Planos estáticos gerados uma única vez não conseguem suportar o ambiente de execução com mudanças de alta frequência15,16. A lógica de agendamento existente carece de uma exploração aprofundada do comportamento histórico das tarefas e dos padrões de mudança no status dos recursos. É incapaz de fornecer previsões precisas e deduções estratégicas para o futuro17,18. A estratégia de agendamento do sistema responde lentamente a tarefas emergenciais e mudanças temporárias nos recursos, afetando a sustentabilidade geral da operação19,20. Construir um sistema de agendamento com previsibilidade, flexibilidade e estabilidade tornou-se um requisito técnico fundamental em aplicações práticas. Isso exige que o modelo possua capacidades de percepção de informações em alta dimensão, memória de sequência e migração de estratégias, além de manter decisões robustas e equilíbrio de recursos em um ambiente com múltiplas tarefas, permitindo assim a coordenação inteligente e otimizada do agendamento de atividades sindicais.
Inúmeros estudos propuseram diversas soluções para o problema de escalonamento dinâmico. Entre eles, a combinação de aprendizado profundo e aprendizado por reforço tem demonstrado forte adaptabilidade e capacidades de otimização. Alguns pesquisadores utilizam LSTM (Long Short-Term Memory)21,22 para modelar dados de séries temporais e combinam estratégias de aprendizado por reforço para otimizar o comportamento de escalonamento, obtendo certos resultados. Outro tipo de pesquisa utiliza um método heurístico baseado em algoritmo guloso, enfatizando a simplicidade e eficiência das decisões de escalonamento, o que é adequado para cenários com regras claras23,24. Outros estudos exploraram a aplicação da rede Q profunda (DQN) ao escalonamento, alcançando estratégias aprimoradas por meio da aproximação da função de valor25,26. No entanto, esses métodos apresentam problemas, como captura insuficiente de dependências de longo prazo, atualizações de estratégias instáveis e grandes atrasos na resposta ao enfrentar cenários complexos e dinâmicos de atividades conjuntas, dificultando o atendimento às necessidades de escalonamento de tarefas com alta densidade e diversidade. Portanto, como construir um algoritmo de escalonamento com capacidades eficientes de extração de características e atualização estável de estratégias tornou-se um gargalo que precisa ser superado na pesquisa atual.
Na pesquisa de agendamento multi-domínio, a arquitetura Transformer tem sido aplicada a diversas tarefas de previsão de séries temporais e otimização de agendamento devido ao seu mecanismo de autoatenção com múltiplos cabeçotes, que efetivamente captura dependências temporais de longo alcance27,28. Quando combinada com o algoritmo PPO no aprendizado por reforço, a estratégia é atualizada de forma estável e eficiente mediante o ajuste da função objetivo, e essa abordagem tem demonstrado bom desempenho em áreas como controle de robôs e manufatura inteligente29,30,31. Alguns estudos tentaram integrar o Transformer com aprendizado por reforço para agendamento complexo de recursos32. No entanto, no agendamento dinâmico de atividades sindicais, poucos estudos abordam a combinação de diferentes tipos de atividades e restrições complexas de recursos. Alguns estudos utilizaram redes neurais gráficas para modelar a relação entre recursos e tarefas, melhorando assim a precisão na identificação de conflitos33,34. Alguns pesquisadores otimizaram o agendamento de recursos com base na computação de borda, aumentando a eficiência e o desempenho do modelo35,36. Contudo, esses métodos ainda possuem capacidades limitadas de modelagem para o contexto temporal. Com base nisso, este artigo propõe o uso de um Transformer para codificar sequências históricas de estados de atividades e recursos, combinado com a rede de política PPO, a fim de alcançar uma alta percepção de riscos de conflito e uma atualização estável das estratégias de agendamento para lidar com as necessidades de agendamento dinâmicas e complexas das atividades sindicais.
Estudos mais recentes exploraram a otimização do agendamento de recursos a partir de diferentes perspectivas, como consolidação de máquinas virtuais para eficiência energética em computação em nuvem37, algoritmos de autenticação em redes celulares38, consolidação aprimorada de máquinas virtuais com migração em tempo real para computação em nuvem sustentável39, otimização de tráfego usando previsão de espera e algoritmos evolutivos40, e armazenamento em nuvem baseado em blockchain com otimização aprimorada e preservação de integridade41. Embora esses trabalhos forneçam insights valiosos sobre alocação de recursos e algoritmos de otimização, eles se concentram principalmente em infraestrutura de nuvem, telecomunicações ou sistemas de armazenamento, e não abordam especificamente as restrições de atividades de múltiplos tipos, os conflitos dinâmicos entre recursos de pessoal e locais, e os requisitos de agendamento em tempo real inerentes ao gerenciamento de atividades sindicais. Essa distinção reforça ainda mais a necessidade de um framework de agendamento dedicado, adaptado ao contexto organizacional das atividades sindicais.
Métodos atuais de agendamento para atividades sindicais frequentemente não conseguem capturar dependências espaço-temporais de longo prazo nem manter a estabilidade das políticas diante de mudanças dinâmicas, resultando em tempos lentos de resposta e altos conflitos de recursos. Para abordar essas lacunas na pesquisa, este estudo propõe um modelo de otimização de agendamento baseado no princípio de que a atenção multi-cabeça do Transformer pode codificar efetivamente sequências históricas para previsão de conflitos, e de que a Otimização de Política Próxima (Proximal Policy Optimization, PPO) com um objetivo limitado garante atualizações de política estáveis e adaptativas. Especificamente, o Transformer é aplicado para codificar sequências de estados de atividades e recursos, extraindo características espaço-temporais essenciais para melhorar a previsão de conflitos, e a PPO é combinada para gerar ações de agendamento de forma eficiente e com atualizações estáveis. Uma matriz de restrições unificada é projetada para mapear atividades, pessoal e locais, melhorando o reconhecimento de dependências complexas. As principais inovações deste trabalho incluem: (1) a integração da codificação temporal e do aprendizado por reforço especificamente para o agendamento de atividades sindicais; (2) um mecanismo de atenção consciente de conflitos que prioriza a percepção de riscos; e (3) uma atualização com poda e correção da função de vantagem para garantir robustez da estratégia em alta concorrência. Extensos experimentos sob diversas densidades e complexidades de tarefas validam a superioridade do modelo em relação aos métodos existentes em velocidade de resposta, utilização de recursos e estabilidade, oferecendo uma solução inteligente de agendamento prática e escalável para a gestão de atividades sindicais.
Protocolo
Figura 1 mostra a estrutura de um sistema de agendamento de atividades sindicais que integra modelagem de séries temporais e aprendizado por reforço. A camada de entrada integra cronogramas de atividades, disponibilidade de recursos e informações sobre janelas de tempo do pessoal, e constrói uma matriz multidimensional de relações de conflito entre tarefas e recursos por meio do módulo de grafo de restrições. O transformador realiza codificação com atenção múltipla sobre a sequência histórica de estados de atividades e recursos, produzindo estados ocultos com dependências temporais. O módulo de política utiliza os resultados da codificação para gerar distribuições de ações e estimativa de estados, e executa decisões de agendamento após amostrar as ações. Os resultados da execução são realimentados ao ambiente, atualizando o status dos recursos e gerando recompensas imediatas. Com base nisso, o módulo de otimização constrói uma função objetivo com limitação, avalia a função de vantagem e corrige a estimativa da rede de valor para limitar a deriva da política e garantir atualizações estáveis dos comportamentos de agendamento. Um ciclo fechado de dados é formado entre os módulos, permitindo uma percepção altamente sensível a conflitos de recursos e atualizações adaptativas de estratégias em ambientes dinâmicos, melhorando assim a capacidade de resposta inteligente e a eficiência na alocação de recursos do sistema de agendamento de atividades sindicais em cenários com múltiplas tarefas e altas restrições.
Modelagem de cenário para agendamento de atividades sindicais
Todos os pedidos de atividades no sistema de agendamento são organizados em sequências discretas de agendamento com base em intervalos de tempo. Cada atividade é definida com horários claros de início e término, categorias de recursos, etapas e níveis de prioridade. O status de utilização do local é modelado como uma matriz bidimensional de intervalos de tempo, onde o eixo horizontal representa a unidade de tempo padronizada e o eixo vertical representa o número do recurso espacial. O status do recurso é marcado como disponível ou ocupado, formando um mapa inicial de distribuição de recursos com uma estrutura estática. As informações de escalonamento de pessoal são expandidas na dimensão tempo-identidade para construir um vetor contínuo de janela temporal, cada um dos quais registra o status ocioso/tarefa do pessoal e o número do departamento. Todas as informações de entrada são integradas em uma estrutura tensorial tridimensional, onde denota o intervalo de tempo discreto, denota o número de entidades de recurso e denota o código do atributo de uso do recurso correspondente (como por exemplo, se está ocupado, o número da atividade, a prioridade de uso, etc.). Essa estrutura permite que o sistema de agendamento leia a configuração de recursos a qualquer momento, garantindo uma representação unificada dos diferentes tipos de status de recurso.
Após as informações da tarefa serem vinculadas ao modelo, o vetor de intensidade da tarefa é definido com base na prioridade da atividade e no período de uso do recurso. A combinação de tarefas que pode causar conflito é marcada por meio do método de detecção de sobreposição de janelas de tempo. As combinações conflitantes são convertidas em conjuntos de nós, e conjuntos de arestas são construídos com base em tipos e períodos de recursos compartilhados, a fim de representar explicitamente dependências implícitas. O grafo de tarefas final construído contém informações de limites sobre sequência temporal, sobreposição de recursos ou conflito de restrições, fornecendo uma base estrutural para a detecção subsequente de conflitos e a geração de estratégias de agendamento. Essa estrutura preserva a natureza dinâmica do agendamento de tarefas e as mudanças contínuas no status dos recursos, além de permitir a percepção em tempo real das alterações nas restrições de agendamento.
A detecção de conflitos utiliza as regiões sobrepostas esparsas das dimensões de tempo e recursos na estrutura tensorial como condições iniciais para julgamento. Ela implementa um processamento de codificação estática de relações para pares de tarefas com metas de agendamento sobrepostas. Constrói-se uma estrutura de grafo G=(V,E,C), onde V representa o conjunto de nós ativos, E representa as arestas geradas com base em conflitos de recursos, e C é a matriz de codificação de pesos de conflito para as arestas. A função de peso de conflito é definida da seguinte forma:
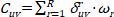 (1)
Dentre eles, Cuv é o peso de conflito entre as atividades u e v; u, v são índices das atividades; R é o número total de tipos de recursos; δuvr ∈ {0,1} indica se as janelas de tempo das atividades u e v se sobrepõem no recurso r; ωr é o peso da sensibilidade ao conflito do recurso r. Esta função realiza uma soma ponderada das intensidades de conflito, levando em conta as diferenças na importância dos conflitos de recursos para os resultados do agendamento, ao mesmo tempo que mantém uma expressão quantificável da distribuição da intensidade de conflito.
A estrutura do grafo de conflito acima é convertida em uma matriz de limites de restrição por meio de uma representação em matriz esparsa. Cada elemento da matriz contém o grau de conflito de recursos. A matriz é incorporada ao processo de decisão de agendamento para determinar se as tarefas podem ser agendadas em paralelo, enquanto a lógica de proteção por ação está na rede de políticas. Para lidar com a agregação periódica de atividades e rajadas densas de tarefas, é implementado um mecanismo de atualização dinâmica para monitorar mudanças no status das tarefas e modificar o conteúdo da matriz em tempo real conforme os recursos são liberados ou adicionados, garantindo a continuidade e consistência do limite de agendamento durante toda a evolução das tarefas.
A aplicação dessa estrutura de grafo de conflito permite que o sistema de agendamento modele visualmente gargalos de recursos e padrões de sobreposição de tarefas, melhorando assim a eficiência da análise de desacoplamento da rede de decisões em cenários de restrições complexas. O comportamento de agendamento não depende mais da correspondência lógica baseada em regras. Em vez disso, busca o caminho ótimo no espaço de restrições, aprimorando a capacidade de equilibrar dinamicamente conflitos locais de recursos com o mapa global de tarefas. O sistema pode manter a estabilidade do agendamento e a coerência das tarefas em um ambiente no qual os recursos flutuam e as tarefas são frequentemente adicionadas ou removidas.
Figura 2 mostra um diagrama de estrutura de rede com base na relação de peso do conflito de tarefas. Cada nó na figura representa uma tarefa a ser agendada, e as linhas entre os nós indicam conflitos no uso de recursos. A espessura da aresta reflete o peso do conflito. Quanto mais grave o conflito, mais espessa é a linha. O cálculo do peso integra a sobreposição de recursos e combina a sensibilidade ao conflito de diversos recursos, formando uma intensidade composta de conflito entre tarefas. A estrutura do grafo revela que algumas tarefas formam áreas densamente conectadas, indicando competição significativa pelo uso de recursos. Esse tipo de fenômeno de agregação local de conflitos é a principal fonte de gargalos de recursos e atrasos de tarefas no processo de agendamento, e o algoritmo de agendamento pode, consequentemente, definir metas prioritárias de mediação. O posicionamento dos nós emprega uma estratégia de layout baseada em forças para agregar automaticamente tarefas com alto conflito, permitindo que o sistema de agendamento identifique grupos-chave de tarefas e otimize a distribuição de estratégias, aumentando assim a coerência geral do agendamento e a coordenação de recursos.
Codificação da sequência de estados históricos
Com base no grafo de conflitos construído e na matriz de restrições, o próximo passo é codificar as sequências históricas de atividades e estados dos recursos, de modo que os padrões temporais subjacentes a essas restrições possam ser extraídos para a tomada de decisões subsequente. As informações centrais no cenário de agendamento consistem em solicitações de atividades, alterações no status de recursos e registros de feedback de tarefas. Essas informações constituem múltiplas séries temporais heterogêneas, correspondentes a atributos como instantes temporais dos eventos, identificadores de uso de recursos e status de execução das atividades. Para unificar a estrutura de processamento, cada tipo de entrada é codificado como uma sequência vetorial de comprimento igual, sendo estabelecido um índice temporal unificado para garantir o alinhamento de estados sob sincronização temporal. A unidade de entrada em cada momento é representada pela concatenação de três conjuntos de vetores de características: o vetor de características da atividade representa o tipo de tarefa, prioridade e número de estágio; o vetor de características do recurso registra a ocupação atual do recurso, capacidade remanescente e posição da janela disponível; o vetor de características do feedback descreve se a tarefa foi executada sem intercorrências no momento anterior e se ocorreu algum conflito de recurso ou evento de atraso.
Todas as características são linearmente transformadas e mapeadas para o mesmo espaço dimensional para obter uma matriz de incorporação padronizada X ∈ ℝT×d, onde T representa o número de etapas temporais e d é a dimensão unificada de incorporação. Para preservar a estrutura temporal, a matriz de entrada é somada elemento a elemento à matriz de codificação de posição P para formar a entrada com informação de posição:
Z = X + P (2)
Z é a sequência de entrada final, que atua como entrada para o mecanismo de atenção subsequente. O design da codificação de posição utiliza um modelo fixo de funções seno e cosseno para evitar vazamento de informações futuras e garantir que as restrições causais sejam estritamente cumpridas durante a codificação. A estrutura descrita permite que o modelo perceba simultaneamente as características da tarefa, o status dos recursos e a posição temporal. Possui uma base de memória de estado completa, fornecendo uma estrutura unificada e de alta resolução para o mecanismo de atenção subsequente.
O módulo de atenção processa a sequência de entrada para capturar relações potenciais entre múltiplos passos temporais. Vários grupos de cabeças de atenção são utilizados para processar a sequência separadamente, aumentando a sensibilidade do modelo a diferentes tipos de trajetórias de evolução de estado. Cada cabeça de atenção gera uma matriz de consulta Q, uma matriz de chaves K e uma matriz de valores V a partir da sequência de entrada, calcula a matriz de distribuição de pesos e gera uma representação ponderada. A saída de uma atenção com uma única cabeça é:
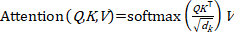 (3)
dk é o número de dimensões de características por cabeça. Nesta fórmula, QK⊤ representa a similaridade entre momentos, √dk é usado para estabilidade numérica, e a função softmax garante a normalização dos pesos. Diferentes cabeças de atenção focam em diferentes combinações de passos temporais, e as dependências dinâmicas que capturam também são diversas, ajudando a revelar regras implícitas, como precursores de conflitos de tarefas, padrões de consumo de recursos e tendências anormais de feedback.
As saídas de todos os cabeçotes de atenção são concatenadas e passadas por uma camada de transformação linear para gerar uma sequência de codificação unificada, que atua como entrada de estado para a rede de geração de estratégia de agendamento. Essa sequência incorpora a trajetória do comportamento da tarefa, as características de mudança de recursos e o impacto dos desvios de execução anteriores na janela de agendamento atual, abordando efetivamente o problema da alta dependência histórica no comportamento de agendamento e da expressão esparsa de características. Módulos de conexão residual e normalização de camada são incorporados à camada de saída da codificação para aprimorar a estabilidade do treinamento e as capacidades de retenção de expressão da rede profunda.
A sequência de estados ocultos de saída não apenas retém informações sobre a evolução temporal, mas também responde a mudanças decorrentes de tarefas repentinas ou desajustes temporários de recursos, demonstrando forte adaptabilidade. Este design estrutural evita a definição explícita de regras, permite a modelagem estruturada de ambientes de agendamento dinâmicos e apoia módulos de política subsequentes na geração de soluções de agendamento com consistência global e adaptabilidade local sob condições multiobjetivo.
Geração de estratégias dinâmicas de agendamento
As sequências de estados ocultos codificadas, que incorporam tanto as dependências temporais quanto as informações sobre conflitos de recursos, são então inseridas na rede de políticas para gerar ações de agendamento que se adaptam ao ambiente atual. A sequência de estados ocultos gerada pelo módulo de codificação é utilizada como entrada para a rede de estratégia de agendamento. O conjunto de vetores de estado em cada momento constitui a expressão atual da observação do ambiente, abrangendo a evolução das características da tarefa, as tendências de uso de recursos e as trajetórias históricas de feedback. A dimensão da representação de estado e o comprimento da janela temporal são fixos, e a continuidade das mudanças de estado é capturada por meio de um mecanismo de atualização deslizante. Antes que o vetor de estado seja enviado à rede de políticas, ele é normalizado e reorganizado em termos de características, garantindo que a entrada mantenha uma distribuição numérica estável no espaço de alta dimensão, reduzindo assim explosões de gradiente e flutuações na convergência.
A estrutura da rede de políticas utiliza um módulo de saída com dois ramos, em que um ramo gera a distribuição de ações e o outro produz a estimativa da função de valor de estado. O espaço de ações compreende todas as tarefas agendáveis e os recursos alocáveis. O mecanismo de triagem de candidatos filtra combinações ilegais ou redundantes de operações para formar um conjunto limitado e válido de ações. O ramo de políticas gera uma distribuição de probabilidade π(at|st), onde at representa a ação de agendamento no passo de tempo, e st é a entrada do estado atual. Uma estratégia padronizada de amostragem gaussiana ou de amostragem softmax é utilizada para selecionar ações a partir da distribuição para o agendamento real. A outra saída é a estimativa da função de valor de estado, que representa a expectativa de recompensa de longo prazo no estado dado e é usada para avaliação e atualização da política.
Na rede de políticas, a camada oculta aplica funções de ativação e normalização por lote para melhorar a capacidade de expressão não linear e acelerar a convergência da rede. No processo de tomada de decisão, a prioridade de execução, o custo de escalonamento de recursos e o desempenho histórico de diferentes tarefas são considerados fatores de atenção e aplicados ao mecanismo de seleção de ações por meio de uma matriz de pesos específica, formando um quadro de saída de políticas adaptativamente ajustável. Esse design evita a dependência de regras fixas, aumentando assim a flexibilidade da estratégia no tratamento de conflitos repentinos e gargalos estruturais.
A estratégia de agendamento utiliza um mecanismo de amostragem aleatória para gerar a sequência real de ações. Em cada ciclo de agendamento, uma ação executável é amostrada a partir da distribuição atual de ações, e o status dos recursos e a marcação do nó da tarefa são atualizados. Após a execução da ação, o sistema calcula a recompensa imediata com base nas alterações nos recursos e nos resultados do progresso da tarefa, a fim de medir o impacto dessa rodada de agendamento sobre o objetivo geral. O design da recompensa considera múltiplas dimensões, incluindo a taxa de conclusão de tarefas, a eficiência na utilização dos recursos e o grau de supressão de conflitos. Ele fornece retroalimentação ao módulo de atualização da estratégia por meio de indicadores abrangentes.
Todo o processo de agendamento constrói uma cadeia de decisão de Markov e utiliza o método de amostragem de trajetória empírica para registrar a sequência estado-ação-recompensa, denotada como (st, at, rt, st+1). A otimização da estratégia depende da construção da função de vantagem, na qual a estimativa de vantagem é definida na seguinte forma:
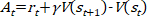 (4)
At representa o valor de vantagem, rt é a recompensa imediata atual, γ é o fator de desconto da recompensa, e V(st) e V(st+1) são as saídas da função de valor de estado nos estados atual e seguinte, respectivamente. A função de vantagem reflete o grau de superioridade da ação atual em relação ao desempenho médio da estratégia. Ela é utilizada para orientar a melhoria subsequente da estratégia. Se At > 0, significa que a ação atual é melhor do que a expectativa média, e sua probabilidade deve ser aumentada; caso contrário, sua tendência de seleção deve ser reduzida.
Durante o processo de atualização da estratégia, para evitar oscilações causadas por amplitudes excessivas de atualização, aplica-se um mecanismo de truncamento da distribuição alvo para limitar a amplitude de variação entre as estratégias nova e antiga, mantendo assim a continuidade e a estabilidade da saída da rede. Estabelece-se um acoplamento estreito entre a distribuição de ações e a recompensa de feedback, permitindo que a estratégia responda imediatamente a mudanças em restrições complexas. Esse mecanismo preserva a estabilidade na tomada de decisões e o agendamento racional de recursos em situações nas quais as tarefas mudam com frequência ou ocorrem desajustes súbitos de recursos, evitando eficazmente problemas como alocação duplicada, congestionamento de recursos ou acúmulo em filas de tarefas. O sistema de agendamento consegue manter um estado operacional mais eficiente diante de diferentes densidades de tarefas e escassez de recursos, demonstrando fortes capacidades adaptativas.
Iteração da estratégia e mecanismo de atualização estável
Para garantir que as estratégias de agendamento geradas permaneçam estáveis e não se degradem ao longo de rodadas repetidas de treinamento, é introduzido nesta subseção um mecanismo de atualização iterativa com limitação e correção de vantagem. O intervalo de atualização do truncamento entre as estratégias antigas e novas é definido, e a função objetiva de limitação é utilizada para restringir a deriva da estratégia, evitando choques de agendamento durante o processo de atualização da estratégia. A rede de avaliação é corrigida em combinação com a função de vantagem para melhorar a precisão do agendamento de longo prazo.
A distribuição de probabilidade da saída de ações da rede de políticas é propensa a flutuações acentuadas durante iterações contínuas de agendamento, o que pode levar a comportamentos instáveis ou a uma alocação desordenada de recursos. Para mitigar o choque de agendamento causado pela deriva da política, foi definido um intervalo de atualização truncado para controlar a amplitude de mudança entre as políticas nova e antiga, e foi construído um termo de restrição para aprimorar a função objetivo. A probabilidade da política histórica é registrada na rodada de amostragem, e o termo de razão é construído com a probabilidade da política atual. O objetivo de atualização da política é definido como:
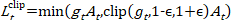 (5)
Aqui, gt = πθ(at|st)/πθold(at|st) denota a razão de probabilidade entre as políticas nova e antiga; ε é o limite de corte que delimita o intervalo de atualização da política. Quando a razão excede o limite, o valor de corte é utilizado em seu lugar para impedir que a estratégia produza gradientes excessivos a partir de amostras extremas, garantindo que o ajuste dos parâmetros da rede permaneça dentro do intervalo pré-definido. Essa estrutura restringe dinamicamente o intervalo de alterações na estratégia de saída a cada rodada de agendamento, mantendo a suavidade e a consistência da saída da estratégia sob distribuições densas de tarefas e reduzindo significativamente a taxa de oscilação do comportamento de agendamento.
A função objetiva da política é aumentada com termos de regularização e recompensa de entropia durante o processo de atualização, a fim de aumentar a diversidade da distribuição de ações e suprimir a convergência precoce. Cada rodada de atualização da política utiliza múltiplos lotes de amostras de trajetórias de experiência para treinamento contínuo, mantendo assim uma ampla cobertura no espaço de estados. Quando a distribuição de probabilidade da sequência de ações de saída é comparada antes e depois da atualização, calcula-se a taxa de desvio da distribuição, e um limite rígido filtra a faixa aceitável de perturbação da política. Esse mecanismo fornece controle de limites para a migração de políticas de escalonamento entre ciclos, suprimindo assim o sobreajuste devido a mudanças drásticas no status dos recursos.
As atualizações de estratégia dependem da avaliação de estado fornecida pela função de valor. Desvios na estimativa do valor do estado podem afetar diretamente a correção da função de vantagem, alterando assim a direção da iteração da estratégia. Para melhorar a precisão da avaliação, é construído um mecanismo de retrocesso de múltiplas séries temporais, e o valor acumulado com desconto das recompensas futuras é utilizado para corrigir o valor do estado atual. A recompensa de retrocesso adota a estrutura de Estimativa Generalizada de Vantagem (Generalized Advantage Estimation, GAE), definida como:
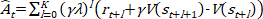 (6)
Ât é o valor de vantagem corrigido; λ é o coeficiente de equilíbrio de retrocesso; rt+l representa a recompensa imediata do passo (t+l); V(st+l) é o valor de estado gerado pela rede de avaliação. Essa estrutura integra feedback imediato de curto prazo e expectativas de estado de longo prazo para corrigir desvios nas previsões de resposta da estratégia frente a conflitos futuros de recursos, picos de carga e acúmulo de tarefas. λ controla a profundidade do retrocesso e se ajusta automaticamente durante períodos de flutuações acentuadas na dinâmica dos recursos, aumentando a robustez da resposta da rede de avaliação a eventos súbitos.
A estrutura dependente do tempo em múltiplas escalas incorporada à função de vantagem permite que a rede de avaliação modele tendências de recursos de longo prazo. Na detecção de desvios na saída da política, o índice de consistência do comportamento da política é utilizado para avaliar se a rede apresenta uma resposta excessiva ao erro de avaliação. Termos residuais de diferença de feedback monitoram o comportamento da atualização da política, e o alvo de treinamento e a amplitude de atualização dos pesos da função de valor são corrigidos dinamicamente. A rede de valor e a rede de política são otimizadas conjuntamente para garantir que a estimativa de valor não se desvie do objetivo de conclusão da tarefa, ao mesmo tempo que evita que agendamentos de alta frequência interpretem incorretamente o status de conflito de recursos.
Esse mecanismo estável de atualização de política pode efetivamente manter a controlabilidade e a consistência das atualizações de comportamento de política em um ambiente de tarefas dinâmico de alta dimensão, melhorando a eficiência de cobertura de tarefas e a flexibilidade na utilização de recursos, além de formar uma estrutura inteligente de agendamento continuamente iterativa. O comportamento de agendamento evita a convergência para otimalidade local na evolução de longo prazo e aumenta a adaptabilidade geral às mudanças nos padrões de tarefas e às flutuações nos ciclos de recursos.
Figura 3A mostra a tendência do valor da função objetivo em função do número de iterações de treinamento sob diferentes condições de limite de truncamento. O eixo horizontal representa o número de iterações de treinamento, e o eixo vertical representa o valor numérico da função objetivo recortada. O valor de ε é definido como 0,1, 0,2 e 0,3, representando diferentes níveis de intensidade no controle da deriva da política. A curva correspondente a um valor menor de ε apresenta menos flutuações, e a função objetivo permanece estável. Quando ε = 0,1, o valor geral da função objetivo situa-se entre 0,8 e 1, demonstrando a gradualidade e estabilidade da atualização da estratégia. No entanto, um valor maior de ε leva a flutuações acentuadas. Quando ε = 0,3, o valor geral da função objetivo varia entre 0,65 e 0,95, e a curva da função objetivo exibe uma amplitude de oscilação maior, refletindo o risco de desvios acentuados no processo de atualização da estratégia. Quanto menor o limite, mais estável é a estratégia, o que a torna adequada para ambientes de agendamento com altas restrições. Figura 3B mostra as alterações na estimativa de vantagem generalizada sob diferentes coeficientes de equilíbrio de retrocesso. Os valores de λ são definidos como 0,8, 0,9 e 1,0, respectivamente, para controlar a profundidade de retrocesso das recompensas futuras. A curva mostra que quanto maior o valor de λ, menor a flutuação da GAE, mais suave a tendência de longo prazo e maior a precisão na captura do impacto potencial do comportamento de agendamento após múltiplos passos. A curva com λ igual a 0,8 exibe flutuações periódicas acentuadas, indicando maior sensibilidade às recompensas imediatas e maior adequação a tarefas de curto prazo e súbitas. Em contraste, um valor de λ igual a 1,0 concentra-se mais na modelagem da tendência de longo prazo e é mais adequado para cenários de tarefas periódicas.
Análise de complexidade computacional e escalabilidade
A complexidade computacional do framework Transformer-PPO proposto é determinada por dois componentes principais: o codificador Transformer e a otimização da política PPO.
Para o codificador Transformer com L camadas, H cabeças de atenção, dimensão de incorporação d e comprimento da sequência de entrada T (a janela temporal histórica), a complexidade temporal por passagem direta é O(L·T2·d + L·T·d2), em que o termo T2 decorre do mecanismo de autoatenção. Na implementação, L = 3, H = 4, d = 128 e T é fixado em 100 passos de tempo, resultando em uma sobrecarga computacional gerenciável. Para janelas históricas mais longas, o termo quadrático T2 torna-se o fator dominante; entretanto, na prática, o planejamento de atividades sindicais geralmente envolve horizontes históricos finitos (por exemplo, janelas móveis de um trimestre ou um ano), e a resolução do passo de tempo pode ser ajustada para equilibrar precisão e eficiência.
Para o componente PPO, as redes de política e de valor são MLPs leves (256 e 128 neurônios por camada oculta), cuja complexidade de inferência é O(d·m), em que m é o número de unidades ocultas, o que é desprezível em comparação com o codificador Transformer. A atualização da política durante o treinamento envolve múltiplas épocas de atualizações de gradiente por mini-lotes, com complexidade O(B·E·d2), onde B é o tamanho do lote e E é o número de épocas de atualização.
Em termos de escalabilidade, o framework apresenta três propriedades favoráveis. Primeiro, o mecanismo de atenção pode ser paralelizado ao longo dos passos temporais, permitindo uma aceleração eficiente pela GPU. Segundo, o tamanho do modelo é independente do número de atividades ou recursos, pois a matriz de restrições é construída dinamicamente a cada passo de agendamento, em vez de ser incorporada como parâmetros fixos. Isso permite que o mesmo modelo treinado seja implantado em conjuntos de diferentes escalas sem necessidade de retratamento. Terceiro, em cenários de escala extremamente grande, o comprimento da janela histórica T e a dimensão da incorporação d podem ser reduzidos como uma compensação, ou pode-se adotar a variante de atenção esparsa para reduzir a complexidade O(T2) para O(T log T) ou O(T).
Resultados
Dados experimentais
Para avaliar de forma abrangente o desempenho do algoritmo de agendamento dinâmico Transformer-PPO apresentado neste artigo, o experimento utiliza dados de gestão de atividades de um grande sindicato empresarial dos últimos três anos como conjunto de dados de referência. Este conjunto contém mais de 5.000 registros de atividades, abrangendo diversos tipos, incluindo reuniões, treinamentos e eventos de entretenimento, com informações de agendamento para múltiplos recursos, como locais, equipamentos e pessoal. Cada registro detalha o horário de início e término da atividade, requisitos de recursos, prioridade e status real de execução (incluindo eventos de conflito e utilização de recursos). Para simular mudanças dinâmicas em cenários reais, os dados são aumentados com 10% adicionais de tarefas súbitas aleatórias e eventos de alteração de recursos (como ocupação temporária de locais e ajustes nas janelas de tempo do pessoal), a fim de verificar a robustez do algoritmo em um ambiente altamente incerto. A sequência contínua de estados fornece entrada estruturada para a modelagem temporal do Transformer e para o treinamento da política PPO. O experimento comparou o desempenho de agendamento sob diferentes densidades e complexidades de tarefas para garantir que a avaliação cubra cenários típicos em aplicações reais, e comparou-o com o modelo LSTM-PPO atualmente popular, um modelo de agendamento por busca gulosa e um modelo de agendamento por política DQN.
O codificador Transformer é composto por 3 camadas, cada uma com 4 cabeças de atenção, uma dimensão de incorporação de 128 e um tamanho oculto feed-forward de 256. A rede de política e a rede de valor compartilham a mesma saída do Transformer como entrada e depois se dividem em dois perceptrons multicamadas (MLPs) separados. Cada MLP possui duas camadas ocultas com 256 e 128 neurônios, respectivamente, utilizando ativação ReLU. Todas as camadas lineares são inicializadas usando a inicialização uniforme de Xavier.
O otimizador é Adam, com uma taxa de aprendizado de 3 × 10⁻⁴, tamanho de lote de 64 e coeficiente de entropia de 0,01. O parâmetro de corte do PPO ε é definido como 0,2, o fator de desconto γ = 0,99 e o GAE λ = 0,95. O modelo é treinado por 5.000 episódios, sendo que cada episódio contém até 100 etapas de agendamento. É aplicado corte de gradiente com uma norma máxima de 0,5 para evitar explosão de gradiente. Esses parâmetros são selecionados por meio de uma busca preliminar em grade e estão de acordo com as práticas comuns em tarefas de agendamento baseadas em aprendizado por reforço. Todos os experimentos são executados em um único acelerador GPU (memória de 40 GB), utilizando Python 3.9 e um framework de aprendizado profundo (veja a Tabela de Materiais).
Tendência temporal da saída da atenção múltipla, realce residual sob variação temporal das características de codificação e estratificação de prioridade de tarefa
Utilizando o histórico real de agendamento como entrada, a solicitação de tarefa, o status de uso de recursos e o status de execução do feedback são extraídos em etapas de tempo contínuas, e informações de múltiplos tipos são incorporadas a um espaço de características unificado por meio de mapeamento linear e codificação posicional. O mecanismo de atenção múltipla calcula, em paralelo, as correlações temporais entre diferentes sequências de características e produz três tipos de sequências de pesos de atenção: tarefa, recurso e feedback. Cada tipo de peso representa a intensidade de atenção do modelo ao estado correspondente em cada etapa de tempo. Após a normalização, uma curva de tendência é traçada para refletir o foco de percepção da camada de codificação e a estrutura de mudança dinâmica das diferentes dimensões de informação no histórico de agendamento. Esse processo é concluído com base na trajetória real de execução das atividades e no registro de uso de recursos no cenário de agendamento.
Figura 4 mostra a tendência dinâmica de atenção do mecanismo de atenção múltipla em diferentes informações de estado no agendamento de atividades sindicais. O passo de tempo está no eixo horizontal, refletindo o avanço contínuo da sequência de agendamento, e o eixo vertical representa o peso de atenção normalizado, limitado ao intervalo [0,1], indicando a importância relativa atribuída pelo modelo às características da tarefa, ao status dos recursos e ao status de feedback. A atenção às características da tarefa apresenta um pico claro por volta do 15º passo. No estágio inicial do agendamento, o modelo prioriza a captura das características temporais das tarefas principais para prever possíveis conflitos e gargalos de recursos, refletindo a sensibilidade ao risco nesta fase do agendamento de atividades. A curva de atenção ao status dos recursos exibe flutuações periódicas, e o peso de atenção geral varia de 0,2 a 0,8, indicando o acompanhamento contínuo pelo sistema de agendamento das mudanças na ocupação de recursos, apoiando o processamento complexo do compartilhamento e alocação de recursos e respondendo efetivamente à competição dinâmica por recursos entre múltiplas tarefas concorrentes. A atenção ao estado de feedback aumenta gradualmente, e o pico de peso ocorre próximo ao passo 35, destacando a atenção do modelo aos resultados da execução e às condições anormais nas fases intermediária e final do agendamento, o que auxilia no ajuste da estratégia para lidar com desvios no agendamento e melhorar a robustez do agendamento geral. Essa tendência mostra que uma estrutura de codificação que integra o mecanismo de atenção múltipla pode captar mudanças sutis nas características temporais e aumentar a adaptabilidade das estratégias de agendamento a recursos diversos e dependências complexas entre tarefas, melhorando assim a eficiência e estabilidade gerais do agendamento dinâmico de atividades sindicais.
A sequência de codificação do estado oculto e a estrutura de resposta às características da tarefa são processadas. A parte de comparação de estados constrói os caminhos de propagação de características antes e depois da conexão residual sob a mesma condição de entrada, observa a evolução temporal do estado oculto ao longo de etapas consecutivas, e extrai suas características de estabilidade local e continuidade global para analisar a evolução suave da expressão de estado durante a transmissão de informação. A tendência de resposta com prioridade para a tarefa é extraída a partir do caminho de ativação de características em diferentes estratégias de ponderação de agendamento. Ao acompanhar os níveis de ativação de diferentes categorias de tarefas ao longo do tempo, capta-se o efeito de ajuste dinâmico do modelo na capacidade de diferenciação de tarefas.
Figura 5A mostra a tendência do estado oculto do modelo antes e após a aplicação do mecanismo de conexão residual. O eixo horizontal representa o passo de tempo, e o eixo vertical representa o valor do estado oculto. A saída original sem conexão residual apresenta flutuações amplas, exibindo instabilidade local acentuada e quebras de tendência. A linha sólida azul representa o valor do estado após a aplicação da estrutura residual. A tendência geral permanece estável, e as flutuações são significativamente reduzidas, indicando que o modelo alcança amortecimento de gradiente e realce de características durante a propagação do estado. Esse fenômeno verifica o papel do mecanismo residual na melhoria da estabilidade de estruturas com dependência de longo prazo, suprimindo eficazmente a atenuação de informação causada por camadas mais profundas e aumentando a capacidade contínua de representação de sequências de estados históricos. Figura 5B descreve a dinâmica de ativação de características de três tipos de tarefas em uma série temporal. O eixo horizontal representa o passo de tempo, e o eixo vertical representa o valor de ativação de características, refletindo a sensibilidade temporal e a atenção à estratégia de tarefas em diferentes níveis de prioridade. As tarefas de baixa prioridade apresentam uma tendência decrescente, e o valor de ativação de características decai para abaixo de 0,5 na fase final, indicando que o modelo lhes dá atenção adequada no estágio inicial de agendamento e gradualmente enfraquece a resposta de recursos ao longo do tempo; as características de tarefas de prioridade média aumentam lentamente ao longo do tempo e apresentam oscilações periódicas, refletindo que o modelo realiza percepção e rastreamento flexíveis das flutuações de sua demanda; tarefas de alta prioridade mantêm uma tendência ascendente contínua ao longo do tempo, e o valor de ativação de características permanece sempre acima de 2, com alto nível de ativação e estabilidade, indicando que o modelo mantém constantemente um alto grau de resposta a essas tarefas. Essa resposta diferencial demonstra a capacidade do módulo de codificação de estado em identificar com precisão os atributos das tarefas e fornece uma base hierárquica para a tomada de decisão na geração de estratégias de agendamento.
Análise multidimensional da evolução de desempenho do algoritmo dinâmico de escalonamento transformer-ppo
Com base na codificação Transformer de sequências históricas de escalonamento e status de recursos, características espaciais e temporais são extraídas como entrada de estado para o PPO; então, a rede de política gera a ação de escalonamento, e o ambiente fornece recompensas imediatas e atualiza o status; durante o processo de treinamento, os indicadores originais de cada rodada são registrados, e em seguida o ruído é eliminado por meio de filtragem com média móvel, analisando-se a tendência de convergência do algoritmo; na visualização final, os dados originais mostram dinâmicas instantâneas, enquanto a curva suavizada reflete a melhoria de desempenho a longo prazo, verificando que o modelo alcança um escalonamento estável por meio da modelagem de séries temporais e da otimização da política.
Figura 6A,B mostra a análise da evolução do desempenho multidimensional do algoritmo dinâmico de escalonamento Transformer-PPO. As flutuações nos dados originais refletem o ruído instantâneo no processo de escalonamento, enquanto os dados suavizados extraem a tendência de longo prazo por meio de uma média móvel, eliminando a interferência de perturbações de curto prazo na avaliação do desempenho do algoritmo e facilitando a observação da evolução do desempenho. Analisando os dados suavizados, a relação dinâmica entre a recompensa e a entropia da política mostra que a curva de recompensa apresenta crescimento logarítmico, e a política aprende rapidamente a agendar ações de forma eficaz por meio da exploração; o crescimento tende a se estabilizar na fase final, e o valor de saturação da recompensa se estabiliza em torno de 12, indicando que a política está próxima do ótimo local. A entropia da política decai gradualmente de cerca de 2,2 no início para cerca de 0,6. O PPO mantém a capacidade necessária de exploração por meio do termo de recompensa de entropia. Uma alta exploração (alta entropia) na fase inicial promove um aumento rápido das recompensas, enquanto a estratégia posterior equilibra exploração e exploração por meio de poda e atualização. A otimização coordenada da taxa de conflito e da utilização de recursos mostra que a taxa de conflito cai para um nível inferior a 10%, sendo que seu limite inferior reflete conflitos que não podem ser eliminados no sistema real devido à aleatoriedade das tarefas. Essa tendência descendente é diretamente atribuível à capacidade do Transformer de codificar sequências históricas de atividades, permitindo que o modelo preveja proativamente disputas por recursos. A utilização de recursos aumentou para cerca de 75%, em conformidade com a lei dos rendimentos marginais decrescentes. É razoável que a utilização não tenha atingido um nível mais alto, pois uma utilização excessiva pode causar atrasos de fila. A redução de conflitos liberou mais recursos disponíveis, e a alocação otimizada de recursos suprimiu ainda mais os conflitos.
Avaliação da velocidade de resposta e da eficiência na tomada de decisões
Comparação do tempo médio de decisão e do atraso médio de resposta sob diferentes densidades de tarefas (número de tarefas: 100, 300, 500, 700, 1000). Comparação do modelo de escalonamento Transformer-PPO apresentado neste artigo com o modelo LSTM-PPO, o modelo de escalonamento por busca gulosa e o modelo de escalonamento de estratégias DQN.
Figura 7A,B mostra o tempo médio de decisão e o atraso médio de resposta para as quatro estratégias de agendamento em diferentes condições de densidade de tarefas, refletindo a capacidade do algoritmo de tomada de decisão em tempo real e a capacidade de resposta do sistema em cenários de alta carga. À medida que o número de tarefas aumenta, cada estratégia apresenta uma tendência crescente em ambos os indicadores, mas as taxas de aumento e a estabilidade diferem. Em cenários com alta intensidade de tarefas, a estrutura Transformer-PPO mantém um desempenho relativamente estável no tempo médio de decisão. Quando a densidade de tarefas é de 1000, o tempo médio de decisão é de 0,72 s e o atraso médio de resposta é de 1,59 s, o que se deve principalmente ao efeito de compressão da codificação de características temporais no espaço de estados e à eficaz eliminação de operações inválidas no espaço de ações. Em contraste, a estratégia DQN apresenta tempos de decisão e atrasos de resposta mais longos conforme o número de tarefas aumenta, refletindo sua capacidade limitada de generalizar políticas em transições de estados de alta dimensionalidade. Embora a estratégia Greedy tome decisões mais rapidamente em diferentes quantidades de tarefas, seu desempenho de resposta degrada em grafos de tarefas complexos devido à ausência de modelagem de dependências de longo prazo. O LSTM-PPO possui uma certa capacidade de percepção temporal na modelagem de sequências, mas apresenta desempenho inferior em cenários de dependência de longo prazo devido à profundidade estrutural limitada. Os resultados revelam o impacto fundamental do design estrutural na capacidade de resposta do sistema de agendamento e enfatizam a necessidade de otimização coordenada do mecanismo de codificação e da eficiência de amostragem de políticas em condições de alta concorrência.
Taxa de conflito e avaliação da utilização de recursos
Sob diferentes condições de complexidade do tipo de atividade (tipo único, múltiplos tipos independentes, múltiplos tipos cruzados, fluxo de trabalho multifásico, colaboração entre departamentos, inserção temporária, ciclo repetido), analisa-se estatisticamente a taxa de conflito de recursos e a taxa média de utilização de recursos. O modelo de agendamento Transformer-PPO apresentado neste artigo é comparado com os modelos de agendamento LSTM-PPO, busca gulosa e DQN.
Figura 8A,B mostra a taxa de conflito de recursos e a utilização média de recursos para diferentes modelos de agendamento em sete níveis de complexidade de atividades. O eixo vertical representa o modelo de agendamento, e o eixo horizontal representa o tipo de atividade. A tendência geral indica que, conforme aumenta a complexidade da estrutura da atividade (como processos multifásicos, colaboração entre departamentos, inserção temporária e ciclos repetidos), a taxa de conflito aumenta em todos os modelos. A estratégia gulosa e o esquema DQN apresentam adaptabilidade limitada a mudanças dinâmicas e são claramente insuficientes no controle de conflitos. O modelo Transformer-PPO mantém uma taxa de conflito baixa mesmo em condições de alta complexidade, com uma taxa geral de conflito de recursos entre 0,05 e 0,12, refletindo sua compreensão profunda da estrutura de dependência de tarefas e das mudanças nos recursos. Em termos de utilização de recursos, o Transformer-PPO mantém um nível elevado em todas as condições, especialmente com cruzamento de múltiplos tipos e inserção temporária. Sua estratégia de ajuste dinâmico reduz efetivamente a ociosidade dos recursos, com uma taxa média de utilização de recursos entre 0,75 e 0,86. Os dados confirmam que o modelo Transformer-PPO alcança um melhor equilíbrio entre flexibilidade de agendamento e eficiência de recursos, oferecendo maior praticidade e escalabilidade.
Estabilidade da programação
O índice de estabilidade da programação é calculado sob diferentes condições de complexidade do tipo de atividade (tipo único, múltiplos tipos independentes, múltiplos tipos cruzados, processo multifásico, colaboração entre departamentos, inserção temporária e ciclo repetido). O modelo de programação Transformer-PPO apresentado neste artigo é comparado com os modelos LSTM-PPO, busca gulosa e DQN.
Tabela 1 apresenta os resultados da comparação do índice de estabilidade da programação entre diferentes modelos de agendamento sob sete condições de complexidade de tipo de atividade. O tipo de complexidade selecionado reflete o desempenho de estabilidade do sistema de agendamento em múltiplos cenários. O valor do índice varia de 0 a 1. Quanto maior o valor, maior a resistência do modelo a perturbações na programação e mais estável é a saída da estratégia. Os resultados experimentais mostram que o Transformer-PPO mantém um índice de estabilidade elevado em todas as estruturas de tarefas. Especialmente em cenários de colaboração multi-tipo, interdepartamental e de ciclo repetido, a estabilidade da estratégia de agendamento é superior à dos demais modelos, demonstrando fortes capacidades de preservação estrutural e de agendamento adaptativo. O índice geral de estabilidade da programação varia de 0,8 a 0,91. Em contraste, a estabilidade do algoritmo guloso e do DQN diminuiu significativamente à medida que a estrutura da tarefa tornou-se mais complexa, com evidente oscilação da política e desvios na execução. O LSTM-PPO exibe alguma estabilidade, mas seu desempenho geral permanece inferior ao do Transformer-PPO. Essa comparação verifica as contribuições positivas do mecanismo de atenção multi-cabeça e do mecanismo de atualização com poda de política para a estabilidade da saída de agendamento, destacando a vantagem do modelo em cenários de atividades complexas e conjuntas.
Análise de adaptação à carga de concorrência de tarefas
À medida que o número de tarefas concorrentes continua a aumentar, o sistema de agendamento deve enfrentar os desafios duplos de conflitos na distribuição de recursos e da redução da generalização da política. Para testar a adaptabilidade do agendamento de diferentes modelos sob expansão da carga de tarefas, esta seção estabelece três níveis de concorrência de tarefas (baixo: 100 itens, médio: 500 itens e alto: 1000 itens) para monitorar a distribuição de recursos do sistema e a consistência da resposta da política durante o ciclo de agendamento. O índice de equilíbrio de recursos é utilizado para refletir o equilíbrio de carga de diferentes unidades de recursos durante o processo de agendamento, sendo calculado da seguinte forma:
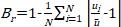 (7)
ui representa a taxa real de utilização das unidades de recurso; ū representa a taxa média de utilização de todos os recursos; e N representa o número total de recursos. A faixa de valores é [0,1], e quanto mais próximo de 1, mais equilibrada é a distribuição dos recursos.
O índice de robustez na transferência de políticas Rs mede o grau de consistência da saída da política sob diferentes condições de carga de tarefa e é definido como:
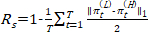 (8)
πt(L) e πt(H) são as distribuições das estratégias de agendamento sob cenários de carga baixa e carga alta, respectivamente, e T é o passo de tempo total. Quanto mais próximo de 1, maior a robustez da migração de estratégias e maior a adaptabilidade.
Tabela 2 apresenta sistematicamente o desempenho dos quatro modelos de escalonamento em termos de equilíbrio de recursos e robustez na transferência de políticas sob cargas variáveis de concorrência de tarefas. Os níveis de concorrência de tarefas são definidos como baixos (100 itens), médios (500 itens) e altos (1000 itens), respectivamente, refletindo a adaptabilidade do modelo sob diferentes pressões de escala de tarefas. Os resultados mostram que o modelo Transformer-PPO alcança o maior índice de equilíbrio de recursos em todos os níveis de carga, refletindo sua capacidade de alocar racionalmente recursos em cenários de múltiplas tarefas concorrentes. Ao mesmo tempo, o índice de robustez na transferência de políticas também é significativamente melhor do que o dos modelos comparativos, demonstrando forte consistência e adaptabilidade nas políticas. Em condições de alta concorrência, os índices de equilíbrio de recursos e de robustez na transferência de políticas são 0,88 e 0,85, respectivamente. Em comparação, o LSTM-PPO obteve o segundo melhor desempenho, enquanto o algoritmo Guloso e o modelo DQN apresentaram degradação significativa do desempenho sob alta carga, com distribuição desigual de recursos e aumento nas flutuações de política sendo mais acentuados. Essa avaliação revelou claramente as diferenças no gerenciamento de recursos e na robustez das políticas no sistema de escalonamento sob expansão da carga de tarefas, e confirmou ainda a aplicabilidade e superioridade da solução fusão Transformer-PPO para o escalonamento dinâmico e complexo de atividades conjuntas.
Comparação com métodos adicionais de última geração
Para comparar ainda mais o método proposto com abordagens recentes de última geração (SOTA), foram implementados três algoritmos representativos da literatura mais recente que combinam aprendizado profundo com aprendizado por reforço para problemas de escalonamento: (1) Transformer+DQN42, utilizando o mesmo codificador Transformer do nosso método, mas substituindo o PPO pelo DQN para aprendizado da política, conforme explorado em estudos recentes de escalonamento baseados em valor; (2) GRU+PPO43, substituindo o codificador Transformer por uma Unidade Recorrente com Portas (Gated Recurrent Unit, GRU) para capturar dependências temporais, representando métodos avançados baseados em RNN; e (3) GraphSAGE+PPO44, empregando um codificador GraphSAGE para modelar as relações entre tarefas e recursos como grafos, refletindo abordagens recentes de redes neurais gráficas para escalonamento. Todos os métodos são treinados sob as mesmas condições experimentais (mesmo conjunto de dados, densidade de tarefas de 1000 e configuração de episódio), com hiperparâmetros ajustados por meio de busca em grade para garantir uma comparação justa. Cada método é avaliado em 10 execuções independentes, e os valores médios das métricas-chave de desempenho (atraso de resposta, taxa de conflito de recursos, utilização de recursos e índice de estabilidade do escalonamento) são registrados.
Conforme mostrado na Tabela 3, o método proposto Transformer+PPO supera consistentemente todos os três baselines SOTA em todas as métricas avaliadas. O atraso médio de resposta do método proposto (1,59 s) é significativamente menor do que o do Transformer+DQN (2,13 s), GRU+PPO (1,89 s) e GraphSAGE+PPO (1,72 s), indicando eficiência superior na tomada de decisões. A taxa de conflito de recursos do método proposto (0,09) também é a mais baixa, indicando melhor prevenção proativa de conflitos. Essa melhoria é atribuída à atenção multi-cabeça do Transformer, que capta dependências de longo alcance de forma mais eficaz do que o GRU ou o GraphSAGE, combinada às atualizações de política estáveis do PPO. Em termos de utilização de recursos, o método proposto alcança 0,82, superando os demais em pelo menos 8 pontos percentuais, demonstrando alocação de recursos mais eficiente. O índice de estabilidade do método proposto (0,88) também é o mais alto, confirmando que o objetivo de limitação e a correção GAE no PPO geram políticas de agendamento mais robustas do que o DQN ou outras variantes do PPO. No geral, os resultados validam que a combinação específica de Transformer e PPO no framework proposto oferece vantagens claras em comparação com arquiteturas alternativas recentes, fortalecendo ainda mais o argumento para sua aplicação no agendamento dinâmico de atividades sindicais.
DECLARAÇÃO DE DISPONIBILIDADE DE DADOS:
O conjunto de dados anonimizado utilizado neste estudo, juntamente com o pipeline de pré-processamento de dados e os scripts de avaliação, foi depositado no repositório Figshare e está publicamente disponível em https://doi.org/10.6084/m9.figshare.33059243 (DOI: 10.6084/m9.figshare.33059243). O conjunto de dados contém cronogramas de atividades, registros de uso de recursos e registros de eventos de conflito de um grande sindicato empresarial, com todas as informações pessoalmente identificáveis e comercialmente sensíveis removidas.
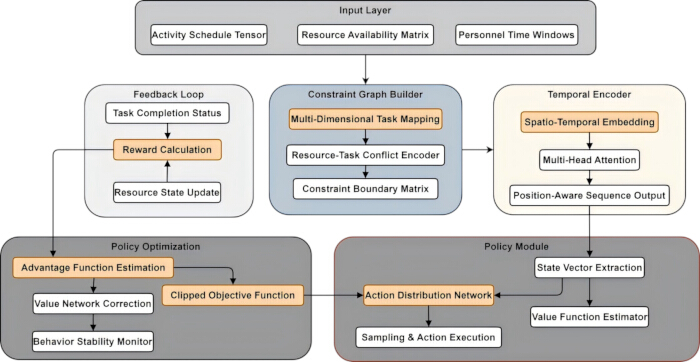
Figura 1: Estrutura do sistema de agendamento de atividades sindicais. Solicitações de atividades, disponibilidade de recursos e informações sobre janelas de tempo do pessoal são integradas para construir um grafo de restrições entre tarefas e recursos e uma matriz de conflitos. Sequências históricas de atividades e estados dos recursos são codificadas usando um Transformer com atenção múltipla. Os estados codificados são fornecidos às redes de política e de valor da otimização de política proximal (PPO), que geram probabilidades de ações de agendamento e estimativas de valor de estado. As ações selecionadas atualizam o ambiente de agendamento e geram recompensas. O objetivo PPO com corte (clipped) e a estimativa generalizada de vantagem são então utilizados para atualizar o modelo, formando um loop de feedback fechado para agendamento adaptativo e alocação de recursos. Clique aqui para visualizar uma versão maior desta figura.
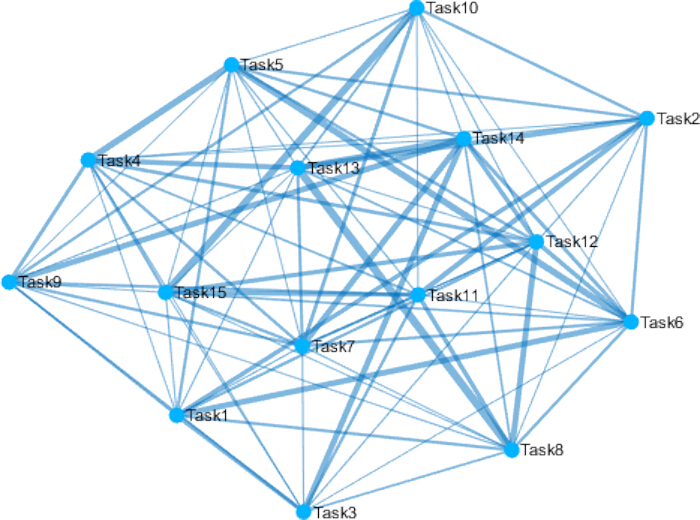
Figura 2: Rede de pesos de conflito de tarefas (a espessura das arestas reflete a gravidade do conflito). Cada nó representa uma atividade aguardando agendamento, e cada aresta representa um conflito causado pelo uso simultâneo de pessoal, locais, equipamentos ou outros recursos. A espessura da aresta é proporcional ao peso do conflito calculado, sendo as arestas mais espessas indicativas de conflitos mais graves. Grupos densamente conectados de nós representam gargalos potenciais de recursos e aglomerados de tarefas concorrentes. Um layout baseado em força direcionada é utilizado para posicionar tarefas com conflitos mais intensos mais próximas umas das outras. Clique aqui para visualizar uma versão maior desta figura.
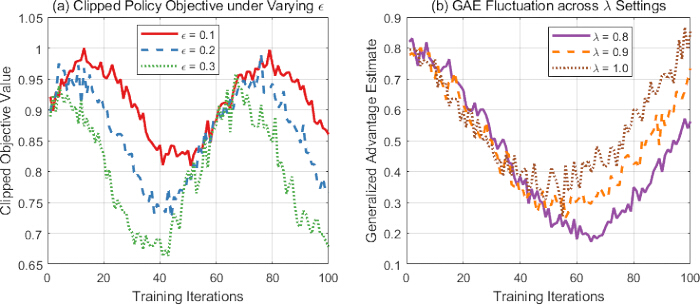
Figura 3: Características dinâmicas da estabilidade da estratégia e da estimativa de vantagem durante a iteração de otimização de agendamento. (A) Objetivo da Política Limitada sob diferentes valores de ε. (B) Flutuação do GAE em diferentes configurações de λ. Clique aqui para visualizar uma versão maior desta figura.
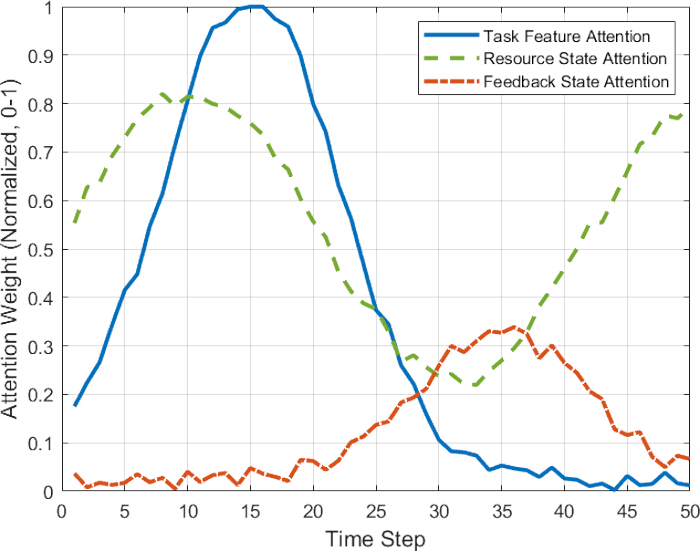
Figura 4: Tendência temporal da saída da atenção multi-cabeça Clique aqui para visualizar uma versão maior desta figura.
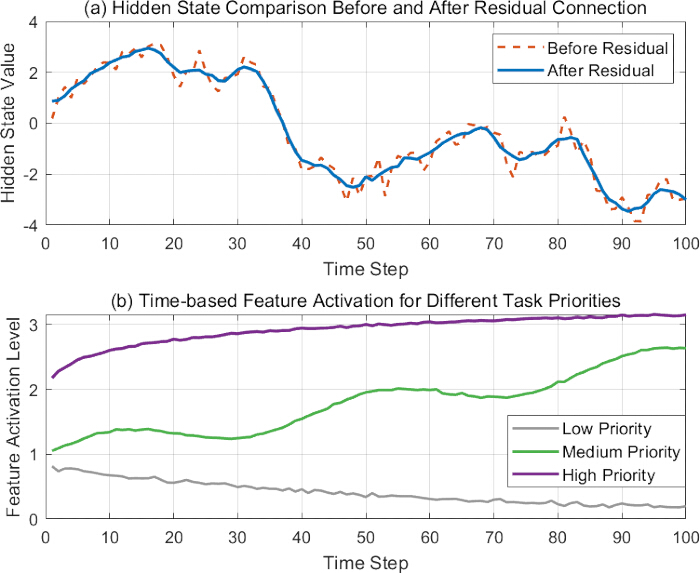
Figura 5: Aprimoramento residual e estratificação de prioridade de tarefas sob variação temporal de características de codificação. (A) Comparação do Estado Oculto Antes e Após a Conexão Residual. (B) Ativação de Características Baseada no Tempo para Diferentes Prioridades de Tarefa. Clique aqui para visualizar uma versão maior desta figura.
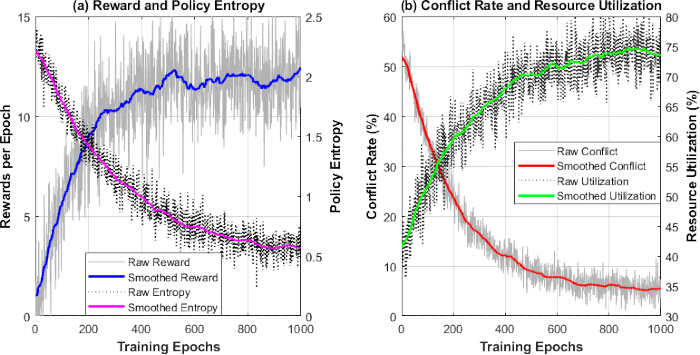
Figura 6: Análise da evolução do desempenho multidimensional. (A) Recompensa e Entropia da Política (B) Taxa de Conflito e Utilização de Recursos. Clique aqui para visualizar uma versão maior desta figura.
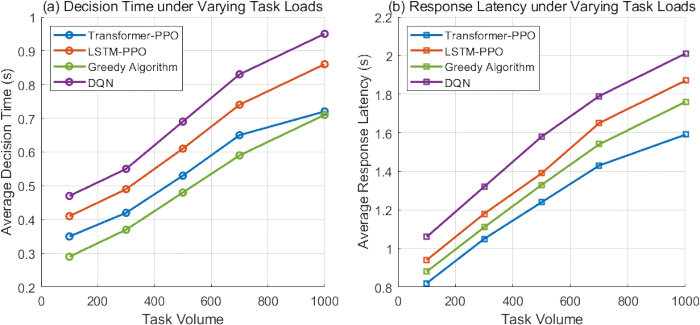
Figura 7: Tempo médio de decisão e atraso médio de resposta. (A): Tempo de Decisão sob Cargas de Tarefa Variáveis. (B): Latência de Resposta sob Cargas de Tarefa Variáveis. Clique aqui para visualizar uma versão maior desta figura.
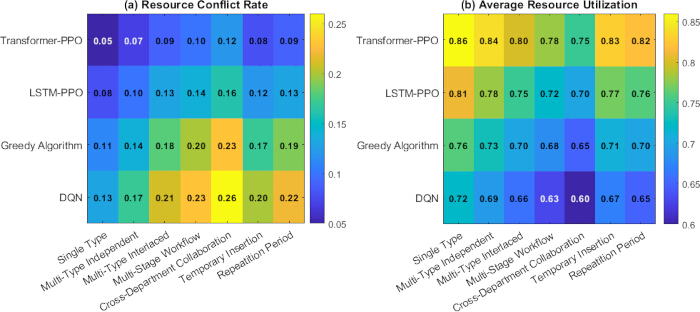
Figura 8: Comparação da taxa de conflito de recursos e da utilização média de recursos (A) Taxa de Conflito de Recursos. (B) Utilização Média de Recursos Clique aqui para visualizar uma versão maior desta figura.
| Condição de Complexidade da Atividade | Transformer-PPO | LSTM-PPO | Algoritmo Guloso | DQN |
| Único Tipo | 0.91 | 0.86 | 0.74 | 0.78 |
| Múltiplos Tipos Independentes | 0.88 | 0.81 | 0.7 | 0.73 |
| Múltiplos Tipos Entrelaçados | 0.85 | 0.76 | 0.65 | 0.68 |
| Fluxo de Trabalho Multietapa | 0.83 | 0.73 | 0.61 | 0.66 |
| Colaboração Interdepartamental | 0.8 | 0.7 | 0.59 | 0.63 |
| Inserção Temporária | 0.86 | 0.78 | 0.68 | 0.72 |
| Período de Repetição | 0.84 | 0.75 | 0.64 | 0.69 |
Tabela 1: Comparação do Índice de Estabilidade de Escalonamento entre Diferentes Complexidades de Atividades. Os índices de estabilidade de escalonamento dos modelos Transformer–PPO, long short-term memory–PPO (LSTM–PPO), busca gulosa, e rede Q profunda (DQN) são comparados em sete condições: atividades de um único tipo, atividades independentes de múltiplos tipos, atividades sobrepostas de múltiplos tipos, fluxos de trabalho multietapa, colaboração entre departamentos, inserção de tarefas temporárias e atividades de ciclo repetido. O índice de estabilidade varia de 0 a 1, sendo que valores mais altos indicam maior resistência a perturbações no escalonamento e saídas de política mais consistentes.
| Condição de Concorrência de Tarefas | Modelo de Escalonamento | Índice de Equilíbrio de Recursos | Índice de Robustez na Transferência de Políticas |
| Baixa Concorrência (100 Tarefas) | Transformer-PPO | 0.94 | 0.92 |
| LSTM-PPO | 0.89 | 0.85 | |
| Algoritmo Guloso | 0.83 | 0.78 | |
| DQN | 0.85 | 0.81 | |
| Concorrência Média (500 Tarefas) | Transformer-PPO | 0.91 | 0.89 |
| LSTM-PPO | 0.86 | 0.82 | |
| Algoritmo Guloso | 0.78 | 0.71 | |
| DQN | 0.81 | 0.76 | |
| Alta Concorrência (1000 Tarefas) | Transformer-PPO | 0.88 | 0.85 |
| LSTM-PPO | 0.82 | 0.76 | |
| Algoritmo Guloso | 0.7 | 0.63 | |
| DQN | 0.75 | 0.68 |
Tabela 2: Avaliação da Adaptabilidade à Carga de Concorrência de Tarefas. O índice de equilíbrio de recursos e o índice de robustez da transferência de políticas dos quatro modelos de agendamento são comparados sob condições de baixa, média e alta concorrência, correspondentes a 100, 500 e 1.000 tarefas simultâneas, respectivamente. Ambos os índices variam de 0 a 1, sendo que valores mais altos indicam uma alocação de recursos mais equilibrada e uma maior consistência das políticas de agendamento diante de mudanças na carga de tarefas.
| Método | Atraso Médio de Resposta (s) | Taxa de Conflito de Recursos | Utilização de Recursos | Índice de Estabilidade |
| Transformer+DQN | 2.13 ± 0.12 | 0.18 ± 0.02 | 0.68 ± 0.03 | 0.76 ± 0.04 |
| GRU+PPO | 1.89 ± 0.09 | 0.15 ± 0.01 | 0.72 ± 0.02 | 0.79 ± 0.03 |
| GraphSAGE+PPO | 1.72 ± 0.08 | 0.13 ± 0.01 | 0.74 ± 0.02 | 0.82 ± 0.03 |
| Proposto | 1.59 ± 0.05 | 0.09 ± 0.01 | 0.82 ± 0.02 | 0.88 ± 0.02 |
| (Transformer+PPO) |
Tabela 3: Comparação de desempenho com métodos adicionais de última geração. O método proposto Transformer–PPO é comparado com Transformer–DQN, unidade recorrente com porta–PPO (GRU–PPO) e GraphSAGE–PPO sob condições experimentais idênticas com uma densidade de tarefas de 1.000. Os resultados representam os valores médios de 10 execuções independentes. Os resultados avaliados incluem atraso de resposta em segundos, taxa de conflito de recursos, taxa de utilização de recursos e índice de estabilidade de agendamento. Atrasos de resposta e taxas de conflito mais baixos indicam melhor desempenho, enquanto taxas de utilização de recursos e índices de estabilidade mais altos indicam melhor desempenho.
Discussão
Os resultados experimentais demonstram que o algoritmo Transformer-PPO proposto supera consistentemente os métodos de referência (LSTM-PPO, busca gulosa e DQN) em todas as métricas de avaliação. O desempenho superior pode ser atribuído a dois fatores principais. Primeiro, o mecanismo de autoatenção com múltiplos cabeçotes do Transformer captura eficazmente as dependências temporais de longo alcance nas sequências de atividades e estados de recursos, permitindo a identificação proativa de conflitos potenciais. Isso explica por que a taxa de conflitos permanece baixa mesmo em alta complexidade (por exemplo, colaboração entre departamentos e inserção temporária), já que o modelo consegue antecipar disputas por recursos antes que ocorram. Segundo, a função objetivo limitada e a correção do valor de vantagem baseada em GAE no PPO garantem atualizações de política estáveis, evitando flutuações acentuadas nas decisões de agendamento e mantendo alta robustez sob cargas de tarefas variáveis.
Em comparação com abordagens de agendamento existentes, o método proposto aborda as limitações dos modelos baseados em LSTM, que sofrem com gradientes desaparecidos em sequências longas, e supera a fraca generalização dos métodos gananciosos e DQN em ambientes dinâmicos. Embora o LSTM-PPO demonstre desempenho moderado, ele falha em manter estabilidade quando as dependências de tarefas abrangem horizontes temporais longos, como refletido em suas taxas mais altas de conflito e menor equilíbrio de recursos sob alta concorrência. O algoritmo ganancioso, embora computacionalmente eficiente, carece de previsão e leva a uma alocação subótima de recursos, aumentando os atrasos de resposta. O DQN, por outro lado, exibe oscilação na política devido à ausência de uma restrição de região de confiança, o que degrada seu desempenho em cenários com múltiplas tarefas.
No entanto, este estudo possui várias limitações. O conjunto de dados é derivado de uma única união empresarial, o que pode limitar a generalização dos resultados para outros contextos organizacionais. Além disso, o modelo assume que todas as atividades e informações sobre recursos são totalmente observáveis, o que pode não ser válido em ambientes do mundo real onde os dados são incompletos ou ruidosos. A sobrecarga computacional do codificador Transformer também aumenta com o comprimento da janela histórica, o que pode afetar a aplicabilidade em tempo real para sistemas de escala extremamente grande.
Trabalhos futuros podem focar em estender o modelo para lidar com ambientes parcialmente observáveis usando estimativa de estado recorrente, e incorporar técnicas de meta-aprendizagem para permitir rápida adaptação a novas uniões com dados históricos limitados. Também planejamos implantar o algoritmo em uma arquitetura colaborativa nuvem-borda para reduzir a latência de decisão e apoiar agendamento distribuído. Além disso, a integração de componentes de IA explicável poderia fornecer justificativas interpretáveis para agendamentos a operadores humanos, aumentando a confiança e a adoção prática.
Este artigo estuda um algoritmo de otimização de escalonamento dinâmico que integra Transformer e aprendizado por reforço PPO, com foco em conflitos frequentes de recursos e atrasos na resposta no escalonamento de atividades sindicais. O algoritmo analisa minuciosamente as características espaço-temporais do histórico de atividades e do status dos recursos por meio de um mecanismo de atenção multi-cabeça, aumentando assim a capacidade de identificar riscos potenciais de conflito. Combinado com o mecanismo estável de atualização da estratégia baseado na função objetivo com corte (clipping), ele alcança resposta eficiente e alocação de recursos em um ambiente dinâmico. Este método demonstra excelentes capacidades de estabilidade no escalonamento, utilização de recursos e controle de conflitos para tipos complexos e diversos de atividades e cargas de tarefas. A análise empírica mostra que o algoritmo apresenta pequeno atraso de resposta sob alta densidade de tarefas. Em sete tipos e complexidades diferentes de atividades, a taxa de conflito de recursos varia entre 0,05 e 0,12, a utilização média de recursos situa-se entre 0,75 e 0,86, e o índice de estabilidade do escalonamento fica entre 0,8 e 0,91. O método mantém uma baixa taxa de conflito de recursos e um alto equilíbrio na utilização, resultados significativamente superiores aos modelos atuais de escalonamento LSTM-PPO, busca gulosa e DQN. Ao mesmo tempo, a robustez da transferência da estratégia e a estabilidade do escalonamento são ambas boas, indicando que o algoritmo possui forte adaptabilidade e capacidade de resistência a perturbações. Essa vantagem de desempenho oferece suporte técnico sólido ao sistema de gestão de atividades sindicais em cenários dinâmicos e mutáveis de escalonamento de recursos.
Divulgações
Os autores declaram que não possuem conflitos de interesses financeiros.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Linguagem de programação principal |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Framework de aprendizado profundo (implementação Transformer/PPO) |
| NumPy 1.23 | Desenvolvedores do NumPy | https://numpy.org/doc/stable/release/1.23.0-notes.html | Biblioteca de computação numérica |
| Matplotlib 3.5 | Equipe de Desenvolvimento do Matplotlib | https://matplotlib.org/stable/users/installing.html | Visualização de resultados |
| Conjunto de dados de agendamento de atividades sindicais | Banco de dados interno de uma empresa colaboradora (anônimo) | Não disponível publicamente devido a acordo de confidencialidade; pesquisadores podem entrar em contato com o autor correspondente para obter acesso | Mais de 5.000 registros de atividades (reuniões, treinamentos, entretenimento) de um sindicato de grande empresa ao longo de três anos |
| NVIDIA A100 GPU | |||
| PyTorch |
Referências
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.