Este estudo investiga biomarcadores de eletroencefalografia para distinguir a doença de Alzheimer, demência frontotemporal e controles saudáveis. Modelos de Floresta Aleatória utilizando características de raiz quadrada média, densidade espectral de potência e entropia foram interpretados por meio de inteligência artificial explicável e análise de tamanho do efeito. A remoção de características de entropia de baixo impacto melhorou o desempenho da classificação, alcançando 94% de precisão no teste.
Artigo de investigação
Fusão de Biomarcadores de Eletroencefalografia Multidomínio para Classificação de Demência Baseada em Aprendizado de Máquina
Neste artigo
Resumo
Resumo
A eletroencefalografia (EEG) tem sido investigada como uma abordagem não invasiva para caracterizar a atividade cerebral em condições neurodegenerativas. Este estudo avaliou se biomarcadores de EEG multiespecializados poderiam distinguir a doença de Alzheimer (AD), a demência frontotemporal (FTD) e controles saudáveis (HC). O conjunto de dados de acesso público continha gravações de EEG em estado de repouso, com os olhos fechados, de 88 participantes, incluindo 36 com AD, 23 com FTD e 29 controles saudáveis. Biomarcadores de EEG multiespecializados e características demográficas foram extraídos para classificação por aprendizado de máquina. As características derivadas do EEG incluíram raiz quadrada média (RMS), densidade espectral de potência (PSD) e medidas de entropia. Um classificador Random Forest foi treinado utilizando o conjunto combinado de características e interpretado com inteligência artificial explicável. Foram realizadas análises de estabilidade das características e do tamanho do efeito de Cohen’s d para avaliar a contribuição das características, seguidas por uma análise de ablação. As características baseadas em entropia mostraram a menor contribuição para a classificação. O modelo multiespecializado completo alcançou 96% de precisão no treinamento e 92% de precisão no teste. Após a remoção das características de entropia, a precisão no teste aumentou para 94%. Esses resultados descrevem o desempenho de classificação das características selecionadas de EEG multiespecializadas e demográficas dentro do framework Random Forest.
Introdução
A doença de Alzheimer (AD) é uma condição neurológica progressiva associada à deterioração das funções cognitiva e motora. Sua prevalência aumenta significativamente com a idade, e a demência é uma das principais causas de morbidade e mortalidade entre adultos mais velhos1,2,3,4,5. Como o diagnóstico e a classificação da doença ainda são desafiadores, a análise de sinais cerebrais tem sido investigada como um meio de caracterizar alterações neurofisiológicas associadas à demência.
A eletroencefalografia (EEG) é um método não invasivo para registrar a atividade elétrica do cérebro e tem sido investigada na doença de Alzheimer e em outros distúrbios neurológicos6,7,8,9,10,11. Os sinais de EEG refletem potenciais elétricos gerados pela atividade neuronal e são registrados de forma não invasiva em múltiplos locais do couro cabeludo12,13,14. A atividade cerebral é comumente caracterizada por meio das bandas de frequência delta, theta, alpha, beta e gamma15. A doença de Alzheimer tem sido associada à desaceleração do EEG, redução da complexidade do sinal e alteração da sincronização16. Análises espectrais relataram aumento da atividade delta e theta, juntamente com redução da atividade alpha e beta, em indivíduos com DA em comparação com controles saudáveis17,18,19. Estudos anteriores de classificação por EEG relataram alto desempenho na distinção entre DA e controles saudáveis (CS) e entre demência frontotemporal (DFT) e CS. Em contraste, a discriminação entre DA e DFT tem sido geralmente mais desafiadora10,11.
Métodos de aprendizado de máquina têm sido utilizados para identificar padrões em sinais de EEG associados a doenças neurológicas20,21. A extração de características é, portanto, um componente importante da classificação baseada em EEG. Estudos anteriores investigaram características espectrais, temporais, de complexidade e de conectividade funcional em combinação com modelos de aprendizado de máquina3,15,22,23. As características espectrais são particularmente relevantes porque quantificam alterações dependentes da frequência na atividade cerebral, incluindo a redução da atividade alfa e o aumento da atividade theta relatados na DA23,24,25,26.
Vários estudos baseados em EEG avaliaram diferentes combinações de características, classificadores e estratégias de validação. A análise baseada em conectividade tem sido utilizada para distinguir DA, DTf e controles saudáveis (CS), com desempenho de classificação relatado variando conforme a comparação e o procedimento de seleção de características27. Características baseadas na transformada de Fourier também foram avaliadas para diferenciar DA, comprometimento cognitivo leve (CCL) e controles saudáveis, embora limitações incluíssem pré-processamento limitado e possível sobreajuste associado à estratégia de validação28. Medidas não lineares de complexidade do EEG demonstraram potencial discriminativo para classificação da DA, com algumas alcançando alta precisão, sensibilidade e especificidade, embora sua aplicabilidade à discriminação do CCL e dos estágios da doença permaneça limitada21.
Métodos de aprendizado profundo baseados em representações temporais e espectrais de EEG também foram investigados para classificação multiclasse de DA, CIM e SC29. Embora alto desempenho de classificação tenha sido relatado, as limitações incluem coortes pequenas ou selecionadas, desequilíbrio entre classes, gravidade heterogênea da doença, ausência de validação externa e baixa interpretabilidade do modelo29. A estratégia de validação também é uma consideração metodológica importante. Abordagens independentes de participantes demonstraram que a validação cruzada convencional em nível de época pode superestimar o desempenho quando épocas do mesmo participante aparecem tanto nos conjuntos de treinamento quanto nos de teste30. Essa limitação é particularmente relevante ao comparar resultados de classificação entre estudos que utilizam esquemas de validação diferentes.
Medidas de complexidade e conectividade também foram avaliadas utilizando classificadores de máquinas de vetores de suporte, com a conectividade baseada em fase e a entropia multiescala mostrando níveis variáveis de desempenho discriminativo31,32. Outros estudos que utilizam características derivadas de Fourier e de wavelet relataram desempenho variável nas comparações entre DA, CIM e GC, sendo a classificação multiclasse geralmente mais difícil do que a classificação binária14. Abordagens baseadas em entropia e sincronia também demonstraram discriminação entre grupos com DA e grupos controle, embora as características da população controle possam afetar o tamanho do efeito observado2.
O presente estudo avalia um conjunto de características multiespectrais composto pelas medidas de raiz quadrada média (RMS), densidade espectral de potência (PSD) e entropia extraídas das bandas de frequência do EEG, juntamente com a idade como variável demográfica. A RMS representa a amplitude do sinal dentro de cada banda de frequência, enquanto a PSD representa a potência no domínio da frequência. A entropia é incluída como uma medida da complexidade do sinal. Essas características fornecem descrições complementares da atividade eletrencefalográfica e são avaliadas utilizando um classificador Random Forest. O estudo analisa ainda a importância das características, a estabilidade das características, a inteligência artificial explicável e a análise do tamanho do efeito para avaliar a contribuição relativa das características extraídas. A presente pesquisa investiga a eficácia de características multidomínio do EEG, incluindo medidas baseadas em espectro, tempo e complexidade, para distinguir entre doença de Alzheimer (AD), demência frontotemporal (FTD) e controles saudáveis (HC) por meio de aprendizado de máquina. Também examina quais características das bandas de frequência do EEG contribuem mais fortemente para a classificação ao utilizar medidas de densidade espectral de potência (PSD), raiz quadrada média (RMS) e entropia. Além disso, o estudo compara as contribuições de características baseadas em potência, incluindo PSD e RMS, com as de características baseadas em entropia e avalia a contribuição da idade no modelo de classificação.
Protocolo
Uma visão geral esquemática do pré-processamento do EEG, extração de características e fluxo de trabalho de classificação é apresentada na Figura 1. Os materiais e softwares utilizados no estudo estão listados na Tabela de Materiais.
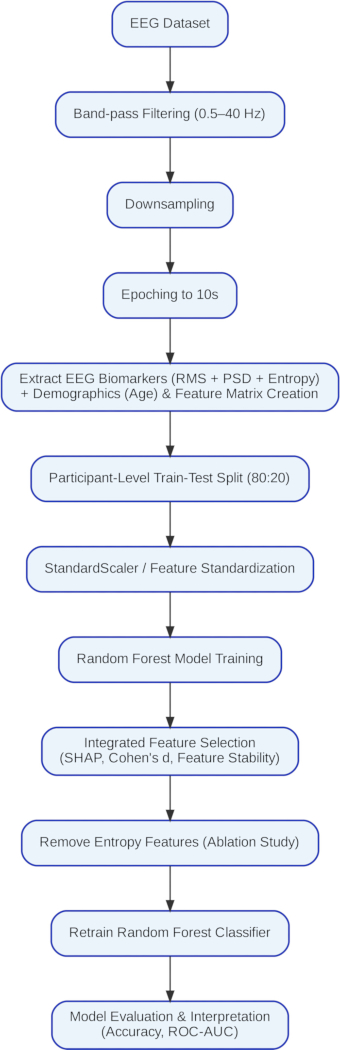
Figura 1: Fluxo de trabalho do pré-processamento de EEG, extração de características e pipeline de classificação. Visão esquemática do fluxo de trabalho do estudo, incluindo verificação dos dados de EEG, filtragem passa-faixa e re-referenciação, extração das características de raiz média quadrática (RMS), densidade espectral de potência (PSD) e entropia, inclusão da idade, divisão entre treinamento e teste, desenvolvimento do modelo Random Forest, análise de estabilidade das características, análise SHAP, análise do tamanho do efeito de Cohen’s d, seleção integrada de características, ablação de características de entropia, re-treinamento do modelo e avaliação do desempenho. Clique aqui para visualizar uma versão maior desta figura.
1. Aquisição de dados
O conjunto de dados de EEG de repouso de acesso público foi obtido do repositório OpenNeuro (conjunto de dados ds004504, versão 1.0.9)33. Os rótulos dos participantes e as informações demográficas foram verificados. O conjunto de dados compreendia 88 participantes, incluindo 36 com doença de Alzheimer (AD), 23 com demência frontotemporal (FTD) e 29 controles saudáveis (HC).
2. Importação da gravação de EEG
Para cada participante, a gravação de EEG foi carregada utilizando a biblioteca MNE-Python. Cada arquivo de EEG foi verificado para confirmar que estava acessível, podia ser importado com sucesso e continha um identificador válido do participante. Gravações com arquivos ausentes ou corrompidos foram excluídas. A frequência original de amostragem de EEG de 500 Hz foi mantida nesta etapa. Os sinais foram subamostrados para reduzir a carga computacional, preservando todas as informações clínicas relevantes de EEG para este estudo.
3. Filtragem passa-faixa
Os registros contínuos de EEG foram filtrados utilizando um filtro passa-faixa de quarta ordem com uma frequência de corte baixa de 0,5 Hz e uma frequência de corte alta de 40 Hz.
4. Referenciação comum média e epocagem
A referenciação comum média (CAR) foi aplicada aos registros de EEG filtrados. Em cada amostra de tempo, o sinal médio de todos os canais de EEG disponíveis foi calculado e subtraído de cada canal. Os sinais de EEG referenciados foram mantidos para análises posteriores. Cada registro de EEG referenciado foi segmentado em épocas de duração fixa utilizando a função make_fixed_length_epochs() no MNE-Python. Foi utilizada uma duração de época de 10 s com sobreposição de 0 s.
5. Validação dos períodos
Para cada participante, apenas os períodos completos de 10 s foram mantidos. Qualquer segmento restante de EEG com menos de 10 s no final de uma gravação foi descartado. Cada período mantido foi posteriormente utilizado como uma amostra individual para extração de características.
6. Preparação das características
Embora os dados do Mini Exame do Estado Mental (MMSE) estivessem disponíveis no conjunto de dados original, foram excluídos da presente análise. As características extraídas do EEG foram combinadas com as informações demográficas dos participantes, incluindo idade e rótulos diagnósticos, obtidas do arquivo de metadados participants.csv. O identificador do participante foi usado como chave comum, e somente os participantes com registros de características de EEG e informações demográficas correspondentes foram mantidos.
A matriz de características multivariada incluiu cinco características de raiz quadrada média (RMS) (delta_rms, theta_rms, alpha_rms, beta_rms e gamma_rms), cinco características de densidade espectral de potência (PSD) (delta_psd, theta_psd, alpha_psd, beta_psd e gamma_psd) e cinco características de entropia (delta_entropy, theta_entropy, alpha_entropy, beta_entropy e gamma_entropy). A idade foi incluída como uma variável demográfica complementar. Como as distribuições de idade podem diferir entre os grupos diagnósticos, não foi possível excluir completamente o confundimento demográfico. O grupo diagnóstico, definido como DA, CS ou DFT, foi atribuído como rótulo alvo.
7. Pré-processamento dos dados e divisão em conjuntos de treinamento e teste
Durante o pré-processamento, as gravações foram subamostradas de 500 Hz para 250 Hz para reduzir os requisitos computacionais, mantendo ao mesmo tempo as informações de frequência de EEG de interesse.
O conjunto de dados foi dividido em subconjuntos de treinamento (80%) e teste (20%) no nível dos participantes, utilizando uma estratégia de divisão agrupada. As previsões por participante foram subsequentemente obtidas por votação majoritária entre as épocas previstas pertencentes a cada participante. A avaliação principal utilizou uma divisão agrupada por participante entre treinamento e teste, a fim de evitar que épocas do mesmo participante aparecessem em ambos os subconjuntos. As previsões por participante foram obtidas por meio de votação majoritária nas épocas previstas associadas a cada participante. O conjunto de dados foi inspecionado quanto a valores ausentes, e observações faltantes foram removidas ou imputadas conforme aplicável. Os rótulos diagnósticos foram codificados. Um StandardScaler foi ajustado aos dados de treinamento e posteriormente aplicado aos conjuntos de dados de treinamento e teste.
8. Desenvolvimento do modelo de floresta aleatória
Um classificador de Floresta Aleatória foi inicializado com 80 árvores, profundidade máxima de árvore de 10, no máximo quatro características, mínimo de cinco amostras por folha e estado aleatório de 42. O classificador foi treinado utilizando o conjunto de dados de treinamento padronizado.
9. Avaliação do modelo
Foram previstos rótulos de classe para os conjuntos de dados de treinamento e de teste. Foi construída uma matriz de confusão, e foram calculadas a acurácia, precisão, revocação e pontuação F1, juntamente com o relatório de classificação. As acurácias de treinamento e de teste foram registradas.
Para a avaliação por participante, certifique-se de que todas as épocas de um determinado participante foram atribuídas exclusivamente ao subconjunto de treinamento ou ao de teste. O classificador Floresta Aleatória foi treinado utilizando os mesmos hiperparâmetros da análise primária.
10. Validação cruzada
Como um procedimento adicional de avaliação do modelo, foi realizada uma validação cruzada estratificada em cinco partes (cinco dobras) utilizando shuffle = True e random_state = 30. Foram calculadas a acurácia média e o desvio padrão nas cinco dobras. Esta análise foi considerada separadamente da avaliação principal por retenção de indivíduos.
11. Análise de estabilidade de características
A estabilidade das características foi avaliada repetindo-se o treinamento da Floresta Aleatória 10 vezes, utilizando sementes aleatórias de 0 a 9. Em cada execução, foram registradas a acurácia no conjunto de teste e as pontuações de importância das características. A média e o desvio padrão da pontuação de importância de cada preditor foram calculados ao longo das 10 execuções, e os preditores foram classificados de acordo com sua estabilidade. Essa análise foi utilizada para avaliar a consistência das classificações das características, e não para substituir a avaliação principal em nível de sujeito.
12. Análise de inteligência artificial explicável
O SHAP TreeExplainer foi aplicado ao modelo de Floresta Aleatória treinado. Os valores SHAP foram calculados para estimar a contribuição de cada característica nas previsões do modelo. O valor médio absoluto de SHAP foi calculado para cada característica, e as características foram classificadas de acordo com suas contribuições SHAP. Características com valores SHAP consistentemente baixos foram identificadas e comparadas com os resultados das análises de estabilidade de características e de d de Cohen. As características que apresentaram contribuições consistentemente baixas foram selecionadas para ablação subsequente e retrinamento do modelo.
13. Análise do tamanho do efeito estatístico
O d de Cohen foi calculado para cada biomarcador de EEG nas comparações AD versus HC, AD versus FTD e FTD versus HC. As magnitudes do tamanho do efeito foram interpretadas utilizando limiares de 0,20 para um efeito pequeno, 0,50 para um efeito médio e 0,80 para um efeito grande.
14. Seleção integrada de características
Os resultados da análise de importância de características do Random Forest, da análise SHAP e da análise de Cohen’s d foram comparados. Os preditores que consistentemente exibiram baixa importância da característica, baixa contribuição SHAP e pequenos tamanhos de efeito foram identificados como candidatos à remoção.
15. Ablação de características
As características de entropia foram avaliadas em uma análise exploratória de ablação, e uma matriz reduzida de características contendo RMS, PSD e idade foi construída. O classificador Random Forest foi treinado novamente usando os mesmos hiperparâmetros. O treinamento do modelo, teste, validação cruzada e análise da curva característica de operação do receptor (ROC) foram repetidos utilizando o conjunto reduzido de características.
16. Análise ROC
As probabilidades das classes foram obtidas a partir do classificador Random Forest otimizado. Curvas ROC multiclasse foram geradas utilizando uma estratégia um-versus-resto. Foram calculados os valores da área sob a curva (AUC) específicos para cada classe e a AUC média.
17. Comparação de desempenho
O desempenho do modelo de características completo foi comparado ao do modelo de características reduzido obtido após a ablação de características por entropia.
Resultados
O modelo Random Forest alcançou 96% de precisão no treinamento e 92% de precisão nos testes. O F1-score macro-médio foi de 92%, enquanto o F1-score médio ponderado também foi de 92%, indicando desempenho comparável entre as três classes. O desempenho na classificação foi mais alto para a classe de doença de Alzheimer (AD), enquanto a classe de demência frontotemporal (FTD) apresentou desempenho relativamente inferior, conforme apresentado na Tabela 1.
A análise da curva característica de operação do receptor (ROC) foi utilizada para avaliar a separação das classes em diferentes limiares de classificação. Conforme mostrado na Figura 2, a área sob a curva ROC (AUC) excedeu 0,98 para as três classes, indicando alta separabilidade entre os grupos de DA, DFT e controle saudável (HC).
A análise SHAP utilizando o TreeExplainer foi realizada para avaliar as contribuições das características no modelo de classificação Random Forest. O gráfico de barras resumo na Figura 3 mostrou a contribuição relativa da densidade espectral de potência (PSD), raiz quadrada média (RMS), entropia e características demográficas. Características com valores SHAP absolutos mais altos contribuíram mais fortemente para as previsões do modelo, enquanto características relacionadas à entropia apresentaram contribuições comparativamente baixas.
A análise de estabilidade das características foi realizada repetindo o treinamento da Floresta Aleatória com as sementes aleatórias especificadas. A precisão no conjunto de teste e os escores de importância das características foram registrados em cada execução, e foram calculadas a média e o desvio padrão da importância das características. O modelo atingiu uma precisão média de classificação de 95% nesta análise, com um desvio padrão de 0,17%. Essas execuções repetidas foram usadas principalmente para avaliar a consistência das classificações das características e foram consideradas separadamente da avaliação principal com validação cruzada por sujeito. A idade apresentou classificação elevada na análise de estabilidade das características, conforme mostrado na Tabela 2. As características theta_psd e theta_rms também apresentaram classificações elevadas, enquanto alpha_psd, alpha_rms, beta_psd e beta_rms mostraram importância moderada das características.
O d de Cohen foi calculado para avaliar a magnitude das diferenças entre grupos, conforme apresentado na Tabela 3. A atenuação na banda alfa (alpha_rms, d = 0,97; alpha_psd, d = 0,87) e o aumento da atividade teta (theta_rms, d = 0,72) apresentaram as maiores diferenças relatadas entre participantes com DA e controles saudáveis. Esses achados foram consistentes com a desaceleração cortical relatada em estudos de EEG sobre demência34. As características baseadas em entropia mostraram tamanhos de efeito comparativamente menores. As comparações entre DA e DFT produziram predominantemente tamanhos de efeito pequenos a moderados.
As características da banda alfa apresentaram tamanhos de efeito grandes nas comparações DA versus SC e DTf versus SC. Para DA versus SC, os tamanhos de efeito relatados foram −0,87 para alfa_psd e −0,97 para alfa_rms. Para DTf versus SC, a atenuação na banda alfa foi de −0,73. A característica theta_psd apresentou um tamanho de efeito de 0,61 para DA versus SC, enquanto theta_rms apresentou um tamanho de efeito de 0,72. Diferenças menores foram observadas para DA versus DTf.
As características na banda beta mostraram predominantemente tamanhos de efeito de pequeno a moderado entre os grupos. Os tamanhos de efeito para beta_psd foram −0,35 para DA versus HC e −0,41 para DA versus FTD, enquanto beta_rms apresentou principalmente efeitos pequenos. As características na banda gama mostraram efeitos moderados em algumas comparações. O tamanho de efeito para gamma_psd foi 0,47 para FTD versus HC e 0,20 para DA versus HC, enquanto gamma_rms apresentou um tamanho de efeito de 0,50 para FTD versus HC.
O PSD delta e o RMS mostraram pequenos tamanhos de efeito positivos para DA versus CH (0,29 e 0,34, respectivamente) e FTD versus CH (0,25 e 0,25, respectivamente). Os tamanhos de efeito para DA versus FTD foram próximos de zero. A entropia delta mostrou pequenos tamanhos de efeito em todas as três comparações (0,08, 0,20 e −0,11).
As análises de estabilidade de características, SHAP e tamanho do efeito indicaram contribuições comparativamente baixas das características de entropia. Consequentemente, realizou-se uma análise de ablação excluindo as características de entropia e mantendo RMS, PSD e idade. Após a ablação das características, o modelo Random Forest alcançou 96% de precisão no treinamento e 94% de precisão nos testes. Esse resultado foi interpretado como uma comparação exploratória dentro do framework avaliado de seleção de características. Precisão, revocação, pontuação F1 e suporte para as classes DA, HC e FTD são apresentados na Tabela 4.
O desempenho antes e após a ablação da característica de entropia é comparado na Tabela 5. A acurácia de teste aumentou de 92% para 94% após a remoção da entropia. As alterações por classe são apresentadas na Tabela 6. Para FTD, a precisão aumentou em 4%, e o escore F1 aumentou em 2%. A revocação para o grupo HC aumentou em 4%, enquanto a precisão diminuiu em 2%. As medidas de desempenho com média macro e média ponderada aumentaram aproximadamente 1%–2% após a ablação da característica.
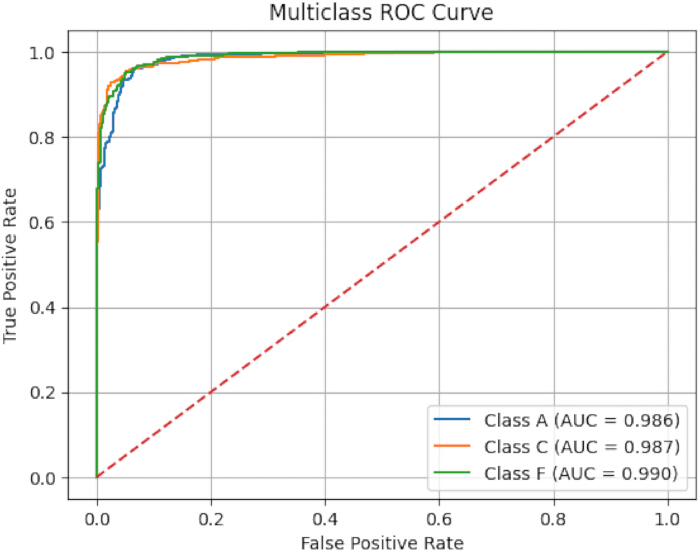
Figura 2Curvas de característica operacional do receptor para doença de Alzheimer, demência frontotemporal e controles saudáveis. Curvas multiclasse de características de operação do receptor (ROC) geradas utilizando o um-versusestratégia de repouso para doença de Alzheimer (classe A), demência frontotemporal (classe F) e controles saudáveis (classe C). A área sob a curva (AUC) foi calculada para cada classe. Clique aqui para visualizar uma versão maior desta figura.
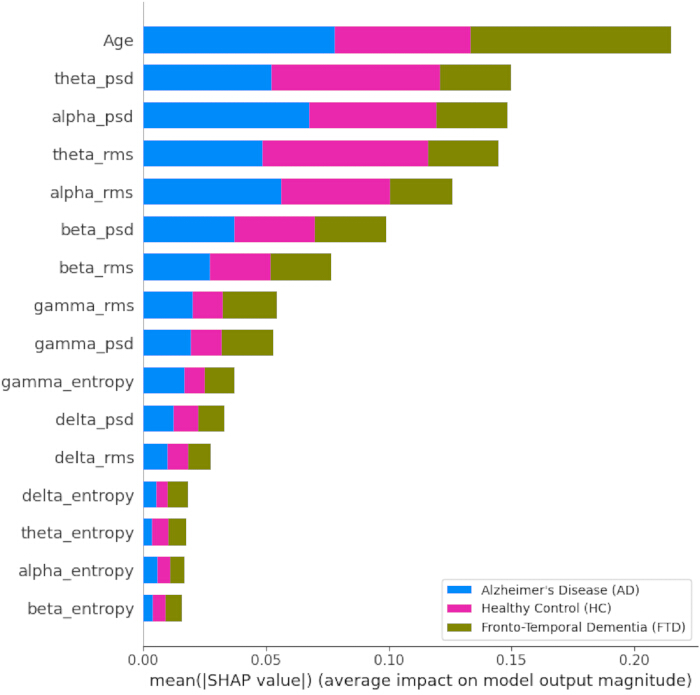
Figura 3: Análise resumida SHAP do modelo de Floresta Aleatória treinado. Gráfico de barras resumido mostrando a contribuição relativa de características derivadas do EEG e características demográficas para o modelo de classificação por Floresta Aleatória. Os valores médios absolutos SHAP foram utilizados para classificar as contribuições das características de raiz quadrada média (RMS), densidade espectral de potência (PSD), entropia e idade. Clique aqui para visualizar uma versão maior desta figura.
| Precisão | Recuperação | Pontuação F1 | Suporte | |
| Alzheimer | 0.92 | 0.95 | 0.94 | 579 |
| Controle | 0.93 | 0.92 | 0.93 | 480 |
| Demência Frontotemporal | 0.93 | 0.87 | 0.9 | 314 |
| Média macro | 0.93 | 0.92 | 0.92 | 1373 |
| Média ponderada | 0.93 | 0.92 | 0.92 | 1373 |
Tabela 1: Relatório de classificação nos dados de teste. Precisão, revocação, pontuação F1 e suporte para as classes de doença de Alzheimer, controle saudável e demência frontotemporal no conjunto de dados de teste, juntamente com as medidas de desempenho médias macro e ponderadas.
| Característica | Média | Desvio Padrão |
| Idade | 0.1966 | 0.0017 |
| theta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropy | 0.0326 | 0.0008 |
| alpha_entropy | 0.0325 | 0.0006 |
| beta_entropy | 0.0283 | 0.0009 |
| theta_entropy | 0.0258 | 0.0004 |
| delta_entropy | 0.0255 | 0.0005 |
Tabela 2: Classificação da estabilidade das características no modelo Random Forest. Valores médios de importância das características e respectiva variabilidade obtidos a partir de treinamentos repetidos do Random Forest utilizando sementes aleatórias de 0 a 9. As características foram classificadas de acordo com sua estabilidade entre as execuções.
| Característica | DA vs. HC | DA vs. DFT | DFT vs. HC |
| DE do Delta | 0,293 | -0,069 | 0,253 |
| DE do Theta | 0,612 | 0,23 | 0,355 |
| DE do Alfa | -0,869 | -0,219 | -0,64 |
| DE do Beta | -0,352 | -0,408 | 0,201 |
| DE do Gama | 0,201 | -0,326 | 0,468 |
| Entropia do Delta | 0,081 | 0,199 | -0,111 |
| Entropia do Theta | 0,208 | 0,033 | 0,163 |
| Entropia do Alfa | -0,061 | 0,071 | -0,137 |
| Entropia do Beta | -0,37 | -0,042 | -0,332 |
| Entropia do Gama | -0,338 | 0,047 | -0,391 |
| RMS do Delta | 0,342 | 0,041 | 0,251 |
| RMS do Theta | 0,718 | 0,354 | 0,318 |
| RMS do Alfa | -0,977 | -0,205 | -0,73 |
| RMS do Beta | -0,494 | -0,365 | 0,015 |
| RMS do Gama | 0,187 | -0,33 | 0,5 |
Tabela 3: Comparação do tamanho do efeito de Cohen’s d entre grupos diagnósticos. Valores de Cohen’s d para biomarcadores de EEG nas comparações entre doença de Alzheimer versus controle saudável, doença de Alzheimer versus demência frontotemporal e demência frontotemporal versus controle saudável.
| Precisão | Recuperação | Pontuação F1 | Suporte | |
| Alzheimer | 0.94 | 0.95 | 0.94 | 579 |
| Controle | 0.91 | 0.96 | 0.94 | 480 |
| Demência Frontotemporal | 0.97 | 0.89 | 0.92 | 314 |
| Média macro | 0.94 | 0.93 | 0.93 | 1373 |
| Média ponderada | 0.94 | 0.94 | 0.94 | 1373 |
Tabela 4: Relatório de classificação após ablação de características. Precisão, revocação, pontuação F1 e suporte para as classes de doença de Alzheimer, controle saudável e demência frontotemporal após a remoção das características de entropia e o reajuste do modelo de Floresta Aleatória.
| Métrica | Antes da Ablação | Após a Ablação | Alteração |
| Precisão no Treinamento | 0.96 | 0.96 | 0% de alteração |
| Precisão no Teste | 0.92 | 0.94 | +2% de melhoria |
| Precisão Macro | 0.93 | 0.94 | +1% de melhoria |
| Revocação Macro | 0.92 | 0.93 | +1% de melhoria |
| Pontuação F1 Macro | 0.92 | 0.93 | +1% de melhoria |
| Precisão Ponderada | 0.93 | 0.94 | +1% de melhoria |
| Revocação Ponderada | 0.92 | 0.94 | +2% de melhoria |
| Pontuação F1 Ponderada | 0.92 | 0.94 | +2% de melhoria |
Tabela 5: Comparação de desempenho antes e depois da ablação de características. Comparação das métricas de desempenho do modelo para o conjunto completo de características multodomínio e o conjunto reduzido de características obtido após a remoção das características de entropia.
DISPONIBILIDADE DE DADOS:
O conjunto de dados CSV processado utilizado para o desenvolvimento e análise do modelo está disponível como Arquivo Suplementar 1. O código de pré-processamento está disponível em um notebook Python em https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing, e os códigos para construção do modelo e análise estão disponíveis em https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. O conjunto de dados CSV processado também pode ser regenerado utilizando o código de pré-processamento fornecido
| Classe | Métrica | Antes | Depois | Alteração |
| Alzheimer | Precisão | 0.92 | 0.94 | 0.02 |
| Revocação | 0.95 | 0.95 | Sem alteração | |
| Pontuação F1 | 0.94 | 0.94 | Sem alteração | |
| Controle | Precisão | 0.93 | 0.91 | −2% |
| Revocação | 0.92 | 0.96 | 0.04 | |
| Pontuação F1 | 0.93 | 0.94 | 0.01 | |
| FTD | Precisão | 0.93 | 0.97 | 0.04 |
| Revocação | 0.87 | 0.89 | 0.02 | |
| Pontuação F1 | 0.9 | 0.92 | 0.02 |
Tabela 6: Alterações no desempenho por classe antes e após a ablação de características. Alterações na precisão, revocação e pontuação F1 para as classes de doença de Alzheimer, controle saudável e demência frontotemporal após a remoção das características de entropia.
Arquivo Suplementar 1: Conjunto de dados de características de EEG em nível de época processadas utilizado para o desenvolvimento e análise do modelo. Clique aqui para baixar este arquivo.
Discussão
O classificador Random Forest foi utilizado para classificar amostras de eletroencefalografia (EEG) nos grupos de doença de Alzheimer (AD), demência frontotemporal (FTD) e controle saudável (HC), usando características multidomínio, incluindo densidade espectral de potência (PSD), raiz quadrada média (RMS) e medidas de entropia. A idade foi incluída como uma variável demográfica complementar. Como as distribuições etárias podem diferir entre os grupos diagnósticos, não foi possível excluir completamente a interferência de fatores demográficos, e, portanto, o desempenho relatado refletiu a contribuição combinada de informações demográficas e eletrofisiológicas. A análise examinou a capacidade das características multissensoriais de EEG de discriminar entre os grupos AD, FTD e HC e avaliou a contribuição das características das bandas delta, theta, alpha, beta e gamma para a classificação35. As análises de estabilidade das características e tamanho do efeito indicaram que as características baseadas em potência, incluindo PSD e RMS, contribuíram mais fortemente do que as características baseadas em entropia. Os biomarcadores de EEG extraídos também refletiram padrões associados à desaceleração dos ritmos e à redução da atividade alfa.
Estudos anteriores avaliaram características do EEG baseadas em entropia, DPE e RMS utilizando diferentes abordagens de aprendizado de máquina2,14,27,28,36,37. A entropia havia sido utilizada para caracterizar a complexidade e irregularidade do EEG, enquanto a DPE havia sido usada para quantificar características espectrais2,14,27,28,36. O RMS também havia sido avaliado como uma característica de banda de frequência37. Utilizando o mesmo conjunto de dados subjacente, trabalhos anteriores aplicaram classificação binária baseada em DPE com validação leave-one-subject-out33. A análise atual, ao contrário, combinou RMS, entropia e DPE nas bandas alfa, beta, gama, theta e delta dentro de um framework de classificação multiclasse. Um transformador leve para EEG foi avaliado no mesmo conjunto de dados utilizando uma estratégia de classificação binária leave-one-subject-out. Um transformador leve para EEG avaliado no mesmo conjunto de dados utilizando uma estratégia de classificação binária leave-one-subject-out relatou uma acurácia de 83,28%. A comparação numérica direta com os resultados atuais deve ser interpretada com cautela, pois a tarefa de classificação e os procedimentos de validação diferiam38.
As características da banda alfa apresentaram os maiores tamanhos de efeito para diferenciar DA de SC e FTD de SC, e a atividade theta aumentada também contribuiu para a diferenciação de DA de SC. As características da banda beta mostraram efeitos menores entre os grupos, enquanto as características baseadas em entropia apresentaram utilidade discriminativa comparativamente limitada. As características da banda gama mostraram efeitos moderados em algumas comparações, incluindo FTD versus SC. Estudos anteriores relataram potência alfa reduzida e atividade theta alterada em DA e comparações diagnósticas relacionadas23,25,39. A entropia também tem sido descrita como um biomarcador potencialmente informativo em doenças neurodegenerativas36, indicando que sua contribuição pode variar conforme o conjunto de dados, a definição das características e a abordagem analítica.
Máquinas de vetores de suporte foram frequentemente utilizadas em estudos anteriores de classificação de EEG3,21,24,37. O classificador Random Forest utilizado na análise atual forneceu estimativas de importância das características e foi aplicável ao conjunto estruturado de características usado neste estudo40,41. Foram obtidas acurácias de treinamento e teste de 96% e 94%, respectivamente, após a ablação das características de entropia. A remoção das características de entropia esteve associada a um desempenho aprimorado do modelo, corroborando a menor contribuição relativa observada para essas características nas análises de estabilidade, SHAP e tamanho do efeito. Abordagens baseadas em aprendizado profundo e em transformadores também foram aplicadas à classificação de EEG, embora tais abordagens geralmente exijam conjuntos de dados maiores e sejam projetadas para representações de alta dimensionalidade ou sequenciais27,39,42,43,44,45.
Os sinais de EEG são ruidosos e não estacionários, e modelos baseados em árvores de conjunto podem oferecer robustez ao analisar representações estruturadas de características. No presente estudo, RMS, PSD, entropia e idade foram avaliados como entradas complementares ao modelo de Floresta Aleatória. RMS representou a amplitude do sinal dentro das bandas de frequência, PSD representou a potência espectral e a entropia representou a complexidade do sinal. Os resultados indicaram que PSD e RMS contribuíram mais fortemente do que a entropia para a classificação dentro da estrutura avaliada. A idade também contribuiu para o modelo, embora sua inclusão tenha introduzido a possibilidade de confundimento demográfico. Investigações futuras poderiam avaliar variáveis demográficas adicionais e abordagens alternativas de aprendizado de máquina ou aprendizado profundo em conjuntos de dados maiores para avaliar ainda mais a generalização e o desempenho da classificação.
Divulgações
Nenhum interesse financeiro concorrente conhecido, relacionamentos pessoais, relacionamentos financeiros ou outras atividades que poderiam ter influenciado o trabalho relatado neste estudo foram declarados.
Agradecimentos
Agradece-se o conjunto de dados de EEG de acesso público utilizado neste estudo e as contribuições dos pesquisadores que disponibilizaram o conjunto de dados para fins de pesquisa. Nenhum financiamento específico foi recebido de agências de fomento públicas, comerciais ou sem fins lucrativos.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | Ambiente computacional baseado em nuvem utilizado para executar os cadernos de análise | |
| MNE-Python | Projeto MNE-Python | 1.12.1 | Utilizado para pré-processamento de EEG, referência, filtragem e segmentação em épocas |
| NumPy | Projeto NumPy | (2.0.2) | Utilizado para cálculos numéricos e baseados em arrays |
| Conjunto de dados EEG do OpenNeuro | OpenNeuro | ds004504, (1.0.9) | Conjunto de dados público de EEG em estado de repouso contendo gravações de AD, FTD e HC |
| Python | Fundação Python Software | [3.12.13 (principal, 4 de mar 2026, 09:23:07) [GCC 11.4.0]] | Ambiente de programação utilizado para processamento de dados e desenvolvimento de modelos |
| scikit-learn | Projeto scikit-learn | 1.6.1 | Utilizado para pré-processamento, divisão agrupada de dados, classificação com Floresta Aleatória e avaliação de desempenho |
| SciPy | Projeto SciPy | (1.16.3) | Utilizado para processamento de sinais e cálculos estatísticos |
| SHAP | Projeto SHAP | 0.52.0 | Utilizado para análise de inteligência artificial explicável com TreeExplainer |
Referências
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379