Este estudo identifica oito genes prognósticos relacionados à catástrofe mitótica (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) no adenocarcinoma pulmonar, estabelece um modelo de risco com desempenho preditivo aceitável e revela características distintas do microambiente imune entre os grupos de risco.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Identificação de Genes Prognósticos Relacionados à Catástrofe Mitótica no Adenocarcinoma de Pulmão via Análise do Transcriptoma
Neste artigo
Resumo
Resumo
O adenocarcinoma pulmonar (LUAD), o subtipo mais comum de câncer de pulmão, apresenta um prognóstico desfavorável. Embora a catástrofe mitótica possa ser induzida no LUAD, levando à morte celular, a importância prognóstica e biológica dos genes relacionados à catástrofe mitótica (MCRGs) nesta doença permanece pouco clara. Genes diferencialmente expressos (DEGs) associados ao LUAD foram selecionados a partir da coorte TCGA-LUAD, e os genes sobrepostos foram definidos pela interseção entre DEGs e MCRGs. Genes prognósticos candidatos foram selecionados por meio de aprendizado de máquina, após o que foi construído um modelo prognóstico multigênico. Foi estabelecida uma assinatura prognóstica composta por oito genes candidatos — PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 e S100B — que demonstrou confiabilidade preditiva aceitável no conjunto de treinamento, com áreas sob a curva (AUCs) de 2, 3 e 5 anos de 0,723, 0,715 e 0,625, respectivamente (C-index corrigido por bootstrap: 0,699, IC 95%: 0,657–0,742), além de validação consistente no conjunto GSE31210 (AUCs: 0,812, 0,766 e 0,814). Pacientes de baixo risco apresentaram resultados de sobrevida significativamente melhores, maior infiltração imune, escores imunes e estromais mais elevados, imunofenopontuações aumentadas e ciclos de imunidade antitumoral mais ativos. Foram observadas diferenças significativas na carga de mutação tumoral e na sensibilidade a medicamentos entre os grupos de alto e baixo risco. A reação em cadeia da polimerase quantitativa (qPCR) validou os perfis transcriptômicos de seis genes candidatos relacionados ao desfecho em amostras clínicas. Um nomograma que incorpora o escore de risco e o estágio clínico mostrou bom desempenho preditivo. Esses achados demonstram que os oito genes candidatos relacionados a MCRGs têm grande potencial para prever os desfechos dos pacientes e estratificar o risco no LUAD, com características distintas do microambiente imune entre os grupos de risco.
Introdução
O câncer de pulmão permanece entre os cânceres mais prevalentes e letais em todo o mundo1,2. O carcinoma de pulmão de não pequenas células (NSCLC) é dominado pelo adenocarcinoma de pulmão (LUAD), que representa cerca de 40% de todos os casos de câncer de pulmão3,4. Embora avanços significativos tenham sido alcançados em procedimentos cirúrgicos, terapias direcionadas molecularmente, inibidores de pontos de controle imunológico e regimes combinados, o prognóstico clínico para pacientes com LUAD permanece desfavorável5,6. Embora abordagens diagnósticas baseadas em patologia e imagem sejam amplamente utilizadas no LUAD, elas apresentam limitações inerentes na captura da heterogeneidade tumoral e das características moleculares. Em contraste, a análise molecular de tecido tumoral baseada em biomarcadores pode fornecer informações mais abrangentes sobre a biologia tumoral e pode contribuir para a avaliação prognóstica e estratégias de tratamento individualizadas7. Portanto, a identificação de biomarcadores moleculares confiáveis permanece importante para melhorar a predição prognóstica e o entendimento biológico do LUAD.
A mitose, um mecanismo essencial de replicação celular, garante a distribuição fiel dos cromossomos replicados entre duas células filhas8. A desregulação dos processos mitóticos pode promover a proliferação celular descontrolada, instabilidade genômica e progressão tumoral. A catástrofe mitótica (MC) define uma via de morte celular desencadeada pela falha na conclusão da mitose, geralmente resultante de danos no fuso mitótico ou defeitos nos pontos de verificação do ciclo celular9. Em nível morfológico, a MC apresenta anormalidades celulares, incluindo multinucleação, micronúcleos, configurações de fuso multipolares e poliploidização10. Como um mecanismo para eliminar células com defeitos mitóticos graves, a MC pode contribuir para a supressão da progressão tumoral9. A deleção de p53 em células de carcinoma pulmonar de tipo adenocarcinoma (LUAD) A549 pode induzir catástrofe mitótica e, eventualmente, morte celular11, sugerindo uma possível ligação entre MC e processos celulares relacionados ao LUAD. No entanto, o significado prognóstico e as funções biológicas dos genes relacionados à MC (MCRGs) no LUAD permanecem pouco esclarecidos.
Nesta pesquisa, a importância prognóstica e a relevância biológica putativa dos MCRGs no LUAD foram sistematicamente investigadas utilizando dados do TCGA e do GEO. Genes candidatos MCRGs foram inicialmente identificados por meio de análises de expressão diferencial e interseção. Diversas abordagens de aprendizado de máquina selecionaram os genes candidatos e estabeleceram uma assinatura prognóstica de risco, que posteriormente foi validada externamente. Um nomograma que incorpora o escore de risco juntamente com características clínicas foi desenvolvido para aprimorar a predição de sobrevida. Além disso, a caracterização do microambiente imunológico, a avaliação de mutações somáticas e a avaliação da quimiosensibilidade foram realizadas para examinar as implicações biológicas e a utilidade clínica dos genes identificados. Em conjunto, esses achados demonstram o potencial prognóstico dos MCRGs no LUAD e podem orientar o desenvolvimento de biomarcadores e o manejo individualizado.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
O estudo foi conduzido de acordo com a Declaração de Helsinque, e o protocolo foi aprovado pelo Comitê de Ética do Hospital Torácico de Anhui (K2025-007) em 22 de abril de 2025. O consentimento informado foi obtido de todos os participantes envolvidos no estudo.
Extração e normalização de dados
Os perfis transcriptômicos e os conjuntos de dados clínicos correspondentes para LUAD foram obtidos dos cohorts do TCGA e do GEO. O conjunto de dados TCGA-LUAD foi designado como conjunto de treinamento, com GSE72094, GSE31210 e GSE26939 servindo como cohorts para validação externa (Tabela 1). Além disso, 900 MCRGs foram coletados de um estudo anterior12 (Tabela Suplementar 1). Os dados do transcriptoma foram anotados utilizando o GENCODE v36 ou os arquivos de anotação da plataforma GPL correspondentes. Os IDs dos probes foram convertidos em símbolos gênicos, genes duplicados foram mesclados usando a função avereps e apenas genes codificadores de proteínas foram mantidos para gerar matrizes de expressão ao nível gênico. Para o conjunto de treinamento TCGA-LUAD, genes com Fragments per kilobase of exon model per million mapped fragments (FPKM) < 1 em mais de 50% das amostras foram filtrados, e os valores de expressão restantes foram transformados por log2 (log2[FPKM+1]). Para os cohorts de validação do GEO, os dados brutos de expressão foram baixados, os IDs dos probes foram mapeados para símbolos gênicos usando os arquivos de anotação da plataforma respectiva e múltiplos probes correspondentes ao mesmo gene foram agrupados pela média de seus valores de expressão. Esses conjuntos de dados foram transformados por log2 quando necessário. Nenhuma correção de efeito de lote entre plataformas foi aplicada entre TCGA e GEO, pois adotamos uma estratégia de padronização por cohort para garantir comparabilidade relativa. Especificamente, tanto para os cohorts de treinamento quanto para os de validação, os valores de expressão gênica foram centralizados e padronizados (transformação por escore z) utilizando a média e o desvio padrão de cada conjunto de dados individualmente. Os mesmos coeficientes de regressão de Cox derivados do conjunto de treinamento foram então usados para calcular os escores de risco para todos os cohorts. Para manter a aplicabilidade clínica e evitar superajuste a qualquer conjunto de validação, a mediana do escore de risco do cohort de treinamento foi utilizada como um ponto de corte fixo para estratificar os pacientes em grupos de alto e baixo risco em todos os cohorts de validação externa. As informações clínicas, incluindo idade, sexo, estágio patológico, estágio Tumor-Nó-Metástase (TNM), tipo histológico, tempo de sobrevida, status de sobrevida e tipo de tecido, foram extraídas quando disponíveis. O desfecho foi a sobrevida global (OS). Amostras com informações incompletas de sobrevida ou tempo de sobrevida < 30 dias foram excluídas. O tempo de sobrevida foi convertido em anos, e o status de sobrevida foi codificado como 0 para vivo e 1 para morto.
Identificação e análises funcionais de genes candidatos
O pacote Limma identificou genes diferencialmente expressos (DEGs) entre amostras tumorais e normais de LUAD no conjunto de treinamento13. Os seguintes critérios definiram os DEGs: |log2FC| > 0,5 e valor p ajustado < 0,05. Posteriormente, o algoritmo de agrupamento difuso mfuzz no pacote R ClusterGVis foi utilizado para particionar os DEGs em clusters distintos de expressão. A análise da Ontologia Genética – Processo Biológico (GO-BP) foi realizada nos cinco principais genes representativos de cada cluster com base em suas pontuações de pertencimento. Um conjunto de genes compartilhados foi obtido pela interseção dos DEGs com os MCRGs. A análise de enriquecimento funcional utilizando Ontologia Genética/Enciclopédia de Genes e Genomas de Kyoto (GO/KEGG) avaliou a relevância biológica dos genes sobrepostos. As redes de interação proteína-proteína (PPI) foram obtidas a partir da base de dados STRING14. Apenas interações com pontuações de confiança > 0,7 foram mantidas para melhorar a confiabilidade da rede.
Triagem de genes prognósticos
O pacote Survival foi utilizado para realizar uma análise de regressão de Cox univariada a fim de identificar genes provavelmente associados à sobrevida global em LUAD15. Genes com valor de p < 0,05 foram considerados indicadores prognósticos potenciais. A coorte de treinamento TCGA-LUAD incluiu 500 pacientes com dados completos de sobrevida, dos quais 216 (43,2%) apresentaram eventos de morte durante o acompanhamento. A razão entre genes candidatos (n = 108) e eventos (n = 216) foi de aproximadamente 1:2, o que é aceitável para análise de regressão de Cox. Posteriormente, a análise de regressão por Seleção e Encolhimento Absoluto Mínimo (LASSO) e o modelo de Boosting Extremo de Gradiente (XGBoost) selecionaram ainda mais as características. Modelos de riscos proporcionais de Cox foram construídos com family = "cox" por meio da função cv.glmnet do pacote glmnet. O parâmetro de regularização ótimo foi identificado utilizando validação cruzada de 10 dobras, sendo o valor λ.min, que representa o erro mínimo de validação cruzada, selecionado como o valor ótimo de λ. Foram extraídos como características candidatas os genes com coeficientes de regressão não nulos. Para o modelo XGBoost, o tempo de sobrevida e o status de sobrevida foram combinados como variável de desfecho, atribuindo-se valores positivos aos eventos de morte e valores negativos aos casos censurados. Os parâmetros foram definidos como objective = "survival: cox" e eval_metric = "cox-nloglik", com 100 iterações e taxa de aprendizado de 0,1. Após o treinamento do modelo, os escores de importância dos genes foram calculados utilizando os valores de ganho das características. Os 20 principais genes foram mantidos após ordenar os escores de importância em ordem decrescente, a fim de reduzir a dimensionalidade das características e a complexidade do modelo. Os genes comuns entre os resultados do LASSO e do XGBoost foram identificados como genes prognósticos candidatos.
Construção e avaliação de um modelo prognóstico
Um modelo prognóstico foi desenvolvido utilizando análise de regressão de Cox multivariada dos genes candidatos identificados. Os escores de risco foram calculados individualmente da seguinte forma:
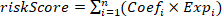 .
em que Coefi refere-se ao coeficiente para o gene i, e Expi indica o respectivo valor de expressão gênica. Os indivíduos foram subsequentemente divididos em dois grupos: alto risco e baixo risco, utilizando a pontuação mediana de risco como ponto de corte. Em seguida, foram criadas curvas de característica operacional do receptor (ROC) dependentes do tempo. Para avaliar o potencial de superajuste, foi realizada validação interna por bootstrap com 1.000 iterações de reamostragem para calcular o índice C corrigido para viés e as AUCs dependentes do tempo com intervalos de confiança de 95%. Curvas de calibração foram geradas para avaliar a concordância entre as probabilidades de sobrevida previstas e observadas aos 2, 3 e 5 anos. Além disso, foi realizada análise de curva de decisão (DCA) utilizando o pacote ggDCA no R para avaliar o benefício clínico líquido do modelo nos pontos temporais de 2, 3 e 5 anos, quantificando o valor potencial da pontuação de risco na tomada de decisões clínicas ao longo de diferentes probabilidades de corte. As disparidades de sobrevida entre os grupos estratificados por risco e entre outras categorias clínicas foram comparadas utilizando curvas de sobrevida de Kaplan-Meier (KM) com teste log-rank. Além disso, para elucidar as contribuições individuais dos genes para o desempenho do modelo, foi empregada a análise Shapley Additive exPlanations (SHAP) para interpretação explicativa pós-hoc.
Desenvolvimento e validação externa de nomograma
As relações entre os escores de risco calculados e diversas características clínicas (incluindo sexo, idade e estágio TNM) foram examinadas utilizando testes de soma de postos de Wilcoxon ou Kruskal-Wallis para avaliar a aplicabilidade clínica do modelo. Para avaliar se o escore de risco funcionava como um fator prognóstico independente, variáveis clínicas, juntamente com o escore de risco, foram incorporadas a modelos de regressão de Cox multivariados. Em seguida, foi construído um nomograma prognóstico combinando os fatores de risco clínicos independentes (por exemplo, Estágio) e o escore genético de risco, utilizando o pacote R regplot, para individualizar as previsões de probabilidade de sobrevida. Curvas de calibração foram utilizadas para avaliar a concordância entre a probabilidade de sobrevida prevista pelo nomograma e os desfechos reais de sobrevida. Por fim, a capacidade preditiva final e a generalização do sistema integrado de nomograma foram rigorosamente validadas por meio de curvas ROC dependentes do tempo e análises abrangentes de subgrupos clínicos KM nas coortes.
Análises de infiltração imune e subtipos imunes
O CIBERSORT, utilizando a matriz de assinatura de genes de leucócitos (LM22), foi usado para estimar as proporções relativas de 22 tipos de células imunes e avaliar a infiltração de células imunes em pacientes com LUAD. As relações entre os níveis de expressão gênica prognóstica e a infiltração imunológica foram avaliadas por análise de correlação de Spearman. Os escores de imunidade, estroma, pureza tumoral e ESTIMATE foram obtidos por meio do algoritmo ESTIMATE, e o teste de Wilcoxon avaliou as diferenças entre os grupos de risco. Os pacientes com LUAD foram classificados em seis subtipos imunes utilizando o pacote ImmuneSubtypeClassifier16. O teste de Wilcoxon também foi utilizado para comparar as distribuições dos subtipos imunes entre os grupos de risco.
Análises de pontos de controle imunológico, escore imunofenotípico e ciclo de imunidade contra o câncer
Neste estudo, o teste de soma de postos de Wilcoxon foi utilizado para avaliar 21 genes de pontos de controle imunológico17 entre grupos estratificados por risco, com o objetivo de caracterizar o panorama imunológico do LUAD. A correlação de Spearman associou genes prognósticos candidatos aos genes de pontos de controle imunológico. Para avaliar as diferenças na resposta a inibidores de pontos de controle imunológico (ICIs) em pacientes com LUAD em diferentes níveis de risco, dados de escore imunofenotípico (IPS) para tratamentos anti-PD-1 e anti-CTLA-4 foram obtidos do The Cancer Immunome Atlas (TCIA)18, e a base de dados Tracking Tumor Immunophenotype (TIP)19 foi utilizada para avaliar a atividade do ciclo câncer-imunidade, comparando os escores correspondentes entre os grupos de risco.
Análise de mutação somática e sensibilidade a medicamentos
A ferramenta de mutações do TCGA recuperou perfis de mutações somáticas para os casos do TCGA-LUAD a fim de investigar a variação nos padrões de mutação entre os grupos de risco. O pacote maftools processou e visualizou os dados de mutação. Os níveis de carga mutacional tumoral (TMB) foram determinados para cada espécime e comparados entre as duas categorias de risco. A análise de sensibilidade farmacogenômica foi realizada utilizando o pacote pRRophetic de acordo com a base de dados Genomics of Drug Sensitivity in Cancer (GDSC)20. Valores da concentração inibitória máxima (IC50) para fármacos anticâncer foram previstos para cada paciente com LUAD, e as diferenças entre os grupos de risco foram quantificadas utilizando o teste de soma de postos de Wilcoxon.
Avaliação dos níveis de expressão de genes prognósticos
Cada conjunto de dados serviu para avaliar os níveis de transcritos de genes candidatos selecionados relacionados ao desfecho. Para associar a expressão gênica ao prognóstico do paciente, cortes ideais foram derivados por meio da função surv_cutpoint no pacote R survminer. Com base nesses limiares, os casos de LUAD foram categorizados em subconjuntos de alta e baixa expressão para análise subsequente de sobrevida.
Além disso, cinco pares de tumores de CAUP e tecidos normais adjacentes correspondentes foram obtidos do Hospital Torácico de Anhui e a validação por qPCR foi posteriormente realizada. Cada participante forneceu consentimento informado por escrito. Seis genes prognósticos candidatos (PDGFB, LDHA, ZEB2, FKBP4, DMD e S100B) foram selecionados para validação por qPCR. O RNA foi extraído de amostras de tecido homogeneizadas utilizando reagente de extração de RNA, seguido por extração com clorofórmio e precipitação com isopropanol. O espectrofotômetro permitiu a medição da concentração e pureza do RNA. A validação por qPCR dos seis genes prognósticos candidatos foi realizada utilizando uma mistura mestra de PCR baseada em SYBR Green em um sistema de PCR em tempo real: desnaturação inicial a 95 °C por 30 s, seguida por 40 ciclos de 95 °C por 20 s, 55 °C por 20 s e 72 °C por 20 s. A expressão relativa foi calculada e normalizada à Gliceraldeído-3-Fosfato Desidrogenase (GAPDH) utilizando a técnica de 2-ΔΔCt. Os detalhes de todos os reagentes e instrumentos estão fornecidos na Tabela de Materiais.
Análise estatística
As análises estatísticas foram realizadas utilizando software de computação e visualização estatística. A rede de interação proteína-proteína foi visualizada usando software de análise de redes. Após a avaliação da normalidade, o teste t de Student foi utilizado para variáveis contínuas com distribuição normal, e o teste U de Mann-Whitney para aquelas com distribuição não normal.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Identificação de genes candidatos e análise funcional
Um total de 4.915 DEGs foi detectado, incluindo 2.485 DEGs com expressão reduzida e 2.430 DEGs com expressão aumentada (Figura 1A). A análise de agrupamento por módulos funcionais classificou esses DEGs em seis módulos de expressão (C1-C6), dos quais os módulos C1, C2, C3 e C5 apresentaram expressão relativamente mais alta em amostras tumorais (Figura 1B). A anotaç...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
O CAPE é uma das principais formas de câncer de pulmão e continua a representar um considerável ônus para a saúde pública21. A MC é um processo relacionado à morte celular que pode contribuir para a eliminação de células com graves anormalidades mitóticas e para a supressão da progressão tumoral22. Portanto, investigar o papel potencial dos GRCM no CAPE pode ajudar a identificar biomarcadores prognósticos e a melhorar a compreensão da biologia do CAPE. O estudo analisou a r...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram não haver conflitos de interesse.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| ClusterGVis | CRAN | versão 0.1.2 | Agrupamento e Visualização de Expressão Gênica |
| Cytoscape | Consortium Cytoscape | versão 3.9.1 | Visualização de Redes de Interação de Proteínas RRID:SCR_003032 |
| Sistema CFX384 de PCR Quantitativa em Tempo Real com Fluorescência | Bio-Rad | CFX384 Touch | reagente de qPCR |
| Primer DMD | Tsingke | N/A | Sentido: 5’-GCTCAACCATCGATTTGCAGCC-3’ Antissentido: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| Primer FKBP4 | Tsingke | N/A | Sentido: 5’-TGACTCCAGTCTGGATCGCAAG-3’ Antissentido: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Ferramenta Online | Obtenção do Conjunto de Dados de Validação Externa de LUAD RRID:SCR_005012 |
| Primer GAPDH | Tsingke | N/A | Sentido: 5’-GTCTCCTCTGACTTCAACAGCG-3’ Antissentido: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | versão 4.1-8 | Seleção de Características na Regressão LASSO RRID:SCR_015505 |
| Primer LDHA | Tsingke | N/A | Sentido: 5’-GGATCTCCAACATGGCAGCCTT-3’ Antissentido: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | versão 3.60.6 | Triagem de Genes Diferencialmente Expressos RRID:SCR_010943 |
| maftools | Bioconductor | versão 2.20.0 | Visualização de Dados de Mutação Somática RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | Predição de Valores de IC50 de Fármacos RRID:SCR_024417 |
| Primer PDGFB | Tsingke | N/A | Sentido: 5’-GAGATGCTGAGTGACCACTCGA-3’ Antissentido: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | reagente de qPCR |
| Software R | Fundação R | versão 4.2.2 | Análise Bioinformática |
| regplot | CRAN | versão 1.1 | Criação de Gráficos de Linha |
| survival | CRAN | versão 3.8-3 | Análise de Sobrevivência e Regressão de Cox RRID:SCR_021137 |
| STRING | Consortium STRING | Ferramenta Online | Análise de Rede de Interação de Proteínas RRID:SCR_005223 |
| Primer S100B | Tsingke | N/A | Sentido: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Antissentido: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | versão 0.5.0 | Plotagem e Otimização de Curvas de Sobrevivência RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | reagente de qPCR |
| TCGA | NCI | Ferramenta Online | Aquisição de Dados Transcriptômicos e Clínicos de LUAD RRID:SCR_003193 |
| Primer ZEB2 | Tsingke | N/A | Sentido: 5’-AATGCACAGAGTGTGGCAAGGC-3’ Antissentido: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Referências
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Reimpressões e permissões
Este artigo foi publicado
Vídeo em breve