Este protocolo descreve como construir, treinar e avaliar uma estrutura multiview Vision Mamba U-Shaped Network para segmentação de imagens médicas, possibilitando segmentação reprodutível de lesões de pele e órgãos abdominais por meio da preparação padronizada de conjuntos de dados, implementação de modelos e avaliação de desempenho.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Estrutura de Rede em U em Múltiplas Visualizações Mamba para Segmentação de Imagens Médicas
Neste artigo
Resumo
Resumo
Segmentação de imagens médicas requer métodos computacionais que capturem com precisão o contexto global, os limites locais e as estruturas anatômicas em múltiplas escalas, permanecendo reprodutíveis em diferentes aplicações. Este artigo apresenta um protocolo para construir, treinar e avaliar uma estrutura Multi-view Vision Mamba U-Shaped Network para segmentação bidimensional de imagens médicas. O protocolo oferece um fluxo de trabalho reproduzível que inclui aquisição de conjuntos públicos de dados, pré-processamento de imagens e máscaras, construção de rede, treinamento de modelos, seleção de checkpoints e avaliação quantitativa e qualitativa de desempenho. A estrutura incorpora varredura de características multiview para capturar informações espaciais, de contorno, escala e limites complementares, e aplica fusão de características em múltiplos estágios dentro de uma arquitetura codificador-decodificador em formato de U para melhorar a integração de características durante a segmentação. O protocolo é demonstrado usando conjuntos de dados de segmentação de lesões cutâneas e órgãos abdominais disponíveis publicamente. Sob o fluxo de trabalho de implementação descrito, a estrutura alcança desempenho competitivo em segmentação usando métricas padrão de avaliação. Ao seguir os procedimentos apresentados neste protocolo, os pesquisadores podem reproduzir a implementação do modelo, treinar a rede usando configurações experimentais definidas, avaliar o desempenho da segmentação e adaptar o fluxo de trabalho para tarefas relacionadas à segmentação de imagens médicas que exigem análise baseada em aprendizado profundo reprodutível.
Introdução
A segmentação de imagens médicas é uma tarefa fundamental nos campos de visão computacional e análise de imagensmédicas 1,2,3. Envolve a partição de uma imagem em múltiplas regiões ou objetos para análise e processamento posteriores. Essa tecnologia é particularmente importante em imagem médica porque auxilia os profissionais a identificar e localizar regiões patológicas, melhorando assim a precisão diagnóstica e o planejamento do tratamento. Com o avanço das tecnologias de imagem médica, como ressonância magnética (MRI), tomografia computorizada (TC) e tomografia por emissão de pósitrons (PET), a demanda por técnicas precisas de segmentação de imagens médicas continuou a aumentar. Os métodos atuais para segmentação de imagens médicas podem ser amplamente categorizados em três abordagens principais: métodos baseados em redes neurais convolucionais (CNN) 4, métodos baseados emTransformer 5 e métodos baseados em modelos de espaço de estados (SSM) 6,7. Métodos baseados em CNN normalmente empregam arquiteturas de rede em formato de U para segmentação de imagens médicas. A arquitetura mais amplamente utilizada nessa categoria é aU-Net 8, que demonstrou a eficácia de uma arquitetura codificador-decodificador em formato de U para segmentação de imagens biomédicas. O U-Net3+ combina conexões de salto denso do UNet++9 com conexões de salto em escala real para aprimorar a agregação de características multiescala. No entanto, métodos baseados em CNN têm capacidade limitada de capturar dependências de longo alcance e, portanto, podem não modelar efetivamente informações contextuais de longo alcance.
Métodos baseados em transformadores capturam efetivamente dependências de longo alcance por meio do mecanismo de autoatenção, que permite computação paralela e atribui diferentes pesos de atenção a diferentes regiões de interesse. O UNETR++10 introduz o módulo de Atenção Eficiente em Pares (EPA) para reduzir o número de parâmetros e o custo computacional. nnFormer11 combina operações convolucionais intercaladas e de autoatenção, e introduz um mecanismo de autoatenção local–global baseado em volume para aprender representações volumétricas em segmentação de imagens médicas tridimensionais (3D). O H2Former12 propõe um transformador de visão híbrido hierárquico eficiente que combina mecanismos de atenção com extração de características baseada em CNN no codificador. No entanto, métodos baseados em transformadores exibem complexidade computacional quadrática com o aumento do comprimento da sequência, resultando em custos computacionais substancialmente maiores. A Figura 1 ilustra a motivação para o MVM-UNet e compara a estratégia proposta de varredura multiview com os frameworks de segmentação baseados em SSM já existentes.
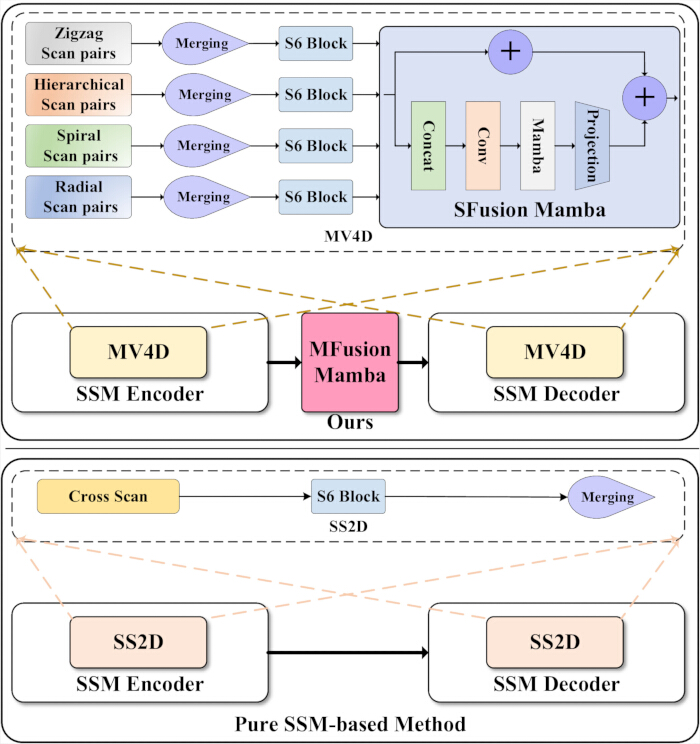
Figura 1. Comparação do MVM-UNet com arquiteturas de segmentação baseadas em modelos puros de espaço de estados (SSM) existentes. Comparação entre um modelo convencional de segmentação baseado em modelo puro de espaço de estados (SSM) e a arquitetura proposta Multi-View Mamba U-Net (MVM-UNet). O painel superior ilustra o MVM-UNet, no qual o módulo Multi-View 4-Directional (MV4D) extrai características complementares usando pares de varredura em ziguezague, hierárquica, espiral e radial que são integrados pelo Spatial Fusion Mamba (SFusion Mamba), enquanto o Multistage Fusion Mamba (MFusion Mamba) agrega características do codificador multiescala antes da decodificação. O painel inferior mostra uma arquitetura representativa baseada em SSM puro usando módulos de Varredura Seletiva 2-Dimensional (SS2D) com varredura cruzada. A figura destaca as diferenças arquitetônicas entre redes convencionais de segmentação baseadas em SSM e o proposto MVM-UNet. Por favor, clique aqui para ver uma versão ampliada desta figura.
Métodos baseados em SSM combinam a capacidade global de modelagem dos Transformers com complexidade computacional linear. A arquitetura Mamba processa seletivamente as informações de entrada usando um modelo seletivo de espaço de estados (Selective-SSM), permitindo que o modelo ajuste dinamicamente seus parâmetros de acordo com a entrada, filtrando informações irrelevantes e enfatizando características informativas. O Vim13 e oVMamba 14 adaptam a arquitetura Mamba para tarefas de visão computacional. O U-Mamba15 emprega uma arquitetura híbrida CNN–SSM para explorar a aplicação dos SSMs na segmentação de imagens médicas, enquanto o Mamba-UNet16 adota uma arquitetura codificador-decodificador totalmente baseada em SSM para segmentação de imagens médicas. Esses métodos alcançam desempenho competitivo utilizando substancialmente menos parâmetros. No entanto, os métodos atuais baseados em SSM/Mamba extraem principalmente características de imagem usando patches simples e estratégias de varredura SS2D, que apresentam várias limitações para a segmentação de imagens médicas. Primeiro, as técnicas SS2D e baseadas em patches são projetadas principalmente para tarefas gerais de visão computacional. O Mamba17 Local e o Mamba 18 do Movimento sugeriram que a estratégia de varredura SS2D é insuficiente para todas as tarefas visuais porque diferentes estratégias capturam diferentes tipos de informações visuais. Segundo, a estratégia de varredura SS2D é relativamente simples, baseando-se apenas em direções horizontais e verticais de varredura. Consequentemente, pode não capturar adequadamente relações espaciais complexas e detalhes estruturais finos. A segmentação de imagens médicas requer modelagem simultânea tanto do contexto espacial global quanto das características anatômicas locais precisas. Além disso, os métodos atuais baseados em SSM/Mamba proporcionam uma fusão limitada de características entre o codificador e o decodificador. Arquiteturas como UNet++ e FATNet melhoram a precisão da segmentação por meio da fusão de características, destacando a importância de uma integração eficaz de características para segmentação de imagens médicas.
Para abordar essas limitações, este artigo propõe uma nova estrutura de segmentação de imagens médicas baseada em Mamba, denominada MVM-UNet. Como mostrado na Figura 1, o módulo Multi-View Four-Directional (MV4D) proposto serve como o componente central de extração de características do MVM-UNet e é projetado especificamente para segmentação de imagens médicas, integrando informações de quatro estratégias de varredura distintas. Cada estratégia de varredura extrai recursos complementares da imagem e representa uma visão diferente da imagem de entrada. A varredura emziguezague 19 alterna a direção de percurso no final de cada linha ou coluna, equilibrando assim informações espaciais locais e globais. Em contraste, os esquemas de varredura espiral e radial20 proporcionam cobertura abrangente ao se estender para fora a partir do centro ou para dentro a partir da periferia. A varredura hierárquica18 captura características locais e globais em múltiplas escalas. Para melhorar a robustez de cada estratégia de varredura, pares de varredura são fundidos antes de serem inseridos no Bloco S6. O módulo Scan-view Fusion Mamba (SFusion Mamba) integra posteriormente as características extraídas das quatro modalidades de varredura. Para utilizar eficazmente recursos de codificadores multiescala, este artigo propõe ainda um módulo de fusão Mamba multiescala (MFusion Mamba), que acumula e funde as saídas de cada estágio do codificador antes de passar as características fundidas para o decodificador. MVM-UNet foi avaliado nos conjuntos de dados ISIC 2017, ISIC 2018 e Synapse. Resultados experimentais demonstram que o MVM-UNet alcança desempenho competitivo em segmentação nos conjuntos de dados ISIC 2017, ISIC 2018 e Synapse.
Arquiteturas de segmentação representativa avançaram ainda mais a segmentação de imagens médicas. O U-Net também foi aplicado com sucesso em tarefas de análise de imagens biomédicas, como contagem celular, detecção emorfometria 21. Arquiteturas CNN aprimoradas pela atenção, como oCA-Net 22, melhoram a representação de características por meio de mecanismos abrangentes de atenção. Frameworks representativos de segmentação baseados em Transformers, incluindo TransUNet23, Pyramid MedicalTransformer 24, Swin U-Net25, TransAttUNet26 e TransCUNet27, demonstram ainda mais a eficácia da modelagem global de características baseada em atenção para segmentação de imagens médicas.
O design do MVM-UNet é motivado por duas limitações dos métodos de segmentação baseados em SSM/Mamba. Primeiro, muitos modelos atuais do Vision Mamba dependem de estratégias simples de varredura bidimensional, que podem ser insuficientes para imagens médicas contendo limites irregulares de lesões, pequenas regiões alvo e estruturas anatômicas multiescala. Segundo, arquiteturas convencionais codificador–decodificador em formato de U transferem principalmente características por meio de conexões de salto correspondentes, limitando o uso direto de informações do codificador multiestágio durante a decodificação. Portanto, o MVM-UNet introduz o MV4D para aprimorar a modelagem espacial multiview e o MFusion Mamba para agregar explicitamente as características do codificador multiestágio. Esse design tem como objetivo adaptar a modelagem de longo alcance baseada em Mamba aos requisitos específicos da segmentação de imagem médica.
Embora o MVM-UNet seja construído sobre o paradigma geral codificador–decodificador e a modelagem de sequências baseada em Mamba, sua novidade está em como esses componentes são adaptados e integrados para segmentação de imagens médicas. Em vez de simplesmente incorporar um bloco Mamba padrão em uma espinha dorsal de rede em formato de U, a estrutura proposta redesenha o processo de modelagem espacial por meio de múltiplos ramificações de pares de varredura orientados a tarefas, introduz o SFusion Mamba para integrar representações específicas de varredura, aprimora o MVV Block com caminhos residuais e de projeção, e insere MFusion Mamba entre o codificador e o decodificador para agregar características do codificador multiestágio antes da decodificação. Este design em nível arquitetônico visa abordar os limites irregulares, pequenas regiões-alvo e estruturas anatômicas multiescala comumente observadas em imagens médicas.
Este protocolo é mais adequado para tarefas de segmentação que exigem modelagem simultânea de informações contextuais de longo alcance, limites irregulares de objetos e estruturas anatômicas multiescala em imagens médicas bidimensionais. Comparado aos métodos de segmentação baseados em CNN, o design codificador–decodificador baseado em Mamba oferece um mecanismo eficaz de modelagem de contexto, mantendo um fluxo de trabalho em formato de U familiar para pesquisadores de segmentação de imagens médicas. Comparado aos métodos baseados em Transformer, o framework proposto evita o uso direto da autoatenção quadrática e é destinado a pesquisadores que buscam modelagem contextual global usando um mecanismo relativamente eficiente de modelagem de sequências. Assim, esse protocolo é adequado para segmentação de lesões de pele, segmentação de órgãos abdominais e tarefas médicas bidimensionais semelhantes de segmentação de imagens médicas, nas quais tanto a informação estrutural global quanto os detalhes locais dos limites são importantes.
Esse protocolo também possui limitações que devem ser consideradas antes do uso. Pode não ser necessário para tarefas de segmentação relativamente simples, nas quais uma CNN leve já oferece desempenho suficiente. Além disso, não é projetado diretamente para segmentação volumétrica tridimensional completa sem adaptação arquitetônica. Pesquisadores com dados anotados muito limitados, recursos limitados de unidades de processamento gráfico (GPU) ou necessidade de modelos clássicos altamente interpretáveis também devem considerar essas restrições antes de aplicar o protocolo. No geral, este método é destinado a pesquisadores que buscam reproduzir e avaliar uma estrutura de segmentação em forma de U baseada em Mamba, que equilibra modelagem de contexto de longo alcance, representação local de fronteira e fusão de características em múltiplos estágios.
As contribuições principais são as seguintes:
1. Este artigo apresenta uma nova estrutura de segmentação de imagens médicas baseada em Mamba, denominada MVM-UNet. Diferentemente de abordagens que incorporam diretamente blocos Mamba baseados em SS2D ou padrão, o MVM-UNet introduz o MV4D para modelar características de imagem médica a partir de quatro visões complementares de pares de varredura, incluindo varredura em ziguezague, hierárquica, espiral e radial.
2. Este artigo projeta o SFusion Mamba e o MVV Block para integrar representações específicas de varredura e aprimorar a transformação de características. O SFusion Mamba funde as características extraídas de diferentes ramificações de par de varredura, enquanto os ramos residual e de Projeção Up-Down dentro do Bloco MVV fornecem caminhos complementares de características que estabilizam e enriquecem representações de características.
3. Este artigo apresenta o MFusion Mamba como um módulo intermediário de fusão multiestágio entre o codificador e o decodificador. Diferentemente das conexões de salto convencionais, que transferem principalmente características correspondentes do estágio, o MFusion Mamba agrega explicitamente características do codificador multiestágio por meio da fusão grosseira a fina e fornece informações enriquecidas para decodificação.
4. Resultados experimentais extensos demonstram que o MVM-UNet proposto alcança desempenho de segmentação competitiva nos conjuntos de dados ISIC 2017 e ISIC 2018 e forte desempenho no conjunto de dados de segmentação multiorgânânico Synapse. Além disso, estudos ablativos de ablação validam a contribuição de cada componente dentro do MVM-UNet.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo utilizou apenas conjuntos de dados de imagens médicas publicamente disponíveis e desidentificados, incluindo ISIC 2017, ISIC 2018 e Synapse. Nenhum novo participante humano, sujeito animal ou prontuário médico privado identificável foi coletado neste estudo. O conjunto de dados ISIC 2017 utilizado neste estudo foi o conjunto de dados de segmentação de lesões cutâneas ISIC 2017 Challenge, obtido do repositório oficial de dados da International Skin Imaging Collaboration (https://challenge.isic-archive.com/data/#2017). A versão do conjunto de dados utilizada neste estudo corresponde à tarefa de segmentação de lesões ISIC 2017, incluindo as partições oficiais de treinamento, validação e teste. O conjunto de dados foi baixado em 15 de março de 2024. O conjunto de dados ISIC 2018 utilizado neste estudo foi o conjunto de dados de segmentação de limites de lesões da ISIC Challenge Task 1, obtido do repositório oficial de dados de desafios da International Imaging Imaging Collaboration (https://challenge.isic-archive.com/data/#2018). A versão do conjunto de dados utilizada neste estudo corresponde à Tarefa 1 ISIC 2018: Segmentação da Fronteira da Lesão. O conjunto de dados foi baixado em 8 de julho de 2024.
O conjunto de dados Synapse utilizado neste estudo foi o conjunto de dados de CT abdominal Multi-Atlas Labeling Beyond the Cranial Vault, obtido do repositório Synapse sob o identificador de acesso syn3193805 (https://www.synapse.org/Synapse:syn3193805). O conjunto de dados utilizado neste estudo corresponde ao conjunto de segmentação multiorgântica de 30 casos de tomografia computorizada abdominal comumente utilizado. O arquivo baixado foi Abdomen/RawData.zip, disponível sob a assinatura de acessão 3193805. Nenhum número de versão, rótulo de lançamento ou tag de lançamento datado separado foi fornecido pelo repositório no momento do download. Seguindo a divisão padrão adotada em estudos anteriores, 18 casos foram usados para treinamento e 12 casos para testes. A divisão dos dados seguiu a lista de casos usada pela TransUNet23. Especificamente, os casos de treinamento eram case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 e case0037, enquanto os casos de teste eram case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0003, case0001, case0004, case0025 e case0035. O conjunto de dados foi baixado em 9 de julho de 2024. Como este estudo utilizou apenas conjuntos de dados públicos e desidentificados e não envolveu a coleta de novos dados de sujeitos humanos ou informações privadas identificáveis, não foi necessária aprovação do conselho de revisão institucional para os experimentos computacionais descritos neste protocolo. Não foi obtida nenhuma determinação formal por escrito sobre isenção institucional. Se exigido pela política institucional local, os pesquisadores devem obter uma determinação de isenção institucional antes de realizar análises secundárias de conjuntos de dados públicos disponíveis. Não havia número de referência para isenção ética institucional ou documentação formal de isenção disponível para este estudo.
1. Preparação de conjuntos de dados
- Baixe o conjunto de dados de segmentação de lesões cutâneas ISIC 2017 do repositório oficial da International Skin Imaging Collaboration. Use as partições oficiais de treinamento, validação e teste. Verifique se o conjunto de dados contém 2.000 imagens de treinamento, 150 imagens de validação e 600 imagens de teste.
- Baixe o conjunto de dados de segmentação de lesões cutâneas ISIC 2018 do repositório oficial da International Skin Imaging Collaboration. Use as partições oficiais de treinamento, validação e teste. Verifique se o conjunto de dados de segmentação contém 2.594 imagens de treinamento, 100 imagens de validação e 1.000 imagens de teste.
- Baixe o conjunto de dados de segmentação multiórgão Synapse. Use a divisão padrão composta por 18 caixas (2.212 fatias axiais) para treinamento e 12 caixas (1.567 fatias axiais) para testes. Não introduza um conjunto de validação separado.
- Reserve os 12 casos de teste exclusivamente para avaliação final. Não use os casos de teste para treinamento de modelos, ajuste de hiperparâmetros ou seleção de modelos. A tarefa de segmentação inclui oito órgãos abdominais: aorta, vesícula biliar, baço, rim esquerdo, rim direito, fígado, pâncreas e estômago.
- Use a seguinte divisão do conjunto de dados Synapse. Os 18 casos de treinamento foram case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 e case0037. Os 12 casos testados foram o caso 0008, caso 0022, caso 0038, caso 0036, caso 0032, caso 0002, caso 0029, caso 0003, caso 0001, caso 0004, caso 0025 e caso 0035.
- Organize cada conjunto de dados em pastas separadas de imagem e máscara. Certifique-se de que cada imagem tenha uma máscara de segmentação correspondente com o mesmo identificador de caso.
- Converta cada máscara de lesão cutânea em um mapa binário de segmentação de primeiro plano e fundo. Mantenha os rótulos originais de órgão multiclasse para o conjunto de dados Synapse.
- Para os conjuntos de dados ISIC 2017 e ISIC 2018, atribua um valor de etiqueta 0 aos pixels de fundo e 1 aos pixels da lesão (em primeiro plano) após conversão binária de máscara. Pixels com valores originais de máscara maiores que 0 são tratados como primeiro plano e convertidos para 1, enquanto pixels com valores originais de máscara iguais a 0 são considerados como fundo e mantidos como 0. Para o conjunto de dados Synapse, mantenha os valores originais do rótulo inteiro, sendo 0 representando a classe de fundo e 1–8 representando as oito classes de órgão em primeiro plano.
- Redimensione as imagens e máscaras ISIC 2017 e ISIC 2018 para 256 × 256 pixels sem preservar a proporção de aspecto original. Não aplique recorte ou enchimento de gordura.
- Redimensione cada fatia do Synapse CT e o correspondente mapeamento de rótulos para 224 × 224 pixels. Use interpolação bilinear para imagens RGB, interpolação de spline de terceira ordem para fatias CT e interpolação de vizinhos mais próximos para máscaras de segmentação.
- Redimensione imagens em Python.
- Para os conjuntos de dados ISIC 2017 e ISIC 2018, use a transformada personalizada myResize implementada em utils.py, que chama torchvision.transforms.functional.resize para redimensionar tanto os tensores de imagem quanto de máscara para 256 × 256 pixels. Não especifique um modo de interpolação explícito ou um argumento de anti-aliasing nesta transformação.
- Para o conjunto de dados Synapse, use scipy.ndimage.zoom em conjuntos de dados/dataset.py. Redimensione fatias de imagem CT para 224 × 224 pixels usando interpolação spline de terceira ordem (ordem = 3), e redimensione mapas de rótulos usando interpolação de vizinhos mais próximos (ordem = 0). Não aplique uma operação de anti-aliasing separada ou uma configuração anti_aliasing=Verdadeiro durante o redimensionamento.
- Normalize cada imagem ISIC RGB antes da conversão de tensor usando a média e o desvio padrão (SD) específicos do conjunto de dados usando a Equação 1 da seguinte forma:
 (1)
Depois, redimensione a imagem normalizada para a faixa de 0–255 usando normalização min–max.- Use μ = 159,922 e σ = 28,871 para o conjunto de treinamento ISIC 2017 e μ = 148,429 e σ = 25,748 para os conjuntos de validação e teste ISIC 2017. Use μ = 157,561 e σ = 26,706 para o conjunto de treinamento ISIC 2018 e μ = 149,034 e σ = 32,022 para os conjuntos de validação e teste ISIC 2018.
- Converta cada imagem normalizada em um tensor de forma 3 × 256 × 256. Converta cada máscara binária em um tensor de forma 1 × 256 × 256.
- Realize a normalização min–max independentemente para cada imagem após a normalização de média e desvio padrão específica do conjunto de dados. Especificamente, subtraia a média específica do conjunto de dados de cada imagem e divida pelo desvio padrão correspondente.
- Calcule os valores mínimos e máximos de intensidade a partir da imagem normalizada e reescale a imagem para a faixa 0–255 usando esses valores mínimos e máximos por imagem. Não use valores mínimos e máximos de todo o conjunto de dados para essa etapa de reescalonamento mínimo–máximo.
- Prepare cada fatia de Synapse CT como uma imagem bidimensional em tons de cinza. Converta cada fatia CT em float32 e adicione uma dimensão de canal singleton para obter um tensor de entrada com forma 1 × 224 × 224.
- Mantenha cada mapa de rótulos Synapse como uma máscara inteira de canal único com formas 224 × 224. Não aplique normalização adicional de média SD em nível de conjunto de dados no carregador de dados.
- Use os arquivos Synapse pré-processados fornecidos no formato .npz para fatias de treinamento e no formato .npy.h5 para volumes de teste. Carregue os arrays de imagem e etiquetas diretamente de cada arquivo .npz durante o treinamento e diretamente de cada arquivo .npy.h5 durante os testes. Não aplique clipping de intensidade adicional, janelas CT, normalização em nível de conjunto de dados ou reamostragem de volume bruto no carregador de dados liberado.
- Durante o treinamento do modelo, converta cada fatia bidimensional carregada para float32, redimensione-a para o tamanho espacial alvo usando scipy.ndimage.zoom com ordem = 3 para fatias de imagem e ordem = 0 para mapas de etiquetas, e então converta os arrays redimensionados em tensores com dimensão de canal único.
- Aplique aumento de dados apenas ao conjunto de treinamento. Para ISIC 2017 e ISIC 2018, aplique inversão horizontal aleatória (p = 0,5), inversão vertical aleatória (p = 0,5) e rotação aleatória (p = 0,5) com um ângulo amostrado de 0° a 360°.
- Aplique a mesma transformação geométrica a cada par imagem-máscara. Durante a validação e os testes, aplique apenas redimensionamento, normalização e conversão de tensorial.
- Para o conjunto de dados Synapse, aplique rotação aleatória e inversão aleatória durante o treinamento. Gire aleatoriamente cada par imagem-etiqueta por k × 90°, onde k ∈ {0,1,2,3}, inverta aleatoriamente o par imagem-etiqueta ao longo de um eixo espacial, ou gire aleatoriamente o par imagem-etiqueta em um ângulo amostrado de −20° a 20°.
- Não aplique aumento estocástico durante os testes.
- Aplique aumento de dados ao conjunto de dados Synapse usando os ramos mutuamente exclusivos implementados na transformação RandomGenerator.
- Para cada amostra de treinamento, primeiro avalie a condição random.random() > 0,5. Se essa condição for satisfeita, aplice-se random_rot_flip, consistindo em uma rotação aleatória de 90° (k = 0, 1, 2 ou 3) seguida de uma inversão aleatória ao longo de um eixo espacial.
- Se o primeiro ramo não for selecionado, avalie uma segunda condição, random.random() > 0,5. Se essa condição for satisfeita, aplice-se random_rotate usando um ângulo de rotação selecionado aleatoriamente entre −20° e 20°. Se nenhuma das condições for satisfeita, não aplique aumento estocástico à amostra.
- Aplique a mesma transformação tanto à imagem de entrada quanto ao mapa de etiquetas correspondente.
- Defina a semente aleatória antes do carregamento do conjunto de dados, pré-processamento e treinamento. Use sementes aleatórias 1, 52 e 100 para os experimentos principais de comparação e use semente 100 para estudos de ablação, a menos que especificado de outra forma.
- Inicialize os geradores aleatórios Python, NumPy, CPU PyTorch, CUDA PyTorch e cuDNN antes de construir o carregador de dados. Mantenha as partições do conjunto de dados, procedimentos de pré-processamento, configurações de aumento, parâmetros de normalização, estratégia de redimensionamento e pré-processamento de avaliação inalterados em todas as execuções seed.
- Defina num_workers = 0 tanto para os experimentos ISIC quanto Synapse para realizar o carregamento de dados no processo principal. Antes de construir o conjunto de dados e criar o DataLoader, inicialize a semente aleatória global usando a função set_seed para gerar os geradores de números aleatórios em Python, NumPy, CPU PyTorch, CUDA e cuDNN. Não defina um gerador aleatório específico de worker_init_fn ou DataLoader separado, pois esses não são usados na implementação lançada.
2. Construção da arquitetura MVM-UNet
- Construa a proposta Multi-view Vision Mamba UNet (MVM-UNet) usando uma arquitetura codificador-decodificador em formato de U.
- Defina a dimensão da imagem de entrada para H × W × 3. Passe a imagem de entrada pela camada de embedding do patch.
- Implemente a camada de embedding de patch usando uma convolução 2D com tamanho de kernel de 4 × 4, passo de 4, três canais de entrada e 96 canais de saída.
- Transforme o mapa de características de entrada para uma resolução espacial de H/4 × W/4 com C = 96 canais de saída.
- Construa quatro estágios codificadores e quatro estágios decodificadores. Reduza a resolução espacial pela metade e dobre a dimensão do canal após cada estágio do codificador.
- Use uma configuração codificador-decodificador simétrica. Defina o número de blocos MVV tanto no codificador quanto no decodificador para {2, 2, 2, 2}.
- Coloque dois blocos MVV em cada estágio do codificador e dois blocos MVV em cada estágio do decodificador.
- Insira um bloco MVV em cada estágio codificador e decodificador. Use o módulo MV4D como módulo central de extração de características dentro de cada bloco MVV.
- Insira o módulo MFusion Mamba entre o codificador e o decodificador. Use este módulo para fundir recursos do codificador multiestágio antes de decodificar.
- Configure o fluxo de trabalho geral MVM-UNet. Use o MV4D para extração de características em todo o codificador.
- Mantenha as saídas do codificador como conexões de pulo. Passe as saídas do codificador para os estágios correspondentes do decodificador.
- Passe os recursos do codificador para o MFusion Mamba antes de decodificar. Faça progressivamente upsampling da representação fundida através do decodificador e gere o mapa final de segmentação usando a cabeça de segmentação.
- Passe a imagem de entrada I ∈ RB×H×W×3 pela camada de embedding de patch para obter
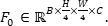 Aqui, C = 96.
- Gerar mapas de características do codificador: E1 ∈ RB×H/4×W/4×C, E 2 ∈R B×H/8×W/8×2C, E3 ∈ RB×H/16×W/16×4C e E 4 ∈ RB×H/32×W/32×8C. Use blocos MVV contendo MV4D em cada estágio do codificador.
- Preserve todos os recursos do codificador para a conexão de pular correspondente. Passe todas as funcionalidades do codificador para MFusion Mamba para fusão de características multiestágio.
- Alinhe as características do codificador a um espaço comum de características antes da fusão grosseira e fina dentro do MFusion Mamba. Passe a representação fundida para o decodificador.
- Aumente progressivamente a representação do decodificador. Funda os recursos do decodificador com E3 em H/16 × W/16, E2 em H/8 × W/8 e E1 em H/4 × W/4.
- Faça upsampling do recurso final do decodificador para a resolução original da imagem. Gerar o mapa
 de previsão ∈ RB×H×W×K. Aqui, K = 1 para segmentação binária da lesão e K = 8 para segmentação multiorgântica sinapse.
- Consulte a Figura 2 para a arquitetura geral da rede e a Tabela Suplementar 1 para a especificação completa camada por camada, incluindo as operações, parâmetros principais e dimensões das características de saída para cada estágio
- Camadas de transição codificador–decodificador
- Amostre recursos do codificador usando camadas de transição com fusão de patches. Para cada transição, amostre quatro grupos de características espacialmente intercaladas de uma vizinhança 2 × 2, concatene-os ao longo da dimensão do canal, aplique a Normalização de Camada (LayerNorm) e projete a característica resultante de dimensão 4C em canais 2C usando uma camada linear sem viés. Essa operação reduz a resolução espacial em um fator de 2 enquanto dobra a dimensão do canal.
- Upsample características do decodificador usando camadas de transição que expandem patches. Aplique uma projeção linear sem viés, reorganize as características expandidas espacialmente para aumentar a resolução por um fator de 2 e aplique o LayerNorm após a expansão espacial. Repita essa operação para reconstruir progressivamente os mapas de características de H/32 × W/32 para H/16 × W/16, H/8 × W/8 e H/4 × W/4.
- Alinhe as características do codificador dentro do módulo MFusion Mamba redimensionando-as para a resolução espacial alvo usando interpolação bilinear (align_corners = Falso) e então aplicando uma projeção de canal linear aprendível antes da fusão das características.
- Cabeça de segmentação
- Faça upsampling do mapa final de características do decodificador de H/4 × W/4 até a resolução original da imagem (H × W) usando a camada final de expansão de patch. Aplique projeção linear, realize rearranjos espaciais com fator de expansão 4 e aplique LayerNorm.
- Projete o mapa de características reconstruído para K canais de saída usando uma convolução 1 × 1 após converter o tensor para o formato channel-first.
- Gerar a previsão final durante a avaliação aplicando uma função de ativação sigmoide para segmentação binária de lesão ou uma ativação softmax seguida por argmax para segmentação multiorgânica sinapse. Não aplique uma função de ativação dentro da própria cabeça de segmentação.
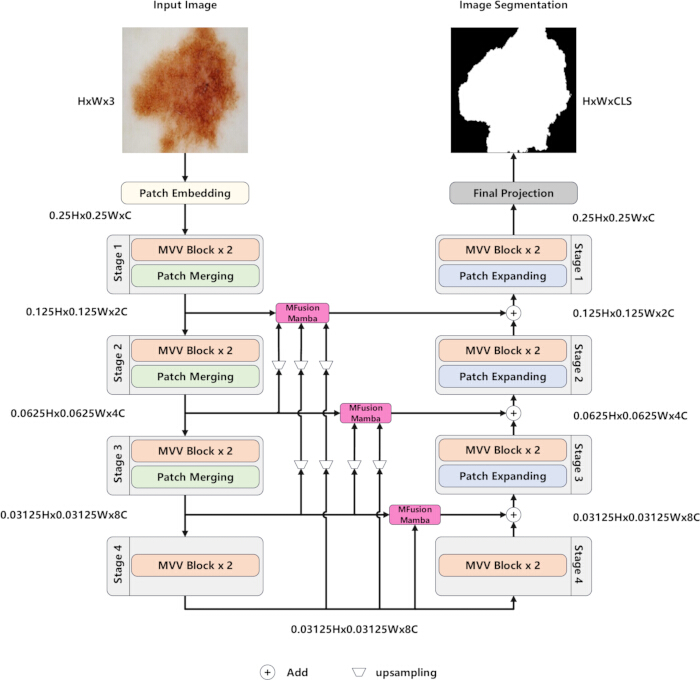
Figura 2. Arquitetura geral do Multi-View Mamba U-Net (MVM-UNet). Visão geral da arquitetura proposta Multi-View Mamba U-Net (MVM-UNet). A imagem de entrada é convertida em embeddings de patch e processada por quatro estágios de codificação compostos por blocos Multi-View Vision (MVV) separados por operações de fusão de patches. As características do codificador são agregadas pelo Multi-stage Fusion Mamba (MFusion Mamba) e propagadas para o decodificador por meio de conexões de salto. O decodificador restaura progressivamente a resolução espacial usando operações de expansão de patches e gera o mapa final de segmentação através da camada de projeção. Por favor, clique aqui para ver uma versão ampliada desta figura.
3. Construção do módulo MV4D
- Use o módulo MV4D como a unidade básica de extração de recursos no Bloco MVV. Alimente os patches de recursos de entrada em quatro ramificações de pares de varredura. Consulte o Algoritmo 1, Arquivo Suplementar 1 para o pseudocódigo completo de achatamento espacial, construção de índice de pares de varredura, coleta de sequências, processamento S6/Mamba, reordenação espacial inversa, fusão de pares de varredura, fusão SFusion Mamba, projeção e remodelação de saída.
- Use os procedimentos exatos de geração de índices de varredura em ziguezague, hierárquicos, espiral e radiais implementados em modelos/mvmunet/core.py. Para cada estratégia de varredura, use a ordem de varredura direta e sua ordem reversa como um par de varredura bidirecional.
- Construa o par de varredura em ziguezague. Percorra as características da imagem em direções alternadas no final de cada linha ou coluna. Use esse padrão de varredura para equilibrar informações espaciais locais e globais.
- Construa o par de varredura hierárquica. Capture características em múltiplas escalas espaciais. Use esse padrão de varredura para fortalecer a extração tanto de representações locais quanto globais.
- Construa o par de varredura em espiral. Escaneie as características da imagem do centro em direção à fronteira ou da fronteira em direção ao centro. Use esse padrão de varredura para aprimorar a extração de informações globais de contorno.
- Construa o par de varredura radial. Escaneie características de imagem em múltiplas direções radiais. Use esse padrão de varredura para aprimorar a extração de detalhes locais de limites e bordas.
- Junte cada par de varredura antes de alimentar a sequência fundida no bloco S6. Use o design pareado para melhorar a robustez de cada estratégia de varredura, preservando a eficiência computacional.
- Alimente a sequência de saída de cada ramificação de par de varrimento em um bloco S6. Obtenha quatro representações de características correspondentes às vistas de varredura ziguezague, hierárquica, espiral e radial.
- Funda as quatro representações de características extraídas usando o módulo SFusion Mamba. Use duas vias de fusão paralelas. No primeiro caminho, integre as quatro características por meio de adição elemental a elemento.
- No segundo caminho SFusion Mamba, concatene as quatro características. Processe a representação concatenada usando Conv1d e Mamba. Reduza a dimensão do canal usando uma camada de projeção para igualar a dimensão de saída do bloco S6.
- Configure o bloco S6/Mamba usando a dimensão de característica C como dimensão do modelo. Use uma camada de projeção para mapear cada característica de par de varredura mesclada de volta à dimensão do canal C antes da fusão.
- No SFusion Mamba, realize adição elemento a elemento no primeiro caminho. Concatene as quatro características de varredura no segundo caminho antes de Conv1d, Mamba e projeção linear. Use as operações de normalização, projeção linear, convolução separável em profundidade e ativação em torno do MV4D conforme descrito no Passo 4.
- Soma-se as saídas das duas vias de fusão para obter a saída final do módulo MV4D.
- Construa quatro ramificações complementares de par de varredura em vez de usar apenas direções de varredura horizontais e verticais. Use varredura em ziguezague para enfatizar a travessia espacial contínua, varredura hierárquica para fortalecer a representação multiescala, varredura em espiral para capturar informações de contorno do centro ao limite e varredura radial para aprimorar a extração de detalhes locais orientados a fronteiras.
- Processe cada ramificação de par de varredura de forma independente. Funda as funcionalidades resultantes usando SFusion Mamba. Mapear cada sequência processada de volta à sua ordem espacial original antes da fusão.
- Dado um mapa de características de entrada X ∈ RB×H×W×C, achate-o em Xseq ∈ RB×L×C, onde L = H × W.
- Reordene a sequência achatada de acordo com os índices de varredura para cada ramo de par de varredura. Processe cada sequência reordenada usando o bloco S6. Restaure a sequência processada à ordem espacial original.
- Fuda as quatro características de varredura através do caminho aditivo e do caminho SFusion Mamba para obter a saída final do MV4D. Consulte a Figura 3 para a arquitetura MV4D e o Algoritmo 1, Arquivo Suplementar 1 para o fluxo de trabalho completo de implementação em nível de tensor.
- Use toda a implementação de software em models/mvmunet/core.py. Este arquivo contém os geradores de índices de varredura, PairwiseScanMamba, SequenceS6, SFusion Mamba e o módulo de envolvimento MV4D.
- Gerar índices de varredura multiview
- Gerar os índices de varredura seguindo a implementação lançada em models/mvmunet/core.py. Para um mapa de características de entrada de tamanho espacial H × W, achate cada localização de pixel em um índice unidimensional usando: índice = r × W + c, onde r e c denotam as coordenadas da linha e coluna, respectivamente.
- Gerar a varredura em ziguezague percorrendo diagonais da imagem com r + c constante. Colete os índices de pixel válidos para cada diagonal e alterne a direção de deslocamento invertendo a ordem de cada diagonal par.
- Gerar a varredura hierárquica dividindo recursivamente a imagem em quatro quadrantes. Visite os quadrantes superior esquerdo, superior direito, inferior esquerdo e inferior direito sequencialmente até que a altura ou largura da sub-região não seja maior que 2 pixels, e então percorra os pixels restantes em ordem de linha maior.
- Gere a varredura em espiral percorrendo a fronteira externa da imagem da esquerda para a direita ao longo da linha superior, descendo pela coluna da direita, da direita para a esquerda pela linha inferior e subindo pela coluna esquerda, enquanto encolhe progressivamente a fronteira em direção ao centro da imagem.
- Gerar a varredura radial ordenando cada pixel de acordo com sua distância quadrada do centro da imagem e depois de acordo com seu ângulo polar calculado usando a função atan2.
- Gerar a varredura reversa para cada estratégia de varredura invertendo a ordem correspondente da varredura frontal. Combine as sequências de varredura direta e reversa para formar um par de varredura para cada estratégia de varredura antes de passar os pares de varredura para o módulo MV4D.
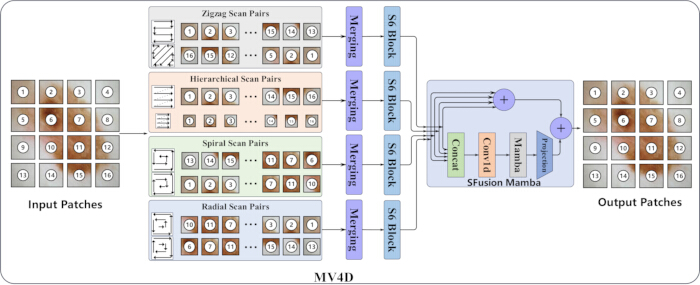
Figura 3. Arquitetura do módulo Multi-View 4-Directional (MV4D). Estrutura do módulo de extração de características Multi-View 4-Directional (MV4D). Os patches de entrada são processados por meio de quatro ramificações complementares de varredura-par, incluindo varredura ziguezague, hierárquica, espiral e radial. As características extraídas dos quatro ramos são fundidas, processadas usando blocos de espaço de estados e integradas pelo Spatial Fusion Mamba (SFusion Mamba) para gerar a representação das características de saída. Por favor, clique aqui para ver uma versão ampliada desta figura.
4. Construção do Bloco MVV
- Construa o Bloco MVV usando um ramo principal e dois ramos auxiliares. Use a estrutura geral mostrada na Figura 4.
- Aplique a normalização de camada ao recurso de entrada no ramo principal. Alimente a característica normalizada em uma camada linear. Passe a característica transformada para a convolução separável em profundidade.
- Processe a característica transformada usando a convolução separável em profundidade. Aplique a função de ativação GELU. Alimente o recurso ativado no módulo MV4D.
- Construa o primeiro ramo auxiliar como uma conexão residual de identidade. Conecte o recurso de entrada diretamente à saída final. Use esse ramo para preservar a representação original e estabilizar o treinamento.
- Construa o segundo ramo auxiliar como um ramo de projeção para baixo e para cima. Comprima a característica de entrada usando uma camada de projeção inferior. Restaure a dimensão das características usando uma camada de projeção para cima.
- Junte as saídas do ramo principal e dos dois ramos auxiliares. Obtenha a saída final do Bloco MVV. Consulte a Figura 4 para a arquitetura completa.
- Defina a dimensão oculta do ramo principal igual à dimensão do canal de entrada Cs. Aplique LayerNorm(Cs) antes da projeção linear principal e use uma camada linear com dimensões Cs→C s. Use uma convolução separável em profundidade consistindo em uma convolução 3×3 em profundidade com preenchimento 1, grupos = Cs e sem viés, seguida por uma convolução 1×1 ponto a ponto sem viés.
- Aplique a função de ativação GELU após a convolução separável em profundidade. Alimente a característica ativada para o MV4D e aplique uma projeção linear de saída com dimensões C s→Cs. Configure o desvio de projeção descendente-subida usando LayerNorm(Cs), uma razão de projeção de 4, uma projeção descendenteC s→C s/4, ativação GELU e uma projeção Cs/4→Cs.
- Combine o branch identidade, o branch de projeção para baixo para cima e o branch principal processado por drop-path usando adição elemental para obter a saída final do Bloco MVV.
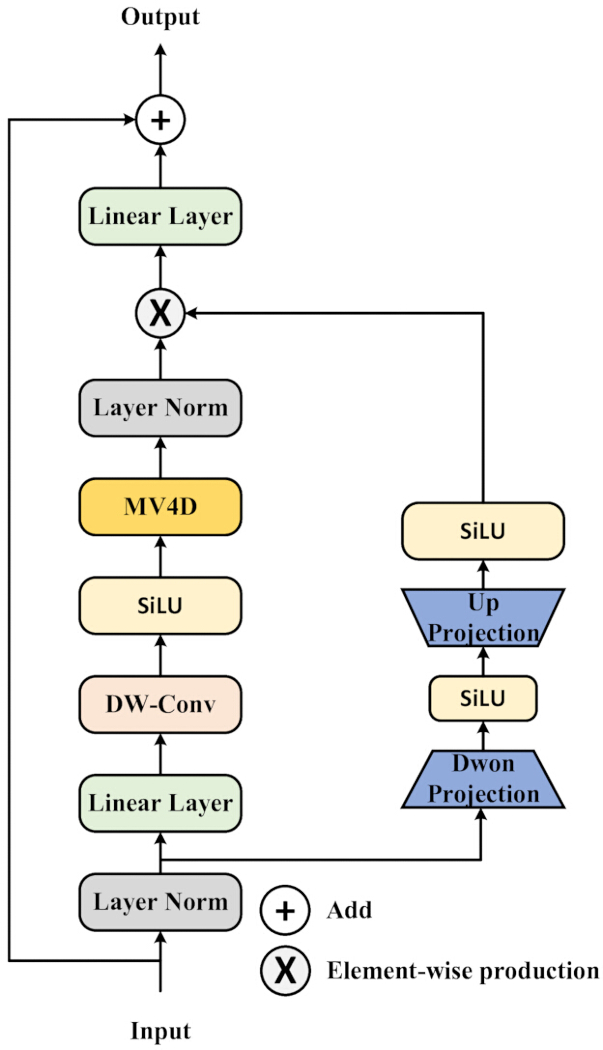
Figura 4. Arquitetura do bloco Multi-View Vision (MVV). Estrutura do Bloco de Visão Multi-Vista (MVV). O bloco consiste em um ramo principal de extração de características contendo o módulo Multi-View 4-Directional (MV4D) juntamente com camadas de convolução profunda, normalização e projeção linear. Um ramo auxiliar de projeção de cima para baixo fornece modulação de características com gate por meio de multiplicação elemento a elemento antes da adição residual para gerar a representação da característica de saída. Por favor, clique aqui para ver uma versão ampliada desta figura.
5. Construção da MFusion Mamba
- Colete os mapas de características de todos os estágios do codificador. Alinhe as características do codificador a um espaço de representação unificado, redimensionando-as ou projetando-as quando necessário. Consulte o Algoritmo 2, Arquivo Suplementar 1 para o fluxo de trabalho completo de implementação em nível de tensor.
- Redimensione as características do codificador para a resolução espacial alvo quando necessário. Projetar recursos com diferentes dimensões de canal na mesma dimensão de canal. Alinhe todas as características do codificador antes da fusão multiestágio.
- Alimente as características do codificador alinhado no componente Fusão Grosseira. Realize fusão grosseira usando o produto de Hadamard. Gerar a representação fundida grosseira.
- Alimente a representação fundida grosseira no componente de Fusão Fina. Construa duas vias paralelas de fusão fina. Processe ambos os caminhos de forma independente.
- Processe o primeiro caminho de Fusão Fina usando uma camada linear. Processe a segunda via de Fusão Fina usando projeção para cima, Conv1d, Mamba e projeção para baixo. Restaure a dimensão da característica após a projeção descendente.
- Junte as saídas das duas vias de Fusão Fina usando o produto de Hadamard. Aplique a camada linear final. Obtenha a saída MFusion Mamba.
- Alimente a saída MFusion Mamba para o decodificador. Decode a representação multiestágio fundida junto com as características de salto codificador-decodificador. Gerar o mapa final de segmentação.
- Alinhe as características do codificador de diferentes estágios em um espaço unificado de características antes da fusão grosseira. Processe as representações de características alinhadas usando os estágios de fusão grosseira e fina. Consulte a Figura 5 para a arquitetura MFusion Mamba e o Algoritmo Suplementar 2 para o fluxo de trabalho completo de implementação em nível de tensor.
- Use os parâmetros de implementação do MFusion Mamba conforme segue. Para cada característica do codificador Ei, projete a dimensão do canal de Ci para C t. Redimensione as características projetadas para o tamanho espacial alvo usando interpolação bilinear com align_corners=Falso quando necessário.
- Aplique o produto de Hadamard para realizar a Fusão Grosseira através das características alinhadas do codificador. Configure o primeiro caminho de Fusão Fina usando uma camada linear com dimensões Ct → Ct. Configure o segundo caminho de Fusão Fina usando uma projeção ascendente Ct → 2Ct, Conv1d, um bloco Mamba/S6 com dimensão de modelo 2Ct, uma direção de varredura, dimensão de estado 16 e uma projeção descendente de 2Ct → Ct.
- Funda as saídas das vias de Fusão Fina usando o produto de Hadamard. Aplique uma projeção linear final com dimensões Ct a Ct. Alimente a representação multiestágio fundida no decodificador.
- Recursos do codificador multiestágio Fuse usando MFusion Mamba
- Colete os recursos do codificador dos quatro estágios do codificador (E1, E2, E3 e E4) e use-os como entrada para o módulo MFusion Mamba. Não selecione apenas o recurso correspondente do codificador de estágio para fusão do decodificador.
- Alinhe todas as características do codificador à resolução espacial necessária para o estágio atual do decodificador. Redimensione as características do codificador para a resolução alvo e projete-as para a dimensão do canal exigida antes da fusão das características.
- Repita o procedimento de alinhamento de características para cada estágio do decodificador. Quando o decodificador opera em H/16 × W/16, H/8 × W/8 e H/4 × W/4, redimensione e projete E1, E2, E3 e E4 para o espaço de características alvo correspondente.
- Funda as características alinhadas do codificador multiestágio usando as operações de Fusão Grosseira e Fusão Fina do módulo MFusion Mamba, e combine a representação fundida com as características do decodificador na escala correspondente.
- Realize as operações de projeção de características, redimensionamento e fusão de acordo com a implementação lançada em models/mvmunet/core.py.
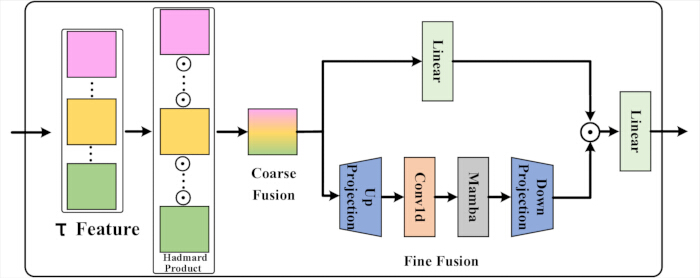
Figura 5. Arquitetura do módulo Multi-stage Fusion Mamba (MFusion Mamba). Estrutura do módulo Multi-stage Fusion Mamba (MFusion Mamba). As características do codificador multiescala são inicialmente combinadas por fusão grosseira e posteriormente refinadas através do módulo Fine Fusion, composto por projeção linear, convolução unidimensional (Conv1d), um bloco Mamba e camadas de projeção de características antes da geração da representação de características fundidas usada pelo decodificador. Por favor, clique aqui para ver uma versão ampliada desta figura.
6. Treinamento modelo
- Treine o MVM-UNet no Ubuntu 22.04.1 com kernel Linux versão 6.8.0. Use uma estação de trabalho equipada com um processador Intel Core i9-13900K de 13ª geração e uma GPU NVIDIA A800. Use a mesma configuração de hardware durante todo o treinamento e avaliação.
- Implemente e treine o modelo usando o PyTorch 2.0.1 com CUDA 11.8. Instale todas as dependências de software necessárias antes do treinamento.
- Use o otimizador AdamW com taxa inicial de aprendizado de 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸ e um decaimento em peso de 0,01. Defina o tamanho do lote para 32, a menos que especificado o contrário.
- Treine cada modelo por 300 épocas. Use um cronograma de taxa de aprendizagem por recozimento cosseno com ηmin = 1 × 10⁻⁵. Defina o tamanho da imagem de entrada para 256 × 256 para ISIC 2017 e ISIC 2018 e para 224 × 224 para Synapse.
- Use três sementes aleatórias independentes (1, 52 e 100) para os experimentos principais de comparação. Repita todo o processo de treinamento e avaliação para cada semente. Reporte os resultados quantitativos finais como média ± SD nas três execuções.
- Use uma semente aleatória fixa de 100 para todos os estudos de ablação, a menos que seja especificado o contrário. Mantenha as partições do conjunto de dados, estratégia de pré-processamento, arquitetura de rede, otimizador, taxa de aprendizado, tamanho do lote e número de épocas de treinamento inalteradas em todos os experimentos de ablação.
- Use a perda BCE-Dice para segmentação binária de lesões no ISIC 2017 e ISIC 2018. Defina os pesos de perda de BCE e Dice em 1.0. Use a perda CE-Dice para Synapse e defina tanto o peso de entropia cruzada quanto o de perda de dados em 1.0.
- Redimensione, normalize e aumente as imagens de treinamento ISIC 2017 e ISIC 2018 usando o procedimento de pré-processamento descrito no Passo 1. Aplique redimensionamento, rotação aleatória e inversão aleatória às imagens de treinamento Synapse, conforme descrito no Passo 1. Use configurações idênticas de pré-processamento em todas as execuções de treinamento.
- Selecione os checkpoints do modelo de acordo com o protocolo de validação específico do conjunto de dados. Salve o checkpoint com o melhor desempenho de validação para ISIC 2017 e ISIC 2018, e realize validação a cada 30 épocas. Treine o Synapse por 300 épocas sem um conjunto de validação e use o ponto final de verificação de treinamento para testes.
- Use o conjunto oficial de validação apenas para seleção de modelos no ISIC 2017 e ISIC 2018. Não use o conjunto de testes Synapse para treinamento, ajuste de hiperparâmetros ou seleção de checkpoint. Reserve todos os dados de testes exclusivamente para avaliação final.
- Use os seguintes parâmetros de treinamento para reprodutibilidade. Defina o tamanho do lote para 32 para todos os conjuntos de dados. Use o AdamW com uma taxa inicial de aprendizado de 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸, e uma redução de peso de 1 × 10⁻².
- Configure o escalonador de taxa de aprendizado de recozimento cosseno com Tmax = 50 e ηmin = 1×10⁻⁵ para ISIC 2017 e ISIC 2018. Configure o agendador com Tmax = 100 e ηmin = 1×10⁻⁵ para o Synapse. Mantenha a configuração do agendador inalterada para todos os experimentos repetidos.
- Treine todos os modelos usando aritmética FP32 de precisão total. Desative o treinamento automático de precisão mista. Não aplique clipping de gradiente durante a otimização.
- Mantenha as configurações de precisão, a estratégia de atualização de gradiente, a configuração do otimizador, o cronograma de taxa de aprendizado e o protocolo de semente aleatória inalterados em todos os experimentos de comparação, estudos de ablação e execuções de reprodutibilidade.
- Selecione o melhor checkpoint de modelo
- Avalie o modelo no conjunto de validação após cada época de treinamento para os conjuntos de dados ISIC 2017 e ISIC 2018.
- Calcule a perda de dados de Binary Cross-Entropia (BCE) para cada lote de validação e calcule a perda média de validação em todo o conjunto de validação.
- Salve o modelo atual como o melhor ponto de verificação quando a perda média de validação for menor do que a perda mínima de validação previamente registrada.
- Registre a interseção média sobre União (mIoU), o Coeficiente de Similaridade de Dados (DSC), a precisão (Acc), a especificidade (Spe) e a sensibilidade (Sen) durante a validação apenas para monitoramento de desempenho. Não use essas métricas como critério de seleção de checkpoint.
7. Avaliação do modelo
- Avalie o modelo treinado usando o conjunto oficial de testes para cada conjunto de dados. Use o conjunto de testes apenas para a avaliação final de desempenho.
- Para ISIC 2017 e ISIC 2018, calcule o mIoU, DSC, Acc, Sen e Spe. Use verdadeiros positivos (TP) em nível de pixel, falsos positivos (FP), verdadeiros negativos (TN) e falsos negativos (FN) para todos os cálculos.
- Aplique uma função de ativação sigmoide à saída do modelo para ISIC 2017 e ISIC 2018. Converta o mapa de probabilidade em uma máscara de segmentação binária usando um limiar de 0,5. Calcule as métricas de avaliação usando as Equações 2–6:
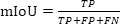 (2)
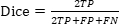 (3)
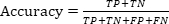 (4)
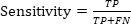 (5)
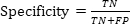 (6)
- Para o Synapse, aplique a função de ativação softmax à saída do modelo. Atribua cada pixel ou voxel à classe com maior probabilidade usando a operação argmax. Calcule o DSC e a distância de Hausdorff do percentil 95 (HD95) para cada órgão em primeiro plano e relate os valores médios em todos os casos de teste.
- Compare o MVM-UNet com métodos representativos de segmentação baseados em CNN, Transformer e modelos de espaço de estados (SSM). Use partições de conjunto de dados idênticas, procedimentos de pré-processamento, resoluções de entrada e métricas de avaliação para todos os métodos.
- Use as partições oficiais de treinamento, validação e teste para ISIC 2017 e ISIC 2018. Use a divisão padrão de 18 casos de treinamento e 12 casos de teste para o Synapse. Defina a resolução de entrada para os conjuntos de dados ISIC e para o Synapse.
- Reproduza métodos de referência usando suas implementações oficiais sempre que disponíveis. Relate os resultados como média ± SD em repetidas corridas. Mantenha os valores reportados pela literatura conforme publicados originalmente e distinga-os nas notas correspondentes da tabela.
- Realize estudos de ablação usando a semente aleatória fixa de 100, salvo especificação em contrário. Mantenha as partições do conjunto de dados, procedimento de pré-processamento, resolução de entrada, otimizador, cronograma de taxa de aprendizado, tamanho do lote, número de épocas, função de perda e métricas de avaliação inalteradas em todos os experimentos de ablação.
- Avalie as contribuições do MV4D, SFusion Mamba, o ramo de Projeção Up-Down no MVV Block, MFusion Mamba, tamanho da imagem de entrada, valor dropout e configuração da camada codificador-decodificador. Modifique apenas o componente ou parâmetro alvo em cada experimento de ablação.
- Realize o teste de rank por sinal Wilcoxon usando resultados pareados por imagem para ISIC 2017 e ISIC 2018 e resultados pareados por caso para Synapse. Considere um valor p menor que 0,05 para indicar significância estatística.
- Avalie a eficiência computacional usando o mesmo ambiente de hardware e resolução de entrada para todos os métodos. Meça o tempo de treinamento por época, tempo de inferência por imagem, uso máximo de memória da GPU durante o treinamento, número de parâmetros do modelo e operações de ponto flutuante (FLOPs). Calcule os FLOPs usando um único passe para frente.
- Selecione exemplos qualitativos representativos apenas do conjunto de testes após concluir a avaliação do modelo. Compare a imagem original, a máscara de verdade no terreno e a máscara prevista usando casos de teste idênticos em todos os métodos. Selecione exemplos representativos que incluam alvos pequenos, limites irregulares, limites ambíguos e estruturas multiorgânicas representativas.
- Calcular métricas de avaliação e realizar análises estatísticas
- Calcule as métricas de segmentação para os conjuntos de dados ISIC 2017 e ISIC 2018 em Python usando NumPy e sklearn.metrics.confusion_matrix. Limite o mapa de probabilidade previsto em 0,5, obtenha os TP, FP, TN e FN em nível de pixel, e calcule o mIoU, DSC, Acc, Sen e Spe a partir desses valores.
- Calcule o DSC e o HD95 para o conjunto de dados Synapse usando medpy.metric.binary.dc e medpy.metric.binary.hd95, respectivamente. Aplique softmax seguido de argmax à saída do modelo antes de calcular as métricas de avaliação.
- Calcule o número de FLOPs e parâmetros treináveis usando thop.profile com uma única passagem para frente.
- Realize o teste de rank por sinal de Wilcoxon em Python usando scipy.stats.wilcoxon. Use valores de métrica pareados por imagem para os conjuntos de dados ISIC 2017 e ISIC 2018 e valores pareados de métricas por caso para o conjunto de dados Synapse.
8. Definição da função de perda
- Use a perda padrão de Entropia Cruzada (CE) para segmentação multiclasse e a perda padrão BCE para segmentação binária. Use a formulação padrão de perda de dados para segmentação. As equações 7–11 definem as funções de perda usadas neste protocolo.
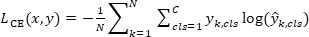 (7)
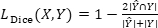 (8)
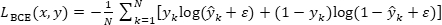 (9)
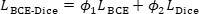 (10)
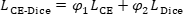 (11)
- Defina os pesos de perda BCE e Dice para 1,0 para ISIC 2017 e ISIC 2018, de modo que
 1 = 1,0 e 2 = 1,0. Defina os pesos de perda de CE e Dice para 1,0 para Synapse, φ1 = 1,0 e φ2 = 1,0.
- Implemente as funções de perda em utils.py. Use nn. BCELoss para o termo BCE e nn. CrossEntropyLoss para o termo CE. Calcule a perda binária de dados achatando cada máscara prevista e máscara de verdade no terreno, calculando a perda de dados para cada amostra e fazendo a média da perda ao longo do lote. Calcule a perda de dados multiclasse convertendo o mapa de etiquetas alvo para o formato one-hot, aplicando softmax à saída do modelo, calculando a perda de dados para cada classe e fazendo a média da perda entre todas as classes.
- Defina a constante de suavização para 1 para a perda binária de dados e para 1×10⁻⁵ para a perda multiclasse de dados. Implemente a perda BCE-Dice usando a classe BceDiceLoss com wb = 1 e wd = 1. Implemente a perda CE-Dice usando a classe CeDiceLoss com loss_weight = [1, 1]. Mantenha as constantes de suavização, a estratégia de redução e a implementação de software inalteradas para todos os conjuntos de dados, sementes aleatórias e experimentos.
- Configure a redução de perdas
- Instaure nn. BCELoss() e nn. CrossEntropyLoss() sem especificar explicitamente o argumento de redução.
- Use a configuração padrão de redução de perda do PyTorch (redução = "média") para ambas as funções de perda. Não use redução = "soma" ou uma saída de perda não reduzida.
9. Configurações de reprodutibilidade e execução
- Baixe a implementação lançada de https://github.com/LIXUEGUANG002/MVM-UNet. Use o repositório junto com os pacotes de software, conjuntos de dados, especificações de hardware e recursos computacionais listados na Tabela de Materiais.
- Clone o repositório e entre no diretório do projeto rodando o git clone https://github.com/LIXUEGUANG002/MVM-UNet.git, seguido pelo cd MVM-Unet.
- Configure o experimento ISIC 2017 ou ISIC 2018 definindo o nome do conjunto de dados, caminho, tamanho de entrada, tamanho do lote, número de épocas, função de perda, otimizador, agendador de taxa de aprendizado e seed aleatória nas configurações/config_setting.py. Execute o script de treinamento a partir da raiz do repositório usando train.py em Python.
- Configure o experimento Synapse definindo o nome do conjunto de dados, caminho dos dados de treinamento, caminho do volume de teste, diretório de lista, tamanho de entrada, número de classes, tamanho do lote, número de épocas, função de perda, otimizador, agendador de taxa de aprendizado e seed aleatória em configurações/config_setting_synapse.py. Execute o script de treinamento a partir da raiz do repositório usando train_synapse.py em python.
- Realize uma avaliação apenas por inferência definindo only_test_and_save_figs = Verdadeiro, best_ckpt_path para o checkpoint treinado e img_save_path para o diretório de saída no arquivo de configuração correspondente. Execute train.py Python para ISIC 2017 ou ISIC 2018, ou execute train_synapse.py Python para Synapse para gerar resultados de previsão e números qualitativos.
- Use a versão do código-fonte lançada
- Clone o repositório GitHub lançado e confira o commit ee891b42c2f083c4990eed72f1d4463adc5e103e no branch mestre antes de configurar os conjuntos de dados, scripts de treinamento e configurações de avaliação.
- Use este commit para reproduzir os experimentos relatados neste estudo. Nenhuma versão de lançamento marcada estava disponível para o repositório no momento da revisão do manuscrito.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Desfechos esperados e interpretação
Quando esse protocolo é implementado corretamente, espera-se que o modelo treinado MVM-UNet produza desempenho estável de segmentação ao longo de execuções repetidas, com apenas pequenas variações entre diferentes sementes aleatórias para a maioria das métricas de avaliação. Para o ISIC 2017 e ISIC 2018, os resultados bem-sucedidos são refletidos por altos valores de DSC, mIoU, Acc, Sen e Spe, juntamente com máscaras de lesão previs...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Este protocolo descreve o MVM-UNet, uma estrutura de segmentação de imagens médicas baseada em Mamba. O método foi projetado para abordar duas limitações dos modelos de segmentação existentes. Primeiro, métodos convencionais baseados em CNN têm capacidade limitada de modelar dependências de longo alcance e informações contextuais hierárquicas em imagens médicascomplexas 43. Segundo, métodos baseados em transformadores podem modelar o contexto global, mas geralment...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram que não têm interesses financeiros concorrentes.
Agradecimentos
Essa pesquisa não recebeu financiamento externo.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 com Linux kernel 6.8.0; Intel Core i9-13900K CPU; GPU NVIDIA A800; 128 GB RAM; 512 GB de armazenamento local. | Plataforma computacional para treinamento, validação, teste, ablação e experimentos apenas de inferência. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | GPU NVIDIA A800 (80 GB de memória). | Treinamento e inferência acelerados por GPU. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | CPU Intel Core i9-13900K de 13ª geração. | Processador host para carregamento de dados, pré-processamento e execução de experimentos. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB de RAM do sistema | Memória para carregamento de conjuntos de dados, pré-processamento e treinamento. |
| Hardware - Storage | Institutional computing platform / local workstation | Unidade de estado sólido NVMe de 2 TB. | Armazenamento para conjuntos de dados, checkpoints, logs e figuras de previsão geradas. |
| Software environment - Operating system | Canonical Ltd. | Recomendado: Ubuntu 22.04.1 LTS | Sistema operacional para o ambiente computacional. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Nome do ambiente: mvmunet | Ambiente Python usado para instalar e isolar dependências. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Linguagem de programação usada para implementação e execução de experimentos. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | Backend de computação GPU necessário para PyTorch e pacotes relacionados ao Mamba. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | Primitivas de aprendizado profundo aceleradas por GPU usadas através do PyTorch. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Framework de aprendizado profundo para treinamento de modelos, cálculo de perda, otimização e inferência. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Utilitários de transformação de imagem usados em pré-processamento e aumento. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Instalado com o ambiente PyTorch recomendado. |
| Python package - timm | timm developers | timm == 0.4.12 | Dependência de componente ou utilitário de modelo listada nas instruções do ambiente do repositório. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Dependência usada por componentes de modelagem de sequência acelerados por GPU. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Dependência de convolução causal eficiente necessária pela implementação Mamba. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | Pacote de modelagem de sequência em espaço de estados usado para componentes relacionados ao Mamba/S6. |
| Python package - NumPy | NumPy developers | NumPy versão 1.24.3. | Computação numérica e operações de matriz. |
| Python package - SciPy | SciPy developers | Versão do SciPy 1.10.1. | Computação científica; scipy.ndimage.zoom é importado em utils.py. |
| Python package - SimpleITK | Insight Software Consortium | Versão do SimpleITK 2.2.1. | Utilitário de entrada/saída e pré-processamento de imagem médica importado em utils.py. |
| Python package - MedPy | MedPy developers | Versão do MedPy 0.4.0. | Pacote de cálculo de métricas de imagem médica importado em utils.py. |
| Python package - scikit-image | scikit-image developers | Versão do scikit-image 0.21.0. | Dependência de processamento de imagem listada no README. |
| Python package - scikit-learn | scikit-learn developers | Versão do scikit-learn 1.3.2. | Pacote utilitário de aprendizado de máquina listado no README. |
| Python package - matplotlib | Matplotlib developers | Versão do Matplotlib 3.7.2. | Usado para salvar figuras de visualização qualitativa. |
| Python package - h5py | h5py developers | Versão do h5py 3.9.0. | Suporte a arquivos HDF5 para volumes de teste Synapse. |
| Python package - thop | THOP developers | Versão do THOP 0.1.1.post2209072238. | Usado ao calcular FLOPs e custo computacional relacionado a parâmetros. |
| Python package - packaging | Python Packaging Authority | Versão do packaging 23.1. | Dependência listada no README. |
| Python package - pytest | pytest developers | Versão do pytest 7.4.0. | Dependência listada no README. |
| Python package - chardet | chardet developers | Versão do chardet 5.2.0. | Dependência listada no README. |
| Python package - yacs | YACS developers | Versão do yacs 0.1.8. | Dependência de utilitário de configuração listada no README. |
| Python package - termcolor | termcolor developers | Versão do termcolor 2.3.0. | Dependência de utilitário de log/terminal listada no README. |
| Python package - submitit | submitit developers | Versão do submitit 1.4.5. | Dependência de utilitário de experimento/tarefa listada no README. |
| Python package - tensorboardX | tensorboardX developers | Versão do tensorboardX 2.6.2.2. | Utilitário de visualização de log de treinamento listado no README. |
| Python package - ml-collections | ml_collections developers | Versão do ml-collections 0.1.1. | Importado por configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | Conjunto de dados de segmentação de lesão cutânea ISIC 2017 | Imagens e máscaras de lesão cutânea dermatoscópica desidentificadas públicas usadas para segmentação binária. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Task 1: Segmentação de Contorno de Lesão | Imagens e máscaras de lesão cutânea dermatoscópica desidentificadas públicas usadas para segmentação binária. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Identificador de acesso: syn3193805 | Conjunto de dados público de segmentação multi-órgão de TC abdominal. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017/ | Pasta local esperada contendo imagens/máscaras de treinamento e validação. |
| Data organization - ISIC 2018 data folder | Authors / repository layout | data/isic2018 |
Referências
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.