Esta pesquisa transversal examinou as associações entre o uso de inteligência artificial generativa, estilo de ensino, alfabetização digital, motivação, ansiedade e criatividade em estudantes universitários sauditas de inglês como língua estrangeira, identificando a motivação como um mediador importante nas relações observadas.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Inteligência Artificial Generativa, Motivação, Ansiedade e Criatividade em Salas de Aula de Inglês como Língua Estrangeira na Arábia Saudita: Um Estudo Transversal
Neste artigo
Resumo
Resumo
Ferramentas de inteligência artificial (IA), como o ChatGPT, estão sendo cada vez mais incorporadas ao ensino de inglês como língua estrangeira (EFL); no entanto, há evidências limitadas sobre como seu uso se relaciona com o estilo de ensino, a alfabetização digital, a motivação, a ansiedade em sala de aula de língua estrangeira (FLCA) e a criatividade no contexto da Arábia Saudita. Este estudo investigou as associações entre essas variáveis e examinou o papel mediador da motivação dentro de uma estrutura conceitual unificada. Foi realizada uma pesquisa quantitativa e transversal com 280 estudantes universitários de EFL matriculados em uma universidade do setor público na Arábia Saudita, utilizando instrumentos de questionário validados. As relações propostas foram analisadas por meio de Modelagem de Equações Estruturais por Mínimos Quadrados Parciais (PLS-SEM). Os resultados indicaram que o uso do ChatGPT, o estilo de ensino e a alfabetização digital estavam positivamente associados à motivação dos estudantes. Uma motivação mais alta estava associada a níveis mais baixos de FLCA e a níveis mais altos de criatividade. A motivação também mediou as associações entre o uso do ChatGPT, o estilo de ensino, a alfabetização digital e a FLCA. Esses achados sugerem que as experiências motivacionais dos estudantes estão estreitamente relacionadas às interações entre práticas pedagógicas, uso de tecnologia e resultados de aprendizagem de línguas. O estudo fornece evidências que apoiam a integração de estratégias de ensino apropriadas, ferramentas de IA generativa e alfabetização digital no ensino de língua inglesa, destacando a importância de considerar as experiências motivacionais e emocionais dos estudantes ao implementar ambientes de aprendizagem apoiados por tecnologia.
Introdução
O Reino da Arábia Saudita está passando por uma agenda transformadora de reforma educacional sob a Visão 2030, que prioriza o desenvolvimento de habilidades do século XXI, competência digital e abordagens pedagógicas inovadoras em todos os níveis educacionais1. Nesse contexto nacional, o ensino de Inglês como Língua Estrangeira (ILE) continua enfrentando desafios persistentes, incluindo uma cultura voltada para exames que enfatiza a memorização e o desempenho em testes em detrimento da competência comunicativa2,3. As oportunidades limitadas de interação autêntica com o idioma inglês fora da sala de aula, juntamente com altos níveis de ansiedade em sala de aula de língua estrangeira (ALE), restringem ainda mais a disposição dos alunos para se comunicar e se envolver significativamente com a língua-alvo4. Esses desafios têm levado educadores e formuladores de políticas a explorar abordagens inovadoras que abordem déficits motivacionais, barreiras emocionais e o uso criativo da linguagem. A inteligência artificial (IA) surgiu como um caminho promissor para apoiar a aprendizagem de idiomas e transformar as práticas de ensino5. Entre as aplicações de IA no Ensino de Língua Inglesa (ELT), o ChatGPT, um modelo de IA generativa conversacional, tem recebido considerável atenção por oferecer prática interativa de idioma e feedback individualizado imediato em contextos conversacionais em tempo real6. Essas características são particularmente relevantes nas salas de aula de ILE na Arábia Saudita, onde a instrução centrada no professor e a interação limitada dos alunos continuam restringindo a produção criativa de linguagem7. O ChatGPT pode ajudar a superar essas limitações ao proporcionar oportunidades de prática de idioma autêntica e com baixa ansiedade com um interlocutor de IA8.
Reformas educacionais recentes na Arábia Saudita incentivaram uma transição rumo a uma pedagogia centrada no aluno, criando oportunidades para integrar tecnologias de IA que promovam participação ativa, pensamento crítico e aprendizagem autodirigida9,10. Quando implementado adequadamente, o ChatGPT pode apoiar essa transição, ampliando a prática da linguagem para além das atividades tradicionais em sala de aula11. No entanto, a eficácia da integração da IA depende em parte da alfabetização digital dos estudantes, definida como sua capacidade de avaliar, utilizar e interagir efetivamente com tecnologias digitais para a aprendizagem12. A alfabetização digital permite que os alunos façam uso produtivo de ferramentas de IA, minimizando ao mesmo tempo riscos potenciais, como dependência excessiva e desinformação13. Essa competência é particularmente importante no ensino superior saudita, onde a transformação digital tem se acelerado sob a Visão 203014.
Embora pesquisas anteriores tenham examinado separadamente ferramentas de IA, estilo de ensino, alfabetização digital, motivação, ansiedade e criatividade, há poucas evidências que investiguem como essas construções interagem dentro de um quadro unificado em contextos de LE estrangeira não ocidentais, como a Arábia Saudita. A motivação tem sido consistentemente identificada como um mecanismo importante que liga práticas instrucionais a resultados de aprendizagem, incluindo menor ansiedade, maior criatividade e engajamento sustentado15. No entanto, as relações entre o uso do ChatGPT, estilo de ensino, alfabetização digital, motivação, AALE e criatividade ainda não foram examinadas de forma abrangente no contexto de LE na Arábia Saudita16. Abordar essa lacuna pode fornecer insights teóricos e práticos para o desenho de ambientes de aprendizagem de línguas aprimorados por tecnologia, que apoiem o desenvolvimento motivacional, emocional e criativo dos estudantes. Assim, este estudo investiga as relações entre o uso do ChatGPT, estilo de ensino, alfabetização digital, motivação, AALE e criatividade entre estudantes universitários sauditas de LE. Especificamente, examina-se (1) as relações entre o uso do ChatGPT, estilo de ensino e alfabetização digital com a motivação dos alunos; (2) as relações entre motivação, AALE e criatividade; e (3) o papel mediador da motivação nas relações entre o uso do ChatGPT, estilo de ensino, alfabetização digital e as variáveis de resultado ansiedade e criatividade.
Este estudo contribui para a educação em Língua Estrangeira (EFL) e a aprendizagem mediada por tecnologia ao incorporar o uso de ferramentas de IA em modelos existentes de motivação e aprendizagem de línguas, ampliando assim a compreensão da aprendizagem de línguas apoiada por tecnologia em contextos educacionais contemporâneos. Também fornece evidências que podem orientar educadores, elaboradores de currículos e formuladores de políticas interessados em integrar ferramentas de IA no ensino de EFL na Arábia Saudita. Ao examinar a motivação como um mediador que liga o uso de tecnologia e práticas pedagógicas à ansiedade em relação à língua estrangeira (FLCA) e à criatividade, o estudo oferece evidências específicas do contexto para apoiar o desenvolvimento de uma educação linguística centrada no aluno, alinhada aos objetivos de reforma educacional da Arábia Saudita.
A Teoria da Autodeterminação (SDT) fornece uma estrutura teórica para compreender a relação entre práticas de ensino e motivação dos alunos em contextos educacionais17. De acordo com a SDT, a motivação intrínseca e as formas autônomas de motivação extrínseca são favorecidas quando as três necessidades psicológicas básicas dos aprendizes — autonomia, competência e relacionamento — são satisfeitas no ambiente de aprendizagem18. O estilo de ensino é, portanto, um fator contextual fundamental que influencia a motivação e o engajamento dos alunos19. Práticas de ensino que apoiam a autonomia, oferecendo escolhas significativas, reconhecendo as perspectivas dos alunos e explicando as atividades de aprendizagem, promovem a motivação intrínseca e o engajamento autodeterminado20. Em contextos de LE (Língua Estrangeira), abordagens centradas no aluno, incluindo os estilos de ensino de facilitador e de delegador, têm sido associadas a maior comprometimento, participação e interesse dos alunos no aprendizado da língua21,22. Por outro lado, o ensino centrado no professor pode reduzir a motivação ao limitar a participação e a autonomia dos alunos, enfatizando recompensas extrínsecas em vez do interesse intrínseco23,24. No contexto saudita de LE, onde o ensino tradicional historicamente enfatizou a memorização e a transmissão de conteúdo centrada no professor25, a adoção de abordagens de ensino mais centradas no aluno pode favorecer a motivação dos estudantes26. Com base nessa fundamentação teórica e empírica, a seguinte hipótese é proposta: H1: O estilo de ensino influencia positivamente a motivação dos alunos de LE.
A relação entre tecnologia educacional e motivação do aluno tem sido amplamente investigada27,28. O Modelo de Aceitação da Tecnologia (TAM) sugere que a motivação dos alunos para utilizar tecnologias educacionais é influenciada pela utilidade percebida e pela facilidade de uso percebida, fatores que moldam as intenções comportamentais e o uso da tecnologia29. Aplicado ao ChatGPT, esse modelo indica que estudantes que consideram a ferramenta útil e fácil de usar têm maior probabilidade de utilizá-la para o aprendizado de idiomas30. Estudos empíricos relataram associações positivas entre o aprendizado de idiomas com suporte de IA e a motivação dos alunos, sendo características interativas, feedback imediato e prática personalizada fatores que contribuem para o engajamento contínuo31,32. O ChatGPT também pode reduzir barreiras associadas à ansiedade linguística, oferecendo oportunidades de prática com baixa pressão, o que pode incentivar o uso contínuo do idioma33. Esse potencial é particularmente relevante no contexto saudita, onde a ansiedade em relação ao aprendizado de línguas estrangeiras (FLCA) tem sido identificada como um obstáculo importante para a motivação e o desempenho linguístico34. Com base nesses achados teóricos e empíricos, a seguinte hipótese é proposta: H2: O uso do ChatGPT influencia positivamente a motivação de alunos de inglês como língua estrangeira (EFL).
A alfabetização digital tornou-se um determinante importante da motivação dos alunos nos ambientes contemporâneos de ensino de LE35. Refere-se à capacidade de buscar, avaliar e utilizar de forma eficaz as tecnologias e mídias digitais para a aprendizagem36. Em contextos de LE, a alfabetização digital permite que os aprendizes utilizem de maneira eficaz recursos digitais, incluindo o ChatGPT, sistemas de gestão de aprendizagem e ferramentas multimídia, para apoiar a aquisição linguística e a motivação37. Alunos com níveis mais elevados de alfabetização digital têm maior probabilidade de usar as tecnologias de aprendizagem com confiança, promovendo competência e autonomia, fatores associados à motivação intrínseca38. Eles também estão melhor preparados para utilizar ferramentas digitais na prática independente da língua, no recebimento de feedback e no engajamento contínuo na aprendizagem39. Com base nessa literatura, a seguinte hipótese é proposta: H3: A alfabetização digital dos alunos de LE influencia positivamente a motivação desses alunos.
A ansiedade na aprendizagem de línguas estrangeiras (FLCA) e a criatividade são construtos intimamente relacionados no ensino de LE, embora sua relação permaneça complexa40. A ansiedade pode limitar o desempenho dos alunos em tarefas que exigem criatividade, flexibilidade cognitiva, pensamento divergente e autoexpressão41. A FLCA reflete o medo dos alunos de cometer erros, de avaliações negativas e de baixa autoconfiança, todos os quais podem interferir na produção criativa da linguagem42. A criatividade, no entanto, é uma competência importante na aprendizagem de LE, pois favorece o uso contextualmente apropriado e inovador da linguagem31. Estudos anteriores relataram que alunos com maior ansiedade têm menor probabilidade de participar de atividades de escrita criativa e de comunicação oral43,44. Com base nessa literatura, as seguintes hipóteses são propostas: 1) H4: A motivação dos alunos de LE apresenta relação negativa com sua ansiedade, e 2) H5: A ansiedade dos alunos de LE influencia negativamente sua criatividade.
A motivação fornece um mecanismo teórico pelo qual o estilo de ensino, o uso do ChatGPT e a alfabetização digital podem estar relacionados à ansiedade na aprendizagem de línguas estrangeiras (FLCA)45. Aprendizes motivados têm maior probabilidade de participar ativamente, persistir diante de desafios e experimentar níveis mais baixos de apreensão na comunicação46. Práticas de ensino que oferecem apoio, o aprendizado de línguas assistido por IA e uma alfabetização digital mais forte já foram associados a maior motivação e menor ansiedade em contextos de ensino de inglês como língua estrangeira (EFL)47,48,49. Pesquisas anteriores também sugerem que uma motivação mais elevada está associada a menor ansiedade em sala de aula e maior criatividade, o que reforça a motivação como um possível mediador que liga práticas instrucionais e o uso de tecnologia aos resultados de aprendizagem50,51,52. Com base nessa literatura, as seguintes hipóteses são propostas: 1) H6: A motivação media a relação entre o estilo de ensino e a ansiedade de estudantes de EFL; 2) H7: A motivação media a relação entre o uso do ChatGPT e a ansiedade de estudantes de EFL; e 3) H8: A motivação media a relação entre a alfabetização digital de estudantes de EFL e sua ansiedade. Figura 1 ilustra o modelo hipotetizado no qual o estilo de ensino, o uso do ChatGPT e a alfabetização digital estão associados à motivação de estudantes de EFL, a qual, por sua vez, media suas relações com a FLCA e a criatividade.
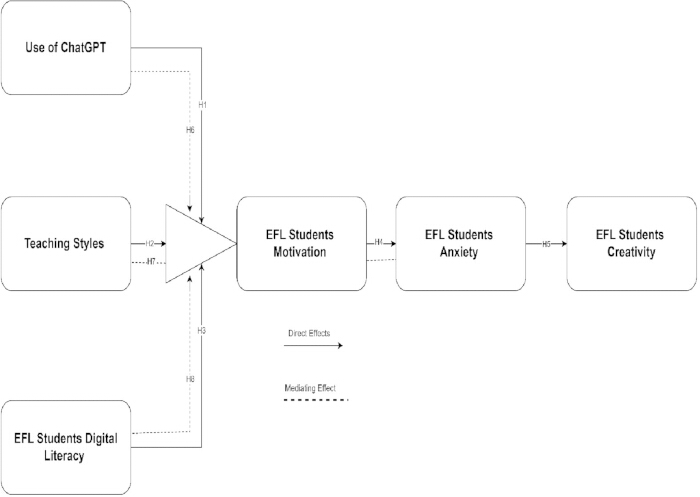
Figura 1. Modelo de pesquisa hipotetizado. O modelo ilustra as relações hipotetizadas entre o uso do ChatGPT, estilo de ensino, alfabetização digital, motivação, ansiedade em sala de aula de língua estrangeira e criatividade em estudantes de inglês como língua estrangeira (EFL). Linhas contínuas representam relações diretas hipotetizadas e linhas tracejadas representam relações mediadoras, conforme indicado na figura. Clique aqui para visualizar uma versão ampliada desta figura.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Embora o estudo não tenha exigido aprovação ética formal de uma comissão de ética institucional devido ao seu desenho de pesquisa não experimental e anônimo, sem intervenções físicas, manipulações ou enganos aos participantes, todos os procedimentos foram conduzidos de acordo com os princípios éticos da Declaração de Helsinque e das diretrizes da Associação Americana de Psicologia para pesquisas envolvendo participantes humanos. O consentimento informado foi obtido de todos os participantes antes da coleta de dados. A instituição não exigiu nem emitiu uma aprovação ética formal ou isenção para este tipo de estudo. Todos os respondentes foram explicitamente informados sobre o objetivo da pesquisa, a participação voluntária, o direito de se retirar a qualquer momento sem consequências e as rigorosas medidas de confidencialidade aplicadas aos seus dados. Nenhuma informação pessoal identificável foi coletada ou relatada, e todos os dados foram utilizados exclusivamente para análise acadêmica agregada. Uma atenção especial foi dada à redação não intrusiva e respeitosa, para garantir que o questionário não interferisse nas atividades acadêmicas ou no bem-estar psicológico dos participantes. Para o formulário de consentimento informado, consulte o Arquivo Suplementar 1. Além disso, os materiais utilizados neste estudo estão listados na Tabela de Materiais.
Desenho da pesquisa
Esta seção descreve o delineamento da pesquisa, os procedimentos de coleta de dados e os detalhes da amostra utilizados no estudo para investigar as relações entre estilo de ensino, uso do ChatGPT, alfabetização digital, motivação, ansiedade e criatividade entre estudantes de LE. O estudo adotou um delineamento quantitativo e transversal para examinar o papel mediador da motivação nas relações entre estilo de ensino, uso do ChatGPT, alfabetização digital e ansiedade entre estudantes de LE, bem como a forma como essas variáveis se relacionam coletivamente com a criatividade. Foi adotada uma metodologia de pesquisa estruturada por meio de questionário para coletar dados primários, garantindo padronização e confiabilidade na mensuração dos construtos. O estudo utilizou escalas validadas para avaliar todas as variáveis, incluindo estilo de ensino, uso do ChatGPT, alfabetização digital, motivação, AALF e criatividade.
Dados e Amostra
Os dados deste estudo foram coletados de estudantes de LE estrangeira matriculados na Universidade de Jeddah, uma universidade do setor público na Arábia Saudita reconhecida por sua ênfase no ensino de línguas e na integração da tecnologia no ensino. Os participantes foram selecionados por meio de uma técnica de amostragem intencional, considerada apropriada para este estudo devido aos critérios específicos de inclusão, que exigiam que os participantes tivessem experiência ativa com ferramentas de IA, como o ChatGPT, em seus ambientes de aprendizagem. Essa abordagem de amostragem não probabilística foi necessária porque as questões de pesquisa do estudo concentravam-se em uma população específica — estudantes de LE estrangeira expostos tanto a métodos tradicionais quanto a métodos de ensino assistidos por tecnologia — e a amostragem aleatória não teria garantido a inclusão de participantes que atendessem a esses critérios. Embora a amostragem intencional limite a generalização dos resultados para a população mais ampla, ela foi justificada para esta investigação exploratória, assegurando que os participantes possuíssem as experiências e perspectivas relevantes necessárias para atender aos objetivos da pesquisa. Para atenuar as limitações da amostragem intencional, esforços foram feitos para incluir participantes com diferentes formações acadêmicas e níveis variados de proficiência tecnológica, aumentando assim a representatividade da amostra dentro da população-alvo. A amostra final consistiu de 280 estudantes universitários de LE estrangeira, um tamanho considerado adequado para as técnicas estatísticas utilizadas.
A determinação da adequação do tamanho da amostra baseou-se em diretrizes estabelecidas para Modelagem de Equações Estruturais (SEM). Recomenda-se um mínimo de 10 casos por parâmetro estimado para SEM, com diretrizes mais conservadoras sugerindo 20 casos por parâmetro para a Modelagem de Equações Estruturais por Mínimos Quadrados Parciais (PLS-SEM). O modelo de mensuração compreendia 29 itens para alfabetização digital, 25 itens para estilo de ensino e 32 itens para FLCA, além de itens adicionais para uso do ChatGPT, motivação e criatividade. As diretrizes do PLS-SEM também recomendam um tamanho mínimo da amostra igual a 10 vezes o maior número de indicadores formativos ou o maior número de caminhos estruturais direcionados a um determinado construto; portanto, a amostra de 280 participantes excedeu esses requisitos mínimos. Além disso, uma análise de poder pós-hoc utilizando o G*Power53 indicou que uma amostra de 280 participantes proporcionou poder estatístico superior a 0,95 para detectar efeitos de magnitude média (f2 = 0,15) com α = 0,05, superando o limiar comumente recomendado de 0,80. Esse tamanho amostral fornece estimativas de parâmetros confiáveis e poder estatístico suficiente para detectar relações significativas entre as variáveis do estudo, ao mesmo tempo que acomoda a complexidade dos modelos de mensuração e estruturais propostos.
Participantes e Procedimento
Os participantes foram estudantes de LE (língua estrangeira) com idades entre 18 e 25 anos, sendo a maioria alunos do primeiro e segundo ano de graduação matriculados em cursos de língua inglesa. A pesquisa foi realizada entre setembro e outubro de 2025, período em que os estudantes foram convidados a participar voluntariamente. O processo de recrutamento envolveu divulgação por meio de canais oficiais da universidade, incluindo e-mails e anúncios em aulas. Os participantes eram estudantes de LE com idades entre 18 e 25 anos, matriculados como alunos do primeiro ou segundo ano em cursos de língua inglesa. A elegibilidade foi determinada com base em critérios pré-definidos de inclusão e exclusão. Os participantes eram elegíveis se (a) estivessem oficialmente matriculados em cursos de língua inglesa de graduação na Universidade de Jeddah, (b) tivessem entre 18 e 25 anos, e (c) estivessem registrados como alunos do primeiro ou segundo ano. Os estudantes foram excluídos se (a) fossem alunos de pós-graduação ou alunos de graduação avançada fora da sequência de cursos básicos, (b) estivessem fora da faixa etária especificada, ou (c) tivessem participado da fase de pré-teste do questionário. Para garantir o consentimento informado, os participantes foram informados sobre o objetivo do estudo, o caráter voluntário da participação e a confidencialidade das respostas. O instrumento de coleta de dados foi um questionário estruturado, autoaplicável, distribuído fisicamente e eletronicamente por meio de uma plataforma online segura. Escalas validadas foram adaptadas para medir o estilo de ensino, o uso do ChatGPT, a alfabetização digital, a motivação dos alunos, a ansiedade em relação à língua estrangeira (FLCA) e a criatividade. Os participantes foram solicitados a avaliar suas respostas em uma escala Likert de 5 pontos, variando de 1 (Discordo totalmente) a 5 (Concordo totalmente). Um pré-teste do questionário foi realizado com um pequeno grupo de 30 estudantes para garantir clareza e confiabilidade. Com base nos resultados do pré-teste, foram feitos pequenos ajustes na redação para melhorar a compreensão dos itens, e não foram identificados problemas significativos quanto à confiabilidade ou validade da escala. Para manter a integridade dos dados e incentivar respostas honestas, a anonimidade foi garantida, e os participantes foram assegurados de que seus dados seriam usados apenas para fins de pesquisa. Das 300 respostas iniciais coletadas, 280 foram consideradas válidas após triagem para dados incompletos ou inconsistentes, resultando em uma taxa de retenção de 93%. Os procedimentos de triagem dos dados incluíram a análise de padrões de resposta para respostas lineares repetitivas (straight-lining), dados ausentes excessivos (mais de 10%) e outliers multivariados utilizando a distância de Mahalanobis. Essa abordagem metodológica fornece uma base sólida para analisar as relações entre as variáveis do estudo e oferece insights valiosos sobre o papel do estilo de ensino, ferramentas de IA e alfabetização digital na formação da motivação, ansiedade e criatividade de estudantes de LE.
Após a coleta de dados, 20 respostas foram excluídas do conjunto inicial de 300 com base em critérios pré-definidos: 12 respostas foram descartadas devido à quantidade excessiva de dados ausentes, superando 10% dos itens do questionário; 5 foram eliminadas por apresentarem padrões de resposta lineares (respostas uniformes em todos os itens, indicando falta de engajamento); e 3 foram identificadas como outliers multivariados utilizando a distância de Mahalanobis (p < 0,001) e subsequentemente removidas para evitar distorção nos resultados do modelo de equações estruturais (SEM). Os valores ausentes para os casos mantidos foram tratados por imputação pela média, quando os dados faltantes eram mínimos (menos de 5% por caso), já que essa abordagem é aceitável para pequenas proporções de dados ausentes em pesquisas com grandes amostras. A taxa final de retenção de 93% (280 respostas válidas de 300 questionários coletados) representa a proporção de respostas utilizáveis mantidas em relação ao total de questionários coletados; entretanto, isso não deve ser interpretado como uma taxa de resposta real, pois o número exato de participantes convidados não pôde ser calculado, uma vez que os métodos combinados de distribuição física e eletrônica por meio de canais oficiais da universidade impediram o rastreamento preciso do número total de convites. Essa limitação é reconhecida, e o valor de 93% é, portanto, relatado como a proporção de respostas válidas mantidas dentre os questionários coletados, e não como uma taxa de resposta em relação ao total da população convidada.
Ferramentas e Medidas
Este estudo utilizou escalas bem estabelecidas e validadas, cuidadosamente adaptadas ao contexto do ensino de LE, para medir os construtos principais: estilo de ensino, alfabetização digital, uso do ChatGPT, AFCLE, motivação e criatividade. Cada escala foi selecionada com base em sua relevância e abrangência na captura das dimensões respectivas das variáveis em investigação. A alfabetização digital foi medida por meio de uma escala adaptada com base em Rodríguez-de-Dios et al.54, composta por seis dimensões com 29 itens. Essas dimensões incluíram Habilidade Tecnológica, Habilidade em Segurança Pessoal, Habilidade Crítica, Habilidade em Segurança de Dispositivos, Habilidade Informacional e Habilidade em Comunicação, permitindo uma avaliação abrangente da proficiência dos estudantes em habilidades digitais essenciais para contextos educacionais modernos. O uso do ChatGPT foi avaliado por meio de uma escala de 8 itens adaptada de Abbas et al.55, com foco na interação dos estudantes com a ferramenta de IA em tarefas de aprendizagem de línguas. O estilo de ensino foi avaliado utilizando uma versão adaptada do Inventário de Estilo de Ensino de Grasha56. Este instrumento mede cinco dimensões dos estilos de ensino: Autoridade, Especialista, Modelo Pessoal, Facilitador e Delegador. Essas dimensões refletem diferentes abordagens instrucionais que influenciam as experiências de aprendizagem dos estudantes de LE. A AFCLE foi medida por meio de uma escala adaptada com base em Briesmaster e Briesmaster57. Este instrumento examinou a ansiedade em três dimensões: Apreensão na Comunicação (10 itens), Ansiedade em Provas (10 itens) e Medo de Avaliação Negativa (7 itens). A motivação dos estudantes foi avaliada por meio de uma escala adaptada de Kanoksilapatham et al.58, que mede três dimensões: Promoção e Prevenção da Instrumentalidade, Etnocentrismo e Integratividade, e Atitude em Relação à Aprendizagem do Inglês. A escala incluiu um total de 20 itens. A criatividade dos estudantes de LE foi medida por meio de uma escala adaptada de Govindasamy et al.59, que avaliou quatro dimensões: Originalidade, Flexibilidade, Fluência e Elaboração. Cada dimensão foi medida com três itens. Para garantir a adequação cultural e contextual dos instrumentos ao ambiente de LE, foi aplicado um procedimento sistemático de adaptação. Como as escalas originais foram desenvolvidas em inglês, dois especialistas bilíngues em LE revisaram e simplificaram a linguagem para melhorar a clareza para estudantes universitários de nível intermediário, preservando o significado original de cada construto. As versões adaptadas foram então retrotraduzidas para a língua materna dos participantes por um tradutor independente, a fim de verificar a equivalência linguística e conceitual, e quaisquer discrepâncias foram resolvidas por meio de discussão entre a equipe de pesquisa. Posteriormente, três instrutores experientes em LE avaliaram os instrumentos adaptados quanto à relevância do conteúdo, adequação cultural e clareza dos itens, resultando em pequenas revisões de redação e na substituição de exemplos culturalmente desconhecidos, quando apropriado. Por fim, os instrumentos revisados foram testados em um estudo piloto com 30 estudantes (ver seção Procedimento), e os comentários dos participantes foram utilizados para realizar refinamentos adicionais e menores na redação, a fim de melhorar a compreensibilidade. Esse processo em múltiplas etapas garantiu que os instrumentos adaptados mantivessem suas propriedades psicométricas originais, ao mesmo tempo que fossem apropriados para a população-alvo de LE. Para o questionário adaptado completo, consulte Arquivo Suplementar 2.
Métodos de Análise de Dados
Os dados coletados para este estudo foram analisados utilizando o Pacote Estatístico para as Ciências Sociais (SPSS 26) e o SmartPLS 4, empregando-se a PLS-SEM. Essa abordagem com métodos duplos garantiu uma análise abrangente dos dados, abordando tanto aspectos descritivos quanto inferenciais, além de testar as relações hipotetizadas e os efeitos de mediação no modelo de pesquisa. Inicialmente, o SPSS foi utilizado para realizar a análise preliminar dos dados, incluindo a limpeza dos dados, estatísticas descritivas e testes de confiabilidade. A triagem dos dados envolveu a verificação de valores ausentes, outliers e normalidade, a fim de assegurar a qualidade e a integridade do conjunto de dados. Foram calculadas estatísticas descritivas, incluindo média, desvio padrão e distribuições de frequência, para resumir as características da amostra. A análise principal foi conduzida utilizando o SmartPLS 4. A PLS-SEM foi escolhida devido à sua adequação para analisar modelos complexos com múltiplas construções e por sua robustez em amostras pequenas a médias. A análise foi realizada em duas etapas: avaliação do modelo de mensuração e avaliação do modelo estrutural. Na avaliação do modelo de mensuração, foram examinadas a confiabilidade dos indicadores, a confiabilidade da consistência interna (utilizando a confiabilidade composta [CR]), a validade convergente (utilizando a variância média extraída [AVE]) e a validade discriminante (utilizando a razão heterotrait–monotrait [HTMT]).
Após a validação do modelo de mensuração, o modelo estrutural foi avaliado para examinar as relações hipotetizadas entre estilo de ensino, uso do ChatGPT, alfabetização digital, motivação, ansiedade e criatividade. Os coeficientes de caminho foram analisados para determinar a intensidade e a significância dos efeitos diretos e indiretos, sendo a significância avaliada por meio de reamostragem bootstrap com 5.000 reamostras. Para avaliar a significância dos efeitos diretos, indiretos e de mediação, foram construídos intervalos de confiança bootstrap com correção de viés (BC) utilizando 5.000 reamostras bootstrap e um nível de confiança de 95%. Os efeitos de mediação da motivação nas relações entre estilo de ensino, uso do ChatGPT, alfabetização digital e ansiedade também foram avaliados por meio de intervalos de confiança bootstrap. O ajuste e o poder preditivo do modelo foram avaliados utilizando o coeficiente de determinação (R2), relevância preditiva (Q2) e resíduo médio quadrático padronizado (SRMR).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Estatísticas Descritivas
A estatística descritiva fornece uma visão geral das características da amostra e da distribuição, tendência central e variabilidade das variáveis do estudo. Neste estudo, análises descritivas foram realizadas para caracterizar a amostra de participantes e resumir as variáveis principais antes de conduzir as análises estruturais.
Tabela 1 resume as características demográficas dos 280 participantes universit...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Este estudo investigou as relações entre estilo de ensino, uso do ChatGPT, alfabetização digital, motivação, ansiedade em relação à língua estrangeira (FLCA) e criatividade entre estudantes universitários sauditas de LE, com atenção especial ao papel mediador da motivação. Os resultados fornecem evidências sobre as relações entre práticas pedagógicas, uso de tecnologia e características dos aprendizes no contexto de aprendizagem de línguas mediada por tecnologia. A associação positiva entre estilo de ensino e motivação d...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Conflito de Interesse:
O autor declara não haver conflitos de interesse.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Escala de uso do ChatGPT (adaptada) | Autores; adaptado de Abbas et al. | N/A | Questionário de oito itens que avalia o uso do ChatGPT pelos alunos para aprendizagem de idiomas. |
| Escala de criatividade (adaptada) | Autores; adaptado de Govindasamy et al. | N/A | Questionário de doze itens que avalia originalidade, flexibilidade, fluência e elaboração. |
| Escala de letramento digital (adaptada) | Autores; adaptado de Rodríguez-de-Dios et al. | N/A | Questionário de vinte e nove itens que mede seis dimensões do letramento digital. |
| Escala de ansiedade na sala de aula de língua estrangeira (FLCA, na sigla em inglês) (adaptada) | Autores; adaptado de Briesmaster & Briesmaster | N/A | Questionário de vinte e sete itens que mede apreensão na comunicação, ansiedade em testes e medo de avaliação negativa. |
| G*Power | Universidade Heinrich Heine de Düsseldorf | Versão 3.1.9.7; RRID: SCR_013726 | Software utilizado para análise estatística pós-hoc de poder estatístico. |
| IBM SPSS Statistics | IBM Corp. | Versão 26; RRID: SCR_002865 | Software estatístico utilizado para limpeza de dados, estatísticas descritivas, análises de confiabilidade e análises preliminares. |
| Análise da distância de Mahalanobis | IBM SPSS Statistics | Versão 26; RRID: SCR_002865 | Procedimento estatístico implementado no IBM SPSS Statistics para identificar outliers multivariados. |
| Escala de motivação (adaptada) | Autores; adaptado de Kanoksilapatham et al. | N/A | Questionário de vinte itens que avalia a motivação do aluno. |
| Questionário em papel | Autores | N/A | Versão impressa do questionário autoaplicável estruturado, utilizado para coleta de dados presencial. |
| Plataforma segura de pesquisa online | Google LLC | N/A | Plataforma Google Forms utilizada para distribuição eletrônica do questionário. |
| SmartPLS | SmartPLS GmbH | Versão 4; RRID: SCR_036419 | Software utilizado para Modelagem de Equações Estruturais por Mínimos Quadrados Parciais (PLS-SEM), incluindo avaliação do modelo de medida, análise do modelo estrutural, reamostragem bootstrap (5.000 reamostragens) e análise de mediação. |
| Questionário autoaplicável estruturado | Autores | N/A | Questionário aplicado em formatos impresso e eletrônico utilizando escala Likert de 5 pontos (1 = Discordo totalmente a 5 = Concordo totalmente). |
| Inventário de Estilo de Ensino (adaptado) | Autores; adaptado do Inventário de Estilo de Ensino de Grasha | N/A | Questionário que mede os estilos de ensino Autoridade, Especialista, Modelo Pessoal, Facilitador e Delegador. |
| Canais de comunicação da universidade | Universidade de Jeddah | N/A | Anúncios oficiais por e-mail e em sala de aula utilizados para recrutamento de participantes. |
Referências
- Ansa H. Exploring the role of artificial intelligence (AI) in enhancing EFL education in Saudi Arabia: A review of opportunities, obstacles, and future directions. Educ Sci. 2026;16(6):981.
- Alshehri A, Aldossary S, Jamshed M, Banu S. Incorporating ChatGPT in Saudi EFL classrooms: Oscillating between expectations and anxiety. J Lang Teach Res. 2025;16(5):1673-81.
- Alzubi AA, Alelaiwi AS. Exploring EFL university teachers’ perceptions of AI-generative tools in Saudi Arabia: A mixed-methods study. Discov Comput. 2025;28(1):282.
- Alzubi AA, Nazim M, Alyami N. Do AI-generative tools kill or nurture creativity in EFL teaching and learning? Educ Inf Technol. 2025;30(11):15147-84.
- Allehyani FS, Albedah F, Jamshed M, Warda WU. Exploring Saudi EFL learners’ engagement with AI generative tools in educational settings: Perceptions, practices, and pedagogical outcomes. Theory Pract Lang Stud. 2025;15(6):1959-66.
- Almusharraf A, Bailey D. Generative AI use among Saudi and Korean language learners in higher education: Examination through a modified TAM framework. SAGE Open. 2025;15(4):21582440251387804.
- Alharbi MA, Hassan Al-Ahdal AA. Exploring Saudi EFL learners’ engagement with ChatGPT: A mixed-methods study of perceptions, attitudes, and intentions. SAGE Open. 2025;15(4):21582440251392080.
- Khoso AK, Honggang W, Darazi MA. Empowering creativity and engagement: The impact of generative artificial intelligence usage on Chinese EFL students’ language learning experience. Comput Hum Behav Rep. 2025;18:100627.
- Alalwi FS, Alqahtani N, Jamshed M, Ahmmed MF. AI-driven feedback for pedagogical innovation: Assessing ChatGPT’s impact on Saudi EFL learners’ writing proficiency. World. 2026;16(5).
- Alshehri N. Speaking with AI: Exploring EFL learners’ attitudes, engagement, and satisfaction through ChatGPT conversations. 2026. 10.2139/ssrn.6595190
- Metwally AA, Bin-Hady WR. Probing the necessity and advantages of AI integration training for EFL educators in Saudi Arabia. Cogent Educ. 2025;12(1):2472462.
- Elmahdi OE, et al. AI-Driven Vocabulary Acquisition in EFL Higher Education: Interdisciplinary Insights into Technological Innovation, Ethical Challenges, and Equitable Access. Forum Linguist Stud. 2025;7(4):477–491.
- Al-Nofaie H, Alwerthan TA. Appreciative inquiry into implementing artificial intelligence for the development of language student teachers. Sustainability (Basel). 2024;16(21):9361.
- Alshayban A. Exploring EFL learners’ use of AI outside the classroom. J Lang Teach Res. 2026;17(1).
- Abdelhalim SM, Alsehibany RA. Integrating AI-powered tools in EFL pronunciation instruction: Effects on accuracy and L2 motivation. Comput Assist Lang Learn. 2025;38:1-25.
- Khoso AK, Honggang W, Darazi MA. Trust and attitude towards AI as pathways to creativity: A TAM model study of EFL students’ digital literacy and AI acceptance. Humanit Soc Sci Commun. 2025;13(1):69.
- Xiong X. Influence of teaching styles of higher education teachers on students’ engagement in learning: The mediating role of learning motivation. Educ Chem Eng. 2025;51:87-102.
- Bartholomew KJ, et al. Beware of your teaching style: A school-year-long investigation of controlling teaching and student motivational experiences. Learn Instr. 2018;53:50-63.
- Wiangga IA. The impact of educators’ teaching styles on secondary school learners’ motivation in English. J Educ Manag Strategy. 2024;3(2):136-44.
- Sheikh A, Mahmood N. Effect of different teaching styles on students’ motivation towards English language learning at secondary level. Sci Int (Lahore). 2014;26:825-30.
- Marina I, Natalia M, Tatiana K, Nataliya S. The influence of the teaching style of communication on the motivation of students to learn foreign languages. J Lang Educ. 2019;5(2):67-77.
- Zalukhu FS, Laoli A, Zebua EP, Daeli H. The influence of teacher teaching styles on English learning motivation of eighth-grade students at SMP Negeri 1 Afulu. J Pembelajaran Bahasa dan Sastra. 2026;5(2):1545-54.
- Yue X, Hou X, Zhang J, Li M. The impact of controlling teaching style on student engagement and academic achievement: Differences across varied motivation profiles. Teach Teach Educ. 2026;176:105479.
- Idhaufi NL, Ashari ZM. Relationship between motivation and teachers’ teaching style among secondary school students in Kulai. Man India. 2017;97(12):299-307.
- Zolfaghari M, Janghorbanian Z, Krevan Brojerdi K, Aghaziarati A. Investigation of the role of teaching styles and student-teacher interaction in students’ academic achievement motivation. Educ Strateg Med Sci. 2020;13(3):220-8.
- Avecilla PA, Capiña XE, Javier AY. Teachers’ teaching style as perceived by students and its influence on students’ level of self-regulation and motivation in learning psychology. Technium Soc Sci J. 2023;43:213-24.
- Khoso AK, et al. The dual forces of AI: How generative AI and perceived AI dependency influence fear of missing out (FoMO) and EFL students’ vocabulary acquisition. J Vis Exp. 2025;(226):e69637.
- Ali JK, Shamsan MA, Hezam TA, Mohammed AA. Impact of ChatGPT on learning motivation: Teachers’ and students’ voices. J Engl Stud Arabia Felix. 2023;2(1):41-9.
- Song C, Song Y. Enhancing academic writing skills and motivation: Assessing the efficacy of ChatGPT in AI-assisted language learning for EFL students. Front Psychol. 2023;14:1260843.
- Khoso AK, et al. Integrating Sustainable Development Goals (SDGs) and generative AI to enhance language digital literacy and creativity in EFL learning environments. J Vis Exp. 2026;(228):e69445.
- Balcı Ö. The role of ChatGPT in English as a foreign language (EFL) learning and teaching: A systematic review. Int J Curr Educ Stud. 2024;3(1):66-82.
- Yamaoka K. ChatGPT’s motivational effects on Japanese university EFL learners: A qualitative analysis. Int J TESOL Stud. 2024;6(3).
- Afkarin MY, Asmara CH. Investigating the implementation of ChatGPT in English language education: Effects on student motivation and performance levels. Journey J Engl Lang Pedagogy. 2024;7(1):57-66.
- Alrabai F. The influence of teachers’ anxiety-reducing strategies on learners’ foreign language anxiety. Innov Lang Learn Teach. 2015;9(2):163-90.
- Kang S, Kim Y. Examining the quality of mobile-assisted video-making task outcomes: The role of proficiency, narrative ability, digital literacy, and motivation. Lang Teach Res. 2024;28(6):2326-53.
- Honggang W, Khoso AK, Althubyani AR. Technostress, digital fatigue, and AI dependency as antecedents of burnout and SDG-4 achievement in EFL classrooms. Sci Rep. 2026;16:15412.
- Sari AA, Ningsih SK. The influence of digital literacy in social media use on high school students’ intrinsic motivation in EFL learning. IDEAS J Engl Lang Teach Learn Linguist Lit. 2025;13(2):6634-51.
- Zhang Y. Impact of digital literacy on college students’ English proficiency: The mediating role of learning motivation and the moderating effect of technological self-efficacy. Acta Psychol (Amst). 2025;259:105452.
- Bender SM. Awareness of artificial intelligence as an essential digital literacy: ChatGPT and Gen-AI in the classroom. Changing Engl. 2024;31(2):161-74.
- Khoso AK, et al. The impact of ESL teachers’ emotional intelligence on ESL students’ academic engagement, reading and writing proficiency: Mediating role of ESL students’ motivation. Int J Early Child Spec Educ. 2022;14:3267-80.
- He M, Abbasi BN, He J. AI-driven language learning in higher education: An empirical study on self-reflection, creativity, anxiety, and emotional resilience in EFL learners. Humanit Soc Sci Commun. 2025;12(1):1-20.
- Wang HC. Exploring the relationships of achievement motivation and state anxiety to creative writing performance in English as a foreign language. Think Skills Creat. 2021;42:100948.
- Khan MA, Mahjabeen AN, Hussain F, Ur Rehman M. Investigating the correlation between writing anxiety and English creativity in Pakistani ESL students. Russ Law J. 2021;9(1):214-24.
- McDonough K, Crawford WJ, Mackey A. Creativity and EFL students’ language use during a group problem-solving task. TESOL Q. 2015;49(1):188-99.
- Rubino C, Luksyte A, Perry SJ, Volpone SD. How do stressors lead to burnout? The mediating role of motivation. J Occup Health Psychol. 2009;14(3):289-304.
- Halbesleben JRB, Bowler WM. Emotional exhaustion and job performance: The mediating role of motivation. J Appl Psychol. 2007;92(1):93-106.
- van Emmerik IJH, et al. The route to employability: Examining resources and the mediating role of motivation. Career Dev Int. 2012;17(2):104-19.
- Dana LP, et al. The impact of entrepreneurial education on technology-based enterprise development: The mediating role of motivation. Adm Sci (Basel). 2021;11(4):105.
- Kholifah N, Nurtanto M, Mutohhari F, et al. The mediating role of motivation and professional development in determining teacher performance in vocational schools. Cogent Educ. 2024;11(1):2421094.
- Güngör P. The relationship between reward management system and employee performance with the mediating role of motivation: A quantitative study on global banks. Procedia Soc Behav Sci. 2011;24:1510-20.
- Danish RQ, Khan MK, Shahid AU, et al. Effect of intrinsic rewards on task performance of employees: Mediating role of motivation. Int J Organ Leadersh. 2015;4:33-46.
- Mavhungu D, Bussin MH. The mediation role of motivation between leadership and public sector performance. SA J Hum Resour Manag. 2017;15(1):1-11.
- Faul F, Erdfelder E, Buchner A, Lang AG. Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behav Res Methods. 2009;41(4):1149-60.
- Rodríguez-de-Dios I, Igartua JJ, González-Vázquez A. Development and validation of a digital literacy scale for teenagers. In: Proceedings of the Fourth International Conference on Technological Ecosystems for Enhancing Multiculturality; 2016. p. 1067-72.
- Abbas M, Jam FA, Khan TI. Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students. Int J Educ Technol High Educ. 2024;21(1):10.
- Grasha AF. Teaching with style: The integration of teaching and learning styles in the classroom. Alliance Publishers; Pittsburgh (PA); 1996.
- Briesmaster M, Briesmaster-Paredes J. The relationship between teaching styles and NNPSETs’ anxiety levels. System. 2015;49:145-56.
- Kanoksilapatham B, et al. Motivation of Thai university students from two disciplinary backgrounds using a hybrid questionnaire. LEARN J Lang Educ Acquis Res Netw. 2021;14(1):455-91.
- Govindasamy P, Cumming TM, Abdullah N. Validity and reliability of a needs analysis questionnaire for the development of a creativity module. J Res Spec Educ Needs. 2024;24(3):637-52.
- Hair JF, Risher JJ, Sarstedt M, Ringle CM. When to use and how to report the results of PLS-SEM. Eur Bus Rev. 2019;31(1):2-24.
- Zhang R, et al. Mediating effect of learning motivation and engagement on the relationship between generative artificial intelligence implementation and English as a foreign language proficiency. 2026. https://doi.org/10.21203/rs.3.rs-9075280/v1.
- Almira NF, Almira ZF, Vircavani C, Agustina E. A systematic review of teachers’ teaching styles and their impact on EFL student learning outcomes. J Appl Linguist Engl Educ. 2025;3(1):1-5.
- Reeve J. Teachers as facilitators: What autonomy-supportive teachers do and why their students benefit. Elem Sch J. 2006;106(3):225-36.
- Huang S, Dong L, Wang W, et al. Language is not all you need: Aligning perception with language models. In: Advances in Neural Information Processing Systems. 2023;36:72096-109.
- Liu L. An international graduate student’s ESL learning experience beyond the classroom. TESL Can J. 2011;29(1):77-92.
- van Laar E, van Deursen AJAM, van Dijk JAGM, De Haan J. The relation between 21st-century skills and digital skills: A systematic literature review. Comput Hum Behav. 2017;72:577-88.
- Al-Kahtani N. A survey assessing health science students’ perceptions of online learning at a Saudi higher education institution during the COVID-19 pandemic. Heliyon. 2022;8(9):e10688.
- Dewaele JM, Chen X, Padilla AM, Lake J. The flowering of positive psychology in foreign language teaching and acquisition research. Front Psychol. 2019;10:2128.
- Liu W, Li Y. A qualitative study of question-posing anxiety in Chinese postgraduates in UK TESOL programs. Sci Rep. 2025;16(1):2081.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.