Este estudo apresenta um framework leve para reduzir alucinações em modelos linguísticos grandes por meio da verificação em nível de afirmação e limiar estatístico adaptativo. Ao corrigir seletivamente afirmações não comprovadas usando Inferência de Linguagem Natural, a abordagem melhora a precisão factual mantendo baixa latência de resposta e eficiência prática de implantação.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Verificação de Alegações Baseada em NLI Adaptativa com Modelagem de Decisão Estatística para a Redução de Alucinações de Baixa Latência em Grandes Modelos de Linguagem
Neste artigo
Resumo
Resumo
Modelos de linguagem grandes (LLMs) apresentam uma tendência crítica de gerar saídas linguisticamente fluentes, mas factualmente incorretas — um fenômeno denominado alucinação — que representa riscos sérios em aplicações que exigem alta precisão. As estratégias atuais de mitigação, incluindo geração aumentada por recuperação e amostragem de autoconsistência, introduzem latência substancial durante a inferência ou dependem de infraestrutura de conhecimento externo, limitando sua aplicabilidade em implantações em tempo real. Este artigo propõe um framework leve de verificação de afirmações em duas etapas, que decompõe as respostas do LLM em afirmações factuais atômicas e verifica independentemente cada afirmação extraída contra uma referência gerada separadamente por meio de um estímulo isolado de recordação factual. Embora o gerador e o verificador compartilhem o mesmo modelo de linguagem subjacente, a separação entre geração de resposta e recordação factual reduz a condicionante direta da resposta e mitiga o viés de confirmação durante a verificação, utilizando Inferência de Linguagem Natural (NLI) e aplicando um limiar estatístico adaptativo — definido como τ = µ + kσ sobre a distribuição dos escores de confiança do NLI — para corrigir seletivamente apenas as afirmações contraditórias. Diferentemente dos métodos anteriores baseados em NLI, que dependem de limites de decisão fixos, o framework proposto adapta dinamicamente seu limiar de verificação à distribuição de confiança de cada resposta, demonstrando desempenho consistente nos benchmarks avaliados, sem necessidade de retravar o modelo. Avaliado nos conjuntos TruthfulQA e FEVER, o framework reduziu a taxa de alucinação de 28% para 9% no TruthfulQA — uma redução relativa de 67,9% — ao adicionar apenas 160 ms de latência adicional em relação ao LLM de referência, superando o SelfCheckGPT e o FActScore em precisão na detecção de alucinações. Esses resultados indicam que o framework pode oferecer um equilíbrio favorável entre confiabilidade factual e latência de resposta nos benchmarks avaliados, embora seja necessária validação adicional em diferentes domínios e configurações de implantação.
Introdução
Modelos de Linguagem de Grande Porte (LLMs) surgiram como componentes fundamentais dos sistemas modernos de inteligência artificial, demonstrando capacidades notáveis em uma ampla gama de tarefas de linguagem natural, incluindo geração de texto, resposta a perguntas, sumarização e raciocínio complexo1. A capacidade deles de produzir respostas fluentes e contextualmente coerentes tem acelerado a adoção em áreas de alto impacto, como apoio à decisão clínica, análise jurídica, engenharia de software e tecnologia educacional2No entanto, uma limitação crítica e persistente compromete sua confiabilidade nesses contextos: a alucinação, na qual os modelos geram respostas fluentes do ponto de vista linguístico, mas factualmente incorretas, sem apoio em evidências ou inteiramente fabricadas³. Estudos empíricos relatam taxas de alucinação variando de 15% a mais de 40%, dependendo da tarefa e do modelo, com sistemas de última geração, como o GPT-4, apresentando inconsistências factuais mensuráveis em avaliações específicas de domínio.2,3. Esta limitação apresenta riscos sérios em aplicações que exigem alta precisão, nas quais saídas incorretas podem levar a informações errôneas, diagnósticos equivocados ou tomadas de decisão deficientes4. As alucinações decorrem fundamentalmente da natureza probabilística dos modelos de linguagem – os LLMs geram tokens prevendo continuidades estatisticamente prováveis de sequências de entrada, ao invés de recuperar ou raciocinar sobre conhecimentos factuais verificados5Como consequência, as saídas geradas podem conter afirmações aparentemente plausíveis, mas incorretas, introduzir asserções sem fundamento ou confundir conceitos semanticamente relacionados, mas factualmente distintos.6.
As estratégias de mitigação existentes abordam esse problema por meio de várias abordagens, cada uma com limitações significativas. A Geração Aumentada por Recuperação (Retrieval-Augmented Generation – RAG) reduz alucinações ao fundamentar as respostas em documentos recuperados externamente, mas introduz uma sobrecarga considerável de latência, exige acesso a bases de conhecimento mantidas e permanece vulnerável a falhas de recuperação em domínios especializados ou com poucos recursos7,8,9.
Embora o gerador de respostas e o gerador de referência sejam instanciados usando o mesmo modelo subjacente GPT-3.5 Turbo, eles operam sob objetivos de estímulo e contextos de execução diferentes. O gerador de respostas produz uma resposta irrestrita à consulta do usuário, enquanto o gerador de referência realiza uma tarefa isolada de recordação factual, sem acesso à resposta previamente gerada. Essa separação reduz os efeitos diretos de condicionamento da resposta e limita o viés de confirmação durante a verificação de afirmações. Assim, o framework trata a referência gerada como proceduralmente independente, e não como estatisticamente independente.
Pesquisas recentes também exploraram estratégias de decodificação leves para reduzir alucinações na geração de texto sem depender de recuperação externa ou verificação repetida. Uma abordagem representativa é a Decodificação por Contraste de Camadas (DoLA), que melhora a factualidade contrastando representações de camadas intermediárias e finais do transformador durante a decodificação. Diferentemente das estruturas de verificação pós-geração, esses métodos intervêm diretamente durante a geração de tokens e, portanto, otimizam uma etapa diferente do processo de geração de linguagem. Essas estratégias complementares demonstram que a mitigação de alucinações pode ser alcançada durante a decodificação ou por meio de verificação pós-geração, com cada abordagem oferecendo trade-offs distintos em termos de sobrecarga computacional, complexidade de implementação e confiabilidade factual.
Métodos de autoconsistência melhoram a confiabilidade factual ao amostrar múltiplas respostas e selecionar a saída mais frequente ou coerente, mas seu custo computacional aumenta linearmente com o número de amostras, tornando-os inadequados para implantações sensíveis à latência8. Abordagens de refinamento iterativo, que revisam repetidamente as saídas por meio de laços de autoavaliação, reduzem progressivamente as taxas de erro, mas ampliam significativamente o tempo de inferência a cada passagem adicional9. Métodos de verificação baseados em inferência natural (NLI) oferecem uma alternativa mais direcionada, ao avaliar a implicação semântica entre afirmações geradas e textos de referência, mas as implementações existentes dependem de limiares de decisão fixos que não conseguem se adaptar a diferentes distribuições de confiança, domínios ou comportamentos de modelos10,11. Em conjunto, essas abordagens ou impõem uma sobrecarga computacional inaceitável, ou dependem de infraestrutura externa, ou carecem da adaptabilidade necessária para implantação generalizada. Uma comparação das principais características dessas abordagens de verificação de alucinações é fornecida na Tabela Suplementar 1.
Este artigo propõe um framework leve de verificação de afirmações em duas etapas, projetado para reduzir alucinações nas saídas de LLMs, mantendo baixa latência de resposta. Na primeira etapa, o LLM gera uma resposta inicial, que é então decomposta em afirmações factuais atômicas. Na segunda etapa, cada afirmação é verificada por meio de Inferência de Linguagem Natural contra uma referência factual gerada separadamente por meio de um raciocínio isolado que não tem acesso à resposta original gerada, e um limiar de confiança derivado estatisticamente rege a decisão de aceitar ou corrigir em nível de afirmação. As principais contribuições deste trabalho são as seguintes: (1) Um pipeline de verificação em nível de afirmação em duas etapas que desacopla a geração de resposta da validação factual, permitindo uma avaliação independente e direcionada de cada afirmação atômica sem necessidade de recuperação externa ou regeneração completa da resposta; (2) Um mecanismo adaptativo de limiarização estatística baseado na distribuição dos escores de confiança de NLI (τ = µ + kσ), que determina dinamicamente os limites de aceitação e correção em vez de depender de regras de decisão fixas, melhorando a robustez em diferentes distribuições de confiança; (3) Uma estratégia de correção seletiva que restringe a regeneração apenas às afirmações classificadas como contraditórias, reduzindo substancialmente o custo computacional em comparação com abordagens de reamostragem completa ou refinamento iterativo; (4) Uma avaliação empírica em um benchmark focado em alucinações, demonstrando que o framework proposto reduz as taxas de alucinação de 28% para 9%, mantendo a latência de resposta dentro de limites práticos para implantação.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo não envolveu participantes humanos, animais, espécimes biológicos ou dados de pacientes. Portanto, a aprovação ética institucional e o consentimento informado não foram necessários.
Visão geral do delineamento do estudo
Um framework de verificação em duas etapas foi implementado para melhorar a confiabilidade factual das saídas de modelos linguísticos grandes (LLM). O procedimento consistiu em geração de respostas, extração de afirmações, construção isolada de referências, verificação baseada em inferência de linguagem natural (NLI), tomada de decisão estatística adaptativa, correção seletiva e montagem final da resposta. O framework foi avaliado utilizando os conjuntos de dados de referência TruthfulQA e FEVER.
Fluxo de trabalho geral
Consulta do usuário → Geração da resposta inicial → Extração de afirmações → Geração independente de referências → Verificação por inferência natural → Cálculo do limiar estatístico → Correção de afirmações → Resposta final verificada. O fluxo geral do framework adaptativo de verificação de afirmações é ilustrado na Figura 1.
Preparação do conjunto de dados
O conjunto de dados TruthfulQA12, contendo 817 perguntas orientadas a fatos, foi baixado e preparado para avaliação. O conjunto de dados FEVER13 compreende 185.445 alegações anotadas rotuladas como Apoiadas, Refutadas ou Informação Insuficiente; a avaliação utilizou os dados de desenvolvimento rotulados com seus campos de alegação, evidência e rótulo de referência. Cada alegação foi avaliada com base em sua evidência fornecida, enquanto o rótulo original do FEVER foi mantido como resultado de referência para verificação. O conjunto de dados FEVER, que contém pares de alegação-evidência para verificação de fatos, foi obtido e pré-processado. As perguntas e alegações de entrada foram convertidas em um formato de texto padronizado. Entradas duplicadas e amostras incompletas foram removidas antes dos experimentos. O TruthfulQA foi dividido em subconjuntos de validação e teste. Aproximadamente 20% das amostras do TruthfulQA (164 perguntas) foram usadas para ajuste de limiar, enquanto as 653 perguntas restantes foram reservadas para avaliação de desempenho. Para o FEVER, as alegações fornecidas pelo benchmark foram usadas diretamente como unidades de verificação e não passaram pelo procedimento de geração de respostas e extração de alegações aplicado ao TruthfulQA. As características dos conjuntos de dados de referência utilizados no desenvolvimento e avaliação do framework são resumidas na Tabela 1.
Geração da resposta inicial
Cada consulta foi enviada ao modelo linguístico base. As respostas foram geradas utilizando amostragem por núcleo com uma temperatura de 0,7 e um top-p de 0,9. O comprimento máximo de saída foi limitado a 256 tokens. As respostas geradas foram armazenadas sem qualquer pós-processamento ou modificação manual. O texto gerado foi encaminhado diretamente para a etapa de extração de afirmações.
Extração de afirmações
Cada resposta gerada foi decomposta em declarações factuais independentemente verificáveis. Utilizou-se um prompt estruturado de decomposição para identificar afirmações atômicas. Declarações compostas foram separadas em unidades factuais mínimas. Opiniões subjetivas, expressões estilísticas e elementos conversacionais irrelevantes foram removidos. Cada afirmação extraída foi armazenada como uma unidade independente de verificação.
Exemplo:
Resposta original:
"Marie Curie foi uma física e química de origem polonesa que realizou pesquisas pioneiras sobre radioatividade."
Afirmações extraídas: (1) Marie Curie nasceu na Polônia; (2) Marie Curie era física e química; (3) Marie Curie realizou pesquisas sobre radioatividade.
Construção de referência isolada:
Para cada afirmação extraída, foi gerada uma referência factual independente. O modelo verificador recebeu apenas a consulta original do usuário. O acesso à resposta original gerada foi restrito para evitar viés de confirmação. Foi utilizado um estímulo de recordação factual para incentivar respostas concisas e baseadas em evidências. As referências geradas foram armazenadas para verificação subsequente.
Verificação da inferência de linguagem natural
Cada par alegação-referência foi submetido a um modelo NLI pré-treinado. O modelo NLI classificou a relação como: Implicação, Neutro ou Contradição. Foram registradas as probabilidades de confiança para as três classes. Uma pontuação de verificação com sinal foi atribuída: valor positivo para implicação, zero para neutro ou valor negativo para contradição. Todas as pontuações de verificação foram coletadas para o cálculo do limiar.
Cálculo adaptativo de limiar estatístico
A confiança na verificação produzida pelo modelo NLI varia substancialmente entre as respostas, pois diferentes consultas geram números distintos de afirmações, níveis de complexidade semântica e distribuições de confiança. Um limiar global fixo assume que todas as respostas seguem um perfil de confiança semelhante, o que raramente é observado na prática. Para acomodar essa variabilidade, o framework proposto estima o limite de decisão individualmente para cada resposta, utilizando a média e o desvio padrão de suas pontuações de verificação. A média reflete o nível geral de confiança da resposta, enquanto o desvio padrão captura a dispersão dos valores de confiança entre as afirmações extraídas. Essa formulação adaptativa permite que o critério de aceitação se ajuste à incerteza específica de cada resposta, em vez de depender de um único limiar para todas as entradas.
A média (µ) e o desvio padrão (σ) de todas as pontuações de verificação com sinal foram calculadas.
O limiar de decisão adaptativo foi calculado como:

em que τ representa o limiar adaptativo, µ denota a pontuação média de verificação, σ denota o desvio padrão e k representa o parâmetro de sensibilidade.
O parâmetro de sensibilidade foi inicializado em 0,7. As alegações classificadas como Implicação com pontuações maiores ou iguais a +τ foram aceitas. As alegações classificadas como Contradição com pontuações menores ou iguais a −τ foram marcadas para correção. As alegações com pontuações dentro do intervalo (−τ, +τ) foram mantidas como neutras.
Correção seletiva de alegações
Uma alegação foi encaminhada para correção apenas quando o modelo NLI classificou o par alegação-referência como Contradição, e sua pontuação de verificação com sinal correspondente atendeu ao critério adaptativo de limite si ≤ -τ. Assim, a decisão de correção foi determinada conjuntamente pelo rótulo da classe NLI e pelo limite estatístico específico da resposta. Alegações classificadas como Implicação com si ≥ τ foram aceitas, enquanto as alegações que caíram no intervalo -τ < si < τ foram tratadas como neutras e mantidas sem correção. Esse critério combinado garantiu que a correção fosse aplicada apenas a alegações que exibissem tanto contradição semântica quanto evidência negativa de verificação suficientemente forte.
Reconstrução da resposta
As reivindicações aceitas e corrigidas foram organizadas em sua sequência original. Os limites das sentenças foram restaurados para manter a legibilidade. Ajustes gramaticais menores foram aplicados quando necessário. A saída montada foi armazenada como a resposta final verificada.
Avaliação de desempenho
A estrutura foi avaliada utilizando quatro métricas: (1) Precisão: a proporção de respostas que permaneceram factualmente corretas após a verificação; (2) Pontuação F1: a média harmônica da precisão e da sensibilidade na detecção de alucinações; (3) Latência da Resposta: o tempo total de processamento desde o envio da consulta até a geração da resposta verificada; (4) Taxa de Alucinação
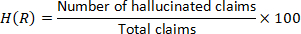
A latência foi relatada como o tempo médio de execução ao longo de medições repetidas. Como os valores individuais de latência por execução não foram mantidos, desvios padrão e intervalos de confiança não foram calculados.
Avaliação da correção específica do conjunto de referência
Para o TruthfulQA, a resposta final verificada foi comparada com as referências de respostas validadas por humanos do benchmark e com listas de respostas incorretas. Uma resposta foi considerada correta quando suas afirmações factuais eram consistentes com as informações da resposta aceita e não continham conteúdo correspondente aos padrões identificados de respostas incorretas. Para o FEVER, cada alegação na saída final foi avaliada com base em sua evidência associada e na anotação original do FEVER; alegações suportadas foram consideradas como verificadas factualmente, enquanto alegações refutadas foram contabilizadas como incorretas. Os casos de Informação Insuficiente foram mantidos como indeterminados, em vez de serem tratados como evidência factual positiva. As decisões resultantes em nível de alegação foram agregadas em cada benchmark para calcular a Acurácia e a Taxa de Alucinação informadas.
Ambiente experimental
O framework foi implementado usando Python 3.9. As operações de processamento de dados foram realizadas usando bibliotecas de análise numérica e tabular. O modelo NLI operou em modo de inferência sem ajuste fino adicional. Os experimentos foram executados em uma estação de trabalho equipada com um processador Intel Core i5, 16 GB de RAM e um sistema operacional de 64 bits. Todas as avaliações foram conduzidas usando uma configuração de inferência de passagem única para garantir operação com baixa latência. Todos os experimentos foram realizados usando configurações idênticas de hardware e software para assegurar avaliação consistente entre conjuntos de dados e métodos de referência.
Resultado esperado
O protocolo foi projetado para gerar decisões de verificação em nível de afirmação, identificando afirmações potencialmente não comprovadas e encaminhando seletivamente as afirmações fortemente contradizidas para correção. A saída esperada é uma resposta verificada com inconsistências factuais reduzidas e sobrecarga de processamento adicional limitada, sujeita ao desempenho observado durante a avaliação experimental.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Geração da resposta inicial
O modelo de linguagem de referência gerou respostas fluentes e contextualmente relevantes para perguntas de ambos os conjuntos de dados de referência. No entanto, um exame detalhado revelou afirmações não comprovadas e factualmente incorretas em várias respostas. No conjunto de dados TruthfulQA, o sistema de referência apresentou uma taxa de alucinação de 28%, enquanto uma taxa de alucinação de 26% foi observada no conjunto de dados FEVER. Esses res...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
O framework proposto melhorou o desempenho na verificação factual, ao mesmo tempo que evitou amostragem repetida e recuperação externa. Em TruthfulQA, a taxa de alucinação diminuiu de 28% para o LLM de referência para 9% com o framework completo, enquanto a precisão aumentou de 0,72 para 0,87. Em FEVER, a taxa de alucinação caiu de 26% para 10%, com precisão aumentando de 0,74 para 0,89. Essas comparações devem ser interpretadas dentro das configurações experimentais e implementações utilizadas neste estudo, e não como e...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm conflitos de interesse a declarar.
Agradecimentos
Os autores gostariam de expressar sua sincera gratidão à sua instituição pelo fornecimento do ambiente acadêmico e dos recursos computacionais necessários para realizar esta pesquisa. Os autores também agradecem aos desenvolvedores e mantenedores dos conjuntos de dados de referência de acesso público utilizados neste estudo, que permitiram uma avaliação abrangente do framework proposto. Aprecia-se a colaboração de colegas e revisores pelo feedback construtivo, que ajudou a melhorar a qualidade e a clareza deste trabalho. Os autores agradecem ainda à comunidade de pesquisa de código aberto pelo fornecimento das bibliotecas e ferramentas de software que facilitaram a experimentação, a análise de dados e a visualização dos resultados. Seus esforços contínuos têm avançado significativamente a pesquisa em processamento de linguagem natural e inteligência artificial confiável. Os autores declaram que nenhum apoio financeiro externo ou financiamento foi recebido para esta pesquisa.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Conjunto de dados de referência FEVER | Tarefa Compartilhada FEVER (Thorne et al.) | https://fever.ai/dataset/fever.html | Conjunto de dados público de pares alegação-evidência para verificação de fatos, usado para avaliação |
| GPT-3.5 Turbo (grande modelo linguístico B10+2:12:12 | OpenAI | Model ID: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | Utilizado tanto como gerador de respostas quanto como gerador de referência independente, acessado por meio da API OpenAI |
| NumPy | Desenvolvedores do NumPy (código aberto) | https://numpy.org/ | Biblioteca de computação numérica usada para cálculos estatísticos, incluindo média e desvio padrão dos escores de verificação NLI |
| Openai (biblioteca cliente Python) | OpenAI | https://github.com/openai/openai-python | Biblioteca cliente Python usada para enviar prompts e recuperar conclusões do GPT-3.5 Turbo |
| pandas | Equipe de Desenvolvimento do pandas (código aberto) | https://pandas.pydata.org/ | Biblioteca de análise de dados tabulares usada para pré-processamento do conjunto de dados e manipulação dos resultados |
| Modelo de classificação pré-treinado de Inferência de Linguagem Natural (NLI) | Model Hub da Hugging Face (modelo baseado na arquitetura DeBERTa-v3-large da Microsoft) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Utilizado em modo de inferência, sem ajuste fino, para classificar cada par alegação-referência como implicação, neutralidade ou contradição |
| Python | Python Software Foundation | Versão 3.9; https://www.python.org/downloads/release/python-390/ | Linguagem de programação principal usada para implementar o framework de verificação |
| SciPy | Desenvolvedores do SciPy (código aberto) | https://scipy.org/ | Biblioteca de computação científica usada para apoiar a análise estatística dos resultados experimentais |
| Transformers (biblioteca Hugging Face Transformers) | Hugging Face | https://github.com/huggingface/transformers | Biblioteca Python usada para carregar e executar o modelo NLI pré-treinado |
| Conjunto de dados de referência TruthfulQA | Originalmente publicado por Lin, Hilton e Evans | https://github.com/sylinrl/TruthfulQA | Conjunto de dados de referência público com 817 perguntas orientadas a fatos, usado para ajuste de limiar e avaliação |
| Computador workstation | Não especificado no manuscrito (por favor, confirme fabricante/modelo) | Processador Intel Core i5; 16 GB de RAM; sistema operacional de 64 bits | Hardware utilizado para executar todos os experimentos em configurações idênticas |
| Observação: Todos os URLs listados acima foram verificados e confirmados ativos na data desta tabela. |
Referências
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Reimpressões e permissões
Este artigo foi publicado
Vídeo em breve