Este artigo apresenta uma estrutura baseada em CNN explicável para classificação de lesões cutâneas que combina alta precisão diagnóstica com interpretabilidade do modelo. Ele classifica imagens de lesões e gera explicações visuais para suas previsões. Os resultados demonstram um desempenho robusto e uma transparência aprimorada, apoiando a tomada de decisões clínicas e auxiliando dermatologistas na detecção precoce de doenças de pele.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Um Framework de Apoio Computacional Explicável para Classificação de Lesões Cutâneas Utilizando Aprendizagem Profunda
Neste artigo
Resumo
Resumo
A utilização de redes neurais convolucionais profundas com a finalidade de diagnosticar doenças na área da pele demonstrou apresentar níveis de precisão semelhantes aos obtidos por dermatologistas em diversos estudos. No entanto, muitos desafios ainda persistem, incluindo desempenho inferior e baixa generalização em alguns casos, além de baixa interpretabilidade relacionada ao uso de modelos do tipo caixa-preta. Isso cria grandes obstáculos para a implementação prática, uma vez que se exige explicabilidade além de diagnósticos precisos, tornando necessário encontrar uma solução. Para superar as dificuldades mencionadas, um framework explicável de aprendizado profundo para classificação de lesões cutâneas (EDLF-SLC) foi desenvolvido neste estudo. O framework utiliza diversas abordagens em aprendizado de máquina e inteligência artificial explicável (XAI) para garantir melhorias tanto em precisão quanto em interpretabilidade, de maneira dividida em três etapas. Na etapa inicial, representações profundas extraídas de múltiplas arquiteturas de CNN pré-treinadas são fundidas para preservar informações discriminativas complementares aprendidas por diferentes arquiteturas de rede antes da classificação, utilizando uma SVM com kernel de função de base radial. Em seguida, classificadores de Máquina de Vetores de Suporte (SVM) com kernel de função de base radial são utilizados para classificar as características obtidas. Por fim, as previsões realizadas pelo modelo são interpretadas por meio de explicações locais, interpretáveis e independentes de modelo (LIME). Os resultados experimentais mostram que o EDLF-SLC atinge 88,0% de precisão, 89,0% de exatidão, 87,0% de revocação e 88,0% de pontuação F1, demonstrando desempenho competitivo em comparação com diversos métodos recentemente relatados nas condições experimentais consideradas neste estudo.
Introdução
Lesões cutâneas são uma preocupação importante em dermatologia e oncologia, pois variam desde anormalidades benignas até cânceres malignos, como o melanoma, a forma mais letal de câncer de pele. Em 2020, o melanoma representou aproximadamente 325.000 novos casos e mais de 57.000 mortes em todo o mundo1. Embora os avanços no rastreamento e tratamento tenham melhorado os resultados para os pacientes, o diagnóstico tardio e o acesso limitado aos cuidados de saúde continuam contribuindo para a alta mortalidade e perda de anos de vida, especialmente entre populações mais jovens2,3.
O diagnóstico tradicional baseia-se principalmente no exame visual e na dermatoscopia, tornando o processo dependente da expertise dos clínicos e suscetível à subjetividade, variabilidade entre observadores, biópsias desnecessárias e tempos prolongados de exame4,5,6. Para superar essas limitações, a aprendizagem profunda, particularmente as CNNs, surgiu como uma solução eficaz para a classificação automatizada de lesões cutâneas. Modelos baseados em CNN, incluindo DDCNN-F7, YOLOv7-XAI8 e diversas outras arquiteturas9,10,11,12,13, demonstraram alta precisão diagnóstica ao aprender automaticamente características discriminativas das imagens. Apesar do seu sucesso, a maioria dos modelos de aprendizagem profunda opera como "caixas pretas", limitando a confiança dos clínicos e dificultando sua adoção na prática médica rotineira. Técnicas de inteligência artificial explicável foram, portanto, introduzidas para melhorar a transparência dos modelos, fornecendo explicações visuais das previsões. Entre esses métodos, as Explicações Locais, Interpretáveis e Agnósticas em relação ao Modelo geram explicações locais interpretáveis ao identificar as regiões da imagem que mais influenciam as decisões do modelo14.
A classificação de lesões cutâneas evoluiu desde a avaliação clínica tradicional até sistemas diagnósticos avançados baseados em IA, impulsionada pela necessidade de detecção precisa, confiável e precoce do câncer de pele. Essa evolução percorreu cinco estágios principais — métodos diagnósticos tradicionais, diagnóstico assistido por computador (CAD), aprendizado de máquina (ML), aprendizado profundo (DL) e, mais recentemente, IA explicável (XAI) e aprendizado federado (FL) — refletindo esforços contínuos para melhorar a precisão diagnóstica, a consistência, a escalabilidade e a confiabilidade clínica, ao mesmo tempo que supera as limitações do exame convencional. Os primeiros métodos computacionais tentaram emular o raciocínio clínico por meio de descritores de imagem manualmente elaborados derivados da regra ABCD, incluindo assimetria, irregularidade de borda, variação de cor e diâmetro da lesão. Essas características foram combinadas com redes bayesianas, árvores de decisão, sistemas especialistas e modelos de inferência difusa para auxiliar no diagnóstico de melanoma, com diversos estudos relatando precisões de classificação superiores a 90%15,16,17. Apesar de terem fornecido uma base importante para o diagnóstico auxiliado por computador, esses métodos dependiam inteiramente de características manualmente projetadas e regras diagnósticas pré-definidas. Consequentemente, apresentavam robustez limitada frente a variações na qualidade da imagem, morfologia da lesão, iluminação e condições de aquisição.
Para superar essas limitações, os sistemas clássicos de CAD surgiram como uma etapa intermediária entre a análise convencional de imagens e as estruturas modernas baseadas em IA. Os sistemas de CAD combinaram extração de características manual com classificadores convencionais para melhorar a consistência diagnóstica e auxiliar na tomada de decisões clínicas. Diversas abordagens híbridas integraram agrupamento hierárquico com redes neurais recorrentes e arquiteturas de memória de curto e longo prazo, alcançando precisões de classificação próximas a 99,5%18. Outras estruturas baseadas em CAD incorporaram classificadores por reforço de gradiente com explicações baseadas em SHAP, demonstrando precisão diagnóstica competitiva enquanto aumentavam a transparência do modelo19. Embora esses sistemas representassem uma melhoria significativa em relação às abordagens puramente baseadas em regras, continuaram a depender fortemente da extração manual de características, pré-processamento extenso, conjuntos de dados cuidadosamente anotados e pipelines de processamento multifásicos.
Técnicas de aprendizado de máquina aprimoraram ainda mais a classificação automatizada de lesões cutâneas ao permitir um aprendizado baseado em dados, em vez de um design explícito de regras. Estruturas híbridas que combinam redes neurais convolucionais com classificadores de aprendizado de máquina convencionais, incluindo regressão logística e k-vizinhos mais próximos, demonstraram alto desempenho de classificação em conjuntos de dados de referência, alcançando precisões superiores a 95%9. O aprendizado multimodal auto-supervisionado aprimorou ainda mais a representação de características ao explorar conjuntamente imagens dermatoscópicas e clínicas, reduzindo assim a dependência de anotações manuais extensivas enquanto melhora o desempenho da classificação20. Estudos adicionais combinaram CNNs com análise discriminante generalizada, descritores SURF e algoritmos de otimização para melhorar a discriminação de características e a precisão da classificação21. Técnicas de seleção automática de características que empregam DenseNet-201, InceptionV3 e algoritmos de otimização por árvore binária aprimoraram ainda mais a representação de características, mantendo um desempenho diagnóstico competitivo22. Abordagens de aprendizado por transferência que utilizam arquiteturas pré-treinadas, como AlexNet e GoogLeNet, também demonstraram capacidade promissora de classificação, mesmo com dados de treinamento limitados23. No entanto, a maioria dos métodos de aprendizado de máquina continuou dependendo de procedimentos de pré-processamento cuidadosamente projetados, estratégias de otimização manuais, conjuntos de dados balanceados e ajuste extensivo de hiperparâmetros. Sua validação externa limitada e sensibilidade ao desequilíbrio de classes restringiram ainda mais sua aplicabilidade prática em diferentes contextos clínicos.
A introdução do DL transformou fundamentalmente a classificação automatizada de lesões cutâneas ao permitir o aprendizado end-to-end diretamente a partir de dados de imagem brutos. As CNNs eliminaram a necessidade de engenharia de características manual, ao mesmo tempo que melhoraram substancialmente o desempenho diagnóstico em diversos conjuntos de dados de referência. A maioria das abordagens baseadas em CNN demonstrou melhorias significativas na classificação de lesões por meio de arquiteturas cada vez mais sofisticadas. Modelos de CNN sensíveis à simetria exploraram características clinicamente relevantes das lesões, mas alcançaram apenas uma precisão balanceada moderada24. Outros integraram arquiteturas EfficientNet com explicações LIME e SHAP para melhorar a interpretabilidade, ao mesmo tempo que introduziram medidas quantitativas de confiabilidade25. Sistemas híbridos de DL que combinam segmentação de lesões, aprendizado em conjunto e CNNs alcançaram excelente desempenho em múltiplos conjuntos de dados ISIC, mas permaneceram sensíveis à qualidade da segmentação e ao desequilíbrio de classes26.
Mais recentemente, arquiteturas híbridas cada vez mais sofisticadas têm aprimorado ainda mais a precisão de classificação ao integrar técnicas complementares de aprendizado profundo. Redes adversárias generativas condicionais combinadas com YOLOv5 e análise de componentes independentes alcançaram precisões de classificação superiores a 99%, embora sua complexidade computacional tenha limitado a implantação prática 27. Da mesma forma, arquiteturas híbridas LSTM–ResNet aprenderam efetivamente representações espaço-temporais, mas exigiram recursos computacionais substancialmente maiores28. Modelos baseados em transformadores, incluindo o Sap-Former, exploraram informações contextuais globais para aprimorar a representação de características, mas exigiram pré-processamento extensivo, conjuntos de dados anotados em larga escala e grande poder computacional29. Alternativas leves, como a S-MobileNet, tentaram equilibrar eficiência computacional com precisão diagnóstica30, enquanto métodos de adaptação de domínio não supervisionados melhoraram a generalização entre domínios, apesar da eficácia reduzida quando disponíveis apenas amostras limitadas de treinamento31. Redes híbridas aprimoradas por mecanismos de atenção, incorporando módulos modificados de atenção convolucional e aprendizado por conjunto de instantâneos, também demonstraram desempenho promissor na classificação de lesões cutâneas de varíola dos macacos, embora desafios associados ao desequilíbrio de classes, diversidade de imagens e baixa explicabilidade permaneçam sem solução32. Arquiteturas residuais personalizadas, empregando designs de rede mais profundos e funções de perda híbridas, aprimoraram ainda mais a precisão de classificação além de 99%, mas acarretaram sobrecarga computacional e tempo de treinamento consideravelmente maiores33. Estudos de revisão abrangentes concluíram consistentemente que o aprendizado profundo supera substancialmente as abordagens tradicionais baseadas em características manualmente projetadas, ao aprender automaticamente representações discriminativas de imagens, identificando simultaneamente desafios persistentes associados a artefatos de imagem, variabilidade de iluminação, complexidade computacional e limitada generalização clínica34.
Embora o aprendizado profundo (DL) tenha melhorado drasticamente a precisão diagnóstica, preocupações sobre a transparência do modelo, estimativa de incerteza e implantação clínica confiável têm estimulado um crescente interesse na explicação de IA (XAI) e no aprendizado federado. Vários estudos investigaram técnicas de quantificação de incerteza, incluindo predição conforme, dropout de Monte Carlo e aprendizado profundo evidencial, demonstrando que uma estimativa confiável de confiança pode melhorar substancialmente o suporte à decisão, apesar de impor restrições adicionais computacionais e relacionadas a dados35. Também foram propostas estruturas de aprendizado mútuo baseadas em transformadores para lidar com o desequilíbrio de classes, ao mesmo tempo que melhoram a eficiência da aprendizagem de características36. Outras abordagens combinaram CNNs de resolução total com técnicas de otimização baseadas em grafos para melhorar a segmentação e classificação de lesões37, enquanto estruturas híbridas de aprendizado profundo que integram múltiplas representações complementares de características alcançaram precisões de classificação próximas a 99,5%, apesar de exigirem pré-processamento extensivo38.
Pesquisas recentes têm se concentrado cada vez mais na integração da explicabilidade diretamente nos frameworks de aprendizado profundo (DL) para aumentar a confiança dos clínicos e facilitar a adoção clínica prática. Sistemas explicáveis que empregam múltiplas arquiteturas de redes neurais convolucionais juntamente com Grad-CAM e Score-CAM localizaram com sucesso regiões de lesões clinicamente relevantes, mantendo um desempenho competitivo de classificação em conjuntos de dados internos e externos39. Frameworks híbridos CNN–Transformer que combinam imagens dermatoscópicas com metadados clínicos aprimoraram ainda mais o desempenho preditivo, utilizando SHAP e Grad-CAM para gerar explicações visuais clinicamente significativas40. Outras arquiteturas híbridas baseadas em transformadores, integrando EfficientNetV2S, Swin Transformers, redes Xception modificadas e mecanismos de atenção em grafos, capturaram eficazmente características complementares globais e locais das lesões, embora sua grande quantidade de parâmetros e desempenho limitado em classes minoritárias tenham restringido a implantação prática41. Da mesma forma, frameworks híbridos YOLOv8–Transformer de Visão demonstraram melhorias na localização de lesões, classificação multiclasse e interpretabilidade visual por meio de aumento adaptativo juntamente com explicações SHAP e Grad-CAM; no entanto, esses métodos continuaram a depender principalmente de conjuntos de dados de referência e exibiram robustez limitada para categorias minoritárias de lesões42. Vários artigos de revisão resumiram esses avanços, enfatizando tanto os notáveis progressos alcançados pelas técnicas modernas de aprendizado profundo quanto os desafios persistentes relacionados à eficiência computacional, explicabilidade, dependência de conjuntos de dados e validação clínica43,44,45. Tabela 1 resume alguns trabalhos publicados recentemente que utilizam algoritmos de aprendizado profundo para classificação de lesões cutâneas.
Apesar dos notáveis avanços alcançados pelos métodos recentes de aprendizado profundo na classificação de lesões cutâneas, a maioria das abordagens existentes permanece limitada pela alta complexidade computacional, dependência de grandes conjuntos de dados anotados, baixa interpretabilidade do modelo e validação insuficiente em diversos ambientes clínicos do mundo real. Para superar essas limitações, este artigo propõe o framework EDLF-SLC, que integra características complementares extraídas de múltiplas arquiteturas CNN com um classificador SVM para uma classificação robusta e precisa. O framework emprega ainda um pré-processamento aprimorado para melhorar a qualidade da imagem e lidar com o desequilíbrio entre classes, além de incorporar a técnica LIME para fornecer explicações visuais das previsões individuais, aumentando assim a transparência do modelo e a confiança clínica.
As contribuições deste estudo são triplices. Primeiro, os autores propõem um framework robusto, EDLF-SLC, que integra redes neurais convolucionais avançadas (CNNs) com um classificador máquina de vetores de suporte (SVM) para alcançar uma classificação precisa e confiável de lesões cutâneas. Segundo, os autores implementam técnicas aprimoradas de pré-processamento para lidar com o desequilíbrio de classes e reduzir o ruído nas imagens, melhorando assim a qualidade das imagens de entrada e o desempenho geral do modelo de classificação. Terceiro, os autores incorporam o método Local Interpretable Model-agnostic Explanations (LIME) para visualizar e interpretar predições individuais do modelo, destacando as regiões da imagem que mais fortemente influenciam as decisões de classificação, aumentando assim a transparência e a interpretabilidade do framework proposto.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo não envolveu a recrutamento de participantes humanos nem a coleta de dados identificáveis de pacientes. Todos os experimentos foram realizados utilizando o conjunto de dados público de lesões cutâneas ISIC 2020 obtido do repositório Kaggle; portanto, não foi necessária a aprovação do comitê de ética institucional nem o consentimento informado. Todos os materiais utilizados neste estudo estão na Tabela de Materiais.
Extração e fusão de características
As imagens de lesões cutâneas foram processadas utilizando múltiplos modelos de CNN pré-treinados. Vetores de características profundas extraídos das arquiteturas de CNN pré-treinadas selecionadas são concatenados para construir uma representação unificada de características para cada imagem de lesão cutânea. A estratégia de fusão adotada preserva informações visuais complementares aprendidas por diferentes arquiteturas de CNN, permitindo que o classificador SVM subsequente explore tanto características de textura de baixo nível quanto representações semânticas de nível superior. Embora técnicas de redução de dimensionalidade, como análise de componentes principais ou seleção de características baseada em informação mútua, possam reduzir a dimensionalidade das características, a representação completa fundida foi intencionalmente mantida porque o espaço de características fundido permanece computacionalmente tratável para o classificador RBF-SVM empregado, ao mesmo tempo que preserva informações diagnósticas complementares extraídas dos diferentes modelos de base CNN.
Classificação
Os vetores de características fundidos foram utilizados para treinar um classificador SVM com um kernel RBF. Técnicas de otimização de hiperparâmetros foram empregadas para determinar as configurações ideais de classificação. O classificador então categorizou lesões cutâneas em suas respectivas classes.
Explicabilidade
Para melhorar a interpretabilidade, o LIME foi aplicado para gerar explicações visuais que destacam as regiões da imagem que contribuem de forma mais significativa para os resultados da classificação. Essas explicações ajudariam os clínicos a compreender e validar as decisões do modelo.
Plano de avaliação
A estrutura proposta foi avaliada utilizando um conjunto de dados de referência de lesões cutâneas. O desempenho foi avaliado por meio de Acurácia, Precisão, Revocação (Recall) e Pontuação F1. Foram realizados experimentos comparativos contra abordagens existentes de aprendizado de máquina e aprendizado profundo para demonstrar a eficácia da estrutura proposta.
Resultados esperados
Esperava-se que o estudo produzisse um sistema preciso e interpretável de classificação de lesões cutâneas. Resultados experimentais preliminares indicam que o EDLF-SLC alcança uma acurácia de 88,0%, precisão de 89,0%, revocação de 87,0% e pontuação F1 de 88,0%, superando diversos métodos concorrentes. A integração de explicações LIME foi considerada capaz de aumentar a confiabilidade e facilitar a adoção de sistemas diagnósticos assistidos por IA na prática clínica.
Significância
Esta pesquisa contribui para o campo em expansão da inteligência artificial explicável em saúde, abordando desafios de desempenho e transparência no diagnóstico de lesões cutâneas. A estrutura proposta tem o potencial de auxiliar dermatologistas a tomarem decisões diagnósticas mais confiáveis e interpretáveis, melhorando, em última instância, o atendimento ao paciente. Além disso, nesta seção, os autores forneceram informações sobre os materiais e a metodologia aplicados neste estudo de pesquisa. Especificamente, os autores iniciaram com a descrição do conjunto de dados utilizado nos experimentos e avançaram para a discussão detalhada do Framework de Aprendizado Profundo Explicável para Classificação de Lesões Cutâneas.
Conjunto de dados
O trabalho apresentado baseia-se no conjunto de dados ISIC 2020 (International Skin Imaging Collaboration), disponível publicamente e acessível no site do Kaggle (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). O repositório ISIC é reconhecido como um dos melhores recursos na área de imagens dermatológicas, pois fornece uma grande variedade de imagens dermatoscópicas de diferentes tipos de lesões cutâneas, conforme mostrado na Figura 1. Importante destacar que o conjunto de dados inclui imagens de condições tanto benignas quanto malignas, tornando-o útil para a realização de tarefas de classificação binária de câncer de pele 46. O conjunto de dados atual contém 3.297 imagens, das quais 1.800 são benignas e 1.497 são malignas. Para experimentos mais eficientes, os dados precisaram ser divididos em um conjunto de treinamento e um conjunto de testes. Em particular, há 2.637 imagens de treinamento, incluindo 1.440 benignas e 1.197 malignas, enquanto o conjunto de testes consiste em 660 imagens, das quais 360 são benignas e 300 são malignas. Um resumo do conjunto de dados é apresentado na Tabela 2.
O modelo EDLF-SLC proposto
Neste artigo, foi proposta uma solução eficiente e compreensível para classificar lesões cutâneas em categorias benignas e malignas, utilizando uma nova técnica de aprendizado profundo explicável baseada em uma abordagem híbrida que combina as vantagens de múltiplos modelos de redes neurais convolucionais pré-treinados. As redes neurais convolucionais demonstraram-se altamente eficazes na extração de características semânticas de alto nível de imagens médicas. Aproveitando essa capacidade, o framework de aprendizado profundo explicável proposto para classificação de lesões cutâneas (EDLF-SLC) utiliza múltiplos modelos de CNN pré-treinados para alcançar um desempenho superior. Para garantir a transparência necessária no processo de tomada de decisão médica, foi adotado o LIME na abordagem proposta, a fim de gerar explicações locais legíveis por humanos para os resultados obtidos. O framework completo pode ser dividido em três etapas principais, conforme ilustrado na Figura 2, a saber: (1) pré-processamento dos dados, (2) extração de características e classificação, e (3) interpretabilidade.
Arquitetura e integração do modelo
Como etapa preliminar, sete modelos populares de aprendizado profundo (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge e MobileNet) foram selecionados e avaliados separadamente no conjunto de dados de validação, e os quatro modelos mais eficazes (ResNet50, EfficientNetB0, MobileNet e Xception) foram escolhidos para a etapa de extração de características. No framework proposto, cada imagem de entrada x é passada independentemente pelos modelos pré-treinados selecionados. A última camada totalmente conectada foi removida de cada um desses modelos, e vetores de características foram obtidos a partir das camadas anteriores. fResNet50(x), fEfficientNetB0(x), fMobileNet(x) e fXception(x) referem-se aos vetores de características de saída de cada um dos modelos mencionados acima. Ao concatenar esses vetores de características, obtém-se um novo vetor de características agregado F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
Posteriormente, F(xi) foi submetido a um classificador SVM com um kernel de função de base radial (RBF) para obter o resultado da classificação. Todo o algoritmo da estrutura proposta é apresentado no Arquivo Suplementar 1.
A estrutura proposta adota a fusão direta no nível de características, pois cada arquitetura de CNN pré-treinada capta características discriminativas diferentes das lesões cutâneas por meio de sua arquitetura de rede distinta e hierarquia de características aprendidas. Consequentemente, a concatenação dessas representações heterogêneas de características preserva informações complementares que contribuem para uma caracterização mais abrangente da lesão antes da classificação. Embora técnicas de redução de dimensionalidade, como a análise de componentes principais (PCA) ou a seleção de características baseada em informação mútua, possam reduzir a dimensionalidade da representação fundida, o vetor completo de características fundidas foi intencionalmente mantido, pois sua dimensionalidade permanece computacionalmente tratável para o classificador RBF-SVM adotado, ao mesmo tempo que preserva informações diagnósticas complementares extraídas pelos diferentes backbones de CNN. Assim, este projeto prioriza a manutenção de representações profundas complementares em vez de eliminar características potencialmente informativas antes da classificação.
Preparação dos dados
A preparação dos dados incluiu o pré-processamento e a divisão do conjunto de dados em conjuntos de treinamento e teste. O pré-processamento tem como objetivo melhorar a qualidade dos dados eliminando inconsistências, removendo elementos duplicados, formatando as imagens de entrada e realizando a normalização de características para um treinamento estável de um bom modelo. Todas as imagens foram normalizadas para a faixa [−1, 1] por meio da normalização Z-score:
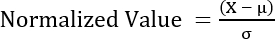 (2)
onde µ e σ representam o valor médio e o desvio padrão da imagem correspondente, respectivamente. O conjunto de dados foi dividido em dois subconjuntos, ou seja, um conjunto de treinamento (70,0%) e um conjunto de teste (30,0%).
Aumento de dados
Para evitar o sobreajuste e aumentar a capacidade de generalização do modelo, algumas técnicas de aumento foram utilizadas para o conjunto de treinamento. Os aumentos de imagens envolvem a modificação de imagens para expandir artificialmente o conjunto de dados sem alterar características essenciais das condições médicas. O pipeline de aumento foi construído utilizando a API Sequencial do Keras. Transformações como inversão horizontal aleatória, rotação dentro de um pequeno ângulo, redimensionamento, escalonamento, ajuste de brilho/contraste, zoom e pequenos deslocamentos foram utilizadas. Exemplos representativos de imagens aumentadas são ilustrados na Figura 3.
Modelos pré-treinados
Vários modelos de aprendizado profundo pré-treinados foram adotados na estrutura proposta para extração de características de imagens de entrada. Esses modelos incluem MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 e MobileNetV2. O MobileNet e o MobileNetV2 são modelos de aprendizado profundo leves, projetados para cálculos eficientes por meio de convoluções separáveis por profundidade. O ResNet50 utiliza o mecanismo de conexões residuais para treinar o modelo, evitando assim o problema do gradiente que desaparece durante o treinamento. O EfficientNetB0 alcança um equilíbrio entre eficiência e precisão por meio da abordagem de escalonamento composto. O Xception estende a rede Inception utilizando convoluções separáveis por profundidade. O NASNetLarge envolve o uso de busca de arquitetura neural para construir estruturas ótimas de redes neurais profundas, enquanto o Inception-ResNet-v2 combina o modelo Inception com o mecanismo de conexões residuais. Vetores de características extraídos do ResNet50 (1.024 características), EfficientNetB0 (1.280 características), MobileNet (1.024 características) e Xception (2.048 características) são concatenados para produzir uma representação unificada de 5.376 dimensões. Essa estratégia de fusão foi escolhida para preservar representações complementares aprendidas pelas diferentes arquiteturas de CNN, em vez de reduzir a representação antes da classificação. O vetor de características resultante é posteriormente fornecido ao classificador RBF-SVM, que determina o limite de decisão não linear ótimo dentro do espaço de características fundido.
Modelo de IA explicável (LIME)
Para fornecer alguma interpretabilidade local das previsões do modelo, os autores adotam o método de gerar explicações locais e legíveis para humanos para cada previsão específica do modelo, denominado LIME47. Para qualquer imagem de entrada, o LIME primeiro a divide em unidades menores chamadas superpixels. Em seguida, são geradas perturbações a partir da imagem original e as previsões do modelo neural profundo são estimadas para cada uma dessas perturbações. Então, um modelo linear ponderado é ajustado às perturbações, utilizando pesos que dependem da proximidade com a instância original de entrada. Após o ajuste do modelo linear, são estimadas as pontuações de importância das características, indicando o papel de cada superpixel na previsão da etiqueta final. Essas pontuações de importância são destacadas visualmente na imagem final de explicação. O algoritmo LIME é apresentado no Arquivo Suplementar 2.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
A avaliação de desempenho do framework de classificação desenvolvido baseia-se em medidas tradicionais de avaliação derivadas da matriz de confusão. Uma matriz de confusão permite obter uma compreensão completa do desempenho do classificador por meio da representação do número de classificações corretas e incorretas feitas para cada classe definida. Dessa forma, todos os tipos de erros podem ser analisados. Por exemplo, tanto os falsos positivos quanto os falsos negativos são especialmente importantes no diagnóstico de d...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
O framework proposto de aprendizado profundo explicável para classificação de lesões cutâneas (EDLF-SLC) demonstra que a combinação de representações complementares de características profundas com inteligência artificial explicável pode melhorar tanto o desempenho da classificação quanto a transparência do modelo. Ao integrar múltiplas arquiteturas de CNN pré-treinadas (ResNet50, EfficientNetB0, MobileNet e Xception) para extração de características e empregar uma Máquina de Vetores de Suporte (SVM) para a classificação...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram que não há conflito de interesses.
Agradecimentos
Os autores gostariam de expressar sua sincera gratidão à Universidade de Taif pelo fornecimento do ambiente de pesquisa e do apoio institucional que facilitaram a conclusão deste trabalho.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Conjunto de Dados de Lesões Cutâneas ISIC 2020 | Colaboração Internacional de Imagem em Dermatologia (ISIC) | Conjunto de Dados do Desafio ISIC 2020 | Conjunto de imagens dermatoscópicas utilizado para desenvolvimento e avaliação de modelos. |
| Keras | Equipe Keras | Integrado com TensorFlow | Construção e treinamento de modelos de aprendizado profundo. |
| LIME (Explicações Locais Interpretáveis e Independes de Modelo) | Ribeiro et al. | Pacote Python | Geração de explicações visuais locais para previsões do modelo. |
| Matplotlib | Desenvolvedores do Matplotlib | Última versão compatível | Visualização de curvas de aprendizado, matrizes de confusão e gráficos de avaliação. |
| NumPy | Desenvolvedores do NumPy | Última versão compatível | Computação numérica e manipulação de arrays. |
| GPU NVIDIA Tesla T4 | Corporação NVIDIA | 16 GB de VRAM | Aceleração do treinamento e inferência do modelo. |
| Pandas | Equipe de Desenvolvimento do Pandas | Última versão compatível | Processamento de dados e gerenciamento de resultados experimentais. |
| Modelos CNN Pré-treinados | Aplicações TensorFlow/Keras | ResNet50, EfficientNetB0, MobileNet, Xception | Extração de características profundas de imagens dermatoscópicas. |
| Python | Fundação Software Python | Versão 3.9 | Linguagem de programação utilizada para implementação. |
| PyTorch | Fundação PyTorch | Versão 2.3.1 | Framework de aprendizado profundo utilizado para extração de características e implementação do modelo. |
| Scikit-learn | Desenvolvedores do Scikit-learn | Última versão compatível | Máquina de Vetores de Suporte (SVM), métricas de avaliação e pré-processamento de dados. |
| Máquina de Vetores de Suporte (Kernel RBF) | Scikit-learn | SVC | Classificação de representações fundidas de características profundas. |
| TensorFlow | Google LLC | Versão 2.x | Framework de aprendizado profundo para treinamento e inferência de modelos. |
| Sistema Operacional Ubuntu | Canonical Ltd. | Ubuntu 20.04 | Ambiente operacional experimental. |
Referências
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.