Este artigo propõe um modelo inovador, redes neurais gráficas com atenção linear baseada em slots com portas para recomendação baseada em sessões, que adota uma atenção linear baseada em slots com portas a partir de um grafo de sessão dualmente construído. O modelo aumenta a precisão e a eficiência da recomendação e supera o estado da arte em três conjuntos de dados públicos.
Artigo de investigação
Redes Neurais em Grafo com Atenção Linear de Slot com Portão para Recomendação Baseada em Sessões
Neste artigo
Resumo
Resumo
Os sistemas de recomendação baseados em sessão (SBR) têm como objetivo prever o próximo item com o qual um usuário provavelmente interagirá, com base na sequência de comportamentos dentro da sessão atual. Abordagens recentes que utilizam o mecanismo de atenção do Transformer (por exemplo, GC-SAN) demonstraram desempenho superior em comparação com métodos tradicionais; no entanto, sofrem com uma carga computacional elevada e complexidade espacial devido ao custo quadrático da autoatenção. Para superar essas limitações, propõe-se um novo modelo denominado GSLA4Rec (redes neurais gráficas com atenção linear baseada em portas e slots para recomendação baseada em sessão), que integra atenção linear com um mecanismo de portas aprendível e uma estratégia de atualização de memória baseada em slots inspirada na atenção baseada em portas e slots. Especificamente, o GSLA4Rec constrói inicialmente dois grafos: um grafo de sessão para capturar as transições entre itens dentro da sessão e um grafo global de vizinhos para codificar sinais colaborativos entre sessões, modelando assim informações de contexto local e global. A abordagem proposta centra-se no mecanismo de atenção linear baseada em portas e slots, que (1) emprega unidades de porta para suprimir ruídos decorrentes de interações irrelevantes ou redundantes em sessões longas, (2) utiliza unidades de slot para armazenar e atualizar dinamicamente representações compactas da sessão — reduzindo o consumo de memória — e (3) substitui a autoatenção por atenção linear para alcançar complexidade de tempo linear. Em conjunto, esses componentes aumentam significativamente a precisão preditiva e a eficiência do modelo na captura dos interesses em evolução dos usuários. Experimentos extensivos em múltiplos conjuntos de dados públicos de referência, incluindo Diginetica, Tmall e NowPlaying, demonstram que o GSLA4Rec supera consistentemente os métodos SBR de estado da arte em desempenho de recomendação, validando a eficácia do mecanismo GSLA.
Introdução
Com o rápido desenvolvimento dos serviços online (como comércio eletrônico, plataformas de vídeos curtos e feeds de notícias), o problema da sobrecarga de informação tornou-se cada vez mais acentuado e grave. Os sistemas de recomendação1,2 fornecem serviços personalizados e precisos de divulgação de informações por meio da análise aprofundada dos dados de comportamento dos usuários. No entanto, em muitas aplicações práticas caracterizadas por acesso anônimo, usuários não autenticados, proteção de privacidade e curtas durações de interação, métodos tradicionais de recomendação, como filtragem colaborativa3 e fatoração de matrizes4,5, limitam grandemente a aplicabilidade dos algoritmos de recomendação. Para enfrentar esses desafios, surgiu a SBR6,7,8,9. A SBR concentra-se nos dados de sequência de interação dentro da sessão atual dos usuários para prever o próximo ponto de interesse potencial. Esse paradigma não apenas evita a dependência de dados históricos de longo prazo dos usuários, mas também capta com sensibilidade as mudanças dinâmicas de interesse de curto prazo, demonstrando, assim, valor único de aplicação em cenários como comércio eletrônico, vídeos curtos, recomendação de músicas, entre outros.
Os métodos iniciais baseavam-se principalmente em Cadeias de Markov5,10,11,12 para modelar as probabilidades de transição entre itens em sequências de sessão. Embora esses métodos pudessem capturar dependências de primeira ordem nas sequências, a caracterização de dependências complexas de ordem superior e dinâmicas não lineares dos interesses dos usuários permanece limitada, restringindo a eficácia do modelo em cenários complexos. Com o desenvolvimento da tecnologia de Aprendizado Profundo13,14, métodos baseados em redes neurais têm sido amplamente aplicados na recomendação baseada em sessão (SBR). O GRU4REC15 foi o primeiro a aplicar redes neurais recorrentes14 (RNNs) à recomendação baseada em sessão, capturando efetivamente as dependências temporais nas sequências; o NARM16 aprimorou ainda mais a capacidade de identificar os interesses principais dos usuários ao integrar mecanismos de atenção com RNNs; o STAMP17 utilizou perceptrons multicamadas (MLPs) combinados com mecanismos de atenção para focar na captura dos interesses de curto prazo dos usuários. Embora esses métodos tenham obtido algum progresso na modelagem de sequências, ainda enfrentam desafios, como dificuldade em lidar com dependências de longo prazo e sensibilidade ao ruído.
Nos últimos anos, as Redes Neurais em Grafos (GNNs)18,19,20,21 trouxeram uma nova perspectiva para a tarefa SBR. Modelos como o SR-GNN22 modelam explicitamente relações complexas de transição ao construir um grafo de sessão (SG), obtendo melhorias substanciais na precisão da recomendação. No entanto, a maioria dos métodos baseados em GNNs existentes realiza a construção do grafo e a passagem de mensagens dentro de sessões individuais, carecendo de uma utilização eficaz das informações de correlação global entre itens. Para resolver esse problema, o GCE-GNN23 integra semântica global e grafos de sessão com um mecanismo de autoatenção para ponderar adaptativamente a importância dos itens ao construir um grafo global de vizinhança (NGG), alcançando melhorias consideráveis no desempenho. Apesar disso, os métodos baseados em GNNs ainda enfrentam dois grandes gargalos: primeiro, a complexidade do mecanismo de autoatenção cresce quadraticamente com o comprimento da sessão, resultando em uma sobrecarga computacional substancial ao processar sessões longas; segundo, os GNNs tradicionais carecem da capacidade de regular dinamicamente a importância dos itens durante a agregação de informações, dificultando a distinção entre ruídos e comportamentos críticos, o que afeta a qualidade da representação.
Para enfrentar esses desafios, este artigo propõe uma rede neural gráfica com atenção linear baseada em slots com comporta para recomendação baseada em sessão (GSLA4Rec): (1) Projetar um mecanismo de slot com comporta que filtra ruídos por meio de comportas e armazena informações semânticas-chave em slots de sessão, aumentando a robustez do modelo e reduzindo o custo de armazenamento; (2) Introduzir o mecanismo de atenção linear que reduz a complexidade computacional de O(N2) para O(N), onde N é o comprimento da sessão, mantendo a capacidade de modelar dependências de longa distância; (3) Realizar experimentos extensivos em três conjuntos de dados públicos de referência (Diginetica, Tmall e NowPlaying), demonstrando que o GSLA4Rec supera significativamente os métodos SOTA existentes, especialmente exibindo vantagens claras em cenários de sessões longas e esparsos.
Protocolo
Experimentando recomendação baseada em sessões
A recomendação baseada em sessões pode ser examinada sob três perspectivas: SBR, aprendizado de contexto global e GSLA (consulte a Tabela de Materiais). Nenhum participante humano ou animal foi envolvido neste estudo. Todos os conjuntos de dados experimentais utilizados neste trabalho estão publicamente disponíveis e foram enviados como Arquivo Suplementar: GSLA4Rec. zip.
Recomendação baseada em sessão
A recomendação baseada em sessões (SBR) era um sistema de inteligência artificial que interagia com os usuários por meio de diálogos naturais de múltiplas rodadas para compreender dinamicamente as preferências dos usuários e fornecer recomendações personalizadas. A SBR evoluiu desde métodos tradicionais até abordagens baseadas em aprendizado profundo e híbridas, avançando posteriormente em direção a soluções baseadas em Modelos de Linguagem de Grande Porte (LLM).
Recomendação tradicional baseada em sessões
O SBR tradicional era tipicamente representado por métodos baseados em Cadeias de Markov e Filtragem Colaborativa. O primeiro gerava recomendações por meio da decomposição de matrizes de transição probabilísticas específicas do usuário. Por exemplo, Guy Shani24 propôs um método de recomendação baseado em Processo de Decisão de Markov que produzia recomendações pela decomposição de matrizes correspondentes; Wanrong Gu25 aprimorou o desempenho das recomendações integrando Cadeias de Markov com intervalos de tempo de compra. O segundo gerava recomendações extraindo relações sequenciais ocultas entre itens interativos adjacentes por meio da fatoração de matrizes. Por exemplo, Sarwar B1 calculou a similaridade entre itens com base no histórico de comportamentos dos usuários (como pontuações e cliques) para recomendar itens compatíveis com as preferências anteriores dos usuários. Se o usuário A gostasse do item a, e o item c fosse altamente semelhante a a, o sistema recomendaria c ao usuário A; Rendle S5 propôs o FPMC, um modelo de recomendação sequencial que combina fatoração de matrizes com Cadeias de Markov, para capturar relações sequenciais ocultas entre itens interativos adjacentes. No entanto, esse SBR tradicional focava nas relações sequenciais entre itens adjacentes, tornando difícil modelar relações de dependência complexas.
Recomendação baseada em sessões com aprendizado profundo
A recomendação baseada em sessões com aprendizado profundo evoluiu por etapas que envolveram Redes Neurais Convolucionais (CNNs)26,27,28,29, RNNs e GNNs. A RBS baseada em CNN utilizou operações como convolução e agrupamento para aprender representações de cada contexto de sessão, que foram então usadas para recomendações subsequentes. O Caser30 converteu os L itens mais recentes com os quais um usuário interagiu em vetores d-dimensionais por meio de uma camada de incorporação, formando uma matriz de incorporação tratada como uma "imagem" mapeada no tempo e no espaço latente. Em seguida, utilizou três filtros convolucionais de padrões sequenciais — em nível pontual, em nível de união sem salto e em nível de união com um salto — para aprender padrões sequenciais e melhorar o desempenho da RBS. Tuan et al.31 modelaram uniformemente fluxos de cliques de sessão e características de conteúdo por meio de kernels convolucionais 3D para formar representações conjuntas espaço-temporais e de conteúdo.
As RNNs eram uma classe de arquiteturas de redes neurais projetadas especificamente para processar dados sequenciais. A ideia central era capturar dependências temporais por meio de estruturas recorrentes, como as redes de memória de longo prazo de curto prazo (LSTM)13 e as unidades recorrentes com portas (GRUs)32, sendo amplamente utilizadas em áreas como processamento de linguagem natural (NLP)33, reconhecimento de fala34, tradução de texto35, viagens36,37, criminalidade38, e previsão de tendências futuras39 (por exemplo, tráfego40, mercados de ações41,42 e meteorologia43). O GRU4Rec, proposto por Hidasi et al., foi um marco na pesquisa em SBR, sendo o primeiro a introduzir RNNs nesse campo e a capturar os padrões comportamentais sequenciais dos usuários por meio da GRU para alcançar recomendações personalizadas.
As RNNs44 demonstraram grande poder de representação na modelagem de relações complexas em dados com estrutura de grafo, e alguns pesquisadores introduziram RNNs para modelar transições complexas dentro ou entre sessões. Dependendo das diferentes arquiteturas de modelos de RNNs, os métodos baseados em RNNs para recomendação de sessões (SBR) foram geralmente categorizados em redes neurais de grafo com portas (GGNNs)45, redes convolucionais de grafo (GCNs)46 e redes de atenção em grafo (GATs)47. O SR-GNN foi o primeiro a aplicar RNNs ao SBR representando sequências de sessões como grafos direcionados e utilizando GGNNs para capturar relações complexas de transição entre itens dentro das sessões, combinado com mecanismos de atenção para obter o embedding final da sessão, melhorando assim o desempenho da recomendação. Chen L48 propôs um framework de RNNs com múltiplas visões que combina atributos estruturados e palavras-chave não estruturadas para modelar associações de produtos multidimensionais, aumentando a precisão do SBR. Driss E49 projetou um sistema inovador de recomendação de sessões que adota redes neurais de cápsulas em grafos para capturar características complexas dos itens e aprimorar a precisão da predição no SBR.
As técnicas de aprendizado profundo mencionadas anteriormente enriqueceram o escopo de pesquisa do SBR e melhoraram efetivamente o desempenho, mas ainda apresentavam certas limitações, manifestadas principalmente em: 1) Para itens recém-emergentes ou sessões muito esparsas, era difícil para os modelos fazerem previsões precisas devido à falta de contexto global; 2) Eles não conseguiam aproveitar os padrões globais contidos em todas as sessões históricas.
Recomendação híbrida baseada em sessões
A recomendação híbrida baseada em sessões integrou os pontos fortes de diferentes técnicas, como filtragem colaborativa, aprendizado profundo e mecanismos de atenção, para melhorar o desempenho da SBR. O GC-SAN50 incorporou um mecanismo de autoatenção baseado no SR-GNN para capturar melhor as informações de interação de itens importantes dentro de uma sessão. O FGNN51 agregou ainda mais informações de itens vizinhos por meio de um mecanismo de atenção com múltiplos cabeçotes, aprendendo múltiplas relações do item alvo. O SR-HetGNN52 pertencia à SBR com grafos heterogêneos; ao introduzir itens de múltiplos tipos (usuário, item, sessão) e arestas multirrelacionais (clique, compra, coocorrência, associação de atributos), construiu uma rede de conhecimento global, superando a limitação de sequências de itens únicos, tornando-se um método importante para modelar o comportamento de usuários anônimos e associações de interesses entre sessões nos últimos anos. O KGSR-SAP53 construiu um grafo de conhecimento conectando itens com arestas de múltiplas relações, descrevendo diversas interações entre usuário e item, resolvendo o problema de perda de informação em que o grafo global contém apenas arestas de um único tipo (interação usuário-item). Wang ZH54 propôs o DiffSBR, um modelo de recomendação de sessão baseado em difusão. Ele gera preferências confiáveis de próximos itens simulando a remoção de ruído, melhorando a modelagem de sequências dinâmicas de cliques do usuário. Qiao ST55 desenvolveu uma estrutura de SBR que combina aprendizado de intenção multivisão e alinhamento com modelos de linguagem grandes (LLM). Essa abordagem explorou a intenção implícita do usuário a partir de diversas perspectivas e utilizou modelos de linguagem para alinhar características semânticas, melhorando ainda mais o desempenho da recomendação.
Contexto global
Para superar a limitação da "análise de sessões isoladas", os pesquisadores perceberam que a informação global poderia ser utilizada para aprimorar a capacidade de representação da sessão atual, resolvendo assim problemas como esparsidade de dados, início a frio e lacuna semântica em métodos tradicionais de SBR. Ao mesmo tempo, na construção do contexto global, era necessário integrar informações globais em uma única sessão minimizando a interferência de ruídos. O CSRM56 otimizou a representação em nível de sessão integrando informações colaborativas entre a sessão atual e sessões vizinhas, utilizando um codificador de memória externa (OME) para extrair intenções colaborativas a partir dessas informações. O CA-TCN57 propôs um modelo de rede convolucional temporal com percepção inter-sessões, construindo grafos globais e grafos de contexto de sessão para simular o impacto das interações entre sessões sobre itens e sessões, enquanto a rede convolucional temporal (TCN) expande o campo receptivo por meio de convoluções dilatadas, com o número de camadas cobrindo sequências de comprimento exponencial (campo receptivo = ), solucionando o problema de desvanecimento de gradiente dos RNNs. Chen58 propôs um método de SBR baseado em redes neurais de hipergrafos (SR-HGNNs), que integra propagação de ordem mista (baixa e alta ordem) e mecanismos de atenção para resolver o problema de super-suavização das GNNs tradicionais em sessões curtas e distinguir a importância de diferentes ordens de propagação, podendo capturar dependências com maior precisão e evitar interferência de ruídos. O GCE-GNN utilizou pares de itens coocorrentes de múltiplas ordens para construir um grafo ponderado não direcionado, contando as frequências de coocorrência de itens para refletir sua importância na sessão; o AGNN-GC59 utilizou relações de transição de itens entre sessões para construir um grafo colaborativo global, calculando as probabilidades de transição de itens no grafo global para refletir mudanças de interesse na sessão; o DA-GCN60 utilizou o caminho mais curto para atualizar a matriz de adjacência e construir um grafo ponderado dinâmico, calculando a frequência de coocorrência no grafo global e a distância de caminho entre os itens. Inspirado pela literatura acima, este artigo propõe a construção de um grafo global por meio de um método baseado em vizinhança, ou seja, utilizando o coeficiente de similaridade de Jaccard para calcular sessões semelhantes, o que não apenas aproveita a informação global, mas também filtra ruídos (eliminando itens irrelevantes), alcançando o objetivo de construir com precisão o contexto global e estabelecendo uma base sólida para o algoritmo subsequente de SBR.
Atenção linear com porta de ranhura
Os transformadores tradicionais61 apresentaram alta complexidade espaciotemporal devido à necessidade de operações de atenção totalmente conectadas em toda a sequência, conforme a seguir:
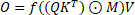 (1)
Onde Q, K, V ∈ RN×d eram transformações lineares dos itens de entrada, M = {Mij = 1 se i ≥ j, caso contrário −∞} era a máscara causal para impedir vazamento de informações futuras, ⊙ denotava produto elemento a elemento, e f denotava a função de ativação softmax.
Para alcançar a atenção linear62, a ideia mais direta era remover a função de ativação softmax. No entanto, se a função de ativação softmax fosse removida diretamente, a atenção linear certamente levaria a alguns problemas potenciais: perda do poder expressivo poderoso das redes neurais e incapacidade de resolver problemas complexos do mundo real.
Atenção linear com slot e controle de memória limitada
Assumindo que a função de ativação softmax precisasse ser mantida, K e V foram compactados separadamente em K̃, Ṽ ∈ Rm×d. Do ponto de vista da rede de memória, K̃ e Ṽ possuíam posições de memória cujo comprimento aumenta com a sequência, ou seja, o número de posições m = N. Se m fosse fixo, a linearização seria obviamente possível. Inspirado pelo Controle de Memória Limitada63, cada token nos itens de entrada com comprimento N precisava ser escrito de forma competitiva em m posições.
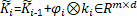 ,
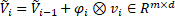 ,
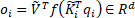 (2)
Onde f era a função de ativação softmax e φi era o vetor para controlar a entrada efetiva para controlar o valor-chave ki conforme a seguir.
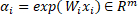 ,
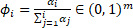 (3)
Aqui, (φi)j representava a intensidade de escrita do token i no slot j e foi obtida utilizando uma função softmax cumulativa.
Para alcançar um cálculo linear eficiente, a fórmula (2) foi reescrita como a fórmula (4), que calcula οi a partir de qi, ki e vi (Eq. 4) por meio de {οi|i=1T, qi, ki, vi)|i=1T} e adotou um cálculo sequencial em duas etapas:
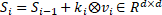 ,
 (4)
Portanto, as operações de SLA poderiam ser derivadas:
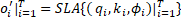 ,
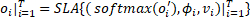 (5)
Onde oi′ ∈ ℝm, οi ∈ ℝd. Portanto, a SLA poderia adquirir um treinamento eficiente em termos de hardware com tempo linear por segmento64.
Atenção linear com porta de ranhura
A atenção linear em slot com controle de memória limitada poderia reduzir a complexidade computacional e espacial. No entanto, o acúmulo de informações também poderia introduzir ruídos na interação da sessão, de modo que o decaimento dependente dos dados era muito importante para reter e esquecer informações seletivamente, e esse mecanismo seletivo havia sido revisitado em modelos recentes de espaço de estado seletivo65. GSLA com dependência de dados poderia ser expressa como:
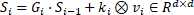 ,
 (6)
Aqui, as portas de decaimento foram parametrizadas por uma forma de produto externo Gi = αi ⊗ βi, αi, βi ∈ [0,1]d. No que segue, GSLA também pode ser escrita na seguinte forma equivalente, definindo-se normalmente βt = 1 e multiplicação matricial como em64:
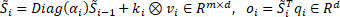 (7)
Onde αi e ki representavam separadamente o portão de esquecimento e o portão de entrada, os dois portões poderiam ser acoplados como ki = 1 − αi, inspirado na literatura sobre RNNs com portões. Ficou evidente que a GSLA poderia ser formulada com um cálculo sequencial em duas etapas, conforme mostrado na Equação (8). A estrutura de segunda ordem permitia treinamento paralelo em blocos para melhorar a eficiência do treinamento, e a inserção da operação softmax no meio da estrutura de segunda ordem aprimorava a capacidade de modelagem da memória de slots finitos.
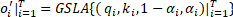 ,
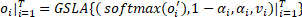 (8)
Transformação dos dados da sessão
Definição do problema
Seja a sequência de sessão dada S = {v1s, v2s, ⋯, vns}, onde vis denota o i-ésimo item clicado. Ao analisar o comportamento de clique do usuário dentro dessa sequência, o sistema previu o próximo item em que o usuário poderia se interessar, vn+1s.
Construção do grafo
Construção do grafo de sessão
Para uma sessão S = {v1s, v2s, ⋯, vns}, um grafo direcionado Gs = (Vs, εs) foi construído, em que Vs era o conjunto de itens da sessão S fornecida, e εs = {eijlocal|vi, vj, vi, vj ∈ Vs} era o conjunto de arestas da sessão S fornecida. ε(vi-1s, vis) representava os itens clicados consecutivamente nesta sessão. A aresta eijlocal podia ser dividida em quatro tipos: ein, eout, ein-out, eself. Como o mesmo item poderia aparecer repetidamente na sequência, o valor ponderado de cada aresta foi contabilizado.
A sessão atual s = [v1, v2, v4, v2, v3] foi convertida em um SG, conforme mostrado na Figura 1A.
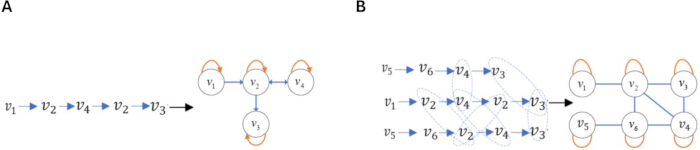
Figura 1: Transformação de itens interativos em estruturas de grafos. (A) Ilustração da construção do grafo de sessão (GS) por meio da transformação de uma sessão em um grafo. (B) Ilustração da construção do grafo global de vizinhos (GGV) combinando várias sessões em um grafo. Esta figura foi criada integralmente pelo autor utilizando o Visio, com elementos totalmente personalizados. Nenhum recurso gráfico externo protegido por direitos autorais foi utilizado; portanto, nenhuma licença adicional de terceiros foi necessária. Os direitos autorais da figura pertencem aos autores e estarão em conformidade com as regras de direitos autorais da revista após a aceitação. Clique aqui para visualizar uma versão maior desta figura.
Construção do grafo global do vizinho
Com base na sessão atual S, o NGG correspondente Gg = (Vg, εg) foi construído para enriquecer a aprendizagem de representação da sessão atual de maneira inter-sessões. Vg era o conjunto de itens contendo todos os itens em Gg, e εg = {eijglobal|vi, vj, vi, vj ∈ Vg} era o conjunto de arestas de Gg. ε(vi-1g, vig) representava os itens interagentes diretamente vi-1g e vig no NGG Gg. Este processo consistia em duas etapas: aquisição da sessão vizinha e construção do NGG.
Aquisição da sessão de vizinhança
Em todo o conjunto de dados, foram pesquisadas as sessões com o número máximo de itens coocorrentes com a sessão atual. As N principais sessões com as maiores contagens de coocorrência foram selecionadas para construir um conjunto candidato de sessões vizinhas S. Posteriormente, o coeficiente de similaridade de Jaccard foi utilizado para calcular a similaridade entre a sessão atual cu e uma sessão Sr ∈ S do conjunto candidato S, conforme mostrado na Equação (9).
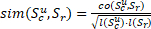 (9)
Aqui, co(Scu, Sr) denota o número de itens que ocorrem simultaneamente em Scu e Sr, enquanto l(Scu) e l(Sr) representam, respectivamente, os comprimentos de Scu e Sr, e Scu e Sr denotam a sessão atual e uma sessão vizinha. As sessões com similaridade abaixo de um determinado limiar (que pode ser definido como um hiperparâmetro) foram filtradas, e as sessões restantes constituíram o conjunto de sessões vizinhas Ns para a sessão atual.
Construção do grafo global do vizinho
Com base no conjunto de sessões vizinhas Ns, o GGN foi construído, conforme ilustrado na Figura 1B. Durante a construção da matriz de adjacência, se dois itens (vi, vj) tinham uma interação, a entrada correspondente Aij era definida como 1; caso contrário, era definida como 0. Além disso, as interações entre os itens foram tratadas como não direcionadas e foram equipadas com laços próprios, seguidas por normalização, conforme mostrado na Tabela 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Tabela 1: Matriz de adjacência normalizada do grafo global de vizinhos. A tabela apresenta a matriz de adjacência normalizada que descreve as conexões ponderadas entre os nós no grafo global de vizinhos construído.
Elaboração de algoritmo de recomendação baseado em sessões
Esta seção detalha o modelo inovador proposto GSLA4Rec, que aprimorou o desempenho do SBR ao introduzir o mecanismo GSLA na representação conjunta de características de SG e NGG.
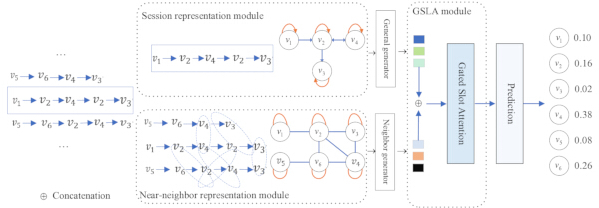
Figura 2: Estrutura do GSLA4Rec. Esta estrutura integrou a aprendizagem da estrutura de grafos de sessão e grafo global de vizinhos, filtrou ruídos de interação com um mecanismo de portão (gating), equilibrou armazenamento e eficiência com um mecanismo de slots de memória e capturou a relevância dos itens com um mecanismo de atenção linear para prever a próxima preferência de clique do usuário. Esta figura foi elaborada pelo próprio autor utilizando o Visio, com elementos totalmente personalizados. Nenhum recurso gráfico externo protegido por direitos autorais foi utilizado, portanto, nenhuma licença adicional de direitos autorais de terceiros foi necessária. Os direitos autorais da figura pertencem aos autores e estarão em conformidade com as regras de direitos autorais da revista após a aceitação. O GSLA4Rec representa redes neurais gráficas com atenção linear com slot e portão (gated-slot linear attention) para SBR. Clique aqui para visualizar uma versão maior desta figura.
Figura 2 apresentou a estrutura do GSLA4Rec, que compreendia quatro componentes principais: 1) Representação de itens no nível da sessão. Utilizava um modelo de GNNs em SG para aprender incorporações de itens no nível da sessão dentro da sessão atual; 2) Representação de itens no nível global dos vizinhos. Aprendia incorporações de itens no nível global em todas as sessões ao empregar uma GRU para incorporar recursivamente as incorporações dos vizinhos de cada item com base no NGG; 3) GSLA. Modelava a preferência dos usuários na sessão atual ao agregar as representações de itens aprendidas nos níveis de sessão e global; 4) Camada de predição. Gerava as probabilidades previstas para os itens candidatos. Os quatro componentes foram apresentados em detalhes a seguir.
Representação da sessão
Em SBR, compreender os comportamentos de interação dos usuários era crucial. Para tanto, um SG e um NGG foram construídos para a aprendizagem de representação de sessão, com o objetivo de compreender de forma abrangente os comportamentos de interação dos usuários e, assim, capturar a intenção mais autêntica dos mesmos.
Representação de itens no nível da sessão
Com base no SG na Figura 1A, um método de Atenção em Grafo Bidirecional com Pesos (WBGAT) foi empregado para extrair características do SG. Este método introduziu pesos nas arestas e direcionalidade dos itens (vizinhos de entrada e vizinhos de saída) com base no mecanismo padrão de GAT, alcançando o efeito de reforçar arestas importantes e capturar dependências bidirecionais, superando assim as limitações do GAT tradicional em relação a relações assimétricas entre itens e intensidade de interação. O processo de cálculo foi o seguinte:
Primeiro, cálculo dos pesos de normalização do grau interno dos itens.
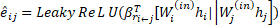 (10)
em que eij indicava o peso da vizinhança de primeira ordem das características do item j para o item i,  era a relação entre o item i e o item j, β* ∈ ℝd eram os vetores de peso, hi e hj eram respectivamente as representações do item i e do item j, Wi(in) ∈ ℝd*d e Wj(in) ∈ ℝd*d eram parâmetros treináveis, || representava a operação de concatenação. Para distinguir diferentes relações de grau de entrada, dois vetores de peso, denominados rin e rin-self, foram treinados. A função de ativação adotada foi a LeakyReLU.
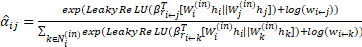 (11)
Para tornar os coeficientes comparáveis entre diferentes itens, os pesos de atenção foram normalizados por meio da função softmax. Onde Ni(in) era o conjunto de vizinhos de primeira ordem do item i,  era o peso do vizinho de entrada da aresta direcionada (i←j) no SG, este método permitiu que o modelo aprendesse as correlações entre características dos itens, ao mesmo tempo que preservava as informações da intensidade intrínseca das conexões na estrutura do grafo, tomando o logaritmo dos pesos das arestas e adicionando-os à pontuação original de atenção eij.
Segundo, cálculo dos pesos de normalização do grau de saída dos itens.
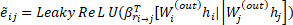 (12)
em que ẽij indicava o peso da vizinhança de primeira ordem das características do item j para o item i,  era a relação entre o item i e j, dois vetores de peso, denominados rout e rout-self, foram treinados.
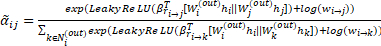 (13)
Onde Ni(out) era o conjunto de vizinhos de primeira ordem de saída do item i,  era o peso do vizinho de saída da aresta direcionada (i→j) no SG.
Terceiro, agregação de informações. O embedding atualizado do item pode ser obtido após a ponderação e soma dos embeddings de grau de entrada e de grau de saída de primeira ordem do item i.
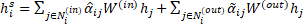 (14)
Onde  e α̃ij denotam, respectivamente, os pesos do grau de entrada e do grau de saída do item i,
 denotou a representação atualizada do item i.
Representação global do item no nível do vizinho
Pesquisas recentes concordam consistentemente que a construção de um grafo global pode aprimorar a representação dos dados e, consequentemente, melhorar o desempenho do SBR, o que é inegável. No entanto, o aprimoramento global dos dados também pode introduzir informações irrelevantes, como ruído. No modelo proposto, para alcançar a ampliação dos dados em nível global minimizando ao máximo o ruído, foi construído um grafo global de vizinhos próximos.
Com base no NGG na Figura 1B e na matriz de adjacência normalizada na Tabela 1, a sessão atual e suas sessões vizinhas foram transformadas em um NGG, e um método GGNNs45 foi aplicado para extrair características do NGG. O processo de aprendizado dos vetores de itens no NGG é mostrado na Equação (15).
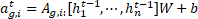
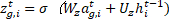
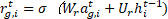
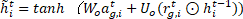
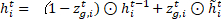 (15)
W ∈ ℝd×2d indicava os pesos de controle, zg,i e rg,i representavam a porta de atualização e a porta de redefinição, respectivamente. [h1t-1, ⋯, hnt-1] representava a lista de todos os vetores de itens na sessão s. σ(x) = 1/(1 + e-x) era a função sigmoide logística, ⊙ indicava multiplicação elemento a elemento, e hi ∈ ℝd representava o vetor após a atualização com portas. A matriz de adjacência As ∈ ℝn×n indicava a conectividade entre os itens em sessões vizinhas, e As,i: ∈ ℝ1×n representava um bloco de coluna de As correspondente ao item vs,i na matriz de adjacência. Para a sessão atual s = [v1, v2, v4, v2, v3], o NGG e a matriz de adjacência normalizada foram mostrados na Figura 1B e na Tabela 1, respectivamente.
Representação do item
A representação do item foi obtida somando o vetor do item no nível da sessão e o vetor do item no nível global do vizinho, conforme mostrado na Equação (16):
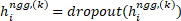
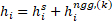 (16)
Onde a eliminação foi utilizada em representações de itens vizinhos em nível global para atenuar o sobreajuste.
Atenção linear com porta de ranhura
A atenção linear com slot com porta (GSLA, na sigla em inglês) neste artigo integrou a atenção linear com controle de memória limitada e um mecanismo de portas dependente dos dados. Por um lado, herdou o mecanismo de slot de memória finita do modelo de controlador baseado em atenção (ABC, na sigla em inglês), que comprime pares chave-valor, originalmente crescentes com o comprimento da sequência, em um número fixo de slots, sendo cada slot atualizado por meio de escrita competitiva, resolvendo assim o problema de complexidade computacional da atenção global do transformador. Por outro lado, introduziu um mecanismo de portas em nível refinado, semelhante ao da GLA, no qual os dados de entrada ajustam dinamicamente a taxa de retenção das informações históricas por meio de uma porta de esquecimento αi, solucionando o problema de ruído causado pela ausência de um mecanismo de esquecimento no ABC.
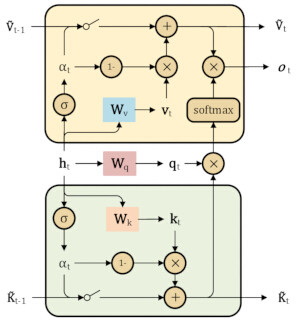
Figura 3: Diagrama esquemático do GSLA. O vetor de entrada foi mapeado para o vetor de consulta, vetor de palavras-chave e vetor de valor, respectivamente, e então processado pela atenção linear com controle de memória limitada e um mecanismo de comporta dependente de dados para obter o vetor de consulta atualizado, vetor de palavras-chave, vetor de valor e vetor de saída. Esta figura foi desenhada pelo próprio autor usando o Visio, com elementos totalmente personalizados. Nenhum recurso gráfico externo protegido por direitos autorais foi utilizado; portanto, nenhuma licença adicional de direitos autorais de terceiros foi necessária. Os direitos autorais da figura pertencem aos autores e estarão em conformidade com as regras de direitos autorais da revista após a aceitação. GSLA representa a atenção linear com comporta e ranhuras. Clique aqui para visualizar uma versão maior desta figura.
Conforme implementado especificamente na Figura 3, o vetor de entrada foi mapeado separadamente em vetor de consulta, vetor de chave e vetor de valor64:
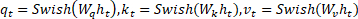 (17)
Onde Wq, Wk, Wv ∈ ℝd×d representavam as matrizes de pesos de transformação correspondentes à consulta, chave e valor, respectivamente, e ht denotava o vetor de incorporação no t-ésimo passo de tempo da sequência de entrada da sessão. A função Swish foi definida como Swish(x) = x · σ(x) e era uma função de ativação com porta própria, onde σ era a função Sigmoide; ela superou a função de ativação ReLU tradicional em múltiplas tarefas de Aprendizado Profundo.
O GSLA utilizou um portão de esquecimento αi e um portão de entrada 1 − αi, dependendo dos dados de entrada, para atualizar dinamicamente as informações no iº compartimento de memória. O processo foi o seguinte64:
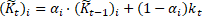 (18)
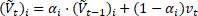 (19)
Aqui, K̃t e Ṽt representavam os slots dos vetores de chave e os slots dos vetores de valor no passo de tempo t, enquanto K̃t-1 e Ṽt-1 representavam os slots dos vetores de chave e os slots dos vetores de valor no passo de tempo t−1. A porta de esquecimento αi = σ(Wαht)1/τ, onde Wα ∈ ℝd era a matriz de pesos de transformação, σ era a função Sigmoide e τ era o coeficiente de amortecimento (geralmente definido como 8), utilizada para controlar a suavidade da porta de esquecimento. Isso permitia que a GSLA ajustasse suavemente a taxa de esquecimento das informações históricas: quanto maior o valor de αi, mais a GSLA dependia das informações históricas; quanto menor o valor de αi, mais a GSLA focava na entrada atual.
Os slots do vetor chave K̃t e os slots do vetor valor Ṽt dos slots na etapa t foram escritos na forma matricial, conforme mostrado65 nas Equações (20) e (21):
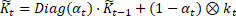 (20)
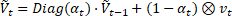 (21)
Em seguida, a GSLA com propriedades de segunda ordem (consulte a Equação (8)) foi utilizada para calcular a saída oi |i=1T para cada passo de tempo i ∈ [1, …, T]. Uma transformação linear foi aplicada à saída de cada passo de tempo para obter o resultado h̃t. Por fim, o valor médio das representações de todos os itens na sequência da sessão foi calculado para gerar o embedding da sessão S̃e com atualizações de memória dinâmica:
 (22)
 (23)
Aqui, ot representava a saída do Gated-Slot no passo de tempo t, h̃t indicava o resultado da transformação linear aplicada a ot. S̃e indicava o valor médio de h̃t em todos os passos de tempo.
Camada de predição
Com base na representação da sessão obtida S̃e e no embedding inicial do item i, foi realizada uma operação de produto escalar para calcular a pontuação de cada item candidato hi. Posteriormente, a função softmax foi utilizada para obter as probabilidades de recomendação do item candidato i:
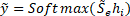 (24)
Aqui, ỹ representava as probabilidades de recomendação do item candidato, hi denotava o vetor do item candidato, e a função de perda de entropia cruzada foi empregada para o treinamento do modelo.
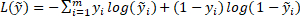 (25)
Aqui, y era a representação codificada one-hot da verdade fundamental.
Resultados
Conjuntos de dados e pré-processamento
Nos experimentos, foram selecionados três conjuntos de dados públicos de SBR derivados de dados reais de transações em cenários práticos de aplicação para avaliar o desempenho do modelo: Diginetica, extraído da competição CIKM Cup 2016, que contém registros de transações e cliques dos usuários; Tmall, que se baseia em logs de usuários da plataforma Tmall e registra os comportamentos de navegação e compra dos usuários; e Nowplaying, que contém registros musicais sobre o histórico de reprodução dos usuários em plataformas de música. Esses conjuntos de dados foram amplamente utilizados na pesquisa de SBR e puderam avaliar de forma abrangente a eficácia e a aplicabilidade do modelo.
Na etapa de pré-processamento dos dados, os conjuntos de dados foram padronizados para garantir consistência na qualidade dos dados. Especificamente, todas as sessões com duração inferior a 2 foram filtradas e os itens que apareceram menos de 5 vezes foram removidos. Além disso, para cada sessão S = {v1, v2, ..., vn}, foram geradas múltiplas subsequências para o treinamento e teste do modelo. Essas subsequências tinham a forma: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). Após a conclusão do pré-processamento descrito acima, foram realizadas análises estatísticas nos conjuntos de dados, cujas informações detalhadas são apresentadas na Tabela 2.
| Conjunto de dados | Diginetica | Tmall | Nowplaying |
| clique | 982961 | 818479 | 1367963 |
| treino | 719470 | 351268 | 825304 |
| teste | 60858 | 25898 | 60417 |
| itens | 43097 | 40728 | 60417 |
| compr. méd. | 5.12 | 6.69 | 7.42 |
Tabela 2: Descrição do conjunto de dados. A tabela resume as estatísticas dos conjuntos de dados Diginetica, Tmall e Nowplaying, incluindo os números de cliques, amostras de treinamento e teste, itens e comprimento médio da sessão.
Configurações experimentais
Configuração dos parâmetros
Para garantir a imparcialidade do experimento, foram adotados métodos de pré-processamento para tratar três conjuntos de dados, além de predefinir os parâmetros do modelo GSLA4Rec. Para os conjuntos de dados Diginetica e Nowplaying, o tamanho do lote foi definido como 150, e 300 para o conjunto de dados Tmall. Os parâmetros deste modelo foram inicializados usando uma distribuição gaussiana com média 0 e desvio padrão 0,1, e a dimensão foi definida como 100; o otimizador utilizado foi o Adam, com taxa de aprendizado inicial definida como 0,001, sendo a taxa de aprendizado multiplicada por 0,1 a cada 3 épocas. O treinamento foi realizado por um total de 30 épocas na GPU NVIDIA TITAN V e no PyTorch 1.11.0 com cu113 (consulte a Tabela de Materiais) para obtenção do melhor valor; o limiar para filtragem de sessões vizinhas foi definido como 0,5, e a regularização L2 foi aplicada no experimento. Para cada conjunto de dados, os últimos 10% dos dados ordenados por horário de transação foram selecionados como conjunto de teste, enquanto os 10% e 80% restantes foram selecionados aleatoriamente como conjuntos de validação e treinamento, respectivamente. O número de slots de memória no GSLA foi definido como um valor em {0, 1, 2, 3, 4, 5}.
Métricas de avaliação
Este artigo adotou P@N (Precisão@N, N = 10/20) e MRR@N (Média do Posto Recíproco@N, N = 10/20). P@N foi utilizado para medir a proporção de recomendações corretas entre os primeiros N resultados recomendados; MRR@N foi usado para calcular a média dos postos recíprocos dos projetos corretos, sendo que quanto maior o valor de MRR, melhor o desempenho na ordenação.
Analisando o desempenho
A eficácia do modelo GSLA4Rec foi avaliada em comparação com modelos de referência que representam diferentes estágios de desenvolvimento tecnológico. Inicialmente, métodos de aprendizado de máquina foram utilizados para SBR, por exemplo, FPMC5 foi usado para prever o efeito sequencial com base em cadeias de Markov. Em seguida, com o avanço da inteligência artificial, o aprendizado profundo passou a ser amplamente aplicado ao SBR; por exemplo, GRU4Rec10 baseou-se em RNNs para modelar o SBR empilhando múltiplas camadas de GRUs e projetou funções de perda especializadas para otimizar o SBR, NARM16 introduziu AM para capturar os principais interesses dos usuários e gerar uma representação vetorial final do próximo item recomendável, e STAMP17 utilizou perceptrons multicamadas aprimorados com AM para capturar simultaneamente o interesse geral e o interesse imediato dos usuários. Nos últimos anos, redes neurais em grafos também têm sido amplamente utilizadas em SBR devido à sua poderosa capacidade de aprendizado com dados não euclidianos. Por exemplo, SR-GNN22 aplicou GNNs ao SBR pela primeira vez, obtendo relações complexas de transição entre itens por meio de GGNNs e focando nos interesses imediatos dos usuários em conjunto com AM, GCE-GNN23 utilizou GATs para obter relações de transferência de itens nos contextos local e global, e gerou representações de sessão por meio de RPE e AM suave, e S2-DHCN66 transformou os dados de sessão em hipergrafos e grafos de linha e aproveitou o aprendizado auto-supervisionado para aprimorar o SBR.
Recentemente, uma abordagem abrangente foi adotada para melhorar o desempenho do SBR. Por exemplo, o GC-SAN50 combinou GNNs com redes de autoatenção em múltiplas camadas para aprimorar o desempenho da recomendação modelando dependências de curto e longo prazo; o TASRec67 incorporou informações temporais por meio da construção de uma sequência de instantâneos de grafos dinâmicos em diferentes marcas de tempo; o CT-GNN68 utilizou GNNs com informações temporais combinadas para aprender informações adicionais de associação temporal entre itens; o CORE69 fundiu as informações de coocorrência e as informações temporais dos itens para obter a representação final da sessão; o RESTC70 propôs padrões de interação espaço-temporal inspirados nas propriedades de uniformidade e alinhamento do aprendizado contrastivo; o COTRec66,71 adotou aprendizado auto-supervisionado em duas visualizações de grafos de sessão e co-treinamento para resolver a esparsidade de dados no SBR; o RAIN71 aproveitou a máscara de arestas e a reconstrução estrutural, além de treinar conjuntamente um indicador de arestas para identificar e eliminar explicitamente arestas ruidosas, o que aumentou significativamente a precisão e a robustez do SBR.
| Conjuntos de dados | Diginetica | Tmall | Nowplaying | ||||||||||
| Classificação por método | Métricas | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Aprendizado de Máquina | FPMC | 15,42 | 22,10 | 6,20 | 6,66 | 13,12 | 16,05 | 7,10 | 7,30 | 5,28 | 7,35 | 2,66 | 2,82 |
| Aprendizado Profundo | GRU4REC | 17,92 | 30,80 | 7,73 | 8,20 | 9,47 | 10,93 | 5,78 | 5,89 | 6,74 | 7,92 | 4,40 | 4,48 |
| Aprendizado Profundo | NARM | 35,44 | 48,32 | 15,12 | 16,00 | 19,16 | 23,30 | 10,40 | 10,70 | 13,60 | 18,59 | 6,62 | 6,92 |
| Aprendizado Profundo | STAMP | 33,97 | 46,62 | 14,26 | 15,13 | 22,63 | 26,47 | 13,10 | 13,35 | 13,20 | 17,65 | 6,57 | 6,88 |
| GNNs | SR-GNN | 38,42 | 51,26 | 16,89 | 17,76 | 23,41 | 27,57 | 13,46 | 13,72 | 14,17 | 18,86 | 7,15 | 7,47 |
| GNNs | S2 -DHCN | 40,21 | 53,66 | 17,59 | 18,51 | 26,22 | 31,42 | 14,60 | 15,05 | 17,35 | 23,50 | 7,87 | 8,18 |
| GNNs | GCE-GNN | 41,16 | 54,22 | 18,15 | 19,04 | 28,01 | 33,42 | 15,08 | 15,42 | 16,94 | 22,37 | 8,03 | 8,40 |
| GNNs+Att | TASRec | 39,85 | 52,53 | 17,19 | 18,22 | 25,72 | 29,58 | 14,22 | 14,51 | 16,35 | 20,52 | 7,30 | 7,78 |
| GNNs+Att | GC-SAN | 38,40 | 51,30 | 16,80 | 17,80 | 23,50 | 27,60 | 13,50 | 13,80 | 14,20 | 18,90 | 7,20 | 7,50 |
| GNNs+Tem | CT-GNN | 39,40 | 52,71 | 17,50 | 18,56 | 25,95 | 31,42 | 14,52 | 15,00 | 16,55 | 22,28 | 7,75 | 8,06 |
| GNNs+Tem | CORE | 41,03 | 52,84 | 17,95 | 18,47 | 32,97 | 39,16 | 18,72 | 19,16 | 17,65 | 21,81 | 7,92 | 7,35 |
| GNNs+Tem | RESTC | 42,35 | 55,93 | 18,75 | 19,65 | 35,57 | 42,47 | 18,05 | 18,52 | 18,39 | 24,79 | 8,31 | 8,72 |
| GNNs+COT | COTRec | 39,87 | 54,18 | 17,53 | 19,07 | 30,62 | 36,35 | 17,65 | 18,04 | - | - | - | - |
| GNNs+ReStr | RAIN | - | 55,50 | - | 19,20 | - | 38,73 | - | 19,12 | - | 24,17 | - | 8,47 |
| GNNs+Gated-Slot | GSLA4Rec | 43,35 | 56,47 | 19,38 | 19,98 | 36,56 | 43,60 | 19,46 | 19,96 | 19,80 | 27,10 | 8,86 | 9,32 |
| SD | ±0,0009 | ±0,0011 | ±0,0008 | ±0,0009 | ±0,0018 | ±0,0021 | ±0,0016 | ±0,0018 | ±0,0028 | ±0,0031 | ±0,0024 | ±0,0026 | |
| valor-p | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,01 | |
| Tinference | 0,294 | 0,296 | 0,295 | 0,297 | 0,168 | 0,169 | 0,169 | 0,171 | 0,472 | 0,478 | 0,475 | 0,479 | |
Tabela 3: Comparação de desempenho em três conjuntos de dados. A tabela compara o GSLA4Rec com métodos de recomendação baseados em aprendizado de máquina, aprendizado profundo, GNN, atenção, métodos temporais e outros, utilizando os conjuntos de dados Diginetica, Tmall e Nowplaying com as métricas P@10, P@20, MRR@10 e MRR@20. O desvio padrão (SD) e os valores de p também são informados para o GSLA4Rec.
Para verificar o desempenho do modelo GSLA4Rec e eliminar a aleatoriedade da melhoria de desempenho causada por fatores randômicos, foram realizados múltiplos experimentos de agrupamento e análise estatística no conjunto de testes. Especificamente, o conjunto de testes foi dividido em grupos de 150 sessões por lote e repetido 30 vezes utilizando o método de semente aleatória. Os resultados médios e o tempo consumido de todos os experimentos agrupados foram calculados como o desempenho e o tempo de inferência do modelo GSLA4Rec, respectivamente. O desvio padrão (SD) e o teste de significância estatística t do modelo GSLA4Rec foram calculados para verificar ainda mais a estabilidade e a certeza da melhoria de desempenho do modelo GSLA4Rec. Tabela 3 apresentou o desempenho, o SD, o valor p e o Tinference do modelo de recomendação proposto, GSLA4Rec, em comparação com os modelos básicos nos três conjuntos de dados. Os números sublinhados indicaram o melhor método básico, e o modelo com melhor desempenho correspondente a cada métrica de avaliação foi destacado em negrito preto.
Métodos de recomendação baseados em aprendizado de máquina: em tarefas de SBR, o método tradicional FPMC apresentou o pior desempenho, principalmente porque modelos de cadeia de Markov não conseguiram capturar padrões complexos de transição entre itens. 2) Métodos de recomendação baseados em aprendizado profundo: modelos como GRU4REC, NARM e STAMP empregaram abordagens de modelagem de sequência e alcançaram certas melhorias de desempenho. Entre eles, NARM e STAMP demonstraram resultados de recomendação superiores ao GRU4REC, principalmente porque o NARM introduziu um mecanismo de atenção para capturar os principais interesses dos usuários. 3) Métodos de recomendação baseados em GNNs: a adoção de GNNs no SBR trouxe melhorias significativas de desempenho. Por exemplo, o SR-GNN, que foi pioneiro na conversão de sequências de sessão em estruturas de grafos para capturar informações estruturais espaciais dos itens, superou os métodos de Aprendizado Profundo representados pelo STAMP com uma melhoria de 0,36–4,64%, demonstrando a vantagem espacial das estruturas de grafos no processamento de dados sequenciais. O S2-DHCN adotou uma convolução hipergráfica de canal duplo para capturar dependências de ordem superior entre itens e combinou-a com aprendizado contrastivo auto-supervisionado para aprimorar as representações, superando a limitação dos GNNs tradicionais de modelar apenas relações par a par e informações insuficientes; seu desempenho superou os métodos de Aprendizado Profundo representados pelo STAMP em 1,30–7,04%. O GCE-GNN, ao integrar efetivamente informações de sessão única e globais, superou os métodos de Aprendizado Profundo representados pelo STAMP em 1,46–7,60% e superou o SR-GNN em 0,88–5,85%, indicando que métodos baseados em estrutura de grafos que incorporam informações contextuais globais podem melhorar significativamente o desempenho do SBR. 4) Métodos de recomendação baseados em GNNs + mecanismo de atenção: o TASRec buscou capturar com maior precisão preferências de curto e longo prazo nas sequências de comportamento dos usuários ao introduzir um mecanismo sensível ao tempo; seu desempenho superou os métodos de Aprendizado Profundo em 0,73–5,91% e o modelo SR-GNN em 0,30–2,31%, mas ficou aquém do modelo GCE-GNN em 0,59–3,84%. O GC-SAN combinou estruturas de grafos convertidas a partir de sequências de sessão com mecanismos de autoatenção de múltiplas cabeças para capturar com sucesso dependências locais e de longo prazo dentro das sessões; seu desempenho foi comparável ou ligeiramente superior ao do modelo SR-GNN, mas inferior aos modelos TASRec e GCE-GNN. Isso sugere que a introdução de mecanismos de atenção pode melhorar efetivamente o desempenho do SBR, embora a melhoria seja menos significativa do que a obtida com informações globais, reafirmando a importância da informação contextual global. 5) Métodos de recomendação baseados em GNNs + codificação temporal: o CT-GNN foi o primeiro a combinar estruturas de grafos com codificação temporal para capturar simultaneamente a "estrutura espacial" e a "dinâmica temporal", superando o modelo GC-SAN em 0,55–3,82%. O CORE capturou preferências de longo prazo e intenções de curto prazo analisando estatisticamente as frequências de coocorrência de itens em sessões globais e projetando um peso de posição temporal para sessões atuais, respectivamente, e fundiu essas informações de coocorrência e temporal para obter a representação final da sessão; seu desempenho superou o modelo TASRec em 0,25–9,58% e o modelo GC-SAN em 0,67–11,56%, mostrando uma melhoria significativa de 3,64–5,74% em relação ao modelo GCE-GNN no conjunto de dados Tmall. O RESTC introduziu um modelo de aprendizado contrastivo baseado em GNNs espaço-temporais para abordar problemas nos GNNs tradicionais, como focar exclusivamente em estruturas de grafos espaciais, ignorar informações temporais e fusão espaço-temporal insuficiente; seu desempenho superou o modelo CORE em 0,39–3,31% e o modelo GCE-GNN em 0,28–7,56%, indicando que tanto a codificação temporal quanto o aprendizado contrastivo melhoram efetivamente o desempenho do SBR. O RAIN utilizou técnicas de mascaramento de arestas e reconstrução estrutural para treinar conjuntamente um indicador de arestas, identificando e eliminando explicitamente arestas ruidosas, alcançando um desempenho próximo ao do modelo RESTC.
O modelo proposto, GSLA4Rec, integrou informações contextuais globais e um mecanismo de atenção linear com slots com porta para capturar efetivamente as informações contextuais dos usuários, ao mesmo tempo que filtra ruídos e reduz a complexidade computacional. Ele demonstrou melhorias de desempenho em todos os conjuntos de dados, superando os dois modelos de referência com melhor desempenho — o modelo RESTC em 0,54–2,31% e o modelo GCE-GNN em 0,83–10,18%. Isso foi particularmente evidente no tratamento de dependências sequenciais em cenários de sessões longas em SBR (especificamente, melhorias de 10,18% e 4,73% em comparação com GCE-GNN e de 1,44% e 2,31% em comparação com RESTC nos conjuntos de dados Tmall e Nowplaying, respectivamente). De forma breve, o modelo proposto GSLA4Rec incorporou uma construção eficiente de grafos para capturar os contextos dos usuários e filtrar ruídos; seu desempenho superou consistentemente o estado da arte em todos os conjuntos de dados.
Analisando a eficiência
Conforme mostrado na Figura 4, os resultados experimentais no conjunto de dados Diginetica mostraram que o GSLA4Rec proposto alcançou uma velocidade de treinamento mais rápida do que os modelos de referência em termos de tempo de treinamento por época, com todos os experimentos executados em uma GPU NVIDIA TITAN V e consumindo aproximadamente 9300 MB de memória. Modelos baseados em aprendizado profundo, incluindo STAMP, NARM e GRU4Rec, executaram-se de forma eficiente, mas apresentaram o desempenho mais fraco; modelos baseados em GNNs e mecanismo de autoatenção, como TASRec e GC-SAN, melhoraram o desempenho, mas sofreram com alto custo computacional. Embora S2-DHCN e CORE, baseados em GNNs, tenham apresentado um leve aumento no tempo de computação, o desempenho geral obteve melhoria notável, particularmente o modelo proposto GSLA4Rec, que exibiu uma melhoria substancial no desempenho. A principal razão foi que o modelo GSLA4Rec gastou menos tempo na construção do grafo do que os modelos de referência; além disso, empregou um mecanismo de atenção linear com portas em duas etapas com slots de memória fixos m, resultando em complexidade temporal linear O(Ldm). Esse design foi significativamente mais eficiente do que a autoatenção padrão O(L2d), ao mesmo tempo que preservou uma forte capacidade de memória por meio da leitura de slots aprimorada por softmax. Realizar experimentos de teste de desempenho no conjunto de teste para sincronizar o tempo de inferência estatística, conforme mostrado na última linha da Tabela 3, demonstrou a vantagem de eficiência do modelo GSLA4Rec, evitando a situação de "alta precisão falsa, mas indisponível" e alcançando verdadeiramente um equilíbrio entre eficácia e eficiência.
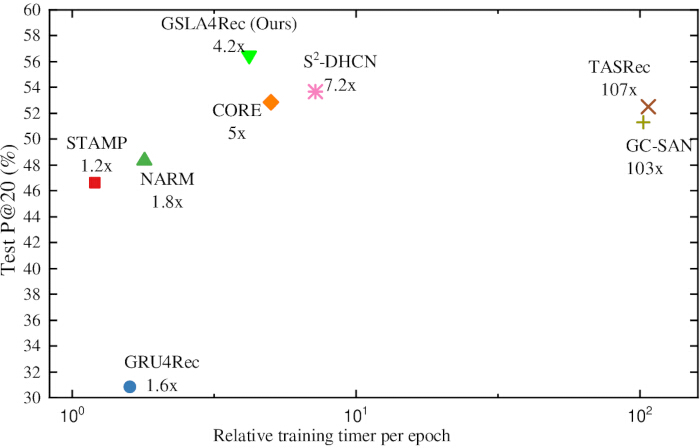
Figura 4: Desempenho ao longo do tempo de execução do GSLA4Rec na Diginetica. A figura mostrou que o nosso modelo proposto GSLA4Rec e os modelos de referência foram executados em GPU NVIDIA TITAN V utilizando Diginetica para o tempo de treinamento relativo por época, e o GSLA4Rec alcançou uma velocidade de treinamento mais rápida do que os modelos de referência. Esta figura foi elaborada manualmente no OriginPro com elementos totalmente personalizados. Nenhum recurso gráfico externo protegido por direitos autorais foi utilizado; portanto, nenhuma licença adicional de direitos autorais de terceiros foi necessária. Os direitos autorais da figura pertencem aos autores e estarão em conformidade com as regras de direitos autorais da revista após a aceitação. GSLA4Rec representa redes neurais gráficas com atenção linear com porta e ranhuras para SBR. Clique aqui para visualizar uma versão maior desta figura.
Em resumo, a eficiência do modelo proposto GSLA4Rec com atenção baseada em slots com comportamento linear superou consistentemente os métodos atuais em todos os conjuntos de dados. Em particular, o GSLA4Rec alcançou ganhos significativos de desempenho em cenários de recomendação de sessões longas nos conjuntos de dados Tmall e Nowplaying, e demonstrou capacidade superior na modelagem de dependências sequenciais.
Análise de experimentos de ablação
Impacto de SG, NGG e GSLA
Para avaliar o impacto do SG, do NGG, do mecanismo de controle, dos slots de memória e da atenção linear no SBR atual, foram realizados estudos de ablação nos conjuntos de dados Diginetica, Tmall e Nowplaying. O GSLA4Rec‑NotSG excluiu a codificação de características do SG, mantendo a codificação do NGG; o GSLA4Rec‑NotNGG descartou a codificação do NGG e realizou a extração de características exclusivamente com base no SG; o GSLA4Rec‑NotGM removeu apenas o mecanismo de controle dentro do GSLA; o GSLA4Rec‑NotMS eliminou apenas os slots de memória do GSLA; e o GSLA4Rec‑NotLA omitiu apenas o módulo de atenção linear no GSLA.
| Conjunto de dados | Diginetica | Tmall | Nowplaying | |||
| Métricas | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54,28 | 18,87 | 31,40 | 15,11 | 22,48 | 7,45 |
| GSLA4Recs-NotNGG | 52,65 | 17,67 | 28,90 | 14,61 | 20,17 | 7,74 |
| GSLA4Rec-NotGM | 53,82 | 18,21 | 39,26 | 16,52 | 23,14 | 7,62 |
| GSLA4Rec-NotMS | 53,40 | 17,60 | 38,05 | 15,65 | 22,55 | 7,40 |
| GSLA4Rec-NotLA | 51,86 | 16,92 | 29,12 | 13,96 | 20,82 | 7,28 |
Tabela 4: Desempenho dos experimentos de ablação do GSLA4Rec. A tabela apresenta o desempenho de ablação do GSLA4Rec após a remoção de componentes individuais do modelo nos conjuntos de dados Diginetica, Tmall e Nowplaying, avaliado utilizando P@20 e MRR@20.
Tabela 4 apresentou os resultados do estudo de ablação em diferentes conjuntos de dados, nos quais todas as métricas de desempenho diminuíram em comparação com o modelo completo. A redução no desempenho ao remover a codificação do grafo global de sessão por vizinhos próximos (GSLA4Rec-NotNGG) foi maior do que ao remover a codificação de características do grafo de sessão (GSLA4Rec-NotSG). A exclusão de qualquer submódulo no GSLA resultaria em degradação do desempenho, sendo essa degradação classificada do mais alto ao mais baixo segundo: atenção linear, slots de memória e mecanismo de portão. O motivo era que a importância de cada item em SBR era definitivamente diferente, e havia necessidade de memória associativa entre os itens. Pode-se concluir que o GSLA era uma parte fundamental do modelo proposto neste artigo.
Impacto de diferentes métodos de agregação
Para avaliar o impacto de diferentes métodos de agregação de informações no desempenho do modelo GSLA4Rec, foram investigados os seguintes três métodos clássicos de agregação de informações: 1) Agrupamento por Média: realizar uma operação de agrupamento médio sobre os vetores gerados pelo SG e pelo NGG; 2) Concatenação de Vetores: concatenar os vetores gerados pelo SG e pelo NGG; 3) Soma de Vetores: somar os vetores gerados pelo SG e pelo NGG. Os resultados foram apresentados na Tabela 5. O GSLA4Rec com soma de vetores (Vec-Sum) obteve o melhor desempenho nos conjuntos de dados Diginetica, Tmall e Nowplaying. Em contraste, o agrupamento por média apresentou resultados pobres em todos os conjuntos de dados. O desempenho inferior da agregação por média e da agregação por concatenação pode decorrer de superajuste causado por parâmetros excessivos, o que degradou o desempenho geral do modelo.
| Conjunto de dados | Diginetica | Tmall | Nowplaying | |||
| Métricas | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Média-Pooling | 45,26 | 15,63 | 38,84 | 16,3 | 23,56 | 7,55 |
| Vec-Concating | 51,77 | 17,24 | 39,83 | 18,24 | 24,06 | 8,88 |
| Vec-Sum | 56,47 | 19,98 | 43,6 | 19,96 | 27,1 | 9,32 |
Tabela 5: Efeitos de diferentes métodos de agregação. A tabela compara os efeitos do agrupamento médio, concatenação de vetores e soma de vetores no desempenho do GSLA4Rec nos conjuntos de dados Diginetica, Tmall e Nowplaying utilizando P@20 e MRR@20.
Análise das configurações de hiperparâmetros
Efeitos de diferentes tamanhos de slots de memória
As ranhuras de memória armazenavam informações de etapas temporais anteriores, o que era particularmente importante para tarefas com dependências temporais. Esta seção investigou o impacto dos tamanhos de ranhuras de memória m = [0, 1, 2, 3, 4, 5] no desempenho do SBR. Os resultados experimentais, apresentados na Tabela 6, indicaram que, quando o tamanho das ranhuras de memória m foi definido como 3, as métricas P@20 e MRR@20 apresentaram desempenho ótimo nos três conjuntos de dados. Isso sugere que um tamanho moderado de ranhuras de memória melhorou efetivamente a precisão da recomendação e a qualidade de classificação do modelo; ranhuras de memória menores têm dificuldade em memorizar informações históricas suficientes e focam mais nos interesses de curto prazo dos usuários, enquanto, ao aumentar o tamanho das ranhuras de memória para 4 ou mais, o modelo armazena informações históricas excessivas, levando-o a depender demais dos interesses passados e negligenciando informações de entrada atuais mais relevantes, o que degrada o desempenho da recomendação.
| Conjunto de dados | Diginetica | Tmall | Nowplaying | |||
| Medidas | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53,40 | 17,60 | 38,05 | 15,65 | 22,55 | 7,40 |
| GSLA4Rec-m1 | 55,43 | 18,92 | 41,55 | 17,12 | 25,60 | 8,43 |
| GSLA4Rec-m2 | 56,02 | 19,35 | 42,90 | 18,25 | 26,62 | 8,95 |
| GSLA4Rec-m3 | 56,47 | 19,98 | 43,60 | 19,96 | 27,10 | 9,32 |
| GSLA4Rec-m4 | 53,96 | 19,25 | 43,06 | 19,09 | 26,34 | 8,35 |
| GSLA4Rec-m5 | 52,18 | 18,03 | 42,12 | 17,56 | 24,86 | 8,85 |
Tabela 6: Efeitos de diferentes tamanhos de slot de memória. A tabela apresenta o desempenho do GSLA4Rec com diferentes configurações de slot de memória (m0–m5) nos conjuntos de dados Diginetica, Tmall e Nowplaying, utilizando P@20 e MRR@20.
Efeitos de diferentes proporções de dropout
Para evitar overfitting, foi introduzida a regularização por dropout. Antes de somar o vetor de itens no nível da sessão e o vetor de itens no nível global dos vizinhos, as saídas dos neurônios foram descartadas aleatoriamente no vetor de itens no nível global dos vizinhos hingg,(k) para aumentar a robustez e a capacidade de generalização do modelo GSLA4Rec.
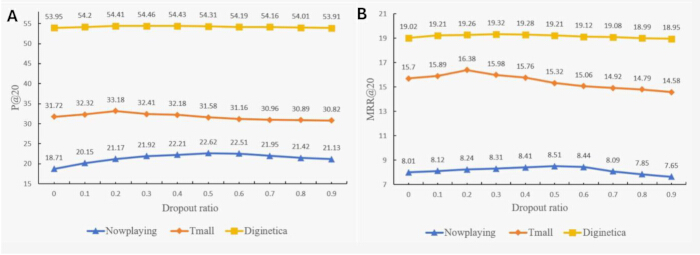
Figura 5: Desempenho do GSLA4Rec sob diferentes taxas de dropout. (A) P@20 e (B) MRR@20 do GSLA4Rec sob diferentes taxas de dropout nos conjuntos de dados Nowplaying, Tmall e Diginetica. O desempenho inicialmente aumentou e depois diminuiu à medida que a taxa de dropout aumentou, demonstrando a robustez e a capacidade de generalização do modelo. GSLA4Rec, redes neurais gráficas com atenção linear de ranhura com porta para recomendação baseada em sessão (SBR). Esta figura foi elaborada pelo próprio autor utilizando o OriginPro com elementos totalmente personalizados. Nenhum recurso gráfico externo protegido por direitos autorais foi utilizado; portanto, nenhuma licença adicional de direitos autorais de terceiros foi necessária. Os direitos autorais da figura pertencem aos autores e estarão em conformidade com as regras de direitos autorais da revista após a aceitação. Clique aqui para visualizar uma versão maior desta figura.
Figura 5A–B mostrou o impacto de diferentes taxas de dropout na Equação (16) sobre o desempenho do modelo. Os resultados experimentais indicaram que o modelo apresenta mau desempenho quando a taxa de dropout é baixa; no entanto, à medida que a taxa de dropout aumenta, o desempenho do modelo melhora gradualmente até atingir um nível ótimo. Especificamente, a taxa de dropout ótima foi de 0,3 no conjunto de dados Diginetica, 0,2 no conjunto de dados Tmall e 0,5 no conjunto de dados Nowplaying. Quando a taxa de dropout excedeu esses valores ótimos, o desempenho do modelo começou a declinar, principalmente porque a eliminação excessiva de neurônios impediu o modelo de aprender efetivamente características importantes dos dados de sessão.
Efeitos de diferentes tamanhos de incorporação
Para minimizar ao máximo a sobrecarga computacional mantendo o desempenho ideal do modelo, investigou-se o impacto de diferentes dimensões de incorporação d no desempenho do modelo GSLA4Rec. Conforme mostrado em Figura 6A–B, em três conjuntos de dados públicos — Diginetica, Tmall e Nowplaying — o modelo GSLA4Rec apresentou desempenho ruim quando a dimensão de incorporação d estava entre 10 e 40; no entanto, o desempenho do modelo aumentou rapidamente à medida que o valor de d cresceu, e as métricas de desempenho tenderam a se estabilizar quando o valor de d esteve na faixa de 80 a 120. Posteriormente, o desempenho realmente diminuiu com o aumento contínuo de d, possivelmente devido ao sobreajuste causado por uma dimensão de incorporação muito grande. Portanto, a dimensão do vetor de incorporação dos itens foi finalmente definida como 100.
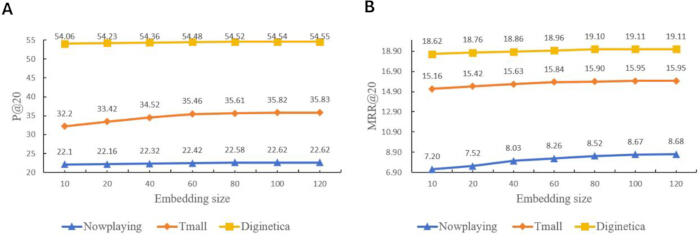
Figura 6: Desempenho do GSLA4Rec com diferentes tamanhos de incorporação. (A) P@20 e (B) MRR@20 do GSLA4Rec com diferentes tamanhos de incorporação nos conjuntos de dados Nowplaying, Tmall e Diginetica. O desempenho do modelo aumentou progressivamente com o aumento do tamanho da incorporação e eventualmente atingiu um platô. GSLA4Rec, redes neurais gráficas com atenção linear baseada em slots com comporta para recomendação baseada em sessão (SBR). Esta figura foi elaborada pelo próprio autor utilizando o OriginPro com elementos totalmente personalizados. Nenhum recurso gráfico externo protegido por direitos autorais foi utilizado; portanto, nenhuma licença adicional de direitos autorais de terceiros foi necessária. Os direitos autorais da figura pertencem aos autores e estarão em conformidade com as regras de direitos autorais da revista após a aceitação. Clique aqui para visualizar uma versão maior desta figura.
Efeitos de diferentes durações de sessão
Sabia-se bem que o comprimento de cada sessão varia entre os três conjuntos de dados reais de SBR (Diginetica, Tmall e Nowplaying). Para verificar a robustez do modelo GSLA4Rec em comparação com as linhas de base em sessões de diferentes comprimentos, todas as sessões em Diginetica e Tmall foram divididas em três grupos: grupo curto (S), grupo médio (M) e grupo longo (L), respectivamente de 1 a 6, 7 a 12 e acima de 12. MRR@20 foi adotado para verificar o desempenho dos métodos em vez de P@20, pois o MRR pode refletir melhor a qualidade da classificação dos resultados corretos. Figura 7A–B indicaram que o modelo GSLA4Rec superou a linha de base baseada em sequência NARM, a linha de base baseada em GNNs SR-GNN, a linha de base GNNs com aprendizado contrastivo S2-DHCN e a linha de base espacial e temporal RESTC em sessões de diferentes comprimentos. Ao mesmo tempo, observou-se também que o desempenho de todos os métodos diminuiu com o aumento do comprimento da sequência, já que transições de itens de longo alcance dificultam a captura das preferências dos usuários, mas o modelo proposto GSLA4Rec apresentou a velocidade de declínio mais lenta em comparação com as linhas de base, já que o mecanismo de slot com porta pode filtrar itens irrelevantes; o desempenho do GSLA4Rec superou respectivamente o do modelo NARM em 6,3 e 8,85 nos grupos longos de Diginetica e Tmall.
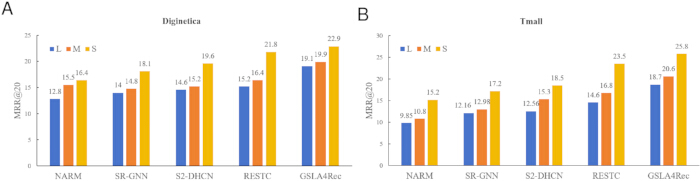
Figura 7: Desempenho do GSLA4Rec em diferentes comprimentos de sessão. Desempenho do GSLA4Rec e modelos de referência em diferentes grupos de comprimento de sessão nos conjuntos de dados (A) Diginetica e (B) Tmall, avaliados utilizando MRR@20. Os grupos de comprimento de sessão são denotados como L, M e S. GSLA4Rec, redes neurais gráficas com atenção linear em slots com portas para recomendação baseada em sessão (SBR). Esta figura foi elaborada pelo próprio autor utilizando o OriginPro com elementos totalmente personalizados. Nenhum recurso gráfico externo protegido por direitos autorais foi utilizado; portanto, nenhuma licença adicional de direitos autorais de terceiros foi necessária. Os direitos autorais da figura pertencem aos autores e estarão em conformidade com as regras de direitos autorais do periódico após a aceitação. Clique aqui para visualizar uma versão maior desta figura.
Conclusão
Este artigo propõe uma rede de atenção linear com ranhuras com contexto global para SBR. Ao combinar SG e NGG e introduzir um mecanismo de atenção linear com ranhuras com comporta, este método permite focar-se em itens-chave na sequência da sessão, capturar dependências de curto e longo prazo, reduzir eficazmente o ruído e diminuir a complexidade computacional. Os resultados experimentais confirmam que este método apresenta excelente precisão e eficiência de recomendação em três conjuntos de dados públicos, destacando-se particularmente em tarefas de modelagem de dependência de longo prazo.
DISPONIBILIDADE DE DADOS:
Três conjuntos de dados públicos comuns (Diginetica, Tmall e Nowplaying, cujas URLs podem ser encontradas na Tabela de Materiais) que apoiam os resultados deste estudo estão disponíveis publicamente na Internet. Ao mesmo tempo, três conjuntos de dados públicos amplamente utilizados e o código-fonte deste trabalho foram enviados como Pasta Suplementar: GSLA4Rec.zip. Clique aqui para baixar este arquivo.
Discussão
Compared with baselines, the GSLA4Rec model achieves dual improvements in performance and efficiency for three core reasons. First, applying gating mechanisms to NGG alleviates data sparsity and filters noise effectively. Second, the memory slots mechanism balances storage capacity and efficiency via hyperparameter m adjustment. Third, the linear attention mechanism computes item correlations at an O(N) complexity, far lower than the O(N2)61. The GSLA4Rec model overly relies on users' interaction sequences and ignores the multimodal properties of items48. Meanwhile, the NGG construction uses a fixed Jaccard threshold without dynamic adjustment function, and the memory slots m cannot achieve adaptive adjustability65.
The GSLA4Rec model, which builds SG&NGG and adopts gated-slot linear attention, especially fits anonymous session recommendation39 across e-commerce and online streaming platforms. In e-commerce platforms, this model recommends matching products to users by capturing their browsing, clicking, or adding behaviors to their shopping cart, without relying on user characteristic attributes. The datasets Diginetica and Tmall used in this paper are e-commerce recommendation datasets. For short-video and music streaming platforms, this method analyzes users' playback sequences to infer their implicit preferences, updates content summaries to retain users, and extends viewing time. The dataset Nowplaying used in this paper is the music recommendation dataset.
There are alternative solutions that can replace the gated slot linear attention architecture. The emerging Mamba65 based state space model, as an alternative, has the characteristics of selective state storage space and linear computational complexity, balancing linear complexity and long sequence fitting ability, and combined with the LLM55 enhancement framework, it extracts the users' implicit intent from the original interaction log, thereby achieving good recommendation performance and efficiency. Future work can optimize GSLA4Rec from multiple perspectives: building dynamic NGG to replace fixed Jaccard filtering, implementing variable memory slots to automatically match sessions of different lengths, and incorporating user multimodal information to improve recommendation accuracy. In addition, with the help of LLM-augmented models55, users' implicit intentions can be mined from interaction sequences, and noisy conversation data can be filtered more accurately72.
Divulgações
Os autores declaram que não possuem interesses financeiros concorrentes conhecidos ou relações pessoais que poderiam ter influenciado o trabalho relatado neste artigo.
Agradecimentos
O autor agradece aos revisores pelos comentários e sugestões ponderados durante o processo de revisão, e ao Professor Jiang Nan, meu orientador de doutorado, por sua orientação cuidadosa. Este estudo foi parcialmente apoiado pelo National Science Foundation of China sob a concessão nº 6217072713 e concessão nº 62061019, e por temas de pesquisa aberta parcialmente financiados pelo Jiangxi Province unmanned sensing system and artificial intelligence technology Engineering Research em 2025, e parcialmente pelo Jiangxi Provincial Key Laboratory of Advanced Electronic Materials and Devices (nº 2024SSY03012).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | NONE | CUDA 11.3 é uma versão da plataforma e modelo de programação de computação paralela lançada pela NVIDIA em 2021, destinada a aprimorar o desempenho e a flexibilidade de desenvolvimento de aplicações aceleradas por GPU. |
| Diginetica | Diginetica | NONE | Diginetica é o conjunto de dados oficial da competição CIKM (Conferência Internacional sobre Recuperação de Informação) Cup de 2016, que foi utilizado na competição de algoritmos CIKM para resolver o problema de recuperação personalizada de produtos no comércio eletrônico com contexto de busca. Atualmente, tornou-se o conjunto de dados padrão mais difundido na área de Recomendação Baseada em Sessão (SBR). |
| Nowplaying | Zenodo | NONE | É um conjunto de dados em larga escala de comportamento de escuta de música construído com base na mineração de tuítes com a tag "#nowplaying", cujo núcleo é usado para pesquisa em recomendação de conversação musical, recomendação com base em contexto e análise de correlação de sentimento. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | NONE | OriginPro é um software científico comercial profissional de desenho e análise de dados desenvolvido pela OriginLab Corporation, comumente utilizado para criar gráficos de nível acadêmico, estatísticas de dados, ajuste de curvas, processamento de sinais, etc. Este artigo utiliza o OriginPro para gerar gráficos comparativos experimentais, gráficos de linhas e gráficos de barras. |
| PyTorch 1.11.0 | PyTorch Foundation | NONE | PyTorch é uma estrutura de aprendizado profundo de código aberto para aprendizado de máquina e aprendizado profundo, lançada pelo Facebook em 2016. Ele implementa principalmente diferenciação automática e introduz gráficos de computação dinâmicos, tornando a construção de modelos mais flexível. |
| TITAN V GPU | NVIDIA | NONE | NVIDIA TITAN V é uma placa gráfica topo de linha lançada pela NVIDIA no final de 2017, voltada principalmente para computação de alto desempenho e áreas de inteligência artificial. |
| Tmall | Tmall | NONE | Originado da Competição de Recomendação Alibaba Tmall IJCAI 2015, a Alibaba Tianchi divulgou publicamente logs reais do Tmall online com dados desensibilizados. É um dos três conjuntos de dados padrão na área SBR (Diginetica, Yoocoose, Tmall) e o conjunto preferido para avaliação em cenários de comércio eletrônico chinês. |
| visio 2021 | Microsoft | NONE | Visio é um software de desenho vetorial desenvolvido pela Microsoft, usado para criar diagramas de estrutura de modelos, fluxogramas, diagramas de estrutura, diagramas de topologia de rede em artigos científicos e gerar ilustrações vetoriais para publicações |
Referências
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.