Este protocolo descreve a geração de um conjunto de dados baseado em condições meteorológicas e a avaliação sistemática de modelos de aprendizado de máquina, aprendizado profundo e modelos híbridos para prever a atenuação atmosférica em comunicações ópticas no espaço livre sob diversas condições ambientais iraquianas, incluindo tempestades de poeira, neblina, chuva e neve.
Artigo de investigação
Aprendizado de Máquina Supera Aprendizado Profundo na Predição de Atenuação Atmosférica em Comunicações Ópticas de Espaço Livre sob Condições Climáticas Iraquianas
Neste artigo
Resumo
Resumo
Os sistemas de comunicação óptica em espaço livre oferecem largura de banda elevada, maior segurança e operação sem necessidade de licença, mas são fortemente afetados pela degradação de desempenho devido à atenuação atmosférica causada por espalhamento e absorção. A previsão precisa da atenuação é ainda mais importante no Iraque, onde o ambiente é quente, poeirento, nebuloso e chuvoso de forma aleatória. O objetivo deste estudo é avaliar o desempenho de técnicas de aprendizado de máquina, aprendizado profundo e modelagem híbrida para a previsão da atenuação atmosférica em sistemas de comunicação óptica em espaço livre sob diferentes condições meteorológicas iraquianas. Um conjunto de dados sintético com 1500 amostras foi criado utilizando modelos físicos de propagação bem estabelecidos para cinco regimes meteorológicos: céu limpo, neblina, chuva, tempestades de poeira e neve. Quinze modelos preditivos foram avaliados sistematicamente, compostos por seis técnicas de aprendizado de máquina (Random Forest [RF], Extreme Gradient Boosting, Light Gradient Boosting Machine, Support Vector Regression, Regressão Linear e K-Vizinhos Mais Próximos), seis arquiteturas de aprendizado profundo (Perceptron Multicamadas, Rede Neural Profunda, Long Short-Term Memory [LSTM], Rede Neural Convolucional Unidimensional [CNN], CNN–LSTM e Rede Baseada em Atenção) e três abordagens híbridas. Os resultados mostraram que o RF obteve o melhor desempenho (R2 = 0,9654, erro quadrático médio = 1,324 dB/km) em comparação com as abordagens de aprendizado profundo (melhor R2 = 0,7766) e métodos híbridos (melhor R2 = 0,9571). A importância das características foi analisada por meio das Explicações Aditivas de Shapley, sendo a concentração de poeira (67,3%) e a visibilidade (21,2%) identificadas como os fatores mais influentes. Embora o RF tenha apresentado tempos substancialmente mais rápidos de treinamento e inferência, testes estatísticos revelaram nenhuma diferença significativa entre o RF e a melhor abordagem híbrida (p = 0,083). Demonstra-se que as técnicas convencionais de aprendizado de máquina são altamente eficientes para a estimativa da atenuação atmosférica em sistemas de comunicação FSO sob condições ambientais adversas, em concordância com teorias físicas de propagação bem conhecidas. Entretanto, enfatizamos que essas conclusões são baseadas em dados sintéticos e devem ser validadas por medições atmosféricas reais antes de serem utilizadas em sistemas FSO operacionais.
Introdução
As redes de comunicação óptica em espaço livre (FSO) geralmente oferecem maior capacidade e melhor segurança, mas a atenuação atmosférica devido à dispersão e absorção é um fator limitante importante para a distância de comunicação1. Neste trabalho, apresentamos uma análise detalhada de abordagens baseadas em aprendizado de máquina, aprendizado profundo e métodos híbridos2 para avaliar a atenuação do sinal FSO no ambiente desafiador do Iraque, com altas temperaturas, tempestades de poeira e precipitação irregular.
Os sistemas de comunicação por FSO surgiram como uma das soluções promissoras para conectividade sem fio de alta largura de banda3 com taxas de dados superiores a 100 Gbps em distâncias que vão de centenas de metros a alguns quilômetros4. Os enlaces FSO operam no espectro visível e infravermelho, diferentemente dos sistemas convencionais de radiofrequência, oferecendo benefícios como operação sem necessidade de licença, imunidade a interferências eletromagnéticas, segurança aprimorada por meio da baixa divergência do feixe e grande capacidade de largura de banda5. Essas características tornam o FSO uma tecnologia atrativa para aplicações de backhaul, enlaces entre edifícios, redes de recuperação em desastres e conectividade de último quilômetro, onde a implantação de fibra óptica é proibitivamente cara6. Contudo, a comunicação por meio de espalhamento, desvio do feixe e absorção7,8 depende fortemente das condições ambientais em termos de disponibilidade e desempenho. Esse desafio é uma das principais limitações dos sistemas de comunicação óptica em espaço livre. As condições meteorológicas provocam grandes variações nos níveis de atenuação (dB/km). Em condições de céu limpo, a atenuação pode ser inferior a 0,5 dB/km, enquanto a neblina severa pode elevar a atenuação a ≥50 dB/km em 1550 nm (usando o modelo de neblina de Kim, que prevê valores de atenuação até 50 dB/km para visibilidade abaixo de 50 m em 1550 nm)9,10, e a chuva forte pode causar atenuação de até 20–30 dB/km, dependendo da taxa de precipitação (previsão do modelo Carbonneau)11. Assim, é necessária uma previsão precisa da atenuação para o projeto confiável de enlaces, planejamento de redes e estratégias de transmissão adaptativas. Os métodos convencionais baseiam-se em modelos físicos de propagação, como o modelo de Kim para neblina12, o modelo de Carbonneau para chuva13 e a teoria de espalhamento de Mie para partículas de aerossóis14. No entanto, embora esses modelos forneçam uma boa base teórica, muitas vezes dependem de parâmetros atmosféricos precisos que nem sempre estão disponíveis na prática e frequentemente não consideram as interações complexas entre múltiplos fenômenos meteorológicos simultâneos15.
A variabilidade ambiental extrema no Iraque apresenta desafios significativos para a implantação de sistemas de comunicação óptica em espaço livre. As condições de transmissão são ainda mais complicadas pela escassez de chuvas e episódios isolados de nevoeiro, enquanto as temperaturas no inverno podem cair abaixo do ponto de congelamento e no verão podem ultrapassar 50 °C16. Em espectros normalmente utilizados, como 1550 nm em comprimentos de onda comuns, tempestades de poeira, conhecidas localmente como "al-haboob", podem restringir a visibilidade a menos de 100 metros, resultando em valores de atenuação superiores a 20 dB/km17. Para que os sistemas FSO sejam implantados com sucesso no Iraque e em outras nações do Oriente Médio, é necessário desenvolver modelos confiáveis de previsão capazes de estimar com precisão o desempenho do sistema sob essas diversas condições ambientais18.
Novos avanços na aprendizagem de máquina apresentam substitutos viáveis às técnicas convencionais baseadas na física para modelagem. A capacidade das técnicas de aprendizagem de máquina de aprender diretamente correlações não lineares complexas entre atenuação e fatores atmosféricos permite a detecção de interações sutis que modelos analíticos tradicionais poderiam ignorar19. Em diversas tarefas de previsão climatológica, as estratégias Floresta Aleatória (RF) e boosting por gradiente demonstraram bom desempenho20. Da mesma forma, técnicas de aprendizagem profunda têm obtido sucesso notável em processamento de linguagem natural, visão computacional e previsão de séries temporais21. No entanto, essas abordagens são pouco exploradas para a previsão de atenuação em FSO, especialmente com conjuntos de dados limitados e condições climáticas altamente variáveis22. Para preencher essa lacuna, este trabalho apresenta uma investigação abrangente de abordagens de aprendizagem de máquina, aprendizagem profunda e híbridas para prever a atenuação do sinal FSO nas condições atmosféricas do Iraque. Isso é alcançado pela construção de um conjunto de dados sintético bem projetado, baseado em modelos de propagação física amplamente conhecidos23. Hipotetizamos que, para conjuntos de dados ambientais tabulares de tamanho moderado com poucas variáveis preditivas dominantes, o desempenho preditivo de métodos ensemble baseados em árvores superará arquiteturas complexas de aprendizagem profunda. Os objetivos principais são (1) estabelecer uma metodologia de referência para comparação de métodos de previsão em um ambiente de simulação controlado, (2) identificar as melhores estratégias algorítmicas para prever a atenuação atmosférica e (3) avaliar a importância das características e a interpretabilidade do modelo para obter insights sobre os fatores ambientais que mais afetam a atenuação. Neste trabalho, são utilizados dados sintéticos, mas é estabelecida a base para uma futura validação com medições experimentais do mundo real, o que está previsto para trabalhos futuros. Além disso, análises de importância e interpretabilidade das características são incorporadas para determinar os fatores ambientais mais relevantes que influenciam a atenuação.
Protocolo
Este estudo não envolveu participantes humanos ou animais vertebrados, nem coleta de tecidos. Todos os dados utilizados nesta pesquisa foram gerados sinteticamente usando modelos físicos de propagação e parâmetros meteorológicos de acesso público. Portanto, nenhuma aprovação ética por parte de um Comitê de Ética em Pesquisa (IRB) ou Comitê Institucional de Cuidado e Uso de Animais (IACUC) foi necessária.
Geração do Conjunto de Dados com Base na Teoria Física de Propagação. O conjunto de dados foi elaborado para simular condições atmosféricas horárias de um sistema de comunicação óptica em espaço livre durante um ano civil completo (2024), considerando as condições atmosféricas do Iraque. Criamos uma base de dados sintética com 1.500 amostras por hora.
Primeiro, as condições meteorológicas foram atribuídas aleatoriamente com base em tendências regionais: céu limpo (54,3%), poeira (24,9%), neblina (10,5%), chuva (7,4%) e neve (2,8%). Em segundo lugar, o modelo físico de atenuação correspondente foi aplicado a cada amostra com base na condição meteorológica, ou seja, a lei de Beer-Lambert para céu limpo, o modelo de Kim para neblina, a teoria de Carbonneau para chuva e a teoria de espalhamento de Mie para tempestades de poeira. Terceiro, os parâmetros do sistema FSO foram definidos da seguinte forma: potência de transmissão de 20 dBm, comprimento de onda de 1550 nm, distância de transmissão de 3 km, abertura de transmissão de 2,5 cm e abertura receptora de 20 cm. Quarto, a atenuação foi calculada em dB/km para cada amostra. Finalmente, o conjunto completo de dados foi dividido aleatoriamente em 1.200 amostras de treinamento (80%) e 300 amostras de teste (20%). As condições simuladas incluem altas concentrações de poeira associadas a tempestades de areia, chuvas fortes e variações de temperatura de −4,89°C a 47,99°C. As condições meteorológicas e as distribuições de parâmetros foram selecionadas com base nos registros climáticos do Iraque no período de 2020 a 2024. Os cinco regimes meteorológicos (céu limpo, neblina, chuva, tempestades de poeira e neve) foram escolhidos porque abrangem todo o espectro de condições atmosféricas que afetam a atenuação FSO no Iraque, sendo as tempestades de poeira especialmente prevalentes no Oriente Médio. Os dados históricos de meteorologia coletados em diversas regiões do Iraque foram utilizados para criar a distribuição de probabilidade para cada condição meteorológica. A distribuição resultante foi a seguinte: 54,3% de céu limpo (estado predominante), 24,9% de poeira (representando o problema de tempestades de areia no Iraque), 10,5% de neblina (frequente nos invernos do norte do Iraque), 7,4% de chuva (baixos índices pluviométricos típicos do Iraque) e 2,8% de neve (ocasional em regiões montanhosas do norte). Os parâmetros meteorológicos relevantes foram modelados utilizando distribuições de probabilidade para cada condição meteorológica da seguinte forma: a temperatura foi modelada usando uma distribuição normal (média 28,55±11,18°C) entre −4,89°C e 47,99°C com base nos extremos sazonais do Iraque; a umidade foi modelada usando uma distribuição uniforme (média 42,01±25,56%) de 0% a 100%; a visibilidade foi modelada usando uma distribuição log-normal entre 0,05 km e 29,99 km (média 13,10±10,91 km) para considerar os frequentes eventos de baixa visibilidade durante tempestades de poeira; a concentração de poeira foi modelada usando uma distribuição exponencial entre 0 e 4,96 mg/m3 (média 0,74±1,30 mg/m3), com maiores probabilidades para baixas concentrações e caudas longas para eventos extremos de poeira.
O sistema de comunicação foi projetado com uma potência de transmissão de 20 dBm, um comprimento de onda de 1550 nm, uma distância de transmissão de até 3 km, uma abertura de transmissão de 2,5 cm e uma abertura de recepção de 20 cm para compensar a perda por divergência. Os parâmetros do sistema FSO foram divididos em dois grupos: parâmetros fixos que não mudaram para todas as amostras e parâmetros variáveis que foram alterados durante a geração do conjunto de dados. Para todas as 1.500 amostras, os seguintes parâmetros foram fixos: potência de transmissão (20 dBm), comprimento de onda de operação (1550 nm), abertura de transmissão (diâmetro de 2,5 cm, eficiência de 0,7) e abertura de recepção (diâmetro de 20 cm, eficiência de 0,7). Esses parâmetros foram fixados porque correspondem às especificações físicas do hardware do sistema FSO e não variam com as condições meteorológicas. O conjunto de dados foi criado com 1.500 amostras, variando os seguintes parâmetros: temperatura (−4,89°C a 47,99°C), umidade (0% a 100%), visibilidade (0,05 km a 29,99 km), concentração de poeira (0 a 4,96 mg/m3) e condição meteorológica (céu limpo, neblina, chuva, poeira, neve). Esses parâmetros foram modificados de acordo com distribuições de probabilidade derivadas de registros climáticos do Iraque para os anos de 2020 a 2024. Para cada amostra, o valor de atenuação (dB/km) foi calculado utilizando o modelo físico de atenuação correspondente, de acordo com a combinação específica de condições meteorológicas e parâmetros variáveis.
A atenuação física foi modelada utilizando o modelo de Carbonneau para chuva, a lei de Beer-Lambert para céu limpo, a teoria de espalhamento de Mie para poeira e o modelo de Kim para nevoeiro24. A lei de Beer-Lambert aplica-se a condições de céu claro, nas quais a atenuação é dominada pelo espalhamento molecular e absorção, que diminuem exponencialmente com a distância25. O coeficiente de extinção α em 1550 nm é devido ao espalhamento Rayleigh por moléculas de ar e à absorção por gases atmosféricos26. O modelo de Kim é um modelo específico para nevoeiro que relaciona a atenuação à visibilidade por meio de coeficientes empíricos derivados das distribuições de tamanho das gotículas de nevoeiro. O expoente dependente do comprimento de onda q leva em conta o espalhamento de Mie27. O parâmetro principal do modelo de Carbonneau é a taxa de precipitação R, já que a atenuação pela chuva depende do tamanho e da densidade das gotas de chuva, e os coeficientes são derivados empiricamente em 1550 nm e calibrados especificamente para comprimentos de onda ópticos28. A teoria de espalhamento de Mie é aplicável a condições de poeira, uma vez que o tamanho das partículas de poeira (raio de 0,1–100 μm) é comparável ao comprimento de onda (1550 nm), e o índice de refração complexo m = 1,55–0,005i para poeira do Oriente Médio inclui tanto espalhamento quanto absorção29. Os seguintes modelos físicos de atenuação foram implementados com suas respectivas equações e configurações de parâmetros.
Para condições de céu claro, a lei de Beer-Lambert foi utilizada:
Aclear = 10×log₁₀(e(α×d)) (1)
em que α é o coeficiente de extinção (variado usando uma distribuição normal centrada em 0,02 dB/km com variação de ±0,005 dB/km a 1550 nm sob condições claras), e d é a distância de transmissão (fixa em 3 km). Para condições de neblina, o modelo de Kim foi implementado usando a equação:
Afog = 10×ln(10)/V×(λ/550)−q (2)
em que V é a visibilidade em quilômetros (variando de 0,05 km a 10 km), λ é o comprimento de onda em nanômetros (fixado em 1550 nm) e q é o coeficiente de distribuição do tamanho das partículas calculado como: q = 1,6 para V>50 km, q = 1,3 para 6<V<50 km, q = 0,585×V(1/3) para 1 <V<6 km, q = 0 para 0,5<V<1 km e q = 0,5 para V<0,5 km. Para condições de chuva, utilizou-se o modelo de Carbonneau:
Arain=0.023×R0.93 (3)
em que R é a taxa de precipitação em mm/h (variando entre 0,25 e 50 mm/h conforme registros pluviométricos do Iraque). A relação de eficiência de extinção foi utilizada para as condições de tempestade de poeira, empregando o espalhamento de Mie:
Adust=10×log₁₀(e(τ×L)) (4)
em que τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r é o raio da partícula (0,1–100 μm de acordo com a composição do pó iraquiano), Qext é a eficiência de extinção calculada utilizando a teoria de Mie, λ=1550 nm, m=1,55–0,005i é o índice de refração complexo para poeira do Oriente Médio e N(r) é a distribuição do tamanho das partículas modelada usando uma distribuição log-normal com raio médio geométrico de 2,5 μm e desvio padrão de 2,0. O modelo de atenuação foi implementado para condições de neve da seguinte forma:
Asnow = 0.1×S0.75 (5)
onde S é a taxa de precipitação de neve em mm/h (0,5–15 mm/h). Esta equação empírica foi escolhida com base no trabalho descrito na literatura30, em que foram desenvolvidos modelos de atenuação para propagação óptica através da neve utilizando a teoria de espalhamento de Mie aplicada às distribuições de tamanho de flocos de neve. A equação é válida para taxas de queda de neve entre 0,5 e 15 mm/h e assume condições de neve seca com diâmetros típicos de flocos de 1–10 mm. O coeficiente 0,1 e o expoente 0,75 foram obtidos por ajuste de curva aos cálculos de espalhamento de Mie30 para neve em 1550 nm. O modelo não faz ajustes para neve úmida ou precipitação combinada, que podem apresentar propriedades de atenuação variáveis, embora ofereça uma estimativa razoável para neve seca. Devido à eficácia computacional do método, seu frequente uso nas publicações sobre FSO e sua adequação às condições de neve previstas no norte do Iraque (região do Curdistão em janeiro e fevereiro), ele foi selecionado para esta investigação. Utilizando o Numpy para cálculos numéricos, todos os modelos foram implementados em Python 3.9. O modelo correspondente foi aplicado às condições meteorológicas escolhidas aleatoriamente e aos dados ambientais amostrados para calcular o valor de atenuação de cada amostra. A distribuição meteorológica obtida incluiu 814 condições de céu limpo (54,27%), 375 eventos de poeira (25,00%), 157 eventos de neblina (10,47%), 111 eventos de chuva (7,40%) e 43 eventos de neve (2,87%).
O exame de informações meteorológicas históricas coletadas em estações meteorológicas iraquianas em diversas regiões (Bagdá, Basra, Mossul e Ramadi) entre 2020 e 2024 foi utilizado para estabelecer as proporções das situações meteorológicas. Os dados originais foram fornecidos pelo Ministério dos Transportes do Iraque e pela Organização Meteorológica do Iraque e Sismologia (IMOS). Os dados incluíram registros meteorológicos diários que registravam as condições atmosféricas vigentes em cada dia. Entre as características específicas extraídas desses registros estavam temperatura (mínima, máxima e média diárias), umidade relativa, visibilidade, quantidade de precipitação pluviométrica e ocorrências de tempestades de poeira. Uma parte dos dados da IMOS está disponível no portal de dados abertos do governo iraquiano (https://www.motrans.gov.iq/); no entanto, os registros específicos utilizados neste estudo não são armazenados publicamente em um repositório central. A informação climática utilizada para calcular as porcentagens das condições meteorológicas e dos valores dos parâmetros está resumida na Tabela 1. Os dias com céu limpo foram definidos como dias sem precipitação, com visibilidade superior a 10 km e sem atividade de poeira, representando 54,27% dos 1.825 dias registrados. Os dias com tempestade de poeira (incluindo tempestade de poeira total (visibilidade < 1 km) e tempestade de poeira parcial (visibilidade entre 1 e 10 km)) representaram 22,47% do período analisado, enquanto os dias nublados (sem precipitação, mas com cobertura de nuvens superior a 7/8 do céu) representaram 15,07%. Os dias chuvosos, definidos como aqueles com precipitação pluviométrica acima de 0,1 mm, representaram 8,22% do total. < 1 km) e poeira suspensa (visibilidade de 1–5 km)) corresponderam a 25,00% dos dias, indicando a alta frequência de eventos de tempestades de areia no clima árido e semiárido do Iraque. Os dias com visibilidade inferior a 1 km causados pela suspensão de gotículas de água (excluindo a redução da visibilidade induzida por poeira) foram classificados como dias de nevoeiro. A porcentagem de dias de nevoeiro foi de 10,47%, ocorrendo principalmente no inverno nas regiões do norte do Iraque. Dias de chuva, dias com precipitação mensurável >0,1 mm, foram de 7,40%, consistente com a baixa média de precipitação anual no Iraque, de 150–200 mm por ano. Os dias com neve (dias com acúmulo de precipitação congelada) representaram 2,87% dos dias e estiveram restritos às áreas montanhosas do norte (região do Curdistão) em janeiro e fevereiro. Essas proporções foram posteriormente utilizadas como pesos probabilísticos para amostragem aleatória na geração do conjunto de dados. Assim, o conjunto de dados sintético reflete a frequência real de cada condição meteorológica no ambiente iraquiano.
Considerações sobre viés na geração de dados sintéticos
Várias etapas foram tomadas para reduzir possíveis vieses:
(1) Seleção da distribuição: As propriedades estatísticas dos dados climáticos de origem foram utilizadas para selecionar as distribuições de probabilidade. A temperatura apresentava distribuição normal com média e desvio padrão conforme registrado pelo IMOS. A umidade apresentava distribuição uniforme em toda a faixa observada (0-100%). Assumiu-se que a visibilidade seguisse uma distribuição log-normal para levar em conta a ocorrência frequente de eventos de baixa visibilidade durante tempestades de poeira. A concentração de poeira seguia uma distribuição exponencial, na qual havia maiores probabilidades em baixas concentrações e caudas longas em eventos extremos de poeira31. Isso estava de acordo com a frequência observada de eventos de poeira no Iraque32.
(2) Proporções das condições meteorológicas: A análise dos registros do IMOS para o período de 2020 a 2024, compreendendo 1.825 observações diárias em todas as quatro regiões, resultou nas seguintes proporções: 54,3% céu claro, 24,9% poeira, 10,5% neblina, 7,4% chuva e 2,8% neve. Dias sem precipitação, visibilidade >10 km e ausência de atividade de poeira foram definidos como dias de céu claro. Dias com tempestades de poeira incluíram tanto tempestades completas (visibilidade <1 km) quanto poeira suspensa (visibilidade entre 1 e 5 km). Um dia de neblina foi definido como um dia em que a visibilidade era inferior a 1 km e a causa era a suspensão de gotículas de água (não poeira). Dias de chuva foram definidos como dias com precipitação mensurável >0,1 mm. Dias de neve foram definidos como dias com precipitação congelada acumulada33.
(3) Faixas de parâmetros: As faixas de parâmetros foram baseadas nos extremos observados nos registros do IMOS: a temperatura variou de −4,89 °C (Mosul, inverno) a 47,99 °C (Basra, verão), a visibilidade variou de 0,05 km (tempestades de poeira severas) a 29,99 km (condições claras) e a concentração de poeira variou de 0 a 4,96 mg/m³ (com base na concentração máxima de poeira observada durante eventos severos de haboob)34.
(4) Pressupostos de Independência: Assumimos que os parâmetros ambientais foram amostrados de forma independente, o que representa uma simplificação das condições do mundo real, nas quais as variáveis atmosféricas são correlacionadas (por exemplo, alta concentração de poeira geralmente se correlaciona com baixa visibilidade). A fim de fornecer um ambiente de simulação controlado para comparação metódica de modelos, adotou-se este pressuposto de independência 35. As consequências desses pressupostos são abordadas na Discussão.
(5) Divisão Estratificada: A divisão entre treinamento e teste foi realizada de forma estratificada com base na categoria de condição meteorológica (céu limpo, neblina, chuva, poeira, neve) para garantir que a proporção de cada condição meteorológica nos conjuntos de treinamento e teste correspondesse à distribuição do conjunto de dados original. Dessa forma, o conjunto de teste não fica desbalanceado em relação a condições meteorológicas raras (especialmente neve, com 2,87%)36.
Reconhecimento da geração determinística de alvos
É importante destacar que o bom desempenho preditivo observado aqui pode ser parcialmente atribuído ao modelo ter aprendido ou aproximado as equações físicas determinísticas utilizadas para gerar os valores-alvo sintéticos37. Diferentemente das medições experimentais do mundo real, que contêm ruído de medição, erros de instrumento e fenômenos físicos não modelados, o conjunto de dados sintéticos oferece uma relação limpa e isenta de ruído entre as características de entrada e o alvo de atenuação. Isso ocorre porque os valores de atenuação foram calculados diretamente a partir dos modelos físicos de propagação (lei de Beer-Lambert, modelo de Kim, modelo de Carbonneau e teoria de espalhamento de Mie) com base nos parâmetros de entrada. Assim, as métricas quantitativas de desempenho (R2, RMSE, MAE) representam o desempenho em dados sintéticos derivados de equações e não devem ser interpretadas como desempenho esperado em dados observacionais ou experimentais com ruído. Os resultados devem ser encarados principalmente como uma avaliação comparativa de metodologias de modelagem em um ambiente de simulação controlado38.
Conjunto completo de características para o treinamento do modelo
O conjunto de dados de treinamento tinha 10 características de entrada para o treinamento do modelo:
1. Temperatura (°C)
2. Umidade (%)
3. Visibilidade (km)
4. Concentração de poeira (mg/m3)
5. Taxa de precipitação (mm/h)
6. Taxa de precipitação de neve (mm/h)
7. Velocidade do vento (m/s)
8. Pressão atmosférica (hPa)
9. Mês (numérico, 1–12)
10. Estação (codificada em uma saída: primavera, verão, outono, inverno)
Esclarecimento importante: as condições meteorológicas (céu limpo, neblina, chuva, poeira, neve) foram utilizadas como uma variável categórica para estratificação durante a divisão do conjunto de dados e não foram incluídas como características de entrada em nenhum modelo. A análise SHAP inclui apenas as 10 características listadas acima. A variável estação foi codificada em one-hot (4 categorias: primavera, verão, outono, inverno), e para a análise SHAP, as contribuições das variáveis de estação codificadas em one-hot foram somadas ao longo das estações para produzir um único valor de contribuição da estação. Esse valor combinado representa a contribuição total de todas as variáveis relacionadas à estação para a predição da atenuação. Antes de criar a figura resumo, as quatro colunas de estação codificadas em one-hot foram identificadas, e seus valores SHAP foram somados para cada amostra. Esse método garante que o uso da estação pelo modelo como uma variável categórica composta seja consistente com a análise SHAP.
Os principais fatores ambientais que afetaram diretamente a atenuação óptica por meio de mecanismos físicos foram as características 1–6. A inclusão das características 7 e 8 (velocidade do vento e pressão) como fatores meteorológicos complementares pode ter um impacto indireto na atenuação, afetando a estabilidade do ar e a dispersão de aerossóis. Para levar em conta as variações sazonais nas condições atmosféricas, as características 9–10 (mês e estação) foram incluídas como descritores temporais. O valor de atenuação (dB/km) foi utilizado como variável alvo para todos os modelos. As estatísticas principais do conjunto de dados incluíram temperatura (28,55°C ± 11,18°C), umidade (42,01% ± 25,56%), visibilidade (13,10 ± 10,91 km; intervalo: 0,05–29,99 km), concentração de poeira (0,74 ± 1,30 mg/m3; máximo: 4,96 mg/m3), atenuação (4,80 ± 7,20 dB/km; intervalo: 0,09–50,93 dB/km), alcance operacional (5,74 ± 1,97 km) e relação sinal-ruído (64,88 ± 15,07 dB). O Alcance Operacional e a RSR foram calculados a partir dos valores de atenuação utilizando equações padrão de orçamento de enlace FSO.
Cálculo do intervalo de operação
A Faixa de Operação (em km) foi calculada utilizando a equação do orçamento de enlace:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
em que: Prx = potência recebida (definida como a sensibilidade mínima de −30 dBm); Ptx = potência de transmissão (fixa em 20 dBm); Gt = ganho do transmissor (calculado a partir dos tamanhos da abertura); Gr = ganho do receptor (calculado a partir dos tamanhos da abertura); λ = comprimento de onda (1550 nm); R = alcance em km; A = atenuação atmosférica em dB/km (calculada a partir dos modelos físicos).
Ganhos do Transmissor e do Receptor: O ganho do transmissor (Gt) foi calculado como: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44,2 dBi. O ganho do receptor (Gr) foi calculado como: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62,3 dBi. A abertura de transmissão tinha diâmetro de 2,5 cm e eficiência de 0,7. A abertura receptora tinha diâmetro de 20 cm e eficiência de 0,7. A equação foi resolvida iterativamente para R a fim de determinar a distância máxima de enlace alcançável para cada valor de atenuação.
Cálculo da relação sinal-ruído
A RSE (Relação Sinal-Ruído) em dB foi calculada utilizando a equação:
SNR=Prx−10×log₁₀(kTB)−NF (7)
em que: Prx = potência recebida em dBm (calculada a partir do orçamento de enlace); k = 1,38×10⁻23 J/K (constante de Boltzmann); T = 290 K (temperatura do receptor); B = 109 Hz (largura de banda do receptor, 1 GHz); NF = 3 dB (figura de ruído do receptor). O nível de ruído foi calculado como:
10 × log10(kTB) ≈ −84 dBm (8)
Para cada amostra, após calcular a atenuação A utilizando o modelo físico apropriado, a Distância de Operação foi determinada resolvendo o orçamento de enlace para R, e a SNR foi calculada a partir da potência recebida resultante Prx nessa distância.
Valores de Faixa Operacional Específicos para Condições Climáticas: A faixa operacional variou conforme as condições meteorológicas: céu claro (7,12 ± 1,85 km), neblina (5,81 ± 1,92 km), neve (5,42 ± 1,56 km), chuva (3,81 ± 0,98 km) e poeira (3,72 ± 1,08 km). Uma margem de 3 dB não foi aplicada nos cálculos atuais; a faixa operacional representa a faixa máxima teórica sem margem de sistema. A faixa operacional relatada (5,74 ± 1,97 km) é a média geral entre todas as condições climáticas39.
Distância de Transmissão Fixa: A distância de transmissão nos modelos físicos de atenuação foi definida em 3 km. Essa é a distância do enlace para a qual foram realizados os cálculos de atenuação. O alcance operacional informado é a distância máxima teórica calculada utilizando a equação do orçamento de enlace, que pode diferir da distância de transmissão fixa de 3 km. Os valores de atenuação específicos para cada condição climática foram registrados para condições claras (0,27±0,06 dB/km), neblina (1,88±1,92 dB/km), neve (6,45±2,54 dB/km), chuva (13,58±6,32 dB/km) e poeira (13,10±7,32 dB/km). Todos os valores quantitativos relatados neste manuscrito são apresentados como média ± desvio padrão (DP), salvo indicação em contrário40.
O R2 de validação cruzada para Floresta Aleatória é informado como 0,960±0,007. Em certos casos, como temperatura (−4,89 a 47,99°C), visibilidade (0,05 a 29,99 km), concentração de poeira (0 a 4,96 mg/m3) e atenuação (0,09 a 50,93 dB/km), a amplitude (mínimo a máximo) é fornecida por extenso. O conjunto de dados foi dividido em subgrupos para teste (300 amostras; 20%) e treinamento (1.200 amostras; 80%). Utilizou-se amostragem aleatória estratificada para realizar a divisão entre treinamento e teste. Para garantir que a porcentagem de cada condição meteorológica no conjunto de treinamento (80%) e no conjunto de teste (20%) correspondesse à distribuição original do conjunto de dados, foi aplicada estratificação com base na categoria de condição meteorológica (céu limpo, neblina, chuva, poeira e neve). Especificamente, 1.200 (80%) das 1.500 amostras foram alocadas ao conjunto de aprendizado e 300 (20%) ao conjunto de teste. As amostras foram escolhidas aleatoriamente para cada categoria de condições meteorológicas, mantendo as proporções originais: das 814 amostras de céu limpo (54,27%), 651 foram destinadas ao treinamento e 163 ao teste; das 375 amostras de poeira (25,00%), 300 ao treinamento e 75 ao teste; das 157 amostras de neblina (10,47%), 126 ao treinamento e 31 ao teste; das 111 amostras de chuva (7,40%), 89 ao treinamento e 22 ao teste; das 43 amostras de neve (2,87%), 34 ao treinamento e 9 ao teste. A amostragem aleatória dentro de cada estrato foi realizada utilizando uma semente aleatória de 42 para garantir a reprodutibilidade. Essa abordagem estratificada foi escolhida para evitar representação desbalanceada das condições meteorológicas raras (especialmente neve, com 2,87%) no conjunto de teste, o que poderia levar a uma avaliação de desempenho não confiável para essas condições.
Avaliação de modelos de aprendizado de máquina
Seis métodos de aprendizado de máquina foram avaliados, incluindo Regressão por Vetores de Suporte (SVR) com kernel de função de base radial (C = 100), K-Vizinhos Mais Próximos (KNN; k = 10, com ponderação por distância), RF (200 árvores, profundidade máxima = 20), Boosting Extremo por Gradiente (XGBoost; 200 estimadores, profundidade máxima = 10, taxa de aprendizado = 0,1), Máquina de Boosting por Gradiente Leve (LightGBM; 200 estimadores, profundidade máxima = 10, taxa de aprendizado = 0,1) e Regressão Linear de referência. Para todos os modelos de aprendizado de máquina e aprendizado profundo, foi realizada a otimização dos hiperparâmetros mais críticos, enquanto os valores padrão foram mantidos para os parâmetros não especificados. Para os modelos de aprendizado de máquina, os seguintes parâmetros foram ajustados explicitamente usando busca em grade com validação cruzada de 5 dobras no conjunto de treinamento: 1) Floresta Aleatória: número de árvores (testados: 50, 100, 150, 200, 250) e profundidade máxima (testadas: 10, 15, 20, 25, sem limite), com valores ótimos de 200 árvores e profundidade 20 selecionados. 2) XGBoost: número de estimadores (testados: 100, 150, 200, 250), profundidade máxima (testadas: 6, 8, 10, 12) e taxa de aprendizado (testadas: 0,05, 0,1, 0,2), com valores ótimos de 200 estimadores, profundidade 10 e taxa de aprendizado 0,1. 3) LightGBM: foram utilizados intervalos idênticos de ajuste, resultando em 200 estimadores, profundidade 10 e taxa de aprendizado 0,1. 4) SVR: o parâmetro de regularização C (testado: 1, 10, 50, 100) e o coeficiente do kernel gamma (testado: ‘scale’, ‘auto’, 0,1, 0,01) foram ajustados, com valores ótimos de C = 100 e kernel RBF. 5) KNN: o número de vizinhos k (testado: 3, 5, 7, 10, 15) foi ajustado, com valor ótimo de k = 10 e votação ponderada por distância habilitada.
Todos os outros parâmetros para esses modelos foram mantidos em seus valores padrão conforme definidos no scikit-learn (consulte a Tabela de Materiais para a versão; por exemplo, Floresta Aleatória: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0). Para os modelos de aprendizado profundo, a arquitetura (número de camadas e unidades por camada) e a taxa de dropout (20%) foram ajustadas manualmente por meio de experimentação iterativa no conjunto de validação, enquanto o otimizador (Adam), a taxa de aprendizado inicial (0,001), a paciência da parada antecipada (20 épocas) e os parâmetros de redução da taxa de aprendizado (fator 0,5, paciência 10) foram definidos com base em práticas padrão na literatura e mantidos fixos em todos os experimentos de aprendizado profundo.
Fontes de dados climáticos
As informações meteorológicas históricas coletadas de estações meteorológicas no Iraque em diversos locais (Bagdá, Basra, Mossul e Ramadi) entre 2020 e 2024 foram utilizadas para calcular as proporções dos estados climáticos e as distribuições das variáveis. Os dados brutos foram fornecidos pelo Ministério dos Transportes do Iraque e pela Organização Meteorológica do Iraque e Seismologia (IMOS). Os dados incluíram registros diários detalhando o estado atmosférico predominante em cada dia. As variáveis específicas obtidas desses registros incluíram temperatura (mínima, máxima e média diárias), umidade relativa, visibilidade, quantidade de precipitação e ocorrências de tempestades de poeira. Os dados da IMOS estão parcialmente disponíveis por meio do portal de dados abertos do governo iraquiano (https://www.motrans.gov.iq/), embora os registros específicos utilizados neste estudo não estejam arquivados publicamente em um repositório centralizado. Um resumo dos dados climáticos utilizados para determinar as proporções das condições meteorológicas e as faixas de parâmetros é apresentado na Tabela 1.
A validação cruzada cinco vezes foi utilizada no conjunto de treinamento (1.200 amostras) para ajustar os hiperparâmetros e estimar o desempenho de todos os modelos de aprendizado de máquina. Todas as variáveis de entrada (temperatura, umidade, visibilidade, concentração de poeira, taxa de precipitação, taxa de neve, velocidade do vento, pressão) foram padronizadas por escalonamento (normalização por escore Z): x_scaled = (x − μ)/σ, em que μ e σ são a média e o desvio padrão do conjunto de treinamento. Realizamos a padronização dentro de cada dobra da validação cruzada utilizando apenas as estatísticas da dobra de treinamento para evitar vazamento de dados. Modelos baseados em árvores (Floresta Aleatória, XGBoost, LightGBM) são invariantes à escala, mas a mesma padronização foi aplicada para garantir consistência entre todos os modelos de aprendizado de máquina. A normalização por min-máx foi utilizada para modelos de aprendizado profundo: x_scaled = (x−x_min)/(x_max−x_min), que transforma as características para a faixa [0, 1] com base nos valores mínimos e máximos do conjunto de treinamento. Entradas limitadas promovem uma convergência mais rápida das redes neurais, razão pela qual foram escolhidas. O conjunto de teste foi escalonado utilizando os parâmetros obtidos a partir do conjunto de treinamento, e não foi usado para seleção de modelos ou ajuste de hiperparâmetros.
As métricas completas de desempenho foram registradas, incluindo o coeficiente de determinação do teste (R2), erro quadrático médio (RMSE), erro absoluto médio (MAE), R2 da validação cruzada e tempo de treinamento. Os tempos de treinamento para todos os modelos de aprendizado de máquina e aprendizado profundo são apresentados em segundos (s) para os modelos mais rápidos (Regressão Linear, KNN, SVR, Floresta Aleatória, XGBoost, LightGBM) e em minutos (min) para os modelos mais lentos (arquiteturas de aprendizado profundo). Todos os modelos foram treinados no mesmo ambiente computacional para garantir uma comparação justa41.
O tempo de treinamento foi medido utilizando o módulo time do Python, ou seja, o tempo decorrido do relógio real desde o início até o fim da função de ajuste do modelo, excluindo o tempo necessário para carregamento e pré-processamento dos dados. O tempo de treinamento de um modelo de aprendizado profundo é o tempo necessário para concluir todas as épocas até a interrupção antecipada. Isso inclui propagação direta, propagação inversa e verificações de validação. Todos os experimentos foram realizados com o sistema sem a execução de outros processos computacionalmente intensivos, a fim de obter medidas de tempo consistentes. Os tempos correspondem à média de 5 execuções independentes (desvios padrão)42.
Avaliação do modelo de aprendizado profundo
Seis arquiteturas de aprendizado profundo foram avaliadas utilizando aceleração por GPU, incluindo um Perceptron Multicamadas (MLP; 64-32-16), uma Rede Neural Profunda (DNN) com normalização por lote (128-64-32-16), uma rede Longa de Memória de Curto Prazo (LSTM; 64-32 unidades, comprimento da sequência = 10), uma rede neural convolucional unidimensional (1D-CNN), um modelo híbrido CNN–LSTM e uma rede baseada em atenção. Todos os modelos de aprendizado profundo foram implementados usando TensorFlow com a API Keras e executados com aceleração por GPU (consulte a Tabela de Materiais para versões de hardware e software). A arquitetura 1D-CNN consistiu em três camadas convolucionais (64, 128 e 256 filtros, tamanho do kernel 3, ativação ReLU, padding=’same’), duas camadas MaxPooling1D (tamanho do pool 2), uma camada GlobalAveragePooling1D, uma camada densa com 128 unidades e ativação ReLU, uma camada Dropout (0,2) e uma camada de saída densa (1 unidade, ativação linear), totalizando aproximadamente 245.000 parâmetros treináveis. A arquitetura híbrida CNN-LSTM aceitou sequências de entrada de 10 passos temporais com 5 características, utilizando duas camadas Conv1D (64 e 128 filtros, tamanho do kernel 3, ReLU, padding=’same’), uma camada MaxPooling1D (tamanho do pool 2), duas camadas LSTM (64 e 32 unidades, return_sequences=False), camadas Dropout (0,2), uma camada densa (32 unidades, ReLU) e uma camada de saída densa (1 unidade, ativação linear), totalizando aproximadamente 198.000 parâmetros treináveis. A rede baseada em atenção utilizou um mecanismo de atenção com múltiplos cabeçotes com 4 cabeçotes (dimensões de chave e valor de 64), em que a entrada foi projetada para 64 dimensões, seguida por atenção de produto escalar (fórmula: Attention(Q, K, V) = softmax(QKT/√d_k)V), conexões residuais, normalização de camada, uma rede feedforward (128→64 unidades), agrupamento médio global, Dropout (0,2), uma camada densa (32 unidades, ReLU) e uma camada de saída densa (1 unidade, ativação linear), totalizando aproximadamente 167.000 parâmetros treináveis43.
Todos os modelos utilizaram parada antecipada (paciente = 20), redução da taxa de aprendizado (fator = 0,5, paciente = 10), dropout (20%) e o otimizador Adam (taxa de aprendizado = 0,001). Para todos os modelos de aprendizado profundo, o tamanho do lote foi definido como 32 amostras, o número máximo de épocas de treinamento foi de 200 com parada antecipada (paciente = 20, restaurando os melhores pesos) e a função de perda foi o erro quadrático médio (MSE). A divisão entre treinamento e validação foi a seguinte: das 1.200 amostras originais de treinamento (após a divisão 80/20 entre treinamento e teste), 80% (960 amostras) foram usadas para treinamento e 20% (240 amostras) para validação. Realizamos a divisão estratificada entre treinamento e validação por condição climática para preservar a distribuição. O conjunto de validação foi usado apenas para parada antecipada, decaimento da taxa de aprendizado e monitoramento de sobreajuste; nunca foi usado para seleção de modelos ou ajuste de hiperparâmetros além desses procedimentos automatizados. Não reservamos um conjunto de validação separado para os modelos de aprendizado de máquina; em vez disso, utilizamos validação cruzada com cinco dobras nas 1.200 amostras de treinamento para ajustar hiperparâmetros e estimar o desempenho44.
Justificativa para a avaliação das arquiteturas LSTM e CNN–LSTM
O conjunto de dados principal consiste em amostras de clima geradas independentemente, mas também testamos arquiteturas LSTM e CNN–LSTM pelos seguintes motivos: (1) as condições atmosféricas do mundo real apresentam autocorrelação temporal, e testar modelos baseados em sequências nos permite determinar se a captura dessas dependências poderia melhorar a precisão das previsões; (2) pesquisas recentes em previsão atmosférica demonstraram o valor potencial de arquiteturas sequenciais para modelar a evolução temporal de parâmetros meteorológicos34; (3) testar uma ampla variedade de arquiteturas garante uma comparação abrangente de abordagens metodológicas, o que constitui uma contribuição fundamental deste estudo; e (4) a arquitetura híbrida CNN–LSTM combina extração de características espaciais com modelagem temporal, o que pode ser benéfico para capturar as interações complexas entre múltiplas variáveis atmosféricas45.
Formatação dos dados para entrada no modelo sequencial
Para as arquiteturas sequenciais (LSTM e CNN–LSTM), os dados de entrada foram reestruturados a partir de amostras independentes em pseudo-sequências usando uma abordagem de janela deslizante. Em particular, as 1.200 amostras de treinamento foram inicialmente agrupadas em categorias de condições meteorológicas para preservar a consistência física. Dentro de cada categoria meteorológica, as amostras foram ordenadas pelos seus carimbos de data e hora gerados (observações simuladas horárias para o ano civil de 2024). Em seguida, aplicou-se uma janela deslizante de comprimento 10 para produzir sequências de entrada com 10 passos de tempo consecutivos (cada um com 5 características: temperatura, umidade, visibilidade, concentração de poeira e taxa de precipitação) para prever a atenuação no 11º passo de tempo. Esse método preserva a ordenação temporal das observações simuladas, ao mesmo tempo que permite que modelos sequenciais aprendam dependências temporais. A estrutura do conjunto de teste foi a mesma, exceto pelo uso do mesmo tamanho de janela e conjunto de características. Reconhecemos que essa estruturação pseudo-sequencial é uma simplificação metodológica e não reflete as dinâmicas temporais do mundo real. Reconhecemos isso como uma limitação na seção de Discussão.
Avaliação de abordagens híbridas
Três abordagens híbridas foram examinadas. A primeira abordagem foi um Ensemble de Votação que média as previsões dos modelos Random Forest, XGBoost e Deep Neural Network usando pesos iguais (cada modelo recebeu um peso de 1/3), com a previsão final calculada como:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
A atribuição de pesos iguais foi escolhida para evitar a introdução de hiperparâmetros adicionais e para avaliar o desempenho básico do conjunto sem viés em relação a qualquer modelo individual. A segunda abordagem utilizou empilhamento com meta-estimador Ridge. Os modelos base foram Floresta Aleatória, XGBoost e uma Rede Neural Profunda (com base em atenção). O procedimento de empilhamento envolveu duas etapas: primeiro, cada modelo base foi treinado no conjunto completo de treinamento, composto por 1.200 amostras, utilizando validação cruzada com 5 dobras para gerar predições fora da dobra, criando assim uma nova matriz de meta-recursos de dimensão 1.200×3 (uma predição por modelo base por amostra). Em segundo lugar, um meta-estimador de regressão Ridge (parâmetro de regularização L2 alpha=1,0) foi treinado com base nesses meta-recursos, utilizando os valores originais de atenuação como variável-alvo, para aprender os pesos ótimos de combinação dos modelos base. A predição final do empilhamento foi:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
em que os pesos w foram aprendidos pelo meta-aprendiz Ridge. O terceiro enfoque foi uma rede neural informada pela física que combinou 70% das previsões da rede neural com 30% do modelo Kim para amostras de condições de nevoeiro. A combinação foi realizada por meio de média ponderada fixa, utilizando a seguinte fórmula:
ŷhybrid=0,7×ŷneural+0,3×ŷKim (11)
em que ŷneural é a saída da rede neural baseada em atenção, e ŷKim é a atenuação calculada a partir do modelo de neblina de Kim com base na entrada de visibilidade. Para amostras sem neblina, a parte física foi definida como 0, e o modelo foi executado como uma rede neural pura. Os pesos (70% neural e 30% física) foram fixados com base em experimentação preliminar no conjunto de validação (não no conjunto de teste), em que testamos combinações de pesos de 90:10, 80:20, 70:30, 60:40 e 50:50. A divisão 70/30 foi escolhida porque proporcionou o melhor R2 de validação e ainda manteve uma restrição física suficiente do modelo de Kim para regular as previsões e evitar saídas fisicamente implausíveis, especialmente na neblina, onde o modelo de Kim fornece limites teóricos estabelecidos de atenuação.
Análise de importância e interpretabilidade de características
O modelo Random Forest com importância de características baseada na impureza (redução da variância) foi utilizado para extrair todos os 10 rankings de importância das características de entrada. A análise mostrou que a concentração de poeira (67,3%) e a visibilidade (21,2%) foram os preditores mais importantes, explicando juntos 88,5% da importância preditiva total. A terceira característica mais importante foi a taxa de chuva (6,0%), seguida pela velocidade do vento (2,1%), temperatura (1,5%), umidade (0,9%), mês (0,5%), estação (0,3%), taxa de neve (0,1%) e pressão atmosférica (0,1%). Os baixos valores de importância para as características temporais (mês e estação) indicam que a variação sazonal na atenuação atmosférica é capturada principalmente por parâmetros ambientais subjacentes, e não apenas por padrões baseados no tempo.
Uma análise SHAP (Shapley Additive exPlanations) foi realizada para avaliar as relações entre fatores ambientais e atenuação. O implementação do SHAP utilizada foi o módulo TreeExplainer da biblioteca SHAP, que é especificamente otimizado para modelos baseados em árvores, incluindo Random Forest, XGBoost e LightGBM (consulte a Tabela de Materiais para a versão). A configuração para a análise SHAP foi a seguinte: o modelo Random Forest treinado foi fornecido ao TreeExplainer, que calculou os valores SHAP usando a abordagem interventiva (marginal) de atribuição de características com base na expectativa condicional da saída do modelo. Os valores SHAP foram calculados para todas as 300 amostras do conjunto de teste, gerando uma matriz de tamanho 300 × 10 (um valor SHAP por característica por amostra). Para cada característica, o valor SHAP representou sua contribuição para a previsão em relação à linha de base (a previsão média do modelo). Valores SHAP negativos indicaram uma redução; enquanto valores SHAP positivos indicaram que a característica aumentou a previsão de atenuação. A intensidade da contribuição foi indicada pela magnitude do valor SHAP. A distribuição dos valores SHAP para cada característica (usando gráficos de enxame), a direção da influência (a correlação entre os valores das características e os valores SHAP) e os rankings de importância das características foram todos visualizados usando gráficos resumo. As funções de plotagem embutidas na biblioteca SHAP — shap.summary_plot() para o gráfico de enxame e shap.bar_plot() para a importância global das características — foram utilizadas para criar todas as visualizações SHAP.
Tratamento de Variáveis Codificadas em One-Hot: Quatro colunas binárias (primavera, verão, outono e inverno) foram inicialmente utilizadas para codificar a variável estação. A fim de criar um único valor de contribuição de "estação" por amostra para a análise SHAP, as contribuições dessas quatro variáveis codificadas em one-hot foram combinadas somando os valores SHAP para cada categoria de estação. Para realizar esse agrupamento, foram identificadas todas as colunas correspondentes aos grupos de estação codificados em one-hot, os valores SHAP foram extraídos para cada amostra e então somados elemento a elemento. Os valores SHAP combinados resultantes representam a contribuição global da estação para a predição de atenuação. Esse método permite uma única linha de "estação" no gráfico resumo SHAP e garante consistência com o uso da estação no modelo como uma variável categórica composta. Como o valor combinado oferece uma representação mais compreensível da contribuição total da estação, os valores SHAP da estação não foram exibidos separadamente para cada categoria de estação.
Resultados
As características do conjunto de dados sintético são resumidas na Figura 1A–F. O conjunto de dados incluiu condições de céu limpo, poeira, neblina, chuva e neve (Figura 1A), com amostras distribuídas entre as estações quente-seca e fria-úmida (Figura 1B) e períodos diurnos e noturnos (Figura 1C). As distribuições de temperatura, umidade e visibilidade sob diferentes condições meteorológicas são apresentadas na Figura 1D–F.
Os modelos de aprendizado de máquina demonstraram alto desempenho preditivo na estimativa da atenuação atmosférica (Figura 2A–D; Tabela 3). O RF obteve o melhor desempenho geral entre os modelos avaliados, com um R2 de teste de 0,9654 e um RMSE de 1,324 dB/km (Figura 2A; Tabela 3). O RF explicou 96,54% da variação observada, mantendo um erro de predição inferior a 1,5 dB/km. O XGBoost também apresentou bom desempenho (Figura 2C), seguido pelo LightGBM (Figura 2B). A robustez do modelo foi confirmada por validação cruzada de cinco dobras, com o RF alcançando um R2 de validação cruzada de 0,960 ± 0,007 (Figura 2D). Em contraste, o K-Vizinhos Mais Próximos demonstrou sinais de sobreajuste, com um R2 de treinamento de 1,000 e um R2 de teste de 0,7341, enquanto a Regressão Linear alcançou desempenho preditivo moderado (Figura 2A; Tabela 3).
A análise de importância das características das 10 características de entrada mencionadas acima é apresentada na Figura 3A. Os escores de importância relativa são classificados da seguinte forma: concentração de poeira (67,3%), visibilidade (21,2%), taxa de chuva (6,0%), velocidade do vento (2,1%), temperatura (1,5%), umidade (0,9%), mês (0,5%), estação (0,3%), taxa de neve (0,1%) e pressão (0,1%). A variável "condição meteorológica" é usada para estratificação do conjunto de dados, mas não é incluída na análise de importância das características, pois é uma variável categórica composta que representa diversos parâmetros físicos subjacentes, e seu efeito é capturado pelas características ambientais individuais. As análises de importância e interpretabilidade das características identificaram as variáveis ambientais mais fortemente associadas à atenuação (Figura 3A,B). A concentração de poeira (67,3%), a visibilidade (21,2%) e a taxa de chuva (6,0%) juntas representaram 94,4% da importância preditiva total (Figura 3A). A análise SHAP demonstrou ainda que o aumento da concentração de poeira e a diminuição da visibilidade estavam associados a previsões maiores de atenuação (Figura 3B).
Os modelos de aprendizado profundo apresentaram desempenho preditivo inferior em comparação com as abordagens de aprendizado de máquina (Figura 4A–D). O modelo de aprendizado profundo com melhor desempenho, a rede baseada em atenção, alcançou um valor de R2 de 0,7766 e um RMSE de 3,362 dB/km (Figura 4A). As arquiteturas recorrentes apresentaram desempenho particularmente ruim, com os modelos LSTM e CNN–LSTM gerando valores de R2 próximos de zero e valores de RMSE superiores a 7,19 dB/km (Figura 4B). O desempenho relativamente baixo das arquiteturas LSTM e CNN-LSTM (R2 = 0,0110 e 0,0109, respectivamente; RMSE = 7,193 dB/km e 7,196 dB/km) pode ser parcialmente explicado pela natureza pseudo-sequencial dos dados de entrada, que não captura plenamente as dinâmicas temporais reais das condições atmosféricas.
Diferentemente de aplicações com séries temporais reais, nas quais as dependências sequenciais são fortes e bem definidas, nosso conjunto de dados consistia principalmente em amostras independentes com uma ordenação temporal artificialmente imposta. O desempenho preditivo insatisfatório dessas arquiteturas sugere que a informação temporal extraída pela abordagem de janela deslizante era insuficiente ou não representativa da evolução atmosférica real (Figura 4C). Isso reforça nossa conclusão de que, para conjuntos de dados dessa natureza, abordagens mais simples de aprendizado de máquina são mais adequadas do que modelos complexos de aprendizado profundo baseados em sequências. O desempenho de validação de todas as arquiteturas de aprendizado profundo é resumido na Figura 4D.
O desempenho das abordagens de aprendizado de máquina, aprendizado profundo e híbridas é resumido na Figura 5A,B e na Tabela 3. Entre os métodos híbridos, o Ensemble de Votação alcançou um R2 de 0,9340 e um RMSE de 1,827 dB/km (Figura 5A,B; Tabela 3). O empilhamento com meta-aprendiz Ridge alcançou um R2 de 0,9571 e um RMSE de 1,473 dB/km (Figura 5A,B; Tabela 3), aproximando-se do desempenho da RF, mas exigindo tempos de treinamento substancialmente mais longos. A Rede Neural Informativa pela Física alcançou um R2 = 0,8269 e RMSE = 2,960 dB/km (Figura 5A,B; Tabela 3) e teve desempenho melhor que os modelos de aprendizado profundo, mas não tão bom quanto as melhores abordagens de aprendizado de máquina. A comparação estatística entre os modelos RF e Ensemble Empilhado indicou nenhuma diferença significativa no desempenho preditivo (Tabela 3; teste t pareado: t = −1,74, p = 0,083). Portanto, embora a RF tenha alcançado o maior valor numérico de R2, a diferença em relação à melhor abordagem híbrida não foi estatisticamente significativa.
De modo geral, os resultados apoiam a hipótese de que abordagens de aprendizado de máquina podem prever com precisão a atenuação atmosférica nas condições climáticas do Iraque. O RF obteve consistentemente o desempenho preditivo mais alto (Figura 2A,B; Tabela 3), enquanto as análises de importância de características e SHAP identificaram a concentração de poeira e a visibilidade como os fatores ambientais dominantes que influenciam a atenuação (Figura 3A,B).
Declaração sobre Dados de Validação: Todas as avaliações do modelo foram realizadas com o conjunto de dados sintéticos descrito na seção Métodos. Nenhum dado experimental ou observacional sobre atenuação atmosférica foi utilizado na validação do modelo. O conjunto de dados sintéticos foi criado usando modelos físicos de propagação bem conhecidos (lei de Beer-Lambert, modelo de Kim, modelo de Carbonneau e teoria de espalhamento de Mie), com parâmetros meteorológicos selecionados a partir de distribuições de probabilidade com base em registros climáticos do Iraque. Conforme observado na seção Métodos, o desempenho preditivo elevado pode refletir parcialmente a capacidade do modelo de aprender ou aproximar as equações físicas determinísticas utilizadas para gerar os valores-alvo. Portanto, as métricas quantitativas de desempenho (R2, RMSE, MAE) representam o desempenho em dados sintéticos derivados de equações e devem ser interpretadas como comparações relativas entre metodologias de modelagem em um ambiente de simulação controlado, e não como garantias absolutas de desempenho para sistemas operacionais de FSO. Essa abordagem fornece um ambiente controlado para avaliação comparativa de metodologias de modelagem preditiva (conforme listadas na Tabela 2), mas não substitui a validação com medições reais de atenuação de FSO sob condições climáticas reais do Iraque.
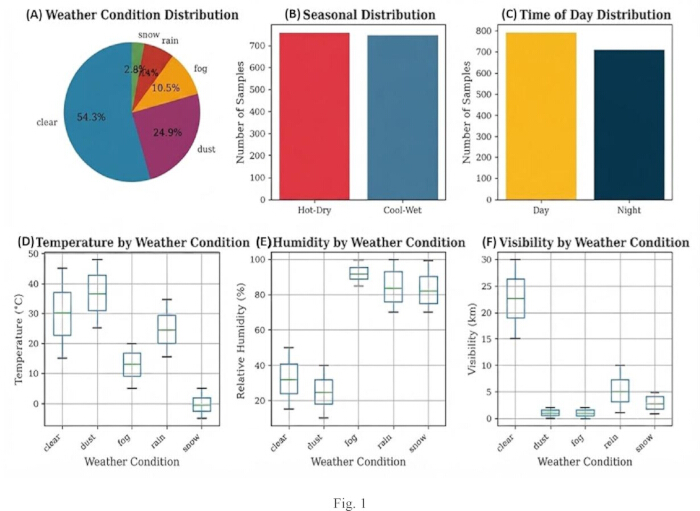
Figura 1: Características do conjunto de dados sintético e variáveis ambientais utilizadas para modelagem de atenuação atmosférica. (A) Distribuição das condições meteorológicas representadas no conjunto de dados, incluindo situações de céu limpo, poeira, neblina, chuva e neve. (B) Distribuição sazonal das amostras entre os períodos quente-seco e frio-úmido. (C) Distribuição das amostras coletadas durante condições diurnas e noturnas. (D) Distribuições de temperatura para cada condição meteorológica. (E) Distribuições de umidade para cada condição meteorológica. (F) Distribuições de visibilidade para cada condição meteorológica. Os diagramas de caixa mostram a mediana (linha central), o intervalo interquartílico (caixa) e os valores mínimo e máximo (extremidades). A temperatura é informada em °C, a umidade em % e a visibilidade em km. Clique aqui para visualizar uma versão maior desta figura.
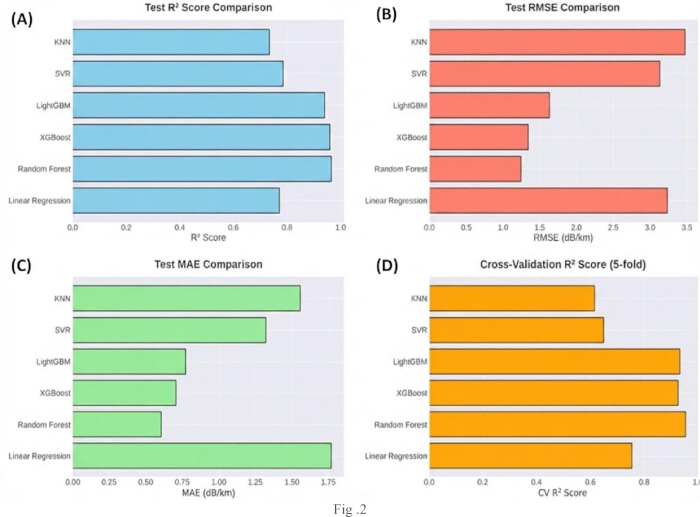
Figura 2: Comparação de desempenho dos modelos de aprendizado de máquina para previsão de atenuação atmosférica. (A) Pontuações do coeficiente de determinação (R2) no conjunto de teste para os modelos de aprendizado de máquina avaliados, incluindo Regressão Linear, Floresta Aleatória, Boosting Extremo de Gradiente (XGBoost), Máquina de Boosting de Gradiente Leve (LightGBM), Regressão por Vetores de Suporte (SVR) e K-Vizinhos Mais Próximos (KNN). (B) Valores de erro quadrático médio (RMSE) no conjunto de teste para cada modelo de aprendizado de máquina. (C) Valores de erro absoluto médio (MAE) no conjunto de teste para cada modelo de aprendizado de máquina. (D) Pontuações do coeficiente de determinação (R2) obtidas na validação cruzada utilizando validação cruzada de cinco dobras. Valores mais altos de R2 e valores mais baixos de RMSE e MAE indicam melhor desempenho preditivo. RMSE e MAE são informados em dB/km. Clique aqui para visualizar uma versão maior desta figura.
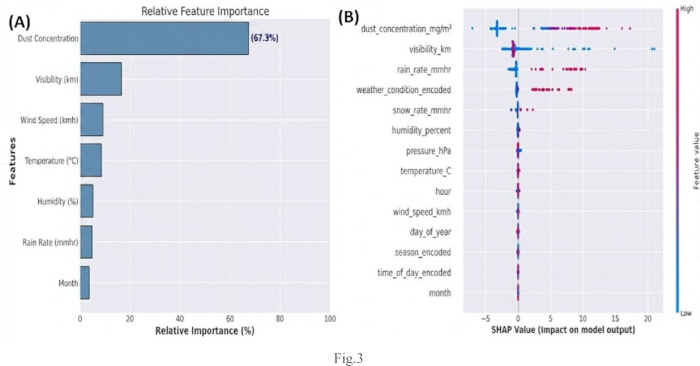
Figura 3: Análise de importância das características e interpretabilidade do modelo para a previsão de atenuação atmosférica. (A) Classificações relativas de importância das características baseadas na impureza do modelo Random Forest, mostrando a contribuição de todas as 10 variáveis ambientais e temporais para a previsão de atenuação. A característica mais influente foi a concentração de poeira (67,3%), seguida por visibilidade (21,2%), taxa de chuva (6,0%), velocidade do vento (2,1%), temperatura (1,5%), umidade (0,9%), mês (0,5%), estação (0,3%), taxa de neve (0,1%) e pressão atmosférica (0,1%). A importância relativa é uma porcentagem da importância total do modelo. (B) Gráfico resumo do método SHapley Additive exPlanations (SHAP), ilustrando o impacto de características individuais nas previsões do modelo. A matriz SHAP foi calculada para 300 amostras do conjunto de teste (300 × 10 características). Para a variável estação codificada em one-hot (originalmente quatro colunas binárias: primavera, verão, outono, inverno), os valores SHAP foram combinados somando-se as quatro categorias, produzindo um único valor de contribuição ‘estação’ por amostra. Cada ponto representa uma amostra, e a escala de cores indica o valor da característica, variando de baixo (azul) a alto (vermelho). Valores SHAP positivos indicam um aumento na atenuação prevista, enquanto valores SHAP negativos indicam uma diminuição na atenuação prevista. Clique aqui para visualizar uma versão maior desta figura.
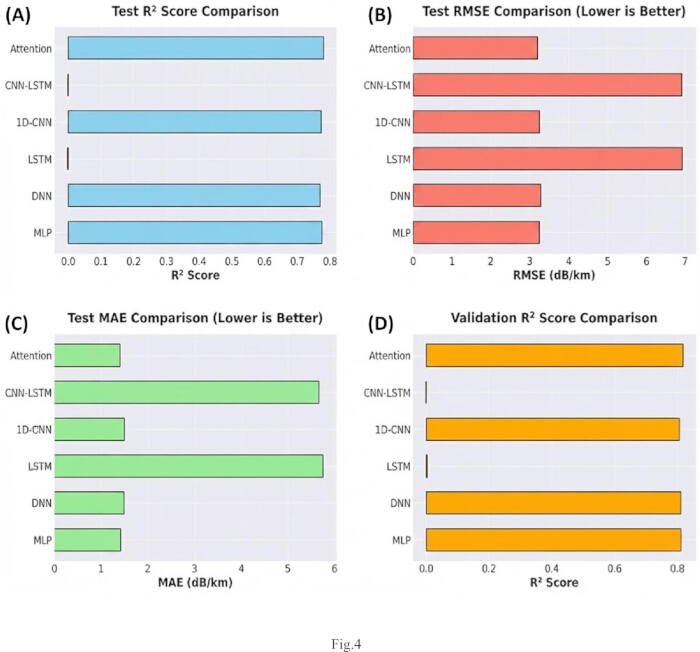
Figura 4Comparação de desempenho de modelos de aprendizado profundo para previsão de atenuação atmosférica. (A) Teste do coeficiente de determinação (R2) pontuações para as arquiteturas de aprendizado profundo avaliadas, incluindo Perceptron Multicamadas (MLP), Rede Neural Profunda (DNN), Memória de Longo e Curto Prazo (LSTM), rede neural convolucional unidimensional (1D-CNN), Rede Neural Convolucional–Memória de Longo e Curto Prazo (CNN–LSTM) e modelos baseados em atenção.B) Valores de erro quadrático médio (RMSE) do teste para cada modelo de aprendizado profundo.C) Valores do erro médio absoluto (MAE) no teste para cada modelo de aprendizado profundo. (D) Coeficiente de determinação (R²) na validação2) pontuações para os modelos de aprendizado profundo avaliados. Maior R2 valores mais baixos de RMSE e MAE indicam desempenho preditivo aprimorado. O RMSE e o MAE são reportados em dB/km. Clique aqui para visualizar uma versão maior desta figura.
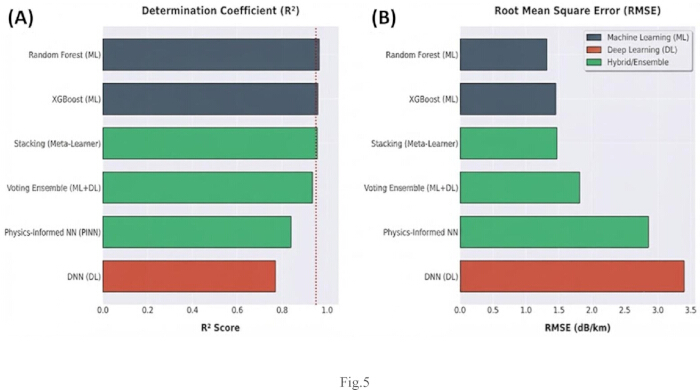
Figura 5: Desempenho comparativo de modelos de aprendizado de máquina, aprendizado profundo e modelos híbridos para previsão de atenuação atmosférica. (A) Valores do coeficiente de determinação (R2) para abordagens representativas de aprendizado de máquina, aprendizado profundo e modelos híbridos, incluindo Floresta Aleatória, Gradiente Boosting Extremo (XGBoost), Rede Neural Profunda (DNN), Ensemble por Votação, Stacking e modelos de Redes Neurais Informatizadas pela Física. (B) Valores do erro quadrático médio (RMSE) para os mesmos modelos. Aprendizado de máquina (ML), aprendizado profundo (DL) e técnicas híbridas/ensemble são as três categorias nas quais os modelos são codificados por cores. Desempenho preditivo melhorado é indicado por valores mais altos de R2 e valores mais baixos de RMSE. O RMSE é expresso em dB/km. Clique aqui para visualizar uma versão maior desta figura.
| Condição Meteorológica | Proporção | Intervalo de Temperatura | Intervalo de Umidade | Intervalo de Visibilidade | Intervalo do Parâmetro Principal |
| Céu Limpo | 54,27% (814 amostras) | −4,89 a 47,99°C | 0–100% | >10 km | — |
| Poeira | 25,00% (375 amostras) | 10–45°C | 10–60% | 0,05–5 km | Poeira: 0–4,96 mg/m3 |
| Neblina | 10,47% (157 amostras) | −5 a 20°C | 70–100% | 0,05–1 km | — |
| Chuva | 7,40% (111 amostras) | 5–30°C | 60–100% | 1–10 km | Chuva: 0,25–50 mm/h |
| Neve | 2,87% (43 amostras) | −10 a 5°C | 50–100% | 0,5–5 km | Neve: 0,5–15 mm/h |
Tabela 1: Medidas de desempenho dos modelos de aprendizado de máquina para prever a atenuação atmosférica.
| Modelo | R2 do Teste | RMSE (dB/km) | MAE (dB/km) | R2 CV | Tempo de Treinamento (s) |
| Random Forest | 0,9654 | 1,324 | 0,815 | 0,960 ± 0,007 | 1,6 |
| XGBoost | 0,9582 | 1,455 | 0,892 | 0,953 ± 0,009 | 2,1 |
| LightGBM | 0,9507 | 1,581 | 0,971 | 0,946 ± 0,011 | 1,8 |
| Support Vector Regression (SVR) | 0,8874 | 2,389 | 1,445 | 0,879 ± 0,015 | 3,2 |
| Linear Regression | 0,8358 | 2,889 | 1,791 | 0,831 ± 0,018 | 0,2 |
| K-Nearest Neighbors (KNN) | 0,7341 | 3,671 | 2,296 | 0,721 ± 0,022 | 0,8 |
Tabela 2: Avaliação comparativa de modelos específicos de aprendizado profundo, híbridos e de aprendizado de máquina.
| Modelo | Categoria | R2 do teste | RMSE (dB/km) | Classificação |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Stacking Ensemble | Híbrido | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Voting Ensemble | Híbrido | 0.934 | 1.827 | 5 |
| Physics-Informed Neural Network | Híbrido | 0.8269 | 2.96 | 6 |
| Attention | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
Tabela 3: Comparação da eficiência computacional (treinamento e inferência) de cada modelo avaliado.
DADOS DISPONIBILIDADE:
O conjunto de dados sintético completo, composto por 1.500 amostras com todas as variáveis de entrada (temperatura, umidade, visibilidade, concentração de poeira, taxa de precipitação, taxa de neve, velocidade do vento, pressão atmosférica, mês, estação e condição meteorológica) e a variável alvo (atenuação em dB/km), é fornecido como arquivo suplementar junto com este manuscrito em https://doi.org/10.5281/zenodo.21792999. O conjunto de dados está formatado de modo que cada amostra ocupe uma linha, incluindo todas as variáveis calculadas (alcance operacional e SNR).
A implementação completa do código, incluindo: scripts de geração de dados (implementações de modelos físicos); funções para pré-processamento e normalização de características; todas as implementações de modelos de aprendizado de máquina; todas as implementações de modelos de aprendizado profundo; scripts para avaliação e visualização; e procedimentos de ajuste de hiperparâmetros e validação cruzada, também deverá ser fornecida como arquivo suplementar.
Dados Climáticos de Origem: Os dados climáticos utilizados para definir as distribuições de dados sintéticos foram obtidos pela Organização Meteorológica do Iraque e Sismologia (IMOS) e pelo Ministério dos Transportes do Iraque, abrangendo o período de 2020 a 2024. Um resumo dos dados climáticos utilizados para determinar as proporções das condições meteorológicas e os intervalos de parâmetros é fornecido na Tabela Suplementar 1. Os registros específicos da IMOS utilizados neste estudo não estão arquivados publicamente em um repositório centralizado, mas podem ser solicitados diretamente à IMOS. As estatísticas descritivas e as distribuições de probabilidade derivadas são fornecidas nos materiais suplementares para permitir a reprodutibilidade.
Informações do repositório: O código-fonte e o conjunto de dados estão depositados em um repositório público (Zenodo) com https://doi.org/10.5281/zenodo.21792999.
Discussão
A fim de prever a atenuação atmosférica em sistemas de comunicação FSO operando sob condições climáticas do Iraque, o presente estudo avaliou técnicas de aprendizado de máquina, aprendizado profundo e métodos híbridos. Como os impactos atmosféricos continuam sendo uma das principais questões que afetam o desempenho e a disponibilidade do enlace, avaliações recentes enfatizaram a crescente importância da modelagem preditiva para sistemas FSO21. Os resultados mostraram que abordagens clássicas de aprendizado de máquina, particularmente RF e XGBoost, proporcionaram alta precisão preditiva e, em alguns casos, superaram numericamente os métodos de aprendizado profundo e híbridos. No entanto, testes estatísticos não revelaram uma diferença significativa (p=0.083) entre RF e o melhor ensemble híbrido (Stacking), o que indica que ambas as abordagens podem alcançar resultados semelhantes nesse conjunto de dados. Nossos achados indicam que métodos ensemble baseados em árvores ainda são altamente eficazes para dados ambientais tabulares com tamanhos amostrais moderados e um pequeno número de variáveis preditoras dominantes. A análise de importância de características mostrou que a concentração de poeira e a visibilidade foram os principais fatores responsáveis pela atenuação, explicando juntos a maior parte do poder preditivo. Esse resultado está de acordo com investigações anteriores que demonstraram a influência significativa de neblina, poeira, aerossóis e poluição atmosférica na propagação do sinal óptico22,23,24,25. Achados semelhantes foram relatados em aplicações de monitoramento ambiental, nas quais modelos de aprendizado de máquina frequentemente se beneficiam de conjuntos de dados contendo um pequeno número de variáveis altamente informativas26,27,28,29,30,31,32. A análise SHAP aprimorou ainda mais a interpretabilidade do modelo ao quantificar a influência de parâmetros ambientais individuais nas previsões de atenuação.
O desempenho inferior dos modelos de aprendizado profundo pode ser atribuído a diversos fatores. O tamanho do conjunto de dados era relativamente modesto para o treinamento de arquiteturas neurais complexas (em https://doi.org/10.5281/zenodo.21792999), e as variáveis ambientais exibiram uma importância de características altamente concentrada. Estudos anteriores demonstraram que os métodos de aprendizado profundo geralmente se beneficiam de grandes conjuntos de dados, estruturas hierárquicas de características e representações não lineares complexas33,34,35,36,37. Em contraste, o conjunto de dados de atenuação utilizado neste estudo continha um número limitado de preditores dominantes e carecia das dependências temporais necessárias para arquiteturas recorrentes. O fraco desempenho dos modelos LSTM e CNN–LSTM sugere que os mecanismos de aprendizado sequencial podem não proporcionar benefícios substanciais para esta aplicação.
A predominância da concentração de poeira (67,3%) e da visibilidade (21,2%) como preditores de atenuação atmosférica pode ser atribuída a diversos fatores. Primeiro, a dispersão e absorção moleculares em 1550 nm são ofuscadas pela dispersão de Mie provocada por partículas de poeira. Na teoria de Mie, a eficiência de extinção Q_ext é altamente sensível à concentração de partículas, e a atenuação escala quase linearmente com a concentração de poeira no regime de concentração moderada a alta. Segundo, o Iraque está sujeito a tempestades de poeira frequentes (25,00% dos dias nos nossos registros climáticos), o que resulta em valores de atenuação de 4–30 dB/km. Isso contrasta com a neblina (10,47%, 0,5–10 dB/km) e a chuva (7,40%, 2–25 dB/km). A maior variabilidade na atenuação por poeira gera sinais mais fortes para que os modelos possam aprender. Terceiro, a distribuição exponencial da concentração de poeira (0,4–4,96 mg/m3) produz uma ampla gama de valores de atenuação. A cauda longa para eventos extremos de poeira gera valores elevados de atenuação, os quais são importantes para uma predição precisa. Quarto, o modelo de dispersão de Mie apresenta uma dependência mais simples (aproximadamente linear) em relação à concentração de poeira, o que é mais fácil para modelos baseados em árvores aproximarem, comparado à relação mais complexa entre visibilidade e atenuação por neblina no modelo de Kim. Quinto, essa descoberta tem relevância prática, pois tempestades de poeira são uma das condições ambientais mais desafiadoras para comunicações ópticas em espaço livre (FSO) no Oriente Médio. A predição precisa durante eventos de poeira é essencial para a operação confiável do sistema.
Os resultados avançam a pesquisa em comunicação por FSO ao fornecer orientações práticas sobre a seleção de algoritmos para previsão de atenuação atmosférica. A previsão precisa de atenuação é essencial para o planejamento de redes, gerenciamento adaptativo de enlaces e implantação confiável de sistemas de comunicação óptica em ambientes desafiadores, como o Oriente Médio23,28,30,36. Além disso, a metodologia pode ser aplicável a outros problemas de previsão ambiental envolvendo propagação no ar, monitoramento atmosférico e avaliação de desempenho de redes ópticas38,39,40. Conjuntos de dados reais maiores, técnicas sofisticadas de aprendizado em conjunto, estruturas de aprendizado por transferência ou arquiteturas mais complexas baseadas em princípios físicos são alguns outros métodos para investigar essa ideia41,42,43,44,45.
Escopo das conclusões e questões de generalizabilidade
As conclusões deste trabalho baseiam-se principalmente em um conjunto de dados sintético gerado a partir de modelos físicos de propagação bem estabelecidos (lei de Beer-Lambert, modelo de Kim, modelo de Carbonneau e teoria de espalhamento de Mie). Essa abordagem metodológica acarreta algumas implicações para o escopo e a generalização dos nossos resultados:
Conclusões a Partir de Dados Simulados: (1) Classificação comparativa de desempenho de abordagens de aprendizado de máquina, aprendizado profundo e métodos híbridos para previsão de atenuação atmosférica. (2) Identificação da concentração de poeira e da visibilidade como os principais preditores ambientais de atenuação óptica sob as condições modeladas. (3) Vantagem em eficiência computacional dos métodos baseados em conjuntos de árvores em relação às arquiteturas de aprendizado profundo. (4) Interpretabilidade das análises de importância de características e SHAP para explicar as previsões do modelo.
Conclusões que Requerem Confirmação no Mundo Real: (1) Os valores absolutos de R2 e RMSE obtidos pelos modelos avaliados dependem das características específicas do conjunto de dados sintéticos e podem refletir a capacidade dos modelos de aprender as equações físicas determinísticas utilizadas para gerar os valores-alvo. (2) Ainda não foi comprovado que o melhor modelo, Floresta Aleatória, possa ser aplicado a condições atmosféricas reais desconhecidas. (3) É necessária uma validação em campo para que os resultados possam ser aplicados a unidades operacionais de FSO instaladas no Iraque. (4) É necessário confirmar que as classificações de importância das variáveis identificadas são robustas sob condições de medição em campo.
É importante distinguir entre o desempenho em dados sintéticos derivados de equações e o desempenho em dados observacionais ou experimentais com ruído. O conjunto de dados sintéticos fornece uma relação limpa e livre de ruído entre as características de entrada e o alvo de atenuação, o que pode produzir indicadores de desempenho preditivo mais altos do que os obtidos com dados do mundo real que contêm ruído de medição, erros de instrumento e fenômenos físicos não modelados. Recomendamos que trabalhos futuros sejam direcionados à obtenção de medições reais de atenuação em enlaces FSO sob condições climáticas iraquianas, a fim de validar os resultados apresentados neste estudo e avaliar a verdadeira generalização das metodologias propostas.
Implicações dos dados sintéticos para a generalização do modelo
As implicações do uso de dados sintéticos neste estudo devem ser cuidadosamente consideradas quanto à generalização dos modelos:
Vantagens da Abordagem Sintética O conjunto de dados é fisicamente consistente e baseia-se em estruturas teóricas estabelecidas por meio da utilização de modelos físicos de propagação consagrados. Parâmetros meteorológicos foram extraídos de registros meteorológicos do Iraque para fazer com que o conjunto de dados reflita as propriedades estatísticas das condições climáticas reais no Iraque. Além de evitar variáveis confundidoras das medições de campo (como erros de medição, calibração de equipamentos ou registros de dados insuficientes), esse ambiente controlado permite uma análise metódica das metodologias de modelagem.
Limitações para a generalização O conjunto de dados sintético possui limitações na representação da complexidade completa da atenuação atmosférica real, incluindo: (1) a interação de múltiplos fenômenos atmosféricos ocorrendo simultaneamente; (2) o comportamento não linear e não estacionário dos parâmetros atmosféricos; (3) a variabilidade climática de longo prazo não capturada pelas distribuições de amostragem; (4) efeitos microclimáticos localizados que podem afetar significativamente a propagação em FSO; e (5) ruído e incerteza inerentes à coleta de dados no mundo real.
Considerações sobre viés na geração de dados sintéticos A suposição de amostragem independente dos parâmetros ambientais (ver Métodos) é uma simplificação excessiva das condições do mundo real, nas quais as variáveis atmosféricas tendem a ser correlacionadas (por exemplo, altas concentrações de poeira tendem a estar associadas à baixa visibilidade). Uma suposição de independência foi adotada para criar um ambiente de simulação controlado, permitindo a comparação sistemática de modelos. No entanto, esse método pode não capturar toda a complexidade das interações entre os parâmetros atmosféricos. Utilizamos um método de divisão estratificada (mantendo as proporções das condições meteorológicas nos conjuntos de treinamento e teste) para minimizar a possibilidade de uma representação desequilibrada de condições raras no conjunto de teste (notadamente neve, com 2,87%).
Geração Determinística do Alvo: O alto desempenho preditivo observado neste estudo pode ser parcialmente explicado pelos modelos que aprendem as equações físicas determinísticas utilizadas para gerar os valores-alvo. Em contraste, dados experimentais do mundo real contêm ruídos de medição, erros de instrumento e fenômenos físicos não modelados que tornam a predição mais desafiadora. Portanto, as métricas de desempenho quantitativas (R2, RMSE, MAE) devem ser interpretadas como comparações relativas entre metodologias em um ambiente de simulação controlado, e não como garantias absolutas de desempenho para sistemas operacionais de FSO.
Portanto, embora os resultados comparativos sobre a classificação de desempenho dos modelos sejam provavelmente robustos (devido à consistência física dos dados sintéticos), as métricas absolutas de desempenho (R2, RMSE, MAE) não devem ser consideradas indicativas do desempenho esperado em sistemas FSO operacionais. É necessário testar a generalização do modelo em condições do mundo real utilizando medições experimentais de atenuação atmosférica obtidas sob diversas condições meteorológicas no Iraque.
Há algumas restrições que devem ser consideradas. Primeiro, em vez de utilizar observações de campo, o estudo baseou-se em um conjunto de dados sintéticos gerado por meio de modelos físicos de propagação bem conhecidos. Como mencionado anteriormente, em vez de fornecer garantias absolutas de desempenho para sistemas FSO operacionais, as métricas quantitativas de desempenho (R², RMSE, MAE) devem ser vistas como comparações relativas entre abordagens em um ambiente de simulação controlado. Segundo, os modelos tradicionais versus de aprendizado profundo podem não ter sido capazes de aprender representações de características robustas devido à magnitude do conjunto de dados. Terceiro, outros indicadores de desempenho do FSO, como disponibilidade da conexão, falhas de apontamento e desvanecimento induzido por turbulência, não foram levados em conta, priorizando-se a predição de atenuação. Quarto, os registros históricos de 2020 a 2024 foram utilizados para calcular as proporções das condições meteorológicas, o que pode não refletir com precisão as variações nos padrões climáticos iraquianos ano a ano. Quinto, a estrutura de dados de entrada pseudo-sequencial dos modelos CNN–LSTM e LSTM constitui uma simplificação metodológica que pode não capturar adequadamente a dinâmica temporal de aplicações do mundo real. Ao avaliar os resultados, essas limitações devem ser consideradas, pois podem impactar a generalização das descobertas.
Prioridade Recomendada: Verificação no Mundo Real. A coleta e análise de medições reais de atenuação FSO sob condições meteorológicas iraquianas é o caminho mais crucial para trabalhos futuros. Isso deverá incluir: (1) instalação de laboratórios experimentais FSO em diversas regiões do Iraque (por exemplo, Bagdá, Basra, Mossul, Ramadi) para registrar variações climáticas regionais; (2) uso de instrumentos calibrados nos locais FSO para medir simultaneamente parâmetros atmosféricos (temperatura, umidade, visibilidade, concentração de poeira); (4) documentação da atenuação durante eventos meteorológicos extremos (tempestades de poeira, neblina intensa, chuva forte); (5) disponibilização pública dos dados coletados para permitir a reprodutibilidade e pesquisas comparativas; e (3) monitoramento contínuo por pelo menos um ciclo anual completo para capturar as flutuações sazonais. Essa validação prática ofereceria a oportunidade de avaliar a generalização do modelo e aprimorar as técnicas preditivas desenvolvidas nesta pesquisa.
Para validar e aprimorar os modelos gerados, pesquisas futuras devem focar na incorporação de medições reais de FSO obtidas em condições climáticas iraquianas. Pesquisas adicionais poderiam examinar estratégias de aprendizado por transferência que utilizem conjuntos de dados atmosféricos relevantes, programas de aprendizado online que se ajustem a condições ambientais variáveis, e estratégias híbridas de experimentação e simulação que combinem dados medidos com modelos físicos. Investigar mais a fundo a IA explicável e abordagens avançadas de aprendizado baseadas na física também pode esclarecer melhor os mecanismos subjacentes à atenuação atmosférica e fortalecer a resiliência dos próximos sistemas de previsão.
Divulgações
Conflito de Interesses: Os autores declaram não haver conflitos de interesses.
Agradecimentos
Os autores declaram que nenhuma fonte externa de financiamento foi recebida para esta pesquisa. Agradecemos ao Centro de Pesquisa Aplicada e Teórica Internacional (IATRC), em Baghdad Quarter, Iraque.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Kit de ferramentas CUDA | NVIDIA Corporation | 11.8 | Biblioteca de aceleração por GPU para treinamento em aprendizagem profunda |
| cuDNN | NVIDIA Corporation | 8.6.0 | Biblioteca de redes neurais profundas acelerada por GPU |
| GPU (unidade de processamento gráfico) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | Utilizada para treinamento em aprendizagem profunda acelerado por GPU |
| CPU (unidade central de processamento) | Intel Corporation | Core i9-13900K, 24 núcleos/32 threads | Processador de estação de trabalho para treinamento/avaliação de todos os modelos |
| Memória do sistema (RAM) | n/a | 64 GB DDR5, 5200 MHz | Memória da estação de trabalho |
| API Keras | Código aberto (parte do TensorFlow) | incluída no TensorFlow 2.11.0 | API de alto nível para aprendizagem profunda, usada em todas as arquiteturas de DL |
| LightGBM | Código aberto (Microsoft) | 3.3.5 | Estrutura de boosting por gradiente |
| NumPy | Código aberto (NumFOCUS) | 1.23.5 | Biblioteca de computação numérica |
| Sistema operacional | Canonical Ltd. | Ubuntu 22.04 LTS | Sistema operacional da estação de trabalho |
| Python | Python Software Foundation | 3.9 | Linguagem de programação usada para toda geração de dados e modelagem |
| scikit-learn | Código aberto | 1.2.2 | Biblioteca de aprendizagem de máquina (RF, SVR, KNN, Regressão Linear, validação cruzada, normalização) |
| SHAP (Explicações Aditivas de Shapley) | Código aberto | 0.41.0 | Biblioteca de interpretabilidade de modelos, módulo TreeExplainer |
| TensorFlow | Código aberto (Google) | 2.11.0 | Estrutura de aprendizagem profunda usada nas seis arquiteturas de DL |
| XGBoost | Código aberto | 1.7.5 | Biblioteca de Boosting Extremo por Gradiente |
Referências
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.