Este protocolo propõe o FedMediFormer-XAI, um framework multimodal de inteligência em diabetes que respeita a privacidade por meio de aprendizado federado, transformadores multimodais, aumento baseado em difusão, recomendação personalizada de medicamentos baseada em grafos e inteligência artificial explicável, para predição precisa, tomada de decisões transparente e manejo personalizado do diabetes.
Artigo de método
FedMediFormer-XAI: Transformers Multimodais Federados com Aumento de Difusão e Recomendação de Medicamentos Baseada em Grafos para Diabetes
Neste artigo
Resumo
Resumo
O manejo do diabetes enfrenta diversos obstáculos, como dados fragmentados de saúde, preocupações com privacidade, baixa explicabilidade e a falta de orientação terapêutica personalizada. Este trabalho de pesquisa apresenta o FedMediFormer-XAI, um framework unificado e adequado que incorpora aprendizado federado, transformadores multimodais, aumento de dados baseado em difusão, Redes Neurais em Grafos (GNNs) para recomendação de medicamentos e Inteligência Artificial Explicável (XAI) para inteligência em diabetes. O sistema utiliza diversos tipos de dados em saúde, por exemplo, registros clínicos, indicadores de saúde populacional, dados de monitoramento contínuo de glicose, imagens de fundo de olho, medições de sensores vestíveis e informações farmacológicas. Para gerar amostras sintéticas e lidar com o desequilíbrio de classes, são utilizados modelos de difusão, e arquiteturas de transformadores multimodais são empregadas para aprender as relações entre fontes de dados muito distintas. O aprendizado federado permite o treinamento colaborativo de modelos de forma que preserve a privacidade, sem compartilhar dados brutos de pacientes. O componente de GNN captura interações entre paciente-medicamento e medicamento-medicamento para recomendações personalizadas de medicamentos. Métodos de explicabilidade, como SHapley Additive exPlanations (SHAP), visualização de atenção, Gradientes Integrados e raciocínio contrafactual, fornecem interpretações transparentes dos resultados de predição e recomendação. Na implementação representativa, o framework proposto alcançou uma acurácia de 94,2%, precisão de 93,1%, revocação de 92,8%, pontuação F1 de 92,9%, Coeficiente de Correlação de Matthews (MCC) de 0,88 e uma Área sob a Curva ROC (AUC-ROC) de 0,96. O módulo de recomendação baseado em grafos alcançou precisão = 0,89, revocação = 0,84 e Ganho Cumulativo Descontado Normalizado (NDCG) = 0,91. O protocolo fornece uma abordagem estruturada para integrar dados heterogêneos em saúde utilizando transformadores multimodais, aprendizado federado, aumento baseado em difusão, recomendação baseada em grafos e inteligência artificial explicável. Os resultados computacionais relatados demonstram o potencial do framework para predição de diabetes e recomendação personalizada de medicamentos, enquanto o design federado apoia o tratamento descentralizado dos dados. Uma avaliação clínica multicêntrica prospectiva é necessária para estabelecer a utilidade clínica, a generalização e a aplicabilidade no mundo real.
Introdução
O diabetes melito está entre as principais doenças metabólicas crônicas que afetam a humanidade e representa um grande problema de saúde pública, pois continua crescendo, com seus efeitos de longo prazo e os altos custos do tratamento dos pacientes1,2. De acordo com um relatório, atualmente há mais de 537 milhões de adultos vivendo com diabetes em todo o mundo, e espera-se que esse número aumente significativamente nas próximas décadas3. Se os níveis elevados de açúcar no sangue não forem controlados, a pessoa sofrerá as piores complicações, como doença cardíaca coronária4, danos renais5, danos nos nervos6, perda da visão7 e acidente vascular cerebral8. Assim, reconhecer a doença em estágio inicial, monitorar regularmente a condição do paciente e oferecer treinamento por meio de abordagens médicas avançadas são etapas necessárias para ajudar os pacientes a viverem vidas mais saudáveis e, com isso, reduzir as despesas do sistema de saúde do Estado9,10.
Atualmente, o uso de prontuários eletrônicos de saúde (EHRs), dispositivos vestíveis, sistemas de monitoramento contínuo de glicose (CGM), tecnologias de imagem de retina e aplicativos móveis de saúde está se expandindo rapidamente, gerando grandes volumes de dados heterogêneos em saúde que podem ser analisados11. Essas diversas ferramentas de coleta de dados podem fornecer informações variadas sobre o corpo humano, sua capacidade de funcionamento em diferentes estágios de uma doença, a forma como o paciente responde a diferentes tipos de tratamento e como ele se comporta na vida real12. A inteligência artificial (AI) mostrou-se a melhor solução para processar dados altamente complexos, prever diabetes, monitorar a doença e auxiliar os médicos em decisões clínicas13. Além disso, algoritmos de aprendizado de máquina, incluindo florestas aleatórias, máquinas de vetores de suporte e métodos de boosting por gradiente, têm apresentado excelentes resultados na avaliação do risco de diabetes14. Mais recentemente, arquiteturas de aprendizado profundo permitiram a extração automática de características e melhoraram o desempenho preditivo em diversas aplicações na área da saúde15.
Utilizando métodos de aprendizado multimodal, a inteligência sobre diabetes foi grandemente aprimorada pela integração de registros clínicos estruturados, medições fisiológicas, imagens de retina e indicadores comportamentais em um único framework preditivo16. Ao utilizar múltiplas fontes de informação, modelos multimodais podem identificar padrões que não são visíveis quando cada modalidade é analisada separadamente17. Modelos baseados em transformadores aprenderam recentemente, de forma muito eficaz, dependências de longo alcance e relações contextuais a partir de diversos tipos de dados de saúde18. No entanto, problemas como classes desbalanceadas, dados ausentes, heterogeneidade dos dados e generalização limitada ainda impedem o uso generalizado de sistemas de IA multimodal em ambientes clínicos19.
Mesmo com esses avanços, muitos sistemas de inteligência para diabetes ainda dependem de estruturas de aprendizado centralizadas que exigem inerentemente a consolidação de dados de pacientes de diferentes instituições em um único repositório20. Métodos como esses já estão gerando disputas sobre privacidade do paciente, custódia de dados, segurança cibernética e conformidade regulatória21. Na verdade, devido a considerações legais e éticas, os prestadores de serviços de saúde frequentemente têm suas capacidades limitadas para compartilhar dados sensíveis de pacientes22. Nesse contexto, o aprendizado federado está se tornando uma solução viável, pois permite treinar um modelo colaborativo sem compartilhar os dados reais dos pacientes23. Por meio da otimização descentralizada e da agregação segura de parâmetros, o aprendizado federado viabiliza análises de saúde com proteção de privacidade, aproveitando o conhecimento de conjuntos de dados distribuídos geograficamente24. No entanto, a sobrecarga de comunicação, a heterogeneidade dos clientes e a estabilidade da convergência ainda representam problemas significativos nos cenários federados de saúde25.
Outra desvantagem dos sistemas de inteligência em diabetes atualmente em uso é a falta de transparência e apoio à terapia personalizada. Muitos modelos de aprendizado profundo comportam-se como caixas pretas, o que representa um problema para clínicos que desejam compreender o raciocínio por trás das previsões e recomendações26. Métodos de inteligência artificial explicável (XAI), como SHAP, Gradientes Integrados, visualização de atenção e raciocínio contrafactual, estão demonstrando grande potencial para aumentar a transparência do modelo e a confiança do clínico27. Além disso, as redes neurais em grafos (GNNs) tornaram-se as ferramentas mais avançadas para capturar interações entre paciente-medicamento e medicamento-medicamento, resultando em recomendações personalizadas de medicamentos e avaliação da segurança medicamentosa28. Novos modelos de difusão também introduziram soluções para gerar dados médicos sintéticos autênticos e abordar o desequilíbrio de classes29.
Transformadores, aprendizado federado, geração de dados sintéticos baseada em difusão, redes neurais em grafos e inteligência artificial explicável demonstraram, cada um, resultados promissores em aplicações na área da saúde; no entanto, sua integração dentro de um único quadro de inteligência em diabetes reprodutível ainda é limitada. As abordagens existentes geralmente tratam esses componentes de forma independente, concentrando-se em aprendizado que preserva a privacidade sem recomendação personalizada de tratamento, predição multimodal sem treinamento descentralizado, ou explicabilidade sem suporte à decisão clínica baseado em grafos. Embora modelos de difusão possam auxiliar no balanceamento de classes e arquiteturas de transformadores possam aprender relações entre modalidades heterogêneas de dados em saúde, protocolos padronizados para integrar essas tecnologias complementares ainda são escassos. Assim, este trabalho apresenta um protocolo metodológico unificado que combina predição multimodal, aumento baseado em difusão, otimização federada, recomendação personalizada de medicamentos baseada em grafos e inteligência artificial explicável em um fluxo de trabalho reprodutível, ao mesmo tempo que fornece uma base para validação clínica e tradução futuras.
Diferentemente de estudos que presumem a disponibilidade de conjuntos de dados multimodais em nível de paciente, este protocolo integra conjuntos de dados públicos heterogêneos sem realizar correspondência direta de pacientes. Modelos independentes específicos para cada modalidade são treinados para cada fonte de dados, e incorporações de características latentes são combinadas por meio de um mecanismo de atenção cruzada entre modalidades. Este desenho preserva o rigor metodológico ao mesmo tempo que permite a integração de conhecimento multimodal através de repositórios de saúde diversos.
O protocolo proposto destina-se principalmente ao desenvolvimento metodológico e a ambientes de inteligência artificial em saúde distribuída, nos quais fontes de dados heterogêneas estão disponíveis em repositórios ou instituições separados e a centralização direta dos dados é restrita. Na implementação atual, os conjuntos de dados específicos por modalidade são independentes e não são correspondentes por paciente; portanto, a integração multimodal é realizada no nível de representação aprendida, em vez de por meio de correspondência direta ao nível do paciente. A aplicação prática exigiria dados multimodais de pacientes adequadamente vinculados, pré-processamento consistente e definições de desfecho uniformes entre os locais participantes, infraestrutura computacional adequada e conformidade com os requisitos éticos, de privacidade e regulamentares aplicáveis.
Este artigo apresenta o FedMediFormer-XAI, um framework federado de transformadores multimodais que permite inteligência em diabetes com preservação de privacidade, reunindo previsão, recomendação e funcionalidades de explicabilidade. Este framework integra aumento de dados baseado em difusão para lidar com desequilíbrio de classes, aprendizado com transformadores multimodais para previsão de diabetes, aprendizado federado para desenvolvimento colaborativo de modelos, recomendação personalizada de medicamentos baseada em redes neurais gráficas e métodos de inteligência artificial explicável para apoiar decisões clínicas de forma transparente. A arquitetura geral e o fluxo de trabalho do framework proposto FedMediFormer-XAI são ilustrados na Figura 1.
As principais contribuições do framework proposto FedMediFormer-XAI são resumidas da seguinte forma: (1) É apresentado um protocolo unificado que integra aprendizado federado, transformadores multimodais, aumento de dados baseado em difusão, recomendação personalizada de medicamentos baseada em redes neurais em grafos e inteligência artificial explicável em um único fluxo de trabalho reprodutível para inteligência em diabetes. (2) É desenvolvida uma estratégia de aprendizado federado que preserva a privacidade, permitindo o treinamento colaborativo do modelo em clientes de saúde simulados distribuídos, sem compartilhar dados brutos de pacientes. (3) É introduzida uma arquitetura de transformador multimodal para aprender conjuntamente representações complementares a partir de registros clínicos estruturados, dados de monitoramento contínuo de glicose, imagens de fundo de retina e indicadores de saúde populacional. (4) É incorporada a geração sintética de dados baseada em difusão para reduzir o desequilíbrio de classes e melhorar a robustez do modelo, preservando as características estatísticas dos dados de treinamento originais. (5) Um módulo de aprendizado em grafos heterogêneos baseado em GraphSAGE é empregado para modelar as relações entre pacientes e medicamentos e entre medicamentos, permitindo recomendações personalizadas de medicamentos e classificação de tratamentos com base na detecção de interações. (6) Múltiplas técnicas de inteligência artificial explicável, incluindo SHapley Additive exPlanations (SHAP), Gradientes Integrados, visualização de atenção e explicações contrafactuais, são integradas para aumentar a transparência do modelo e fornecer saídas de previsão e recomendação interpretáveis. (7) É fornecido um protocolo abrangente de validação, incluindo avaliação preditiva, avaliação do aprendizado federado, avaliação de recomendações, análise de explicabilidade, avaliação centrada no clínico, validação externa e avaliação de reprodutibilidade.
Protocolo
Todos os conjuntos de dados utilizados neste estudo foram obtidos de repositórios publicamente acessíveis e continham informações de pacientes desidentificadas. Eles incluíram o Conjunto de Dados de Diabetes dos Índios Pima, o Conjunto de Dados de Indicadores de Saúde de Diabetes do CDC, o Conjunto de Dados OhioT1DM, o Conjunto de Dados de Detecção de Cegueira APTOS 2019, o Conjunto de Dados de Avaliação de Drogas e o Conjunto de Dados de Interação entre Drogas. Não houve recrutamento direto de pacientes, intervenção, coleta de espécimes ou acesso a informações de saúde pessoais identificáveis. O estudo limitou-se a uma análise secundária de conjuntos de dados anonimizados e publicamente disponíveis para desenvolvimento e validação metodológicos, e foi conduzido de acordo com os requisitos institucionais para o uso desses dados. A avaliação centrada no ser humano descrita neste protocolo destina-se à implementação futura e não foi realizada no presente estudo. Pesquisadores que conduzirem essa avaliação devem obter a aprovação apropriada do Comitê de Ética Institucional, obter consentimento informado por escrito de todos os participantes e cumprir os requisitos institucionais aplicáveis, acordos de uso de dados e regulamentações nacionais.
1. Configure o ambiente computacional
- Instale o Python 3.11 como ambiente de programação principal. Instale o PyTorch 2.3 e o TensorFlow 2.15 para desenvolvimento e treinamento de modelos de aprendizado profundo. Instale a biblioteca Transformers (v4.45) para implementar arquiteturas baseadas em transformadores.
- Instale o PyTorch Geometric (v2.5) para dar suporte à construção e ao treinamento de redes neurais em grafos. Instale o SHAP (v0.47) e o Captum (v0.8) para realizar análises de explicabilidade e atribuição de características.
- Instale o NumPy, Pandas e Scikit-learn para computação numérica, pré-processamento de dados e utilitários de aprendizado de máquina. Instale o OpenCV e o Matplotlib para tarefas de processamento e visualização de imagens. Instale o NetworkX para construir e analisar grafos de interação de medicamentos.
- Instale o CUDA Toolkit e os drivers da GPU NVIDIA compatíveis para habilitar a computação acelerada por hardware. Configure uma GPU NVIDIA RTX 4090 com pelo menos 32 GB de memória de sistema. Defina a semente aleatória como 42 para treinamento, validação e testes, garantindo resultados reprodutíveis. Verifique as instalações e a compatibilidade das bibliotecas de software utilizadas. Registre as versões do software, as especificações de hardware e os parâmetros de configuração do modelo usados na análise.
2. Preparar e pré-processar conjuntos de dados
- Baixe e organize os conjuntos de dados clínicos, fisiológicos, de imagem e farmacológicos necessários em repositórios específicos por modalidade e verifique sua integridade. Confirme as características dos conjuntos de dados, os alvos de predição e os níveis de integração conforme especificado nas Tabelas 1 e 2. O fluxo de trabalho é ilustrado na Figura 2.
- Remova registros duplicados, inválidos ou inconsistentes, bem como registros com variáveis essenciais ausentes. Divida cada conjunto de dados aplicável em subconjuntos independentes por paciente: treinamento (70%), validação (15%) e teste (15%). Aplique imputação pela mediana, escalonamento Min-Max e codificação categórica utilizando apenas o subconjunto de treinamento, e aplique as transformações ajustadas inalteradas aos subconjuntos de validação e teste. Realize a geração de dados sintéticos apenas no subconjunto de treinamento. Verifique a partição e a prevenção de vazamento conforme descrito na Tabela Suplementar 1.
- Importe os dados de glicose, ingestão alimentar, dose de insulina, atividade física e sono. Padronize os carimbos de tempo, alinhe eventos a intervalos regulares, interpole linearmente os valores de glicose não registrados, divida os registros contínuos em janelas de comprimento fixo e aplique normalização por escore z para gerar as entradas do transformador temporal.
- Carregue as imagens de fundo de olho e remova arquivos corrompidos ou ilegíveis, duplicatas, imagens com rótulos ausentes e imagens com artefatos graves ou visibilidade insuficiente do campo retiniano.
- Redimensione as imagens mantidas para 224 × 224 pixels, normalize as intensidades dos pixels para [0, 1] e aplique equalização de histograma adaptativa com limite de contraste (CLAHE).
- Aumente as imagens de treinamento usando rotação aleatória dentro de ±15°, inversão horizontal com probabilidade de 0,5, zoom aleatório entre 0,9–1,1× e ajuste de brilho dentro de ±20%. Não aplique aumento estocástico às imagens de validação ou teste. Armazene as imagens processadas para o treinamento do Transformador de Visão.
- Integre as representações específicas de cada modalidade de acordo com a estratégia de integração de conjuntos de dados resumida na Tabela 2. Não realize correspondência direta entre pacientes em repositórios independentes quando identificadores comuns de pacientes não estiverem disponíveis.
- Armazene cada conjunto de dados público como um conjunto de dados independente e específico à modalidade, pois os identificadores de pacientes não são compartilhados entre repositórios.
- Treine extratores de características específicos à modalidade de forma independente, utilizando os conjuntos de dados correspondentes: (a) Registros clínicos → codificador TabTransformer; (b) Indicadores de saúde populacional → codificador TabTransformer; (c) Monitoramento contínuo de glicose → Transformador Temporal; (d) Imagens de fundo de olho → Transformador de Visão; (e) Dados farmacológicos → módulo GraphSAGE.
- Extraia incorporações latentes de características independentemente de cada modalidade. Combine apenas as incorporações latentes aprendidas por meio do módulo proposto de fusão com atenção cruzada, em vez de mesclar registros brutos de pacientes.
- Garanta que nenhuma correspondência artificial de pacientes seja realizada entre conjuntos de dados públicos independentes. Mantenha partições independentes de treinamento, validação e teste para cada conjunto de dados durante todo o pré-processamento, aumento e desenvolvimento do modelo.
- Armazene as representações multimodais fundidas para predição subsequente, aprendizado federado, explicabilidade e recomendação personalizada de medicamentos (Figura 2).
3. Realizar a ampliação de dados baseada em difusão
- Aplique a ampliação baseada em difusão a conjuntos de dados clínicos e de saúde populacional tabulares estruturados usando o TabDDPM. Gere amostras sintéticas exclusivamente a partir da partição de treinamento pré-processada para evitar vazamento de informações. Configure o modelo de acordo com a Tabela Suplementar 2.
- Treine o TabDDPM por um máximo de 500 épocas usando o otimizador Adam (taxa de aprendizado = 1 × 10⁻4; tamanho do lote = 256). Aplique a interrupção antecipada se a perda de validação não melhorar em pelo menos 0,001 durante 20 épocas consecutivas. Gere amostras sintéticas para classes sub-representadas.
- Avalie a qualidade dos dados sintéticos usando estatísticas de Kolmogorov–Smirnov (KS), divergência de Jensen–Shannon, distância de Wasserstein, análise de correlação por característica e desempenho em classificação subsequente. Compare as distribuições de características originais e sintéticas usando sobreposição de histogramas, estimativa de densidade do kernel e coeficientes de correlação par a par.
- Accepte amostras sintéticas apenas quando as distribuições de características por classe permanecerem consistentes com os dados de treinamento originais (teste KS, p > 0,05; divergência de Jensen–Shannon < 0,10) e não contiverem valores clínicos irreais. Combine as amostras aceitas com o conjunto de dados de treinamento original para gerar um conjunto de dados balanceado por classe. O fluxo de trabalho de ampliação é mostrado na Figura 3.
- Valide os dados sintéticos retreinando o modelo de predição de diabetes usando os conjuntos de treinamento original e aumentado. Compare a Acurácia, o índice F1, o coeficiente MCC e a AUC-ROC para avaliar mudanças na generalização do modelo e no viés distribucional.
4. Desenvolver o modelo de transformador multimodal
Configure o transformador multimodal com codificadores específicos para cada modalidade para dados clínicos estruturados, sequências de MCG e imagens de fundo de retina, conforme ilustrado na Figura 4. Integre as representações resultantes utilizando atenção cruzada entre modalidades para predição de diabetes e recomendação personalizada de medicamentos baseada em grafos.
- Desenvolver o Codificador Clínico
- Inicialize a arquitetura do codificador TabTransformer. Insira variáveis clínicas normalizadas e indicadores de saúde populacional. Gere representações de características contextuais utilizando mecanismos de atenção do transformador.
- Configure o codificador TabTransformer com 32 variáveis clínicas estruturadas, uma dimensão de incorporação de 128, quatro camadas do transformador, oito cabeças de atenção, uma dimensão de alimentação direta de 512, uma taxa de abandono (dropout) de 0,20 e ativação da Unidade Linear de Erro Gaussiana (GELU).
- Aprenda incorporações clínicas latentes que capturem as relações entre os atributos do paciente. Armazene as incorporações clínicas resultantes para integração multimodal.
- Desenvolver o Codificador de Monitoramento Contínuo de Glicose
- Inicialize o codificador temporal do transformador. Insira sequências de monitoramento contínuo de glicose e medições fisiológicas. Utilize mecanismos de autoatenção para codificar dependências temporais.
- Configure o transformador temporal com um comprimento de sequência de 96 passos de tempo, um intervalo de amostragem de 15 min, uma dimensão de incorporação de 128, quatro camadas do transformador, oito cabeças de atenção, codificação posicional senoidal e uma taxa de abandono (dropout) de 0,20.
- Produza incorporações sequenciais que reflitam a dinâmica glicêmica do paciente. Mantenha as incorporações temporais prontas para o próximo processo de fusão.
- Desenvolver o Codificador do Transformador de Visão
- Inicialize a arquitetura do Transformador de Visão. Insira imagens pré-processadas do fundo de olho. Divida as imagens em segmentos de tamanho fixo.
- Configure o Transformador de Visão com uma resolução de imagem de entrada de 224 × 224 pixels, um tamanho de segmento de 16 × 16 pixels, uma dimensão de incorporação de 768, 12 blocos do transformador, 12 cabeças de atenção e uma taxa de abandono (dropout) de 0,10.
- Gere representações de características em nível de segmento. Adquira características visuais que indiquem patologias retinianas e biomarcadores relacionados à doença. Mantenha as incorporações de imagem para fusão multimodal.
- Realizar a Fusão Cruzada de Modalidades
- Extraia as representações latentes dos codificadores clínico, de CGM e do Transformador de Visão e projete cada uma em um espaço latente comum de 256 dimensões, utilizando projeções lineares independentes seguidas pela Normalização por Camada.
- Concatene os tokens de modalidade projetados, adicione incorporações de tipo de modalidade aprendíveis e aplique atenção multi-cabeça cruzada entre modalidades para permitir a troca de informações entre as representações clínicas, de CGM e retinianas. Configure o bloco de atenção com oito cabeças, um espaço de modelo de 256 dimensões, uma camada de alimentação direta de 1.024 dimensões, ativação GELU, abandono (dropout) de 0,10, conexões residuais e Normalização por Camada.
- Realize a média de cada grupo de tokens específico à modalidade e concatene as representações resultantes. Projete o vetor concatenado de 768 dimensões em uma representação unificada multimodal de 512 dimensões e mantenha os pesos de atenção e as representações fundidas para análises subsequentes de explicabilidade e ablação.
- Encaminhe a representação unificada aos módulos de predição de diabetes e de recomendação de medicamentos baseado em GraphSAGE. Mantenha as partições originais específicas à modalidade para treinamento, validação e testes durante toda a fusão, sem correspondência artificial em nível de paciente entre os conjuntos de dados independentes.
- Configure o transformador multimodal de acordo com os parâmetros do modelo resumidos na Supplementary Table 3.
5. Configurar o aprendizado federado
- Configure a estrutura de aprendizado federado para permitir o treinamento colaborativo de modelos entre instituições de saúde distribuídas geograficamente, sem a troca de dados individuais de pacientes. Realize a otimização local do modelo em cada instituição participante utilizando os dados disponíveis localmente. Compartilhe apenas os parâmetros do modelo protegidos com o servidor central de agregação. Preserve a privacidade dos pacientes enquanto possibilita o desenvolvimento colaborativo de modelos multimodais.
- Separe os conjuntos de dados multimodais e distribua-os entre múltiplos clientes federados para simular o cenário de diferentes instituições de saúde colaborando sem compartilhar seus dados.
- Configure a rede de aprendizado federado com 10 clientes hospitalares participantes, um servidor central de agregação, cinco épocas locais por rodada de comunicação, 100 rodadas de comunicação, uma fração de participação de clientes de 80%, seleção aleatória de clientes em cada rodada de comunicação e um mínimo de oito clientes participantes por rodada.
- Forneça a cada cliente um conjunto de dados pertencente a uma instituição específica, de modo que os dados permaneçam locais e confidenciais. Particione os dados multimodais de treinamento entre 10 clientes hospitalares simulados utilizando uma estratégia não independente e identicamente distribuída (não-IID) baseada em Dirichlet. para gerar distribuições de classes heterogêneas, composições demográficas e tamanhos de conjuntos de dados dos clientes.
- Utilize uma semente aleatória fixa para garantir a reprodutibilidade. Verifique as distribuições resultantes no nível dos clientes e mantenha essas partições durante todo o treinamento federado. Mantenha os conjuntos de dados de validação e teste independentes das partições dos clientes.
- Inicialize cada cliente local com os parâmetros do modelo global recebidos do servidor central de agregação. Treine o transformador multimodal local por cinco épocas utilizando os dados de treinamento locais do cliente. Otimize o modelo local usando o otimizador AdamW com uma taxa de aprendizado de 1 × 10⁻4.
- Calcule as atualizações dos parâmetros do modelo local após a conclusão do treinamento local. Proteja os parâmetros do modelo local antes da transmissão para o servidor central de agregação. Transmita os parâmetros do modelo local protegidos para o servidor central de agregação para agregação global.
- Receba os parâmetros do modelo protegidos de todos os clientes hospitalares participantes. Verifique a integridade das atualizações do modelo recebidas antes da agregação. Agregue os pesos do modelo local utilizando o algoritmo Federated Averaging (FedAvg). Atualize o transformador multimodal global utilizando os parâmetros do modelo agregados.
- Redistribua os parâmetros atualizados do modelo global para os clientes hospitalares participantes. Repita os procedimentos de treinamento local e agregação global até que 100 rodadas de comunicação sejam concluídas ou até que o critério de convergência predefinido seja satisfeito.
- Proteja os parâmetros do modelo transmitidos utilizando o mecanismo especificado de agregação segura e criptografia AES-256. Autentique os clientes participantes utilizando certificados digitais.
- Estabeleça canais de comunicação criptografados utilizando o Protocolo de Camada de Transporte Seguro (TLS) 1.3. Mantenha apenas os parâmetros agregados do modelo global após a conclusão de cada rodada de comunicação.
- Avalie a privacidade e segurança utilizando exposição de dados brutos, compartilhamento não autorizado, inferência de associação e avaliações de inversão de modelo. Para inferência de associação, compare a AUC-ROC do ataque com a linha de base aleatória (0,50); avalie a inversão utilizando o índice de similaridade estrutural (SSIM) e a razão sinal-ruído de pico (PSNR) para imagens de retina e erro normalizado de reconstrução para características numéricas.
- Verifique a agregação segura confirmando que o servidor não pode acessar atualizações individuais dos clientes não agregadas. Verifique a proteção AES-256/TLS 1.3 e confirme que não ocorrem transmissões de atualizações do modelo sem criptografia.
- Compare métricas de privacidade entre configurações federadas e centralizadas, quando aplicável, e relate as métricas especificadas em Tabela Suplementar 4.
- Estime a complexidade computacional do treinamento do transformador local como O(N × L × d2), onde N representa o número de amostras, L representa o número de camadas do transformador e d representa a dimensão do embedding.
- Estime a complexidade computacional da agregação federada como O(K × P) por rodada de comunicação, onde K representa o número de clientes participantes e P representa o número de parâmetros treináveis do modelo.
- Troque apenas os parâmetros protegidos do modelo entre os clientes participantes e o servidor central de agregação durante cada rodada de comunicação. Calcule a sobrecarga de comunicação com base no tamanho do modelo, no número de clientes participantes e no número de rodadas de comunicação.
- Compare a sobrecarga de troca de parâmetros com o custo estimado de transferir os conjuntos de dados multimodais correspondentes em saúde. Configure o framework de aprendizado federado de acordo com os parâmetros resumidos em Tabela Suplementar 4. O fluxo de trabalho de aprendizado federado e o processo de agregação de parâmetros são ilustrados em Figura 5.
6. Construa o módulo de recomendação personalizada de medicamentos
- Importe os dados farmacológicos, de medicamentos, tratamento de pacientes e interações medicamentosas para o ambiente computacional. Construa um grafo heterogêneo de saúde contendo nós de pacientes, medicamentos, doenças, exames laboratoriais e fatores de risco clínicos.
- Defina as relações entre paciente-doença, paciente-medicamento, doença-medicamento, interação medicamento-medicamento e paciente-laboratório como arestas do grafo. Verifique a estrutura do grafo e remova relações duplicadas, inválidas ou desconectadas antes do treinamento do modelo.
- Represente os nós de pacientes usando idade, sexo, índice de massa corporal (IMC), HbA1c, glicemia, pressão arterial e duração do diabetes. Represente os nós de medicamentos usando classe do fármaco, mecanismo de ação, dosagem, frequência de administração e efeitos adversos conhecidos.
- Represente os nós de doenças usando gravidade da doença, estágio da doença e complicações associadas. Codifique atributos categóricos e normalize características contínuas dos nós antes do treinamento do GraphSAGE.
- Inicialize os embeddings dos nós usando as características pré-processadas dos nós. Amostre até 25 nós vizinhos para cada nó alvo durante a agregação de vizinhança. Agregue as representações dos nós vizinhos usando agregação por média. Atualize os embeddings dos nós alvo usando as representações agregadas da vizinhança.
- Aplique a função de ativação linear retificada (ReLU) após cada camada do GraphSAGE. Normalize os embeddings resultantes dos nós. Repita o procedimento de agregação de vizinhança em três camadas do GraphSAGE.
- Configure o modelo GraphSAGE com uma dimensão oculta de 256, uma dimensão de embedding de 128, três camadas do GraphSAGE, tamanho de amostragem de vizinhos de 25, taxa de dropout de 0,30, taxa de aprendizado de 1 × 10⁻4, tamanho de lote de 512 e um máximo de 100 épocas de treinamento. Otimize o modelo usando o otimizador Adam.
- Calcule o embedding específico do paciente a partir do modelo GraphSAGE treinado. Calcule embeddings para medicamentos candidatos. Calcule pontuações de adequação entre a representação do paciente e as representações dos medicamentos candidatos. Ordene os medicamentos candidatos de acordo com suas pontuações de adequação previstas.
- Identifique e remova medicamentos contraindicados ou potencialmente inseguros usando as informações disponíveis sobre interações medicamentosas. Retorne os cinco medicamentos elegíveis com as pontuações mais altas como as recomendações personalizadas Top-5.
- Treine o modelo de recomendação usando a função de perda Bayesian Personalized Ranking (BPR). Otimize o objetivo de classificação para atribuir pontuações mais altas a medicamentos clinicamente apropriados do que a medicamentos candidatos menos adequados.
- Identifique os nós vizinhos influentes e as relações do grafo clinicamente relevantes que contribuem para cada recomendação de medicamento. Calcule pontuações de atribuição de características para atributos relacionados a pacientes, doenças, laboratórios e medicamentos que contribuem para a recomendação.
- Gere explicações baseadas em grafos visuais mostrando as relações que contribuem para cada recomendação personalizada de medicamento. Configure o modelo de recomendação GraphSAGE de acordo com os parâmetros resumidos na Tabela Suplementar 5. O fluxo de trabalho de recomendação personalizada de medicamentos baseado em grafos é ilustrado na Figura 6.
7. Realize a avaliação de explicabilidade
- Realizar análise SHAP
- Carregue o transformador multimodal treinado e o conjunto de testes reservado no ambiente computacional.
- Inicialize o explicador SHAP utilizando o modelo de predição treinado e uma amostra de fundo composta por 100 amostras de treinamento, selecionadas exclusivamente do conjunto de treinamento por meio de amostragem aleatória estratificada de acordo com a classe do desfecho de diabetes. Mantenha a distribuição aproximada das classes da partição completa de treinamento na amostra de fundo e utilize uma semente aleatória fixa de 42 para garantir a seleção reprodutível das amostras. Calcule os valores SHAP para as amostras de teste selecionadas.
- Calcule a importância global das características a partir dos valores absolutos de SHAP, gere visualizações globais e locais de SHAP e mantenha os valores calculados para análises quantitativas e estatísticas subsequentes.
- Realizar análise de gradientes integrados
- Selecione amostras representativas corretamente classificadas e incorretamente classificadas do conjunto de testes reservado. Defina entradas de referência específicas para cada modalidade antes de calcular os Gradientes Integrados. Utilize uma referência nula para características numéricas clínicas e de CGM normalizadas, representando contribuição nula da característica normalizada, e utilize uma imagem de referência com valores zero para a entrada de imagem de retina normalizada.
- Calcule os escores de atribuição de Gradientes Integrados usando 100 etapas de interpolação entre a referência e a entrada original. Normalize os escores de atribuição resultantes para permitir comparação entre características e modalidades. Gere visualizações de atribuição para identificar características clínicas, temporais e de imagem influentes que contribuem para predições individuais do modelo.
- Realizar visualização de atenção
- Extraia as matrizes de atenção das camadas do transformador treinado para amostras de teste representativas. Calcule os pesos médios de atenção ao longo das cabeças de atenção correspondentes. Gere mapas de calor de atenção para visualizar interações cruzadas entre representações clínicas, temporais e de imagem de retina. Identifique as características clínicas, temporais e de retina dominantes que recebem altos pesos de atenção durante a predição.
- Extraia os pesos de atenção do transformador multimodal treinado para uma amostra de teste reservada selecionada aleatoriamente e visualize as distribuições correspondentes de atenção para características clínicas, temporais de CGM, espaciais de retina e cruzadas entre modalidades.
- Gerar explicações contrafactuais
- Selecione registros de pacientes representativos do conjunto de testes reservado. Defina intervalos clinicamente permitidos e restrições para características modificáveis do paciente antes de gerar amostras contrafactuais. Restrinja características contínuas ao intervalo observado nos dados de treinamento e restrinja características categóricas às categorias válidas observadas nos dados de treinamento. Não modifique características demográficas imutáveis, incluindo idade e sexo.
- Gere amostras contrafactuais modificando minimamente apenas as características modificáveis permitidas, preservando as restrições clínicas e do domínio de características previamente definidas. Rejeite contrafactuais que contenham valores fora do intervalo observado nos dados de treinamento, estados categóricos inválidos ou modificações em características imutáveis. Identifique as menores modificações clinicamente plausíveis nas características necessárias para alterar o desfecho predito.
- Relate as características modificadas, valores originais, valores contrafactuais e as alterações correspondentes nas predições do modelo. O fluxo de trabalho de avaliação de explicabilidade é ilustrado na Figura 7, enquanto saídas representativas de visualização de atenção e explicações contrafactuais são apresentadas na Figura Suplementar 1.
- Avaliar a qualidade da explicação
- Calcule a fidelidade para quantificar a concordância entre as explicações geradas e o comportamento do modelo de predição. Calcule a estabilidade gerando repetidamente explicações sob pequenas perturbações nas entradas e comparando os padrões de atribuição resultantes. Avalie a consistência comparando explicações geradas para amostras de teste clinicamente semelhantes.
- Calcule a esparsidade determinando o número ou proporção de características que contribuem significativamente para cada explicação. Avalie a completude para determinar se as características atribuídas explicam adequadamente a saída correspondente do modelo. Avalie a sensibilidade medindo as alterações nos escores de atribuição após perturbações controladas nas características de entrada.
- Calcule a infidelidade para quantificar a discordância entre as atribuições de características e as alterações observadas nas predições do modelo. Registre todas as métricas quantitativas de explicabilidade para análise estatística subsequente.
- Realizar validação prospectiva por clínicos
- Para futura validação clínica prospectiva, obtenha aprovação do Comitê de Ética Institucional apropriado antes de recrutar especialistas clínicos. Após obter a aprovação ética, recrute 12 clínicos, compreendendo seis endocrinologistas, três especialistas em diabetes e três farmacologistas clínicos, e obtenha consentimento informado de todos os participantes antes de iniciar a avaliação.
- Selecione aleatoriamente predições do modelo e suas explicações correspondentes para avaliação por clínicos. Apresente as explicações selecionadas independentemente a cada clínico participante utilizando um formato padronizado de avaliação.
- Solicite a cada clínico que avalie a utilidade, relevância clínica, interpretabilidade e confiabilidade da explicação utilizando uma escala Likert de cinco pontos. Registre as avaliações anônimas dos clínicos e calcule a concordância entre avaliadores e as medidas estatísticas correspondentes conforme especificado na Etapa 7.7.
- Realizar análise estatística
- Avalie a distribuição dos escores de avaliação quantitativos antes de selecionar o teste estatístico de comparação. Aplique o teste t pareado para medições pareadas com distribuição normal ou o teste de Wilcoxon para medições pareadas com distribuição não normal, conforme apropriado.
- Calcule o kappa de Fleiss para quantificar a concordância entre os clínicos participantes. Calcule intervalos de confiança de 95% para as métricas principais de explicabilidade e avaliação por clínicos. Estabeleça o limiar de significância estatística em p < 0,05.
- Relate as estatísticas de teste calculadas, intervalos de confiança e valores-p juntamente com os resultados da avaliação. Avalie e relate as métricas de explicabilidade de acordo com os critérios resumidos na Tabela Suplementar 6.
8. Avaliar o desempenho do modelo
- Compare o FedMediFormer-XAI com Regressão Logística, Floresta Aleatória, XGBoost, TabTransformer, Vision Transformer, Temporal Transformer e o transformador multimodal centralizado utilizando acurácia, precisão, revocação, pontuação F1, MCC e AUC-ROC.
- Realize cada avaliação de linha de base usando a mesma estratégia predefinida de treinamento, validação e teste para garantir uma comparação consistente com o framework proposto.
- Repita a avaliação do modelo em execuções experimentais independentes e registre as métricas de desempenho obtidas em cada execução. Calcule a média, o desvio padrão (DP) e o intervalo de confiança de 95% (IC) para Acurácia, Precisão, Revocação, Pontuação F1, MCC e AUC-ROC. Relate os resultados de desempenho como média ± DP juntamente com o respectivo IC de 95%.
- Avalie a normalidade das diferenças pareadas de desempenho entre o FedMediFormer-XAI e cada modelo de linha de base. Aplique um teste t pareado para medições pareadas com distribuição normal e o teste de postos com sinal de Wilcoxon para medições pareadas com distribuição não normal. Defina o limiar de significância estatística em p < 0,05.
- Relate as estatísticas de teste correspondentes, valores-p e intervalos de confiança de 95% para quantificar a significância estatística e a incerteza das diferenças de desempenho observadas.
- Obtenha a contagem de todas as rodadas de comunicação até que os modelos finalmente converjam. Acompanhe o desempenho do modelo global durante o treinamento federado. Estude como a convergência muda ao longo do tempo nas rodadas de comunicação.
- Verifique a eficácia da agregação de parâmetros. Examine como a aprendizagem descentralizada influencia o desempenho preditivo. Faça uma comparação entre os resultados da aprendizagem federada e da aprendizagem centralizada.
- Avalie a convergência federada ao longo das rodadas de comunicação e compare o desempenho preditivo federado e centralizado. Avalie as recomendações de medicamentos usando Precisão@5, Revocação@5 e NDCG@5.
- Gere amostras negativas – amostras de medicamentos a partir do conjunto candidato elegível, selecionando medicamentos que não são observados como interações positivas entre paciente e medicamento para o paciente correspondente. Exclua todas as interações positivas conhecidas e todos os medicamentos contraindicados do conjunto de amostragem negativa. Mantenha uma razão fixa de amostragem negativa para positiva de 1:1 para o treinamento de recomendação e use uma semente aleatória fixa de 42 para seleção reprodutível de amostras negativas.
- Estabeleça o conjunto de itens relevantes para cada paciente exclusivamente a partir dos dados de avaliação retidos. Defina o conjunto de itens relevantes Ru para o paciente u como o conjunto de medicamentos que satisfazem os critérios positivos de interação entre paciente e medicamento nos registros reais retidos. Não use previsões do modelo para construir Ru. Remova medicamentos contraindicados do conjunto de recomendação candidato antes da classificação.
- Gere os cinco medicamentos elegíveis com as classificações mais altas para cada paciente de avaliação. Calcule a Precisão@5 como a proporção dos cinco medicamentos recomendados que pertencem ao conjunto de itens relevantes Ru do paciente. Calcule a Revocação@5 como a proporção dos medicamentos relevantes do paciente recuperados entre as cinco recomendações. Calcule o NDCG@5 usando a relevância graduada dos medicamentos recomendados, atribuindo maior relevância a medicamentos clinicamente apropriados e relevância zero a medicamentos não relevantes. Agregue as métricas para todos os pacientes de avaliação e relate a média de Precisão@5, Revocação@5 e NDCG@5.
- Construa a verdade fundamental para recomendação antes da avaliação do modelo e mantenha as interações entre paciente e medicamento retidas separadas dos dados de treinamento de recomendação. Não use interações de medicamentos do conjunto de teste, rótulos do conjunto de teste ou informações de tratamento futuro durante o treinamento do GraphSAGE, amostragem negativa ou classificação de candidatos.
- Meça a Fidelidade para verificar quão bem as explicações correspondem ao comportamento do modelo. Avalie a estabilidade da explicação por meio de múltiplas análises. Julgue a Compreensibilidade com base em critérios voltados para médicos.
- Investigue a consistência das explicações em diferentes tipos de dados. Confirme o valor clínico das explicações produzidas. As métricas de avaliação utilizadas ao longo do estudo são resumidas na Supplementary Table 7.
9. Realize a validação prospectiva do clínico
- Realize a validação prospectiva por clínicos após obter a aprovação ética apropriada e o consentimento informado, seguindo os procedimentos de recrutamento, avaliação, coleta de dados e análise estatística descritos nas Etapas 7.6–7.8. O desenho do estudo de validação clínica prospectiva, incluindo a composição dos participantes, critérios de avaliação, condições de comparação e análises estatísticas planejadas, é resumido na Supplementary Table 8.
10. Realize a validação e a avaliação da reprodutibilidade
- Realize estudos de ablação removendo sistematicamente componentes individuais do framework completo FedMediFormer-XAI, mantendo as mesmas partições do conjunto de dados, procedimentos de pré-processamento, configurações de treinamento e critérios de avaliação. Avalie o modelo completo e as configurações sem aumento por difusão, aprendizado federado, recomendação de medicamentos baseada em GraphSAGE e fusão multimodal.
- Compare as configurações ablatadas com o framework completo FedMediFormer-XAI utilizando Acurácia, Precisão, Revocação, pontuação F1, MCC e AUC-ROC. Quantifique a alteração em cada métrica de desempenho para determinar a contribuição de cada componente do framework. Compare os resultados de validação com os resultados do teste interno para avaliar a generalização. Realize testes de significância estatística para determinar a confiabilidade das diferenças de desempenho observadas.
- Avalie a generalização do framework utilizando um conjunto de dados externo independente, quando disponível um conjunto de dados com variáveis de entrada compatíveis e definições de desfecho. Aplique os mesmos procedimentos de pré-processamento e avaliação utilizados para o conjunto de dados de teste interno e compare as métricas de desempenho resultantes com os resultados do teste interno.
- Realize análise de significância estatística ao longo de execuções experimentais repetidas. Avalie a normalidade das diferenças de desempenho pareadas antes dos testes estatísticos. Aplique o teste t pareado para medições pareadas com distribuição normal e o teste de postos com sinal de Wilcoxon para medições pareadas com distribuição não normal. Defina o limiar de significância estatística em p < 0,05.
- Calcule a média e o intervalo de confiança de 95% para Acurácia, Precisão, Revocação, pontuação F1, MCC e AUC-ROC. Relate as estatísticas de teste correspondentes, valores-p e intervalos de confiança para as comparações principais entre modelos. Documente todos os parâmetros do modelo, procedimentos de pré-processamento, configurações de treinamento e protocolos de avaliação necessários para reproduzir os experimentos relatados.
- Preserve o código-fonte, arquivos de configuração, scripts de avaliação e especificações dos modelos treinados utilizados nos experimentos relatados. Mantenha registros detalhados do treinamento dos modelos, configurações experimentais, sementes aleatórias e resultados de avaliação.
- Verifique a completude e consistência dos materiais de reprodutibilidade disponíveis. Assegure-se de que os métodos e materiais documentados forneçam informações suficientes para a reprodução independente do fluxo de trabalho experimental.
- Resuma os recursos de reprodutibilidade e os procedimentos de validação utilizados no estudo na Supplementary Table 9. Documente o procedimento do estudo de ablação e os critérios de avaliação para analisar a contribuição dos principais componentes do framework.
Resultados
Análise do desempenho preditivo
O FedMediFormer-XAI demonstrou desempenho preditivo aprimorado em comparação com os modelos de referência unimodais e convencionais avaliados. A ampliação baseada em difusão melhorou a representação das classes minoritárias, e o desempenho preditivo resultante é resumido na Tabela 3. A avaliação com execuções repetidas demonstrou desempenho preditivo estável entre os modelos avaliados. O FedMediFormer-XAI alcançou o desempenho geral mais alto, com uma acurácia de 94,20 ± 0,34% (IC 95%: 93,78–94,62), precisão de 93,10 ± 0,30% (IC 95%: 92,73–93,47), revocação de 92,80 ± 0,28% (IC 95%: 92,45–93,15) e pontuação F1 de 92,90 ± 0,28% (IC 95%: 92,55–93,25). O modelo alcançou um MCC de 0,88 ± 0,02 (IC 95%: 0,86–0,90) e AUC-ROC de 0,96 ± 0,01 (IC 95%: 0,95–0,97). O transformador multimodal centralizado apresentou o segundo melhor desempenho geral, enquanto os modelos de aprendizado de máquina unimodais e convencionais mostraram desempenho preditivo comparativamente inferior. Esses resultados indicam que a aprendizagem de representação multimodal, combinada com otimização federada, proporciona desempenho aprimorado e mais estável na classificação de diabetes.
Estudo de ablação
A ablação por componentes foi utilizada para avaliar a contribuição do aumento por difusão, aprendizado federado, recomendação de fármacos baseada em GraphSAGE e fusão multimodal. O framework completo FedMediFormer-XAI alcançou uma acurácia de 94,20 ± 0,34%, precisão de 93,10 ± 0,30%, revocação de 92,80 ± 0,28%, pontuação F1 de 92,90 ± 0,28%, MCC de 0,88 ± 0,02 e AUC-ROC de 0,96 ± 0,01 ao longo de cinco execuções independentes. A remoção do aumento por difusão reduziu a acurácia para 91,80 ± 0,42%, correspondendo a uma diminuição de 2,40 pontos percentuais, enquanto a pontuação F1 e a AUC-ROC diminuíram para 90,30 ± 0,38% e 0,94 ± 0,01, respectivamente. Essa redução indica a contribuição do aumento baseado em difusão para a representação de classes minoritárias e a robustez preditiva.
A remoção do aprendizado federado resultou em uma acurácia de 93,10 ± 0,37%, representando uma diminuição de 1,10 ponto percentual em relação à estrutura completa. A precisão, revocação, pontuação F1, MCC e AUC-ROC também foram reduzidos para 92,20 ± 0,34%, 91,80 ± 0,32%, 92,00 ± 0,33%, 0,86 ± 0,02 e 0,95 ± 0,01, respectivamente. Essa comparação demonstra a contribuição da configuração federada para o desempenho preditivo.
A remoção do componente de recomendação personalizada de medicamentos baseado no GraphSAGE resultou em uma alteração comparativamente pequena no desempenho da predição de diabetes, com a acurácia diminuindo para 93,80 ± 0,35% e o F1-score para 92,60 ± 0,30%. Os valores correspondentes de MCC e AUC-ROC foram 0,87 ± 0,02 e 0,96 ± 0,01, respectivamente. Esse resultado indica que o GraphSAGE contribui principalmente para a recomendação personalizada de medicamentos, em vez de determinar diretamente o desempenho da classificação de diabetes.
A maior redução foi observada quando a fusão multimodal foi removida. A acurácia diminuiu para 87,60 ± 0,55%, representando uma queda de 6,60 pontos percentuais, enquanto precisão, revocação, pontuação F1, MCC e AUC-ROC diminuíram para 86,80 ± 0,51%, 85,90 ± 0,54%, 86,30 ± 0,52%, 0,76 ± 0,03 e 0,91 ± 0,01, respectivamente. Esse resultado demonstra a importância de modelar conjuntamente as informações complementares provenientes das modalidades clínicas, de CGM e retinianas.
Análise de aprendizado federado
O framework de aprendizado federado permitiu o treinamento colaborativo de modelos em clientes distribuídos, mantendo o tratamento descentralizado dos dados brutos dos pacientes. Durante o treinamento, o modelo local de cada cliente foi ajustado individualmente e combinado por meio do método de Média Federada. Após 100 rodadas de comunicação, o modelo global convergiu, e seu desempenho preditivo permaneceu consistente com o aprendizado centralizado. O framework de aprendizado federado demonstrou convergência estável ao longo das rodadas de comunicação, apesar das distribuições heterogêneas dos dados dos clientes. A troca protegida de parâmetros preservou o manuseio descentralizado dos dados, enquanto o modelo global manteve um desempenho preditivo competitivo em relação à linha de base centralizada. Tabela 4 compara as implementações centralizada e federada. O aprendizado federado exigiu tempo adicional de treinamento devido à sobrecarga de comunicação, mantendo ao mesmo tempo um desempenho preditivo comparável ao do aprendizado centralizado.
Análise de Desempenho no Nível de Conjunto de Dados
Para avaliar a generalização em diferentes modalidades de saúde, avaliamos o desempenho em cada conjunto de dados separadamente. O modelo multimodal FedMediFormer-XAI demonstrou desempenho robusto e geralmente competitivo nos conjuntos de dados avaliados. Ele alcançou uma acurácia de 91,8%, 93,1%, 92,4% e 94,2% nos conjuntos de dados Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM e APTOS 2019, respectivamente. Embora o conjunto de dados APTOS 2019 tenha alcançado acurácia (94,7%) e precisão (93,9%) ligeiramente superiores em comparação com o modelo multimodal, a abordagem multimodal proposta manteve desempenho competitivo em todos os conjuntos de dados e obteve uma AUC-ROC de 0,96, comparável à AUC-ROC mais alta no nível de conjunto de dados. Os resultados gerais no nível de conjunto de dados são apresentados na Tabela 5. Para conjuntos de dados individuais, a análise de imagens de retina alcançou o melhor desempenho quando utilizada isoladamente, enquanto a fusão multimodal gerou previsões mais estáveis e equilibradas.
Análise de recomendação personalizada de medicamentos
O componente de recomendação baseado em rede neural gráfica foi avaliado utilizando informações sobre eficácia medicamentosa e dados de interação entre medicamentos, com os medicamentos candidatos classificados de acordo com escores aprendidos de adequação paciente-medicamento e combinações contraindicadas excluídas durante a geração das recomendações. O uso do formato de grafo heterogêneo e a modelagem das interações paciente-medicamento e medicamento-medicamento puderam ser realizados de forma minuciosa, apoiando assim a escolha personalizada de medicamentos e a avaliação de segurança. O modelo de recomendação GraphSAGE capturou efetivamente relações complexas entre pacientes, doenças, achados laboratoriais e medicamentos. As recomendações personalizadas demonstraram alto desempenho na classificação, mantendo ao mesmo tempo explicações clinicamente significativas por meio da análise de vizinhança do grafo e da atribuição de características.
De acordo com a Tabela 6, o módulo de recomendação personalizada de medicamentos foi avaliado usando Precisão@5, Revocação@5 e NDCG@5. Essas métricas quantificam a relevância e a qualidade da classificação das cinco principais recomendações personalizadas de medicamentos geradas pelo módulo de recomendação baseado em GraphSAGE. O sistema de recomendação alcançou um desempenho elevado na classificação, com precisão = 0,89, revocação = 0,84 e NDCG = 0,91.
Análise de explicabilidade
O framework incorpora SHAP, Gradientes Integrados, visualização de atenção e explicações contrafactuais para apoiar a interpretação de previsões multimodais. O SHAP foi utilizado para quantificar as contribuições em nível de características, os Gradientes Integrados para atribuir as previsões às características de entrada, a visualização de atenção para examinar o foco do modelo nas diferentes modalidades e as explicações contrafactuais para identificar alterações nas características associadas a previsões alternativas. Figura 8 apresenta um gráfico resumo representativo derivado do modelo FedMediFormer-XAI treinado, enquanto Figura 9 apresenta visualizações representativas de atenção extraídas do transformador treinado. Essas figuras representam saídas obtidas a partir da avaliação do modelo, e não ilustrações esquemáticas da arquitetura proposta.
Na Figura 8, são apresentadas as classificações agregadas de importância das características. Características com valores SHAP absolutos mais altos tiveram maior influência nas previsões do modelo e também se alinharam bem com o conhecimento clínico existente.
Figura 9 apresenta visualizações representativas de atenção extraídas diretamente do modelo treinado FedMediFormer-XAI para uma amostra de teste mantida selecionada aleatoriamente. As visualizações incluem atenção a características clínicas, atenção temporal à CGM, atenção espacial à retina e atenção cruzada entre as três modalidades. A visualização de atenção demonstrou ainda mais a alocação aprendida pelo modelo ao longo de múltiplas modalidades. A amostra selecionada mostrou atenção relativamente maior a HbA1c, duração do diabetes e idade entre as características clínicas, enquanto o mapa de atenção da CGM destacou vários períodos com variabilidade glicêmica acentuada. O mapa de atenção da retina identificou regiões específicas da imagem que contribuíram para a representação do modelo, e a matriz de atenção cruzada demonstrou padrões de atenção tanto intra-modal quanto intermodal. Como mostrado na Figura 9, os mapas de atenção derivados do modelo destacam padrões temporais selecionados de glicose, variáveis clínicas influentes e regiões da imagem de retina clinicamente relevantes em uma amostra de teste mantida.
Resultados da avaliação centrada no ser humano
Um protocolo prospectivo de avaliação centrada no ser humano foi projetado para avaliar a confiança do clínico, interpretabilidade, usabilidade, utilidade clínica e relevância das explicações sob condições de apenas previsão e previsão com explicação. A avaliação proposta envolverá endocrinologistas, especialistas em diabetes e farmacologistas clínicos, com aprovação apropriada do Comitê de Ética Institucional e consentimento informado. Como esta avaliação destina-se à implementação prospectiva futura, pontuações de desfecho em nível de clínico não são relatadas no presente protocolo.
Tabela 7 resume o design proposto para a avaliação clínica prospectiva e os critérios predefinidos para avaliar os efeitos das explicações sobre a confiança do clínico, a interpretabilidade e a utilidade percebida. A avaliação prospectiva comparará as avaliações clínicas das previsões do modelo com e sem explicações acompanhantes, utilizando critérios predefinidos em escala Likert. O quadro proposto para avaliação de explicabilidade centrada no ser humano é apresentado na Figura 10
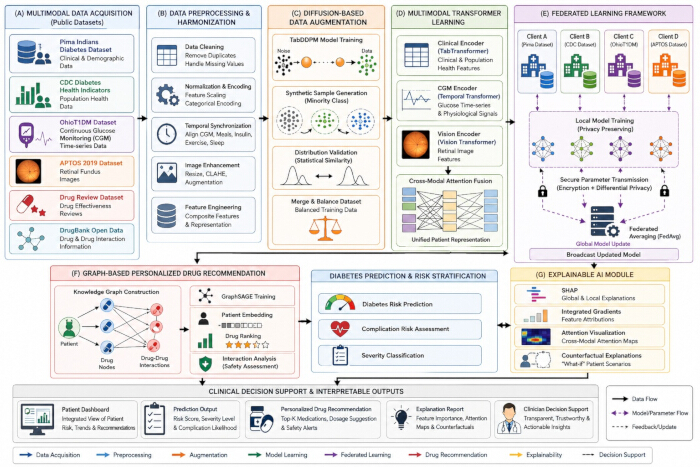
Figura 1: Arquitetura geral do framework FedMediFormer-XAI. Visão esquemática do framework FedMediFormer-XAI, mostrando a aquisição e pré-processamento de dados multimodais, aumento baseado em difusão, aprendizado com transformadores específico por modalidade, treinamento federado do modelo, recomendação personalizada de medicamentos baseada em GraphSAGE e análise de explicabilidade. O framework gera predição de diabetes, recomendações personalizadas de medicamentos e saídas de modelo interpretáveis. Clique aqui para visualizar uma versão maior desta figura.
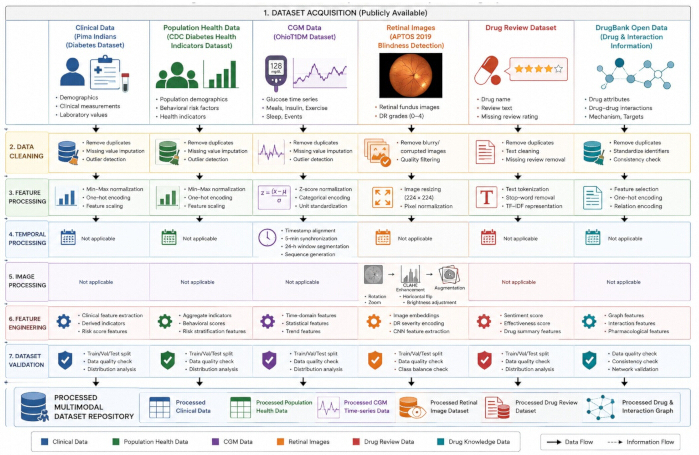
Figura 2: Pipeline de aquisição e pré-processamento de conjunto de dados multimodal. Fluxo esquemático para aquisição e pré-processamento dos conjuntos de dados multimodais utilizados no FedMediFormer-XAI. Dados clínicos e de saúde populacional, registros de CGM, imagens de retina e informações farmacológicas passam por controle de qualidade, pré-processamento, normalização, codificação e aumento específicos para cada modalidade antes de serem convertidos em representações prontas para o modelo, destinadas à análise posterior. Clique aqui para visualizar uma versão maior desta figura.
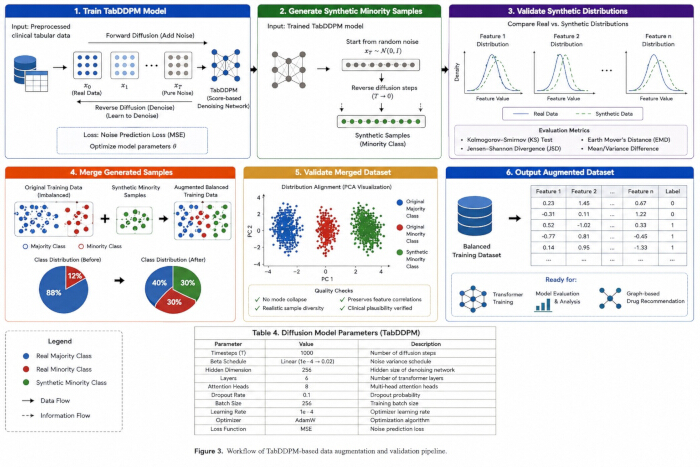
Figura 3: Fluxo de trabalho para aumento de dados baseado em difusão. Fluxo esquemático do aumento baseado em difusão de dados tabulares estruturados utilizando TabDDPM. As amostras geradas passam por avaliações de qualidade e de semelhança de distribuição antes de serem integradas aos dados de treinamento originais para melhorar o equilíbrio entre classes. Clique aqui para visualizar uma versão maior desta figura.
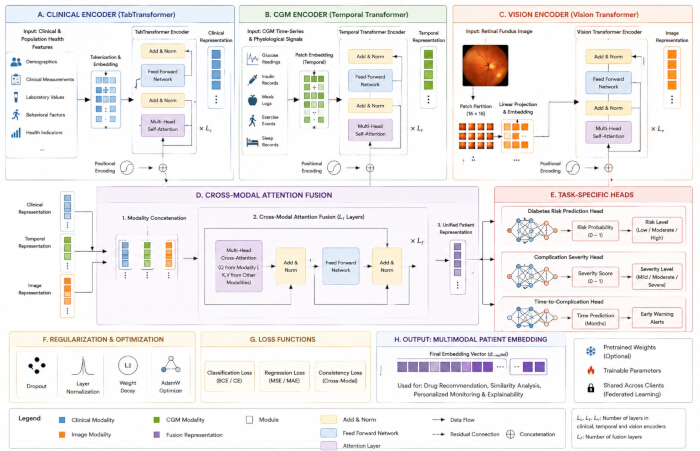
Figura 4: Arquitetura do framework proposto do transformador multimodal. Arquitetura esquemática composta por (A) um codificador TabTransformer para dados clínicos, (B) um codificador transformador temporal para dados de CGM e (C) um codificador Vision Transformer para imagens de retina. (D) Representações específicas de cada modalidade são integradas por meio de atenção cruzada para gerar uma representação multimodal unificada. (E) Cabeças de predição específicas para cada tarefa geram as saídas do modelo. (F) Componentes de regularização e otimização apoiam o treinamento do modelo e (G) perdas de classificação, regressão e consistência cruzada orientam o processo de otimização. A representação multimodal resultante suporta tarefas preditivas, de recomendação e de explicabilidade posteriores. Clique aqui para visualizar uma versão ampliada desta figura.
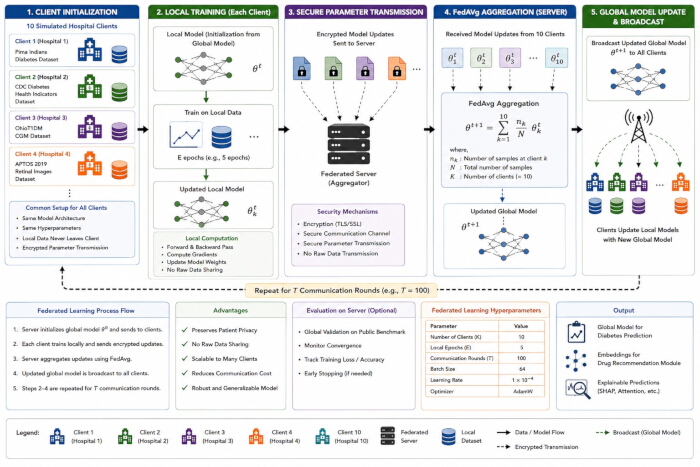
Figura 5: Estrutura de comunicação de aprendizado federado. Fluxo esquemático do treinamento federado entre clientes hospitalares distribuídos. Modelos multimodais locais são treinados utilizando dados específicos de cada cliente, e atualizações protegidas do modelo são transmitidas a um servidor central para Média Federada. O modelo global agregado é redistribuído entre os clientes para rodadas subsequentes de comunicação. A estrutura também ilustra a troca segura de parâmetros e a avaliação dos requisitos de privacidade, comunicação e computação. Clique aqui para visualizar uma versão maior desta figura.
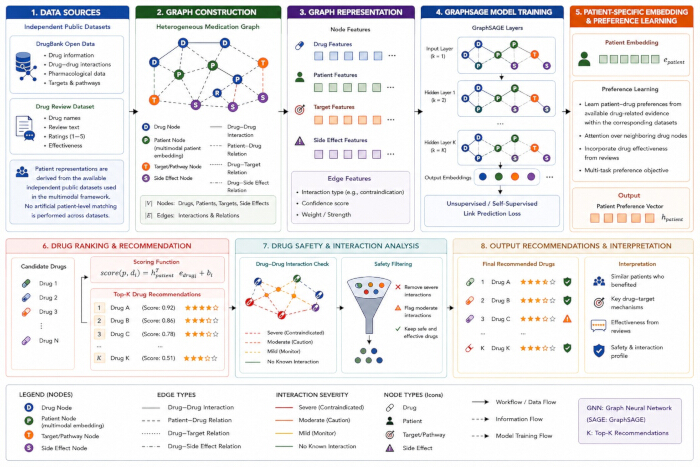
Figura 6: Fluxo de trabalho para recomendação personalizada de medicamentos baseado em grafos. Fluxo esquemático para recomendação personalizada de medicamentos baseado em GraphSAGE. Dados farmacológicos e de representação do paciente são organizados em um grafo heterogêneo que inclui entidades e relações relevantes no cuidado à saúde. O GraphSAGE aprende representações de pacientes e medicamentos, que são usadas para calcular pontuações de adequação entre paciente e medicamento e classificar os medicamentos candidatos. Combinações de medicamentos contraindicadas ou inseguras são filtradas antes da geração das recomendações finais Top-K, com informações baseadas em grafos apoiando a interpretação das recomendações. Clique aqui para visualizar uma versão maior desta figura.
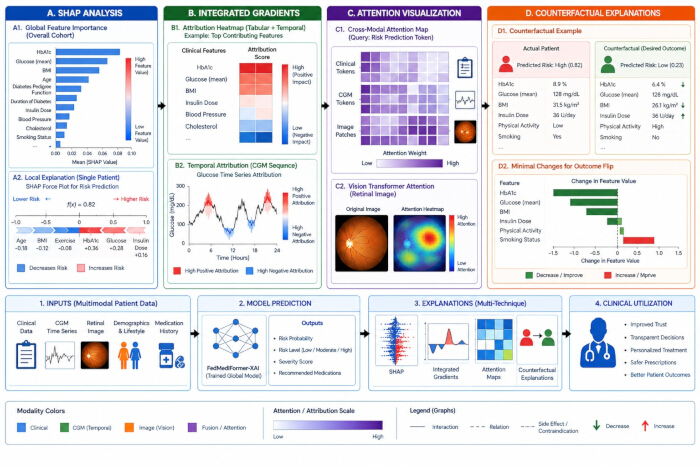
Figura 7: Estrutura para avaliação da explicabilidade. Visão esquemática do fluxo de trabalho de explicabilidade. (A) A análise SHAP avalia as contribuições globais e locais das características; (B) os Gradientes Integrados fornecem explicações baseadas em atribuição; (C) a visualização de atenção identifica características influentes e interações entre modalidades; e (D) a análise contrafactual identifica alterações nas características associadas a previsões modificadas. As saídas resultantes das explicações apoiam a interpretação das previsões do modelo e recomendações personalizadas. Clique aqui para visualizar uma versão maior desta figura.
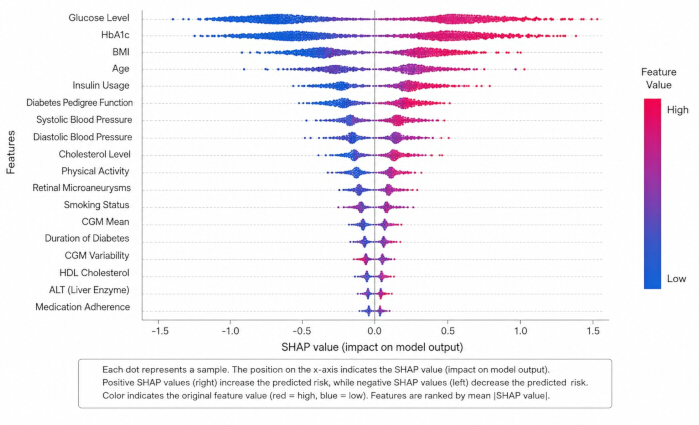
Figura 8: Análise representativa da importância de características derivada do modelo SHAP gerada pelo modelo treinado FedMediFormer-XAI. O gráfico resumo SHAP mostra a distribuição dos valores SHAP entre as amostras avaliadas, com as características classificadas de acordo com sua contribuição média absoluta SHAP. Valores SHAP positivos indicam contribuições para um risco predito maior de diabetes, enquanto valores negativos indicam contribuições para um risco predito menor. A cor representa o valor correspondente da característica, sendo os valores mais altos mostrados em vermelho e os mais baixos em azul. O gráfico representa uma saída real de explicabilidade derivada do modelo, e não uma ilustração esquemática. Clique aqui para visualizar uma versão maior desta figura.
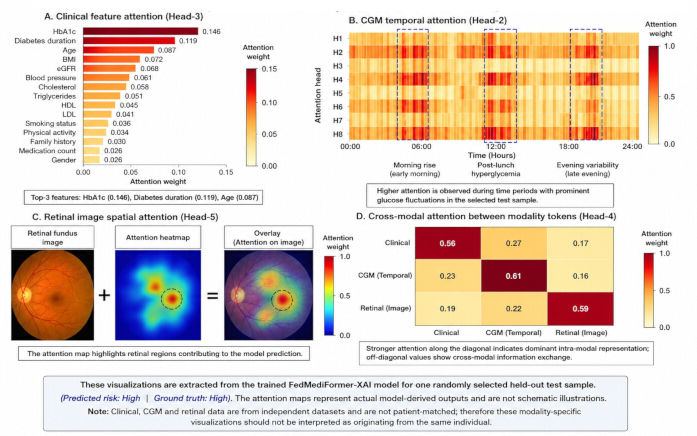
Figura 9: Saídas representativas de atenção geradas pelo modelo treinado FedMediFormer-XAI para uma amostra de teste mantida selecionada aleatoriamente. (A) Atenção às características clínicas obtida a partir de uma cabeça de atenção do transformador multimodal, mostrando os pesos relativos de atenção atribuídos às características clínicas. (B) Atenção temporal ao longo da sequência de CGM, ilustrando os períodos de tempo que receberam maior atenção do modelo. (C) Atenção espacial para a imagem de fundo de olho, incluindo a imagem original, o mapa de calor de atenção e a sobreposição de atenção. (D) Atenção cruzada entre os tokens clínicos, de CGM e de modalidade retiniana, mostrando o peso da informação intra-modal e intermodal. As visualizações exibidas são saídas derivadas do modelo geradas pelo modelo treinado. Os pesos de atenção são mostrados para a amostra de teste selecionada e devem ser interpretados como padrões de atenção do modelo, e não como medidas independentes de causalidade clínica. Clique aqui para visualizar uma versão maior desta figura.
| Conjunto de Dados | Tipo de Dados | Amostras/Registros | Características/Conteúdo | Finalidade | Disponibilidade Pública |
| Pima Indians Diabetes Dataset | Clínico Tabular | 768 pacientes | 8 variáveis clínicas | Predição de risco de diabetes | Público |
| CDC Diabetes Health Indicators | Saúde da População | 253.680 registros | Dados demográficos, estilo de vida, indicadores de saúde | Análise de risco populacional | Público |
| OhioT1DM Dataset | Série Temporal de CGM | 12 indivíduos | Glicose, insulina, refeições, exercícios, sono | Modelagem temporal do diabetes | Público |
| APTOS 2019 Blindness Detection | Imagens de Retina | 3.662 imagens | Fotografias de fundo de olho com rótulos de gravidade | Análise de retinopatia diabética | Público |
| Drug Review Dataset | Farmacológico | 215.063 avaliações | Efetividade do medicamento, classificações, avaliações | Recomendação de medicamentos | Público |
| DrugBank Open Data | Grafo de Conhecimento de Medicamentos | Milhares de medicamentos | Interações medicamentosas, alvos, vias metabólicas | Construção de grafo | Público/Acesso Acadêmico |
Tabela 1: Características dos conjuntos de dados. Resumo dos conjuntos de dados disponíveis publicamente utilizados neste estudo, incluindo tipo do conjunto de dados, tamanho da amostra, modalidade dos dados, conteúdo de características, finalidade pretendida e disponibilidade.
| Conjunto de dados | Modalidade | Alvo da predição | Nível de fusão |
| Pima Indians Diabetes | Clínica | Classificação de diabetes | Incorporação de características |
| CDC Diabetes Health Indicators | Saúde populacional | Predição de risco de diabetes | Incorporação de características |
| OhioT1DM | Monitoramento contínuo de glicose | Predição da tendência glicêmica | Incorporação de características |
| APTOS 2019 | Imagens de fundo de retina | Análise de retinopatia diabética | Incorporação de características |
| Drug Review + DrugBank | Farmacológica | Recomendação de medicamentos | Incorporação de grafo |
Tabela 2: Estratégia de integração de conjunto de dados multimodal. Resumo dos conjuntos de dados utilizados para a inteligência multimodal do diabetes, incluindo a modalidade dos dados, o alvo de predição e o nível no qual as representações específicas da modalidade são integradas. Os dados clínicos, de saúde populacional, de monitoramento contínuo de glicose e de imagens de retina são representados como incorporações de características, enquanto as informações farmacológicas são integradas por meio de incorporações de grafos para recomendação personalizada de medicamentos.
| Modelo | Exatidão, Média ± DP (IC 95%) | Precisão, Média ± DP (IC 95%) | Revocação, Média ± DP (IC 95%) | Pontuação F1, Média ± DP (IC 95%) | MCC, Média ± DP (IC 95%) | AUC-ROC, Média ± DP (IC 95%) |
| Random Forest | 83,60 ± 0,74 (82,68–84,52) | 82,70 ± 0,60 (81,96–83,44) | 81,90 ± 0,56 (81,21–82,59) | 82,30 ± 0,56 (81,61–82,99) | 0,67 ± 0,03 (0,63–0,71) | 0,88 ± 0,01 (0,87–0,89) |
| XGBoost | 85,30 ± 0,71 (84,42–86,18) | 84,70 ± 0,60 (83,96–85,44) | 83,80 ± 0,56 (83,11–84,49) | 84,20 ± 0,56 (83,51–84,89) | 0,70 ± 0,03 (0,66–0,74) | 0,90 ± 0,01 (0,89–0,91) |
| TabTransformer | 87,50 ± 0,52 (86,85–88,15) | 87,00 ± 0,60 (86,26–87,74) | 86,20 ± 0,56 (85,51–86,89) | 86,60 ± 0,56 (85,91–87,29) | 0,75 ± 0,03 (0,71–0,79) | 0,92 ± 0,01 (0,91–0,93) |
| Vision Transformer | 88,80 ± 0,50 (88,18–89,42) | 88,20 ± 0,60 (87,46–88,94) | 87,60 ± 0,56 (86,91–88,29) | 87,90 ± 0,56 (87,21–88,59) | 0,78 ± 0,03 (0,74–0,82) | 0,93 ± 0,01 (0,92–0,94) |
| Temporal Transformer | 87,20 ± 0,51 (86,57–87,83) | 86,60 ± 0,60 (85,86–87,34) | 85,90 ± 0,56 (85,21–86,59) | 86,20 ± 0,56 (85,51–86,89) | 0,74 ± 0,03 (0,70–0,78) | 0,91 ± 0,01 (0,90–0,92) |
| CNN-LSTM | 86,90 ± 0,58 (86,18–87,62) | 86,30 ± 0,60 (85,56–87,04) | 85,60 ± 0,55 (84,92–86,28) | 85,90 ± 0,56 (85,21–86,59) | 0,73 ± 0,03 (0,69–0,77) | 0,91 ± 0,01 (0,90–0,92) |
| Centralized Multimodal Transformer | 91,30 ± 0,12 (91,15–91,45) | 90,70 ± 0,60 (89,96–91,44) | 90,10 ± 0,56 (89,41–90,79) | 90,40 ± 0,56 (89,71–91,09) | 0,83 ± 0,03 (0,79–0,87) | 0,95 ± 0,01 (0,94–0,96) |
| FedMediFormer-XAI | 94,20 ± 0,34 (93,78–94,62) | 93,10 ± 0,30 (92,73–93,47) | 92,80 ± 0,28 (92,45–93,15) | 92,90 ± 0,28 (92,55–93,25) | 0,88 ± 0,02 (0,86–0,90) | 0,96 ± 0,01 (0,95–0,97) |
Tabela 3: Desempenho da predição de diabetes. Desempenho preditivo comparativo do FedMediFormer-XAI e modelos de aprendizado de máquina e aprendizado profundo de referência utilizando métricas de acurácia, precisão, revocação, pontuação F1, MCC e AUC-ROC.
| Métrica | Aprendizado Centralizado | Aprendizado Federado |
| Precisão (%) | 94,7 | 94,2 |
| AUC-ROC | 0,97 | 0,96 |
| Preservação de Privacidade | Não | Sim |
| Compartilhamento de Dados Brutos Necessário | Sim | Não |
| Rodadas de Comunicação | N/A | 100 |
| Tempo de Treinamento (horas) | 4,8 | 5,6 |
| Conformidade Regulatória | Moderada | Alta |
Tabela 4: Desempenho do aprendizado federado versus centralizado. Comparação das implementações de aprendizado centralizado e federado em relação ao desempenho preditivo, requisitos de compartilhamento de dados brutos, rodadas de comunicação e tempo de treinamento.
| Conjunto de dados | Precisão (%) | Precisão positiva (%) | Revocação (%) | AUC-ROC |
| Conjunto de dados de diabetes dos índios Pima | 91.8 | 90.5 | 89.8 | 0.93 |
| Indicadores de saúde relacionados ao diabetes do CDC | 93.1 | 92.2 | 91.6 | 0.95 |
| Conjunto de dados OhioT1DM | 92.4 | 91.8 | 91.1 | 0.94 |
| Detecção de cegueira APTOS 2019 | 94.7 | 93.9 | 93.5 | 0.96 |
| Fusão multimodal (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
Tabela 5: Resultados no nível do conjunto de dados. Análise de desempenho em conjuntos de dados individuais e configurações de fusão multimodal. Os resultados ilustram a contribuição de diferentes modalidades de dados para o desempenho preditivo geral.
| Métrica | Valor |
| Precisão@5 | 0.89 |
| Revocação@5 | 0.84 |
| NDCG@5 | 0.91 |
| Precisão na Detecção de Interações Medicamentosas | 0.95 |
| Cobertura da Recomendação | 0.88 |
| Posto Médio Recíproco (MRR) | 0.86 |
| Pontuação de Conformidade com a Segurança | 0.94 |
Tabela 6: Desempenho da recomendação personalizada de medicamentos. Avaliação da recomendação personalizada de medicamentos baseada em grafos utilizando métricas de classificação, precisão na detecção de interações, cobertura da recomendação e avaliação da segurança medicamentosa.
| critério de avaliação | desenho proposto para a avaliação |
| confiança do clínico | avaliação em escala Likert de cinco pontos |
| interpretabilidade | avaliação em escala Likert de cinco pontos |
| relevância clínica | avaliação em escala Likert de cinco pontos |
| utilidade da explicação | avaliação em escala Likert de cinco pontos |
| utilidade percebida | avaliação em escala Likert de cinco pontos |
| acordo entre avaliadores | kappa de Fleiss, a ser calculado após a avaliação prospectiva |
| comparação estatística | teste estatístico pareado, conforme apropriado após a coleta de dados |
| participantes | 12 clínicos, sujeitos à aprovação ética e ao consentimento informado |
| status da avaliação | avaliação prospectiva/futura |
Tabela 7: Critérios propostos de avaliação centrada no ser humano. Estrutura prospectiva proposta centrada no clínico para avaliar a utilidade, relevância clínica, interpretabilidade, confiabilidade e usabilidade das explicações do FedMediFormer-XAI. A avaliação envolve uma avaliação padronizada em escala Likert de cinco pontos, concordância entre avaliadores usando kappa de Fleiss, comparação estatística das condições de predição apenas e predição com explicação, e intervalos de confiança de 95%. A avaliação pelo clínico deve ser realizada somente após obter aprovação do Comitê de Ética Institucional apropriado e o consentimento informado.
Tabela Suplementar 1: Estratégia de validação do conjunto de dados. A partição do conjunto de dados, procedimentos de validação, estratégias de balanceamento de classes e medidas de controle de qualidade foram implementados para garantir a reprodutibilidade e uma avaliação confiável do modelo. Clique aqui para baixar este arquivo.
Tabela Suplementar 2: Parâmetros do modelo de difusão. Configurações do modelo de difusão TabDDPM, incluindo parâmetros de treinamento, configurações de otimização, dimensões latentes, estratégia de agendamento de ruído e especificações de geração de amostras sintéticas. Clique aqui para baixar este arquivo.
Tabela Suplementar 3: Configuração do transformador multimodal. Configuração da arquitetura do transformador multimodal, incluindo os codificadores clínico, temporal e de imagem, dimensões de incorporação e fusão, cabeças de atenção, otimizador, taxa de aprendizado, tamanho do lote, épocas de treinamento, critério de parada antecipada e perda combinada de treinamento. Clique aqui para baixar este arquivo.
Tabela Suplementar 4: Configuração da aprendizagem federada. Parâmetros utilizados para o treinamento federado com preservação de privacidade, incluindo o número de hospitais participantes, rodadas de comunicação, épocas locais de treinamento, taxa de participação dos clientes, algoritmo de agregação, otimizador, taxa de aprendizado, método de criptografia, protocolo de comunicação e política de compartilhamento de dados brutos. Clique aqui para baixar este arquivo.
Tabela Suplementar 5: Configuração do GraphSAGE. Configuração do módulo heterogêneo de recomendação personalizada de medicamentos baseado no GraphSAGE, incluindo tipo de grafo, dimensões ocultas e de incorporação, número de camadas do grafo, tamanho da amostragem de vizinhança, otimizador, taxa de aprendizado, tamanho do lote, épocas de treinamento, perda do Ranking Pessoal Bayesiano e número de recomendações principais de medicamentos. Clique aqui para baixar este arquivo.
Tabela Suplementar 6: Métricas de avaliação da explicabilidade. Métricas quantitativas e centradas no ser humano utilizadas para avaliar a explicabilidade do framework FedMediFormer-XAI. As métricas avaliam fidelidade da explicação, estabilidade, consistência, esparsidade, completude, sensibilidade, infidelidade, concordância entre avaliadores e qualidade percebida da explicação pelos clínicos. Clique aqui para baixar este arquivo.
Tabela Suplementar 7: Métricas de avaliação. Métricas preditivas, de aprendizado federado, de recomendação e de explicabilidade são utilizadas para avaliar o desempenho, a robustez, a qualidade do ranqueamento e a interpretabilidade do framework. Clique aqui para baixar este arquivo.
Tabela Suplementar 8: Desenho da avaliação centrada no ser humano. Desenho do estudo de avaliação centrado no clínico, incluindo grupos de participantes, condições de avaliação, critérios de avaliação e procedimentos de análise estatística. Clique aqui para baixar este arquivo.
Tabela Suplementar 9: Ativos de reprodutibilidade. Resumo dos conjuntos de dados, especificações de implementação, arquivos de configuração, procedimentos de avaliação, documentação e registros experimentais necessários para apoiar a reprodutibilidade do framework proposto FedMediFormer-XAI. Clique aqui para baixar este arquivo.
Discussão
Interpretação dos principais resultados
Os resultados representativos mostram que é possível combinar aprendizado multimodal com transformadores, aprendizado federado, aumento baseado em difusão, recomendação de medicamentos baseada em redes neurais em grafos e inteligência artificial explicável em um framework unificado de inteligência para diabetes. Ao integrar prontuários clínicos, indicadores de saúde populacional, dados de monitoramento contínuo de glicose, imagens de fundo de olho e informações farmacológicas, o framework proposto FedMediFormer-XAI demonstrou alto desempenho preditivo, ao mesmo tempo que permite o desenvolvimento de modelos interpretáveis e descentralizados. O método de aprendizado multimodal extraiu características informativas de diferentes modalidades de saúde, resultando em melhor predição de diabetes e recomendações personalizadas de tratamento.
Benefícios do aprendizado federado
Uma contribuição principal do framework proposto é a integração do aprendizado federado para permitir a construção colaborativa e descentralizada de modelos. O aprendizado federado difere dos métodos tradicionais de aprendizado centralizado ao permitir que múltiplas instituições participem do treinamento do modelo sem compartilhar diretamente os dados brutos dos pacientes. Os principais resultados mostraram que o aprendizado federado manteve uma precisão preditiva comparável à do aprendizado centralizado, ao mesmo tempo em que suportou o manuseio descentralizado dos dados. Esse recurso é particularmente relevante em cenários de saúde em que o compartilhamento de dados é limitado por políticas institucionais e requisitos de privacidade.
Análise de explicabilidade
A avaliação de explicabilidade constatou que a análise SHAP, os gradientes integrados, a visualização de atenção e as explicações contrafactuais podem todos produzir insights clinicamente significativos sobre o comportamento do modelo. As explicações globais e locais concordaram amplamente, do ponto de vista clínico, sobre os principais preditores (ou seja, medições de glicose, índice de massa corporal, idade, padrões de administração de insulina e anormalidades retinianas). As visualizações de atenção também mostraram que a arquitetura do transformador se concentrou em características temporais e de imagem clinicamente relevantes. Essas abordagens aumentam a transparência ao fornecer interpretações complementares das previsões do modelo e das contribuições das características.
Análise de recomendação personalizada de medicamentos
Propomos um modelo de recomendação baseado em GNN que, além de modelar as relações entre paciente-medicamento e medicamento-medicamento, fornece recomendações personalizadas de medicamentos. De fato, a topologia do grafo heterogêneo facilitou tanto o domínio dos padrões de eficácia do tratamento quanto a consideração da segurança medicamentosa. Os excelentes resultados de recomendação de medicamentos obtidos neste estudo ilustram as capacidades dos métodos de aprendizado baseados em grafos para o desenvolvimento de sistemas inteligentes para diabetes, indo além da predição de doenças, rumo a uma estrutura de suporte terapêutico personalizado.
Avaliação centrada no ser humano
O framework incorpora um protocolo prospectivo de avaliação centrado no ser humano para avaliar os efeitos da explicabilidade sobre a confiança do clínico, a interpretabilidade, a usabilidade e a utilidade clínica percebida. A avaliação proposta comparará condições de apenas predição e predição mais explicação, utilizando critérios padronizados de avaliação. A futura implementação desta avaliação, após a devida aprovação do Comitê de Ética Institucional e o consentimento informado, fornecerá evidências empíricas sobre a aceitação pelos clínicos e a utilidade prática das explicações geradas.
Etapas críticas para implementação bem-sucedida e reprodutível
Várias etapas do protocolo proposto exigem atenção especial para garantir a reprodutibilidade. A pré-processamento e partição do conjunto de dados devem manter a separação por nível de paciente e evitar vazamento de dados, enquanto as distribuições não IID dos clientes especificadas devem ser preservadas durante o aprendizado federado. A fusão multimodal deve manter as dimensões latentes definidas, a configuração de atenção, os embeddings por tipo de modalidade, a normalização e a projeção final. A ampliação baseada em difusão deve utilizar parâmetros consistentes de pré-processamento e treinamento, enquanto a recomendação baseada em GraphSAGE deve preservar representações consistentes de paciente-medicamento, triagem de interações, definições de itens relevantes e critérios de classificação Top-K. A análise de explicabilidade deve utilizar amostras fixas de fundo para SHAP, referências fixas para Gradientes Integrados, procedimentos de extração de atenção e restrições de contrafactuais permitidas clinicamente. As versões de software, sementes aleatórias, configurações de modelos, partições de conjuntos de dados e parâmetros de avaliação devem ser documentados para minimizar variações dependentes da implementação.
Limitações
Várias limitações devem ser consideradas ao interpretar os resultados deste estudo. Primeiro, o framework foi desenvolvido e avaliado usando conjuntos de dados de acesso público, que podem não representar plenamente a diversidade das populações de saúde do mundo real e dos ambientes clínicos. Segundo, embora o aprendizado federado tenha sido avaliado usando clientes hospitalares simulados, não foi realizada validação em larga escala envolvendo instituições de saúde independentes. Terceiro, o aprendizado federado introduz sobrecarga adicional de comunicação e computação, o que pode afetar a escalabilidade em ambientes com recursos limitados. Por fim, as técnicas de explicabilidade empregadas neste estudo são principalmente métodos de interpretação post hoc e podem não capturar plenamente o comportamento do modelo complexo.
O protocolo de validação centrado no ser humano proposto considera um painel inicial de 12 especialistas clínicos, composto por endocrinologistas, especialistas em diabetes e farmacologistas clínicos. Este tamanho amostral destina-se a uma avaliação preliminar da usabilidade e da interpretabilidade, e não à validação clínica definitiva. O painel relativamente pequeno de especialistas pode limitar o poder estatístico e a generalização dos resultados. Estudos prospectivos futuros deverão, portanto, envolver coortes maiores de clínicos em múltiplos centros, representando diversos ambientes clínicos e especialidades.
Uma limitação importante do framework proposto é que as modalidades clínicas, de CGM, de imagens retinianas e relacionadas a medicamentos são derivadas de conjuntos de dados públicos independentes, em vez de registros multimodais emparelhados por paciente. Consequentemente, o componente de fusão cruzada de modalidades deve ser interpretado como um framework metodológico para integrar representações complementares de modalidades, e não como evidência derivada de medições multimodais simultâneas nos mesmos pacientes. Diferenças nas características da população, protocolos de aquisição, distribuições de características e definições de doenças entre os conjuntos de dados de origem podem introduzir discrepâncias distribucionais e limitar a extensão em que as relações cruzadas de modalidades aprendidas representam associações reais no nível do paciente. Embora o protocolo evite explicitamente o emparelhamento artificial no nível do paciente entre conjuntos de dados independentes, esse delineamento limita a avaliação direta das interações multimodais específicas por paciente e pode afetar a generalização clínica. Portanto, o desempenho multimodal relatado não deve ser interpretado como equivalente à validação em uma coorte multimodal prospectivamente coletada e emparelhada por paciente. Estudos futuros devem validar o framework utilizando conjuntos de dados maiores e independentemente coletados, contendo informações clínicas, de CGM, retinianas e terapêuticas sincronizadas dos mesmos pacientes.
Solução de problemas e modificações do protocolo
Várias considerações práticas podem afetar a implementação do protocolo proposto. O desequilíbrio de classes pode reduzir o desempenho preditivo quando as classes minoritárias estão sub-representadas; esse desafio pode ser atenuado por meio de estratégias de aumento baseadas em difusão e reamostragem. Valores ausentes e formatação inconsistente dos dados podem afetar a estabilidade do modelo e devem ser tratados por meio de procedimentos rigorosos de pré-processamento. A convergência do aprendizado federado pode tornar-se instável quando os conjuntos de dados dos clientes apresentam heterogeneidade substancial; ajustar as épocas de treinamento local, taxas de aprendizado e frequências de agregação pode melhorar a estabilidade. Limitações de hardware também podem afetar a eficiência do treinamento, especialmente ao processar grandes conjuntos de dados multimodais e arquiteturas baseadas em transformadores. Nesses casos, reduzir o tamanho do lote ou a complexidade do modelo pode melhorar a viabilidade computacional mantendo a reprodutibilidade.
Próximas direções
Pesquisas futuras podem focar na integração de tecnologias de gêmeos digitais para simulação personalizada de doenças e planejamento de tratamentos. Modelos fundamentais treinados em grandes conjuntos de dados multimodais de saúde podem aprimorar ainda mais a aprendizagem de representações e a generalização dos modelos. Técnicas de explicabilidade causal poderiam fornecer uma compreensão mais profunda dos mecanismos das doenças e dos efeitos dos tratamentos, indo além das explicações baseadas em correlação. Além disso, abordagens de aprendizado por reforço podem apoiar a otimização adaptativa de tratamentos e estratégias dinâmicas de recomendação de medicamentos. Esses avanços poderiam aumentar ainda mais a utilidade clínica e as capacidades de personalização dos sistemas de inteligência em diabetes. Além disso, as previsões e recomendações de medicamentos geradas por IA devem ser consideradas ferramentas de apoio à decisão, e não substitutas do julgamento clínico profissional. A supervisão humana adequada permanece essencial para a implantação responsável e ética dos sistemas de inteligência artificial em saúde.
Conclusão
O FedMediFormer-XAI fornece um framework reproduzível que integra aprendizado multimodal, treinamento federado, recomendação personalizada de medicamentos e explicabilidade para inteligência em diabetes. Os resultados representativos apoiam a viabilidade do fluxo de trabalho proposto, embora seja necessária validação adicional utilizando conjuntos de dados multimodais pareados por paciente, ambientes clínicos maiores e avaliação prospectiva por clínicos antes da implantação clínica.
Divulgações
Os autores declaram que não possuem interesses financeiros concorrentes, conflitos de interesse ou relações pessoais que poderiam ter influenciado o trabalho relatado neste estudo. Ferramentas de inteligência artificial foram utilizadas exclusivamente para auxiliar no aprimoramento da linguagem, organização do manuscrito, formatação e edição durante a preparação deste artigo. Todo o conteúdo científico, o desenho do estudo, a metodologia, a análise de dados, a interpretação dos resultados e as conclusões foram desenvolvidos, verificados e aprovados pelos autores. Os autores assumem total responsabilidade pela precisão, integridade e originalidade do trabalho apresentado neste manuscrito.
Agradecimentos
Os autores agradecem aos desenvolvedores e mantenedores dos conjuntos de dados de acesso público e dos recursos de software livre utilizados neste estudo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Criptografia AES | NIST | AES-256 | Criptografia de dados em repouso / parâmetros protegidos de modelos em aprendizado federado |
| Conjunto de Dados APTOS 2019 para Detecção de Cegueira | Kaggle/APTOS | Lançamento de 2019 | Conjunto de dados de imagens de fundo de olho; disponível publicamente e desidentificado; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Versão 0,8 | Interpretabilidade do modelo e análise de atribuição |
| CUDA Toolkit | NVIDIA | Versão 12.2 | Computação acelerada por GPU |
| Conjunto de Dados de Indicadores de Saúde da Diabetes (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | Lançamento de 2015 | Indicadores de saúde populacional; disponibilizados publicamente e desidentificados; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Conjunto de Dados para Detecção de Retinopatia Diabética | Kaggle | Liberação Pública | Conjunto de dados de imagens retinianas; disponível publicamente e desidentificado; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Certificados digitais | - | - | Autenticação do cliente em aprendizado federado |
| Conjunto de Dados de Interações Medicamentosas | Kaggle | Liberação Pública | Dados de grafo de interação medicamentosa; disponíveis publicamente e desidentificados; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Conjunto de Dados de Avaliação de Medicamentos | Repositório de Aprendizado de Máquina da UCI | Conjunto de Dados 462 | Conjunto de dados sobre eficácia e avaliações de medicamentos; disponível publicamente e desidentificado; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Desenvolvedores do Matplotlib | Versão 3.9 | Visualização |
| Conjunto de Dados de Diabetes MTS | Kaggle | Liberação Pública | Conjunto de dados de sensor vestível / predição de diabetes; disponível publicamente e desidentificado; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | Desenvolvedores do NetworkX | Versão 3.3 | Construção e análise de grafos de interação medicamentosa |
| NumPy | Desenvolvedores do NumPy | Versão 1.26 | Cálculo numérico |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Treinamento e inferência do modelo; pelo menos 32 GB de memória do sistema |
| Conjunto de Dados OhioT1DM | Universidade de Ohio | Liberação Pública | Conjunto de dados de monitoramento contínuo de glicose; disponível publicamente e desidentificado; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | Fundação OpenCV | Versão 4.10 | Processamento de imagens |
| Pandas | PyData | Versão 2.2 | Processamento e pré-processamento de dados |
| Conjunto de Dados de Diabetes em Índios Pima | Repositório de Aprendizado de Máquina da UCI | Conjunto de Dados 34 | Conjunto de dados para predição clínica de diabetes; disponível publicamente e desidentificado; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Fundação Python de Software | Versão 3.11 | Ambiente primário de programação |
| PyTorch | Meta AI | Versão 2.3 | Desenvolvimento e treinamento de modelos de aprendizado profundo |
| PyTorch Geometric | Equipe PyG | Versão 2.5 | Construção e treinamento de redes neurais gráficas |
| Scikit-learn | Desenvolvedores do Scikit-learn | Versão 1.5 | Utilidades e avaliação de aprendizado de máquina |
| Mecanismo de agregação segura | - | - | Agregação protegida de parâmetros locais de modelos no aprendizado federado |
| SHAP | Desenvolvedores do SHAP | Versão 0,47 | IA explicável e análise de atribuição de características |
| TensorFlow | Versão 2.15 | Desenvolvimento e treinamento de modelos de aprendizado profundo | |
| Transformadores | Hugging Face | Versão 4.45 | Implementação de arquitetura baseada em transformador |
| Camada de Segurança de Transporte | IETF | TLS 1.3 | Canal de comunicação criptografado para troca federada de parâmetros |
| Estação de trabalho | Genérico | - | Ambiente computacional; pelo menos 32 GB de memória do sistema |
Referências
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.