Este estudo integra um experimento com cenários e eletroencefalogramas para examinar como o enquadramento dos papéis de especialista e companheiro está associado à confiança em diferentes contextos de tarefas médicas.
Artigo de método
Enquadramento de Papel e Confiança em IA Médica: Evidências de um Experimento de Cenário e EEG
Neste artigo
Resumo
Resumo
A inteligência artificial médica online evoluiu de ferramentas analíticas de back-end para interfaces de serviço voltadas ao paciente, tornando a confiança calibrada um problema crescente de design e governança. Com base na teoria da congruência de papéis, este estudo examinou como o enquadramento do papel de especialista e de companheiro está associado à confiança em diferentes contextos de tarefas médicas. O Estudo 1 utilizou um experimento cenario baseado em um delineamento 2 (papel: especialista versus companheiro) × 2 (tarefa: consulta de doença versus consulta de saúde) (N = 300). O enquadramento como especialista aumentou a percepção de profissionalismo, enquanto o enquadramento como companheiro aumentou a presença social; ambas as percepções estiveram independentemente associadas à confiança geral quando inseridas simultaneamente. A associação indireta por meio do profissionalismo foi condicionada pelo contexto da tarefa, mas uma comparação direta por bootstrap não indicou diferença entre os dois índices de mediação moderada quanto à confiança geral. Os diagnósticos de mensuração indicaram sobreposição substancial entre o profissionalismo percebido e a confiança cognitiva, bem como entre a presença social e a confiança afetiva, exigindo interpretação cautelosa. O Estudo 2 comparou declarações com enquadramento de especialista e de companheiro utilizando EEG em 39 observações pareadas. O enquadramento como especialista foi acompanhado por maior ERS de onda theta frontal-midial e por um ΔPLV theta FCz-F6 menos negativo após correção da linha de base, enquanto o comportamento em nível de condição não mostrou diferença confiável na taxa de confiança, tempo de resposta ou taxa de respostas ausentes. Esses achados de EEG são correlatos exploratórios em nível de processo, e não uma validação neural do modelo indireto condicional. De modo geral, os indicadores de papel parecem moldar avaliações não exclusivas orientadas à competência e orientadas ao relacionamento. O design de papéis deve apoiar uma dependência calibrada por meio de limites de capacidade, comunicação de incerteza, alertas baseados em risco e escalonamento adequado, em vez de simplesmente maximizar a confiança.
Introdução
A IA médica agora abrange aplicações back-end, como reconhecimento de imagens, análise de patologia e descoberta de fármacos, além de interfaces de serviço voltadas ao paciente. Análises do setor projetam crescimento contínuo do mercado de IA em saúde até 20331. Modelos de linguagem grandes permitem que sistemas de IA médica respondam perguntas de saúde, interpretem resultados de exames, resumam informações e forneçam recomendações em linguagem natural2. Essa mudança altera a relação do usuário com a tecnologia. Uma ferramenta analítica back-end é avaliada por clínicos e organizações, enquanto uma interface voltada ao paciente precisa comunicar seu papel, evidências, incertezas e limites aos usuários. A IA médica pode se apresentar como uma assistente diagnóstica, uma interface de médico da família ou uma companheira de gestão da saúde, e cada uma dessas formas pode influenciar a forma como os usuários entendem a identidade do serviço do sistema. À medida que esses sistemas participam cada vez mais de consultas sobre doenças e da gestão diária da saúde, a confiança torna-se algo mais do que uma atitude em relação à tecnologia. Ela afeta se os usuários divulgam informações, consideram as recomendações críveis, interagem com o sistema e agem com base em orientações de saúde. Portanto, a confiança é uma preocupação central no design e na governança de plataformas digitais de saúde.
A capacidade técnica isolada não determina se os usuários consideram a IA médica como crível e aceitável. Revisões sobre agentes conversacionais em saúde mostram que a implementação depende da qualidade da interação, relevância clínica, transparência e condições de implantação3. Trabalhos recentes sobre evidências críveis para IA médica argumentam igualmente que o desempenho do modelo é insuficiente a menos que as alegações sejam apoiadas por evidências adequadas ao uso pretendido4. A transparência é essencial porque os pacientes precisam ser capazes de identificar os limites de capacidade, a incerteza e a base de uma recomendação, em vez de inferir confiabilidade apenas pela fluência da linguagem5. A pesquisa em sistemas de informação também aborda a adoção de diagnósticos assistidos por IA como um problema de configuração de confiança, no qual interpretabilidade, proteção da privacidade e indicadores da interface moldam conjuntamente a aceitação6. Essas considerações são importantes para interfaces baseadas em modelos de linguagem. A fluência pode tornar uma resposta fácil de entender, mas ainda assim deixar em aberto se o sistema possui conhecimento clínico, se sua recomendação se aplica às circunstâncias do usuário e quando é necessário encaminhar para um clínico qualificado. A questão relevante não é apenas se a IA médica pode produzir uma resposta, mas se os usuários conseguem avaliá-la com um nível apropriado de confiança.
A confiança em IA médica é sensível ao contexto da tarefa. Pesquisas sobre resistência à IA médica mostram que os usuários podem rejeitar recomendações algorítmicas em decisões de alto risco porque acreditam que um algoritmo não consegue levar em conta sua singularidade7. A resistência não é universal. A pesquisa sobre apreciação de algoritmos indica que as pessoas podem preferir o julgamento algorítmico quando as tarefas são objetivas e as regras são mais claras8. Em consultas médicas online, a personalização e o cuidado nas orientações geradas por IA afetam a confiança e a adoção9. Pesquisas de escolha discreta que comparam consultas convencionais, digitais e baseadas em IA também constatam que as preferências e expectativas de confiança variam entre os formatos10. O trabalho conjunto entre humanos e IA também pode reduzir a resistência por meio da transferência de confiança da expertise humana para uma configuração de serviço apoiada por IA11. Assim, a confiança em IA médica se desenvolve por meio da interação entre risco percebido, exigências da tarefa, estilo de comunicação e avaliação do sistema. A consulta sobre doenças torna evidentes a incerteza, a perda possível, as consequências diagnósticas e os custos de erros. A consulta em saúde, por outro lado, trata mais frequentemente de dieta, exercícios, sono, adesão e manejo preventivo, contextos nos quais a interação contínua e a acessibilidade relacional podem ter maior peso. Um mesmo indicador de interface pode, portanto, ser interpretado de forma diferente quando um usuário busca ajuda para uma possível doença em vez de para o manejo de longo prazo da saúde.
A molduração do papel é um recurso de interface por meio do qual essas expectativas podem ser comunicadas. A IA médica pode ser apresentada como uma especialista que enfatiza autoridade profissional, raciocínio estruturado, limites clínicos e evidências de capacidade, ou como uma companheira que enfatiza empatia, tranquilidade, apoio social e continuidade. Essa distinção está relacionada à competência e à simpatia, as duas dimensões da percepção social, mas não se trata simplesmente de escolher entre um sistema competente e um sistema afetuoso12. O estilo de comunicação e a molduração da agência influenciam as avaliações de agentes conversacionais13. Em aplicações médicas móveis, pistas sociais e preocupações com privacidade afetam conjuntamente a confiança e a intenção comportamental14. Indícios antropomórficos em agentes conversacionais de saúde podem aumentar a presença social, a confiança e a aceitação, embora também possam criar expectativas que excedem as capacidades do sistema15. Pesquisas sobre equipes humano-IA mostram ainda que simpatia e competência predizem diferentes formas de receptividade16. Em tarefas de alto risco, a confiança depende da adequação entre o papel da equipe, o contexto da tarefa e a violação de desempenho17. A consistência entre o papel social de um chatbot e seu desempenho também afeta a construção e a recuperação da confiança18. Assim, as pistas de especialista e de companheira tornam salientes diferentes padrões avaliativos, em vez de meramente alterar o tom da conversa.
Duas lacunas permanecem. Primeiro, a pesquisa ainda não explicou como a relevância de sinais orientados para competência e relacionamento muda conforme as demandas da tarefa médica. Revisões sobre a confiança humana em IA enfatizam a dependência do contexto, mas não esclarecem como os sinais de especialista e de companheiro atuam nas consultas de doença e de saúde19. Segundo, os estudos sobre confiança em IA médica baseiam-se em autorrelatos, fornecendo evidências limitadas sobre o processamento associado à avaliação orientada por papéis. Privacidade, transparência, responsabilidade e viés também restringem a interpretação dos sinais de papel na interface20,21. Para abordar essas lacunas, este estudo baseia-se na teoria da congruência de papéis, que explica a avaliação pela alinhamento entre sinais de papel e demandas salientes no contexto22. O Estudo 1 utiliza um experimento aleatorizado com cenários 2 (papel: especialista versus companheiro) × 2 (tarefa: consulta de doença versus consulta de saúde) (N = 300) para examinar o enquadramento de papéis, o contexto da tarefa e associações indiretas paralelas por meio da percepção de profissionalismo e presença social. O Estudo 2 utiliza um experimento eletroencefalográfico (EEG) separado, com medidas repetidas (N = 39), para comparar a atividade na banda teta em resposta a afirmações enunciadas sob enquadramentos de especialista e de companheiro. O Estudo 1 avalia associações comportamentais e moderação contextual; o Estudo 2 fornece uma comparação exploratória em nível de processamento, e não uma validação neural do modelo indireto condicional.
Referencial teórico e desenvolvimento da hipótese
Enquadramento de papéis na IA médica
A inteligência artificial (IA) médica atua em contextos de alto risco envolvendo probabilidade de doenças, recomendações de tratamento, responsabilidade legal e limites éticos23. Assim, a definição do papel é relevante porque a linguagem apresentada ao usuário pode tornar mais ou menos evidentes os limites de capacidade, base de evidências e responsabilidade. A pesquisa sobre transparência também enfatiza que os sistemas de IA médica devem comunicar claramente os limites de suas capacidades e suas bases de evidência5. Respostas no estilo especialista transmitem competência por meio de terminologia formal, raciocínio estruturado, declarações de limites e recomendações de ação, enquanto respostas no estilo companheiro transmitem apoio relacional por meio de empatia, tranquilização e linguagem colaborativa. Essas pistas não são meramente decorativas: elas moldam os critérios que os usuários aplicam ao avaliar um sistema24,25. O antropomorfismo pode provocar respostas sociais, mas também pode gerar expectativas irreais e tornar nebulosos os limites de responsabilidade26,27. Pesquisas sobre equipes humano-IA e chatbots indicam ainda que calor humano, competência, adequação do papel ao contexto e consistência entre o papel social e o desempenho influenciam a aceitação e a confiança16,17,18. Neste estudo, congruência de papel refere-se à alinhamento entre as pistas transmitidas por uma resposta de IA e as exigências avaliativas evidentes na tarefa de consulta22.
Confiança de duplo caminho: Profissionalismo percebido e presença social
A congruência de papéis é inferida a partir da interação observada entre papel e tarefa, em vez de ser medida como um constructo subjetivo separado. A interpretação está, portanto, vinculada à interação experimental e não implica que os participantes tenham relatado conscientemente uma sensação de adequação ao papel. A confiança envolve julgamentos cognitivos sobre competência e confiabilidade, bem como julgamentos afetivos sobre segurança relacional e conforto28,29,30. No uso de IA médica, os usuários avaliam tanto se o sistema pode apoiar uma decisão em saúde quanto se a interação com ele parece suficientemente segura e acessível. A apresentação como especialista deve tornar mais evidente a avaliação orientada à competência. Evidências provenientes de pesquisas sobre sistemas de apoio à decisão clínica indicam que explicações e informações sobre o raciocínio do sistema afetam a confiança e a dependência31. Em consultas médicas online, personalização e cuidado também estão associadas à confiança e à aceitação9. A profissionalismo percebido capta uma avaliação orientada à competência, relevante para a confiança25. Pesquisas sobre consultas médicas online identificam igualmente a credibilidade da fonte como relevante para a aceitação de sugestões de saúde pelos usuários32. O presente estudo, portanto, testa se a apresentação como especialista está associada a um maior profissionalismo percebido.
H1: Os papéis de companhia geram menor profissionalismo percebido em comparação com IAs médicas no estilo de especialista.
A moldura comparativa deve tornar a avaliação relacional mais evidente. Presença social refere-se à qualidade interpessoal percebida na interação mediada, e não à crença de que o sistema é humano33. Está associada à qualidade da interação, confiança e aceitação em serviços online e agentes conversacionais de saúde15,34.
A presença social pode reduzir o custo psicológico da autorrevelação e apoiar a troca de informações durante consultas on-line32. O presente estudo, portanto, testa se o enquadramento de companhia está associado a uma maior presença social.
H2: Os papéis especialistas geram menor presença social em comparação com as IAs médicas de estilo companheiro.
A profissionalismo percebido e a presença social são tratados como associações paralelas e não exclusivas com a confiança. A dependência adequada em automação de alto risco depende das capacidades do sistema, de seus limites e dos requisitos da tarefa, e não apenas da maximização da confiança35.
H3: A percepção de profissionalismo e de presença social prediz positivamente a confiança quando modeladas simultaneamente.
Efeito moderador do contexto da tarefa
Os mesmos indicadores de papel podem ter pesos psicológicos diferentes em diversas tarefas médicas. A adequação entre tarefa e tecnologia fornece uma justificativa contextual para examinar se os indicadores de papel estão alinhados com os requisitos da tarefa36. A consulta sobre doenças envolve maior incerteza, risco de perda e custos decorrentes de erros, tornando especialmente relevantes o profissionalismo, a precisão e limites claros7,37. Assim, os indicadores de especialista devem estar mais estreitamente alinhados com essas exigências do que os indicadores de companheiro. A consulta sobre saúde centra-se no manejo prolongado da saúde, na persistência comportamental e na continuidade da interação. Revisões sobre sistemas de apoio à decisão clínica baseados em IA e agentes conversacionais em saúde enfatizam a importância de informações contextuais, capacidade de ação, interação e condições de implementação3,38,39.
Este estudo prevê que a diferença entre especialista e companheiro na profissionalismo percebido será maior na consulta de doença do que na consulta de saúde. Não considera uma interação não significativa na presença social como evidência de invariância. A hipótese é proposta da seguinte forma:
H4: O contexto da tarefa modera significativamente o impacto dos papéis de especialista na profissionalismo percebido. O impacto é mais acentuado na consulta de doença do que na consulta de saúde.
Protocolo
Visão geral da pesquisa
O estudo foi conduzido de acordo com a Declaração de Helsinque e foi aprovado pelo Comitê de Ética da Universidade Huaqiao (M2025021), que abrangeu tanto o experimento em cenário online quanto o experimento de EEG. Todos os participantes forneceram consentimento informado e receberam compensação após a conclusão.
Este artigo contém dois estudos complementares (veja Figura 1). O Estudo 1 é um experimento aleatorizado com delineamento 2 × 2 que estima os efeitos do enquadramento de papéis e do contexto da tarefa, avalia a estrutura de mensuração e testa associações indiretas condicionais paralelas por meio da percepção de profissionalismo e presença social. O Estudo 2 é um experimento com eletroencefalografia (EEG) do tipo intra-sujeitos que compara a atividade na banda teta sob afirmações enquadradas como de especialista e de companheiro, sendo interpretado como uma comparação exploratória em nível de processo. Os estudos fornecem evidências comportamentais e neurais em diferentes níveis; eles não são tratados como um único mecanismo progressivo.
Estudo 1: Experimento de cenário
Participantes e desenho
O Estudo 1 utilizou um delineamento balanceado 2 × 2 entre sujeitos com enquadramento de papel (especialista versus companheiro) e contexto da tarefa (consulta de doença versus consulta de saúde). O cálculo inicial realizado no G*Power assumiu um efeito médio para ANOVA omnibus (f = 0,25), α = 0,05 e poder = 0,80, indicando um mínimo de 128 participantes40. Como esse cálculo não foi ajustado para efeitos indiretos condicionais, ele é relatado como base original de recrutamento, e não como evidência de poder para mediação moderada. Com N = 300 e quatro células balanceadas, uma análise de sensibilidade indicou poder de 80% para detectar uma interação de f = 0,162 (η2 parcial = 0,026) em α = 0,05.
Além disso, realizamos uma análise de poder baseada em simulação post hoc para os índices de mediação moderada utilizando o conjunto de dados do questionário SPSS com 300 casos. A simulação gerou 1.000 amostras balanceadas 2 × 2 a partir do modelo com mediadores paralelos ajustado, reamostrando os resíduos empíricos; cada conjunto de dados simulado utilizou 500 intervalos de confiança bootstrap percentil baseados em reamostragem de casos. As probabilidades estimadas de que o intervalo de confiança excluísse o zero foram de 0,698 para o índice de profissionalismo, 0,157 para o índice de presença social e 0,279 para a diferença direta entre os dois índices. Essa análise está condicionada aos coeficientes observados, às distribuições dos resíduos e à especificação do modelo, e não constitui uma justificativa a priori do tamanho da amostra. A análise completa de poder baseada em simulação post hoc é apresentada na Tabela Suplementar S1.
Trezentos participantes foram recrutados por meio do Credamo e alocados aleatoriamente em quatro condições (n = 75 por célula). A amostra incluiu 109 homens (36,3%) e 191 mulheres (63,7%); 43,7% tinham entre 21 e 30 anos, 41,3% tinham entre 31 e 40 anos, e 69,7% possuíam diploma de graduação. Todos os itens obrigatórios do questionário foram preenchidos. Não foi utilizado nenhum item específico de verificação de atenção nem exclusão pré-registrada com base no tempo de conclusão, e nenhum participante foi excluído. O tempo mediano de conclusão foi de 268 s (intervalo = 67-1.894 s). Uma análise post hoc de robustez excluindo respostas abaixo do quinto percentil do tempo de conclusão (<125 s; n mantido = 285) foi realizada para avaliar a sensibilidade a respostas incomumente rápidas. As estatísticas detalhadas dos testes de verificação da manipulação e as análises de sensibilidade ao tempo de conclusão são apresentadas na Tabela Suplementar S2.
Estímulos experimentais e procedimento
Os materiais estímulos consistiram em uma introdução ao cenário da tarefa e uma resposta em formato de diálogo com um médico-IA, formando quatro conjuntos experimentais completos. O cenário de consulta médica solicitava que os participantes imaginassem episódios recorrentes de aperto no peito e palpitações noturnas, e a preocupação sobre a necessidade de atendimento hospitalar imediato. O cenário de consulta de saúde solicitava que os participantes imaginassem estar em boa saúde geral e procurassem um plano personalizado de dieta e exercícios. Cada categoria de tarefa foi representada por um cenário; portanto, as conclusões estão limitadas a esses dois cenários, em vez de serem generalizadas para todas as consultas médicas e de saúde.
As quatro imagens das telas do questionário utilizaram o mesmo ícone e exibiram o nome do sistema, Medical AI (DiagnosPro), mantendo assim a identidade exibida constante entre as condições. As respostas com enquadramento de especialista utilizaram análise estruturada, afirmações sobre risco ou evidências, linguagem direta e recomendações explícitas de ação. As respostas com enquadramento de companheiro utilizaram empatia, tranquilização, linguagem colaborativa e sugestões flexíveis. A manipulação, portanto, representou um conjunto de sinais comunicacionais e informativos congruentes com o papel; ela não isolou o enquadramento do papel da especificidade, da capacidade de ação, da certeza, dos detalhes médicos ou do apoio emocional. O nome compartilhado DiagnosPro também pode ter transmitido um sinal de especialista em todas as condições. O conjunto completo de estímulos está disponível no Arquivo Suplementar 1.
Os participantes leram primeiro o termo de consentimento informado e, em seguida, foram aleatoriamente designados a uma de quatro condições experimentais. Após a leitura do cenário e do estímulo de diálogo, eles preencheram o questionário com base em suas respostas. O questionário iniciou-se com verificações de manipulação, seguidas por medidas de profissionalismo percebido, presença social, confiança e dados demográficos. O procedimento levou aproximadamente 15 min.
Todas as escalas utilizaram pontuação Likert de 7 pontos, sendo 1 que representa discordo totalmente e 7 que representa concordo totalmente. A profissionalismo percebido foi medida com três itens: 'Esta IA médica é capaz de fornecer orientação médica', 'Esta IA médica parece muito profissional' e 'Esta IA médica é uma especialista na área médica' (α = .883)41. A presença social foi medida com três itens: 'Na interação com esta IA médica, senti um toque humano', 'A interação com esta IA médica me fez sentir proximidade' e 'Esta IA médica pareceu sociável durante a interação' (α = .932)42. A confiança cognitiva compreendeu três itens: 'Posso confiar nesta IA médica porque ela possui as habilidades necessárias para fornecer orientações', 'Tenho confiança na precisão das orientações fornecidas por esta IA médica' e 'Esta IA médica possui capacidade suficiente para lidar com meu problema de saúde' (α = .837). A confiança afetiva compreendeu três itens: 'Esta IA médica me transmite calor e cuidado', 'Confiar nesta IA médica me faz sentir seguro porque parece se importar com minha saúde' e 'Acredito que esta IA médica não faria intencionalmente nada que me prejudicasse' (α = .700). A confiança geral foi a média de todos os seis itens de confiança (α = .784). Essas medidas foram analisadas como resultados orientados à competência, interpessoais, de confiança cognitiva, de confiança afetiva e de confiança geral, e não como construtos mutuamente exclusivos.
A análise prosseguiu em quatro etapas. Primeiro, a análise fatorial confirmatória comparou o modelo proposto de quatro fatores com alternativas de dois e um fator; foram examinadas a confiabilidade composta, a variância média extraída, as correlações latentes e as razões heterotrait-monotrait. Segundo, modelos fatoriais completos 2 x 2 estimaram os efeitos principais e de interação para profissionalismo percebido, presença social, confiança cognitiva, confiança afetiva e confiança geral, com médias das células, intervalos de confiança e η2 parcial. As médias marginais estimadas e os intervalos de confiança de 95% são apresentados na Figura 2. Terceiro, o Modelo 7 do PROCESS 4.2 beta incluiu simultaneamente o profissionalismo percebido e a presença social como mediadores paralelos, com 5.000 amostras bootstrap percentil43. A enquadramento de papel foi codificado como 1 = especialista e 2 = companheiro, e o contexto da tarefa foi codificado como 1 = consulta de doença e 2 = consulta de saúde. Um bootstrap com reamostragem comum contrastou diretamente os dois índices de mediação moderada. Quarto, a confiança cognitiva e a confiança afetiva foram analisadas separadamente como resultados exploratórios. Como os mediadores e os resultados foram medidos simultaneamente, as estimativas são interpretadas como associações indiretas compatíveis com mediação, e não como mecanismos psicológicos causais.
Estudo 2: Experimento de EEG
Participantes
O Estudo 2 recrutou 40 participantes. Um participante foi excluído porque os ensaios contaminados por artefatos excederam 30% em pelo menos uma condição experimental, restando 39 participantes nas análises finais de EEG. Esse critério garantiu que cada participante incluído contribuísse com pelo menos 70% dos ensaios em cada condição. Todos os participantes forneceram consentimento informado por escrito e receberam compensação após o experimento. As informações demográficas não puderam ser vinculadas a todos os registros de EEG mantidos e, portanto, não são resumidas para a amostra final de EEG.
Estímulos e procedimento experimentais
O experimento foi conduzido em um laboratório padrão de EEG utilizando um delineamento intra-sujeitos, com estímulos apresentados no E-Prime 2.1. Os participantes foram instruídos a imaginar que interagiam com um sistema de IA médica e a avaliar sua confiança no sistema para cada cenário de consulta médica. O experimento manipulou o papel percebido do sistema de IA médica, incluindo variantes do tipo especialista e do tipo companheiro.
Um total de 40 estímulos com frases em chinês foi elaborado. A condição do tipo especialista continha 20 estímulos iniciados com "especialista em IA médica", enquanto a condição do tipo companheiro continha 20 estímulos paralelos iniciados com "companheiro de IA médica". Os cenários médicos abrangiam tanto funções profissionais de diagnóstico, como perguntar sobre histórico médico, analisar laudos de exames, avaliar dados de frequência cardíaca, interpretar testes genéticos, julgar risco de doenças e recomendar planos de tratamento, quanto funções de apoio à gestão da saúde, como demonstrar preocupação com a condição física, perguntar sobre qualidade do sono, aliviar a ansiedade, registrar dados de saúde, incentivar a adesão ao tratamento e fornecer dicas diárias de saúde. As condições, portanto, também diferiam em conteúdo semântico e complexidade; não havia correspondência independente de estímulos nem pré-teste disponível.
Antes do experimento formal, os participantes realizaram um breve bloco de prática. Cada tentativa iniciava com uma cruz de fixação de 500 ms, seguida por um intervalo em branco com duração variável de 300–500 ms e uma declaração de IA médica apresentada por 1.600 ms. Em seguida, os participantes emitiam um julgamento binário de confiança em seu próprio ritmo, pressionando a tecla F para indicar confiança ou a tecla J para indicar desconfiança (veja Figura 3). As declarações com enquadramento de especialista e de companheiro foram apresentadas em ordem aleatória. Os registros da tarefa E-Prime indicaram 80 tentativas formais por registro de tarefa: 40 tentativas com especialista e 40 com companheiro, sendo que cada uma das 20 declarações únicas por papel foi apresentada duas vezes.
Dados da tarefa comportamental
Os dados das tarefas comportamentais foram utilizáveis para 38 dos 39 participantes na amostra final de EEG; o registro da tarefa E-Prime de um participante foi inviável. Assim, as análises comportamentais utilizaram N = 38. Os resultados comportamentais detalhados e o controle da amostra são fornecidos na Tabela Suplementar S3. A confiança foi codificada como resposta da tecla F; respostas da tecla J indicaram desconfiança. Respostas em branco ou um tempo de resposta registrado de 0 ms foram codificados como ausentes. A taxa de confiança foi calculada entre os ensaios respondidos, e o tempo de resposta foi resumido ao longo dos ensaios respondidos. Os dados neurais disponíveis para análise continham medidas agregadas por condição, mas nenhum índice de EEG em nível de ensaio ou identificador verificado que vinculasse cada registro comportamental ao seu registro de EEG; portanto, não foi estimado nenhum modelo misto em nível de ensaio de EEG e julgamentos de confiança.
Gravação e análise de EEG
Utilizou-se o gel eletrolítico condutivo Quik-Gel para manter a impedância entre o eletrodo e a pele abaixo de 5 kOhm. O FCz foi a referência padrão online do dispositivo, e a taxa de amostragem foi de 1.000 Hz. A re-referência offline em relação à média das mastoides bilaterais foi realizada com a função integrada de re-referência do CURRY; o FCz foi mantido e automaticamente reconstruído em relação à nova referência, e nenhum comando ou script personalizado de reconstrução foi utilizado. O processamento offline subsequente foi realizado no MATLAB R2020b com o EEGLAB44 e o ICLabel45. Os dados foram subamostrados para 500 Hz e filtrados em banda passante de 0,1 a 40 Hz. Canais ruins e segmentos de dados gravemente contaminados foram identificados e removidos por inspeção visual; não foi aplicada interpolação automatizada nem limiar automatizado de rejeição de segmentos. Em seguida, utilizou-se a implementação padrão do runica do EEGLAB (ICA Infomax), e os componentes foram removidos quando o ICLabel atribuiu uma probabilidade de pelo menos 0,70 a uma classe de artefato (por exemplo, atividade ocular, muscular, cardíaca, de ruído da linha ou de ruído do canal). Participantes com mais de 30% de ensaios contaminados por artefatos em qualquer condição foram excluídos, garantindo retenção de pelo menos 70% dos ensaios em cada condição. Os épocas abrangeram de −1.000 a 1.996 ms. Para a análise de conectividade funcional, os dados pré-processados foram subamostrados novamente para 250 Hz, e os eletrodos periféricos, incluindo P7, P8, F7 e F8, foram excluídos antes da estimativa de sincronia de fase.
A atividade theta registrada em locais frontais-medianos do couro cabeludo tem sido associada a cálculos realizados por demandas de controle cognitivo46. A sincronização de fase na faixa theta entre eletrodos frontais mediais e laterais também tem sido associada à coordenação durante o processamento relacionado ao controle47. Em particular, observou-se um aumento da sincronização de fase na faixa theta entre locais como FCz e F6 após a detecção de conflito ou erro48. Como essas medidas do couro cabeludo não são exclusivamente específicas ao controle cognitivo, são tratadas aqui como indicadores convergentes de processo, e não como leituras diretas de um único mecanismo cognitivo.
Primeiro, a sincronização relativa ao evento na faixa frontomediana de teta (ERS) foi quantificada na banda de 4–8 Hz dentro da janela pós-estímulo de 800–1.000 ms. O ERS foi calculado utilizando análise no domínio tempo-frequência, com a variação relativa da potência computada em relação à linha de base pré-estímulo de −500 a −200 ms. Valores positivos indicam aumento da potência (sincronização), enquanto valores negativos indicam supressão da potência (dessincronização). Em segundo lugar, a conectividade funcional foi estimada após nova redução da frequência de amostragem dos dados pré-processados para 250 Hz e exclusão dos eletrodos periféricos, incluindo P7, P8, F7 e F8. Uma transformada de Fourier de curta duração (STFT) foi aplicada antes do cálculo do valor de travamento de fase na banda teta entre FCz e F6. A variação do PLV corrigida pela linha de base (ΔPLV) foi calculada em relação à linha de base pré-estímulo de −600 a −200 ms. O valor bruto de PLV varia entre 0 e 1; portanto, valores negativos de ΔPLV indicam uma diminuição em relação à linha de base, e não um travamento de fase negativo. Essas medidas no couro cabeludo são interpretadas como padrões exploratórios associados ao processamento relacionado ao controle e à coordenação pré-frontal; elas não identificam diretamente um processo cognitivo específico nem uma fonte neural específica.
Resultados
Estudo 1: Resultados do cenário-experimento
Modelo de mensuração. O modelo de quatro fatores apresentou melhor ajuste do que as alternativas de dois e um fator, mas o ajuste absoluto foi moderado: χ2(48) = 223,93, p < ,001; CFI = ,935; TLI = ,911; RMSEA = ,111; SRMR = ,140. As cargas padronizadas variaram de ,382 a ,937. A confiabilidade composta foi ,886 para profissionalismo percebido, ,932 para presença social, ,840 para confiança cognitiva e ,709 para confiança afetiva; os valores correspondentes de AVE foram ,722, ,821, ,636 e ,474. A validade discriminante foi limitada: os valores de HTMT foram ,935 entre profissionalismo percebido e confiança cognitiva, e ,926 entre presença social e confiança afetiva. Os resultados do processo condicional devem, portanto, ser interpretados com cautela, e as análises de confiança específicas por dimensão são exploratórias (Tabela 1).
Verificações de manipulação. Os participantes do grupo com enquadramento de especialista (n = 150, M = 5,57, DP = 1,18) avaliaram a IA médica como mais semelhante a um especialista do que os participantes do grupo com enquadramento de companheiro (n = 150, M = 3,21, DP = 1,76). Como as variâncias diferiram, F = 47,42, p < ,001, utilizou-se o teste de Welch, t(259,90) = 13,63, p < ,001, diferença média = 2,36, IC 95% [2,02, 2,70]. Os participantes no estado de doença (n = 150, M = 2,51, DP = 1,53) atribuíram pontuações mais baixas de orientação para a saúde preventiva do que os participantes no estado de saúde (n = 150, M = 5,98, DP = 1,22), F = 10,96, p = ,001; t de Welch (284,11) = −21,70, p < ,001, diferença média = −3,47, IC 95% [−3,79, −3,16]. Os graus de liberdade de Welch não são iguais a N − 2 quando as variâncias são desiguais; todas as análises utilizaram N = 300.
Estatísticas descritivas por condição experimental. Para o enquadramento de especialista, doença e consulta de saúde produziram médias de profissionalismo percebido de 5,69 (DP = 0,83) e 5,85 (DP = 0,63), médias de presença social de 4,28 (DP = 1,54) e 4,25 (DP = 1,64) e médias de confiança geral de 5,45 (DP = 0,86) e 5,28 (DP = 0,87), respectivamente. Para o enquadramento de companheiro, as médias correspondentes para doença e saúde foram 4,52 (DP = 1,47) e 5,25 (DP = 0,94) para profissionalismo percebido, 5,68 (DP = 1,07) e 5,93 (DP = 0,74) para presença social e 5,30 (DP = 1,02) e 5,61 (DP = 0,64) para confiança geral. Table 2 apresenta todos os intervalos de confiança específicos por condição e os testes fatoriais completos.
Resultados fatoriais completos. A profissionalismo percebido apresentou um efeito principal de enquadramento de papel, F(1, 296) = 56,92, p < ,001, η2 parcial = ,161, um efeito principal de contexto da tarefa, F(1, 296) = 14,37, p < ,001, η2 parcial = ,046, e uma interação papel × tarefa, F(1, 296) = 5,89, p = ,016, η2 parcial = ,020. A presença social mostrou um efeito principal de enquadramento de papel, F(1, 296) = 105,57, p < ,001, η2 parcial = ,263, mas nem o efeito principal da tarefa, F(1, 296) = 0,59, p = ,442, nem a interação, F(1, 296) = 0,84, p = ,359, foram significativos. Esse último resultado indica que não foi detectada moderação; ele não estabelece equivalência entre as tarefas. Para a confiança cognitiva, a interação papel × tarefa foi significativa, F(1, 296) = 5,60, p = ,019, η2 parcial = ,019; a interação correspondente não foi significativa para a confiança afetiva, F(1, 296) = 3,48, p = ,063, η2 parcial = ,012. A confiança geral não apresentou efeito principal de enquadramento de papel, F(1, 296) = 0,81, p = ,369, nem efeito principal de tarefa, F(1, 296) = 0,55, p = ,459, mas a interação papel × tarefa foi significativa, F(1, 296) = 5,78, p = ,017, η2 parcial = ,019. Na consulta sobre doença, a confiança geral não diferiu entre o enquadramento de companheiro e o de especialista, diferença média = −0,15, EP = 0,14, t(296) = −1,06, p = ,288, IC 95% [−0,42, 0,13]. Na consulta sobre saúde, a confiança geral foi maior com o enquadramento de companheiro, diferença média = 0,33, EP = 0,14, t(296) = 2,34, p = ,020, IC 95% [0,05, 0,60].
Associações indiretas condicionais paralelas. Quando a profissionalismo percebido e a presença social foram inseridos simultaneamente, ambos apresentaram associação positiva com a confiança geral: b = 0,4872, SE = 0,0258, p < ,001, IC 95% [0,4294, 0,5460] e b = 0,3293, SE = 0,0208, p < ,001, IC 95% [0,2762, 0,3829], respectivamente. A associação direta com o enquadramento de papel não foi significativa, b = 0,0119, SE = 0,0680, p = ,861, IC 95% [−0,1071, 0,1361]. As associações indiretas do profissionalismo foram −0,5695 na consulta de doença, IC bootstrap 95% [−0,7687, −0,3851], e −0,2923 na consulta de saúde, IC bootstrap 95% [−0,4288, −0,1634]. As associações indiretas da presença social foram 0,4625 na consulta de doença, IC bootstrap 95% [0,3165, 0,6091], e 0,5532 na consulta de saúde, IC bootstrap 95% [0,3855, 0,7383] (Tabela 3). O índice de mediação moderada por meio do profissionalismo percebido foi 0,2772, IC bootstrap 95% [0,0594, 0,5035], enquanto o índice por meio da presença social foi 0,0907, IC bootstrap 95% [−0,0984, 0,3008]. O contraste direto bootstrap entre os índices não foi significativo, diferença = 0,1864, IC bootstrap 95% [−0,0856, 0,4447]. Os resultados, portanto, apoiam a moderação contextual da associação indireta com o profissionalismo, mas não estabelecem moderação contextual estatisticamente distinta entre as duas associações.
Análises exploratórias das dimensões de confiança. Para a confiança cognitiva, o contraste entre os índices de mediação moderada da profissionalismo e da presença social foi positivo, diferença = 0,3707, IC bootstrap 95% [0,0493, 0,6996]. Para a confiança afetiva, o contraste correspondente não foi comprovado, diferença = 0,0022, IC bootstrap 95% [−0,3421, 0,3127]. Ambos os mediadores mantiveram associações positivas com as duas dimensões de confiança, indicando efeitos cruzados em vez de efeitos exclusivos. Dados os altos valores de HTMT, esses resultados não devem ser interpretados como uma separação definitiva dos mecanismos cognitivo e afetivo.
Poder pós-hoc de mediação moderada. Sob o modelo ajustado e as suposições de reamostragem dos resíduos, a probabilidade estimada de que o intervalo de confiança percentil-bootstrap excluísse zero foi de 0,698 para o índice de profissionalismo, 0,157 para o índice de presença social e 0,279 para a diferença direta entre eles (1.000 simulações; 500 reamostragens bootstrap por simulação). Essas estimativas baseadas no delineamento observado explicam por que o índice de profissionalismo apoiado e o contraste direto não significativo não devem ser interpretados como evidência conclusiva de moderação contextual diferente.
Robustez do tempo de conclusão. Excluindo as 15 respostas abaixo de 125 s, restaram 285 casos. A interação confiança geral manteve-se significativa, p = .029; o índice de profissionalismo continuou apoiado, IC bootstrap de 95% [0,0242, 0,4827]; e o contraste entre os índices de mediação moderada manteve-se não significativo, IC bootstrap de 95% [−0,1027, 0,4506]. As conclusões principais não dependeram dos 5% mais rápidos de respostas.
Estudo 2: Resultados de EEG
ERS teta medial-frontal. Na amostra analítica final (N = 39), a ERS teta na janela de 4–8 Hz, 800–1.000 ms foi maior sob enquadramento de especialista (M = 0,2948, DP = 0,8218) do que sob enquadramento de companheiro (M = −0,0422, DP = 1,2155), diferença média = 0,3369, IC 95% [0,0125, 0,6614], t(38) = 2,10, p = ,042, dz de Cohen = 0,337, η2 parcial = ,104. O valor-p ajustado por Holm para os dois resultados pareados de EEG relatados foi ,042. Essa diferença indica processamento diferencial na banda teta nesta janela da tarefa; a ERS teta isoladamente não identifica um processo psicológico específico.
Mudança na PLV de teta corrigida para a linha de base em FCz-F6 (ΔPLV). Na amostra analítica final (N = 39), o ΔPLV de teta foi menos negativo sob enquadramento de especialista (M = −0,0111, DP = 0,0546) do que sob enquadramento de companheiro (M = −0,0350, DP = 0,0473), diferença média = 0,0239, IC 95% [0,0058, 0,0420], t(38) = 2,68, p = ,011, dz de Cohen = 0,429, η2 parcial = ,159. O valor p ajustado por Holm entre os dois resultados pareados de EEG relatados foi ,022. Esse padrão representa uma diminuição menor na consistência de fase de teta em relação à linha de base sob enquadramento de especialista; isso por si só não estabelece um controle pré-frontal mais forte ou um mecanismo cognitivo específico (ver Figura 4 e Tabela 4).
Resultados da tarefa comportamental. Nos 38 registros de tarefa analisados, a taxa de resposta de confiança foi de 83,1% (DP = 15,8%) sob enquadramento de especialista e 82,4% (DP = 17,5%) sob enquadramento de companheiro, diferença média = 0,7 pontos percentuais, IC 95% [−0,9, 2,4], t(37) = 0,91, p = ,371, dz = 0,147. Os tempos médios de resposta foram 828,7 ms (DP = 204,6) e 826,1 ms (DP = 208,9), respectivamente, diferença média = 2,5 ms, IC 95% [−14,0, 19,1], t(37) = 0,31, p = ,758, dz = 0,050. As taxas de respostas ausentes foram 6,3% (DP = 7,4%) e 5,2% (DP = 6,3%), respectivamente, diferença média = 1,1 ponto percentual, IC 95% [−1,0, 3,1], t(37) = 1,05, p = ,302, dz = 0,170.
Declaração de disponibilidade de dados:
Os dados do questionário do Estudo 1 desidentificados, arquivos de EEG pré-processados e arquivos agregados de saída de EEG que apoiam o Estudo 2 estão publicamente disponíveis no Open Science Framework (OSF) em https://doi.org/10.17605/OSF.IO/JKSP7. Os materiais suplementares incluem os estímulos experimentais completos (Arquivo Suplementar 1), verificações de manipulação, análises comportamentais adicionais, análises pós-hoc de poder estatístico e informações metodológicas complementares.
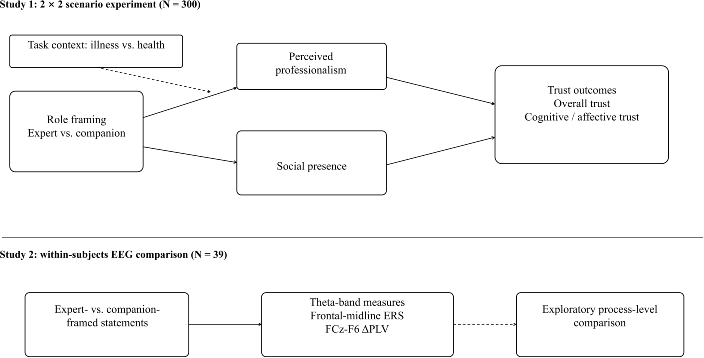
Figura 1. Estrutura da pesquisa. O Estudo 1 é um experimento cenario 2 × 2 (N = 300) que examina o enquadramento de papéis, o contexto da tarefa e associações indiretas paralelas por meio do profissionalismo percebido e da presença social. O Estudo 2 fornece uma comparação exploratória de eletroencefalograma entre declarações com enquadramento de especialista e de companheiro (N = 39); ele não testa diretamente o modelo indireto condicional. Clique aqui para visualizar uma versão maior desta figura.
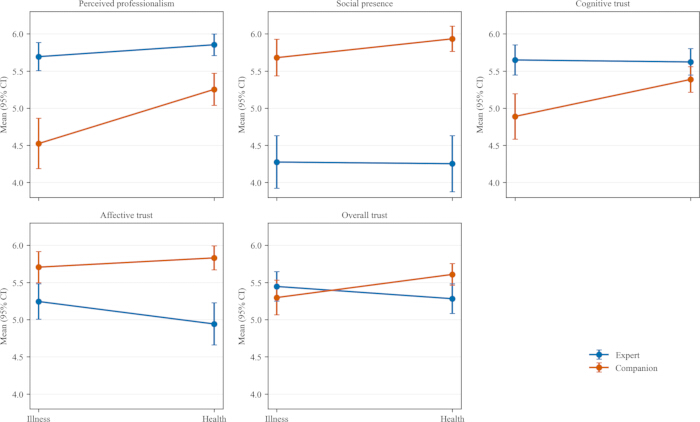
Figura 2. Gráficos de enquadramento de função × contexto de tarefa para profissionalismo percebido, presença social, confiança cognitiva, confiança afetiva e confiança geral. Os pontos indicam as médias das células e as barras de erro indicam os intervalos de confiança de 95% (n = 75 por célula). Clique aqui para visualizar uma versão maior desta figura.
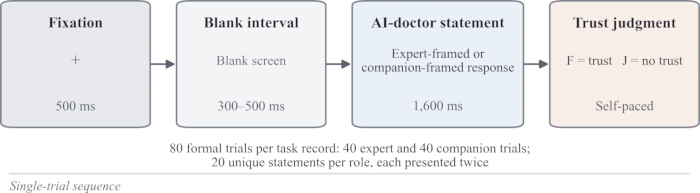
Figura 3. Sequência por tentativa no Estudo 2. Cada tentativa compreendia uma fixação de 500 ms, um intervalo em branco com duração variável entre 300 e 500 ms, uma declaração do médico-IA com enquadramento de especialista ou companheiro por 1.600 ms e um julgamento binário de confiança autocontrolado. Os registros da tarefa E-Prime indicaram 80 tentativas formais por registro de tarefa, com 40 tentativas por condição de enquadramento de papel e duas apresentações de cada uma das 20 declarações únicas por condição. Clique aqui para visualizar uma versão maior desta figura.
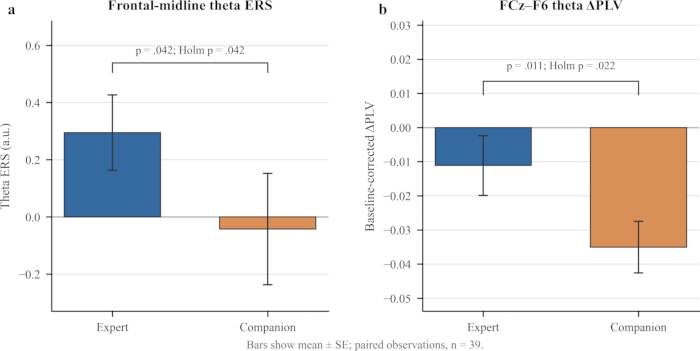
Figura 4. Efeitos do enquadramento do papel da IA médica na sincronização relacionada a eventos de teta frontal-medianal e no valor de bloqueio de fase de teta FCz-F6. (A) Sincronização relacionada a eventos na faixa de teta frontal-medianal. (B) Alteração no valor de bloqueio de fase de teta FCz-F6 corrigida para a linha de base (ΔPLV); valores negativos indicam uma diminuição em relação à linha de base pré-estímulo. As barras mostram a média ± EP para n = 39. Testes t pareados resultaram em p = .042 para a ERS de teta e p = .011 para o ΔPLV; os valores de p ajustados por Holm para esses dois resultados relatados foram .042 e .022, respectivamente. Abreviações: Clique aqui para visualizar uma versão maior desta figura.
Tabela 1: Diagnósticos do modelo de medição para o Estudo 1. A tabela apresenta cargas padronizadas, alfa de Cronbach, confiabilidade composta, variância média extraída, correlações latentes e valores HTMT para profissionalismo percebido, presença social, confiança cognitiva e confiança afetiva. N = 300. O modelo de quatro fatores apresentou melhor ajuste do que as alternativas, mas RMSEA e SRMR indicaram ajuste absoluto fraco e dois valores HTMT excederam 0,90. Abreviações: CR = confiabilidade composta; AVE = variância média extraída; HTMT = razão heterotrait-monotrait. Clique aqui para baixar esta tabela.
Tabela 2: Estatísticas descritivas de quatro condições e testes fatoriais completos 2 × 2 para o Estudo 1. As células apresentam n, média, desvio padrão e intervalo de confiança de 95%; os testes fatoriais apresentam F, p e η2 parcial. N = 300; n = 75 por célula. A representação do papel foi codificada como 1 = especialista e 2 = companheiro; o contexto da tarefa foi codificado como 1 = doença e 2 = consulta de saúde. Os coeficientes e os intervalos de confiança são não padronizados. Clique aqui para baixar esta tabela.
Tabela 3: Associações indiretas condicionais paralelas no Estudo 1. N = 300. A representação do papel foi codificada como 1 = especialista e 2 = companheiro; o contexto da tarefa foi codificado como 1 = consulta sobre doença e 2 = consulta sobre saúde. A profissionalismo percebido e a presença social foram inseridos simultaneamente. As estimativas são não padronizadas, e os intervalos de confiança percentil-bootstrap utilizaram 5.000 reamostragens. A tabela inclui associações indiretas condicionais, ambos os índices de mediação moderada e seu contraste direto por bootstrap. O contraste direto entre os dois índices de mediação moderada para a confiança geral foi 0,1864, IC 95% [-0,0856, 0,4447]. Clique aqui para baixar esta tabela.
Tabela 4: Resultados de EEG pareados no Estudo 2. N = 39 observações pareadas na amostra analítica final. A tabela apresenta as médias das condições, as diferenças médias pareadas, os intervalos de confiança de 95% e os testes pareados t testes, Cohen’s dz, η parcial2e valores de p ajustados por Holm para a ERS de teta frontal-mediana e para o ΔPLV de teta FCz-F6 corrigido em relação à linha de base. A correção de Holm abrange apenas os dois resultados pareados de EEG relatados e não reconstrói qualquer busca mais ampla não documentada sobre eletrodos, bandas ou janelas de tempo. Clique aqui para baixar esta Tabela.
Arquivo Suplementar 1: Estímulos experimentais utilizados no Estudo 1. O arquivo contém o texto completo das respostas de IA médica estruturadas por especialistas e por acompanhantes, usadas nos cenários de consulta de doença e consulta de saúde. São fornecidos tanto o texto original em chinês quanto a tradução para o inglês.Clique aqui para baixar este arquivo.
Tabela Suplementar S1. Análise de poder baseada em simulação post hoc para o modelo de mediação moderada. Clique aqui para baixar este arquivo.
Tabela Suplementar S2. Estatísticas da verificação de manipulação e análises de sensibilidade do tempo de conclusão para o Estudo 1. Clique aqui para baixar este arquivo.
Tabela Suplementar S3. Resultados da tarefa comportamental, contabilização da amostra e estatísticas descritivas para o Estudo 2. Clique aqui para baixar este arquivo.
Discussão
Implicações teóricas
Os dois estudos fornecem evidências em diferentes níveis. O Estudo 1 identifica associações entre função e tarefa, bem como associações indiretas paralelas, em um experimento com cenário randomizado, enquanto o Estudo 2 oferece uma comparação exploratória em nível de processo por meio de EEG. Assim, os estudos apoiam uma explicação limitada da avaliação estruturada por funções, em vez de um único mecanismo progressivo. Os resultados ampliam a teoria da congruência de função ao contexto da IA médica, tratando a congruência como o alinhamento entre pistas de função e demandas avaliativas salientes para a tarefa22. Essa interpretação difere do conteúdo competência-benevolência e do ajuste tarefa-tecnologia. Descobertas sobre aversão a algoritmos e apreciação de algoritmos podem ser compreendidas como avaliações sensíveis ao contexto sobre se as pistas de função e capacidade se adequam à tarefa49,50.
Os resultados também apoiam associações paralelas e não exclusivas entre enquadramento de papel, profissionalismo percebido, presença social e confiança. Como o profissionalismo se sobrepõe à confiança cognitiva e a presença social se sobrepõe à confiança afetiva, as evidências apoiam um conteúdo avaliativo diferenciado, mas não dois mecanismos claramente separados. A interação papel-por-tarefa no profissionalismo percebido é consistente com a explicação proposta de congruência de papel. As evidências apoiam a moderação contextual da associação com o profissionalismo, mas não estabelecem mecanismos contextuais estatisticamente assimétricos nem invariância no caminho da presença social.
Os achados de EEG fornecem uma perspectiva exploratória em nível de processo. Declarações estruturadas por especialistas foram acompanhadas por padrões distintos na banda teta, mas as condições também diferiam em conteúdo semântico e complexidade, e o comportamento em nível de condição não mostrou diferença confiável na confiança. As medidas de EEG, portanto, não estabelecem um mecanismo distinto de controle cognitivo ou de confiança. Os achados neurais devem ser tratados como geradores de hipóteses. O Estudo 2 não manipulou o contexto da tarefa, nem mensurou a profissionalismo percebido ou presença social, nem vinculou índices de EEG em nível de tentativa a julgamentos de confiança; os resultados de EEG, portanto, complementam em vez de validar o modelo indireto condicional.
Os resultados são compatíveis com uma dependência adequada, e não máxima. A dependência do sistema automatizado deve ser calibrada de acordo com as capacidades, limites e requisitos da tarefa35. Trabalhos relacionados descrevem mecanismos cognitivos adaptativos que podem apoiar a confiança e a dependência calibradas51. A perspectiva NeuroIS apoia o uso de medidas neurais como complemento às evidências comportamentais ao examinar processos com resolução temporal52. Estudos prévios de fMRI também mostram que a atividade neural durante julgamentos de confiança em tempo real varia conforme os alvos e contextos53.
Implicações gerenciais
Para plataformas médicas online, a implicação prática é uma dependência calibrada, e não uma simples maximização da confiança. As pistas de papel desempenhado devem ser combinadas com as exigências da tarefa e associadas à comunicação de incerteza, limites explícitos de capacidade, alertas baseados em riscos e encaminhamento para clínicos qualificados.
Em módulos de alto risco envolvendo diagnóstico, interpretação de resultados anormais, orientação médica ou triagem, sinais orientados para competência podem ajudar os usuários a reconhecer os limites das evidências e das ações, sem conferir autoridade indevida. Em módulos de menor urgência, como dieta, exercícios, sono, adesão ao tratamento e apoio emocional, sinais orientados para o relacionamento podem favorecer o engajamento, sem criar falsa tranquilidade ou antropomorfismo inadequado.
O design de papéis deve ser modular e baseado em cenários, em vez de uma configuração fixa de personalidade. A configuração de papéis deve ser integrada com explicações, avisos de privacidade, rótulos de risco e mecanismos de escalonamento. A pesquisa em governança enfatiza que transparência, responsabilidade, gestão de vieses e privacidade devem ser projetadas em conjunto, para que indicadores de papel críveis na interface não ocultem riscos no sistema interno6,20,21.
Limitações da pesquisa e direções futuras
O Estudo 1 é um experimento com cenário, e não uma consulta real. As condições não foram pré-testadas independentemente quanto à extensão, frequência de palavras, legibilidade, precisão, capacidade de ação, valência emocional, excitação, risco, familiaridade ou complexidade. Estudos futuros devem utilizar múltiplos cenários, nomes neutros para os sistemas, estímulos com conteúdo pareado, manipulação independente ou medição temporalmente separada e efeitos aleatórios ao nível dos participantes e dos estímulos.
O Estudo 2 forneceu evidências eletroencefalográficas em nível de processo, mas a ligação demográfica final com 39 pessoas foi incompleta, as frases para o EEG não foram comparadas independentemente nem pré-testadas quanto ao comprimento da sentença, frequência de palavras, legibilidade, valência emocional, excitação, risco percebido, familiaridade e complexidade, e rótulos explícitos de papéis podem ter criado características de demanda. O presente estudo utilizou o valor de travamento de fase corrigido pela linha de base (ΔPLV) como medida pré-definida de conectividade funcional. Embora o índice ponderado de atraso de fase (wPLI) seja menos sensível à condução volumétrica, ele não foi incluído no pipeline original de análise. Estudos futuros devem examinar se as descobertas atuais são replicadas utilizando wPLI ou outras medidas complementares de conectividade. As saídas neurais disponíveis são agregadas por condição e não podem ser vinculadas a julgamentos de confiança em nível de tentativa; um modelo misto EEG-comportamento em nível de tentativa, portanto, não foi estimado. O PLV no couro cabeludo também é sensível a efeitos de referência comum e condução volumétrica. Essas limitações indicam que os achados neurais devem permanecer exploratórios e não devem ser interpretados como evidência de um mecanismo único de controle cognitivo ou de confiança.
Divulgações
Os autores não têm conflitos de interesse a declarar.
Durante a preparação deste trabalho, os autores utilizaram o ChatGPT para aprimorar a linguagem. Após utilizar essa ferramenta/serviço, os autores revisaram e editaram o conteúdo conforme necessário e assumem total responsabilidade pelo conteúdo da publicação.
Agradecimentos
Este projeto de pesquisa foi apoiado pelos Projetos Gerais de Financiamento das Ciências Sociais Nacionais, RPC (número do convênio: 22BGL006).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Plataforma online de pesquisa Credamo | Credamo (Jianshu), China | Não aplicável | Plataforma online para questionário, atribuição aleatória e recrutamento de participantes utilizada no Estudo 1. |
| Função de rereferenciamento CURRY | Compumedics Neuroscan, EUA | Versão não especificada | Re-referenciamento offline integrado, mudando da referência online FCz para a média dos mastoides bilaterais; o FCz foi reconstruído automaticamente em relação à nova referência. |
| Capacete de eletrodos EEG, 64 canais | Compumedics Neuroscan (Compumedics Limited), Austrália | Modelo/número de catálogo não especificado | Capacete de eletrodos Ag/AgCl de 64 canais utilizado para gravação contínua de EEG. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, EUA | Versão 2023.0 | Caixa de ferramentas MATLAB utilizada para pré-processamento de EEG e análise de componentes independentes. |
| E-Prime | Psychology Software Tools, Inc., EUA | Versão 2.1 | Apresentação de estímulos e coleta de respostas no Estudo 2. |
| G*Power | Heinrich Heine University Dusseldorf, Alemanha | Versão 3.1.9.7 | Cálculo inicial de tamanho amostral, análise de sensibilidade à interação e análise de poder pós-hoc baseada em modelo para o Estudo 1. |
| IBM SPSS Statistics | IBM Corp., EUA | Versão 27 | Ambiente estatístico utilizado para executar a macro PROCESS. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, EUA | Versão 1.7 | Plugin do EEGLAB utilizado para classificar componentes independentes com artefatos. |
| MATLAB | The MathWorks, Inc., EUA | Release R2020b | Ambiente computacional utilizado para processamento e análise de EEG. |
| Macro PROCESS para SPSS | Andrew F. Hayes, Canadá | Versão 4.2 beta | Modelo 7 com profissionalismo percebido e presença social inseridos simultaneamente como mediadores paralelos, utilizando 5.000 amostras percentil bootstrap no Estudo 1. |
| Gel condutivo Quik-Gel | Compumedics Neuroscan (Compumedics Limited), Austrália | Número de catálogo não especificado; 32 oz | Gel condutivo utilizado para reduzir a impedância entre o eletrodo e a pele durante a gravação de EEG. |
| Amplificador EEG SynAmps2 | Compumedics Neuroscan (Compumedics Limited), Austrália | SynAmps2; número de catálogo não especificado | Amplificador EEG de 64 a 256 canais configurado para gravação de 64 canais. |
Referências
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.