Este estudo computacional apresenta um fluxo de trabalho com reconhecimento de compartimentos para avaliação de transcriptomas públicos de vírus respiratórios, demonstrando que as respostas hospedeiras no nariz e no sangue apresentam concordância limitada ao nível gênico, mas geram módulos específicos de compartimento reproduzíveis e biologicamente interpretáveis em diferentes conjuntos de dados, comparações clínicas, recuperação longitudinal e análises de robustez.
Artigo de investigação
Benchmarking Consciente de Compartimentos de Transcriptomas de Vírus Respiratórios para Módulos de Resposta do Hospedeiro Nasal e Sanguíneo: Um Estudo Computacional
Neste artigo
Resumo
Resumo
Transcriptomas respiratórios públicos são valiosos para estudar respostas do hospedeiro, mas diferenças na origem do tecido, definição de controles e delineamento do estudo podem dificultar análises agrupadas. Desenvolvemos um fluxo de trabalho computacional com distinção por compartimento para determinar se atividade reprodutível na resposta do hospedeiro pode ser identificada, preservando o contexto biológico nasal e sanguíneo. A coorte pediátrica pareada GSE117827 serviu como conjunto de dados âncora, composto por transcriptomas de swab nasal e sangue total provenientes de infecção sintomática por picornavírus, infecção sintomática por vírus respiratório sincicial, detecção assintomática de picornavírus e controles negativos para vírus. Após filtragem pelo Comitê de Nomenclatura Genética HUGO (HGNC), foram analisados 27.685 genes. Módulos separados de 50 genes codificadores de proteínas, nos compartimentos nasal e sanguíneo, foram definidos com base nas respostas positivas mais elevadas e fixados antes da avaliação externa. Os efeitos genéticos nos compartimentos nasal e sanguíneo foram quase independentes (r de Pearson = 0,015), e os módulos compartilharam seis genes com sobreposição de classificação exploratória (índice de Jaccard = 0,064). Apesar disso, o módulo nasal separou infecção de controles em coortes independentes de vias aéreas superiores, com áreas sob a curva característica de operação do receptor (AUROC) de 0,749, 0,693 e 0,609, enquanto o módulo sanguíneo alcançou AUROCs de 0,832, 0,924 e 0,870 em coortes sanguíneos externos. Em dados longitudinais de infecção natural, os escores pareados diminuíram da fase aguda da doença até a alta hospitalar, com deltas pareados de 0,436 para amostras nasais e 0,330 para sangue. Três conjuntos de dados adicionais de referência, compreendendo 666 amostras externas, juntamente com controles nulos de genes aleatórios, varreduras de tamanho de módulo, estabilidade por reamostragem bootstrap, correlações com programas de marcadores e partição de variância, definiram a robustez e limitações do fluxo de trabalho. O conjunto de 33 ácidos ribonucleicos mensageiros (mRNA) de Pandya manteve desempenho superior na discriminação entre infecções virais e bacterianas, enquanto o módulo sanguíneo também aumentou na pneumonia bacteriana. Esses achados sustentam módulos específicos por compartimento como escores reutilizáveis de atividade da resposta do hospedeiro para comparação de coortes e acompanhamento da recuperação, em vez de biomarcadores universais pan-teciduais ou classificadores isolados de patógenos.
Introdução
Assinaturas transcritômicas do hospedeiro são amplamente utilizadas para classificar síndromes infecciosas e comparar respostas imunes entre patógenos1,2,3,4,5. Vírus respiratórios frequentemente ativam genes estimulados por interferon (ISGs), mediadores inflamatórios e vias de apresentação de antígenos com sobreposição6,7,8,9,10. Estudos recentes pareados e longitudinais também mostram que as respostas locais nas vias aéreas e sistêmicas podem diferir em relação ao momento, composição celular e magnitude11. Esse problema vai além da influenza, do vírus respiratório sincicial (VSR), do rinovírus e do SARS-CoV-2. O metapneumovírus humano permanece uma causa importante de doenças respiratórias, embora a literatura sobre sua resposta do hospedeiro e intervenções ainda esteja em desenvolvimento12,13. Essas observações em infecções por vírus respiratórios destacam ainda mais as diferenças entre as respostas do hospedeiro nas vias aéreas locais e sistêmicas14. Para estudos computacionais sobre hospedeiro e vírus, a questão prática, portanto, não é apenas se uma resposta existe. É se dados públicos podem ser reutilizados por meio de um fluxo de trabalho transparente que preserve o contexto tecidual e gere escores reprodutíveis de resposta do hospedeiro.
A maioria dos conjuntos de dados transcriptômicos públicos de vírus respiratórios não foi projetada para inferência limpa entre vírus ou entre tecidos. A origem do tecido, o momento, a gravidade, a idade, a definição do controle e a plataforma geralmente variam em conjunto. Conjuntos de dados de expressão de alto rendimento também são vulneráveis à variação técnica indesejada e em nível de estudo15,16. Uma análise agrupada pode, portanto, recuperar uma assinatura forte de interferon ou inflamatória, ao mesmo tempo em que oculta sua origem. Amostras nasais capturam a biologia imune epitelial e mucosal, enquanto o sangue total reflete respostas sistêmicas de leucócitos. Tratar esses compartimentos como intercambiáveis facilita o cálculo de um escore, mas dificulta sua interpretação.
Construímos a análise com base em GSE117827, uma coorte pareada de nariz-sangue do mesmo estudo, em vez da maior coleção de descoberta disponível17. A coorte é pequena, mas reduz o confundimento entre estudos ao comparar os tamanhos de efeito no nariz e no sangue. Ela inclui infecção sintomática por picornavírus, infecção sintomática por VSR, detecção assintomática de picornavírus e controles negativos para vírus. Portanto, utilizamos essa coorte apenas como uma âncora para módulos específicos de compartimentos separados. A pertinência ao módulo foi fixada antes dos testes externos. A estabilidade da seleção com base na coorte pequena foi examinada por meio de reamostragem bootstrap estratificada, nulos de genes aleatórios e análises de sensibilidade ao tamanho do módulo.
Adicionamos uma camada de comparação com comparadores bacterianos e não infecciosos. O GSE63990 contém amostras de sangue total de doenças respiratórias agudas rotuladas como virais, bacterianas ou não infecciosas18. O GSE40012 contém pneumonia grave adquirida na comunidade, síndrome de resposta inflamatória sistêmica (SIRS) e controles saudáveis19. Essas coortes testam se um módulo reflete atividade geral da resposta do hospedeiro ou especificidade da classe de patógeno. O GSE53543 foi analisado separadamente como uma referência de perturbação ex vivo de células mononucleares do sangue periférico (PBMC) por rinovírus. Ele mede a resposta dos leucócitos sob um estímulo controlado, mas não é equivalente à infecção natural.
Nossa premissa é deliberadamente conservadora. Não tentamos comprovar uma assinatura antiviral universal a partir de dados públicos heterogêneos. Em vez disso, perguntamos se um fluxo de trabalho sensível aos compartimentos pode gerar escores de módulos que permaneçam úteis após testes externos. O uso pretendido é complementar aos classificadores diagnósticos, como o de Pandya com 33-mRNA. Esses módulos pontuam a atividade da resposta do hospedeiro no nariz e no sangue em diferentes coortes, na recuperação e nos gradientes de sintomas. Eles não são projetados para atribuir a classe do patógeno.
Protocolo
Este estudo reanalisou dados anonimizados e de acesso público e não envolveu nova recrutamento, intervenção ou coleta de espécimes. Assim, não foi necessária aprovação ética institucional nem novo consentimento informado para a presente análise secundária. A aprovação ética e o consentimento informado para os estudos originais foram relatados pelos respectivos geradores dos dados.
Desenho do estudo e lógica do fluxo de trabalho
Realizamos um estudo bioinformático retrospectivo com dados públicos utilizando conjuntos de dados depositados no Gene Expression Omnibus20,21. Nenhuma nova amostra de paciente, experimento de cultura celular, modelo animal ou validação em laboratório foi gerada. O fluxo de trabalho utilizou um desenho baseado em ancoragem inicial. O conjunto GSE117827 foi usado para estimativa do tamanho do efeito, construção de módulos, concordância entre compartimentos e análise de gradiente de sintomas. Conjuntos de dados independentes foram introduzidos somente após a fixação da composição dos módulos. O fluxo de trabalho incluiu ancoragem em pares de compartimentos, mapeamento HGNC e filtragem por genes codificadores de proteínas, construção separada de módulos nasais e sanguíneos, validação em tecidos correspondentes e longitudinal, comparação com parâmetros clínicos e análises de robustez. As análises confirmatórias compreenderam testes fixos em tecidos correspondentes e longitudinais. As análises de sobreposição gênica, gradiente de sintomas, programas marcadores e variância foram exploratórias ou descritivas.
Cohorte âncora e contraste principal
GSE117827 contém perfis de expressão de swab nasal e sangue total de 26 crianças: 9 casos sintomáticos de picornavírus, 5 detecções assintomáticas de picornavírus, 6 casos sintomáticos de VSR e 6 controles assintomáticos negativos para vírus17. Dois casos de VSR não tinham espécimes de sangue. O delineamento âncora completo continha, portanto, 50 amostras, e o contraste principal entre infectados e controles continha 40 amostras após a exclusão das detecções assintomáticas de picornavírus da construção dos módulos. Para o contraste principal, as amostras sintomáticas de picornavírus e sintomáticas de VSR foram rotuladas como infectadas, e as amostras assintomáticas negativas para vírus foram rotuladas como controles. As detecções assintomáticas de picornavírus não foram tratadas como controles porque a detecção viral na ausência de sintomas é biologicamente distinta da saúde negativa para vírus. Essas amostras foram excluídas da construção dos módulos e posteriormente utilizadas em uma análise de gradiente de sintomas.
Mapeamento e pré-processamento das sondas
O conjunto de dados GSE117827 foi perfilado na plataforma GPL23126. Os identificadores de agrupamentos de transcritos foram mapeados para símbolos gênicos utilizando o arquivo de anotação Clariom D Human na36, hg38 disponibilizado pela plataforma GEO GPL24539. Apenas símbolos aprovados pelo HGNC foram mantidos22. Sondas de controle, sondas ERCC, agrupamentos de transcritos não mapeados e símbolos não aprovados foram removidos. Vários agrupamentos de transcritos mapeados para o mesmo símbolo aprovado foram agrupados por expressão mediana. Após filtragem e agrupamento, 27.685 genes estavam disponíveis para a análise de âncora. Uma transformação log₂(x + 1) foi aplicada somente quando o percentil 95 da matriz de expressão excedeu 50, indicando uma escala de intensidade não logarítmica. Genes com mais de 20% de valores ausentes foram removidos; os valores ausentes restantes foram substituídos pela mediana intra-gênica. Cada gene foi então padronizado em todas as amostras desse conjunto de dados como z = (x − média)/desvio padrão amostral (ddof = 1). Genes com variância zero tiveram valor padronizado atribuído como 0. A construção dos módulos foi restrita às entradas classificadas como genes codificadores de proteínas no conjunto completo do HGNC.
Análise do tamanho do efeito e construção do módulo
Os compartimentos nasal e sanguíneo foram analisados separadamente. Amostras virais sintomáticas foram comparadas com controles negativos para vírus utilizando diferenças médias padronizadas de Hedges g e testes de Welch bicaudais23. O valor de Hedges g foi calculado como a diferença média entre infectados e controles dividida pelo desvio padrão agrupado, multiplicada pela correção para pequenas amostras 1 − 3/(4df − 1), em que df = ninfected + ncontrol − 2. Os testes de Welch foram implementados admitindo variâncias desiguais. As taxas de falsa descoberta de Benjamini–Hochberg foram calculadas para todos os genes testados dentro de cada compartimento24. Como nenhum gene codificador de proteína atendeu à combinação pré-especificada e rigorosa de FDR < 0,05 e Hedges g > 0,8 na pequena coorte âncora, os genes com efeito positivo foram ordenados primeiramente pelo valor de P de Welch bicaudal em ordem crescente, seguido por Hedges g em ordem decrescente, utilizando o símbolo do gene como critério determinístico final para desempate. Os 50 genes superiores formaram cada módulo principal. Escolheu-se previamente um total de 50 genes como um tamanho moderado de módulo, que manteve a amplitude biológica ao mesmo tempo que limitou a perda de genes ausentes entre plataformas. Esse tamanho de módulo não foi ajustado com base na AUROC externa. Análises de sensibilidade utilizando 10, 25, 50, 100 e 200 genes produziram o mesmo resultado qualitativo de separação da coorte âncora. O objetivo foi a reprodutibilidade em nível de módulo, e não a descoberta de genes individuais.
Concordância entre compartimentos
As estimativas de Hedges g nasais e sanguíneas foram alinhadas por gene e comparadas utilizando correlações de Pearson e Spearman. A sobreposição entre os 50 principais módulos nasais e os 50 principais módulos sanguíneos foi resumida pelo número de sobreposição e pelo índice de Jaccard. Os genes com sobreposição foram interpretados como candidatos exploratórios de sobreposição de classificação entre compartimentos, e não como biomarcadores conservados e validados.
Validação externa com tecidos correspondentes
A validação por pontuação de módulo utilizou conjuntos de dados públicos independentes com grupos de origem interpretáveis. A validação em vias aéreas superiores incluiu as amostras de lavado nasal de RSV do conjunto GSE41374 e os conjuntos de dados de SARS-CoV-2 GSE152075 e GSE156063. A validação em sangue incluiu GSE171110 e duas unidades do GSE38900 normalizadas separadamente: GPL10558 (36 amostras; 28 de RSV e 8 controles) e GPL6884 (138 amostras; 107 de RSV e 31 controles). Para cada conjunto de dados externo, as sondas foram mapeadas para símbolos HGNC, e símbolos duplicados foram agrupados pela mediana da expressão. A mesma transformação, filtragem de valores ausentes, imputação pela mediana e padronização por z por gene utilizada no conjunto de dados âncora foi aplicada dentro de cada conjunto de dados. Uma pontuação de módulo foi calculada como a média não ponderada dos valores padronizados de expressão dos genes do módulo representado. AUC-ROC, precisão média e FDR do teste de Welch foram relatados como métricas de portabilidade, e não como estimativas de desempenho diagnóstico clínico.
Grandes conjuntos de dados clínicos de referência e perturbação ex vivo
Dois conjuntos de dados de sangue total foram utilizados como referências clínicas em vez de coortes de descoberta. Em GSE63990, as amostras foram atribuídas com base nos metadados depositados sobre o estado de infecção a infecção respiratória viral (n = 117), infecção respiratória bacteriana (n = 73) ou doença não infecciosa (n = 90); amostras sem uma dessas etiquetas inequívocas foram excluídas18. Em GSE40012, os campos de diagnóstico depositados foram mapeados para pneumonia por influenza A (n = 39), pneumonia bacteriana sem influenza (n = 61), SIRS sem pneumonia (n = 40), controles saudáveis (n = 36) ou pneumonia bacteriana/influenza mista (n = 14)19. As amostras com pneumonia bacteriana/influenza mista foram descritas, mas excluídas das comparações binárias de referência.
O GSE53543 contém 196 perfis de PBMC ex vivo de 98 indivíduos. Cada indivíduo contribuiu com uma amostra somente de meio e uma amostra exposta ao rinovírus 16 por 24 h; os identificadores dos indivíduos confirmaram 98 pares completos. A principal avaliação comparativa relatou a AUROC entre as 98 amostras estimuladas e as 98 não estimuladas, pois a AUROC é uma métrica de separação por classificação. O pareamento dos indivíduos foi mantido nos metadados e utilizado em uma análise de sensibilidade pareada das diferenças de pontuação. Este experimento foi analisado separadamente da infecção clínica natural e não foi usado para sustentar alegações diagnósticas clínicas.
As matrizes brutas das séries GEO foram baixadas para GSE63990, GSE40012 e GSE53543. O GPL571 foi utilizado para GSE63990, o GPL6947 para GSE40012 e o GPL10558 para GSE53543. As sondas foram mapeadas para símbolos aprovados pelo HGNC, e os mapeamentos duplicados foram reduzidos pela expressão mediana. Foram utilizadas matrizes normalizadas depositadas. A regra geral do percentil 95 acionou a transformação log₂(x + 1) apenas para matrizes em escala não logarítmica. O GSE53543 já estava transformado em log₂, normalizado por invariância de posto e ajustado quanto ao dia de processamento pelos investigadores originais, portanto nenhuma transformação log adicional foi aplicada. Após a remoção dos genes com mais de 20% de valores ausentes e a imputação mediana dos valores ausentes restantes, cada gene foi padronizado por z em todas as amostras dentro de seu conjunto de dados. A camada de referência continha 470 amostras clínicas de sangue total e 196 amostras de PBMC ex vivo.
Teste de referência de assinatura
Os módulos nasais e sanguíneos de referência foram testados frente a três conjuntos de referência não ponderados. O conjunto oficial de 33 mRNAs de Pandya foi transcrito da Tabela Suplementar 1 do relatório original do classificador5. O comparador Andres-Terre continha 33 genes orientados para interferon, curados a partir da assinatura multiviral relatada3. O comparador Hallmark compreendia um subconjunto de 33 genes centrais de interferon-alfa associado ao conjunto MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE25,26. As listas completas de genes para os três conjuntos de referência estão disponíveis em Dados Suplementares 1. Essas pontuações de referência não recriam os classificadores ponderados originais. Para cada conjunto de dados, uma pontuação foi calculada como a média não ponderada dos escores z por gene disponíveis; exigia-se pelo menos três genes representados, e o número de genes representados foi informado. Os contrastes de referência foram vírus versus bactéria, vírus versus não infeccioso, vírus versus bacteriano-ou-não-infeccioso, vírus versus saudável/controle e bacteriano versus saudável/controle, sempre que os grupos necessários estivessem disponíveis. A AUROC e a precisão média foram interpretadas como métricas de avaliação de referência. Os valores de P do teste de Welch foram ajustados utilizando o procedimento de Benjamini–Hochberg em todas as combinações válidas de conjunto de dados–contraste–módulo na tabela de referência.
Validação longitudinal independente
Os conjuntos de dados pareados agudo versus alta GSE97741 e GSE97742 foram utilizados apenas para validação longitudinal27. As amostras rotuladas como infecção única por VSR (VSRsi) ou rinovírus (hRV) nos metadados depositados formaram a análise principal; as co-infecções por VSR (VSRco) foram mantidas apenas na saída suplementar. Os rótulos agudo e alta foram extraídos dos títulos das amostras. As amostras foram pareadas por conjunto de dados, compartimento, grupo viral e identificador do sujeito, e apenas os indivíduos com ambos os pontos temporais foram mantidos. O grupo combinado principal compreendeu 38 pares de VSRsi e 30 pares de hRV (68 pares por compartimento).
Nenhuma seleção de genes, refinamento de módulos ou ajuste de limiares foi utilizado nos conjuntos de dados GSE97741 ou GSE97742. Esses conjuntos de dados foram reservados para validação externa. Os identificadores de sondas foram mapeados para símbolos HGNC aprovados, e os símbolos duplicados foram reduzidos pela mediana da expressão. A mesma regra de transformação logarítmica no percentil 95, filtro de valores ausentes, imputação pela mediana e procedimentos de padronização por gene dentro do conjunto de dados (z-padronização) foram aplicados antes do cálculo das pontuações fixas dos módulos do GSE117827.
Para cada tecido e módulo, os escores agudos e de alta foram pareados por indivíduo e grupo viral. A diferença entre agudo e alta foi calculada para cada par. O Cohen dz foi calculado como a média da diferença pareada dividida pelo seu desvio padrão amostral. Foram realizados testes t pareados bicaudais e testes de postos com sinal de Wilcoxon bicaudais, juntamente com a AUROC para a separação dos escores agudo versus alta. Os valores de FDR de Benjamini–Hochberg foram calculados em todos os 20 testes t pareados válidos na saída longitudinal completa (dois conjuntos de dados, duas fontes de módulos e cinco resumos pré-especificados por grupo viral).
Análise do gradiente de sintomas e análise post hoc
Após a fixação da pertinência aos módulos, as detecções de picornavírus assintomáticas mantidas em GSE117827 foram utilizadas apenas para a análise do gradiente de sintomas. A pontuação clínica ordinal foi 0 para controles negativos para o vírus, 1 para detecções assintomáticas de picornavírus e 2 para infecções sintomáticas. A correlação de Spearman avaliou a tendência ordinal, enquanto o teste de Kruskal–Wallis avaliou as diferenças gerais entre os três grupos. Testes post hoc Mann–Whitney U bicaudais compararam os três pares de grupos. A correção de Benjamini–Hochberg foi aplicada separadamente dentro de cada compartimento à sua família de três comparações aos pares.
Enriquecimento funcional
Os genes dos módulos nasal e sanguíneo foram analisados com o Enrichr por meio do gseapy, utilizando as bibliotecas MSigDB Hallmark 2020, Reactome 2022 e GO Biological Process 202325,26,28,29,30,31. O Enrichr utilizou sua estrutura padrão de super-representação baseada no teste exato de Fisher. Ajuste de Benjamini–Hochberg informado pela biblioteca P valores < 0,05 foram considerados significativos. Os oito termos mais significativos por módulo nas três bibliotecas consultadas foram classificados por ajuste P valor. Os resultados de enriquecimento foram utilizados apenas para interpretação.
Análises de robustez, programa de marcadores e variância
As análises de robustez testaram se os resultados dependiam do tamanho do módulo ou da seleção aleatória. Foram avaliados tamanhos de módulos de 10, 25, 50, 100 e 200 genes. Para a análise nula de genes aleatórios, o universo elegível compreendia os genes codificadores de proteínas do HGNC representados na matriz GSE117827 processada. Foram amostrados quinhentos conjuntos de 50 genes sem reposição, utilizando uma semente aleatória do NumPy de 20260622. A reseleção por bootstrap foi restrita aos 1.000 genes codificadores de proteínas com efeito positivo mais altamente classificados na análise âncora original para cada compartimento. Em cada reamostragem, os genes codificadores de proteínas positivos foram classificados por valor de P de Welch bicaudal crescente e, em seguida, por diferença média decrescente. Os 50 genes superiores foram selecionados. A estabilidade dos genes foi calculada como o número de seleções dividido por 100. Os 20 genes com a maior frequência de seleção em cada compartimento foram exibidos.
Os escores dos programas de marcadores foram utilizados como auxiliares descritivos, e não como estimativas de fração celular. Seis programas curados foram avaliados: epitelial (EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), monócito/macrófago (LYZ, LST1, S100A8, S100A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), neutrófilo (S100A8, S100A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK (CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/plasma (MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1) e mieloide interferônico (SIGLEC1, IFI27, IFI44L, ISG15, MX1, OAS1, RSAD2, IFIT3). O escore de cada programa foi calculado como a média dos escores z por gene disponíveis, exigindo-se pelo menos três genes representados. Os valores de P de Spearman foram ajustados utilizando o procedimento de Benjamini–Hochberg em toda a família de correlações entre conjunto de dados, módulo e programa. A eta-quadrado unidirecional foi calculada como a soma dos quadrados entre grupos dividida pela soma total dos quadrados para cada par módulo-fator. As linhas que faltavam o fator relevante foram excluídas desse cálculo. Esta análise foi descritiva e não ajustou fatores mutuamente correlacionados.
Reprodutibilidade
Todas as análises foram conduzidas usando fluxos de trabalho automatizados em Python 3.12.13, com os pacotes de software e versões relatados na Tabela de Materiais. Os procedimentos aleatórios utilizaram uma semente fixa de 20260622. Matrizes de expressão públicas do GEO foram processadas usando uma estrutura de projeto consistente que separava entradas brutas, dados processados, saídas estatísticas, tabelas e figuras. As definições de módulos, registros de curadoria de amostras, estimativas de tamanho do efeito, estatísticas de validação, resultados de enriquecimento, análises de robustez e dados-fonte das figuras foram mantidos para apoiar a verificação independente. O código de análise, as especificações de dependências e os dados derivados complementares estão disponíveis conforme descrito na declaração de disponibilidade de dados.
Resultados
A avaliação por etapa de referência separou os efeitos gênicos específicos de tecido dos efeitos gênicos pan-teciduais
A matriz de referência curada GSE117827 continha 27.685 genes aprovados pela HGNC. O contraste principal nasal incluiu 15 amostras de indivíduos infectados sintomáticos e 6 amostras controle negativas para o vírus; o contraste sanguíneo incluiu 13 amostras de indivíduos infectados sintomáticos e 6 controles (Tabela 1). Como essa pequena coorte não pode sustentar a descoberta estável de genes individuais, foi utilizada como referência emparelhada por compartimento. A estabilidade foi avaliada ao nível do módulo por meio de reamostragem bootstrap, testes nulos com genes aleatórios, validação externa e análises de sensibilidade ao tamanho dos módulos.
| Fonte | Grupo | Condição | Contraste primário | n |
| Sangue | RSV | Infectado | Sim | 4 |
| Sangue | Picornavírus assintomático | Secundário | Não | 5 |
| Sangue | Picornavírus sintomático | Infectado | Sim | 9 |
| Sangue | Controle negativo para vírus | Controle | Sim | 6 |
| Nasal | RSV | Infectado | Sim | 6 |
| Nasal | Picornavírus assintomático | Secundário | Não | 5 |
| Nasal | Picornavírus sintomático | Infectado | Sim | 9 |
| Nasal | Controle negativo para vírus | Controle | Sim | 6 |
Tabela 1: Projeto do conjunto âncora GSE117827 após a curadoria do contraste principal. Distribuição das amostras entre os compartimentos sanguíneo e nasal no conjunto de dados âncora pareado após a curadoria do contraste principal. As amostras de vírus respiratório sincicial (VRS) sintomáticas e as amostras de picornavírus sintomáticas foram classificadas como infectadas e incluídas no contraste principal, enquanto os controles negativos para vírus foram classificados como controles e incluídos no contraste principal. As amostras de picornavírus assintomáticas foram designadas como secundárias e excluídas da construção do módulo; foram utilizadas apenas na análise exploratória do gradiente de sintomas. Dois casos de VRS não possuíam espécimes sanguíneos, resultando em quatro amostras de VRS sanguíneas e seis amostras nasais de VRS.
Entre os 27.685 genes compartilhados, as estimativas de Hedges g no tecido nasal e no sangue foram quase não correlacionadas (Pearson r = 0,015; Figura 1). Esse resultado surgiu dentro de um único estudo e está menos sujeito a diferenças entre estudos do que uma comparação agrupada entre coortes. A nuvem densa no centro mostra que a maioria dos genes não apresentou movimentação semelhante em ambos os compartimentos. Os genes de sobreposição destacados representam exceções no topo de ambas as listas de classificação. Esse padrão apoia a construção separada de módulos para o tecido nasal e o sangue.
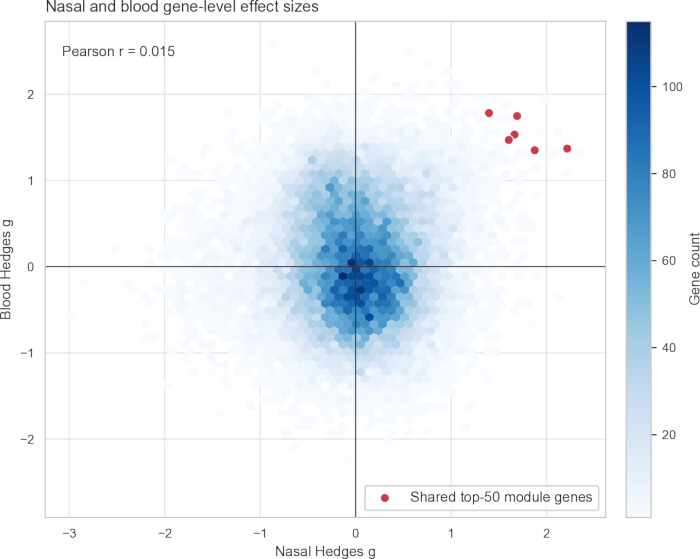
Figura 1. Tamanhos dos efeitos em nível gênico no nariz e no sangue na coorte âncora pareada GSE117827. Os valores de Hedges g comparam infecção sintomática com controles negativos para o vírus em 27.685 genes. As estimativas nasais (15 infectados, 6 controles) são mostradas no eixo x e as estimativas sanguíneas (13 infectados, 6 controles) no eixo y. A tonalidade dos hexágonos indica o número de genes por bin. Os pontos vermelhos indicam os seis genes compartilhados entre os módulos nasais e sanguíneos entre os 50 primeiros. Pearson r = 0,015. Clique aqui para visualizar uma versão maior desta figura.
A construção de módulos produziu uma pequena sobreposição centrada em interferon
Os 50 principais módulos nasais e sanguíneos compartilharam seis genes: ISG15, ACRBP, IFIT1, RSAD2, CCRL2 e XAF1 (índice de Jaccard = 0,064; Tabela 2; Figura 2). ISG15, IFIT1, RSAD2 e XAF1 são compatíveis com a biologia antiviral associada ao interferon32,33,34. CCRL2 é melhor interpretado no contexto da migração inflamatória de leucócitos35. ACRBP não possui um papel antiviral estabelecido. Todos os seis genes são relatados por transparência, mas nenhum é reivindicado como biomarcador validado entre tecidos. Os valores de FDR individuais desses genes não foram significativos na pequena coorte âncora. A principal inferência baseia-se, portanto, na validação em nível de módulo fixo, e não na lista de sobreposição.
| Gene | Hedges nasal g | FDR nasal | Hedges sanguíneo g | FDR sanguíneo | Interpretação |
| ISG15 | 2,215 | 0,213 | 1,369 | 0,442 | Gene antiviral estimulado por interferon; sobreposição exploratória |
| ACRBP | 1,69 | 0,205 | 1,748 | 0,429 | Sem função antiviral estabelecida; mantido por transparência |
| IFIT1 | 1,875 | 0,213 | 1,35 | 0,442 | Gene antiviral estimulado por interferon; sobreposição exploratória |
| RSAD2 | 1,663 | 0,213 | 1,532 | 0,442 | Gene antiviral estimulado por interferon; sobreposição exploratória |
| CCRL2 | 1,396 | 0,217 | 1,782 | 0,442 | Contexto inflamatório de migração de leucócitos; não específico para vírus |
| XAF1 | 1,603 | 0,226 | 1,47 | 0,442 | Fator de apoptose ligado à interferona; sobreposição exploratória |
Tabela 2: Sobreposição exploratória completa entre os módulos nasais e sanguíneos mais bem classificados. Todos os seis genes compartilhados são apresentados com os valores de Hedges g e valores de FDR por gene para os dados nasais e sanguíneos. Os seis genes são considerados candidatos exploratórios de sobreposição de classificação, pois os valores de FDR por gene não foram significativos na pequena coorte âncora. ACRBP é mantido por transparência, apesar de não ter um papel antiviral estabelecido. Nenhum dos seis genes é apresentado como biomarcador universal validado; a evidência principal baseia-se na validação externa em nível de módulo.
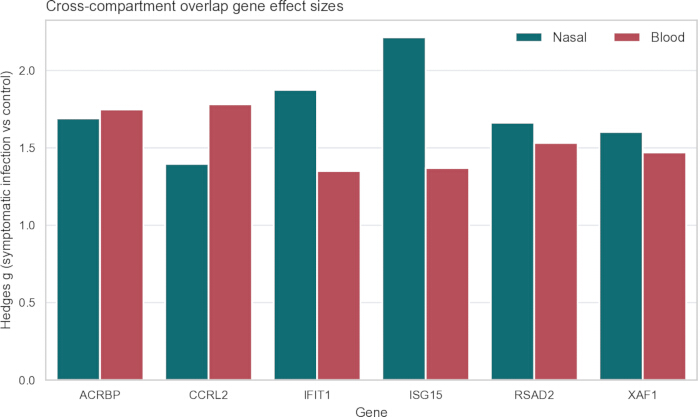
Figura 2. Tamanhos do efeito dos seis genes sobrepostos exploratórios no nariz e no sangue. As estimativas de Hedges g no nariz e no sangue são mostradas para ACRBP, CCRL2, IFIT1, ISG15, RSAD2 e XAF1 em GSE117827. Valores positivos indicam expressão maior na infecção sintomática do que nos controles negativos para o vírus. A sobreposição completa é mostrada para fins de transparência; os valores de FDR por gene individual não foram significativos, e esses genes não são apresentados como biomarcadores universais validados. Clique aqui para visualizar uma versão maior desta figura.
O enriquecimento funcional forneceu uma verificação biológica sobre o conteúdo dos módulos
Ambos os módulos apresentaram enriquecimento para vias de interferon e antivirais, embora a composição gênica e a intensidade do enriquecimento tenham diferido (Figura 3). Os oito termos mais significativos por módulo são exibidos. Para o módulo nasal, as respostas ao interferon-gama do Hallmark (valor P ajustado = 2,23 × 10⁻24), resposta ao interferon-alfa do Hallmark (valor P ajustado = 1,40 × 10⁻22), sinalização de interferon-alfa/beta do Reactome (valor P ajustado = 3,64 × 10⁻19) e resposta de defesa ao vírus do GO (valor P ajustado = 5,47 × 10⁻15) estiveram entre os principais termos. O módulo sanguíneo mostrou a mesma biologia geral, mas com menor intensidade de enriquecimento: resposta ao interferon-alfa (valor P ajustado = 3,87 × 10⁻6), sinalização de interferon-alfa/beta do Reactome (valor P ajustado = 5,70 × 10⁻6), resposta ao interferon-gama (valor P ajustado = 8,89 × 10⁻6) e resposta de defesa ao vírus (valor P ajustado = 1,07 × 10⁻4). Esses resultados apoiam a coerência biológica sem implicar classificações idênticas de genes nos compartimentos.
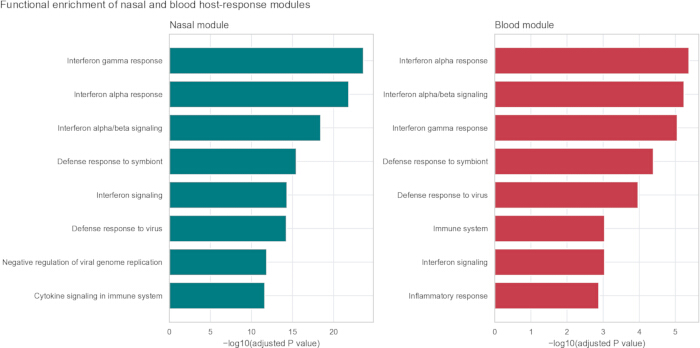
Figura 3. Termos de enriquecimento selecionados para os módulos nasal e sanguíneo. A análise de super-representação foi realizada utilizando o Enrichr com Hallmark 2020, Reactome 2022 e GO Biological Process 2023. Os oito termos com os menores valores de P ajustados pelo método de Benjamini–Hochberg para cada módulo são apresentados. O comprimento das barras representa −log10(valor de P ajustado). Os painéis esquerdo e direito mostram os módulos nasal e sanguíneo, respectivamente. Os termos são exibidos em caixa de frase. A análise de enriquecimento não alterou a composição dos módulos. Clique aqui para visualizar uma versão maior desta figura.
Os módulos travados foram testados em validação externa com tecidos correspondentes
O módulo nasal travado alcançou AUCs de 0,749 em GSE41374, 0,693 em GSE152075 e 0,609 em GSE156063 (Tabela 3; Figura 4). O módulo sanguíneo travado alcançou AUCs de 0,832 em GSE171110, 0,924 na unidade GSE38900 GPL10558 e 0,870 na unidade GPL6884. O desempenho interno do ancoradouro é omitido porque é otimista por construção. As AUCs externas são tratadas como resumos de portabilidade. Elas não estabelecem sensibilidade clínica, especificidade ou prontidão para diagnóstico.
| Cohorte | Amostra/vírus | Módulo | n positivo | n negativo | Genes representados | AUROC | Precisão média | FDR do teste de Welch |
| GSE152075 | SARS-CoV-2 vias aéreas superiores | Nasal | 430 | 54 | 50 | 0.693 | 0.935 | 2.20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 vias aéreas superiores | Nasal | 93 | 100 | 49 | 0.609 | 0.551 | 1.38 × 10⁻² |
| GSE171110 | SARS-CoV-2 sangue total | Sangue | 44 | 10 | 50 | 0.832 | 0.959 | 7.94 × 10⁻⁴ |
| GSE38900-GPL10558 | RSV sangue total | Sangue | 28 | 8 | 50 | 0.924 | 0.979 | 7.94 × 10⁻⁴ |
| GSE38900-GPL6884 | RSV sangue total | Sangue | 107 | 31 | 49 | 0.87 | 0.962 | 3.47 × 10⁻¹⁵ |
| GSE41374 | RSV lavado nasal | Nasal | 76 | 10 | 50 | 0.749 | 0.951 | 2.63 × 10⁻² |
Tabela 3: Validação externa do escore do módulo com tecidos correspondentes. O módulo nasal fixado foi testado nos conjuntos de dados GSE41374, GSE152075 e GSE156063, e o módulo sanguíneo fixado foi testado em GSE171110 e nas plataformas GSE38900 com unidades GPL10558 e GPL6884. A tabela apresenta os números de amostras positivas e negativas, os genes do módulo representados, AUROC, precisão média e FDR do teste de Welch. O desempenho do ancoradouro interno foi omitido. AUROC e precisão média são apresentados como resumos de portabilidade e não como estimativas de desempenho diagnóstico clínico.
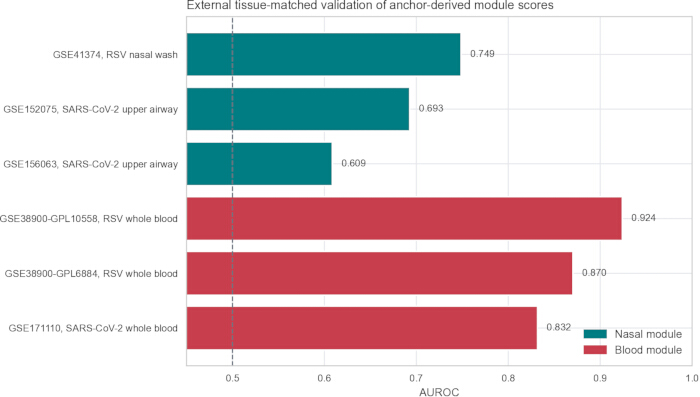
Figura 4. Portabilidade de escores de módulos pareados por tecido externo. Os AUROCs são mostrados para o módulo nasal em GSE41374 (76 RSV, 10 controles), GSE152075 (430 SARS-CoV-2, 54 controles) e GSE156063 (93 SARS-CoV-2, 100 controles), e para o módulo sanguíneo em GSE171110 (44 SARS-CoV-2, 10 controles), GSE38900-GPL10558 (28 RSV, 8 controles) e GSE38900-GPL6884 (107 RSV, 31 controles). Os escores são médias não ponderadas dos valores z por gene representados. A linha tracejada indica AUROC = 0,5. Os valores são resumos de portabilidade, não estimativas diagnósticas clínicas. Clique aqui para visualizar uma versão maior desta figura.
A validação longitudinal testou se os escores diminuem durante a recuperação
Os conjuntos de dados complementares GSE97741/GSE97742 forneceram um cenário de validação independente de infecção natural, com amostras de fase aguda e de alta de crianças hospitalizadas27. Essas amostras não foram utilizadas como dados de descoberta de controle saudável. Foram usadas para avaliar se os escores dos módulos derivados do ancoramento diminuíram da fase aguda da doença até a alta.
Para o grupo combinado pré-especificado de infecção única por VSR e rinovírus, 68 pares de indivíduos foram analisados em cada tecido (Tabela 4; Figura 5). O módulo sanguíneo diminuiu da fase aguda da doença até a alta hospitalar no sangue (delta médio = 0,330; Cohen dz = 0,740; FDR do teste pareado = 1,98 × 10⁻7; AUROC = 0,765). O módulo nasal também diminuiu nas amostras nasofaríngeas (delta médio = 0,436; Cohen dz = 0,477; FDR do teste pareado = 3,06 × 10⁻4; AUROC = 0,679). As trajetórias pareadas e seus erros-padrão mostram que a diminuição em nível de grupo não foi impulsionada por alguns extremos não pareados.
| Conjunto de dados | Fonte da amostra | Módulo | Tecido correspondente | n pares | Média do delta agudo-alta | Cohen dz | AUROC | FDR do teste pareado |
| GSE97741 | Sangue | Sangue | Sim | 68 | 0,330 | 0,740 | 0,765 | 1,98 × 10⁻⁷ |
| GSE97741 | Sangue | Nasal | Não | 68 | 0,479 | 0,721 | 0,755 | 3,19 × 10⁻⁷ |
| GSE97742 | Nasofaringe | Sangue | Não | 68 | 0,361 | 0,914 | 0,845 | 9,42 × 10⁻¹⁰ |
| GSE97742 | Nasofaringe | Nasal | Sim | 68 | 0,436 | 0,477 | 0,679 | 3,06 × 10⁻⁴ |
Tabela 4: Validação longitudinal independente agudo-versus-alta. A tabela apresenta o número de pares completos, a diferença média entre escores agudo e de alta, Cohen dz, AUROC e valor FDR do teste pareado para os módulos fixos em GSE97741 e GSE97742. Um delta positivo indica um escore de módulo mais alto durante a doença aguda. Os valores de FDR do teste pareado são valores de P ajustados pelo método de Benjamini–Hochberg para testes t pareados bicaudais, calculados em todos os 20 testes t pareados válidos na saída longitudinal completa.
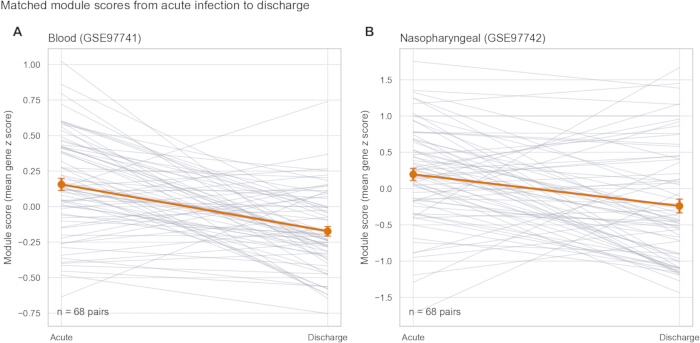
Figura 5. Alterações pareadas nas pontuações dos módulos da doença aguda à alta hospitalar. (A) Pontuações dos módulos sanguíneos em sangue total (GSE97741). (B) Pontuações dos módulos nasais em amostras nasofaríngeas (GSE97742). Cada painel contém 68 pares completos de indivíduos: 38 infecções isoladas por VSR e 30 infecções por rinovírus. Linhas finas conectam as medições pareadas por indivíduo. Pontos laranja indicam as médias dos grupos e barras de erro laranja indicam o erro padrão da média. Foram realizados testes t pareados bilaterais e testes de postos com sinal de Wilcoxon; a correção FDR de Benjamini–Hochberg foi aplicada nos 20 testes t pareados longitudinais válidos. Clique aqui para visualizar uma versão maior desta figura.
Os testes entre compartimentos revelaram uma nuance útil. O módulo sanguíneo aplicado a amostras nasofaríngeas resultou em uma AUC-ROC de 0,845, embora os tamanhos dos efeitos individuais no nariz e no sangue fossem fracamente concordantes no compartimento de referência. A inspeção das trajetórias emparelhadas mostrou uma diminuição consistente das pontuações, em vez de uma distribuição invertida de rótulos. Assim, o resultado não é evidência de que os mesmos genes individuais dominem ambos os tecidos. Indica que um programa coordenado de interferon/inflamação pode ser resumido por conjuntos de genes diferentes, mas parcialmente redundantes. A especificidade de compartimento é mais acentuada no nível de classificação dos genes e não é absoluta no nível de vias ou pontuações.
Detecções assintomáticas mantidas foram testadas quanto ao comportamento do gradiente de sintomas
As detecções assintomáticas de picornavírus em GSE117827 foram excluídas da construção do módulo para evitar sua inclusão no grupo controle principal. Esse grupo mantido então forneceu uma verificação biológica. Em ambos os compartimentos, os escores dos módulos aumentaram ao longo dos grupos ordenados de controles negativos para o vírus, detecção assintomática de picornavírus e infecção sintomática (Figura 6A,B).
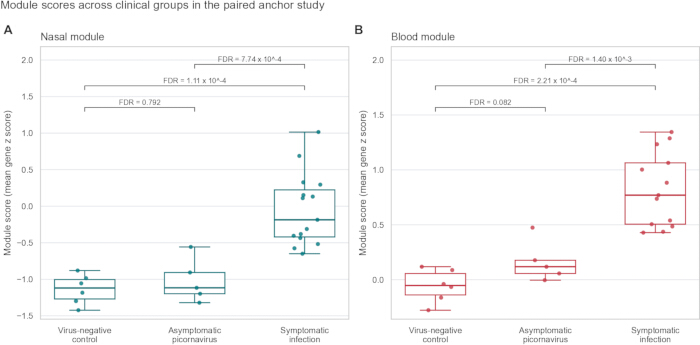
Figura 6. Escores dos módulos ao longo do gradiente de sintomas mantido. (A) Módulo nasal: 6 controles negativos para vírus, 5 detecções assintomáticas de picornavírus e 15 infecções sintomáticas. (B) Módulo sanguíneo: 6 controles negativos para vírus, 5 detecções assintomáticas de picornavírus e 13 infecções sintomáticas. Os pontos representam amostras individuais. As linhas centrais indicam as medianas; as caixas abrangem do percentil 25 ao 75; e os bigodes estendem-se até os valores mais extremos dentro de 1,5 vez a amplitude interquartil. As legendas informam comparações pós-hoc de Mann–Whitney U bicaudais com correção de Benjamini–Hochberg nas três comparações por compartimento. Clique aqui para visualizar uma versão maior desta figura.
O módulo nasal correlacionou-se com a pontuação ordinal dos sintomas (rho de Spearman = 0,818, P = 3,28 × 10⁻7; Kruskal-Wallis P = 1,57 × 10⁻4). O módulo sanguíneo mostrou um gradiente semelhante (rho = 0,861, P = 6,89 × 10⁻8; Kruskal-Wallis P = 1,92 × 10⁻4). Após correção dentro de cada família de três comparações, a infecção sintomática diferiu dos controles e das detecções assintomáticas em ambos os compartimentos. As detecções assintomáticas não diferiram dos controles negativos para o vírus (FDR nasal = 0,792; FDR sanguíneo = 0,082). Assim, os módulos acompanharam a atividade da resposta do hospedeiro sintomático de forma mais clara do que a detecção viral isolada.
Parâmetros clínicos definiram o limite entre resposta do hospedeiro e especificidade do patógeno
Parâmetros clínicos definiram a distinção entre atividade da resposta do hospedeiro e classificação do patógeno (Tabela 5; Figura 7). No conjunto GSE63990, o módulo nasal apresentou valores de AUROC de 0,782 para doença viral versus bacteriana e de 0,791 para doença viral versus não infecciosa. O módulo sanguíneo apresentou valores de AUROC de 0,678 e 0,753, respectivamente. O comparador de 33-mRNA de Pandya apresentou desempenho superior, com valores de AUROC de 0,867 e 0,852, respectivamente. Esse resultado era esperado para um conjunto projetado para discriminação entre infecções virais e não virais, e demonstra que os módulos âncora não devem ser apresentados como classificadores diagnósticos substitutos.
| Conjunto de dados | Contraste | Nasal âncora | Sangue âncora | Pandya 33 mRNA | Andres-Terre ISG | Interferon-alfa marcador |
| GSE63990 | Viral versus bacteriano | 0,782 | 0,678 | 0,867 | 0,833 | 0,831 |
| GSE63990 | Viral versus não infeccioso | 0,791 | 0,753 | 0,852 | 0,851 | 0,848 |
| GSE40012 | Pneumonia viral versus pneumonia bacteriana | 0,755 | 0,789 | 0,893 | 0,867 | 0,872 |
| GSE40012 | Pneumonia viral versus SIRS | 0,897 | 0,907 | 0,985 | 0,965 | 0,956 |
| GSE40012 | Pneumonia viral versus saudável | 0,804 | 0,986 | 0,923 | 0,906 | 0,891 |
| GSE40012 | Pneumonia bacteriana versus saudável | 0,476 | 0,917 | 0,465 | 0,391 | 0,378 |
| GSE53543 | PBMCs estimuladas ex vivo com rinovírus versus não estimuladas | 1 | 0,957 | 1 | 1 | 1 |
Tabela 5: Comparação de AUROC para módulos âncora e conjuntos de referência de resposta do hospedeiro. GSE63990 e GSE40012 são coortes clínicas de sangue total. GSE53543 é um experimento de perturbação de PBMCs ex vivo envolvendo 98 indivíduos pareados e é relatado separadamente dos coortes clínicos naturais. Os conjuntos de referência foram pontuados como médias não ponderadas de genes, em vez de seus classificadores ponderados originais. Os valores de AUROC são apresentados como métricas de comparação e não como estimativas de desempenho diagnóstico clínico.
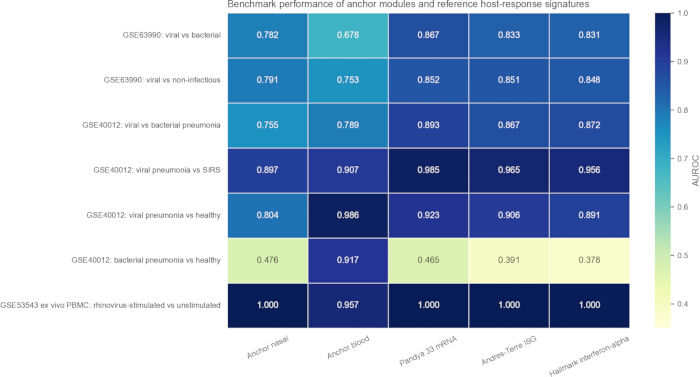
Figura 7. Avaliação comparativa de AUROC de módulos âncora e conjuntos de referência de resposta do hospedeiro. As linhas representam contrastes pré-especificados nos conjuntos GSE63990, GSE40012 e GSE53543; as colunas representam os dois módulos âncora e três conjuntos de referência não ponderados. O GSE53543 é rotulado como PBMCs estimulados com rinovírus ex vivo versus não estimulados e é apresentado separadamente dos coortes clínicos naturais. O comparador Hallmark é rotulado como interferon-alfa Hallmark. Os valores nas células indicam os AUROCs utilizados para avaliação comparativa de métodos e não devem ser interpretados como estimativas de desempenho diagnóstico clínico. Clique aqui para visualizar uma versão maior desta figura.
O GSE40012 definiu melhor esse limite. O comparador Pandya alcançou valores de AUROC de 0,893 para pneumonia viral versus bacteriana e de 0,985 para pneumonia viral versus SIRS. O módulo sanguíneo separou pneumonia por influenza A de controles saudáveis (AUROC = 0,986) e de SIRS (AUROC = 0,907), mas também separou pneumonia bacteriana de controles saudáveis (AUROC = 0,917). O módulo sanguíneo, portanto, mede atividade inflamatória sistêmica ampla e associada ao interferon. Ele não é específico para vírus, e um escore alto não pode atribuir a classe do patógeno.
No conjunto de referência ex vivo GSE53543 separado, o módulo nasal e os comparadores de interferon alcançaram uma AUROC de 1,000 para PBMCs estimulados por rinovírus em comparação com PBMCs apenas em meio; o módulo sanguíneo alcançou uma AUROC de 0,957. Todos os 98 indivíduos contribuíram com condições pareadas. Esse resultado controlado apoia a resposta dos programas pontuados à estimulação por rinovírus. Ele não estima o desempenho diagnóstico clínico.
Os testes de robustez avaliaram o tamanho do módulo, alternativas aleatórias e estabilidade da seleção
A separação dos âncoras permaneceu inalterada entre os 10, 25, 50, 100 e 200 genes com as classificações mais altas (Figura 8A). Essas AUROCs internas não constituem uma validação externa, mas demonstram que o resultado qualitativo não dependeu da escolha exata de 50 genes. Em 500 conjuntos aleatórios de 50 genes, as medianas da AUROC nula foram 0,489 para o tecido nasal e 0,705 para o sangue; os percentis correspondentes ao 99º foram 0,722 e 0,872 (Figura 8B). Os módulos observados superaram essas distribuições nulas. As frequências de seleção por reamostragem bootstrap foram distribuídas, em vez de concentradas em uma única lista invariável (Figura 8C). Esse achado reflete diretamente o pequeno tamanho da amostra de âncoras. Ele apoia um sinal agregado estável, ao mesmo tempo que adverte contra tratar cada gene selecionado como fixo.
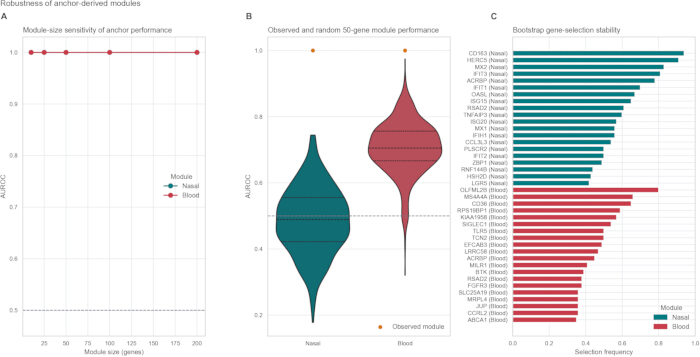
Figura 8. Análises de robustez quanto ao tamanho do módulo, genes aleatórios e bootstrap. (A) AUROC do ancoramento em diferentes tamanhos de módulo: 10, 25, 50, 100 e 200 genes; esses valores representam verificações internas de sensibilidade. (B) Distribuições de AUROC obtidas a partir de 500 conjuntos aleatórios de 50 genes codificadores de proteínas, amostrados sem reposição entre os genes representados em GSE117827 (semente = 20260622). Os pontos laranja indicam os AUROC observados nos módulos. As linhas horizontais dentro de cada violino indicam o 25º percentil, a mediana e o 75º percentil. (C) A reseleção com bootstrap foi restrita aos 1.000 genes codificadores de proteínas com efeito positivo, classificados mais alto na análise original de ancoramento para cada compartimento. As barras mostram os 20 genes com maior frequência de seleção por compartimento; a frequência de seleção foi calculada como o número de seleções dividido por 100. Clique aqui para visualizar uma versão maior desta figura.
As análises de marcadores e de variância esclareceram o que as pontuações medem
Nas bases GSE40012, GSE53543 e GSE63990, ambos os módulos correlacionaram-se de forma mais consistente com o programa de interferon mieloide (Figura 9A). As correlações do módulo nasal foram 0,812, 0,878 e 0,882; as correlações do módulo sanguíneo foram 0,517, 0,843 e 0,774. A partição da variância foi descritiva (Tabela 6; Figura 9B). Para o módulo sanguíneo, a condição e o grupo detalhado explicaram mais variância (eta-quadrado = 0,282 e 0,250, respectivamente) do que o conjunto de dados (0,066), o tipo de amostra (0,026) ou o grupo de origem (0,025). Para o módulo nasal, o grupo detalhado e a condição também explicaram mais variância do que o conjunto de dados, o tipo de amostra ou o grupo de origem. A condição biológica e o grupo detalhado, portanto, representaram frações maiores da variância das pontuações dos módulos do que o conjunto de dados ou o tipo de amostra, embora os efeitos não nulos do conjunto de dados e da composição permaneçam como uma limitação da reutilização de dados públicos em massa.
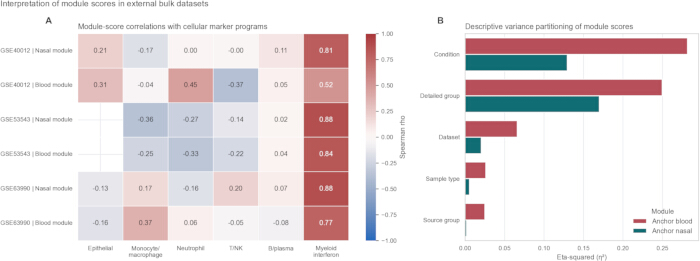
Figura 9. Correlações entre marcadores e programas e partição descritiva da variância. (A) Correlações de Spearman entre escores de módulo e seis escores de programas marcadores em GSE40012, GSE53543 e GSE63990. Os programas exigiam pelo menos três genes representados. Os valores de P foram ajustados em todas as correlações entre conjunto de dados, módulo e programa. Células em branco indicam combinações indisponíveis ou não estimáveis após os critérios de genes e amostras. (B) Eta-quadrado unidirecional (η2; soma dos quadrados entre grupos / soma total dos quadrados) para condição, grupo detalhado, conjunto de dados, tipo de amostra e grupo de origem. A análise incluiu 934 escores de módulo sanguíneo e 1.469 escores de módulo nasal e é descritiva, não causal. Clique aqui para visualizar uma versão maior desta figura.
| Módulo | Fator | Eta-ao-quadrado | n amostras |
| Sangue de referência | Condição | 0.282 | 934 |
| Sangue de referência | Grupo detalhado | 0.25 | 934 |
| Sangue de referência | Conjunto de dados | 0.066 | 934 |
| Sangue de referência | Tipo de amostra | 0.026 | 934 |
| Sangue de referência | Grupo de origem | 0.025 | 934 |
| Nasal de referência | Grupo detalhado | 0.17 | 1469 |
| Nasal de referência | Condição | 0.13 | 1469 |
| Nasal de referência | Conjunto de dados | 0.021 | 1469 |
| Nasal de referência | Tipo de amostra | 0.006 | 1469 |
| Nasal de referência | Grupo de origem | 0.002 | 1469 |
Tabela 6: Particionamento descritivo da variância dos escores dos módulos. Uma linha é fornecida para cada par módulo-fator, com o valor correspondente de eta ao quadrado e o tamanho da amostra. O eta ao quadrado foi calculado como a soma dos quadrados entre grupos dividida pela soma total dos quadrados, após a exclusão das linhas com escore do módulo ou fator relevante ausente. Os fatores foram avaliados individualmente; portanto, a análise é descritiva, não ajusta fatores mutuamente correlacionados e não deve ser interpretada de forma causal.
Disponibilidade de Dados:
Todos os conjuntos de dados transcriptômicos analisados neste estudo estão disponíveis publicamente no Gene Expression Omnibus sob os números de acesso GSE117827, GSE41374, GSE152075, GSE156063, GSE171110, GSE38900, GSE97741, GSE97742, GSE63990, GSE40012 e GSE53543. Os dados derivados das análises que sustentam as principais figuras e tabelas, bem como o código de análise, estão disponíveis junto ao autor correspondente mediante solicitação razoável. Nenhum dado restrito ou novo em nível individual de participantes foi utilizado neste estudo.
Discussão
A principal lição é operacional: comece com o compartimento amostrado, não com a matriz agrupada maior. O GSE117827 é pequeno, mas seu delineamento pareado permite uma comparação direta entre nariz e sangue dentro de um único estudo. A correlação quase nula no nível gênico mostra que uma lista classificada pan-tecidual agrupada ocultaria uma estrutura compartimental substancial. Assim, módulos separados foram o delineamento mais justificável. O desempenho externo e longitudinal apoia uma atividade reprodutível da resposta do hospedeiro ao nível dos módulos, e não uma lista universal de genes.
A portabilidade em nível gênico e em nível de módulo são diferentes. O módulo sanguíneo apresentou bom desempenho em amostras longitudinais de nasofaringe (AUROC 0,845), apesar da fraca concordância entre os tamanhos de efeito individuais do nariz e do sangue. As trajetórias emparelhadas não mostraram inversão de rótulos. Uma explicação mais provável é a redundância de vias: a atividade coordenada do interferon e inflamatória pode ser resumida por subconjuntos diferentes de genes em compartimentos distintos6,7,8,9,10,11,32,33,34. É por isso que descrevemos os módulos como cientes do compartimento, em vez de exclusivos do compartimento. As classificações exatas diferem, mas um componente compartilhado em nível de via permanece detectável. Os perfis em massa também misturam alterações de expressão com mudanças na composição celular. As correlações entre marcadores e programas podem sinalizar esse problema, mas não podem fornecer mecanismos resolvidos em nível celular36,37.
Os parâmetros clínicos definem um segundo limite. Os comparadores de 33 mRNA de Pandya e de interferon foram mais eficazes na discriminação entre vírus e bactérias. Os módulos de referência respondem a uma pergunta diferente: com que intensidade uma amostra expressa um programa de resposta aguda do hospedeiro? O módulo sanguíneo também aumentou na pneumonia bacteriana. Deve, portanto, ser interpretado como um escore de atividade inflamatória sistêmica ampla/atividade de interferon, e não como um classificador específico de vírus. Um escore alto pode auxiliar na comparação de coortes, no acompanhamento de resposta ou na descrição do estado inflamatório, mas não pode identificar o patógeno. A crescente importância clínica de vírus como o metapneumovírus humano reforça ainda mais a necessidade de validação diversificada em relação ao patógeno e compatível com o tecido, em vez de extrapolação a partir de um conjunto restrito de vírus12,13.
Os seis genes sobrepostos são exploratórios. ISG15, IFIT1, RSAD2 e XAF1 têm papéis plausíveis ligados ao interferon32,33,34; CCRL2 está associado à migração inflamatória de leucócitos35; ACRBP não possui uma interpretação antiviral estabelecida. A pequena coorte e os valores de FDR não significativos por gene impedem afirmações mais fortes. A inovação metodológica reside em outro lugar: um âncora emparelhado no mesmo estudo, módulos específicos de compartimento fixos, testes externos com tecidos correspondentes, análise de recuperação emparelhada, comparação com parâmetros clínicos e verificações explícitas de aleatoriedade, tamanho, bootstrap, marcadores e variância. Essa hierarquia de evidências fornece um arcabouço conservador para a interpretação dos resultados.
Várias limitações permanecem. A coorte âncora contém apenas 15 amostras nasais infectadas e 6 amostras de controle, e 13 amostras sanguíneas infectadas e 6 amostras de controle. Os resultados do método de reamostragem (bootstrap) confirmam que a pertinência individual dos genes não é totalmente estável. Os casos sintomáticos de VSR e picornavírus foram combinados, de modo que os efeitos âncora não são específicos de vírus. As coortes externas diferem quanto à idade, plataforma, gravidade, cronologia e definição dos controles. O GSE53543 é um estudo de perturbação pareado ex vivo. O GSE63990 e o GSE40012 fornecem comparadores clínicos úteis, mas não incluem amostragem pareada de nariz e sangue. A carga viral, a duração dos sintomas, a necessidade de oxigênio e a gravidade não estavam consistentemente disponíveis. Um delineamento prospectivo mais robusto coletaria swabs nasais e amostras sanguíneas dos mesmos participantes em pontos temporais correspondentes, com medições de carga viral e sintomas, comparadores bacterianos e vírus-negativos sintomáticos, além de validação com resolução celular11,14,36,37.
Em conclusão, os transcriptomas públicos atuais apoiam módulos reprodutíveis de atividade da resposta do hospedeiro em tecidos nasais e sanguíneos quando o contexto tecidual é preservado. Eles não apoiam uma assinatura gênica pan-tecidual intercambiável. O par de âncoras mostrou pouca concordância ao nível gênico, enquanto os escores dos módulos fixos foram transferidos dentro de tecidos correspondentes e diminuíram durante a recuperação. A resposta do módulo sanguíneo na pneumonia bacteriana e o desempenho superior do classificador estabelecido na distinção entre vírus e bactérias definem o uso pretendido: esses módulos descrevem a atividade da resposta do hospedeiro e permitem a comparação transparente de coortes; eles não são classificadores de patógenos independentes. O código de análise e os dados derivados estão disponíveis conforme descrito na declaração de disponibilidade de dados, para apoiar a verificação independente e o reuso do fluxo de trabalho.
Divulgações
Os autores declaram não haver conflitos de interesses financeiros ou não financeiros relevantes para este trabalho.
Agradecimentos
Os autores agradecem aos pesquisadores e participantes dos estudos públicos do GEO reanalisados neste trabalho. Nenhum indivíduo adicional preencheu os critérios para autoria. Esta pesquisa não recebeu nenhuma bolsa específica de agência de fomento nos setores público, comercial ou sem fins lucrativos.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Conjunto de genes estimulados por interferon multivírus de Andres-Terre | Andres-Terre et al. | Comparador de 33 genes; Dados Suplementares 1 | Comparador não ponderado orientado a interferon curado a partir da assinatura multivírus relatada; a lista completa de genes está fornecida nos Dados Suplementares 1. |
| Enrichr | Laboratório Ma'ayan | Acessado em 18 de agosto de 2026; RRID:SCR_001575 | Recurso de super-representação de conjuntos de genes acessado por meio do gseapy. |
| Gene Expression Omnibus | Centro Nacional de Informação Biotecnológica | GEO; RRID:SCR_005012 | Repositório público de transcriptoma utilizado para acessar os conjuntos de dados analisados. |
| Gene Ontology | Consortium Gene Ontology | Processo Biológico GO 2023; RRID:SCR_002811 | Biblioteca de anotação funcional utilizada por meio do Enrichr. |
| GPL10558 | NCBI GEO | GPL10558 | Plataforma para GSE53543 e unidade de validação GSE38900 com 36 amostras. |
| GPL23126 | NCBI GEO | GPL23126 | Plataforma de expressão para GSE117827. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | Anotação Clariom D Human na36, hg38 utilizada para mapeamento de transcript-clusters em GSE117827. |
| GPL571 | NCBI GEO | GPL571 | Anotação de plataforma aplicada a GSE63990. |
| GPL6884 | NCBI GEO | GPL6884 | Plataforma para a unidade de validação de sangue total com 138 amostras de GSE38900 para VSR. |
| GPL6947 | NCBI GEO | GPL6947 | Anotação de plataforma aplicada a GSE40012. |
| GSE117827 | NCBI GEO | GSE117827 | Conjunto de dados principal emparelhado de swab nasal e sangue total. |
| GSE152075 | NCBI GEO | GSE152075 | Conjunto de dados externo de validação de vias aéreas superiores para SARS-CoV-2. |
| GSE156063 | NCBI GEO | GSE156063 | Conjunto de dados externo de validação de vias aéreas superiores para SARS-CoV-2. |
| GSE171110 | NCBI GEO | GSE171110 | Conjunto de dados externo de validação de sangue total para SARS-CoV-2. |
| GSE38900 | NCBI GEO | GSE38900; GPL10558 e GPL6884 | Validação externa de sangue total para VSR analisada como unidades de plataforma separadamente normalizadas com 36 e 138 amostras. |
| GSE40012 | NCBI GEO | GSE40012 | Referência clínica para pneumonia por influenza A, pneumonia bacteriana, SIRS e controles saudáveis. |
| GSE41374 | NCBI GEO | GSE41374 | Conjunto de dados externo de validação de lavado nasal para VSR. |
| GSE53543 | NCBI GEO | GSE53543 | Referência de perturbação ex vivo de PBMC por rinovírus emparelhada, envolvendo 98 indivíduos e 196 amostras. |
| GSE63990 | NCBI GEO | GSE63990 | Referência clínica de sangue total para infecções virais, bacterianas e não infecciosas. |
| GSE97741 | NCBI GEO | GSE97741 | Conjunto de dados longitudinal de validação de sangue total agudo versus alta. |
| GSE97742 | NCBI GEO | GSE97742 | Conjunto de dados longitudinal de validação de nasofaringe agudo versus alta. |
| gseapy | Desenvolvedores do gseapy | Versão 1.3.1 | Interface Python utilizada para consultar o Enrichr. |
| Recurso de símbolos gênicos HGNC | Comitê de Nomenclatura Gênica HUGO | Acessado em 18 de agosto de 2026; RRID:SCR_002827 | Recurso de normalização de símbolos gênicos aprovados e classificação de codificação proteica. |
| Matplotlib | Equipe de desenvolvimento do Matplotlib | Versão 3.11.1 | Geração de figuras. |
| Conjuntos de genes MSigDB Hallmark | Instituto Broad | Hallmark 2020; RRID:SCR_016863 | Biblioteca de enriquecimento Hallmark acessada por meio do Enrichr. |
| Conjunto de genes de resposta ao interferon-alfa MSigDB Hallmark | Instituto Broad | HALLMARK_INTERFERON_ALPHA_ RESPONSE; subconjunto principal de 33 genes nos Dados Suplementares 1 | Comparador não ponderado de interferon-alfa; o subconjunto exato está fornecido nos Dados Suplementares 1. |
| NumPy | Desenvolvedores do NumPy | Versão 2.5.2 | Computação numérica e amostragem aleatória com semente. |
| pandas | Equipe de desenvolvimento do pandas | Versão 3.0.5 | Processamento de dados tabulares. |
| Conjunto de 33 mRNAs de resposta do hospedeiro de Pandya | Pandya et al. | Tabela Suplementar 1; Dados Suplementares 1 | Conjunto oficial de 33 genes pontuado como comparador não ponderado. |
| Python | Fundação Python Software | Versão 3.12.13 | Ambiente de análise computacional. |
| Reactome | Reactome | Reactome 2022; RRID:SCR_003485 | Biblioteca de enriquecimento de vias acessada por meio do Enrichr. |
| scikit-learn | Desenvolvedores do scikit-learn | Versão 1.9.0 | Cálculos de AUROC e precisão média. |
| SciPy | Desenvolvedores do SciPy | Versão 1.18.0 | Testes de Welch, t pareado, Wilcoxon, Mann–Whitney e correlação. |
| Seaborn | Equipe de desenvolvimento do Seaborn | Versão 0.13.2 | Gráficos estatísticos. |
| statsmodels | Desenvolvedores do statsmodels | Versão 0.14.6 | Utilitários estatísticos. |
Referências
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.