Este trabalho de pesquisa apresentou uma abordagem, a FusionNetX, enriquecendo a capacidade de fusão de características do DenseNet121 e do EfficientNetB7 para a classificação de tumores cerebrais em cinco conjuntos de dados publicamente disponíveis, com aumento de dados, pré-processamento e personalização do modelo híbrido (fusão intermediária), obtendo resultados que variam de 98,77% a 99,89%, superando outros métodos em múltiplos parâmetros de avaliação.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
FusionNetX: Um Modelo de Fusão de Características Profundas Utilizando RM e Aprendizado Profundo para a Detecção Aprimorada de Tumores Cerebrais
Neste artigo
Resumo
Resumo
Os tumores cerebrais são considerados uma das doenças mais letais do mundo, e o diagnóstico incorreto coloca em risco a vida dos pacientes e reduz a taxa de sobrevivência. A ressonância magnética (MRI) com técnicas baseadas em aprendizado profundo, especialmente redes neurais convolucionais, é fundamental para superar esse obstáculo, pois permite um exame mais detalhado da estrutura interna do cérebro e oferece capacidades excepcionais de aprendizado e predição. A necessidade de um diagnóstico preciso do tumor no cérebro ainda é significativa. Portanto, propõe-se um modelo aprimorado baseado em fusão de características (FusionNetX) que aproveita as forças de dois modelos pré-treinados, DenseNet121 e EfficientNetB7, utilizando hiperparâmetros personalizados de ajuste fino, incluindo camadas treináveis e não treináveis. O modelo proposto FusionNetX foi aplicado a cinco conjuntos de dados de tumores cerebrais disponíveis publicamente: Br35H, Figshare, Sartaj, Masoud e Balanced Brain Tumor. Algumas etapas de pré-processamento foram aplicadas para melhorar a qualidade da imagem e combater o sobreajuste por meio do redimensionamento e da ampliação dos dados. Utilizando diversas métricas de avaliação de desempenho, como acurácia, perda, valor preditivo positivo, valor preditivo negativo, taxa de verdadeiro positivo, taxa de verdadeiro negativo, pontuação F1, taxa de falso negativo e taxa de falso positivo, verificou-se que o modelo proposto FusionNetX obteve uma acurácia de 99,33% para o Br35H, 99,13% para o Figshare, 99,89% para o Masoud, 99,19% para o BBT-Dataset e 98,77% para o Sartaj. Além disso, os cinco conjuntos de dados de tumores cerebrais foram avaliados usando fusão tardia e fusão baseada em atenção para demonstrar a relevância do modelo proposto FusionNetX, e os resultados foram substancialmente melhores, com ganhos de 0,3% a 1,9% em todos os conjuntos de dados. Além disso, a curva característica de operação do receptor foi calculada, e os resultados de várias métricas de avaliação de desempenho indicam que o modelo proposto FusionNetX pode detectar e prever com precisão tumores cerebrais e auxiliar os profissionais de saúde a tomarem decisões oportunas.
Introdução
O câncer é a doença mais letal no corpo humano atualmente devido à sua gravidade e taxa crescente, enquanto múltiplas doenças cancerígenas, como tumores cerebrais, câncer de mama, nódulos pulmonares, câncer renal e outras, são encontradas no corpo humano, causando um aumento na taxa de mortalidade. O câncer se desenvolve quando células ou tecidos no corpo de uma pessoa se multiplicam de forma anormal. Quando o câncer metastatiza, pode danificar outros órgãos humanos e tornar-se mais perigoso1. Como o cérebro controla todas as funções corporais, qualquer dano a ele pode ter consequências amplas para todo o organismo. É por isso que tumores cerebrais ou câncer são tão letais para os seres humanos2. Além disso, tumores cerebrais benignos e malignos são as duas categorias principais nas quais eles se dividem. "Benigno" basicamente significa não canceroso; é apenas um problema no cérebro que pode ser corrigido alterando o ambiente ao redor. Mas no caso de malignidade, é considerado perigoso devido à sua natureza metastática, pela movimentação de células ou tecidos anormais para outras partes do corpo ou delas, perturbando também outros órgãos, aumentando a probabilidade de câncer no organismo3.
Além disso, de acordo com a American Brain Tumor Association e a Organização Mundial da Saúde (OMS), tumores hipofisários, meningiomas e gliomas são as três principais categorias de cânceres cerebrais4. Os gliomas se originam a partir de células gliais, que nutrem os neurônios no cérebro. Os tumores hipofisários começam na glândula pituitária, localizada na base do cérebro e responsável por diversas funções corporais; os tumores meningiomas, por outro lado, se originam nas meninges, que protegem as membranas que envolvem o cérebro e a medula espinhal. Além disso, várias modalidades de imagem médica são comumente utilizadas para examinar as partes internas do corpo com fins diagnósticos, incluindo raios X, tomografias computadorizadas (TC) e ressonância magnética (RM)5,6. Cada modalidade de imagem possui suas próprias vantagens e desvantagens. A RM é uma modalidade de imagem que fornece imagens detalhadas dos tecidos moles e células do corpo, especialmente no cérebro. O câncer envolve tecidos ou células anormais no organismo, e a RM fornece imagens detalhadas dessas anormalidades, tornando-a uma modalidade de imagem mais útil para o diagnóstico de tumores cerebrais ou câncer. Além disso, a RM é mais segura do que outras modalidades de imagem, pois não produz radiação nociva durante exames da anatomia interna do corpo.
Além disso, muitas metodologias computacionais também são empregadas para enfrentar os desafios diagnósticos associados aos tumores cerebrais, incluindo aprendizado de máquina (ML), processamento de imagens (IP) e aprendizado profundo (DL), sendo que cada abordagem é aplicada a imagens obtidas por modalidades de imagem para diagnosticar o câncer7. Essas abordagens aprendem os padrões e estruturas ocultos de diferentes objetos nas imagens para diagnosticar o câncer mediante a identificação de padrões na região afetada. Cada abordagem computacional possui vantagens e desvantagens próprias no processo de diagnóstico. As abordagens baseadas em ML e IP extraem características elaboradas manualmente, o que geralmente leva a previsões imprecisas e ao erro diagnóstico, especialmente em conjuntos de dados maiores8. Para superar os problemas relacionados à extração de características manuais, as pessoas estão migrando para modelos baseados em aprendizado profundo, comumente chamados de modelos baseados em redes neurais convolucionais (CNN), que aprendem e extraem automaticamente as melhores características das imagens para diagnosticar tumores com precisão. Atualmente, as abordagens baseadas em DL são amplamente utilizadas em imagens médicas para diagnosticar doenças no corpo humano, especialmente para detecção precoce e precisa de tumores cerebrais, câncer de mama, câncer de pulmão e outras doenças, devido à sua capacidade de aprender e extrair padrões complexos em dados de grande escala, produzindo resultados mais precisos9. O principal problema enfrentado em um modelo de DL é o consumo excessivo de recursos e amostragem de dados, o qual é superado por outra abordagem baseada em aprendizado profundo chamada aprendizado por transferência10 (TL), na qual modelos pré-treinados são utilizados para diagnosticar doenças, economizando tempo e recursos. O diagnóstico precoce e preciso de problemas de saúde é viabilizado por modelos pré-treinados, que já aprenderam características básicas relacionadas à textura, cor, bordas e outras a partir de um grande conjunto de dados. Esses modelos podem então ser transferidos para um novo conjunto de dados nunca antes visto, aproveitando o modelo e adicionando hiperparâmetros e camadas treináveis e não treináveis11. Uma quantidade significativa de pesquisa já foi realizada sobre a classificação de tumores cerebrais, e Tabela 112,13,14,15,16,17,18,19,20,21,22,23 apresenta os detalhes dessa pesquisa, incluindo as abordagens, conjuntos de dados e resultados. Ainda assim, nenhum estudo empregou uma metodologia que combine dois modelos de aprendizado por transferência para uma extração robusta de características e ajuste técnicas de regularização para garantir um treinamento e teste suaves. A avaliação aprofundada da metodologia proposta fornece insights sobre o desempenho do modelo em diferentes características de tumores cerebrais.
| Ref | Abordagem | Amostras de Dados | Resultados | Limitações |
| 12 | CNN personalizada | Br35H | Exatidão = 97,45%, | Ainda há necessidade de melhorias nos resultados; em vez de usar uma CNN desenvolvida internamente, é melhor utilizar um modelo CNN pré-existente com modificações. |
| Perda = 0,1141%, | ||||
| Recuperação = 98,09%, | ||||
| Pontuação F1 = 97,69%, | ||||
| Precisão = 97,29%, | ||||
| Br35H aumentado | Exatidão = 98,99%, | |||
| Precisão = 98,90%, | ||||
| Perda = 0,0570%, | ||||
| Recuperação = 98,91%, | ||||
| Pontuação F1 = 99,04% | ||||
| 13 | Modelo DNN de fusão de características | Br35H | Exatidão = 98,22%, | Ainda há necessidade de melhorias nos resultados, e em vez de usar um modelo personalizado, ainda é necessário utilizar um modelo pré-existente para fusão de características. |
| Taxa de Falsos Negativos = 1,77%, | ||||
| Sensibilidade = 98,2%, | ||||
| Pontuação F1 = 98%, | ||||
| Especificidade = 98%, | ||||
| Figshare | Exatidão = 98,01%, | |||
| Sensibilidade = 96,03%, | ||||
| Pontuação F1 = 96%, | ||||
| Especificidade = 98,67%, | ||||
| Taxa de Falsos Negativos = 3,96% | ||||
| 14 | AlexNet com SGD | Br35H | Exatidão = 98,79%, | Ainda há necessidade de algumas melhorias nos resultados, e também precisamos testar modelos baseados em CNN mais avançados em diferentes amostras de dados. |
| Taxa de Erro de Classificação = 1,20%, | ||||
| Sensibilidade = 98,98%, | ||||
| Especificidade = 98,58%, | ||||
| Pontuação F1 = 98,82% | ||||
| 15 | InceptionV3 | Figshare | Exatidão = 98,89%, | Os autores utilizaram o conjunto de dados Figshare, que possui três classes de tumores; em vez de classificá-los, eles classificam apenas a presença ou ausência de tumor, e ainda há necessidade de melhorias nos resultados, bem como na categorização das classes de tumor. |
| SensibilidadeB = 95,28%, | ||||
| SensibilidadeM = 94,47% | ||||
| 16 | ResNet50 otimizada | Figshare | Exatidão = 99,03%, | Outros parâmetros de avaliação de desempenho precisam ser calculados, com mais melhorias nos resultados. |
| Recuperação = 99%, | ||||
| Pontuação F1 = 99% | ||||
| 17 | Res-BRNet | Br35H | Exatidão = 98,22%, | Ainda há necessidade de melhorias nos resultados. |
| Sensibilidade = 98,11%, | ||||
| Precisão = 98,22%, | ||||
| Figshare | Pontuação F1 = 98,41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Exatidão = 99,18%, | Há uma pequena melhoria nos resultados e necessidade de testar mais conjuntos de dados relacionados a tumores cerebrais. |
| Recuperação = 99,11%, | ||||
| Pontuação F1 = 99,08, | ||||
| Precisão = 99,07%, | ||||
| Sartaj | Exatidão = 97,24%, | |||
| Recuperação = 97,58%, | ||||
| Pontuação F1 = 97,28%, | ||||
| Precisão = 97,06%, | ||||
| 19 | CNN-SVM | Brats | Exatidão = 98,02%, | Há necessidade de aplicar alguns modelos pré-existentes com SVM, e ainda há necessidade de melhorias nos resultados. |
| Pontuação F1 = 98,31%, | ||||
| Precisão = 98,09%, | ||||
| Sensibilidade = 98,53%, | ||||
| Especificidade = 97,30%, | ||||
| Sartaj | Exatidão = 96,83%, | |||
| Precisão = 95,36%, | ||||
| Sensibilidade = 94,73%, | ||||
| Especificidade = 97,56%, | ||||
| Pontuação F1 = 95% | ||||
| 20 | EfficientNetB3 com ajuste fino | Figshare | Exatidão = 98,70% | Há necessidade das variantes mencionadas anteriormente do EfficientNetB3 para melhorar os resultados. |
| Sartaj | Exatidão = 97,50% | |||
| 21 | InceptionV4 | Masoud | Exatidão = 98,7%, | São necessárias algumas melhorias nos resultados com o uso de mais conjuntos de dados. |
| Precisão = 99%, | ||||
| Sensibilidade = 98%, | ||||
| Especificidade = 99%, | ||||
| Pontuação F1 = 99,1% | ||||
| 22 | VGG16 | Masoud | Exatidão = 98% | Há necessidade de melhorias nos resultados com a avaliação de mais modelos de redes neurais profundas. |
| 23 | MFR-CNN | Masoud | Exatidão = 94%, | É uma arquitetura complexa utilizada nesta solução proposta. |
| Recuperação = 96%, | ||||
| Pontuação F1 = 96%, | ||||
| Precisão = 96%, |
Tabela 1: Uma análise comparativa dos trabalhos de pesquisa mais recentes. A tabela resume pesquisas existentes, juntamente com suas abordagens, amostras de dados, resultados e limitações. Clique aqui para baixar esta tabela.
Tabela 1 revisa as abordagens existentes, destacando suas limitações na melhoria dos resultados e a necessidade de utilizar modelos de DL pré-existentes ao avaliar seu desempenho em relação a diversos parâmetros estatísticos, tudo dentro de uma estrutura eficiente que apresenta melhor desempenho em diferentes conjuntos de dados de tumores cerebrais.
Objetivos do estudo e enunciado do problema
A interpretação manual é demorada e sofre com variabilidade interobservador; portanto, a categorização rápida e precisa de tipos de tumores cerebrais por meio de RNM é essencial para a tomada de decisões clínicas. A maioria das abordagens de aprendizado profundo (DL) para classificação automatizada de tumores cerebrais atualmente baseia-se em uma única rede principal ou em uma fusão simples no nível de decisão, o que não aproveita plenamente as representações de características complementares provenientes de múltiplas arquiteturas pré-treinadas, e muitas vezes são validadas apenas em um único conjunto de dados, o que limita a confiança em sua generalização.
Este projeto de pesquisa tem como objetivo desenvolver e fornecer um método completo e preciso para o diagnóstico de cânceres cerebrais em cérebros humanos, utilizando uma estrutura de aprendizado profundo de dupla base (EfficientNetB7 e DenseNet121) que aproveita representações de características complementares para permitir uma classificação robusta de tumores cerebrais a partir de ressonância magnética. Também avalia a robustez da estrutura em múltiplos conjuntos de dados públicos independentes. Esta abordagem pode ajudar radiologistas e paramédicos a diagnosticar tumores cerebrais de forma rápida e eficaz, salvando vidas ao permitir o reconhecimento e a classificação.
Para resolver um problema de pesquisa específico e alcançar os objetivos ou metas deste projeto de pesquisa, seguem-se as perguntas de pesquisa e a contribuição para abordar essas questões: 1) A fusão em nível de características (intermediária) de duas redes convolucionais pré-treinadas é melhor do que as técnicas de fusão em nível de decisão (tardia) e baseadas em atenção para a classificação de tumores cerebrais? 2) O sistema proposto fornecerá desempenho consistente de classificação em diversos conjuntos de dados de ressonância magnética de tumores cerebrais adquiridos independentemente?
O escopo deste estudo restringe-se à classificação em nível de imagem (corte de RM 2D), utilizando cinco conjuntos de dados de ressonância magnética de tumores cerebrais de acesso público (Br35H, Figshare, Sartaj, Masoud e BBT-Dataset); avaliados independentemente, sem comparação entre conjuntos de dados; e empregando a arquitetura específica, o pipeline de pré-processamento e a configuração experimental descritos na seção de metodologia. O estudo não inclui validação em nível de paciente nem testes em ambiente clínico de implantação.
As principais contribuições deste trabalho de pesquisa são as seguintes: 1) A contribuição primária deste trabalho de pesquisa é utilizar modelos pré-treinados duplos para uma melhor extração de características, incluindo DenseNet121 e EfficientNetb7 com hiperparâmetros otimizados. 2) Arquitetura inovadora de modelo com uma técnica avançada de regularização integrada às características concatenadas de um modelo pré-treinado duplo, garantindo desempenho robusto. 3) Uma estratégia eficaz de aumento de dados é aplicada para aumentar a diversidade das amostras de treinamento, permitindo aprender características mais genéricas e específicas, superando problemas de sobreajuste. 4) O desempenho do modelo proposto foi avaliado em cinco conjuntos de dados distintos e publicamente disponíveis de tumores cerebrais, com foco em diversos parâmetros estatísticos de avaliação, incluindo acurácia, taxa de erro de classificação, precisão, valor preditivo negativo, sensibilidade, especificidade, F1-Score, taxa de falso negativo e taxa de falso positivo.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
A doença mais grave do mundo é o tumor cerebral. Um diagnóstico preciso pode ser benéfico para a sobrevivência dos pacientes. Ainda assim, há necessidade de um sistema diagnóstico preciso capaz de detectar tumores cerebrais em estágio inicial. Para resolver esse problema, foi proposta uma técnica mais confiável para detecção precisa de tumores cerebrais em seus estágios iniciais, utilizando um mecanismo híbrido de aprendizado profundo duplo com hiperparâmetros otimizados e camadas ajustadas com base nos modelos DenseNet121 e EfficientNetB7. A abordagem proposta utiliza imagens de RM 2D como entrada e fornece como saída uma previsão de presença ou ausência de tumor para o conjunto de dados de classificação binária Br35H, e a categorização do tumor para outros quatro conjuntos de dados de classificação multiclasse. Assim, esta seção demonstra os principais passos da abordagem proposta, desde a coleta de dados até a saída final, incluindo aquisição de dados, pré-processamento de dados, divisão dos dados, seleção do modelo, extração de características, predição do tumor e avaliação do modelo proposto, conforme mostrado na Figura 1.
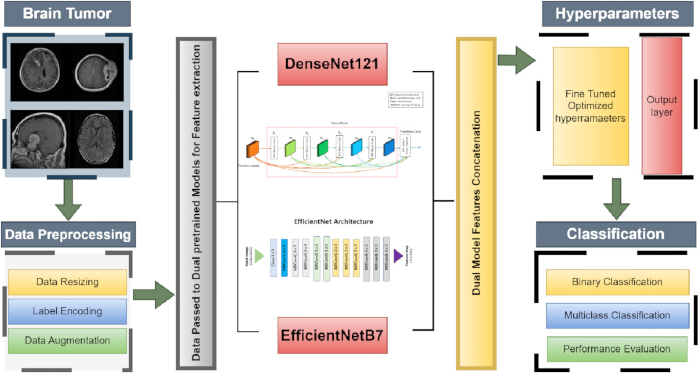
Figura 1: Fluxo da metodologia proposta. Este diagrama mostra a arquitetura geral do modelo proposto, incluindo aquisição e pré-processamento de dados; dois modelos pré-treinados para extração de características; concatenação de suas características; e ajuste fino de hiperparâmetros para classificação e tipo de tumor. Clique aqui para visualizar uma versão ampliada desta figura.
Aquisição de dados
Em qualquer pesquisa experimental, o primeiro passo é a aquisição de dados. Para isso, foram escolhidos cinco conjuntos de dados diferentes disponíveis publicamente, incluindo Br35H24, Figshare25, Sartaj26, Masoud27 e o conjunto de dados baseado em imagens de ressonância magnética de tumores cerebrais da biblioteca de código aberto Kaggle28, que já foram utilizados por muitos pesquisadores para o diagnóstico da detecção de tumores cerebrais. O conjunto de dados Br35H possui 3.000 imagens divididas em duas classes: imagens saudáveis e não saudáveis (com tumor), com 1.500 imagens em cada classe, enquanto o conjunto de dados Figshare possui 3.064 imagens, divididas em três grupos com base no tipo de tumor: 1.426 imagens de glioma, 708 imagens de meningioma e 930 imagens de tumores de hipófise. O conjunto de dados Sartaj possui 3.264 imagens categorizadas em quatro classes de tumores: gliomas (926 imagens), meningiomas (937 imagens), tumores de hipófise (901 imagens) e saudável ou sem tumor (500 imagens). Além disso, o conjunto de dados Masoud também compreende quatro classes diferentes de tumores, cujas imagens foram extraídas dos três conjuntos de dados mencionados anteriormente, totalizando 7.023 imagens, que são subdivididas em glioma (1.621 imagens), meningioma (1.645 imagens), hipófise (1.757 imagens) e saudável ou sem tumor (2.000 imagens). O último conjunto de dados escolhido é um conjunto baseado em imagens de ressonância magnética, que também possui quatro classes com um total de 5.248 imagens, divididas igualmente em tipos de tumores, incluindo 1.312 imagens de glioma, 1.312 imagens de meningioma, 1.312 imagens de hipófise e 1.312 imagens saudáveis ou sem tumor, sendo considerado um conjunto de dados balanceado.
Pré-processamento de dados
Após a aquisição dos dados, a próxima etapa é o pré-processamento, que é essencial para obter melhores resultados e mais útil para abordagens computacionais extraírem e aprenderem as melhores características dos dados, produzindo resultados mais precisos. O primeiro passo aplicado foi o redimensionamento das imagens. Foram escolhidos cinco conjuntos de dados publicamente disponíveis com diferentes classes e tamanhos de imagem, mesmo dentro do mesmo conjunto de dados, para diferentes classes de tumores, que foram uniformemente redimensionados para 224 x 224 para melhor interpretação e aprendizado do modelo. Além disso, foi aplicada a ampliação de dados (data augmentation) a todos os conjuntos de dados, gerando amostras adicionais a partir de diferentes ângulos, melhorando assim a extração de características e o aprendizado pelos modelos de aprendizado profundo (DL). Para isso, foi aplicado um intervalo de rotação de 7% a todas as imagens, girando-as até 7 graus. Além disso, foi aplicado um deslocamento aleatório de 5% a todas as imagens, horizontal e verticalmente, com um deslocamento de 5% na altura e largura em relação às imagens originais. Em seguida, as imagens foram ampliadas em 10% em relação às imagens originais e, finalmente, todas as imagens foram invertidas horizontal e verticalmente. A principal razão para realizar a ampliação de dados29 é superar o sobreajuste (overfitting) e melhorar a generalização dos modelos, treinando-os com várias versões transformadas das amostras de dados originais. Antes de dividir os conjuntos de dados em treinamento e validação, foi aplicada a codificação de rótulos (label encoding), o que é mais útil para calcular a perda (loss) durante o treinamento e a validação, além de tornar as amostras de dados mais adequadas para que os modelos processem corretamente os rótulos. Adicionalmente, o conjunto de dados foi particionado em conjuntos de treinamento e validação, com uma proporção de 80% para 20%30, respectivamente, e Tabela 2 mostra a distribuição geral das amostras de dados e suas proporções de treinamento e validação.
| Conjunto de dados | Classes de tumor | Total de imagens | Imagens de treinamento | Imagens de validação |
| Br35H | Saudável | 1500 | 1200 | 300 |
| Tumor | 1500 | 1200 | 300 | |
| Total de imagens | 3000 | 2400 | 600 | |
| Figshare | Glioma | 1426 | 1141 | 285 |
| Meningioma | 708 | 566 | 142 | |
| Hipófise | 930 | 744 | 186 | |
| Total de imagens | 3064 | 2451 | 613 | |
| Sartaj | Glioma | 926 | 741 | 185 |
| Meningioma | 937 | 749 | 188 | |
| Sem tumor | 500 | 400 | 100 | |
| Hipófise | 901 | 721 | 180 | |
| Total de imagens | 3264 | 2611 | 653 | |
| Masoud | Glioma | 1621 | 1297 | 324 |
| Meningioma | 1645 | 1316 | 329 | |
| Sem tumor | 2000 | 1600 | 400 | |
| Hipófise | 1757 | 1405 | 352 | |
| Total de imagens | 7023 | 5618 | 1405 | |
| Conjunto de dados equilibrado de tumores cerebrais (BBT-Dataset) | Glioma | 1312 | 1050 | 262 |
| Meningioma | 1312 | 1050 | 262 | |
| Sem tumor | 1312 | 1050 | 262 | |
| Hipófise | 1312 | 1050 | 262 | |
| Total de imagens | 5248 | 4200 | 1048 |
Tabela 2: Distribuição do conjunto de dados. A tabela apresenta estatísticas por classe sobre os totais, treinamento e contagens de imagens de validação em conjuntos de dados de tumores cerebrais.
O conjunto de dados Br35H consiste em 3000 imagens, sendo 2400 selecionadas para treinamento e 600 para validação. O conjunto de dados Figshare compreende 3064 imagens. Dentre todas as imagens, 2451 foram selecionadas para treinamento e as restantes 613 para validação. O conjunto de dados Sartaj possui um total de 3264 imagens, com 2611 utilizadas para treinamento e as restantes 653 para validação. O conjunto de dados Masoud possui um total de 7023 imagens; dessas, 5618 foram utilizadas para treinamento e as restantes 1405 para validação. O conjunto de dados BBT possui um total de 5248 imagens. Dentre o total de imagens, 4200 foram consideradas para fins de treinamento, enquanto as demais 1048 imagens foram consideradas para fins de validação. Além disso, Figura 2 abaixo ilustra as diversas imagens de tumores cerebrais.
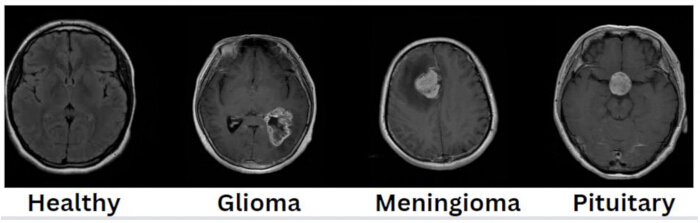
Figura 2: Imagens de tumores cerebrais, incluindo tipos de tumores. O conjunto de dados contém quatro imagens de tecido cerebral saudável e três imagens tumorais: glioma, meningioma e pituitário. Clique aqui para visualizar uma versão maior desta figura.
Modelo proposto
Após a etapa de pré-processamento, o próximo passo é sugerir um modelo de treinamento eficaz exclusivamente para a classificação de tumores cerebrais. Para isso, foi proposto um modelo eficiente de treinamento, especificamente voltado para classificar tumores cerebrais. Nesse sentido, propõe-se um novo modelo híbrido e eficiente baseado em fusão de características pré-treinado, incluindo DenseNet12131,32 e EfficientNetB733, os quais foram utilizados para extrair características das imagens; posteriormente, essas características extraídas foram concatenadas e encaminhadas a diferentes hiperparâmetros ajustados finamente, incluindo camadas treináveis e não treináveis, com o objetivo de diagnosticar tumores cerebrais com precisão, e foram implementadas em cinco conjuntos de dados diferentes de acesso público, os quais foram discutidos nas seções relacionadas acima. Além disso, o modelo DenseNet121 foi desenvolvido por Gao Huang e seus colaboradores em 2017 e possui 121 camadas. O objetivo principal desse modelo era concentrar-se na maximização do reuso de características e na prevenção do problema do gradiente que desaparece34. As camadas nesse modelo são organizadas em blocos densos, cada um contendo múltiplas camadas convolucionais que extraem e aprendem características. Cada camada recebe o mapa de características de todas as camadas anteriores como entrada, e sua saída é conectada às saídas dessas camadas e repassada como entrada para as camadas subsequentes no mesmo bloco, de maneira feed-forward. Além disso, camadas de transição são inseridas entre os blocos densos, sendo cada uma composta por uma camada convolucional 1 × 1, uma camada de Normalização em Lote (BatchNormalization) e camadas de agrupamento médio (pooling) 2 × 2, que reduzem o mapa de características para controlar a complexidade do modelo. Adicionalmente, uma camada final é acrescentada com função de ativação SoftMax (AF) antes de uma camada de agrupamento médio global para classificação. O design fundamental do modelo DenseNet121 é apresentado na Figura 334 abaixo.
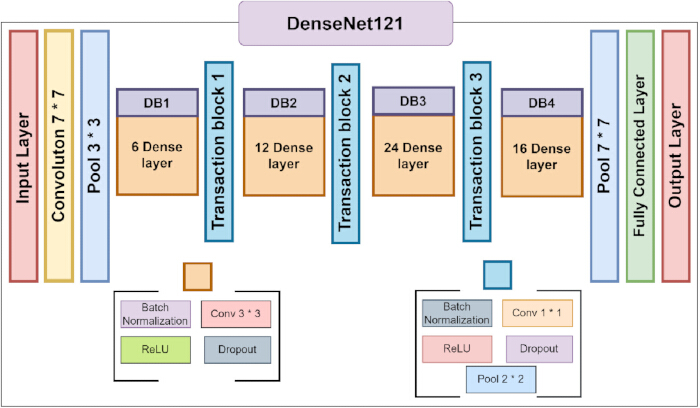
Figura 3: Detalhe da arquitetura DenseNet12134. Esta figura mostra o detalhe arquitetônico do modelo DenseNet121, incluindo todos os blocos densos e de transição. Clique aqui para visualizar uma versão maior desta figura.
Além disso, o modelo EfficientNetB7 foi criado por Tan e Lee em 2019. Ele pertence à família EfficientNet, com variantes de B0 a B7, e seu objetivo principal é superar outros modelos utilizando menos parâmetros e menor poder computacional. A largura do modelo (número de canais por camada), profundidade (número de camadas) e resolução podem ser ajustadas por meio da escala composta, que é a característica central do modelo. Além disso, este modelo é composto por blocos MBConv (convolução com inversão de bottleneck móvel), que possuem uma camada de expansão convolucional 1 × 1 responsável por expandir os canais, uma convolução separável por profundidade que aplica a convolução separadamente a cada canal e uma camada de projeção convolucional 1 × 1 que reduz o número de canais ao valor original. Ademais, cada bloco MBConv inclui blocos de Compressão e Excitação (Squeeze and Excitation, SE)35, que recalibram as características por canal, ajudando a rede a se concentrar nas mais importantes. Além disso, em vez da função sigmoide ou qualquer outra FA, utiliza-se a função Swish, que apresenta desempenho superior ao ReLU ao permitir valores negativos, o que auxilia no fluxo do gradiente. Além disso, uma camada de saída final é adicionada com uma FA SoftMax antes de uma camada de agrupamento por média global para fins de classificação. Figura 435 mostra o design básico do modelo EfficientNetB7, enquanto Figura 5 mostra a arquitetura recomendada do modelo.
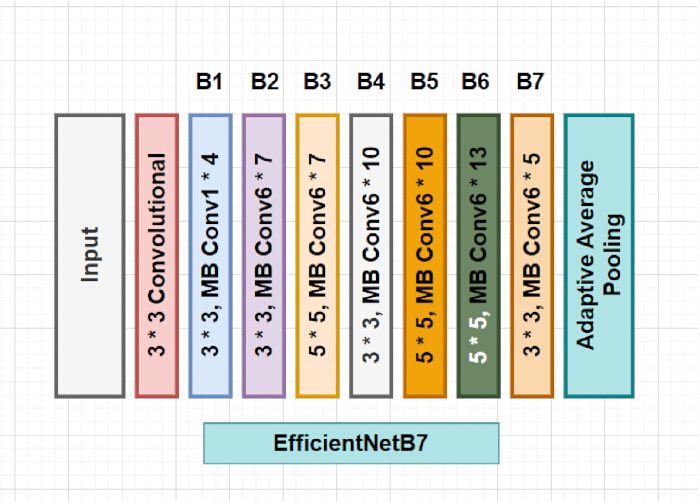
Figura 4: Detalhe arquitetônico do EfficientNetB735. Esta figura mostra o detalhe arquitetônico do modelo EfficientNetB7, incluindo todos os blocos convolucionais com inversão de gargalo móvel. Clique aqui para visualizar uma versão maior desta figura.
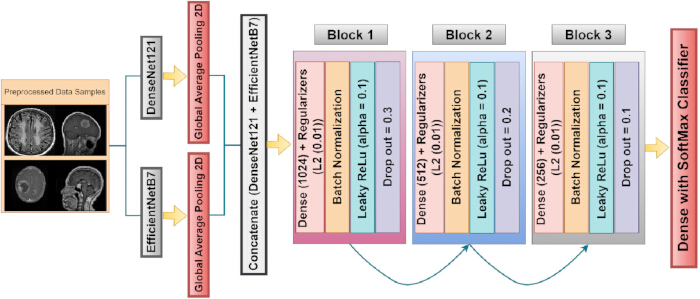
Figura 5: Arquitetura proposta do modelo híbrido fundido. A arquitetura proposta ilustra como imagens pré-processadas são encaminhadas para o extrator de características, que consiste em três blocos personalizados com diferentes hiperparâmetros, seguidos por uma camada de saída. Clique aqui para visualizar uma versão maior desta figura.
Além disso, primeiramente, características foram extraídas dos modelos pré-treinados DenseNet121 e EfficientNetB7. Os pesos atualizados dos modelos pré-treinados foram carregados nos modelos treinados, e as camadas base não treináveis dos modelos foram congeladas para impedir que o modelo fosse treinado novamente. Isso deve ajudar o modelo a manter seus melhores conhecimentos anteriores, adaptá-los à luz de novas amostras de dados para melhorar a convergência e concentrar-se nas camadas adicionais para treinar e extrair características avançadas. As equações 1 e 2 abaixo mostram o funcionamento dos modelos DenseNet121 e EfficientNetB7.
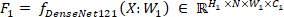 (1)
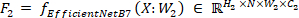 (2)
As equações 1 e 2 acima mostram o funcionamento do modelo pré-treinado em relação à extração de características; F1 denota os mapas de características de saída produzidos pelo modelo DenseNet121 pré-treinado e F2 denota os mapas de características de saída produzidos pelo modelo EfficientNetB7 pré-treinado mediante a aplicação de processamento às imagens de entrada, representadas por X. Além disso, W1 e W2 são os parâmetros ou pesos ajustáveis associados aos primeiros blocos e camadas dos modelos DenseNet121 e EfficientNetB7, respectivamente. Além disso, ∈ RN ×H1×W1×C1 e ∈ RN ×H2×W2×C2 representam a dimensionalidade dos mapas de características de saída dos modelos DenseNet121 e EfficientNetB7, respectivamente, com dimensões de H1 ×N×W1×C1 e H2 ×N×W2×C2, onde N representa o tamanho do lote de imagens, considerado como 16. Além disso, H1×W1 representa a altura e largura das imagens, respectivamente, para o modelo DenseNet121, e H2×W2 representa a altura e largura das imagens para o modelo EfficientNetB7, sendo selecionadas com tamanhos de altura e largura de 224 × 224. C1 e C2 representam o canal de cor para os modelos DenseNet121 e EfficientNetB7, respectivamente. Após obter os mapas de características de saída do modelo — 2560 canais do EfficientNetB7 e 1024 do DenseNet121 —, aplica-se a camada de agrupamento médio global 2D36 aos mapas de características de saída para reduzir a dimensão espacial, tomando a média de todas as dimensões espaciais em um único vetor, o que é mais conveniente para passar à próxima camada, permitindo melhor extração de características e reconhecimento de padrões em termos de características interpretáveis.
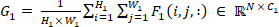 (3)
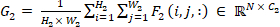 (4)
As equações 3 e 4 acima mostram o funcionamento da camada de agrupamento médio global 2D aplicada aos modelos DenseNet121 e EfficientNetB7, respectivamente, onde  e
 mostram o procedimento de normalização da soma, dividindo pelo número total de posições espaciais em ambos os modelos, garantindo que a saída agrupada seja uma média e não uma soma simples.
 e
 representam o somatório ao longo das dimensões espaciais dos mapas de características, enquanto i e j servem apenas para iterar sobre altura e largura, respectivamente, a fim de somar os mapas de características em ambos os modelos. Além disso, F1(i, j, :) e F2(i, j, :) representam os valores dos mapas de características em posições espaciais específicas (i, j) em todos os canais, para os modelos DenseNet121 e EfficientNetB7, respectivamente. Essa operação de agrupamento agrega informações espaciais em uma representação mais compacta e precisa, preservando as características mais importantes em cada imagem. Além disso, as saídas das camadas de agrupamento médio global são concatenadas para produzir um único vetor de características para cada amostra, o que é frequentemente usado para fundir características de diferentes modelos, melhorando o desempenho ao aproveitar os pontos fortes de ambos; a Equação 5 mostra como isso funciona.
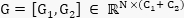 (5)
A equação acima 5 mostra o procedimento de concatenação de dois vetores de características de modelos diferentes [G1, G2], onde G1 representa o vetor de características do modelo DenseNet121 e G2 representa o vetor de características do modelo EfficientNetB7, enquanto a forma do vetor de características concatenado é representada por RN ×(C1+ C2), onde N é o tamanho do lote, que representa o número de amostras que prosseguem em paralelo, e (C1+ C2) é o número total de características obtidas dos modelos 1 e 2, respectivamente, cerca de 3584, que são processadas em paralelo, e o vetor de características de saída concatenado é representado por G. Além disso, três blocos diferentes foram adicionados para modificar o modelo fundido, a fim de extrair características mais complexas, melhorar a generalização e prevenir overfitting, apenas para obter resultados mais precisos e eficientes. Cada bloco é composto por uma camada densa com um número diferente de neurônios, sendo que o primeiro bloco possui 1024 neurônios em suas camadas densas, que se concentram em capturar uma ampla gama de características e padrões mais genéricos nos dados, enquanto o segundo bloco possui 512 neurônios em sua camada densa, que refinam especificamente as características, reduzindo a dimensionalidade e focando em padrões mais específicos. O terceiro bloco contém 256 neurônios em sua camada densa, que destilam ainda mais as características, garantindo que apenas as características e padrões mais relevantes sejam transmitidos à camada de saída para realizar uma tarefa mais pertinente. Além disso, abordagens de regularização L237 são adicionadas a cada camada densa em cada bloco para prevenir overfitting, penalizando pesos maiores, o que também torna o modelo mais complexo. Uma camada de dropout38 também é introduzida após cada bloco, com o objetivo de ignorar aleatoriamente 30%, 20% e 10% dos neurônios nos blocos 1, 2 e 3, respectivamente, o que força as redes a desenvolverem características mais robustas, que não dependem de um único neurônio. Além disso, para estabilizar o processo de treinamento, uma camada de BatchNormalization39 é aplicada após cada camada densa, o que garante que as ativações permaneçam dentro de uma faixa estável e também ajuda o modelo a evitar problemas como gradientes que desaparecem ou explodem durante a fase de treinamento. Adicionalmente, essa camada de BatchNormalization também acelera o processo de treinamento, permitindo que o modelo convirja mais rapidamente ao suavizar a paisagem de perda, o que facilita a obtenção de mínimos globais pelos otimizadores. Além disso, em cada bloco, para gerar não linearidade, é utilizada a ativação leaky ReLU40, que permite ao modelo aprender padrões complexos, e a leaky ReLU apresenta vantagens sobre outras funções de ativação, garantindo que o neurônio não fique inativo ao permitir um pequeno gradiente não nulo para entradas negativas. Além disso, a equação abaixo 6 mostra o funcionamento dos diferentes blocos integrados ao modelo híbrido fundido.
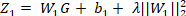 (6)
Após obter o vetor concatenado, G é processado pela camada densa do bloco 1 (totalmente conectada) com 1024 neurônios, onde a matriz de pesos W1 transforma o vetor de entrada G em um vetor de saída de 1024 dimensões, sendo cada elemento do vetor de saída uma combinação linear das características de entrada. Em seguida, o vetor de viés b1 é somado a cada um dos 1024 elementos do vetor de saída, o que permite ao modelo deslocar a saída das características de entrada de forma independente. Além disso, o termo de regularização L2: λ||W1||22 penaliza os pesos elevados, o que desencoraja o modelo a depender excessivamente de um único neurônio, ajudando assim a evitar o sobreajuste. Nesse contexto, a matriz de pesos de uma camada específica é W1 na rede neural, enquanto ||W1||22 denota a norma L2 quadrada da matriz de pesos W1 e λ é o parâmetro de regularização que controla o grau de regularização aplicado, sendo definido como 0,1 em todos os blocos. Z1 torna-se a nova representação de características após a aplicação da camada densa e da regularização L2 na entrada proveniente do vetor concatenado G, conforme mostrado na equação 6.
Após obter a saída da camada densa do bloco 1 como Z1, aplicou-se a camada de BatchNormalization, utilizada para acelerar o processo de treinamento, e a equação 7 abaixo mostra como ela funciona.
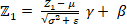 (7)
σ2 representa a variância da saída da última camada Z1 ao longo do lote, enquanto μ é a média da saída Z1, calculada separadamente para cada neurônio, que era 1024 na primeira camada densa. Já ε é uma constante pequena incorporada para garantir a estabilidade numérica e evitar a divisão por zero. A saída normalizada pode ser ajustada pelo modelo por meio do parâmetro escalável aprendível γ, enquanto a saída normalizada pode ser deslocada pelo parâmetro de deslocamento aprendível β. Por fim, após aplicar a camada de Normalização por Lote à saída da camada densa, a saída normalizada Z1 assegura que as ativações tenham uma distribuição consistente ao longo das diferentes camadas, o que ajuda a estabilizar e acelerar o treinamento. Após a Normalização por Lote, a saída normalizada Z1 passa pela função de ativação Leaky ReLU, que introduz não linearidade na rede, ajudando a aprender padrões complexos nos dados. Em vez de escolher ReLU ou outra função de ativação, optou-se pela Leaky ReLU, que é uma versão modificada da função ReLU e considera também pequenos valores negativos, em vez de torná-los zero como faz a função de ativação ReLU, superando assim o problema do "ReLU morto". A Equação 8 abaixo mostra como ela funciona.
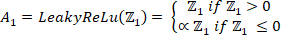 (8)
Onde Z1 pertence à saída da camada de Normalização por Lote, que é repassada à Leaky ReLU como entrada para executar a não linearidade, enquanto ∝ é uma constante pequena utilizada para determinar a inclinação da parte negativa da função. Além disso, A1 representa a saída obtida após a aplicação da não linearidade. Por fim, uma camada de dropout é aplicada à saída A1 recebida como entrada da ativação Leaky ReLU, conforme mostrado na equação 9.
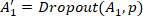 (9)
Onde A1 é a saída original da função de ativação recebida da última função de ativação ReLu, e onde p é a taxa de dropout, que varia entre 0 e 1 e foi definida como 0,3, 0,2 e 0,1 para três camadas de bloco, respectivamente, apenas para descartar uma fração dos neurônios. Além disso, A1′ mostra a saída modificada após a aplicação da camada de dropout, na qual alguns neurônios foram definidos como 0. A principal vantagem de utilizá-la é apenas prevenir problemas de overfitting, bem como reduzir a coadaptação. Adicionalmente, a saída do bloco1 A1′ é encaminhada para o próximo bloco novamente para extrair características ainda mais abstratas, aplicando-se os mesmos parâmetros usados no bloco 1, com algumas diferenças: 512 neurônios na camada densa em vez de 1024 e uma taxa de dropout de 0,2 em vez de 0,3; as demais sequências operacionais são as mesmas, conforme descrito nas equações 10 a 13 abaixo.
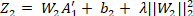 (10)
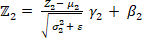 (11)
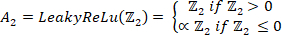 (12)
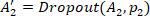 (13)
Após obter a saída do bloco 1 como A1′, que passa pela camada densa (totalmente conectada) do bloco 2 com 512 neurônios, onde a matriz de pesos W2 transforma o vetor de entrada A1′ em um vetor de saída de 512 dimensões, sendo cada elemento do vetor de saída uma combinação linear das características de entrada. Em seguida, o vetor de bias b2 é adicionado a cada um dos 512 elementos da saída, o que permite ao modelo deslocar a saída das características de entrada independentemente. Além disso, a regularização L2 também é aplicada, onde: λ||W2||22 penaliza os pesos elevados, servindo para mitigar o sobreajuste, impedindo que o modelo dependa excessivamente de qualquer neurônio específico neste bloco. Nesse contexto, W2 é a matriz de pesos de uma camada específica da rede neural, enquanto λ é o parâmetro de regularização que controla o grau de regularização aplicado, definido como 0,1. Z2 torna-se a nova representação de características após a aplicação da camada densa e da regularização L2 na entrada proveniente do bloco 1, conforme mostrado na equação 10.
Além disso, a camada de Normalização por Lote (BatchNormalization) foi aplicada à nova característica Z2, utilizada para acelerar o processo de treinamento, onde σ22 representa a variância ao longo do lote, enquanto μ2 é a média da saída Z2. Embora ε seja uma constante pequena incorporada para garantir a estabilidade numérica, γ é um parâmetro de escala ajustável que permite ao modelo modificar a saída normalizada, e β é um parâmetro de deslocamento ajustável que permite ao modelo transladar a saída normalizada. Finalmente, após a aplicação da camada de Normalização por Lote, conforme mostrado na equação 11, a saída normalizada Z2 passou pela função de ativação ReLU com vazamento (leaky ReLU AF), o que introduziu não linearidade na rede, conforme ilustrado na equação 12. Nesse contexto, Z2 corresponde à saída da camada de Normalização por Lote, que é fornecida como entrada à função Leaky ReLU para introduzir não linearidade. Enquanto isso, A2 representa a saída obtida após a aplicação da não linearidade.
Finalmente, uma camada de dropout é aplicada à saída A2 recebida como entrada da ativação Leaky ReLU, conforme mostrado na equação 13. Onde A2 é a saída recebida da última função de ativação ReLU, e onde p2 é a taxa de dropout, escolhida como 0,2 para este bloco, apenas para descartar uma fração dos neurônios. Além disso, A2′ representa a saída modificada após a aplicação da camada de dropout, na qual alguns neurônios foram definidos como 0. Em seguida, a saída do bloco 2, A2′, é enviada ao terceiro bloco novamente para extrair características ainda mais abstratas, aplicando-se os mesmos parâmetros utilizados no bloco 2, com algumas diferenças: 256 neurônios na camada densa em vez de 512 e uma taxa de dropout de 0,1 em vez de 0,2; as demais sequências operacionais são iguais, conforme descrito nas equações abaixo, de 14 a 17.
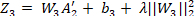 (14)
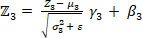 (15)
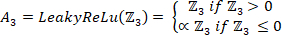 (16)
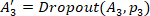 (17)
Após obter a saída do bloco 2 como A2′, que é passada pela camada densa (totalmente conectada) do bloco 3 com 256 neurônios, onde a matriz de pesos W3 transforma o vetor de entrada A2′ em um vetor de saída de 256 dimensões, e cada elemento no vetor de saída é uma combinação linear das características de entrada. Em seguida, o vetor de viés b3 é adicionado a cada um dos 256 elementos na saída, o que permite ao modelo deslocar a saída das características de entrada de forma independente. Além disso, a regularização L2 também é aplicada, onde: λ||W3||22 penaliza os pesos elevados, o que desencoraja o modelo a depender excessivamente de um único neurônio, ajudando assim a evitar o sobreajuste. Nesse contexto, W3 é a matriz de pesos de uma camada específica na rede neural, enquanto o grau de regularização empregado é controlado pelo parâmetro de regularização λ, que foi definido como 0,01. Z3 torna-se a nova representação de características após a aplicação da camada densa, bem como da regularização L2, na entrada proveniente do bloco 3, conforme mostrado na equação 14.
Além disso, a camada de Normalização por Lote foi aplicada à nova característica Z3, utilizada para acelerar o processo de treinamento, em que σ32 representa a variância ao longo do lote, enquanto μ3 é a média da saída Z3. O valor ε é uma constante pequena adicionada para garantir a estabilidade numérica. A saída normalizada pode ser ajustada pelo modelo utilizando o parâmetro de escala aprendível γ3 e deslocada utilizando o parâmetro de deslocamento aprendível β3. Por fim, após a aplicação da camada de Normalização por Lote, conforme mostrado na equação 15, a saída normalizada Z3 passa pela função de ativação ReLU com vazamento (leaky ReLU), que introduz não linearidade na rede, conforme mostrado na equação 16. Nesse caso, Z3 corresponde à saída da camada de Normalização por Lote, que é fornecida como entrada à função Leaky ReLU para introduzir a não linearidade. Já A3 representa a saída obtida após a aplicação da não linearidade.
Finalmente, uma camada de dropout é aplicada à saída A3 recebida como entrada da ativação Leaky ReLU, conforme mostrado na equação 17. Em que A3 é a saída recebida da última função de ativação ReLU, e em que p3 é a taxa de dropout, escolhida como 0,1 para este bloco, com o objetivo de descartar uma fração dos neurônios. Além disso, A3′ representa a saída modificada após a aplicação da camada de dropout, na qual alguns neurônios foram definidos como 0.
Além disso, a saída do bloco 3 A3′ passa pela última camada densa para fins de classificação, com um número K de neurônios que representa o número real de classes no conjunto de dados, conforme descrito na equação 18 abaixo.
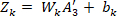 (18)
A matriz de pesos associada à camada densa é Wk, responsável por transformar o vetor de 256 dimensões A3′ em um vetor de k dimensões, que representa as características aprendidas no bloco anterior e é gerado como saída. Além disso, bk representa o vetor de viés que ajusta a predição para garantir que a função de ativação tenha uma saída diferente de zero quando a entrada for zero, e Zk é a saída da camada final antes da aplicação da função de ativação, gerando os logits para cada classe; por fim, foi aplicado o classificador SoftMax41, que converte o logit Zk na probabilidade de cada classe, conforme mostrado nas equações 19 e 20.
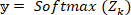 (19)
 (20)
Onde a probabilidade prevista da classe iésima é representada por yi, K é o número de classes, enquanto Zk, i é o logito para a classe iésima, e eZk, i é a exponencial do logito da classe iésima. y mostra a distribuição de probabilidade de todas as classes possíveis e garante que a soma das probabilidades seja 1. A Tabela 3 abaixo fornece os detalhes dos hiperparâmetros utilizados para treinar o modelo híbrido proposto, incluindo os detalhes arquiteturais adotados para melhorar a reprodutibilidade e o desempenho.
| Parâmetros Hyper | Modelo Proposto (FusionNetX) |
| Tamanho da imagem | 224 × 224 |
| Arquitetura do Backbone | EfficientNetB7 e DenseNet121 pré-treinados como BBA1 e BBA2 |
| Aumento de dados | Intervalo de rotação = 7, |
| Intervalo de deslocamento de largura/altura até 0,05, | |
| Intervalo de zoom até 0,01, | |
| Inversão horizontal/vertical | |
| Razão de divisão dos dados | 80% para treinamento e 20% para validação com amostragem estratificada e randome_state fixo = 42 |
| Extração e fusão de características | Aplica-se o agrupamento médio global na saída de cada backbone: 2560 para BBA1 e 1024 para BBA2, fundidos para obter vetores de características conjuntas de 3584. |
| Composição do bloco totalmente conectado | 3 blocos totalmente conectados com 1 camada de saída. Cada bloco contém regularização L2 (λ=0,01), Normalização por Lote, LeakyReLU (α=0,01), Dropout de (0,3, 0,2 e 0,1) e dimensão oculta de (1024, 512, 256), respectivamente. Nenhuma conexão Skip adicional introduzida no cabeçote de fusão |
| Função de ativação | Leaky ReLU & SoftMax |
| Otimizador e taxa de aprendizado | Adam com taxa de aprendizado fixa de 0,00001, sem agendador de taxa de aprendizado. |
| Função de perda | sparse_categorical_crossentropy |
| Tamanho do lote | 16 |
| Épocas | 100 épocas fixas para cada conjunto de dados |
| Plataforma utilizada | Caderno Kaggle com GPU P100 e 16 GB de VRAM, utilizando as plataformas TensorFlow e Keras. |
Tabela 3: Hiperparâmetros utilizados para treinar o modelo proposto e detalhes arquiteturais propostos. Esta tabela fornece os detalhes estruturais e arquiteturais do modelo proposto, juntamente com os parâmetros ajustados e o ambiente de implementação.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Esta parte detalha os resultados dos testes do modelo proposto de fusão de características duplas em cinco conjuntos de dados de código aberto sobre cânceres cerebrais, incluindo os conjuntos de dados Br35H, Figshare, Sartaj, Masoud e Balanced Brain Tumor, e seu desempenho é avaliado com base em diferentes parâmetros estatísticos de avaliação de desempenho, incluindo acurácia42,43,44, taxa de classificação incorreta (MCR)
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Concluiu-se que o modelo proposto funcionou da seguinte maneira: primeiro, o tamanho da imagem foi definido como 224 × 224, um tamanho moderado que permite a qualquer modelo de aprendizado profundo extrair e aprender características adequadas das amostras de dados, mantendo todas as informações importantes. Em seguida, foi realizada a ampliação dos dados (data augmentation), o que é mais benéfico para diversificar as amostras em múltiplas direções, desempenhando um papel importante na capacidade do modelo de extrair cara...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm nada a declarar e não possuem conflito de interesses. Além disso, nenhuma ferramenta de IA foi utilizada para gerar o manuscrito ou as figuras.
Agradecimentos
Os autores agradecem o apoio fornecido pelo Projeto de Apoio aos Pesquisadores da Universidade Princess Nourah bint Abdulrahman (PNURSP2026R192), Universidade Princess Nourah bint Abdulrahman, Riade, Arábia Saudita. Os autores também agradecem aos participantes da pesquisa e às instituições que contribuíram para este estudo.
Financiamento:
Este trabalho foi apoiado pela concessão da National Research Foundation da Coreia (NRF), financiada pelo governo da Coreia (MSIT) (nº RS-2023-00218176) e pelo Fundo de Pesquisa da Universidade Soonchunhyang. Projeto de Apoio aos Pesquisadores da Universidade Princess Nourah bint Abdulrahman (PNURSP2026R192), Universidade Princess Nourah bint Abdulrahman, Riade, Arábia Saudita.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Conjunto de Dados de Tumor Cerebral Br35H | Kaggle (colaborador do conjunto de dados) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Conjunto de dados público; classificação binária (tumor / sem tumor) 300 imagens de RM |
| Conjunto de Dados de Tumor Cerebral Figshare | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Conjunto de dados público; multiclasse (glioma, meningioma, tumor pituitário) 3064 imagens de RM |
| Conjunto de Dados de Classificação de Tumor Cerebral Sartaj | Kaggle (conjunto de dados por Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | Conjunto de dados público; multiclasse (glioma, meningioma, sem tumor, tumor pituitário) 3264 imagens de RM |
| Conjunto de Dados de RM de Tumor Cerebral Masoud | Kaggle (conjunto de dados por Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | Conjunto de dados público; multiclasse (glioma, meningioma, sem tumor, tumor pituitário) 7023 imagens de RM |
| BBT-Conjunto de Dados (Conjunto de Dados de Tumor Cerebral) | Kaggle (colaborador do conjunto de dados) | https://doi.org/10.34740/kaggle/dsv/6758053 | Conjunto de dados público; tumor cerebral multiclasse balanceado, 5248 imagens de RM |
| Python | Python Software Foundation | https://www.python.org | Linguagem de programação, versão 3.10.13 |
| TensorFlow / Keras | Google / desenvolvedores do TensorFlow | https://www.tensorflow.org | Framework de aprendizado profundo; construção, treinamento e avaliação de modelos, versão 2.15.0 |
| EfficientNetB7 (pré-treinado) | Google / Aplicações Keras | https://keras.io/api/applications/efficientnet/ | Backbone pré-treinado no ImageNet; extração de características |
| DenseNet121 (pré-treinado) | Aplicações Keras | https://keras.io/api/applications/densenet/ | Backbone pré-treinado no ImageNet; extração de características |
| scikit-learn | desenvolvedores do scikit-learn (NumFOCUS) | https://scikit-learn.org | Codificação de rótulos, divisão treino-teste, métricas de avaliação (relatório de classificação, matriz de confusão, ROC/AUC) |
| OpenCV (cv2) | equipe OpenCV | https://opencv.org | Carregamento e redimensionamento de imagens |
| NumPy | desenvolvedores do NumPy (NumFOCUS) | https://numpy.org | Computação numérica e operações com arrays |
| pandas | equipe de desenvolvimento do pandas (NumFOCUS) | https://pandas.pydata.org | Organização de dados e tabulação de métricas |
Referências
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.