Este artigo apresenta um fluxo de trabalho computacional supervisionado por humanos para examinar representações recorrentes de mulheres em 433 pinturas chinesas de exportação do período Qing. Sete categorias de referência humana e pistas visuais recorrentes caracterizam os padrões dentro do corpus, enquanto os resultados permanecem limitados às imagens amostradas e não medem a realidade social ou a recepção histórica do período Qing.
Artigo de investigação
Identidade Feminina e Imaginação de Classe nas Pinturas de Exportação Chinesas da Dinastia Qing: Um Estudo de Interpretação Transcultural Assistido por Inteligência Artificial
Neste artigo
Resumo
Resumo
Este estudo analisou representações recorrentes de identidade feminina e pistas visuais codificadas por classe em um corpus de 433 pinturas chinesas de exportação da dinastia Qing, datadas entre 1757 e 1911. O fluxo de trabalho combinou o CLIP ViT-B/32 para rotulagem preliminar, localização assistida pelo Segment Anything Model (SAM), redução de dimensionalidade e agrupamento em clusters, além de codificação iconográfica manual realizada por dois codificadores independentes. Os rótulos do CLIP foram utilizados para organização inicial, o SAM atuou como auxílio na localização, e a codificação humana consensual forneceu as categorias de referência. Os resultados agregados identificaram sete categorias com referência humana: elite/beleza (n = 112), trabalho (n = 72), doméstica (n = 64), servente (n = 58), ritual/casamento (n = 45), mercado (n = 43) e artística (n = 39). Os rótulos computacionais preliminares coincidiram com os rótulos de referência humana em 356 das 433 pinturas (82,2%), com índices de revocação no nível das categorias variando de 73,3% a 88,4%. Combinações recorrentes de vestuário, cenário espacial, objetos, postura e relações sociais retratadas foram utilizadas para caracterizar os perfis visuais dessas categorias. A avaliação dos 433 pares de rótulos IA–humano por caso gerou escores abrangentes de precisão, revocação e F1 em nível de categoria, juntamente com uma matriz de confusão detalhando os padrões de classificação. A validação dos clusters apoiou a solução de agrupamento selecionada e demonstrou correspondência entre os clusters derivados e as categorias de referência definidas por humanos. No geral, combinações recorrentes de vestuário, cenário espacial, objetos, postura e relações sociais indicam tipologias pictóricas padronizadas dentro do corpus amostrado. Esses achados caracterizam a representação visual em pinturas chinesas de exportação da dinastia Qing, mas não devem ser interpretados como medidas diretas de status legal, experiências vividas, demanda de mercado ou recepção histórica por estrangeiros.
Introdução
As pinturas chinesas de exportação da dinastia Qing fizeram parte das redes comerciais e culturais que ligavam Cantão e outros centros colecionadores a compradores euro-americanos a partir do final do século XVIII1,2,3,4,5. Mercadores, viajantes, diplomatas, missionários e colecionadores adquiriram essas pinturas como bens portáteis, lembranças, fontes de informação visual e representações de lugares, profissões, processos produtivos, costumes e tipos sociais. Assim, sua circulação refletiu tanto as práticas de oficinas chinesas quanto as expectativas dos mercados externos.
A demanda estrangeira favorecia assuntos reconhecíveis, formatos seriados, motivos repetidos e cenas que podiam ser coletadas e comparadas. Os ateliês adaptavam o suporte, a escala, a composição e o tema para a venda, enquanto os compradores muitas vezes preferiam representações legíveis de ofícios, cerimônias, interiores, jardins, ruas e tipos sociais pitorescos. Versões repetidas de cenas de ateliês de Cantão demonstram ainda mais como artistas e assistentes adaptavam a iconografia e os recursos pictóricos ocidentais para clientes no exterior1,2,3,4,5. Embora a demanda do mercado possa ter influenciado o que foi produzido e preservado, o corpus atual não mede diretamente as preferências ou respostas individuais dos compradores.
Essas pinturas devem, portanto, ser consideradas fontes seletivas e mediadas, e não registros abrangentes da vida cotidiana. Suas cenas podem idealizar, simplificar, padronizar ou adaptar práticas sociais por meio de convenções de oficina, seleção de mercado, aquisição por museus, catalogação e digitalização1,2,3,4,5. A interpretação histórica deve distinguir características diretamente observáveis nas pinturas de inferências sobre os indivíduos representados, as condições de produção e os significados que espectadores posteriores atribuíram às obras.
As figuras femininas oferecem um meio focado para examinar essa distinção. Roupas, penteados, postura, cenário espacial, objetos, atividades e relações com outras figuras podem organizar as mulheres em papéis visualmente recorrentes, incluindo categorias de elite/beleza, doméstica, servidora, trabalhadora, de mercado, artística e ritual/nupcial. Essas categorias são descrições analíticas de padrões pictóricos e, por si só, não estabelecem patente legal, riqueza, ocupação, etnia, filiação a Banner ou Han, caráter moral ou identidade vivida.
A história da arte digital e a visão computacional podem facilitar comparações em larga escala de coleções visuais digitalizadas, ao mesmo tempo que permitem a análise crítica das suposições incorporadas nos modelos computacionais6,7. Modelos de visão e linguagem podem auxiliar na identificação e organização de motivos visuais recorrentes, embora o viés cultural permaneça uma limitação importante quando vocabulários contemporâneos de modelos são aplicados a imagens históricas não ocidentais8. Pesquisas computacionais relacionadas sobre pintura tradicional chinesa demonstram igualmente o valor de combinar a detecção quantitativa de padrões com interpretações informadas historicamente9.
Este estudo aborda três perguntas: (1) Quais categorias de identidade feminina codificadas por humanos e julgadas estão representadas no corpus? (2) Quais combinações de vestuário, cenário espacial, objetos, postura e relações sociais caracterizam essas categorias? (3) Como a precisão geral de correspondência exata e a recordação em nível de categoria variam entre as sete categorias? O fluxo de trabalho baseia-se em abordagens computacionais para pintura tradicional chinesa9, limitando ao mesmo tempo suas afirmações históricas às imagens amostradas e às análises documentadas.
A contribuição pretendida é tanto historiográfica quanto técnica. A comparação em escala de corpus pode identificar fórmulas pictóricas recorrentes que, posteriormente, podem ser contextualizadas por meio de análise histórica detalhada. Essa abordagem pode orientar pesquisas sobre gênero, hierarquia, representações da vida cotidiana e encontros interculturais, sem tratar a frequência de imagens como evidência de prevalência social ou a semelhança visual como prova de identidade histórica.
Protocolo
Desenho do estudo e unidade analítica
Cada pintura ou registro catalográfico foi tratado como uma unidade analítica. Utilizou-se um desenho observacional baseado em corpus, combinando revisão de metadados, organização computacional preliminar, codificação manual independente e interpretação histórico-artística. O período do estudo foi definido como 1757–1911, e os critérios de inclusão e exclusão foram aplicados dentro desse intervalo. Obras de arte históricas e seus metadados catalográficos associados foram analisados. Quando foram comparadas distribuições ao longo de intervalos de datas de duração desigual, as contagens foram normalizadas pela duração do intervalo, considerando-se potenciais vieses de sobrevivência e aquisição na interpretação.
Construção e seleção do corpus
Os registros candidatos foram recuperados dos catálogos de museus citados, arquivos digitais e catálogos publicados. Para cada registro candidato, foram mantidos a instituição, título, data ou período, suporte, número de aquisição ou catálogo, URL estável da fonte, data de recuperação e declaração de direitos. Os links de origem foram preservados mesmo quando o arquivo de imagem correspondente não podia ser redistribuído legalmente. O procedimento de triagem relatado iniciou-se com 612 imagens candidatas. Desses, 85 foram excluídos por estarem fora do período de 1757–1911 ou da tradição das pinturas de exportação, 58 foram excluídos por serem reproduções modernas, registros desfocados ou retratarem temas incorretos, 29 foram excluídos por não apresentarem uma figura feminina identificável ou por terem resolução de imagem inadequada, e 7 foram excluídos por apresentarem metadados insuficientes. O corpus analítico final compreendeu 433 registros.
Padronização de metadados e pré-processamento de imagens
Cada pintura no corpus analítico final recebeu um identificador QEP estável, variando de QEP_001 a QEP_433. Os metadados do museu associados foram mantidos, incluindo instituição, número de registro, título, data, técnica ou materiais, local de origem, link de origem e descrição de catálogo disponível. Para análise visual, foram registrados a classificação preliminar por IA, a categoria humana validada, o número de figuras femininas, grupo etário, postura, vestuário, cenário espacial, objetos associados e relações sociais. Cada pintura foi classificada em uma das sete categorias principais: elite/beleza, doméstica, servidão, trabalho, mercado, atuação ou ritual/casamento. Em cenas com múltiplas figuras femininas, a figura focal foi identificada com base na proeminência visual e centralidade narrativa. Quando nenhuma figura feminina era predominante, a categoria principal foi definida com base na atividade principal retratada e no contexto geral da cena. Categorias sobrepostas foram resolvidas priorizando a atividade retratada e o contexto da cena em vez do vestuário ou aparência isoladamente. Casos ambíguos foram revisados independentemente por ambos os codificadores e resolvidos por consenso. As imagens originais foram salvas nos formatos JPEG ou PNG. Apenas bordas de páginas, molduras de catálogo ou margens sem imagem foram recortadas. O conteúdo pictórico não foi reconstruído, recolorido, melhorado ou restaurado.
Rotulagem preliminar baseada em CLIP
O codificador de imagens CLIP ViT-B/32 foi utilizado para análise preliminar de similaridade entre imagem e texto9. Os termos candidatos de identidade incluíram mulher elite, mulher doméstica, empregada doméstica, mulher trabalhadora, mulher do mercado, mulher artista, noiva e mulher ritualística. Os termos de cena incluíram interior chinês, jardim, mercado de rua, oficina, produção de chá, trabalho têxtil e cena cerimonial. O conjunto completo de modelos de prompts, sua ordem, qualquer agrupamento de prompts, procedimentos de normalização de texto, regras de decisão, pontuações de confiança e empates foram mantidos para cada imagem.
A lista completa de prompts foi aplicada de forma consistente a todas as imagens utilizando o modelo OpenAI CLIP ViT-B/32 implementado em Python 3.10 com PyTorch 2.0.1 e o pacote OpenAI CLIP. A inferência foi realizada em uma GPU com suporte a CUDA, com tamanho de lote de 32, usando precisão FP32. Cada imagem foi redimensionada e recortada no centro para 224 × 224 pixels, e os canais RGB foram normalizados usando a transformação de pré-processamento associada ao modelo ViT-B/32. Os prompts de texto foram construídos utilizando os descritores de identidade e de cena definidos acima e codificados com o codificador de texto do CLIP. A similaridade cosseno foi calculada entre os embeddings normalizados de imagem e texto, e o prompt com a maior pontuação de similaridade foi atribuído como rótulo preliminar de IA. As pontuações de similaridade para todos os rótulos candidatos foram mantidas para revisão humana subsequente. Uma semente aleatória fixa de 42 foi utilizada, e procedimentos idênticos de pré-processamento, modelos de prompts e regras de decisão foram aplicados a todas as 433 pinturas.
Localização assistida por SAM
O Modelo de Segmentação Universal (SAM) foi utilizado estritamente para localizar figuras, vestuários, móveis, ferramentas, objetos rituais e regiões arquitetônicas para inspeção visual humana. É fundamental enfatizar que o SAM não participou do processo de classificação; suas máscaras, recortes e características derivadas foram isolados dos processos de rotulagem e agrupamento do CLIP, garantindo que a aplicação do SAM fornecesse apenas auxílios de localização sem influenciar ou inflar o desempenho da classificação.
Sugestões manuais de pontos ou caixas delimitadoras foram aplicadas quando necessário para refinar a localização de elementos visuais. Máscaras SAM foram geradas para figuras femininas, vestuários, móveis, ferramentas, objetos rituais e elementos arquitetônicos, e cada resultado de segmentação foi inspecionado visualmente quanto à cobertura regional adequada. As máscaras resultantes auxiliaram na identificação e revisão de características iconográficas relevantes, mas não foram utilizadas para rotulagem CLIP ou atribuição de categorias.
Redução de dimensionalidade e agrupamento
Os embeddings de imagens CLIP foram calculados, e o UMAP com distância cosseno foi utilizado para visualização bidimensional10. A representação usada para agrupamento, juntamente com seu procedimento de pré-processamento, dimensionalidade e definição de distância, foi registrada.
Aplicaram-se agrupamentos por K-médias e hierárquico às representações baseadas em características visuais para identificar agrupamentos recorrentes dentro do corpus11. Avaliaram-se soluções candidatas do K-médias para k = 5–9 utilizando o coeficiente de silhueta e o índice de Davies–Bouldin. Utilizou-se inicialização K-médias++ com n_init = 10, max_iter = 300, tol = 1 × 10⁻4 e random_state = 42. Realizou-se o agrupamento hierárquico utilizando agrupamento aglomerativo com ligação média e distância cosseno. Compararam-se as soluções candidatas utilizando índices quantitativos de validação, estabilidade dos agrupamentos e interpretabilidade sob a perspectiva da história da arte, selecionando-se a solução final de agrupamento por apresentar a representação mais coerente dos padrões visuais recorrentes. A atribuição final de agrupamentos para cada uma das 433 pinturas foi mantida para comparações posteriores com as categorias codificadas por humanos.
Codificação manual, treinamento e adjudicação
Dois codificadores revisaram independentemente todas as 433 imagens utilizando um manual de codificação versionado que abrangia categoria principal, quantidade de figuras, grupo etário, postura, vestuário, cenário espacial, objetos e relações sociais. Os registros específicos de cada codificador foram mantidos antes da adjudicação. Os codificadores tinham formações relevantes em história da arte e análise visual e foram treinados com o manual de codificação padronizado e exemplos representativos do corpus de pinturas. Antes da codificação formal, eles realizaram um exercício de calibração envolvendo 30 pinturas para promover a interpretação consistente das sete categorias de identidade e das cinco dimensões de indicadores visuais.
Durante a codificação formal, ambos os codificadores avaliaram independentemente todas as pinturas elegíveis, permanecendo cegos às decisões de codificação um do outro, bem como aos rótulos preliminares da IA e às atribuições de agrupamento. A confiabilidade entre codificadores foi avaliada utilizando o kappa de Cohen. O valor de kappa observado para a categoria principal de identidade foi de 0,88, e as variáveis categóricas de pistas visuais variaram de 0,79 a 0,92, demonstrando forte concordância entre os codificadores. Os desacordos foram resolvidos por meio de discussão e consenso, e as categorias adjudicadas e os códigos de pistas visuais foram registrados para análises posteriores12. Os rótulos pré-adjudicação foram mantidos.
Concordância entre IA e humano e estimativa de desempenho
A categoria humana adjudicada foi usada como referência para comparação descritiva com uma etiqueta preliminar de IA por pintura. A acurácia geral de correspondência exata foi calculada como 356/433 (82,2%). A recordação por categoria foi calculada como o número de correspondências exatas entre IA e humano dividido pelo suporte da referência humana para cada categoria. O suporte por categoria, correspondências exatas, discrepâncias e os respectivos denominadores foram relatados explicitamente.
Com base nas 433 etiquetas pareadas em nível de caso, de IA e humanas, foram calculados os falsos positivos da classe-alvo, além das pontuações de precisão, revocação e F1 por categoria. Uma matriz de confusão completa foi construída para analisar os padrões de classificação fora da diagonal, o que posteriormente orientou a revisão de discrepâncias, a documentação da taxonomia de erros e as regras de arbitragem.
Pacote e materiais de reprodutibilidade
O fluxo de trabalho computacional e os materiais de pesquisa complementares foram organizados em um repositório com controle de versão. O pacote de reprodutibilidade foi projetado para incluir scripts para pré-processamento, análise de CLIP, localização de SAM, UMAP, agrupamento, análise de concordância e geração de figuras, juntamente com o código de codificação manual, arquivos de configuração, informações sobre dependências, resultados derivados por caso e um inventário legível por máquina das fontes de imagens e informações sobre direitos. Um identificador persistente foi atribuído aos materiais de pesquisa arquivados para facilitar a reprodutibilidade e o reuso.
O Microsoft Excel 2021 foi utilizado para organizar e gerenciar os metadados. As análises computacionais utilizaram o CLIP ViT-B/32 para rotulagem preliminar visão-linguagem, o SAM para localização de elementos visuais, o UMAP com distância cosseno para redução de dimensionalidade e os métodos de agrupamento K-médias e agrupamento hierárquico para análise exploratória de padrões. As soluções de agrupamento foram avaliadas utilizando o coeficiente de silhueta e o índice de Davies–Bouldin, e a concordância entre codificadores foi avaliada usando o kappa de Cohen. O ambiente de software, as configurações dos modelos, as configurações computacionais e as sementes aleatórias utilizadas em todo o fluxo de trabalho foram documentadas para apoiar a reprodutibilidade.
Resultados
Construção do corpus e composição descritiva
Figura 1 apresenta a visão geral em quatro painéis do corpus. Figura 1A mostra o processo de triagem relatado, desde 612 registros candidatos até 433 registros mantidos. Figura 1B exibe exemplos representativos de mídias e formatos. Figura 1C apresenta as contagens em quatro intervalos de datas, e Figura 1D resume a composição por fonte e tipo de mídia do corpus. Como os intervalos de datas abrangem períodos desiguais, essas contagens descrevem a composição do corpus amostrado e não devem ser interpretadas como taxas históricas de produção.
Tabela 1 resume as características agregadas do corpus. As coleções de museus corresponderam a 302 registros, os arquivos digitais a 81 e os catálogos publicados a 50. Os suportes foram categorizados como aquarela de exportação (n = 176), pintura sobre papel de pith (n = 112), folha de álbum de exportação (n = 83), pintura de figura (n = 41) e outro formato (n = 21). Os metadados foram classificados como completos (n = 288), parciais (n = 118) ou mínimos (n = 27). As figuras femininas foram classificadas como centrais (n = 214), secundárias (n = 102) ou múltiplas (n = 117). Cada bloco de classificação compreendeu os 433 registros.
Rótulos preliminares de IA e categorias de referência humana
Tabela 2 resume o acordo agregado entre as etiquetas preliminares geradas por IA e as categorias de referência humana ao longo das 433 pinturas, enquanto Tabela Suplementar 1 fornece as respectivas etiquetas preliminares de IA por caso, classificações dos codificadores, categorias de referência humana adjudicadas, status de correspondência e atribuições de agrupamento. No geral, as etiquetas de IA e de referência humana coincidiram em 356 pinturas, correspondendo a uma precisão de acerto exato de 82,2%. A revocação no nível de categoria foi calculada como a proporção de acertos exatos entre IA e humano em relação ao suporte de referência humana para cada categoria.
A recordação em nível de categoria variou de 73,3% para cenas rituais/casamentos (33/45) a 88,4% para elite/beleza (99/112). A recordação foi de 84,7% para trabalho (61/72), 82,1% para atuação (32/39), 79,7% para ambiente doméstico (51/64), 79,3% para servo (46/58) e 79,1% para mercado (34/43). No geral, a concordância exata foi de 356/433 (82,2%). A avaliação dos pares em nível de caso permitiu o cálculo da precisão e dos escores F1 em todas as sete categorias, variando de 74,5% a 89,2% para a precisão e de 0,75 a 0,88 para os escores F1. Uma matriz de confusão abrangente detalhando os falsos positivos por classe-alvo e os padrões fora da diagonal é fornecida na Figura Suplementar 1.
Resumos dos padrões computacionais relatados
Figura 2 apresenta quatro exibições de análises computacionais relatadas. Figura 2A mostra uma galeria de nove pinturas com sobreposições coloridas de segmentação utilizadas para localização visual e revisão. Figura 2B mostra um gráfico de dispersão UMAP dos embeddings de imagens CLIP relatados, com contornos de densidade rotulados de C1 a C7. Figura 2C compara o número relatado de pinturas (pontos sólidos) com a recordação em nível de categoria (círculos vazados), e Figura 2D apresenta uma galeria de pinturas representativas agrupadas de acordo com as mesmas etiquetas. A validação dos agrupamentos apoiou a solução de agrupamento selecionada, que resultou em um escore de silhueta de 0,54 e um índice de Davies–Bouldin de 0,92. O mapeamento entre agrupamentos e categorias humanas demonstrou forte alinhamento, com cada agrupamento derivado correspondendo predominantemente a uma categoria de referência humana distinta.
Tabela 3 apresenta sete perfis computacionais relatados com tamanhos amostrais correspondentes aos sete suportes de categorias de referência humana. A tabela de contingência agrupada por categoria é fornecida na Tabela Suplementar 2 e mostra a distribuição das sete categorias de referência humana adjudicadas entre os agrupamentos C1–C7. A análise dessas atribuições de agrupamento em nível de caso demonstrou que o agrupamento computacional recuperou estruturas visuais que correspondiam estreitamente às sete categorias de referência humana.
Associações baseadas em pistas visuais e síntese interpretativa
Tabela 4 resume os perfis qualitativos de pistas visuais utilizados para caracterizar as sete categorias codificadas por humanos. Esses perfis descrevem associações recorrentes entre vestuário, ambiente espacial, postura, objetos e relações sociais. Eles não foram derivados de uma tabulação cruzada quantitativa e, portanto, não estabelecem status legal, etnia, causação social ou recepção pelo público.
Figura 3 integra resumos quantitativos descritivos das características visuais codificadas com um modelo conceitual interpretativo. Figura 3A apresenta as sete categorias de referência humana adjudicadas e seus tamanhos amostrais. Figura 3B mostra as associações relativas entre essas categorias e os marcadores visuais codificados ao longo de cinco dimensões: vestuário, cenário espacial, objetos, postura e relações sociais. As intensidades das associações exibidas foram calculadas a partir das anotações em nível de caso dentro de cada categoria de referência humana. Figura 3C resume as relações entre as categorias de referência humana, as dimensões de marcação visual e os arquétipos de implicação de classe, utilizando fluxos ponderados derivados das observações codificadas. Essas relações quantitativas caracterizam padrões representacionais recorrentes nas pinturas amostradas e não devem ser interpretadas como estimativas de distribuições demográficas ou sociais históricas. Figura 3D apresenta um modelo conceitual interpretativo transcultural e deve ser compreendido como um referencial interpretativo historicamente fundamentado, e não como um caminho causal empiricamente testado.
Interpretação integrada de padrões visuais
Ao longo do corpus, as sete categorias de identidade feminina foram caracterizadas por combinações recorrentes de vestuário, cenário espacial, objetos, postura e relações sociais. Essas combinações forneceram evidências descritivas de convenções visuais padronizadas nas pinturas analisadas. As interpretações históricas relativas a gênero, hierarquia e mediação intercultural permaneceram inferenciais.
Em conjunto, os resultados agregados identificaram sete categorias de identidade feminina de referência humana e cinco dimensões recorrentes utilizadas para caracterizá-las: vestuário, cenário espacial, objetos, postura e relações sociais. As etiquetas preliminares de IA coincidiram com as categorias humanas adjudicadas em 356 de 433 pinturas (82,2%), com a menor taxa de recuperação ao nível das categorias observada em cenas rituais/casamentos (73,3%). Esses achados apoiaram a organização descritiva e a comparação do corpus. As etiquetas de IA–humano ao nível dos casos permitiram estimativas de precisão e F1 ao nível das categorias. Separadamente, a análise de agrupamento identificou estruturas que correspondiam às sete categorias de referência humana. Contudo, esses achados computacionais caracterizam convenções de representação visual, em vez de estabelecer afirmações causais sobre a realidade social histórica ou a recepção pelo público.
DISPONIBILIDADE DE DADOS:
Os dados que apoiam este estudo, incluindo metadados, informações de origem e registros de triagem, estão disponíveis por meio do Zenodo em https://doi.org/10.5281/zenodo.21130291.
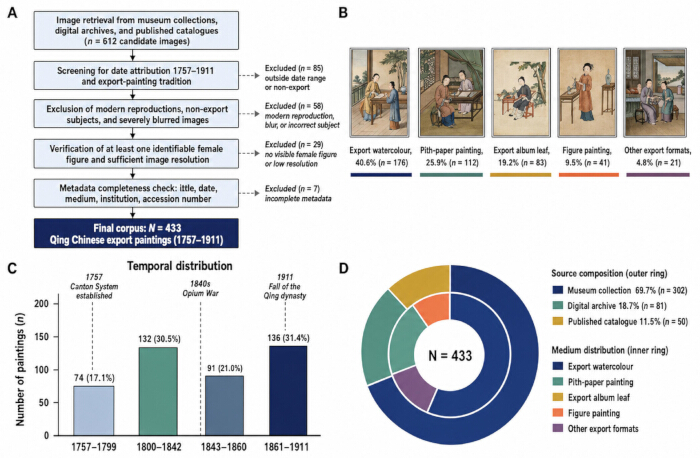
Figura 1: Construção do corpus e composição descritiva da amostra de 433 pinturas. (A) Triagem sequencial de 612 imagens candidatas, resultando em 433 pinturas elegíveis. As exclusões incluíram pinturas fora do período do estudo ou da tradição de pintura de exportação (n = 85), reproduções modernas, imagens desfocadas ou com temas incorretos (n = 58), imagens sem uma figura feminina identificável ou com resolução inadequada (n = 29) e registros com metadados insuficientes (n = 7). (B) Exemplos representativos de cinco mídias e formatos: aquarela de exportação (40,6%, n = 176), pintura em papel pith (25,9%, n = 112), folha de álbum de exportação (19,2%, n = 83), pintura de figura (9,5%, n = 41) e outros formatos de exportação (4,8%, n = 21). (C) Distribuição das pinturas amostradas em quatro intervalos cronológicos. (D) Distribuição das fontes de coleção (anel externo) e das mídias/formatos (anel interno). As porcentagens são baseadas na amostra total (N = 433) e arredondadas para uma casa decimal. Clique aqui para visualizar uma versão maior desta figura.
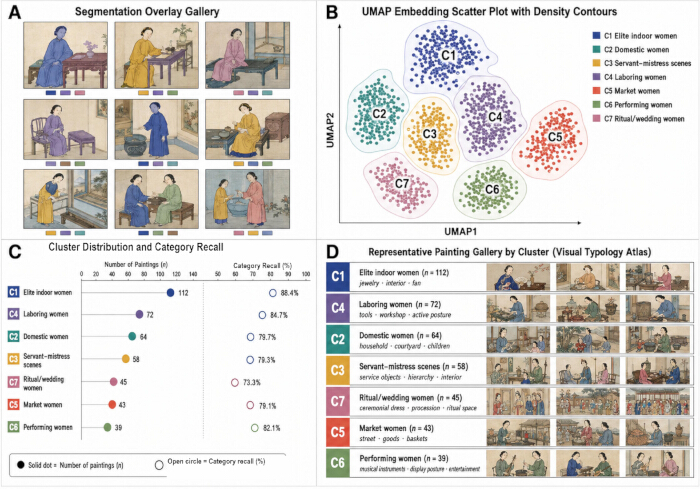
Figura 2: Segmentação relatada, visualização de incorporação, distribuição de agrupamentos, recuperação de categorias e pinturas representativas. (A) Galeria de nove pinturas com sobreposições coloridas de segmentação utilizadas para localizar figuras ou elementos visuais para análise. (B) Gráfico de dispersão UMAP dos incorporamentos de imagens CLIP relatados, com contornos de densidade e rótulos C1–C7. (C) Número relatado de pinturas (pontos sólidos, eixo superior) e recuperação de categoria (círculos vazados, eixo inferior); a recuperação de categoria equivale ao número de acertos exatos dividido pelo suporte de referência humana. Nenhum intervalo de confiança ou barra de erro é mostrado. (D) Galeria de pinturas representativas agrupadas pelos rótulos C1–C7, com imagens selecionadas com base em sua proximidade aos respectivos centróides dos agrupamentos. Abreviações: IA = inteligência artificial; CLIP = Pré-treinamento Contrastivo entre Linguagem e Imagem; SAM = Modelo de Segmentação Universal; UMAP = Aproximação Uniforme de Variedade e Projeção; C1–C7 = rótulos relatados 1–7. Clique aqui para visualizar uma versão maior desta figura.
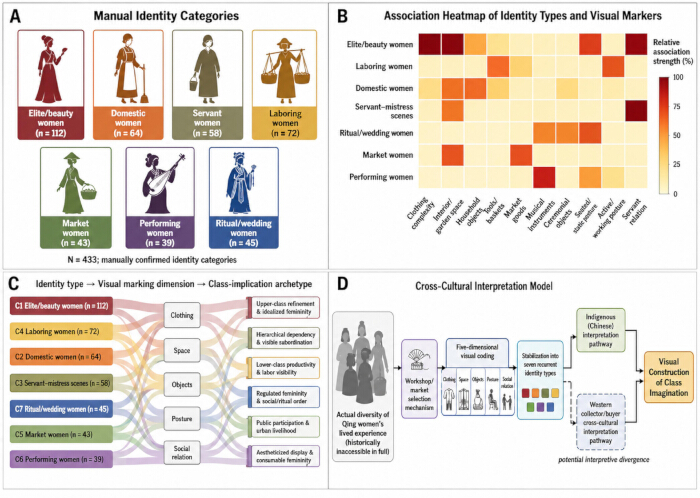
Figura 3: Associações de pistas visuais e estrutura interpretativa transcultural. (A) Sete categorias adjudicadas de identidade feminina de referência humana e seus tamanhos amostrais dentro do corpus de 433 pinturas. (B) Mapa de calor de associação mostrando a intensidade relativa das relações entre as sete categorias de referência humana e marcadores visuais codificados relacionados a vestuário, cenário espacial, objetos, postura e relações sociais. As intensidades de associação foram derivadas das anotações em nível de caso dentro de cada categoria. (C) Representação aluvial que resume as relações ponderadas entre categorias de referência humana, dimensões de marcação visual e arquétipos de implicação de classe com base nas observações codificadas. (D) Modelo conceitual de interpretação transcultural que conecta atividades representadas, seleção de oficinas e mercados, codificação visual pentadimensional, tipos recorrentes de identidade e possíveis trajetórias interpretativas. Clique aqui para visualizar uma versão ampliada desta figura.
Tabela 1: Características do corpus e completude dos metadados (N = 433). As contagens e porcentagens resumem seis blocos separados: intervalo de datas, fonte, suporte ou formato, completude dos metadados, representação de figuras femininas e tipo de cena. Cada bloco utiliza N = 433 como seu denominador e soma 433; as porcentagens são proporções do corpus dentro de cada bloco, arredondadas para uma casa decimal. Clique aqui para baixar este arquivo.
Tabela 2: Rótulos preliminares de IA e categorias de referência humana (N = 433). O suporte representa o número de pinturas atribuídas a cada categoria de referência humana. As correspondências exatas indicam pinturas para as quais o rótulo preliminar gerado por IA correspondeu à categoria de referência humana. O recall no nível da categoria é calculado como o número de correspondências exatas dividido pelo número de suportes de referência humana. Clique aqui para baixar este arquivo.
Tabela 3: Resumo do perfil computacional relatado. C1–C7 reproduzem os tamanhos dos perfis validados e as etiquetas dominantes. A integração das atribuições de clusters em nível de caso e da tabela de contingência entre clusters e categorias confirma que o agrupamento não supervisionado capturou efetivamente as estruturas visuais correspondentes às sete categorias de referência humana. Clique aqui para baixar este arquivo.
Tabela 4: Perfis qualitativos das categorias de identidade feminina e pistas visuais relacionadas à classe. As contagens e porcentagens resumem as categorias de referência humana, enquanto a vestimenta, o espaço, os objetos, a postura e as relações sociais caracterizam os perfis visuais recorrentes associados a cada categoria. As interpretações relacionadas à classe representam leituras iconográficas de padrões pictóricos, e não medidas diretas do status social histórico. Clique aqui para baixar este arquivo.
Figura Suplementar 1: Matriz de confusão comparando rótulos preliminares de IA com categorias de referência humana adjudicadas para o corpus de 433 pinturas. As linhas representam as categorias de referência humana adjudicadas (rótulos reais) e as colunas representam as categorias preliminares geradas pelo CLIP (rótulos previstos). Os valores das células indicam o número de pinturas para cada combinação de rótulos de IA e humanos. As células diagonais representam correspondências exatas entre IA e humano, com a taxa de recuperação específica da categoria apresentada como uma porcentagem. As células fora da diagonal representam discrepâncias entre a classificação preliminar de IA e a categoria de referência humana adjudicada. A precisão geral de correspondência exata foi de 82,2% (356/433). Clique aqui para baixar este arquivo.
Tabela Suplementar 1: Comparação por caso entre rótulos preliminares de IA, categorias de referência humanas adjudicadas e atribuições de agrupamento UMAP. Cada linha representa uma das 433 pinturas chinesas de exportação da dinastia Qing incluídas no corpus analítico. A tabela apresenta o identificador estável da imagem QEP, rótulo preliminar do CLIP ViT-B/32, classificações independentes dos Codificadores Humanos 1 e 2, categoria de referência humana adjudicada, status de correspondência entre IA e humano, e atribuição do agrupamento UMAP. “Correspondência Exata” indica concordância entre o rótulo preliminar de IA e a categoria de referência humana adjudicada; “Discordância” indica desacordo. A categoria humana adjudicada serviu como classificação de referência para as análises de concordância entre IA e humano. Clique aqui para baixar este arquivo.
Tabela Suplementar 2: Tabela de contingência das categorias de referência humana e atribuições de agrupamentos computacionais. As linhas representam as sete categorias de referência humana adjudicadas, e as colunas representam os agrupamentos C1–C7 obtidos a partir da análise computacional de agrupamento. Os valores das células indicam o número de pinturas atribuídas a cada combinação categoria–agrupamento. O suporte total representa o número de pinturas em cada categoria de referência humana. A concentração de observações entre as combinações categoria–agrupamento fornece uma avaliação descritiva da correspondência entre os agrupamentos computacionais derivados independentemente e as categorias de referência humana adjudicadas. Clique aqui para baixar este arquivo.
Discussão
Nas sumarizações agregadas fornecidas, 433 registros foram organizados em sete categorias de referência humana e descritos por meio de cinco famílias de sinais visuais. Elite/beleza foi a categoria mais numerosa (112/433), e 356 rótulos preliminares coincidiram com a referência humana relatada (82,2%). Essas são observações do corpus. Elas apoiam o estudo de fórmulas pictóricas recorrentes, mas não a proposição mais forte de que as fórmulas reproduzem fielmente a sociedade Qing ou provocaram uma resposta específica entre plateias estrangeiras13.
O discurso prescritivo de gênero, a posição doméstica, o trabalho e a lei Qing moldaram as vidas das mulheres sem determiná-las de forma uniforme. Estudos sobre mulheres do Alto Qing documentam sua participação no trabalho, na escrita, em rituais, na religião e no entretenimento, paralelamente aos regimes familiares e de castidade prescritivos. As Oito Banderas formaram um grupo de status hereditário e multiétnico definido por lei e pela prática administrativa; portanto, a filiação às Banderas não deve ser automaticamente equiparada à etnia manchu14,15,16,17. Neste estudo, a vestimenta, a postura, os objetos e o cenário são pistas pictóricas, e não evidência de posto legal, filiação Banner/Han, etnia, conformidade moral ou identidade vivida. Evidências arquivísticas e jurídicas seriam necessárias para sustentar tais afirmações.
Os resultados computacionais também exigem contenção cultural e técnica. Não se deve presumir que modelos gerais de visão e linguagem sejam culturalmente neutros. Os resultados publicados do CulturalVQA mostram desempenho desigual entre regiões e aspectos culturais, mas essa referência não avaliou o CLIP ViT-B/32 nem utilizou arte histórica do leste asiático8,18,19. Isso, portanto, motiva — em vez de substituir — um benchmark com casos comparáveis nesse corpus. Até que tal experimento esteja disponível, o CLIP atua como um auxiliar preliminar de organização, e não como autoridade sobre identidade ou hierarquia Qing. O fluxo computacional confirmou que o SAM funcionou estritamente como evidência auxiliar de localização; nenhuma máscara ou característica derivada de máscaras foi utilizada como entrada para rotulagem ou agrupamento, garantindo que a categorização visual dependesse exclusivamente dos embeddings semânticos globais das imagens não segmentadas. A pesquisa em patrimônio digital também enfatiza a sensibilidade cultural, supervisão interdisciplinar, acessibilidade, proteção de dados e fluxos de trabalho transparentes20.
Historicamente, a relevância dos padrões reside no comércio de pinturas para exportação: oficinas chinesas e a demanda estrangeira selecionaram e padronizaram temas que eram portáteis, compreensíveis e colecionáveis; imagens repetidas em oficinas também demonstram cópia com variação, e não duplicação puramente mecânica1,2,3,4,5. O corpus pode, portanto, contribuir para as histórias de gênero, hierarquia, representações do cotidiano e encontros interculturais, mostrando quais fórmulas se repetem em larga escala. No entanto, isso não indica que as imagens sejam registros etnográficos abrangentes. A comparação computacional pode orientar a leitura atenta e a contextualização intercultural21, enquanto registros de produção, históricos de compra e evidências de recepção devem sustentar afirmações sobre intenções de mercado ou significados para o público.
A resposta afetiva e cognitiva permanece como uma direção adicional de pesquisa, e não como um resultado do presente estudo. Shi e colegas combinaram avaliações de preferência, análise de dimensão latente e rastreamento ocular para distinguir caminhos emocionais, formal-estéticos e cognitivos em respostas a imagens de lanternas de pino de Xiashi22. Um delineamento comparável poderia testar se observadores prestam atenção de forma diferente a roupas, objetos, postura ou hierarquia em pinturas de exportação. Como este estudo não coletou avaliações, rastreamento ocular ou outros dados do público, não é possível inferir ativação emocional, saliência visual ou recepção a partir do conteúdo da imagem isoladamente.
As limitações são teóricas, metodológicas e práticas. Teoricamente, as categorias de indícios materiais simplificam o gênero, as relações domésticas, a hierarquia legal, a etnia e a experiência vivida. Metodologicamente, as inferências são limitadas pela sobrevivência, coleta, digitalização, metadados, modelos de zero-shot, codificação e vieses de períodos desiguais. Embora o fluxo analítico demonstre detecção robusta de padrões, esses vieses estruturais enfatizam a necessidade de tratar as saídas computacionais como análises de convenções pictóricas, e não como janelas transparentes para a realidade social da dinastia Qing. Na prática, os direitos de imagem restringem a redistribuição, e os resultados podem não ser generalizáveis entre instituições, períodos, mídias ou ambientes computacionais. Sujeito a essas limitações, o estudo oferece um arcabouço supervisionado por humanos para transformar observações visuais recorrentes em questões históricas testáveis, em vez de conclusões automatizadas. Por ser um estudo interpretativo e não uma intervenção, ele não avaliou o progresso em direção a nenhum Objetivo de Desenvolvimento Sustentável (ODS) ou indicador. Seu tema é, contudo, relevante para o Objetivo 5, e sua documentação atenta aos direitos e sua estrutura educacional de cunho intercultural estão conceitualmente alinhadas com as metas 11.4 e 4.7; nenhum resultado de ODS foi mensurado. O pacote de reprodutibilidade fornecido alinha o estudo com os recentes apelos por fluxos de trabalho transparentes em patrimônio digital e com os requisitos FAIR de identificadores persistentes, metadados ricos, licenças, proveniência e dados, algoritmos, ferramentas e fluxos de trabalho reutilizáveis20,23.
Divulgações
Os autores não têm nada a declarar.
Agradecimentos
Os autores agradecem ao Museu Victoria e Albert, ao Museu Britânico, ao Museu de Arte Metropolitano, ao Museu Nacional de Arte Asiática do Smithsonian, ao Museu Peabody Essex, ao Museu de Arte de Hong Kong, à Biblioteca Britânica, ao Instituto de Pesquisa Getty e a outras instituições detentoras e equipes de catálogo cujos registros online apoiaram a descoberta do corpus. O acesso a um registro online não implica permissão para redistribuir sua imagem; os direitos e links de origem por painel são, portanto, documentados separadamente. Os autores também agradecem às comunidades de pesquisa aberta que apoiam o CLIP e o SAM, bem como ao apoio administrativo da City University of Macau e da Universidade Normal Politécnica de Guangdong.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | Modelo de visão e linguagem utilizado para análise preliminar de similaridade entre imagem–texto e atribuição de rótulos preliminares de IA. |
| Estação de trabalho computacional | Estação de trabalho computacional dos autores’ | GPU com suporte a CUDA; configuração exata do hardware a ser informada | Estação de trabalho utilizada para inferência do CLIP e do SAM e análises computacionais; as especificações da GPU, CPU, RAM, sistema operacional e CUDA devem ser relatadas a partir do ambiente original de execução. |
| Matplotlib | Equipe de desenvolvimento do Matplotlib | Pacote Python; versão exata a ser informada | Utilizado para visualização computacional e geração de figuras e gráficos de análise. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | Utilizado para organização de metadados, registros de triagem e gerenciamento de dados tabulares do estudo. |
| NumPy | Desenvolvedores do NumPy | Pacote Python; versão exata a ser informada | Utilizado para cálculos numéricos e manipulação de matrizes de características de imagem e dados analíticos. |
| pandas | Equipe de desenvolvimento do pandas | Pacote Python; versão exata a ser informada | Utilizado para manipulação de dados estruturados, processamento de metadados e organização de resultados analíticos por caso. |
| Python 3.10 | Python Software Foundation | Python 3.10 | Ambiente de programação utilizado para implementar o fluxo de trabalho computacional de análise de imagens. |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | Framework de aprendizado profundo utilizado para execução da codificação de imagens e textos baseada no CLIP e inferência com GPU. |
| scikit-learn | Desenvolvedores do scikit-learn | Pacote Python; versão exata a ser informada | Utilizado para cálculos de agrupamento por K-médias, agrupamento aglomerativo, coeficiente de silhueta, índice de Davies–Bouldin e kappa de Cohen’. |
| Modelo de Segmentação Universal (SAM) | Pesquisa da Meta AI | SAM | Modelo de segmentação utilizado para localizar figuras femininas, vestuários, móveis, ferramentas, objetos rituais e regiões arquitetônicas para inspeção visual. |
| umap-learn | McInnes et al. | Implementação Python do UMAP | Utilizado para redução de dimensionalidade e visualização bidimensional dos embeddings de imagens do CLIP com distância cosseno. |
Referências
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.