O VoiceNet-RAI integra características MFCC, incorporações multilíngues do wav2vec 2.0 e EfficientNet-Lite para classificação de gênero e idade a partir de dados de voz. O framework alcança até 97,87% de precisão no subconjunto em língua inglesa e suporta aplicações responsáveis em reconhecimento de fala, autenticação e perícia digital.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
VoiceNet: Uma Estrutura de Fala Multilíngue de Inteligência Artificial Responsável para Classificação de Gênero e Idade
127 visualizações
⸱
11 de setembro de 2026
Neste artigo
Resumo
Resumo
A classificação precisa de gênero e idade a partir de dados de voz é importante para uma interação humano-computador (IHC) personalizada, segura e ética. Com o crescente uso de modelos de fala pré-treinados em larga escala, como o wav2vec 2.0, surge a necessidade de utilizar essas representações de forma responsável para inferência demográfica multilíngue e com atenção à privacidade. Este estudo propõe o VoiceNet-RAI, um framework de aprendizado profundo (DL) que integra coeficientes cepstrais em escala de frequência Mel (MFCCs) com incorporações multilíngues baseadas em transformador do wav2vec 2.0 dentro de uma arquitetura EfficientNet-Lite, para apoiar classificação precisa, justa e transparente em diversos contextos linguísticos. O framework combina informações espectrais e contextuais para melhorar a robustez sob condições variáveis de gravação. Experimentos com dados de fala multilíngues cobrindo 28 idiomas demonstraram alto desempenho na classificação, com o subconjunto em inglês alcançando precisão de 97,87%, exatidão de 98,61%, revocação de 98,70% e pontuação F1 de 98,65%. A validação externa utilizando o conjunto de dados Mozilla Common Voice resultou em precisão de 98,27% na classificação de gênero, demonstrando generalização para um conjunto de dados independente. Uma análise de ablação mostrou ainda que a combinação de características MFCC e wav2vec 2.0 melhorou o desempenho em comparação com representações apenas brutas ou exclusivamente com MFCC. Esses resultados demonstram o potencial de representações híbridas de fala espectrais-contextuais para classificação robusta e responsável de gênero e idade.
Introdução
O reconhecimento de voz é um componente fundamental da comunicação humana, por meio do qual os indivíduos expressam seus sentimentos, pensamentos e objetivos. As vozes humanas são produzidas por um processo biológico no qual o ar é expelido dos pulmões e moldado em som pelos órgãos articulatórios, como lábios, língua e dentes1. O ouvido desempenha um papel essencial na identificação da voz e pode distinguir entre vozes masculinas e femininas com base em características como volume e altura. Uma característica que contribui para diferenças significativas na altura vocal entre homens e mulheres é o dimorfismo sexual2. A classificação por idade e gênero a partir da voz é relevante para diversas aplicações, incluindo interação homem-máquina, reconhecimento automático de gênero, saudações personalizadas, pré-classificação de emoções na fala e classificação de chamadas baseada em gênero3.
A fala é uma parte intrínseca da interação humana. A voz humana contém múltiplas características que variam entre indivíduos e podem fornecer informações sobre estados emocionais e mentais, bem como idade e sexo. Essas características multidimensionais podem ser utilizadas em aplicações como sistemas de segurança baseados em voz e assistentes de Inteligência Artificial (IA) orientados à fala. Outras áreas nas quais a análise de voz é importante incluem sistemas de Verificação Automática de Locutor (ASV) e sistemas de IA baseados em emoção. Sistemas de entrada baseados em voz também podem reduzir o espaço de busca em bancos de dados4,5. Além disso, sistemas de segurança baseados em IA podem usar dados de voz em aplicações como investigações criminais e proteção de vítimas. As vozes masculinas e femininas apresentam características diferentes devido a variações nas propriedades ressonantes do trato vocal. Essas características podem ser extraídas de sinais de fala em um formato adequado para processamento computacional, permitindo a classificação de gênero a partir de dados de voz6,7. Portanto, são necessários algoritmos eficazes de aprendizado para a classificação de gênero baseada em voz. Algoritmos de Aprendizado Profundo (DL) são particularmente adequados para classificação relacionada à fala devido à sua capacidade de aprender padrões complexos a partir de dados de áudio. Tais modelos podem conter camadas convolucionais, recorrentes, convolucionais temporais ou totalmente conectadas, dependendo da arquitetura. Essas camadas podem aprender características acústicas relevantes, incluindo tom e entonação. Uma vez treinado, um modelo pode classificar o gênero a partir de gravações de áudio previamente não vistas8. Outra área importante da pesquisa em Aprendizado de Máquina (ML) é a classificação de idade a partir de gravações de voz. Algoritmos de ML podem usar características acústicas como entonação, timbre e amplitude para identificar padrões relacionados à idade. Técnicas como Análise de Componentes Principais (PCA) também podem ser aplicadas para extrair padrões informativos de dados de fala e potencialmente melhorar o desempenho da classificação9.
A aprendizagem profunda (DL) demonstrou alto desempenho em aplicações como reconhecimento de imagem, emoção e fala. Redes Neurais Profundas (DNNs), em particular, são amplamente utilizadas em tarefas relacionadas à fala. Neste estudo, abordagens baseadas em DL são aplicadas à classificação de voz em combinação com técnicas estabelecidas de extração de características. Os Coeficientes Cepstrais na Escala de Frequência Mel (MFCCs) capturam características espectrais relevantes dos sinais de fala e fornecem uma representação eficiente para o processamento subsequente. As características extraídas são posteriormente integradas em um framework de aprendizagem por transferência para classificação de gênero e idade baseada na voz10,11.
Estudos recentes têm adotado cada vez mais representações de fala auto-supervisionadas e baseadas em Transformer para classificação de atributos do falante. Pesquisadores investigaram vieses demográficos, incluindo vieses de gênero e idade, em modelos de fala auto-supervisionados, como o HuBERT e o wav2vec 2.0, destacando a importância de avaliações conscientes da equidade12. Mais recentemente, abordagens baseadas em Transformer e independentes de idioma demonstraram a eficácia de representações de fala contextuais aprendidas para o reconhecimento de gênero em condições multilíngues e ruidosas13. Sinha et al. investigaram ainda mais as representações do wav2vec 2.0 por camadas para classificação de idade e gênero e mostraram que diferentes camadas do Transformer capturam níveis variados de informações relacionadas ao falante14. Esses avanços motivam o framework proposto VoiceNet-RAI, que combina informações espectrais convencionais baseadas em MFCC com representações contextuais do wav2vec 2.0, incorporando ao mesmo tempo considerações multilíngues e de Inteligência Artificial Responsável.
Estudos recentes demonstraram que a idade e o gênero do falante podem ser caracterizados usando tanto características acústicas convencionais quanto representações baseadas em aprendizado profundo. Abordagens que combinam informações acústicas e temporais mostraram que características complementares da fala podem melhorar o desempenho da classificação de idade e gênero15,16. Pesquisas relacionadas também demonstraram que características de fala transformadas, geradas usando representações profundas do tipo gargalo (bottleneck), podem melhorar o desempenho da classificação de idade e gênero do falante17. Esses achados apoiam o uso mais amplo de representações espectrais, temporais e aprendidas em tarefas de classificação envolvendo sinais de fala e derivados da fala.
Vários estudos investigaram o reconhecimento de idade e gênero a partir da fala utilizando abordagens de aprendizado de máquina e aprendizado profundo18,19,20,21,22,23,24,25,26,27,28,29,30. Abordagens mais recentes exploraram representações transformadas de MFCC e redes neurais profundas para classificação de idade e gênero do falante31, enquanto a variabilidade multilíngue e dependente do idioma permanece uma consideração importante no desenvolvimento de sistemas robustos de classificação demográfica baseados na voz. Diferenças na pronúncia, estrutura fonética, características do falante e condições de gravação podem reduzir a generalização do modelo entre idiomas e populações. Assim, o uso de representações espectrais e contextuais complementares da fala pode melhorar a robustez em contextos multilíngues.
Embora abordagens híbridas tenham anteriormente combinado múltiplas características acústicas ou classificadores em conjunto para reconhecimento demográfico baseado na voz, o VoiceNet-RAI se diferencia ao integrar dois níveis complementares de representação da fala dentro de um quadro unificado. Especificamente, as características convencionais de MFCC preservam características espectrais e vocais localizadas, enquanto o wav2vec 2.0 fornece representações contextualizadas aprendidas a partir de sinais de fala brutos usando um codificador Transformer. Em vez de depender exclusivamente de descritores acústicos manualmente elaborados ou de uma única representação profunda, o VoiceNet-RAI realiza a fusão em nível de características das representações de MFCC e wav2vec 2.0 agregadas temporalmente, refinando em seguida a representação híbrida resultante usando o EfficientNet-Lite. A novidade científica reside, portanto, na integração coordenada de representações espectrais, contextuais auto-supervisionadas e profundas leves para classificação de gênero e idade, juntamente com avaliação multilíngue, validação em conjunto de dados independente e análise de equidade em subgrupos. Essa combinação estende os tradicionais pipelines híbridos de classificação de fala para além da fusão de características orientada à precisão, rumo a um quadro que considera simultaneamente a complementaridade das representações, o design de modelos leves, a generalização e a Inteligência Artificial Responsável.
As principais contribuições desta pesquisa incluem o desenvolvimento de uma abordagem para identificar gênero e idade a partir de dados de voz, integrando características MFCC e wav2vec 2.0 com EfficientNet-Lite. Foram realizados extensos experimentos em um conjunto de dados de gravações de voz de 28 idiomas, avaliando-se características originais, características MFCC, características wav2vec 2.0 e suas combinações com modelos de ML e DL. O desempenho dos modelos é avaliado utilizando tanto o conjunto de dados multilíngue completo quanto o subconjunto em língua inglesa. O framework é ainda avaliado sob perspectivas multilíngue e de Inteligência Artificial Responsável, por meio de análises de subgrupos específicos por gênero e idioma, avaliação independente de locutores e validação utilizando o conjunto de dados Mozilla Common Voice. Além disso, o desempenho do framework proposto é comparado com abordagens de estado da arte relatadas na literatura existente, sendo fornecidos resultados de validação cruzada. Uma grande quantidade de pesquisas relacionadas já foi realizada, e Tabela 1 resume esses estudos, incluindo os modelos, conjuntos de dados e resultados relatados19,20,21,22,23,24,25,26,27,28,29,30,31.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo utilizou conjuntos de dados publicamente disponíveis, o BVC Challenging Voice Set e o Mozilla Common Voice, sem envolvimento direto de participantes. Portanto, não foi necessária aprovação ética institucional nem consentimento informado adicional. Apenas os dados necessários para classificação de gênero e idade foram processados, e nenhuma tentativa foi feita para identificar falantes individuais. A metodologia completa do fluxo de trabalho da estrutura proposta está apresentada na Figura 1.
Aquisição de dados
O conjunto de dados utilizado na abordagem proposta consistiu em arquivos de áudio no formato .wav obtidos do BVC Challenging Voice Set, um conjunto de voz de acesso público desenvolvido pelo grupo Biometrics Vision and Computing (BVC) e hospedado no GitHub32. O conjunto de dados continha gravações de voz de 526 indivíduos, incluindo 336 falantes do sexo masculino e 190 do sexo feminino. Ele compreendia aproximadamente 3.964 gravações, incluindo gravações de uma única frase e de múltiplas frases de cada falante. Tabela 2 resume as características demográficas, cobertura linguística, propriedades das gravações, estratégia de particionamento dos dados e configurações de pré-processamento utilizadas para os conjuntos de dados de fala na estrutura proposta do VoiceNet-RAI.
Extração de características
Os arquivos de áudio foram processados para extrair propriedades essenciais, que posteriormente foram armazenadas em um arquivo CSV. Metadados, incluindo idade, gênero e pronúncia do locutor, foram extraídos dos arquivos README correspondentes. Python, juntamente com o pacote SciPy, foi utilizado para processar os arquivos WAV e extrair características relevantes. A Transformada Rápida de Fourier (FFT) do NumPy e funções de frequência foram empregadas para converter os sinais de áudio do domínio do tempo para o domínio da frequência. Os arquivos WAV representavam a amplitude como uma função do tempo; no entanto, características relacionadas à frequência que poderiam distinguir vozes masculinas e femininas eram de maior interesse para a tarefa de classificação33.
Para transformar os sinais de áudio em representações no domínio da frequência, a Transformada Discreta de Fourier (DFT) foi implementada usando o algoritmo FFT. A transformada de Fourier converte um sinal no domínio do tempo em um espectro de frequência. Como esse espectro não preserva informações temporais, o sinal de áudio foi dividido em segmentos sobrepostos e a transformada de Fourier foi aplicada a cada segmento usando a abordagem da Transformada de Fourier de Curto Tempo (STFT). A função np.fft.fft gerou o espectro de frequência complexo, enquanto np.fft.fftfreq forneceu as frequências das amostras correspondentes. No diretório de amostras, havia 10 arquivos de áudio disponíveis para um único locutor. Cada arquivo WAV foi processado usando janelas deslizantes de 200 ms para extrair as frequências dominantes. Por exemplo, uma gravação de áudio de 4 segundos produziu uma lista de 20 valores de frequência. Para um diretório contendo 10 gravações, as 10 listas correspondentes, cada uma contendo 20 valores de frequência, foram combinadas em uma lista de listas. As frequências foram filtradas para manter valores entre 20 Hz e 280 Hz, enquanto ruídos potenciais em torno de 50 Hz foram excluídos.
Representação híbrida de características MFCC e wav2vec 2.0
Para capturar representações contextuais de alto nível da fala e características acústicas de baixo nível, este estudo empregou uma estratégia híbrida de extração de características que integrou características MFCC com incorporações baseadas no Transformer wav2vec 2.0.
Extração de características MFCC
Os coeficientes cepstrais na escala Mel (MFCCs) são características amplamente utilizadas no processamento de sinais de áudio e fala, especialmente em aplicações como reconhecimento de fala e identificação de falante34,35. Neste estudo, a extração de MFCCs transformou os sinais de áudio em vetores de características que representam propriedades perceptualmente relevantes da fala. O processo iniciou-se com a pré-enfatização para realçar os componentes de alta frequência, seguida por segmentação e janelamento para dividir o sinal em quadros curtos e sobrepostos. Cada amostra de áudio foi primeiramente reamostrada para 16 kHz e segmentada em quadros de 25 ms com sobreposição de 10 ms. A Transformada Rápida de Fourier foi então aplicada a cada quadro para converter o sinal do domínio do tempo para o domínio da frequência.
O espectro de frequência resultante foi submetido a uma série de bancos de filtros Mel que aproximaram a resposta de frequência não linear da percepção auditiva humana. Esses bancos de filtros enfatizaram frequências mais relevantes à percepção, ao mesmo tempo que reduziram a contribuição das menos informativas. O logaritmo da saída de cada banco de filtros foi posteriormente calculado para aproximar a sensibilidade logarítmica da audição humana em relação à intensidade sonora. Uma Transformada Cosseno Discreta (DCT) foi então aplicada às energias logarítmicas dos bancos de filtros para descorrelacionar os coeficientes e gerar uma representação compacta do sinal de áudio. Os coeficientes resultantes, conhecidos como MFCCs, capturaram características espectrais importantes da fala. Os MFCCs foram utilizados para classificação de gênero e idade porque capturam características acústicas que diferenciam vozes de acordo com esses atributos.
extração de incorporação wav2vec 2.0
O modelo Wav2vec 2.0 Base foi pré-treinado em grandes corpora de fala não rotulados. O modelo consistia em um codificador Transformer de múltiplas camadas que processava entradas de forma de onda bruta e gerava incorporações de fala contextualizadas36.
Dada uma forma de onda de entrada x ∈ RT, o modelo wav2vec 2.0 produziu uma sequência de representações latentes:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
em que cada vetor de incorporação tinha uma dimensionalidade de 768. Para obter uma representação de comprimento fixo adequada para classificação, foi aplicada uma operação de agrupamento temporal médio em todos os passos de tempo.
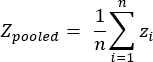 (2)
Mecanismo de fusão de características
As características MFCC e wav2vec 2.0 foram fundidas por meio de concatenação no nível de características. Especificamente, as características MFCC foram inicialmente agregadas utilizando média temporal para produzir um vetor de comprimento fixo.
m ∈ R40 (3)
O vetor de características híbrido final foi obtido como:
h = [m || zpooled] ∈ R808 (4)
onde || denota concatenação. Essa fusão combinou incorporações contextuais profundas com características espectrais elaboradas manualmente, permitindo que o modelo capturasse tanto informações semânticas de alto nível quanto padrões acústicos finos.
Todas as amostras de áudio foram primeiramente reamostradas para 16 kHz. As características MFCC foram calculadas por quadro e médias temporalmente para produzir um vetor fixo de 40 dimensões, enquanto os embeddings do wav2vec 2.0 foram agrupados pela média ao longo do tempo para gerar uma representação de 768 dimensões. Como ambos os conjuntos de características foram convertidos em vetores de comprimento fixo antes da fusão, não foi necessária a alinhação temporal no nível dos quadros. As representações resultantes de MFCC e wav2vec foram então concatenadas em um vetor de características híbrido de 808 dimensões antes de serem fornecidas ao modelo de classificação.
Integração com EfficientNet-Lite
O vetor de características fundido, h, foi remodelado em um formato adequado para aprendizado de características e fornecido como entrada para o modelo EfficientNet-Lite para treinamento. Uma camada de projeção totalmente conectada primeiro mapeou o vetor de 808 dimensões para um espaço latente de maior dimensão, após o que os blocos EfficientNet-Lite refinaram as características hierárquicas. Camadas de normalização por lote e dropout foram empregadas para reduzir o sobreajuste e melhorar a generalização do modelo. A função de ativação SoftMax foi utilizada para gerar as probabilidades finais previstas para as classes de gênero e idade. A representação fundida, h ∈ R808, foi inicialmente tratada como um vetor de características unidimensional e passada por uma camada de projeção totalmente conectada que a mapeou para 4.096 dimensões. A representação projetada foi então remodelada em um tensor 1 × 64 × 64 antes de ser fornecida à arquitetura EfficientNet-Lite.
Para acomodar a representação de características de fala de canal único, em vez da entrada convencional de imagem de três canais, a camada convolucional de entrada do EfficientNet-Lite original foi modificada de três para um canal de entrada. Os demais blocos de extração de características do EfficientNet-Lite foram mantidos sem modificações arquitetônicas significativas. Uma camada de agrupamento médio global adaptativo foi aplicada aos mapas de características finais para produzir uma representação de comprimento fixo. A cabeça de classificação original foi substituída por uma camada totalmente conectada específica para a tarefa, contendo duas unidades de saída para classificação de gênero e o número correspondente de unidades de saída para os grupos etários predefinidos. Por fim, a função de ativação SoftMax foi aplicada para gerar as probabilidades das classes. A representação híbrida proposta combinou incorporações de fala modernas auto-supervisionadas com características tradicionais de processamento de sinal. As incorporações wav2vec 2.0 capturaram informações contextuais e dependências de longo alcance, enquanto as características MFCC forneceram informações acústicas complementares de baixo nível. A integração dessas representações melhorou o desempenho da classificação, particularmente em condições de fala ruidosa e multilíngue.
Classificador ML
Nesta pesquisa, o desempenho de múltiplos algoritmos de ML foi analisado para a classificação baseada na voz por gênero e grupo etário.
Floresta Aleatória
A Floresta Aleatória (RF) foi utilizada como um classificador robusto de Aprendizado de Máquina (ML), combinando múltiplas Árvores de Decisão (DTs) para melhorar a precisão das previsões e reduzir o sobreajuste. O RF operou por meio de um procedimento de aprendizado conjunto, no qual as previsões de múltiplas árvores eram agregadas para gerar a previsão final37,38. Essa abordagem permitiu ao RF capturar padrões diversos nos dados, ao mesmo tempo que reduzia o sobreajuste comumente associado a DTs individuais. A aleatoriedade introduzida durante a construção das árvores melhorou a generalização do modelo, tornando o RF adequado para tarefas de classificação, como classificação de gênero e idade a partir de dados de voz.
Regressão Logística
A regressão logística (RL) foi utilizada como um modelo estatístico de aprendizado de máquina para classificação39. Para classificação binária, a RL estima a probabilidade de um resultado com base nas características de entrada usando a função logística (sigmoide), e as probabilidades resultantes são usadas para gerar previsões de classe. A RL também era aplicável a problemas de classificação multiclasse envolvendo mais de duas classes. Para classificação multiclasse, a RL utilizava abordagens como um-contra-todos ou regressão SoftMax, dependendo do contexto de classificação.
Classificador Extra Tree
O classificador Extra Trees (ETC) foi utilizado como um algoritmo de aprendizado conjunto que combina várias árvores de decisão (DTs) para gerar previsões40,41. Diferentemente da RF, o ETC introduz aleatoriedade adicional ao selecionar aleatoriamente as características candidatas e os limites de divisão durante a construção da árvore. Esse procedimento gerou árvores menos correlacionadas e reduziu a sensibilidade do modelo a características individuais, aumentando assim a robustez ao ruído. O índice de Gini foi utilizado como critério de divisão para avaliar a importância das características e particionar os dados.
Máquina de Vetores de Suporte
A máquina de vetores de suporte (SVM) foi utilizada como classificador de aprendizado de máquina para identificar um limite de decisão ótimo em um espaço de características de alta dimensão42. O objetivo era determinar um hiperplano que maximizasse a margem entre as classes. Uma margem maior entre o limite de decisão e os pontos de dados mais próximos geralmente favorecia uma melhor separação entre classes e generalização. A SVM era aplicável a diversas tarefas de aprendizado de máquina, incluindo classificação, regressão e análise de dados baseada em características.
Redes Neurais Convolucionais
Redes Neurais Convolucionais (CNNs) foram utilizadas como modelos de Aprendizado Profundo (DL) para tarefas de classificação envolvendo representações estruturadas de dados de imagem e áudio. Redes neurais convolucionais unidimensionais (1D-CNNs) também têm sido amplamente aplicadas a dados sequenciais e textuais. As arquiteturas de CNNs utilizaram filtros convolucionais e operações de agrupamento para extrair características discriminativas dos dados de entrada43,44. Para classificação de gênero e idade a partir de dados de voz, as CNNs foram aplicadas a representações derivadas da fala para aprender padrões associados ao tom, frequência, entonação e outras características vocais relevantes para distinguir grupos de gênero e idade.
VGG19
A VGG19 foi utilizada como uma arquitetura de aprendizado profundo caracterizada por uma estrutura hierárquica profunda e relativamente uniforme de extração de características45. Sua arquitetura empregou pequenos filtros convolucionais de 3 × 3 ao longo de 19 camadas, permitindo a extração progressiva de características discriminativas. Quando aplicada a representações derivadas da fala, a VGG19 capturou tanto padrões acústicos de baixo nível, como variações de tom e frequência, quanto características discriminativas de nível superior. Sua arquitetura profunda permitiu a abstração progressiva de características para modelar as características vocais associadas ao gênero e à idade.
EfficientNet-Lite
O EfficientNet-Lite foi utilizado como uma arquitetura de DL eficiente computacionalmente46,47. O modelo empregou uma estratégia de dimensionamento equilibrado para alcançar um bom desempenho de classificação, exigindo menos recursos computacionais do que arquiteturas de DL mais pesadas. Sua abordagem de dimensionamento composto considerou conjuntamente a profundidade, largura do modelo e resolução da entrada para obter uma extração eficiente de características.
O EfficientNet-Lite foi selecionado para o framework proposto VoiceNet-RAI devido à sua arquitetura leve e ao equilíbrio favorável entre desempenho de classificação e complexidade do modelo. Em comparação com arquiteturas mais pesadas, ele utilizou blocos convolucionais eficientes e dimensionamento composto para alcançar um aprendizado eficaz de características com menos parâmetros e menores requisitos computacionais. Essas características tornaram o EfficientNet-Lite adequado para o framework de classificação de fala proposto e proporcionaram potencial para implantação em ambientes com restrição de recursos.
MobileNet
O MobileNet foi utilizado como uma arquitetura de aprendizado profundo leve para aplicações com recursos computacionais limitados, incluindo ambientes de computação móvel e de borda48. Sua eficiência computacional foi alcançada principalmente por meio de convoluções separáveis por profundidade, que reduziram o número de parâmetros e operações computacionais em comparação com arquiteturas convolucionais tradicionais. Essas características tornaram o MobileNet adequado para avaliar a classificação de gênero e idade a partir de dados de voz, mantendo requisitos computacionais relativamente baixos.
InceptionV3
O InceptionV3 foi utilizado como uma arquitetura profunda para extrair características hierárquicas de representações derivadas da fala49. A arquitetura incorporou operações convolucionais, de agrupamento e mistas para extrair características em diferentes níveis de abstração. Para classificação de gênero e idade a partir de dados de voz, o InceptionV3 foi usado para aprender padrões acústicos complexos e representações hierárquicas associadas às variações nas características vocais.
Parâmetros de avaliação
A acurácia foi uma das métricas de avaliação mais frequentemente utilizadas para tarefas de classificação50. Embora a acurácia forneça uma medida útil do desempenho geral da classificação, ela nem sempre oferece uma avaliação abrangente, especialmente para conjuntos de dados desbalanceados. Portanto, métricas adicionais, incluindo precisão, revocação e pontuação F1, foram utilizadas para avaliar o desempenho do modelo. Essas métricas forneceram uma avaliação mais completa ao considerar as previsões corretas e incorretas para cada classe.
A acurácia foi definida como a razão entre as observações corretamente classificadas e o número total de observações. Embora a acurácia seja particularmente informativa para conjuntos de dados balanceados, o conjunto de dados utilizado neste estudo era desbalanceado. Portanto, os Verdadeiros Positivos (TP), Falsos Positivos (FP), Verdadeiros Negativos (TN) e Falsos Negativos (FN) foram considerados ao calcular e interpretar as métricas de classificação. A equação abaixo representa a definição padrão de acurácia:
Precisão = (VP+VN)/(VP+VN+FP+FN)×100 (5)
A precisão avalia a capacidade do classificador de retornar apenas instâncias relevantes:
Precisão= VP/(VP+FP) ×100 (6)
A sensibilidade, também conhecida como revocação, mede a capacidade do classificador de identificar todas as instâncias relevantes:
Recall= TP/(FN+TP) × 100 (7)
O valor F1 combina precisão e revocação em uma única medida e é particularmente útil para avaliar o desempenho de classificação em conjuntos de dados desbalanceados:
Pontuação F1 = 2 × (PPV × TPR)/(TPR + PPV) × 100 (8)
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Experimental results for age and gender classification were evaluated using MFCC-based and hybrid feature representations with ML and DL models. The dataset was partitioned into training and testing sets at an 80:20 ratio, with 80% used for training and 20% for testing. Speaker-level partitioning was applied to prevent recordings from the same speaker from appearing in both sets.
The hyperparameters and implementation details of the proposed framework are summarized in Table 3...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Este estudo desenvolveu e avaliou um framework automatizado para classificação de gênero e idade a partir de dados de voz, integrando características MFCC e incorporações wav2vec 2.0 com EfficientNet-Lite. Nos experimentos iniciais, o EfficientNet-Lite alcançou uma acurácia de 83,48%, precisão de 82,87%, revocação de 84,28% e pontuação F1 de 83,54% utilizando as características originais. Após a integração das características MFCC, o desempenho melhorou substancialmente, com acurácia de 92,64%, precisão de 93,79%, revoca...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm conflitos de interesse a declarar.
Agradecimentos
Os autores gostaria de agradecer ao Projeto de Apoio aos Pesquisadores da Universidade Princess Nourah bint Abdulrahman, número (PNURSP2026R748), Universidade Princess Nourah bint Abdulrahman, Riade, Arábia Saudita, pelo financiamento desta pesquisa.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Conjunto de Voz Desafiador BVC | Biometrics Vision and Computing Group / OgeNI | Conjunto de Voz Desafiador BVC | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite, variante exata utilizada | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| Unidade de Processamento Gráfico | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Conjunto de Dados Mozilla Common Voice | Fundação Mozilla | Common Voice, versão utilizada nos experimentos | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | Desenvolvedores do NumPy | Versão exata utilizada nos experimentos | https://numpy.org/ |
| Processador | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Fundação Python Software | Versão exata utilizada nos experimentos | https://www.python.org/ |
| PyTorch | Fundação PyTorch | Versão exata utilizada nos experimentos | https://pytorch.org/ |
| Scikit-learn | Desenvolvedores do Scikit-learn | Versão exata utilizada nos experimentos | https://scikit-learn.org/ |
| SciPy | Desenvolvedores do SciPy | Versão exata utilizada nos experimentos | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 11 | Microsoft | Windows 11, edição/versão exata, se disponível | https://www.microsoft.com/windows/windows-11 |
Referências
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.